Co to jest analiza pośrednia?
Analiza pośrednia (ang. interim analysis) to analiza danych zebranych przed planowanym końcem badania, wykonywana po to, by zdecydować, czy je kontynuować. Reguła zatrzymania (ang. stopping rule) to ustalona z góry granica statystyki testu: jej przekroczenie kończy badanie wcześniej. Pocock (1977) opisał grupowe plany sekwencyjne, w których rekrutację dzieli się na równe grupy, a po każdej testuje się zgromadzone dane.
Dlaczego potrzebna jest surowsza granica
Każde spojrzenie na dane to kolejny test, więc działa problem wielokrotnych porównań. Przy pięciu analizach (cztery pośrednie i końcowa) w badaniu bez prawdziwego efektu dokładny odsetek fałszywie pozytywnych wyników, czyli błąd I rodzaju, wynosi:
- |Z| > 1.96 w każdej analizie (bez korekty): 14.2%;
- Bonferroni (|Z| > 2.576): 3.3% – za ostrożnie;
- Pocock (stała granica 2.413): 5.0%;
- O'Brien–Fleming (4.562, 3.226, 2.634, 2.281, 2.040): 5.0%.
Granica O'Briena i Fleminga (1979) jest bardzo surowa na początku i zbliża się do 1.96 w analizie końcowej (nominalne p .041 wobec .016 u Pococka). Autorzy pokazali, że poziom istotności i moc całej procedury są praktycznie takie jak w pojedynczym teście na pełnej próbie. Lan i DeMets (1983) zaproponowali funkcję wydawania α, dzięki której liczby i terminów analiz nie trzeba ustalać z góry. Ogólniej o poprawkach na wielokrotne porównania piszemy osobno.
Na rysunku
Granice z poprzedniej sekcji narysowane razem ze ścieżkami statystyki Z w 100 badaniach bez efektu (A) i 100 badaniach z efektem (B). Efekt dobrano tak, by jeden test na pełnej próbie miał moc 90%.
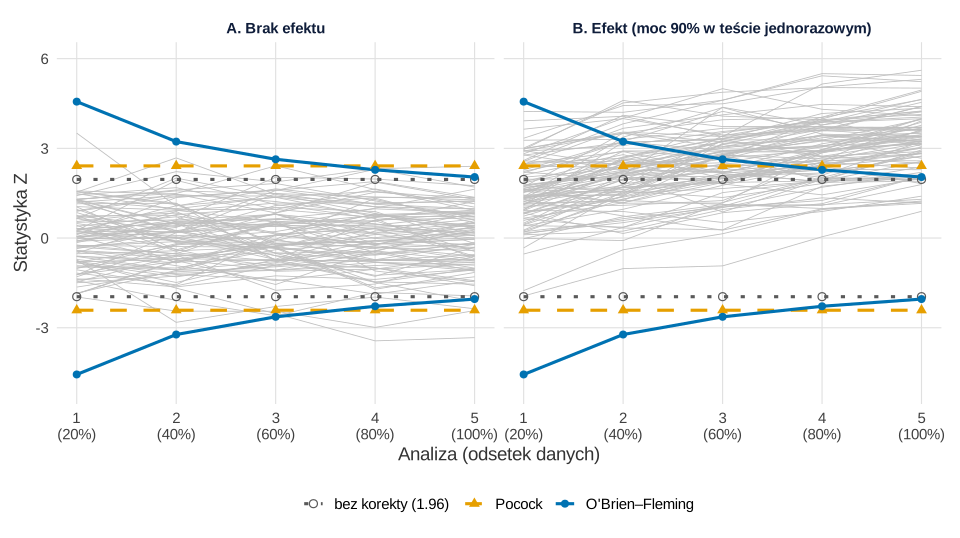
set.seed(415)).Co widać. Bez efektu ścieżki błądzą wokół zera i co jakiś czas wychodzą poza ±1.96 – z 100 narysowanych zrobiło to 12, a granice Pococka i O’Briena–Fleminga przekroczyło 7 i 6. Z efektem ścieżki rosną i reguły różnią się momentem zatrzymania. W 10 000 takich badań plan Pococka zatrzymał 16.6% badań już w pierwszej analizie, a plan O’Briena–Fleminga tylko 0.1%; za to O’Brien–Fleming wykrył efekt w 89.2% badań, a Pocock w 83.0% (błąd Monte Carlo 0.4 i 0.3 punktu procentowego). Średnio badanie kończyło się w analizie 3.13 przy Pococku i 3.68 przy O’Brienie–Flemingu.
Na co uważać. Liczby ze 100 ścieżek to ilustracja – dokładny błąd I rodzaju podaje lista wyżej (14.2% bez korekty, 5.0% z korektą). Wykres nie pokazuje, że badanie zatrzymane wcześnie zwykle zawyża efekt; to i oczekiwaną liczebność omawia wpis Analizy pośrednie w praktyce. Jak α rozkłada się między analizy, pokazuje rysunek w haśle funkcja wydatkowania alfa, a podglądanie bez planu – opcjonalne zatrzymywanie.
Podpis do pracy:
Kod bierze dokładne granice z rpact, jak przykład w R poniżej. Oba bloki losujące mają własne set.seed(415) – to samo ziarno co w przykładzie, ustalone raz. Liczbę 100 narysowanych ścieżek i wielkość efektu wybrano ręcznie. Rysunek na stronie różni się od wyniku kodu tylko motywem serwisu.
Kod R rysunku 1
# Rysunek 1. Granice Pococka i O'Briena-Fleminga w pięciu analizach oraz 100 ścieżek statystyki Z
# w badaniach bez efektu (A) i z efektem (B)
suppressPackageStartupMessages(library(rpact))
library(ggplot2)
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom", plot.title = element_text(face = "bold"))
kol <- c("bez korekty (1.96)" = "grey35", "Pocock" = "#E69F00", "O'Brien–Fleming" = "#0072B2")

K <- 5
gr <- rbind(naiwnie = rep(qnorm(0.975), K),
  Pocock = getDesignGroupSequential(kMax = K, alpha = 0.05, sided = 2, typeOfDesign = "P")$criticalValues,
  OBF    = getDesignGroupSequential(kMax = K, alpha = 0.05, sided = 2, typeOfDesign = "OF")$criticalValues)
round(gr, 3)
granice <- data.frame(analiza = rep(1:K, 3), z = c(t(gr)), regula = factor(rep(names(kol), each = K), levels = names(kol)))

# Ścieżki Z: suma k niezależnych porcji N(dryf, 1) podzielona przez sqrt(k)
# dryf = 0 (brak efektu) albo taki, by test jednorazowy na pełnej próbie miał moc 90% (oczekiwane Z na końcu = 3.24)
sciezki_z <- function(n, dryf) t(apply(matrix(rnorm(n * K, mean = dryf), n, K), 1, cumsum)) / matrix(sqrt(1:K), n, K, byrow = TRUE)
dryf_H1 <- (qnorm(0.975) + qnorm(0.90)) / sqrt(K)
# kiedy (w której analizie) dana reguła zatrzymuje badanie; 6 = brak przekroczenia granicy
kiedy_stop <- function(Z, g) apply(abs(Z) >= matrix(g, nrow(Z), K, byrow = TRUE), 1, function(x) if (any(x)) which(x)[1] else K + 1)

set.seed(415)
Z0 <- sciezki_z(100, 0); Z1 <- sciezki_z(100, dryf_H1)                # po 100 ścieżek na rysunku
# ile z narysowanych ścieżek przekroczyło granicę w którejkolwiek analizie
rbind(bez_efektu = apply(gr, 1, function(g) sum(kiedy_stop(Z0, g) <= K)),
      z_efektem  = apply(gr, 1, function(g) sum(kiedy_stop(Z1, g) <= K)))
# 10 000 badań z efektem: w której analizie zatrzymuje się badanie (%), z błędem MC
set.seed(415)
Zd <- sciezki_z(10000, dryf_H1)
st <- sapply(c(Pocock = "Pocock", OBF = "OBF"), function(r) 100 * table(factor(kiedy_stop(Zd, gr[r, ]), levels = 1:(K + 1))) / 10000)
rownames(st) <- c(paste0("analiza", 1:K), "brak_odrzucenia")
round(st, 1)
round(rbind(moc = 100 - st["brak_odrzucenia", ],
            blad_MC_pp = sqrt((100 - st["brak_odrzucenia", ]) * st["brak_odrzucenia", ] / 10000),
            srednia_analiza_zatrzymania = colSums(st[1:K, ] * 1:K) / 100 + st["brak_odrzucenia", ] / 100 * K), 2)

dl <- function(Z, scen) data.frame(id = rep(seq_len(nrow(Z)), K), analiza = rep(1:K, each = nrow(Z)), z = c(Z), scen = scen)
sc <- rbind(dl(Z0, "A. Brak efektu"), dl(Z1, "B. Efekt (moc 90% w teście jednorazowym)"))
gr_pl <- rbind(transform(granice, z = z), transform(granice, z = -z))
gr_pl$strona <- rep(c("gora", "dol"), each = nrow(granice))
p1 <- ggplot() +
  geom_line(data = sc, aes(analiza, z, group = id), colour = "grey75", linewidth = 0.3) +
  geom_line(data = gr_pl, aes(analiza, z, colour = regula, linetype = regula, group = interaction(regula, strona)), linewidth = 1.1) +
  geom_point(data = gr_pl, aes(analiza, z, colour = regula, shape = regula), size = 2.4) +
  facet_wrap(~ scen) +
  scale_colour_manual(values = kol, name = NULL) +
  scale_linetype_manual(values = c("dotted", "dashed", "solid"), name = NULL) +
  scale_shape_manual(values = c(1, 17, 16), name = NULL) +
  scale_x_continuous(breaks = 1:K, labels = paste0(1:K, "\n(", seq(20, 100, 20), "%)")) +
  coord_cartesian(ylim = c(-5, 6)) +
  labs(x = "Analiza (odsetek danych)", y = "Statystyka Z") +
  motyw
p1
Wynik w R
         [,1]  [,2]  [,3]  [,4]  [,5]
naiwnie 1.960 1.960 1.960 1.960 1.960
Pocock  2.413 2.413 2.413 2.413 2.413
OBF     4.562 3.226 2.634 2.281 2.040
           naiwnie Pocock OBF
bez_efektu      12      7   6
z_efektem       92     81  87
                Pocock  OBF
analiza1          16.6  0.1
analiza2          22.6 12.1
analiza3          19.2 33.5
analiza4          14.5 28.2
analiza5          10.1 15.3
brak_odrzucenia   17.0 10.8
                            Pocock   OBF
moc                          82.95 89.22
blad_MC_pp                    0.38  0.31
srednia_analiza_zatrzymania   3.13  3.68
Jak opisać w pracy
Na co uważać
- Reguła dopisana po fakcie. Liczbę analiz i granice zapisz w planie analizy statystycznej i przy rejestracji badania.
- Niezaplanowane spojrzenia. Każde liczy się do błędu I rodzaju, nawet jeśli nie przerwało badania.
- Brak opisu w raporcie. Podaj, ile analiz pośrednich wykonano i dlaczego badanie zakończono – zgodnie z wytycznymi CONSORT.
Błąd I rodzaju przy analizach pośrednich w R
Kod symuluje 100 000 badań bez prawdziwego efektu z pięcioma analizami, wyznacza granice Pococka i O'Briena–Fleminga na połowie symulacji i sprawdza na drugiej połowie, jak często każda reguła daje fałszywie pozytywny wynik. Druga część wyznacza dokładne granice funkcją rpact::getDesignGroupSequential() i dokładny błąd I rodzaju funkcją gsDesign::gsProbability(); symulacja daje wyniki bliskie dokładnym (bez korekty 14.4% wobec 14.2%).
Granice i błąd I rodzaju dla czterech reguł zatrzymania
R
# Błąd I rodzaju przy pięciu analizach (4 pośrednie + końcowa) w badaniu bez prawdziwego efektu.
set.seed(415)
K <- 5; powt <- 100000
# Statystyka Z po k-tej analizie = suma k niezależnych porcji N(0, 1) / sqrt(k)
Z <- t(apply(matrix(rnorm(powt * K), powt, K), 1, cumsum)) / matrix(sqrt(1:K), powt, K, byrow = TRUE)
# CZĘŚĆ 1 (symulacja): granice wyznaczone na pierwszej połowie symulacji, sprawdzone na drugiej
a <- 1:(powt / 2); b <- (powt / 2 + 1):powt
c_pocock <- quantile(apply(abs(Z[a, ]), 1, max), 0.95)                                     # stała granica
c_obf    <- quantile(apply(abs(Z[a, ]) * matrix(sqrt(1:K / K), length(a), K, byrow = TRUE), 1, max), 0.95)
granice <- rbind(naiwnie = rep(qnorm(0.975), K), Bonferroni = rep(qnorm(1 - 0.05 / (2 * K)), K),
                 Pocock = rep(c_pocock, K), OBrien_Fleming = c_obf * sqrt(K / 1:K))
colnames(granice) <- paste0("analiza", 1:K)
round(granice, 3)                                                                          # granice |Z|
round(apply(granice, 1, function(g) mean(apply(abs(Z[b, ]) > matrix(g, length(b), K, byrow = TRUE), 1, any))), 3)  # błąd I rodzaju
# CZĘŚĆ 2 (dokładnie): granice z rpact i błąd I rodzaju z gsDesign::gsProbability (całkowanie numeryczne)
library(rpact); library(gsDesign)
dokladne <- rbind(naiwnie = rep(qnorm(0.975), K), Bonferroni = rep(qnorm(1 - 0.05 / (2 * K)), K),
  Pocock = getDesignGroupSequential(kMax = K, alpha = 0.05, sided = 2, typeOfDesign = "P")$criticalValues,
  OBrien_Fleming = getDesignGroupSequential(kMax = K, alpha = 0.05, sided = 2, typeOfDesign = "OF")$criticalValues)
colnames(dokladne) <- paste0("analiza", 1:K)
round(dokladne, 3)                                                                         # dokładne granice |Z|
blad_I <- function(g) { x <- gsProbability(k = K, theta = 0, n.I = 1:K, a = -g, b = g); sum(x$upper$prob + x$lower$prob) }
round(apply(dokladne, 1, blad_I), 4)                                                       # dokładny błąd I rodzaju
round(apply(granice, 1, blad_I), 4)                                                        # dokładny błąd I rodzaju granic z symulacji
round(2 * pnorm(-dokladne[, K]), 4)                                                        # nominalne p w analizie końcowej
Wynik w R
               analiza1 analiza2 analiza3 analiza4 analiza5
naiwnie           1.960    1.960    1.960    1.960    1.960
Bonferroni        2.576    2.576    2.576    2.576    2.576
Pocock            2.414    2.414    2.414    2.414    2.414
OBrien_Fleming    4.593    3.248    2.652    2.297    2.054
       naiwnie     Bonferroni         Pocock OBrien_Fleming
         0.144          0.032          0.050          0.050
               analiza1 analiza2 analiza3 analiza4 analiza5
naiwnie           1.960    1.960    1.960    1.960    1.960
Bonferroni        2.576    2.576    2.576    2.576    2.576
Pocock            2.413    2.413    2.413    2.413    2.413
OBrien_Fleming    4.562    3.226    2.634    2.281    2.040
       naiwnie     Bonferroni         Pocock OBrien_Fleming
        0.1417         0.0327         0.0500         0.0500
       naiwnie     Bonferroni         Pocock OBrien_Fleming
        0.1417         0.0327         0.0499         0.0483
       naiwnie     Bonferroni         Pocock OBrien_Fleming
        0.0500         0.0100         0.0158         0.0413
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiety base i stats oraz rpact i gsDesign). Rysunek 1 wykonano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- rpact (wersja 4.4.0): Wassmer, G., & Pahlke, F. (2026). rpact: Confirmatory adaptive clinical trial design and analysis [R package]. https://doi.org/10.32614/CRAN.package.rpact
- gsDesign (wersja 3.11.0): Anderson, K. (2026). gsDesign: Group sequential design [R package]. https://doi.org/10.32614/CRAN.package.gsDesign
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Czy można zajrzeć do danych w trakcie badania bez żadnej korekty?
Można, ale każde spojrzenie z decyzją o przerwaniu to kolejny test. Pięć analiz z progiem |Z| > 1.96 daje 14.2% fałszywie pozytywnych wyników zamiast 5%.
Czym różni się granica Pococka od granicy O'Briena–Fleminga?
Granica Pococka jest taka sama w każdej analizie, więc łatwiej przerwać badanie wcześnie, ale analiza końcowa wymaga surowszego progu. Granica O'Briena–Fleminga jest bardzo wysoka na początku, a w analizie końcowej bliska zwykłemu 1.96.
Co zrobić, gdy terminów analiz pośrednich nie da się ustalić z góry?
Użyj funkcji wydawania α (Lan i DeMets, 1983). Określa ona, jaką część błędu I rodzaju można zużyć do danego momentu badania, więc granica zależy od dotychczasowych analiz, a nie od ich łącznej liczby.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Plan analizy statystycznej i prerejestracja
12 elementów planu analizy, moc i SESOI w R, OSF czy AsPredicted, registered reports, tabela odstępstw i wzór planu w Wordzie do pobrania.
Czytaj →PoradnikPoprawki na wielokrotne porównania
Bonferroni, Holm, Hochberg, BH i BY na jednym przykładzie: co kontroluje każda poprawka, kiedy którą wybrać i jak opisać wynik w pracy.
Czytaj →PoradnikSTROBE, CONSORT i TRIPOD – która lista
Jak dobrać listę raportowania do schematu badania, wypełnić ją z numerami stron i obsłużyć punkty „nie dotyczy” – z tabelą i schematem wyboru.
Czytaj →PoradnikBadania kliniczne i pomiar przed i po – przewodnik
Osiem etapów badania z interwencją: schemat, etyka, błąd pomiaru, liczebność, ITT, ANCOVA, RCI i MCID oraz CONSORT – z linkami do każdego etapu.
Czytaj →PoradnikAnalizy pośrednie w praktyce
Plan grupowo-sekwencyjny w R: granice Pococka i OBF, wzrost N, symulacja błędu I rodzaju, daremność i zawyżony efekt po wczesnym zatrzymaniu.
Czytaj →PoradnikSekwencyjny test A/B i granice zatrzymania
Gazeta cyfrowa testuje paywall z 4 analizami pośrednimi: granice O’Briena–Fleminga i Pococka, fałszywe alarmy, czas testu i zawyżony efekt – z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Lan, K. K. G., & DeMets, D. L. (1983). Discrete sequential boundaries for clinical trials. Biometrika, 70(3), 659–663. https://doi.org/10.1093/biomet/70.3.659
- O'Brien, P. C., & Fleming, T. R. (1979). A multiple testing procedure for clinical trials. Biometrics, 35(3), 549–556. https://doi.org/10.2307/2530245
- Pocock, S. J. (1977). Group sequential methods in the design and analysis of clinical trials. Biometrika, 64(2), 191–199. https://doi.org/10.1093/biomet/64.2.191
Cytowania BibTeX
@article{lan1983discrete, author={Lan, K. K. Gordon and DeMets, David L.}, title={{Discrete sequential boundaries for clinical trials}}, journal={Biometrika}, year={1983}, volume={70}, number={3}, pages={659--663}, doi={10.1093/biomet/70.3.659}}@article{obrien1979multiple, author={O'Brien, Peter C. and Fleming, Thomas R.}, title={{A multiple testing procedure for clinical trials}}, journal={Biometrics}, year={1979}, volume={35}, number={3}, pages={549--556}, doi={10.2307/2530245}}@article{pocock1977group, author={Pocock, Stuart J.}, title={{Group sequential methods in the design and analysis of clinical trials}}, journal={Biometrika}, year={1977}, volume={64}, number={2}, pages={191--199}, doi={10.1093/biomet/64.2.191}}