Co to jest opcjonalne zatrzymywanie?
Opcjonalne zatrzymywanie (ang. optional stopping) to kończenie zbierania danych w zależności od bieżącego wyniku testu: badacz sprawdza p po kolejnych porcjach osób i przerywa, gdy wynik stanie się istotny, a gdy nie – dobiera następne. To jedna z form p-hackingu. Simmons, Nelson i Simonsohn (2011) pokazali w symulacjach i dwóch eksperymentach, że taka nieujawniona elastyczność w zbieraniu i analizie danych drastycznie podnosi rzeczywisty odsetek wyników fałszywie pozytywnych.
Dlaczego zawyża błąd I rodzaju
Każde spojrzenie na dane to kolejna szansa na błąd I rodzaju. Gdy hipoteza zerowa jest prawdziwa, wartość p w miarę napływu danych błądzi i może na chwilę spaść poniżej .05. Kto zatrzyma się właśnie wtedy, zapisze wynik istotny, który przy pełnej próbie by zniknął. Armitage, McPherson i Rowe (1969) wykazali, że przy powtarzanych testach na tym samym nominalnym poziomie prawdopodobieństwo istotnego wyniku na którymś etapie może być znacznie większe niż ten poziom.
Przykład
W 10 000 symulowanych badań z dwiema grupami bez żadnej różnicy test t wykonany raz, po 100 osobach w grupie, dał wynik istotny w 5.0% przypadków. Gdy wynik sprawdzano po 50 i po 100 osobach, odsetek wzrósł do 8.1%, przy pięciu spojrzeniach (co 20 osób) do 14.4%, a przy dziesięciu (co 10 osób) do 19.6%. Poprawka Bonferroniego (α = .005 przy każdym z 10 spojrzeń) obniżyła go do 2.7% – błąd jest pod kontrolą, ale kosztem mocy testu.
Na rysunku
Rysunek pokazuje symulację z przykładu z dwóch stron: jak wartość p błądzi w pojedynczych badaniach i jak rośnie odsetek fałszywych alarmów, gdy spojrzeń przybywa.
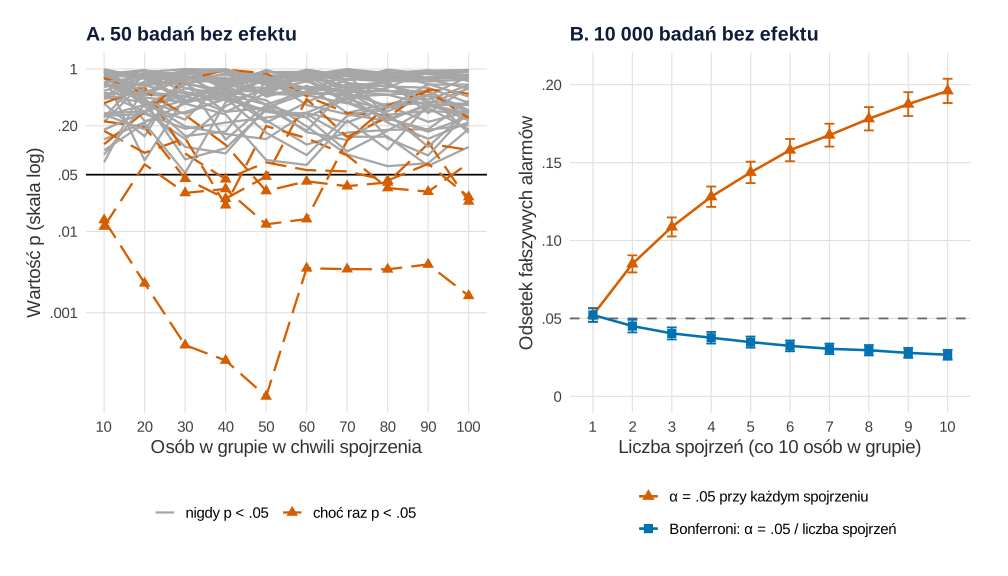
set.seed(705)).Co widać. W panelu A 7 z 50 ścieżek choć raz spada poniżej .05, a tylko 3 z nich kończą się istotnym wynikiem przy 100 osobach. Kto przerwałby badanie przy pierwszym p < .05, zapisałby 7 „odkryć” zamiast 3. Ścieżki nie są niezależnymi losowaniami – każda kolejna analiza zawiera wcześniejsze osoby, więc p zmienia się płynnie i potrafi długo krążyć tuż przy progu. W panelu B jedno spojrzenie (po 10 osobach) daje .052, dwa – .085, pięć – .144, a dziesięć – .196 (błąd Monte Carlo najwyżej 0.4 pp). Z poprawką Bonferroniego odsetek spada do .027 przy dziesięciu spojrzeniach.
Na co uważać. Spojrzenia na osi B są kolejnymi analizami co 10 osób, więc przy dwóch spojrzeniach wynik (.085) różni się od przykładu wyżej, w którym patrzono po 50 i 100 osobach (.081). Wykres pokazuje tylko błąd I rodzaju: nie pokazuje, ile mocy kosztuje poprawka Bonferroniego, ani że wczesne zatrzymanie przy prawdziwym efekcie zawyża jego oszacowanie (klątwa zwycięzcy). Ten sam problem przy wielu testach zamiast wielu spojrzeń pokazuje wpis Wielokrotne testy w obrazkach.
Podpis do pracy (np. w części o planie analiz):
Kod powtarza symulację z przykładu (to samo ziarno 705, ustalone raz i niezmieniane). W panelu A pierwotnie miało być pierwszych 20 badań, ale żadne nie spadło w nich poniżej .05, więc liczbę zwiększono do 50 – nadal są to pierwsze badania z symulacji, bez wybierania. Kod liczy się w kilka sekund. Rysunek na stronie różni się od wyniku kodu tylko motywem (krój i kolor czcionki, siatka).
R – kod rysunku
# Rysunek 1. Ścieżki p przy dokładaniu po 10 osób (A) i odsetek fałszywych alarmów a liczba spojrzeń (B)
# Symulacja jak w przykładzie z hasła: H0 prawdziwa, 10 000 badań, test t po 10, 20, ..., 100 osobach w grupie
library(ggplot2)
library(patchwork)
set.seed(705)
R <- 10000
etapy <- seq(10, 100, by = 10)
p_etap <- matrix(NA, R, length(etapy))
for (r in 1:R) {
  a <- rnorm(100); b <- rnorm(100)
  for (j in seq_along(etapy)) {
    n <- etapy[j]
    p_etap[r, j] <- t.test(a[1:n], b[1:n], var.equal = TRUE)$p.value
  }
}
# B: odsetek badań z p < .05 przy którymkolwiek z pierwszych k spojrzeń (k = 1, ..., 10)
fa <- function(alfa_k) sapply(1:10, function(k) mean(apply(p_etap[, 1:k, drop = FALSE] < alfa_k(k), 1, any)))
krzywe <- rbind(data.frame(k = 1:10, odsetek = fa(function(k) .05), wariant = "α = .05 przy każdym spojrzeniu"),
                data.frame(k = 1:10, odsetek = fa(function(k) .05 / k), wariant = "Bonferroni: α = .05 / liczba spojrzeń"))
krzywe$wariant <- factor(krzywe$wariant, levels = unique(krzywe$wariant))
krzywe$blad_MC <- sqrt(krzywe$odsetek * (1 - krzywe$odsetek) / R)
print(within(krzywe, { odsetek <- round(odsetek, 3); blad_MC <- round(blad_MC, 4) }), row.names = FALSE)

# A: pierwsze 50 symulowanych badań (bez wybierania; wśród pierwszych 20 żadne nie spadło poniżej .05)
pierwsze <- 50
sciezki <- data.frame(badanie = rep(1:pierwsze, each = 10), n = rep(etapy, pierwsze), p = c(t(p_etap[1:pierwsze, ])))
sciezki$typ <- ave(sciezki$p, sciezki$badanie, FUN = function(x) any(x < .05))
sciezki$typ <- factor(ifelse(sciezki$typ == 1, "choć raz p < .05", "nigdy p < .05"), levels = c("nigdy p < .05", "choć raz p < .05"))
c(sciezek_z_p_ponizej_05 = sum(tapply(sciezki$p < .05, sciezki$badanie, any)),
  istotnych_przy_n100 = sum(p_etap[1:pierwsze, 10] < .05))

kol <- c("nigdy p < .05" = "grey65", "choć raz p < .05" = "#D55E00")         # Okabe–Ito
motyw <- theme_minimal(base_size = 14) + theme(legend.position = "bottom", panel.grid.minor = element_blank())
pA <- ggplot(sciezki, aes(n, p, group = badanie, colour = typ, linetype = typ)) +
  geom_hline(yintercept = .05, colour = "black", linewidth = 0.6) +
  geom_line(linewidth = 0.8) +
  geom_point(data = subset(sciezki, p < .05), shape = 17, size = 2.6) +
  scale_y_log10(breaks = c(.001, .01, .05, .2, 1), labels = c(".001", ".01", ".05", ".20", "1")) +
  scale_x_continuous(breaks = etapy) +
  scale_colour_manual(values = kol, name = NULL) +
  scale_linetype_manual(values = c("nigdy p < .05" = "solid", "choć raz p < .05" = "longdash"), name = NULL) +
  labs(x = "Osób w grupie w chwili spojrzenia", y = "Wartość p (skala log)", title = "A. 50 badań bez efektu") +
  motyw
pB <- ggplot(krzywe, aes(k, odsetek, colour = wariant, shape = wariant)) +
  geom_hline(yintercept = .05, linetype = "dashed", colour = "grey40") +
  geom_line(linewidth = 0.9) +
  geom_errorbar(aes(ymin = odsetek - 1.96 * blad_MC, ymax = odsetek + 1.96 * blad_MC), width = 0.25) +
  geom_point(size = 2.8) +
  scale_x_continuous(breaks = 1:10) +
  scale_y_continuous(limits = c(0, 0.21), breaks = seq(0, 0.20, 0.05), labels = c("0", ".05", ".10", ".15", ".20")) +
  scale_colour_manual(values = c("#D55E00", "#0072B2"), name = NULL) +
  scale_shape_manual(values = c(17, 15), name = NULL) +
  guides(colour = guide_legend(ncol = 1), shape = guide_legend(ncol = 1)) +
  labs(x = "Liczba spojrzeń (co 10 osób w grupie)", y = "Odsetek fałszywych alarmów", title = "B. 10 000 badań bez efektu") +
  motyw
p1 <- pA + pB
p1   # zapis: ggsave("opcjonalne-zatrzymywanie-sciezki-p.svg", p1, width = 10.5, height = 6)
Wynik w R
  k odsetek                               wariant blad_MC
  1   0.052        α = .05 przy każdym spojrzeniu  0.0022
  2   0.085        α = .05 przy każdym spojrzeniu  0.0028
  3   0.109        α = .05 przy każdym spojrzeniu  0.0031
  4   0.128        α = .05 przy każdym spojrzeniu  0.0033
  5   0.144        α = .05 przy każdym spojrzeniu  0.0035
  6   0.158        α = .05 przy każdym spojrzeniu  0.0036
  7   0.168        α = .05 przy każdym spojrzeniu  0.0037
  8   0.178        α = .05 przy każdym spojrzeniu  0.0038
  9   0.188        α = .05 przy każdym spojrzeniu  0.0039
 10   0.196        α = .05 przy każdym spojrzeniu  0.0040
  1   0.052 Bonferroni: α = .05 / liczba spojrzeń  0.0022
  2   0.045 Bonferroni: α = .05 / liczba spojrzeń  0.0021
  3   0.040 Bonferroni: α = .05 / liczba spojrzeń  0.0020
  4   0.038 Bonferroni: α = .05 / liczba spojrzeń  0.0019
  5   0.035 Bonferroni: α = .05 / liczba spojrzeń  0.0018
  6   0.032 Bonferroni: α = .05 / liczba spojrzeń  0.0018
  7   0.030 Bonferroni: α = .05 / liczba spojrzeń  0.0017
  8   0.030 Bonferroni: α = .05 / liczba spojrzeń  0.0017
  9   0.028 Bonferroni: α = .05 / liczba spojrzeń  0.0016
 10   0.027 Bonferroni: α = .05 / liczba spojrzeń  0.0016
sciezek_z_p_ponizej_05    istotnych_przy_n100
                     7                      3
Jak zatrzymywać badanie poprawnie
- Liczebność ustal z góry na podstawie analizy mocy i zapisz ją w prerejestracji.
- Jeśli chcesz móc przerwać wcześniej, zaplanuj analizy pośrednie z granicami utrzymującymi łączne α, np. przez funkcję wydatkowania alfa, albo użyj SPRT. Lakens (2014) pokazuje, że analizy sekwencyjne pozwalają zakończyć badanie przy przekonujących wynikach lub przy znikomej szansie na efekt, z kontrolą błędu I rodzaju, co zwiększa efektywność zbierania danych.
- Liczbę i moment analiz wpisz do planu analizy statystycznej przed zebraniem danych.
Jak opisać w pracy
Na co uważać
- Jednorazowe dobranie osób też się liczy. Dodanie próby po nieistotnym wyniku to już dwa spojrzenia (8.1% fałszywych alarmów w symulacji).
- Zatrzymanie z powodów zewnętrznych (koniec semestru, budżet) nie zależy od wyniku, ale opisz je otwarcie.
- Nie ukrywaj spojrzeń. Jeśli nieplanowane analizy się odbyły, zgłoś je w raporcie.
Symulacja opcjonalnego zatrzymywania w R
Kod symuluje badania przy prawdziwej hipotezie zerowej, wykonuje test t po każdych 10 osobach w grupie i liczy, jak często choć jedno spojrzenie daje p < .05. Wystarcza podstawowy R. Liczby w tekście pochodzą z tego kodu.
Odsetek wyników fałszywie istotnych przy różnej liczbie spojrzeń
R
set.seed(705)                                  # H0 prawdziwa: obie grupy z tego samego rozkładu
R <- 10000                                     # liczba symulowanych badań
etapy <- seq(10, 100, by = 10)                 # analiza po każdych 10 osobach w grupie
p_etap <- matrix(NA, R, length(etapy))
for (r in 1:R) {
  a <- rnorm(100); b <- rnorm(100)
  for (j in seq_along(etapy)) {
    n <- etapy[j]
    p_etap[r, j] <- t.test(a[1:n], b[1:n], var.equal = TRUE)$p.value
  }
}
istotny_kiedykolwiek <- function(p, alfa) mean(apply(p < alfa, 1, any))
round(c(
  jedna_analiza_n100      = mean(p_etap[, 10] < .05),
  dwa_spojrzenia_50_100   = istotny_kiedykolwiek(p_etap[, c(5, 10)], .05),
  piec_spojrzen_co_20     = istotny_kiedykolwiek(p_etap[, c(2, 4, 6, 8, 10)], .05),
  dziesiec_spojrzen_co_10 = istotny_kiedykolwiek(p_etap, .05),
  dziesiec_bonferroni     = istotny_kiedykolwiek(p_etap, .05 / 10)
), 3)
Wynik w R
     jedna_analiza_n100   dwa_spojrzenia_50_100     piec_spojrzen_co_20
                  0.050                   0.081                   0.144
dziesiec_spojrzen_co_10     dziesiec_bonferroni
                  0.196                   0.027
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (bez dodatkowych pakietów); Rysunek 1 narysowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czy wolno dobrać osoby badane, gdy wynik jest prawie istotny?
Nie bez korekty. Dobieranie osób po zobaczeniu p to opcjonalne zatrzymywanie i zawyża błąd I rodzaju. Jeśli taki krok może być potrzebny, zaplanuj go wcześniej jako analizę sekwencyjną z poprawionymi granicami.
O ile opcjonalne zatrzymywanie zwiększa odsetek fałszywych wyników?
Zależy od liczby spojrzeń. W symulacji testu t przy prawdziwej hipotezie zerowej dwa spojrzenia dały 8.1%, a dziesięć – 19.6% wyników istotnych zamiast nominalnych 5%.
Czym opcjonalne zatrzymywanie różni się od analizy pośredniej?
Analiza pośrednia jest zaplanowana z góry: liczba spojrzeń i granice istotności są ustalone tak, by łączne α wynosiło np. .05. Opcjonalne zatrzymywanie to nieplanowane sprawdzanie p bez takiej korekty.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Armitage, P., McPherson, C. K., & Rowe, B. C. (1969). Repeated significance tests on accumulating data. Journal of the Royal Statistical Society. Series A (General), 132(2), 235–244. https://doi.org/10.2307/2343787
- Lakens, D. (2014). Performing high-powered studies efficiently with sequential analyses. European Journal of Social Psychology, 44(7), 701–710. https://doi.org/10.1002/ejsp.2023 ● Otwarty dostęp
- Simmons, J. P., Nelson, L. D., & Simonsohn, U. (2011). False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant. Psychological Science, 22(11), 1359–1366. https://doi.org/10.1177/0956797611417632
Cytowania BibTeX
@article{armitage1969repeated, author={Armitage, P. and McPherson, C. K. and Rowe, B. C.}, title={{Repeated significance tests on accumulating data}}, journal={Journal of the Royal Statistical Society. Series A (General)}, year={1969}, volume={132}, number={2}, pages={235--244}, doi={10.2307/2343787}}@article{lakens2014performing, author={Lakens, Daniël}, title={{Performing high-powered studies efficiently with sequential analyses}}, journal={European Journal of Social Psychology}, year={2014}, volume={44}, number={7}, pages={701--710}, doi={10.1002/ejsp.2023}}@article{simmons2011false, author={Simmons, Joseph P. and Nelson, Leif D. and Simonsohn, Uri}, title={{False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant}}, journal={Psychological Science}, year={2011}, volume={22}, number={11}, pages={1359--1366}, doi={10.1177/0956797611417632}}