Co to jest ogród rozwidlających się ścieżek?
Ogród rozwidlających się ścieżek (ang. garden of forking paths) to określenie Gelmana i Lokena (2014) na analizę zależną od danych. Między surowym plikiem a wynikiem w tabeli leży wiele rozwidleń: kogo wykluczyć, jak potraktować obserwacje odstające, czy dodać kowariant, którą miarę wybrać. Badacz wykonuje jedną analizę, ale wybiera jej postać po zobaczeniu danych. Przy innej próbie poszedłby inną ścieżką, więc nominalne α = .05 przestaje opisywać rzeczywiste ryzyko błędu I rodzaju.
Czym różni się od p-hackingu
P-hacking to świadome lub półświadome próbowanie wielu wersji analizy, aż któraś da p < .05. W ogrodzie ścieżek nie trzeba niczego próbować ani ukrywać. Wystarczy, że decyzje są rozsądne, ale podejmowane w świetle wyników. Problem jest więc subtelniejszy i dotyczy także uczciwych badaczy. Mechanizm przypomina problem wielokrotnych porównań, tyle że porównania są potencjalne – nikt ich nie wykonał, więc nie da się ich policzyć ani skorygować. Pokrewny jest HARKing: tu do danych dopasowuje się analizę, tam – hipotezę.
Przykład
Badacz sprawdza, czy trening uważności obniża stres. Efekt w całej próbie jest nieistotny, ale widać go u kobiet, więc „naturalnie” raportuje analizę w podgrupie. Gdyby efekt wyszedł u osób starszych, raportowałby tamten wynik. Każda decyzja z osobna wygląda na uzasadnioną. Simmons, Nelson i Simonsohn (2011) pokazali w symulacjach, że taka elastyczność w zbieraniu, analizie i raportowaniu danych radykalnie zwiększa odsetek wyników fałszywie pozytywnych.
Na rysunku
Przykład z treningiem powtórzono na danych symulowanych bez efektu w populacji (2 × 40 osób, dwie miary stresu skorelowane na poziomie r = .5). Trzy rozsądne decyzje – miara (A, B albo średnia), usunięcie obserwacji odstających (|z| > 2) i podgrupa kobiet – dają 12 wersji tego samego testu.
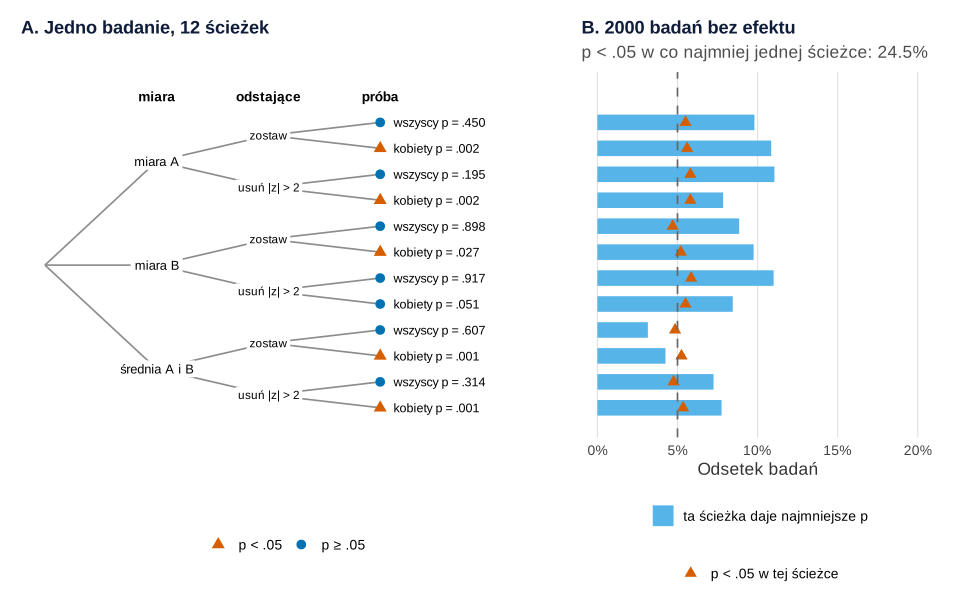
set.seed(525) i set.seed(2525)).Co widać. W jednym badaniu (panel A) te same dane dają p od .001 do .917. W całej próbie nic nie wychodzi, ale pięć z sześciu ścieżek w podgrupie kobiet daje p < .05 – analiza w podgrupie wydaje się „naturalna”. W 2000 badań (panel B) każda ścieżka osobno daje p < .05 w 4.7–5.9% badań, czyli tyle, ile obiecuje α. Co najmniej jedna z 12 ścieżek daje jednak p < .05 w 24.5% badań (błąd Monte Carlo 1.0 punktu procentowego). Najmniejsze p daje raz jedna ścieżka, raz inna (od 3.2% do 11.0% badań) – nie ma jednej „podejrzanej” analizy do skorygowania.
Na co uważać. 24.5% to najgorszy przypadek: badacz zawsze trafia w ścieżkę z najmniejszym p. Zwykle wybór jest mniej systematyczny, więc rzeczywiste ryzyko leży między 5% a tą wartością i nie da się go policzyć – nie wiadomo, którą drogę badacz wybrałby przy innych danych. Krzywe wzrostu odsetka fałszywych alarmów wraz z liczbą ścieżek pokazuje wpis wielokrotne testy w obrazkach.
Podpis do pracy:
Kod odtwarza rysunek i liczby z akapitu (ok. 10 s). Parametry (40 osób w grupie, r = .5, próg |z| > 2, 2000 powtórzeń) ustawiono ręcznie przed uruchomieniem; ziarna 525 (A) i 2525 (B) ustalono raz i nie zmieniano – podgrupa kobiet „wyszła” w panelu A przypadkiem. Rysunek na stronie powstał z tych samych obiektów z motywem serwisu – różni się tylko krojem czcionki.
Kod R rysunku 1
# Rysunek 1. Ogród rozwidlających się ścieżek: 12 wersji analizy jednego badania bez efektu (A)
# i to, która wersja daje najmniejsze p w 2000 takich badaniach (B)
library(ggplot2)
library(patchwork)
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom", plot.title = element_text(face = "bold"))
kol <- c("p < .05" = "#D55E00", "p ≥ .05" = "#0072B2")                 # Okabe–Ito

# Badanie: trening vs kontrola po 40 osób, dwie miary stresu (r = .5), płeć; prawdziwy efekt = 0
symuluj <- function(n = 40) {
  wspolny <- rnorm(2 * n)
  data.frame(grupa = rep(c("trening", "kontrola"), each = n),
             kobieta = rbinom(2 * n, 1, 0.5) == 1,
             A = sqrt(0.5) * wspolny + sqrt(0.5) * rnorm(2 * n),
             B = sqrt(0.5) * wspolny + sqrt(0.5) * rnorm(2 * n))
}
sciezki <- expand.grid(proba = c("wszyscy", "kobiety"), odstajace = c("zostaw", "usuń |z| > 2"),
                       miara = c("miara A", "miara B", "średnia A i B"), stringsAsFactors = FALSE)
analizuj <- function(d) {                                    # p testu Welcha w każdej z 12 ścieżek
  d$srednia <- (d$A + d$B) / 2
  sapply(seq_len(nrow(sciezki)), function(i) {
    y <- d[[c("miara A" = "A", "miara B" = "B", "średnia A i B" = "srednia")[[sciezki$miara[i]]]]]
    ok <- if (sciezki$proba[i] == "kobiety") d$kobieta else rep(TRUE, nrow(d))
    if (sciezki$odstajace[i] != "zostaw") ok <- ok & abs(as.numeric(scale(y))) <= 2
    t.test(y[ok] ~ d$grupa[ok])$p.value
  })
}

# A: jedno badanie, 12 ścieżek
set.seed(525)
p_jedno <- analizuj(symuluj())
drzewo <- cbind(sciezki, p = p_jedno, y = 12:1)
print(transform(drzewo[, c("miara", "odstajace", "proba")], p = round(p_jedno, 3)), row.names = FALSE)
round(c(min_p = min(p_jedno), max_p = max(p_jedno)), 3)
w2 <- aggregate(y ~ miara + odstajace, drzewo, mean)          # węzły drugiego poziomu
w1 <- aggregate(y ~ miara, drzewo, mean)                       # węzły pierwszego poziomu
kraw <- rbind(data.frame(x = 0, y = mean(drzewo$y), xend = 1, yend = w1$y),
              data.frame(x = 1, y = w1$y[match(w2$miara, w1$miara)], xend = 2, yend = w2$y),
              data.frame(x = 2, y = w2$y[match(paste(drzewo$miara, drzewo$odstajace), paste(w2$miara, w2$odstajace))],
                         xend = 3, yend = drzewo$y))
drzewo$wynik <- ifelse(drzewo$p < 0.05, "p < .05", "p ≥ .05")
drzewo$etykieta <- sprintf("%s  p = %s", drzewo$proba, sub("^0", "", formatC(drzewo$p, format = "f", digits = 3)))
pA <- ggplot() +
  geom_segment(data = kraw, aes(x, y, xend = xend, yend = yend), colour = "grey55") +
  geom_label(data = w1, aes(1, y, label = miara), size = 3.4, linewidth = 0) +
  geom_label(data = w2, aes(2, y, label = odstajace), size = 3.1, linewidth = 0) +
  geom_point(data = drzewo, aes(3, y, colour = wynik, shape = wynik), size = 3) +
  geom_text(data = drzewo, aes(3.12, y, label = etykieta), hjust = 0, size = 3.3) +
  annotate("text", x = c(1, 2, 3), y = 13, label = c("miara", "odstające", "próba"), fontface = "bold", size = 3.6) +
  scale_colour_manual(values = kol, drop = FALSE, name = NULL) +
  scale_shape_manual(values = c("p < .05" = 17, "p ≥ .05" = 16), drop = FALSE, name = NULL) +
  scale_x_continuous(limits = c(0, 4.3)) + scale_y_continuous(limits = c(0.5, 13.3)) +
  labs(title = "A. Jedno badanie, 12 ścieżek", x = NULL, y = NULL) +
  motyw + theme(axis.text = element_blank(), panel.grid.major = element_blank())

# B: 2000 badań bez efektu – która ścieżka daje najmniejsze p i jak często p < .05
set.seed(2525)
R <- 2000
P <- t(replicate(R, analizuj(symuluj())))                     # R × 12 wartości p
najlepsza <- tabulate(apply(P, 1, which.min), nbins = 12) / R
istotne <- colMeans(P < 0.05)
cokolwiek <- mean(apply(P, 1, min) < 0.05)
round(c(min_p_ponizej_05 = cokolwiek, mcse = sqrt(cokolwiek * (1 - cokolwiek) / R),
        najlepsza_min = min(najlepsza), najlepsza_max = max(najlepsza),
        istotne_min = min(istotne), istotne_max = max(istotne)), 3)
dB <- data.frame(y = 12:1, najlepsza, istotne)
pB <- ggplot(dB, aes(y = y)) +
  geom_col(aes(x = najlepsza, fill = "ta ścieżka daje najmniejsze p"), orientation = "y", width = 0.6) +
  geom_point(aes(x = istotne, shape = "p < .05 w tej ścieżce"), size = 2.8, colour = "#D55E00") +
  geom_vline(xintercept = 0.05, linetype = "dashed", colour = "grey40") +
  scale_fill_manual(values = "#56B4E9", name = NULL) +
  scale_shape_manual(values = 17, name = NULL) +
  scale_x_continuous(labels = function(x) paste0(100 * x, "%"), limits = c(0, 0.2)) +
  scale_y_continuous(limits = c(0.5, 13.3), breaks = NULL) +
  labs(title = "B. 2000 badań bez efektu", subtitle = sprintf("p < .05 w co najmniej jednej ścieżce: %.1f%%", 100 * cokolwiek),
       x = "Odsetek badań", y = NULL) +
  motyw + theme(legend.box = "vertical")
p1 <- pA + pB + plot_layout(widths = c(1.5, 1))
p1   # zapis: ggsave("ogrod-sciezek-12-wersji-analizy.svg", p1, width = 10, height = 6.4)
Wynik w R
         miara    odstajace   proba     p
       miara A       zostaw wszyscy 0.450
       miara A       zostaw kobiety 0.002
       miara A usuń |z| > 2 wszyscy 0.195
       miara A usuń |z| > 2 kobiety 0.002
       miara B       zostaw wszyscy 0.898
       miara B       zostaw kobiety 0.027
       miara B usuń |z| > 2 wszyscy 0.917
       miara B usuń |z| > 2 kobiety 0.051
 średnia A i B       zostaw wszyscy 0.607
 średnia A i B       zostaw kobiety 0.001
 średnia A i B usuń |z| > 2 wszyscy 0.314
 średnia A i B usuń |z| > 2 kobiety 0.001
min_p max_p
0.001 0.917
min_p_ponizej_05             mcse    najlepsza_min    najlepsza_max
           0.245            0.010            0.032            0.110
     istotne_min      istotne_max
           0.047            0.059
Bibliografia oprogramowania
Wyniki i rysunek pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiety base i stats; rysunek – ggplot2 i patchwork, zapis pakietem svglite). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Jak zamknąć ścieżki
- Zaplanuj analizę przed danymi. Prerejestracja lub registered report ustala ścieżkę z góry. Lista 34 stopni swobody badacza (Wicherts i in., 2016) pomaga sprawdzić, czy plan nie zostawia furtek.
- Pokaż wszystkie rozsądne ścieżki. Analiza multiverse i krzywa specyfikacji raportuje wynik dla każdej kombinacji decyzji.
- Oddziel eksplorację od konfirmacji. Wynik znaleziony po drodze opisz jako eksploracyjny i sprawdź na nowych danych.
Jak opisać w pracy
Najczęstsze pytania
Czy ogród rozwidlających się ścieżek to to samo co p-hacking?
Nie. P-hacking polega na próbowaniu wielu analiz i raportowaniu tej istotnej. W ogrodzie ścieżek badacz wykonuje jedną analizę, ale wybiera ją po obejrzeniu danych. Skutek jest podobny: zawyżony odsetek fałszywych odkryć.
Czy poprawka Bonferroniego rozwiązuje ten problem?
Zwykle nie. Poprawka wymaga znajomości liczby porównań, a tu porównania są potencjalne – zostałyby wykonane tylko przy innych danych. Pomaga dopiero zaplanowanie analizy z góry albo pokazanie wszystkich rozsądnych wariantów.
Co zrobić, gdy w pracy dyplomowej zmieniłem analizę po zobaczeniu danych?
Napisz to wprost. Opisz, co planowałeś, co zmieniłeś i dlaczego, a wynik nowej analizy przedstaw jako eksploracyjny. Jeśli to możliwe, pokaż też wynik pierwotnie zaplanowanej analizy.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Gelman, A., & Loken, E. (2014). The statistical crisis in science. American Scientist, 102(6), 460. https://doi.org/10.1511/2014.111.460
- Simmons, J. P., Nelson, L. D., & Simonsohn, U. (2011). False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant. Psychological Science, 22(11), 1359–1366. https://doi.org/10.1177/0956797611417632
- Wicherts, J. M., Veldkamp, C. L. S., Augusteijn, H. E. M., Bakker, M., van Aert, R. C. M., & van Assen, M. A. L. M. (2016). Degrees of freedom in planning, running, analyzing, and reporting psychological studies: A checklist to avoid p-hacking. Frontiers in Psychology, 7, Article 1832. https://doi.org/10.3389/fpsyg.2016.01832 ● Otwarty dostęp
Cytowania BibTeX
@article{gelman2014statistical, author={Gelman, Andrew and Loken, Eric}, title={{The statistical crisis in science}}, journal={American Scientist}, year={2014}, volume={102}, number={6}, pages={460}, doi={10.1511/2014.111.460}}@article{simmons2011false, author={Simmons, Joseph P. and Nelson, Leif D. and Simonsohn, Uri}, title={{False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant}}, journal={Psychological Science}, year={2011}, volume={22}, number={11}, pages={1359--1366}, doi={10.1177/0956797611417632}}@article{wicherts2016degrees, author={Wicherts, Jelte M. and Veldkamp, Coosje L. S. and Augusteijn, Hilde E. M. and Bakker, Marjan and van Aert, Robbie C. M. and van Assen, Marcel A. L. M.}, title={{Degrees of freedom in planning, running, analyzing, and reporting psychological studies: A checklist to avoid p-hacking}}, journal={Frontiers in Psychology}, year={2016}, volume={7}, eid={1832}, doi={10.3389/fpsyg.2016.01832}}