Co to jest funkcja wydatkowania alfa?
Funkcja wydatkowania alfa (ang. alpha spending function) α*(t) określa, jaką część łącznego poziomu istotności α „wydano” do chwili, w której zebrano odsetek t planowanej informacji (np. pacjentów lub zdarzeń). Rośnie od α*(0) = 0 do α*(1) = α. Lan i DeMets (1983) zaproponowali ją jako elastyczniejszą alternatywę dla granic Pococka (1977) i O’Briena–Fleminga, które wymagają ustalenia liczby analiz z góry. Granica w danej analizie pośredniej zależy tylko od funkcji oraz od dotychczasowych i bieżącego momentu analizy, a nie od przyszłych.
Dwie najczęstsze funkcje
- typ O’Briena–Fleminga: w teście dwustronnym każdy ogon wydaje α/2 według 2 − 2Φ(z1−α/4 / √t), łącznie α*(t) = 4 − 4Φ(z1−α/4 / √t) – na początku wydaje prawie nic, większość α zostaje na analizę końcową;
- typ Pococka: α*(t) = α · ln(1 + (e − 1)t) – wydaje α równomierniej, więc łatwiej przerwać badanie wcześnie, ale analiza końcowa ma surowszą granicę.
Kim i DeMets (1987) rozszerzyli metodę na granice asymetryczne i pokazali, jak wybór funkcji wpływa na maksymalną liczebność potrzebną do uzyskania zadanej mocy i na oczekiwany moment zatrzymania.
Przykład
Przy α = .05 (dwustronnie) i analizach po 25%, 50%, 75% i 100% danych funkcja typu O’Briena–Fleminga wydaje skumulowanie 0.0000, 0.0031, 0.0193 i 0.0500, a funkcja typu Pococka 0.0179, 0.0310, 0.0414 i 0.0500. Na samą analizę końcową O’Brien–Fleming zostawia 0.0307, a Pocock tylko 0.0086. Z tych przyrostów, uwzględniając korelację kolejnych statystyk, programy takie jak gsDesign i rpact wyznaczają granice |Z|: 4.333, 2.963, 2.359 i 2.014 dla O’Briena–Fleminga oraz 2.368, 2.368, 2.358 i 2.350 dla Pococka.
Na rysunku
Liczby z przykładu łatwiej porównać na wykresie. Panel A pokazuje całe funkcje α*(t), panel B – ile α przypada na każdą z czterech analiz. Dla porównania dorysowano wydawanie równomierne, α · t.
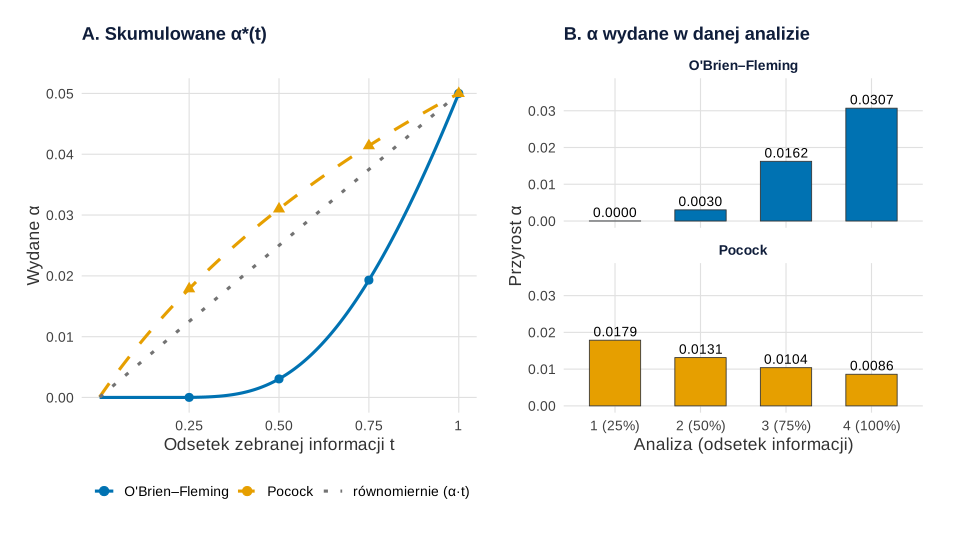
Co widać. Obie krzywe zaczynają się w 0 i kończą w α = .05, ale różnią się drogą. Do połowy badania funkcja typu O’Briena–Fleminga wydaje 0.0031, wydawanie równomierne 0.0250, a funkcja typu Pococka 0.0310 – więcej niż połowę α. Panel B pokazuje skutek: u O’Briena–Fleminga przyrosty rosną i najwięcej (0.0307) zostaje na analizę końcową, u Pococka maleją i na koniec zostaje 0.0086. Dlatego wczesne zatrzymanie jest łatwiejsze w planie Pococka, a analiza końcowa – w planie O’Briena–Fleminga.
Na co uważać. Przyrost α to nie nominalny poziom istotności w danej analizie. Granicę |Z| wyznacza się z przyrostu z uwzględnieniem korelacji kolejnych statystyk (stąd granica końcowa 2.014, a nie 1.96), więc słupków nie porównuj bezpośrednio z wartościami p. Wykres nie pokazuje też mocy ani oczekiwanej liczebności – te zależą od prawdziwego efektu. Granice i ścieżki statystyki Z pokazuje rysunek w haśle o analizie pośredniej, a koszt i zysk planów – wpis Analizy pośrednie w praktyce.
Podpis do pracy:
Kod liczy funkcje tymi samymi wzorami co przykład w R poniżej i nie losuje danych. Rysunek na stronie różni się od wyniku kodu tylko motywem serwisu.
Kod R rysunku 1
# Rysunek 1. Funkcje wydatkowania alfa typu O'Briena-Fleminga i Pococka (A)
# oraz alfa wydane w każdej z czterech analiz (B); alfa = .05, test dwustronny
library(ggplot2)
library(patchwork)
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom", plot.title = element_text(face = "bold"))
kol <- c("O'Brien–Fleming" = "#0072B2", "Pocock" = "#E69F00", "równomiernie (α·t)" = "grey45")

alfa <- 0.05
obf    <- function(t) 2 * (2 - 2 * pnorm(qnorm(1 - alfa / 4) / sqrt(t)))  # oba ogony razem
pocock <- function(t) alfa * log(1 + (exp(1) - 1) * t)
t_siatka <- seq(0.001, 1, by = 0.001)
krzywe <- data.frame(t = rep(t_siatka, 3),
                     alfa = c(obf(t_siatka), pocock(t_siatka), alfa * t_siatka),
                     funkcja = factor(rep(names(kol), each = length(t_siatka)), levels = names(kol)))
# jaką część alfa każda funkcja wydała do połowy badania
round(c(OBF_t0.5 = obf(0.5), Pocock_t0.5 = pocock(0.5), rownomiernie_t0.5 = alfa * 0.5), 4)

t_an <- c(0.25, 0.50, 0.75, 1)                             # cztery analizy
an <- data.frame(t = rep(t_an, 2), funkcja = factor(rep(names(kol)[1:2], each = 4), levels = names(kol)),
                 skumulowane = c(obf(t_an), pocock(t_an)))
an$przyrost <- c(diff(c(0, obf(t_an))), diff(c(0, pocock(t_an))))
an$analiza <- factor(rep(c("1 (25%)", "2 (50%)", "3 (75%)", "4 (100%)"), 2))
print(cbind(an[, c("funkcja", "t")], round(an[, c("skumulowane", "przyrost")], 4)))

pA <- ggplot(krzywe, aes(t, alfa, colour = funkcja, linetype = funkcja)) +
  geom_line(linewidth = 1.1) +
  geom_point(data = an, aes(t, skumulowane, shape = funkcja), size = 2.8) +
  scale_colour_manual(values = kol, name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed", "dotted"), name = NULL) +
  scale_shape_manual(values = c(16, 17), guide = "none") +
  scale_x_continuous(breaks = t_an, labels = c("0.25", "0.50", "0.75", "1")) +
  labs(title = "A. Skumulowane α*(t)", x = "Odsetek zebranej informacji t", y = "Wydane α") +
  motyw
pB <- ggplot(an, aes(analiza, przyrost, fill = funkcja)) +
  geom_col(width = 0.6, colour = "grey20", linewidth = 0.3) +
  geom_text(aes(label = sprintf("%.4f", przyrost)), vjust = -0.4, size = 3.6) +
  facet_wrap(~ funkcja, ncol = 1) +
  scale_fill_manual(values = kol, guide = "none") +
  scale_y_continuous(limits = c(0, 0.037)) +
  labs(title = "B. α wydane w danej analizie", x = "Analiza (odsetek informacji)", y = "Przyrost α") +
  motyw
p1 <- pA + pB + plot_layout(widths = c(1.1, 1))
p1
Wynik w R
         OBF_t0.5       Pocock_t0.5 rownomiernie_t0.5
           0.0031            0.0310            0.0250
          funkcja    t skumulowane przyrost
1 O'Brien–Fleming 0.25      0.0000   0.0000
2 O'Brien–Fleming 0.50      0.0031   0.0030
3 O'Brien–Fleming 0.75      0.0193   0.0162
4 O'Brien–Fleming 1.00      0.0500   0.0307
5          Pocock 0.25      0.0179   0.0179
6          Pocock 0.50      0.0310   0.0131
7          Pocock 0.75      0.0414   0.0104
8          Pocock 1.00      0.0500   0.0086
Jak opisać w pracy
Na co uważać
Funkcję wybiera się przed badaniem i zapisuje w planie analizy statystycznej; elastyczność dotyczy terminów analiz, a nie zmiany funkcji po obejrzeniu danych. Każde spojrzenie bez korekty zawyża błąd I rodzaju – to szczególny przypadek problemu wielokrotnych porównań. Wyniki analiz pośrednich ocenia zwykle komitet monitorowania danych. Osobną decyzją jest przerwanie badania z powodu daremności.
Funkcja wydatkowania alfa w R
Kod liczy ręcznie skumulowane α*(t) i przyrosty dla funkcji typu O’Briena–Fleminga i Pococka (α/2 w każdym ogonie), a potem wyznacza granice |Z| funkcją gsDesign::gsDesign() i sprawdza je w rpact::getDesignGroupSequential(). Skumulowane α z gsDesign jest takie samo jak z obliczenia ręcznego (0.0000, 0.0031, 0.0193, 0.0500).
Wydatkowanie α przy czterech analizach
R
# Funkcje wydatkowania alfa Lana-DeMetsa (alfa = 0.05, test dwustronny: alfa/2 w każdym ogonie)
alfa <- 0.05
t <- c(0.25, 0.50, 0.75, 1)                            # odsetek zebranej informacji
obf    <- 2 * (2 - 2 * pnorm(qnorm(1 - alfa / 4) / sqrt(t)))  # typ O'Briena-Fleminga, oba ogony razem
pocock <- alfa * log(1 + (exp(1) - 1) * t)             # typ Pococka (alfa/2 w każdym ogonie, razem alfa)
tab <- rbind(OBF_skumulowane = obf, OBF_przyrost = diff(c(0, obf)),
             Pocock_skumulowane = pocock, Pocock_przyrost = diff(c(0, pocock)))
colnames(tab) <- paste0("t=", t)
round(tab, 4)
# Granice |Z| dla tych funkcji: gsDesign (alfa/2 = 0.025 w każdym ogonie)
library(gsDesign)
g_obf    <- gsDesign(k = 4, test.type = 2, alpha = alfa / 2, sfu = sfLDOF)
g_pocock <- gsDesign(k = 4, test.type = 2, alpha = alfa / 2, sfu = sfLDPocock)
granice <- rbind(OBF = g_obf$upper$bound, Pocock = g_pocock$upper$bound)
colnames(granice) <- paste0("t=", t)
round(granice, 3)
round(2 * cumsum(g_obf$upper$prob[, 1]), 4)           # skumulowane alfa OBF wg gsDesign (= wiersz 1 tabeli)
# Sprawdzenie w rpact (te same granice)
library(rpact)
round(rbind(
  OBF    = getDesignGroupSequential(kMax = 4, alpha = alfa, sided = 2, typeOfDesign = "asOF")$criticalValues,
  Pocock = getDesignGroupSequential(kMax = 4, alpha = alfa, sided = 2, typeOfDesign = "asP")$criticalValues), 3)
Wynik w R
                   t=0.25  t=0.5 t=0.75    t=1
OBF_skumulowane    0.0000 0.0031 0.0193 0.0500
OBF_przyrost       0.0000 0.0030 0.0162 0.0307
Pocock_skumulowane 0.0179 0.0310 0.0414 0.0500
Pocock_przyrost    0.0179 0.0131 0.0104 0.0086
       t=0.25 t=0.5 t=0.75   t=1
OBF     4.333 2.963  2.359 2.014
Pocock  2.368 2.368  2.358 2.350
[1] 0.0000 0.0031 0.0193 0.0500
        [,1]  [,2]  [,3]  [,4]
OBF    4.333 2.963 2.359 2.014
Pocock 2.368 2.368 2.358 2.350
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiety base i stats oraz gsDesign i rpact). Rysunek 1 wykonano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- gsDesign (wersja 3.11.0): Anderson, K. (2026). gsDesign: Group sequential design [R package]. https://doi.org/10.32614/CRAN.package.gsDesign
- rpact (wersja 4.4.0): Wassmer, G., & Pahlke, F. (2026). rpact: Confirmatory adaptive clinical trial design and analysis [R package]. https://doi.org/10.32614/CRAN.package.rpact
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czym funkcja wydatkowania alfa różni się od granic Pococka i O’Briena–Fleminga?
Klasyczne granice wymagają z góry ustalonej liczby równo rozłożonych analiz. Funkcja wydatkowania daje podobny kształt granic, ale pozwala zmienić liczbę i terminy analiz w trakcie badania bez przekroczenia łącznego α.
Którą funkcję wydatkowania alfa wybrać?
Typ O’Briena–Fleminga, gdy badanie ma się kończyć wcześniej tylko przy bardzo silnym efekcie, a analiza końcowa ma pozostać bliska zwykłej. Typ Pococka, gdy ważne jest wczesne zatrzymanie, kosztem surowszej granicy końcowej.
Jak policzyć funkcję wydatkowania alfa w R?
Same wartości α*(t) policzysz ze wzorów w bazowym R, jak w kodzie na tej stronie. Granice Z dla kolejnych analiz wyznaczają funkcje gsDesign::gsDesign() (np. sfu = sfLDOF) i rpact::getDesignGroupSequential() (np. typeOfDesign = "asOF"); obie dzielą α po połowie między ogony.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Plan analizy statystycznej i prerejestracja
12 elementów planu analizy, moc i SESOI w R, OSF czy AsPredicted, registered reports, tabela odstępstw i wzór planu w Wordzie do pobrania.
Czytaj →PoradnikAnalizy pośrednie w praktyce
Plan grupowo-sekwencyjny w R: granice Pococka i OBF, wzrost N, symulacja błędu I rodzaju, daremność i zawyżony efekt po wczesnym zatrzymaniu.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Kim, K., & DeMets, D. L. (1987). Design and analysis of group sequential tests based on the type I error spending rate function. Biometrika, 74(1), 149–154. https://doi.org/10.1093/biomet/74.1.149
- Lan, K. K. G., & DeMets, D. L. (1983). Discrete sequential boundaries for clinical trials. Biometrika, 70(3), 659–663. https://doi.org/10.1093/biomet/70.3.659
- Pocock, S. J. (1977). Group sequential methods in the design and analysis of clinical trials. Biometrika, 64(2), 191–199. https://doi.org/10.1093/biomet/64.2.191
Cytowania BibTeX
@article{kim1987design, author={Kim, Kyungmann and DeMets, David L.}, title={{Design and analysis of group sequential tests based on the type I error spending rate function}}, journal={Biometrika}, year={1987}, volume={74}, number={1}, pages={149--154}, doi={10.1093/biomet/74.1.149}}@article{lan1983discrete, author={Lan, K. K. Gordon and DeMets, David L.}, title={{Discrete sequential boundaries for clinical trials}}, journal={Biometrika}, year={1983}, volume={70}, number={3}, pages={659--663}, doi={10.1093/biomet/70.3.659}}@article{pocock1977group, author={Pocock, Stuart J.}, title={{Group sequential methods in the design and analysis of clinical trials}}, journal={Biometrika}, year={1977}, volume={64}, number={2}, pages={191--199}, doi={10.1093/biomet/64.2.191}}