Kiedy plan sekwencyjny ma sens
Planujesz eksperyment z dwiema grupami. Analiza mocy mówi, że do wykrycia najmniejszego efektu, na którym Ci zależy, potrzebujesz kilkuset osób. Jeśli jednak efekt jest większy, niż zakładasz, część tych osób zbierzesz niepotrzebnie. Jeśli efektu nie ma wcale, zbierzesz wszystkie i dowiesz się tego dopiero na końcu. Plan grupowo-sekwencyjny rozwiązuje oba problemy. Z góry ustalasz kilka analiz i granice, których przekroczenie kończy badanie. Lakens (2014) pokazuje, że w psychologii takie analizy pozwalają zakończyć badanie, gdy wyniki są dostatecznie przekonujące, albo przerwać je, gdy przewidywany efekt jest skrajnie mało prawdopodobny. Błąd I rodzaju pozostaje przy tym pod kontrolą.
To co innego niż opcjonalne zatrzymywanie, czyli sprawdzanie p „po drodze” bez korekty. Definicje i klasyczne granice opisują hasła analiza pośrednia i reguły zatrzymania oraz funkcja wydatkowania alfa. Skutki podglądania w teście A/B pokazuje wpis test A/B – plan i analiza. Ten tekst przechodzi przez cały plan na jednym eksperymencie: liczebność, symulację z testem t, daremność, obciążenie oszacowania i raport. Gdy decyzja ma zapadać po każdej osobie, a nie po grupach osób, sięgnij po SPRT.
Przykład: eksperyment z trzema analizami
Zespół sprawdza, czy krótkie pisanie ekspresywne przed egzaminem obniża lęk egzaminacyjny. Lęk mierzy skala o odchyleniu standardowym 10 punktów. Za najmniejszy interesujący efekt przyjęto 4 punkty, czyli d Cohena = 0.4. Hipoteza jest kierunkowa, więc stosujemy jednostronny test t dla prób niezależnych z α = .025, co odpowiada górnemu ogonowi testu dwustronnego na poziomie .05. Planowana moc to 90%. W planie stałym, z jedną analizą na końcu, potrzeba 133 osób w grupie, czyli 266 łącznie.
Plan sekwencyjny przewiduje trzy analizy: po zebraniu 1/3 danych, 2/3 danych i całości. Tabela porównuje cztery sposoby wyznaczenia granic. Wszystkie dane są symulowane, a liczebności policzono w pakiecie rpact.
| Plan | Granice z (analizy 1, 2, 3) | Nominalne p na końcu | Maks. N (wzrost) | Oczekiwane N, brak efektu | Oczekiwane N, d = 0.4 |
|---|---|---|---|---|---|
| Pocock | 2.289; 2.289; 2.289 | .0110 | 304.5 (+15.1%) | 301.4 | 190.8 |
| O'Brien–Fleming | 3.471; 2.454; 2.004 | .0225 | 268.9 (+1.6%) | 268.2 | 211.4 |
| Lan–DeMets typu Pococka | 2.279; 2.295; 2.296 | .0108 | 305.4 (+15.4%) | 302.3 | 190.8 |
| Lan–DeMets typu OBF | 3.710; 2.511; 1.993 | .0231 | 267.8 (+1.2%) | 267.2 | 214.7 |
Wzrost liczebności liczono względem planu stałego w tym samym przybliżeniu normalnym (N = 264.6). Dalej wybieramy plan Lana–DeMetsa typu OBF. Zaokrąglony w górę daje analizy po 45, 90 i 134 osobach w grupie.
Pocock, O'Brien–Fleming i funkcja wydatkowania
Pocock (1977) zaproponował plan, w którym po każdej równej grupie osób wykonuje się test na wszystkich dotąd zebranych danych; jego granica jest taka sama w każdej analizie. Granica O'Briena i Fleminga jest bardzo surowa na początku i zbliża się do zwykłej wartości krytycznej na końcu. Autorzy pokazali, że łączny poziom istotności i moc ich procedury są praktycznie takie jak w pojedynczym teście na pełnej próbie (O'Brien i Fleming, 1979). Rysunek 1 pokazuje różnicę na naszym przykładzie. W planie Pococka każda analiza wymaga p < .0110, także końcowa. W planie typu OBF pierwsza analiza wymaga p < .0001, a końcowa tylko p < .0231.
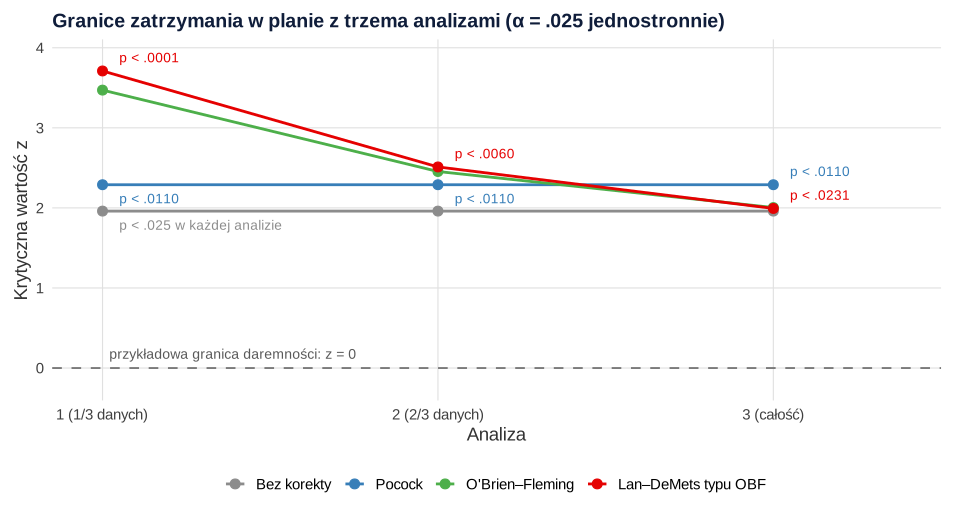
Klasyczne granice wymagają ustalenia z góry liczby analiz i ich terminów. Lan i DeMets (1983) zastąpili je funkcją α*(t), która mówi, ile błędu I rodzaju „wydano” do chwili zebrania odsetka t informacji. W naszym planie skumulowane α wynosi .0001, .0060 i .0250. Granica w danej analizie zależy tylko od dotychczasowych i bieżącego momentu, a nie od przyszłych. W praktyce to ważne, bo rekrutacja rzadko idzie zgodnie z kalendarzem.
Załóżmy, że analizy wypadły po 60 i 110 osobach w grupie zamiast po 45 i 90. Po przeliczeniu granic dla faktycznych odsetków informacji nominalne progi wynoszą p < .000809, .0131 i .021. W symulacji 20 000 badań bez efektu błąd I rodzaju wyniósł 2.4%, a moc przy d = 0.4 – 89.8%. Pozostawienie starych granic dało 2.3% fałszywych alarmów, ale oczekiwane N przy prawdziwym efekcie wzrosło z 215.0 do 230.3. Elastyczność dotyczy jednak terminów analiz. Funkcji nie zmieniasz po obejrzeniu danych.
Symulacja: podglądanie bez korekty i z korektą
Granice wyznacza się dla statystyki z, a w psychologii analizujesz dane testem t. Lakens i in. (2021) pokazują, jak zaplanować plan grupowo-sekwencyjny dla testów t w rpact. Prosta reguła to porównanie p z testu t z nominalnym progiem z planu. Sprawdziliśmy ją w symulacji: 20 000 badań na wariant, osobno bez efektu i przy d = 0.4. Błąd Monte Carlo dla odsetka 2.5% wynosi 0.11 punktu procentowego.
| Wariant | n w grupie w analizach | Błąd I rodzaju | Średnie N, brak efektu | Moc przy d = 0.4 | Średnie N, d = 0.4 |
|---|---|---|---|---|---|
| Plan stały | 133 | 2.4% | 266.0 | 90.1% | 266.0 |
| Trzy analizy bez korekty | 45/90/134 | 5.3% | 262.1 | 92.2% | 157.5 |
| Pocock | 51/102/153 | 2.5% | 303.0 | 90.3% | 192.5 |
| Lan–DeMets typu OBF | 45/90/134 | 2.5% | 267.4 | 90.0% | 215.8 |
Trzy spojrzenia bez korekty podwoiły błąd I rodzaju (5.3% wobec nominalnych 2.5%). Armitage i in. (1969) pokazali, że przy powtarzaniu testu na tym samym nominalnym poziomie szansa wyniku istotnego na którymś etapie może znacznie przekroczyć ten poziom. Wystarczą do tego trzy analizy. Oba plany sekwencyjne utrzymały 2.5%. Gdy efekt istnieje, plan Pococka kończył się średnio po 192.5 osobach, a plan typu OBF po 215.8, wobec 266 w planie stałym. Bez efektu plan Pococka kosztował 303.0 osoby, czyli więcej niż plan stały. Plan typu OBF prawie nic nie kosztował (267.4).
Koszt i zysk: maksymalne a oczekiwane N
Plan sekwencyjny ma dwie liczebności. Maksymalną, którą musisz móc zebrać, gdy badanie dojdzie do końca, i oczekiwaną, czyli średnią po wielu powtórzeniach badania. Kim i DeMets (1987) badali obie przy wyborze funkcji wydatkowania. Granice typu OBF zwiększają maksimum minimalnie, ale rzadko kończą badanie w pierwszej analizie. Granice typu Pococka częściej kończą je wcześnie, ale wymagają o około 15% większego maksimum.
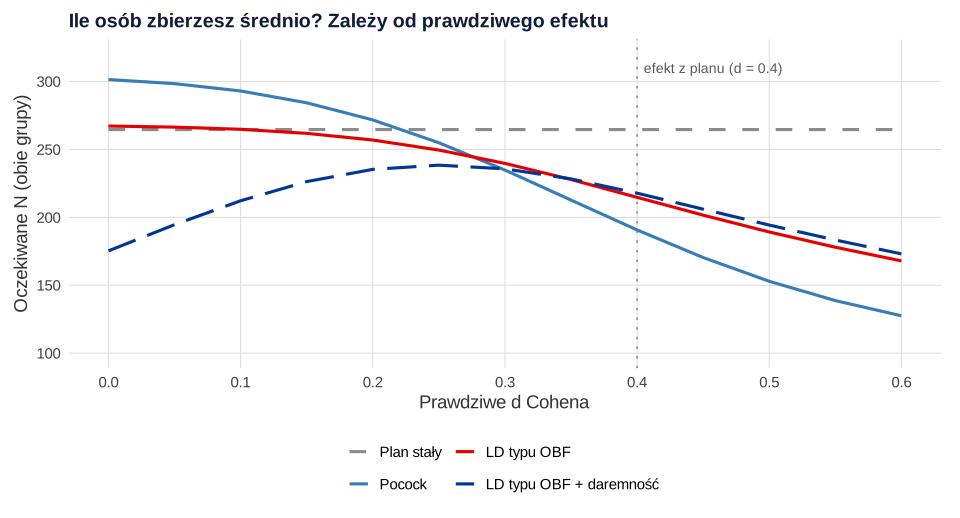
Rysunek 2 pokazuje, od czego zależy wybór. Przy dużym prawdziwym efekcie (d = 0.6) plan Pococka kończy się średnio po 127.5 osobach, a plan typu OBF po 167.9. Przy efekcie zerowym lub bardzo małym plan Pococka jest najdroższy. Jeśli nie wiesz, jaki efekt naprawdę istnieje, a budżet jest sztywny, zwykle bezpieczniejsze są granice typu OBF. W registered report albo wniosku grantowym podaj maksymalne N, bo na nie musisz mieć zasoby. Ogólne zasady opisuje wpis o doborze liczebności próby.
Granica daremności: wiążąca czy niewiążąca
Plan typu OBF bez dodatkowych reguł prawie nie oszczędza osób, gdy efektu nie ma (267.2). Tę oszczędność daje granica daremności. W przykładzie przyjęto najprostszą: przerwij w analizie 1 lub 2, gdy z < 0, czyli gdy efekt idzie w złą stronę. Hasło o daremności omawia kryterium mocy warunkowej. Lakens i in. (2021) opisują też granice wyznaczane funkcją wydatkowania β.
| Plan (Lan–DeMets typu OBF) | Granica z na końcu | Maks. N | Oczekiwane N, brak efektu | Oczekiwane N, d = 0.4 | Przerwanie z daremności: brak efektu / d = 0.4 |
|---|---|---|---|---|---|
| Bez daremności | 1.993 | 267.8 | 267.2 | 214.7 | 0 / 0 |
| Daremność niewiążąca | 1.993 | 281.5 | 175.3 | 217.8 | 62.5% / 2.8% |
| Daremność wiążąca | 1.968 | 278.0 | 173.2 | 215.7 | 62.5% / 2.9% |
Gdy efektu nie ma, granica daremności skraca badanie średnio z 267.2 do 175.3 osób. Ceną jest strata mocy: część badań z prawdziwym efektem (2.8%) zostanie błędnie przerwana. Dlatego maksymalne N rośnie do 281.5, żeby utrzymać moc 90%. Lachin (2005) opisuje ten mechanizm: reguła daremności obniża błąd I rodzaju i zwiększa błąd II rodzaju.
Granica niewiążąca pozwala kontynuować badanie mimo jej przekroczenia, a błąd I rodzaju i tak jest kontrolowany. Granica wiążąca wykorzystuje fakt, że badanie na pewno zostanie przerwane, i obniża próg końcowy (1.968 zamiast 1.993). Jeśli jednak ją zignorujesz, błąd I rodzaju przekroczy α. W badaniach akademickich, gdzie decyzję o kontynuacji podejmuje sam zespół, bezpieczniejsza jest granica niewiążąca. W badaniach klinicznych wyniki pośrednie ocenia zwykle komitet monitorowania danych.
Obciążenie oszacowania po wczesnym zatrzymaniu
Badanie kończy się wcześnie wtedy, gdy wynik przekroczy surową granicę. Częściej dzieje się tak w próbach, w których efekt losowo wypadł duży. Whitehead (1986) pokazał, że zwykłe oszacowanie największej wiarygodności obliczone na końcu procedury sekwencyjnej jest obciążone, i zaproponował oszacowanie skorygowane. Bassler i in. (2010) porównali 91 badań klinicznych przerwanych z powodu korzyści z 424 badaniami na ten sam temat, których nie przerwano. W badaniach przerwanych efekty były większe, niezależnie od obecności formalnej reguły zatrzymania, a różnice były największe w mniejszych badaniach.
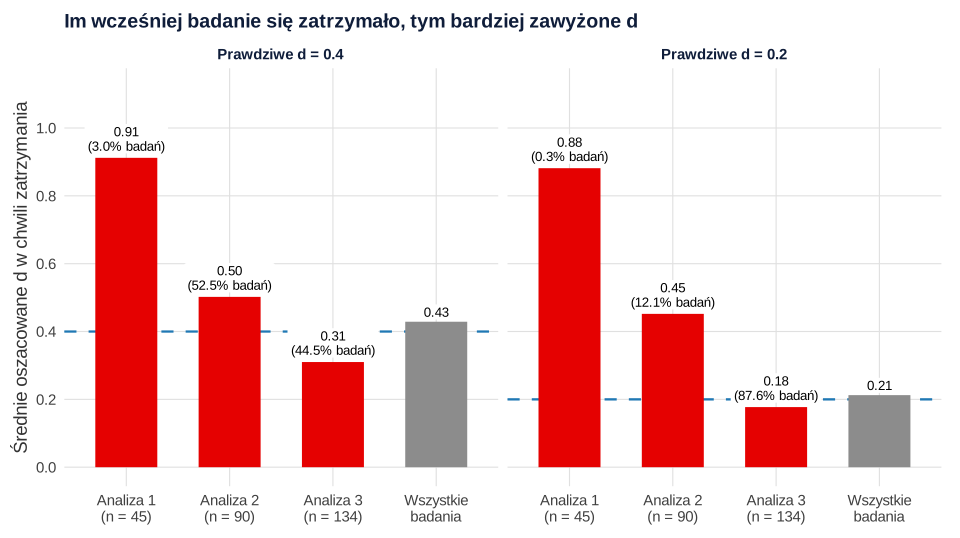
W naszej symulacji (20 000 badań przy prawdziwym d = 0.4) 3.0% badań zatrzymało się w pierwszej analizie ze średnim d = 0.91. W drugiej analizie zatrzymało się 52.5% badań, ze średnim d = 0.50. Badania doprowadzone do końca dały średnio 0.31. Po uśrednieniu wszystkich badań obciążenie jest niewielkie (0.43 wobec 0.40), ale pojedynczy artykuł raportuje jedno badanie, zwykle właśnie to zatrzymane wcześnie. Przy mniejszym prawdziwym efekcie (d = 0.2) średnie d wśród wyników istotnych wyniosło 0.36. To ten sam mechanizm co klątwa zwycięzcy i błąd typu M.
Co z tym zrobić? Lakens i in. (2021) omawiają, jak raportować skorygowane oszacowania i przedziały ufności. Weźmy pierwsze symulowane badanie zatrzymane w analizie 2. Prawdziwa różnica wynosi 4 punkty. Zwykła różnica średnich po 90 osobach w grupie to 6.29 punktu (d = 0.64), 95% CI [3.40, 9.18]. Funkcja getAnalysisResults() z rpact podaje oszacowanie mediano-nieobciążone 6.03 i przedział skorygowany o plan sekwencyjny, 95% CI [3.02, 8.94], przy końcowym p = .000115. Korekta nie usuwa całego zawyżenia w jednym badaniu, ale przesuwa wynik i poszerza przedział we właściwą stronę. Podaj oba zestawy liczb.
Jak opisać plan i wynik
Plan zapisz przed zebraniem danych w planie analizy statystycznej i prerejestracji: liczbę i terminy analiz, funkcję wydatkowania, granicę daremności (wiążąca czy nie), test i maksymalne N. Ukryta albo dopisana później reguła zatrzymania to p-hacking, nawet jeśli granice wyglądają poprawnie.
Jeśli plan sekwencyjny ma trafić do wniosku grantowego albo odpowiedzi recenzentom, możemy wspólnie sprawdzić granice, symulację i opis w ramach wsparcia statystycznego dla badaczy.
Przykład w R
Cztery przepisy niezależne od siebie: każdy możesz uruchomić osobno. Pierwszy i trzeci liczą plany analitycznie, drugi i czwarty symulują badania z testem t. Potrzebny jest pakiet rpact.
1. Liczebność i granice czterech planów
R
# Plan: eksperyment z dwiema grupami (pisanie ekspresywne przed egzaminem a grupa kontrolna).
# Wynik: lęk egzaminacyjny (punkty, SD = 10). Najmniejszy interesujący efekt: 4 punkty, czyli d = 0.4.
# Hipoteza kierunkowa: test jednostronny, alfa = .025 (odpowiada górnemu ogonowi testu dwustronnego .05),
# moc 90%, trzy analizy: po 1/3, 2/3 i całości danych.
suppressPackageStartupMessages(library(rpact))
alfa <- 0.025; moc <- 0.90; d <- 0.4

# 1. Plan o stałej liczebności (jedna analiza na końcu)
n_staly <- ceiling(power.t.test(delta = d, sd = 1, sig.level = alfa, power = moc,
                                alternative = "one.sided")$n)
cat("Plan stały: n na grupę =", n_staly, " N łącznie =", 2 * n_staly, "\n\n")

# 2. Plany grupowo-sekwencyjne: klasyczne granice i funkcje wydatkowania Lana–DeMetsa
typy <- c(Pocock = "P", "O'Brien-Fleming" = "OF", "LD typu Pococka" = "asP", "LD typu OBF" = "asOF")
plany <- lapply(typy, function(t) getDesignGroupSequential(kMax = 3, alpha = alfa, beta = 1 - moc,
                                                         sided = 1, typeOfDesign = t))
tabela <- do.call(rbind, lapply(names(plany), function(nm) {
  pl <- plany[[nm]]
  ss <- getSampleSizeMeans(pl, alternative = d, stDev = 1)
  data.frame(plan = nm,
             z1 = pl$criticalValues[1], z2 = pl$criticalValues[2], z3 = pl$criticalValues[3],
             p3_nominalne = 1 - pnorm(pl$criticalValues[3]),
             N_max = ss$maxNumberOfSubjects,
             wzrost_proc = 100 * (ss$maxNumberOfSubjects / ss$nFixed - 1),
             EN_H0 = ss$expectedNumberOfSubjectsH0, EN_H1 = ss$expectedNumberOfSubjectsH1)
}))
cat("Granice z, nominalne p w analizie końcowej i liczebności (N łącznie, d = 0.4, moc 90%)\n")
print(cbind(tabela[1], round(tabela[2:4], 3), p3_nominalne = round(tabela$p3_nominalne, 4),
            round(tabela[6:9], 1)), row.names = FALSE)
cat("\nN dla planu stałego w przybliżeniu normalnym (rpact):",
    round(getSampleSizeMeans(plany[[1]], alternative = d, stDev = 1)$nFixed, 1), "\n")

# 3. Wydatkowanie alfa w planie LD typu OBF (skumulowane) i nominalne p w każdej analizie
obf <- plany[["LD typu OBF"]]
cat("\nLD typu OBF: skumulowane alfa =", formatC(obf$alphaSpent, format = "f", digits = 4),
    "\nnominalne p (jednostronnie) =", signif(1 - pnorm(obf$criticalValues), 3), "\n")

# 4. Liczebności etapów, które użyjemy w symulacjach (n na grupę, zaokrąglone w górę)
n_max <- ceiling(getSampleSizeMeans(obf, alternative = d, stDev = 1)$maxNumberOfSubjects / 2)
n_etapy <- ceiling(n_max * c(1, 2, 3) / 3)
cat("\nLD typu OBF: n na grupę w analizach =", n_etapy, "\n")
Wynik w R
Plan stały: n na grupę = 133  N łącznie = 266

Granice z, nominalne p w analizie końcowej i liczebności (N łącznie, d = 0.4, moc 90%)
            plan    z1    z2    z3 p3_nominalne N_max wzrost_proc EN_H0 EN_H1
          Pocock 2.289 2.289 2.289       0.0110 304.5        15.1 301.4 190.8
 O'Brien-Fleming 3.471 2.454 2.004       0.0225 268.9         1.6 268.2 211.4
 LD typu Pococka 2.279 2.295 2.296       0.0108 305.4        15.4 302.3 190.8
     LD typu OBF 3.710 2.511 1.993       0.0231 267.8         1.2 267.2 214.7

N dla planu stałego w przybliżeniu normalnym (rpact): 264.6

LD typu OBF: skumulowane alfa = 0.0001 0.0060 0.0250
nominalne p (jednostronnie) = 0.000104 0.00601 0.0231

LD typu OBF: n na grupę w analizach = 45 90 134
2. Symulacja: błąd I rodzaju i moc z testem t
R
# Symulacja: zwykłe testy t (jednostronne) w kolejnych analizach i reguła zatrzymania.
# Każdy wiersz macierzy to jedno badanie; analizy po n1 < n2 < n3 osobach w grupie.
suppressPackageStartupMessages(library(rpact))
set.seed(335)
R <- 20000; alfa <- 0.025

# p jednostronne testu t Studenta (H1: kontrola - interwencja > 0) po pierwszych n osobach w grupie
p_t <- function(k, ie, n) {
  mk <- rowMeans(k[, 1:n, drop = FALSE]); mi <- rowMeans(ie[, 1:n, drop = FALSE])
  vk <- apply(k[, 1:n, drop = FALSE], 1, var); vi <- apply(ie[, 1:n, drop = FALSE], 1, var)
  t <- (mk - mi) / sqrt((vk + vi) / n)
  pt(t, df = 2 * n - 2, lower.tail = FALSE)
}
# Badanie kończy się w pierwszej analizie z p < granicy; zwraca odsetek odrzuceń H0 i średnie N
symuluj <- function(n_etapy, p_granice, d) {
  nmax <- max(n_etapy)
  k  <- matrix(rnorm(R * nmax, 50 + 10 * d, 10), R)   # lęk w grupie kontrolnej
  ie <- matrix(rnorm(R * nmax, 50, 10), R)            # lęk po pisaniu ekspresywnym
  P <- sapply(n_etapy, function(n) p_t(k, ie, n))
  if (is.null(dim(P))) P <- matrix(P, ncol = 1)
  istotne <- sweep(P, 2, p_granice, "<")
  etap <- apply(istotne, 1, function(x) if (any(x)) which(x)[1] else NA)
  N <- 2 * ifelse(is.na(etap), nmax, n_etapy[pmin(etap, length(n_etapy), na.rm = TRUE)])
  c(odrzucenia = mean(!is.na(etap)), N_srednie = mean(N))
}
plan <- function(typ, inf = c(1, 2, 3) / 3)
  getDesignGroupSequential(kMax = 3, alpha = alfa, sided = 1, typeOfDesign = typ, informationRates = inf)
p_nom <- function(pl) 1 - pnorm(pl$criticalValues)

warianty <- list(
  "1. stały plan"        = list(n = 133,             p = alfa),
  "2. bez korekty"       = list(n = c(45, 90, 134),  p = rep(alfa, 3)),
  "3. Pocock"            = list(n = c(51, 102, 153), p = p_nom(plan("P"))),
  "4. LD typu OBF"       = list(n = c(45, 90, 134),  p = p_nom(plan("asOF"))),
  "5. przesun., stare"   = list(n = c(60, 110, 134), p = p_nom(plan("asOF"))),
  "6. przesun., nowe"    = list(n = c(60, 110, 134), p = p_nom(plan("asOF", c(60, 110, 134) / 134))))
wyniki <- t(sapply(warianty, function(w) c(symuluj(w$n, w$p, d = 0), symuluj(w$n, w$p, d = 0.4))))
colnames(wyniki) <- c("blad_I_H0", "N_H0", "moc_d0.4", "N_d0.4")
wyniki <- data.frame(n_w_grupie = sapply(warianty, function(w) paste(w$n, collapse = "/")), round(wyniki, 3))
cat("Symulacja:", R, "badań na wariant i scenariusz; test t jednostronny, alfa = .025\n")
print(wyniki)
cat("5 i 6: analizy po 60 i 110 osobach w grupie zamiast 45 i 90; 5 – granice z planu, 6 – przeliczone funkcją wydatkowania\n")
cat("\nBłąd Monte Carlo odsetka 0.025 przy R =", R, ":", round(sqrt(0.025 * 0.975 / R), 4), "\n")
cat("Granice nominalnego p po przesunięciu analiz:", signif(p_nom(plan("asOF", c(60, 110, 134) / 134)), 3), "\n")
Wynik w R
Symulacja: 20000 badań na wariant i scenariusz; test t jednostronny, alfa = .025
                   n_w_grupie blad_I_H0    N_H0 moc_d0.4  N_d0.4
1. stały plan             133     0.024 266.000    0.901 266.000
2. bez korekty      45/90/134     0.053 262.148    0.922 157.507
3. Pocock          51/102/153     0.025 302.966    0.903 192.505
4. LD typu OBF      45/90/134     0.025 267.393    0.900 215.825
5. przesun., stare 60/110/134     0.023 267.733    0.897 230.289
6. przesun., nowe  60/110/134     0.024 267.342    0.898 215.042
5 i 6: analizy po 60 i 110 osobach w grupie zamiast 45 i 90; 5 – granice z planu, 6 – przeliczone funkcją wydatkowania

Błąd Monte Carlo odsetka 0.025 przy R = 20000 : 0.0011
Granice nominalnego p po przesunięciu analiz: 0.000809 0.0131 0.021
3. Granica daremności i oczekiwana liczebność
R
# Granica daremności: przerwij w analizie pośredniej, gdy z < 0 (efekt w złym kierunku).
# Porównanie: bez granicy daremności, granica niewiążąca i wiążąca (LD typu OBF, alfa = .025, moc 90%).
suppressPackageStartupMessages(library(rpact))
alfa <- 0.025; moc <- 0.90; d <- 0.4
pl <- list(
  "bez daremności"      = getDesignGroupSequential(kMax = 3, alpha = alfa, beta = 1 - moc, sided = 1,
                                                   typeOfDesign = "asOF"),
  "daremność niewiążąca" = getDesignGroupSequential(kMax = 3, alpha = alfa, beta = 1 - moc, sided = 1,
                                                   typeOfDesign = "asOF", futilityBounds = c(0, 0),
                                                   bindingFutility = FALSE),
  "daremność wiążąca"   = getDesignGroupSequential(kMax = 3, alpha = alfa, beta = 1 - moc, sided = 1,
                                                   typeOfDesign = "asOF", futilityBounds = c(0, 0),
                                                   bindingFutility = TRUE))
zero_gdy_brak <- function(x) if (is.numeric(x)) x else 0
tab <- do.call(rbind, lapply(names(pl), function(nm) {
  ss <- getSampleSizeMeans(pl[[nm]], alternative = d, stDev = 1)
  h0 <- getPowerMeans(pl[[nm]], alternative = 0, stDev = 1, maxNumberOfSubjects = ss$maxNumberOfSubjects)
  data.frame(plan = nm, z3 = round(pl[[nm]]$criticalValues[3], 3),
             N_max = round(ss$maxNumberOfSubjects, 1),
             EN_H0 = round(ss$expectedNumberOfSubjectsH0, 1), EN_H1 = round(ss$expectedNumberOfSubjectsH1, 1),
             daremnosc_H0 = round(zero_gdy_brak(h0$futilityStop), 3), daremnosc_H1 = round(zero_gdy_brak(ss$futilityStop), 3))
}))
print(tab, row.names = FALSE)
n_max_f <- ceiling(tab$N_max[2] / 2)
cat("Daremność niewiążąca: n na grupę w analizach =", ceiling(n_max_f * c(1, 2, 3) / 3), "\n\n")

# Oczekiwana liczebność i moc przy różnych prawdziwych efektach (do rysunku 2)
d_siatka <- seq(0, 0.6, by = 0.05)
krzywe <- do.call(rbind, lapply(c("P", "asOF"), function(t) {
  p <- getDesignGroupSequential(kMax = 3, alpha = alfa, beta = 1 - moc, sided = 1, typeOfDesign = t)
  nmax <- getSampleSizeMeans(p, alternative = d, stDev = 1)$maxNumberOfSubjects
  w <- getPowerMeans(p, alternative = d_siatka, stDev = 1, maxNumberOfSubjects = nmax)
  data.frame(plan = unname(c(P = "Pocock", asOF = "LD typu OBF")[t]), d = d_siatka,
             EN = w$expectedNumberOfSubjects, moc = w$overallReject)
}))
nmax_f <- getSampleSizeMeans(pl[[2]], alternative = d, stDev = 1)$maxNumberOfSubjects
w_f <- getPowerMeans(pl[[2]], alternative = d_siatka, stDev = 1, maxNumberOfSubjects = nmax_f)
krzywe <- rbind(krzywe, data.frame(plan = "LD typu OBF + daremność", d = d_siatka,
                                   EN = w_f$expectedNumberOfSubjects, moc = w_f$overallReject))
n_staly <- getSampleSizeMeans(pl[[1]], alternative = d, stDev = 1)$nFixed
krzywe <- rbind(krzywe, data.frame(plan = "Plan stały", d = d_siatka, EN = n_staly,
                                   moc = sapply(d_siatka, function(x) if (x == 0) alfa else
                                     power.t.test(n = n_staly / 2, delta = x, sig.level = alfa,
                                                  alternative = "one.sided")$power)))
krzywe$EN <- round(krzywe$EN, 1); krzywe$moc <- round(krzywe$moc, 3)
print(krzywe[krzywe$d %in% c(0, 0.2, 0.4, 0.6), ], row.names = FALSE)
Wynik w R
                 plan    z3 N_max EN_H0 EN_H1 daremnosc_H0 daremnosc_H1
       bez daremności 1.993 267.8 267.2 214.7        0.000        0.000
 daremność niewiążąca 1.993 281.5 175.3 217.8        0.625        0.028
    daremność wiążąca 1.968 278.0 173.2 215.7        0.625        0.029
Daremność niewiążąca: n na grupę w analizach = 47 94 141

                    plan   d    EN   moc
                  Pocock 0.0 301.4 0.025
                  Pocock 0.2 271.7 0.347
                  Pocock 0.4 190.7 0.900
                  Pocock 0.6 127.5 0.999
             LD typu OBF 0.0 267.2 0.025
             LD typu OBF 0.2 256.9 0.366
             LD typu OBF 0.4 214.7 0.900
             LD typu OBF 0.6 167.9 0.998
 LD typu OBF + daremność 0.0 175.3 0.024
 LD typu OBF + daremność 0.2 235.3 0.368
 LD typu OBF + daremność 0.4 217.8 0.900
 LD typu OBF + daremność 0.6 173.1 0.997
              Plan stały 0.0 264.6 0.025
              Plan stały 0.2 264.6 0.367
              Plan stały 0.4 264.6 0.900
              Plan stały 0.6 264.6 0.998
4. Obciążenie po wczesnym zatrzymaniu i oszacowanie skorygowane
R
# Obciążenie oszacowania po wczesnym zatrzymaniu: LD typu OBF, analizy po 45/90/134 osobach w grupie.
suppressPackageStartupMessages(library(rpact))
set.seed(3354)
R <- 20000; n_etapy <- c(45, 90, 134)
obf <- getDesignGroupSequential(kMax = 3, alpha = 0.025, sided = 1, typeOfDesign = "asOF")
z_gr <- obf$criticalValues

# d Cohena (wspólne SD) i statystyka t po pierwszych n osobach w grupie
d_i_t <- function(k, ie, n) {
  mk <- rowMeans(k[, 1:n]); mi <- rowMeans(ie[, 1:n])
  sp <- sqrt((apply(k[, 1:n], 1, var) + apply(ie[, 1:n], 1, var)) / 2)
  list(d = (mk - mi) / sp, t = (mk - mi) / (sp * sqrt(2 / n)))
}
badania <- function(d_prawd) {
  k  <- matrix(rnorm(R * 134, 50 + 10 * d_prawd, 10), R)
  ie <- matrix(rnorm(R * 134, 50, 10), R)
  wyn <- lapply(seq_along(n_etapy), function(j) {
    x <- d_i_t(k, ie, n_etapy[j])
    # granica na skali p: nominalne p testu t < nominalne p granicy z
    list(d = x$d, stop = pt(x$t, 2 * n_etapy[j] - 2, lower.tail = FALSE) < 1 - pnorm(z_gr[j]))
  })
  stopy <- sapply(wyn, `[[`, "stop"); stopy[, 3] <- TRUE        # w analizie 3 badanie i tak się kończy
  etap <- apply(stopy, 1, which.max)
  d_hat <- sapply(wyn, `[[`, "d")[cbind(1:R, etap)]
  list(etap = etap, d_hat = d_hat, istotne = sapply(wyn, `[[`, "stop")[cbind(1:R, etap)],
       d_staly = sapply(wyn, `[[`, "d")[, 3], k = k, ie = ie)
}
tabele <- list()
for (d_prawd in c(0.4, 0.2)) {
  b <- badania(d_prawd)
  tab <- data.frame(analiza = c("1 (n = 45)", "2 (n = 90)", "3 (n = 134)", "razem"),
                    odsetek_badan = c(tabulate(b$etap, 3) / R, 1),
                    srednie_d = c(tapply(b$d_hat, factor(b$etap, 1:3), mean), mean(b$d_hat)))
  cat("\nPrawdziwe d =", d_prawd, "\n"); print(cbind(tab[1], round(tab[-1], 3)), row.names = FALSE)
  cat("Średnie d w planie stałym (zawsze n = 134):", round(mean(b$d_staly), 3),
      "\nŚrednie d wśród badań z wynikiem istotnym:", round(mean(b$d_hat[b$istotne]), 3), "\n")
  tabele[[as.character(d_prawd)]] <- tab
  if (d_prawd == 0.4) wzor <- b
}

# Jedno badanie (pierwsze z symulacji przy d = 0.4 zatrzymane w analizie 2) w rpact:
# oszacowanie mediano-nieobciążone i przedział ufności skorygowany o plan sekwencyjny
i <- which(wzor$etap == 2)[1]
grupy <- list(k = wzor$k[i, ], ie = wzor$ie[i, ]); od <- c(1, 46); do_ <- c(45, 90)
etap_stat <- function(x, f) sapply(1:2, function(j) f(x[od[j]:do_[j]]))
dane <- getDataset(n1 = c(45, 45), n2 = c(45, 45),
                   means1 = etap_stat(grupy$k, mean), means2 = etap_stat(grupy$ie, mean),
                   stDevs1 = etap_stat(grupy$k, sd), stDevs2 = etap_stat(grupy$ie, sd))
wynik <- getAnalysisResults(obf, dataInput = dane, directionUpper = TRUE)
cat("\nBadanie nr", i, ": różnica średnich po 90 osobach w grupie (zwykła) =",
    round(mean(grupy$k[1:90]) - mean(grupy$ie[1:90]), 2), "pkt, d =", round(wzor$d_hat[i], 3), "\n")
print(t.test(grupy$k[1:90], grupy$ie[1:90], var.equal = TRUE)$conf.int)
cat("rpact: etap końcowy =", wynik$finalStage, "\nkońcowe p =", sub("^0", "", formatC(wynik$finalPValues[2], format = "f", digits = 6)),
    "\noszacowanie mediano-nieobciążone =", round(wynik$medianUnbiasedEstimates[2], 2),
    "\nskorygowany 95% CI (dwustronny) = [", round(wynik$finalConfidenceIntervalLowerBounds[2], 2), ",",
    round(wynik$finalConfidenceIntervalUpperBounds[2], 2), "]\n")
Wynik w R
Prawdziwe d = 0.4
     analiza odsetek_badan srednie_d
  1 (n = 45)         0.030     0.912
  2 (n = 90)         0.525     0.502
 3 (n = 134)         0.445     0.310
       razem         1.000     0.429
Średnie d w planie stałym (zawsze n = 134): 0.4
Średnie d wśród badań z wynikiem istotnym: 0.456

Prawdziwe d = 0.2
     analiza odsetek_badan srednie_d
  1 (n = 45)         0.003     0.882
  2 (n = 90)         0.121     0.452
 3 (n = 134)         0.876     0.177
       razem         1.000     0.212
Średnie d w planie stałym (zawsze n = 134): 0.201
Średnie d wśród badań z wynikiem istotnym: 0.359

Badanie nr 1 : różnica średnich po 90 osobach w grupie (zwykła) = 6.29 pkt, d = 0.64
[1] 3.399088 9.178991
attr(,"conf.level")
[1] 0.95
rpact: etap końcowy = 2
końcowe p = .000115
oszacowanie mediano-nieobciążone = 6.03
skorygowany 95% CI (dwustronny) = [ 3.02 , 8.94 ]
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiety base i stats oraz rpact); rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- rpact (wersja 4.4.0): Wassmer, G., & Pahlke, F. (2026). rpact: Confirmatory adaptive clinical trial design and analysis [R package]. https://doi.org/10.32614/CRAN.package.rpact
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Analizy pośrednie, których nie ma w planie. Każde nieujawnione spojrzenie zawyża błąd I rodzaju, także wtedy, gdy nie zakończyło badania.
- Granice Pococka bez sprawdzenia maksymalnego N. W przykładzie wymagały 15.1% więcej osób niż plan stały. Bez efektu plan Pococka zbiera średnio więcej osób niż plan stały.
- Zignorowana granica wiążąca. Jeśli kontynuujesz badanie mimo jej przekroczenia, użyj od początku granicy niewiążącej.
- Zmiana funkcji wydatkowania po obejrzeniu danych. Przeliczać wolno granice dla nowych terminów, nie samą funkcję.
- Raport samego zwykłego d z badania przerwanego wcześnie. Dodaj oszacowanie skorygowane i informację, w której analizie badanie zakończono.
- Nieistotny wynik po przerwaniu z daremności jako dowód braku efektu. To decyzja o oszczędności zasobów, a nie test równoważności.
Najczęstsze pytania
Ile analiz pośrednich zaplanować w eksperymencie psychologicznym?
Nie ma jednej liczby. Każda analiza to dodatkowa szansa na wcześniejsze zakończenie, ale też większe maksymalne N przy granicach typu Pococka i więcej pracy z przygotowaniem danych. W przykładzie z trzema analizami plan Lana–DeMetsa typu OBF zwiększył maksymalne N tylko o 1.2%, a plan Pococka o 15.1%. Policz kilka wariantów w rpact i wybierz ten, którego maksimum możesz zebrać.
Czy analizę pośrednią można zrobić w innym momencie, niż zaplanowano?
Tak, jeśli plan opiera się na funkcji wydatkowania alfa Lana–DeMetsa. Granice przelicza się wtedy dla faktycznego odsetka zebranych danych. W symulacji z analizami po 60 i 110 zamiast po 45 i 90 osobach w grupie błąd I rodzaju po przeliczeniu wyniósł 2.4% przy α = .025. Nie wolno natomiast zmieniać samej funkcji po obejrzeniu danych.
Czy w badaniu sekwencyjnym można użyć zwykłego testu t?
Tak. W każdej analizie wykonujesz zwykły test t na wszystkich dotąd zebranych danych i porównujesz p z nominalnym progiem z planu, a nie z .05. W symulacji 20 000 badań bez efektu taka reguła dała 2.5% fałszywych alarmów przy α = .025. Funkcja getAnalysisResults() w rpact wykorzystuje rozkład t bezpośrednio.
Czy efekt z badania przerwanego w analizie pośredniej jest zawyżony?
Zwykle tak, bo badanie kończy się wcześnie częściej wtedy, gdy efekt losowo wypadł duży. W symulacji przy prawdziwym d = 0.4 badania zatrzymane w drugiej analizie dawały średnio d = 0.50, a w pierwszej 0.91. Podaj zwykłe oszacowanie, oszacowanie mediano-nieobciążone i przedział skorygowany o plan sekwencyjny.
Czym różni się wiążąca granica daremności od niewiążącej?
Granica wiążąca zakłada, że po jej przekroczeniu badanie na pewno zostanie przerwane, dzięki czemu próg końcowy może być łagodniejszy (w przykładzie 1.968 zamiast 1.993). Jeśli ją zignorujesz i będziesz kontynuować, błąd I rodzaju przekroczy α. Granica niewiążąca pozwala kontynuować bez utraty kontroli nad błędem, więc w badaniach akademickich jest bezpieczniejsza.
Powiązane hasła
Przeczytaj też
Test A/B – plan i analiza
Metryka główna, liczebność z power.prop.test, losowanie i czas trwania, skutki podglądania wyników w symulacji oraz różnica odsetków z CI i względny wzrost.
Czytaj →PoradnikPlan analizy statystycznej i prerejestracja
12 elementów planu analizy, moc i SESOI w R, OSF czy AsPredicted, registered reports, tabela odstępstw i wzór planu w Wordzie do pobrania.
Czytaj →PoradnikDobór liczebności próby
Analiza mocy a priori, SESOI i test równoważności, precyzja przedziału ufności, analiza wrażliwości i pułapka pilotażu – z obliczeniami w R.
Czytaj →PoradnikSekwencyjny test A/B i granice zatrzymania
Gazeta cyfrowa testuje paywall z 4 analizami pośrednimi: granice O’Briena–Fleminga i Pococka, fałszywe alarmy, czas testu i zawyżony efekt – z kodem R.
Czytaj →Planujesz analizy pośrednie w eksperymencie albo grancie?
Pomożemy dobrać granice zatrzymania, policzyć maksymalną i oczekiwaną liczebność oraz opisać plan i wynik tak, żebyś mógł(a) samodzielnie obronić je przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Armitage, P., McPherson, C. K., & Rowe, B. C. (1969). Repeated significance tests on accumulating data. Journal of the Royal Statistical Society. Series A (General), 132(2), 235–244. https://doi.org/10.2307/2343787
- Bassler, D., Briel, M., Montori, V. M., Lane, M., Glasziou, P., Zhou, Q., Heels-Ansdell, D., Walter, S. D., Guyatt, G. H., & STOPIT-2 Study Group. (2010). Stopping randomized trials early for benefit and estimation of treatment effects: Systematic review and meta-regression analysis. JAMA, 303(12), 1180–1187. https://doi.org/10.1001/jama.2010.310
- Kim, K., & DeMets, D. L. (1987). Design and analysis of group sequential tests based on the type I error spending rate function. Biometrika, 74(1), 149–154. https://doi.org/10.1093/biomet/74.1.149
- Lachin, J. M. (2005). A review of methods for futility stopping based on conditional power. Statistics in Medicine, 24(18), 2747–2764. https://doi.org/10.1002/sim.2151
- Lakens, D. (2014). Performing high-powered studies efficiently with sequential analyses. European Journal of Social Psychology, 44(7), 701–710. https://doi.org/10.1002/ejsp.2023 ● Otwarty dostęp
- Lakens, D., Pahlke, F., & Wassmer, G. (2021). Group sequential designs: A tutorial. PsyArXiv. https://doi.org/10.31234/osf.io/x4azm ● Otwarty dostęp
- Lan, K. K. G., & DeMets, D. L. (1983). Discrete sequential boundaries for clinical trials. Biometrika, 70(3), 659–663. https://doi.org/10.1093/biomet/70.3.659
- O'Brien, P. C., & Fleming, T. R. (1979). A multiple testing procedure for clinical trials. Biometrics, 35(3), 549–556. https://doi.org/10.2307/2530245
- Pocock, S. J. (1977). Group sequential methods in the design and analysis of clinical trials. Biometrika, 64(2), 191–199. https://doi.org/10.1093/biomet/64.2.191
- Whitehead, J. (1986). On the bias of maximum likelihood estimation following a sequential test. Biometrika, 73(3), 573–581. https://doi.org/10.1093/biomet/73.3.573
Cytowania BibTeX
@article{armitage1969repeated, author={Armitage, P. and McPherson, C. K. and Rowe, B. C.}, title={{Repeated significance tests on accumulating data}}, journal={Journal of the Royal Statistical Society. Series A (General)}, year={1969}, volume={132}, number={2}, pages={235--244}, doi={10.2307/2343787}}@article{bassler2010stopping, author={Bassler, Dirk and Briel, Matthias and Montori, Victor M. and Lane, Melanie and Glasziou, Paul and Zhou, Qi and Heels-Ansdell, Diane and Walter, Stephen D. and Guyatt, Gordon H. and {STOPIT-2 Study Group}}, title={{Stopping randomized trials early for benefit and estimation of treatment effects: Systematic review and meta-regression analysis}}, journal={JAMA}, year={2010}, volume={303}, number={12}, pages={1180--1187}, doi={10.1001/jama.2010.310}}@article{kim1987design, author={Kim, Kyungmann and DeMets, David L.}, title={{Design and analysis of group sequential tests based on the type I error spending rate function}}, journal={Biometrika}, year={1987}, volume={74}, number={1}, pages={149--154}, doi={10.1093/biomet/74.1.149}}@article{lachin2005review, author={Lachin, John M.}, title={{A review of methods for futility stopping based on conditional power}}, journal={Statistics in Medicine}, year={2005}, volume={24}, number={18}, pages={2747--2764}, doi={10.1002/sim.2151}}@article{lakens2014performing, author={Lakens, Daniël}, title={{Performing high-powered studies efficiently with sequential analyses}}, journal={European Journal of Social Psychology}, year={2014}, volume={44}, number={7}, pages={701--710}, doi={10.1002/ejsp.2023}}@article{lakens2021group, author={Lakens, Daniël and Pahlke, Friedrich and Wassmer, Gernot}, title={{Group sequential designs: A tutorial}}, journal={PsyArXiv}, year={2021}, doi={10.31234/osf.io/x4azm}}@article{lan1983discrete, author={Lan, K. K. Gordon and DeMets, David L.}, title={{Discrete sequential boundaries for clinical trials}}, journal={Biometrika}, year={1983}, volume={70}, number={3}, pages={659--663}, doi={10.1093/biomet/70.3.659}}@article{obrien1979multiple, author={O'Brien, Peter C. and Fleming, Thomas R.}, title={{A multiple testing procedure for clinical trials}}, journal={Biometrics}, year={1979}, volume={35}, number={3}, pages={549--556}, doi={10.2307/2530245}}@article{pocock1977group, author={Pocock, Stuart J.}, title={{Group sequential methods in the design and analysis of clinical trials}}, journal={Biometrika}, year={1977}, volume={64}, number={2}, pages={191--199}, doi={10.1093/biomet/64.2.191}}@article{whitehead1986bias, author={Whitehead, John}, title={{On the bias of maximum likelihood estimation following a sequential test}}, journal={Biometrika}, year={1986}, volume={73}, number={3}, pages={573--581}, doi={10.1093/biomet/73.3.573}}