Przykład: gazeta cyfrowa i nowy paywall
Fikcyjny dziennik regionalny wydaje się tylko w sieci. Pięć artykułów w miesiącu można przeczytać za darmo, potem wyskakuje paywall z ofertą prenumeraty. Dziś prenumeratę kupuje w tej samej wizycie 2.0% czytelników, którzy go zobaczą. Zespół przygotował nowy paywall B: pokazuje początek artykułu, listę korzyści i tę samą cenę. Pytanie: czy B sprzedaje więcej prenumerat – i czy da się to sprawdzić szybciej niż w zwykłym teście?
To test A/B: każdy czytelnik, który po raz pierwszy trafia na paywall, losowo widzi wersję A albo B. Dziennie jest to około 1800 osób, czyli 900 na wersję. Wdrożenie ma sens, jeśli B podnosi zakupy co najmniej o 15% względnie (z 2.0% do 2.3%). Pytamy tylko, czy B jest lepsze, więc stosujemy test jednostronny z α = .025, a moc ma wynosić 80%. Plan stały, z jedną analizą na końcu, wymaga 36 693 czytelników na wersję, czyli 40.8 dnia.
Redakcja nie chce czekać sześciu tygodni, jeśli B wyraźnie wygrywa. Dlatego plan jest sekwencyjny: cztery analizy pośrednie (po 2, 3, 4 i 5 tygodniach) i analiza końcowa po 6 tygodniach, każda z granicą ustaloną przed startem. Ten wpis pokazuje, co takie granice dają w praktyce marketingowej. Teorię, porównanie planów przy stałej mocy i oszacowania skorygowane opisuje wpis analizy pośrednie w praktyce.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Ręcznie ustaliliśmy: zakupy 2.0% przy A, najmniejszy ważny wzrost 15%, 900 czytelników na wersję dziennie, terminy analiz i prawdziwy wzrost w teście gazety (B: 2.3%). W symulacjach dodaliśmy scenariusze bez efektu i z wzrostem o 25% oraz granicę daremności (parametr −4). Ziarna 687, 6870 i 6871 ustalono raz i nie zmieniano. Po pierwszym uruchomieniu poprawiliśmy tylko układ podpisów na rysunkach – żadnych parametrów danych. Dzienne dane testu pobierzesz jako sekwencyjny-test-ab-paywall-dzienne.csv.
Rysunek 1: plan – analiza, granica, decyzja
Każda analiza wygląda tak samo. Liczymy statystykę Z testu dla dwóch proporcji na wszystkich dotąd zebranych czytelnikach i porównujemy ją z granicą na ten tydzień. Granice wyznacza pakiet gsDesign, a wszystkie razem utrzymują łączny błąd I rodzaju na poziomie 2.5%.
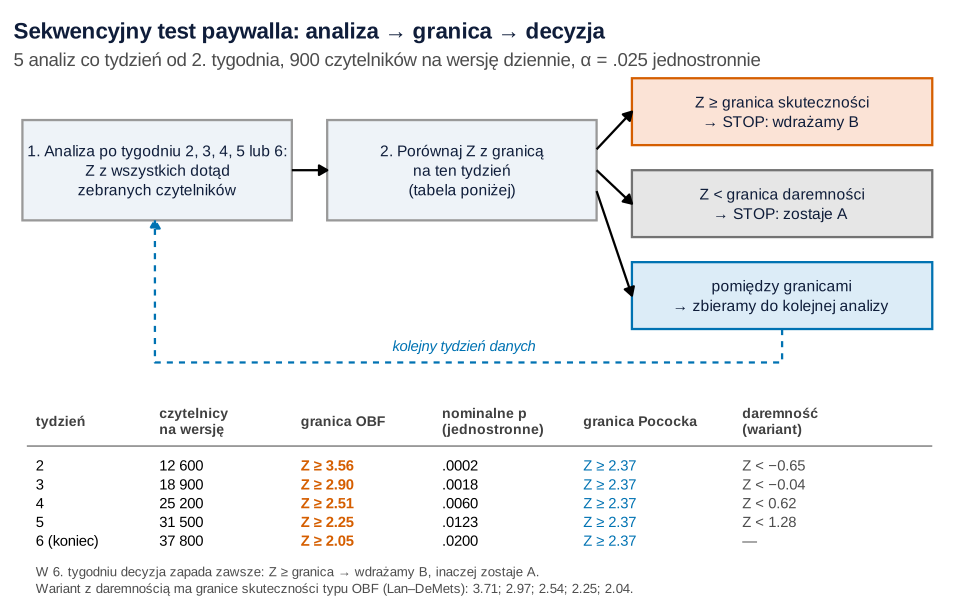
Co widać. Granica O'Briena–Fleminga jest surowa na początku: po 2 tygodniach wymaga Z ≥ 3.56, po 4 – 2.51, na końcu 2.05. Granica Pococka jest stała: 2.37 w każdym tygodniu. O'Brien i Fleming (1979) pokazali, że ich procedura ma praktycznie ten sam poziom istotności i moc co pojedynczy test na pełnej próbie. Pocock (1977) zaproponował stały próg po każdej grupie obserwacji. Klasyczne granice zakładają z góry znane terminy analiz; gdy analiza wypada w innym dniu, pomaga funkcja wydatkowania alfa (Lan i DeMets, 1983).
Jak może zmylić. Ostatnia kolumna należy do wariantu z granicą daremności, który ma nieco inne granice skuteczności (typu O'Briena–Fleminga z funkcją Lana–DeMetsa: 3.71, 2.97, 2.54, 2.25 i 2.04). Nie mieszaj granic dwóch planów w jednym teście.
Podpis do pracy:
Rysunek 2: przebieg testu gazety
Test ruszył i co tydzień od 2. tygodnia analityk liczył Z. Rysunek pokazuje Z dzień po dniu, choć decyzje zapadały tylko w kółkach.
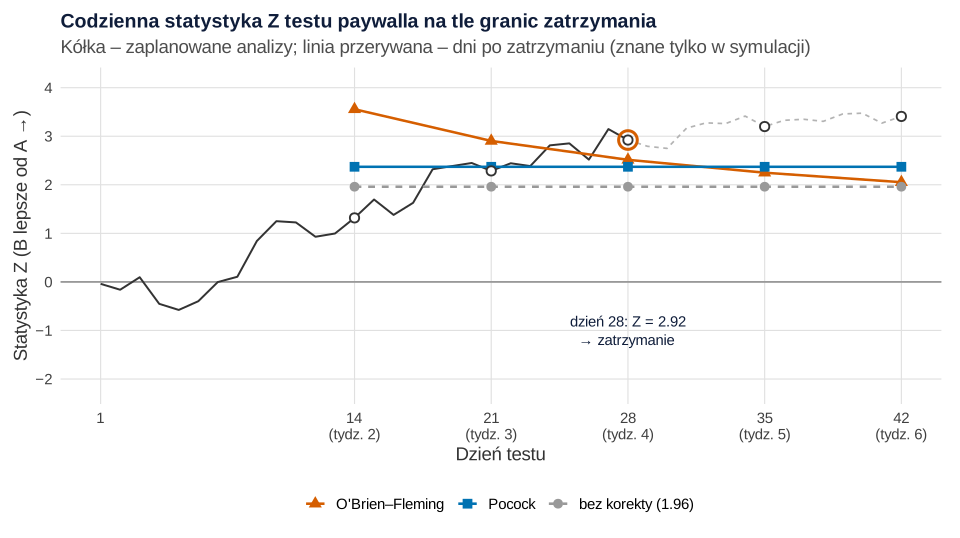
set.seed(687)).Co widać. Po 2 tygodniach B miało 2.325% zakupów, A – 2.083%, Z = 1.32: zbieramy dalej. Po 3 tygodniach Z = 2.29, poniżej granicy 2.90. Po 4 tygodniach (25 314 i 25 550 czytelników) A miało 1.975%, B – 2.352%, a Z = 2.92 przekroczyło granicę 2.51. Test zakończono w dniu 28, dwa tygodnie przed planem, i wdrożono B.
Jak może zmylić. Bez korekty test „wygrałby” już w 3. tygodniu, a przy codziennym zaglądaniu – w dniu 18. Tutaj B naprawdę jest lepsze, więc szczęśliwie nic złego by się nie stało, ale tego nie wiadomo z góry (rysunek 3). Drugie złudzenie to wielkość efektu: w dniu zatrzymania wzrost wyniósł 19.1%, a prawda to 15% (rysunek 5).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: zaglądanie bez korekty a granice
Po co te surowe granice? Sprawdziliśmy to na 10 000 testach A/A, w których obie wersje sprzedają dokładnie 2.0%. Każdy „zwycięzca” jest więc fałszywym alarmem. Porównaliśmy pięć zasad: zaglądanie codziennie i co tydzień ze zwykłym progiem 1.96, granice Pococka i O'Briena–Fleminga oraz jedną analizę na końcu.
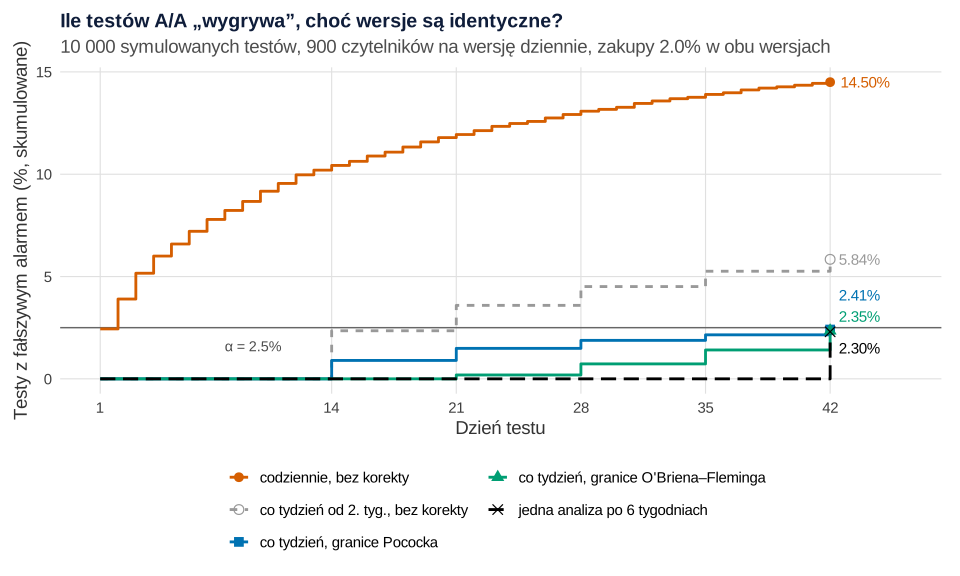
set.seed(6870)).Co widać. Codzienne zaglądanie dało 14.50% fałszywych alarmów (błąd Monte Carlo 0.35 pp) zamiast 2.5%, z czego 10.43% przyszło już w pierwszych dwóch tygodniach. Pięć tygodniowych spojrzeń ze zwykłym progiem – 5.84%. Granice Pococka i O'Briena–Fleminga dały 2.41% i 2.35%, a jedna analiza na końcu – 2.30% (błąd MC 0.15 pp). Armitage i in. (1969) opisali ten mechanizm: powtarzany test na tym samym poziomie częściej daje wynik istotny, niż obiecuje α. To opcjonalne zatrzymywanie.
Jak może zmylić. Granice chronią tylko zaplanowane spojrzenia. Jeśli ktoś „tylko zerknie” w czwartek i zatrzyma test, liczby z wykresu przestają obowiązywać. Inne ujęcie tej samej pułapki (test dwustronny, inny serwis) jest we wpisie o pułapkach testów A/B.
Podpis do pracy:
Rysunek 4: ile trwa test – przy efekcie i bez
Granice kosztują trochę mocy, ale skracają test. Ile? Symulowaliśmy po 10 000 testów w trzech scenariuszach i stosowaliśmy cztery plany do tych samych danych. Wszystkie plany mają ten sam budżet: najwyżej 6 tygodni, czyli 37 800 czytelników na wersję. Czwarty plan dodaje granicę daremności: kończy test, gdy B wypada tak słabo, że wygrana jest mało prawdopodobna. Granica jest niewiążąca, więc jej zignorowanie nie psuje kontroli błędu I rodzaju.
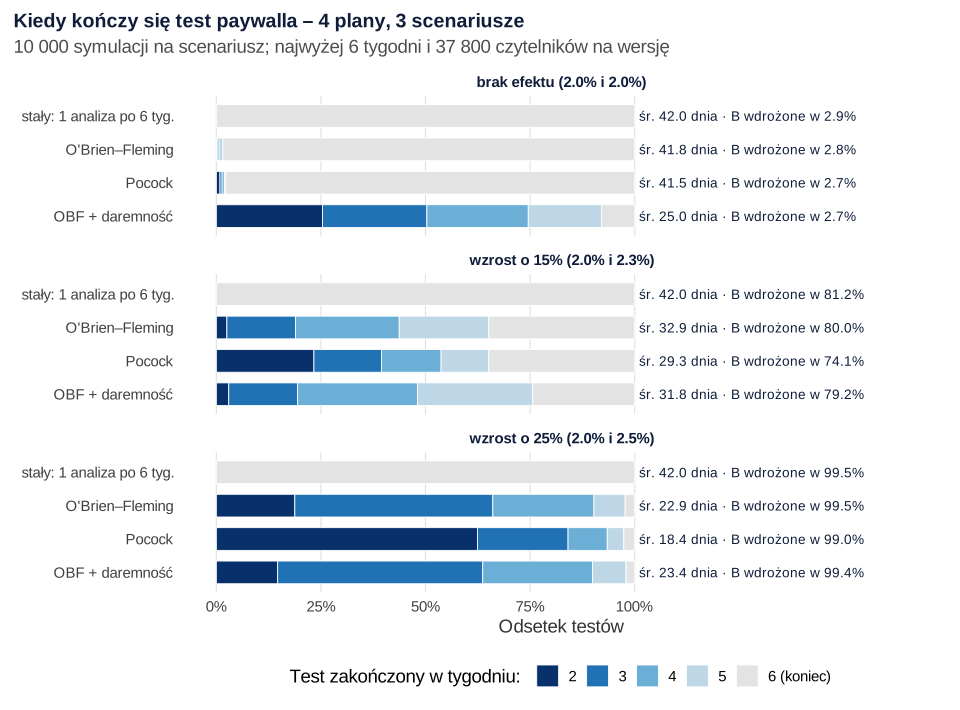
set.seed(6871)).Co widać. Przy wzroście 15% plan O'Briena–Fleminga trwał średnio 32.9 dnia zamiast 42 i wdrożył B w 79.95% testów; plan stały – w 81.25%. Pocock skraca test bardziej (29.3 dnia), ale przy tym samym budżecie traci moc: 74.11%. Przy wzroście 25% O'Brien–Fleming kończy średnio po 22.9 dnia, a Pocock – po 18.4. Bez efektu oba plany trwają prawie zawsze pełne 6 tygodni; skraca je dopiero daremność – średnio 25.0 dnia przy mocy 79.21%. Wzory gsDesign dają to samo: moc 79.9% i 73.9% oraz 32.9 i 29.3 dnia.
Jak może zmylić. Średnia ukrywa rozrzut: przy wzroście 15% w 34.9% testów O'Briena–Fleminga i tak trzeba czekać do końca. Odsetek fałszywych wdrożeń w scenariuszu bez efektu waha się tu od 2.68% do 2.88% – to błąd Monte Carlo (ok. 0.16 pp), a nie wada planu. Proste reguły daremności, np. Z < 0, opisuje wpis o analizach pośrednich.
Podpis do pracy:
Zdanie do Metody:
Rysunek 5: wygrana za wcześnie zawyża wzrost
Test gazety zatrzymał się z wynikiem +19.1%, choć prawda to +15%. Przypadek? Sprawdziliśmy oszacowania z 10 000 testów z rysunku 4 (wzrost 15%, plan O'Briena–Fleminga).
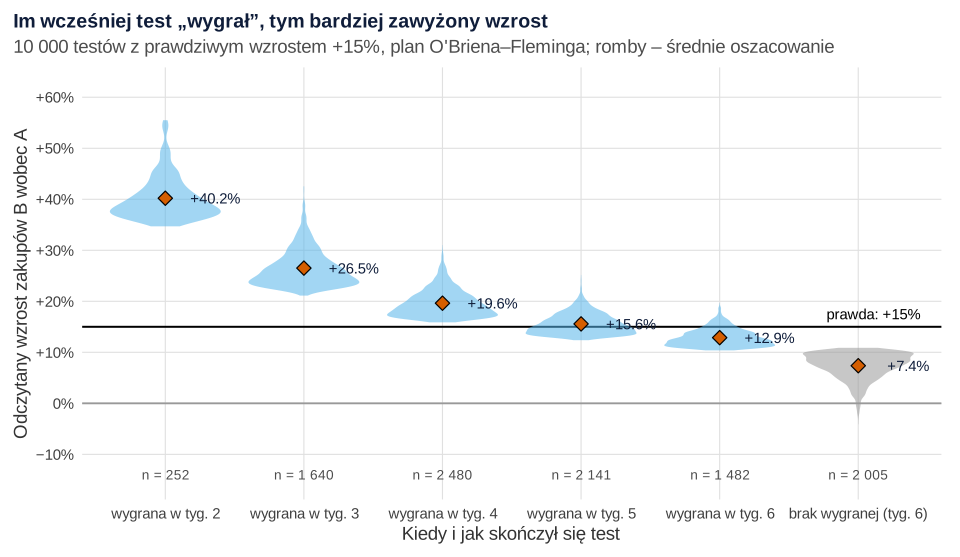
set.seed(6871)).Co widać. Testy, które wygrały w 2. tygodniu, pokazywały średnio +40.2%, w 3. tygodniu +26.5%, w 4. +19.6%. Wcześnie przekracza surową granicę tylko ten test, któremu los dodał dużo. Średnio wszystkie wygrane O'Briena–Fleminga pokazywały +19.3%, wygrane Pococka – +21.3%. To klątwa zwycięzcy w wersji czasowej. Whitehead (1986) pokazał, że oszacowania po procedurze sekwencyjnej są obciążone, a Bassler i in. (2010) – że badania kliniczne przerwane wcześnie z powodu korzyści dawały większe efekty niż badania nieprzerwane.
Jak może zmylić. Granice chronią decyzję „czy B jest lepsze”, nie liczbę „o ile”. Prognoza przychodu z +19.1% obiecałaby redakcji za dużo. Ten sam mechanizm przy wyborze najlepszej z wielu wersji opisuje wpis test A/B z wieloma wariantami.
Podpis do pracy:
Co z tym zrobić w marketingu
- Zapisz plan przed startem: metrykę, najmniejszy ważny wzrost, terminy analiz, granice i daremność (plan analizy). Panel z wynikami pokazuj zespołowi tylko w dniach analiz.
- Dla testów marketingowych wybierz O'Briena–Fleminga. Przy tym samym budżecie traci mało mocy, a duże efekty i tak kończy szybko. Pocock pasuje, gdy liczy się przede wszystkim szybka decyzja, a moc ma mniejsze znaczenie.
- Dodaj daremność, gdy ruch jest drogi. W naszej symulacji test bez efektu trwał średnio 25.0 dnia zamiast 41.8, a paywall mógł wrócić do kolejnych pomysłów.
- Do prognoz bierz wynik ostrożnie. Po wczesnej wygranej licz przychód z dolnej części przedziału albo potwierdź efekt w długoterminowej grupie kontrolnej (długoterminowy holdout).
- Gdy decyzja ma zapadać po każdym czytelniku, sięgnij po SPRT albo po „zawsze ważne” wartości p, które Johari i in. (2022) zaproponowali do stałego monitorowania testów A/B. Test można też skrócić inaczej – redukcją wariancji (CUPED) albo, gdy liczy się zysk w trakcie, algorytmem wielorękiego bandyty.
Szerzej o metodach w pracach z tej dziedziny pisze statystyka w pracy z marketingu.
Jak opisać w pracy
W Metodzie podaj liczbę i terminy analiz, metodę wyznaczania granic, α, moc i maksymalną liczebność. W Wynikach – w której analizie test zakończono i dlaczego, a przy wczesnym zatrzymaniu zaznacz, że oszacowanie efektu jest prawdopodobnie zawyżone.
Gdy test zatrzymano wcześnie, dopisz w ograniczeniach, że zwykłe oszacowanie i przedział nie uwzględniają reguły zatrzymania i że zgłaszany wzrost należy potwierdzić na nowych danych.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw, założenia i granice, z których korzystają przepisy 2–4, a przepis 5 korzysta z symulacji z przepisu 4. Przepisy 1–5 kończą się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Każdy blok, który losuje (przepisy 2, 3 i 4), zaczyna od własnego set.seed(): 687 w przepisie 2, 6870 w przepisie 3 i 6871 w przepisie 4. Skopiowany osobno (z przepisami, z których korzysta) da te same liczby co na stronie. Ziarna ustalono raz i nie zmieniano ich. Ręcznie ustalono: zakupy przy A (2.0%), najmniejszy ważny wzrost (15%), 900 czytelników na wersję dziennie, terminy analiz (dni 14, 21, 28, 35 i 42), α = .025 jednostronnie, moc 80% i parametr granicy daremności (−4) (przepis 1); prawdziwe zakupy przy B w teście gazety (2.3%) i średnio 1800 czytelników dziennie (przepis 2); liczbę 10 000 symulacji (przepisy 3 i 4) oraz scenariusze 2.0%, 2.3% i 2.5% (przepis 4). W symulacjach liczba czytelników jest stała (900 na wersję dziennie), a w teście gazety losowa – to uproszczenie nie zmienia wniosków. Cały kod liczy się w kilka sekund.
1. Plan, granice i schemat decyzji: Rysunek 1
R
# Rysunek 1. Plan sekwencyjnego testu paywalla: granice O'Briena–Fleminga i Pococka oraz schemat decyzji
library(gsDesign)
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", pomaranczowy = "#D55E00", blekit = "#56B4E9", zielony = "#009E73",
         szary = "#999999", granat = "#0f1d3a")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
minus <- function(x) gsub("-", "−", x)

# Założenia planu, ustalone ręcznie przed startem testu
p_A <- 0.020                     # obecny paywall: 2.0% czytelników kupuje prenumeratę w tej samej wizycie
mde <- 0.15                      # najmniejszy wzrost wart wdrożenia: +15% względnie, czyli 2.30%
p_B <- p_A * (1 + mde)
na_dzien <- 900                  # czytelników na wersję dziennie (1800 trafia na paywall)
dni <- c(14, 21, 28, 35, 42)     # 4 analizy pośrednie (po 2, 3, 4 i 5 tygodniach) i końcowa po 6 tygodniach
t_inf <- dni / max(dni)          # odsetek informacji w każdej analizie
n_I <- na_dzien * dni            # czytelników na wersję w każdej analizie

# Plan stały: jedna analiza na końcu, test jednostronny (alfa = .025), moc 80%
n_staly <- nBinomial(p1 = p_B, p2 = p_A, alpha = 0.025, beta = 0.2) / 2   # nBinomial podaje sumę obu wersji
round(c(na_wersje = n_staly, dni = n_staly / na_dzien), 1)

# Granice skuteczności dla 5 analiz (klasyczne O'Brien–Fleming i Pocock)
obf <- gsDesign(k = 5, test.type = 1, alpha = 0.025, beta = 0.2, timing = t_inf, sfu = "OF")
poc <- gsDesign(k = 5, test.type = 1, alpha = 0.025, beta = 0.2, timing = t_inf, sfu = "Pocock")
# Wariant z niewiążącą granicą daremności: Lan–DeMets typu O'Briena–Fleminga + Hwang–Shih–DeCani (gamma = −4)
dar <- gsDesign(k = 5, test.type = 4, alpha = 0.025, beta = 0.2, timing = t_inf,
                sfu = sfLDOF, sfl = sfHSD, sflpar = -4)
granice <- data.frame(dzien = dni, n_na_wersje = n_I,
                      z_OBF = obf$upper$bound, p_OBF = pnorm(-obf$upper$bound),
                      z_Pocock = poc$upper$bound, p_Pocock = pnorm(-poc$upper$bound),
                      z_LD_OBF = dar$upper$bound, z_daremnosc = c(dar$lower$bound[1:4], NA))
print(transform(granice, z_OBF = round(z_OBF, 3), p_OBF = signif(p_OBF, 3), z_Pocock = round(z_Pocock, 3),
                p_Pocock = signif(p_Pocock, 3), z_LD_OBF = round(z_LD_OBF, 3), z_daremnosc = round(z_daremnosc, 3)),
      row.names = FALSE)

# Moc i oczekiwana liczba czytelników przy 6 tygodniach (wzory gsDesign, bez losowania)
theta <- function(pb) (pb - p_A) / sqrt(p_A * (1 - p_A) + pb * (1 - pb))   # dryf statystyki Z na pierwiastek z n
ocena <- do.call(rbind, lapply(c(brak_efektu = 0.020, wzrost_15proc = 0.023, wzrost_25proc = 0.025), function(pb)
  sapply(list(OBF = obf$upper$bound, Pocock = poc$upper$bound), function(b) {
    g <- gsProbability(k = 5, theta = theta(pb), n.I = n_I, a = rep(-20, 5), b = b)
    c(p_wdrozenia = sum(g$upper$prob), sredni_czas_dni = g$en / na_dzien)
  })))
round(ocena, 3)   # wiersze parami: P(wdrożenie B) i średni czas testu w dniach

# Schemat „analiza → granica → decyzja” z granicami z planu
f2 <- function(x) formatC(x, format = "f", digits = 2)
tabela <- data.frame(y = seq(1.62, 0.72, length.out = 5),
                     tydzien = c("2", "3", "4", "5", "6 (koniec)"),
                     n = format(n_I, big.mark = " "),
                     obf = paste0("Z ≥ ", f2(granice$z_OBF)),
                     pobf = sub("^0", "", formatC(granice$p_OBF, format = "f", digits = 4)),
                     poc = paste0("Z ≥ ", f2(granice$z_Pocock)),
                     dar = c(minus(paste0("Z < ", f2(granice$z_daremnosc[1:4]))), "—"))
kolumny <- data.frame(x = c(0.25, 1.65, 3.25, 4.85, 6.45, 8.25),
                      etykieta = c("tydzień", "czytelnicy\nna wersję", "granica OBF", "nominalne p\n(jednostronne)",
                                   "granica Pococka", "daremność\n(wariant)"))
pud <- data.frame(x0 = c(0.1, 3.55, 7.0, 7.0, 7.0), x1 = c(3.15, 6.6, 10.4, 10.4, 10.4),
                  y0 = c(4.55, 4.55, 5.45, 4.35, 3.25), y1 = c(5.75, 5.75, 6.25, 5.15, 4.05),
                  wypelnienie = c("#eef3f8", "#eef3f8", "#fbe3d6", "#e6e6e6", "#dcecf7"),
                  ramka = c("grey60", "grey60", kol[["pomaranczowy"]], "grey45", kol[["niebieski"]]),
                  tekst = c("1. Analiza po tygodniu 2, 3, 4, 5 lub 6:\nZ z wszystkich dotąd\nzebranych czytelników",
                            "2. Porównaj Z z granicą\nna ten tydzień\n(tabela poniżej)",
                            "Z ≥ granica skuteczności\n→ STOP: wdrażamy B",
                            "Z < granica daremności\n→ STOP: zostaje A",
                            "pomiędzy granicami\n→ zbieramy do kolejnej analizy"))
p1 <- ggplot() +
  geom_rect(data = pud, aes(xmin = x0, xmax = x1, ymin = y0, ymax = y1), fill = pud$wypelnienie,
            colour = pud$ramka, linewidth = 0.8) +
  geom_text(data = pud, aes(x = (x0 + x1) / 2, y = (y0 + y1) / 2, label = tekst), size = 4.1,
            lineheight = 1.05, colour = "#0f1d3a") +
  annotate("segment", x = 3.15, xend = 3.55, y = 5.15, yend = 5.15, linewidth = 0.8,
           arrow = arrow(length = unit(0.25, "cm"), type = "closed")) +
  annotate("segment", x = 6.6, xend = 7.0, y = c(5.4, 5.15, 4.9), yend = c(5.85, 4.75, 3.65), linewidth = 0.8,
           arrow = arrow(length = unit(0.25, "cm"), type = "closed")) +
  annotate("path", x = c(8.7, 8.7, 1.6, 1.6), y = c(3.25, 2.85, 2.85, 4.55), linewidth = 0.8, colour = kol[["niebieski"]],
           linetype = "22", arrow = arrow(length = unit(0.25, "cm"), type = "closed")) +
  annotate("text", x = 5.1, y = 3.05, label = "kolejny tydzień danych", colour = kol[["niebieski"]], size = 3.9,
           fontface = "italic") +
  geom_text(data = kolumny, aes(x = x, y = 2.15, label = etykieta), hjust = 0, size = 3.7, fontface = "bold",
            colour = "grey25", lineheight = 0.95) +
  annotate("segment", x = 0.15, xend = 10.4, y = 1.85, yend = 1.85, colour = "grey60") +
  geom_text(data = tabela, aes(x = 0.25, y = y, label = tydzien), hjust = 0, size = 3.9) +
  geom_text(data = tabela, aes(x = 1.65, y = y, label = n), hjust = 0, size = 3.9) +
  geom_text(data = tabela, aes(x = 3.25, y = y, label = obf), hjust = 0, size = 3.9, fontface = "bold",
            colour = kol[["pomaranczowy"]]) +
  geom_text(data = tabela, aes(x = 4.85, y = y, label = pobf), hjust = 0, size = 3.9) +
  geom_text(data = tabela, aes(x = 6.45, y = y, label = poc), hjust = 0, size = 3.9, colour = kol[["niebieski"]]) +
  geom_text(data = tabela, aes(x = 8.25, y = y, label = dar), hjust = 0, size = 3.9, colour = "grey30") +
  annotate("text", x = 0.25, y = 0.25, hjust = 0, size = 3.5, colour = "grey30", lineheight = 1.05,
           label = paste0("W 6. tygodniu decyzja zapada zawsze: Z ≥ granica → wdrażamy B, inaczej zostaje A.\n",
                          "Wariant z daremnością ma granice skuteczności typu OBF (Lan–DeMets): ",
                          paste(f2(granice$z_LD_OBF), collapse = "; "), ".")) +
  coord_cartesian(xlim = c(0, 10.5), ylim = c(0, 6.35), expand = FALSE) +
  labs(title = "Sekwencyjny test paywalla: analiza → granica → decyzja",
       subtitle = "5 analiz co tydzień od 2. tygodnia, 900 czytelników na wersję dziennie, α = .025 jednostronnie") +
  theme_void(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a"), plot.subtitle = element_text(colour = "grey30"),
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
p1   # zapis: ggsave("sekwencyjny-test-ab-schemat-decyzji.svg", p1, width = 10, height = 6.4)
Wynik w R
na_wersje       dni
  36692.8      40.8
 dzien n_na_wersje z_OBF    p_OBF z_Pocock p_Pocock z_LD_OBF z_daremnosc
    14       12600 3.556 0.000189    2.371  0.00888    3.710      -0.649
    21       18900 2.903 0.001850    2.371  0.00888    2.970      -0.036
    28       25200 2.514 0.005970    2.371  0.00888    2.539       0.618
    35       31500 2.249 0.012300    2.371  0.00888    2.252       1.284
    42       37800 2.053 0.020000    2.371  0.00888    2.045          NA
                   OBF Pocock
p_wdrozenia      0.025  0.025
sredni_czas_dni 41.837 41.554
p_wdrozenia      0.799  0.739
sredni_czas_dni 32.929 29.340
p_wdrozenia      0.996  0.991
sredni_czas_dni 22.988 18.445
2. Test gazety: dane, analizy i Rysunek 2
R
# Rysunek 2. Test paywalla gazety: ścieżka statystyki Z na tle granic O'Briena–Fleminga i Pococka
# (korzysta z kol, motyw, minus, p_A, dni, n_I i granice z przepisu 1)
library(ggplot2)

# Prawda ukryta w danych (ustalona ręcznie): nowy paywall B podnosi zakupy z 2.0% do 2.3%
prawda <- c(p_A = 0.020, p_B = 0.023)

set.seed(687)                                          # ziarno ustalone raz, bez dobierania pod wynik
czytelnicy <- rpois(42, 1800)                          # nowi czytelnicy na paywallu każdego dnia
dzienne <- data.frame(dzien = 1:42, n_B = rbinom(42, czytelnicy, 0.5))   # losowy przydział do wersji
dzienne$n_A <- czytelnicy - dzienne$n_B
dzienne$kupili_A <- rbinom(42, dzienne$n_A, prawda[["p_A"]])
dzienne$kupili_B <- rbinom(42, dzienne$n_B, prawda[["p_B"]])

# Statystyka Z (test dwóch proporcji z łączną wariancją) na danych zebranych do danego dnia
z_test <- function(xA, nA, xB, nB) {
  p <- (xA + xB) / (nA + nB)
  (xB / nB - xA / nA) / sqrt(p * (1 - p) * (1 / nA + 1 / nB))
}
skum <- with(dzienne, data.frame(dzien, nA = cumsum(n_A), xA = cumsum(kupili_A),
                                 nB = cumsum(n_B), xB = cumsum(kupili_B)))
skum$z <- with(skum, z_test(xA, nA, xB, nB))

# Pięć zaplanowanych analiz i decyzja według granic O'Briena–Fleminga
an <- merge(skum[skum$dzien %in% dni, ], granice[c("dzien", "z_OBF", "z_Pocock")])
an$proc_A <- 100 * an$xA / an$nA
an$proc_B <- 100 * an$xB / an$nB
an$wzrost_proc <- 100 * (an$proc_B / an$proc_A - 1)
an$decyzja <- ifelse(an$z >= an$z_OBF, "STOP: wdrażamy B", "zbieramy dalej")
print(transform(an, z = round(z, 3), proc_A = round(proc_A, 3), proc_B = round(proc_B, 3),
                wzrost_proc = round(wzrost_proc, 1), z_OBF = round(z_OBF, 3), z_Pocock = round(z_Pocock, 3)),
      row.names = FALSE)
stop_dzien <- min(c(an$dzien[an$decyzja == "STOP: wdrażamy B"], 42))
stop_dzien
min(skum$dzien[skum$z > 1.96])                         # pierwszy dzień, w którym codzienne zaglądanie bez korekty dałoby „wygraną”

# Wynik w dniu zatrzymania: zwykły (naiwny) 95% przedział dla różnicy odsetków
k <- an[an$dzien == stop_dzien, ]
roznica <- k$xB / k$nB - k$xA / k$nA
se <- sqrt(k$xA / k$nA * (1 - k$xA / k$nA) / k$nA + k$xB / k$nB * (1 - k$xB / k$nB) / k$nB)
round(100 * c(roznica_pp = roznica, dolna = roznica - 1.96 * se, gorna = roznica + 1.96 * se), 3)
dzienne_do_stopu <- dzienne[dzienne$dzien <= stop_dzien, ]
write.csv(dzienne_do_stopu, "sekwencyjny-test-ab-paywall-dzienne.csv", row.names = FALSE)

# Wykres: granice w dniach analiz i codzienna ścieżka Z (dni po zatrzymaniu – szare, tylko do pokazania)
gr <- rbind(data.frame(dzien = dni, z = granice$z_OBF, plan = "O'Brien–Fleming"),
            data.frame(dzien = dni, z = granice$z_Pocock, plan = "Pocock"),
            data.frame(dzien = dni, z = 1.96, plan = "bez korekty (1.96)"))
gr$plan <- factor(gr$plan, levels = c("O'Brien–Fleming", "Pocock", "bez korekty (1.96)"))
p2 <- ggplot() +
  geom_hline(yintercept = 0, colour = "grey60") +
  geom_line(data = skum[skum$dzien <= stop_dzien, ], aes(dzien, z), colour = "grey20", linewidth = 0.7) +
  geom_line(data = skum[skum$dzien >= stop_dzien, ], aes(dzien, z), colour = "grey70", linewidth = 0.6,
            linetype = "22") +
  geom_line(data = gr, aes(dzien, z, colour = plan, linetype = plan), linewidth = 0.9) +
  geom_point(data = gr, aes(dzien, z, colour = plan, shape = plan), size = 3) +
  geom_point(data = an, aes(dzien, z), size = 2.6, colour = "grey20", fill = "white", shape = 21, stroke = 1) +
  annotate("point", x = stop_dzien, y = an$z[an$dzien == stop_dzien], size = 5.5, shape = 21,
           colour = kol[["pomaranczowy"]], stroke = 1.6) +
  annotate("text", x = stop_dzien, y = -1.0, size = 3.9, colour = "#0f1d3a", lineheight = 1.05,
           label = sprintf("dzień %d: Z = %.2f\n→ zatrzymanie", stop_dzien, an$z[an$dzien == stop_dzien])) +
  scale_colour_manual(values = c(kol[["pomaranczowy"]], kol[["niebieski"]], kol[["szary"]]), name = NULL) +
  scale_linetype_manual(values = c("solid", "solid", "22"), name = NULL) +
  scale_shape_manual(values = c(17, 15, 16), name = NULL) +
  scale_x_continuous(breaks = c(1, dni), labels = c("1", paste0(dni, "\n(tydz. ", dni / 7, ")"))) +
  scale_y_continuous(labels = minus, breaks = seq(-2, 4, 1)) +
  coord_cartesian(ylim = c(-2.2, 4.1)) +
  labs(title = "Codzienna statystyka Z testu paywalla na tle granic zatrzymania",
       subtitle = "Kółka – zaplanowane analizy; linia przerywana – dni po zatrzymaniu (znane tylko w symulacji)",
       x = "Dzień testu", y = "Statystyka Z (B lepsze od A →)") +
  motyw
p2   # zapis: ggsave("sekwencyjny-test-ab-granice-sciezka-z.svg", p2, width = 10, height = 5.6)
Wynik w R
 dzien    nA  xA    nB  xB     z z_OBF z_Pocock proc_A proc_B wzrost_proc
    14 12821 267 12733 296 1.319 3.556    2.371  2.083  2.325        11.6
    21 19155 388 19042 451 2.286 2.903    2.371  2.026  2.368        16.9
    28 25314 500 25550 601 2.922 2.514    2.371  1.975  2.352        19.1
    35 31642 625 31952 749 3.199 2.249    2.371  1.975  2.344        18.7
    42 38003 746 38270 888 3.408 2.053    2.371  1.963  2.320        18.2
          decyzja
   zbieramy dalej
   zbieramy dalej
 STOP: wdrażamy B
 STOP: wdrażamy B
 STOP: wdrażamy B
[1] 28
[1] 18
roznica_pp      dolna      gorna
     0.377      0.124      0.630
3. Fałszywe alarmy w testach A/A: Rysunek 3
R
# Rysunek 3. Fałszywe alarmy w 10 000 testach A/A: zaglądanie bez korekty a granice sekwencyjne
# (korzysta z kol, motyw, p_A, na_dzien, dni i granice z przepisu 1)
library(ggplot2)

set.seed(6870)                                    # ziarno ustalone raz, bez dobierania pod wynik
R <- 10000                                        # liczba symulowanych testów A/A (obie wersje identyczne)
xA <- matrix(rbinom(R * 42, na_dzien, p_A), R, 42)   # zakupy dzień po dniu, 900 czytelników na wersję
xB <- matrix(rbinom(R * 42, na_dzien, p_A), R, 42)
nn <- na_dzien * (1:42)                           # skumulowana liczba czytelników na wersję
sA <- t(apply(xA, 1, cumsum)); sB <- t(apply(xB, 1, cumsum))
pw <- (sA + sB) / (2 * rep(nn, each = R))         # łączny odsetek do danego dnia
Z <- (sB - sA) / rep(nn, each = R) / sqrt(pw * (1 - pw) * 2 / rep(nn, each = R))
Z[is.nan(Z)] <- 0

# Dzień pierwszego „alarmu” (Z przekracza próg) dla każdej zasady; Inf = brak alarmu w 42 dniach
pierwszy <- function(przekroczone) apply(przekroczone, 1, function(w) if (any(w)) which(w)[1] else Inf)
progi <- function(z) matrix(rep(z, each = R), R)  # te same progi dla każdego testu
alarm <- list(
  "codziennie, bez korekty" = pierwszy(Z > 1.96),
  "co tydzień od 2. tyg., bez korekty" = dni[pierwszy(Z[, dni] > 1.96)],
  "co tydzień, granice Pococka" = dni[pierwszy(Z[, dni] > progi(granice$z_Pocock))],
  "co tydzień, granice O'Briena–Fleminga" = dni[pierwszy(Z[, dni] > progi(granice$z_OBF))],
  "jedna analiza po 6 tygodniach" = ifelse(Z[, 42] > 1.96, 42, Inf))
alarm <- lapply(alarm, function(a) ifelse(is.na(a), Inf, a))
wynik <- data.frame(zasada = names(alarm), alarmy_proc = sapply(alarm, function(a) 100 * mean(is.finite(a))))
wynik$blad_MC_pp <- sqrt(wynik$alarmy_proc * (100 - wynik$alarmy_proc) / R)
print(transform(wynik, alarmy_proc = round(alarmy_proc, 2), blad_MC_pp = round(blad_MC_pp, 2)), row.names = FALSE)
round(100 * mean(alarm[["codziennie, bez korekty"]] <= 14), 2)   # % testów A/A z alarmem już w pierwszych 2 tygodniach

# Skumulowany odsetek testów z alarmem dzień po dniu
krzywe <- do.call(rbind, lapply(names(alarm), function(nm)
  data.frame(zasada = nm, dzien = 1:42, proc = sapply(1:42, function(d) 100 * mean(alarm[[nm]] <= d)))))
krzywe$zasada <- factor(krzywe$zasada, levels = names(alarm))
konce <- krzywe[krzywe$dzien == 42, ]
konce$y_etykiety <- c(konce$proc[1:2], 4.1, 3.05, 1.5)    # rozsunięte podpisy trzech prawie równych końców
p3 <- ggplot(krzywe, aes(dzien, proc, colour = zasada, linetype = zasada)) +
  geom_hline(yintercept = 2.5, colour = "grey40", linewidth = 0.5) +
  annotate("text", x = 8, y = 1.6, label = "α = 2.5%", hjust = 0, size = 3.8, colour = "grey30") +
  geom_step(linewidth = 1) +
  geom_point(data = konce, aes(shape = zasada), size = 3) +
  geom_text(data = konce, aes(y = y_etykiety, label = sprintf("%.2f%%", proc)), hjust = -0.2, size = 4,
            show.legend = FALSE) +
  scale_colour_manual(values = c(kol[["pomaranczowy"]], kol[["szary"]], kol[["niebieski"]], kol[["zielony"]], "black"),
                      name = NULL) +
  scale_linetype_manual(values = c("solid", "22", "solid", "solid", "42"), name = NULL) +
  scale_shape_manual(values = c(16, 1, 15, 17, 4), name = NULL) +
  scale_x_continuous(breaks = c(1, dni), limits = c(1, 46)) +
  guides(colour = guide_legend(ncol = 2), linetype = guide_legend(ncol = 2), shape = guide_legend(ncol = 2)) +
  labs(title = "Ile testów A/A „wygrywa”, choć wersje są identyczne?",
       subtitle = "10 000 symulowanych testów, 900 czytelników na wersję dziennie, zakupy 2.0% w obu wersjach",
       x = "Dzień testu", y = "Testy z fałszywym alarmem (%, skumulowane)") +
  motyw
p3   # zapis: ggsave("sekwencyjny-test-ab-falszywe-alarmy.svg", p3, width = 10, height = 6)
Wynik w R
                                zasada alarmy_proc blad_MC_pp
               codziennie, bez korekty       14.50       0.35
    co tydzień od 2. tyg., bez korekty        5.84       0.23
           co tydzień, granice Pococka        2.41       0.15
 co tydzień, granice O'Briena–Fleminga        2.35       0.15
         jedna analiza po 6 tygodniach        2.30       0.15
[1] 10.43
4. Czas testu i moc czterech planów: Rysunek 4
R
# Rysunek 4. Kiedy kończy się test: oczekiwany czas i odsetek wdrożeń przy braku efektu i przy efekcie
# (korzysta z kol, motyw, p_A, na_dzien, dni, n_I i granice z przepisu 1)
library(ggplot2)

set.seed(6871)                                    # ziarno ustalone raz, bez dobierania pod wynik
R <- 10000                                        # symulowanych testów w każdym scenariuszu
scenariusze <- c("brak efektu (2.0% i 2.0%)" = 0.020, "wzrost o 15% (2.0% i 2.3%)" = 0.023,
                 "wzrost o 25% (2.0% i 2.5%)" = 0.025)
przyrost <- diff(c(0, n_I))                       # nowi czytelnicy na wersję między analizami
symuluj <- function(pB) {                         # zakupy skumulowane w 5 analizach (R × 5)
  xA <- t(apply(matrix(rbinom(R * 5, rep(przyrost, each = R), p_A), R), 1, cumsum))
  xB <- t(apply(matrix(rbinom(R * 5, rep(przyrost, each = R), pB), R), 1, cumsum))
  n <- matrix(rep(n_I, each = R), R)
  pw <- (xA + xB) / (2 * n)
  list(Z = (xB - xA) / n / sqrt(pw * (1 - pw) * 2 / n), pA = xA / n, pB = xB / n)
}
# Pierwsza analiza, w której Z ≥ górna granica (wdrożenie B) albo Z < dolna (daremność); inaczej analiza 5
zatrzymaj <- function(Z, gorna, dolna = rep(-Inf, 5)) {
  t(apply(Z, 1, function(z) {
    k <- which(z >= gorna | z < dolna)[1]
    if (is.na(k)) k <- 5
    c(analiza = k, wdrozenie = as.numeric(z[k] >= gorna[k]))
  }))
}
plany <- list("stały: 1 analiza po 6 tyg." = list(g = c(rep(Inf, 4), qnorm(0.975)), d = rep(-Inf, 5)),
              "O'Brien–Fleming" = list(g = granice$z_OBF, d = rep(-Inf, 5)),
              "Pocock" = list(g = granice$z_Pocock, d = rep(-Inf, 5)),
              "OBF + daremność" = list(g = granice$z_LD_OBF, d = c(granice$z_daremnosc[1:4], -Inf)))
sim <- lapply(scenariusze, symuluj)
wyniki <- do.call(rbind, lapply(names(scenariusze), function(s) do.call(rbind, lapply(names(plany), function(pl) {
  st <- zatrzymaj(sim[[s]]$Z, plany[[pl]]$g, plany[[pl]]$d)
  stop_proc <- sapply(1:5, function(k) 100 * mean(st[, "analiza"] == k))
  names(stop_proc) <- paste0("stop_tydz", 2:6)                     # odsetek testów zakończonych w tygodniu 2–6
  data.frame(scenariusz = s, plan = pl, wdrozenie_proc = 100 * mean(st[, "wdrozenie"]),
             sredni_czas_dni = mean(dni[st[, "analiza"]]), as.list(stop_proc))
}))))
print(transform(wyniki, wdrozenie_proc = round(wdrozenie_proc, 2), sredni_czas_dni = round(sredni_czas_dni, 1),
                stop_tydz2 = round(stop_tydz2, 1), stop_tydz3 = round(stop_tydz3, 1), stop_tydz4 = round(stop_tydz4, 1),
                stop_tydz5 = round(stop_tydz5, 1), stop_tydz6 = round(stop_tydz6, 1)), row.names = FALSE)

# Wykres: w którym tygodniu kończą się testy (słupki) i średni czas testu (podpis)
dl <- do.call(rbind, lapply(1:5, function(k) data.frame(wyniki[c("scenariusz", "plan")],
                                                       tydzien = factor(k + 1, levels = 6:2),
                                                       proc = wyniki[[paste0("stop_tydz", k + 1)]])))
dl$plan <- factor(dl$plan, levels = rev(names(plany)))
wyniki$plan <- factor(wyniki$plan, levels = rev(names(plany)))
wyniki$etykieta <- sprintf("śr. %.1f dnia · B wdrożone w %.1f%%", wyniki$sredni_czas_dni, wyniki$wdrozenie_proc)
p4 <- ggplot(dl, aes(x = proc, y = plan, fill = tydzien)) +
  geom_col(width = 0.68, colour = "white", linewidth = 0.3) +
  geom_text(data = wyniki, aes(x = 101, y = plan, label = etykieta), inherit.aes = FALSE, hjust = 0, size = 3.6,
            colour = "#0f1d3a") +
  facet_wrap(~ scenariusz, ncol = 1) +
  scale_fill_manual(values = c("2" = "#08306B", "3" = "#2171B5", "4" = "#6BAED6", "5" = "#BDD7E7", "6" = "#E3E3E3"),
                    breaks = as.character(2:6), labels = c(2:5, "6 (koniec)"),
                    name = "Test zakończony w tygodniu:") +
  scale_x_continuous(breaks = seq(0, 100, 25), labels = function(x) paste0(x, "%")) +
  coord_cartesian(xlim = c(0, 165), clip = "off") +
  labs(title = "Kiedy kończy się test paywalla – 4 plany, 3 scenariusze",
       subtitle = "10 000 symulacji na scenariusz; najwyżej 6 tygodni i 37 800 czytelników na wersję",
       x = "Odsetek testów", y = NULL) +
  motyw + theme(panel.grid.major.y = element_blank(), plot.title.position = "plot")
p4   # zapis: ggsave("sekwencyjny-test-ab-czas-testu.svg", p4, width = 10, height = 7.4)
Wynik w R
                 scenariusz                       plan wdrozenie_proc
  brak efektu (2.0% i 2.0%) stały: 1 analiza po 6 tyg.           2.88
  brak efektu (2.0% i 2.0%)            O'Brien–Fleming           2.81
  brak efektu (2.0% i 2.0%)                     Pocock           2.68
  brak efektu (2.0% i 2.0%)            OBF + daremność           2.74
 wzrost o 15% (2.0% i 2.3%) stały: 1 analiza po 6 tyg.          81.25
 wzrost o 15% (2.0% i 2.3%)            O'Brien–Fleming          79.95
 wzrost o 15% (2.0% i 2.3%)                     Pocock          74.11
 wzrost o 15% (2.0% i 2.3%)            OBF + daremność          79.21
 wzrost o 25% (2.0% i 2.5%) stały: 1 analiza po 6 tyg.          99.52
 wzrost o 25% (2.0% i 2.5%)            O'Brien–Fleming          99.52
 wzrost o 25% (2.0% i 2.5%)                     Pocock          99.01
 wzrost o 25% (2.0% i 2.5%)            OBF + daremność          99.40
 sredni_czas_dni stop_tydz2 stop_tydz3 stop_tydz4 stop_tydz5 stop_tydz6
            42.0        0.0        0.0        0.0        0.0      100.0
            41.8        0.0        0.2        0.5        0.9       98.4
            41.5        0.9        0.5        0.5        0.4       97.7
            25.0       25.4       25.0       24.2       17.5        8.0
            42.0        0.0        0.0        0.0        0.0      100.0
            32.9        2.5       16.4       24.8       21.4       34.9
            29.3       23.3       16.2       14.2       11.4       34.9
            31.8        3.0       16.5       28.6       27.6       24.4
            42.0        0.0        0.0        0.0        0.0      100.0
            22.9       18.8       47.3       24.2        7.4        2.3
            18.4       62.4       21.7        9.4        4.0        2.6
            23.4       14.7       49.0       26.3        8.0        2.1
5. Zawyżenie wzrostu po wczesnym zatrzymaniu: Rysunek 5
R
# Rysunek 5. Oszacowanie wzrostu po wczesnym zatrzymaniu jest zawyżone
# (korzysta z kol, motyw, minus i granice z przepisu 1 oraz sim, zatrzymaj i plany z przepisu 4; bez nowego losowania)
library(ggplot2)

s15 <- sim[["wzrost o 15% (2.0% i 2.3%)"]]        # prawdziwy wzrost: +15%
oszacowanie <- function(plan) {
  st <- zatrzymaj(s15$Z, plany[[plan]]$g, plany[[plan]]$d)
  k <- st[, "analiza"]
  idx <- cbind(seq_along(k), k)
  data.frame(plan = plan, analiza = k, wdrozenie = st[, "wdrozenie"],
             wzrost_proc = 100 * (s15$pB[idx] / s15$pA[idx] - 1))   # względny wzrost odczytany w dniu zatrzymania
}
oo <- rbind(oszacowanie("O'Brien–Fleming"), oszacowanie("Pocock"))
oo$grupa <- ifelse(oo$wdrozenie == 1, paste0("wygrana w tyg. ", oo$analiza + 1), "brak wygranej (tyg. 6)")
podsum <- aggregate(wzrost_proc ~ plan + grupa, data = oo, FUN = function(x) c(n = length(x), srednia = mean(x)))
podsum <- do.call(data.frame, podsum)
names(podsum) <- c("plan", "grupa", "n", "srednia_proc")
print(transform(podsum, srednia_proc = round(srednia_proc, 1)), row.names = FALSE)
# Średnie oszacowanie: wszystkie testy, tylko wygrane i tylko wygrane do 3. tygodnia
round(sapply(split(oo, oo$plan), function(d) c(wszystkie = mean(d$wzrost_proc),
                                              wygrane = mean(d$wzrost_proc[d$wdrozenie == 1]),
                                              wygrane_do_tyg3 = mean(d$wzrost_proc[d$wdrozenie == 1 & d$analiza <= 2]))), 1)

# Wykres dla planu O'Briena–Fleminga: rozkład oszacowań według momentu zatrzymania
d5 <- oo[oo$plan == "O'Brien–Fleming", ]
poziomy <- c(paste0("wygrana w tyg. ", 2:6), "brak wygranej (tyg. 6)")
d5$grupa <- factor(d5$grupa, levels = poziomy)
sr <- podsum[podsum$plan == "O'Brien–Fleming", ]
sr$grupa <- factor(sr$grupa, levels = poziomy)
p5 <- ggplot(d5, aes(x = grupa, y = wzrost_proc)) +
  geom_hline(yintercept = 15, colour = "black", linewidth = 0.7) +
  geom_hline(yintercept = 0, colour = "grey60") +
  geom_violin(aes(fill = wdrozenie == 1), colour = NA, alpha = 0.55, scale = "width", width = 0.8) +
  annotate("text", x = 6.45, y = 17.5, label = "prawda: +15%", hjust = 1, size = 3.9) +
  geom_point(data = sr, aes(y = srednia_proc), shape = 23, size = 3.6, fill = kol[["pomaranczowy"]], colour = "black") +
  geom_text(data = sr, aes(y = srednia_proc, label = sprintf("%+.1f%%", srednia_proc)), nudge_x = 0.36, size = 3.9,
            colour = "#0f1d3a") +
  geom_text(data = sr, aes(y = -14, label = paste0("n = ", format(n, big.mark = " ", trim = TRUE))), size = 3.6, colour = "grey30") +
  scale_fill_manual(values = c(`TRUE` = kol[["blekit"]], `FALSE` = kol[["szary"]]), guide = "none") +
  scale_y_continuous(labels = function(x) minus(paste0(ifelse(x > 0, "+", ""), x, "%")), breaks = seq(-10, 60, 10)) +
  coord_cartesian(ylim = c(-15, 62)) +
  labs(title = "Im wcześniej test „wygrał”, tym bardziej zawyżony wzrost",
       subtitle = "10 000 testów z prawdziwym wzrostem +15%, plan O'Briena–Fleminga; romby – średnie oszacowanie",
       x = "Kiedy i jak skończył się test", y = "Odczytany wzrost zakupów B wobec A") +
  motyw + theme(plot.title.position = "plot")
p5   # zapis: ggsave("sekwencyjny-test-ab-zawyzenie-efektu.svg", p5, width = 10, height = 5.8)
Wynik w R
            plan                  grupa    n srednia_proc
 O'Brien–Fleming brak wygranej (tyg. 6) 2005          7.4
          Pocock brak wygranej (tyg. 6) 2589          8.4
 O'Brien–Fleming       wygrana w tyg. 2  252         40.2
          Pocock       wygrana w tyg. 2 2333         28.7
 O'Brien–Fleming       wygrana w tyg. 3 1640         26.5
          Pocock       wygrana w tyg. 3 1616         21.4
 O'Brien–Fleming       wygrana w tyg. 4 2480         19.6
          Pocock       wygrana w tyg. 4 1423         18.0
 O'Brien–Fleming       wygrana w tyg. 5 2141         15.6
          Pocock       wygrana w tyg. 5 1142         15.8
 O'Brien–Fleming       wygrana w tyg. 6 1482         12.9
          Pocock       wygrana w tyg. 6  897         14.2
                O'Brien–Fleming Pocock
wszystkie                  16.9   18.0
wygrane                    19.3   21.3
wygrane_do_tyg3            28.3   25.7
6. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("pomarańczowy – niebieski" = c("#D55E00", "#0072B2"), "pomarańczowy – zielony" = c("#D55E00", "#009E73"),
             "niebieski – zielony" = c("#0072B2", "#009E73"), "szary – pomarańczowy" = c("#999999", "#D55E00"),
             "granat – jasnoniebieski (tydz. 2 i 5)" = c("#08306B", "#BDD7E7"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                      widzenie_typowe deuteranopia protanopia
pomarańczowy – niebieski                        114.6        108.3       91.9
pomarańczowy – zielony                          102.4         53.5       37.3
niebieski – zielony                              70.1         55.4       58.0
szary – pomarańczowy                             77.2         62.9       56.0
granat – jasnoniebieski (tydz. 2 i 5)            71.4         70.3       68.0
czerwony – zielony (do unikania)                121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Granice zatrzymania, liczebność planu stałego i moc wyznaczono w pakiecie gsDesign; losowanie danych i symulacje – pakiet stats z podstawowej instalacji R. Rysunki wykonano w pakiecie ggplot2 i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- gsDesign (wersja 3.11.0): Anderson, K. (2026). gsDesign: Group sequential design [R package]. https://doi.org/10.32614/CRAN.package.gsDesign
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Zaglądanie poza planem. Każde dodatkowe spojrzenie z decyzją zwiększa błąd I rodzaju (rysunek 3).
- Zmiana granic w trakcie. Granice wybiera się przed startem; po obejrzeniu danych nie zamieniaj O'Briena–Fleminga na Pococka.
- Analiza w środku tygodnia. Ruch i zakupy różnią się w dniach tygodnia, więc analizuj po pełnych tygodniach.
- Efekt nowości. Wczesna wygrana mierzy reakcję na nowość z pierwszych tygodni; trwałość sprawdza dłuższa obserwacja.
- Raport bez reguły zatrzymania. Podaj, w której analizie test zakończono i jaką miał granicę; sama wartość p z dnia zatrzymania nic nie mówi o planie.
Najczęstsze pytania
Czy można zaglądać do wyników testu A/B przed końcem?
Można, jeśli spojrzenia i granice zatrzymania ustalisz przed startem. Bez korekty każde spojrzenie to kolejny test: w symulacji 10 000 testów A/A codzienne zaglądanie z progiem 1.96 dało 14.50% fałszywych alarmów, a pięć tygodniowych spojrzeń – 5.84%, przy dopuszczalnych 2.5%. Granice O’Briena–Fleminga utrzymały 2.35%.
Czym różnią się granice O’Briena–Fleminga i Pococka?
Granica O’Briena–Fleminga jest bardzo surowa na początku i łagodnieje do końca (w przykładzie Z ≥ 3.56 po 2 tygodniach, 2.05 po 6). Granica Pococka jest stała (2.37). Pocock częściej kończy test wcześnie, ale przy tym samym maksymalnym czasie ma mniejszą moc: 74.1% wobec 80.0% w przykładzie.
Ile czasu oszczędza sekwencyjny test A/B?
To zależy od prawdziwego efektu. W przykładzie przy wzroście o 15% plan O’Briena–Fleminga trwał średnio 32.9 dnia zamiast 42, a przy wzroście o 25% – 22.9 dnia. Bez efektu oszczędności daje dopiero granica daremności: średnio 25.0 dnia.
Dlaczego wynik testu zatrzymanego wcześnie jest zawyżony?
Bo wcześnie przekraczają granicę głównie te testy, którym przypadek dodał dużo. W symulacji przy prawdziwym wzroście 15% testy wygrane w 2. tygodniu pokazywały średnio +40.2%, a wszystkie wygrane +19.3%. Granice chronią decyzję, nie wielkość efektu – do prognoz bierz wynik ostrożnie albo potwierdź go na nowych danych.
Jak wyznaczyć granice zatrzymania w R?
Użyj pakietu gsDesign: gsDesign(k = 5, test.type = 1, alpha = 0.025, beta = 0.2, timing = c(14, 21, 28, 35, 42) / 42, sfu = "OF") daje granice O’Briena–Fleminga, a sfu = "Pocock" – Pococka. Funkcja gsProbability() liczy moc i oczekiwaną liczebność przy danym efekcie.
Powiązane hasła
Przeczytaj też
Analizy pośrednie w praktyce
Plan grupowo-sekwencyjny w R: granice Pococka i OBF, wzrost N, symulacja błędu I rodzaju, daremność i zawyżony efekt po wczesnym zatrzymaniu.
Czytaj →PoradnikPułapki testów A/B na obrazkach
Zaglądanie do p, wiele wersji i metryk, efekt nowości i SRM w symulacjach 1000 testów A/A – pięć rysunków z kodem R i lista kontrolna.
Czytaj →PoradnikTest A/B z wieloma wariantami
Pięć tematów maila i kontrola: Dunnett, Holm i Tukey, klątwa zwycięzcy w 1000 symulacji, test potwierdzający i moc – pięć rysunków z kodem R.
Czytaj →PoradnikDługoterminowy holdout personalizacji
Serwis z muzyką: efekt personalizacji tydzień po tygodniu, zanik nowości, retencja abonentów, pułapki i koszt holdoutu – kod R.
Czytaj →Analizujesz test A/B do pracy?
Pomożemy zaplanować analizy pośrednie, wyznaczyć granice zatrzymania, policzyć moc i czas testu w symulacji i opisać wynik – tak, żebyś umiał(a) go obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Armitage, P., McPherson, C. K., & Rowe, B. C. (1969). Repeated significance tests on accumulating data. Journal of the Royal Statistical Society. Series A (General), 132(2), 235–244. https://doi.org/10.2307/2343787
- Bassler, D., Briel, M., Montori, V. M., Lane, M., Glasziou, P., Zhou, Q., Heels-Ansdell, D., Walter, S. D., Guyatt, G. H., & STOPIT-2 Study Group. (2010). Stopping randomized trials early for benefit and estimation of treatment effects: Systematic review and meta-regression analysis. JAMA, 303(12), 1180–1187. https://doi.org/10.1001/jama.2010.310
- Johari, R., Koomen, P., Pekelis, L., & Walsh, D. (2022). Always valid inference: Continuous monitoring of A/B tests. Operations Research, 70(3), 1806–1821. https://doi.org/10.1287/opre.2021.2135
- Lan, K. K. G., & DeMets, D. L. (1983). Discrete sequential boundaries for clinical trials. Biometrika, 70(3), 659–663. https://doi.org/10.1093/biomet/70.3.659
- O'Brien, P. C., & Fleming, T. R. (1979). A multiple testing procedure for clinical trials. Biometrics, 35(3), 549–556. https://doi.org/10.2307/2530245
- Pocock, S. J. (1977). Group sequential methods in the design and analysis of clinical trials. Biometrika, 64(2), 191–199. https://doi.org/10.1093/biomet/64.2.191
- Whitehead, J. (1986). On the bias of maximum likelihood estimation following a sequential test. Biometrika, 73(3), 573–581. https://doi.org/10.1093/biomet/73.3.573
Cytowania BibTeX
@article{armitage1969repeated, author={Armitage, P. and McPherson, C. K. and Rowe, B. C.}, title={{Repeated significance tests on accumulating data}}, journal={Journal of the Royal Statistical Society. Series A (General)}, year={1969}, volume={132}, number={2}, pages={235--244}, doi={10.2307/2343787}}@article{bassler2010stopping, author={Bassler, Dirk and Briel, Matthias and Montori, Victor M. and Lane, Melanie and Glasziou, Paul and Zhou, Qi and Heels-Ansdell, Diane and Walter, Stephen D. and Guyatt, Gordon H. and {STOPIT-2 Study Group}}, title={{Stopping randomized trials early for benefit and estimation of treatment effects: Systematic review and meta-regression analysis}}, journal={JAMA}, year={2010}, volume={303}, number={12}, pages={1180--1187}, doi={10.1001/jama.2010.310}}@article{johari2022always, author={Johari, Ramesh and Koomen, Pete and Pekelis, Leonid and Walsh, David}, title={{Always valid inference: Continuous monitoring of A/B tests}}, journal={Operations Research}, year={2022}, volume={70}, number={3}, pages={1806--1821}, doi={10.1287/opre.2021.2135}}@article{lan1983discrete, author={Lan, K. K. Gordon and DeMets, David L.}, title={{Discrete sequential boundaries for clinical trials}}, journal={Biometrika}, year={1983}, volume={70}, number={3}, pages={659--663}, doi={10.1093/biomet/70.3.659}}@article{obrien1979multiple, author={O'Brien, Peter C. and Fleming, Thomas R.}, title={{A multiple testing procedure for clinical trials}}, journal={Biometrics}, year={1979}, volume={35}, number={3}, pages={549--556}, doi={10.2307/2530245}}@article{pocock1977group, author={Pocock, Stuart J.}, title={{Group sequential methods in the design and analysis of clinical trials}}, journal={Biometrika}, year={1977}, volume={64}, number={2}, pages={191--199}, doi={10.1093/biomet/64.2.191}}@article{whitehead1986bias, author={Whitehead, John}, title={{On the bias of maximum likelihood estimation following a sequential test}}, journal={Biometrika}, year={1986}, volume={73}, number={3}, pages={573--581}, doi={10.1093/biomet/73.3.573}}