Przykład: sześć tematów maila powitalnego
Fikcyjna platforma kursów online wysyła każdej nowej osobie mail powitalny z linkiem do pierwszej lekcji. Dział marketingu ma pięć pomysłów na nowy temat i robi test z sześcioma grupami: obecny temat (K, kontrola) i pięć nowych (T1–T5). Przez 28 dni każde nowe konto trafia losowo do jednej grupy. Pytanie biznesowe: czy któryś nowy temat zwiększa odsetek osób, które klikną link w mailu – i o ile?
| Grupa | Temat maila | Wysłane | Kliknięcia |
|---|---|---|---|
| K | Witaj na platformie – zacznij pierwszą lekcję | 18 701 | 11.36% |
| T1 | Twoja pierwsza lekcja już czeka | 18 796 | 10.78% |
| T2 | 3 kursy, od których warto zacząć | 18 726 | 11.59% |
| T3 | 10 minut dziennie do pierwszego certyfikatu | 18 765 | 12.26% |
| T4 | Witaj! Mamy dla Ciebie prezent | 18 777 | 10.61% |
| T5 | Ostatnie 48 godzin z rabatem 30% | 18 604 | 11.76% |
Łącznie wysłano 112 369 maili. Metryką główną, ustaloną przed startem, jest kliknięcie w link. Dodatkowo mierzymy rozpoczęcie lekcji w ciągu 7 dni i wypisanie się z listy (metryka ochronna: temat nie może zrażać ludzi). Jak zaplanować i przeanalizować zwykły test A/B z dwiema wersjami, opisuje wpis test A/B – plan i analiza. Zaglądanie do wyników i testy A/A omawiamy w pułapkach testów A/B. Tu zajmujemy się tym, co zmienia się, gdy wersji jest wiele.
Dane są fikcyjne i znamy prawdę. Ręcznie ustaliliśmy prawdziwe efekty tematów względem K: T1 0, T2 +0.5, T3 +1.0, T4 −0.3 i T5 +0.6 punktu procentowego (pp) dla kliknięć. T5 dodatkowo zwiększa wypisania o 0.4 pp. Ustaliliśmy też średnio 4000 nowych kont dziennie i odsetek kliknięć w K: 10% w dwóch pierwszych tygodniach i 12% od 15. dnia, gdy rusza kampania reklamowa platformy. Ziarno 658 ustalono raz i nie zmieniano go. Dzienne liczby dla grup pobierzesz jako test-a-b-wiele-wariantow-maile-powitalne.csv.
Rysunek 1: turniej, a potem potwierdzenie
Test z wieloma wersjami ma dwa etapy. Turniej odsiewa słabe tematy i wskazuje kandydata. Test potwierdzający (zwycięzca kontra kontrola na nowych osobach) daje rzetelną liczbę do decyzji. Rysunek 1 pokazuje tę drogę na liczbach z przykładu.
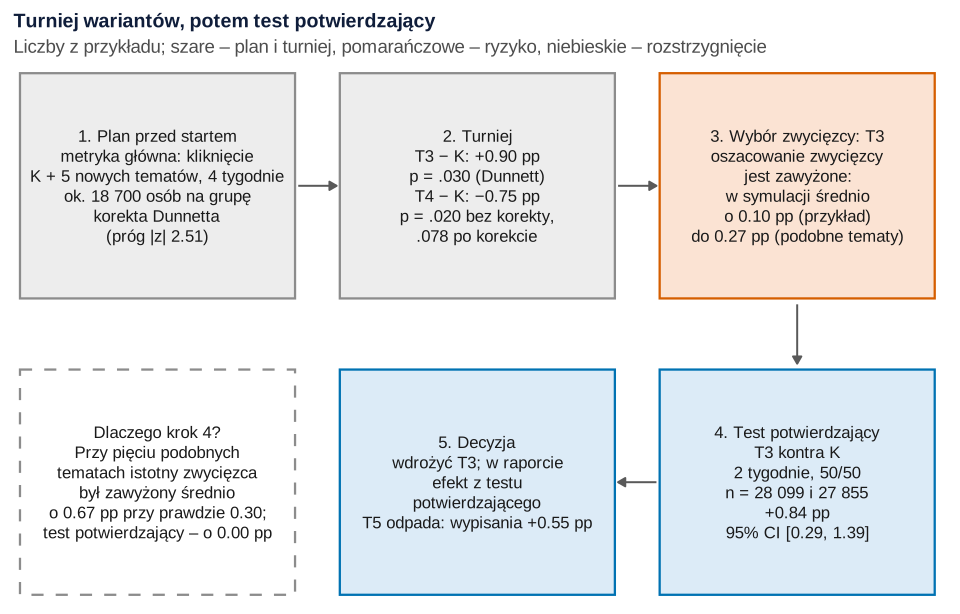
set.seed(658) i set.seed(6581)).Co widać. Plan powstaje przed startem. W turnieju T3 wygrywa z wynikiem +0.90 pp. Test potwierdzający na nowych osobach (28 099 i 27 855) daje +0.84 pp, 95% CI [0.29, 1.39]. T5 odpada mimo wyższych kliknięć niż K, bo wyraźnie zwiększa wypisania.
Jak może zmylić. Test potwierdzający też może wyjść nieistotny – to cenna informacja, nie porażka. Kosztuje jednak ruch i czas.
Podpis do pracy:
Rysunek 2: z kontrolą czy każdy z każdym
„Który temat jest lepszy od obecnego?” to pięć porównań z kontrolą. „Który temat jest najlepszy?” to wszystkie pary – 15 porównań. Im więcej porównań, tym większa szansa na fałszywy alarm (problem wielokrotnych porównań), więc korekta podnosi próg.
- Test Dunnetta – tylko porównania z jedną kontrolą (Dunnett, 1955). Uwzględnia, że wszystkie porównania dzielą tę samą grupę K, więc próg jest niższy niż przy innych korektach.
- Poprawka Holma – działa na dowolnym zbiorze wartości p i kontroluje łączny błąd I rodzaju przy każdym układzie prawdziwych hipotez (Holm, 1979). Zawsze odrzuca co najmniej tyle hipotez co korekta Bonferroniego, a pasującym do niej przedziałem jest przedział Bonferroniego.
- Test Tukeya – wszystkie pary. Najwięcej porównań, najwyższy próg.
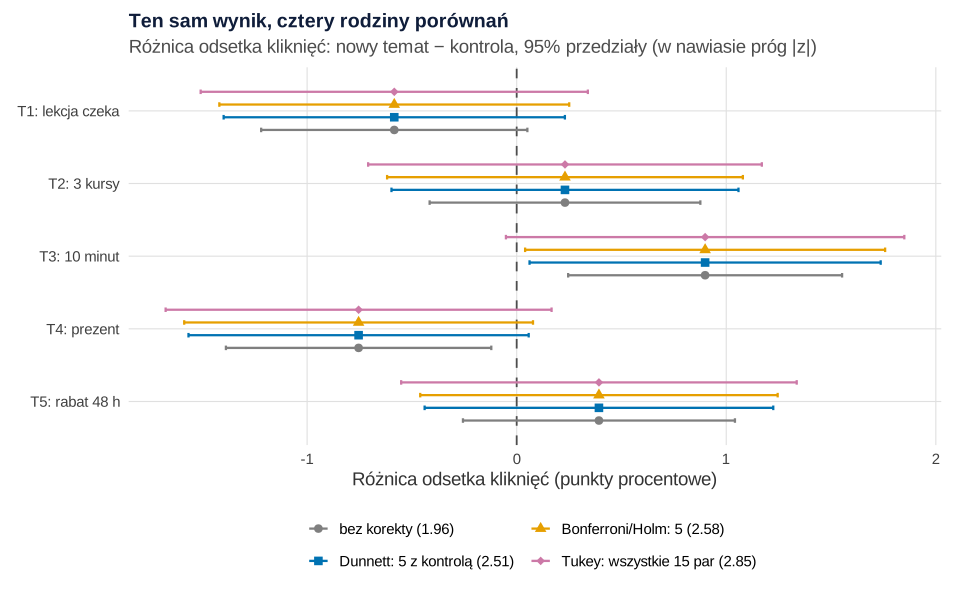
set.seed(658)).Co widać. Środki przedziałów się nie zmieniają – korekta nie zmienia różnic, tylko mnożnik błędu standardowego: 1.96 bez korekty, 2.51 w teście Dunnetta, 2.58 w poprawce Bonferroniego dla pięciu porównań i 2.85 przy wszystkich 15 parach. T3 ma +0.90 pp (z = 2.70). Jest istotny bez korekty (p = .007), po korekcie Dunnetta (p = .030) i Holma (p = .035), ale nie po korekcie Tukeya (p = .076). T4 wypada gorzej od K o 0.75 pp i bez korekty jest „istotny” (p = .020), a po korekcie Dunnetta już nie (p = .078).
Jak może zmylić. Wybór korekty po obejrzeniu wyników to naciąganie. Firma pyta, czy zmienić obecny temat, więc właściwy jest Dunnett; Tukey nie jest „ostrożniejszy”, tylko odpowiada na inne pytanie. Gdy porównania między nowymi tematami też mają znaczenie, Tukey wskazuje m.in., że T3 jest lepszy od T1 o 1.48 pp, 95% CI [0.54, 2.42], i od T4 o 1.65 pp. Szerzej o wyborze korekty: czy muszę stosować poprawkę?, a skorygowane p dla własnych wyników policzysz w kalkulatorze poprawek.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: klątwa zwycięzcy
Ile naprawdę daje T3? Odruchowo podajemy +0.90 pp z turnieju, ale T3 wybraliśmy właśnie dlatego, że miał najwyższy wynik. Wśród pięciu oszacowań wygrywa zwykle to, któremu los coś dodał. To klątwa zwycięzcy: oszacowanie wybranej opcji jest zawyżone, bo częściej wybieramy ją wtedy, gdy jej skuteczność przeszacowaliśmy (Andrews i in., 2024). Lee i Shen (2018) opisują to samo zjawisko na platformach, które prowadzą setki testów A/B i wdrażają zmiany z istotnym, korzystnym wynikiem: suma „zysków” z wdrożonych zmian jest wtedy zawyżona.
Powtórzyliśmy turniej 1000 razy w dwóch światach: A – jak w przykładzie, B – pięć podobnych tematów po +0.3 pp. Za każdym razem zwycięzca dostaje test potwierdzający (14 dni, 50/50).
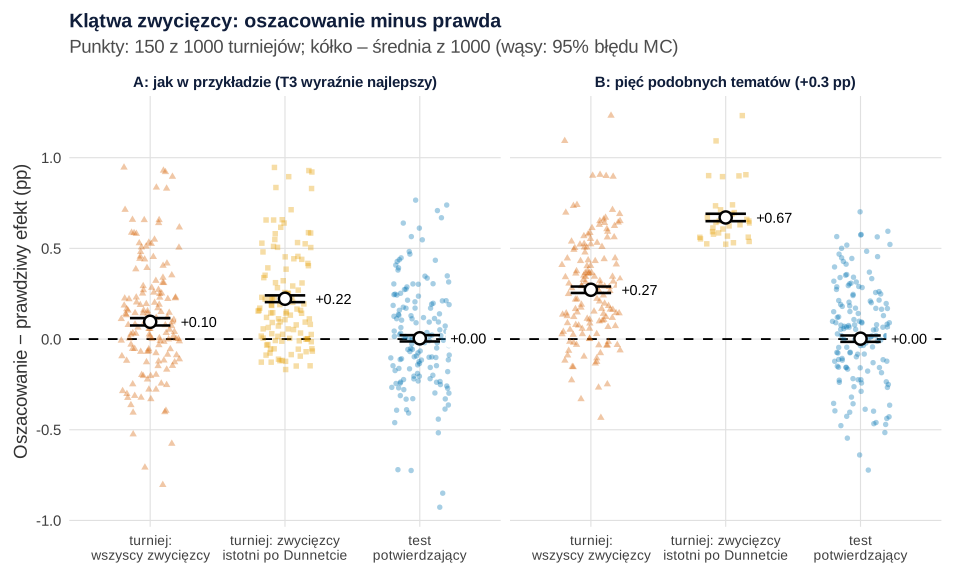
set.seed(658)).Co widać. W świecie A T3 wygrywał w 85.1% turniejów, a T5 w 10.0%. Zwycięzca był zawyżony średnio o 0.10 pp (błąd Monte Carlo 0.010). Wśród zwycięzców istotnych po korekcie Dunnetta (73.1% turniejów) – o 0.22 pp. W świecie B klątwa jest silniejsza: zwycięzca zawyżony o 0.27 pp, a zwycięzca istotny (20.2% turniejów) miał średnio 0.97 pp przy prawdzie 0.30 – zawyżenie o 0.67 pp. Test potwierdzający w obu światach trafiał średnio w prawdę (zawyżenie 0.00, błąd MC 0.009). W naszych danych T3 dał 0.90 pp przy prawdzie 1.0: zawyżona jest średnia zwycięzców, nie każdy wynik.
Jak może zmylić. Klątwa jest tym większa, im bardziej podobne są warianty, im ich więcej i im mniejsza moc testu. Gelman i Carlin (2014) nazywają zawyżenie wyników istotnych błędem typu M. Ioannidis (2008) pokazuje, że efekt ogłoszony po przekroczeniu progu istotności w badaniu o niskiej mocy powinien być zawyżony. Mechanizm progu istotności przy jednym efekcie pokazuje wpis moc testu w obrazkach. Istnieją metody korekty oszacowania zwycięzcy bez nowego testu (Andrews i in., 2024; Lee i Shen, 2018), ale świeży test najłatwiej wyjaśnić.
Podpis do pracy:
Zdanie do Metody:
Rysunek 4: każdy temat zabiera ruch pozostałym
Każdy dodatkowy temat dzieli te same 4000 osób dziennie na więcej grup, a korekta podnosi próg. Rysunek 4 pokazuje, jak spada moc wykrycia tematu, który naprawdę podnosi kliknięcia z 11% do 12%, przy 112 000 maili w cztery tygodnie.
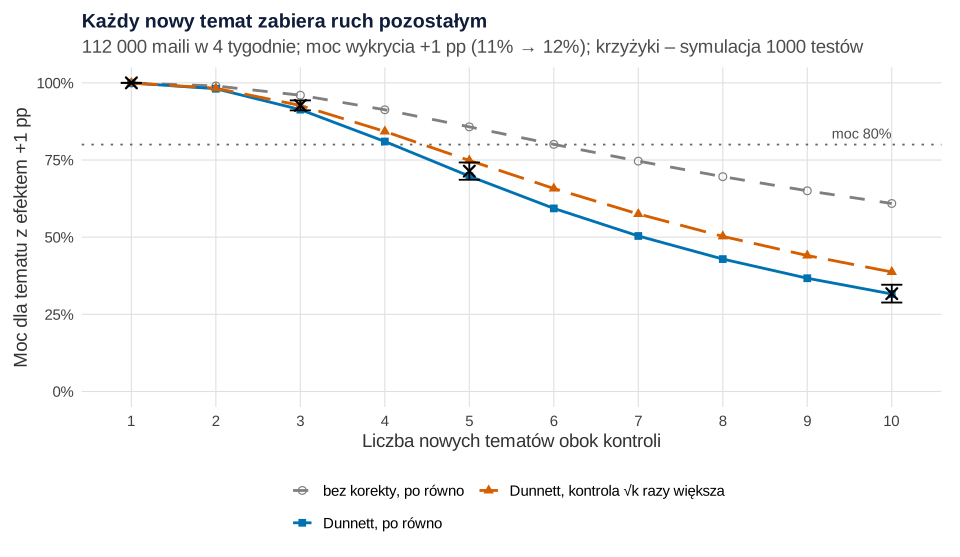
set.seed(6582)).Co widać. Przy jednym nowym temacie moc wynosi 99.9%. Przy pięciu tematach i podziale po równo (18 667 osób na grupę) spada do 69.8% z korektą Dunnetta, a przy dziesięciu – do 31.6%. Symulacja 1000 testów potwierdza wzór (71.4% przy pięciu, błąd MC 1.4 pp). Pomaga kontrola √k razy większa od grupy każdego tematu, bo bierze udział we wszystkich porównaniach. Przy pięciu tematach (34 610 osób w K i 15 478 na temat) moc rośnie do 74.8%. Aby osiągnąć 80% przy pięciu tematach, test trzeba wydłużyć do 4.9 tygodnia przy podziale po równo albo 4.4 tygodnia z większą kontrolą; przy jednym temacie wystarczyłby 1.1 tygodnia.
Jak może zmylić. Krzywa dotyczy efektu +1 pp; przy mniejszych efektach spada szybciej. Liczebność licz z korektą, której naprawdę użyjesz. Jeśli zamiast testu z równym podziałem chcesz w trakcie przesuwać ruch do lepszych wersji, to inny schemat – wielorękie bandyty – z innymi kompromisami.
Podpis do pracy:
Rysunek 5: temat dodany w połowie testu
Po dwóch tygodniach zespół „dorzuca” szósty temat (T6) i od 15. dnia ruch dzieli się na siedem grup. Z którą kontrolą porównać T6: z całą czy z dni 15–28? W symulacji T6 nie ma żadnego efektu.
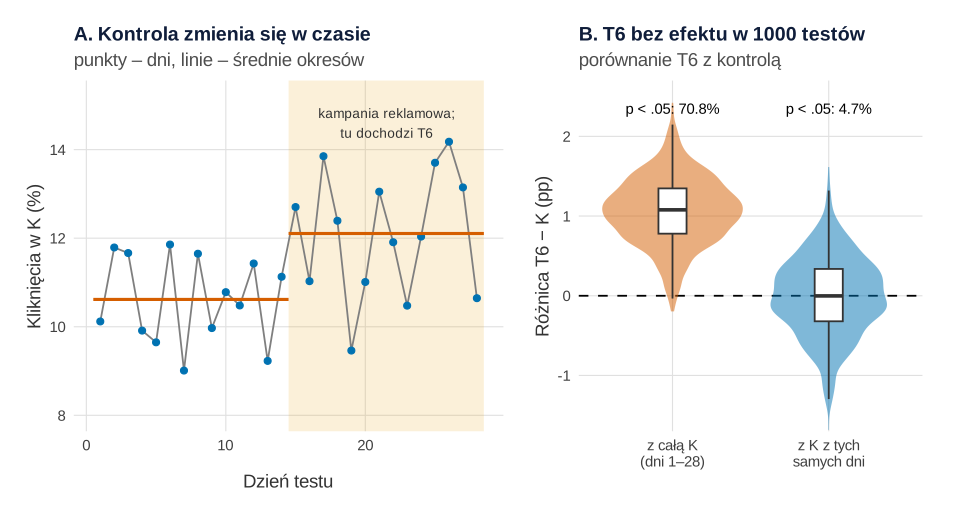
set.seed(658) i set.seed(6583)).Co widać. W naszych danych K miało 10.62% kliknięć w dniach 1–14 i 12.11% w dniach 15–28. T6 widzi tylko lepszy okres. Porównany z całą kontrolą „wygrywa” średnio o 1.07 pp i jest istotny w 70.8% testów (błąd MC 1.4 pp), choć nie robi nic. Porównany z kontrolą z tych samych dni ma średnio −0.01 pp i fałszywy alarm w 4.7% testów, zgodnie z założonym poziomem 5%.
Jak może zmylić. Wystarczy słabsza zmiana w czasie: dzień tygodnia, święta, inne źródło ruchu. Wariant dodany w trakcie porównuj tylko z kontrolą z tego samego okresu i licz jako osobne porównanie w korekcie. Testy wiarygodności, które ostrzegają przed naruszeniem założeń, omawiają Kohavi i in. (2020).
Podpis do pracy:
Wiele metryk: jedna główna, jedna ochronna
Pięć tematów i trzy metryki to 15 testów. Bez korekty p < .05 wyszło w czterech: T3 i T4 dla kliknięć, T3 dla rozpoczęcia lekcji (+0.91 pp, p = .044) i T5 dla wypisań. Wrzucenie wszystkich 15 testów do jednej poprawki Holma zostawia tylko wypisania w T5 (+0.55 pp, p < .001), a główny wynik T3 przestaje być istotny (p = .098). Dlatego ustal z góry hierarchię: metryka główna z korektą na liczbę tematów, dodatkowe jako eksploracyjne, ochronna jako warunek wdrożenia. Wypisania w T5 wzrosły z 0.71% do 1.26% – to wystarczy, żeby temat odrzucić. Więcej: pułapki testów A/B i wielokrotne testy w obrazkach.
Co z tym zrobić w firmie
- Ogranicz liczbę wariantów do tylu, ile udźwignie ruch. Przy 4000 maili dziennie pięć tematów to 4.9 tygodnia na moc 80% dla efektu +1 pp. Słabe pomysły odrzuć przed testem.
- Daj kontroli większy udział. Przy pięciu tematach podział 30.9% ruchu na K i 13.8% na każdy temat podnosi moc z 69.8% do 74.8% bez wydłużania testu.
- Do budżetu i prognoz bierz liczbę z testu potwierdzającego. Turniej wskazuje kandydata, test potwierdzający mówi, ile daje. Jeśli nie ma czasu na drugi etap, opisz efekt zwycięzcy jako górną granicę.
- Zapisz plan przed startem (metryka, rodzina porównań, korekta, czas) – to samo, co w nauce robi prerejestracja badań.
W eksperymentach, w których wersje wpływają na siebie nawzajem (np. wspólni kurierzy), losowanie osób nie wystarczy – zob. eksperymenty z efektem sieciowym.
Jak opisać w pracy
W Metodzie podaj liczbę grup, przydział, metrykę główną, korektę i test potwierdzający, a w Wynikach – odsetki, różnice z przedziałami po korekcie i wynik testu potwierdzającego. Zob. też: statystyka w pracy z zarządzania i ekonomii.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę i motyw, a kolejne korzystają z jego obiektów (przepis 7 – także z wyników przepisów 2–4). Przepisy z rysunkami kończą się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Każdy przepis, który losuje, zaczyna od własnego ziarna: set.seed(658) w przepisach 1, 2 (numeryczny próg Dunnetta), 4 (symulacja turniejów) i 5 (progi), set.seed(6581) dla testu potwierdzającego w przykładzie, set.seed(6582) dla symulacji mocy i set.seed(6583) dla tematu dodanego w trakcie. Ziarna ustalono raz i nie zmieniano ich. Ręcznie ustalono: prawdziwe efekty tematów dla trzech metryk, 4000 kont dziennie, odsetki w K (kliknięcia 10% i 12%, lekcje 25% i 27%, wypisania 0.8%) i start kampanii 15. dnia (przepis 1); długość i podział testu potwierdzającego oraz scenariusz B z efektem +0.3 pp (przepis 4); efekt +1 pp przy 11% i ruch 112 000 maili (przepis 5); dzień dodania T6 (przepis 6); po 1000 powtórzeń w przepisach 4–6. Efekty tematów i wzrost kliknięć w czasie wybraliśmy przed pierwszym uruchomieniem; po nim dodaliśmy scenariusz B, bo w scenariuszu A klątwa zwycięzcy była mała. Cały kod liczy się w kilka sekund.
1. Dane: sześć grup maila powitalnego, 28 dni
R
# Przepis 1. Fikcyjna platforma kursów online: mail powitalny z kontrolnym tematem i pięcioma nowymi
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(bez = "grey50", dunnett = "#0072B2", holm = "#E69F00", tukey = "#CC79A7", akcent = "#D55E00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Grupy testu: K = obecny temat maila, T1–T5 = nowe tematy
grupy <- c("K", "T1", "T2", "T3", "T4", "T5")
tematy <- c(K  = "Witaj na platformie – zacznij pierwszą lekcję",
            T1 = "Twoja pierwsza lekcja już czeka",
            T2 = "3 kursy, od których warto zacząć",
            T3 = "10 minut dziennie do pierwszego certyfikatu",
            T4 = "Witaj! Mamy dla Ciebie prezent",
            T5 = "Ostatnie 48 godzin z rabatem 30%")
# Prawdziwe efekty (punkty procentowe względem K) – ustalone ręcznie:
ef_klik  <- c(K = 0, T1 = 0, T2 = 0.5, T3 = 1.0, T4 = -0.3, T5 = 0.6)   # kliknięcie w link (metryka główna)
ef_lekc  <- c(K = 0, T1 = 0, T2 = 0.3, T3 = 0.6, T4 = 0,    T5 = 0.3)   # rozpoczęcie lekcji w 7 dni
ef_wypis <- c(K = 0, T1 = 0, T2 = 0,   T3 = 0,   T4 = 0,    T5 = 0.4)   # wypisanie z listy (metryka ochronna)

# Generator: 28 dni, średnio 4000 nowych kont dziennie, losowy przydział do grup (domyślnie po równo).
# Od 15. dnia kampania reklamowa przyciąga bardziej zdecydowane osoby: odsetek kliknięć w K rośnie z 10% do 12%,
# rozpoczęć lekcji z 25% do 27%; wypisania 0.8% przez cały czas.
generuj <- function(dni = 28, dziennie = 4000, udzialy = rep(1, length(grupy)), ef = ef_klik) {
  wiersze <- lapply(seq_len(dni), function(d) {
    n <- as.vector(rmultinom(1, rpois(1, dziennie), udzialy))
    p_klik <- ifelse(d >= 15, 12, 10) + ef
    p_lekc <- ifelse(d >= 15, 27, 25) + ef_lekc
    data.frame(dzien = d, grupa = grupy, wyslane = n,
               klikniecia = rbinom(length(n), n, p_klik / 100),
               lekcje = rbinom(length(n), n, p_lekc / 100),
               wypisania = rbinom(length(n), n, (0.8 + ef_wypis) / 100))
  })
  do.call(rbind, wiersze)
}

set.seed(658)                                            # ziarno ustalone raz, bez dobierania pod wynik
maile <- generuj()
write.csv(maile, "test-a-b-wiele-wariantow-maile-powitalne.csv", row.names = FALSE)

razem <- aggregate(cbind(wyslane, klikniecia, lekcje, wypisania) ~ grupa, data = maile, FUN = sum)
razem$klik_proc <- 100 * razem$klikniecia / razem$wyslane
razem$lekc_proc <- 100 * razem$lekcje / razem$wyslane
razem$wypis_proc <- 100 * razem$wypisania / razem$wyslane
cat("Wysłane maile razem:", sum(razem$wyslane), " dni: 28\n")
print(data.frame(grupa = razem$grupa, wyslane = razem$wyslane, klik = round(razem$klik_proc, 2),
                 lekcja = round(razem$lekc_proc, 2), wypis = round(razem$wypis_proc, 2),
                 prawdziwy_efekt_klik = ef_klik[razem$grupa]), row.names = FALSE)
Wynik w R
Wysłane maile razem: 112369  dni: 28
 grupa wyslane  klik lekcja wypis prawdziwy_efekt_klik
     K   18701 11.36  25.80  0.71                  0.0
    T1   18796 10.78  26.29  0.76                  0.0
    T2   18726 11.59  26.11  0.84                  0.5
    T3   18765 12.26  26.71  0.78                  1.0
    T4   18777 10.61  25.52  0.85                 -0.3
    T5   18604 11.76  26.10  1.26                  0.6
2. Porównania z kontrolą, wszystkie pary i Holm: Rysunek 2
R
# Przepis 2. Pięć tematów a kontrola: bez korekty, Dunnett, Holm (Bonferroni) i wszystkie pary (Tukey): Rysunek 2
# (korzysta z razem, grupy, kol i motyw z przepisu 1)
library(ggplot2); suppressPackageStartupMessages(library(multcomp))
pz <- function(x) ifelse(x < .001, "p < .001", sub("0\\.", ".", sprintf("p = %.3f", x)))   # zapis APA

p <- setNames(razem$klik_proc, razem$grupa)              # odsetki kliknięć (%)
V <- diag(p * (100 - p) / razem$wyslane)                 # wariancje odsetków (niezależne grupy)
dimnames(V) <- list(grupy, grupy)
est <- parm(p, V)                                        # oszacowania + macierz kowariancji dla glht()
n_gr <- setNames(rep(1, 6), grupy)
C_d <- contrMat(n_gr, type = "Dunnett")                  # 5 porównań z kontrolą K
C_t <- contrMat(n_gr, type = "Tukey")                    # 15 porównań wszystkich par

set.seed(658)                                            # mvtnorm liczy progi numerycznie – ziarno dla powtarzalności
dun <- glht(est, linfct = C_d)                           # df nieskończone: przybliżenie normalne (duże n)
tuk <- glht(est, linfct = C_t)
ci_d <- confint(dun)$confint; ci_t <- confint(tuk)$confint
prog <- c(bez = qnorm(0.975), dunnett = attr(confint(dun)$confint, "calpha"),
          bonferroni = qnorm(1 - 0.025 / 5), tukey = attr(confint(tuk)$confint, "calpha"))
cat("Progi |z| dla 95%: bez korekty", round(prog[1], 2), " Dunnett (5 porównań)", round(prog[2], 2),
    " Bonferroni (5)", round(prog[3], 2), " Tukey (15 par)", round(prog[4], 2), "\n\n")

roz <- as.vector(C_d %*% p); se <- sqrt(diag(C_d %*% V %*% t(C_d))); z <- roz / se
p_bez <- 2 * pnorm(-abs(z))
p_dun <- summary(dun, test = adjusted("single-step"))$test$pvalues
p_holm <- p.adjust(p_bez, "holm")
p_tuk <- summary(tuk, test = adjusted("single-step"))$test$pvalues[1:5]   # pierwsze 5 par to porównania z K
tab <- data.frame(porownanie = paste(grupy[-1], "− K"), roznica_pp = round(roz, 2), SE = round(se, 2), z = round(z, 2),
                  p_bez = round(p_bez, 3), p_holm = round(p_holm, 3), p_dunnett = round(as.vector(p_dun), 3),
                  p_tukey15 = round(as.vector(p_tuk), 3))
print(tab, row.names = FALSE)

cat("\nPorównania między nowymi tematami (Tukey, 15 par) z p < .05:\n")
st <- summary(tuk, test = adjusted("single-step"))$test
ist <- which(st$pvalues < .05)
for (i in ist) cat(sprintf("  %-8s różnica %5.2f pp, 95%% CI [%5.2f, %5.2f], %s\n", rownames(C_t)[i],
                           st$coefficients[i], ci_t[i, "lwr"], ci_t[i, "upr"], pz(st$pvalues[i])))

# Przedziały dla 5 porównań z kontrolą przy czterech rodzinach porównań
pr <- do.call(rbind, lapply(names(prog), function(m)
  data.frame(metoda = m, porownanie = grupy[-1], roznica = roz, lo = roz - prog[m] * se, hi = roz + prog[m] * se)))
cat("\n95% przedziały (pp):\n")
print(transform(pr, lo = round(lo, 2), hi = round(hi, 2), roznica = round(roznica, 2)), row.names = FALSE)

etyk <- c(bez = "bez korekty (1.96)", dunnett = paste0("Dunnett: 5 z kontrolą (", sprintf("%.2f", prog[2]), ")"),
          bonferroni = paste0("Bonferroni/Holm: 5 (", sprintf("%.2f", prog[3]), ")"),
          tukey = paste0("Tukey: wszystkie 15 par (", sprintf("%.2f", prog[4]), ")"))
pr$metoda <- factor(pr$metoda, levels = names(prog), labels = etyk)
pr$porownanie <- factor(pr$porownanie, levels = rev(grupy[-1]),
                        labels = rev(paste0(grupy[-1], ": ", c("lekcja czeka", "3 kursy", "10 minut", "prezent", "rabat 48 h"))))
p2 <- ggplot(pr, aes(x = roznica, y = porownanie, colour = metoda, shape = metoda)) +
  geom_vline(xintercept = 0, linetype = "dashed", colour = "grey30") +
  geom_errorbar(aes(xmin = lo, xmax = hi), orientation = "y", width = 0.25, linewidth = 0.8,
                position = position_dodge(width = 0.7)) +
  geom_point(size = 2.6, position = position_dodge(width = 0.7)) +
  scale_colour_manual(values = unname(kol[c("bez", "dunnett", "holm", "tukey")]), name = NULL) +
  scale_shape_manual(values = c(16, 15, 17, 18), name = NULL) +
  guides(colour = guide_legend(nrow = 2), shape = guide_legend(nrow = 2)) +
  labs(title = "Ten sam wynik, cztery rodziny porównań",
       subtitle = "Różnica odsetka kliknięć: nowy temat − kontrola, 95% przedziały (w nawiasie próg |z|)",
       x = "Różnica odsetka kliknięć (punkty procentowe)", y = NULL) +
  motyw
p2   # zapis: ggsave("test-a-b-wiele-wariantow-przedzialy.svg", p2, width = 10, height = 6.2)
Wynik w R
Progi |z| dla 95%: bez korekty 1.96  Dunnett (5 porównań) 2.51  Bonferroni (5) 2.58  Tukey (15 par) 2.85

 porownanie roznica_pp   SE     z p_bez p_holm p_dunnett p_tukey15
     T1 − K      -0.58 0.32 -1.80 0.071  0.214     0.249     0.464
     T2 − K       0.23 0.33  0.70 0.484  0.484     0.933     0.982
     T3 − K       0.90 0.33  2.70 0.007  0.035     0.030     0.076
     T4 − K      -0.75 0.32 -2.33 0.020  0.078     0.078     0.180
     T5 − K       0.39 0.33  1.19 0.236  0.472     0.643     0.844

Porównania między nowymi tematami (Tukey, 15 par) z p < .05:
  T3 - T1  różnica  1.48 pp, 95% CI [ 0.54,  2.42], p < .001
  T5 - T1  różnica  0.98 pp, 95% CI [ 0.04,  1.91], p = .034
  T4 - T2  różnica -0.98 pp, 95% CI [-1.91, -0.06], p = .029
  T4 - T3  różnica -1.65 pp, 95% CI [-2.59, -0.72], p < .001
  T5 - T4  różnica  1.15 pp, 95% CI [ 0.22,  2.08], p = .006

95% przedziały (pp):
     metoda porownanie roznica    lo    hi
        bez         T1   -0.58 -1.22  0.05
        bez         T2    0.23 -0.42  0.88
        bez         T3    0.90  0.25  1.55
        bez         T4   -0.75 -1.39 -0.12
        bez         T5    0.39 -0.26  1.04
    dunnett         T1   -0.58 -1.40  0.23
    dunnett         T2    0.23 -0.60  1.06
    dunnett         T3    0.90  0.06  1.74
    dunnett         T4   -0.75 -1.57  0.06
    dunnett         T5    0.39 -0.44  1.22
 bonferroni         T1   -0.58 -1.42  0.25
 bonferroni         T2    0.23 -0.62  1.08
 bonferroni         T3    0.90  0.04  1.76
 bonferroni         T4   -0.75 -1.59  0.08
 bonferroni         T5    0.39 -0.46  1.25
      tukey         T1   -0.58 -1.51  0.34
      tukey         T2    0.23 -0.71  1.17
      tukey         T3    0.90 -0.05  1.85
      tukey         T4   -0.75 -1.68  0.17
      tukey         T5    0.39 -0.55  1.34
3. Trzy metryki × pięć tematów
R
# Przepis 3. Trzy metryki × pięć tematów = 15 testów: bez korekty i z poprawką Holma
# (korzysta z razem i grupy z przepisu 1)
pz <- function(x) ifelse(x < .001, "p < .001", sub("0\\.", ".", sprintf("p = %.3f", x)))   # zapis APA
test_k <- function(licznik) {                            # test z dla różnicy dwóch odsetków: temat − kontrola
  n <- razem$wyslane; x <- razem[[licznik]]; pk <- x[1] / n[1]
  sapply(2:6, function(j) { pj <- x[j] / n[j]; pp <- (x[1] + x[j]) / (n[1] + n[j])
    z <- (pj - pk) / sqrt(pp * (1 - pp) * (1 / n[1] + 1 / n[j])); c(roznica = 100 * (pj - pk), p = 2 * pnorm(-abs(z))) })
}
metryki <- c(klikniecia = "kliknięcie (główna)", lekcje = "rozpoczęcie lekcji", wypisania = "wypisanie (ochronna)")
wyn <- do.call(rbind, lapply(names(metryki), function(m) { t <- test_k(m)
  data.frame(metryka = unname(metryki[m]), temat = grupy[-1], roznica_pp = round(t["roznica", ], 2), p = t["p", ]) }))
wyn$p_holm15 <- p.adjust(wyn$p, "holm")                  # Holm na całej rodzinie 15 testów
wyn$p_tekst <- pz(wyn$p); wyn$p_holm_tekst <- pz(wyn$p_holm15)
print(wyn[, c("metryka", "temat", "roznica_pp", "p_tekst", "p_holm_tekst")], row.names = FALSE)
cat("\nWyniki p < .05 bez korekty:", sum(wyn$p < .05), "z 15;  po poprawce Holma (15 testów):", sum(wyn$p_holm15 < .05), "\n")
Wynik w R
              metryka temat roznica_pp  p_tekst p_holm_tekst
  kliknięcie (główna)    T1      -0.58 p = .071     p = .786
  kliknięcie (główna)    T2       0.23 p = .484    p = 1.000
  kliknięcie (główna)    T3       0.90 p = .007     p = .098
  kliknięcie (główna)    T4      -0.75 p = .020     p = .254
  kliknięcie (główna)    T5       0.39 p = .236    p = 1.000
   rozpoczęcie lekcji    T1       0.50 p = .272    p = 1.000
   rozpoczęcie lekcji    T2       0.31 p = .490    p = 1.000
   rozpoczęcie lekcji    T3       0.91 p = .044     p = .533
   rozpoczęcie lekcji    T4      -0.28 p = .535    p = 1.000
   rozpoczęcie lekcji    T5       0.30 p = .507    p = 1.000
 wypisanie (ochronna)    T1       0.05 p = .574    p = 1.000
 wypisanie (ochronna)    T2       0.13 p = .144    p = 1.000
 wypisanie (ochronna)    T3       0.07 p = .417    p = 1.000
 wypisanie (ochronna)    T4       0.14 p = .121    p = 1.000
 wypisanie (ochronna)    T5       0.55 p < .001     p < .001

Wyniki p < .05 bez korekty: 4 z 15;  po poprawce Holma (15 testów): 1
4. Klątwa zwycięzcy i test potwierdzający: Rysunek 3
R
# Przepis 4. Klątwa zwycięzcy: test potwierdzający w przykładzie i 1000 symulowanych turniejów: Rysunek 3
# (korzysta z razem, grupy, ef_klik, prog i motyw z przepisów 1–2)
library(ggplot2)

# Test potwierdzający: zwycięzca turnieju kontra K, 14 dni, podział 50/50, średnio 4000 kont dziennie;
# kampania reklamowa trwa, więc odsetek kliknięć w K wynosi 12%
potwierdz <- function(zw, ef = ef_klik, dni = 14, dziennie = 4000) {
  n_razem <- rpois(1, dni * dziennie); n_zw <- rbinom(1, n_razem, 0.5); n_k <- n_razem - n_zw
  x_k <- rbinom(1, n_k, 0.12); x_zw <- rbinom(1, n_zw, (12 + ef[[zw]]) / 100)
  r <- 100 * (x_zw / n_zw - x_k / n_k)
  se <- 100 * sqrt((x_zw / n_zw) * (1 - x_zw / n_zw) / n_zw + (x_k / n_k) * (1 - x_k / n_k) / n_k)
  c(roznica = r, lo = r - 1.96 * se, hi = r + 1.96 * se, p = 2 * pnorm(-abs(r / se)), n_zw = n_zw, n_k = n_k)
}
zwyc <- razem$grupa[-1][which.max(razem$klik_proc[-1] - razem$klik_proc[1])]
set.seed(6581)                                           # osobne ziarno dla testu potwierdzającego
pot <- potwierdz(zwyc)
cat("Zwycięzca turnieju:", zwyc, " oszacowanie w turnieju:", round(razem$klik_proc[razem$grupa == zwyc] - razem$klik_proc[1], 2),
    "pp  prawda:", ef_klik[[zwyc]], "pp\n")
cat(sprintf("Test potwierdzający: n = %d i %d, różnica %.2f pp, 95%% CI [%.2f, %.2f], p = %s\n\n",
            pot[["n_zw"]], pot[["n_k"]], pot[["roznica"]], pot[["lo"]], pot[["hi"]], sub("^0", "", sprintf("%.3f", pot[["p"]]))))

# 1000 turniejów tym samym schematem (szybka wersja generatora: dwa okresy po 14 dni zamiast 28 dni –
# sumy dziennych liczebności i kliknięć mają ten sam rozkład). Dwa scenariusze prawdziwych efektów:
# A – jak w przykładzie (T3 wyraźnie najlepszy), B – pięć podobnych tematów, każdy +0.3 pp (ustalone ręcznie)
scen <- list(A = ef_klik, B = c(K = 0, T1 = 0.3, T2 = 0.3, T3 = 0.3, T4 = 0.3, T5 = 0.3))
turniej <- function(ef) {
  x <- n <- numeric(6)
  for (okres in 1:2) {
    nn <- as.vector(rmultinom(1, rpois(1, 14 * 4000), rep(1, 6)))
    n <- n + nn; x <- x + rbinom(6, nn, (ifelse(okres == 1, 10, 12) + ef) / 100)
  }
  pr <- x / n; r <- 100 * (pr[-1] - pr[1]); se <- 100 * sqrt(pr[-1] * (1 - pr[-1]) / n[-1] + pr[1] * (1 - pr[1]) / n[1])
  j <- which.max(r)                                      # zwycięzca = największa różnica wobec K
  wyb <- grupy[-1][j]
  c(wybrany = j, prawda = ef[[wyb]], oszac = r[j],
    istotny = r[j] / se[j] > prog[["dunnett"]],          # istotny po korekcie Dunnetta
    potw = potwierdz(wyb, ef)[["roznica"]])              # świeży test: zwycięzca kontra K
}
mc <- function(x) sd(x) / sqrt(length(x))
R <- 1000
wyniki <- list()
for (s in names(scen)) {
  set.seed(658)                                          # to samo ziarno w obu scenariuszach
  sym <- as.data.frame(t(replicate(R, turniej(scen[[s]]))))
  ist <- sym$istotny == 1
  cat("Scenariusz", s, "– prawdziwe efekty:", paste(names(scen[[s]])[-1], scen[[s]][-1], collapse = ", "), "\n")
  cat("  wybrany temat (%):", paste(grupy[-1], sprintf("%.1f", 100 * tabulate(sym$wybrany, 5) / R), collapse = "  "), "\n")
  cat(sprintf("  turniej, wszyscy zwycięzcy: oszacowanie %.2f, prawda %.2f, zawyżenie %.2f pp (błąd MC %.3f)\n",
              mean(sym$oszac), mean(sym$prawda), mean(sym$oszac - sym$prawda), mc(sym$oszac - sym$prawda)))
  cat(sprintf("  zwycięzca istotny (Dunnett) w %.1f%% turniejów (błąd MC %.1f pp); w nich oszacowanie %.2f, zawyżenie %.2f pp (błąd MC %.3f)\n",
              100 * mean(ist), 100 * sqrt(mean(ist) * (1 - mean(ist)) / R), mean(sym$oszac[ist]),
              mean(sym$oszac[ist] - sym$prawda[ist]), mc(sym$oszac[ist] - sym$prawda[ist])))
  cat(sprintf("  test potwierdzający: oszacowanie %.2f, zawyżenie %.2f pp (błąd MC %.3f)\n\n",
              mean(sym$potw), mean(sym$potw - sym$prawda), mc(sym$potw - sym$prawda)))
  wyniki[[s]] <- rbind(
    data.frame(scen = s, etap = "turniej:\nwszyscy zwycięzcy", blad = sym$oszac - sym$prawda, nr = 1:R),
    data.frame(scen = s, etap = "turniej: zwycięzcy\nistotni po Dunnetcie", blad = (sym$oszac - sym$prawda)[ist], nr = which(ist)),
    data.frame(scen = s, etap = "test\npotwierdzający", blad = sym$potw - sym$prawda, nr = 1:R))
}
w <- do.call(rbind, wyniki)
w$etap <- factor(w$etap, levels = unique(w$etap))
w$scen <- factor(w$scen, levels = c("A", "B"),
                 labels = c("A: jak w przykładzie (T3 wyraźnie najlepszy)", "B: pięć podobnych tematów (+0.3 pp)"))
sr <- aggregate(blad ~ scen + etap, data = w, FUN = function(x) c(m = mean(x), mc = mc(x)))
sr <- data.frame(sr[, 1:2], m = sr$blad[, "m"], mc = sr$blad[, "mc"])
p3 <- ggplot(subset(w, nr <= 150), aes(x = etap, y = blad)) +
  geom_hline(yintercept = 0, linetype = "dashed", colour = "black") +
  geom_point(aes(colour = etap, shape = etap), position = position_jitter(width = 0.22, height = 0, seed = 1),
             alpha = 0.35, size = 1.5) +
  geom_errorbar(data = sr, aes(y = m, ymin = m - 1.96 * mc, ymax = m + 1.96 * mc), width = 0.3, linewidth = 0.9) +
  geom_point(data = sr, aes(y = m), size = 3.4, shape = 21, fill = "white", stroke = 1.3) +
  geom_label(data = sr, aes(y = m, label = sprintf("%+.2f", m)), nudge_x = 0.36, size = 3.8, linewidth = 0) +
  facet_wrap(~ scen) +
  scale_colour_manual(values = c("#D55E00", "#E69F00", "#0072B2"), guide = "none") +
  scale_shape_manual(values = c(17, 15, 16), guide = "none") +
  labs(title = "Klątwa zwycięzcy: oszacowanie minus prawda",
       subtitle = "Punkty: 150 z 1000 turniejów; kółko – średnia z 1000 (wąsy: 95% błędu MC)",
       x = NULL, y = "Oszacowanie − prawdziwy efekt (pp)") +
  motyw + theme(axis.text.x = element_text(size = rel(0.92)))
p3   # zapis: ggsave("test-a-b-wiele-wariantow-klatwa-zwyciezcy.svg", p3, width = 10, height = 6)
Wynik w R
Zwycięzca turnieju: T3  oszacowanie w turnieju: 0.9 pp  prawda: 1 pp
Test potwierdzający: n = 28099 i 27855, różnica 0.84 pp, 95% CI [0.29, 1.39], p = .003

Scenariusz A – prawdziwe efekty: T1 0, T2 0.5, T3 1, T4 -0.3, T5 0.6
  wybrany temat (%): T1 0.1  T2 4.8  T3 85.1  T4 0.0  T5 10.0
  turniej, wszyscy zwycięzcy: oszacowanie 1.03, prawda 0.94, zawyżenie 0.10 pp (błąd MC 0.010)
  zwycięzca istotny (Dunnett) w 73.1% turniejów (błąd MC 1.4 pp); w nich oszacowanie 1.17, zawyżenie 0.22 pp (błąd MC 0.010)
  test potwierdzający: oszacowanie 0.94, zawyżenie 0.00 pp (błąd MC 0.009)

Scenariusz B – prawdziwe efekty: T1 0.3, T2 0.3, T3 0.3, T4 0.3, T5 0.3
  wybrany temat (%): T1 20.1  T2 19.2  T3 18.4  T4 21.5  T5 20.8
  turniej, wszyscy zwycięzcy: oszacowanie 0.57, prawda 0.30, zawyżenie 0.27 pp (błąd MC 0.009)
  zwycięzca istotny (Dunnett) w 20.2% turniejów (błąd MC 1.3 pp); w nich oszacowanie 0.97, zawyżenie 0.67 pp (błąd MC 0.010)
  test potwierdzający: oszacowanie 0.30, zawyżenie 0.00 pp (błąd MC 0.009)
5. Moc przy rosnącej liczbie tematów: Rysunek 4
R
# Przepis 5. Ten sam ruch, coraz więcej tematów: moc wykrycia +1 pp przy podziale po równo i z większą kontrolą: Rysunek 4
# (korzysta z motyw i kol z przepisu 1)
library(ggplot2); library(mvtnorm)

N <- 28 * 4000                    # cztery tygodnie maili powitalnych
p0 <- 0.11; delta <- 0.01         # średni odsetek kliknięć w K i efekt wart wykrycia (+1 pp) – założenia planu
prog_d <- function(k, rho) if (k == 1) qnorm(0.975) else
  qmvnorm(0.95, tail = "both.tails", corr = matrix(rho, k, k) + diag(1 - rho, k))$quantile   # próg Dunnetta
moc <- function(n_v, n_k, c) {    # P(wariant z efektem +1 pp istotnie lepszy od K)
  se <- sqrt(p0 * (1 - p0) / n_k + (p0 + delta) * (1 - p0 - delta) / n_v); pnorm(delta / se - c)
}
set.seed(658)                     # qmvnorm liczy próg numerycznie
krzywe <- do.call(rbind, lapply(1:10, function(k) {
  n_r <- N / (k + 1)                                     # podział po równo
  n_v <- N / (k + sqrt(k)); n_k <- sqrt(k) * n_v         # kontrola √k razy większa od każdego wariantu
  c_r <- prog_d(k, 0.5); c_s <- prog_d(k, 1 / (1 + sqrt(k)))
  data.frame(k = k, n_wariant_rowno = round(n_r), bez_korekty = moc(n_r, n_r, qnorm(0.975)),
             dunnett_rowno = moc(n_r, n_r, c_r), dunnett_wieksza_K = moc(n_v, n_k, c_s),
             n_wariant_wiekszaK = round(n_v), n_K_wiekszaK = round(n_k))
}))
cat("k = liczba tematów; n = osób na temat (po równo) | na temat i w K (kontrola √k razy większa)\n")
print(with(krzywe, data.frame(k, n_rowno = n_wariant_rowno, moc_bez_korekty = round(bez_korekty, 3),
                              moc_dunnett = round(dunnett_rowno, 3), n_temat = n_wariant_wiekszaK, n_K = n_K_wiekszaK,
                              moc_dunnett_wiekszaK = round(dunnett_wieksza_K, 3))), row.names = FALSE)

# Ile tygodni (4000 kont dziennie) do mocy 80% przy 5 tematach?
tyg <- function(k, rowno = TRUE) {
  f <- function(t) { M <- t * 7 * 4000
    if (rowno) moc(M / (k + 1), M / (k + 1), prog_d(k, 0.5)) - 0.8
    else { nv <- M / (k + sqrt(k)); moc(nv, sqrt(k) * nv, prog_d(k, 1 / (1 + sqrt(k)))) - 0.8 } }
  uniroot(f, c(0.2, 30))$root
}
set.seed(658)
k5 <- krzywe[krzywe$k == 5, ]
cat(sprintf("\nPrzy 5 tematach z większą K: udział K %.1f%%, każdego tematu %.1f%% ruchu\n",
            100 * k5$n_K_wiekszaK / N, 100 * k5$n_wariant_wiekszaK / N))
cat(sprintf("Moc 80%% dla +1 pp: 1 temat %.1f tyg.; 5 tematów po równo %.1f tyg.; 5 tematów z większą K %.1f tyg.\n",
            tyg(1), tyg(5), tyg(5, FALSE)))

# Sprawdzenie symulacją (1000 testów na punkt, podział po równo, jeden temat z +1 pp, reszta bez efektu)
set.seed(6582)
spr <- do.call(rbind, lapply(c(1, 3, 5, 10), function(k) {
  c_r <- prog_d(k, 0.5)
  traf <- replicate(1000, {
    n <- as.vector(rmultinom(1, N, rep(1, k + 1)))
    x <- rbinom(k + 1, n, c(p0, p0 + delta, rep(p0, k - 1))); pr <- x / n
    (pr[2] - pr[1]) / sqrt(pr[2] * (1 - pr[2]) / n[2] + pr[1] * (1 - pr[1]) / n[1]) > c_r })
  data.frame(k = k, moc_sym = mean(traf), blad_mc = sqrt(mean(traf) * (1 - mean(traf)) / 1000))
}))
cat("\nSymulacja (Dunnett, po równo):\n"); print(transform(spr, moc_sym = round(moc_sym, 3), blad_mc = round(blad_mc, 3)), row.names = FALSE)

dl <- rbind(data.frame(k = krzywe$k, moc = krzywe$bez_korekty, wariant = "bez korekty, po równo"),
            data.frame(k = krzywe$k, moc = krzywe$dunnett_rowno, wariant = "Dunnett, po równo"),
            data.frame(k = krzywe$k, moc = krzywe$dunnett_wieksza_K, wariant = "Dunnett, kontrola √k razy większa"))
dl$wariant <- factor(dl$wariant, levels = unique(dl$wariant))
p4 <- ggplot(dl, aes(k, moc, colour = wariant, linetype = wariant, shape = wariant)) +
  geom_hline(yintercept = 0.8, colour = "grey40", linetype = "dotted") +
  geom_line(linewidth = 1) + geom_point(size = 2.3) +
  geom_errorbar(data = spr, aes(x = k, ymin = moc_sym - 1.96 * blad_mc, ymax = moc_sym + 1.96 * blad_mc),
                inherit.aes = FALSE, width = 0.25, colour = "black") +
  geom_point(data = spr, aes(x = k, y = moc_sym), inherit.aes = FALSE, shape = 4, size = 3, stroke = 1.2) +
  annotate("text", x = 10, y = 0.82, label = "moc 80%", hjust = 1, vjust = 0, size = 3.8, colour = "grey30") +
  scale_x_continuous(breaks = 1:10) + scale_y_continuous(labels = function(x) paste0(100 * x, "%"), limits = c(0, 1)) +
  scale_colour_manual(values = unname(kol[c("bez", "dunnett", "akcent")]), name = NULL) +
  scale_linetype_manual(values = c("dashed", "solid", "longdash"), name = NULL) +
  scale_shape_manual(values = c(1, 15, 17), name = NULL) +
  guides(colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2), shape = guide_legend(nrow = 2)) +
  labs(title = "Każdy nowy temat zabiera ruch pozostałym",
       subtitle = "112 000 maili w 4 tygodnie; moc wykrycia +1 pp (11% → 12%); krzyżyki – symulacja 1000 testów",
       x = "Liczba nowych tematów obok kontroli", y = "Moc dla tematu z efektem +1 pp") +
  motyw
p4   # zapis: ggsave("test-a-b-wiele-wariantow-moc.svg", p4, width = 10, height = 5.8)
Wynik w R
k = liczba tematów; n = osób na temat (po równo) | na temat i w K (kontrola √k razy większa)
  k n_rowno moc_bez_korekty moc_dunnett n_temat   n_K moc_dunnett_wiekszaK
  1   56000           0.999       0.999   56000 56000                0.999
  2   37333           0.990       0.981   32804 46392                0.983
  3   28000           0.960       0.913   23668 40995                0.927
  4   22400           0.913       0.810   18667 37333                0.842
  5   18667           0.857       0.698   15478 34610                0.748
  6   16000           0.801       0.593   13255 32469                0.658
  7   14000           0.746       0.504   11611 30721                0.575
  8   12444           0.696       0.429   10343 29255                0.503
  9   11200           0.650       0.367    9333 28000                0.441
 10   10182           0.609       0.316    8509 26908                0.387

Przy 5 tematach z większą K: udział K 30.9%, każdego tematu 13.8% ruchu
Moc 80% dla +1 pp: 1 temat 1.1 tyg.; 5 tematów po równo 4.9 tyg.; 5 tematów z większą K 4.4 tyg.

Symulacja (Dunnett, po równo):
  k moc_sym blad_mc
  1   1.000   0.000
  3   0.927   0.008
  5   0.714   0.014
 10   0.317   0.015
6. Temat dodany w połowie testu: Rysunek 5
R
# Przepis 6. Temat dodany w połowie testu: porównanie z całą kontrolą a z kontrolą z tych samych dni: Rysunek 5
# (korzysta z maile i motyw z przepisu 1)
library(ggplot2); suppressPackageStartupMessages(library(patchwork))

# Panel A: dzienny odsetek kliknięć w grupie K z przykładu (od 15. dnia kampania reklamowa)
k_dzien <- subset(maile, grupa == "K")
k_dzien$klik_proc <- 100 * k_dzien$klikniecia / k_dzien$wyslane
srK <- c(100 * with(subset(k_dzien, dzien <= 14), sum(klikniecia) / sum(wyslane)),
         100 * with(subset(k_dzien, dzien >= 15), sum(klikniecia) / sum(wyslane)))
cat(sprintf("K, dni 1–14: %.2f%%  dni 15–28: %.2f%%\n", srK[1], srK[2]))

# Symulacja: 15. dnia dochodzi temat T6 BEZ żadnego efektu (taki jak K); od tego dnia ruch dzielony na 7 grup
dodany <- function(dziennie = 4000) {
  n_k <- x_k <- c(0, 0); n6 <- x6 <- 0
  for (okres in 1:2) {
    g <- if (okres == 1) 6 else 7; p <- if (okres == 1) 0.10 else 0.12
    n <- as.vector(rmultinom(1, rpois(1, 14 * dziennie), rep(1, g)))
    n_k[okres] <- n[1]; x_k[okres] <- rbinom(1, n[1], p)
    if (okres == 2) { n6 <- n[7]; x6 <- rbinom(1, n6, p) }
  }
  porownaj <- function(xk, nk) { pk <- xk / nk; p6 <- x6 / n6; r <- 100 * (p6 - pk)
    c(r, 2 * pnorm(-abs(r / (100 * sqrt(pk * (1 - pk) / nk + p6 * (1 - p6) / n6))))) }
  c(porownaj(sum(x_k), sum(n_k)), porownaj(x_k[2], n_k[2]))   # cała K | K z dni 15–28
}
set.seed(6583)
R <- 1000
s6 <- t(replicate(R, dodany()))
fa <- c(cala = mean(s6[, 2] < .05), rownolegla = mean(s6[, 4] < .05))
cat(sprintf("T6 (efekt 0) a cała K:        średnia różnica %.2f pp, p < .05 w %.1f%% testów (błąd MC %.1f pp)\n",
            mean(s6[, 1]), 100 * fa[1], 100 * sqrt(fa[1] * (1 - fa[1]) / R)))
cat(sprintf("T6 a K z tych samych dni:     średnia różnica %.2f pp, p < .05 w %.1f%% testów (błąd MC %.1f pp)\n",
            mean(s6[, 3]), 100 * fa[2], 100 * sqrt(fa[2] * (1 - fa[2]) / R)))

pa <- ggplot(k_dzien, aes(dzien, klik_proc)) +
  annotate("rect", xmin = 14.5, xmax = 28.5, ymin = -Inf, ymax = Inf, fill = "#E69F00", alpha = 0.15) +
  annotate("text", x = 21.5, y = 14.6, label = "kampania reklamowa;\ntu dochodzi T6", size = 3.6, colour = "grey20") +
  geom_line(colour = "grey50") + geom_point(colour = "#0072B2", size = 2) +
  annotate("segment", x = c(0.5, 14.5), xend = c(14.5, 28.5), y = srK, yend = srK, colour = "#D55E00", linewidth = 1.1) +
  coord_cartesian(ylim = c(8, 15.2)) +
  labs(title = "A. Kontrola zmienia się w czasie", subtitle = "punkty – dni, linie – średnie okresów", x = "Dzień testu", y = "Kliknięcia w K (%)") + motyw
dl <- data.frame(roznica = c(s6[, 1], s6[, 3]),
                 porownanie = factor(rep(c("z całą K\n(dni 1–28)", "z K z tych\nsamych dni"), each = R),
                                     levels = c("z całą K\n(dni 1–28)", "z K z tych\nsamych dni")))
et <- data.frame(porownanie = levels(dl$porownanie), y = 2.35,
                 tekst = sprintf("p < .05: %.1f%%", 100 * fa))
pb <- ggplot(dl, aes(porownanie, roznica, fill = porownanie)) +
  geom_hline(yintercept = 0, linetype = "dashed") +
  geom_violin(alpha = 0.5, colour = NA) + geom_boxplot(width = 0.18, outlier.shape = NA, fill = "white") +
  geom_text(data = et, aes(y = y, label = tekst), size = 3.9) +
  scale_fill_manual(values = c("#D55E00", "#0072B2"), guide = "none") +
  coord_cartesian(ylim = c(-1.5, 2.5)) +
  labs(title = "B. T6 bez efektu w 1000 testów", subtitle = "porównanie T6 z kontrolą", x = NULL, y = "Różnica T6 − K (pp)") + motyw
p5 <- pa + pb + plot_layout(widths = c(1.25, 1))
p5   # zapis: ggsave("test-a-b-wiele-wariantow-dodany-temat.svg", p5, width = 10, height = 5.4)
Wynik w R
K, dni 1–14: 10.62%  dni 15–28: 12.11%
T6 (efekt 0) a cała K:        średnia różnica 1.07 pp, p < .05 w 70.8% testów (błąd MC 1.4 pp)
T6 a K z tych samych dni:     średnia różnica -0.01 pp, p < .05 w 4.7% testów (błąd MC 0.7 pp)
7. Grafika: turniej i test potwierdzający (Rysunek 1)
R
# Przepis 7. Grafika: turniej wariantów → test potwierdzający, z liczbami z przykładu (Rysunek 1)
# (korzysta z razem, tab, prog, pot, w i wyn z przepisów 1–4 i motyw z przepisu 1)
library(ggplot2)

f <- function(x) formatC(x, format = "f", digits = 2)
pp <- function(x) sub("0\\.", ".", sprintf("%.3f", x))
zaw <- with(aggregate(blad ~ scen + etap, data = w, FUN = mean), setNames(blad, paste(substr(scen, 1, 1), as.integer(etap))))
# zaw["A 1"] – scenariusz A, wszyscy zwycięzcy; "B 2" – scenariusz B, zwycięzcy istotni; "B 3" – B, test potwierdzający
t3 <- tab[tab$porownanie == "T3 − K", ]; t4 <- tab[tab$porownanie == "T4 − K", ]
w5 <- wyn[wyn$metryka == "wypisanie (ochronna)" & wyn$temat == "T5", ]
karty <- data.frame(
  x = c(1, 2, 3, 3, 2, 1), y = c(2, 2, 2, 1, 1, 1),
  rodzaj = c("etap", "etap", "ryzyko", "rozstrzygniecie", "rozstrzygniecie", "uwaga"),
  tekst = c(paste0("1. Plan przed startem\nmetryka główna: kliknięcie\nK + 5 nowych tematów, 4 tygodnie\nok. ",
                   format(round(mean(razem$wyslane), -2), big.mark = " "), " osób na grupę\nkorekta Dunnetta\n(próg |z| ", f(prog[["dunnett"]]), ")"),
            paste0("2. Turniej\nT3 − K: +", f(t3$roznica_pp), " pp\np = ", pp(t3$p_dunnett), " (Dunnett)\nT4 − K: ", sub("-", "−", f(t4$roznica_pp)),
                   " pp\np = ", pp(t4$p_bez), " bez korekty,\n", pp(t4$p_dunnett), " po korekcie"),
            paste0("3. Wybór zwycięzcy: T3\noszacowanie zwycięzcy\njest zawyżone:\nw symulacji średnio\no ", f(zaw[["A 1"]]), " pp (przykład)\ndo ", f(zaw[["B 1"]]), " pp (podobne tematy)"),
            paste0("4. Test potwierdzający\nT3 kontra K\n2 tygodnie, 50/50\nn = ", format(pot[["n_zw"]], big.mark = " "), " i ",
                   format(pot[["n_k"]], big.mark = " "), "\n+", f(pot[["roznica"]]), " pp\n95% CI [", f(pot[["lo"]]), ", ", f(pot[["hi"]]), "]"),
            paste0("5. Decyzja\nwdrożyć T3; w raporcie\nefekt z testu\npotwierdzającego\nT5 odpada: wypisania +", f(w5$roznica_pp), " pp"),
            paste0("Dlaczego krok 4?\nPrzy pięciu podobnych\ntematach istotny zwycięzca\nbył zawyżony średnio\no ", f(zaw[["B 2"]]),
                   " pp przy prawdzie 0.30;\ntest potwierdzający – o ", f(abs(zaw[["B 3"]])), " pp")))
wyp <- c(etap = "grey93", ryzyko = "#FBE3D3", rozstrzygniecie = "#DCEBF7", uwaga = "white")
ram <- c(etap = "grey55", ryzyko = "#D55E00", rozstrzygniecie = "#0072B2", uwaga = "grey55")
strz <- data.frame(x = c(1.44, 2.44, 3, 2.56), xend = c(1.56, 2.56, 3, 2.44), y = c(2, 2, 1.6, 1), yend = c(2, 2, 1.4, 1))
p1 <- ggplot(karty) +
  geom_rect(aes(xmin = x - 0.43, xmax = x + 0.43, ymin = y - 0.38, ymax = y + 0.38, fill = rodzaj, colour = rodzaj),
            linewidth = 0.8, linetype = ifelse(karty$rodzaj == "uwaga", "dashed", "solid")) +
  geom_text(aes(x = x, y = y, label = tekst), size = 4.4, colour = "grey10", lineheight = 1.0) +
  geom_segment(data = strz, aes(x = x, xend = xend, y = y, yend = yend),
               arrow = arrow(length = unit(0.22, "cm"), type = "closed"), colour = "grey35", linewidth = 0.7) +
  scale_fill_manual(values = wyp, guide = "none") + scale_colour_manual(values = ram, guide = "none") +
  coord_cartesian(xlim = c(0.55, 3.45), ylim = c(0.6, 2.4), expand = FALSE) +
  labs(title = "Turniej wariantów, potem test potwierdzający",
       subtitle = "Liczby z przykładu; szare – plan i turniej, pomarańczowe – ryzyko, niebieskie – rozstrzygnięcie") +
  motyw + theme(axis.text = element_blank(), axis.title = element_blank(), panel.grid.major = element_blank())
p1   # zapis: ggsave("test-a-b-wiele-wariantow-schemat.svg", p1, width = 10, height = 6.4)
8. Sprawdzenie palety (deuteranopia i protanopia)
R
# Przepis 8. Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("bez korekty – Dunnett" = c("grey50", "#0072B2"), "Dunnett – Bonferroni/Holm" = c("#0072B2", "#E69F00"),
             "Bonferroni/Holm – Tukey" = c("#E69F00", "#CC79A7"), "Dunnett – Tukey" = c("#0072B2", "#CC79A7"),
             "turniej – potwierdzenie" = c("#D55E00", "#0072B2"), "turniej – istotni" = c("#D55E00", "#E69F00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
hex <- function(k) rgb(t(col2rgb(k)), maxColorValue = 255)
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(hex(k)), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(hex(k))),
                                   protanopia = roznica(protan(hex(k)))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
bez korekty – Dunnett                       42.1         45.8       38.4
Dunnett – Bonferroni/Holm                  120.2        121.5      109.3
Bonferroni/Holm – Tukey                     88.6         81.3       87.6
Dunnett – Tukey                             53.6         42.0       22.5
turniej – potwierdzenie                    114.6        108.3       91.9
turniej – istotni                           33.4         18.4       24.9
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, testy dla proporcji i poprawkę Holma (p.adjust()) policzono w pakiecie stats wbudowanym w R. Przedziały i skorygowane p Dunnetta i Tukeya policzono pakietem multcomp, a progi do krzywych mocy – pakietem mvtnorm. Rysunki wykonano w pakietach ggplot2 i patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- multcomp (wersja 1.4-30): Hothorn, T., Bretz, F., & Westfall, P. (2008). Simultaneous inference in general parametric models. Biometrical Journal, 50(3), 346–363. https://doi.org/10.1002/bimj.200810425
- mvtnorm (wersja 1.3-6): Genz, A., & Bretz, F. (2009). Computation of multivariate normal and t probabilities. Springer. ISBN 978-3-642-01688-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1), 1–49. https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Efekt zwycięzcy z turnieju jako pewny. W symulacji był zawyżony średnio o 0.10–0.67 pp.
- Wybór korekty po obejrzeniu wyników. T3 jest istotny po Dunnetcie, a po Tukeyu nie.
- Wnioski bez korekty. T4 był „istotnie gorszy” od K bez korekty (p = .020), a po niej nie.
- Liczebność policzona jak dla testu z dwiema wersjami. Pięć tematów przy tym samym ruchu to moc 69.8% zamiast 99.9%.
- Wariant dodany w trakcie porównany z całą kontrolą. W symulacji temat bez efektu wygrywał w 70.8% testów.
- Wszystkie metryki w jednym worku albo każda bez korekty. Pierwsze zabija wynik główny, drugie daje fałszywe sukcesy.
Najczęstsze pytania
Jaką korektę zastosować w teście A/B z kilkoma wariantami?
Zależy od pytania. Gdy pytasz, które warianty są lepsze od obecnej wersji, użyj testu Dunnetta – porównuje każdy wariant tylko z kontrolą i ma niższy próg niż korekty dla wszystkich par. Poprawka Holma działa na dowolnym zbiorze wartości p. Test Tukeya wybierz, gdy ważne są też porównania wariantów między sobą. Rodzinę porównań ustal przed startem.
Co to jest klątwa zwycięzcy w testach A/B?
To zawyżenie efektu wariantu, który wybrano dlatego, że miał najlepszy wynik. Wśród kilku oszacowań wygrywa zwykle to, któremu przypadek coś dodał. W symulacji z pięcioma podobnymi tematami (prawda +0.3 pp) istotny zwycięzca miał średnio 0.97 pp. Efekt do decyzji szacuj w osobnym teście potwierdzającym.
Czy można dodać nowy wariant w trakcie testu A/B?
Lepiej nie, a jeśli trzeba – porównuj go wyłącznie z kontrolą z tych samych dni i licz jako dodatkowe porównanie w korekcie. W symulacji wariant bez efektu porównany z całą kontrolą „wygrywał” w 70.8% testów, bo wszedł w okresie z wyższym odsetkiem kliknięć; z kontrolą z tych samych dni – w 4.7%.
Ile wariantów można testować naraz?
Tyle, ile udźwignie ruch. Każdy wariant dzieli tę samą liczbę osób na więcej grup, a korekta podnosi próg. W przykładzie przy 112 000 maili moc wykrycia +1 pp spadła z 99.9% przy jednym wariancie do 69.8% przy pięciu i 31.6% przy dziesięciu. Większa grupa kontrolna (√k razy większa od grupy wariantu) trochę pomaga.
Czy przy wielu metrykach w teście A/B trzeba stosować korektę?
Ustal hierarchię przed startem: jedna metryka główna z korektą na liczbę wariantów, metryki dodatkowe jako eksploracyjne, metryka ochronna (np. wypisania) jako warunek wdrożenia. Jedna poprawka na wszystkie 15 testów w przykładzie odebrała istotność głównemu wynikowi (p = .098), a testy bez korekty dały cztery „sukcesy”.
Powiązane hasła
Przeczytaj też
Pułapki testów A/B na obrazkach
Zaglądanie do p, wiele wersji i metryk, efekt nowości i SRM w symulacjach 1000 testów A/A – pięć rysunków z kodem R i lista kontrolna.
Czytaj →PoradnikWielorękie bandyty a test A/B
Portal z przepisami i cztery nagłówki: test A/B, strategia epsilon-zachłanna i UCB1 w 1000 symulacjach – utracone kliknięcia, trafność i obciążone średnie.
Czytaj →PoradnikTest A/B – plan i analiza
Metryka główna, liczebność z power.prop.test, losowanie i czas trwania, skutki podglądania wyników w symulacji oraz różnica odsetków z CI i względny wzrost.
Czytaj →PoradnikIle kreacji testować przy małym budżecie
20 000 wyświetleń i pytanie: 2, 4 czy 8 kreacji? Szansa wyboru najlepszej, wartość informacji w zł i klątwa zwycięzcy – z kodem R.
Czytaj →Analizujesz test z kilkoma wariantami?
Pomożemy dobrać korektę do pytania, policzyć liczebność przy wielu wariantach, zaplanować test potwierdzający i opisać wynik tak, żebyś umiał(a) go obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Andrews, I., Kitagawa, T., & McCloskey, A. (2024). Inference on winners. The Quarterly Journal of Economics, 139(1), 305–358. https://doi.org/10.1093/qje/qjad043 ● Otwarty dostęp
- Dunnett, C. W. (1955). A multiple comparison procedure for comparing several treatments with a control. Journal of the American Statistical Association, 50(272), 1096–1121. https://doi.org/10.1080/01621459.1955.10501294
- Gelman, A., & Carlin, J. (2014). Beyond power calculations: Assessing type S (sign) and type M (magnitude) errors. Perspectives on Psychological Science, 9(6), 641–651. https://doi.org/10.1177/1745691614551642
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70. https://www.jstor.org/stable/4615733
- Ioannidis, J. P. A. (2008). Why most discovered true associations are inflated. Epidemiology, 19(5), 640–648. https://doi.org/10.1097/ede.0b013e31818131e7
- Kohavi, R., Tang, D., & Xu, Y. (2020). Trustworthy online controlled experiments: A practical guide to A/B testing. Cambridge University Press. https://doi.org/10.1017/9781108653985
- Lee, M. R., & Shen, M. (2018). Winner’s curse: Bias estimation for total effects of features in online controlled experiments. In Proceedings of the 24th ACM SIGKDD International Conference on Knowledge Discovery & Data Mining (pp. 491–499). ACM. https://doi.org/10.1145/3219819.3219905
Cytowania BibTeX
@article{andrews2024inference, author={Andrews, Isaiah and Kitagawa, Toru and McCloskey, Adam}, title={{Inference on winners}}, journal={The Quarterly Journal of Economics}, year={2024}, volume={139}, number={1}, pages={305--358}, doi={10.1093/qje/qjad043}}@article{dunnett1955multiple, author={Dunnett, Charles W.}, title={{A multiple comparison procedure for comparing several treatments with a control}}, journal={Journal of the American Statistical Association}, year={1955}, volume={50}, number={272}, pages={1096--1121}, doi={10.1080/01621459.1955.10501294}}@article{gelman2014beyond, author={Gelman, Andrew and Carlin, John}, title={{Beyond power calculations: Assessing type S (sign) and type M (magnitude) errors}}, journal={Perspectives on Psychological Science}, year={2014}, volume={9}, number={6}, pages={641--651}, doi={10.1177/1745691614551642}}@article{holm1979simple, author={Holm, Sture}, title={{A simple sequentially rejective multiple test procedure}}, journal={Scandinavian Journal of Statistics}, year={1979}, volume={6}, number={2}, pages={65--70}, url={https://www.jstor.org/stable/4615733}}@article{ioannidis2008why, author={Ioannidis, John P. A.}, title={{Why most discovered true associations are inflated}}, journal={Epidemiology}, year={2008}, volume={19}, number={5}, pages={640--648}, doi={10.1097/ede.0b013e31818131e7}}@book{kohavi2020trustworthy, author={Kohavi, Ron and Tang, Diane and Xu, Ya}, title={{Trustworthy online controlled experiments: A practical guide to A/B testing}}, year={2020}, publisher={Cambridge University Press}, doi={10.1017/9781108653985}}@inproceedings{lee2018winners, author={Lee, Minyong R. and Shen, Milan}, title={{Winner’s curse: Bias estimation for total effects of features in online controlled experiments}}, booktitle={Proceedings of the 24th ACM SIGKDD International Conference on Knowledge Discovery \& Data Mining}, year={2018}, pages={491--499}, publisher={ACM}, doi={10.1145/3219819.3219905}}