Przykład: sklep wędkarski i 20 000 wyświetleń
Fikcyjny sklep internetowy z akcesoriami wędkarskimi kupuje na sezon 400 000 wyświetleń reklamy w mediach społecznościowych. Pierwsze 20 000 chce przeznaczyć na test A/B kreacji, a pozostałe 380 000 oddać zwycięzcy. Grafik może przygotować kolejne wersje po 120 zł za sztukę. Pytanie właściciela: testować 2, 4 czy 8 kreacji? Każda dodatkowa daje nową szansę na trafienie, ale zabiera wyświetlenia pozostałym i kosztuje.
Kliknięcie ma wartość: 2.5% kliknięć kończy się zamówieniem, a średnia marża z zamówienia to 48 zł, więc kliknięcie jest warte 1.20 zł. Przy CTR (odsetku wyświetleń zakończonych kliknięciem) równym 1% wdrożenie jest warte 4560 zł – i od tej kwoty zależy, ile wolno wydać na test.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Parametry ustawiliśmy ręcznie: prawdziwe CTR w przykładowym teście (A 1.00%, B 0.92%, C 1.18%, D 1.08%), a w symulacjach „pulę pomysłów”, z której biorą się kreacje – średni CTR 1.0% i typowy rozrzut między kreacjami 20% (kreacja bywa o kilkanaście–kilkadziesiąt procent lepsza lub gorsza od przeciętnej). Wszystkie ziarna ustaliliśmy raz i nie zmienialiśmy ich; zmiany po pierwszym uruchomieniu opisujemy przy kodzie. Dzienne dane przykładowego testu pobierzesz jako ile-kreacji-test-4-kreacji-wedkarstwo.csv.
Rysunek 1: cztery kreacje, jeden test
Sklep najpierw zrobił to, co robi większość: cztery kreacje po 5000 wyświetleń przez 14 dni.
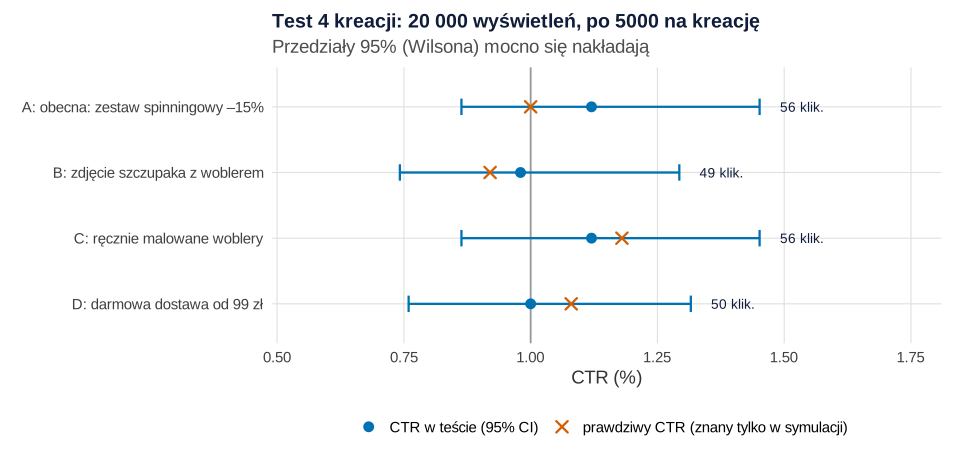
set.seed(694)).Co widać. Kreacje A i C mają po 56 kliknięć (1.12%), B – 49, D – 50. Przedziały ufności dla proporcji nakładają się prawie w całości, a test χ² równości czterech CTR daje χ²(3) = 0.82, p = .845. Remis A i C nic nie rozstrzyga: prawdziwie najlepsza jest C (1.18%), ale A, czyli obecna kreacja, ma naprawdę tylko 1.00%.
Jak może zmylić. „Brak istotnej różnicy” nie znaczy, że kreacje są równe. Znaczy, że przy 5000 wyświetleń na kreację (ok. 50 kliknięć) test ma za małą moc, by odróżnić 1.0% od 1.2%. A sprzedaży nie zobaczysz wcale: cały test dał 7 zamówień.
Podpis do pracy:
Lepsze pytanie brzmi więc: ile średnio zarobię na teście z k kreacjami w porównaniu z wdrożeniem jednej kreacji bez testu?
Rysunek 2: szansa wyboru najlepszej i przyrost CTR
Symulujemy 20 000 testów dla każdego k od 1 do 10: losujemy prawdziwe CTR k kreacji z puli, dzielimy 20 000 wyświetleń po równo, losujemy kliknięcia i wybieramy kreację z najwyższym CTR. Znamy prawdę, więc widzimy, czy wybór był trafny.
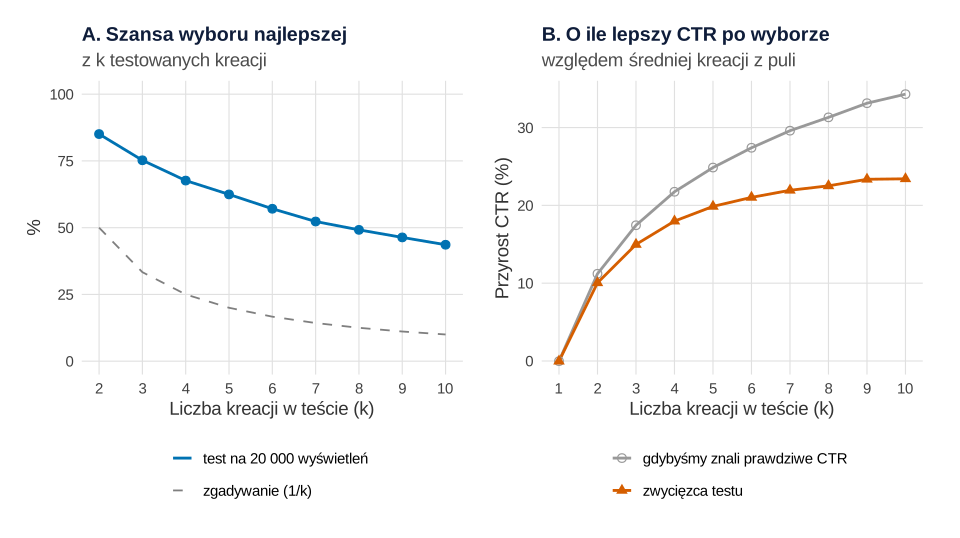
set.seed(6941)).Co widać. Przy dwóch kreacjach test wskazuje lepszą w 85.1% przypadków, przy czterech – w 67.6%, przy ośmiu – w 49.2% (błąd Monte Carlo ≤ 0.4 pp). Mimo to przyrost CTR rośnie: 10.0% przy dwóch, 18.0% przy czterech, 22.5% przy ośmiu kreacjach. Więcej kreacji to więcej szans na naprawdę dobrą, nawet jeśli nie zawsze ją rozpoznamy. Po ośmiu kreacjach krzywa jest prawie płaska (23.4% przy dziesięciu), a szara linia „gdybyśmy znali prawdę” odjeżdża coraz dalej (34.3%): różnicę zjada szum.
Jak może zmylić. Prawdopodobieństwo poprawnego wyboru jako kryterium planowania zaproponował Bechhofer (1954): liczbę obserwacji dobiera się tak, by przy zadanej różnicy średnich wskazać najlepszą populację z zadanym prawdopodobieństwem. Ale w biznesie liczy się, ile tracimy, gdy wybierzemy drugą w kolejności – czyli złotówki.
Podpis do pracy:
Rysunek 3: wartość informacji w złotówkach
Wartość informacji to różnica między oczekiwanym zyskiem z decyzją podjętą po teście a oczekiwanym zyskiem z decyzją bez testu. Howard (1966) pokazał, że zmniejszeniu niepewności można przypisać wartość liczbową, gdy łączy się prawdopodobieństwa ze skutkami ekonomicznymi decyzji. U nas „bez testu” znaczy: wdrażamy jedną kreację, której oczekiwany CTR to średnia puli. Faza testu daje średnio tyle samo kliknięć co bez testu, więc różnica powstaje we wdrożeniu:
gdzie W = 380 000 wyświetleń wdrożenia, CTR0 = 1%, v = 1.20 zł za kliknięcie, mzw – prawdziwy CTR zwycięzcy względem średniej (1.18 = o 18% lepszy), E[…] – wartość oczekiwana, czyli średnia z symulacji, a c = 120 zł – koszt każdej dodatkowej kreacji.
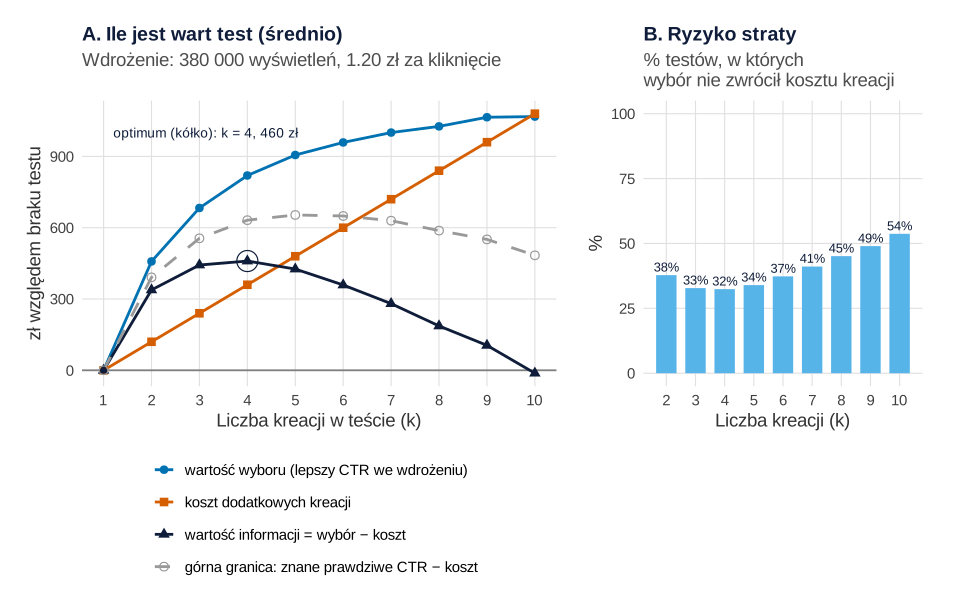
set.seed(6941)).Co widać. Wartość wyboru rośnie coraz wolniej (458 zł przy dwóch kreacjach, 820 zł przy czterech, 1068 zł przy dziesięciu), a koszt kreacji rośnie liniowo. Różnica, czyli wartość informacji, ma maksimum przy czterech kreacjach: 460 zł (błąd Monte Carlo ok. 6 zł) przy koszcie 360 zł. Trzy kreacje dają 443 zł, pięć – 426 zł: optimum jest płaskie. Przy dziesięciu kreacjach test średnio traci 12 zł. Przerywana linia to górna granica – wartość, gdyby test bezbłędnie wskazywał najlepszą (632 zł przy czterech kreacjach). Różnica to koszt pomyłki: przy czterech kreacjach średnio 172 zł, przy ośmiu – 401 zł.
Jak może zmylić. To średnia z wielu testów. W pojedynczym teście z czterema kreacjami w 32% przypadków zysk z wyboru nie pokrył kosztu kreacji (panel B). Wynik zależy od założeń (rysunki 5 i 6), więc policz go dla swoich liczb jako analizę wrażliwości. Podobnie myślą Feit i Berman (2019): traktują test A/B jako problem decyzyjny, w którym celem jest zysk, i z tego wyprowadzają liczebność próby. Jak dzielić cały budżet między kanały, opisuje wpis o podziale budżetu marketingowego.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: zwycięzca obiecuje więcej, niż da
Po teście zysk zwykle liczy się z CTR zwycięzcy w teście. To błąd, który rośnie z liczbą kreacji.
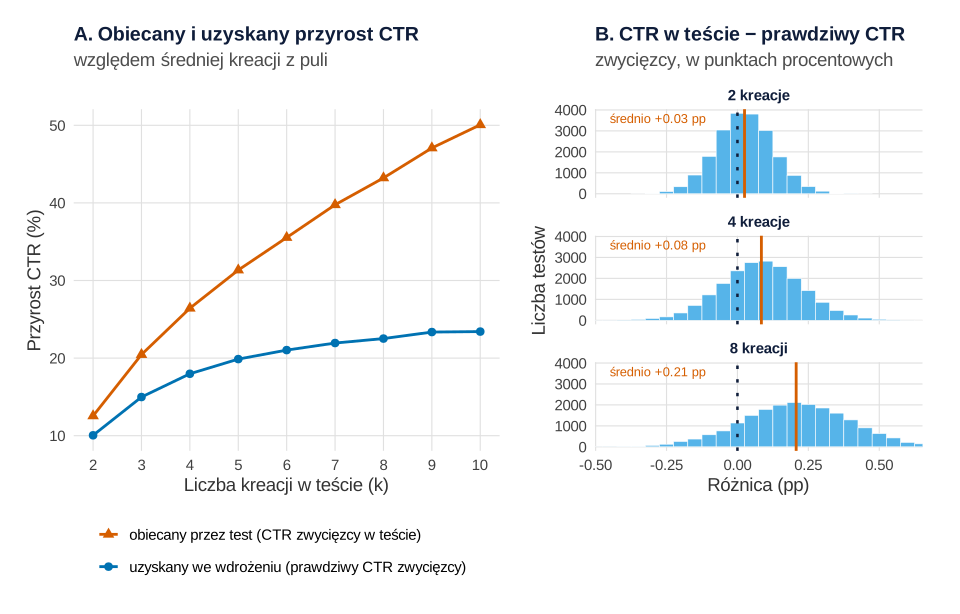
set.seed(6941)).Co widać. Przy czterech kreacjach zwycięzca miał w teście średnio CTR 1.26% i „obiecywał” +26.4%, a po wdrożeniu dał 1.18%, czyli +18.0%. Przy ośmiu kreacjach obietnica to +43.2%, a rzeczywistość +22.5%: CTR zwycięzcy jest zawyżony średnio o 0.21 pp, czyli o 16.9%.
Jak może zmylić. To klątwa zwycięzcy: wygrywa kreacja, której przypadek dodał kliknięć, więc wybrane oszacowanie jest zawyżone, a zwykły przedział ufności dla niego może być nieważny (Andrews i in., 2024). Zjawisko dotyczy też wdrożonych zmian na platformach eksperymentów (Lee i Shen, 2018). Przy wielu wariantach przyda się korekta i test potwierdzający – opisuje je wpis o teście A/B z wieloma wariantami i problemie wielokrotnych porównań.
Podpis do pracy:
Zdanie do Metody:
Rysunek 5: gdy kreacje są podobne i gdy CTR to nie sprzedaż
Panel A zmienia rozrzut prawdziwego CTR kreacji: od 5% („to samo zdjęcie, inny kolor przycisku”) do 35% („zupełnie różne pomysły”). W panelu B kreacje różnią się też konwersją kliknięć w zamówienia (rozrzut 20%), skorelowaną z CTR dodatnio, wcale albo ujemnie. Wybieramy po CTR – zamówień jest za mało (1.25 na kreację przy czterech kreacjach) – ale zysk liczymy z zamówień.
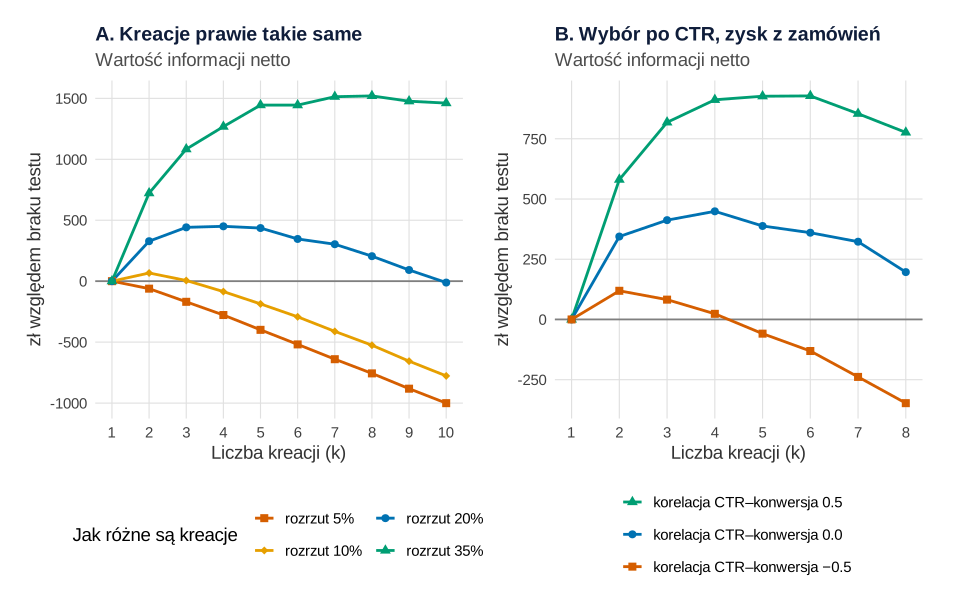
set.seed(6942) i set.seed(6943)).Co widać. Gdy kreacje są prawie takie same (rozrzut 5%), każdy test traci: −61 zł przy dwóch kreacjach, −278 zł przy czterech, −756 zł przy ośmiu. Przy rozrzucie 10% optimum to dwie kreacje (67 zł), przy 35% – osiem (1520 zł). Panel B: jeśli kreacje przyciągające kliknięcia przyciągają też kupujących (korelacja 0.5), test jest wart więcej (928 zł przy sześciu kreacjach). Jeśli jest odwrotnie (−0.5, np. krzykliwy rabat ściąga ciekawskich), optimum spada do dwóch kreacji i 119 zł, a od pięciu kreacji test przynosi stratę (−347 zł przy ośmiu).
Jak może zmylić. CTR jest tu wskaźnikiem zastępczym. W badaniach klinicznych pokazano, że efekt interwencji na wskaźniku zastępczym nie musi przewidywać efektu na wyniku, który naprawdę się liczy (Fleming i DeMets, 1996) – z kliknięciami i sprzedażą jest tak samo. Dlatego w eksperymentach online tyle uwagi poświęca się definiowaniu kluczowych metryk i ogólnego kryterium oceny (Kohavi i in., 2020). Jak liczyć CTR i jego przedział, gdy jedna osoba widzi reklamę wiele razy, opisuje wpis o wskaźnikach ilorazowych w testach A/B.
Podpis do pracy:
Rysunek 6: karta decyzji „ile wariantów”
Karta zbiera wynik dla trzech rozrzutów i trzech wielkości wdrożenia (osobna symulacja, 20 000 testów na punkt; stąd 440 zł zamiast 460 zł dla naszego sklepu – to błąd Monte Carlo). Optimum jest płaskie, więc podajemy zakres liczby kreacji z co najmniej 90% największej wartości.
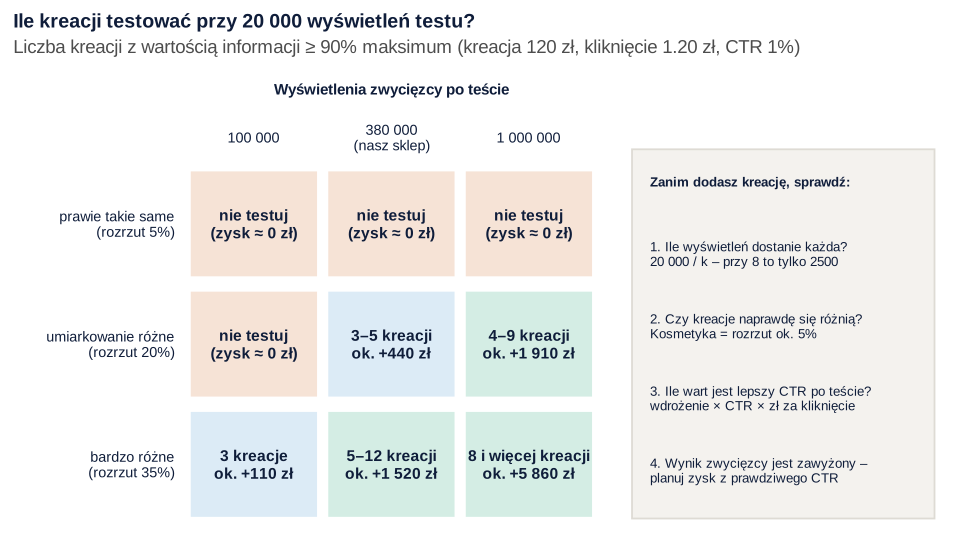
set.seed(6944)).Co widać. Liczbę kreacji wyznacza rozrzut kreacji i wielkość wdrożenia. Przy małym wdrożeniu (100 000 wyświetleń) i umiarkowanym rozrzucie test ledwo zwraca koszt jednej dodatkowej kreacji (3 zł na plusie). Przy milionie wyświetleń i bardzo różnych pomysłach opłaca się osiem i więcej kreacji (ok. 5860 zł).
Jak może zmylić. Karta działa dla naszych założeń: CTR 1%, 1.20 zł za kliknięcie, 120 zł za kreację i wybór po CTR bez korelacji z konwersją. Rozrzutu kreacji nie znasz dokładnie – oszacuj go z poprzednich testów sklepu (o ile różnił się najlepszy i najgorszy wariant) albo z pre-testu kreacji w ankiecie.
Podpis do pracy:
Co z tym zrobić w marketingu
- Zacznij od pieniędzy, nie od istotności. Policz wartość wdrożenia: wyświetlenia × CTR × wartość kliknięcia (w przykładzie 4560 zł). Test, który może poprawić CTR o kilkanaście procent, jest wart kilkaset złotych – nie więcej.
- Przy małym budżecie testuj 2–4 kreacje. Przy 20 000 wyświetleń osiem kreacji to tylko 2500 wyświetleń na każdą; więcej pomysłów nie nadrobi szumu (rysunki 2 i 3).
- Testuj pomysły, nie odcienie. Kreacje różniące się kolorem przycisku mają mały rozrzut, a test kosztuje więcej, niż daje (rysunek 5A). Różne obietnice (rabat, darmowa dostawa, zdjęcie łowiska) dają szansę na prawdziwą różnicę.
- Planuj zysk z prawdziwego CTR, nie z wyniku zwycięzcy. Obiecane +26% przy czterech kreacjach to po wdrożeniu +18% (rysunek 4).
- Sprawdzaj, czy kliknięcia kupują. Po wdrożeniu porównaj konwersję zwycięzcy z poprzednią kreacją na większym ruchu; przy podejrzeniu „klikalnej przynęty” testuj mniej kreacji (rysunek 5B). Wpływ samej reklamy na sprzedaż zmierzysz testem wyłączenia reklamy.
- Nie zaglądaj codziennie i nie przerywaj testu przy pierwszym prowadzeniu. Jeśli musisz, zaplanuj granice zatrzymania (sekwencyjny test A/B). Gdy ważniejsze jest zarabianie w trakcie niż wiedza, rozważ wielorękiego bandytę; pozostałe błędy pokazuje wpis pułapki testów A/B.
Jak opisać w pracy
Opisz budżet testu, liczbę kreacji i podział wyświetleń, regułę wyboru zwycięzcy, założenia symulacji (rozrzut kreacji, wartość kliknięcia, koszt kreacji, wielkość wdrożenia) i liczbę powtórzeń. Uczciwie nazwij ograniczenie: wynik zależy od założeń, więc pokaż analizę wrażliwości. Więcej o analizach w pracach z marketingu: statystyka w pracy z marketingu.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i parametry, przepis 2 – funkcję symuluj_test() i obiekt sym używane dalej. Przepisy 1–6 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Każdy blok, który losuje, zaczyna od własnego set.seed(): 694 w przepisie 1, 6941 w przepisie 2, 6942 i 6943 w przepisie 5, 6944 w przepisie 6; przepisy 3, 4 i 7 nie losują. Ziarna ustalono raz i nie zmieniano ich. Ręcznie ustalono (przepis 1): budżet testu 20 000 wyświetleń, wdrożenie 380 000 wyświetleń, średni CTR kreacji 1.0%, konwersję 2.5%, marżę 48 zł, koszt kreacji 120 zł i prawdziwe CTR czterech kreacji przykładu (1.00, 0.92, 1.18 i 1.08%); w przepisie 2: rozrzut prawdziwego CTR kreacji 0.20 (odchylenie standardowe na skali logarytmu) i 20 000 powtórzeń; w przepisie 5: rozrzuty 0.05–0.35, rozrzut konwersji 0.20, korelacje −0.5, 0 i 0.5, 10 000 powtórzeń; w przepisie 6: trzy wielkości wdrożenia i 20 000 powtórzeń. Po pierwszym uruchomieniu nie zmieniano parametrów danych. Zmieniono tylko sposób liczenia i prezentacji: punkt „bez testu” (k = 1) ustawiono na 0 zł z definicji zamiast wyniku symulacji (−1 zł, błąd MC 7 zł); w karcie rozszerzono zakres do 16 kreacji i zamiast jednego optimum podano zakres ≥ 90% maksimum, bo pojedyncze optimum zależało od błędu Monte Carlo (przy rozrzucie 35% i 380 000 wyświetleń zależnie od symulacji 6, 8 albo 9 kreacji); przesunięto też etykiety na rysunkach 3, 4 i 6. Wszystkie przepisy liczą się w kilka sekund.
1. Dane przykładowego testu: Rysunek 1
R
# Rysunek 1. Fikcyjny sklep z akcesoriami wędkarskimi: test 4 kreacji na 20 000 wyświetleniach
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", pomaranczowy = "#D55E00", blekit = "#56B4E9", zielony = "#009E73",
         zolty = "#E69F00", rozowy = "#CC79A7", szary = "#999999", granat = "#0f1d3a")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustawione ręcznie (wspólne dla przepisów 2–6):
budzet_testu <- 20000        # wyświetleń przeznaczonych na test, dzielonych po równo między kreacje
wdrozenie    <- 380000       # wyświetleń zwycięskiej kreacji do końca sezonu
ctr0         <- 0.010        # średni CTR kreacji z „puli pomysłów” (1.0%)
konw         <- 0.025        # odsetek kliknięć kończących się zamówieniem
marza        <- 48           # średnia marża z zamówienia, zł
wart_klik    <- konw * marza # wartość jednego kliknięcia: 1.20 zł
koszt_kreacji <- 120         # koszt przygotowania każdej dodatkowej kreacji, zł

# Przykładowy test: 4 kreacje po 5000 wyświetleń przez 14 dni.
# Prawdziwe CTR ustawione ręcznie (w prawdziwym teście ich nie znamy).
kreacje <- data.frame(
  kreacja = c("A", "B", "C", "D"),
  opis = c("obecna: zestaw spinningowy –15%", "zdjęcie szczupaka z woblerem",
           "ręcznie malowane woblery", "darmowa dostawa od 99 zł"),
  ctr_prawdziwy = c(0.0100, 0.0092, 0.0118, 0.0108))
set.seed(694)
dni <- expand.grid(dzien = 1:14, kreacja = kreacje$kreacja, stringsAsFactors = FALSE)
dni$wyswietlenia <- ifelse(dni$dzien <= 2, 358, 357)            # 5000 wyświetleń na kreację
dni$ctr_prawdziwy <- kreacje$ctr_prawdziwy[match(dni$kreacja, kreacje$kreacja)]
dni$klikniecia <- rbinom(nrow(dni), dni$wyswietlenia, dni$ctr_prawdziwy)
dni$zamowienia <- rbinom(nrow(dni), dni$klikniecia, konw)
write.csv(dni[c("dzien", "kreacja", "wyswietlenia", "klikniecia", "zamowienia")],
          "ile-kreacji-test-4-kreacji-wedkarstwo.csv", row.names = FALSE)

wynik <- aggregate(cbind(wyswietlenia, klikniecia, zamowienia) ~ kreacja, data = dni, FUN = sum)
ci <- t(mapply(function(x, n) prop.test(x, n, correct = FALSE)$conf.int, wynik$klikniecia, wynik$wyswietlenia))
wynik$ctr <- wynik$klikniecia / wynik$wyswietlenia
wynik$dolna <- ci[, 1]
wynik$gorna <- ci[, 2]
wynik$opis <- kreacje$opis
print(cbind(wynik[1:4], round(100 * wynik[c("ctr", "dolna", "gorna")], 2)), row.names = FALSE)
tabela <- cbind(klik = wynik$klikniecia, brak = wynik$wyswietlenia - wynik$klikniecia)
test4 <- chisq.test(tabela)
cat("Test chi-kwadrat równości CTR 4 kreacji: chi2 =", round(test4$statistic, 2), "df =", test4$parameter,
    "p =", sub("^0", "", formatC(test4$p.value, format = "f", digits = 3)), "\n")
cat("Najwyższy CTR w teście:", wynik$kreacja[wynik$ctr == max(wynik$ctr)], "| prawdziwie najlepsza:",
    kreacje$kreacja[which.max(kreacje$ctr_prawdziwy)], "\n")
cat("Wartość kliknięcia:", wart_klik, "zł | zamówień w całym teście:", sum(wynik$zamowienia), "\n")

wynik$etykieta <- paste0(wynik$kreacja, ": ", wynik$opis)
wynik$etykieta <- factor(wynik$etykieta, levels = rev(wynik$etykieta))
wynik$prawda <- kreacje$ctr_prawdziwy
p1 <- ggplot(wynik, aes(y = etykieta)) +
  geom_vline(xintercept = 100 * ctr0, colour = "grey60") +
  geom_errorbar(aes(xmin = 100 * dolna, xmax = 100 * gorna), width = 0.25, orientation = "y",
                colour = kol[["niebieski"]], linewidth = 0.8) +
  geom_point(aes(x = 100 * ctr, shape = "CTR w teście (95% CI)"), size = 3.4, colour = kol[["niebieski"]]) +
  geom_point(aes(x = 100 * prawda, shape = "prawdziwy CTR (znany tylko w symulacji)"), size = 3.2,
             colour = kol[["pomaranczowy"]], stroke = 1.2) +
  geom_text(aes(x = 100 * gorna + 0.04, label = paste0(klikniecia, " klik.")), hjust = 0, size = 3.6,
            colour = "#0f1d3a") +
  scale_shape_manual(values = c(16, 4), name = NULL) +
  coord_cartesian(xlim = c(0.55, 1.75)) +
  labs(title = "Test 4 kreacji: 20 000 wyświetleń, po 5000 na kreację",
       subtitle = "Przedziały 95% (Wilsona) mocno się nakładają",
       x = "CTR (%)", y = NULL) +
  motyw
p1                       # do pliku: ggsave("ile-kreacji-test-4-kreacji.svg", p1, width = 10, height = 4.8)
Wynik w R
 kreacja wyswietlenia klikniecia zamowienia  ctr dolna gorna
       A         5000         56          1 1.12  0.86  1.45
       B         5000         49          2 0.98  0.74  1.29
       C         5000         56          2 1.12  0.86  1.45
       D         5000         50          2 1.00  0.76  1.32
Test chi-kwadrat równości CTR 4 kreacji: chi2 = 0.82 df = 3 p = .845
Najwyższy CTR w teście: A C | prawdziwie najlepsza: C
Wartość kliknięcia: 1.2 zł | zamówień w całym teście: 7
2. Symulacja testów z k kreacjami: Rysunek 2
R
# Rysunek 2. Ile kreacji przy 20 000 wyświetleń: szansa wyboru najlepszej i przyrost CTR
# (korzysta z kol, motyw i parametrów z przepisu 1)
library(ggplot2)
library(patchwork)

# Jeden test z k kreacjami, powtórzony R razy. Prawdziwe CTR kreacji losujemy z „puli pomysłów”:
#   CTR = ctr0 × mnożnik, mnożnik log-normalny o średniej 1 i rozrzucie sd_kre (0.20 ≈ kreacje różnią się
#   typowo o ±20%). Opcjonalnie kreacje różnią się też konwersją kliknięć w zamówienia (sd_konw)
#   skorelowaną z mnożnikiem CTR (rho). Wyświetlenia testu dzielimy po równo; wygrywa najwyższy CTR w teście.
symuluj_test <- function(k, R, n_test = budzet_testu, sd_kre = 0.20, sd_konw = 0, rho = 0) {
  n <- floor(n_test / k)
  z1 <- matrix(rnorm(R * k), R, k)
  z2 <- matrix(rnorm(R * k), R, k)
  m_ctr <- exp(sd_kre * z1 - sd_kre^2 / 2)
  m_konw <- exp(sd_konw * (rho * z1 + sqrt(1 - rho^2) * z2) - sd_konw^2 / 2)
  klik <- matrix(rbinom(R * k, n, ctr0 * m_ctr), R, k)
  wyb <- if (k == 1) rep(1L, R) else max.col(klik, ties.method = "random")
  naj <- max.col(m_ctr)
  idx <- cbind(seq_len(R), wyb)
  data.frame(k = k, trafiony = wyb == naj,
             m_wyb = m_ctr[idx],                                    # prawdziwy mnożnik CTR zwycięzcy
             m_naj = m_ctr[cbind(seq_len(R), naj)],                 # najlepszy z testowanych (gdybyśmy znali prawdę)
             m_obs = klik[idx] / n / ctr0,                          # CTR zwycięzcy w teście / ctr0
             w_wyb = m_ctr[idx] * m_konw[idx],                      # wartość wyświetlenia zwycięzcy (CTR × konwersja)
             w_los = m_ctr[, 1] * m_konw[, 1],                      # wartość kreacji wybranej bez testu
             w_naj_konw = apply(m_ctr * m_konw, 1, max))            # najlepsza pod względem zamówień
}

set.seed(6941)
R <- 20000
sym <- do.call(rbind, lapply(1:10, function(k) symuluj_test(k, R)))
tab <- do.call(rbind, lapply(split(sym, sym$k), function(d) data.frame(
  k = d$k[1], wysw_na_kreacje = floor(budzet_testu / d$k[1]),
  P_najlepsza = mean(d$trafiony), bladMC_P = sqrt(mean(d$trafiony) * (1 - mean(d$trafiony)) / R),
  przyrost_wybor = 100 * (mean(d$m_wyb) - 1), przyrost_prawda = 100 * (mean(d$m_naj) - 1),
  bladMC_przyrost = 100 * sd(d$m_wyb) / sqrt(R))))
print(round(tab, 3), row.names = FALSE)
cat("Losowa szansa wskazania najlepszej (1/k) dla k = 2, 4, 8:", round(1 / c(2, 4, 8), 3), "\n")

tab_d <- subset(tab, k >= 2)
pA <- ggplot(tab_d, aes(k, 100 * P_najlepsza)) +
  geom_line(aes(y = 100 / k, linetype = "zgadywanie (1/k)"), colour = "grey50") +
  geom_line(aes(linetype = "test na 20 000 wyświetleń"), colour = kol[["niebieski"]], linewidth = 1) +
  geom_point(colour = kol[["niebieski"]], size = 2.6) +
  scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  scale_x_continuous(breaks = 2:10) + scale_y_continuous(limits = c(0, 100)) +
  labs(title = "A. Szansa wyboru najlepszej", subtitle = "z k testowanych kreacji",
       x = "Liczba kreacji w teście (k)", y = "%") + motyw +
  guides(linetype = guide_legend(nrow = 2))
dl <- rbind(data.frame(k = tab$k, przyrost = tab$przyrost_prawda, co = "gdybyśmy znali prawdziwe CTR"),
            data.frame(k = tab$k, przyrost = tab$przyrost_wybor, co = "zwycięzca testu"))
pB <- ggplot(dl, aes(k, przyrost, colour = co, shape = co)) +
  geom_line(linewidth = 1) + geom_point(size = 2.6) +
  scale_colour_manual(values = c(kol[["szary"]], kol[["pomaranczowy"]]), name = NULL) +
  scale_shape_manual(values = c(1, 17), name = NULL) +
  scale_x_continuous(breaks = 1:10) +
  labs(title = "B. O ile lepszy CTR po wyborze", subtitle = "względem średniej kreacji z puli",
       x = "Liczba kreacji w teście (k)", y = "Przyrost CTR (%)") + motyw +
  guides(colour = guide_legend(nrow = 2), shape = guide_legend(nrow = 2))
p2 <- pA + pB
p2                       # do pliku: ggsave("ile-kreacji-szansa-i-przyrost.svg", p2, width = 10, height = 5.6)
Wynik w R
  k wysw_na_kreacje P_najlepsza bladMC_P przyrost_wybor przyrost_prawda
  1           20000       1.000    0.000         -0.022          -0.022
  2           10000       0.851    0.003         10.048          11.210
  3            6666       0.752    0.003         14.980          17.445
  4            5000       0.676    0.003         17.978          21.749
  5            4000       0.624    0.003         19.870          24.860
  6            3333       0.571    0.003         21.029          27.401
  7            2857       0.523    0.004         21.940          29.598
  8            2500       0.492    0.004         22.512          31.313
  9            2222       0.464    0.004         23.354          33.132
 10            2000       0.436    0.004         23.414          34.295
 bladMC_przyrost
           0.143
           0.137
           0.135
           0.138
           0.140
           0.143
           0.144
           0.146
           0.148
           0.148
Losowa szansa wskazania najlepszej (1/k) dla k = 2, 4, 8: 0.5 0.25 0.125
3. Wartość informacji i koszt pomyłki: Rysunek 3
R
# Rysunek 3. Wartość informacji: oczekiwany zysk z testu k kreacji wobec braku testu
# (korzysta z kol, motyw, parametrów z przepisu 1 i obiektów sym, R z przepisu 2 – bez nowego losowania)
library(ggplot2)
library(patchwork)

zl_na_pkt <- wdrozenie * ctr0 * wart_klik          # wartość wdrożenia średniej kreacji: 4560 zł
cat("Wartość kliknięć we wdrożeniu przy średniej kreacji:", zl_na_pkt, "zł\n")
# Brak testu = wdrażamy jedną kreację bez porównania (jej oczekiwany CTR to średnia puli, mnożnik 1).
# Faza testu daje średnio tyle samo kliknięć co bez testu (średnia z k kreacji = średnia puli), więc liczymy
# różnicę tylko we wdrożeniu: wartość wyboru – koszt dodatkowych kreacji.
# k = 1 (brak testu) to punkt odniesienia: 0 zł z definicji (oczekiwany mnożnik losowej kreacji = 1)
sym$wybor_zl <- ifelse(sym$k == 1, 0, zl_na_pkt * (sym$m_wyb - 1))
sym$pelna_zl <- ifelse(sym$k == 1, 0, zl_na_pkt * (sym$m_naj - 1))
sym$koszt_zl <- koszt_kreacji * (sym$k - 1)
sym$netto <- sym$wybor_zl - sym$koszt_zl
sym$pomylka_zl <- zl_na_pkt * (sym$m_naj - sym$m_wyb)    # koszt pomyłki: strata wobec najlepszej z testowanych

wart <- do.call(rbind, lapply(split(sym, sym$k), function(d) data.frame(
  k = d$k[1], wartosc_wyboru = mean(d$wybor_zl), koszt = d$koszt_zl[1],
  wartosc_informacji = mean(d$netto), bladMC = sd(d$netto) / sqrt(R),
  pelna_informacja = mean(d$pelna_zl) - d$koszt_zl[1], koszt_pomylki = mean(d$pomylka_zl),
  P_strata = mean(d$netto < 0))))
print(round(wart, 2), row.names = FALSE)
k_opt <- wart$k[which.max(wart$wartosc_informacji)]
cat("Optimum liczby kreacji:", k_opt, "| wartość informacji:", round(max(wart$wartosc_informacji)),
    "zł | test kosztuje", wart$koszt[wart$k == k_opt], "zł\n")
cat("Zwrot z kosztu kreacji przy optimum:", round(max(wart$wartosc_informacji) / wart$koszt[wart$k == k_opt], 2), "\n")

dl <- rbind(data.frame(k = wart$k, zl = wart$wartosc_wyboru, co = "wartość wyboru (lepszy CTR we wdrożeniu)"),
            data.frame(k = wart$k, zl = wart$koszt, co = "koszt dodatkowych kreacji"),
            data.frame(k = wart$k, zl = wart$wartosc_informacji, co = "wartość informacji = wybór − koszt"),
            data.frame(k = wart$k, zl = wart$pelna_informacja, co = "górna granica: znane prawdziwe CTR − koszt"))
dl$co <- factor(dl$co, levels = unique(dl$co))
pA <- ggplot(dl, aes(k, zl, colour = co, shape = co, linetype = co)) +
  geom_hline(yintercept = 0, colour = "grey50") +
  geom_line(linewidth = 1) + geom_point(size = 2.6) +
  annotate("point", x = k_opt, y = max(wart$wartosc_informacji), size = 7, shape = 1, colour = "#0f1d3a") +
  annotate("text", x = 1.2, y = 1000, hjust = 0, size = 3.6, colour = "#0f1d3a",
           label = sprintf("optimum (kółko): k = %d, %.0f zł", k_opt, max(wart$wartosc_informacji))) +
  scale_colour_manual(values = c(kol[["niebieski"]], kol[["pomaranczowy"]], kol[["granat"]], kol[["szary"]]), name = NULL) +
  scale_shape_manual(values = c(16, 15, 17, 1), name = NULL) +
  scale_linetype_manual(values = c("solid", "solid", "solid", "dashed"), name = NULL) +
  scale_x_continuous(breaks = 1:10) +
  labs(title = "A. Ile jest wart test (średnio)", subtitle = "Wdrożenie: 380 000 wyświetleń, 1.20 zł za kliknięcie",
       x = "Liczba kreacji w teście (k)", y = "zł względem braku testu") +
  motyw + guides(colour = guide_legend(ncol = 1))
pB <- ggplot(subset(wart, k >= 2), aes(k, 100 * P_strata)) +
  geom_col(fill = kol[["blekit"]], width = 0.7) +
  geom_text(aes(label = sprintf("%.0f%%", 100 * P_strata)), vjust = -0.4, size = 3.4, colour = "#0f1d3a") +
  scale_x_continuous(breaks = 2:10) + scale_y_continuous(limits = c(0, 100)) +
  labs(title = "B. Ryzyko straty", subtitle = "% testów, w których\nwybór nie zwrócił kosztu kreacji",
       x = "Liczba kreacji (k)", y = "%") + motyw
p3 <- pA + pB + plot_layout(widths = c(1.7, 1))
p3                       # do pliku: ggsave("ile-kreacji-wartosc-informacji.svg", p3, width = 10, height = 6.4)
Wynik w R
Wartość kliknięć we wdrożeniu przy średniej kreacji: 4560 zł
  k wartosc_wyboru koszt wartosc_informacji bladMC pelna_informacja
  1           0.00     0               0.00   0.00             0.00
  2         458.17   120             338.17   6.25           391.18
  3         683.10   240             443.10   6.18           555.50
  4         819.81   360             459.81   6.31           631.77
  5         906.06   480             426.06   6.38           653.63
  6         958.94   600             358.94   6.50           649.50
  7        1000.47   720             280.47   6.59           629.69
  8        1026.57   840             186.57   6.64           587.88
  9        1064.94   960             104.94   6.74           550.83
 10        1067.69  1080             -12.31   6.74           483.87
 koszt_pomylki P_strata
          0.00     0.00
         53.01     0.38
        112.40     0.33
        171.96     0.32
        227.57     0.34
        290.56     0.37
        349.22     0.41
        401.31     0.45
        445.89     0.49
        496.18     0.54
Optimum liczby kreacji: 4 | wartość informacji: 460 zł | test kosztuje 360 zł
Zwrot z kosztu kreacji przy optimum: 1.28
4. Klątwa zwycięzcy: Rysunek 4
R
# Rysunek 4. Klątwa zwycięzcy: CTR zwycięzcy w teście a jego prawdziwy CTR
# (korzysta z kol, motyw, ctr0 z przepisu 1 i obiektu sym z przepisu 2 – bez nowego losowania)
library(ggplot2)
library(patchwork)

kl <- do.call(rbind, lapply(split(subset(sym, k >= 2), subset(sym, k >= 2)$k), function(d) data.frame(
  k = d$k[1], ctr_w_tescie = 100 * ctr0 * mean(d$m_obs), ctr_prawdziwy = 100 * ctr0 * mean(d$m_wyb),
  zapowiedz = 100 * (mean(d$m_obs) - 1), realnie = 100 * (mean(d$m_wyb) - 1),
  zawyzenie_pp = 100 * ctr0 * mean(d$m_obs - d$m_wyb))))
kl$zawyzenie_proc <- 100 * (kl$ctr_w_tescie / kl$ctr_prawdziwy - 1)
print(round(kl, 3), row.names = FALSE)

dl <- rbind(data.frame(k = kl$k, przyrost = kl$zapowiedz, co = "obiecany przez test (CTR zwycięzcy w teście)"),
            data.frame(k = kl$k, przyrost = kl$realnie, co = "uzyskany we wdrożeniu (prawdziwy CTR zwycięzcy)"))
pA <- ggplot(dl, aes(k, przyrost, colour = co, shape = co)) +
  geom_line(linewidth = 1) + geom_point(size = 2.6) +
  scale_colour_manual(values = c(kol[["pomaranczowy"]], kol[["niebieski"]]), name = NULL) +
  scale_shape_manual(values = c(17, 16), name = NULL) +
  scale_x_continuous(breaks = 2:10) +
  labs(title = "A. Obiecany i uzyskany przyrost CTR", subtitle = "względem średniej kreacji z puli",
       x = "Liczba kreacji w teście (k)", y = "Przyrost CTR (%)") +
  motyw + guides(colour = guide_legend(ncol = 1), shape = guide_legend(ncol = 1))
roz <- subset(sym, k %in% c(2, 4, 8))
roz$roznica <- 100 * ctr0 * (roz$m_obs - roz$m_wyb)
roz$panel <- factor(paste(roz$k, "kreacje"), levels = paste(c(2, 4, 8), "kreacje"))
levels(roz$panel)[3] <- "8 kreacji"
sr <- aggregate(roznica ~ panel, data = roz, FUN = mean)
pB <- ggplot(roz, aes(roznica)) +
  geom_histogram(binwidth = 0.05, fill = kol[["blekit"]], colour = "white", linewidth = 0.2) +
  geom_vline(xintercept = 0, linetype = "dotted", linewidth = 0.9, colour = "#0f1d3a") +
  geom_vline(data = sr, aes(xintercept = roznica), colour = kol[["pomaranczowy"]], linewidth = 1) +
  geom_text(data = sr, aes(x = -0.45, y = Inf, label = sprintf("średnio +%.2f pp", roznica)), vjust = 1.5,
            hjust = 0, size = 3.4, colour = kol[["pomaranczowy"]]) +
  facet_wrap(~ panel, ncol = 1) + coord_cartesian(xlim = c(-0.45, 0.6)) +
  labs(title = "B. CTR w teście − prawdziwy CTR", subtitle = "zwycięzcy, w punktach procentowych",
       x = "Różnica (pp)", y = "Liczba testów") + motyw
p4 <- pA + pB + plot_layout(widths = c(1.3, 1))
p4                       # do pliku: ggsave("ile-kreacji-klatwa-zwyciezcy.svg", p4, width = 10, height = 6.4)
Wynik w R
  k ctr_w_tescie ctr_prawdziwy zapowiedz realnie zawyzenie_pp zawyzenie_proc
  2        1.125         1.100    12.549  10.048        0.025          2.273
  3        1.205         1.150    20.452  14.980        0.055          4.758
  4        1.264         1.180    26.424  17.978        0.084          7.159
  5        1.313         1.199    31.342  19.870        0.115          9.571
  6        1.355         1.210    35.532  21.029        0.145         11.983
  7        1.398         1.219    39.759  21.940        0.178         14.613
  8        1.432         1.225    43.215  22.512        0.207         16.898
  9        1.471         1.234    47.076  23.354        0.237         19.231
 10        1.501         1.234    50.069  23.414        0.267         21.598
5. Kreacje prawie takie same i CTR zamiast sprzedaży: Rysunek 5
R
# Rysunek 5. Pułapki: kreacje prawie takie same (A) i CTR zamiast sprzedaży (B)
# (korzysta z kol, motyw, parametrów z przepisu 1 i funkcji symuluj_test z przepisu 2)
library(ggplot2)
library(patchwork)

zl_na_pkt <- wdrozenie * ctr0 * wart_klik
R2 <- 10000
# A: jak bardzo różnią się kreacje w puli (rozrzut prawdziwego CTR), wartość informacji netto
set.seed(6942)
rozrzuty <- c(0.05, 0.10, 0.20, 0.35)
wA <- do.call(rbind, lapply(rozrzuty, function(s) do.call(rbind, lapply(1:10, function(k) {
  d <- symuluj_test(k, R2, sd_kre = s)
  data.frame(sd_kre = s, k = k,                     # k = 1 (brak testu): 0 zł z definicji
             wartosc = if (k == 1) 0 else mean(zl_na_pkt * (d$m_wyb - 1)) - koszt_kreacji * (k - 1))
}))))
optA <- do.call(rbind, lapply(split(wA, wA$sd_kre), function(d) d[which.max(d$wartosc), ]))
print(transform(optA, wartosc = round(wartosc, 1)), row.names = FALSE)
cat("Wartość informacji przy rozrzucie 0.05 dla k = 2, 4, 8:",
    round(wA$wartosc[wA$sd_kre == 0.05 & wA$k %in% c(2, 4, 8)]), "zł\n")

# B: kreacje różnią się też konwersją kliknięć w zamówienia (rozrzut 0.20), skorelowaną z CTR (rho);
#    wybieramy po CTR (zamówień w teście jest za mało), a liczymy zysk z zamówień
set.seed(6943)
rho_s <- c(0.5, 0, -0.5)
wB <- do.call(rbind, lapply(rho_s, function(r) do.call(rbind, lapply(1:8, function(k) {
  d <- symuluj_test(k, R2, sd_konw = 0.20, rho = r)
  data.frame(rho = r, k = k, wartosc = mean(zl_na_pkt * (d$w_wyb - d$w_los)) - koszt_kreacji * (k - 1),
             bladMC = sd(zl_na_pkt * (d$w_wyb - d$w_los)) / sqrt(R2))
}))))
print(round(wB, 1), row.names = FALSE)
optB <- do.call(rbind, lapply(split(wB, wB$rho), function(d) d[which.max(d$wartosc), ]))
print(transform(optB, wartosc = round(wartosc, 1), bladMC = round(bladMC, 1)), row.names = FALSE)
cat("Zamówień w teście na kreację przy k = 4:", budzet_testu / 4 * ctr0 * konw, "\n")

wA$scen <- factor(sprintf("rozrzut %.0f%%", 100 * wA$sd_kre), levels = sprintf("rozrzut %.0f%%", 100 * rozrzuty))
pA <- ggplot(wA, aes(k, wartosc, colour = scen, shape = scen)) +
  geom_hline(yintercept = 0, colour = "grey50") +
  geom_line(linewidth = 1) + geom_point(size = 2.4) +
  scale_colour_manual(values = c(kol[["pomaranczowy"]], kol[["zolty"]], kol[["niebieski"]], kol[["zielony"]]),
                      name = "Jak różne są kreacje") +
  scale_shape_manual(values = c(15, 18, 16, 17), name = "Jak różne są kreacje") +
  scale_x_continuous(breaks = 1:10) +
  labs(title = "A. Kreacje prawie takie same", subtitle = "Wartość informacji netto",
       x = "Liczba kreacji (k)", y = "zł względem braku testu") +
  motyw + guides(colour = guide_legend(nrow = 2), shape = guide_legend(nrow = 2))
wB$scen <- factor(sprintf("korelacja CTR–konwersja %s", sub("-", "−", format(wB$rho))),
                  levels = sprintf("korelacja CTR–konwersja %s", sub("-", "−", format(rho_s))))
pB <- ggplot(wB, aes(k, wartosc, colour = scen, shape = scen)) +
  geom_hline(yintercept = 0, colour = "grey50") +
  geom_line(linewidth = 1) + geom_point(size = 2.4) +
  scale_colour_manual(values = c(kol[["zielony"]], kol[["niebieski"]], kol[["pomaranczowy"]]), name = NULL) +
  scale_shape_manual(values = c(17, 16, 15), name = NULL) +
  scale_x_continuous(breaks = 1:8) + scale_y_continuous(breaks = seq(-500, 1000, 250)) +
  labs(title = "B. Wybór po CTR, zysk z zamówień", subtitle = "Wartość informacji netto",
       x = "Liczba kreacji (k)", y = "zł względem braku testu") +
  motyw + guides(colour = guide_legend(ncol = 1), shape = guide_legend(ncol = 1))
p5 <- pA + pB
p5                       # do pliku: ggsave("ile-kreacji-pulapki.svg", p5, width = 10, height = 6.4)
Wynik w R
 sd_kre k wartosc
   0.05 1     0.0
   0.10 2    67.2
   0.20 4   450.0
   0.35 8  1519.9
Wartość informacji przy rozrzucie 0.05 dla k = 2, 4, 8: -61 -278 -756 zł
  rho k wartosc bladMC
  0.5 1     0.0    0.0
  0.5 2   580.7   15.1
  0.5 3   818.3   18.2
  0.5 4   911.9   20.0
  0.5 5   926.7   20.9
  0.5 6   928.0   22.3
  0.5 7   854.1   22.5
  0.5 8   776.3   23.3
  0.0 1     0.0    0.0
  0.0 2   344.3   12.3
  0.0 3   412.2   14.6
  0.0 4   448.9   15.9
  0.0 5   388.0   16.6
  0.0 6   360.1   17.5
  0.0 7   322.8   17.8
  0.0 8   196.6   18.3
 -0.5 1     0.0    0.0
 -0.5 2   119.0    8.9
 -0.5 3    82.3   10.4
 -0.5 4    23.4   11.0
 -0.5 5   -58.9   11.6
 -0.5 6  -131.0   11.7
 -0.5 7  -238.4   12.1
 -0.5 8  -347.4   12.1
  rho k wartosc bladMC
 -0.5 2   119.0    8.9
  0.0 4   448.9   15.9
  0.5 6   928.0   22.3
Zamówień w teście na kreację przy k = 4: 1.25
6. Karta decyzji „ile wariantów”: Rysunek 6
R
# Rysunek 6. Karta decyzji „ile wariantów”: optimum k dla wielkości wdrożenia i rozrzutu kreacji
# (korzysta z kol, motyw, parametrów z przepisu 1 i funkcji symuluj_test z przepisu 2)
library(ggplot2)

# Średni przyrost CTR zwycięzcy (mnożnik − 1) dla k = 1…16 i trzech rozrzutów; wartość informacji rośnie
# liniowo z liczbą wyświetleń wdrożenia, więc jedna symulacja wystarcza dla każdego wdrożenia.
set.seed(6944)
R3 <- 20000
rozrzuty <- c(0.05, 0.20, 0.35)
wdrozenia <- c(100000, 380000, 1000000)
przyrost <- do.call(rbind, lapply(rozrzuty, function(s) data.frame(
  sd_kre = s, k = 1:16, g = sapply(1:16, function(k)       # k = 1 (brak testu): przyrost 0 z definicji
    if (k == 1) 0 else mean(symuluj_test(k, R3, sd_kre = s)$m_wyb) - 1))))
# Optimum jest płaskie, więc na karcie podajemy zakres k z wartością co najmniej 90% maksimum;
# gdy maksimum < 50 zł (mniej niż pół kosztu jednej kreacji) – „nie testuj”
siatka <- do.call(rbind, lapply(wdrozenia, function(D) {
  x <- przyrost
  x$D <- D
  x$wartosc <- D * ctr0 * wart_klik * x$g - koszt_kreacji * (x$k - 1)
  do.call(rbind, lapply(split(x, x$sd_kre), function(d) {
    dobre <- d$k[d$wartosc >= 0.9 * max(d$wartosc)]
    data.frame(D = D, sd_kre = d$sd_kre[1], k_opt = d$k[which.max(d$wartosc)], wartosc = max(d$wartosc),
               k_od = min(dobre), k_do = max(dobre))
  }))
}))
print(data.frame(wdrozenie = siatka$D, rozrzut = siatka$sd_kre, k_opt = siatka$k_opt,
                 wartosc_zl = round(siatka$wartosc), zakres_90proc = paste(siatka$k_od, siatka$k_do, sep = "–")),
      row.names = FALSE)

siatka$x <- match(siatka$D, wdrozenia)
siatka$y <- match(siatka$sd_kre, rev(rozrzuty))
zakres <- ifelse(siatka$k_do == 16, paste0(siatka$k_od, " i więcej"),
                 ifelse(siatka$k_od == siatka$k_do, siatka$k_od, paste0(siatka$k_od, "–", siatka$k_do)))
siatka$etykieta <- ifelse(siatka$wartosc < 50, "nie testuj\n(zysk ≈ 0 zł)",
                          sprintf("%s kreacji\nok. +%s zł", zakres, trimws(format(round(siatka$wartosc, -1), big.mark = " "))))
siatka$etykieta <- sub("^([2-4]|[2-4]–[2-4]) kreacji", "\\1 kreacje", siatka$etykieta)
siatka$tlo <- ifelse(siatka$wartosc < 50, "#f6e3d6", ifelse(siatka$k_opt <= 4, "#dcebf6", "#d4ede4"))
reguly <- data.frame(y = c(3.35, 2.75, 2.15, 1.55, 0.95), tekst = c(
  "Zanim dodasz kreację, sprawdź:",
  "1. Ile wyświetleń dostanie każda?\n   20 000 / k – przy 8 to tylko 2500",
  "2. Czy kreacje naprawdę się różnią?\n   Kosmetyka = rozrzut ok. 5%",
  "3. Ile wart jest lepszy CTR po teście?\n   wdrożenie × CTR × zł za kliknięcie",
  "4. Wynik zwycięzcy jest zawyżony –\n   planuj zysk z prawdziwego CTR"))
p6 <- ggplot() +
  geom_tile(data = siatka, aes(x, y), fill = siatka$tlo, colour = "white", linewidth = 2, width = 0.96, height = 0.92) +
  geom_text(data = siatka, aes(x, y, label = etykieta), size = 4.1, lineheight = 0.95, colour = "#0f1d3a",
            fontface = "bold") +
  annotate("text", x = 1:3, y = 3.72, label = c("100 000", "380 000\n(nasz sklep)", "1 000 000"), size = 3.8,
           lineheight = 0.9, colour = "#0f1d3a") +
  annotate("text", x = 2, y = 4.12, label = "Wyświetlenia zwycięzcy po teście", size = 4, fontface = "bold",
           colour = "#0f1d3a") +
  annotate("text", x = 0.42, y = 3:1, hjust = 1, size = 3.8, lineheight = 0.9, colour = "#0f1d3a",
           label = c("prawie takie same\n(rozrzut 5%)", "umiarkowanie różne\n(rozrzut 20%)", "bardzo różne\n(rozrzut 35%)")) +
  annotate("rect", xmin = 3.75, xmax = 5.95, ymin = 0.55, ymax = 3.62, fill = "#f4f2ee", colour = "#dedbd4") +
  geom_text(data = reguly, aes(x = 3.88, y = y, label = tekst), hjust = 0, vjust = 0.5, size = 3.5,
            lineheight = 0.92, colour = "#0f1d3a", fontface = c("bold", rep("plain", 4))) +
  coord_cartesian(xlim = c(-0.75, 6), ylim = c(0.5, 4.3), expand = FALSE) +
  labs(title = "Ile kreacji testować przy 20 000 wyświetleń testu?",
       subtitle = "Liczba kreacji z wartością informacji ≥ 90% maksimum (kreacja 120 zł, kliknięcie 1.20 zł, CTR 1%)",
       x = NULL, y = NULL) +
  motyw + theme(panel.grid.major = element_blank(), axis.text = element_blank())
p6                       # do pliku: ggsave("ile-kreacji-karta-decyzji.svg", p6, width = 10, height = 5.6)
Wynik w R
 wdrozenie rozrzut k_opt wartosc_zl zakres_90proc
    100000    0.05     1          0           1–1
    100000    0.20     2          3           2–2
    100000    0.35     3        113           3–3
    380000    0.05     1          0           1–1
    380000    0.20     4        443           3–5
    380000    0.35     9       1519          5–12
   1000000    0.05     2         39           2–2
   1000000    0.20     6       1915           4–9
   1000000    0.35    15       5865          8–16
7. Kontrola palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – pomarańczowy" = c("#0072B2", "#D55E00"), "błękit – pomarańczowy" = c("#56B4E9", "#D55E00"),
             "niebieski – zielony" = c("#0072B2", "#009E73"), "pomarańczowy – zielony" = c("#D55E00", "#009E73"),
             "żółty – zielony" = c("#E69F00", "#009E73"), "pomarańczowy – żółty" = c("#D55E00", "#E69F00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
niebieski – pomarańczowy                   114.6        108.3       91.9
błękit – pomarańczowy                      113.6        101.1       89.0
niebieski – zielony                         70.1         55.4       58.0
pomarańczowy – zielony                     102.4         53.5       37.3
żółty – zielony                             88.7         66.3       51.5
pomarańczowy – żółty                        33.4         18.4       24.9
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie, przedziały Wilsona (prop.test) i test χ² wykonano pakietem stats (z podstawowej instalacji R). Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Za dużo kreacji na mały ruch (rysunki 2 i 3).
- Kreacje prawie takie same – test kosztuje więcej, niż daje (rysunek 5A).
- Klątwa zwycięzcy – zysk liczony z CTR zwycięzcy w teście (rysunek 4).
- Metryka zastępcza – wybór po CTR, gdy klikający nie kupują (rysunek 5B).
- „Nieistotny” znaczy „nie wiem”. p = .845 w teście czterech kreacji nie dowodzi, że są równe (rysunek 1).
Najczęstsze pytania
Ile kreacji reklamowych testować naraz przy małym budżecie?
Zwykle 2–4. Każda kolejna kreacja zabiera wyświetlenia pozostałym i kosztuje. W symulacji z 20 000 wyświetleń testu i 380 000 wdrożenia wartość informacji była największa przy 4 kreacjach (460 zł), przy 3 i 5 zbliżona, a przy 10 ujemna. Więcej kreacji opłaca się dopiero przy dużym wdrożeniu i bardzo różnych pomysłach.
Co to jest wartość informacji w teście A/B?
To różnica między oczekiwanym zyskiem z decyzji podjętej po teście a oczekiwanym zyskiem z decyzji bez testu, po odjęciu kosztu testu. Liczy się ją w złotówkach, np. symulacją: losujesz wiele testów, wybierasz zwycięzcę i sprawdzasz, ile naprawdę daje we wdrożeniu.
Dlaczego zwycięska kreacja po wdrożeniu wypada gorzej niż w teście?
To klątwa zwycięzcy: wygrywa kreacja, której przypadek dodał kliknięć, więc jej wynik z testu jest zawyżony. W symulacji przy 4 kreacjach CTR zwycięzcy w teście obiecywał +26.4%, a po wdrożeniu dawał +18.0%; przy 8 kreacjach +43.2% wobec +22.5%.
Czy wybierać kreację po CTR, czy po sprzedaży?
Przy małym budżecie po sprzedaży się nie da – w teście czterech kreacji na 20 000 wyświetleń było 7 zamówień. CTR to jednak metryka zastępcza: jeśli kreacje przyciągające kliknięcia przyciągają osoby, które nie kupują, test może przynieść stratę. Wtedy testuj mniej kreacji i sprawdzaj konwersję po wdrożeniu.
Czy warto testować kreacje, które różnią się tylko kolorem przycisku?
Przy małym ruchu zwykle nie. Gdy prawdziwy CTR kreacji różni się o ok. 5%, test nie odróżni ich od szumu, a koszt przygotowania kreacji przewyższa zysk: w symulacji wartość informacji wynosiła −61 zł przy 2 kreacjach i −278 zł przy 4. Testuj różne pomysły, nie odcienie.
Powiązane hasła
Przeczytaj też
Test A/B z wieloma wariantami
Pięć tematów maila i kontrola: Dunnett, Holm i Tukey, klątwa zwycięzcy w 1000 symulacji, test potwierdzający i moc – pięć rysunków z kodem R.
Czytaj →PoradnikWielorękie bandyty a test A/B
Portal z przepisami i cztery nagłówki: test A/B, strategia epsilon-zachłanna i UCB1 w 1000 symulacjach – utracone kliknięcia, trafność i obciążone średnie.
Czytaj →PoradnikPodział budżetu marketingowego
Szkoła programowania i cztery kanały reklamy: krzywe odpowiedzi, programowanie liniowe, krańcowy zwrot, 1000 losowań i pułapka ekstrapolacji – z kodem R.
Czytaj →Planujesz test kreacji albo piszesz o nim pracę?
Pomożemy policzyć, ile wariantów udźwignie budżet, przygotować symulację wartości informacji i opisać wynik tak, żebyś umiał(a) go obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Andrews, I., Kitagawa, T., & McCloskey, A. (2024). Inference on winners. The Quarterly Journal of Economics, 139(1), 305–358. https://doi.org/10.1093/qje/qjad043 ● Otwarty dostęp
- Bechhofer, R. E. (1954). A single-sample multiple decision procedure for ranking means of normal populations with known variances. The Annals of Mathematical Statistics, 25(1), 16–39. https://doi.org/10.1214/aoms/1177728845 ● Otwarty dostęp
- Feit, E. M., & Berman, R. (2019). Test & roll: Profit-maximizing A/B tests. Marketing Science, 38(6), 1038–1058. https://doi.org/10.1287/mksc.2019.1194 ● Otwarty dostęp: pełny tekst
- Fleming, T. R., & DeMets, D. L. (1996). Surrogate end points in clinical trials: Are we being misled? Annals of Internal Medicine, 125(7), 605–613. https://doi.org/10.7326/0003-4819-125-7-199610010-00011
- Howard, R. A. (1966). Information value theory. IEEE Transactions on Systems Science and Cybernetics, 2(1), 22–26. https://doi.org/10.1109/tssc.1966.300074
- Kohavi, R., Tang, D., & Xu, Y. (2020). Trustworthy online controlled experiments: A practical guide to A/B testing. Cambridge University Press. https://doi.org/10.1017/9781108653985
- Lee, M. R., & Shen, M. (2018). Winner’s curse: Bias estimation for total effects of features in online controlled experiments. In Proceedings of the 24th ACM SIGKDD International Conference on Knowledge Discovery & Data Mining (pp. 491–499). ACM. https://doi.org/10.1145/3219819.3219905
Cytowania BibTeX
@article{andrews2024inference, author={Andrews, Isaiah and Kitagawa, Toru and McCloskey, Adam}, title={{Inference on winners}}, journal={The Quarterly Journal of Economics}, year={2024}, volume={139}, number={1}, pages={305--358}, doi={10.1093/qje/qjad043}}@article{bechhofer1954single, author={Bechhofer, Robert E.}, title={{A single-sample multiple decision procedure for ranking means of normal populations with known variances}}, journal={The Annals of Mathematical Statistics}, year={1954}, volume={25}, number={1}, pages={16--39}, doi={10.1214/aoms/1177728845}}@article{feit2019test, author={Feit, Elea McDonnell and Berman, Ron}, title={{Test \& roll: Profit-maximizing A/B tests}}, journal={Marketing Science}, year={2019}, volume={38}, number={6}, pages={1038--1058}, doi={10.1287/mksc.2019.1194}}@article{fleming1996surrogate, author={Fleming, Thomas R. and DeMets, David L.}, title={{Surrogate end points in clinical trials: Are we being misled?}}, journal={Annals of Internal Medicine}, year={1996}, volume={125}, number={7}, pages={605--613}, doi={10.7326/0003-4819-125-7-199610010-00011}}@article{howard1966information, author={Howard, Ronald A.}, title={{Information value theory}}, journal={IEEE Transactions on Systems Science and Cybernetics}, year={1966}, volume={2}, number={1}, pages={22--26}, doi={10.1109/tssc.1966.300074}}@book{kohavi2020trustworthy, author={Kohavi, Ron and Tang, Diane and Xu, Ya}, title={{Trustworthy online controlled experiments: A practical guide to A/B testing}}, year={2020}, publisher={Cambridge University Press}, doi={10.1017/9781108653985}}@inproceedings{lee2018winners, author={Lee, Minyong R. and Shen, Milan}, title={{Winner’s curse: Bias estimation for total effects of features in online controlled experiments}}, booktitle={Proceedings of the 24th ACM SIGKDD International Conference on Knowledge Discovery \& Data Mining}, year={2018}, pages={491--499}, publisher={ACM}, doi={10.1145/3219819.3219905}}