Przykład: cztery spoty lodów przed kampanią
Fikcyjna marka lodów ma przed sezonem cztery wersje 20-sekundowego spotu: A „Upał w mieście”, B „Rodzinny deser”, C „Chrupiąca polewa” i D „Pies i lody” (humor). Wyemituje jedną, a wcześniej agencja robi pre-test w ankiecie online: respondenci z panelu oglądają spot i odpowiadają na trzy pytania. Pytanie biznesowe: który spot wybrać i czy różnica jest na tyle duża, żeby na niej polegać?
- Zapamiętanie marki (tak/nie): po spocie i krótkim pytaniu odwracającym uwagę respondent wskazuje reklamowaną markę.
- Sympatia do spotu: „Jak bardzo podobała Ci się ta reklama?” na skali 1–7 – wskaźnik główny.
- Intencja zakupu: odsetek odpowiedzi „raczej” i „zdecydowanie kupię” (tzw. top-2-box) na skali 1–5.
Agencja losowo dzieli 1200 osób między dwa plany. W planie monadycznym 800 osób widzi tylko jeden spot (po 200 na spot). W planie sekwencyjnym 400 osób widzi wszystkie cztery w losowej kolejności i ocenia każdy zaraz po obejrzeniu. Ogólne zasady takich badań opisuje wpis eksperyment w ankiecie online krok po kroku; tu skupiamy się na tym, co zmienia oglądanie kilku reklam po kolei.
Dane są fikcyjne i znamy prawdę. Parametry ustaliliśmy ręcznie przed pierwszym uruchomieniem kodu. Średnia sympatia przy pierwszym obejrzeniu wynosi 4.7 (A), 4.9 (B), 5.4 (C) i 4.8 (D). Respondenci różnią się skłonnością do wysokich ocen (SD 0.8), a pojedyncza ocena ma szum (SD 1.2). W planie sekwencyjnym spot na pozycji 2, 3 i 4 dostaje ocenę niższą o 0.25, 0.40 i 0.50 punktu (efekt kolejności). Spot oglądany zaraz po spocie C traci dodatkowo 0.30 punktu (przeniesienie). Zapamiętanie marki wynosi 48%, 55%, 58% i 38% i spada z każdą kolejną pozycją. Ziarno 669 ustaliliśmy raz i nie zmienialiśmy go. Po pierwszym uruchomieniu nie zmienialiśmy parametrów danych – tylko zakres osi na rysunku 5 i dopisaliśmy test interakcji. Dane pobierzesz jako pre-test-kreacji-reklamowych-ankieta.csv (jeden wiersz = jedna ocena spotu).
Rysunek 1: plan monadyczny i sekwencyjny
To klasyczny wybór między schematem międzyobiektowym i wewnątrzobiektowym. Greenwald (1976) wskazuje, że główną zaletą schematu wewnątrzobiektowego jest efektywność, bo różnice między osobami znikają z błędu, a główną wadą – efekty kontekstu: wprawa, uwrażliwienie i przeniesienie.
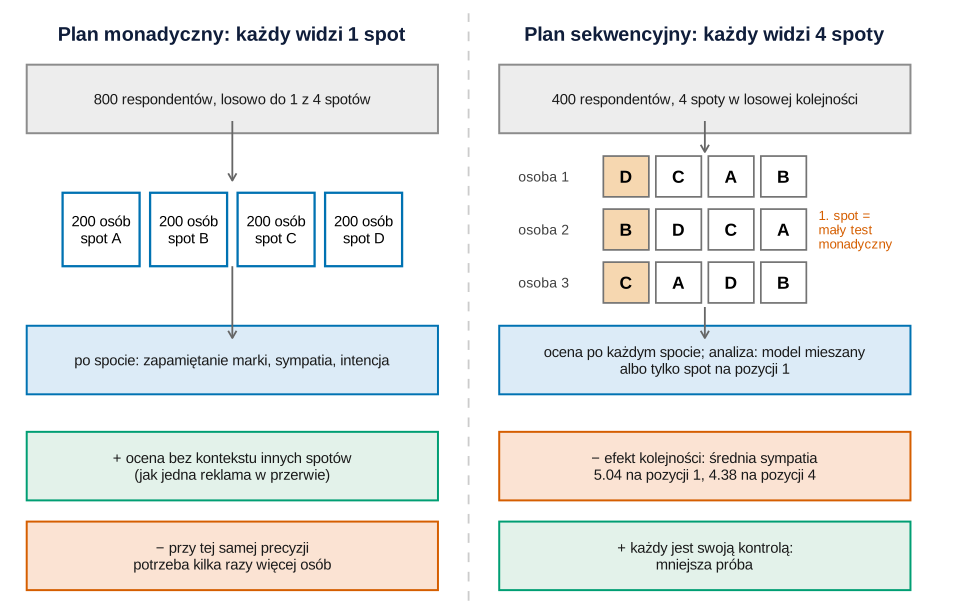
set.seed(669)).Co widać. W planie monadycznym każda osoba ocenia spot tak, jak zobaczy go widz w przerwie reklamowej – bez porównania z innymi. W planie sekwencyjnym każda osoba ocenia wszystkie spoty, a pierwszy spot każdej osoby to w praktyce mały test monadyczny (po około 100 osób na spot).
Jak może zmylić. Schemat nie pokazuje kosztu czasu: cztery spoty wydłużają ankietę, a zmęczenie samo wywołuje efekt kolejności.
Podpis do pracy:
Plan monadyczny: wynik i wiele porównań
Analiza to średnie i odsetki w czterech niezależnych grupach.
| Spot | n | Sympatia M [95% CI] | Zapamiętanie marki | Intencja (top-2-box) |
|---|---|---|---|---|
| A Upał w mieście | 200 | 4.75 [4.56, 4.94] | 44.5% | 32.5% |
| B Rodzinny deser | 200 | 4.71 [4.54, 4.88] | 55.0% | 29.5% |
| C Chrupiąca polewa | 200 | 5.38 [5.19, 5.56] | 59.5% | 38.0% |
| D Pies i lody | 200 | 4.63 [4.45, 4.81] | 36.5% | 27.5% |
Spoty różnią się sympatią: F(3, 796) = 13.96, p < .001, η² = .050 (ANOVA). Cztery spoty to sześć par, więc rośnie ryzyko fałszywego alarmu – to problem wielokrotnych porównań. Po poprawce Holma (Holm, 1979) C jest lepszy od każdego z pozostałych (p < .001), a różnice między A, B i D znikają (bez korekty najmniejsze p = .355). Różnica C – B wynosi 0.67 punktu, 95% CI [0.41, 0.92]. Turniej wariantów, korekty i klątwę zwycięzcy szerzej omawia wpis test A/B z wieloma wariantami.
Spot D jest zabawny, ale markę zapamiętało tylko 36.5% osób wobec 53.0% w spotach A–C. Zapamiętany żart, zapomniany nadawca.
Zdanie do Wyników:
Rysunek 2: pierwszy spot oceniany lepiej
To samo pytanie pada w planie sekwencyjnym cztery razy, a odpowiedź na czwartą reklamę zależy od trzech poprzednich – to odmiana efektu kolejności pytań, tylko zamiast pytań zmieniają się bodźce.
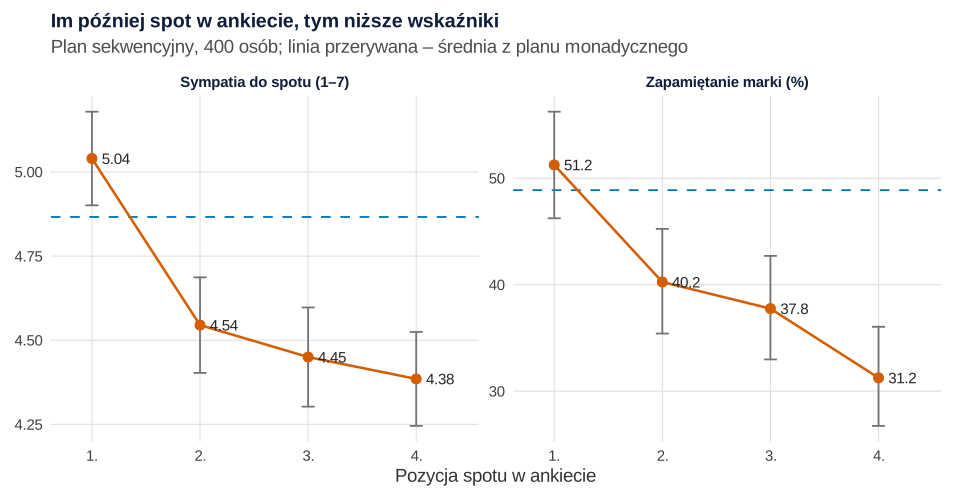
set.seed(669)).Co widać. Spot oglądany jako pierwszy dostaje średnio 5.04 punktu, a jako czwarty – 4.38. Zapamiętanie marki spada z 51.2% do 31.2%: w regresji logistycznej mieszanej każda kolejna pozycja zmniejsza szansę zapamiętania, OR = 0.73, 95% CI [0.66, 0.81]. Widać też efekt przeniesienia: spoty A, B i D oglądane zaraz po najlepszym spocie C dostały średnio 4.09 punktu (309 ocen), a po innym spocie – 4.40 (603 oceny).
Jak może zmylić. Losowa kolejność nie usuwa efektu, tylko rozkłada go mniej więcej równo między spoty. W naszych danych spot A był pierwszy 81 razy, a C – 112 razy, więc proste średnie i tak lekko faworyzują C. Lepiej zaplanować kontrbalansowanie: każdy spot na każdej pozycji tyle samo razy, np. w kwadracie łacińskim. Brooks (2012) pokazuje, że kontrbalansowanie jest niezbędne, gdy grożą przeniesienia, i podaje sposób budowy sekwencji zrównoważonych także pod względem tego, który warunek następuje po którym.
Podpis do pracy:
Rysunek 3: model mieszany i cztery sposoby liczenia
Każdy respondent planu sekwencyjnego daje cztery oceny, które nie są niezależne – jedni oceniają wszystko łagodniej, inni surowiej. Dlatego analizujemy je modelem mieszanym (lme4; Bates i in., 2015): sympatia zależy od spotu, pozycji i tego, czy poprzedni był spot C, a respondent ma własny losowy wyraz wolny. Barr i in. (2013) zalecają, by w analizie konfirmacyjnej struktura efektów losowych była tak pełna, jak pozwala schemat; przy jednej ocenie spotu na osobę losowe nachylenia spotów nie dają się oszacować, więc zostaje wyraz wolny.
Model potwierdza oba efekty: pozycja 4 obniża ocenę o 0.55 punktu, a spot zaraz po C – o 0.31. ICC = .28, czyli ponad jedna czwarta zmienności ocen to stały styl respondenta. Różnica C – B wynosi 0.55, 95% CI [0.38, 0.72], t(1197) = 6.39, p < .001. Przedział jest węższy niż w planie monadycznym przy połowie osób.
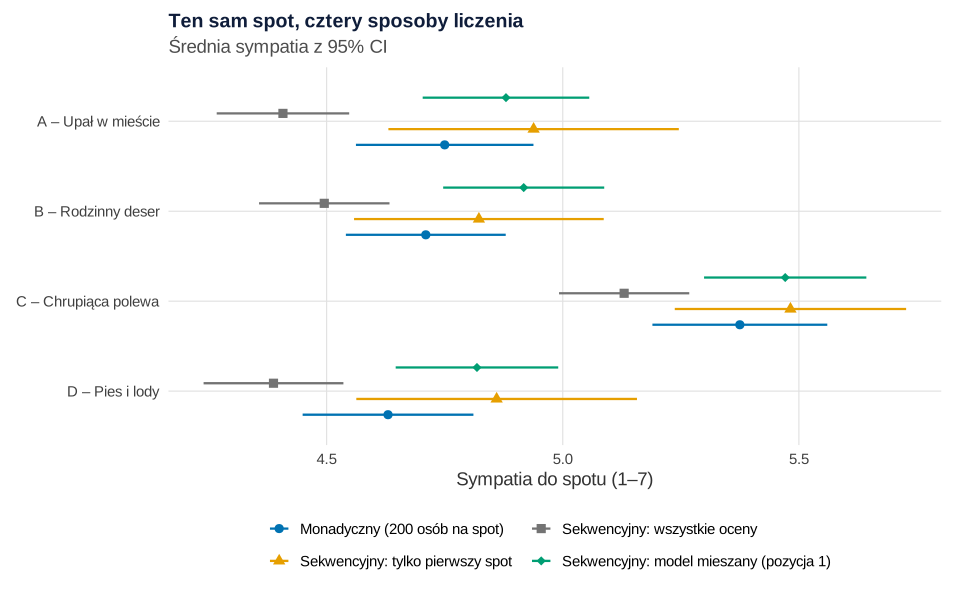
set.seed(669)).Co widać. Średnie ze wszystkich ocen sekwencyjnych są przesunięte w dół (C: 5.13 wobec 5.38 w planie monadycznym), bo trzy z czterech ocen pochodzą z dalszych pozycji. Analiza samego pierwszego spotu trafia w poziom (C: 5.48), ale ma najszersze przedziały. Model mieszany przewiduje ocenę na pozycji 1 bez przeniesienia (C: 5.47) i ma wąskie przedziały. Różnica C – B: 0.67 (monadyczny), 0.66 (tylko pierwszy spot), 0.64 (wszystkie oceny) i 0.55 (model).
Jak może zmylić. Model zakłada, że różnice między spotami są takie same na każdej pozycji. Sprawdź to testem interakcji spot × pozycja – tu F(9, 1522) = 0.79, p = .629, ale brak istotności przy 400 osobach nie dowodzi braku interakcji. Gdy różnice słabną pod koniec ankiety, wiarygodny poziom daje tylko pierwszy spot. Średnich z planu sekwencyjnego nie porównuj z normami z testów monadycznych.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: który sposób trafia w prawdę – 1000 badań
Powtórzyliśmy cały pre-test 1000 razy z tymi samymi parametrami. Prawdziwa różnica C – B w planie monadycznym, po zaokrągleniu ocen do skali 1–7, wynosi 0.45 punktu. Dodaliśmy piąty wariant, który zdarza się w praktyce: wszyscy oglądają spoty w tej samej kolejności A → B → C → D.
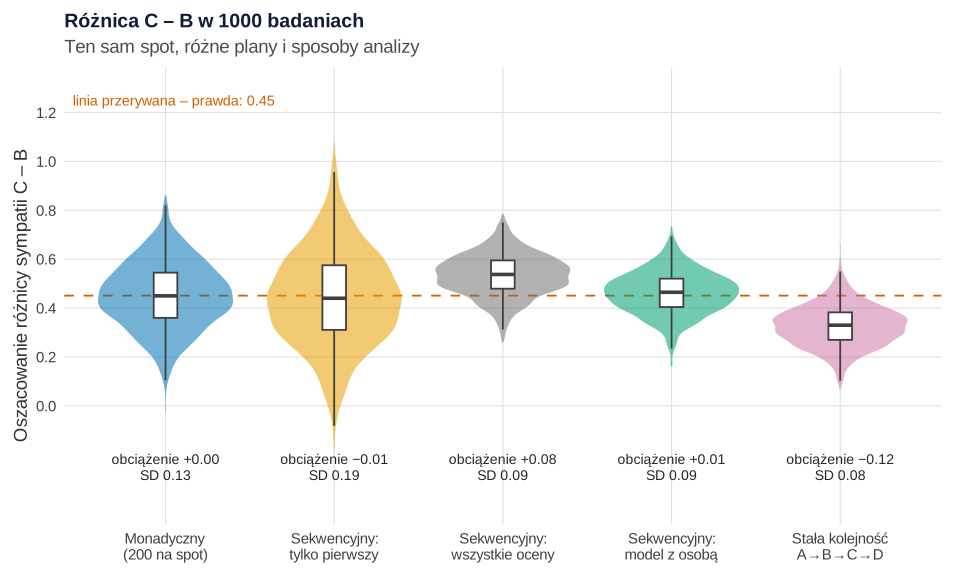
set.seed(6691)).Co widać. Plan monadyczny trafia w prawdę (obciążenie 0.001) z rozrzutem SD = 0.135. Sam pierwszy spot z planu sekwencyjnego też jest nieobciążony, ale rozrzut rośnie do 0.194, bo osób na spot jest dwa razy mniej. Proste średnie ze wszystkich ocen zawyżają różnicę o 0.084: spot B bywa oglądany zaraz po C i traci na przeniesieniu, a sam C nigdy. Model z efektem osoby, pozycją i przeniesieniem ma obciążenie 0.012 i SD = 0.087, więc najmniejszy błąd średniokwadratowy (0.088 wobec 0.135 w planie monadycznym). Stała kolejność zaniża różnicę o 0.124: C stoi zawsze na dalszej pozycji niż B, a pozycji nie da się oddzielić od spotu żadnym modelem. Błąd Monte Carlo obciążeń wynosi 0.003–0.006.
Jak może zmylić. Model wygrywa, bo odpowiada mechanizmowi, który sami ustaliliśmy (drobne obciążenie 0.012 to skutek ucięcia skali na 1 i 7). Gdy prawdziwe przeniesienie działa inaczej, model z błędną jego postacią zostawi część obciążenia.
Podpis do pracy:
Rysunek 5: ilu respondentów w każdym planie
Liczebność policzyliśmy dla różnicy C – B (0.45 punktu) i progu α = .05/6 (ostrożna poprawka na sześć par). Krzywe pochodzą ze wzoru na moc testu z rozrzutem oszacowań z symulacji, a krzyżyki – z 500 nowych badań dla każdej liczebności.
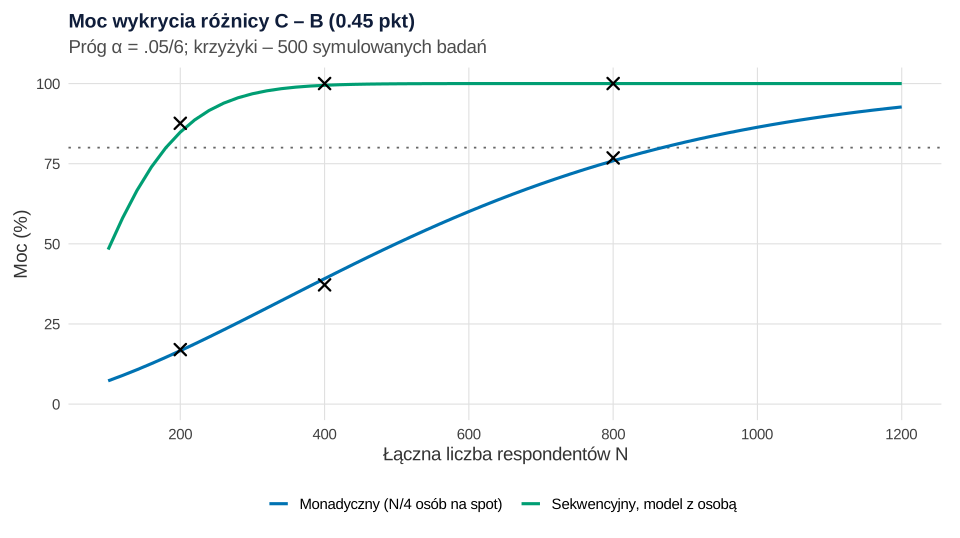
set.seed(6692)).Co widać. Na moc 80% plan monadyczny potrzebuje 868 osób (217 na spot), a sekwencyjny – 180. Przy różnicy 0.25 punktu to 2824 wobec 586 osób. Symulacja zgadza się ze wzorem: przy 800 osobach moc planu monadycznego wyniosła 76.8% (błąd MC 1.9 pp), a przy 200 osobach planu sekwencyjnego – 87.6%. Ogólne zasady liczenia próby w eksperymentach ankietowych opisuje wpis liczebność próby w eksperymencie ankietowym.
Jak może zmylić. Ta przewaga dotyczy porównania spotów, nie poziomu wskaźnika. Jeśli spot ma przekroczyć próg z wcześniejszych testów monadycznych albo potrzebujesz poziomu z pierwszej ekspozycji, w planie sekwencyjnym liczy się tylko około N/4 osób na spot – tyle co w monadycznym.
Podpis do pracy:
Co z tym zrobić w marketingu
- Wybór jednego spotu z kilku – plan sekwencyjny z losową, zrównoważoną kolejnością. Daje to samo rozstrzygnięcie co monadyczny przy mniej więcej pięć razy mniejszej próbie. Kolejność zapisz w danych – bez niej nie sprawdzisz efektu kolejności ani przeniesienia.
- Ocena „czy spot jest dość dobry” wobec norm – plan monadyczny albo tylko pierwszy spot z planu sekwencyjnego. Średnie ze wszystkich pozycji są zaniżone.
- Nigdy stała kolejność. Myli efekt spotu z efektem pozycji.
- Nie wybieraj spotu po jednym wskaźniku. D przegrywa w zapamiętaniu marki mimo sympatii zbliżonej do A i B – kampania z takim spotem buduje rozpoznawalność żartu, nie marki.
- Intencję zakupu traktuj ostrożnie. Morwitz i in. (2007) stwierdzili, że deklaracje silniej wiążą się z późniejszymi zakupami m.in. dla produktów istniejących niż nowych i przy pomiarze porównawczym niż monadycznym. Jak przełożyć deklaracje na zakup, pokazuje wpis deklaracja zakupu a faktyczny zakup.
Pre-test wskazuje spot; efekt kampanii po emisji zmierzysz osobno, np. badaniem brand lift. Siłą obu jest losowanie – gdy klienci sami wybierają udział (jak w programie lojalnościowym), potrzebne są inne narzędzia.
Jak opisać w pracy
W Metodzie opisz plan, liczbę osób, sposób losowania kolejności, wskaźniki i model, a w Wynikach – oszacowania z przedziałami i korektę na wiele porównań. Więcej o układzie takiego rozdziału: analiza eksperymentu ankietowego i statystyka w pracy z marketingu.
Kod R: dane, model mieszany, symulacja i liczebność
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę i motyw, a kolejne korzystają z jego obiektów (przepis 5 – także z wyników przepisu 4). Przepisy z rysunkami kończą się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave(). Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Każdy przepis, który losuje, zaczyna od własnego ziarna: set.seed(669) w przepisie 1 (dane), set.seed(6691) w przepisie 4 (1000 badań) i set.seed(6692) w przepisie 5 (500 badań na liczebność). Przepisy 2, 3, 6 i 7 nie losują. Ziarna ustalono raz i nie zmieniano ich. Ręcznie ustalono: średnie sympatii spotów, SD respondenta i reszty, przesunięcia na pozycjach 2–4, przeniesienie po spocie C, odsetki zapamiętania i jego spadek z pozycją, związek intencji z sympatią oraz liczebności 800 i 400 (przepis 1); próg α = .05/6 i różnicę 0.25 jako drugi scenariusz (przepis 5). Przepisy 4 i 5 liczą się po kilkadziesiąt sekund.
1. Dane: dwa plany pre-testu czterech spotów
R
# Przepis 1. Fikcyjna marka lodów: pre-test czterech spotów w ankiecie online, dwa plany badania
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(monad = "#0072B2", pierwsza = "#E69F00", wszystkie = "grey45", model = "#009E73",
         stala = "#CC79A7", akcent = "#D55E00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

spoty <- c("A", "B", "C", "D")
nazwy <- c(A = "Upał w mieście", B = "Rodzinny deser", C = "Chrupiąca polewa", D = "Pies i lody")

# Parametry ustalone ręcznie przed pierwszym uruchomieniem.
# Sympatia do spotu (1–7) przy PIERWSZYM obejrzeniu – tak, jak w planie monadycznym:
mu_symp  <- c(A = 4.7, B = 4.9, C = 5.4, D = 4.8)
sd_osoba <- 0.8                            # różnice między respondentami (jedni oceniają łagodniej)
sd_reszta <- 1.2                           # szum pojedynczej oceny
przes_poz <- c(0, -0.25, -0.40, -0.50)     # efekt kolejności: spot na pozycji 2–4 oceniany niżej
po_C <- -0.30                              # przeniesienie (kontrast): spot zaraz po spocie C wypada gorzej
# Zapamiętanie marki (tak/nie) przy pierwszym obejrzeniu i spadek z każdą kolejną pozycją (logit):
p_zap <- c(A = .48, B = .55, C = .58, D = .38); zap_poz <- -0.30; sd_osoba_zap <- 0.8
# Intencja zakupu: odsetek „raczej/zdecydowanie kupię” rośnie z sympatią do spotu (logit):
int_a <- -5.2; int_b <- 0.85

# Generator: n_monad osób na spot w planie monadycznym i n_sekw osób w planie sekwencyjnym
# (każda widzi cztery spoty w losowej kolejności; stala = TRUE – wszyscy w kolejności A, B, C, D)
generuj <- function(n_monad = 200, n_sekw = 400, stala = FALSE) {
  m <- data.frame(osoba = seq_len(4 * n_monad), plan = "monadyczny",
                  spot = sample(rep(spoty, n_monad)), pozycja = 1L, poprzedni = "brak")
  kolej <- if (stala) matrix(spoty, n_sekw, 4, byrow = TRUE) else t(replicate(n_sekw, sample(spoty)))
  s <- data.frame(osoba = 4 * n_monad + rep(seq_len(n_sekw), each = 4), plan = "sekwencyjny",
                  spot = as.vector(t(kolej)), pozycja = rep(1:4, n_sekw),
                  poprzedni = as.vector(t(cbind("brak", kolej[, 1:3]))))
  d <- rbind(m, s)
  u <- rnorm(max(d$osoba), 0, sd_osoba)[d$osoba]            # skłonność osoby do wysokich ocen
  v <- rnorm(max(d$osoba), 0, sd_osoba_zap)[d$osoba]        # skłonność osoby do zapamiętywania
  ukryta <- mu_symp[d$spot] + przes_poz[d$pozycja] + po_C * (d$poprzedni == "C") + u + rnorm(nrow(d), 0, sd_reszta)
  d$sympatia <- pmin(7, pmax(1, round(ukryta)))
  d$zapamietanie <- rbinom(nrow(d), 1, plogis(qlogis(p_zap[d$spot]) + zap_poz * (d$pozycja - 1) + v))
  d$intencja_top2 <- rbinom(nrow(d), 1, plogis(int_a + int_b * ukryta))
  d$spot <- factor(d$spot, levels = spoty)
  d
}

set.seed(669)                                  # ziarno ustalone raz, bez dobierania pod wynik
ankieta <- generuj()
write.csv(ankieta, "pre-test-kreacji-reklamowych-ankieta.csv", row.names = FALSE)
monad <- subset(ankieta, plan == "monadyczny")
sekw  <- subset(ankieta, plan == "sekwencyjny")

cat("Respondenci:", length(unique(monad$osoba)), "w planie monadycznym,", length(unique(sekw$osoba)),
    "w sekwencyjnym; ocen spotów:", nrow(monad), "i", nrow(sekw), "\n")
print(table(plan = ankieta$plan, spot = ankieta$spot))
cat("Kolejność w planie sekwencyjnym – ile razy spot był na pozycji 1–4:\n")
print(table(spot = sekw$spot, pozycja = sekw$pozycja))
Wynik w R
Respondenci: 800 w planie monadycznym, 400 w sekwencyjnym; ocen spotów: 800 i 1600
             spot
plan            A   B   C   D
  monadyczny  200 200 200 200
  sekwencyjny 400 400 400 400
Kolejność w planie sekwencyjnym – ile razy spot był na pozycji 1–4:
    pozycja
spot   1   2   3   4
   A  81 101 114 104
   B 107  89  94 110
   C 112  97 100  91
   D 100 113  92  95
2. Plan monadyczny: średnie, ANOVA i poprawka Holma
R
# Przepis 2. Plan monadyczny: każdy respondent ocenia jeden spot (korzysta z monad i spoty z przepisu 1)
srednia_ci <- function(y) { t <- t.test(y); c(M = mean(y), lo = t$conf.int[1], hi = t$conf.int[2]) }
fp <- function(p) if (p < .001) "p < .001" else sub("0\\.", ".", sprintf("p = %.3f", p))   # zapis p w stylu APA
odsetek_ci <- function(y) { b <- binom.test(sum(y), length(y)); 100 * c(p = mean(y), lo = b$conf.int[1], hi = b$conf.int[2]) }

tab_m <- do.call(rbind, lapply(spoty, function(s) {
  x <- monad[monad$spot == s, ]
  data.frame(spot = s, n = nrow(x), t(srednia_ci(x$sympatia)), SD = sd(x$sympatia),
             zap = odsetek_ci(x$zapamietanie)[1], int = odsetek_ci(x$intencja_top2)[1])
}))
print(within(tab_m, { M <- round(M, 2); lo <- round(lo, 2); hi <- round(hi, 2); SD <- round(SD, 2)
                      zap <- round(zap, 1); int <- round(int, 1) }), row.names = FALSE)

# Czy spoty różnią się sympatią? ANOVA jednoczynnikowa
a <- anova(lm(sympatia ~ spot, data = monad))
cat(sprintf("\nANOVA: F(%d, %d) = %.2f, %s, eta2 = %.3f\n", a$Df[1], a$Df[2], a$`F value`[1], fp(a$`Pr(>F)`[1]),
            a$`Sum Sq`[1] / sum(a$`Sum Sq`)))

# Sześć par spotów: p bez korekty i z poprawką Holma (wspólne SD, jak w ANOVA)
p_bez  <- pairwise.t.test(monad$sympatia, monad$spot, p.adjust.method = "none")$p.value
p_holm <- pairwise.t.test(monad$sympatia, monad$spot, p.adjust.method = "holm")$p.value
pary <- which(!is.na(p_bez), arr.ind = TRUE)
print(data.frame(para = paste(rownames(p_bez)[pary[, 1]], "–", colnames(p_bez)[pary[, 2]]),
                 roznica = round(sapply(seq_len(nrow(pary)), function(i)
                   tab_m$M[tab_m$spot == rownames(p_bez)[pary[i, 1]]] - tab_m$M[tab_m$spot == colnames(p_bez)[pary[i, 2]]]), 2),
                 p_bez = round(p_bez[pary], 4), p_holm = round(p_holm[pary], 4)), row.names = FALSE)

# Najlepszy spot wobec drugiego: C – B z 95% CI (test t Welcha)
tw <- t.test(monad$sympatia[monad$spot == "C"], monad$sympatia[monad$spot == "B"])
cat(sprintf("\nC – B: %.2f, 95%% CI [%.2f, %.2f], t(%.1f) = %.2f, %s\n", diff(rev(tw$estimate)),
            tw$conf.int[1], tw$conf.int[2], tw$parameter, tw$statistic, fp(tw$p.value)))
# Zapamiętanie marki: D wobec średniej pozostałych spotów
cat(sprintf("Zapamiętanie marki: D %.1f%% wobec %.1f%% w spotach A–C\n",
            100 * mean(monad$zapamietanie[monad$spot == "D"]), 100 * mean(monad$zapamietanie[monad$spot != "D"])))
Wynik w R
 spot   n    M   lo   hi   SD  zap  int
    A 200 4.75 4.56 4.94 1.35 44.5 32.5
    B 200 4.71 4.54 4.88 1.21 55.0 29.5
    C 200 5.38 5.19 5.56 1.33 59.5 38.0
    D 200 4.63 4.45 4.81 1.30 36.5 27.5

ANOVA: F(3, 796) = 13.96, p < .001, eta2 = 0.050
  para roznica  p_bez p_holm
 B – A   -0.04 0.7580      1
 C – A    0.62 0.0000      0
 D – A   -0.12 0.3553      1
 C – B    0.66 0.0000      0
 D – B   -0.08 0.5377      1
 D – C   -0.75 0.0000      0

C – B: 0.67, 95% CI [0.41, 0.92], t(394.8) = 5.23, p < .001
Zapamiętanie marki: D 36.5% wobec 53.0% w spotach A–C
3. Plan sekwencyjny: kolejność, przeniesienie i model mieszany: Rysunki 2 i 3
R
# Przepis 3. Plan sekwencyjny: efekt kolejności, przeniesienie i model mieszany: Rysunki 2 i 3
# (korzysta z monad, sekw, tab_m, srednia_ci, odsetek_ci, fp, spoty, kol i motyw z przepisów 1–2)
library(ggplot2); library(patchwork); library(lme4); library(lmerTest)

# 1. Ocena i zapamiętanie w zależności od pozycji spotu (wszystkie spoty razem)
poz <- do.call(rbind, lapply(1:4, function(k) {
  x <- sekw[sekw$pozycja == k, ]
  rbind(data.frame(wskaznik = "Sympatia do spotu (1–7)", pozycja = k, t(srednia_ci(x$sympatia))),
        data.frame(wskaznik = "Zapamiętanie marki (%)", pozycja = k, setNames(as.list(odsetek_ci(x$zapamietanie)), c("M", "lo", "hi"))))
}))
print(within(poz, { M <- round(M, 2); lo <- round(lo, 2); hi <- round(hi, 2) }), row.names = FALSE)
odn <- data.frame(wskaznik = c("Sympatia do spotu (1–7)", "Zapamiętanie marki (%)"),
                  y = c(mean(monad$sympatia), 100 * mean(monad$zapamietanie)))
p2 <- ggplot(poz, aes(pozycja, M)) +
  geom_hline(data = odn, aes(yintercept = y), linetype = "dashed", colour = kol[["monad"]]) +
  geom_errorbar(aes(ymin = lo, ymax = hi), width = 0.12, colour = kol[["wszystkie"]]) +
  geom_line(colour = kol[["akcent"]], linewidth = 0.9) + geom_point(colour = kol[["akcent"]], size = 3) +
  geom_text(aes(label = ifelse(M > 10, sprintf("%.1f", M), sprintf("%.2f", M))), nudge_x = 0.22, size = 4, colour = "grey15") +
  facet_wrap(~ wskaznik, scales = "free_y") + scale_x_continuous(breaks = 1:4, labels = paste0(1:4, "."), limits = c(0.8, 4.4)) +
  labs(title = "Im później spot w ankiecie, tym niższe wskaźniki",
       subtitle = "Plan sekwencyjny, 400 osób; linia przerywana – średnia z planu monadycznego",
       x = "Pozycja spotu w ankiecie", y = NULL) + motyw

# 2. Przeniesienie: ocena spotu zaraz po spocie C vs po innym spocie (pozycje 2–4)
dalej <- subset(sekw, pozycja > 1 & spot != "C")
cat(sprintf("\nSpoty A, B, D na pozycjach 2–4: po spocie C M = %.2f (n = %d), po innym M = %.2f (n = %d)\n",
            mean(dalej$sympatia[dalej$poprzedni == "C"]), sum(dalej$poprzedni == "C"),
            mean(dalej$sympatia[dalej$poprzedni != "C"]), sum(dalej$poprzedni != "C")))

# 3. Model mieszany: spot + pozycja + „zaraz po C” + losowy wyraz wolny respondenta
sekw$poz_f <- factor(sekw$pozycja); sekw$po_C <- as.integer(sekw$poprzedni == "C")
mm <- lmer(sympatia ~ spot + poz_f + po_C + (1 | osoba), data = sekw)
print(round(coef(summary(mm)), 3))
vc <- as.data.frame(VarCorr(mm))
cat(sprintf("SD respondenta = %.2f, SD reszty = %.2f, ICC = %.2f\n", vc$sdcor[1], vc$sdcor[2], vc$vcov[1] / sum(vc$vcov)))
L <- c(0, -1, 1, 0, 0, 0, 0, 0)                 # kontrast C – B (współczynniki: B, C, D, pozycje 2–4, po_C)
cb <- contest(mm, L, joint = FALSE, confint = TRUE)
cat(sprintf("Model mieszany C – B: %.2f, 95%% CI [%.2f, %.2f], t(%.0f) = %.2f, %s\n",
            cb$Estimate, cb$lower, cb$upper, cb$df, cb$`t value`, fp(cb$`Pr(>|t|)`)))
# To samo oszacowanie z regresji na odchyleniach od średniej respondenta (efekty stałe osoby) – używa go symulacja
odch <- function(x) x - ave(x, sekw$osoba)
X <- model.matrix(~ spot + poz_f + po_C, sekw)[, -1]
fe <- lm(odch(sekw$sympatia) ~ 0 + apply(X, 2, odch))
cat(sprintf("Efekty stałe osoby C – B: %.2f\n", coef(fe)[2] - coef(fe)[1]))
# Czy różnice między spotami zależą od pozycji (np. spłaszczenie ocen pod koniec)? Test interakcji spot × pozycja
mm_i <- lmer(sympatia ~ spot * poz_f + po_C + (1 | osoba), data = sekw)
ai <- anova(mm_i)["spot:poz_f", ]
cat(sprintf("Interakcja spot × pozycja: F(%.0f, %.0f) = %.2f, %s\n", ai$NumDF, ai$DenDF, ai$`F value`, fp(ai$`Pr(>F)`)))

# 4. Cztery oszacowania średniej sympatii dla każdego spotu (Rysunek 3)
sr <- function(d, metoda) do.call(rbind, lapply(spoty, function(s) data.frame(metoda = metoda, spot = s, t(srednia_ci(d$sympatia[d$spot == s])))))
b <- fixef(mm); V <- vcov(mm)
pred <- do.call(rbind, lapply(spoty, function(s) {
  l <- c(1, s == "B", s == "C", s == "D", 0, 0, 0, 0); m <- sum(l * b); se <- sqrt(drop(t(l) %*% V %*% l))
  data.frame(metoda = "Sekwencyjny: model mieszany (pozycja 1)", spot = s, M = m, lo = m - 1.96 * se, hi = m + 1.96 * se)
}))
est <- rbind(data.frame(metoda = "Monadyczny (200 osób na spot)", tab_m[, c("spot", "M", "lo", "hi")]),
             sr(subset(sekw, pozycja == 1), "Sekwencyjny: tylko pierwszy spot"),
             sr(sekw, "Sekwencyjny: wszystkie oceny"), pred)
est$metoda <- factor(est$metoda, levels = unique(est$metoda))
cat("\nŚrednia sympatia (95% CI) według sposobu analizy:\n")
print(within(est, { M <- round(M, 2); lo <- round(lo, 2); hi <- round(hi, 2) }), row.names = FALSE)
roz <- aggregate(M ~ metoda, est, function(m) m[3] - m[2])
cat("Różnica C – B według sposobu analizy:\n"); print(transform(roz, M = sprintf("%.2f", M)), row.names = FALSE)
p3 <- ggplot(est, aes(M, spot, colour = metoda, shape = metoda)) +
  geom_errorbar(aes(xmin = lo, xmax = hi), width = 0, orientation = "y", linewidth = 0.8, position = position_dodge(width = 0.7)) +
  geom_point(size = 2.8, position = position_dodge(width = 0.7)) +
  scale_colour_manual(values = unname(kol[c("monad", "pierwsza", "wszystkie", "model")])) +
  scale_shape_manual(values = c(16, 17, 15, 18)) + scale_y_discrete(limits = rev(spoty), labels = rev(paste(spoty, nazwy[spoty], sep = " – "))) +
  guides(colour = guide_legend(ncol = 2), shape = guide_legend(ncol = 2)) +
  labs(title = "Ten sam spot, cztery sposoby liczenia", subtitle = "Średnia sympatia z 95% CI",
       x = "Sympatia do spotu (1–7)", y = NULL, colour = NULL, shape = NULL) + motyw

# 5. Zapamiętanie marki: regresja logistyczna mieszana z pozycją
gm <- glmer(zapamietanie ~ spot + pozycja + (1 | osoba), data = sekw, family = binomial)
ci <- confint(gm, parm = "pozycja", method = "Wald")
cat(sprintf("\nZapamiętanie: OR na każdą kolejną pozycję = %.2f, 95%% CI [%.2f, %.2f]\n",
            exp(fixef(gm)["pozycja"]), exp(ci[1]), exp(ci[2])))
p2
p3
Wynik w R
                wskaznik pozycja     M    lo    hi
 Sympatia do spotu (1–7)       1  5.04  4.90  5.18
  Zapamiętanie marki (%)       1 51.25 46.23 56.25
 Sympatia do spotu (1–7)       2  4.54  4.40  4.69
  Zapamiętanie marki (%)       2 40.25 35.41 45.24
 Sympatia do spotu (1–7)       3  4.45  4.30  4.60
  Zapamiętanie marki (%)       3 37.75 32.98 42.70
 Sympatia do spotu (1–7)       4  4.38  4.25  4.52
  Zapamiętanie marki (%)       4 31.25 26.74 36.04

Spoty A, B, D na pozycjach 2–4: po spocie C M = 4.09 (n = 309), po innym M = 4.40 (n = 603)
            Estimate Std. Error       df t value Pr(>|t|)
(Intercept)    4.880      0.090 1582.110  54.230    0.000
spotB          0.038      0.085 1193.303   0.443    0.658
spotC          0.591      0.088 1198.848   6.731    0.000
spotD         -0.061      0.085 1193.153  -0.726    0.468
poz_f2        -0.382      0.088 1198.533  -4.354    0.000
poz_f3        -0.496      0.087 1197.214  -5.710    0.000
poz_f4        -0.547      0.087 1197.346  -6.289    0.000
po_C          -0.313      0.085 1274.133  -3.695    0.000
SD respondenta = 0.75, SD reszty = 1.19, ICC = 0.28
Model mieszany C – B: 0.55, 95% CI [0.38, 0.72], t(1197) = 6.39, p < .001
Efekty stałe osoby C – B: 0.55
Interakcja spot × pozycja: F(9, 1522) = 0.79, p = .629

Średnia sympatia (95% CI) według sposobu analizy:
                                  metoda spot    M   lo   hi
           Monadyczny (200 osób na spot)    A 4.75 4.56 4.94
           Monadyczny (200 osób na spot)    B 4.71 4.54 4.88
           Monadyczny (200 osób na spot)    C 5.38 5.19 5.56
           Monadyczny (200 osób na spot)    D 4.63 4.45 4.81
        Sekwencyjny: tylko pierwszy spot    A 4.94 4.63 5.25
        Sekwencyjny: tylko pierwszy spot    B 4.82 4.56 5.09
        Sekwencyjny: tylko pierwszy spot    C 5.48 5.24 5.73
        Sekwencyjny: tylko pierwszy spot    D 4.86 4.56 5.16
            Sekwencyjny: wszystkie oceny    A 4.41 4.27 4.55
            Sekwencyjny: wszystkie oceny    B 4.49 4.36 4.63
            Sekwencyjny: wszystkie oceny    C 5.13 4.99 5.27
            Sekwencyjny: wszystkie oceny    D 4.39 4.24 4.54
 Sekwencyjny: model mieszany (pozycja 1)    A 4.88 4.70 5.06
 Sekwencyjny: model mieszany (pozycja 1)    B 4.92 4.75 5.09
 Sekwencyjny: model mieszany (pozycja 1)    C 5.47 5.30 5.64
 Sekwencyjny: model mieszany (pozycja 1)    D 4.82 4.65 4.99
Różnica C – B według sposobu analizy:
                                  metoda    M
           Monadyczny (200 osób na spot) 0.67
        Sekwencyjny: tylko pierwszy spot 0.66
            Sekwencyjny: wszystkie oceny 0.64
 Sekwencyjny: model mieszany (pozycja 1) 0.55

Zapamiętanie: OR na każdą kolejną pozycję = 0.73, 95% CI [0.66, 0.81]
4. Symulacja 1000 badań: Rysunek 4
R
# Przepis 4. 1000 badań: pięć sposobów oszacowania różnicy C – B: Rysunek 4
# (korzysta z generuj, mu_symp, sd_osoba, sd_reszta, spoty, kol i motyw z przepisu 1)
library(ggplot2)

# Prawdziwa różnica C – B w planie monadycznym na skali 1–7 (po zaokrągleniu i ucięciu ocen)
sd_c <- sqrt(sd_osoba^2 + sd_reszta^2)
e_ocena <- function(m) { k <- 1:7; g <- c(-Inf, 1.5:6.5, Inf); sum(k * diff(pnorm(g, m, sd_c))) }
prawda <- e_ocena(mu_symp[["C"]]) - e_ocena(mu_symp[["B"]])
cat(sprintf("Prawdziwa różnica C – B (plan monadyczny, skala 1–7): %.3f\n", prawda))

# Model z efektem respondenta liczony na odchyleniach od średniej osoby (szybki odpowiednik modelu mieszanego)
efekt_osoby <- function(d) {
  odch <- function(x) x - ave(x, d$osoba)
  X <- model.matrix(~ spot + factor(pozycja) + I(poprzedni == "C"), d)[, -1]
  b <- lm.fit(apply(X, 2, odch), odch(d$sympatia))$coefficients
  c(A = 0, B = b[[1]], C = b[[2]], D = b[[3]])
}
srednie <- function(d) tapply(d$sympatia, d$spot, mean)

set.seed(6691)                                   # osobne ziarno symulacji, ustalone raz
R <- 1000
wyn <- do.call(rbind, lapply(seq_len(R), function(r) {
  d <- generuj()
  s <- subset(d, plan == "sekwencyjny")
  st <- subset(generuj(n_monad = 1, n_sekw = 400, stala = TRUE), plan == "sekwencyjny")
  ocen <- list("Monadyczny\n(200 na spot)" = srednie(subset(d, plan == "monadyczny")),
               "Sekwencyjny:\ntylko pierwszy" = srednie(subset(s, pozycja == 1)),
               "Sekwencyjny:\nwszystkie oceny" = srednie(s),
               "Sekwencyjny:\nmodel z osobą" = efekt_osoby(s),
               "Stała kolejność\nA→B→C→D" = srednie(st))
  data.frame(r = r, metoda = names(ocen), cb = sapply(ocen, function(o) o[["C"]] - o[["B"]]))
}))
wyn$metoda <- factor(wyn$metoda, levels = unique(wyn$metoda))
pod <- do.call(rbind, lapply(split(wyn, wyn$metoda), function(x) data.frame(
  metoda = x$metoda[1], srednia = mean(x$cb), obciazenie = mean(x$cb) - prawda, SD = sd(x$cb),
  RMSE = sqrt(mean((x$cb - prawda)^2)))))
pod$blad_MC_obc <- pod$SD / sqrt(R)
print(transform(pod, metoda = gsub("\n", " ", metoda), srednia = round(srednia, 3), obciazenie = round(obciazenie, 3),
                SD = round(SD, 3), RMSE = round(RMSE, 3), blad_MC_obc = round(blad_MC_obc, 3)), row.names = FALSE)

p4 <- ggplot(wyn, aes(metoda, cb)) +
  geom_hline(yintercept = prawda, linetype = "dashed", colour = kol[["akcent"]]) +
  geom_violin(aes(fill = metoda), colour = NA, alpha = 0.55, scale = "width", width = 0.8) +
  geom_boxplot(width = 0.14, outlier.shape = NA, fill = "white", colour = "grey25") +
  geom_text(data = pod, aes(y = -0.25, label = sub("-", "−", sprintf("obciążenie %+.2f\nSD %.2f", obciazenie, SD))),
            size = 3.7, colour = "grey15", lineheight = 0.95) +
  annotate("text", x = 0.45, y = 1.25, label = sprintf("linia przerywana – prawda: %.2f", prawda), hjust = 0, size = 3.8, colour = kol[["akcent"]]) +
  scale_fill_manual(values = unname(kol[c("monad", "pierwsza", "wszystkie", "model", "stala")]), guide = "none") +
  scale_y_continuous(limits = c(-0.4, 1.3), breaks = seq(0, 1.2, 0.2)) +
  labs(title = "Różnica C – B w 1000 badaniach", subtitle = "Ten sam spot, różne plany i sposoby analizy",
       x = NULL, y = "Oszacowanie różnicy sympatii C – B") + motyw
p4
Wynik w R
Prawdziwa różnica C – B (plan monadyczny, skala 1–7): 0.451
                       metoda srednia obciazenie    SD  RMSE blad_MC_obc
     Monadyczny (200 na spot)   0.452      0.001 0.135 0.135       0.004
  Sekwencyjny: tylko pierwszy   0.442     -0.009 0.194 0.194       0.006
 Sekwencyjny: wszystkie oceny   0.535      0.084 0.086 0.120       0.003
   Sekwencyjny: model z osobą   0.463      0.012 0.087 0.088       0.003
      Stała kolejność A→B→C→D   0.327     -0.124 0.084 0.150       0.003
5. Liczebność próby w obu planach: Rysunek 5
R
# Przepis 5. Ilu respondentów potrzeba w obu planach? Moc testu różnicy C – B: Rysunek 5
# (korzysta z generuj, efekt_osoby, prawda i pod z przepisów 1 i 4 oraz kol i motyw z przepisu 1)
library(ggplot2)

alfa <- .05 / 6                                  # sześć par spotów, ostrożnie: próg Bonferroniego
z_a <- qnorm(1 - alfa / 2)
sd_m <- pod$SD[1]; sd_s <- pod$SD[4]             # rozrzut oszacowań C – B z 1000 badań (800 i 400 osób)
moc <- function(se, d) pnorm(d / se - z_a) + pnorm(-d / se - z_a)
N <- seq(100, 1200, by = 20)                     # łączna liczba respondentów
krzywe <- rbind(data.frame(plan = "Monadyczny (N/4 osób na spot)", N = N, moc = moc(sd_m * sqrt(800 / N), prawda)),
                data.frame(plan = "Sekwencyjny, model z osobą", N = N, moc = moc(sd_s * sqrt(400 / N), prawda)))
n80 <- function(sd0, n0, d) n0 * (sd0 * (z_a + qnorm(.80)) / d)^2
for (d in c(prawda, 0.25))
  cat(sprintf("Różnica %.2f, moc 80%%: monadyczny N = %.0f, sekwencyjny N = %.0f\n", d, n80(sd_m, 800, d), n80(sd_s, 400, d)))

# Sprawdzenie symulacją: 500 badań dla N = 200, 400 i 800
istotny_s <- function(s) {                       # test C – B w modelu z efektem osoby
  odch <- function(x) x - ave(x, s$osoba)
  X <- apply(model.matrix(~ spot + factor(pozycja) + I(poprzedni == "C"), s)[, -1], 2, odch)
  f <- lm.fit(X, odch(s$sympatia)); df <- nrow(s) - length(unique(s$osoba)) - ncol(X)
  V <- sum(f$residuals^2) / df * chol2inv(f$qr$qr[1:ncol(X), 1:ncol(X)])
  l <- c(-1, 1, rep(0, ncol(X) - 2)); est <- sum(l * f$coefficients)
  2 * pt(-abs(est / sqrt(drop(t(l) %*% V %*% l))), df) < alfa
}
set.seed(6692)                                   # osobne ziarno symulacji mocy
sym <- do.call(rbind, lapply(c(200, 400, 800), function(n) {
  r <- replicate(500, {
    d <- generuj(n_monad = n / 4, n_sekw = n)
    m <- subset(d, plan == "monadyczny")
    c(t.test(m$sympatia[m$spot == "C"], m$sympatia[m$spot == "B"], var.equal = TRUE)$p.value < alfa,
      istotny_s(subset(d, plan == "sekwencyjny")))
  })
  data.frame(plan = c("Monadyczny (N/4 osób na spot)", "Sekwencyjny, model z osobą"), N = n, moc = rowMeans(r))
}))
sym$blad_MC <- sqrt(sym$moc * (1 - sym$moc) / 500)
print(transform(sym, moc = round(100 * moc, 1), blad_MC = round(100 * blad_MC, 1),
                wzor = round(100 * moc(ifelse(grepl("Mon", plan), sd_m * sqrt(800 / N), sd_s * sqrt(400 / N)), prawda), 1)),
      row.names = FALSE)

p5 <- ggplot(krzywe, aes(N, 100 * moc, colour = plan)) +
  geom_hline(yintercept = 80, linetype = "dotted", colour = "grey40") +
  geom_line(linewidth = 1.1) +
  geom_point(data = sym, shape = 4, size = 3.2, stroke = 1.2, colour = "black") +
  scale_colour_manual(values = unname(kol[c("monad", "model")])) +
  scale_x_continuous(breaks = seq(200, 1200, 200)) + scale_y_continuous(limits = c(0, 100)) +
  labs(title = sprintf("Moc wykrycia różnicy C – B (%.2f pkt)", prawda), subtitle = "Próg α = .05/6; krzyżyki – 500 symulowanych badań",
       x = "Łączna liczba respondentów N", y = "Moc (%)", colour = NULL) + motyw
p5
Wynik w R
Różnica 0.45, moc 80%: monadyczny N = 868, sekwencyjny N = 180
Różnica 0.25, moc 80%: monadyczny N = 2824, sekwencyjny N = 586
                          plan   N   moc blad_MC  wzor
 Monadyczny (N/4 osób na spot) 200  17.0     1.7  16.7
    Sekwencyjny, model z osobą 200  87.6     1.5  84.8
 Monadyczny (N/4 osób na spot) 400  37.2     2.2  39.1
    Sekwencyjny, model z osobą 400 100.0     0.0  99.5
 Monadyczny (N/4 osób na spot) 800  76.8     1.9  75.9
    Sekwencyjny, model z osobą 800 100.0     0.0 100.0
6. Grafika: schemat dwóch planów (Rysunek 1)
R
# Przepis 6. Grafika: dwa plany pre-testu obok siebie (Rysunek 1)
# (korzysta z monad, sekw, poz, kol i motyw z przepisów 1–3)
library(ggplot2)

f2 <- function(x) formatC(x, format = "f", digits = 2)
kolejnosci <- sapply(split(as.character(sekw$spot), sekw$osoba)[1:3], identity)   # pierwsze trzy osoby planu sekwencyjnego
s1 <- poz$M[poz$wskaznik == "Sympatia do spotu (1–7)"]
ramki <- data.frame(
  x = rep(c(2.3, 7.7), each = 4), y = rep(c(5.25, 2.05, 0.75, -0.35), 2),
  rodzaj = c("start", "ocena", "plus", "minus", "start", "ocena", "minus", "plus"),
  tekst = c(paste(length(unique(monad$osoba)), "respondentów, losowo do 1 z 4 spotów"),
            "po spocie: zapamiętanie marki, sympatia, intencja",
            "+ ocena bez kontekstu innych spotów\n(jak jedna reklama w przerwie)",
            "− przy tej samej precyzji\npotrzeba kilka razy więcej osób",
            paste(length(unique(sekw$osoba)), "respondentów, 4 spoty w losowej kolejności"),
            "ocena po każdym spocie; analiza: model mieszany\nalbo tylko spot na pozycji 1",
            paste0("− efekt kolejności: średnia sympatia\n", f2(s1[1]), " na pozycji 1, ", f2(s1[4]), " na pozycji 4"),
            "+ każdy jest swoją kontrolą:\nmniejsza próba"))
# Plan monadyczny: cztery grupy po jednym spocie
grupy_m <- data.frame(x = 2.3 + c(-1.5, -0.5, 0.5, 1.5), y = 3.65, spot = c("A", "B", "C", "D"),
                      tekst = paste0(as.vector(table(monad$spot)), " osób\nspot ", c("A", "B", "C", "D")))
# Plan sekwencyjny: kolejność spotów u trzech pierwszych osób
kafle <- data.frame(x = 7.7 + rep(c(-0.9, -0.3, 0.3, 0.9), 3), y = rep(c(4.3, 3.65, 3.0), each = 4),
                    spot = as.vector(kolejnosci), pierwszy = rep(c(TRUE, FALSE, FALSE, FALSE), 3))
osoby <- data.frame(x = 7.7 - 1.55, y = c(4.3, 3.65, 3.0), tekst = paste("osoba", 1:3))
wyp <- c(start = "grey93", ocena = "#DCEBF7", plus = "#E3F2EA", minus = "#FBE3D3")
ram <- c(start = "grey55", ocena = "#0072B2", plus = "#009E73", minus = "#D55E00")
strz <- data.frame(x = c(2.3, 2.3, 7.7, 7.7), xend = c(2.3, 2.3, 7.7, 7.7), y = c(4.98, 3.2, 4.98, 2.7), yend = c(4.25, 2.32, 4.6, 2.32))

p1 <- ggplot() +
  annotate("text", x = c(2.3, 7.7), y = 6.05, label = c("Plan monadyczny: każdy widzi 1 spot", "Plan sekwencyjny: każdy widzi 4 spoty"),
           fontface = "bold", size = 5.2, colour = "#0f1d3a") +
  geom_rect(data = ramki, aes(xmin = x - 2.35, xmax = x + 2.35, ymin = y - 0.42, ymax = y + 0.42, fill = rodzaj, colour = rodzaj), linewidth = 0.7) +
  geom_text(data = ramki, aes(x, y, label = tekst), size = 3.9, lineheight = 0.95, colour = "grey10") +
  geom_segment(data = strz, aes(x = x, xend = xend, y = y, yend = yend), arrow = arrow(length = unit(2.2, "mm")), colour = "grey40") +
  geom_rect(data = grupy_m, aes(xmin = x - 0.44, xmax = x + 0.44, ymin = y - 0.45, ymax = y + 0.45), fill = "white", colour = kol[["monad"]], linewidth = 0.8) +
  geom_text(data = grupy_m, aes(x, y, label = tekst), size = 3.9, lineheight = 0.95) +
  geom_rect(data = kafle, aes(xmin = x - 0.26, xmax = x + 0.26, ymin = y - 0.25, ymax = y + 0.25, fill = pierwszy),
            colour = "grey45", linewidth = 0.6, show.legend = FALSE) +
  geom_text(data = kafle, aes(x, y, label = spot), size = 4.6, fontface = "bold") +
  geom_text(data = osoby, aes(x, y, label = tekst), size = 3.7, hjust = 1, colour = "grey25") +
  annotate("text", x = 7.7 + 1.3, y = 3.65, label = "1. spot =\nmały test\nmonadyczny", hjust = 0, size = 3.5, colour = kol[["akcent"]], lineheight = 0.9) +
  annotate("segment", x = 5, xend = 5, y = -0.9, yend = 6.3, colour = "grey80", linetype = "dashed") +
  scale_fill_manual(values = c(wyp, "TRUE" = "#F6D7B0", "FALSE" = "white")) + scale_colour_manual(values = ram, guide = "none") +
  coord_cartesian(xlim = c(-0.2, 10.4), ylim = c(-0.9, 6.3), expand = FALSE) +
  guides(fill = "none") + labs(x = NULL, y = NULL) + motyw +
  theme(axis.text = element_blank(), panel.grid = element_blank())
p1
7. Kontrola palety przy zaburzeniach widzenia barw
R
# Przepis 7. Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("monadyczny – tylko pierwszy" = c("#0072B2", "#E69F00"), "monadyczny – model" = c("#0072B2", "#009E73"),
             "tylko pierwszy – model" = c("#E69F00", "#009E73"), "wszystkie – stała kolejność" = c("grey45", "#CC79A7"),
             "model – stała kolejność" = c("#009E73", "#CC79A7"), "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
hex <- function(k) rgb(t(col2rgb(k)), maxColorValue = 255)
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(hex(k)), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(hex(k))),
                                   protanopia = roznica(protan(hex(k)))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
monadyczny – tylko pierwszy                120.2        121.5      109.3
monadyczny – model                          70.1         55.4       58.0
tylko pierwszy – model                      88.7         66.3       51.5
wszystkie – stała kolejność                 41.9         16.2       19.8
model – stała kolejność                     87.5         18.1       36.2
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, ANOVA, testy t, poprawkę Holma i symulacje policzono w pakiecie stats wbudowanym w R. Modele mieszane dopasowano pakietem lme4, a test t kontrastu i test interakcji ze stopniami swobody Satterthwaite’a – pakietem lmerTest. Rysunki wykonano w pakietach ggplot2 i patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2.1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1), 1–49. https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Stała kolejność spotów. W symulacji zaniżyła różnicę C – B o 0.12 punktu i żaden model tego nie naprawi.
- Średnie ze wszystkich pozycji porównane z normą. Spot C miał 5.13 zamiast 5.38 tylko dlatego, że oglądano go także jako drugi, trzeci i czwarty.
- Analiza ocen jak niezależnych obserwacji. Cztery oceny jednej osoby to nie cztery osoby (ICC = .28).
- Przeniesienie pominięte w modelu. Proste średnie zawyżyły różnicę o 0.08 punktu.
- Sześć par bez korekty. Przy kilku spotach któraś para „wygra” przez przypadek.
Najczęstsze pytania
Czym różni się test monadyczny od sekwencyjnego w badaniu reklamy?
W teście monadycznym każdy respondent widzi i ocenia tylko jedną wersję reklamy, więc ocena nie zależy od innych wersji. W teście sekwencyjnym (sekwencyjno-monadycznym) respondent ocenia kilka wersji po kolei, każdą osobno. Sekwencyjny wymaga mniejszej próby, bo każdy jest swoją kontrolą, ale wprowadza efekt kolejności i przeniesienia.
Czy w pre-teście reklamy trzeba losować kolejność spotów?
Tak. Przy stałej kolejności efekt spotu miesza się z efektem pozycji – w symulacji różnica między dwoma spotami była zaniżona o 0.12 punktu i żaden model tego nie naprawił. Najlepiej zrównoważyć kolejność (każdy spot na każdej pozycji tyle samo razy, np. kwadrat łaciński) i zapisać ją w danych.
Jak analizować dane z testu sekwencyjnego kilku reklam?
Modelem mieszanym: ocena zależy od spotu, pozycji i spotu poprzedzającego, a respondent ma losowy wyraz wolny. Cztery oceny jednej osoby nie są niezależne. Gdy potrzebujesz poziomu porównywalnego z testami monadycznymi, analizuj osobno spot oglądany jako pierwszy.
Ilu respondentów potrzeba do pre-testu reklamy?
Zależy od planu i różnicy, którą chcesz wykryć. W przykładzie różnicę 0.45 punktu na skali 1–7 z mocą 80% i korektą na sześć par wykrywa 868 osób w planie monadycznym (217 na spot) i 180 w sekwencyjnym. Przy różnicy 0.25 punktu to 2824 i 586 osób.
Co to jest efekt przeniesienia w badaniu reklamy?
To wpływ poprzedniej reklamy na ocenę następnej. Najczęściej działa jak kontrast: słabszy spot oglądany zaraz po mocnym wypada gorzej. W przykładzie spoty oglądane po najlepszym spocie dostały średnio 4.09 punktu, a po innych – 4.40. Uwzględnij to w modelu i równoważ, który spot następuje po którym.
Powiązane hasła
Przeczytaj też
Test A/B z wieloma wariantami
Pięć tematów maila i kontrola: Dunnett, Holm i Tukey, klątwa zwycięzcy w 1000 symulacji, test potwierdzający i moc – pięć rysunków z kodem R.
Czytaj →PoradnikLiczebność próby w eksperymencie ankietowym
Ile osób na warunek przy małych efektach, ile daje kowariata przed bodźcem i plan wewnątrzosobowy, ile kosztują dodatkowe warunki i ubytek.
Czytaj →PoradnikAnaliza eksperymentu ankietowego
Kolejność analizy eksperymentu w ankiecie: SMD bez testów, różnica średnich z CI i d, ANCOVA i estymator Lina, kontrasty i AME, z kodem R.
Czytaj →PoradnikTest koncepcji: monadyczny czy sekwencyjny
Cztery koncepcje napoju roślinnego: efekt pozycji i kontrastu, model mieszany, moc obu układów, top-2-box i analiza pierwszej pozycji – z kodem R.
Czytaj →Testujesz kilka wersji reklamy?
Pomożemy wybrać plan pre-testu, zrównoważyć kolejność, policzyć liczebność, dopasować model mieszany i opisać wynik tak, żebyś umiał(a) go obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Barr, D. J., Levy, R., Scheepers, C., & Tily, H. J. (2013). Random effects structure for confirmatory hypothesis testing: Keep it maximal. Journal of Memory and Language, 68(3), 255–278. https://doi.org/10.1016/j.jml.2012.11.001 ● Otwarty dostęp: pełny tekst
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01 ● Otwarty dostęp
- Brooks, J. L. (2012). Counterbalancing for serial order carryover effects in experimental condition orders. Psychological Methods, 17(4), 600–614. https://doi.org/10.1037/a0029310 ● Otwarty dostęp: pełny tekst
- Greenwald, A. G. (1976). Within-subjects designs: To use or not to use? Psychological Bulletin, 83(2), 314–320. https://doi.org/10.1037/0033-2909.83.2.314
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70. https://www.jstor.org/stable/4615733
- Morwitz, V. G., Steckel, J. H., & Gupta, A. (2007). When do purchase intentions predict sales? International Journal of Forecasting, 23(3), 347–364. https://doi.org/10.1016/j.ijforecast.2007.05.015 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{barr2013random, author={Barr, Dale J. and Levy, Roger and Scheepers, Christoph and Tily, Harry J.}, title={{Random effects structure for confirmatory hypothesis testing: Keep it maximal}}, journal={Journal of Memory and Language}, year={2013}, volume={68}, number={3}, pages={255--278}, doi={10.1016/j.jml.2012.11.001}}@article{bates2015fitting, author={Bates, Douglas and Mächler, Martin and Bolker, Ben and Walker, Steve}, title={{Fitting linear mixed-effects models using lme4}}, journal={Journal of Statistical Software}, year={2015}, volume={67}, number={1}, pages={1--48}, doi={10.18637/jss.v067.i01}}@article{brooks2012counterbalancing, author={Brooks, Joseph L.}, title={{Counterbalancing for serial order carryover effects in experimental condition orders}}, journal={Psychological Methods}, year={2012}, volume={17}, number={4}, pages={600--614}, doi={10.1037/a0029310}}@article{greenwald1976within, author={Greenwald, Anthony G.}, title={{Within-subjects designs: To use or not to use?}}, journal={Psychological Bulletin}, year={1976}, volume={83}, number={2}, pages={314--320}, doi={10.1037/0033-2909.83.2.314}}@article{holm1979simple, author={Holm, Sture}, title={{A simple sequentially rejective multiple test procedure}}, journal={Scandinavian Journal of Statistics}, year={1979}, volume={6}, number={2}, pages={65--70}, url={https://www.jstor.org/stable/4615733}}@article{morwitz2007when, author={Morwitz, Vicki G. and Steckel, Joel H. and Gupta, Alok}, title={{When do purchase intentions predict sales?}}, journal={International Journal of Forecasting}, year={2007}, volume={23}, number={3}, pages={347--364}, doi={10.1016/j.ijforecast.2007.05.015}}