Przykład: catering pudełkowy i pytanie „ilu klientów będzie w nowym mieście?”
Fikcyjny catering dietetyczny (pięć posiłków dziennie w pudełkach) wchodzi do nowych miast. Przed startem zleca ankietę w panelu internetowym z jednym kluczowym pytaniem: „Czy w ciągu 3 miesięcy od startu zamówisz próbny pakiet (5 dni) za 69 zł dziennie?”. Odpowiedzi tworzą pięciostopniową skalę porządkową: 1 = na pewno nie, 2 = raczej nie, 3 = trudno powiedzieć, 4 = raczej tak, 5 = na pewno tak. Pytamy też, czy ktoś zamawiał już catering dietetyczny innej firmy.
W mieście A firma działa od kwartału, a panel pozwolił połączyć ankietę sprzed startu z późniejszymi zamówieniami (za zgodą badanych). Wiemy więc, kto zadeklarował zakup, a kto naprawdę kupił. W mieście B ankieta dopiero się skończyła i dział marketingu pyta: ilu z 240 000 dorosłych w strefie dostaw zamówi pakiet w pierwszych 3 miesiącach?
Dane są fikcyjne, więc znamy prawdę. Ręcznie ustaliliśmy rozkład odpowiedzi i prawdopodobieństwa zamówienia osobno dla dwóch segmentów. Osoby nowe w kategorii odpowiadają 1–5 z prawdopodobieństwami .30, .25, .25, .14 i .06, a zamawiają odpowiednio z prawdopodobieństwem .005, .01, .03, .08 i .20. Osoby znające catering odpowiadają z prawdopodobieństwami .12, .15, .28, .28 i .17, a zamawiają z prawdopodobieństwem .01, .03, .08, .22 i .45. Znający kategorię to 35% panelu w mieście A i 15% rynku w mieście B; w panelu B mają 2.4 raza większą szansę trafienia do próby niż reszta. W każdym mieście ankietę wypełnia 1000 osób. Ziarno to 680; po pierwszym uruchomieniu nie zmienialiśmy ani parametrów, ani ziarna, poprawiliśmy tylko układ rysunków. Dane pobierzesz jako deklaracja-zakupu-catering-ankieta.csv (wiersz = respondent: miasto, segment, odpowiedź, zamówienie; w mieście B zamówień jeszcze nie ma).
Rysunek 1: od deklaracji do zakupu
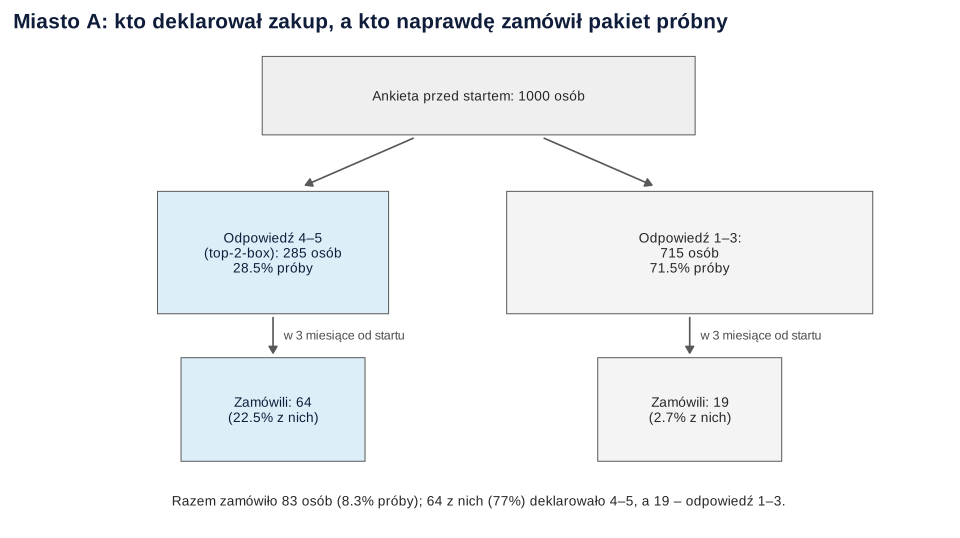
set.seed(680)).Co widać. Odpowiedź 4 albo 5 wybrało 285 z 1000 osób (28.5%). To popularny wskaźnik top-2-box. Pakiet zamówiło jednak tylko 64 z nich (22.5%). Kupiło też 19 z 715 osób z odpowiedzią 1–3 (2.7%). Razem zamówiło 83 osoby, czyli 8.3% próby – ponad trzy razy mniej, niż sugeruje top-2-box.
Jak może zmylić. Lejek pokazuje jedną próbę i jeden horyzont. Morwitz i in. (2007) w przeglądzie wielu badań stwierdzili, że deklaracje silniej wiążą się z zakupami przy krótkim horyzoncie, pytaniu o konkretną markę oraz dla produktów istniejących niż nowych.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: odsetek kupujących według odpowiedzi
Zamiast jednej liczby (top-2-box) liczymy dla każdej odpowiedzi osobno, jaki odsetek osób naprawdę kupił. To współczynniki konwersji deklaracji. Na wykresie zestawiamy je z odczytem naiwnym, w którym odpowiedź 1–5 traktuje się jak prawdopodobieństwo 0, 25, 50, 75 i 100%. Taki rysunek to zwykły wykres kalibracji: gdyby deklaracje były trafnymi prawdopodobieństwami, punkty leżałyby na przekątnej. Przedziały to przedziały Wilsona dla odsetka (przedział ufności dla proporcji).
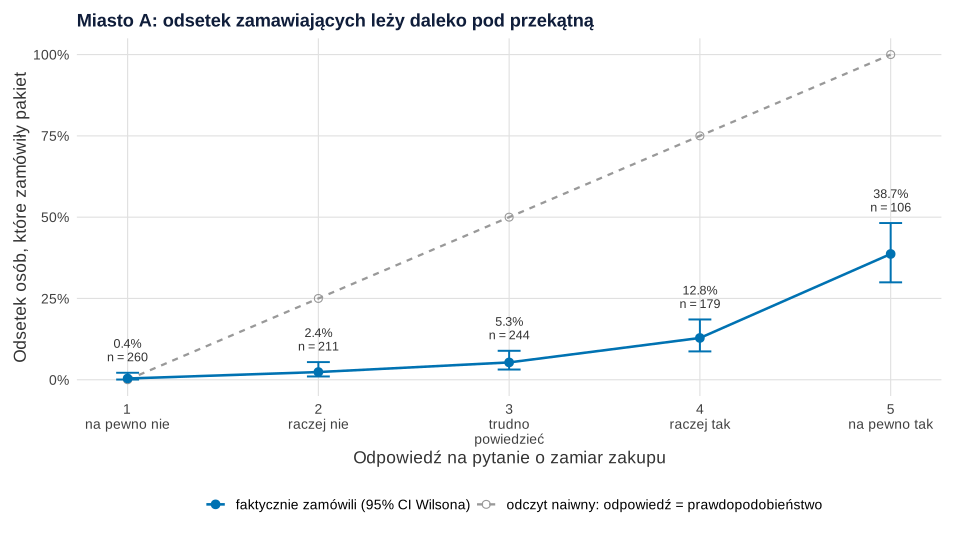
set.seed(680)).Co widać. Odsetek zamawiających rośnie z każdą odpowiedzią: 0.4% (1 z 260), 2.4%, 5.3%, 12.8% i 38.7% (41 ze 106 osób z odpowiedzią „na pewno tak”; 95% CI [30.0, 48.2]). Kolejność jest trafna, poziom – nie: odczyt naiwny daje średnio 41.5%, top-2-box 28.5%, a zamówiło 8.3%.
Jak może zmylić. Współczynniki dotyczą tego produktu, tej ceny, tego horyzontu i tego panelu. Kalwani i Silk (1982) znaleźli inny kształt tej zależności dla dóbr trwałych (liniowy) niż dla markowych produktów paczkowanych (z progiem), a Jamieson i Bass (1989) przypominają, że badania łączące deklaracje z zachowaniem często stwierdzały duże rozbieżności, i porównują modele korygujące deklaracje o inne oceny produktu.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: ta sama „piątka” w dwóch segmentach
Czy odpowiedź „na pewno tak” znaczy to samo dla kogoś, kto zna catering, i dla kogoś, kto nigdy go nie zamawiał? Sprawdzamy to regresją logistyczną zamówienia na odpowiedzi (5 kategorii) i segmencie, a potem dokładamy interakcję odpowiedź × segment. Modele porównujemy testem ilorazu wiarygodności.
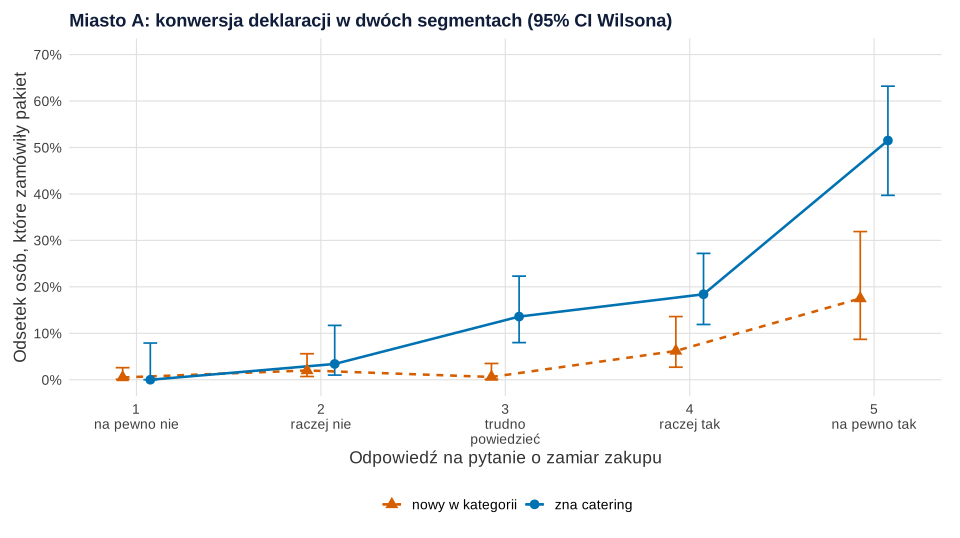
set.seed(680)).Co widać. Przy tej samej deklaracji znający catering zamawiają częściej: z odpowiedzią 5 – 51.5% (34 z 66), a nowi w kategorii – 17.5% (7 z 40). Dodanie segmentu wyraźnie poprawia model, χ²(1) = 32.65, p < .001; przy tej samej odpowiedzi szansa zamówienia jest u znających kategorię 4.86 raza większa (OR, 95% CI [2.70, 8.73]). Interakcja nie poprawia modelu istotnie, χ²(4) = 6.67, p = .155. To „nowość kategorii” w liczbach: nowicjusz deklaruje łatwiej, bo nie zna ceny ani smaku.
Jak może zmylić. Komórki są małe: w segmencie nowych odpowiedź 3 dała 1 zamówienie na 156 osób (0.6%), choć w danych ukryliśmy 3%. Brak istotnej interakcji przy kilkudziesięciu osobach w części komórek nie dowodzi, że jej nie ma. Morwitz i Schmittlein (1992) pokazali, że podział respondentów na segmenty o różnej realizacji deklaracji poprawia prognozy sprzedaży z intencji; segmenty warto wybierać pod kątem samego zakupu, a nie przez proste grupowanie (o grupowaniu: analiza skupień w marketingu).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: próba z panelu a rynek
Teraz miasto B. Prognoza ma dotyczyć całego rynku, a ankieta pochodzi z panelu, do którego chętniej zapisują się i odpowiadają osoby zainteresowane tematem. To pytanie o reprezentatywność próby, a nie o jej wielkość.
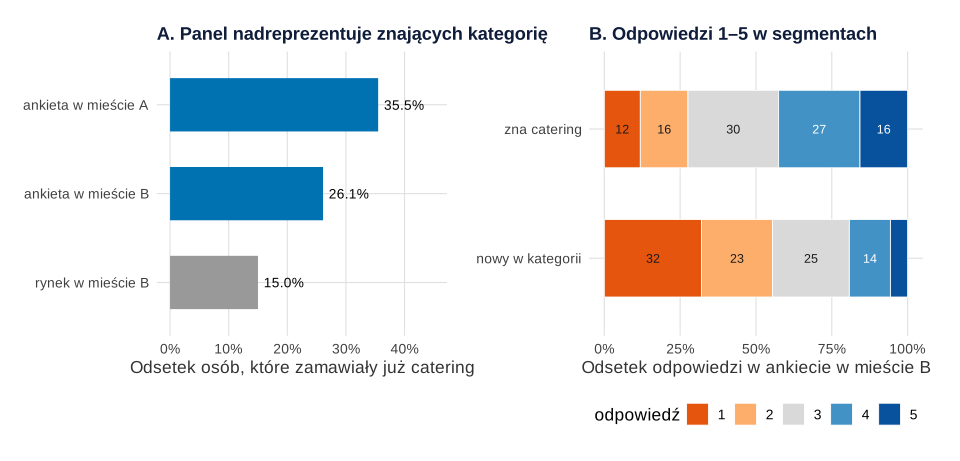
set.seed(680)).Co widać. Znający catering stanowią 26.1% próby w mieście B, a tylko 15.0% rynku. W ankiecie A było ich jeszcze więcej (35.5%). Ten segment deklaruje dużo chętniej: odpowiedź 4–5 wybrało 42.5% znających i 19.2% nowych. Nadreprezentacja entuzjastów zawyża więc top-2-box (25.3% w próbie wobec 23.7% na całym rynku) i prognozę.
Jak może zmylić. Udział 15% bierzemy z zewnętrznego badania i traktujemy jako pewny – jego błąd nie wchodzi do przedziałów niżej. Ważenie naprawia tylko te różnice, które mierzymy; jeśli panel przyciąga ludzi bardziej skłonnych do zakupów w obrębie segmentu, waga tego nie zobaczy (ważenie danych sondażowych krok po kroku).
Podpis do pracy:
Zdanie do Metody:
Rysunek 5: cztery prognozy i bootstrap
Z tej samej ankiety B liczymy cztery prognozy liczby klientów w 3 miesiące:
- surowa: top-2-box × 240 000;
- kalibracja z miasta A: odsetek każdej odpowiedzi w B × współczynnik konwersji tej odpowiedzi z A (rysunek 2), zsumowane i razy rynek;
- kalibracja + ważenie: jak wyżej, ale rozkład odpowiedzi przeważony do 15% znających kategorię (wagi poststratyfikacyjne);
- kalibracja w segmentach + ważenie: osobny rozkład odpowiedzi i osobne konwersje w każdym segmencie, segmenty zważone udziałem w rynku.
Słowami: dla każdego segmentu mnożysz odsetek osób z daną odpowiedzią przez odsetek, który przy tej odpowiedzi naprawdę kupuje, sumujesz, ważysz segmenty ich udziałem w rynku i mnożysz przez wielkość rynku. Niepewność daje bootstrap (Efron, 1979): 2000 razy losujemy ze zwracaniem respondentów obu ankiet – A, bo z niej są konwersje, i B, bo z niej jest rozkład odpowiedzi – i liczymy prognozy od nowa (mechanizm: bootstrap – wizualizacja na obrazkach).
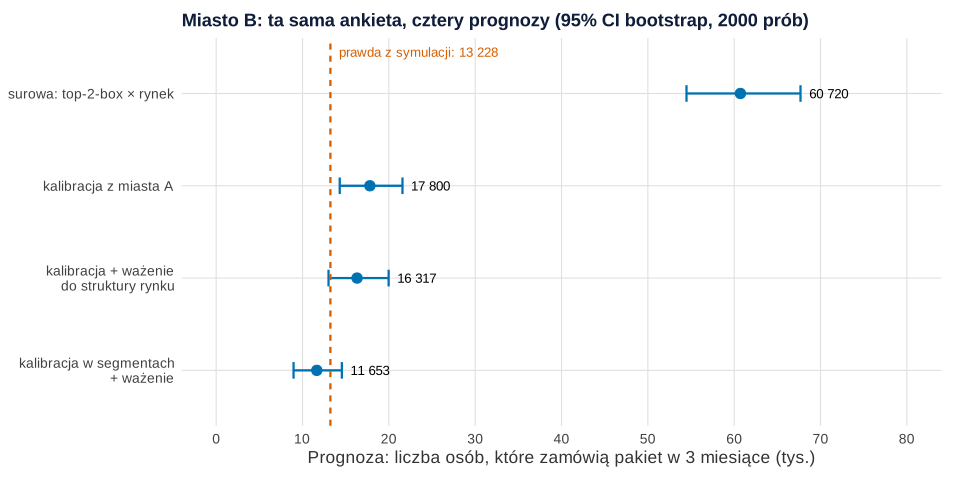
set.seed(680)).Co widać. W mieście B zamówi naprawdę 13 228 osób (5.51% rynku). Surowa prognoza daje 60 720 (95% CI [54 474, 67 680]) – 4.6 raza za dużo, i to z wąskim przedziałem, który pewnie wskazuje zły wynik. Kalibracja z miasta A sprowadza prognozę do 17 800 [14 310, 21 578] (+34.6%), ważenie do struktury rynku – do 16 317 [13 013, 19 975] (+23.3%), a kalibracja w segmentach z ważeniem daje 11 653 [8 961, 14 556] (−11.9%). Każdy krok usuwa jedno źródło obciążenia: przesadne deklaracje, nadreprezentację entuzjastów i różną wartość deklaracji w segmentach.
Jak może zmylić. Ostatnia prognoza wylądowała poniżej prawdy przez przypadek w małych komórkach (0.6% zamówień przy odpowiedzi 3 u nowych zamiast ukrytych 3%); przedział obejmuje prawdę, ale jest szeroki – od 9 do 15 tys. klientów. Przedział bootstrapowy mierzy tylko losowość obu ankiet. Nie obejmuje różnic między miastami, ceny ani reklamy przy starcie. Przy prognozie dalej niż na pierwsze miesiące połącz tę liczbę z modelem rozchodzenia się nowego produktu (model dyfuzji Bassa), a wielkość rynku policz jak we wpisie wielkość rynku z ankiety.
Podpis do pracy:
Zdanie do Wyników:
Co z tym zrobić w marketingu
- Nie planuj kuchni i kierowców na top-2-box. W przykładzie byłoby to 60 tys. klientów zamiast 13 tys. Raportuj top-2-box tylko do porównań konceptów badanych tą samą metodą (np. w pre-teście kreacji reklamowych).
- Zbuduj własną bazę konwersji. Przy każdym starcie łącz ankietę z zamówieniami (kod rabatowy, numer telefonu w panelu – za zgodą) i zapisuj odsetek kupujących dla każdej odpowiedzi, produktu, ceny i horyzontu.
- Pytaj o konkret: pakiet, cenę i horyzont („w ciągu 3 miesięcy”), a nie „czy byłbyś zainteresowany”. Zasady pytania o cenę opisuje wpis badanie ceny: van Westendorp i Gabor–Granger.
- Licz konwersje w segmentach, które różnią się realizacją deklaracji (znajomość kategorii, wcześniejsze zakupy), a próbę waż do struktury rynku.
- Podawaj zarządowi przedział, nie punkt. 9–15 tys. klientów to inna decyzja o liczbie kuchni niż „11 653”.
- Po starcie sprawdź prognozę. Porównanie prognozy z zamówieniami w mieście B to kolejny punkt do bazy konwersji; kto nie odpowiada na ankiety po zakupie, opisuje wpis ankieta po zakupie i brak odpowiedzi.
Jak opisać w pracy
W Metodzie podaj dokładne brzmienie pytania i skali, horyzont, źródło danych o zakupach (jak połączono ankietę z zamówieniami), definicję segmentów, źródło struktury rynku i metodę przedziałów. W Wynikach – tabelę współczynników konwersji z przedziałami, wynik testu segmentu i prognozę z przedziałem. Ocena kalibracji to ten sam pomysł co w modelach predykcyjnych: Steyerberg i in. (2010) zalecają raportować ją zawsze obok zdolności odróżniania. Więcej przykładów prac: statystyka w pracy z marketingu.
Kod R: deklaracje, konwersje, segmenty i prognoza z bootstrapem
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, z których korzystają przepisy 2–4. Wszystko liczymy w bazowym R (prop.test(), glm(), anova(), bootstrap pętlą replicate()). Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (dane) i 4 (bootstrap); każdy zaczyna losowanie od własnego set.seed(680). Ziarno 680 ustalono raz i nie zmieniano go. Ręcznie ustalono: rozkłady odpowiedzi i prawdopodobieństwa zamówienia w dwóch segmentach, udział znających catering (35% w panelu A, 15% na rynku B), 2.4 raza większą szansę trafienia znających kategorię do próby w B, liczebności ankiet (po 1000 osób) i wielkość rynku B (240 000). Parametrów po pierwszym uruchomieniu nie zmieniano. Powtórzenia: bootstrap 2000 prób. Całość liczy się w kilka sekund.
1. Paleta, motyw i dane z dwóch miast
R
# Przepis 1. Fikcyjny catering dietetyczny: ankieta z intencją zakupu i późniejsze zakupy (dane symulowane)
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         blekit = "#56B4E9", fiolet = "#CC79A7", szary = "grey60", ciemny = "grey20")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustalone ręcznie ---------------------------------------------------------------
# Pytanie: „Czy w ciągu 3 miesięcy od startu zamówisz próbny pakiet (5 dni) za 69 zł dziennie?”
# 1 = na pewno nie, 2 = raczej nie, 3 = trudno powiedzieć, 4 = raczej tak, 5 = na pewno tak
odp_nowi   <- c(0.30, 0.25, 0.25, 0.14, 0.06)   # P(odpowiedź) – nigdy nie zamawiali cateringu dietetycznego
odp_znaja  <- c(0.12, 0.15, 0.28, 0.28, 0.17)   # P(odpowiedź) – zamawiali już catering (innej firmy)
kup_nowi   <- c(0.005, 0.01, 0.03, 0.08, 0.20)  # P(zakup w 3 miesiące | odpowiedź) – nowi w kategorii
kup_znaja  <- c(0.01, 0.03, 0.08, 0.22, 0.45)   # P(zakup w 3 miesiące | odpowiedź) – znający kategorię
N_B        <- 240000   # dorośli 25–59 lat w strefie dostaw w mieście B (rynek docelowy)
udzial_B   <- 0.15     # odsetek znających kategorię na rynku B (z zewnętrznego badania, traktujemy jako znany)
udzial_A   <- 0.35     # odsetek znających kategorię w próbie z panelu w mieście A
szansa_panel <- 2.4    # znający kategorię chętniej biorą udział w ankiecie z panelu w mieście B

osoby <- function(znaja) {          # losuje odpowiedź i zakup dla wektora 0/1 „zna kategorię”
  n <- length(znaja)
  odp <- ifelse(znaja == 1, sample(1:5, n, TRUE, odp_znaja), sample(1:5, n, TRUE, odp_nowi))
  p_kup <- ifelse(znaja == 1, kup_znaja[odp], kup_nowi[odp])
  data.frame(segment = ifelse(znaja == 1, "zna catering", "nowy w kategorii"), odp = odp,
             kupil = rbinom(n, 1, p_kup))
}
set.seed(680)
# Miasto A (pilotaż): ankieta w panelu przed startem, zakupy połączone po 3 miesiącach
miasto_A <- osoby(rbinom(1000, 1, udzial_A))
# Miasto B: cały rynek (prawdy analityk nie zna) i ankieta z panelu przed startem
rynek_B <- osoby(rbinom(N_B, 1, udzial_B))
w_proba <- sample(N_B, 1000, prob = ifelse(rynek_B$segment == "zna catering", szansa_panel, 1))
proba_B <- rynek_B[w_proba, c("segment", "odp")]     # w mieście B zakupów jeszcze nie ma

dane <- rbind(data.frame(miasto = "A", miasto_A), data.frame(miasto = "B", proba_B, kupil = NA))
dane$osoba <- seq_len(nrow(dane))
write.csv(dane[, c("osoba", "miasto", "segment", "odp", "kupil")], "deklaracja-zakupu-catering-ankieta.csv",
          row.names = FALSE, na = "")

# Opis prób: liczebność, odsetek znających kategorię, top-2-box (odpowiedzi 4–5) i zakupy
opis <- function(d) c(n = nrow(d), zna_proc = 100 * mean(d$segment == "zna catering"),
                      top2_proc = 100 * mean(d$odp >= 4), top1_proc = 100 * mean(d$odp == 5))
round(rbind(miasto_A = opis(miasto_A), proba_B = opis(proba_B), rynek_B = opis(rynek_B)), 1)
table(miasto_A = miasto_A$odp)
c(kupilo_A = sum(miasto_A$kupil), kupilo_A_proc = round(100 * mean(miasto_A$kupil), 1))
# Prawda znana tylko w symulacji: ilu mieszkańców B zamówi pakiet w 3 miesiące
c(prawda_B = sum(rynek_B$kupil), prawda_B_proc = round(100 * mean(rynek_B$kupil), 2))
Wynik w R
              n zna_proc top2_proc top1_proc
miasto_A   1000     35.5      28.5      10.6
proba_B    1000     26.1      25.3       8.3
rynek_B  240000     15.0      23.7       7.7
miasto_A
  1   2   3   4   5
260 211 244 179 106
     kupilo_A kupilo_A_proc
         83.0           8.3
     prawda_B prawda_B_proc
     13228.00          5.51
2. Lejek „deklaruje → kupuje”: Rysunek 1
R
# Rysunek 1. Grafika: lejek „deklaruje → kupuje” w mieście A (liczby z przepisu 1)
# Korzysta z obiektów miasto_A i kol z przepisu 1; niczego nie losuje.
top2 <- miasto_A$odp >= 4
lejek <- data.frame(
  y = c(3, 2, 2, 1, 1),
  x = c(0, -1.9, 1.95, -1.9, 1.95),
  n = c(nrow(miasto_A), sum(top2), sum(!top2), sum(miasto_A$kupil[top2]), sum(miasto_A$kupil[!top2])),
  grupa = c("wszyscy", "deklaracja", "reszta", "deklaracja", "reszta"))
lejek$szer <- 4 * sqrt(lejek$n / nrow(miasto_A))   # pole prostokąta rośnie z liczbą osób
lejek$szer <- pmax(lejek$szer, 1.7)                  # najmniejsze pola poszerzone, żeby zmieścić tekst
lejek$opis <- c(sprintf("Ankieta przed startem: %d osób", lejek$n[1]),
                sprintf("Odpowiedź 4–5\n(top-2-box): %d osób\n%.1f%% próby", lejek$n[2], 100 * lejek$n[2] / lejek$n[1]),
                sprintf("Odpowiedź 1–3:\n%d osób\n%.1f%% próby", lejek$n[3], 100 * lejek$n[3] / lejek$n[1]),
                sprintf("Zamówili: %d\n(%.1f%% z nich)", lejek$n[4], 100 * lejek$n[4] / lejek$n[2]),
                sprintf("Zamówili: %d\n(%.1f%% z nich)", lejek$n[5], 100 * lejek$n[5] / lejek$n[3]))
kupili <- sum(miasto_A$kupil)
p1 <- ggplot(lejek) +
  geom_tile(aes(x, y, width = szer, height = c(0.5, 0.78, 0.78, 0.66, 0.66), fill = grupa), colour = "grey35", linewidth = 0.35) +
  geom_text(aes(x, y, label = opis, colour = grupa == "deklaracja"), size = 3.6, lineheight = 0.92, show.legend = FALSE) +
  annotate("segment", x = c(-0.6, 0.6), xend = c(-1.6, 1.6), y = 2.73, yend = 2.43,
           arrow = arrow(length = unit(0.2, "cm"), type = "closed"), colour = "grey35") +
  annotate("segment", x = c(-1.9, 1.95), xend = c(-1.9, 1.95), y = 1.59, yend = 1.36,
           arrow = arrow(length = unit(0.2, "cm"), type = "closed"), colour = "grey35") +
  annotate("text", x = 0, y = 0.42, size = 3.6, colour = "grey15",
           label = sprintf("Razem zamówiło %d osób (%.1f%% próby); %d z nich (%.0f%%) deklarowało 4–5, a %d – odpowiedź 1–3.",
                           kupili, 100 * kupili / nrow(miasto_A), lejek$n[4], 100 * lejek$n[4] / kupili, lejek$n[5])) +
  annotate("text", x = c(-1.8, 2.05), y = 1.475, hjust = 0, size = 3.3, colour = "grey30", label = "w 3 miesiące od startu") +
  scale_fill_manual(values = c(wszyscy = "#EFEFEF", deklaracja = "#DCEEF8", reszta = "#F4F4F4")) +
  scale_colour_manual(values = c(`TRUE` = "#0f1d3a", `FALSE` = "grey15")) +
  coord_cartesian(xlim = c(-4.3, 4.3), ylim = c(0.25, 3.35), expand = FALSE) +
  labs(title = "Miasto A: kto deklarował zakup, a kto naprawdę zamówił pakiet próbny") +
  theme_void(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", margin = margin(b = 6)),
        legend.position = "none", plot.background = element_rect(fill = "white", colour = NA),
        plot.margin = margin(10, 12, 8, 10))
p1   # zapis: ggsave("deklaracja-zakupu-lejek.svg", p1, width = 10, height = 5.6)
3. Współczynniki konwersji i segmenty: Rysunki 2 i 3
R
# Rysunki 2 i 3. Współczynniki konwersji deklaracji w mieście A: ogółem i w segmentach
# Korzysta z obiektów miasto_A, kol i motyw z przepisu 1; niczego nie losuje.
wilson <- function(k, n) {                  # przedział Wilsona dla odsetka
  if (n == 0) return(c(NA, NA))
  prop.test(k, n, correct = FALSE)$conf.int[1:2]
}
konwersja <- function(d) {                  # tabela: odpowiedź → odsetek zamawiających z 95% CI
  t(sapply(1:5, function(k) {
    x <- d$kupil[d$odp == k]
    c(odp = k, n = length(x), kupilo = sum(x), proc = 100 * mean(x), 100 * wilson(sum(x), length(x)))
  }))
}
tab_ogol <- konwersja(miasto_A)
colnames(tab_ogol)[5:6] <- c("ci_dol", "ci_gora")
round(tab_ogol, 1)
# Odczyt naiwny: odpowiedź jako prawdopodobieństwo (1 = 0%, 2 = 25%, 3 = 50%, 4 = 75%, 5 = 100%)
naiwnie <- c(0, 25, 50, 75, 100)
c(naiwna_prognoza_proc = mean(naiwnie[miasto_A$odp]), top2_proc = 100 * mean(miasto_A$odp >= 4),
  faktycznie_proc = 100 * mean(miasto_A$kupil))

tab_seg <- do.call(rbind, lapply(split(miasto_A, miasto_A$segment), function(d)
  data.frame(segment = d$segment[1], konwersja(d))))
names(tab_seg)[6:7] <- c("ci_dol", "ci_gora")
tab_seg[, 4:7] <- round(tab_seg[, 4:7], 1)
tab_seg
# Czy konwersja deklaracji zależy od segmentu? Regresja logistyczna i testy ilorazu wiarygodności
m0 <- glm(kupil ~ factor(odp), family = binomial, data = miasto_A)
m1 <- glm(kupil ~ factor(odp) + segment, family = binomial, data = miasto_A)
m2 <- glm(kupil ~ factor(odp) * segment, family = binomial, data = miasto_A)
anova(m0, m1, m2, test = "LRT")
round(exp(cbind(OR = coef(m1), confint.default(m1)))["segmentzna catering", ], 2)

# Rysunek 2: odsetek zamawiających według odpowiedzi wobec odczytu naiwnego
d2 <- data.frame(tab_ogol, naiwnie = naiwnie)
p2 <- ggplot(d2, aes(odp)) +
  geom_line(aes(y = naiwnie, linetype = "odczyt naiwny: odpowiedź = prawdopodobieństwo"), colour = kol[["szary"]], linewidth = 0.8) +
  geom_point(aes(y = naiwnie, shape = "odczyt naiwny: odpowiedź = prawdopodobieństwo"), colour = kol[["szary"]], size = 2.4) +
  geom_errorbar(aes(ymin = ci_dol, ymax = ci_gora), width = 0.12, colour = kol[["niebieski"]], linewidth = 0.7) +
  geom_line(aes(y = proc, linetype = "faktycznie zamówili (95% CI Wilsona)"), colour = kol[["niebieski"]], linewidth = 0.9) +
  geom_point(aes(y = proc, shape = "faktycznie zamówili (95% CI Wilsona)"), colour = kol[["niebieski"]], size = 3) +
  geom_text(aes(y = ci_gora + 7, label = sprintf("%.1f%%\nn = %d", proc, n)), size = 3.3, lineheight = 0.9, colour = kol[["ciemny"]]) +
  scale_x_continuous(breaks = 1:5, labels = c("1\nna pewno nie", "2\nraczej nie", "3\ntrudno\npowiedzieć", "4\nraczej tak", "5\nna pewno tak")) +
  scale_y_continuous(limits = c(0, 100), breaks = seq(0, 100, 25), labels = function(x) paste0(x, "%")) +
  scale_linetype_manual(values = c("faktycznie zamówili (95% CI Wilsona)" = "solid", "odczyt naiwny: odpowiedź = prawdopodobieństwo" = "22"), name = NULL) +
  scale_shape_manual(values = c("faktycznie zamówili (95% CI Wilsona)" = 16, "odczyt naiwny: odpowiedź = prawdopodobieństwo" = 1), name = NULL) +
  labs(x = "Odpowiedź na pytanie o zamiar zakupu", y = "Odsetek osób, które zamówiły pakiet",
       title = "Miasto A: odsetek zamawiających leży daleko pod przekątną") + motyw
p2   # zapis: ggsave("deklaracja-zakupu-kalibracja.svg", p2, width = 10, height = 5.6)

# Rysunek 3: ta sama odpowiedź znaczy co innego dla nowych w kategorii i znających catering
p3 <- ggplot(tab_seg, aes(odp, proc, colour = segment, shape = segment, linetype = segment)) +
  geom_errorbar(aes(ymin = ci_dol, ymax = ci_gora), width = 0.15, linewidth = 0.6, linetype = "solid",
                position = position_dodge(width = 0.3)) +
  geom_line(position = position_dodge(width = 0.3), linewidth = 0.9) +
  geom_point(position = position_dodge(width = 0.3), size = 3) +
  scale_colour_manual(values = c("nowy w kategorii" = kol[["cynober"]], "zna catering" = kol[["niebieski"]]), name = NULL) +
  scale_shape_manual(values = c("nowy w kategorii" = 17, "zna catering" = 16), name = NULL) +
  scale_linetype_manual(values = c("nowy w kategorii" = "22", "zna catering" = "solid"), name = NULL) +
  scale_x_continuous(breaks = 1:5, labels = c("1\nna pewno nie", "2\nraczej nie", "3\ntrudno\npowiedzieć", "4\nraczej tak", "5\nna pewno tak")) +
  scale_y_continuous(limits = c(0, 70), breaks = seq(0, 70, 10), labels = function(x) paste0(x, "%")) +
  labs(x = "Odpowiedź na pytanie o zamiar zakupu", y = "Odsetek osób, które zamówiły pakiet",
       title = "Miasto A: konwersja deklaracji w dwóch segmentach (95% CI Wilsona)") + motyw
p3   # zapis: ggsave("deklaracja-zakupu-segmenty.svg", p3, width = 10, height = 5.6)
Wynik w R
     odp   n kupilo proc ci_dol ci_gora
[1,]   1 260      1  0.4    0.1     2.1
[2,]   2 211      5  2.4    1.0     5.4
[3,]   3 244     13  5.3    3.1     8.9
[4,]   4 179     23 12.8    8.7    18.5
[5,]   5 106     41 38.7   30.0    48.2
naiwna_prognoza_proc            top2_proc      faktycznie_proc
                41.5                 28.5                  8.3
                            segment odp   n kupilo proc ci_dol ci_gora
nowy w kategorii.1 nowy w kategorii   1 215      1  0.5    0.1     2.6
nowy w kategorii.2 nowy w kategorii   2 153      3  2.0    0.7     5.6
nowy w kategorii.3 nowy w kategorii   3 156      1  0.6    0.1     3.5
nowy w kategorii.4 nowy w kategorii   4  81      5  6.2    2.7    13.6
nowy w kategorii.5 nowy w kategorii   5  40      7 17.5    8.7    31.9
zna catering.1         zna catering   1  45      0  0.0    0.0     7.9
zna catering.2         zna catering   2  58      2  3.4    1.0    11.7
zna catering.3         zna catering   3  88     12 13.6    8.0    22.3
zna catering.4         zna catering   4  98     18 18.4   11.9    27.2
zna catering.5         zna catering   5  66     34 51.5   39.7    63.2
Analysis of Deviance Table

Model 1: kupil ~ factor(odp)
Model 2: kupil ~ factor(odp) + segment
Model 3: kupil ~ factor(odp) * segment
  Resid. Df Resid. Dev Df Deviance  Pr(>Chi)
1       995     440.72
2       994     408.07  1   32.645 1.106e-08 ***
3       990     401.41  4    6.665    0.1547
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
    OR  2.5 % 97.5 %
  4.86   2.70   8.73
4. Próba a rynek i cztery prognozy z bootstrapem: Rysunki 4 i 5
R
# Rysunki 4 i 5. Struktura próby a rynek; cztery prognozy sprzedaży dla miasta B z bootstrapem
# Korzysta z obiektów miasto_A, proba_B, rynek_B, N_B, udzial_B, kol i motyw z przepisu 1.
segmenty <- c("nowy w kategorii", "zna catering")
rozklad <- function(odp) tabulate(odp, 5) / length(odp)          # odsetki odpowiedzi 1–5
konw <- function(d) sapply(1:5, function(k) if (any(d$odp == k)) mean(d$kupil[d$odp == k]) else 0)

prognozy <- function(A, B) {             # liczba zamawiających w mieście B według czterech metod
  udz <- c(1 - udzial_B, udzial_B)       # struktura rynku B: nowi / znający kategorię
  pB_seg <- sapply(segmenty, function(s) rozklad(B$odp[B$segment == s]))    # kolumny = segmenty
  pB_wazony <- drop(pB_seg %*% udz)       # rozkład odpowiedzi przeważony do struktury rynku
  kA_seg <- sapply(segmenty, function(s) konw(A[A$segment == s, ]))
  N_B * c(surowa_top2 = mean(B$odp >= 4),
          kalibracja_ogolna = sum(rozklad(B$odp) * konw(A)),
          kalibracja_ogolna_wazenie = sum(pB_wazony * konw(A)),
          kalibracja_segmenty_wazenie = sum(colSums(pB_seg * kA_seg) * udz))
}
prawda <- sum(rynek_B$kupil)
est <- prognozy(miasto_A, proba_B)

# Bootstrap: losujemy ze zwracaniem osoby z ankiety A (konwersje) i z ankiety B (rozkład odpowiedzi)
set.seed(680)
B_boot <- 2000
boot <- t(replicate(B_boot, prognozy(miasto_A[sample(nrow(miasto_A), replace = TRUE), ],
                                     proba_B[sample(nrow(proba_B), replace = TRUE), ])))
wynik <- data.frame(metoda = names(est), prognoza = round(est), ci_dol = round(apply(boot, 2, quantile, 0.025)),
                    ci_gora = round(apply(boot, 2, quantile, 0.975)), wzgledem_prawdy_proc = round(100 * (est / prawda - 1), 1))
wynik
c(prawda = prawda)
# Udział segmentu i top-2-box w segmentach (próba B)
round(100 * c(zna_A = mean(miasto_A$segment == "zna catering"), zna_proba_B = mean(proba_B$segment == "zna catering"),
              zna_rynek_B = udzial_B), 1)
round(100 * tapply(proba_B$odp >= 4, proba_B$segment, mean), 1)
round(100 * prop.table(table(proba_B$segment, proba_B$odp), 1), 1)   # odpowiedzi 1–5 w segmentach (%)

# Rysunek 4: struktura prób i rynku (A) oraz odpowiedzi w próbie B według segmentu (B)
d4a <- data.frame(gdzie = factor(c("ankieta w mieście A", "ankieta w mieście B", "rynek w mieście B"),
                                 levels = c("rynek w mieście B", "ankieta w mieście B", "ankieta w mieście A")),
                  proc = 100 * c(mean(miasto_A$segment == "zna catering"), mean(proba_B$segment == "zna catering"), udzial_B),
                  rodzaj = c("ankieta", "ankieta", "rynek"))
p4a <- ggplot(d4a, aes(proc, gdzie, fill = rodzaj)) +
  geom_col(width = 0.6) +
  geom_text(aes(label = sprintf("%.1f%%", proc)), hjust = -0.15, size = 3.6) +
  scale_fill_manual(values = c(ankieta = kol[["niebieski"]], rynek = kol[["szary"]]), guide = "none") +
  scale_x_continuous(limits = c(0, 45), labels = function(x) paste0(x, "%")) +
  labs(x = "Odsetek osób, które zamawiały już catering", y = NULL, title = "A. Panel nadreprezentuje znających kategorię") + motyw
d4b <- as.data.frame(table(segment = proba_B$segment, odp = proba_B$odp))
d4b$proc <- 100 * d4b$Freq / ave(d4b$Freq, d4b$segment, FUN = sum)
d4b$odp <- factor(d4b$odp, levels = 5:1)
p4b <- ggplot(d4b, aes(proc, segment, fill = odp)) +
  geom_col(width = 0.6, colour = "white", linewidth = 0.3) +
  geom_text(aes(label = ifelse(proc >= 7, sprintf("%.0f", proc), "")), position = position_stack(vjust = 0.5),
            size = 3.3, colour = ifelse(as.integer(as.character(d4b$odp)) >= 4, "white", "grey10")) +
  scale_fill_manual(values = c(`5` = "#08519C", `4` = "#4292C6", `3` = "#D9D9D9", `2` = "#FDAE6B", `1` = "#E6550D"),
                    name = "odpowiedź", breaks = 1:5) +
  scale_x_continuous(labels = function(x) paste0(x, "%")) +
  labs(x = "Odsetek odpowiedzi w ankiecie w mieście B", y = NULL, title = "B. Odpowiedzi 1–5 w segmentach") + motyw
p4 <- p4a + p4b + plot_layout(widths = c(1, 1.15))
p4   # zapis: ggsave("deklaracja-zakupu-proba-a-rynek.svg", p4, width = 10, height = 4.8)

# Rysunek 5: cztery prognozy z 95% przedziałem bootstrapowym wobec prawdy znanej z symulacji
wynik$etykieta <- factor(c("surowa: top-2-box × rynek", "kalibracja z miasta A", "kalibracja + ważenie\ndo struktury rynku",
                           "kalibracja w segmentach\n+ ważenie"), levels = rev(c("surowa: top-2-box × rynek", "kalibracja z miasta A",
                           "kalibracja + ważenie\ndo struktury rynku", "kalibracja w segmentach\n+ ważenie")))
p5 <- ggplot(wynik, aes(prognoza / 1000, etykieta)) +
  geom_errorbar(aes(xmin = ci_dol / 1000, xmax = ci_gora / 1000), width = 0.18, orientation = "y",
                colour = kol[["niebieski"]], linewidth = 0.8) +
  geom_point(size = 3.2, colour = kol[["niebieski"]]) +
  geom_vline(xintercept = prawda / 1000, colour = kol[["cynober"]], linetype = "22", linewidth = 0.8) +
  annotate("text", x = prawda / 1000 + 1, y = 4.45, hjust = 0, size = 3.5, colour = kol[["cynober"]],
           label = sprintf("prawda z symulacji: %s", format(prawda, big.mark = " "))) +
  geom_text(aes(x = ci_gora / 1000 + 1, label = format(prognoza, big.mark = " ")), hjust = 0, size = 3.5) +
  scale_x_continuous(limits = c(0, 80), breaks = seq(0, 80, 10)) +
  labs(x = "Prognoza: liczba osób, które zamówią pakiet w 3 miesiące (tys.)", y = NULL,
       title = "Miasto B: ta sama ankieta, cztery prognozy (95% CI bootstrap, 2000 prób)") + motyw
p5   # zapis: ggsave("deklaracja-zakupu-prognoza-bootstrap.svg", p5, width = 10, height = 5)
Wynik w R
                                                 metoda prognoza ci_dol ci_gora
surowa_top2                                 surowa_top2    60720  54474   67680
kalibracja_ogolna                     kalibracja_ogolna    17800  14310   21578
kalibracja_ogolna_wazenie     kalibracja_ogolna_wazenie    16317  13013   19975
kalibracja_segmenty_wazenie kalibracja_segmenty_wazenie    11653   8961   14556
                            wzgledem_prawdy_proc
surowa_top2                                359.0
kalibracja_ogolna                           34.6
kalibracja_ogolna_wazenie                   23.3
kalibracja_segmenty_wazenie                -11.9
prawda
 13228
      zna_A zna_proba_B zna_rynek_B
       35.5        26.1        15.0
nowy w kategorii     zna catering
            19.2             42.5

                      1    2    3    4    5
  nowy w kategorii 32.1 23.4 25.3 13.5  5.7
  zna catering     11.9 15.7 29.9 26.8 15.7
5. Sprawdzenie palety przy zaburzeniach widzenia barw
R
# Przepis 5. Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – szary (faktycznie / odczyt naiwny; ankieta / rynek)" = c("#0072B2", "#999999"),
             "niebieski – cynober (zna catering / nowy; prognoza / prawda)" = c("#0072B2", "#D55E00"),
             "ciemnoniebieski – pomarańczowy (odpowiedź 5 / 2)" = c("#08519C", "#FDAE6B"),
             "niebieski – rudy (odpowiedź 4 / 1)" = c("#4292C6", "#E6550D"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                                widzenie_typowe
niebieski – szary (faktycznie / odczyt naiwny; ankieta / rynek)            44.9
niebieski – cynober (zna catering / nowy; prognoza / prawda)              114.6
ciemnoniebieski – pomarańczowy (odpowiedź 5 / 2)                          102.2
niebieski – rudy (odpowiedź 4 / 1)                                        114.9
czerwony – zielony (do unikania)                                          121.7
                                                                deuteranopia
niebieski – szary (faktycznie / odczyt naiwny; ankieta / rynek)         48.9
niebieski – cynober (zna catering / nowy; prognoza / prawda)           108.3
ciemnoniebieski – pomarańczowy (odpowiedź 5 / 2)                       107.9
niebieski – rudy (odpowiedź 4 / 1)                                     101.4
czerwony – zielony (do unikania)                                        21.1
                                                                protanopia
niebieski – szary (faktycznie / odczyt naiwny; ankieta / rynek)       40.6
niebieski – cynober (zna catering / nowy; prognoza / prawda)          91.9
ciemnoniebieski – pomarańczowy (odpowiedź 5 / 2)                      94.3
niebieski – rudy (odpowiedź 4 / 1)                                    85.5
czerwony – zielony (do unikania)                                      31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, przedziały Wilsona, regresja logistyczna, testy ilorazu wiarygodności i bootstrap – pakiety base i stats). Rysunki wykonano w ggplot2 i złożono pakietem patchwork; pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Odpowiedź jako prawdopodobieństwo. „Raczej tak” to nie 75%; w przykładzie 12.8%.
- Konwersje z innej kategorii lub ceny. Nowy produkt w nowej kategorii realizuje deklaracje słabiej (Morwitz i in., 2007).
- Próba inna niż rynek. Panel nadreprezentuje zainteresowanych; bez ważenia prognoza rośnie, a większa próba tego nie naprawi.
- Konwersje policzone na ankietowanych. Samo pytanie o zamiar może zwiększać jego realizację (Chandon i in., 2005); to bliskie zjawisku warunkowania panelowego. Konwersje z pilotażu mogą wtedy zawyżać prognozę dla osób, których nikt nie pytał.
Najczęstsze pytania
Co to jest top-2-box w pytaniu o intencję zakupu?
To odsetek osób, które wybrały dwie najwyższe odpowiedzi na skali, np. „raczej kupię” i „na pewno kupię”. Jest wygodny do porównań konceptów, ale nie jest prognozą sprzedaży. W przykładzie top-2-box wyniósł 28.5%, a pakiet zamówiło 8.3% badanych.
Jak przeliczyć intencję zakupu z ankiety na prognozę sprzedaży?
Pomnóż odsetek każdej odpowiedzi przez współczynnik konwersji tej odpowiedzi (jaki odsetek osób z tą odpowiedzią naprawdę kupił w podobnym badaniu z danymi o zakupach), zsumuj i pomnóż przez wielkość rynku. Konwersje licz w segmentach, a rozkład odpowiedzi przeważ do struktury rynku. Niepewność pokaże bootstrap obu ankiet.
Dlaczego ludzie deklarują zakup, a potem nie kupują?
Deklaracja jest tania, a zakup wymaga pieniędzy, czasu i okazji. Badania łączące deklaracje z zakupami często pokazują duże rozbieżności (Jamieson i Bass, 1989); intencje lepiej przewidują zakupy produktów istniejących niż nowych i przy krótkim horyzoncie (Morwitz i in., 2007).
Skąd wziąć współczynniki konwersji deklaracji?
Najlepiej z własnych danych: z pilotażu, z wcześniejszego wprowadzenia podobnego produktu albo z panelu, w którym ankietę można połączyć z późniejszymi zakupami. Liczba osób w każdej odpowiedzi powinna wystarczyć na sensowny przedział ufności; przy małych komórkach użyj regresji logistycznej zamiast osobnych odsetków.
Czy samo zadanie pytania o intencję zmienia zachowanie?
Może. Chandon i in. (2005) w trzech badaniach terenowych stwierdzili, że związek intencji z późniejszymi zakupami był średnio o 58% silniejszy u ankietowanych niż u podobnych osób, których nie pytano. Konwersje policzone na ankietowanych mogą więc zawyżać prognozę dla całego rynku.
Powiązane hasła
Przeczytaj też
Wielkość rynku z ankiety
Abonament na sprzątanie mieszkań: rynek jako iloczyn, raking próby online, bootstrap iloczynu, tornado i kontrola top-down – pięć rysunków z kodem R.
Czytaj →PoradnikAnkieta po zakupie i brak odpowiedzi
Odpowiada 12% klientów sklepu z materacami: model odpowiedzi z CRM, wagi IPW, kalibracja, efekt schematu i symulacja MAR/MNAR – z kodem R.
Czytaj →PoradnikBadanie ceny: van Westendorp i Gabor–Granger
Abonament serwisu rowerowego: krzywe van Westendorpa z bootstrapem, popyt i przychód Gabora–Grangera, zakotwiczenie i deklaracje a zakupy – z kodem R.
Czytaj →PoradnikCena zestawu (bundling)
Sieć kin studyjnych: ankieta WTP, czysty i mieszany pakiet, wpływ korelacji, optymalna cena zestawu z bootstrapem i kanibalizacja – z kodem R.
Czytaj →Prognozujesz sprzedaż z ankiety w pracy dyplomowej?
Pomożemy zaplanować pytanie o intencję, policzyć współczynniki konwersji, przeważyć próbę i opisać prognozę z niepewnością – tak, żebyś umiał(a) ją obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Chandon, P., Morwitz, V. G., & Reinartz, W. J. (2005). Do intentions really predict behavior? Self-generated validity effects in survey research. Journal of Marketing, 69(2), 1–14. https://doi.org/10.1509/jmkg.69.2.1.60755
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552 ● Otwarty dostęp
- Jamieson, L. F., & Bass, F. M. (1989). Adjusting stated intention measures to predict trial purchase of new products: A comparison of models and methods. Journal of Marketing Research, 26(3), 336–345. https://doi.org/10.1177/002224378902600307
- Kalwani, M. U., & Silk, A. J. (1982). On the reliability and predictive validity of purchase intention measures. Marketing Science, 1(3), 243–286. https://doi.org/10.1287/mksc.1.3.243 ● Otwarty dostęp: pełny tekst
- Morwitz, V. G., & Schmittlein, D. (1992). Using segmentation to improve sales forecasts based on purchase intent: Which “intenders” actually buy? Journal of Marketing Research, 29(4), 391–405. https://doi.org/10.1177/002224379202900401
- Morwitz, V. G., Steckel, J. H., & Gupta, A. (2007). When do purchase intentions predict sales? International Journal of Forecasting, 23(3), 347–364. https://doi.org/10.1016/j.ijforecast.2007.05.015 ● Otwarty dostęp: pełny tekst
- Steyerberg, E. W., Vickers, A. J., Cook, N. R., Gerds, T., Gonen, M., Obuchowski, N., Pencina, M. J., & Kattan, M. W. (2010). Assessing the performance of prediction models: A framework for traditional and novel measures. Epidemiology, 21(1), 128–138. https://doi.org/10.1097/ede.0b013e3181c30fb2 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{chandon2005do, author={Chandon, Pierre and Morwitz, Vicki G. and Reinartz, Werner J.}, title={{Do intentions really predict behavior? Self-generated validity effects in survey research}}, journal={Journal of Marketing}, year={2005}, volume={69}, number={2}, pages={1--14}, doi={10.1509/jmkg.69.2.1.60755}}@article{efron1979bootstrap, author={Efron, Bradley}, title={{Bootstrap methods: Another look at the jackknife}}, journal={The Annals of Statistics}, year={1979}, volume={7}, number={1}, pages={1--26}, doi={10.1214/aos/1176344552}}@article{jamieson1989adjusting, author={Jamieson, Linda F. and Bass, Frank M.}, title={{Adjusting stated intention measures to predict trial purchase of new products: A comparison of models and methods}}, journal={Journal of Marketing Research}, year={1989}, volume={26}, number={3}, pages={336--345}, doi={10.1177/002224378902600307}}@article{kalwani1982reliability, author={Kalwani, Manohar U. and Silk, Alvin J.}, title={{On the reliability and predictive validity of purchase intention measures}}, journal={Marketing Science}, year={1982}, volume={1}, number={3}, pages={243--286}, doi={10.1287/mksc.1.3.243}}@article{morwitz1992using, author={Morwitz, Vicki G. and Schmittlein, David}, title={{Using segmentation to improve sales forecasts based on purchase intent: Which “intenders” actually buy?}}, journal={Journal of Marketing Research}, year={1992}, volume={29}, number={4}, pages={391--405}, doi={10.1177/002224379202900401}}@article{morwitz2007when, author={Morwitz, Vicki G. and Steckel, Joel H. and Gupta, Alok}, title={{When do purchase intentions predict sales?}}, journal={International Journal of Forecasting}, year={2007}, volume={23}, number={3}, pages={347--364}, doi={10.1016/j.ijforecast.2007.05.015}}@article{steyerberg2010assessing, author={Steyerberg, Ewout W. and Vickers, Andrew J. and Cook, Nancy R. and Gerds, Thomas and Gonen, Mithat and Obuchowski, Nancy and Pencina, Michael J. and Kattan, Michael W.}, title={{Assessing the performance of prediction models: A framework for traditional and novel measures}}, journal={Epidemiology}, year={2010}, volume={21}, number={1}, pages={128--138}, doi={10.1097/ede.0b013e3181c30fb2}}