Przykład: księgarnia internetowa i 1500 klientów
Mała księgarnia internetowa ma w bazie 1500 klientów, którzy kupili coś w ostatnich 12 miesiącach. Dział marketingu pyta: komu wysłać którą promocję? Rabat dla kogoś, kto i tak kupuje co miesiąc, tylko obniża marżę.
Z systemu sklepu dla każdego klienta bierzemy cztery liczby. Trzy pierwsze to klasyczne RFM: recency – dni od ostatniego zamówienia, frequency – liczba zamówień w roku, monetary – wydatki w roku (zł). Czwarta opisuje zachowanie: udział produktów kupionych w promocji. RFM to prosty i znany opis historii zakupów. Fader i in. (2005) łączą go z przewidywaną wartością klienta w czasie (CLV). Tu używamy go do grupowania, czyli analizy skupień metodą k-średnich.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Liczebności, średnie i rozrzuty ustawiliśmy ręcznie, tak by przypominały typowy sklep. Ukryte segmenty to lojalni (330 osób), łowcy promocji (300), uśpieni (540) i nowi (330). Dorzuciliśmy jednego hurtownika (85 zamówień, 41 250 zł). Ziarno 602 ustalono raz i nie zmieniano go. Dane z kolumną segment_ukryty pobierzesz jako segmentacja-klienci-ksiegarni.csv. W prawdziwej bazie tej kolumny nie ma.
Procedurę ogólną (odległości, Ward, statystyka luki) opisuje wpis analiza skupień krok po kroku, menu SPSS – analiza skupień w SPSS, a segmentację ankietową z LPA – segmentacja respondentów: k-średnich i LPA. Tu idziemy od danych sklepu do decyzji.
Rysunek 1: dlaczego logarytm i standaryzacja
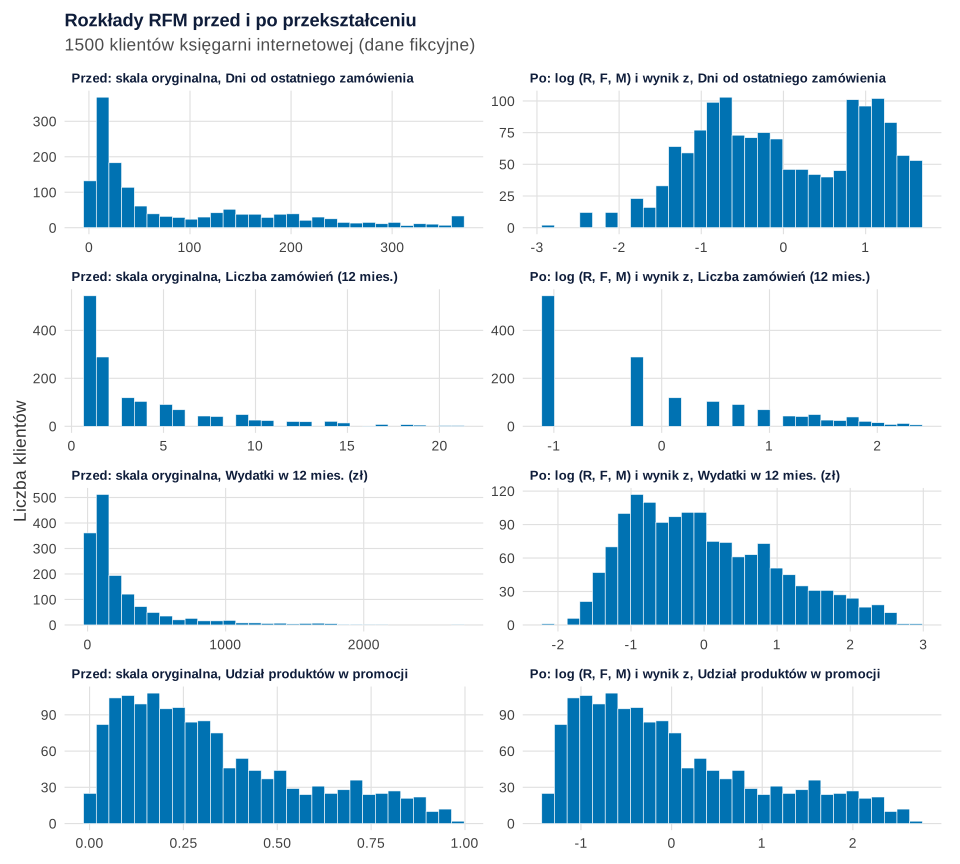
set.seed(602)).Co widać. Większość klientów kupiła niedawno, raz lub dwa razy i za niewielką kwotę, ale kilku wydało ponad 2000 zł. Skośność wynosi 1.17 dla dni od zakupu, 1.76 dla zamówień i 2.78 dla wydatków. K-średnich mierzy odległość euklidesową, więc liczy się surowa różnica liczb. Odchylenie standardowe wydatków (336.58 zł) jest 1394 razy większe niż udziału promocji (0.24). Bez przekształceń o segmentach decydowałyby złotówki. Dlatego robimy dwa kroki: logarytm dla R, F i M, potem standaryzację wszystkich czterech zmiennych:
Wynik z mówi, o ile odchyleń standardowych klient odbiega od przeciętnego klienta sklepu. Po przekształceniu każda zmienna ma SD = 1, a skośność wydatków spada do 0.56.
Jak może zmylić. Logarytm nie musi dać rozkładu normalnego: zamówienia pozostały „schodkowe”, a dwa garby dni od zakupu to już sygnał segmentów. Standaryzacja ma też cenę: każda zmienna waży tyle samo, także mniej ważna. Wybór zmiennych to decyzja biznesowa. Steinley (2006) omawia, jak na wynik k-średnich wpływają punkty startowe i wstępne przygotowanie zmiennych, dlatego algorytm uruchamiamy z 50 losowymi startami.
Podpis do pracy:
Zdanie do Metody:
Rysunek 2: ile segmentów?
K-średnich zawsze podzieli dane na tyle grup, ile każesz. Porównujemy więc rozwiązania od 1 do 8 na danych sklepu i na danych bez struktury. Powstają przez przetasowanie każdej kolumny osobno, więc rozkłady zostają, a segmenty znikają.
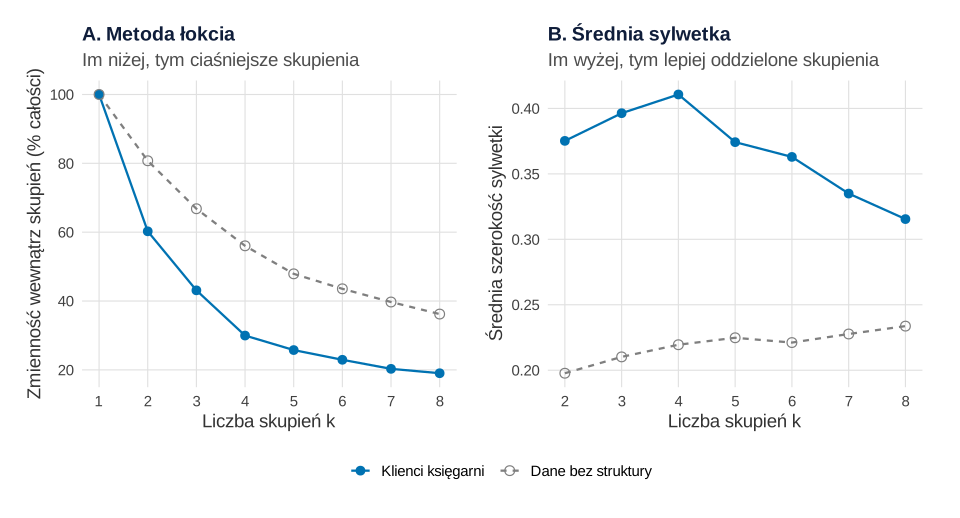
set.seed(602)).Co widać. W panelu A zmienność wewnątrz skupień spada z 43.1% przy trzech skupieniach do 30.0% przy czterech, a dalej już wolno (25.8% przy pięciu) – to „łokieć”. Sylwetka porównuje, jak blisko klient jest swojego skupienia i jak daleko od najbliższego innego (Rousseeuw, 1987). Jej średnia jest najwyższa przy k = 4 (.411). Oba kryteria wskazują cztery segmenty.
Jak może zmylić. Przewaga jest niewielka: przy k = 3 sylwetka to .396. Gdyby kryteria się rozjechały, o wyborze decyduje to, czy segmenty da się nazwać i obsłużyć różnymi działaniami. Dane bez struktury też dały „łokieć” i sylwetkę od .198 do .234. Segmenty znajdą się zawsze, nawet w szumie. Ratuje nas tylko porównanie: sylwetka sklepu jest prawie dwa razy wyższa. Oś panelu B nie zaczyna się od zera.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: mapa klientów
Czterech wymiarów nie da się narysować. Robimy więc mapę: PCA (analiza głównych składowych) streszcza cztery wyniki z w dwóch osiach. Segmenty pochodzą z k-średnich na wszystkich czterech zmiennych. Nazwy nadaliśmy po profilu: najwyższy udział promocji, potem najdłużej bez zakupu, potem więcej zamówień.
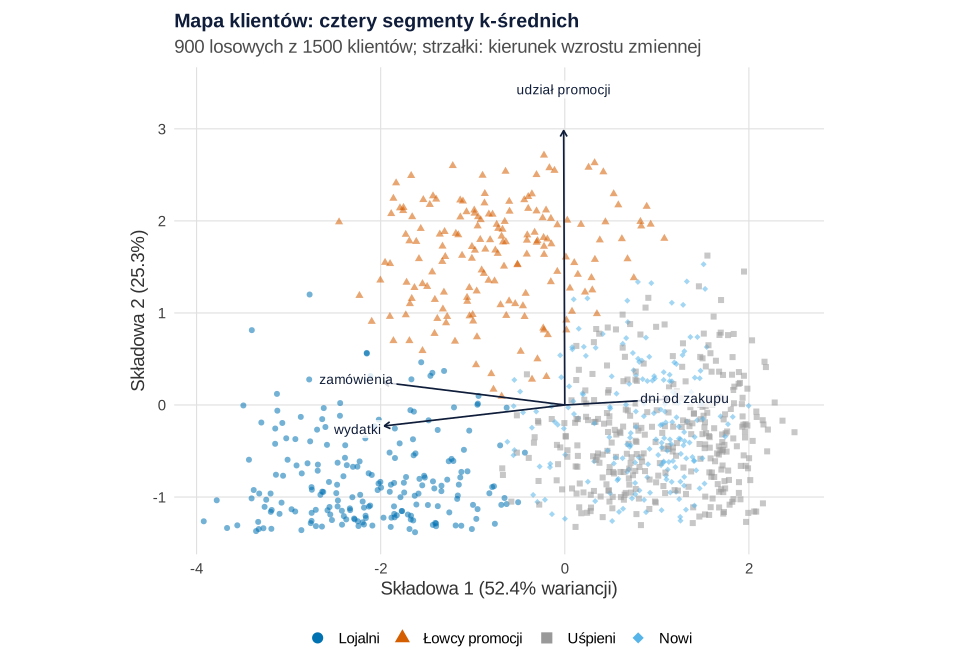
set.seed(602)).Co widać. Pierwsza składowa (52.4% wariancji) to „aktywność”: w lewo rosną zamówienia i wydatki, w prawo – dni od zakupu. Druga (25.3%) to prawie wyłącznie udział promocji. Lojalni są po lewej, łowcy promocji u góry, uśpieni po prawej. Udziały segmentów to 21.7%, 19.3%, 36.6% i 22.3%. Ponieważ dane są fikcyjne, możemy sprawdzić trafienia: 1398 z 1500 klientów (93.2%) trafiło do swojego ukrytego segmentu. Skorygowany indeks Randa (ARI) to .842 (1 = podział identyczny, 0 = zgodność przypadkowa; Hubert i Arabie, 1985).
Jak może zmylić. Nowi nakładają się na uśpionych, choć k-średnich dobrze ich rozdzielił. Mapa pokazuje 77.7% wariancji, a różnica „kupił niedawno” siedzi głównie w trzeciej składowej (20.5% wariancji, ładunek dni od zakupu 0.93). Nakładanie się na mapie nie dowodzi, że segmentów nie ma. Mapy t-SNE i UMAP rozdzielają grupy mocniej, ale odległości między wyspami nic tam nie znaczą.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: profil segmentów
Profil pokazuje, czym różnią się segmenty: średnie wyniki z segmentu na każdej zmiennej połączone linią (w marketingu: snake plot).
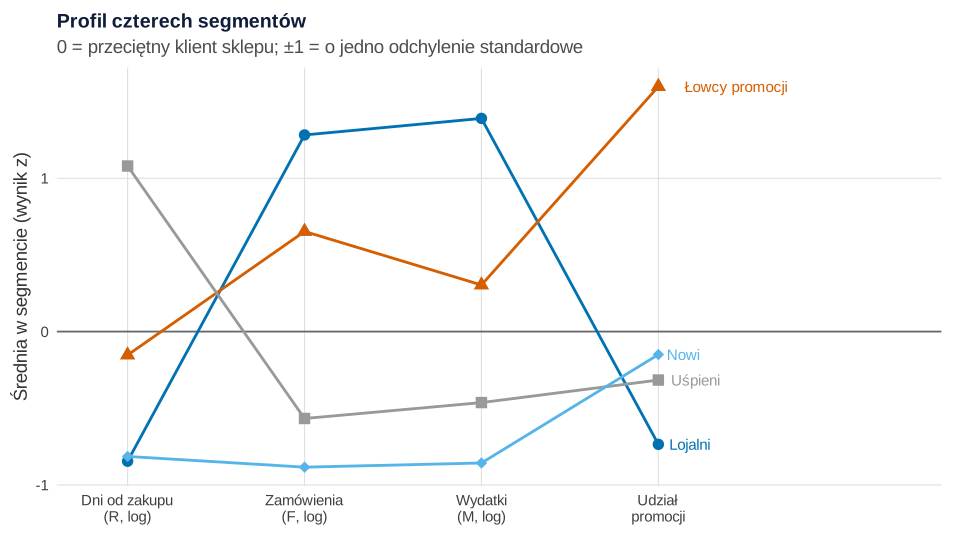
set.seed(602)).Co widać. Lojalni zamawiają i wydają o 1.3–1.4 SD więcej niż przeciętny klient, a promocji używają rzadko (−0.74). Łowców promocji wyróżnia przede wszystkim udział promocji (1.60). Uśpieni mają najdłuższy czas od zakupu (1.08). Nowi kupili niedawno (−0.81), ale mało i tanio. Uwaga na kierunek: przy dniach od zakupu wysoko znaczy „dawno”, czyli źle.
Jak może zmylić. Wyniki z są względne: „−0.86” u nowych znaczy „mniej niż przeciętnie w tym sklepie”, a nie „mało”. Do raportu dla zarządu przelicz profil na mediany w złotówkach i dniach (tabela w sekcji Jak opisać w pracy). Nazwę segmentu sprawdź na zmiennej spoza analizy. Mediana stażu nowych to 20 dni, wobec 332–622.5 dni w pozostałych segmentach.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: karty segmentów
Dla zespołu marketingu przygotuj karty segmentów (persony): nazwa, kilka liczb w zrozumiałych jednostkach i jedno działanie. Narysowaliśmy je w R z prostokątów i tekstu.
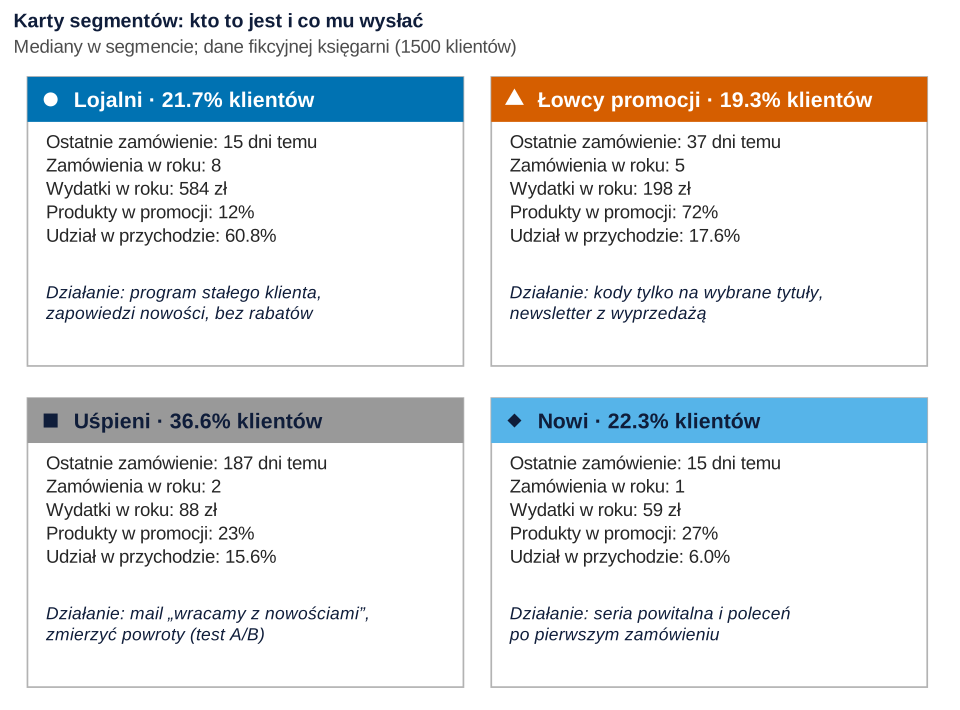
set.seed(602)).Co widać. Lojalni to 21.7% klientów i 60.8% przychodu. Uśpieni to największa grupa (36.6%), ale tylko 15.6% przychodu. Łowcy promocji kupują częściej niż uśpieni (mediana 5 zamówień), ale 72% ich produktów było przecenionych.
Jak może zmylić. Mediana „8 zamówień” nie opisuje każdego lojalnego klienta, a nazwy segmentów to etykiety analityka. Działania na kartach to hipotezy do sprawdzenia, a nie wnioski z analizy skupień.
Podpis do pracy (np. w aneksie lub w rekomendacjach):
Zdanie do Dyskusji:
Rysunek 6: czy segmenty są stabilne? k-średnich a Ward
Czy przy trochę innych klientach wyszłyby te same segmenty? Robimy bootstrap: losujemy ze zwracaniem 1500 klientów, grupujemy od nowa, przypisujemy każdego klienta do najbliższego nowego środka i liczymy ARI z podziałem z pełnych danych. 200 powtórzeń dla każdego k od 2 do 6. Obok dendrogram metody Warda dla 40 losowych klientów.
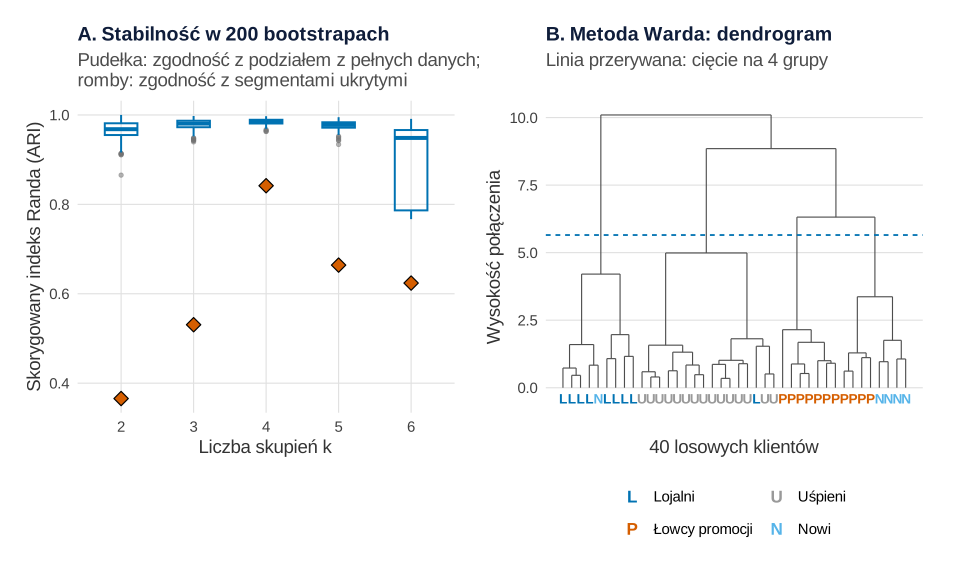
set.seed(602)).Co widać. Przy k = 4 mediana ARI to .986, a żadna próba nie spadła poniżej .80. Przy k = 6 – 27.5% prób. W panelu B Ward w większości odtwarza litery k-średnich. Na całej próbie zgodność Warda z k-średnich to ARI = .706. Punj i Stewart (1983) zalecali w badaniach marketingowych podejście dwuetapowe: Ward na start, potem dopracowanie k-średnich. Ward w R to method = "ward.D2"; różnice wersji opisują Murtagh i Legendre (2014).
Jak może zmylić. Przy k = 2 i 3 podział też jest bardzo stabilny (.968 i .981), a z ukrytymi segmentami zgadza się słabo (.366 i .531). Stabilny nie znaczy trafny. Hennig (2007) ostrzega, że niska stabilność jest sygnałem problemu, ale wysoka nie dowodzi sensu skupień. Romby widzimy tylko dlatego, że dane są fikcyjne.
Podpis do pracy:
Zdanie do Wyników:
Co z tym zrobić w marketingu
- Lojalni: nie dawaj rabatów, bo i tak kupują. Program stałego klienta i wcześniejszy dostęp do nowości.
- Łowcy promocji: kody tylko na wybrane tytuły i newsletter z wyprzedażą. Pilnuj marży.
- Uśpieni: przypomnienie z nowościami z ulubionej kategorii. Połowę segmentu wylosuj do grupy kontrolnej bez maila i porównaj powroty (test A/B).
- Nowi: seria powitalna po pierwszym zamówieniu, rekomendacje „klienci kupili też” (analiza koszykowa i systemy rekomendacyjne).
- Co kwartał: przelicz segmenty – nowy klient staje się lojalny albo uśpiony.
Wynik kampanii skierowanej do segmentu porównuj z losową grupą kontrolną. Skuteczność wyboru adresatów pokaże wykres lift i gain. Gdy segmentujesz klientów na podstawie ankiety z pytaniami tak/nie, zamiast k-średnich użyj modelu klas latentnych (analiza klas latentnych w marketingu); dla zmiennych ciągłych odpowiednikiem jest LPA. Inne projekty do pracy z marketingu opisuje wpis statystyka w pracy z marketingu.
Jak opisać w pracy
W symulacjach Dolnicar i in. (2014) we wszystkich warunkach wystarczała próba równa 70-krotności liczby zmiennych segmentacji. Dla czterech zmiennych to 280 osób, a my mamy 1500.
Do Wyników dołącz tabelę median w jednostkach zrozumiałych bez statystyki:
| Segment | n (%) | Dni od zakupu | Zamówienia | Wydatki (zł) | W promocji (%) | Przychód (%) |
|---|---|---|---|---|---|---|
| Lojalni | 326 (21.7) | 15 | 8 | 584 | 12 | 60.8 |
| Łowcy promocji | 290 (19.3) | 37 | 5 | 198 | 72 | 17.6 |
| Uśpieni | 549 (36.6) | 187 | 2 | 88 | 23 | 15.6 |
| Nowi | 335 (22.3) | 15 | 1 | 59 | 27 | 6.0 |
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę i motyw, przepis 3 – segmenty, a przepis 4 – tabelę używaną na kartach. Przepisy 1–6 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Każdy blok, który losuje (przepisy 1, 2, 3, 6 i 7), zaczyna losowanie od własnego set.seed(602), a w przepisie 2 ziarno jest ustawiane przed każdym uruchomieniem k-średnich. Skopiowany osobno (z przepisem 1, a od przepisu 4 także z 3) da te same liczby co na stronie. Ziarno 602 ustalono raz i nie zmieniano go. Ręcznie ustalono: liczebności segmentów ukrytych (330, 300, 540, 330), ich średnie dni od zakupu, liczby zamówień, typowe wartości koszyka i udziały promocji, rozrzuty oraz dane hurtownika (przepis 1); 50 startów k-średnich, zakres k = 1–8, 200 prób bootstrapowych i próbkę 40 klientów (przepisy 2–6); 900 klientów na mapie (przepis 3). Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się w kilkanaście sekund.
1. Dane, przekształcenia i rozkłady: Rysunek 1
R
# Rysunek 1. Klienci fikcyjnej księgarni internetowej: rozkłady RFM przed i po logarytmie i standaryzacji
library(ggplot2)

# Paleta Okabe–Ito dla czterech segmentów (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c("Lojalni" = "#0072B2", "Łowcy promocji" = "#D55E00", "Uśpieni" = "#999999", "Nowi" = "#56B4E9")
ksztalt <- c("Lojalni" = 16, "Łowcy promocji" = 17, "Uśpieni" = 15, "Nowi" = 18)
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
skosnosc <- function(x) mean((x - mean(x))^3) / sd(x)^3

# 1500 klientów z ostatnich 12 miesięcy i jeden hurtownik. Cztery segmenty ukryte w danych – liczebności,
# średnie i rozrzuty ustalono ręcznie, żeby segmenty różniły się jak w typowym sklepie internetowym.
set.seed(602)                                    # ziarno ustalone raz, bez dobierania pod wynik
seg <- data.frame(segment = c("Lojalni", "Łowcy promocji", "Uśpieni", "Nowi"), n = c(330, 300, 540, 330),
                  dni_sr = c(18, 45, 210, 20),     # średnia liczba dni od ostatniego zamówienia
                  zam_sr = c(8, 4, 0.8, 0.3),      # średnia liczba zamówień ponad pierwsze
                  koszyk = c(75, 42, 60, 55),      # typowa wartość zamówienia (zł)
                  promo = c(0.15, 0.70, 0.25, 0.30)) # średni udział produktów kupionych w promocji
klienci <- do.call(rbind, lapply(1:4, function(s) {
  n <- seg$n[s]; ksztalt_gamma <- if (seg$segment[s] == "Uśpieni") 6 else 2
  dni <- pmin(365, ceiling(rgamma(n, ksztalt_gamma, ksztalt_gamma / seg$dni_sr[s])))
  zamowienia <- 1 + rnbinom(n, mu = seg$zam_sr[s], size = 4)
  wydatki <- round(zamowienia * seg$koszyk[s] * exp(rnorm(n, 0, 0.35)), 2)
  promo <- round(rbeta(n, 8 * seg$promo[s], 8 * (1 - seg$promo[s])), 3)
  staz <- dni + ifelse(zamowienia == 1, 0, round(runif(n, 30, if (seg$segment[s] == "Nowi") 90 else 1200)))
  data.frame(segment_ukryty = seg$segment[s], dni_od_zakupu = dni, zamowienia, wydatki_zl = wydatki,
             udzial_promocji = promo, staz_dni = staz)
}))
klienci <- rbind(klienci, data.frame(segment_ukryty = "hurtownik", dni_od_zakupu = 3, zamowienia = 85,
                                     wydatki_zl = 41250, udzial_promocji = 0.05, staz_dni = 1400))
klienci <- cbind(id = sprintf("K%04d", seq_len(nrow(klienci))), klienci)
write.csv(klienci, "segmentacja-klienci-ksiegarni.csv", row.names = FALSE)

# Hurtownik (85 zamówień, 41 250 zł) to inny typ klienta – wyłączamy go przed segmentacją (zob. Pułapki)
klienci[which.max(klienci$wydatki_zl), c("id", "zamowienia", "wydatki_zl")]
dane <- subset(klienci, segment_ukryty != "hurtownik")
zm <- c("dni_od_zakupu", "zamowienia", "wydatki_zl", "udzial_promocji")
round(sapply(dane[zm], function(x) c(M = mean(x), Me = median(x), SD = sd(x), min = min(x), max = max(x),
                                     skosnosc = skosnosc(x))), 2)

# Przekształcenie: logarytm trzech skośnych zmiennych RFM, potem standaryzacja (z) wszystkich czterech
przeksztalc <- function(d) data.frame(R = log(d$dni_od_zakupu), F = log(d$zamowienia),
                                      M = log(d$wydatki_zl), P = d$udzial_promocji)
Z <- scale(przeksztalc(dane))
round(rbind(skosnosc_po = apply(Z, 2, skosnosc), SD_po = apply(Z, 2, sd)), 2)
round(sapply(dane[zm], sd) / sd(dane$udzial_promocji))   # ile razy większy rozrzut niż udziału promocji

# Rysunek: każda zmienna przed (skala oryginalna) i po przekształceniu (z)
nazwy <- c("Dni od ostatniego zamówienia", "Liczba zamówień (12 mies.)", "Wydatki w 12 mies. (zł)",
           "Udział produktów w promocji")
dl <- rbind(
  data.frame(zmienna = rep(nazwy, each = nrow(dane)), wartosc = unlist(dane[zm]), etap = "Przed: skala oryginalna"),
  data.frame(zmienna = rep(nazwy, each = nrow(dane)), wartosc = c(Z), etap = "Po: log (R, F, M) i wynik z"))
dl$zmienna <- factor(dl$zmienna, nazwy)
dl$etap <- factor(dl$etap, c("Przed: skala oryginalna", "Po: log (R, F, M) i wynik z"))
p1 <- ggplot(dl, aes(wartosc)) +
  geom_histogram(bins = 30, fill = "#0072B2", colour = "white", linewidth = 0.2) +
  facet_wrap(etap ~ zmienna, ncol = 2, scales = "free", dir = "v",
             labeller = labeller(etap = function(x) x, zmienna = function(x) x, .multi_line = FALSE)) +
  labs(x = NULL, y = "Liczba klientów", title = "Rozkłady RFM przed i po przekształceniu",
       subtitle = "1500 klientów księgarni internetowej (dane fikcyjne)") +
  motyw + theme(strip.text = element_text(size = rel(0.75), hjust = 0))
p1   # zapis: ggsave("segmentacja-rozklady-rfm-przed-po.svg", p1, width = 10, height = 9)
Wynik w R
        id zamowienia wydatki_zl
1501 K1501         85      41250
         dni_od_zakupu zamowienia wydatki_zl udzial_promocji
M                90.25       3.90     256.10            0.33
Me               38.50       2.00     124.29            0.27
SD               97.83       3.93     336.58            0.24
min               1.00       1.00      17.18            0.00
max             365.00      21.00    2681.50            0.98
skosnosc          1.17       1.76       2.78            0.81
               R    F    M    P
skosnosc_po -0.1 0.48 0.56 0.81
SD_po        1.0 1.00 1.00 1.00
  dni_od_zakupu      zamowienia      wydatki_zl udzial_promocji
            405              16            1394               1
2. Łokieć i sylwetka, także dla danych bez struktury: Rysunek 2
R
# Rysunek 2. Ile segmentów? Metoda łokcia i średnia sylwetka – dla danych sklepu i dla danych bez struktury
# (korzysta z Z, motyw z przepisu 1)
library(ggplot2)
library(patchwork)
library(cluster)

# Dane bez struktury: każdą kolumnę Z przetasowano osobno – rozkłady zmiennych zostają, segmenty znikają
set.seed(602)
Z_szum <- apply(Z, 2, sample)
oceny <- function(X, nazwa) {
  d <- dist(X)
  do.call(rbind, lapply(1:8, function(k) {
    set.seed(602)
    km <- kmeans(X, k, nstart = 50, iter.max = 50)
    syl <- if (k == 1) NA else mean(silhouette(km$cluster, d)[, "sil_width"])
    data.frame(dane = nazwa, k, WSS_proc = 100 * km$tot.withinss / km$totss, sylwetka = syl)
  }))
}
wyb <- rbind(oceny(Z, "Klienci księgarni"), oceny(Z_szum, "Dane bez struktury"))
print(transform(wyb, WSS_proc = round(WSS_proc, 1), sylwetka = round(sylwetka, 3)), row.names = FALSE)

wyb$dane <- factor(wyb$dane, c("Klienci księgarni", "Dane bez struktury"))
skala <- list(scale_colour_manual(values = c("#0072B2", "grey50"), name = NULL),
              scale_shape_manual(values = c(16, 1), name = NULL),
              scale_linetype_manual(values = c("solid", "22"), name = NULL),
              scale_x_continuous(breaks = 1:8))
pa <- ggplot(wyb, aes(k, WSS_proc, colour = dane, shape = dane, linetype = dane)) +
  geom_line(linewidth = 0.8) + geom_point(size = 3) + skala +
  labs(x = "Liczba skupień k", y = "Zmienność wewnątrz skupień (% całości)",
       title = "A. Metoda łokcia", subtitle = "Im niżej, tym ciaśniejsze skupienia") + motyw
pb <- ggplot(subset(wyb, k > 1), aes(k, sylwetka, colour = dane, shape = dane, linetype = dane)) +
  geom_line(linewidth = 0.8) + geom_point(size = 3) + skala +
  labs(x = "Liczba skupień k", y = "Średnia szerokość sylwetki",
       title = "B. Średnia sylwetka", subtitle = "Im wyżej, tym lepiej oddzielone skupienia") + motyw
p2 <- pa + pb + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p2   # zapis: ggsave("segmentacja-wybor-liczby-skupien.svg", p2, width = 10, height = 5.4)
Wynik w R
               dane k WSS_proc sylwetka
  Klienci księgarni 1    100.0       NA
  Klienci księgarni 2     60.2    0.375
  Klienci księgarni 3     43.1    0.396
  Klienci księgarni 4     30.0    0.411
  Klienci księgarni 5     25.8    0.374
  Klienci księgarni 6     22.9    0.363
  Klienci księgarni 7     20.3    0.335
  Klienci księgarni 8     19.0    0.315
 Dane bez struktury 1    100.0       NA
 Dane bez struktury 2     80.7    0.198
 Dane bez struktury 3     66.8    0.210
 Dane bez struktury 4     56.0    0.219
 Dane bez struktury 5     47.9    0.225
 Dane bez struktury 6     43.5    0.221
 Dane bez struktury 7     39.7    0.228
 Dane bez struktury 8     36.2    0.234
3. K-średnich, nazwy segmentów i mapa PCA: Rysunek 3
R
# Rysunek 3. Cztery segmenty k-średnich na mapie dwóch pierwszych składowych PCA
# (korzysta z dane, Z, kol, ksztalt i motyw z przepisu 1)
library(ggplot2)
library(mclust)                                  # adjustedRandIndex()

set.seed(602)
km <- kmeans(Z, centers = 4, nstart = 50, iter.max = 50)
# Nazwy nadajemy po profilu (średnie z), nie po segmentach ukrytych: najwyższy udział promocji -> Łowcy promocji,
# z pozostałych najdłużej bez zakupu -> Uśpieni, z dwóch ostatnich więcej zamówień -> Lojalni, mniej -> Nowi
sr <- as.data.frame(km$centers)
lowcy <- which.max(sr$P)
uspieni <- setdiff(1:4, lowcy)[which.max(sr$R[-lowcy])]
reszta <- setdiff(1:4, c(lowcy, uspieni))
lojalni <- reszta[which.max(sr$F[reszta])]; nowi <- setdiff(reszta, lojalni)
etykiety <- character(4); etykiety[c(lojalni, lowcy, uspieni, nowi)] <- names(kol)
dane$segment <- factor(etykiety[km$cluster], names(kol))
round(prop.table(table(dane$segment)) * 100, 1)

# Zgodność z segmentami ukrytymi w danych (znanymi tylko dlatego, że dane są fikcyjne)
table(znaleziony = dane$segment, ukryty = factor(dane$segment_ukryty, names(kol)))
c(trafieni = sum(as.character(dane$segment) == dane$segment_ukryty),
  procent = round(100 * mean(as.character(dane$segment) == dane$segment_ukryty), 1))
round(adjustedRandIndex(dane$segment, dane$segment_ukryty), 3)

# PCA na tych samych zmiennych z: dwie pierwsze składowe jako mapa klientów
pca <- prcomp(Z)
round(100 * summary(pca)$importance["Proportion of Variance", ], 1)
round(pca$rotation[, 1:3], 2)
mapa <- data.frame(PC1 = pca$x[, 1], PC2 = pca$x[, 2], segment = dane$segment)
set.seed(602)
mapa <- mapa[sample(nrow(mapa), 900), ]          # na mapie 900 losowych klientów (czytelność, rozmiar pliku)
strzalki <- data.frame(zmienna = c("dni od zakupu", "zamówienia", "wydatki", "udział promocji"),
                       x = 3 * pca$rotation[, 1], y = 3 * pca$rotation[, 2])
p3 <- ggplot(mapa, aes(PC1, PC2)) +
  geom_point(aes(colour = segment, shape = segment), alpha = 0.55, size = 1.7) +
  geom_segment(data = strzalki, aes(x = 0, y = 0, xend = x, yend = y), inherit.aes = FALSE,
               arrow = arrow(length = unit(0.18, "cm")), colour = "#0f1d3a", linewidth = 0.6) +
  geom_label(data = strzalki, aes(x = 1.15 * x, y = 1.15 * y, label = zmienna), inherit.aes = FALSE,
             size = 3.6, colour = "#0f1d3a", linewidth = 0, fill = alpha("white", 0.8)) +
  scale_colour_manual(values = kol, name = NULL) + scale_shape_manual(values = ksztalt, name = NULL) +
  guides(colour = guide_legend(override.aes = list(alpha = 1, size = 3.5))) +
  coord_equal() +
  labs(x = sprintf("Składowa 1 (%.1f%% wariancji)", 100 * summary(pca)$importance[2, 1]),
       y = sprintf("Składowa 2 (%.1f%%)", 100 * summary(pca)$importance[2, 2]),
       title = "Mapa klientów: cztery segmenty k-średnich",
       subtitle = "900 losowych z 1500 klientów; strzałki: kierunek wzrostu zmiennej") + motyw
p3   # zapis: ggsave("segmentacja-mapa-klientow-pca.svg", p3, width = 10, height = 7)
Wynik w R
       Lojalni Łowcy promocji        Uśpieni           Nowi
          21.7           19.3           36.6           22.3
                ukryty
znaleziony       Lojalni Łowcy promocji Uśpieni Nowi
  Lojalni            309             11       2    4
  Łowcy promocji       5            263      10   12
  Uśpieni              3              8     525   13
  Nowi                13             18       3  301
trafieni  procent
  1398.0     93.2
[1] 0.842
 PC1  PC2  PC3  PC4
52.4 25.3 20.5  1.8
    PC1   PC2   PC3
R  0.38  0.02  0.93
F -0.66  0.08  0.26
M -0.65 -0.08  0.28
P  0.00  0.99 -0.02
4. Profil segmentów i tabela median: Rysunek 4
R
# Rysunek 4. Profil segmentów: średnie z na czterech zmiennych („snake plot”) i mediany w jednostkach sklepu
# (korzysta z dane, Z, kol, ksztalt i motyw z przepisu 1 oraz segment z przepisu 3)
library(ggplot2)

prof <- aggregate(as.data.frame(Z), list(segment = dane$segment), mean)
print(cbind(prof[1], round(prof[-1], 2)), row.names = FALSE)
# Tabela do pracy: liczebność i mediany w jednostkach, które rozumie dział marketingu
tab <- do.call(rbind, lapply(split(dane, dane$segment), function(d)
  data.frame(n = nrow(d), proc = round(100 * nrow(d) / nrow(dane), 1), dni = median(d$dni_od_zakupu),
             zamowienia = median(d$zamowienia), wydatki = round(median(d$wydatki_zl)),
             promocja_proc = round(100 * median(d$udzial_promocji)),
             udzial_w_przychodzie = round(100 * sum(d$wydatki_zl) / sum(dane$wydatki_zl), 1),
             staz_dni = median(d$staz_dni))))
tab

dl <- data.frame(segment = rep(prof$segment, 4),
                 zmienna = factor(rep(c("Dni od zakupu\n(R, log)", "Zamówienia\n(F, log)", "Wydatki\n(M, log)",
                                        "Udział\npromocji"), each = 4),
                                  c("Dni od zakupu\n(R, log)", "Zamówienia\n(F, log)", "Wydatki\n(M, log)", "Udział\npromocji")),
                 z = unlist(prof[-1]))
koniec <- subset(dl, zmienna == "Udział\npromocji")
p4 <- ggplot(dl, aes(zmienna, z, colour = segment, shape = segment, group = segment)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_line(linewidth = 1) + geom_point(size = 3.6) +
  geom_text(data = koniec, aes(label = segment), hjust = -0.25, size = 4, show.legend = FALSE) +
  scale_colour_manual(values = kol, name = NULL) + scale_shape_manual(values = ksztalt, name = NULL) +
  scale_x_discrete(expand = expansion(add = c(0.4, 1.6))) +
  labs(x = NULL, y = "Średnia w segmencie (wynik z)", title = "Profil czterech segmentów",
       subtitle = "0 = przeciętny klient sklepu; ±1 = o jedno odchylenie standardowe") +
  motyw + theme(legend.position = "none")
p4   # zapis: ggsave("segmentacja-profil-segmentow.svg", p4, width = 10, height = 5.6)
Wynik w R
        segment     R     F     M     P
        Lojalni -0.85  1.28  1.39 -0.74
 Łowcy promocji -0.15  0.65  0.30  1.60
        Uśpieni  1.08 -0.57 -0.46 -0.32
           Nowi -0.81 -0.88 -0.86 -0.15
                 n proc dni zamowienia wydatki promocja_proc
Lojalni        326 21.7  15          8     584            12
Łowcy promocji 290 19.3  37          5     198            72
Uśpieni        549 36.6 187          2      88            23
Nowi           335 22.3  15          1      59            27
               udzial_w_przychodzie staz_dni
Lojalni                        60.8    621.0
Łowcy promocji                 17.6    622.5
Uśpieni                        15.6    332.0
Nowi                            6.0     20.0
5. Karty segmentów: Rysunek 5
R
# Rysunek 5. Karty segmentów: nazwa, kilka liczb i proponowane działanie (grafika z prostokątów i tekstu)
# (korzysta z kol, ksztalt z przepisu 1 i tabeli tab z przepisu 4)
library(ggplot2)

dzialania <- c("Lojalni" = "program stałego klienta,\nzapowiedzi nowości, bez rabatów",
               "Łowcy promocji" = "kody tylko na wybrane tytuły,\nnewsletter z wyprzedażą",
               "Uśpieni" = "mail „wracamy z nowościami”,\nzmierzyć powroty (test A/B)",
               "Nowi" = "seria powitalna i poleceń\npo pierwszym zamówieniu")
karty <- data.frame(segment = factor(rownames(tab), names(kol)),
                    x = c(0, 1, 0, 1), y = c(1, 1, 0, 0))          # układ 2 × 2
karty$kolor_tekstu <- c("white", "white", "#0f1d3a", "#0f1d3a")   # ciemny tekst na jasnych nagłówkach
karty$naglowek <- sprintf("%s · %.1f%% klientów", karty$segment, tab$proc)
karty$liczby <- sprintf("Ostatnie zamówienie: %d dni temu\nZamówienia w roku: %d\nWydatki w roku: %d zł\nProdukty w promocji: %d%%\nUdział w przychodzie: %.1f%%",
                        round(tab$dni), round(tab$zamowienia), tab$wydatki, tab$promocja_proc, tab$udzial_w_przychodzie)
karty$dzialanie <- paste0("Działanie: ", dzialania[as.character(karty$segment)])
s <- 0.47                                                     # pół szerokości karty
p5 <- ggplot(karty) +
  geom_rect(aes(xmin = x - s, xmax = x + s, ymin = y - 0.45, ymax = y + 0.45), fill = "white",
            colour = "grey70", linewidth = 0.6) +
  geom_rect(aes(xmin = x - s, xmax = x + s, ymin = y + 0.31, ymax = y + 0.45, fill = segment), colour = NA) +
  geom_point(aes(x = x - s + 0.05, y = y + 0.38, shape = segment, colour = kolor_tekstu), size = 4.5) +
  geom_text(aes(x = x - s + 0.1, y = y + 0.38, label = naglowek, colour = kolor_tekstu), hjust = 0,
            fontface = "bold", size = 5.6) +
  geom_text(aes(x = x - s + 0.04, y = y + 0.27, label = liczby), hjust = 0, vjust = 1, size = 4.9,
            lineheight = 1.05, colour = "grey15") +
  geom_text(aes(x = x - s + 0.04, y = y - 0.2, label = dzialanie), hjust = 0, vjust = 1, size = 4.6,
            lineheight = 1.0, colour = "#0f1d3a", fontface = "italic") +
  scale_fill_manual(values = kol, guide = "none") + scale_shape_manual(values = ksztalt, guide = "none") +
  scale_colour_identity() +
  coord_cartesian(xlim = c(-0.5, 1.5), ylim = c(-0.48, 1.48), expand = FALSE) +
  labs(title = "Karty segmentów: kto to jest i co mu wysłać",
       subtitle = "Mediany w segmencie; dane fikcyjnej księgarni (1500 klientów)") +
  motyw + theme(axis.text = element_blank(), axis.title = element_blank(), panel.grid.major = element_blank())
p5   # zapis: ggsave("segmentacja-karty-segmentow.svg", p5, width = 10, height = 7.4)
6. Stabilność w bootstrapie i metoda Warda: Rysunek 6
R
# Rysunek 6. Stabilność segmentów (bootstrap, skorygowany indeks Randa) i dendrogram Warda dla 40 klientów
# (korzysta z dane, Z, kol, motyw z przepisu 1 oraz km i segment z przepisu 3)
library(ggplot2)
library(patchwork)
library(mclust)                                  # adjustedRandIndex()

# A. Dla k = 2–6: 200 prób bootstrapowych, w każdej k-średnich od nowa; każdego klienta przypisujemy
# do najbliższego środka z próby i porównujemy z podziałem z pełnych danych (ARI: 1 = ten sam podział)
najblizszy <- function(X, srodki) apply(X, 1, function(x) which.min(colSums((t(srodki) - x)^2)))
set.seed(602)
B <- 200
stab <- do.call(rbind, lapply(2:6, function(k) {
  pelny <- kmeans(Z, k, nstart = 50, iter.max = 50)$cluster
  ari <- replicate(B, {
    i <- sample(nrow(Z), replace = TRUE)
    kb <- kmeans(Z[i, ], k, nstart = 10, iter.max = 50)
    adjustedRandIndex(pelny, najblizszy(Z, kb$centers))
  })
  data.frame(k, ari, z_ukrytymi = adjustedRandIndex(pelny, dane$segment_ukryty))
}))
podsum <- aggregate(ari ~ k, stab, function(a) c(mediana = median(a), proc_ponizej_08 = 100 * mean(a < 0.8)))
podsum <- cbind(k = podsum$k, round(podsum$ari, 3), z_ukrytymi = round(unique(stab[c("k", "z_ukrytymi")])$z_ukrytymi, 3))
podsum

pa <- ggplot(stab, aes(factor(k), ari)) +
  geom_boxplot(width = 0.45, fill = NA, colour = "#0072B2", linewidth = 0.7,
               outlier.colour = "grey45", outlier.size = 1.2, outlier.alpha = 0.5) +
  geom_point(data = unique(stab[c("k", "z_ukrytymi")]), aes(factor(k), z_ukrytymi), shape = 23,
             size = 3.6, fill = "#D55E00", colour = "black") +
  labs(x = "Liczba skupień k", y = "Skorygowany indeks Randa (ARI)", title = "A. Stabilność w 200 bootstrapach",
       subtitle = "Pudełka: zgodność z podziałem z pełnych danych;\nromby: zgodność z segmentami ukrytymi") + motyw

# B. Metoda Warda na losowej próbce 40 klientów: dendrogram z literą segmentu k-średnich przy liściu
set.seed(602)
proba <- sample(nrow(Z), 40)
h <- hclust(dist(Z[proba, ]), method = "ward.D2")
gr_ward <- cutree(h, 4)
litera <- c("Lojalni" = "L", "Łowcy promocji" = "P", "Uśpieni" = "U", "Nowi" = "N")
table(Ward = gr_ward, kmeans = dane$segment[proba])
# Odcinki dendrogramu policzone z obiektu hclust (bez dodatkowych pakietów)
poz <- numeric(40); poz[h$order] <- 1:40
x_wezla <- numeric(39); odc <- NULL
for (j in 1:39) {
  xy <- sapply(h$merge[j, ], function(m) if (m < 0) c(poz[-m], 0) else c(x_wezla[m], h$height[m]))
  x_wezla[j] <- mean(xy[1, ])
  odc <- rbind(odc, data.frame(x = xy[1, ], y = xy[2, ], xend = xy[1, ], yend = h$height[j]),
               data.frame(x = xy[1, 1], y = h$height[j], xend = xy[1, 2], yend = h$height[j]))
}
liscie <- data.frame(x = poz, segment = dane$segment[proba])
prog <- mean(sort(h$height, decreasing = TRUE)[3:4])       # wysokość cięcia na 4 grupy
pb <- ggplot() +
  geom_segment(data = odc, aes(x, y, xend = xend, yend = yend), colour = "grey30", linewidth = 0.4) +
  geom_hline(yintercept = prog, linetype = "22", colour = "#0072B2") +
  geom_text(data = liscie, aes(x, -0.4, label = litera[as.character(segment)], colour = segment),
            fontface = "bold", size = 3.6) +
  scale_colour_manual(values = kol, name = NULL) +
  guides(colour = guide_legend(ncol = 2, override.aes = list(label = litera, size = 4.5))) +
  scale_x_continuous(breaks = NULL) +
  labs(x = "40 losowych klientów", y = "Wysokość połączenia",
       title = "B. Metoda Warda: dendrogram", subtitle = "Linia przerywana: cięcie na 4 grupy") + motyw
p6 <- pa + pb
p6   # zapis: ggsave("segmentacja-stabilnosc-i-dendrogram.svg", p6, width = 10, height = 6)

# Cała próba: Ward (ward.D2) przecięty na 4 grupy a k-średnich
ward_pelny <- cutree(hclust(dist(Z), method = "ward.D2"), 4)
round(adjustedRandIndex(ward_pelny, dane$segment), 3)
round(adjustedRandIndex(ward_pelny, dane$segment_ukryty), 3)
Wynik w R
     k mediana proc_ponizej_08 z_ukrytymi
[1,] 2   0.968             0.0      0.366
[2,] 3   0.981             0.0      0.531
[3,] 4   0.986             0.0      0.842
[4,] 5   0.978             0.5      0.664
[5,] 6   0.949            27.5      0.624
    kmeans
Ward Lojalni Łowcy promocji Uśpieni Nowi
   1       1              0      15    0
   2       0              4       0    4
   3       8              0       0    1
   4       0              7       0    0
[1] 0.706
[1] 0.672
7. Pułapki: bez przekształceń i z hurtownikiem
R
# Pułapki: segmentacja bez logarytmu i standaryzacji oraz z hurtownikiem w danych
# (korzysta z klienci, dane, Z i przeksztalc() z przepisu 1)
library(mclust)                                  # adjustedRandIndex()

# 1. Surowe zmienne bez przekształceń: odległość liczą głównie złotówki (SD wydatków 337 zł, udziału promocji 0.24)
set.seed(602)
km_surowe <- kmeans(dane[c("dni_od_zakupu", "zamowienia", "wydatki_zl", "udzial_promocji")], 4, nstart = 50)
round(km_surowe$centers, 2)
round(adjustedRandIndex(km_surowe$cluster, dane$segment_ukryty), 3)

# 2. Standaryzacja bez logarytmu: najpierw bez hurtownika, potem z nim
set.seed(602)
km_z <- kmeans(scale(dane[c("dni_od_zakupu", "zamowienia", "wydatki_zl", "udzial_promocji")]), 4, nstart = 50)
round(adjustedRandIndex(km_z$cluster, dane$segment_ukryty), 3)
set.seed(602)
X_h <- scale(klienci[c("dni_od_zakupu", "zamowienia", "wydatki_zl", "udzial_promocji")])
km_h <- kmeans(X_h, 4, nstart = 50)
round(X_h[klienci$segment_ukryty == "hurtownik", ], 1)              # wyniki z hurtownika
table(km_h$cluster)                                                   # liczebności skupień
sum(km_h$cluster == km_h$cluster[klienci$segment_ukryty == "hurtownik"])  # wielkość jego skupienia
bez_h <- klienci$segment_ukryty != "hurtownik"
round(adjustedRandIndex(km_h$cluster[bez_h], klienci$segment_ukryty[bez_h]), 3)

# 3. Logarytm i standaryzacja, hurtownik w danych: jest skrajny, ale nie tworzy własnego skupienia
set.seed(602)
Z_h <- scale(przeksztalc(klienci))
km_hl <- kmeans(Z_h, 4, nstart = 50)
round(Z_h[klienci$segment_ukryty == "hurtownik", ], 1)
round(adjustedRandIndex(km_hl$cluster[bez_h], klienci$segment_ukryty[bez_h]), 3)
Wynik w R
  dni_od_zakupu zamowienia wydatki_zl udzial_promocji
1         18.39      15.64    1634.37            0.16
2         39.54       6.49     379.39            0.38
3         18.32      11.27     884.89            0.16
4        114.86       1.92      98.99            0.34
[1] 0.227
[1] 0.57
  dni_od_zakupu      zamowienia      wydatki_zl udzial_promocji
           -0.9            18.2            36.9            -1.2

  1   2   3   4
543 325 187 446
[1] 187
[1] 0.56
   R    F    M    P
-2.0  3.9  5.6 -1.2
[1] 0.84
8. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("Lojalni – Łowcy promocji" = c("#0072B2", "#D55E00"), "Lojalni – Uśpieni" = c("#0072B2", "#999999"),
             "Lojalni – Nowi" = c("#0072B2", "#56B4E9"), "Łowcy promocji – Uśpieni" = c("#D55E00", "#999999"),
             "Łowcy promocji – Nowi" = c("#D55E00", "#56B4E9"), "Uśpieni – Nowi" = c("#999999", "#56B4E9"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
Lojalni – Łowcy promocji                   114.6        108.3       91.9
Lojalni – Uśpieni                           44.9         48.9       40.6
Lojalni – Nowi                              26.4         24.7       24.6
Łowcy promocji – Uśpieni                    77.2         62.9       56.0
Łowcy promocji – Nowi                      113.6        101.1       89.0
Uśpieni – Nowi                              37.4         38.3       33.0
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, k-średnich (kmeans()), metoda Warda (hclust()) i PCA (prcomp()) – pakiet stats z podstawowej instalacji R; sylwetka – pakiet cluster; skorygowany indeks Randa – pakiet mclust. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- cluster (wersja 2.1.8.2): Maechler, M., Rousseeuw, P., Struyf, A., Hubert, M., & Hornik, K. (2026). cluster: Cluster analysis basics and extensions (R package version 2.1.8.2) [Computer software]. https://CRAN.R-project.org/package=cluster
- mclust (wersja 6.1.2): Scrucca, L., Fraley, C., Murphy, T. B., & Raftery, A. E. (2023). Model-based clustering, classification, and density estimation using mclust in R. Chapman and Hall/CRC. https://doi.org/10.1201/9781003277965
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Brak przekształceń. Na surowych zmiennych segmenty różnią się prawie tylko wydatkami (średnie skupień: 99, 379, 885 i 1634 zł), a zgodność z ukrytymi segmentami spada do ARI = .227. Sama standaryzacja bez logarytmu daje .570, logarytm i standaryzacja – .842 (rysunek 1).
- Jeden hurtownik. Bez logarytmu jego wydatki to z = 36.9, czyli obserwacja odstająca, która rozciąga skalę. Tu nie utworzył własnego skupienia (trafił do grupy 187 osób), ale w innych danych może zostać jednoosobowym „segmentem”. Po logarytmie ma z = 5.6 i nie psuje segmentacji (ARI = .840). Hurtowników i firmy opisz osobno.
- Segmenty „z definicji”. K-średnich podzieli na k grup także szum (rysunek 2). Porównaj kryteria z danymi bez struktury i sprawdź stabilność.
- Stabilny ≠ trafny. Podział na dwa segmenty był stabilny, a słabo zgodny z prawdziwymi segmentami (rysunek 6).
- Zmienne mieszane. Gdy dochodzą zmienne kategorialne (kanał, region), odległość euklidesowa nie wystarczy – zob. odległość Gowera.
- Segmentacja to nie przyczynowość. Z tego, że „łowcy promocji” kupują głównie przecenione książki, nie wynika, że kody ich przyciągają – może to sklep nauczył ich czekać na rabat. Opis segmentu nie mówi, co zadziała. Odpowiedź daje dopiero eksperyment (korelacja a przyczynowość).
Najczęstsze pytania
Jakie zmienne wybrać do segmentacji klientów sklepu internetowego?
Najprostszy zestaw to RFM: liczba dni od ostatniego zamówienia, liczba zamówień i wydatki w ostatnim roku, plus jedna–dwie zmienne zachowania, np. udział zakupów w promocji. Wybieraj zmienne, które różnicują działania marketingowe. Zmienne opisowe (staż, region) zostaw do sprawdzenia, czy segmenty mają sens – w przykładzie mediana stażu „nowych” to 20 dni.
Czy przed analizą skupień trzeba standaryzować zmienne RFM?
Tak, a skośne R, F i M najpierw zlogarytmuj. K-średnich liczy odległości, więc wygrywa zmienna o największym rozrzucie: w przykładzie SD wydatków było 1394 razy większe niż udziału promocji. Na surowych danych zgodność z prawdziwymi segmentami wyniosła ARI = .227, po samej standaryzacji .570, a po logarytmie i standaryzacji .842.
Jak wybrać liczbę segmentów klientów?
Porównaj rozwiązania dla kilku k metodą łokcia i średnią sylwetką, najlepiej obok danych bez struktury (przetasowanych kolumn). W przykładzie oba kryteria wskazały cztery segmenty (sylwetka .411 wobec najwyżej .234 w szumie). Gdy kryteria się nie zgadzają, wybierz rozwiązanie, którego segmenty da się nazwać i obsłużyć różnymi działaniami, i sprawdź jego stabilność.
Czy stabilne segmenty to dobre segmenty?
Niekoniecznie. W przykładzie podział na dwa segmenty był w bootstrapie bardzo stabilny (mediana ARI .968), a z prawdziwymi segmentami zgadzał się słabo (ARI = .366). Niska stabilność ostrzega przed problemem, ale wysoka nie dowodzi sensu skupień (Hennig, 2007). Trafność sprawdzaj na zmiennych spoza analizy i w eksperymencie.
Jak opisać segmentację klientów w pracy z marketingu?
W Metodzie: zmienne i przekształcenia, k-średnich z liczbą startów, kryteria wyboru k i sposób oceny stabilności. W Wynikach: liczebności segmentów, profil (średnie z lub mediany w tabeli), nazwy segmentów i rysunek. Działania marketingowe opisz jako rekomendacje do sprawdzenia, a nie wnioski przyczynowe.
Powiązane hasła
Przeczytaj też
Klasy latentne w marketingu
Ankieta 1000 klientów drogerii: ile klas, profil, entropia, karty segmentów z działaniami, wiek jako kowariant i LCA a k-średnich – sześć rysunków z kodem R.
Czytaj →PoradnikAnaliza koszykowa i rekomendacje
Wsparcie, ufność i lift na przykładzie sklepu z kawą, sieć reguł, test na nowych paragonach i rekomendacje „klienci kupili też” z kodem R.
Czytaj →PoradnikAnaliza skupień krok po kroku
Ward i dendrogram, k-średnich, sylwetka i statystyka luki, stabilność w podpróbach, kontrola na danych bez skupień i opis APA – na jednym przykładzie w R.
Czytaj →PoradnikWartość klienta w czasie (CLV)
Sklep z abonamentem na karmę: koncentracja marży, prosty wzór CLV, wrażliwość na retencję, model rezygnacji i bootstrap – pięć rysunków z kodem R.
Czytaj →PoradnikLejek konwersji – etapy i test A/B
Sklep zoologiczny i nowy koszyk: odsetki od początku i warunkowe, przedziały Wilsona i Newcombe’a, liczebność i symulacja 1000 testów z kodem R.
Czytaj →Segmentujesz klientów do pracy z marketingu?
Pomożemy dobrać zmienne, przygotować dane, wybrać liczbę segmentów, sprawdzić ich stabilność i opisać profile oraz rekomendacje – tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Dolnicar, S., Grün, B., Leisch, F., & Schmidt, K. (2014). Required sample sizes for data-driven market segmentation analyses in tourism. Journal of Travel Research, 53(3), 296–306. https://doi.org/10.1177/0047287513496475 ● Otwarty dostęp
- Fader, P. S., Hardie, B. G. S., & Lee, K. L. (2005). RFM and CLV: Using iso-value curves for customer base analysis. Journal of Marketing Research, 42(4), 415–430. https://doi.org/10.1509/jmkr.2005.42.4.415
- Hennig, C. (2007). Cluster-wise assessment of cluster stability. Computational Statistics & Data Analysis, 52(1), 258–271. https://doi.org/10.1016/j.csda.2006.11.025
- Hubert, L., & Arabie, P. (1985). Comparing partitions. Journal of Classification, 2(1), 193–218. https://doi.org/10.1007/bf01908075
- Murtagh, F., & Legendre, P. (2014). Ward’s hierarchical agglomerative clustering method: Which algorithms implement Ward’s criterion? Journal of Classification, 31(3), 274–295. https://doi.org/10.1007/s00357-014-9161-z ● Otwarty dostęp: pełny tekst
- Punj, G., & Stewart, D. W. (1983). Cluster analysis in marketing research: Review and suggestions for application. Journal of Marketing Research, 20(2), 134–148. https://doi.org/10.1177/002224378302000204
- Rousseeuw, P. J. (1987). Silhouettes: A graphical aid to the interpretation and validation of cluster analysis. Journal of Computational and Applied Mathematics, 20, 53–65. https://doi.org/10.1016/0377-0427(87)90125-7 ● Otwarty dostęp
- Steinley, D. (2006). K-means clustering: A half-century synthesis. British Journal of Mathematical and Statistical Psychology, 59(1), 1–34. https://doi.org/10.1348/000711005x48266
Cytowania BibTeX
@article{dolnicar2014required, author={Dolnicar, Sara and Grün, Bettina and Leisch, Friedrich and Schmidt, Kathrin}, title={{Required sample sizes for data-driven market segmentation analyses in tourism}}, journal={Journal of Travel Research}, year={2014}, volume={53}, number={3}, pages={296--306}, doi={10.1177/0047287513496475}}@article{fader2005rfm, author={Fader, Peter S. and Hardie, Bruce G. S. and Lee, Ka Lok}, title={{RFM and CLV: Using iso-value curves for customer base analysis}}, journal={Journal of Marketing Research}, year={2005}, volume={42}, number={4}, pages={415--430}, doi={10.1509/jmkr.2005.42.4.415}}@article{hennig2007cluster, author={Hennig, Christian}, title={{Cluster-wise assessment of cluster stability}}, journal={Computational Statistics \& Data Analysis}, year={2007}, volume={52}, number={1}, pages={258--271}, doi={10.1016/j.csda.2006.11.025}}@article{hubert1985comparing, author={Hubert, Lawrence and Arabie, Phipps}, title={{Comparing partitions}}, journal={Journal of Classification}, year={1985}, volume={2}, number={1}, pages={193--218}, doi={10.1007/bf01908075}}@article{murtagh2014ward, author={Murtagh, Fionn and Legendre, Pierre}, title={{Ward’s hierarchical agglomerative clustering method: Which algorithms implement Ward’s criterion?}}, journal={Journal of Classification}, year={2014}, volume={31}, number={3}, pages={274--295}, doi={10.1007/s00357-014-9161-z}}@article{punj1983cluster, author={Punj, Girish and Stewart, David W.}, title={{Cluster analysis in marketing research: Review and suggestions for application}}, journal={Journal of Marketing Research}, year={1983}, volume={20}, number={2}, pages={134--148}, doi={10.1177/002224378302000204}}@article{rousseeuw1987silhouettes, author={Rousseeuw, Peter J.}, title={{Silhouettes: A graphical aid to the interpretation and validation of cluster analysis}}, journal={Journal of Computational and Applied Mathematics}, year={1987}, volume={20}, pages={53--65}, doi={10.1016/0377-0427(87)90125-7}}@article{steinley2006kmeans, author={Steinley, Douglas}, title={{K-means clustering: A half-century synthesis}}, journal={British Journal of Mathematical and Statistical Psychology}, year={2006}, volume={59}, number={1}, pages={1--34}, doi={10.1348/000711005x48266}}