Przykład: komu wysłać którą promocję?
Fikcyjna drogeria internetowa po każdym zakupie wysyła krótką ankietę. Jedno pytanie brzmi: „Co było dla Ciebie ważne przy wyborze produktu?”. Klient zaznacza „tak” albo „nie” przy siedmiu odpowiedziach (od niskiej ceny po polecenie w mediach społecznościowych) i podaje wiek oraz płeć. Ankietę wypełniło 1000 klientów (średni wiek 37.9 roku, 70.6% kobiet).
Dział marketingu pyta: czy klienci dzielą się na kilka typów i komu wysłać którą kampanię? Odsetki z całej próby (cena 45.5%, opinie 57.7%, skład 29.8%) nie mówią, czy to te same osoby. Analiza klas latentnych (LCA) szuka grup osób o podobnym wzorcu odpowiedzi. Definicję znajdziesz w haśle analiza klas latentnych, a pełną procedurę naukową (test BLRT, reszty dwuzmiennowe, poprawka BCH) we wpisie LCA krok po kroku.
Dane są fikcyjne i wiemy, jakie klasy w nich ukryliśmy. Dzięki temu widać, co metoda odnalazła. Ręcznie ustaliliśmy cztery klasy i prawdopodobieństwo „tak” na każde pytanie w każdej z nich (np. .90 dla ceny i promocji w jednej klasie, .90 dla znanej marki w drugiej). Udział klas zależy też od wieku. Wszystkie parametry są w przepisie 1 kodu, a ziarno 603 ustalono raz i nie zmieniano go. Dane pobierzesz jako analiza-klas-latentnych-marketing-ankieta.csv. Kodowanie: 1 = nie, 2 = tak (wymóg pakietu poLCA). Kolumna klasa_prawdziwa to klasa ukryta przy losowaniu.
Jak działa model klas latentnych
W bazie klientów są ukryte typy, ale nikt nie nosi plakietki z nazwą typu. Model zakłada, że każdy typ ma własne prawdopodobieństwo odpowiedzi „tak” na każde pytanie. W obrębie jednego typu odpowiedzi są niezależne – to założenie lokalnej niezależności. Typ jest kategorią zmiennej ukrytej, a pytania są jej wskaźnikami na skali dychotomicznej. Prawdopodobieństwo całego wzorca odpowiedzi osoby to średnia ważona po klasach:
Słowami: πk to udział klasy k w populacji, a pjk to prawdopodobieństwo „tak” na pytanie j w tej klasie; yj = 1 przy odpowiedzi „tak”. Parametry szacuje się metodą największej wiarygodności, zwykle algorytmem EM. W R robi to pakiet poLCA, który obsługuje też zmienne towarzyszące (Linzer i Lewis, 2011). Na końcu każda osoba dostaje nie jedną etykietę, lecz prawdopodobieństwo przynależności do każdej klasy. Decyzje analityka krok po kroku omawiają Weller i in. (2020) oraz Sinha i in. (2021).
Rysunek 1: ile klas?
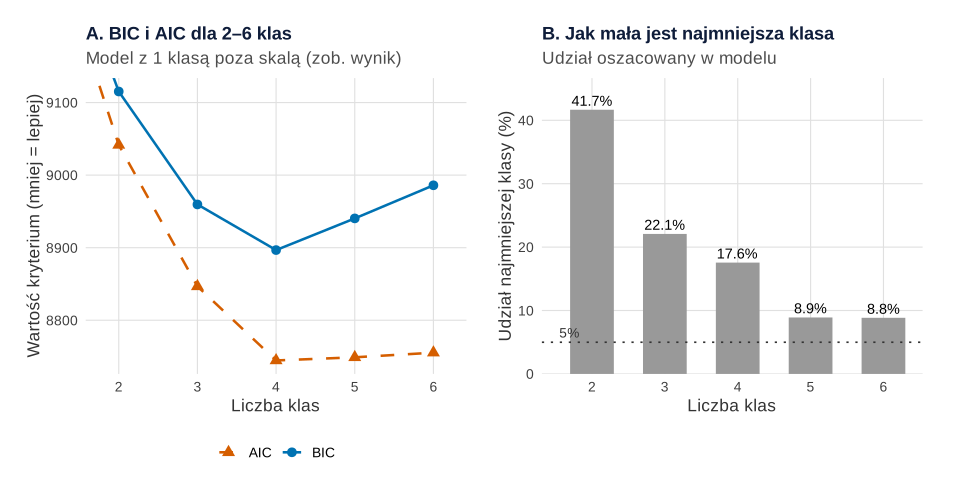
set.seed(603)).Co widać. Modele z 1–6 klasami oszacowaliśmy z 10 losowych startów każdy. BIC (panel A, mniej = lepiej) spada z 9407.71 dla jednej klasy do 8896.71 dla czterech, a potem rośnie: 8940.34 dla pięciu i 8985.97 dla sześciu. AIC też jest najmniejsze przy czterech klasach (8744.57), ale przy pięciu jest prawie takie samo (8748.94). Panel B: w modelu z czterema klasami najmniejsza klasa obejmuje 17.6% klientów, w modelu z pięcioma – 8.9%.
Jak może zmylić. Tu kryteria się zgadzają, w prawdziwych danych często nie. AIC karze za liczbę parametrów słabiej niż BIC, więc częściej wskazuje więcej klas. W symulacjach Nylunda i in. (2007) BIC był najlepszym z kryteriów informacyjnych (zob. AIC i BIC). Gdy się rozchodzą, rozstrzygają wielkość klas i sens dodatkowej klasy. Model z pięcioma klasami dzieli łowców okazji na grupę z prawdopodobieństwem „tak” przy cenie 1.00 (31.2%) i grupę z 0.00 (8.9%). Wartości 0 i 1 sugerują podział na siłę, a nie nowy segment.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: profil klas
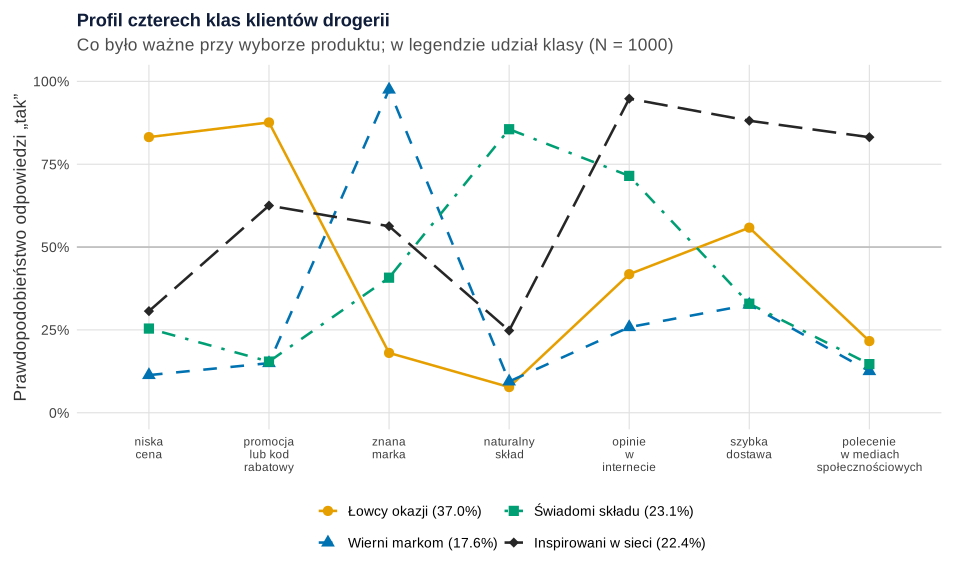
Co widać. Każda linia to jeden typ klienta. Łowcy okazji (37.0%) zaznaczają cenę (.83) i promocję (.88), rzadko markę (.18) i skład (.08). Wierni markom (17.6%) prawie zawsze wskazują znaną markę (.98), a promocję tylko z prawdopodobieństwem .15. Świadomi składu (23.1%) wybierają naturalny skład (.86) i czytają opinie (.71). Inspirowani w sieci (22.4%) kierują się opiniami (.95), szybką dostawą (.88) i poleceniami w mediach społecznościowych (.83). Model odtworzył klasy ukryte w danych: np. przy mediach u inspirowanych ustaliliśmy .80, a model oszacował .83.
Jak może zmylić. Profil to parametry modelu, a nie odsetki w grupach przypisanych osób. Linie tylko pomagają śledzić klasę – kolejność pytań jest umowna, jak na wykresie współrzędnych równoległych. Nazwy klas to interpretacja badacza i upraszczają obraz: np. inspirowani w sieci też często wybierają promocję (.63).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: jak pewne jest przypisanie klienta?
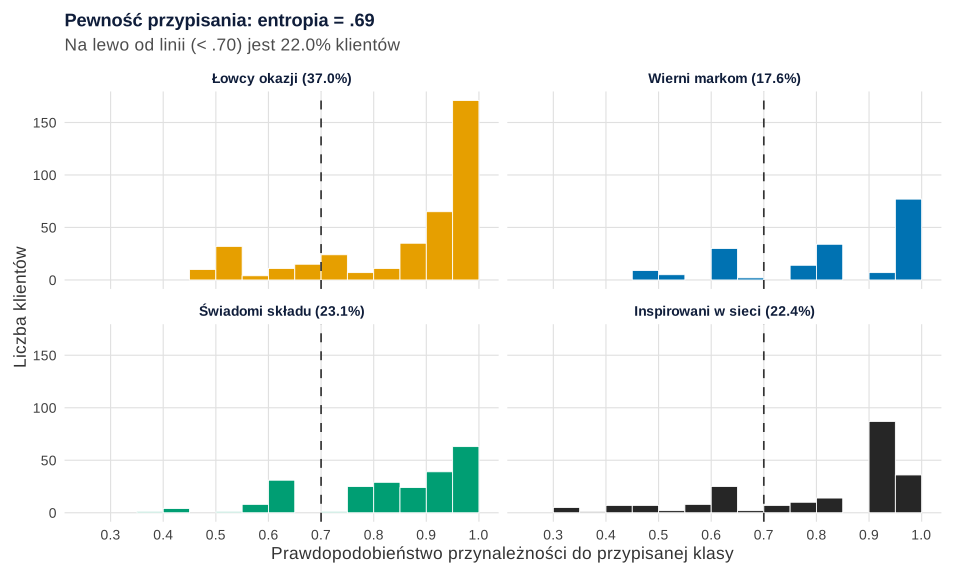
Co widać. Rysunek pokazuje największe z czterech prawdopodobieństw przynależności (a posteriori) każdej osoby. U 54.5% klientów przekracza ono .90 – wiadomo, do której klasy należą. U 22.0% jest niższe niż .70. To osoby „pomiędzy” – np. ktoś, kto zaznaczył tylko opinie, pasuje do dwóch klas. Jedną liczbą podsumowuje to entropia względna (zob. entropia Shannona): od 0 (przypisanie zgadywane) do 1 (pewne). Tu wynosi .69.
Co znaczy niska entropia. Entropia .69 nie oznacza złego modelu, tylko klasy, które częściowo na siebie zachodzą. Etykieta pojedynczej osoby bywa jednak błędna. W danych symulowanych przypisana klasa zgadzała się z prawdziwą u 79.8% klientów. Przy prawdopodobieństwie powyżej .90 zgadzała się u 93.2%, a poniżej .70 – tylko u 48.6%. Entropia nie służy do wyboru liczby klas: przy pięciu klasach była wyższa (.755) niż przy czterech (.690).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: karty klas i co z nimi zrobić w marketingu
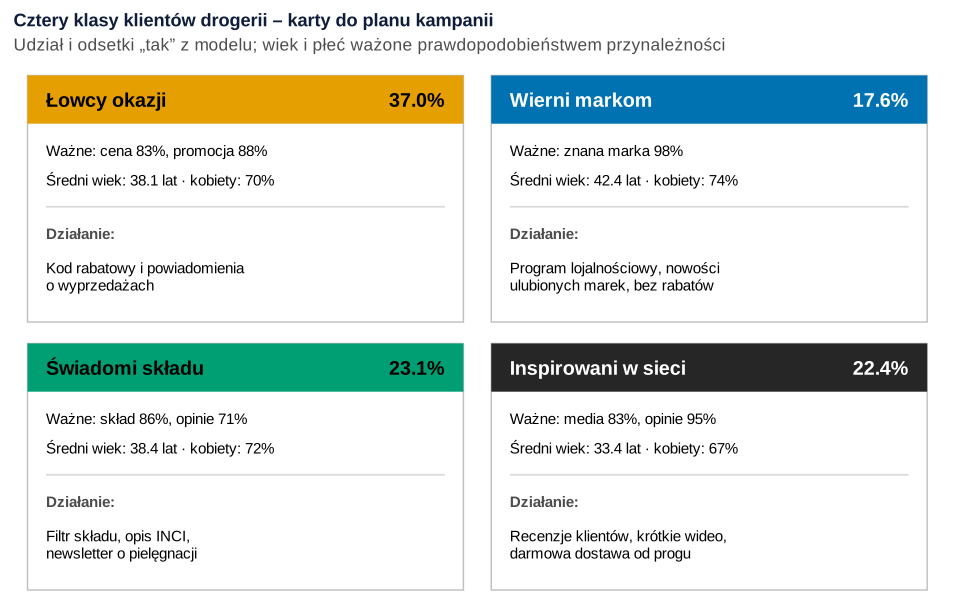
Co widać. Karta streszcza klasę i proponuje działanie. Wiek i płeć to średnie ważone prawdopodobieństwem przynależności, bez sztywnego przypisania osób. Wierni markom są najstarsi (42.4 roku), inspirowani w sieci najmłodsi (33.4). Odsetek kobiet jest podobny we wszystkich klasach (67.2–74.1%), więc płeć tych typów nie różnicuje.
Jak może zmylić. Działania na kartach to hipotezy, a nie wynik modelu. Przed wdrożeniem porównaj kampanię z grupą kontrolną w teście A/B.
Co z tym zrobić w marketingu
- Łowcy okazji (37.0%) – kody rabatowe i powiadomienia o wyprzedażach.
- Wierni markom (17.6%) – nowości ulubionych marek i program lojalnościowy. Promocję wskazują rzadko (.15) – rabat to tu głównie strata marży.
- Świadomi składu (23.1%) – filtr „naturalny skład”, pełna lista składników, opinie przy produkcie, newsletter o pielęgnacji.
- Inspirowani w sieci (22.4%) – recenzje klientów, krótkie wideo z użycia produktu, darmowa dostawa od progu.
- Klienci z niepewnym przypisaniem (22.0%) – kampania ogólna zamiast dedykowanej.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: wiek jako zmienna towarzysząca
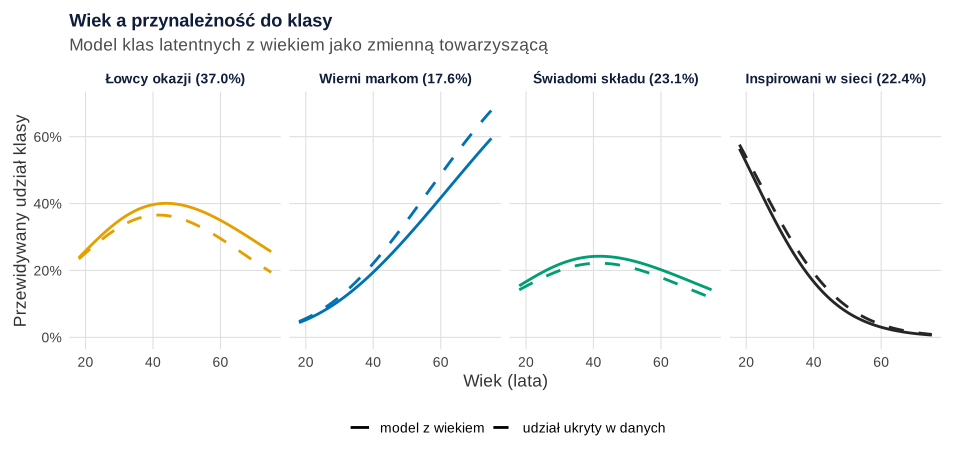
Co widać. Wiek dodaliśmy do modelu jako zmienną towarzyszącą. Klasy szacuje się razem z wielomianową regresją logistyczną przynależności na wiek – w poLCA wystarczy formuła ~ wiek10. Model z wiekiem jest lepiej dopasowany: w teście ilorazu wiarygodności LR = 103.66, df = 3, p < .001. Każda dekada wieku zwiększa szanse przynależności do wiernych markom względem łowców okazji (OR = 1.56, 95% CI [1.26, 1.93]). Szanse przynależności do inspirowanych w sieci maleją (OR = 0.46, 95% CI [0.36, 0.58]). Wśród 25-latków inspirowanych w sieci jest 42.0%, wśród 55-latków – 4.8%. Wiernych markom jest odpowiednio 7.8% i 35.8%. Prawdziwe udziały (linie przerywane) to 44.3% i 6.0% dla inspirowanych.
Jak może zmylić. Krzywe to przewidywania modelu i pokazują związek, a nie przyczynę. Kusi prostsza droga: przypisać osoby do klas, a potem policzyć regresję przypisanej klasy na wiek („przypisz i licz”). Taka analiza zaniża związki, bo pomija błąd klasyfikacji z rysunku 3 (Vermunt, 2010). W przykładzie nachylenie dla inspirowanych w sieci wyniosło −0.478 na dekadę zamiast −0.787 z modelu jednoetapowego, a w danych ukryliśmy −0.700. Poprawione metody trzykrokowe (np. BCH) pokazuje wpis LCA krok po kroku.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 6: LCA a k-średnich i lokalne maksima
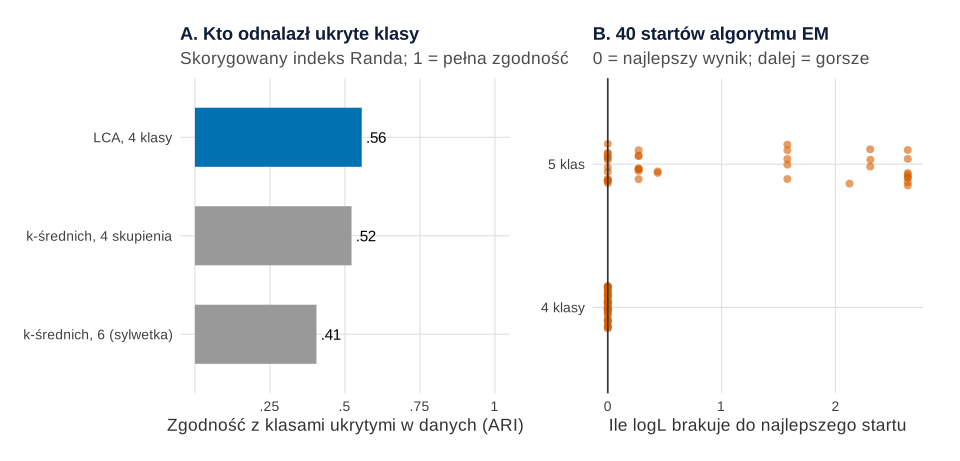
set.seed(603)).Co widać. Panel A: zgodność podziału z klasami ukrytymi w danych mierzona skorygowanym indeksem Randa (ARI: 0 = zgodność przypadkowa, 1 = pełna). LCA z czterema klasami osiąga .56, a metoda k-średnich z hasła analiza skupień (cztery skupienia, odpowiedzi zestandaryzowane) – .52. Przy znanej liczbie grup różnica jest mała, większa – przy wyborze liczby grup. Średnia sylwetka rosła od .199 przy dwóch do .240 przy sześciu skupieniach, a podział na sześć skupień ma ARI .41. Przy siedmiu pytaniach tak/nie 1000 osób ma tylko 113 różnych wzorców odpowiedzi, a k-średnich zakłada zmienne ciągłe.
Panel B: wszystkie 40 startów modelu z czterema klasami dało ten sam wynik. Przy pięciu klasach najlepszy wynik osiągnęło 13 z 40 startów, a pozostałe utknęły do 2.64 punktu logarytmu wiarygodności niżej – w lokalnych maksimach. Dlatego szacuj model z wielu startów (nrep).
Jak może zmylić. ARI znamy tylko dla danych symulowanych, a jeden zbiór nie rozstrzyga, która metoda jest lepsza. Nowy start dał identyczny logarytm wiarygodności (−4341.28), ale łowcy okazji byli w nim klasą 2, a nie 1. To zamiana etykiet – dlatego nazwy nadajemy po profilu. Porównanie obu rodzin metod na danych ciągłych opisują wpisy segmentacja respondentów: k-średnich i LPA oraz analiza skupień w marketingu.
Podpis do pracy:
Zdanie do Metody:
Pułapki
- Jeden start algorytmu – ryzyko lokalnego maksimum (rysunek 6B).
- Numer klasy jako nazwa – kolejność zmienia się między startami.
- Złamana lokalna niezależność. Jeśli dwa pytania są powiązane także w obrębie klasy (np. „promocja” i „kod rabatowy” jako osobne pozycje), model doda klasę, żeby ten związek wyjaśnić. Unikaj pytań, które prawie się powtarzają. Sprawdzenie resztami opisuje LCA krok po kroku.
- Klasa 3% respondentów. Jej profil jest niepewny, a kampania dla 30 osób z 1000 rzadko się opłaca. Sprawdź, czy nie ma prawdopodobieństw 0 i 1.
- Za mała próba. W symulacjach segmentacji opartej na danych wystarczała próba równa 70-krotności liczby zmiennych (Dolnicar i in., 2014). Przy siedmiu pytaniach to 490 osób.
- Przypisana klasa jak zmienna obserwowana – zaniżone związki (rysunek 5).
- Wyniki skal zamiast odpowiedzi tak/nie. Do wskaźników ciągłych służy analiza profili latentnych.
Jak opisać w pracy
W Metodzie podaj wskaźniki, program, liczbę startów i kryteria wyboru liczby klas, w Wynikach – tabelę modeli, profil klas i entropię. Inne typowe analizy opisuje wpis statystyka w pracy z marketingu.
| Klasy | logL | Parametry | AIC | BIC | Najmniejsza klasa (%) | Entropia |
|---|---|---|---|---|---|---|
| 1 | −4679.68 | 7 | 9373.36 | 9407.71 | 100.0 | – |
| 2 | −4505.81 | 15 | 9041.62 | 9115.23 | 41.7 | .61 |
| 3 | −4400.35 | 23 | 8846.69 | 8959.57 | 22.1 | .67 |
| 4 | −4341.28 | 31 | 8744.57 | 8896.71 | 17.6 | .69 |
| 5 | −4335.47 | 39 | 8748.94 | 8940.34 | 8.9 | .76 |
| 6 | −4330.65 | 47 | 8755.30 | 8985.97 | 8.8 | .75 |
Podpis tabeli:
Do Metody:
Dane o zakupach analizuje wpis analiza koszykowa i systemy rekomendacyjne. Ile klient zapłaci za cechę produktu, pokaże analiza conjoint. Między klasami warto też porównać NPS.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw, dane i modele, z których korzystają następne. Każdy przepis kończy się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Przepisy, które losują (1, 5 i 6), mają własne set.seed(603) przed każdym losowaniem. Ziarno 603 ustalono raz i nie zmieniano go. Ręcznie ustalono: 1000 klientów, prawdopodobieństwa „tak” w czterech klasach (macierz p_tak), rozkład wieku (średnia 38, odchylenie 12, zakres 18–75), 70% kobiet, logity udziału klas zależne od wieku (−0.6 + 0.05 × (wiek − 38), −0.5 oraz −0.5 − 0.07 × (wiek − 38) względem łowców okazji), 10 startów na model i 40 startów w kontroli lokalnych maksimów. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Przepis 1 liczy się około 25 sekund, a przepis 6 – około 40 sekund.
1. Paleta, dane i modele z 1–6 klasami: Rysunek 1
R
# Rysunek 1. Ile klas? BIC, AIC i wielkość najmniejszej klasy (dane fikcyjne, symulowane)
library(ggplot2)
library(patchwork)
library(poLCA)                                   # analiza klas latentnych

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(okazje = "#E69F00", marka = "#0072B2", sklad = "#009E73", siec = "#262626",
         bic = "#0072B2", aic = "#D55E00", dane = "grey60", ciemny = "grey20")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Fikcyjna drogeria internetowa: ankieta po zakupie, 1000 klientów.
# „Co było dla Ciebie ważne przy wyborze produktu?” – 7 pytań tak/nie.
pytania <- c(cena = "niska cena", promocja = "promocja lub kod rabatowy", marka = "znana marka",
             sklad = "naturalny skład", opinie = "opinie w internecie", dostawa = "szybka dostawa",
             media = "polecenie w mediach społecznościowych")
# Ukryte w danych 4 klasy – prawdopodobieństwa „tak” ustalone ręcznie
p_tak <- rbind(okazje = c(.90, .90, .15, .10, .40, .55, .20),
               marka  = c(.15, .20, .90, .20, .25, .35, .10),
               sklad  = c(.25, .15, .35, .90, .80, .25, .15),
               siec   = c(.35, .60, .50, .30, .90, .85, .80))
colnames(p_tak) <- names(pytania)

set.seed(603)                                    # ziarno ustalone raz, bez dobierania pod wynik
N <- 1000
wiek <- pmin(pmax(round(rnorm(N, 38, 12)), 18), 75)
plec <- sample(c("kobieta", "mężczyzna"), N, replace = TRUE, prob = c(.7, .3))
# Udział klas zależy od wieku (logity względem „okazje”, parametry ustalone ręcznie)
eta <- cbind(0, -0.6 + 0.05 * (wiek - 38), -0.5, -0.5 - 0.07 * (wiek - 38))
pr <- exp(eta) / rowSums(exp(eta))
klasa_prawdziwa <- apply(pr, 1, function(p) sample(1:4, 1, prob = p))
odp <- sapply(1:7, function(j) rbinom(N, 1, p_tak[klasa_prawdziwa, j]))
colnames(odp) <- names(pytania)
dane <- data.frame(id = 1:N, wiek, plec, odp + 1, klasa_prawdziwa)   # poLCA: 1 = nie, 2 = tak
write.csv(dane, "analiza-klas-latentnych-marketing-ankieta.csv", row.names = FALSE)
round(100 * colMeans(odp), 1)                    # odsetek „tak” w całej próbie
round(100 * prop.table(table(klasa_prawdziwa)), 1)
c(sredni_wiek = round(mean(wiek), 1), kobiety_proc = round(100 * mean(plec == "kobieta"), 1))

# Modele z 1–6 klasami, każdy z 10 losowych startów
f <- cbind(cena, promocja, marka, sklad, opinie, dostawa, media) ~ 1
set.seed(603)
modele <- lapply(1:6, function(k) poLCA(f, data = dane, nclass = k, nrep = 10, maxiter = 3000, verbose = FALSE))
entropia <- function(m) {                        # entropia względna (0–1)
  p <- m$posterior; if (ncol(p) == 1) return(NA)
  1 - sum(-p * log(pmax(p, 1e-12))) / (nrow(p) * log(ncol(p)))
}
porownanie <- data.frame(
  klasy = 1:6,
  logL = sapply(modele, function(m) m$llik), parametry = sapply(modele, function(m) m$npar),
  AIC = sapply(modele, function(m) m$aic), BIC = sapply(modele, function(m) m$bic),
  najmniejsza_proc = sapply(modele, function(m) 100 * min(m$P)),
  entropia = sapply(modele, entropia),
  starty_z_maks = sapply(modele, function(m) if (length(m$attempts)) sum(m$attempts > max(m$attempts) - 0.01) else NA))
print(cbind(porownanie[1:3], round(porownanie[4:7], 3), porownanie[8]), row.names = FALSE)

dl <- rbind(data.frame(klasy = 1:6, wartosc = porownanie$BIC, kryterium = "BIC"),
            data.frame(klasy = 1:6, wartosc = porownanie$AIC, kryterium = "AIC"))
p1a <- ggplot(dl, aes(klasy, wartosc, colour = kryterium, shape = kryterium, linetype = kryterium)) +
  geom_line(linewidth = 0.9) + geom_point(size = 3) +
  scale_colour_manual(values = c(BIC = kol[["bic"]], AIC = kol[["aic"]]), name = NULL) +
  scale_shape_manual(values = c(BIC = 16, AIC = 17), name = NULL) +
  scale_linetype_manual(values = c(BIC = "solid", AIC = "dashed"), name = NULL) +
  scale_x_continuous(breaks = 2:6) +
  labs(x = "Liczba klas", y = "Wartość kryterium (mniej = lepiej)",
       title = "A. BIC i AIC dla 2–6 klas", subtitle = "Model z 1 klasą poza skalą (zob. wynik)") +
  coord_cartesian(xlim = c(1.8, 6.2), ylim = range(dl$wartosc[dl$klasy > 1])) + motyw
p1b <- ggplot(porownanie[-1, ], aes(klasy, najmniejsza_proc)) +
  geom_col(fill = kol[["dane"]], width = 0.6) +
  geom_text(aes(label = sprintf("%.1f%%", najmniejsza_proc)), vjust = -0.4, size = 3.8) +
  geom_hline(yintercept = 5, linetype = "dotted", colour = kol[["ciemny"]]) +
  annotate("text", x = 1.55, y = 6.5, label = "5%", hjust = 0, size = 3.6, colour = kol[["ciemny"]]) +
  scale_x_continuous(breaks = 2:6) + scale_y_continuous(expand = expansion(mult = c(0, 0.12))) +
  labs(x = "Liczba klas", y = "Udział najmniejszej klasy (%)",
       title = "B. Jak mała jest najmniejsza klasa", subtitle = "Udział oszacowany w modelu") + motyw
p1 <- p1a + p1b
p1   # ggsave("lca-bic.svg", p1, width = 10, height = 5.2)
Wynik w R
    cena promocja    marka    sklad   opinie  dostawa    media
    45.5     52.6     45.8     29.8     57.7     53.7     32.2
klasa_prawdziwa
   1    2    3    4
32.5 22.7 19.4 25.4
 sredni_wiek kobiety_proc
        37.9         70.6
 klasy      logL parametry      AIC      BIC najmniejsza_proc entropia
     1 -4679.678         7 9373.356 9407.710          100.000       NA
     2 -4505.808        15 9041.616 9115.232           41.668    0.613
     3 -4400.347        23 8846.694 8959.572           22.076    0.665
     4 -4341.283        31 8744.565 8896.706           17.558    0.690
     5 -4335.469        39 8748.938 8940.341            8.907    0.755
     6 -4330.651        47 8755.302 8985.967            8.846    0.746
 starty_z_maks
            NA
             9
            10
            10
             5
             4
2. Profil klas: Rysunek 2
R
# Rysunek 2. Profil klas: prawdopodobieństwo odpowiedzi „tak” w każdej z 4 klas
# Dane wejściowe: dane, modele, pytania, kol i motyw z przepisu 1.
m4 <- modele[[4]]
tak <- sapply(m4$probs, function(x) x[, 2])          # wiersze = klasy w kolejności z poLCA, kolumny = pytania
# Kolejność klas z poLCA jest przypadkowa (zamiana etykiet). Nazwę nadajemy po treści profilu:
# klasa z najwyższym „tak” dla ceny = okazje, dla marki = marka, dla składu = skład, dla mediów = sieć.
kolejnosc <- sapply(c(okazje = "cena", marka = "marka", sklad = "sklad", siec = "media"),
                    function(j) unname(which.max(tak[, j])))
kolejnosc                                             # numer klasy w poLCA dla każdej nazwy
stopifnot(length(unique(kolejnosc)) == 4)
nazwy <- c(okazje = "Łowcy okazji", marka = "Wierni markom", sklad = "Świadomi składu", siec = "Inspirowani w sieci")
udzial <- m4$P[kolejnosc]
etykiety <- sprintf("%s (%.1f%%)", nazwy, 100 * udzial)
wynik_profil <- cbind(udzial_proc = 100 * udzial, tak[kolejnosc, ])
rownames(wynik_profil) <- names(kolejnosc)
round(wynik_profil, 2)
# Dla porównania: prawdopodobieństwa ustalone przy losowaniu danych
p_tak

profil <- data.frame(klasa = factor(rep(etykiety, times = 7), levels = etykiety),
                     kod = rep(names(kolejnosc), times = 7),
                     pytanie = factor(rep(pytania, each = 4), levels = pytania),
                     p = as.vector(tak[kolejnosc, ]))
p2 <- ggplot(profil, aes(pytanie, p, colour = klasa, shape = klasa, linetype = klasa, group = klasa)) +
  geom_hline(yintercept = 0.5, colour = "grey75") +
  geom_line(linewidth = 0.9) + geom_point(size = 3.2) +
  scale_colour_manual(values = unname(kol[names(kolejnosc)]), name = NULL) +
  scale_shape_manual(values = c(16, 17, 15, 18), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed", "dotdash", "longdash"), name = NULL) +
  scale_x_discrete(labels = function(x) gsub(" ", "\n", sub(" lub ", " lub ", sub("w mediach", "w mediach", x)))) +
  scale_y_continuous(limits = c(0, 1), breaks = seq(0, 1, .25), labels = scales::label_percent()) +
  guides(colour = guide_legend(nrow = 2), shape = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2)) +
  labs(x = NULL, y = "Prawdopodobieństwo odpowiedzi „tak”",
       title = "Profil czterech klas klientów drogerii",
       subtitle = "Co było ważne przy wyborze produktu; w legendzie udział klasy (N = 1000)") + motyw +
  theme(axis.text.x = element_text(size = rel(0.85), lineheight = 0.9))
p2   # ggsave("lca-profil.svg", p2, width = 10, height = 5.8)

# Dla porównania: model z 5 klasami – jedna klasa „rozpada się” na dwie, z prawdopodobieństwami 0 i 1
tak5 <- sapply(modele[[5]]$probs, function(x) x[, 2])
round(cbind(udzial_proc = 100 * modele[[5]]$P, tak5), 2)
Wynik w R
okazje  marka  sklad   siec
     1      2      3      4
       udzial_proc cena promocja marka sklad opinie dostawa media
okazje       37.01 0.83     0.88  0.18  0.08   0.42    0.56  0.22
marka        17.56 0.11     0.15  0.98  0.09   0.26    0.33  0.13
sklad        23.06 0.25     0.15  0.41  0.86   0.71    0.33  0.15
siec         22.38 0.31     0.63  0.56  0.25   0.95    0.88  0.83
       cena promocja marka sklad opinie dostawa media
okazje 0.90     0.90  0.15   0.1   0.40    0.55  0.20
marka  0.15     0.20  0.90   0.2   0.25    0.35  0.10
sklad  0.25     0.15  0.35   0.9   0.80    0.25  0.15
siec   0.35     0.60  0.50   0.3   0.90    0.85  0.80
          udzial_proc cena promocja marka sklad opinie dostawa media
class 1:        21.90 0.31     0.63  0.55  0.25   0.96    0.87  0.84
class 2:        23.76 0.25     0.18  0.40  0.84   0.71    0.33  0.14
class 3:         8.91 0.00     0.82  0.47  0.00   0.30    0.62  0.17
class 4:        14.24 0.12     0.00  1.00  0.12   0.26    0.28  0.13
class 5:        31.20 1.00     0.88  0.19  0.08   0.42    0.55  0.22
3. Prawdopodobieństwa przynależności i entropia: Rysunek 3
R
# Rysunek 3. Jak pewne jest przypisanie? Prawdopodobieństwa przynależności a posteriori i entropia
# Dane wejściowe: dane, m4, kolejnosc, nazwy, etykiety, entropia(), kol i motyw z przepisów 1–2.
post <- m4$posterior[, kolejnosc]                    # kolumny w kolejności nazw
colnames(post) <- names(kolejnosc)
przypisana <- apply(post, 1, which.max)
maks <- apply(post, 1, max)
c(entropia = round(entropia(m4), 3),
  maks_ponizej_07_proc = round(100 * mean(maks < .7), 1), maks_powyzej_09_proc = round(100 * mean(maks > .9), 1))
# Średnie prawdopodobieństwo każdej klasy u osób przypisanych do danej klasy (na przekątnej – pewność)
round(t(sapply(1:4, function(k) colMeans(post[przypisana == k, , drop = FALSE]))), 2)
table(przypisana = nazwy[przypisana])
# Ile osób przypisanych zgadza się z klasą ukrytą w danych (tylko w danych symulowanych)
prawda <- names(kolejnosc)[dane$klasa_prawdziwa]     # klasy w p_tak mają tę samą kolejność co nazwy
c(zgodnosc_proc = round(100 * mean(names(kolejnosc)[przypisana] == prawda), 1),
  zgodnosc_maks_pow_09 = round(100 * mean((names(kolejnosc)[przypisana] == prawda)[maks > .9]), 1),
  zgodnosc_maks_pon_07 = round(100 * mean((names(kolejnosc)[przypisana] == prawda)[maks < .7]), 1))

pd <- data.frame(klasa = factor(etykiety[przypisana], levels = etykiety), maks = maks)
p3 <- ggplot(pd, aes(maks, fill = klasa)) +
  geom_histogram(breaks = seq(0.25, 1, 0.05), colour = "white", linewidth = 0.3) +
  geom_vline(xintercept = 0.7, linetype = "dashed", colour = kol[["ciemny"]]) +
  facet_wrap(~ klasa, ncol = 2) +
  scale_fill_manual(values = unname(kol[names(kolejnosc)]), guide = "none") +
  scale_x_continuous(breaks = seq(0.3, 1, 0.1), labels = scales::label_number(accuracy = 0.1)) +
  labs(x = "Prawdopodobieństwo przynależności do przypisanej klasy", y = "Liczba klientów",
       title = sprintf("Pewność przypisania: entropia = %s", sub("^0", "", sprintf("%.2f", entropia(m4)))),
       subtitle = sprintf("Na lewo od linii (< .70) jest %.1f%% klientów", 100 * mean(maks < .7))) + motyw
p3   # ggsave("lca-przynaleznosc.svg", p3, width = 10, height = 6)
Wynik w R
            entropia maks_ponizej_07_proc maks_powyzej_09_proc
                0.69                22.00                54.50
     okazje marka sklad siec
[1,]   0.86  0.01  0.04 0.09
[2,]   0.07  0.82  0.06 0.05
[3,]   0.04  0.08  0.84 0.05
[4,]   0.08  0.04  0.08 0.81
przypisana
Inspirowani w sieci        Łowcy okazji     Świadomi składu       Wierni markom
                211                 385                 226                 178
       zgodnosc_proc zgodnosc_maks_pow_09 zgodnosc_maks_pon_07
                79.8                 93.2                 48.6
4. Karty klas: Rysunek 4
R
# Rysunek 4. Karty klas: nazwa, udział, 3 liczby i proponowane działanie (grafika z ggplot2)
# Dane wejściowe: dane, post, tak, kolejnosc, nazwy, udzial, kol i motyw z przepisów 1–3.
# Wiek i odsetek kobiet ważone prawdopodobieństwem przynależności (bez sztywnego przypisania)
w_srednia <- function(x) colSums(post * x) / colSums(post)
opis <- data.frame(kod = names(kolejnosc), nazwa = nazwy, udzial = 100 * udzial,
                   wiek = w_srednia(dane$wiek), kobiety = 100 * w_srednia(dane$plec == "kobieta"))
opis$klucz <- c(sprintf("cena %.0f%%, promocja %.0f%%", 100 * tak[kolejnosc[1], "cena"], 100 * tak[kolejnosc[1], "promocja"]),
                sprintf("znana marka %.0f%%", 100 * tak[kolejnosc[2], "marka"]),
                sprintf("skład %.0f%%, opinie %.0f%%", 100 * tak[kolejnosc[3], "sklad"], 100 * tak[kolejnosc[3], "opinie"]),
                sprintf("media %.0f%%, opinie %.0f%%", 100 * tak[kolejnosc[4], "media"], 100 * tak[kolejnosc[4], "opinie"]))
opis$dzialanie <- c("Kod rabatowy i powiadomienia\no wyprzedażach",
                    "Program lojalnościowy, nowości\nulubionych marek, bez rabatów",
                    "Filtr składu, opis INCI,\nnewsletter o pielęgnacji",
                    "Recenzje klientów, krótkie wideo,\ndarmowa dostawa od progu")
print(cbind(opis[c("nazwa", "klucz")], round(opis[c("udzial", "wiek", "kobiety")], 1)), row.names = FALSE)

opis$x <- c(0, 1, 0, 1); opis$y <- c(1, 1, 0, 0)
p4 <- ggplot(opis) +
  geom_rect(aes(xmin = x + 0.03, xmax = x + 0.97, ymin = y + 0.04, ymax = y + 0.96),
            fill = "white", colour = "grey75", linewidth = 0.5) +
  geom_rect(aes(xmin = x + 0.03, xmax = x + 0.97, ymin = y + 0.78, ymax = y + 0.96, fill = kod)) +
  geom_text(aes(x + 0.07, y + 0.87, label = nazwa, colour = kod), hjust = 0, fontface = "bold", size = 5.2) +
  geom_text(aes(x + 0.93, y + 0.87, label = sprintf("%.1f%%", udzial), colour = kod), hjust = 1, fontface = "bold", size = 5.2) +
  geom_text(aes(x + 0.07, y + 0.68, label = paste("Ważne:", klucz)), hjust = 0, size = 4) +
  geom_text(aes(x + 0.07, y + 0.57, label = sprintf("Średni wiek: %.1f lat · kobiety: %.0f%%", wiek, kobiety)), hjust = 0, size = 4) +
  geom_segment(aes(x = x + 0.07, xend = x + 0.93, y = y + 0.47, yend = y + 0.47), colour = "grey85") +
  geom_text(aes(x + 0.07, y + 0.37, label = "Działanie:"), hjust = 0, size = 4, fontface = "bold", colour = "grey30") +
  geom_text(aes(x + 0.07, y + 0.21, label = dzialanie), hjust = 0, size = 4, lineheight = 0.95) +
  scale_fill_manual(values = kol[c("okazje", "marka", "sklad", "siec")], guide = "none") +
  scale_colour_manual(values = c(okazje = "black", marka = "white", sklad = "black", siec = "white"), guide = "none") +
  coord_cartesian(xlim = c(0, 2), ylim = c(0, 2), expand = FALSE) +
  labs(title = "Cztery klasy klientów drogerii – karty do planu kampanii",
       subtitle = "Udział i odsetki „tak” z modelu; wiek i płeć ważone prawdopodobieństwem przynależności") +
  motyw + theme(axis.text = element_blank(), axis.title = element_blank(),
                panel.grid.major = element_blank(), panel.grid.minor = element_blank())
p4   # ggsave("lca-karty.svg", p4, width = 10, height = 6.4)
Wynik w R
               nazwa                  klucz udzial wiek kobiety
        Łowcy okazji cena 83%, promocja 88%   37.0 38.1    70.4
       Wierni markom        znana marka 98%   17.6 42.4    74.1
     Świadomi składu  skład 86%, opinie 71%   23.1 38.4    71.6
 Inspirowani w sieci  media 83%, opinie 95%   22.4 33.4    67.2
5. Wiek jako zmienna towarzysząca: Rysunek 5
R
# Rysunek 5. Zmienna towarzysząca: jak udział klas zmienia się z wiekiem
# Dane wejściowe: dane, f, m4, kolejnosc, nazwy, etykiety, przypisana, kol i motyw z przepisów 1–3.
library(nnet)                                        # multinom(): porównanie z „przypisz i licz”
dane$wiek10 <- (dane$wiek - 38) / 10                 # wiek w dekadach, wyśrodkowany na 38 latach
fw <- cbind(cena, promocja, marka, sklad, opinie, dostawa, media) ~ wiek10
# Start z rozwiązania m4, żeby klasy miały tę samą kolejność (bez zamiany etykiet)
set.seed(603)
m4w <- poLCA(fw, data = dane, nclass = 4, probs.start = m4$probs, maxiter = 3000, verbose = FALSE)
LR <- 2 * (m4w$llik - m4$llik)                       # test ilorazu wiarygodności, df = 3 (1 współczynnik × 3 klasy)
c(logL_bez_wieku = round(m4$llik, 2), logL_z_wiekiem = round(m4w$llik, 2), LR = round(LR, 2))
format.pval(pchisq(LR, df = 3, lower.tail = FALSE), digits = 3, eps = 0.001)
# Współczynniki logitu: każda klasa względem klasy nr 1 z poLCA; tu przeliczone względem „Łowców okazji”
b <- cbind(0, m4w$coeff)                             # kolumny: klasy w kolejności poLCA
b <- b[, kolejnosc] - b[, kolejnosc[1]]
colnames(b) <- names(kolejnosc)
round(b, 3)
# Iloraz szans na dekadę wieku względem „Łowców okazji” z 95% CI (błędy standardowe z poLCA są
# względem klasy nr 1 z poLCA – tu jest nią klasa „okazje”, co sprawdza stopifnot)
stopifnot(kolejnosc[["okazje"]] == 1)
se <- m4w$coeff.se[2, kolejnosc[-1] - 1]
round(rbind(OR = exp(b[2, -1]), dolna = exp(b[2, -1] - 1.96 * se), gorna = exp(b[2, -1] + 1.96 * se)), 2)

# Przewidywane udziały klas dla wieku 18–75 lat; linia przerywana: udziały ukryte w danych (prawda)
siatka <- seq(18, 75, 1)
eta_m <- cbind(1, (siatka - 38) / 10) %*% b
udz_m <- exp(eta_m) / rowSums(exp(eta_m))
eta_p <- cbind(0, -0.6 + 0.05 * (siatka - 38), -0.5, -0.5 - 0.07 * (siatka - 38))
udz_p <- exp(eta_p) / rowSums(exp(eta_p))
round(100 * rbind(model_25 = udz_m[siatka == 25, ], model_55 = udz_m[siatka == 55, ],
                  prawda_25 = udz_p[siatka == 25, ], prawda_55 = udz_p[siatka == 55, ]), 1)

# „Przypisz i licz”: regresja przypisanej klasy na wiek zaniża związek (Vermunt, 2010)
kl <- factor(names(kolejnosc)[przypisana], levels = names(kolejnosc))
mn <- multinom(kl ~ wiek10, data = dane, trace = FALSE)
round(rbind(jednoetapowo_poLCA = b[2, -1], przypisz_i_licz = coef(mn)[, "wiek10"],
            prawda = c(0.5, 0, -0.7)), 3)        # prawdziwe nachylenia na dekadę: 0.05 × 10, 0, −0.07 × 10

wl <- rbind(data.frame(wiek = siatka, udzial = as.vector(udz_m), zrodlo = "model z wiekiem",
                       klasa = factor(rep(etykiety, each = length(siatka)), levels = etykiety)),
            data.frame(wiek = siatka, udzial = as.vector(udz_p), zrodlo = "udział ukryty w danych",
                       klasa = factor(rep(etykiety, each = length(siatka)), levels = etykiety)))
p5 <- ggplot(wl, aes(wiek, udzial, colour = klasa, linetype = zrodlo)) +
  geom_line(linewidth = 1) +
  facet_wrap(~ klasa, ncol = 4) +
  scale_colour_manual(values = unname(kol[names(kolejnosc)]), guide = "none") +
  scale_linetype_manual(values = c("model z wiekiem" = "solid", "udział ukryty w danych" = "dashed"), name = NULL) +
  scale_y_continuous(labels = scales::label_percent(), limits = c(0, 0.7)) +
  scale_x_continuous(breaks = c(20, 40, 60)) +
  labs(x = "Wiek (lata)", y = "Przewidywany udział klasy",
       title = "Wiek a przynależność do klasy",
       subtitle = "Model klas latentnych z wiekiem jako zmienną towarzyszącą") + motyw
p5   # ggsave("lca-wiek.svg", p5, width = 10, height = 4.8)
Wynik w R
logL_bez_wieku logL_z_wiekiem             LR
      -4341.28       -4289.45         103.66
[1] "<0.001"
            okazje  marka  sklad   siec
(Intercept)      0 -0.801 -0.489 -0.713
wiek10           0  0.444 -0.027 -0.787
      marka sklad siec
OR     1.56  0.97 0.46
dolna  1.26  0.80 0.36
gorna  1.93  1.19 0.58
          okazje marka sklad siec
model_25    30.8   7.8  19.5 42.0
model_55    37.5  35.8  21.9  4.8
prawda_25   29.4   8.4  17.8 44.3
prawda_55   32.5  41.8  19.7  6.0
                   marka  sklad   siec
jednoetapowo_poLCA 0.444 -0.027 -0.787
przypisz_i_licz    0.398  0.080 -0.478
prawda             0.500  0.000 -0.700
6. k-średnich, lokalne maksima i zamiana etykiet: Rysunek 6
R
# Rysunek 6. LCA a k-średnich na tych samych odpowiedziach oraz lokalne maksima
# Dane wejściowe: dane, f, modele, m4, przypisana, kolejnosc, kol i motyw z przepisów 1–3.
library(cluster)                                     # silhouette()
library(mclust)                                      # adjustedRandIndex()
X <- scale(as.matrix(dane[, c("cena", "promocja", "marka", "sklad", "opinie", "dostawa", "media")]) - 1)
set.seed(603)
km <- lapply(2:6, function(k) kmeans(X, centers = k, nstart = 25, iter.max = 50))
d <- dist(X)
sylwetka <- sapply(km, function(m) mean(silhouette(m$cluster, d)[, 3]))
names(sylwetka) <- 2:6
round(sylwetka, 3)
k_syl <- as.integer(names(which.max(sylwetka)))
ari <- c(LCA_4 = adjustedRandIndex(przypisana, dane$klasa_prawdziwa),
         kmeans_4 = adjustedRandIndex(km[[3]]$cluster, dane$klasa_prawdziwa),
         kmeans_sylwetka = adjustedRandIndex(km[[k_syl - 1]]$cluster, dane$klasa_prawdziwa),
         LCA_vs_kmeans_4 = adjustedRandIndex(przypisana, km[[3]]$cluster))
c(k_wg_sylwetki = k_syl, round(ari, 3))
# Ile różnych wzorców odpowiedzi ma 1000 osób (przy 7 pytaniach tak/nie możliwych jest 128)
nrow(unique(X))

# Lokalne maksima: 40 pojedynczych startów modelu z 4 i 5 klasami
set.seed(603)
starty <- do.call(rbind, lapply(4:5, function(k) {
  ll <- replicate(40, poLCA(f, data = dane, nclass = k, nrep = 1, maxiter = 3000, verbose = FALSE)$llik)
  data.frame(klasy = paste(k, "klasy" , sep = " "), logL = ll, roznica = max(ll) - ll)
}))
starty$klasy[starty$klasy == "5 klasy"] <- "5 klas"
aggregate(roznica ~ klasy, starty, function(x) c(w_maks = sum(x < 0.01), maks_roznica = round(max(x), 2)))
# Zamiana etykiet: m4 (10 startów) i jeden nowy start – to samo logL, inna kolejność klas
set.seed(603)
a <- poLCA(f, data = dane, nclass = 4, nrep = 1, maxiter = 3000, verbose = FALSE)
round(c(logL_m4 = m4$llik, logL_nowy_start = a$llik), 2)
rbind(udzialy_m4 = round(m4$P, 3), udzialy_nowy_start = round(a$P, 3))
table(m4 = m4$predclass, nowy_start = a$predclass)

wa <- data.frame(metoda = factor(c("LCA, 4 klasy", "k-średnich, 4 skupienia", sprintf("k-średnich, %d (sylwetka)", k_syl)),
                                 levels = rev(c("LCA, 4 klasy", "k-średnich, 4 skupienia", sprintf("k-średnich, %d (sylwetka)", k_syl)))),
                 ari = ari[1:3])
p6a <- ggplot(wa, aes(ari, metoda)) +
  geom_col(fill = c(kol[["bic"]], kol[["dane"]], kol[["dane"]]), width = 0.6) +
  geom_text(aes(label = sub("^0", "", sprintf("%.2f", ari))), hjust = -0.2, size = 4) +
  scale_x_continuous(limits = c(0, 1), breaks = seq(0, 1, .25), labels = function(x) sub("^0", "", x)) +
  labs(x = "Zgodność z klasami ukrytymi w danych (ARI)", y = NULL,
       title = "A. Kto odnalazł ukryte klasy", subtitle = "Skorygowany indeks Randa; 1 = pełna zgodność") + motyw
p6b <- ggplot(starty, aes(roznica, klasy)) +
  geom_point(position = position_jitter(width = 0, height = 0.15, seed = 603), size = 2.4, alpha = 0.6,
             colour = kol[["aic"]], shape = 16) +
  geom_vline(xintercept = 0, colour = kol[["ciemny"]]) +
  labs(x = "Ile logL brakuje do najlepszego startu", y = NULL,
       title = "B. 40 startów algorytmu EM", subtitle = "0 = najlepszy wynik; dalej = gorsze") + motyw
p6 <- p6a + p6b
p6   # ggsave("lca-kmeans-starty.svg", p6, width = 10, height = 4.8)
Wynik w R
    2     3     4     5     6
0.199 0.215 0.230 0.231 0.240
  k_wg_sylwetki           LCA_4        kmeans_4 kmeans_sylwetka LCA_vs_kmeans_4
          6.000           0.556           0.522           0.405           0.712
[1] 113
    klasy roznica.w_maks roznica.maks_roznica
1 4 klasy          40.00                 0.00
2  5 klas          13.00                 2.64
        logL_m4 logL_nowy_start
       -4341.28        -4341.28
                    [,1]  [,2]  [,3]  [,4]
udzialy_m4         0.370 0.176 0.231 0.224
udzialy_nowy_start 0.176 0.370 0.231 0.224
   nowy_start
m4    1   2   3   4
  1   0 385   0   0
  2 178   0   0   0
  3   0   0 226   0
  4   0   0   0 211
7. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("pomarańczowy – niebieski (okazje / marka; AIC / BIC)" = c("#E69F00", "#0072B2"),
             "pomarańczowy – zielony (okazje / skład)" = c("#E69F00", "#009E73"),
             "pomarańczowy – grafit (okazje / sieć)" = c("#E69F00", "#262626"),
             "niebieski – zielony (marka / skład)" = c("#0072B2", "#009E73"),
             "niebieski – grafit (marka / sieć)" = c("#0072B2", "#262626"),
             "zielony – grafit (skład / sieć)" = c("#009E73", "#262626"),
             "niebieski – cynober (BIC / AIC)" = c("#0072B2", "#D55E00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                     widzenie_typowe
pomarańczowy – niebieski (okazje / marka; AIC / BIC)           120.2
pomarańczowy – zielony (okazje / skład)                         88.7
pomarańczowy – grafit (okazje / sieć)                           94.5
niebieski – zielony (marka / skład)                             70.1
niebieski – grafit (marka / sieć)                               51.7
zielony – grafit (skład / sieć)                                 63.8
niebieski – cynober (BIC / AIC)                                114.6
czerwony – zielony (do unikania)                               121.7
                                                     deuteranopia protanopia
pomarańczowy – niebieski (okazje / marka; AIC / BIC)        121.5      109.3
pomarańczowy – zielony (okazje / skład)                      66.3       51.5
pomarańczowy – grafit (okazje / sieć)                        93.4       86.8
niebieski – zielony (marka / skład)                          55.4       58.0
niebieski – grafit (marka / sieć)                            53.3       51.3
zielony – grafit (skład / sieć)                              41.7       49.0
niebieski – cynober (BIC / AIC)                             108.3       91.9
czerwony – zielony (do unikania)                             21.1       31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Modele klas latentnych oszacowano pakietem poLCA, regresję „przypisz i licz” – funkcją multinom() z pakietu nnet, metodę k-średnich – funkcją kmeans() (pakiet stats), sylwetkę – pakietem cluster, a skorygowany indeks Randa – funkcją adjustedRandIndex() z pakietu mclust. Rysunki wykonano w ggplot2 z pakietem scales, panele złożono pakietem patchwork i zapisano pakietem svglite; paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- poLCA (wersja 1.6.0.2): Linzer, D. A., & Lewis, J. B. (2011). poLCA: An R package for polytomous variable latent class analysis. Journal of Statistical Software, 42(10), 1–29. https://doi.org/10.18637/jss.v042.i10
- nnet (wersja 7.3.20): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- cluster (wersja 2.1.8.2): Maechler, M., Rousseeuw, P., Struyf, A., Hubert, M., & Hornik, K. (2026). cluster: Cluster analysis basics and extensions (R package version 2.1.8.2) [Computer software]. https://CRAN.R-project.org/package=cluster
- mclust (wersja 6.1.2): Scrucca, L., Fraley, C., Murphy, T. B., & Raftery, A. E. (2023). Model-based clustering, classification, and density estimation using mclust in R. Chapman and Hall/CRC. https://doi.org/10.1201/9781003277965
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- scales (wersja 1.4.0): Wickham, H., Pedersen, T. L., & Seidel, D. (2025). scales: Scale functions for visualization [R package]. https://doi.org/10.32614/CRAN.package.scales
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym różni się analiza klas latentnych od analizy skupień w segmentacji klientów?
Analiza klas latentnych jest modelem statystycznym dla odpowiedzi kategorialnych: daje każdej osobie prawdopodobieństwo przynależności do każdej klasy, a liczbę klas wybiera się kryteriami takimi jak BIC. Metoda k-średnich dzieli osoby sztywno i zakłada zmienne ciągłe. W przykładzie z ankietą drogerii przy czterech grupach obie metody odtworzyły ukryte klasy podobnie (ARI .56 i .52), ale sylwetka wskazała dla k-średnich sześć skupień, a BIC dla LCA – właściwe cztery.
Co oznacza niska entropia w analizie klas latentnych?
Że klasy częściowo na siebie zachodzą i przypisanie części osób jest niepewne. Model może być mimo to dobry. W przykładzie entropia wyniosła .69: 22.0% klientów miało największe prawdopodobieństwo przynależności poniżej .70, a wśród nich przypisana klasa zgadzała się z prawdziwą tylko w 48.6%. Entropia nie służy do wyboru liczby klas.
Ile osób potrzeba do segmentacji klientów analizą klas latentnych?
Nie ma jednej reguły. W symulacjach segmentacji opartej na danych wystarczała próba równa 70-krotności liczby zmiennych (Dolnicar i in., 2014), czyli 490 osób przy siedmiu pytaniach. Planuj próbę z myślą o najmniejszej spodziewanej klasie – jej profil jest szacowany najmniej dokładnie.
Jak sprawdzić, czy wiek wiąże się z przynależnością do klasy latentnej?
Wprowadź wiek do modelu jako zmienną towarzyszącą (w pakiecie poLCA formuła ~ wiek) i porównaj model z wiekiem i bez niego testem ilorazu wiarygodności. Nie licz regresji na przypisanych klasach: w przykładzie zaniżyła ona nachylenie dla jednej klasy z −0.787 do −0.478 na dekadę.
Dlaczego klasy w poLCA mają inną kolejność przy każdym uruchomieniu?
Bo numer klasy zależy od losowych wartości startowych – to tzw. zamiana etykiet. Dwa starty mogą dać identyczny logarytm wiarygodności i te same klasy w innej kolejności. Nazywaj klasy po profilu (np. klasa z najwyższym prawdopodobieństwem wskazania ceny), a nie po numerze, a do kolejnych modeli podawaj wartości startowe z wybranego rozwiązania.
Powiązane hasła
Przeczytaj też
Analiza klas latentnych (LCA) krok po kroku
Wiele startów EM, BIC i BLRT, lokalna niezależność, profile i entropia, poprawka BCH dla zmiennych zewnętrznych i opis APA – z kodem R.
Czytaj →PoradnikAnaliza skupień w marketingu – segmentacja klientów
Księgarnia internetowa, 1500 klientów i RFM: przekształcenia, liczba segmentów, mapa PCA, karty segmentów z działaniami i stabilność – sześć rysunków z kodem R.
Czytaj →PoradnikAnaliza koszykowa i rekomendacje
Wsparcie, ufność i lift na przykładzie sklepu z kawą, sieć reguł, test na nowych paragonach i rekomendacje „klienci kupili też” z kodem R.
Czytaj →PoradnikStatystyka w pracy z marketingu
Skala postaw wobec marki, NPS z przedziałem ufności, test A/B, intencja zakupu, mediacja i segmentacja: testy, zdania APA, dane XLSX i kod R.
Czytaj →Segmentujesz klientów w pracy z marketingu?
Pomożemy przygotować pytania do ankiety, oszacować i wybrać model klas latentnych, nazwać segmenty i opisać wyniki z tabelą i rysunkami – tak, żebyś umiał(a) je wyjaśnić na obronie.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Dolnicar, S., Grün, B., Leisch, F., & Schmidt, K. (2014). Required sample sizes for data-driven market segmentation analyses in tourism. Journal of Travel Research, 53(3), 296–306. https://doi.org/10.1177/0047287513496475 ● Otwarty dostęp
- Linzer, D. A., & Lewis, J. B. (2011). poLCA: An R package for polytomous variable latent class analysis. Journal of Statistical Software, 42(10). https://doi.org/10.18637/jss.v042.i10 ● Otwarty dostęp
- Nylund, K. L., Asparouhov, T., & Muthén, B. O. (2007). Deciding on the number of classes in latent class analysis and growth mixture modeling: A Monte Carlo simulation study. Structural Equation Modeling: A Multidisciplinary Journal, 14(4), 535–569. https://doi.org/10.1080/10705510701575396
- Sinha, P., Calfee, C. S., & Delucchi, K. L. (2021). Practitioner’s guide to latent class analysis: Methodological considerations and common pitfalls. Critical Care Medicine, 49(1), e63–e79. https://doi.org/10.1097/ccm.0000000000004710 ● Otwarty dostęp: pełny tekst
- Vermunt, J. K. (2010). Latent class modeling with covariates: Two improved three-step approaches. Political Analysis, 18(4), 450–469. https://doi.org/10.1093/pan/mpq025
- Weller, B. E., Bowen, N. K., & Faubert, S. J. (2020). Latent class analysis: A guide to best practice. Journal of Black Psychology, 46(4), 287–311. https://doi.org/10.1177/0095798420930932 ● Otwarty dostęp
Cytowania BibTeX
@article{dolnicar2014required, author={Dolnicar, Sara and Grün, Bettina and Leisch, Friedrich and Schmidt, Kathrin}, title={{Required sample sizes for data-driven market segmentation analyses in tourism}}, journal={Journal of Travel Research}, year={2014}, volume={53}, number={3}, pages={296--306}, doi={10.1177/0047287513496475}}@article{linzer2011polca, author={Linzer, Drew A. and Lewis, Jeffrey B.}, title={{poLCA: An R package for polytomous variable latent class analysis}}, journal={Journal of Statistical Software}, year={2011}, volume={42}, number={10}, doi={10.18637/jss.v042.i10}}@article{nylund2007deciding, author={Nylund, Karen L. and Asparouhov, Tihomir and Muthén, Bengt O.}, title={{Deciding on the number of classes in latent class analysis and growth mixture modeling: A Monte Carlo simulation study}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2007}, volume={14}, number={4}, pages={535--569}, doi={10.1080/10705510701575396}}@article{sinha2021practitioner, author={Sinha, Pratik and Calfee, Carolyn S. and Delucchi, Kevin L.}, title={{Practitioner’s guide to latent class analysis: Methodological considerations and common pitfalls}}, journal={Critical Care Medicine}, year={2021}, volume={49}, number={1}, pages={e63--e79}, doi={10.1097/ccm.0000000000004710}}@article{vermunt2010latent, author={Vermunt, Jeroen K.}, title={{Latent class modeling with covariates: Two improved three-step approaches}}, journal={Political Analysis}, year={2010}, volume={18}, number={4}, pages={450--469}, doi={10.1093/pan/mpq025}}@article{weller2020latent, author={Weller, Bridget E. and Bowen, Natasha K. and Faubert, Sarah J.}, title={{Latent class analysis: A guide to best practice}}, journal={Journal of Black Psychology}, year={2020}, volume={46}, number={4}, pages={287--311}, doi={10.1177/0095798420930932}}