Przykład: sklep z kawą i pytanie „co dołożyć do koszyka?”
Fikcyjny sklep internetowy sprzedaje 20 produktów: kawę, sprzęt do parzenia, syropy, herbatę i drobiazgi. Ma 3956 paragonów od 1400 klientów. Dział marketingu pyta: które produkty kupuje się razem i co pokazać klientowi w ramce „klienci, którzy kupili X, kupili też…”? Odpowiedzią są analiza koszykowa (reguły asocjacyjne) i prosty system rekomendacyjny. Segmentację klientów opisują wpisy analiza skupień w marketingu i analiza klas latentnych w marketingu, a inne typowe projekty – wpis statystyka w pracy z marketingu.
Dane są fikcyjne, więc wiemy, co w nich ukryliśmy. Ręcznie ustaliliśmy: trzy powiązania (kto kupił drip ceramiczny, dokłada filtry papierowe z prawdopodobieństwem .75; spieniacz do mleka → syrop waniliowy: .50; młynek ręczny → kawa Etiopia: .45), promocję „czekolada + cantuccini taniej” na 10% paragonów (zestaw trafia tam do koszyka z prawdopodobieństwem .6) i jeden bardzo popularny produkt – mieszankę domową, kupowaną niezależnie od reszty. Klienci mają też cztery „gusty” (przelew, kawa z mlekiem, kawiarka, herbata): produkty ze swojego gustu kupują 6 razy częściej. Mnożnik podnieśliśmy z 4 po pierwszym uruchomieniu, bo przy słabszych gustach rekomendacje nie różniły się od listy bestsellerów. Ziarno 604 ustalono raz i nie zmieniano go. Ostatni paragon klientów z co najmniej dwoma zakupami (1166) to zbiór testowy; na pozostałych 2790 uczymy reguły i rekomendacje. Dane pobierzesz jako analiza-koszykowa-paragony.csv (wiersz = paragon, kolumny 0/1 = produkty).
Rysunek 1: co ludzie kupują
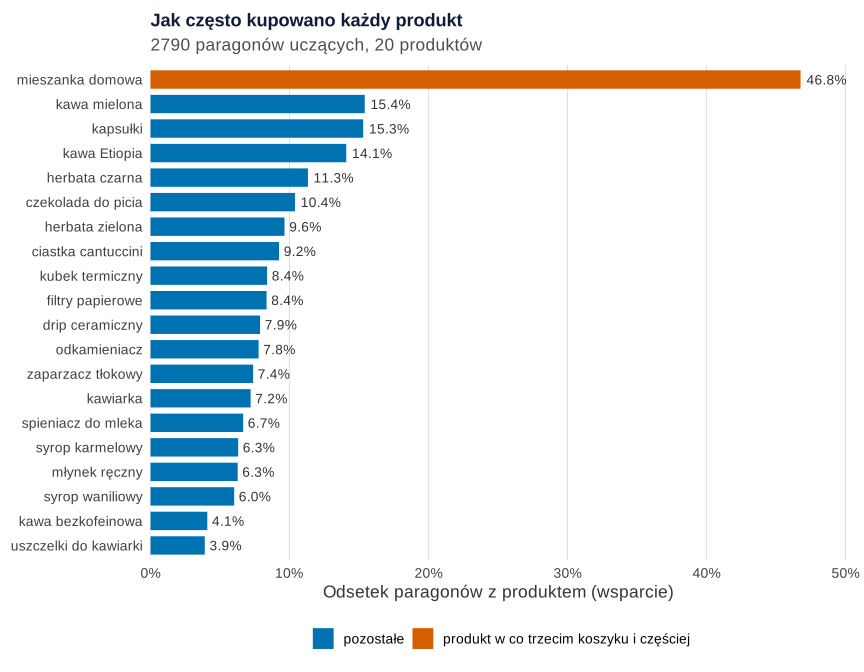
set.seed(604)).Co widać. Mieszanka domowa jest w 46.8% paragonów. Kolejna kawa mielona – w 15.4%, a uszczelki do kawiarki tylko w 3.9%. Odsetek paragonów z produktem to jego wsparcie (ang. support). Średnio paragon ma 2.14 produktu.
Jak może zmylić. Popularność mówi, co się sprzedaje, a nie co z czym. Produkt z co drugiego koszyka pojawi się „razem” z każdym innym.
Podpis do pracy:
Zdanie do Wyników:
Wsparcie, ufność i lift na jednym rachunku
Reguła asocjacyjna ma postać A → B: „kto kupił A, kupił też B” (Agrawal i in., 1993). Weźmy drip ceramiczny i filtry papierowe. Wystarczy tabela krzyżowa 2 × 2 z paragonów uczących:
| Paragony | kupił filtry | bez filtrów | razem |
|---|---|---|---|
| kupił drip | 155 | 65 | 220 |
| bez dripu | 78 | 2492 | 2570 |
| razem | 233 | 2557 | 2790 |
- Wsparcie reguły = paragony z A i B / wszystkie: 155 / 2790 = 5.6%. Mówi, jak częsta jest para.
- Ufność = paragony z A i B / paragony z A: 155 / 220 = 70.5% kupujących drip wzięło filtry.
- Lift porównuje ufność z tym, jak często filtry kupuje się w ogóle (233 / 2790 = 8.4%):
Kupujący drip biorą filtry 8.44 razy częściej niż przeciętny klient. Lift = 1 oznacza brak związku (para pojawia się tak często, jak przy niezależnych zakupach), lift < 1 – produkty „odpychają się”. Lift jest symetryczny: lift(A → B) = lift(B → A), a ufność nie. To ta sama idea co na wykresie lift dla modeli predykcyjnych: iloraz względem wyboru losowego.
Rysunek 2: mapa liftu
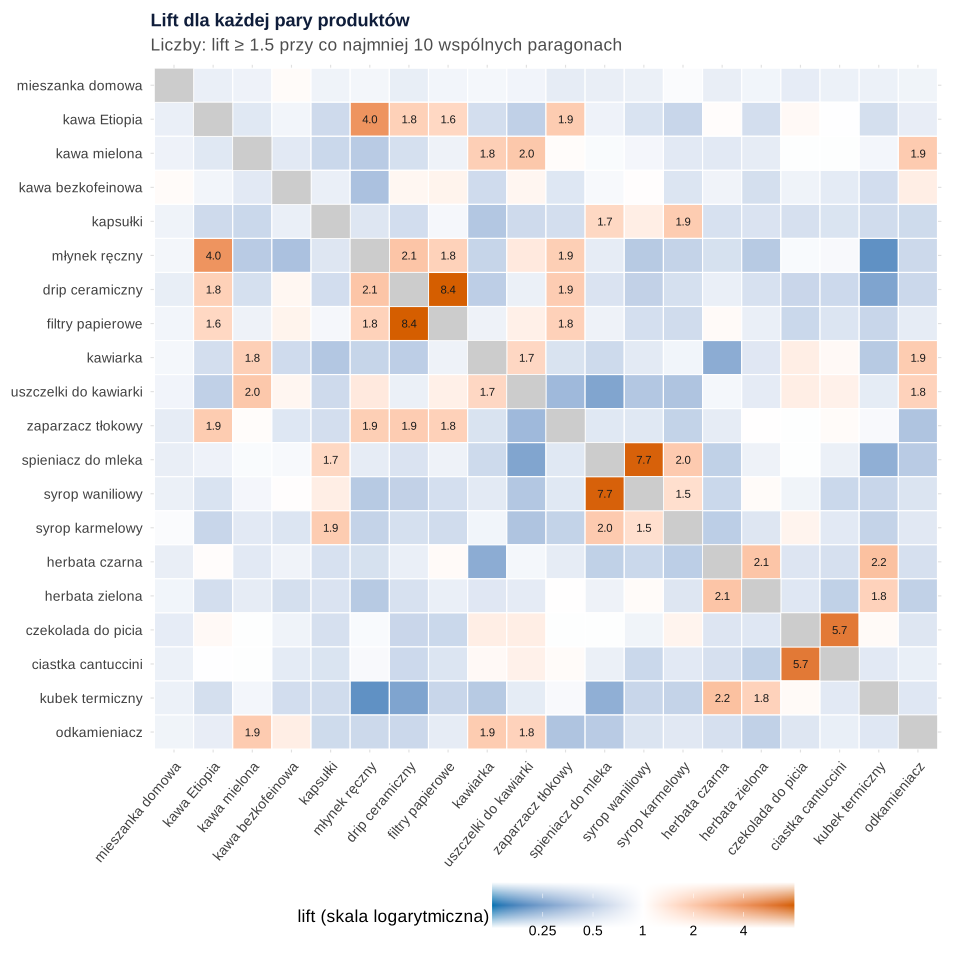
Co widać. Pomarańczowe kratki – lift > 1, niebieskie – lift < 1. Wyróżniają się trzy ukryte powiązania (drip–filtry 8.4, spieniacz–syrop waniliowy 7.7, młynek–Etiopia 4.0) i promocja (czekolada–cantuccini 5.7). Słabsze pomarańczowe pola (lift ok. 1.6–2.2) układają się w „gusty”: herbata czarna z zieloną i kubkiem termicznym, kawa mielona z kawiarką, uszczelkami i odkamieniaczem. Wiersz mieszanki domowej jest biały lub jasnoniebieski.
Jak może zmylić. Mapa nie pokazuje liczebności: para kupiona razem 5 razy może mieć lift 3 przypadkiem. Dlatego liczby wpisaliśmy tylko przy co najmniej 10 wspólnych paragonach.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: reguły na wykresie wsparcie × ufność
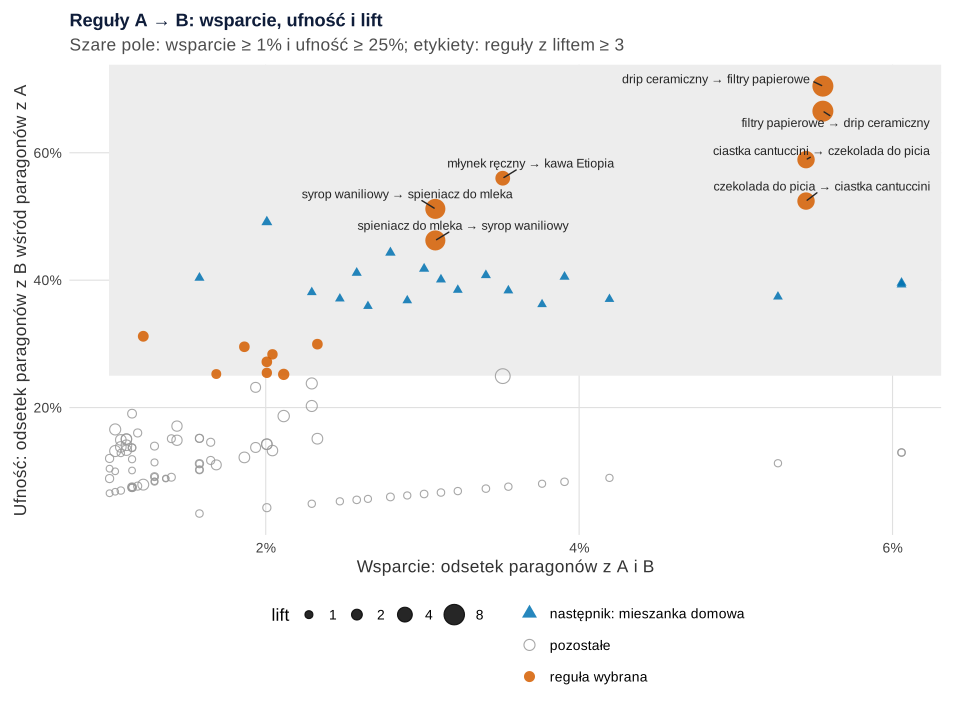
Co widać. Z 20 produktów powstaje 380 reguł A → B. W 114 para pojawia się w co najmniej 1% paragonów. Przyjęliśmy progi: wsparcie ≥ 1%, ufność ≥ 25% i lift ≥ 1.5. Spełnia je 15 reguł (pomarańczowe koła), z liftem od 1.65 do 8.44. Najwyżej leżą reguły z ukrytymi powiązaniami.
Jak może zmylić: pułapka popularnego produktu. Niebieskie trójkąty to reguły „X → mieszanka domowa”. Mają ufność od 35.9% do 49.1% – wyższą niż 8 z 15 wybranych reguł. Lift wynosi jednak od 0.77 do 1.05: klienci kupujący X biorą mieszankę tak samo często jak wszyscy. Sortowanie reguł po samej ufności wyrzuciłoby na górę listy bestseller.
Podpis do pracy:
Zdanie do Wyników:
Wiele reguł to wiele porównań: sprawdzenie na paragonach testowych
Wśród setek reguł zawsze kilka ma wysoki lift przypadkiem. Webb (2007) pokazał, że standardowe metody znajdują liczne fałszywe wzorce nawet w danych losowych, i zaproponował kontrolę błędu I rodzaju dla całego przeszukiwania – to problem wielokrotnych porównań. Najprostsza obrona to podział danych, jak przy walidacji krzyżowej: szukasz na paragonach uczących, sprawdzasz na testowych.
Przy celowo luźnych progach (wsparcie ≥ 0.5%, lift ≥ 1.2) dostaliśmy 54 reguły, czyli 27 par. Każdą sprawdziliśmy na 1166 paragonach testowych jednostronnym testem dokładnym Fishera z poprawką Holma. Utrzymało się 16 par:
| Co naprawdę było w danych | Par znalezionych | Utrzymało się w teście |
|---|---|---|
| ukryte powiązanie lub promocja | 4 | 4 |
| wspólny gust klientów | 16 | 11 |
| brak bezpośredniego związku | 7 | 1 |
Wszystkie cztery prawdziwe powiązania przeszły test z liftem podobnym jak w danych uczących (np. drip–filtry: 8.44 i 7.75). Odpadło 6 z 7 par bez bezpośredniego związku (np. czekolada–kawiarka: lift 1.24, w teście 0.97). Odpadło też 5 słabszych par z gustów – przy kilkunastu wspólnych paragonach test ma małą moc. Jedyna przepuszczona para „bez związku” (filtry–Etiopia) łączy się pośrednio, przez drip.
Rysunek 4: sieć reguł
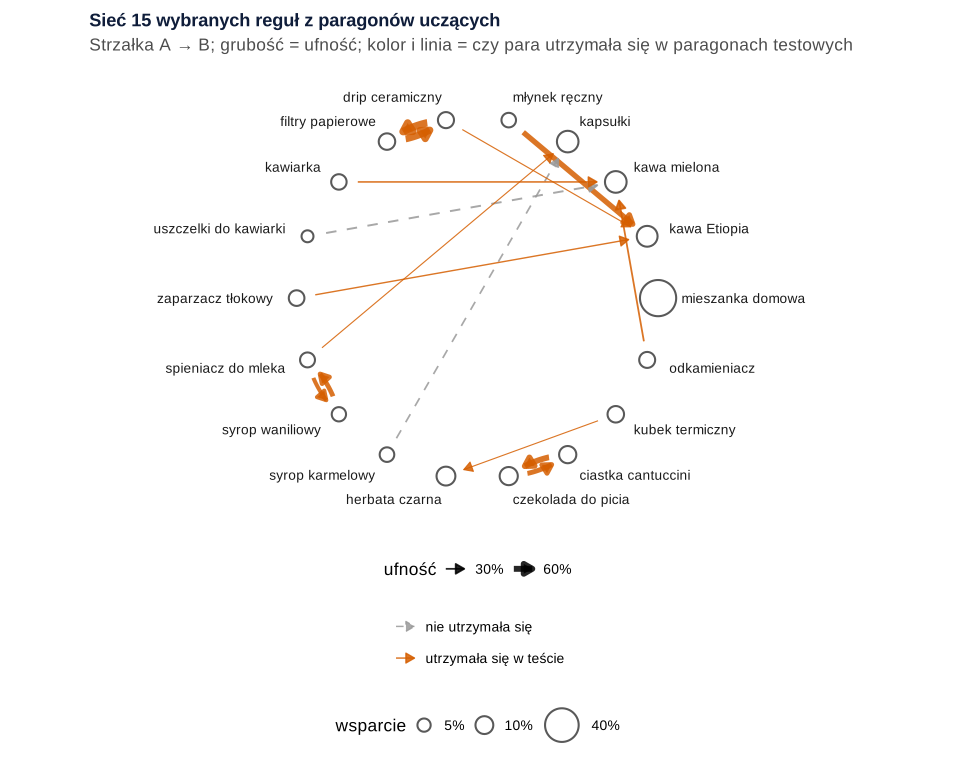
Co widać. 15 wybranych reguł jako strzałki między 18 produktami. Grube strzałki w obie strony łączą drip z filtrami, spieniacz z syropem waniliowym i czekoladę z cantuccini. Kawa Etiopia i kawa mielona przyciągają po kilka strzałek – to „produkty-centra” swoich gustów. Szare przerywane strzałki to 2 reguły, których para nie utrzymała się w teście (uszczelki → kawa mielona, syrop karmelowy → kapsułki). Mieszanka domowa ma największe koło i ani jednej strzałki.
Jak może zmylić. Strzałka nie oznacza przyczyny: czekolada i cantuccini są połączone, bo sklep sprzedawał je w promocji. Położenie węzłów na okręgu nic nie znaczy.
Podpis do pracy:
Zdanie do Wyników:
Od reguł do „klienci, którzy kupili X, kupili też Y”
Reguły opisują jeden koszyk, rekomendacja – całą historię klienta. Budujemy macierz klient × produkt (1 = klient kupił produkt choć raz) i dla każdej pary produktów liczymy podobieństwo cosinusowe:
Cosinus = 0: brak wspólnych klientów; 1: dokładnie ci sami klienci. To filtrowanie oparte na produktach (ang. item-based collaborative filtering): najpierw związki między produktami z macierzy klient × produkt, potem rekomendacje (Sarwar i in., 2001). Najbardziej podobne do dripu są filtry (0.718), kawa Etiopia (0.320), mieszanka domowa (0.304) i młynek ręczny (0.298). Wynik produktu dla klienta to suma jego podobieństw do produktów, które klient już ma. Lista „top-3” to trzy najwyższe wyniki z pominięciem produktów już kupionych.
Rysunek 5: rekomendacja krok po kroku dla jednej klientki
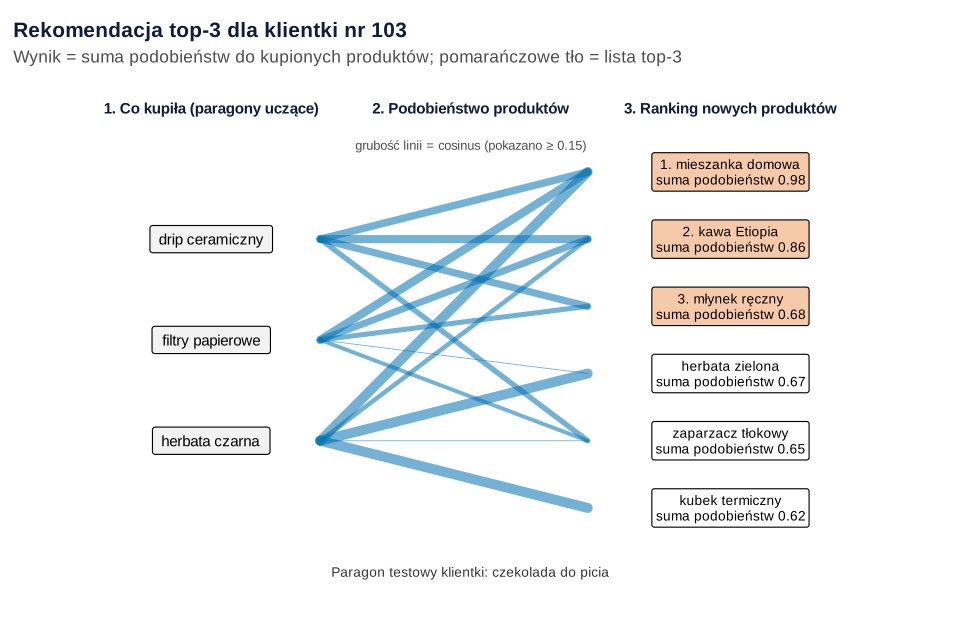
Co widać. Klientka nr 103 (pierwsza w danych, która w paragonach uczących kupiła dokładnie 3 produkty, w tym drip) ma w historii drip, filtry i herbatę czarną. Najwyższe sumy podobieństw mają mieszanka domowa (0.98), kawa Etiopia (0.86) i młynek ręczny (0.68). Tuż za listą jest herbata zielona (0.67). W paragonie testowym kupiła jednak czekoladę do picia – lista nie trafiła.
Jak może zmylić. Jeden przykład niczego nie dowodzi – dlatego kryterium wyboru klientki podajemy z góry. Widać też drugi problem: mieszanka domowa jest pierwsza, bo kupuje ją prawie każdy. To rekomendacja oczywista.
Podpis do pracy:
Zdanie do Metody:
Rysunek 6: czy rekomendacje trafiają?
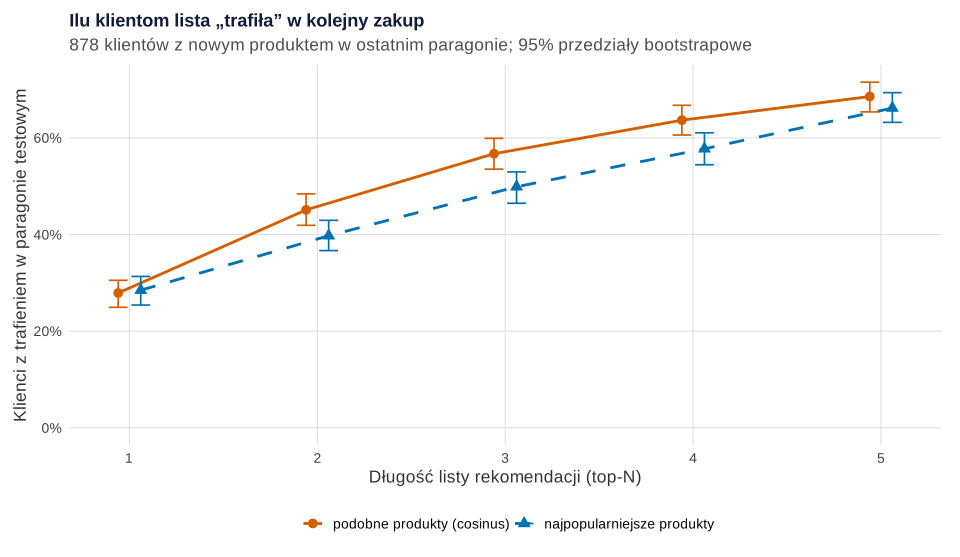
set.seed(604)).Oceniamy 878 klientów, których ostatni paragon zawierał produkt dla nich nowy. „Trafienie” = co najmniej jeden produkt z listy top-N w tym paragonie. Punkt odniesienia: najpopularniejsze produkty, których klient jeszcze nie ma. Przy zadaniu „top-N” liczy się trafność krótkiej listy, a nie błąd przewidywanych ocen (Cremonesi i in., 2010), a ocena systemu zaczyna się od decyzji, jakie zadanie użytkownika sprawdzamy i jaką miarą (Herlocker i in., 2004). Inne miary list top-N to precyzja i czułość, znane z krzywej precyzja–czułość.
Co widać. Przy top-3 lista z podobieństw trafiła u 56.7% klientów (95% przedział bootstrapowy z 1000 prób [53.5, 59.9]), lista bestsellerów u 49.9% [46.5, 53.0]. Różnica: 6.8 punktu procentowego, 95% CI [4.0, 9.9]. Przy top-1 metody się nie różnią (27.9% i 28.5%). Mieszanka domowa trafiła do top-3 z podobieństw u wszystkich 342 ocenianych klientów, którzy jej jeszcze nie kupili.
Jak może zmylić. Trafienie to nie zakup wywołany rekomendacją – klient mógł kupić produkt i tak. Porównuj metody przy tym samym N. Ile sprzedaży naprawdę dodaje ramka, rozstrzyga dopiero eksperyment.
Podpis do pracy:
Zdanie do Wyników:
Co z tym zrobić w marketingu
- Drip → filtry, spieniacz → syrop: ramka „dokup” w koszyku albo zestaw startowy.
- Młynek → kawa Etiopia: e-mail po zakupie młynka z kawą ziarnistą single origin.
- Czekolada + cantuccini: to efekt promocji, nie odkryta preferencja. Sprawdź parę poza promocją (kolumna
promocja). - Mieszanka domowa: nie polecaj jej – i tak trafia do co drugiego koszyka. Usuń ją z ramki.
- Nowi klienci bez historii (zimny start): bestsellery albo produkty podobne opisem, np. sposobem parzenia (filtrowanie oparte na treści).
- Ostateczna ocena to test A/B: połowa klientów widzi ramkę, połowa nie. Kontrolowany eksperyment najlepiej ustala, czy zmiana wpływa na zachowanie użytkowników (Kohavi i in., 2009). Plan i liczebność opisuje wpis test A/B – plan i analiza.
Jak opisać w pracy
W Metodzie podaj liczbę paragonów i produktów, progi wsparcia, ufności i liftu (z uzasadnieniem), sposób podziału na zbiór uczący i testowy oraz test potwierdzający. Gdy produktów jest setki, a reguły mają po kilka produktów po lewej stronie, użyj algorytmu Apriori, np. z pakietu R arules (Hahsler i in., 2005). Dla 20 produktów wystarczy bazowy R.
Tabela reguł: reguła, liczba paragonów z A i B, wsparcie, ufność, lift w zbiorze uczącym i testowym. W Ograniczeniach napisz, że reguły opisują współwystępowanie, a nie przyczyny zakupu. Gdy praca łączy reguły z segmentacją, zajrzyj do hasła analiza skupień.
Kod R: reguły i rekomendacje w bazowym R
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, z których korzystają kolejne. Reguły i podobieństwa liczy bazowy R (crossprod(), rowsum(), fisher.test(), p.adjust()) – bez pakietów do analizy koszykowej. Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują tylko przepisy 1 (dane) i 6 (bootstrap); oba zaczynają się od własnego set.seed(604). Etykiety na rysunku 3 rozsuwa ggrepel z seed = 604. Ziarno 604 ustalono raz i nie zmieniano go. Ręcznie ustalono: 1400 klientów, liczbę paragonów klienta 1 + Poisson(1.8), prawdopodobieństwa bazowe produktów, udziały gustów (.2, .2, .15, .15 i .3 bez gustu), mnożnik gustu 6 (podniesiony z 4 po pierwszym uruchomieniu), trzy ukryte powiązania (.75, .50, .45), promocję na 10% paragonów z zestawem w 60% z nich oraz progi reguł (1%, 25%, 1.5; w sprawdzeniu 0.5% i 1.2). Całość liczy się w kilka sekund.
1. Paleta, dane i popularność: Rysunek 1
R
# Rysunek 1. Fikcyjny sklep internetowy z kawą: paragony, produkty i ich popularność (dane symulowane)
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         fiolet = "#CC79A7", szary = "grey60", ciemny = "grey20")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# 20 produktów w kolejności katalogu sklepu: kod (do pliku CSV), nazwa, prawdopodobieństwo bazowe w paragonie
produkty <- data.frame(
  kod = c("mieszanka_domowa", "kawa_etiopia", "kawa_mielona", "kawa_bezkofeinowa", "kapsulki",
          "mlynek_reczny", "drip_ceramiczny", "filtry_papierowe", "kawiarka", "uszczelki_kawiarka",
          "zaparzacz_tlokowy", "spieniacz_mleka", "syrop_waniliowy", "syrop_karmelowy", "herbata_czarna",
          "herbata_zielona", "czekolada_do_picia", "ciastka_cantuccini", "kubek_termiczny", "odkamieniacz"),
  nazwa = c("mieszanka domowa", "kawa Etiopia", "kawa mielona", "kawa bezkofeinowa", "kapsułki",
            "młynek ręczny", "drip ceramiczny", "filtry papierowe", "kawiarka", "uszczelki do kawiarki",
            "zaparzacz tłokowy", "spieniacz do mleka", "syrop waniliowy", "syrop karmelowy", "herbata czarna",
            "herbata zielona", "czekolada do picia", "ciastka cantuccini", "kubek termiczny", "odkamieniacz"),
  p_bazowe = c(0.42, 0.06, 0.08, 0.04, 0.07, 0.03, 0.04, 0.03, 0.04, 0.02,
               0.03, 0.03, 0.03, 0.03, 0.06, 0.05, 0.04, 0.04, 0.05, 0.04))
# Cztery „gusty” klientów (ustalone ręcznie): produkty z gustu klienta kupuje on 6 razy częściej (najwyżej z p = .6)
gusty <- list(przelew = c("kawa_etiopia", "mlynek_reczny", "drip_ceramiczny", "zaparzacz_tlokowy"),
              mleko = c("kapsulki", "spieniacz_mleka", "syrop_karmelowy"),
              kawiarka = c("kawa_mielona", "kawiarka", "uszczelki_kawiarka", "odkamieniacz"),
              herbata = c("herbata_czarna", "herbata_zielona", "kubek_termiczny"))

set.seed(604)                                   # ziarno ustalone raz, bez dobierania pod wynik
n_klientow <- 1400
gust <- sample(c(names(gusty), "brak"), n_klientow, replace = TRUE, prob = c(.2, .2, .15, .15, .3))
n_paragonow <- 1 + rpois(n_klientow, 1.8)       # 1, 2, 3… paragony na klienta
klient <- rep(seq_len(n_klientow), n_paragonow)
kolejny <- sequence(n_paragonow)                # numer zakupu danego klienta
N <- length(klient)
X <- matrix(0L, N, nrow(produkty), dimnames = list(NULL, produkty$kod))
for (i in seq_len(N)) {
  p <- produkty$p_bazowe
  g <- gust[klient[i]]
  if (g != "brak") p[produkty$kod %in% gusty[[g]]] <- pmin(6 * p[produkty$kod %in% gusty[[g]]], 0.6)
  X[i, ] <- rbinom(nrow(produkty), 1, p)
}
# Ukryte powiązania (ustalone ręcznie): kto kupił A, ten z prawdopodobieństwem q dokłada B
dodaj <- function(X, a, b, q) { ma <- X[, a] == 1 & X[, b] == 0; X[ma, b] <- rbinom(sum(ma), 1, q); X }
X <- dodaj(X, "drip_ceramiczny", "filtry_papierowe", 0.75)
X <- dodaj(X, "spieniacz_mleka", "syrop_waniliowy", 0.50)
X <- dodaj(X, "mlynek_reczny", "kawa_etiopia", 0.45)
# Promocja zimowa „czekolada + cantuccini taniej o 20%” na 10% paragonów: tam zestaw trafia do koszyka z p = .6
promocja <- rbinom(N, 1, 0.10)
zestaw <- promocja == 1 & rbinom(N, 1, 0.6) == 1
X[zestaw, c("czekolada_do_picia", "ciastka_cantuccini")] <- 1L
puste <- which(rowSums(X) == 0)                 # pusty paragon: jeden produkt losowany wg popularności
for (i in puste) X[i, sample(ncol(X), 1, prob = produkty$p_bazowe)] <- 1L

# Podział: ostatni paragon klienta z co najmniej dwoma zakupami – testowy, wszystkie wcześniejsze – uczące
ostatni <- kolejny == n_paragonow[klient] & n_paragonow[klient] >= 2
zbior <- ifelse(ostatni, "testowy", "uczacy")
dane <- data.frame(paragon = seq_len(N), klient, zakup = kolejny, zbior, promocja, X)
write.csv(dane, "analiza-koszykowa-paragony.csv", row.names = FALSE)
c(klienci = n_klientow, paragony = N, uczace = sum(zbior == "uczacy"), testowe = sum(zbior == "testowy"),
  produkty_na_paragon = round(mean(rowSums(X)), 2))

# Popularność: odsetek paragonów z produktem (wsparcie pojedynczego produktu) w zbiorze uczącym
Xu <- X[zbior == "uczacy", ]
pop <- data.frame(nazwa = produkty$nazwa, wsparcie = colMeans(Xu))
pop <- pop[order(-pop$wsparcie), ]
pop$nazwa <- factor(pop$nazwa, levels = rev(pop$nazwa))
pop$typ <- ifelse(pop$wsparcie > 0.3, "produkt w co trzecim koszyku i częściej", "pozostałe")
print(transform(pop[, 1:2], wsparcie = round(wsparcie, 3)), row.names = FALSE)

p1 <- ggplot(pop, aes(wsparcie, nazwa, fill = typ)) +
  geom_col(width = 0.75) +
  geom_text(aes(label = sprintf("%.1f%%", 100 * wsparcie)), hjust = -0.15, size = 3.6, colour = "grey20") +
  scale_fill_manual(values = c("produkt w co trzecim koszyku i częściej" = kol[["cynober"]],
                               "pozostałe" = kol[["niebieski"]]), name = NULL) +
  scale_x_continuous(labels = scales::percent, limits = c(0, 0.5), expand = c(0, 0)) +
  labs(x = "Odsetek paragonów z produktem (wsparcie)", y = NULL,
       title = "Jak często kupowano każdy produkt",
       subtitle = sprintf("%d paragonów uczących, 20 produktów", nrow(Xu))) + motyw +
  theme(panel.grid.major.y = element_blank())
p1   # zapis: ggsave("analiza-koszykowa-popularnosc.svg", p1, width = 9, height = 7)
Wynik w R
            klienci            paragony              uczace             testowe
            1400.00             3956.00             2790.00             1166.00
produkty_na_paragon
               2.14
                 nazwa wsparcie
      mieszanka domowa    0.468
          kawa mielona    0.154
              kapsułki    0.153
          kawa Etiopia    0.141
        herbata czarna    0.113
    czekolada do picia    0.104
       herbata zielona    0.096
    ciastka cantuccini    0.092
       kubek termiczny    0.084
      filtry papierowe    0.084
       drip ceramiczny    0.079
          odkamieniacz    0.078
     zaparzacz tłokowy    0.074
              kawiarka    0.072
    spieniacz do mleka    0.067
       syrop karmelowy    0.063
         młynek ręczny    0.063
       syrop waniliowy    0.060
     kawa bezkofeinowa    0.041
 uszczelki do kawiarki    0.039
2. Wsparcie, ufność, lift i wybór reguł: Rysunki 2 i 3
R
# Rysunki 2 i 3. Wsparcie, ufność i lift z macierzy paragon × produkt (bazowy R: crossprod)
# Korzysta z obiektów przepisu 1: X, zbior, produkty, kol, motyw. Niczego nie losuje.
library(ggplot2)
library(ggrepel)

reguly_z <- function(M) {                       # wszystkie reguły A → B dla par produktów
  n <- nrow(M)
  W <- crossprod(M)                             # W[a, b] = liczba paragonów z A i B; przekątna = z A
  ile <- diag(W)
  r <- expand.grid(a = colnames(M), b = colnames(M), stringsAsFactors = FALSE)
  r <- r[r$a != r$b, ]
  r$n_ab <- W[cbind(r$a, r$b)]
  r$wsparcie <- r$n_ab / n                      # P(A i B)
  r$ufnosc <- r$n_ab / ile[r$a]                 # P(B | A)
  r$lift <- r$ufnosc / (ile[r$b] / n)           # P(B | A) / P(B)
  r
}
Xu <- X[zbior == "uczacy", ]
ru <- reguly_z(Xu)

# Jeden rachunek na liczbach: drip ceramiczny → filtry papierowe (tabela 2 × 2)
a <- Xu[, "drip_ceramiczny"]; b <- Xu[, "filtry_papierowe"]
table(drip = factor(a, 1:0, c("kupił drip", "bez dripu")), filtry = factor(b, 1:0, c("kupił filtry", "bez filtrów")))
r1 <- ru[ru$a == "drip_ceramiczny" & ru$b == "filtry_papierowe", ]
round(c(wsparcie = r1$wsparcie, ufnosc = r1$ufnosc, wsparcie_filtrow = mean(b), lift = r1$lift), 3)

# Pułapka popularnego produktu: reguły X → mieszanka domowa mają wysoką ufność, ale lift ≈ 1
md <- ru[ru$b == "mieszanka_domowa", ]
round(c(min_ufnosc = min(md$ufnosc), max_ufnosc = max(md$ufnosc), min_lift = min(md$lift), max_lift = max(md$lift)), 3)

# Wybór reguł: wsparcie ≥ 1%, ufność ≥ 25%, lift ≥ 1.5
wyb <- ru[ru$wsparcie >= 0.01 & ru$ufnosc >= 0.25 & ru$lift >= 1.5, ]
wyb <- wyb[order(-wyb$lift), ]
nazwy <- setNames(produkty$nazwa, produkty$kod)
wyb$regula <- paste(nazwy[wyb$a], "→", nazwy[wyb$b])
c(wszystkie_pary = nrow(ru), wsparcie_min_1proc = sum(ru$wsparcie >= 0.01), wybrane = nrow(wyb))
print(data.frame(regula = wyb$regula, n_ab = wyb$n_ab, wsparcie = round(wyb$wsparcie, 3),
                 ufnosc = round(wyb$ufnosc, 3), lift = round(wyb$lift, 2)), row.names = FALSE)

# Rysunek 2: mapa ciepła liftu (lift jest symetryczny: lift(A → B) = lift(B → A))
ru$A <- factor(nazwy[ru$a], levels = produkty$nazwa)
ru$B <- factor(nazwy[ru$b], levels = rev(produkty$nazwa))
p2 <- ggplot(ru, aes(A, B, fill = log2(lift))) +
  geom_tile(colour = "white", linewidth = 0.4) +
  geom_tile(data = data.frame(A = factor(produkty$nazwa, levels = produkty$nazwa),
                              B = factor(produkty$nazwa, levels = rev(produkty$nazwa))),
            aes(A, B), inherit.aes = FALSE, fill = "grey80", colour = "white") +       # przekątna
  geom_text(data = subset(ru, lift >= 1.5 & n_ab >= 10), aes(label = sprintf("%.1f", lift)), size = 3, colour = "grey10") +
  scale_fill_gradient2(low = kol[["niebieski"]], mid = "white", high = kol[["cynober"]], midpoint = 0,
                       limits = c(-3, 3), oob = scales::squish, breaks = -2:2, labels = c("0.25", "0.5", "1", "2", "4"),
                       name = "lift (skala logarytmiczna)") +
  labs(x = NULL, y = NULL, title = "Lift dla każdej pary produktów",
       subtitle = "Liczby: lift ≥ 1.5 przy co najmniej 10 wspólnych paragonach") + motyw +
  theme(axis.text.x = element_text(angle = 50, hjust = 1), panel.grid = element_blank(),
        legend.key.width = unit(1.6, "cm"))
p2   # zapis: ggsave("analiza-koszykowa-mapa-liftu.svg", p2, width = 10, height = 10)

# Rysunek 3: reguły na wykresie wsparcie × ufność (tylko pary z co najmniej 1% paragonów)
r3 <- subset(ru, wsparcie >= 0.01)
r3$rodzaj <- ifelse(r3$b == "mieszanka_domowa", "następnik: mieszanka domowa",
                    ifelse(r3$lift >= 1.5 & r3$ufnosc >= 0.25, "reguła wybrana", "pozostałe"))
r3$etykieta <- ifelse(r3$rodzaj == "reguła wybrana" & r3$lift >= 3, paste(nazwy[r3$a], "→", nazwy[r3$b]), "")
p3 <- ggplot(r3, aes(wsparcie, ufnosc)) +
  annotate("rect", xmin = 0.01, xmax = Inf, ymin = 0.25, ymax = Inf, fill = "grey93") +
  geom_point(aes(size = lift, colour = rodzaj, shape = rodzaj), alpha = 0.85) +
  geom_text_repel(aes(label = etykieta), size = 3.3, colour = "grey15", min.segment.length = 0,
                  box.padding = 0.5, max.overlaps = Inf, seed = 604) +
  scale_colour_manual(values = c("reguła wybrana" = kol[["cynober"]], "następnik: mieszanka domowa" = kol[["niebieski"]],
                                 "pozostałe" = kol[["szary"]]), name = NULL) +
  scale_shape_manual(values = c("reguła wybrana" = 16, "następnik: mieszanka domowa" = 17, "pozostałe" = 1), name = NULL) +
  scale_size_area(max_size = 7, breaks = c(1, 2, 4, 8), name = "lift") +
  scale_x_continuous(labels = scales::percent) + scale_y_continuous(labels = scales::percent) +
  guides(colour = guide_legend(ncol = 1, override.aes = list(size = 3.5)), shape = guide_legend(ncol = 1)) +
  labs(x = "Wsparcie: odsetek paragonów z A i B", y = "Ufność: odsetek paragonów z B wśród paragonów z A",
       title = "Reguły A → B: wsparcie, ufność i lift",
       subtitle = "Szare pole: wsparcie ≥ 1% i ufność ≥ 25%; etykiety: reguły z liftem ≥ 3") + motyw
p3   # zapis: ggsave("analiza-koszykowa-reguly-wsparcie-ufnosc.svg", p3, width = 10, height = 7.4)
Wynik w R
            filtry
drip         kupił filtry bez filtrów
  kupił drip          155          65
  bez dripu            78        2492
        wsparcie           ufnosc wsparcie_filtrow             lift
           0.056            0.705            0.084            8.436
min_ufnosc max_ufnosc   min_lift   max_lift
     0.359      0.491      0.768      1.050
    wszystkie_pary wsparcie_min_1proc            wybrane
               380                114                 15
                                  regula n_ab wsparcie ufnosc lift
      filtry papierowe → drip ceramiczny  155    0.056  0.665 8.44
      drip ceramiczny → filtry papierowe  155    0.056  0.705 8.44
    syrop waniliowy → spieniacz do mleka   86    0.031  0.512 7.68
    spieniacz do mleka → syrop waniliowy   86    0.031  0.462 7.68
 ciastka cantuccini → czekolada do picia  152    0.054  0.589 5.67
 czekolada do picia → ciastka cantuccini  152    0.054  0.524 5.67
            młynek ręczny → kawa Etiopia   98    0.035  0.560 3.98
        kubek termiczny → herbata czarna   59    0.021  0.252 2.23
    uszczelki do kawiarki → kawa mielona   34    0.012  0.312 2.02
             odkamieniacz → kawa mielona   65    0.023  0.300 1.94
              syrop karmelowy → kapsułki   52    0.019  0.295 1.93
        zaparzacz tłokowy → kawa Etiopia   56    0.020  0.272 1.93
                 kawiarka → kawa mielona   57    0.020  0.284 1.84
          drip ceramiczny → kawa Etiopia   56    0.020  0.255 1.81
           spieniacz do mleka → kapsułki   47    0.017  0.253 1.65
3. Sprawdzenie reguł na paragonach testowych: Tabela
R
# Tabela 1. Wiele reguł = wiele porównań: które pary utrzymały się na paragonach testowych?
# Korzysta z obiektów przepisów 1–2: X, zbior, ru, reguly_z, nazwy, gusty, produkty. Niczego nie losuje.
# Luźniejsze progi: wsparcie ≥ 0.5% (co najmniej 14 paragonów) i lift ≥ 1.2. Lift jest symetryczny,
# więc sprawdzamy pary produktów (każda para daje dwie reguły: A → B i B → A).
luzne <- subset(ru, wsparcie >= 0.005 & lift >= 1.2)
pary <- unique(t(apply(luzne[, c("a", "b")], 1, sort)))
pary <- data.frame(a = pary[, 1], b = pary[, 2])
c(reguly = nrow(luzne), pary = nrow(pary))

Xt <- X[zbior == "testowy", ]
rt <- reguly_z(Xt)
fisher_p <- function(M, a, b) {                 # jednostronny test dokładny Fishera: czy A i B współwystępują częściej?
  fisher.test(table(factor(M[, a], 0:1), factor(M[, b], 0:1)), alternative = "greater")$p.value
}
pary$lift_uczacy <- ru$lift[match(paste(pary$a, pary$b), paste(ru$a, ru$b))]
pary$n_ab_test <- rt$n_ab[match(paste(pary$a, pary$b), paste(rt$a, rt$b))]
pary$lift_test <- rt$lift[match(paste(pary$a, pary$b), paste(rt$a, rt$b))]
pary$p <- mapply(fisher_p, a = pary$a, b = pary$b, MoreArgs = list(M = Xt))
pary$p_holm <- p.adjust(pary$p, method = "holm")
pary$utrzymala <- pary$lift_test > 1 & pary$p_holm < .05

# Co naprawdę było w danych (wiemy, bo dane są fikcyjne)
ukryte <- c("drip_ceramiczny filtry_papierowe", "spieniacz_mleka syrop_waniliowy", "kawa_etiopia mlynek_reczny",
            "ciastka_cantuccini czekolada_do_picia")
gust_produktu <- sapply(produkty$kod, function(k) { g <- names(gusty)[sapply(gusty, function(s) k %in% s)]; if (length(g)) g else "-" })
pary$prawda <- ifelse(paste(pary$a, pary$b) %in% ukryte, "ukryte powiązanie",
                      ifelse(gust_produktu[pary$a] == gust_produktu[pary$b] & gust_produktu[pary$a] != "-",
                             "wspólny gust", "brak bezpośredniego związku"))
pary <- pary[order(-pary$lift_uczacy), ]
print(data.frame(para = paste(nazwy[pary$a], "–", nazwy[pary$b]), prawda = pary$prawda,
                 lift_uczacy = round(pary$lift_uczacy, 2), n_test = pary$n_ab_test, lift_test = round(pary$lift_test, 2),
                 p_holm = signif(pary$p_holm, 2), utrzymala = pary$utrzymala), row.names = FALSE)
table(prawda = pary$prawda, utrzymala = pary$utrzymala)
Wynik w R
reguly   pary
    54     27
                                       para                      prawda
         drip ceramiczny – filtry papierowe           ukryte powiązanie
       spieniacz do mleka – syrop waniliowy           ukryte powiązanie
    ciastka cantuccini – czekolada do picia           ukryte powiązanie
               kawa Etiopia – młynek ręczny           ukryte powiązanie
           herbata czarna – kubek termiczny                wspólny gust
            drip ceramiczny – młynek ręczny                wspólny gust
           herbata czarna – herbata zielona                wspólny gust
       kawa mielona – uszczelki do kawiarki                wspólny gust
       spieniacz do mleka – syrop karmelowy                wspólny gust
                kawa mielona – odkamieniacz                wspólny gust
                 kapsułki – syrop karmelowy                wspólny gust
           kawa Etiopia – zaparzacz tłokowy                wspólny gust
                    kawiarka – odkamieniacz                wspólny gust
        drip ceramiczny – zaparzacz tłokowy                wspólny gust
          młynek ręczny – zaparzacz tłokowy                wspólny gust
                    kawa mielona – kawiarka                wspólny gust
             drip ceramiczny – kawa Etiopia                wspólny gust
       filtry papierowe – zaparzacz tłokowy brak bezpośredniego związku
           filtry papierowe – młynek ręczny brak bezpośredniego związku
          herbata zielona – kubek termiczny                wspólny gust
       odkamieniacz – uszczelki do kawiarki                wspólny gust
              kapsułki – spieniacz do mleka                wspólny gust
            filtry papierowe – kawa Etiopia brak bezpośredniego związku
          syrop karmelowy – syrop waniliowy brak bezpośredniego związku
                 kapsułki – syrop waniliowy brak bezpośredniego związku
              czekolada do picia – kawiarka brak bezpośredniego związku
 czekolada do picia – uszczelki do kawiarki brak bezpośredniego związku
 lift_uczacy n_test lift_test  p_holm utrzymala
        8.44     76      7.75 9.6e-67      TRUE
        7.68     42      9.28 3.2e-36      TRUE
        5.67     85      5.06 2.5e-52      TRUE
        3.98     35      3.62 6.1e-13      TRUE
        2.23     27      2.32 1.6e-04      TRUE
        2.10     13      2.30 3.2e-02      TRUE
        2.10     32      2.60 9.2e-07      TRUE
        2.02     12      2.03 9.5e-02     FALSE
        1.96      8      1.77 4.5e-01     FALSE
        1.94     27      1.83 9.6e-03      TRUE
        1.93     17      1.64 2.0e-01     FALSE
        1.93     28      2.02 1.5e-03      TRUE
        1.92     16      2.36 1.0e-02      TRUE
        1.91     17      2.09 2.4e-02      TRUE
        1.86     11      2.18 9.5e-02     FALSE
        1.84     27      1.87 6.7e-03      TRUE
        1.81     28      1.80 1.0e-02      TRUE
        1.80     15      1.71 2.0e-01     FALSE
        1.78      8      1.31 1.0e+00     FALSE
        1.77     21      2.22 3.7e-03      TRUE
        1.77      5      1.80 6.9e-01     FALSE
        1.65     19      2.22 6.5e-03      TRUE
        1.65     28      1.67 3.0e-02      TRUE
        1.51      7      1.28 1.0e+00     FALSE
        1.24     16      1.54 3.0e-01     FALSE
        1.24     10      0.97 1.0e+00     FALSE
        1.24      5      1.18 1.0e+00     FALSE
                             utrzymala
prawda                        FALSE TRUE
  brak bezpośredniego związku     6    1
  ukryte powiązanie               0    4
  wspólny gust                    5   11
4. Sieć reguł: Rysunek 4
R
# Rysunek 4. Sieć reguł: produkty jako węzły, reguły A → B jako strzałki
# Korzysta z obiektów przepisów 1–3: wyb, pary, Xu, nazwy, kol, motyw. Układ „circle” (produkty na okręgu
# w kolejności katalogu) jest deterministyczny – nic nie jest losowane.
library(ggplot2)
library(igraph)
library(ggraph)

kraw <- wyb[, c("a", "b", "ufnosc", "lift")]               # 15 reguł wybranych w przepisie 2
klucz <- function(a, b) paste(pmin(a, b), pmax(a, b))
kraw$wynik <- ifelse(pary$utrzymala[match(klucz(kraw$a, kraw$b), paste(pary$a, pary$b))],
                     "utrzymała się w teście", "nie utrzymała się")
wezly <- data.frame(kod = produkty$kod[produkty$kod %in% c(kraw$a, kraw$b, "mieszanka_domowa")])
wezly$nazwa <- nazwy[wezly$kod]
wezly$wsparcie <- colMeans(Xu)[wezly$kod]
g <- graph_from_data_frame(kraw, directed = TRUE, vertices = wezly)
c(wezly = vcount(g), strzalki = ecount(g))

p4 <- ggraph(g, layout = "circle") +
  geom_edge_fan(aes(edge_width = ufnosc, edge_colour = wynik, edge_linetype = wynik),
                arrow = arrow(length = unit(2.6, "mm"), type = "closed"), end_cap = circle(5, "mm"),
                start_cap = circle(5, "mm"), alpha = 0.85, strength = 1.2) +
  geom_node_point(aes(size = wsparcie), colour = "grey35", fill = "white", shape = 21, stroke = 1.1) +
  geom_node_text(aes(x = 1.13 * x, y = 1.13 * y, label = nazwa, hjust = ifelse(x > 0.01, 0, ifelse(x < -0.01, 1, 0.5))),
                 size = 3.6, colour = "grey10") +
  scale_edge_width(range = c(0.4, 2.6), breaks = c(0.1, 0.3, 0.6), labels = c("10%", "30%", "60%"), name = "ufność") +
  scale_edge_colour_manual(values = c("utrzymała się w teście" = kol[["cynober"]], "nie utrzymała się" = kol[["szary"]]),
                           name = NULL) +
  scale_edge_linetype_manual(values = c("utrzymała się w teście" = "solid", "nie utrzymała się" = "dashed"), name = NULL) +
  scale_size_area(max_size = 12, breaks = c(0.05, 0.1, 0.4), labels = c("5%", "10%", "40%"), name = "wsparcie") +
  scale_x_continuous(expand = expansion(mult = 0.45)) + scale_y_continuous(expand = expansion(mult = 0.08)) +
  coord_fixed() +
  guides(edge_colour = guide_legend(ncol = 1), edge_linetype = guide_legend(ncol = 1)) +
  labs(title = "Sieć 15 wybranych reguł z paragonów uczących",
       subtitle = "Strzałka A → B; grubość = ufność; kolor i linia = czy para utrzymała się w paragonach testowych") +
  motyw + theme(axis.text = element_blank(), axis.title = element_blank(), panel.grid.major = element_blank(),
                legend.box = "vertical")
p4   # zapis: ggsave("analiza-koszykowa-siec-regul.svg", p4, width = 10, height = 8)
Wynik w R
   wezly strzalki
      18       15
5. Podobieństwo produktów i rekomendacja dla jednej klientki: Rysunek 5
R
# Rysunek 5. „Klienci, którzy kupili X, kupili też Y”: podobieństwo cosinusowe produktów i top-3 dla jednej klientki
# Korzysta z obiektów przepisu 1: X, klient, zbior, produkty, kol, motyw. Niczego nie losuje.
library(ggplot2)

# Macierz klient × produkt z paragonów uczących: 1 = klient kupił produkt choć raz
U <- rowsum(X[zbior == "uczacy", ], klient[zbior == "uczacy"]) > 0
U <- U * 1L
ile_klientow <- colSums(U)
# Podobieństwo cosinusowe: wspólni klienci / pierwiastek z (klienci A × klienci B)
S <- crossprod(U) / sqrt(outer(ile_klientow, ile_klientow))
diag(S) <- 0
nazwy <- setNames(produkty$nazwa, produkty$kod)
c(klienci = nrow(U), produkty = ncol(U))
round(S["drip_ceramiczny", order(-S["drip_ceramiczny", ])[1:4]], 3)

rekomenduj <- function(kupione, S, n = 3) {     # suma podobieństw do kupionych, bez produktów już kupionych
  wynik <- colSums(S[kupione, , drop = FALSE])
  wynik[kupione] <- -Inf
  head(sort(wynik, decreasing = TRUE), n)
}

# Przykład: pierwsza klientka (najniższy numer), która w paragonach uczących kupiła dokładnie 3 produkty, w tym drip
kandydatki <- which(rowSums(U) == 3 & U[, "drip_ceramiczny"] == 1)
ewa <- rownames(U)[kandydatki[1]]
kupione <- colnames(U)[U[ewa, ] == 1]
c(klientka = ewa, kupione = paste(nazwy[kupione], collapse = ", "))
round(S[kupione, ], 2)[, order(-colSums(S[kupione, ]))[1:6]]
top3 <- rekomenduj(kupione, S)
round(top3, 3)
test_ewy <- colnames(X)[X[zbior == "testowy" & klient == as.integer(ewa), ] == 1]
c(paragon_testowy = paste(nazwy[test_ewy], collapse = ", "))

# Grafika schematu: koszyk → podobieństwa → lista top-3
kand <- names(sort(colSums(S[kupione, ]), decreasing = TRUE))
kand <- setdiff(kand, kupione)[1:6]
lewa <- data.frame(kod = kupione, x = 1, y = seq(4.5, 1.5, length.out = length(kupione)))
prawa <- data.frame(kod = kand, x = 3, y = seq(5.5, 0.5, length.out = length(kand)),
                    wynik = colSums(S[kupione, kand]), top = seq_along(kand) <= 3)
linie <- expand.grid(od = kupione, do = kand, stringsAsFactors = FALSE)
linie$cos <- S[cbind(linie$od, linie$do)]
linie <- merge(merge(linie, setNames(lewa[, c("kod", "y")], c("od", "y0"))), setNames(prawa[, c("kod", "y")], c("do", "y1")))
linie <- linie[linie$cos >= 0.15, ]                 # cieńsze powiązania pomijamy na rysunku
p5 <- ggplot() +
  geom_segment(data = linie, aes(x = 1.42, xend = 2.45, y = y0, yend = y1, linewidth = cos), colour = kol[["niebieski"]],
               alpha = 0.55, lineend = "round") +
  geom_label(data = lewa, aes(x, y, label = nazwy[kod]), size = 4, fill = "grey95", linewidth = 0.4,
             label.padding = unit(0.45, "lines")) +
  geom_label(data = prawa, aes(x, y, label = sprintf("%s%s\nsuma podobieństw %.2f", ifelse(top, paste0(seq_along(kod), ". "), ""),
                                                      nazwy[kod], wynik), fill = top), size = 3.6, linewidth = 0.4,
             label.padding = unit(0.4, "lines"), lineheight = 0.95) +
  annotate("text", x = c(1, 2, 3), y = 6.45, label = c("1. Co kupiła (paragony uczące)", "2. Podobieństwo produktów",
                                                       "3. Ranking nowych produktów"),
           fontface = "bold", size = 4, colour = "#0f1d3a") +
  annotate("text", x = 2, y = 5.9, label = "grubość linii = cosinus (pokazano ≥ 0.15)", size = 3.4, colour = "grey30") +
  annotate("text", x = 2, y = -0.45, size = 3.6, colour = "grey20",
           label = paste0("Paragon testowy klientki: ", paste(nazwy[test_ewy], collapse = ", "))) +
  scale_fill_manual(values = c("TRUE" = "#F6C9A9", "FALSE" = "white"), guide = "none") +
  scale_linewidth(range = c(0.3, 3.5), guide = "none") +
  scale_x_continuous(limits = c(0.4, 3.65)) + scale_y_continuous(limits = c(-0.8, 6.7)) +
  labs(title = sprintf("Rekomendacja top-3 dla klientki nr %s", ewa),
       subtitle = "Wynik = suma podobieństw do kupionych produktów; pomarańczowe tło = lista top-3") +
  motyw + theme_void(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a"), plot.subtitle = element_text(colour = "grey30"),
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
p5   # zapis: ggsave("analiza-koszykowa-schemat-rekomendacji.svg", p5, width = 10, height = 6.6)
Wynik w R
 klienci produkty
    1400       20
filtry_papierowe     kawa_etiopia mieszanka_domowa    mlynek_reczny
           0.718            0.320            0.304            0.298
                                           klientka
                                              "103"
                                            kupione
"drip ceramiczny, filtry papierowe, herbata czarna"
                 mieszanka_domowa filtry_papierowe drip_ceramiczny kawa_etiopia
drip_ceramiczny              0.30             0.72            0.00         0.32
filtry_papierowe             0.32             0.00            0.72         0.29
herbata_czarna               0.36             0.21            0.19         0.24
                 mlynek_reczny herbata_zielona
drip_ceramiczny           0.30            0.15
filtry_papierowe          0.25            0.16
herbata_czarna            0.13            0.36
mieszanka_domowa     kawa_etiopia    mlynek_reczny
           0.982            0.855            0.683
     paragon_testowy
"czekolada do picia"
6. Odsetek trafień top-N i bootstrap: Rysunek 6
R
# Rysunek 6. Ocena rekomendacji: odsetek trafień w top-N na paragonach testowych
# Korzysta z obiektów przepisów 1 i 5: X, klient, zbior, U, S, rekomenduj, produkty, kol, motyw.
library(ggplot2)

# Oceniamy klientów, których paragon testowy zawiera co najmniej jeden produkt nowy (nie kupiony wcześniej)
Tst <- rowsum(X[zbior == "testowy", ], klient[zbior == "testowy"]) > 0
ocena <- rownames(Tst)[sapply(rownames(Tst), function(k) any(Tst[k, ] & !U[k, ]))]
popularnosc <- colSums(U)
lista <- function(k, metoda, n) {
  kupione <- colnames(U)[U[k, ] == 1]
  if (metoda == "cosinus") names(rekomenduj(kupione, S, n))
  else head(setdiff(names(sort(popularnosc, decreasing = TRUE)), kupione), n)
}
traf <- function(k, metoda, n) any(Tst[k, lista(k, metoda, n)])
wyniki <- expand.grid(n = 1:5, metoda = c("cosinus", "popularne"), stringsAsFactors = FALSE)
H <- sapply(seq_len(nrow(wyniki)), function(i) sapply(ocena, traf, metoda = wyniki$metoda[i], n = wyniki$n[i]))
wyniki$trafienia <- colMeans(H)
c(oceniani_klienci = length(ocena))

# 95% przedziały: bootstrap klientów (1000 prób) – ta sama próba klientów dla obu metod
set.seed(604)                                   # to samo ziarno co w przepisie 1
B <- replicate(1000, colMeans(H[sample(nrow(H), replace = TRUE), ]))
wyniki$dolna <- apply(B, 1, quantile, 0.025)
wyniki$gorna <- apply(B, 1, quantile, 0.975)
print(transform(wyniki, trafienia = round(100 * trafienia, 1), dolna = round(100 * dolna, 1),
                gorna = round(100 * gorna, 1)), row.names = FALSE)
# Różnica cosinus − popularne przy top-3, z przedziałem bootstrapowym
i3 <- which(wyniki$n == 3)
roznica <- B[i3[1], ] - B[i3[2], ]
round(100 * c(roznica = wyniki$trafienia[i3[1]] - wyniki$trafienia[i3[2]], quantile(roznica, c(0.025, 0.975))), 1)
# Jak często „mieszanka domowa” trafia do top-3 cosinusowego, gdy klient jej jeszcze nie kupił?
bez_mieszanki <- ocena[U[ocena, "mieszanka_domowa"] == 0]
round(c(klienci_bez_mieszanki = length(bez_mieszanki),
        proc_z_mieszanka_w_top3 = 100 * mean(sapply(bez_mieszanki, function(k) "mieszanka_domowa" %in% lista(k, "cosinus", 3)))), 1)

wyniki$metoda <- factor(wyniki$metoda, c("cosinus", "popularne"),
                        c("podobne produkty (cosinus)", "najpopularniejsze produkty"))
wyniki$x <- wyniki$n + ifelse(wyniki$metoda == "najpopularniejsze produkty", 0.06, -0.06)   # lekkie rozsunięcie
p6 <- ggplot(wyniki, aes(x, trafienia, colour = metoda, shape = metoda, linetype = metoda)) +
  geom_line(linewidth = 1) +
  geom_errorbar(aes(ymin = dolna, ymax = gorna), width = 0.1, linetype = "solid") +
  geom_point(size = 3) +
  scale_colour_manual(values = c(kol[["cynober"]], kol[["niebieski"]]), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  scale_y_continuous(labels = scales::percent, limits = c(0, NA)) + scale_x_continuous(breaks = 1:5) +
  labs(x = "Długość listy rekomendacji (top-N)", y = "Klienci z trafieniem w paragonie testowym",
       title = "Ilu klientom lista „trafiła” w kolejny zakup",
       subtitle = sprintf("%d klientów z nowym produktem w ostatnim paragonie; 95%% przedziały bootstrapowe", length(ocena))) +
  motyw
p6   # zapis: ggsave("analiza-koszykowa-trafnosc-top-n.svg", p6, width = 10, height = 5.8)
Wynik w R
oceniani_klienci
             878
 n    metoda trafienia dolna gorna
 1   cosinus      27.9  24.9  30.5
 2   cosinus      45.1  41.9  48.4
 3   cosinus      56.7  53.5  59.9
 4   cosinus      63.7  60.6  66.7
 5   cosinus      68.6  65.4  71.5
 1 popularne      28.5  25.4  31.3
 2 popularne      39.7  36.7  42.9
 3 popularne      49.9  46.5  53.0
 4 popularne      57.7  54.4  61.0
 5 popularne      66.2  63.2  69.4
roznica    2.5%   97.5%
    6.8     4.0     9.9
  klienci_bez_mieszanki proc_z_mieszanka_w_top3
                    342                     100
7. Sprawdzenie palety (deuteranopia, protanopia)
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober (lift < 1 / lift > 1; popularne / cosinus)" = c("#0072B2", "#D55E00"),
             "cynober – szary (reguła wybrana / pozostałe; utrzymała się / nie)" = c("#D55E00", "#999999"),
             "niebieski – szary (następnik: mieszanka / pozostałe)" = c("#0072B2", "#999999"),
             "jasnopomarańczowy – biały (top-3 / pozostałe na schemacie)" = c("#F6C9A9", "#FFFFFF"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                                  widzenie_typowe
niebieski – cynober (lift < 1 / lift > 1; popularne / cosinus)              114.6
cynober – szary (reguła wybrana / pozostałe; utrzymała się / nie)            77.2
niebieski – szary (następnik: mieszanka / pozostałe)                         44.9
jasnopomarańczowy – biały (top-3 / pozostałe na schemacie)                   29.5
czerwony – zielony (do unikania)                                            121.7
                                                                  deuteranopia
niebieski – cynober (lift < 1 / lift > 1; popularne / cosinus)           108.3
cynober – szary (reguła wybrana / pozostałe; utrzymała się / nie)         62.9
niebieski – szary (następnik: mieszanka / pozostałe)                      48.9
jasnopomarańczowy – biały (top-3 / pozostałe na schemacie)                27.9
czerwony – zielony (do unikania)                                          21.1
                                                                  protanopia
niebieski – cynober (lift < 1 / lift > 1; popularne / cosinus)          91.9
cynober – szary (reguła wybrana / pozostałe; utrzymała się / nie)       56.0
niebieski – szary (następnik: mieszanka / pozostałe)                    40.6
jasnopomarańczowy – biały (top-3 / pozostałe na schemacie)              26.8
czerwony – zielony (do unikania)                                        31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, macierze, test Fishera i poprawka Holma – pakiety base i stats). Rysunki wykonano w ggplot2 (osie procentowe – pakiet scales, etykiety – ggrepel), sieć reguł – pakietami igraph i ggraph; pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- scales (wersja 1.4.0): Wickham, H., Pedersen, T. L., & Seidel, D. (2025). scales: Scale functions for visualization [R package]. https://doi.org/10.32614/CRAN.package.scales
- ggrepel (wersja 0.9.8): Slowikowski, K. (2026). ggrepel: Automatically position non-overlapping text labels with 'ggplot2' [R package]. https://doi.org/10.32614/CRAN.package.ggrepel
- igraph (wersja 2.2.2): Csárdi, G., & Nepusz, T. (2006). The igraph software package for complex network research. InterJournal, Complex Systems, 1695. https://igraph.org
- ggraph (wersja 2.2.2): Pedersen, T. L. (2025). ggraph: An implementation of grammar of graphics for graphs and networks [R package]. https://doi.org/10.32614/CRAN.package.ggraph
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Ranking reguł po ufności. Wygrywa bestseller, a lift ≈ 1 (rysunek 3).
- Reguły bez sprawdzenia na nowych danych. Im luźniejsze progi, tym więcej przypadkowych par – 6 z 7 par bez bezpośredniego związku odpadło w teście. To odmiana przeuczenia.
- Reguła jako przyczyna. Para czekolada–cantuccini to skutek promocji łączonej. Współwystępowanie nie mówi, że zakup A „powoduje” zakup B – zob. korelacja a przyczynowość.
- Rekomendacje oczywiste. Mieszanka domowa trafiała do top-3 każdego klienta, który jej nie miał. Trafienie bestsellerem niczego klientowi nie podsuwa.
- Ocena rekomendacji na danych uczących i bez punktu odniesienia (lista bestsellerów).
- Dane osobowe. Historia zakupów to dane osobowe: w pracy użyj danych zanonimizowanych i opisz podstawę ich przetwarzania (zob. świadoma zgoda i RODO).
Macierz klient × produkt można też streścić np. PCA, ale do ramki „kupili też” wystarczy cosinus. Pomoc przy takiej analizie: analizy statystyczne dla studentów.
Najczęstsze pytania
Czym się różni ufność od liftu w analizie koszykowej?
Ufność to odsetek paragonów z produktem B wśród paragonów z A. Lift dzieli tę ufność przez ogólną częstość B, więc mówi, ile razy częściej B pojawia się przy A niż przeciętnie. W przykładzie reguły z bestsellerem jako następnikiem miały ufność do 49.1%, ale lift od 0.77 do 1.05, czyli brak związku. Do wyboru reguł używaj liftu razem z minimalnym wsparciem.
Jakie progi wsparcia i ufności przyjąć w analizie koszykowej?
Nie ma progów uniwersalnych – zależą od liczby paragonów i produktów. W przykładzie z 2790 paragonami i 20 produktami przyjęto wsparcie co najmniej 1%, ufność co najmniej 25% i lift co najmniej 1.5, co dało 15 z 380 reguł. Progi podaj w Metodzie z uzasadnieniem i sprawdź, jak zmienia się lista przy innych wartościach.
Czy reguły asocjacyjne trzeba testować statystycznie?
Przy przeszukiwaniu setek reguł część wysokich liftów jest przypadkowa, a standardowe metody znajdują fałszywe wzorce nawet w danych losowych (Webb, 2007). Najprostsze rozwiązanie to znaleźć reguły na części danych i sprawdzić je na pozostałych, np. testem Fishera z poprawką na wiele porównań. W przykładzie z 27 par utrzymało się 16, w tym wszystkie 4 prawdziwe powiązania.
Jak ocenić system rekomendacyjny w pracy dyplomowej?
Odłóż ostatni zakup każdego klienta, wyznacz rekomendacje z wcześniejszych zakupów i policz, u ilu klientów produkt z listy top-N znalazł się w tym zakupie. Porównaj wynik z listą najpopularniejszych produktów i podaj przedział ufności, np. bootstrapowy. To ocena offline; czy rekomendacje zwiększają sprzedaż, rozstrzyga dopiero test A/B (Kohavi i in., 2009).
Czy analiza koszykowa pokazuje, dlaczego klienci kupują produkty razem?
Nie. Reguła opisuje współwystępowanie w koszyku, a przyczyną może być promocja łączona, układ strony albo wspólny gust klientów. W przykładzie czekolada i ciastka miały lift 5.67 wyłącznie dlatego, że sklep sprzedawał je razem w promocji. Wnioski przyczynowe wymagają eksperymentu.
Powiązane hasła
Przeczytaj też
Analiza skupień w marketingu – segmentacja klientów
Księgarnia internetowa, 1500 klientów i RFM: przekształcenia, liczba segmentów, mapa PCA, karty segmentów z działaniami i stabilność – sześć rysunków z kodem R.
Czytaj →PoradnikKlasy latentne w marketingu
Ankieta 1000 klientów drogerii: ile klas, profil, entropia, karty segmentów z działaniami, wiek jako kowariant i LCA a k-średnich – sześć rysunków z kodem R.
Czytaj →PoradnikStatystyka w pracy z marketingu
Skala postaw wobec marki, NPS z przedziałem ufności, test A/B, intencja zakupu, mediacja i segmentacja: testy, zdania APA, dane XLSX i kod R.
Czytaj →PoradnikWyszukiwarka w sklepie – NDCG i przeplatanie
Sklep z narzędziami: precyzja@5, MRR i NDCG krok po kroku, obciążenie pozycji, test A/B vs przeplatanie team-draft i zapytania rzadkie – kod R.
Czytaj →Masz w pracy dane o zakupach lub paragony?
Pomożemy policzyć reguły asocjacyjne, sprawdzić je na nowych danych, zbudować i ocenić proste rekomendacje oraz opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Agrawal, R., Imieliński, T., & Swami, A. (1993). Mining association rules between sets of items in large databases. ACM SIGMOD Record, 22(2), 207–216. https://doi.org/10.1145/170036.170072
- Cremonesi, P., Koren, Y., & Turrin, R. (2010). Performance of recommender algorithms on top-N recommendation tasks. In Proceedings of the Fourth ACM Conference on Recommender Systems (pp. 39–46). ACM. https://doi.org/10.1145/1864708.1864721
- Hahsler, M., Grün, B., & Hornik, K. (2005). arules – A computational environment for mining association rules and frequent item sets. Journal of Statistical Software, 14(15). https://doi.org/10.18637/jss.v014.i15 ● Otwarty dostęp
- Herlocker, J. L., Konstan, J. A., Terveen, L. G., & Riedl, J. T. (2004). Evaluating collaborative filtering recommender systems. ACM Transactions on Information Systems, 22(1), 5–53. https://doi.org/10.1145/963770.963772
- Kohavi, R., Longbotham, R., Sommerfield, D., & Henne, R. M. (2009). Controlled experiments on the web: Survey and practical guide. Data Mining and Knowledge Discovery, 18(1), 140–181. https://doi.org/10.1007/s10618-008-0114-1 ● Otwarty dostęp
- Sarwar, B., Karypis, G., Konstan, J., & Riedl, J. (2001). Item-based collaborative filtering recommendation algorithms. In Proceedings of the 10th International Conference on World Wide Web (pp. 285–295). ACM. https://doi.org/10.1145/371920.372071
- Webb, G. I. (2007). Discovering significant patterns. Machine Learning, 68(1), 1–33. https://doi.org/10.1007/s10994-007-5006-x ● Otwarty dostęp
Cytowania BibTeX
@article{agrawal1993mining, author={Agrawal, Rakesh and Imieliński, Tomasz and Swami, Arun}, title={{Mining association rules between sets of items in large databases}}, journal={ACM SIGMOD Record}, year={1993}, volume={22}, number={2}, pages={207--216}, doi={10.1145/170036.170072}}@inproceedings{cremonesi2010performance, author={Cremonesi, Paolo and Koren, Yehuda and Turrin, Roberto}, title={{Performance of recommender algorithms on top-N recommendation tasks}}, booktitle={Proceedings of the Fourth ACM Conference on Recommender Systems}, year={2010}, pages={39--46}, publisher={ACM}, doi={10.1145/1864708.1864721}}@article{hahsler2005arules, author={Hahsler, Michael and Grün, Bettina and Hornik, Kurt}, title={{arules – A computational environment for mining association rules and frequent item sets}}, journal={Journal of Statistical Software}, year={2005}, volume={14}, number={15}, doi={10.18637/jss.v014.i15}}@article{herlocker2004evaluating, author={Herlocker, Jonathan L. and Konstan, Joseph A. and Terveen, Loren G. and Riedl, John T.}, title={{Evaluating collaborative filtering recommender systems}}, journal={ACM Transactions on Information Systems}, year={2004}, volume={22}, number={1}, pages={5--53}, doi={10.1145/963770.963772}}@article{kohavi2009controlled, author={Kohavi, Ron and Longbotham, Roger and Sommerfield, Dan and Henne, Randal M.}, title={{Controlled experiments on the web: Survey and practical guide}}, journal={Data Mining and Knowledge Discovery}, year={2009}, volume={18}, number={1}, pages={140--181}, doi={10.1007/s10618-008-0114-1}}@inproceedings{sarwar2001item, author={Sarwar, Badrul and Karypis, George and Konstan, Joseph and Riedl, John}, title={{Item-based collaborative filtering recommendation algorithms}}, booktitle={Proceedings of the 10th International Conference on World Wide Web}, year={2001}, pages={285--295}, publisher={ACM}, doi={10.1145/371920.372071}}@article{webb2007discovering, author={Webb, Geoffrey I.}, title={{Discovering significant patterns}}, journal={Machine Learning}, year={2007}, volume={68}, number={1}, pages={1--33}, doi={10.1007/s10994-007-5006-x}}