Przykład: sklep z narzędziami warsztatowymi
Fikcyjny sklep internetowy sprzedaje wiertła, klucze, szlifierki i akcesoria warsztatowe. Wielu klientów zaczyna od okienka wyszukiwania i wpisuje np. „wiertło do betonu 8 mm”. Zespół sklepu przygotował nowy algorytm rankingu B (uczony m.in. na kliknięciach), który ma zastąpić obecny algorytm A (dopasowanie słów). Pytanie: czy B ustawia trafne produkty wyżej i jak sprawdzić to szybko, bez wielotygodniowego testu?
Mamy 400 różnych zapytań z jednego miesiąca. Ich popularność jest bardzo nierówna: 20 najczęstszych daje 54.8% sesji wyszukiwania, 80 kolejnych – 24.2%, a 300 rzadkich – 21.0%. Dla każdego zapytania zespół ocenił 40 pasujących produktów w skali 0–3 (3 – dokładnie to, 2 – pasuje, 1 – związany, 0 – nie na temat). To skala porządkowa, więc przy prawdziwych ocenach sprawdź zgodność oceniających (zob. zgodność sędziów: kappa, ICC, alfa). 43 zapytania (3.96% sesji) nie zwracają żadnego produktu.
Dane są fikcyjne, więc wiemy, co w nich ukryliśmy. Algorytm B jest lepszy dla zapytań częstych, a gorszy dla rzadkich (więcej losowego szumu w rankingu). Parametry ustaliliśmy ręcznie; pełna lista jest przy kodzie. Listy wyników pobierzesz jako wyszukiwarka-narzedzia-listy-wynikow.csv (wiersz = zapytanie × algorytm × pozycja z oceną produktu). Inne tematy prac zbiera wpis statystyka w pracy z marketingu.
Precyzja@5, MRR i NDCG na jednym zapytaniu
Zapytanie „wiertło do betonu 8 mm”; obie listy ułożyliśmy ręcznie. Algorytm A dopasowuje słowa „wiertło” i „8 mm”, więc na górze stawia wiertła do drewna i metalu. Algorytm B zaczyna od wierteł do betonu.
- Precyzja@5 – odsetek trafnych produktów (ocena 2 lub 3) w pierwszej piątce. A: 2 z 5, czyli .40; B: .60.
- Odwrotność rangi (RR) – 1 podzielone przez pozycję pierwszego trafnego produktu. A: pierwszy trafny na 3. miejscu, RR = 1/3 = .333; B: na 1. miejscu, RR = 1. Średnia RR z wielu zapytań to MRR (mean reciprocal rank).
- NDCG@10 – korzysta z całej skali 0–3 i z pozycji. Każda ocena jest dzielona przez log₂(pozycja + 1), więc ten sam produkt na 1. miejscu daje 1.000 ocen, a na 3. – tylko 0.500. Suma to DCG; dzielimy ją przez DCG idealnej kolejności (IDCG).
Miary oparte na skumulowanym zysku z dyskontem za pozycję i porównaniu z idealną kolejnością zaproponowali Järvelin i Kekäläinen (2002) – tak, by premiować systemy za wysoko ustawione produkty bardzo trafne, a nie tylko za „trafne lub nie”.
| Pozycja | Dyskonto 1/log₂(i + 1) | Algorytm A: produkt (ocena) | Wkład A | Algorytm B: produkt (ocena) | Wkład B |
|---|---|---|---|---|---|
| 1 | 1.000 | wiertło do drewna 8 mm (1) | 1.000 | wiertło SDS-plus 8 × 160 mm (3) | 3.000 |
| 2 | 0.631 | wiertło do metalu HSS 8 mm (1) | 0.631 | wiertło do betonu 8 × 120 mm (3) | 1.893 |
| 3 | 0.500 | wiertło SDS-plus 8 × 160 mm (3) | 1.500 | zestaw wierteł do betonu 5–10 mm (2) | 1.000 |
| 4 | 0.431 | kołki rozporowe 8 mm (1) | 0.431 | wiertło do metalu HSS 8 mm (1) | 0.431 |
| 5 | 0.387 | zestaw wierteł do betonu 5–10 mm (2) | 0.774 | kołki rozporowe 8 mm (1) | 0.387 |
| 6–10 | 0.356–0.289 | wiertarka (0), wiertło do betonu 8 × 120 mm (3), glazura (1), SDS-plus 8 × 210 mm (2), uchwyt (0) | 1.917 | SDS-plus 8 × 210 mm (2), drewno (1), wiertarka (0), glazura (1), dłuto (0) | 1.346 |
| DCG@10 (IDCG@10 = 8.146) | 6.253 | 8.057 | |||
| NDCG@10 | .768 | .989 | |||
Idealna kolejność ocenionych produktów to 3, 3, 2, 2, 1, 1, 1, 1, 0, 0 – stąd IDCG@10 = 8.146. Lista A traci, bo oba wiertła z oceną 3 stoją na 3. i 7. miejscu. Precyzja@5 i RR widzą tylko „trafny / nietrafny”, NDCG widzi też różnicę między „pasuje” i „dokładnie to”.
Rysunek 1: ocena offline na wszystkich zapytaniach
Te same miary liczymy dla 357 zapytań z wynikami. Każda miara daje jedną liczbę na zapytanie i algorytm, więc porównanie jest w parach: różnica B − A dla tego samego zapytania. Przedziały liczymy bootstrapem zapytań (2000 powtórzeń). Pytanie brzmi jednak: średnia po czym?
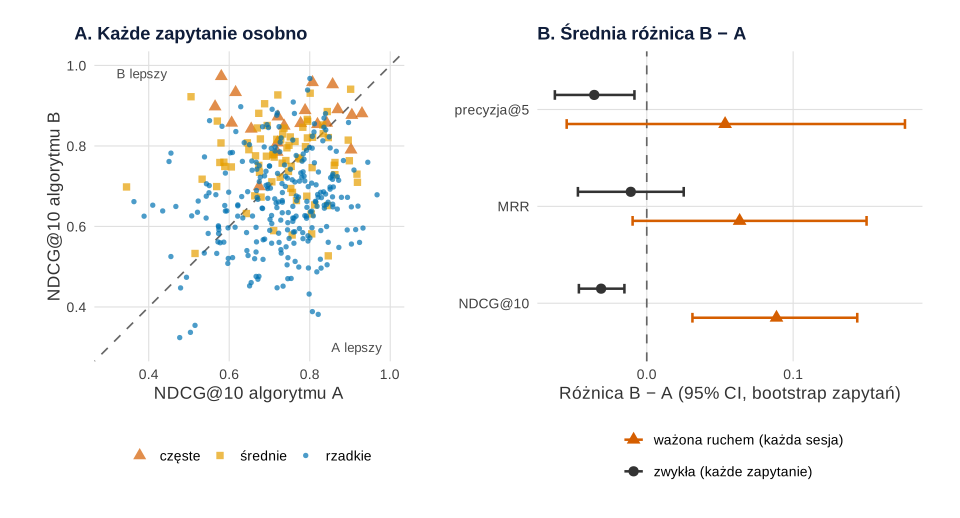
Co widać. Średnio po zapytaniach B jest gorszy: NDCG@10 .695 wobec .726, różnica −.031 (95% CI [−.046, −.015]; test t dla par: t(356) = −3.84, p < .001). B wygrywa tylko w 150 z 357 zapytań. Gdy jednak każde zapytanie waży tyle, ile ma sesji (średnia ważona), B jest lepszy: .816 wobec .728, różnica +.089 [.031, .144]. Podobnie MRR: −.011 [−.047, .025] bez wag i +.063 [−.010, .150] z wagami.
Jak może zmylić. Oba wyniki są poprawne – odpowiadają na inne pytania. Średnia zwykła mówi „czy B jest lepszy dla typowego zapytania”, ważona – „czy jest lepszy dla typowego klienta”. Przedziały ważone są szerokie, bo o wyniku decyduje 20 zapytań. To bliski krewny paradoksu Simpsona: wynik ogólny zależy od tego, jak połączysz grupy.
Rysunek 2: kliknięcia zależą od pozycji
Oceny ekspertów są drogie, więc kusi, by zastąpić je kliknięciami. Joachims i in. (2005) pokazali jednak, że kliknięcia są informatywne, ale obciążone – trudno je traktować jako bezwzględne oceny trafności, choć względne preferencje z kliknięć są średnio dość trafne. Główne źródło obciążenia to pozycja: Craswell i in. (2008) zaburzali ranking dużej wyszukiwarki i najlepiej wyjaśniał wyniki model kaskadowy – użytkownik czyta listę od góry i odchodzi, gdy znajdzie coś wartościowego. Taki model kliknięć wbudowaliśmy w symulację 200 000 sesji z algorytmem A.
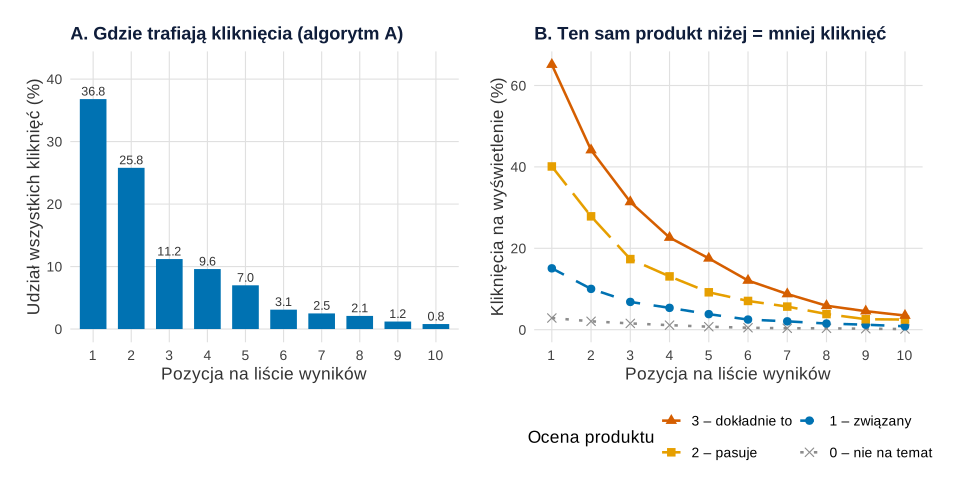
Co widać. Pierwsze dwie pozycje zbierają 62.6% kliknięć (36.8% i 25.8%). Produkt z oceną 3 klikany jest w 65.1% wyświetleń na 1. miejscu, w 31.4% na 3. i w 3.5% na 10. – 18.8 raza rzadziej, choć to ten sam stopień trafności. Produkt „pasuje” na 1. miejscu (40.1%) zbiera więcej kliknięć niż „dokładnie to” na 3. (31.4%).
Jak może zmylić. „Produkty z wysokim CTR są najlepsze” to w dużej mierze „produkty, które już stoją wysoko”. Algorytm uczony na surowych kliknięciach utrwala obecny ranking. Dlatego dwóch algorytmów nie porównuj klikalnością z dwóch różnych okresów – porównuj je w eksperymencie.
Rysunek 3: jak działa test przeplatania
Klasyczny test A/B pokazuje połowie klientów listę A, połowie listę B i porównuje konwersję z wyszukiwania (plan i analizę opisuje wpis test A/B – plan i analiza). Test przeplatania (interleaving) robi co innego: każdy klient widzi jedną listę złożoną z obu rankingów, a o wyniku decyduje, w produkty której „drużyny” klikał. Najczęściej używany wariant to team-draft.
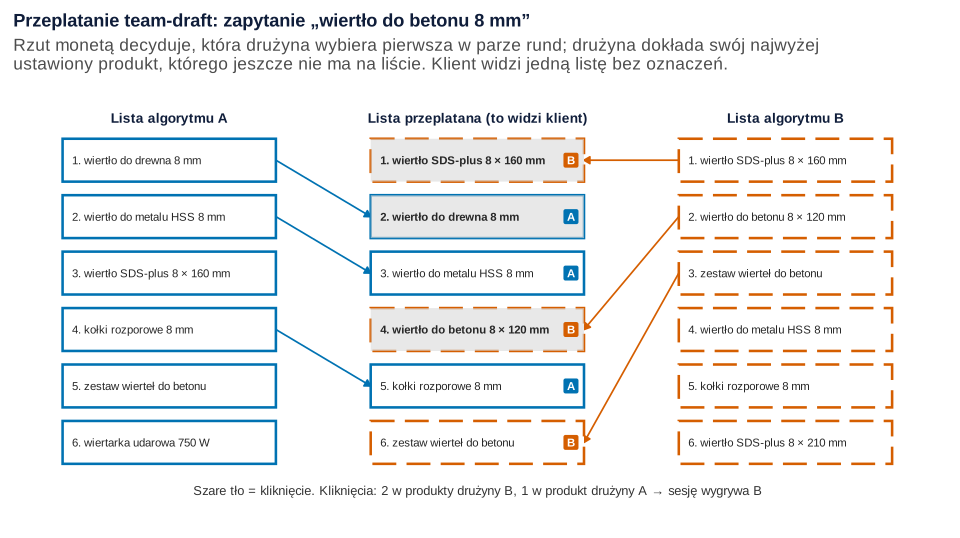
Co widać. W każdej parze rund rzut monetą decyduje, kto wybiera pierwszy; drużyna dokłada swój najwyżej ustawiony produkt, którego jeszcze nie ma na liście. Tu B wybrał pierwszy wiertło SDS-plus, potem A dołożył wiertło do drewna. Klient kliknął pozycje 1, 2 i 4 – dwa razy drużynę B, raz A – więc tę sesję wygrywa B. Równa liczba kliknięć (także zero) to remis.
Jak może zmylić. Przeplatanie mówi, który ranking klienci wolą, a nie o ile wzrośnie sprzedaż. Rzut monetą jest konieczny: bez niego jedna drużyna stałaby zawsze wyżej i zbierała kliknięcia dzięki obciążeniu pozycji.
Rysunek 4: ta sama decyzja przy znacznie mniejszej liczbie sesji
Radlinski i in. (2008) stwierdzili, że bezwzględne miary użycia (np. liczba kliknięć, porzucenie wyszukiwania) nie odzwierciedlały wiarygodnie jakości wyszukiwarki przy badanych liczebnościach, a porównania w parach na liście przeplatanej dawały wyniki trafniejsze i czulsze. Chapelle i in. (2012) przeanalizowali przeplatanie na danych z dwóch dużych wyszukiwarek, sprawdzając m.in. jego zgodność z ocenami ekspertów i efektywność statystyczną.
W 200 000 symulowanych sesjach na każdy dziennik konwersja z wyszukiwania wyniosła 8.89% przy A i 9.76% przy B. W teście przeplatania B wygrał 35.04% sesji, A – 27.42%, a 37.54% to remisy (w tym 21.36% sesji bez kliknięć). Wśród sesji rozstrzygniętych B wygrywa w 56.1%. Z tych odsetków losujemy 2000 eksperymentów dla każdej liczby sesji i liczymy, jak często test wskaże B przy α = .05. Test A/B: test z dla dwóch odsetków; przeplatanie: test znaków na sesjach rozstrzygniętych.
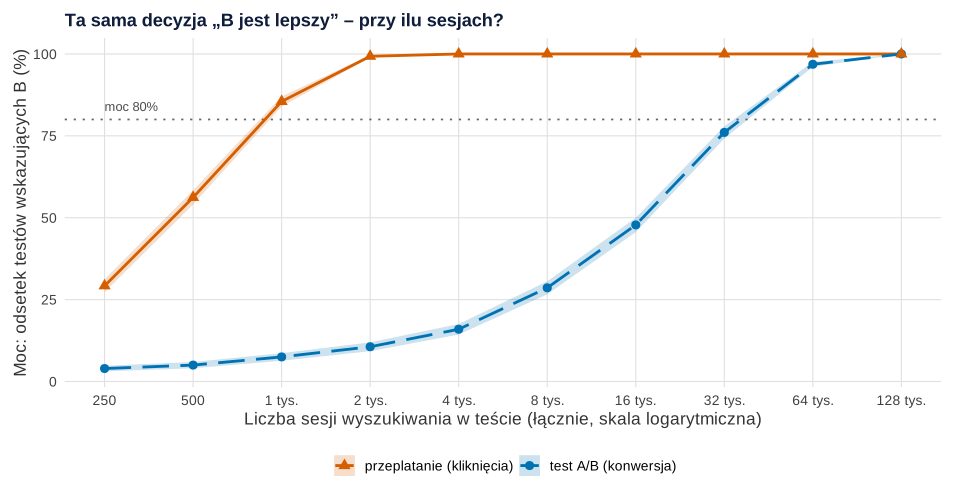
Co widać. Przeplatanie osiąga moc 85.5% już przy 1000 sesji (błąd MC 0.8 pp); test A/B ma wtedy 7.5%. Test A/B dochodzi do 76.1% przy 32 000 sesji i 96.9% przy 64 000. Ze wzoru: do mocy 80% test A/B potrzebuje 34 674 sesji, przeplatanie – 840, czyli 41.3 raza mniej.
Jak może zmylić. Przewaga wynika z dwóch rzeczy: każda sesja porównuje oba algorytmy naraz (jak plan wewnątrzosobowy), a kliknięcie zdarza się dużo częściej niż zakup. Ten mnożnik dotyczy tego modelu – w innym sklepie będzie inny. Liczba sesji nie zastąpi też czasu: efekt nowości sprawdzisz tylko dłuższą obserwacją (zob. długoterminowy holdout personalizacji).
Rysunek 5: zapytania częste, rzadkie i bez wyników
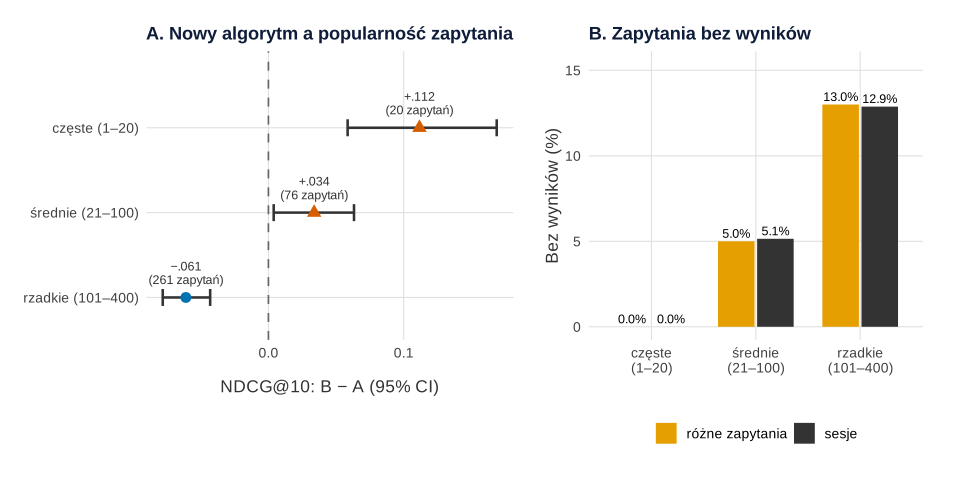
Co widać – panel A. B poprawia NDCG@10 zapytań częstych o .112 [.059, .169] i średnich o .034 [.004, .063], a w rzadkich różnica wynosi −.061 [−.078, −.043]. Dzienniki sesji mówią to samo: konwersja przy B rośnie z 9.68% do 11.29% dla zapytań częstych, a dla rzadkich spada z 7.65% do 6.95%; w przeplataniu B wygrywa 60.3% rozstrzygniętych sesji z zapytań częstych i 46.6% z rzadkich.
Co widać – panel B. Wśród rzadkich zapytań 13.0% nie zwraca nic. Ani NDCG, ani przeplatanie tego nie widzą: zapytanie bez wyników nie ma czego oceniać, a w przeplataniu daje remis. Lepszy ranking nie naprawi braku synonimów czy literówek – zapytania bez wyników mierz osobnym wskaźnikiem.
Jak może zmylić. Jedna liczba „B wygrywa” ukrywa przegraną w 261 rzadkich zapytaniach, które razem dają 21.0% sesji.
Co z tym zrobić w marketingu
- Przeplatanie jako szybkie sito, test A/B jako potwierdzenie. Kilka wersji rankingu sprawdź przeplataniem w parach (dni zamiast tygodni), a zwycięzcę – testem A/B na konwersji i przychodzie. Przegląd metod oceny online, także w małej skali, daje Hofmann i in. (2016). Przy wielu wersjach pamiętaj o porównaniach wielokrotnych (zob. test A/B z wieloma wariantami).
- Przed testem ustal metrykę główną i jednostkę. W teście A/B losuj klientów, nie sesje ani kliknięcia. Kohavi i in. (2020) opisują, jak zdefiniować kluczowe metryki i ogólne kryterium oceny eksperymentu. Skrócić test A/B pomoże też CUPED.
- Raportuj wynik osobno dla zapytań częstych i rzadkich oraz średnią zwykłą i ważoną ruchem. Wdrożenie tylko dla zapytań częstych to też decyzja.
- Śledź odsetek zapytań bez wyników i listę najczęstszych z nich – to praca dla katalogu (synonimy, literówki), nie dla rankingu.
- Nie ucz rankingu na surowym CTR – część kliknięć to efekt pozycji. Rekomendacje „klienci kupili też” to osobny temat (zob. analiza koszykowa i systemy rekomendacyjne).
Jak opisać w pracy
Metoda: zapytania, skala ocen, miary, sposób uśredniania. Wyniki: różnice z przedziałami i eksperyment online.
Kod R: metryki rankingu, kliknięcia, przeplatanie i moc
Kod odtwarza wszystkie liczby z tekstu, tabelę i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw, funkcje metryk i dane, z których korzystają kolejne. Wszystko liczy bazowy R (pakiety base i stats), rysunki – ggplot2 i patchwork. Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Ziarna: 685 (dane), 6851 (bootstrap offline), 6852 (przeplecenia), 6853 (sesje), 6854 (moc), 6855 (bootstrap w grupach), 6856 (schemat); ustalono je raz i nie zmieniano. Ręcznie ustalono: 400 zapytań o popularności z rozkładu Zipfa (waga 1/numer), podział na zapytania częste (1–20), średnie (21–100) i rzadkie (101–400), prawdopodobieństwo braku wyników 0, .04 i .12 w tych grupach, 40 ocenionych produktów na zapytanie z ocenami 0–3 w proporcjach .55, .25, .13, .07 (co najmniej jeden produkt z oceną 2), ranking jako ocena + szum normalny o odchyleniu 1.4 dla A oraz 0.9, 1.2 i 1.7 dla B w trzech grupach, model kliknięć (kliknięcie obejrzanego produktu z prawdopodobieństwem .03, .15, .40, .65 dla ocen 0–3, zakup po kliknięciu .00, .01, .04, .10, powrót do listy po kliknięciu bez zakupu .6, przejście dalej bez kliknięcia .8), 64 przeplecenia na zapytanie, 200 000 sesji na dziennik, 2000 symulowanych eksperymentów na punkt krzywej mocy oraz obie listy i kliknięcia w przykładzie „wiertło do betonu 8 mm”. Po pierwszym uruchomieniu obniżyliśmy prawdopodobieństwa zakupu po kliknięciu (z .00, .03, .12, .25), bo konwersja z wyszukiwania wynosiła ok. 21% – więcej niż w typowym sklepie; po zmianie wynosi ok. 9%. Ziaren nie zmienialiśmy. Całość liczy się w kilka sekund.
1. Paleta, motyw, metryki i dane
R
# Przepis 1. Fikcyjny sklep internetowy z narzędziami warsztatowymi: 400 zapytań w wyszukiwarce,
# oceny trafności produktów i dwa algorytmy rankingu (dane symulowane)
library(ggplot2)
library(patchwork)

# Paleta oparta na Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(A = "#0072B2", B = "#D55E00", szary = "grey55", jasny = "grey85", ciemny = "grey20",
         zielony = "#009E73", zolty = "#E69F00")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Metryki rankingu dla wektora ocen trafności (0–3) w kolejności wyświetlenia
prec_k <- function(oceny, k = 5, prog = 2) mean(oceny[1:k] >= prog)           # precyzja@k
rr     <- function(oceny, prog = 2) { i <- which(oceny >= prog)[1]; if (is.na(i)) 0 else 1 / i }
dcg    <- function(oceny, k = 10) sum(oceny[1:k] / log2(seq_len(k) + 1))      # zysk liniowy, dyskonto log2
ndcg   <- function(oceny, wszystkie, k = 10) dcg(oceny, k) / dcg(sort(wszystkie, decreasing = TRUE), k)

# Parametry ustalone ręcznie --------------------------------------------------------------
n_zap   <- 400                          # różne zapytania w miesiącu
waga    <- 1 / seq_len(n_zap)           # popularność zapytań: rozkład Zipfa (zapytanie nr 1 najczęstsze)
waga    <- waga / sum(waga)
grupa   <- cut(seq_len(n_zap), c(0, 20, 100, n_zap), labels = c("częste (1–20)", "średnie (21–100)", "rzadkie (101–400)"))
p_zero  <- c(0, 0.04, 0.12)             # odsetek zapytań bez wyników w grupach (literówki, brak w ofercie)
sd_A    <- 1.4                          # szum rankingu A (obecny algorytm, dopasowanie słów) – taki sam w grupach
sd_B    <- c(0.9, 1.2, 1.7)             # szum rankingu B (nowy, uczony na kliknięciach): lepszy dla częstych
n_kand  <- 40                           # produkty pasujące do zapytania, które ocenił zespół sklepu
p_ocen  <- c(0.55, 0.25, 0.13, 0.07)    # odsetki ocen 0, 1, 2, 3 wśród kandydatów

set.seed(685)
zapytania <- data.frame(zapytanie = seq_len(n_zap), udzial_sesji = waga, grupa = grupa,
                        zero_wynikow = rbinom(n_zap, 1, p_zero[as.integer(grupa)]))
listy <- vector("list", n_zap)
for (q in seq_len(n_zap)) {
  oceny <- sample(0:3, n_kand, replace = TRUE, prob = p_ocen)
  if (max(oceny) < 2) oceny[1] <- 2                      # każde zapytanie ma choć jeden trafny produkt
  sA <- oceny + rnorm(n_kand, 0, sd_A)
  sB <- oceny + rnorm(n_kand, 0, sd_B[as.integer(grupa[q])])
  listy[[q]] <- list(oceny = oceny, A = order(-sA)[1:10], B = order(-sB)[1:10])   # numery produktów top-10
  if (zapytania$zero_wynikow[q] == 1) listy[[q]]$A <- listy[[q]]$B <- integer(0)   # wyszukiwarka nic nie zwraca
}

# Długi plik: zapytanie × algorytm × pozycja (ocena trafności wyświetlonego produktu); tylko zapytania z wynikami
z_wynikami <- which(zapytania$zero_wynikow == 0)
dlugie <- do.call(rbind, lapply(z_wynikami, function(q) {
  L <- listy[[q]]
  data.frame(zapytanie = q, algorytm = rep(c("A", "B"), each = 10), pozycja = rep(1:10, 2),
             produkt = c(L$A, L$B), ocena = L$oceny[c(L$A, L$B)])
}))
dlugie <- merge(zapytania[, c("zapytanie", "grupa", "udzial_sesji")], dlugie, by = "zapytanie")
dlugie$udzial_sesji <- signif(dlugie$udzial_sesji, 4)
dlugie <- dlugie[order(dlugie$zapytanie, dlugie$algorytm, dlugie$pozycja), ]
write.csv(dlugie, "wyszukiwarka-narzedzia-listy-wynikow.csv", row.names = FALSE)

# Opis danych
c(zapytan = n_zap, bez_wynikow = sum(zapytania$zero_wynikow),
  sesje_bez_wynikow_proc = round(100 * sum(waga * zapytania$zero_wynikow), 2))
round(100 * tapply(waga, grupa, sum), 1)                 # udział sesji w grupach
table(zapytania$grupa, zapytania$zero_wynikow)
Wynik w R
               zapytan            bez_wynikow sesje_bez_wynikow_proc
                400.00                  43.00                   3.96
    częste (1–20)  średnie (21–100) rzadkie (101–400)
             54.8              24.2              21.0

                      0   1
  częste (1–20)      20   0
  średnie (21–100)   76   4
  rzadkie (101–400) 261  39
2. Jedno zapytanie krok po kroku: tabela
R
# Przepis 2. Precyzja@5, odwrotność rangi i NDCG@10 policzone krok po kroku dla jednego zapytania
# („wiertło do betonu 8 mm”). Listy i oceny ułożone ręcznie. Korzysta z funkcji z przepisu 1. Nie losuje.
produkty <- data.frame(
  produkt = c("wiertło do drewna 8 mm", "wiertło do metalu HSS 8 mm", "wiertło SDS-plus 8 × 160 mm",
              "kołki rozporowe 8 mm", "zestaw wierteł do betonu 5–10 mm", "wiertarka udarowa 750 W",
              "wiertło do betonu 8 × 120 mm", "wiertło do glazury 8 mm", "wiertło SDS-plus 8 × 210 mm",
              "uchwyt wiertarski 13 mm", "dłuto płaskie SDS-plus"),
  ocena = c(1, 1, 3, 1, 2, 0, 3, 1, 2, 0, 0))          # 3 = dokładnie to, 2 = pasuje, 1 = związane, 0 = nie
lista_A <- c(1, 2, 3, 4, 5, 6, 7, 8, 9, 10)            # obecny algorytm: kolejność produktów
lista_B <- c(3, 7, 5, 2, 4, 9, 1, 6, 8, 11)            # nowy algorytm
krok <- function(lista) {
  o <- produkty$ocena[lista]
  data.frame(pozycja = 1:10, produkt = produkty$produkt[lista], ocena = o,
             dyskonto = round(1 / log2(1:10 + 1), 3), wklad = round(o / log2(1:10 + 1), 3))
}
krok(lista_A)
krok(lista_B)
idealna <- sort(produkty$ocena, decreasing = TRUE)[1:10]   # najlepsza możliwa kolejność ocenionych produktów
idealna
round(c(IDCG = dcg(idealna)), 3)
wynik <- sapply(list(A = lista_A, B = lista_B), function(l) {
  o <- produkty$ocena[l]
  c(prec5 = prec_k(o, 5), pierwszy_trafny = which(o >= 2)[1], RR = rr(o), DCG10 = dcg(o), NDCG10 = ndcg(o, produkty$ocena))
})
round(wynik, 3)
Wynik w R
   pozycja                          produkt ocena dyskonto wklad
1        1           wiertło do drewna 8 mm     1    1.000 1.000
2        2       wiertło do metalu HSS 8 mm     1    0.631 0.631
3        3      wiertło SDS-plus 8 × 160 mm     3    0.500 1.500
4        4             kołki rozporowe 8 mm     1    0.431 0.431
5        5 zestaw wierteł do betonu 5–10 mm     2    0.387 0.774
6        6          wiertarka udarowa 750 W     0    0.356 0.000
7        7     wiertło do betonu 8 × 120 mm     3    0.333 1.000
8        8          wiertło do glazury 8 mm     1    0.315 0.315
9        9      wiertło SDS-plus 8 × 210 mm     2    0.301 0.602
10      10          uchwyt wiertarski 13 mm     0    0.289 0.000
   pozycja                          produkt ocena dyskonto wklad
1        1      wiertło SDS-plus 8 × 160 mm     3    1.000 3.000
2        2     wiertło do betonu 8 × 120 mm     3    0.631 1.893
3        3 zestaw wierteł do betonu 5–10 mm     2    0.500 1.000
4        4       wiertło do metalu HSS 8 mm     1    0.431 0.431
5        5             kołki rozporowe 8 mm     1    0.387 0.387
6        6      wiertło SDS-plus 8 × 210 mm     2    0.356 0.712
7        7           wiertło do drewna 8 mm     1    0.333 0.333
8        8          wiertarka udarowa 750 W     0    0.315 0.000
9        9          wiertło do glazury 8 mm     1    0.301 0.301
10      10           dłuto płaskie SDS-plus     0    0.289 0.000
 [1] 3 3 2 2 1 1 1 1 0 0
 IDCG
8.146
                    A     B
prec5           0.400 0.600
pierwszy_trafny 3.000 1.000
RR              0.333 1.000
DCG10           6.253 8.057
NDCG10          0.768 0.989
3. Ocena offline: Rysunek 1
R
# Przepis 3. Ocena offline: precyzja@5, MRR i NDCG@10 dla wszystkich zapytań z wynikami, średnia
# zwykła (każde zapytanie tak samo) i ważona ruchem (każda sesja tak samo) z bootstrapem (Rysunek 1)
# Korzysta z obiektów przepisu 1: zapytania, listy, z_wynikami, funkcje metryk, kol, motyw.
metryki <- do.call(rbind, lapply(z_wynikami, function(q) {
  L <- listy[[q]]; oA <- L$oceny[L$A]; oB <- L$oceny[L$B]
  data.frame(zapytanie = q, grupa = zapytania$grupa[q], waga = zapytania$udzial_sesji[q],
             prec5_A = prec_k(oA), prec5_B = prec_k(oB), RR_A = rr(oA), RR_B = rr(oB),
             NDCG_A = ndcg(oA, L$oceny), NDCG_B = ndcg(oB, L$oceny))
}))
nazwy <- c(prec5 = "precyzja@5", RR = "MRR", NDCG = "NDCG@10")
# Średnie A i B oraz różnica B − A: zwykła (po zapytaniach) i ważona udziałem w sesjach
srednie <- do.call(rbind, lapply(names(nazwy), function(m) {
  a <- metryki[[paste0(m, "_A")]]; b <- metryki[[paste0(m, "_B")]]; w <- metryki$waga
  data.frame(metryka = nazwy[[m]], A_zwykla = mean(a), B_zwykla = mean(b),
             A_wazona = weighted.mean(a, w), B_wazona = weighted.mean(b, w))
}))
print(srednie, digits = 3)
# Odsetek zapytań, w których B wypada lepiej / gorzej / tak samo (NDCG@10)
table(sign(round(metryki$NDCG_B - metryki$NDCG_A, 10)))

# Bootstrap zapytań (2000 powtórzeń): 95% CI różnicy B − A; para A–B zostaje razem (porównanie w parach)
set.seed(6851)
B_rep <- 2000
idx <- replicate(B_rep, sample(nrow(metryki), replace = TRUE))
roznice <- do.call(rbind, lapply(names(nazwy), function(m) {
  d <- metryki[[paste0(m, "_B")]] - metryki[[paste0(m, "_A")]]; w <- metryki$waga
  bz <- apply(idx, 2, function(i) mean(d[i])); bw <- apply(idx, 2, function(i) weighted.mean(d[i], w[i]))
  data.frame(metryka = nazwy[[m]], srednia = c("zwykła (każde zapytanie)", "ważona ruchem (każda sesja)"),
             roznica = c(mean(d), weighted.mean(d, w)),
             dolna = c(quantile(bz, .025), quantile(bw, .025)), gorna = c(quantile(bz, .975), quantile(bw, .975)))
}))
rownames(roznice) <- NULL
print(roznice, digits = 3)
# Test t dla par (zwykła średnia, NDCG@10) – dla porównania z bootstrapem
t.test(metryki$NDCG_B, metryki$NDCG_A, paired = TRUE)

# Rysunek 1: A – NDCG@10 każdego zapytania (A na osi x, B na osi y); B – różnice średnich z 95% CI
metryki$grupa_kr <- factor(sub(" \\(.*", "", metryki$grupa), levels = c("częste", "średnie", "rzadkie"))
pA <- ggplot(metryki, aes(NDCG_A, NDCG_B)) +
  geom_abline(slope = 1, intercept = 0, colour = "grey40", linetype = "dashed") +
  geom_point(aes(shape = grupa_kr, colour = grupa_kr, size = grupa_kr), alpha = 0.7) +
  annotate("text", x = 0.32, y = 0.98, label = "B lepszy", hjust = 0, size = 3.5, colour = "grey30") +
  annotate("text", x = 0.98, y = 0.30, label = "A lepszy", hjust = 1, size = 3.5, colour = "grey30") +
  scale_colour_manual(values = c(kol[["B"]], kol[["zolty"]], kol[["A"]]), name = NULL) +
  scale_shape_manual(values = c(17, 15, 16), name = NULL) +
  scale_size_manual(values = c(3, 2.2, 1.5), name = NULL) +
  coord_equal(xlim = c(0.3, 1), ylim = c(0.3, 1)) +
  labs(x = "NDCG@10 algorytmu A", y = "NDCG@10 algorytmu B", title = "A. Każde zapytanie osobno") + motyw
roznice$metryka <- factor(roznice$metryka, levels = rev(nazwy))
pB <- ggplot(roznice, aes(roznica, metryka, colour = srednia, shape = srednia)) +
  geom_vline(xintercept = 0, colour = "grey40", linetype = "dashed") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.2, linewidth = 0.9, orientation = "y",
                position = position_dodge(width = 0.6)) +
  geom_point(size = 3.2, position = position_dodge(width = 0.6)) +
  scale_colour_manual(values = c(kol[["B"]], kol[["ciemny"]]), name = NULL, breaks = rev(unique(roznice$srednia))) +
  scale_shape_manual(values = c(17, 16), name = NULL, breaks = rev(unique(roznice$srednia))) +
  guides(colour = guide_legend(ncol = 1), shape = guide_legend(ncol = 1)) +
  labs(x = "Różnica B − A (95% CI, bootstrap zapytań)", y = NULL, title = "B. Średnia różnica B − A") + motyw
p2 <- pA + pB + plot_layout(widths = c(1, 1.1))
p2   # zapis: ggsave("wyszukiwarka-ocena-offline.svg", p2, width = 10, height = 5.4)
Wynik w R
     metryka A_zwykla B_zwykla A_wazona B_wazona
1 precyzja@5    0.641    0.606    0.688    0.742
2        MRR    0.874    0.864    0.876    0.940
3    NDCG@10    0.726    0.695    0.728    0.816

 -1   1
207 150
     metryka                     srednia roznica    dolna   gorna
1 precyzja@5    zwykła (każde zapytanie) -0.0359 -0.06276 -0.0084
2 precyzja@5 ważona ruchem (każda sesja)  0.0535 -0.05469  0.1764
3        MRR    zwykła (każde zapytanie) -0.0109 -0.04702  0.0253
4        MRR ważona ruchem (każda sesja)  0.0634 -0.00966  0.1501
5    NDCG@10    zwykła (każde zapytanie) -0.0312 -0.04636 -0.0153
6    NDCG@10 ważona ruchem (każda sesja)  0.0886  0.03121  0.1438

	Paired t-test

data:  metryki$NDCG_B and metryki$NDCG_A
t = -3.8429, df = 356, p-value = 0.000144
alternative hypothesis: true mean difference is not equal to 0
95 percent confidence interval:
 -0.04711728 -0.01521685
sample estimates:
mean difference
    -0.03116707
4. Sesje, przeplatanie team-draft i obciążenie pozycji: Rysunek 2
R
# Przepis 4. Sesje wyszukiwania z modelem kliknięć (kaskada), test przeplatania team-draft
# i obciążenie pozycji (Rysunek 2). Korzysta z obiektów przepisu 1: zapytania, listy, n_zap, kol, motyw.

# Team-draft interleaving: w każdej rundzie drużyna z mniejszą liczbą produktów (przy remisie – rzut monetą)
# dokłada swój najwyżej oceniony produkt, którego jeszcze nie ma na liście przeplatanej
team_draft <- function(lA, lB, k = 10) {
  lista <- integer(0); druzyna <- character(0)
  while (length(lista) < k) {
    nA <- sum(druzyna == "A"); nB <- sum(druzyna == "B")
    kto <- if (nA < nB || (nA == nB && runif(1) < 0.5)) "A" else "B"
    zrodlo <- if (kto == "A") lA else lB
    nowy <- zrodlo[!zrodlo %in% lista][1]
    if (is.na(nowy)) { kto <- setdiff(c("A", "B"), kto); zrodlo <- if (kto == "A") lA else lB
                       nowy <- zrodlo[!zrodlo %in% lista][1] }
    lista <- c(lista, nowy); druzyna <- c(druzyna, kto)
  }
  list(lista = lista, druzyna = druzyna)
}

# Parametry modelu kliknięć ustalone ręcznie (ocena trafności 0, 1, 2, 3)
p_klik   <- c(0.03, 0.15, 0.40, 0.65)   # kliknięcie w obejrzany produkt
p_zakup  <- c(0, 0.01, 0.04, 0.10)      # zakup po kliknięciu
p_dalej_po_kliku <- 0.6                 # po kliknięciu bez zakupu użytkownik wraca do listy
p_dalej_bez      <- 0.8                 # bez kliknięcia przechodzi do następnej pozycji
n_ses  <- 200000                        # sesje w każdym z trzech dzienników (A, B, przeplatanie)
n_przepl <- 64                          # gotowe przeplecenia na zapytanie (losowane do sesji)

# Macierze ocen na pozycjach 1–10: zapytanie × pozycja (NA = brak wyników)
oceny_listy <- function(alg) t(sapply(listy, function(L) if (length(L[[alg]])) L$oceny[L[[alg]]] else rep(NA, 10)))
gA <- oceny_listy("A"); gB <- oceny_listy("B")
set.seed(6852)
gI <- array(NA, c(n_zap, n_przepl, 10)); tI <- array(NA, c(n_zap, n_przepl, 10))
for (q in which(zapytania$zero_wynikow == 0)) for (r in seq_len(n_przepl)) {
  td <- team_draft(listy[[q]]$A, listy[[q]]$B)
  gI[q, r, ] <- listy[[q]]$oceny[td$lista]; tI[q, r, ] <- td$druzyna == "B"
}

# Kaskada: użytkownik czyta listę od góry; klika z prawdopodobieństwem zależnym od trafności,
# po kliknięciu może kupić (koniec sesji) albo wrócić; w każdej chwili może przerwać przeglądanie
kaskada <- function(G) {
  n <- nrow(G); ogl <- rep(TRUE, n); klik <- matrix(FALSE, n, 10); zakup <- rep(FALSE, n)
  for (k in 1:10) {
    g <- G[, k]; akt <- ogl & !is.na(g); gg <- ifelse(is.na(g), 1, g + 1)
    klik[, k] <- akt & runif(n) < p_klik[gg]
    kup <- klik[, k] & runif(n) < p_zakup[gg]
    zakup <- zakup | kup
    ogl <- akt & !kup & ifelse(klik[, k], runif(n) < p_dalej_po_kliku, runif(n) < p_dalej_bez)
  }
  list(klik = klik, zakup = zakup)
}
set.seed(6853)
sesje <- data.frame(zapytanie = sample(n_zap, 3 * n_ses, replace = TRUE, prob = zapytania$udzial_sesji),
                    dziennik = rep(c("A", "B", "przeplatanie"), each = n_ses))
sesje$grupa <- zapytania$grupa[sesje$zapytanie]
iA <- which(sesje$dziennik == "A"); iB <- which(sesje$dziennik == "B"); iI <- which(sesje$dziennik == "przeplatanie")
kA <- kaskada(gA[sesje$zapytanie[iA], ]); kB <- kaskada(gB[sesje$zapytanie[iB], ])
r_wyb <- sample(n_przepl, length(iI), replace = TRUE)
pom <- cbind(rep(sesje$zapytanie[iI], 10), rep(r_wyb, 10), rep(1:10, each = length(iI)))
GI <- matrix(gI[pom], ncol = 10); TI <- matrix(tI[pom], ncol = 10)
kI <- kaskada(GI)
sesje$zakup <- NA; sesje$zakup[iA] <- kA$zakup; sesje$zakup[iB] <- kB$zakup; sesje$zakup[iI] <- kI$zakup
kl_B <- rowSums(kI$klik & TI, na.rm = TRUE); kl_A <- rowSums(kI$klik & !TI, na.rm = TRUE)
sesje$wynik_przepl <- NA
sesje$wynik_przepl[iI] <- ifelse(kl_B > kl_A, "wygrywa B", ifelse(kl_A > kl_B, "wygrywa A", "remis"))

# (a) Konwersja z wyszukiwania w dziennikach A i B (to mierzy test A/B)
konw <- c(A = mean(kA$zakup), B = mean(kB$zakup))
round(100 * konw, 3)
# (b) Wynik przeplatania: odsetki sesji wygranych przez A, B i remisów (w tym sesje bez kliknięć)
przepl <- prop.table(table(factor(sesje$wynik_przepl[iI], levels = c("wygrywa A", "wygrywa B", "remis"))))
round(100 * przepl, 2)
round(100 * mean(rowSums(kI$klik, na.rm = TRUE) == 0), 2)       # sesje przeplatane bez żadnego kliknięcia
# Odsetek wygranych B wśród sesji rozstrzygniętych
round(przepl[["wygrywa B"]] / (przepl[["wygrywa A"]] + przepl[["wygrywa B"]]), 4)

# (c) Obciążenie pozycji w dzienniku A: CTR na pozycjach 1–10 osobno dla produktów o tej samej ocenie
GA <- gA[sesje$zapytanie[iA], ]
ctr <- do.call(rbind, lapply(0:3, function(o) data.frame(ocena = o, pozycja = 1:10,
  wyswietlenia = colSums(GA == o, na.rm = TRUE), klikniecia = colSums(kA$klik & GA == o, na.rm = TRUE))))
ctr$ctr <- 100 * ctr$klikniecia / ctr$wyswietlenia
print(ctr[ctr$pozycja %in% c(1, 2, 3, 5, 10), ], digits = 3)
udzial_klik <- round(100 * colSums(kA$klik) / sum(kA$klik), 1)
udzial_klik
# Pozycja 1 wobec pozycji 10 dla produktów z oceną 3: ile razy więcej kliknięć na wyświetlenie?
with(ctr[ctr$ocena == 3, ], round(ctr[pozycja == 1] / ctr[pozycja == 10], 1))

# Rysunek 2: A – udział kliknięć na pozycjach; B – CTR w zależności od pozycji przy tej samej ocenie
pA <- ggplot(data.frame(pozycja = 1:10, udzial = udzial_klik), aes(factor(pozycja), udzial)) +
  geom_col(fill = kol[["A"]], width = 0.7) +
  geom_text(aes(label = sprintf("%.1f", udzial)), vjust = -0.4, size = 3.3, colour = "grey20") +
  scale_y_continuous(limits = c(0, max(udzial_klik) * 1.15)) +
  labs(x = "Pozycja na liście wyników", y = "Udział wszystkich kliknięć (%)",
       title = "A. Gdzie trafiają kliknięcia (algorytm A)") + motyw
ctr$ocena_f <- factor(ctr$ocena, levels = 3:0, labels = c("3 – dokładnie to", "2 – pasuje", "1 – związany", "0 – nie na temat"))
pB <- ggplot(ctr, aes(pozycja, ctr, colour = ocena_f, shape = ocena_f, linetype = ocena_f)) +
  geom_line(linewidth = 0.9) + geom_point(size = 2.6) +
  scale_colour_manual(values = c(kol[["B"]], kol[["zolty"]], kol[["A"]], kol[["szary"]]), name = "Ocena produktu") +
  scale_shape_manual(values = c(17, 15, 16, 4), name = "Ocena produktu") +
  scale_linetype_manual(values = c("solid", "longdash", "dashed", "dotted"), name = "Ocena produktu") +
  scale_x_continuous(breaks = 1:10) +
  guides(colour = guide_legend(ncol = 2)) +
  labs(x = "Pozycja na liście wyników", y = "Kliknięcia na wyświetlenie (%)",
       title = "B. Ten sam produkt niżej = mniej kliknięć") + motyw
p3 <- pA + pB
p3   # zapis: ggsave("wyszukiwarka-obciazenie-pozycji.svg", p3, width = 10, height = 5.2)
Wynik w R
    A     B
8.888 9.763

wygrywa A wygrywa B     remis
    27.42     35.04     37.54
[1] 21.36
[1] 0.561
   ocena pozycja wyswietlenia klikniecia    ctr
1      0       1         6843        196  2.864
2      0       2         7547        155  2.054
3      0       3        45960        707  1.538
5      0       5        20979        153  0.729
10     0      10        98442        152  0.154
11     1       1        38178       5754 15.072
12     1       2        24816       2488 10.026
13     1       3        41454       2827  6.820
15     1       5        49245       1880  3.818
20     1      10        44031        366  0.831
21     2       1        51468      20641 40.105
22     2       2        67180      18709 27.849
23     2       3        67021      11622 17.341
25     2       5        78382       7200  9.186
30     2      10        40798       1014  2.485
31     3       1        95656      62308 65.138
32     3       2        92602      40868 44.133
33     3       3        37710      11836 31.387
35     3       5        43539       7628 17.520
40     3      10         8874        308  3.471
 [1] 36.8 25.8 11.2  9.6  7.0  3.1  2.5  2.1  1.2  0.8
[1] 18.8
5. Moc testu A/B i przeplatania: Rysunek 4
R
# Przepis 5. Moc: test A/B na konwersji z wyszukiwania vs test przeplatania przy tej samej liczbie sesji
# (Rysunek 4). Korzysta z wyników przepisu 4: konw, przepl, kol, motyw.
# Sesje są niezależne, więc liczba zakupów w grupie testu A/B ma rozkład dwumianowy, a liczby sesji
# wygranych przez A, B i remisów w teście przeplatania – rozkład wielomianowy z odsetkami z przepisu 4.
sesje_lacznie <- c(250, 500, 1000, 2000, 4000, 8000, 16000, 32000, 64000, 128000)
n_powt <- 2000
set.seed(6854)
moc <- do.call(rbind, lapply(sesje_lacznie, function(N) {
  # Test A/B: połowa sesji widzi A, połowa B; test z dla dwóch odsetków, α = .05 dwustronnie
  n <- N / 2
  xA <- rbinom(n_powt, n, konw[["A"]]); xB <- rbinom(n_powt, n, konw[["B"]])
  pp <- (xA + xB) / (2 * n); z <- (xB / n - xA / n) / sqrt(pp * (1 - pp) * 2 / n)
  ab <- mean(z > qnorm(0.975), na.rm = TRUE)            # istotnie i we właściwą stronę (B lepszy)
  # Przeplatanie: wszystkie N sesji widzą listę przeplataną; test znaków na sesjach rozstrzygniętych
  w <- rmultinom(n_powt, N, c(przepl[["wygrywa A"]], przepl[["wygrywa B"]], przepl[["remis"]]))
  p_znak <- pbinom(w[1, ], w[1, ] + w[2, ], 0.5)          # jednostronnie, H1: B wygrywa częściej
  il <- mean(2 * p_znak < 0.05 & w[2, ] > w[1, ])
  data.frame(sesje = N, test = c("test A/B (konwersja)", "przeplatanie (kliknięcia)"), moc = c(ab, il))
}))
moc$blad_mc <- sqrt(moc$moc * (1 - moc$moc) / n_powt)    # błąd Monte Carlo odsetka
print(moc, digits = 3)
# Ile sesji potrzeba do mocy 80%? A/B ze wzoru (power.prop.test), przeplatanie z przybliżenia normalnego
ab80 <- 2 * ceiling(power.prop.test(p1 = konw[["A"]], p2 = konw[["B"]], power = 0.8)$n)
q_roz <- przepl[["wygrywa A"]] + przepl[["wygrywa B"]]; pi_B <- przepl[["wygrywa B"]] / q_roz
il80 <- ceiling(((qnorm(0.975) * 0.5 + qnorm(0.8) * sqrt(pi_B * (1 - pi_B))) / (pi_B - 0.5))^2 / q_roz)
c(sesje_AB_80 = ab80, sesje_przeplatanie_80 = il80, ile_razy_mniej = round(ab80 / il80, 1))

# Rysunek 4: krzywe mocy na logarytmicznej osi liczby sesji
p4 <- ggplot(moc, aes(sesje, 100 * moc, colour = test, shape = test, linetype = test)) +
  geom_hline(yintercept = 80, colour = "grey40", linetype = "dotted") +
  geom_ribbon(aes(ymin = 100 * (moc - 1.96 * blad_mc), ymax = 100 * (moc + 1.96 * blad_mc), fill = test),
              colour = NA, alpha = 0.2) +
  geom_line(linewidth = 1) + geom_point(size = 2.8) +
  annotate("text", x = 250, y = 84, label = "moc 80%", hjust = 0, size = 3.4, colour = "grey30") +
  scale_x_log10(breaks = sesje_lacznie, labels = c("250", "500", "1 tys.", "2 tys.", "4 tys.", "8 tys.",
                                                  "16 tys.", "32 tys.", "64 tys.", "128 tys.")) +
  scale_colour_manual(values = c(kol[["B"]], kol[["A"]]), name = NULL) +
  scale_fill_manual(values = c(kol[["B"]], kol[["A"]]), name = NULL) +
  scale_shape_manual(values = c(17, 16), name = NULL) +
  scale_linetype_manual(values = c("solid", "longdash"), name = NULL) +
  labs(x = "Liczba sesji wyszukiwania w teście (łącznie, skala logarytmiczna)",
       y = "Moc: odsetek testów wskazujących B (%)",
       title = "Ta sama decyzja „B jest lepszy” – przy ilu sesjach?") + motyw
p4   # zapis: ggsave("wyszukiwarka-moc-ab-przeplatanie.svg", p4, width = 10, height = 5.2)
Wynik w R
    sesje                      test    moc blad_mc
1     250      test A/B (konwersja) 0.0395 0.00436
2     250 przeplatanie (kliknięcia) 0.2920 0.01017
3     500      test A/B (konwersja) 0.0500 0.00487
4     500 przeplatanie (kliknięcia) 0.5620 0.01109
5    1000      test A/B (konwersja) 0.0750 0.00589
6    1000 przeplatanie (kliknięcia) 0.8550 0.00787
7    2000      test A/B (konwersja) 0.1060 0.00688
8    2000 przeplatanie (kliknięcia) 0.9930 0.00186
9    4000      test A/B (konwersja) 0.1595 0.00819
10   4000 przeplatanie (kliknięcia) 1.0000 0.00000
11   8000      test A/B (konwersja) 0.2860 0.01010
12   8000 przeplatanie (kliknięcia) 1.0000 0.00000
13  16000      test A/B (konwersja) 0.4780 0.01117
14  16000 przeplatanie (kliknięcia) 1.0000 0.00000
15  32000      test A/B (konwersja) 0.7605 0.00954
16  32000 przeplatanie (kliknięcia) 1.0000 0.00000
17  64000      test A/B (konwersja) 0.9685 0.00391
18  64000 przeplatanie (kliknięcia) 1.0000 0.00000
19 128000      test A/B (konwersja) 1.0000 0.00000
20 128000 przeplatanie (kliknięcia) 1.0000 0.00000
          sesje_AB_80 sesje_przeplatanie_80        ile_razy_mniej
              34674.0                 840.0                  41.3
6. Zapytania częste, rzadkie i bez wyników: Rysunek 5
R
# Przepis 6. Zapytania częste vs rzadkie i zapytania bez wyników (Rysunek 5)
# Korzysta z obiektów przepisów 1, 3 i 4: zapytania, metryki, sesje, kol, motyw.
# (a) NDCG@10: różnica B − A w grupach zapytań, bootstrap zapytań wewnątrz grupy
set.seed(6855)
grupy <- do.call(rbind, lapply(split(metryki, metryki$grupa), function(d) {
  r <- d$NDCG_B - d$NDCG_A
  b <- replicate(2000, mean(sample(r, replace = TRUE)))
  data.frame(grupa = d$grupa[1], zapytan = nrow(d), roznica = mean(r),
             dolna = quantile(b, .025), gorna = quantile(b, .975), B_lepszy_proc = 100 * mean(r > 0))
}))
rownames(grupy) <- NULL
print(grupy, digits = 3)
# (b) Te same grupy w dziennikach sesji: konwersja A i B oraz odsetek wygranych B w przeplataniu
s <- sesje[!is.na(sesje$zakup), ]
konw_gr <- 100 * tapply(s$zakup, list(s$grupa, s$dziennik), mean)[, c("A", "B")]
roz <- s[s$dziennik == "przeplatanie" & s$wynik_przepl != "remis", ]
wyg_gr <- 100 * tapply(roz$wynik_przepl == "wygrywa B", roz$grupa, mean)
round(cbind(konw_gr, roznica_pp = konw_gr[, "B"] - konw_gr[, "A"], B_wygrywa_proc = wyg_gr), 2)
# (c) Zapytania bez wyników: odsetek różnych zapytań i odsetek sesji w grupach
zero <- data.frame(grupa = levels(zapytania$grupa),
  zapytan_proc = 100 * tapply(zapytania$zero_wynikow, zapytania$grupa, mean),
  sesji_proc = 100 * tapply(zapytania$udzial_sesji * zapytania$zero_wynikow, zapytania$grupa, sum) /
               tapply(zapytania$udzial_sesji, zapytania$grupa, sum))
rownames(zero) <- NULL
print(zero, digits = 3)
c(sesji_bez_wynikow_proc = round(100 * mean(is.na(gA[sesje$zapytanie, 1])), 2),
  remisy_z_braku_wynikow_proc = round(100 * mean(is.na(gA[sesje$zapytanie[sesje$dziennik == "przeplatanie"], 1])), 2))

# Rysunek 5
grupy$grupa <- factor(grupy$grupa, levels = rev(levels(zapytania$grupa)))
pA <- ggplot(grupy, aes(roznica, grupa)) +
  geom_vline(xintercept = 0, colour = "grey40", linetype = "dashed") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.2, linewidth = 0.9, orientation = "y", colour = kol[["ciemny"]]) +
  geom_point(aes(shape = roznica > 0, colour = roznica > 0), size = 3.4) +
  geom_text(aes(label = sub("-", "−", sub("^([+-])0", "\\1", sprintf("%+.3f\n(%d zapytań)", roznica, zapytan)))), vjust = -0.6, size = 3.3,
            colour = "grey20", lineheight = 0.9) +
  scale_colour_manual(values = c(`TRUE` = kol[["B"]], `FALSE` = kol[["A"]]), guide = "none") +
  scale_shape_manual(values = c(`TRUE` = 17, `FALSE` = 16), guide = "none") +
  scale_y_discrete(expand = expansion(add = c(0.5, 0.9))) +
  labs(x = "NDCG@10: B − A (95% CI)", y = NULL, title = "A. Nowy algorytm a popularność zapytania") + motyw
zero_d <- rbind(data.frame(grupa = zero$grupa, miara = "różne zapytania", proc = zero$zapytan_proc),
                data.frame(grupa = zero$grupa, miara = "sesje", proc = zero$sesji_proc))
zero_d$grupa <- factor(sub(" \\(", "\n(", zero_d$grupa), levels = sub(" \\(", "\n(", levels(zapytania$grupa)))
pB <- ggplot(zero_d, aes(grupa, proc, fill = miara)) +
  geom_col(position = position_dodge(width = 0.75), width = 0.7) +
  geom_text(aes(label = sprintf("%.1f%%", proc)), position = position_dodge(width = 0.75), vjust = -0.4, size = 3.3) +
  scale_fill_manual(values = c(kol[["zolty"]], kol[["ciemny"]]), name = NULL) +
  scale_y_continuous(limits = c(0, max(zero_d$proc) * 1.18)) +
  labs(x = NULL, y = "Bez wyników (%)", title = "B. Zapytania bez wyników") + motyw
p5 <- pA + pB + plot_layout(widths = c(1.1, 1))
p5   # zapis: ggsave("wyszukiwarka-czeste-rzadkie-bez-wynikow.svg", p5, width = 10, height = 5)
Wynik w R
              grupa zapytan roznica    dolna   gorna B_lepszy_proc
1     częste (1–20)      20  0.1117  0.05856  0.1688          85.0
2  średnie (21–100)      76  0.0338  0.00389  0.0633          63.2
3 rzadkie (101–400)     261 -0.0610 -0.07813 -0.0431          32.6
                     A     B roznica_pp B_wygrywa_proc
częste (1–20)     9.68 11.29        1.6          60.27
średnie (21–100)  8.18  8.77        0.6          53.29
rzadkie (101–400) 7.65  6.95       -0.7          46.61
              grupa zapytan_proc sesji_proc
1     częste (1–20)            0       0.00
2  średnie (21–100)            5       5.15
3 rzadkie (101–400)           13      12.88
     sesji_bez_wynikow_proc remisy_z_braku_wynikow_proc
                       3.96                        3.96
7. Grafika: schemat przeplatania (Rysunek 3)
R
# Przepis 7. Grafika: jak działa przeplatanie team-draft na przykładzie zapytania z przepisu 2 (Rysunek 3)
# Korzysta z: produkty, lista_A, lista_B (przepis 2), team_draft() (przepis 4), kol, motyw.
set.seed(6856)
td <- team_draft(lista_A, lista_B)
data.frame(pozycja = 1:10, produkt = produkty$produkt[td$lista], druzyna = td$druzyna,
           ocena = produkty$ocena[td$lista])
# Przykładowe kliknięcia użytkownika (ustalone ręcznie do ilustracji): pozycje 1, 2 i 4 listy przeplatanej
klikniete <- c(1, 2, 4)
table(druzyna = td$druzyna[klikniete])

k <- 6                                                   # na grafice pokazujemy 6 pierwszych pozycji
krotko <- function(i) sub(" 5–10 mm", "", produkty$produkt[i])   # krótsze etykiety na grafice
kolumny <- rbind(
  data.frame(x = 1.0, y = 1:k, etyk = krotko(lista_A[1:k]), druzyna = "A", prod = lista_A[1:k]),
  data.frame(x = 3.6, y = 1:k, etyk = krotko(lista_B[1:k]), druzyna = "B", prod = lista_B[1:k]),
  data.frame(x = 2.3, y = 1:k, etyk = krotko(td$lista[1:k]), druzyna = td$druzyna[1:k], prod = td$lista[1:k]))
kolumny$klik <- kolumny$x == 2.3 & kolumny$y %in% klikniete
# Strzałki: z listy, której drużyna wybrała produkt, do pozycji na liście przeplatanej
strz <- do.call(rbind, lapply(1:k, function(p) {
  zr <- if (td$druzyna[p] == "A") lista_A else lista_B
  y0 <- match(td$lista[p], zr)
  if (is.na(y0) || y0 > k) return(NULL)
  data.frame(x0 = if (td$druzyna[p] == "A") 1.45 else 3.15, y0 = y0,
             x1 = if (td$druzyna[p] == "A") 1.85 else 2.75, y1 = p, druzyna = td$druzyna[p])
}))
p1 <- ggplot() +
  geom_segment(data = strz, aes(x = x0, y = y0, xend = x1, yend = y1, colour = druzyna),
               arrow = arrow(length = unit(0.18, "cm"), type = "closed"), linewidth = 0.6) +
  geom_rect(data = kolumny, aes(xmin = x - 0.45, xmax = x + 0.45, ymin = y - 0.38, ymax = y + 0.38,
                                colour = druzyna, linetype = druzyna), fill = "white", linewidth = 0.9) +
  geom_rect(data = kolumny[kolumny$klik, ], aes(xmin = x - 0.45, xmax = x + 0.45, ymin = y - 0.38, ymax = y + 0.38),
            fill = kol[["jasny"]], colour = NA, alpha = 0.6) +
  geom_text(data = kolumny, aes(x = x - 0.41, y = y, label = paste0(y, ". ", etyk), fontface = ifelse(klik, "bold", "plain")),
            hjust = 0, size = 3.0, colour = "grey15") +
  geom_label(data = kolumny[kolumny$x == 2.3, ], aes(x = x + 0.395, y = y, label = druzyna, fill = druzyna),
             colour = "white", size = 3.0, fontface = "bold", linewidth = 0) +
  annotate("text", x = c(1, 2.3, 3.6), y = 0.25, label = c("Lista algorytmu A", "Lista przeplatana (to widzi klient)",
           "Lista algorytmu B"), fontface = "bold", size = 3.6, colour = "#0f1d3a") +
  annotate("text", x = 2.3, y = k + 0.85, size = 3.4, colour = "grey20",
           label = paste0("Szare tło = kliknięcie. Kliknięcia: ", sum(td$druzyna[klikniete] == "B"), " w produkty drużyny B, ",
                          sum(td$druzyna[klikniete] == "A"), " w produkt drużyny A → sesję wygrywa B")) +
  scale_colour_manual(values = c(A = kol[["A"]], B = kol[["B"]]), guide = "none") +
  scale_fill_manual(values = c(A = kol[["A"]], B = kol[["B"]]), guide = "none") +
  scale_linetype_manual(values = c(A = "solid", B = "longdash"), guide = "none") +
  scale_y_reverse() + coord_cartesian(xlim = c(0.52, 4.08), ylim = c(k + 1.1, 0)) +
  labs(title = "Przeplatanie team-draft: zapytanie „wiertło do betonu 8 mm”",
       subtitle = paste("Rzut monetą decyduje, która drużyna wybiera pierwsza w parze rund; drużyna dokłada swój",
                        "najwyżej\nustawiony produkt, którego jeszcze nie ma na liście. Klient widzi jedną listę bez oznaczeń.")) +
  motyw + theme(axis.text = element_blank(), axis.title = element_blank(), panel.grid.major = element_blank())
p1   # zapis: ggsave("wyszukiwarka-schemat-przeplatania.svg", p1, width = 10, height = 5.6)
Wynik w R
   pozycja                          produkt druzyna ocena
1        1      wiertło SDS-plus 8 × 160 mm       B     3
2        2           wiertło do drewna 8 mm       A     1
3        3       wiertło do metalu HSS 8 mm       A     1
4        4     wiertło do betonu 8 × 120 mm       B     3
5        5             kołki rozporowe 8 mm       A     1
6        6 zestaw wierteł do betonu 5–10 mm       B     2
7        7          wiertarka udarowa 750 W       A     0
8        8      wiertło SDS-plus 8 × 210 mm       B     2
9        9          wiertło do glazury 8 mm       A     1
10      10           dłuto płaskie SDS-plus       B     0
druzyna
A B
1 2
8. Czy paleta przetrwa zaburzenia widzenia barw?
R
# Przepis 8. Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober (algorytm A / B)" = c("#0072B2", "#D55E00"),
             "cynober – pomarańczowy (ocena 3 / 2; częste / średnie)" = c("#D55E00", "#E69F00"),
             "pomarańczowy – niebieski (ocena 2 / 1; średnie / rzadkie)" = c("#E69F00", "#0072B2"),
             "niebieski – szary (ocena 1 / 0)" = c("#0072B2", "#8C8C8C"),
             "cynober – ciemnoszary (dwie średnie różnicy)" = c("#D55E00", "#333333"),
             "pomarańczowy – ciemnoszary (zapytania / sesje)" = c("#E69F00", "#333333"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                          widzenie_typowe
niebieski – cynober (algorytm A / B)                                114.6
cynober – pomarańczowy (ocena 3 / 2; częste / średnie)               33.4
pomarańczowy – niebieski (ocena 2 / 1; średnie / rzadkie)           120.2
niebieski – szary (ocena 1 / 0)                                      43.2
cynober – ciemnoszary (dwie średnie różnicy)                         83.4
pomarańczowy – ciemnoszary (zapytania / sesje)                       91.0
czerwony – zielony (do unikania)                                    121.7
                                                          deuteranopia
niebieski – cynober (algorytm A / B)                             108.3
cynober – pomarańczowy (ocena 3 / 2; częste / średnie)            18.4
pomarańczowy – niebieski (ocena 2 / 1; średnie / rzadkie)        121.5
niebieski – szary (ocena 1 / 0)                                   47.1
cynober – ciemnoszary (dwie średnie różnicy)                      72.7
pomarańczowy – ciemnoszary (zapytania / sesje)                    89.7
czerwony – zielony (do unikania)                                  21.1
                                                          protanopia
niebieski – cynober (algorytm A / B)                            91.9
cynober – pomarańczowy (ocena 3 / 2; częste / średnie)          24.9
pomarańczowy – niebieski (ocena 2 / 1; średnie / rzadkie)      109.3
niebieski – szary (ocena 1 / 0)                                 39.2
cynober – ciemnoszary (dwie średnie różnicy)                    59.9
pomarańczowy – ciemnoszary (zapytania / sesje)                  83.3
czerwony – zielony (do unikania)                                31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, metryki rankingu, bootstrap, test t, test z, test znaków i power.prop.test() – pakiety base i stats). Rysunki wykonano w ggplot2 i złożono pakietem patchwork; pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Średnia po zapytaniach albo po sesjach bez komentarza. W przykładzie dają przeciwne wnioski.
- Kliknięcia jako oceny trafności – obciążenie pozycji zawyża produkty stojące wysoko.
- Przeplatanie bez losowania kolejności drużyn albo z wynikiem traktowanym jako przyrost sprzedaży.
- Pominięcie zapytań bez wyników – żadna miara rankingu ich nie widzi.
- Zaglądanie do testu i zatrzymanie przy pierwszym p < .05 – zob. pułapki testów A/B.
Najczęstsze pytania
Jak policzyć NDCG krok po kroku?
Każdą ocenę trafności (np. 0–3) na pozycji i podziel przez log₂(i + 1) i zsumuj dla pierwszych k pozycji – to DCG@k. Tak samo policz DCG dla idealnej kolejności tych produktów (IDCG) i podziel jedno przez drugie. W przykładzie lista z dwoma najlepszymi wiertłami na 3. i 7. miejscu miała DCG@10 = 6.253 przy IDCG@10 = 8.146, czyli NDCG@10 = .768 (Järvelin i Kekäläinen, 2002).
Czym różni się MRR od NDCG?
MRR patrzy tylko na pozycję pierwszego trafnego wyniku (1/pozycja, uśrednione po zapytaniach) i traktuje trafność jako tak/nie. NDCG uwzględnia stopnie trafności i całą listę do pozycji k. MRR pasuje, gdy klient szuka jednego produktu, NDCG – gdy przegląda kilka propozycji. W przykładzie zmiana algorytmu przesunęła MRR mniej niż NDCG.
Co to jest test przeplatania (interleaving) wyszukiwarki?
Każdy użytkownik widzi jedną listę złożoną z wyników dwóch algorytmów; w wariancie team-draft rzut monetą decyduje, który algorytm dokłada produkt pierwszy. Sesję wygrywa algorytm, którego produkty kliknięto więcej razy. Porównania na liście przeplatanej okazały się czulsze niż bezwzględne miary użycia (Radlinski i in., 2008). W przykładzie dały moc 80% przy 840 sesjach.
Dlaczego CTR według pozycji nie mierzy trafności wyników?
Bo kliknięcia są obciążone pozycją: użytkownicy czytają listę od góry i rzadko schodzą nisko (Craswell i in., 2008). W symulacji produkt najwyższej trafności był klikany w 65.1% wyświetleń na 1. miejscu i w 3.5% na 10. Kliknięcia lepiej nadają się do porównań względnych – np. w teście przeplatania – niż do bezwzględnych ocen (Joachims i in., 2005).
Czy test przeplatania zastępuje test A/B wyszukiwarki?
Nie całkiem. Przeplatanie szybko mówi, który ranking klienci wolą, ale nie mówi, o ile wzrośnie konwersja czy przychód. Użyj go jako sita dla kilku wersji, a zwycięzcę potwierdź testem A/B na metryce biznesowej. W przykładzie test A/B wymagał 41.3 raza więcej sesji niż przeplatanie, by z mocą 80% wskazać lepszy algorytm.
Powiązane hasła
Przeczytaj też
Test A/B – plan i analiza
Metryka główna, liczebność z power.prop.test, losowanie i czas trwania, skutki podglądania wyników w symulacji oraz różnica odsetków z CI i względny wzrost.
Czytaj →PoradnikAnaliza koszykowa i rekomendacje
Wsparcie, ufność i lift na przykładzie sklepu z kawą, sieć reguł, test na nowych paragonach i rekomendacje „klienci kupili też” z kodem R.
Czytaj →PoradnikDługoterminowy holdout personalizacji – efekt po pół roku i zanik nowości
Czytaj →PoradnikPozycja w wynikach a CTR – efekt pozycji
Noclegi w agroturystykach: krzywa CTR z logów, błąd selekcji, eksperyment z zamianą pozycji i regresja beta-dwumianowa – sześć rysunków z kodem R.
Czytaj →Porównujesz algorytmy wyszukiwania albo rankingi w pracy?
Pomożemy dobrać metryki rankingu, zaplanować ocenę offline i eksperyment online, policzyć przedziały i moc oraz opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Chapelle, O., Joachims, T., Radlinski, F., & Yue, Y. (2012). Large-scale validation and analysis of interleaved search evaluation. ACM Transactions on Information Systems, 30(1), 1–41. https://doi.org/10.1145/2094072.2094078
- Craswell, N., Zoeter, O., Taylor, M., & Ramsey, B. (2008). An experimental comparison of click position-bias models. In Proceedings of the International Conference on Web Search and Web Data Mining (WSDM '08) (pp. 87–94). Association for Computing Machinery. https://doi.org/10.1145/1341531.1341545
- Hofmann, K., Li, L., & Radlinski, F. (2016). Online evaluation for information retrieval. Foundations and Trends in Information Retrieval, 10(1), 1–117. https://doi.org/10.1561/1500000051
- Järvelin, K., & Kekäläinen, J. (2002). Cumulated gain-based evaluation of IR techniques. ACM Transactions on Information Systems, 20(4), 422–446. https://doi.org/10.1145/582415.582418
- Joachims, T., Granka, L., Pan, B., Hembrooke, H., & Gay, G. (2005). Accurately interpreting clickthrough data as implicit feedback. In Proceedings of the 28th Annual International ACM SIGIR Conference on Research and Development in Information Retrieval (pp. 154–161). Association for Computing Machinery. https://doi.org/10.1145/1076034.1076063
- Kohavi, R., Tang, D., & Xu, Y. (2020). Trustworthy online controlled experiments: A practical guide to A/B testing. Cambridge University Press. https://doi.org/10.1017/9781108653985
- Radlinski, F., Kurup, M., & Joachims, T. (2008). How does clickthrough data reflect retrieval quality? In Proceedings of the 17th ACM Conference on Information and Knowledge Management (pp. 43–52). Association for Computing Machinery. https://doi.org/10.1145/1458082.1458092
Cytowania BibTeX
@article{chapelle2012large, author={Chapelle, Olivier and Joachims, Thorsten and Radlinski, Filip and Yue, Yisong}, title={{Large-scale validation and analysis of interleaved search evaluation}}, journal={ACM Transactions on Information Systems}, year={2012}, volume={30}, number={1}, pages={1--41}, doi={10.1145/2094072.2094078}}@inproceedings{craswell2008experimental, author={Craswell, Nick and Zoeter, Onno and Taylor, Michael and Ramsey, Bill}, title={{An experimental comparison of click position-bias models}}, booktitle={Proceedings of the International Conference on Web Search and Web Data Mining (WSDM '08)}, year={2008}, pages={87--94}, publisher={Association for Computing Machinery}, doi={10.1145/1341531.1341545}}@article{hofmann2016online, author={Hofmann, Katja and Li, Lihong and Radlinski, Filip}, title={{Online evaluation for information retrieval}}, journal={Foundations and Trends in Information Retrieval}, year={2016}, volume={10}, number={1}, pages={1--117}, doi={10.1561/1500000051}}@article{jarvelin2002cumulated, author={J{\"a}rvelin, Kalervo and Kek{\"a}l{\"a}inen, Jaana}, title={{Cumulated gain-based evaluation of IR techniques}}, journal={ACM Transactions on Information Systems}, year={2002}, volume={20}, number={4}, pages={422--446}, doi={10.1145/582415.582418}}@inproceedings{joachims2005accurately, author={Joachims, Thorsten and Granka, Laura and Pan, Bing and Hembrooke, Helene and Gay, Geri}, title={{Accurately interpreting clickthrough data as implicit feedback}}, booktitle={Proceedings of the 28th Annual International ACM SIGIR Conference on Research and Development in Information Retrieval}, year={2005}, pages={154--161}, publisher={Association for Computing Machinery}, doi={10.1145/1076034.1076063}}@book{kohavi2020trustworthy, author={Kohavi, Ron and Tang, Diane and Xu, Ya}, title={{Trustworthy online controlled experiments: A practical guide to A/B testing}}, year={2020}, publisher={Cambridge University Press}, doi={10.1017/9781108653985}}@inproceedings{radlinski2008clickthrough, author={Radlinski, Filip and Kurup, Madhu and Joachims, Thorsten}, title={{How does clickthrough data reflect retrieval quality?}}, booktitle={Proceedings of the 17th ACM Conference on Information and Knowledge Management}, year={2008}, pages={43--52}, publisher={Association for Computing Machinery}, doi={10.1145/1458082.1458092}}