Przykład: platforma z noclegami w agroturystykach
Fikcyjna platforma zbiera oferty 300 gospodarstw agroturystycznych. Ktoś wpisuje termin, region i liczbę osób, a wyszukiwarka pokazuje listę 10 ofert. Właściciele pytają dział marketingu, ile da im wyższe miejsce na liście. Dział chce też sprzedawać płatne wyróżnienie. Pytanie brzmi: o ile wzrośnie liczba kliknięć, gdy oferta przesunie się z 6. na 3. miejsce?
CTR (ang. click-through rate) to odsetek wyświetleń zakończonych kliknięciem. W logach z 30 dni (150 000 wyszukiwań, 62.1% z telefonu) CTR spada z 21.24% na 1. pozycji do 0.70% na 10. Na komputerze 3. pozycja ma CTR 8.71%, a 6. – 3.88%, czyli 2.24 raza mniej. Na telefonie: 6.91% i 2.19%, czyli 3.15 raza mniej. Kusi odpowiedź: „z 6. na 3. miejsce – ponad dwa razy więcej kliknięć”. Pokażemy, dlaczego to za dużo.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Parametry ustawiliśmy ręcznie. Każdą ofertę ktoś klika, jeśli ją obejrzy i jeśli mu się spodoba. Szansę obejrzenia wyznacza pozycja: na komputerze 100% na 1. miejscu, 66% na 3. i 42% na 6.; na telefonie 100%, 52% i 24%, bo na ekranie mieści się mniej wyników. To jest prawdziwy efekt pozycji: z 6. na 3. miejsce daje 1.57 raza więcej kliknięć na komputerze i 2.17 raza więcej na telefonie. Atrakcyjność oferty zależy od niej samej (zdjęcia, cena, opinie), od dopasowania do konkretnego wyszukiwania i od dnia. Algorytm układa listę według swojej, niedoskonałej oceny tej atrakcyjności. Po kliknięciu rezerwuje ok. 11% osób, niezależnie od pozycji. Dane zbiorcze (wyświetlenia, kliknięcia i rezerwacje według okresu, urządzenia, oferty, rangi i pozycji) pobierzesz jako agroturystyki-pozycja-klikniecia.csv.
Rysunek 1: krzywa CTR z logów a prawdziwy efekt pozycji
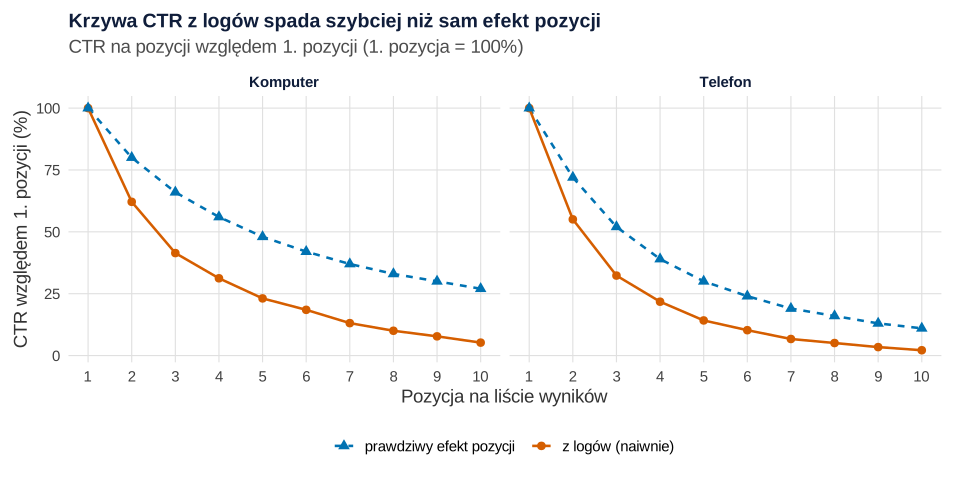
set.seed(701)).Co widać. Krzywa z logów spada dużo szybciej niż sam efekt pozycji. Na komputerze 6. pozycja ma w logach 18.5% CTR pierwszej, choć sama pozycja odbiera tylko 58% kliknięć (zostaje 42%). Na telefonie: 10.2% wobec 24%.
Jak może zmylić. Krzywa z logów to dwa zjawiska naraz: efekt pozycji i to, że na górze stoją inne oferty niż na dole. Że kliknięcia zależą od kolejności prezentacji, pokazali Craswell i in. (2008), zaburzając ranking dużej wyszukiwarki. W prawdziwych danych linii przerywanej nie znasz – trzeba ją zmierzyć.
Podpis do pracy:
Rysunek 2: skąd bierze się błąd selekcji
Algorytm nie stawia ofert na pozycjach losowo. Wyżej trafiają te, które jego zdaniem lepiej pasują – i często ma rację. To klasyczny błąd selekcji: o tym, co porównujemy na pozycji 3 i 6, decyduje mechanizm związany z wynikiem. Atrakcyjność oferty działa jak zmienna zakłócająca: podnosi i pozycję, i szansę kliknięcia.
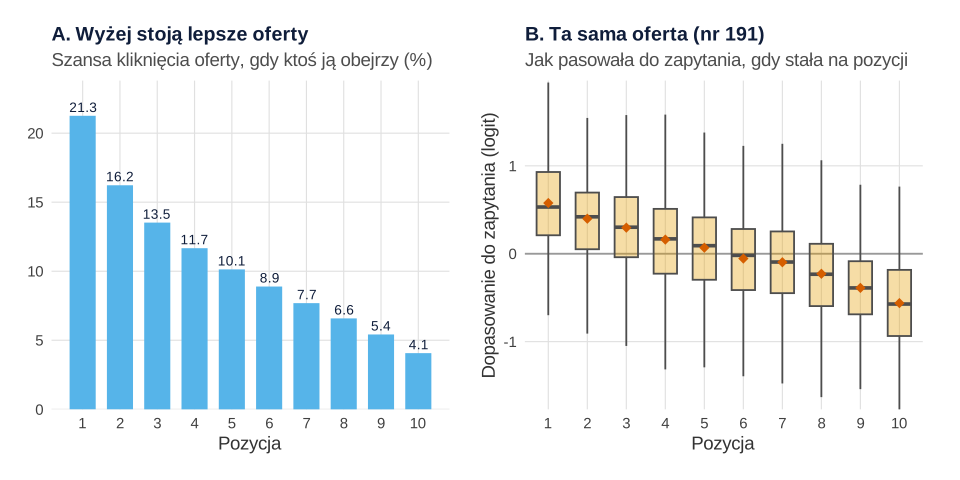
set.seed(701)).Co widać. Obejrzana oferta z 1. pozycji jest klikana w 21.3% przypadków, z 3. – w 13.5%, z 6. – w 8.9%. Oferty z 3. miejsca są więc same z siebie 1.52 raza atrakcyjniejsze niż z 6. Stosunek CTR z logów to iloczyn dwóch czynników: na komputerze 1.57 (pozycja) × 1.52 (oferty) ≈ 2.38, a w logach wyszło 2.24 – resztę różnicy robi losowość kliknięć. Panel B pokazuje ofertę nr 191, która w logach stała na 6. miejscu 631 razy: na górze listy lądowała wtedy, gdy lepiej pasowała do zapytania (średnie dopasowanie 0.30 na 3. pozycji, −0.05 na 6.).
Jak może zmylić. Panel B to argument przeciw prostemu „dodam efekt oferty i po kłopocie”. Porównanie tej samej oferty na różnych pozycjach usuwa jej stałą jakość, ale nie dopasowanie do konkretnego wyszukiwania. Szerzej o tym mechanizmie piszemy we wpisie o błędzie selekcji i zmiennej zderzeniowej w praktyce.
Podpis do pracy:
Rysunek 3: eksperyment z zamianą sąsiednich pozycji
Najpewniejszy sposób to randomizacja: losowo zmienić pozycję tych samych ofert. Losowe tasowanie całej listy byłoby kosztowne dla użytkowników, więc platforma przez 28 dni robiła coś łagodniejszego. W 40% wyszukiwań (55 627 list) losowano jeden z dwóch układów par: 1–2, 3–4, …, 9–10 albo 2–3, 4–5, …, 8–9. Każdą parę zamieniano z prawdopodobieństwem 1/2. Wang i in. (2018) porównali schematy losowego przestawiania wyników (tasowanie czołówki listy i zamianę par) i pokazali, że pogarszają one doświadczenie użytkowników – dlatego robi się je na części ruchu.
Logika jest prosta. Na pozycję k i k + 1 trafiają w tym układzie oferty o tej samej średniej atrakcyjności, bo o kolejności zdecydował rzut monetą. Stosunek CTR(k + 1) / CTR(k) mierzy więc sam efekt pozycji. Pomnożenie kolejnych stosunków daje całą krzywą.
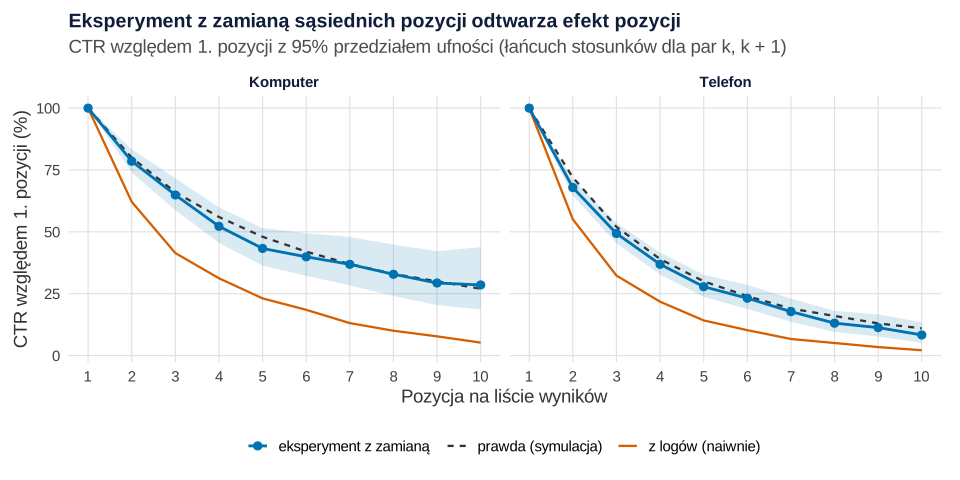
set.seed(701)).Co widać. Krzywa z eksperymentu leży na linii prawdy. Na komputerze 6. pozycja ma 39.9% CTR pierwszej, 95% CI [32.2, 49.5] (prawda 42%), na telefonie 23.2% [18.8, 28.6] (prawda 24%). Przejście z 6. na 3. pozycję daje na komputerze 1.63 raza więcej kliknięć, 95% CI [1.34, 1.97], a na telefonie 2.13 [1.76, 2.58]. Prawda: 1.57 i 2.17. Logi obiecywały 2.24 i 3.15.
Jak może zmylić. Każdy krok łańcucha dokłada niepewności, więc pasmo rośnie ku dołowi listy. Przedział liczymy metodą delta na skali logarytmu, zakładając niezależność par. Ursu (2018) przeanalizowała eksperyment terenowy z losową zmianą rankingu w dużym serwisie rezerwacji podróży: oszacowany efekt pozycji był mniejszy niż w badaniach bez losowej zmienności rankingu.
Podpis do pracy:
Rysunek 4: regresja logistyczna i beta-dwumianowa z efektem oferty
Ten sam efekt da się oszacować regresją. Dane zbiorcze to komórki: oferta × ranga nadana przez algorytm × pozycja pokazana × urządzenie, z liczbą wyświetleń i kliknięć. Porównujemy pięć podejść, osobno dla komputera i telefonu:
- logi, surowy stosunek CTR;
- logi, regresja logistyczna z pozycją i stałym efektem każdej z 300 ofert (o efektach stałych i losowych piszemy osobno);
- eksperyment, regresja logistyczna z pozycją i rangą od algorytmu (ranga ustala, które oferty porównujemy; losowa jest tylko zamiana);
- eksperyment, ta sama regresja z rozkładem beta-dwumianowym;
- eksperyment, regresja logistyczna z rangą i efektem oferty.
Model beta-dwumianowy przydaje się, gdy kliknięcia w komórce są bardziej zmienne, niż przewiduje rozkład dwumianowy. Tak jest tu: oferty w tej samej komórce różnią się atrakcyjnością, więc pojawia się nadmierna dyspersja. Rozkład beta-dwumianowy zakłada, że prawdopodobieństwo sukcesu zmienia się między seriami prób – tak go opisał Skellam (1948). Współczynniki logitowe przeliczamy na mnożnik CTR typowej oferty: na 6. pozycji ma ona CTR 3.68% (komputer) albo 2.10% (telefon).
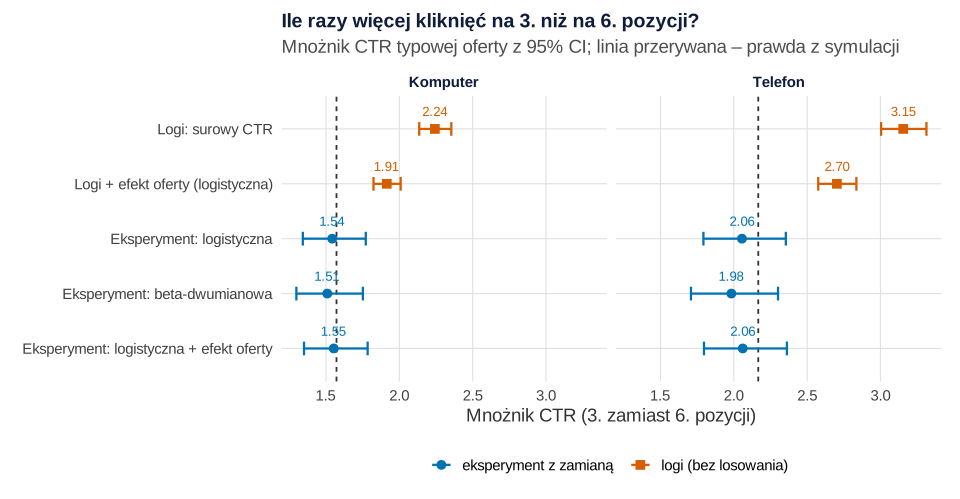
set.seed(701)).Co widać. Efekt oferty w logach pomaga tylko częściowo: na komputerze 1.91, 95% CI [1.82, 2.01], na telefonie 2.70 [2.58, 2.84] – wciąż daleko od prawdy (1.57 i 2.17). Wszystkie trzy modele z eksperymentu obejmują prawdę: regresja logistyczna daje 1.54 [1.34, 1.77] i 2.06 [1.79, 2.35], beta-dwumianowa 1.51 [1.30, 1.75] i 1.98 [1.71, 2.30], logistyczna z efektem oferty 1.55 [1.35, 1.78] i 2.06 [1.80, 2.36]. W modelu logistycznym statystyka Pearsona χ²/df wynosi 1.57 (komputer) i 1.72 (telefon), a model beta-dwumianowy ma niższe AIC (27 742.3 wobec 29 216.8 na komputerze).
Jak może zmylić. Wąski przedział z logów nie oznacza dobrego oszacowania – jest precyzyjny, ale obciążony. Beta-dwumianowa poszerzyła przedział tylko trochę, bo pozycję losowano wśród ofert o tej samej randze. Podobny wniosek dla reklam w wyszukiwarce przedstawili Narayanan i Kalyanam (2015): naiwne porównania pozycji wskazywały bardzo duże efekty, a oszacowania z regresji nieciągłej – znacznie mniejsze.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: z 6. na 3. miejsce – kliknięcia i rezerwacje
Właściciel oferty nr 191 pyta o konkretną liczbę. W 30 dniach jego oferta stała na 6. miejscu 631 razy (236 na komputerze, 395 na telefonie). Prognozę liczymy z modelu 5: ta sama oferta, ta sama ranga od algorytmu, pozycja 3 zamiast 6. Niepewność współczynników losujemy z ich rozkładu (10 000 losowań), a do tego dokładamy losowość przyszłych kliknięć i rezerwacji. Tak powstaje przedział predykcji, a nie tylko przedział dla średniej.
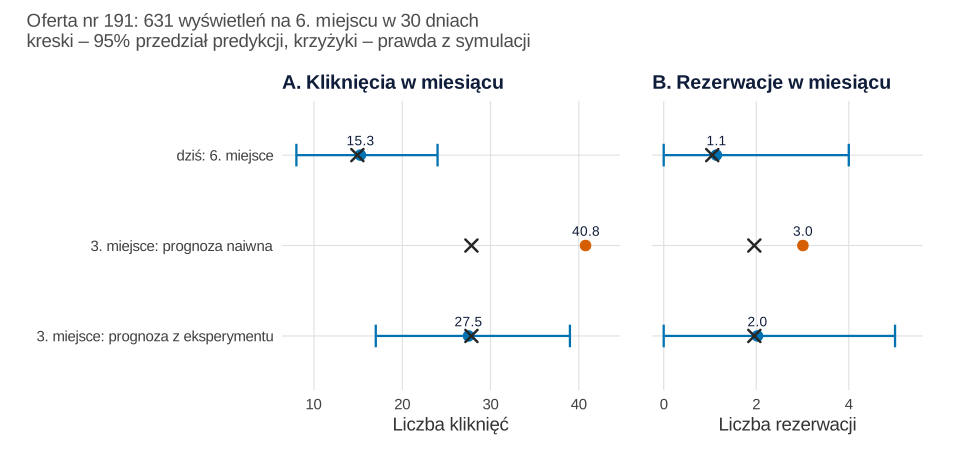
set.seed(7015)).Co widać. Dziś oferta ma średnio 15.3 kliknięcia miesięcznie (95% przedział predykcji [8, 24]). Po przesunięciu na 3. miejsce – 27.5 [17, 39]; prawda to 27.8. Prognoza naiwna z mnożników z logów obiecuje 40.8. Przyrost to średnio 12.3 kliknięcia [0, 26]. Rezerwacji jest mało: oferta zamienia na rezerwację 7.4% kliknięć (29 z 393), więc przyrost to średnio 0.9 rezerwacji miesięcznie, 95% przedział predykcji [−2, 5]. W 42.7% losowań miesiąc z wyróżnieniem nie dał żadnej dodatkowej rezerwacji.
Jak może zmylić. W grupie z zamianą pozycji na 100 kliknięć przypadało od 10.6 do 12.5 rezerwacji, bez różnic między pozycjami (χ²(9) = 7.86, p = .548). Pozycja zmienia więc to, co ludzie oglądają, a nie to, czy kupią po obejrzeniu – zgodnie z wynikami Ursu (2018). Przy kilku rezerwacjach miesięcznie przypadek łatwo zasłoni efekt. Jak liczyć odsetki na kolejnych etapach ścieżki klienta, pokazuje wpis o lejku konwersji.
Podpis do pracy:
Rysunek 6: lista wyników z odsetkami
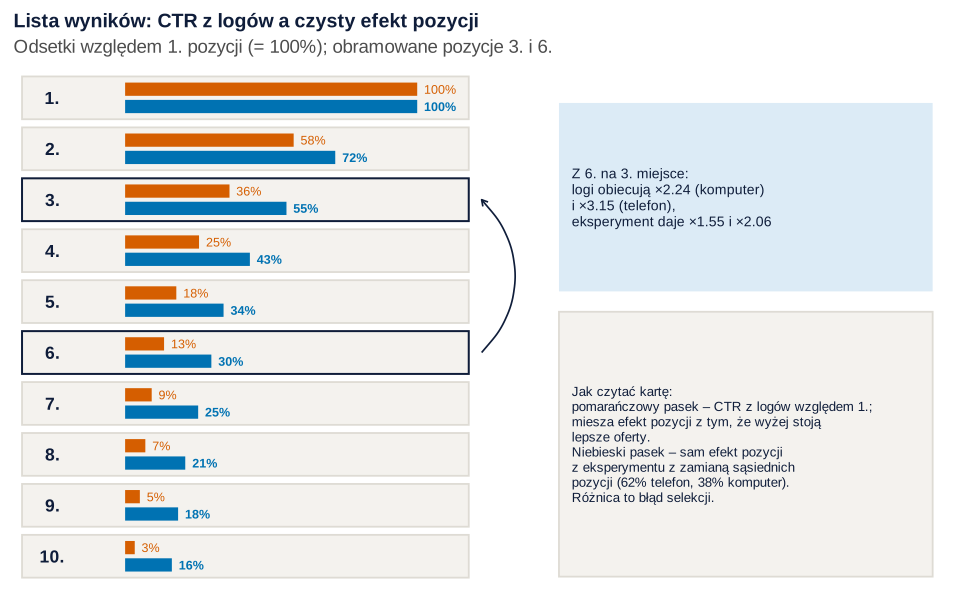
set.seed(701)).Co widać. Według logów oferta na 3. miejscu zbiera 36% kliknięć pierwszej, a na 6. – 13%. Sama pozycja odpowiada za 55% i 30% (średnia ważona: 62% telefon, 38% komputer). Pozostała różnica to oferty, nie miejsce.
Jak może zmylić. Średnia ukrywa różnicę między urządzeniami. Gdy przybywa telefonów, niższe pozycje tracą jeszcze więcej – licz osobno.
Podpis do pracy:
Co z tym zrobić w marketingu
- Nie wyceniaj pozycji z surowej krzywej CTR. W przykładzie logi zawyżały zysk z przejścia z 6. na 3. miejsce o ponad 40% (2.24 zamiast 1.57 na komputerze).
- Zmierz efekt pozycji eksperymentem. Zamiana sąsiednich pozycji na części ruchu wystarczy; to test A/B, w którym losujesz kolejność, a nie wersję strony. Ogranicz go w czasie i w zasięgu, bo pogarsza wyniki wyszukiwania (Wang i in., 2018).
- Licz osobno dla telefonu i komputera. Na telefonie pozycja waży więcej (2.06 wobec 1.55).
- Sprzedawaj wyróżnienie z przedziałem, nie z obietnicą. „Średnio 27 kliknięć zamiast 15, zwykle 17–39” jest uczciwsze niż „2.7 raza więcej”.
- Oceniaj rezerwacje, nie tylko kliknięcia – w sumie wielu ofert albo kilku miesięcy.
- Nie ucz rankingu na surowych kliknięciach. Kliknięcia trzeba ważyć odwrotnością szansy obejrzenia (Joachims i in., 2017) – to te same wagi IPW, które znasz z badań obserwacyjnych. Porównanie całych algorytmów rankingu opisuje wpis o wyszukiwarce w sklepie: NDCG i przeplataniu.
Jak opisać w pracy
Opisz, skąd pochodzą dane (logi czy eksperyment), jednostkę losowania (lista wyników), schemat zamiany, model i sposób przeliczenia współczynników na mnożnik CTR. W pracy dyplomowej nazwij wprost ograniczenie danych bez losowania. Więcej o analizach w pracach z marketingu: statystyka w pracy z marketingu.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw, parametry i dane używane dalej. Przepisy 1–6 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne. Przepisy 1 i 4 liczą się po ok. 10 sekund, pozostałe – w sekundę.
Losują dwa przepisy i każdy zaczyna od własnego set.seed(): 701 w przepisie 1 i 7015 w przepisie 5; pozostałe nie losują. Ziarna ustalono raz i nie zmieniano ich. Ręcznie ustalono (przepis 1): 300 ofert, 10 wyników na liście, 30 dni logów i 28 dni eksperymentu, 62% wyszukiwań z telefonu, prawdziwy efekt pozycji (szansę obejrzenia wyniku na pozycjach 1–10, osobno dla komputera i telefonu), rozrzut atrakcyjności ofert (odchylenie standardowe 0.6 na skali logitu), dopasowania do zapytania (0.6) i dnia (0.25), szum oceny algorytmu (0.8), wyraz wolny −2.4 oraz skłonność do rezerwacji po kliknięciu (ok. 11%, niezależnie od pozycji); w przepisie 5 – 10 000 losowań. Zmiany po pierwszym uruchomieniu: zwiększono liczbę wyszukiwań z 3000 do 5000 dziennie i udział wyszukiwań z zamianą pozycji z 25% do 40%, bo przedziały z eksperymentu były zbyt szerokie, by cokolwiek rozstrzygnąć (mnożnik 3. / 6. na komputerze 2.01, 95% CI [1.45, 2.78]); w rysunku 2B zamiast wykresu średniej pozycji ofert (prawie idealna zależność od atrakcyjności, nic nie wyjaśniała) pokazano dopasowanie jednej oferty do zapytań; prognozę naiwną liczono od oczekiwanej, a nie zaobserwowanej liczby kliknięć na 6. miejscu, żeby obie prognozy miały tę samą podstawę; poprawiono też podpisy i etykiety na rysunkach 2, 4 i 5.
1. Dane: logi i eksperyment – Rysunek 1
R
# Rysunek 1. Fikcyjna platforma z noclegami w agroturystykach: logi wyników wyszukiwania
# i eksperyment z zamianą sąsiednich pozycji (dane symulowane)
library(ggplot2)
options(width = 120)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", pomaranczowy = "#D55E00", blekit = "#56B4E9", zielony = "#009E73",
         zolty = "#E69F00", rozowy = "#CC79A7", szary = "#999999", granat = "#0f1d3a")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustawione ręcznie
J <- 300                          # oferty agroturystyk
wysz_dzien <- 5000                # wyszukiwań dziennie, po 10 wyników na liście
dni_logi <- 30                    # okres 1: zwykłe logi
dni_eks <- 28                     # okres 2: eksperyment
udzial_eks <- 0.40                # odsetek wyszukiwań w grupie z zamianą pozycji
p_telefon <- 0.62                 # odsetek wyszukiwań z telefonu
# Prawdziwy efekt pozycji: szansa, że użytkownik w ogóle obejrzy wynik na pozycji 1–10
theta <- rbind(komputer = c(1, .80, .66, .56, .48, .42, .37, .33, .30, .27),
               telefon  = c(1, .72, .52, .39, .30, .24, .19, .16, .13, .11))

set.seed(701)
oferta_u <- rnorm(J, 0, 0.6)                          # stała atrakcyjność oferty (zdjęcia, cena, opinie)
oferta_v <- 0.2 * oferta_u + rnorm(J, 0, 0.45)        # skłonność do rezerwacji po kliknięciu

symuluj_okres <- function(dni, eksperyment) {
  S <- dni * wysz_dzien
  d <- data.frame(sesja = rep(1:S, each = 10), dzien = rep(rep(1:dni, each = wysz_dzien), each = 10))
  d$oferta <- as.vector(replicate(S, sample.int(J, 10)))          # 10 ofert pasujących do zapytania
  d$urzadzenie <- rep(ifelse(runif(S) < p_telefon, "telefon", "komputer"), each = 10)
  w <- matrix(rnorm(J * dni, 0, 0.25), J, dni)                    # dzień: wolne terminy, zmiana ceny
  d$m <- rnorm(nrow(d), 0, 0.6)                                   # dopasowanie do tego wyszukiwania
  d$gamma <- plogis(-2.4 + oferta_u[d$oferta] + d$m + w[cbind(d$oferta, d$dzien)])
  wynik <- oferta_u[d$oferta] + d$m + rnorm(nrow(d), 0, 0.8)      # ocena algorytmu (niedoskonała)
  d$ranga <- ave(-wynik, d$sesja, FUN = rank)                     # kolejność ustalona przez algorytm
  d$pozycja <- d$ranga
  d$grupa <- "zwykla"
  if (eksperyment) {
    eks <- runif(S) < udzial_eks
    uklad <- ifelse(runif(S) < 0.5, "A", "B")    # A: pary 1–2, 3–4, …, 9–10; B: pary 2–3, 4–5, …, 8–9
    zamiana <- matrix(runif(S * 5) < 0.5, S, 5)  # każda para zamieniana z prawdop. 1/2
    s <- d$sesja
    para <- ifelse(uklad[s] == "A", (d$ranga + 1) %/% 2, d$ranga %/% 2)
    gora <- ifelse(uklad[s] == "A", d$ranga %% 2 == 1, d$ranga %% 2 == 0)
    ok <- eks[s] & para >= 1 & para <= ifelse(uklad[s] == "A", 5, 4)
    zam <- ok & zamiana[cbind(s, pmax(para, 1))]
    d$pozycja[zam] <- d$ranga[zam] + ifelse(gora[zam], 1, -1)
    d$grupa[eks[s]] <- ifelse(uklad[s][eks[s]] == "A", "eks_A", "eks_B")
  }
  th <- ifelse(d$urzadzenie == "telefon", theta["telefon", ][d$pozycja], theta["komputer", ][d$pozycja])
  d$klik <- rbinom(nrow(d), 1, th * d$gamma)
  d$rezerwacja <- d$klik * rbinom(nrow(d), 1, plogis(-2.2 + oferta_v[d$oferta]))
  d$klik_oczek <- th * d$gamma                                   # prawda znana tylko w symulacji
  d
}
logi <- symuluj_okres(dni_logi, eksperyment = FALSE)
eks  <- symuluj_okres(dni_eks, eksperyment = TRUE)

# Dane zagregowane do analizy i do pliku CSV: wyświetlenia, kliknięcia i rezerwacje
agreguj <- function(d, okres) {
  a <- aggregate(cbind(wyswietlenia = 1, klikniecia = klik, rezerwacje = rezerwacja) ~
                   urzadzenie + oferta + ranga + pozycja, data = d, FUN = sum)
  cbind(okres = okres, a)
}
dane <- rbind(agreguj(logi, "logi"), agreguj(eks, "eksperyment"))
write.csv(dane, "agroturystyki-pozycja-klikniecia.csv", row.names = FALSE)

cat("Wyszukiwań: logi", max(logi$sesja), "| eksperyment", max(eks$sesja),
    "(w grupie z zamianą par:", sum(eks$grupa[eks$ranga == 1] != "zwykla"), ")\n")
cat("Wierszy w CSV:", nrow(dane), "| wyświetleń:", sum(dane$wyswietlenia), "| kliknięć:", sum(dane$klikniecia),
    "| rezerwacji:", sum(dane$rezerwacje), "\n")
cat("Odsetek wyszukiwań z telefonu w logach:", round(100 * mean(logi$urzadzenie[logi$ranga == 1] == "telefon"), 1), "%\n")

# CTR według pozycji w logach (naiwnie) i prawdziwy efekt pozycji (z parametrów theta)
ctr <- aggregate(cbind(wysw = 1, klik = klik) ~ urzadzenie + pozycja, data = logi, FUN = sum)
ctr$ctr <- ctr$klik / ctr$wysw
ctr$wzgl_naiwny <- ctr$ctr / ctr$ctr[ctr$pozycja == 1][match(ctr$urzadzenie, ctr$urzadzenie[ctr$pozycja == 1])]
ctr$wzgl_prawdziwy <- theta[cbind(match(ctr$urzadzenie, rownames(theta)), ctr$pozycja)]
print(data.frame(ctr[c("urzadzenie", "pozycja")], CTR_proc = round(100 * ctr$ctr, 2),
                 wzgl_naiwny = round(ctr$wzgl_naiwny, 3), wzgl_prawdziwy = ctr$wzgl_prawdziwy), row.names = FALSE)
for (u in c("komputer", "telefon")) {
  x <- ctr[ctr$urzadzenie == u, ]
  cat(u, ": CTR 3. / 6. pozycji – w logach", round(x$ctr[3] / x$ctr[6], 2), "| prawdziwy efekt pozycji",
      round(theta[u, 3] / theta[u, 6], 2), "\n")
}
cat("Wszystkie urządzenia: CTR 1. pozycji", round(100 * sum(ctr$klik[ctr$pozycja == 1]) / sum(ctr$wysw[ctr$pozycja == 1]), 2),
    "% | 10. pozycji", round(100 * sum(ctr$klik[ctr$pozycja == 10]) / sum(ctr$wysw[ctr$pozycja == 10]), 2), "%\n")

ctr$panel <- factor(ifelse(ctr$urzadzenie == "telefon", "Telefon", "Komputer"), c("Komputer", "Telefon"))
dl <- rbind(data.frame(ctr[c("panel", "pozycja")], wart = ctr$wzgl_naiwny, co = "z logów (naiwnie)"),
            data.frame(ctr[c("panel", "pozycja")], wart = ctr$wzgl_prawdziwy, co = "prawdziwy efekt pozycji"))
p1 <- ggplot(dl, aes(pozycja, 100 * wart, colour = co, shape = co, linetype = co)) +
  geom_line(linewidth = 0.9) + geom_point(size = 2.6) +
  facet_wrap(~ panel) +
  scale_x_continuous(breaks = 1:10) +
  scale_colour_manual(values = c("z logów (naiwnie)" = kol[["pomaranczowy"]], "prawdziwy efekt pozycji" = kol[["niebieski"]]),
                      name = NULL) +
  scale_shape_manual(values = c("z logów (naiwnie)" = 16, "prawdziwy efekt pozycji" = 17), name = NULL) +
  scale_linetype_manual(values = c("z logów (naiwnie)" = "solid", "prawdziwy efekt pozycji" = "22"), name = NULL) +
  labs(title = "Krzywa CTR z logów spada szybciej niż sam efekt pozycji",
       subtitle = "CTR na pozycji względem 1. pozycji (1. pozycja = 100%)",
       x = "Pozycja na liście wyników", y = "CTR względem 1. pozycji (%)") +
  motyw
p1                       # do pliku: ggsave("pozycja-ctr-krzywa-z-logow.svg", p1, width = 10, height = 5)
Wynik w R
Wyszukiwań: logi 150000 | eksperyment 140000 (w grupie z zamianą par: 55627 )
Wierszy w CSV: 22761 | wyświetleń: 2900000 | kliknięć: 168376 | rezerwacji: 19019
Odsetek wyszukiwań z telefonu w logach: 62.1 %
 urzadzenie pozycja CTR_proc wzgl_naiwny wzgl_prawdziwy
   komputer       1    21.02       1.000           1.00
    telefon       1    21.37       1.000           1.00
   komputer       2    13.06       0.621           0.80
    telefon       2    11.76       0.550           0.72
   komputer       3     8.71       0.414           0.66
    telefon       3     6.91       0.323           0.52
   komputer       4     6.56       0.312           0.56
    telefon       4     4.65       0.218           0.39
   komputer       5     4.86       0.231           0.48
    telefon       5     3.03       0.142           0.30
   komputer       6     3.88       0.185           0.42
    telefon       6     2.19       0.102           0.24
   komputer       7     2.75       0.131           0.37
    telefon       7     1.43       0.067           0.19
   komputer       8     2.11       0.100           0.33
    telefon       8     1.08       0.051           0.16
   komputer       9     1.63       0.078           0.30
    telefon       9     0.73       0.034           0.13
   komputer      10     1.10       0.052           0.27
    telefon      10     0.46       0.021           0.11
komputer : CTR 3. / 6. pozycji – w logach 2.24 | prawdziwy efekt pozycji 1.57
telefon : CTR 3. / 6. pozycji – w logach 3.15 | prawdziwy efekt pozycji 2.17
Wszystkie urządzenia: CTR 1. pozycji 21.24 % | 10. pozycji 0.7 %
2. Skąd błąd selekcji – Rysunek 2
R
# Rysunek 2. Skąd błąd selekcji: algorytm stawia wyżej oferty, które i tak częściej klikamy
# (korzysta z kol, motyw, theta, logi i oferta_u z przepisu 1; nic nie losuje)
library(ggplot2)
library(patchwork)

# A: średnia prawdziwa atrakcyjność (szansa kliknięcia, gdy wynik zostanie obejrzany) na każdej pozycji
atr <- aggregate(gamma ~ pozycja, data = logi, FUN = mean)
cat("Średnia atrakcyjność oferty (szansa kliknięcia po obejrzeniu), %:\n")
print(data.frame(pozycja = atr$pozycja, atrakcyjnosc_proc = round(100 * atr$gamma, 1)), row.names = FALSE)
cat("Stosunek atrakcyjności 3. / 6. pozycji:", round(atr$gamma[3] / atr$gamma[6], 2), "\n")

# Rozkład CTR z logów: CTR = szansa obejrzenia (efekt pozycji) × atrakcyjność ofert na tej pozycji
# (logi różnią się od iloczynu tylko losowością kliknięć)
for (u in c("komputer", "telefon")) {
  x <- logi[logi$urzadzenie == u, ]
  c3 <- mean(x$klik[x$pozycja == 3]); c6 <- mean(x$klik[x$pozycja == 6])
  a3 <- mean(x$gamma[x$pozycja == 3]); a6 <- mean(x$gamma[x$pozycja == 6])
  cat(u, ": CTR 3./6. w logach =", round(c3 / c6, 2), "| oczekiwany = efekt pozycji", round(theta[u, 3] / theta[u, 6], 2),
      "× różnica ofert", round(a3 / a6, 2), "=", round(theta[u, 3] / theta[u, 6] * a3 / a6, 2), "\n")
}

# B: jedna oferta (ta, która w logach najczęściej stała na 6. miejscu) – w różnych wyszukiwaniach trafia
# na różne pozycje, a wyżej wtedy, gdy lepiej pasuje do zapytania (m). Sam efekt oferty tego nie usuwa.
nr6 <- as.integer(names(which.max(table(logi$oferta[logi$pozycja == 6]))))
x6 <- logi[logi$oferta == nr6, ]
cat("Oferta nr", nr6, ": wyświetleń w logach", nrow(x6), "| na 6. pozycji", sum(x6$pozycja == 6),
    "| średnia pozycja", round(mean(x6$pozycja), 1), "\n")
dop <- aggregate(m ~ pozycja, data = x6, FUN = mean)
cat("Średnie dopasowanie do zapytania (m) tej oferty według pozycji:\n")
print(data.frame(pozycja = dop$pozycja, m = round(dop$m, 2)), row.names = FALSE)

pA <- ggplot(atr, aes(pozycja, 100 * gamma)) +
  geom_col(fill = kol[["blekit"]], width = 0.7) +
  geom_text(aes(label = sprintf("%.1f", 100 * gamma)), vjust = -0.4, size = 3.6, colour = "#0f1d3a") +
  scale_x_continuous(breaks = 1:10) +
  scale_y_continuous(expand = expansion(mult = c(0, 0.12))) +
  labs(title = "A. Wyżej stoją lepsze oferty",
       subtitle = "Szansa kliknięcia oferty, gdy ktoś ją obejrzy (%)", x = "Pozycja", y = NULL) +
  motyw
x6$poz_f <- factor(x6$pozycja)
pB <- ggplot(x6, aes(poz_f, m)) +
  geom_hline(yintercept = 0, colour = "grey60") +
  geom_boxplot(fill = kol[["zolty"]], alpha = 0.35, colour = "grey30", outlier.shape = NA, width = 0.6) +
  stat_summary(fun = mean, geom = "point", shape = 18, size = 3.2, colour = kol[["pomaranczowy"]]) +
  coord_cartesian(ylim = c(-1.6, 1.8)) +
  labs(title = sprintf("B. Ta sama oferta (nr %d)", nr6),
       subtitle = "Jak pasowała do zapytania, gdy stała na pozycji",
       x = "Pozycja", y = "Dopasowanie do zapytania (logit)") +
  motyw
p2 <- pA + pB
p2                       # do pliku: ggsave("pozycja-ctr-blad-selekcji.svg", p2, width = 10, height = 5)
Wynik w R
Średnia atrakcyjność oferty (szansa kliknięcia po obejrzeniu), %:
 pozycja atrakcyjnosc_proc
       1              21.3
       2              16.2
       3              13.5
       4              11.7
       5              10.1
       6               8.9
       7               7.7
       8               6.6
       9               5.4
      10               4.1
Stosunek atrakcyjności 3. / 6. pozycji: 1.52
komputer : CTR 3./6. w logach = 2.24 | oczekiwany = efekt pozycji 1.57 × różnica ofert 1.52 = 2.38
telefon : CTR 3./6. w logach = 3.15 | oczekiwany = efekt pozycji 2.17 × różnica ofert 1.52 = 3.3
Oferta nr 191 : wyświetleń w logach 4991 | na 6. pozycji 631 | średnia pozycja 5.6
Średnie dopasowanie do zapytania (m) tej oferty według pozycji:
 pozycja     m
       1  0.58
       2  0.40
       3  0.30
       4  0.16
       5  0.07
       6 -0.05
       7 -0.10
       8 -0.23
       9 -0.39
      10 -0.56
3. Eksperyment z zamianą sąsiednich pozycji – Rysunek 3
R
# Rysunek 3. Eksperyment z zamianą sąsiednich pozycji: czysty efekt pozycji
# (korzysta z kol, motyw, theta, eks i ctr z przepisu 1; nic nie losuje)
library(ggplot2)

# W grupie eksperymentalnej każda para sąsiednich wyników (układ A: 1–2, 3–4, …; układ B: 2–3, 4–5, …)
# była zamieniana z prawdopodobieństwem 1/2. Na pozycję k i k + 1 trafiają więc oferty o tej samej
# średniej atrakcyjności, a stosunek CTR(k + 1) / CTR(k) mierzy sam efekt pozycji.
pary <- do.call(rbind, lapply(c("komputer", "telefon"), function(u) {
  do.call(rbind, lapply(1:9, function(k) {
    uklad <- if (k %% 2 == 1) "eks_A" else "eks_B"            # w którym układzie para (k, k + 1) jest parą
    x <- eks[eks$urzadzenie == u & eks$grupa == uklad & eks$ranga %in% c(k, k + 1), ]
    gora <- x[x$pozycja == k, ]; dol <- x[x$pozycja == k + 1, ]
    data.frame(urzadzenie = u, k = k, wysw_gora = nrow(gora), klik_gora = sum(gora$klik),
               wysw_dol = nrow(dol), klik_dol = sum(dol$klik),
               log_R = log(mean(dol$klik) / mean(gora$klik)),
               var_log_R = 1 / sum(dol$klik) - 1 / nrow(dol) + 1 / sum(gora$klik) - 1 / nrow(gora))
  }))
}))
cat("Stosunek CTR(k + 1) / CTR(k) w parach zamienianych losowo:\n")
print(data.frame(pary[c("urzadzenie", "k")], klik_k = pary$klik_gora, klik_k1 = pary$klik_dol,
                 R = round(exp(pary$log_R), 3), prawda = round(theta[cbind(match(pary$urzadzenie, rownames(theta)), pary$k + 1)] /
                                                              theta[cbind(match(pary$urzadzenie, rownames(theta)), pary$k)], 3)),
      row.names = FALSE)

# Łańcuch: CTR na pozycji p względem 1. = iloczyn kolejnych stosunków; wariancje logarytmów się sumują
krzywa <- do.call(rbind, lapply(split(pary, pary$urzadzenie), function(d) {
  data.frame(urzadzenie = d$urzadzenie[1], pozycja = 1:10, log_w = c(0, cumsum(d$log_R)), se = sqrt(c(0, cumsum(d$var_log_R))))
}))
krzywa$wzgl <- exp(krzywa$log_w)
krzywa$dolna <- exp(krzywa$log_w - 1.96 * krzywa$se)
krzywa$gorna <- exp(krzywa$log_w + 1.96 * krzywa$se)
krzywa$prawda <- theta[cbind(match(krzywa$urzadzenie, rownames(theta)), krzywa$pozycja)]
krzywa$naiwnie <- ctr$wzgl_naiwny[match(paste(krzywa$urzadzenie, krzywa$pozycja), paste(ctr$urzadzenie, ctr$pozycja))]
print(data.frame(krzywa[c("urzadzenie", "pozycja")], ekspery = round(krzywa$wzgl, 3), dolna = round(krzywa$dolna, 3),
                 gorna = round(krzywa$gorna, 3), prawda = krzywa$prawda, naiwnie = round(krzywa$naiwnie, 3)), row.names = FALSE)
for (u in c("komputer", "telefon")) {
  d <- pary[pary$urzadzenie == u & pary$k %in% 3:5, ]                 # z 3. na 6. to trzy kroki: 3→4, 4→5, 5→6
  m <- exp(-sum(d$log_R)); s <- sqrt(sum(d$var_log_R))
  cat(u, ": 3. zamiast 6. pozycji – eksperyment", round(m, 2), "[", round(m * exp(-1.96 * s), 2), ",",
      round(m * exp(1.96 * s), 2), "] | prawda", round(theta[u, 3] / theta[u, 6], 2), "\n")
}

krzywa$panel <- factor(ifelse(krzywa$urzadzenie == "telefon", "Telefon", "Komputer"), c("Komputer", "Telefon"))
p3 <- ggplot(krzywa, aes(pozycja)) +
  geom_ribbon(aes(ymin = 100 * dolna, ymax = 100 * gorna), fill = kol[["niebieski"]], alpha = 0.15) +
  geom_line(aes(y = 100 * naiwnie, colour = "z logów (naiwnie)", linetype = "z logów (naiwnie)"), linewidth = 0.8) +
  geom_line(aes(y = 100 * prawda, colour = "prawda (symulacja)", linetype = "prawda (symulacja)"), linewidth = 0.8) +
  geom_line(aes(y = 100 * wzgl, colour = "eksperyment z zamianą", linetype = "eksperyment z zamianą"), linewidth = 1) +
  geom_point(aes(y = 100 * wzgl, colour = "eksperyment z zamianą"), size = 2.4) +
  facet_wrap(~ panel) +
  scale_x_continuous(breaks = 1:10) +
  scale_colour_manual(values = c("eksperyment z zamianą" = kol[["niebieski"]], "prawda (symulacja)" = "grey20",
                                 "z logów (naiwnie)" = kol[["pomaranczowy"]]), name = NULL) +
  scale_linetype_manual(values = c("eksperyment z zamianą" = "solid", "prawda (symulacja)" = "22",
                                   "z logów (naiwnie)" = "solid"), name = NULL) +
  labs(title = "Eksperyment z zamianą sąsiednich pozycji odtwarza efekt pozycji",
       subtitle = "CTR względem 1. pozycji z 95% przedziałem ufności (łańcuch stosunków dla par k, k + 1)",
       x = "Pozycja na liście wyników", y = "CTR względem 1. pozycji (%)") +
  motyw
p3                       # do pliku: ggsave("pozycja-ctr-eksperyment-zamiany.svg", p3, width = 10, height = 5)
Wynik w R
Stosunek CTR(k + 1) / CTR(k) w parach zamienianych losowo:
 urzadzenie k klik_k klik_k1     R prawda
   komputer 1   1999    1570 0.785  0.800
   komputer 2   1237    1022 0.826  0.825
   komputer 3    897     722 0.805  0.848
   komputer 4    677     561 0.829  0.857
   komputer 5    486     448 0.922  0.875
   komputer 6    342     316 0.924  0.881
   komputer 7    284     253 0.891  0.892
   komputer 8    224     200 0.893  0.909
   komputer 9    149     145 0.973  0.900
    telefon 1   3299    2240 0.679  0.720
    telefon 2   1864    1354 0.726  0.722
    telefon 3   1114     833 0.748  0.750
    telefon 4    766     578 0.755  0.769
    telefon 5    460     383 0.833  0.800
    telefon 6    350     268 0.766  0.792
    telefon 7    259     191 0.737  0.842
    telefon 8    175     151 0.863  0.812
    telefon 9    110      81 0.736  0.846
 urzadzenie pozycja ekspery dolna gorna prawda naiwnie
   komputer       1   1.000 1.000 1.000   1.00   1.000
   komputer       2   0.785 0.739 0.834   0.80   0.621
   komputer       3   0.649 0.588 0.716   0.66   0.414
   komputer       4   0.522 0.456 0.599   0.56   0.312
   komputer       5   0.433 0.364 0.515   0.48   0.231
   komputer       6   0.399 0.322 0.495   0.42   0.185
   komputer       7   0.369 0.284 0.479   0.37   0.131
   komputer       8   0.328 0.241 0.448   0.33   0.100
   komputer       9   0.293 0.204 0.422   0.30   0.078
   komputer      10   0.285 0.186 0.438   0.27   0.052
    telefon       1   1.000 1.000 1.000   1.00   1.000
    telefon       2   0.679 0.646 0.713   0.72   0.550
    telefon       3   0.493 0.454 0.536   0.52   0.323
    telefon       4   0.369 0.327 0.416   0.39   0.218
    telefon       5   0.278 0.237 0.327   0.30   0.142
    telefon       6   0.232 0.188 0.286   0.24   0.102
    telefon       7   0.177 0.137 0.231   0.19   0.067
    telefon       8   0.131 0.095 0.180   0.16   0.051
    telefon       9   0.113 0.077 0.166   0.13   0.034
    telefon      10   0.083 0.051 0.135   0.11   0.021
komputer : 3. zamiast 6. pozycji – eksperyment 1.63 [ 1.34 , 1.97 ] | prawda 1.57
telefon : 3. zamiast 6. pozycji – eksperyment 2.13 [ 1.76 , 2.58 ] | prawda 2.17
4. Regresja logistyczna i beta-dwumianowa – Rysunek 4
R
# Rysunek 4. Regresja logistyczna i beta-dwumianowa: ile razy więcej kliknięć na 3. niż na 6. pozycji?
# (korzysta z kol, motyw, theta i dane z przepisu 1 – te same kolumny co w pliku CSV; nic nie losuje)
library(ggplot2)
library(glmmTMB)

# Mnożnik „3. zamiast 6.” dla typowej oferty: z różnicy logitów (Δ) i CTR na 6. pozycji
mnoznik <- function(delta, c6) plogis(qlogis(c6) + delta) / c6
wyniki <- list(); dyspersja <- list(); modele_eo <- list()
for (u in c("komputer", "telefon")) {
  L <- dane[dane$okres == "logi" & dane$urzadzenie == u, ]
  E <- dane[dane$okres == "eksperyment" & dane$urzadzenie == u, ]
  c6 <- sum(E$klikniecia[E$pozycja == 6]) / sum(E$wyswietlenia[E$pozycja == 6])  # CTR typowej oferty na 6.
  E$pozycja_f <- relevel(factor(E$pozycja), ref = "6"); L$pozycja_f <- relevel(factor(L$pozycja), ref = "6")
  E$ranga_f <- factor(E$ranga); E$oferta_f <- factor(E$oferta); L$oferta_f <- factor(L$oferta)

  # 1) Naiwnie: stosunek CTR z logów (przedział z metody delta na skali logarytmu)
  k3 <- sum(L$klikniecia[L$pozycja == 3]); n3 <- sum(L$wyswietlenia[L$pozycja == 3])
  k6 <- sum(L$klikniecia[L$pozycja == 6]); n6 <- sum(L$wyswietlenia[L$pozycja == 6])
  se_n <- sqrt(1 / k3 - 1 / n3 + 1 / k6 - 1 / n6)
  r_n <- (k3 / n3) / (k6 / n6)
  w <- data.frame(metoda = "Logi: surowy CTR", m = r_n, dolna = r_n * exp(-1.96 * se_n), gorna = r_n * exp(1.96 * se_n))

  # 2) Logi + efekt oferty: regresja logistyczna ze stałym efektem każdej z 300 ofert
  m_lo <- glm(cbind(klikniecia, wyswietlenia - klikniecia) ~ pozycja_f + oferta_f, family = binomial, data = L)
  # 3) Eksperyment: regresja logistyczna z rangą nadaną przez algorytm (losowa jest tylko zamiana)
  m_el <- glm(cbind(klikniecia, wyswietlenia - klikniecia) ~ pozycja_f + ranga_f, family = binomial, data = E)
  # 4) Eksperyment: regresja beta-dwumianowa – zmienność ofert jako nadmierna dyspersja
  m_eb <- glmmTMB(cbind(klikniecia, wyswietlenia - klikniecia) ~ pozycja_f + ranga_f, family = betabinomial, data = E)
  # 5) Eksperyment: regresja logistyczna z rangą i efektem oferty
  m_eo <- glm(cbind(klikniecia, wyswietlenia - klikniecia) ~ pozycja_f + ranga_f + oferta_f, family = binomial, data = E)

  for (mm in list(list("Logi + efekt oferty (logistyczna)", m_lo), list("Eksperyment: logistyczna", m_el),
                  list("Eksperyment: beta-dwumianowa", m_eb), list("Eksperyment: logistyczna + efekt oferty", m_eo))) {
    b <- if (inherits(mm[[2]], "glmmTMB")) fixef(mm[[2]])$cond else coef(mm[[2]])
    V <- vcov(mm[[2]]); if (inherits(mm[[2]], "glmmTMB")) V <- V$cond
    d <- b[["pozycja_f3"]]; s <- sqrt(V["pozycja_f3", "pozycja_f3"])
    w <- rbind(w, data.frame(metoda = mm[[1]], m = mnoznik(d, c6), dolna = mnoznik(d - 1.96 * s, c6),
                             gorna = mnoznik(d + 1.96 * s, c6)))
  }
  modele_eo[[u]] <- m_eo
  w$urzadzenie <- u; w$prawda <- theta[u, 3] / theta[u, 6]; w$ctr6 <- c6
  wyniki[[u]] <- w
  dyspersja[[u]] <- data.frame(urzadzenie = u, komorek = nrow(E),
    pearson_chi2_df_logistyczna = sum(residuals(m_el, type = "pearson")^2) / df.residual(m_el),
    rho_beta_dwumianowa = 1 / (1 + sigma(m_eb)),                      # korelacja kliknięć w obrębie komórki
    AIC_logistyczna = AIC(m_el), AIC_beta_dwumianowa = AIC(m_eb))
}
wyn <- do.call(rbind, wyniki)
print(data.frame(wyn[c("urzadzenie", "metoda")], mnoznik = round(wyn$m, 2), dolna = round(wyn$dolna, 2),
                 gorna = round(wyn$gorna, 2), prawda = round(wyn$prawda, 2), szer_CI = round(wyn$gorna - wyn$dolna, 2)),
      row.names = FALSE)
cat("CTR na 6. pozycji w okresie eksperymentu (%):", paste(names(wyniki), round(100 * sapply(wyniki, function(w) w$ctr6[1]), 2)), "\n")
dys <- do.call(rbind, dyspersja)
print(data.frame(dys[1:2], lapply(dys[-(1:2)], round, 3)), row.names = FALSE)

wyn$metoda <- factor(wyn$metoda, levels = rev(unique(wyn$metoda)))
wyn$panel <- factor(ifelse(wyn$urzadzenie == "telefon", "Telefon", "Komputer"), c("Komputer", "Telefon"))
wyn$rodzaj <- ifelse(grepl("^Logi", wyn$metoda), "logi (bez losowania)", "eksperyment z zamianą")
p4 <- ggplot(wyn, aes(m, metoda, colour = rodzaj, shape = rodzaj)) +
  geom_vline(aes(xintercept = prawda), linetype = "22", colour = "grey20") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.25, orientation = "y", linewidth = 0.8) +
  geom_point(size = 3) +
  geom_text(aes(label = sprintf("%.2f", m)), nudge_y = 0.32, size = 3.5, show.legend = FALSE) +
  facet_wrap(~ panel) +
  scale_colour_manual(values = c("logi (bez losowania)" = kol[["pomaranczowy"]], "eksperyment z zamianą" = kol[["niebieski"]]),
                      name = NULL) +
  scale_shape_manual(values = c("logi (bez losowania)" = 15, "eksperyment z zamianą" = 16), name = NULL) +
  labs(title = "Ile razy więcej kliknięć na 3. niż na 6. pozycji?",
       subtitle = "Mnożnik CTR typowej oferty z 95% CI; linia przerywana – prawda z symulacji",
       x = "Mnożnik CTR (3. zamiast 6. pozycji)", y = NULL) +
  motyw
p4                       # do pliku: ggsave("pozycja-ctr-modele-mnoznik.svg", p4, width = 10, height = 5.2)
Wynik w R
 urzadzenie                                  metoda mnoznik dolna gorna prawda szer_CI
   komputer                        Logi: surowy CTR    2.24  2.14  2.35   1.57    0.22
   komputer       Logi + efekt oferty (logistyczna)    1.91  1.82  2.01   1.57    0.19
   komputer                Eksperyment: logistyczna    1.54  1.34  1.77   1.57    0.43
   komputer            Eksperyment: beta-dwumianowa    1.51  1.30  1.75   1.57    0.45
   komputer Eksperyment: logistyczna + efekt oferty    1.55  1.35  1.78   1.57    0.43
    telefon                        Logi: surowy CTR    3.15  3.00  3.31   2.17    0.31
    telefon       Logi + efekt oferty (logistyczna)    2.70  2.58  2.84   2.17    0.26
    telefon                Eksperyment: logistyczna    2.06  1.79  2.35   2.17    0.56
    telefon            Eksperyment: beta-dwumianowa    1.98  1.71  2.30   2.17    0.59
    telefon Eksperyment: logistyczna + efekt oferty    2.06  1.80  2.36   2.17    0.57
CTR na 6. pozycji w okresie eksperymentu (%): komputer 3.68 telefon 2.1
 urzadzenie komorek pearson_chi2_df_logistyczna rho_beta_dwumianowa AIC_logistyczna AIC_beta_dwumianowa
   komputer    8369                       1.568               0.008        29216.83             27742.3
    telefon    8392                       1.718               0.006        30748.47             28377.6
5. Prognoza dla jednej oferty – Rysunek 5
R
# Rysunek 5. Prognoza: oferta przesunięta z 6. na 3. miejsce – kliknięcia i rezerwacje w miesiącu
# (korzysta z kol, motyw, theta, logi, eks, oferta_v z przepisu 1, nr6 z przepisu 2,
#  wyn i modele_eo z przepisu 4)
library(ggplot2)
library(patchwork)

# Rezerwacje na kliknięcie według pozycji w grupie z zamianą: czy pozycja zmienia tylko kliknięcia?
g <- eks[eks$grupa != "zwykla" & eks$klik == 1, ]
rk <- aggregate(cbind(klik = klik, rez = rezerwacja) ~ pozycja, data = g, FUN = sum)
rk$proc <- 100 * rk$rez / rk$klik
cat("Rezerwacje na 100 kliknięć według pozycji (grupa z zamianą):", paste0(rk$pozycja, ": ", round(rk$proc, 1)), "\n")
tab <- cbind(rk$rez, rk$klik - rk$rez)
cat("Test chi-kwadrat równości odsetka rezerwacji na pozycjach 1–10: chi2 =", round(chisq.test(tab)$statistic, 2),
    "df =", chisq.test(tab)$parameter, "p =", sub("^0", "", formatC(chisq.test(tab)$p.value, format = "f", digits = 3)), "\n")

# Oferta nr6: ile razy stała na 6. miejscu w 30 dniach logów (osobno telefon i komputer)
x6 <- logi[logi$oferta == nr6 & logi$pozycja == 6, ]
n_d <- table(factor(x6$urzadzenie, c("komputer", "telefon")))
hist_o <- rbind(logi[logi$oferta == nr6, ], eks[eks$oferta == nr6, ])
rez_na_klik <- sum(hist_o$rezerwacja) / sum(hist_o$klik)
cat("Oferta nr", nr6, ": na 6. miejscu", sum(n_d), "razy (komputer", n_d[["komputer"]], ", telefon", n_d[["telefon"]],
    ") | kliknięć tam", sum(x6$klik), "| rezerwacje na kliknięcie w historii", round(100 * rez_na_klik, 1), "% (",
    sum(hist_o$rezerwacja), "/", sum(hist_o$klik), ")\n")

# Prognoza z modelu eksperymentu z efektem oferty: ta sama oferta, ranga 6 od algorytmu, pokazana na 3. lub 6.
set.seed(7015)
B <- 10000
los <- sapply(c("komputer", "telefon"), function(u) {
  m <- modele_eo[[u]]
  nz <- c("(Intercept)", "pozycja_f3", "ranga_f6", paste0("oferta_f", nr6))
  b <- coef(m)[nz]; V <- vcov(m)[nz, nz]
  bb <- MASS::mvrnorm(B, b, V)                                 # niepewność współczynników
  eta6 <- bb[, 1] + bb[, 3] + bb[, 4]
  cbind(p6 = plogis(eta6), p3 = plogis(eta6 + bb[, 2]))
}, simplify = "array")
klik6 <- rbinom(B, n_d[["komputer"]], los[, "p6", "komputer"]) + rbinom(B, n_d[["telefon"]], los[, "p6", "telefon"])
klik3 <- rbinom(B, n_d[["komputer"]], los[, "p3", "komputer"]) + rbinom(B, n_d[["telefon"]], los[, "p3", "telefon"])
stopa <- rbinom(B, sum(hist_o$klik), rez_na_klik) / sum(hist_o$klik)   # niepewność odsetka rezerwacji
rez6 <- rbinom(B, klik6, stopa); rez3 <- rbinom(B, klik3, stopa)
# Prognoza naiwna: ta sama podstawa (oczekiwane kliknięcia na 6.), ale mnożnik z surowego CTR w logach
naiw <- wyn$m[wyn$metoda == "Logi: surowy CTR"]; names(naiw) <- wyn$urzadzenie[wyn$metoda == "Logi: surowy CTR"]
klik6_oczek <- c(n_d) * colMeans(los[, "p6", ])                 # komputer, telefon
klik3_naiw <- sum(klik6_oczek * naiw[names(klik6_oczek)])
cat("Mnożnik naiwny: komputer", round(naiw[["komputer"]], 2), "| telefon", round(naiw[["telefon"]], 2), "\n")
# Prawda z symulacji: oczekiwane kliknięcia tych samych wyświetleń na 3. i 6. pozycji
th3 <- theta[cbind(match(x6$urzadzenie, rownames(theta)), 3)]; th6 <- theta[cbind(match(x6$urzadzenie, rownames(theta)), 6)]
p_rez <- plogis(-2.2 + oferta_v[nr6])
prawda <- c(klik6 = sum(th6 * x6$gamma), klik3 = sum(th3 * x6$gamma))
pi95 <- function(x) quantile(x, c(.025, .975))
tab5 <- data.frame(
  wariant = c("dziś: 6. miejsce", "3. miejsce: prognoza naiwna", "3. miejsce: prognoza z eksperymentu"),
  klik = c(mean(klik6), klik3_naiw, mean(klik3)),
  klik_dolna = c(pi95(klik6)[1], NA, pi95(klik3)[1]), klik_gorna = c(pi95(klik6)[2], NA, pi95(klik3)[2]),
  rez = c(mean(rez6), klik3_naiw * rez_na_klik, mean(rez3)),
  rez_dolna = c(pi95(rez6)[1], NA, pi95(rez3)[1]), rez_gorna = c(pi95(rez6)[2], NA, pi95(rez3)[2]),
  prawda_klik = c(prawda[["klik6"]], prawda[["klik3"]], prawda[["klik3"]]),
  prawda_rez = c(prawda[["klik6"]], prawda[["klik3"]], prawda[["klik3"]]) * p_rez)
print(data.frame(tab5[1], lapply(tab5[-1], function(x) ifelse(is.na(x), "–", sprintf("%.1f", x)))), row.names = FALSE)
cat("Przyrost kliknięć (eksperyment): średnio", round(mean(klik3 - klik6), 1), "95% PI [", paste(pi95(klik3 - klik6), collapse = ", "),
    "] | przyrost rezerwacji: średnio", round(mean(rez3 - rez6), 1), "95% PI [", paste(pi95(rez3 - rez6), collapse = ", "),
    "] | P(przyrost rezerwacji <= 0) =", round(mean(rez3 - rez6 <= 0), 3), "\n")
cat("Prawda: przyrost kliknięć", round(prawda[["klik3"]] - prawda[["klik6"]], 1), "| przyrost rezerwacji",
    round((prawda[["klik3"]] - prawda[["klik6"]]) * p_rez, 1), "\n")

tab5$wariant <- factor(tab5$wariant, levels = rev(tab5$wariant))
rys <- function(sr, dl, gr, pr, tytul, x) {
  ggplot(tab5, aes(.data[[sr]], wariant)) +
    geom_errorbar(aes(xmin = .data[[dl]], xmax = .data[[gr]]), width = 0.25, orientation = "y",
                  colour = kol[["niebieski"]], linewidth = 0.8, na.rm = TRUE) +
    geom_point(aes(colour = wariant == "3. miejsce: prognoza naiwna"), size = 3.2, show.legend = FALSE) +
    geom_point(aes(x = .data[[pr]]), shape = 4, size = 3.4, stroke = 1.3, colour = "grey15") +
    geom_text(aes(label = sprintf("%.1f", .data[[sr]])), vjust = -1, size = 3.6, colour = "#0f1d3a") +
    scale_colour_manual(values = c("TRUE" = kol[["pomaranczowy"]], "FALSE" = kol[["niebieski"]])) +
    scale_x_continuous(expand = expansion(mult = c(0.05, 0.12))) +
    labs(title = tytul, x = x, y = NULL) + motyw
}
p5 <- rys("klik", "klik_dolna", "klik_gorna", "prawda_klik", "A. Kliknięcia w miesiącu", "Liczba kliknięć") +
  (rys("rez", "rez_dolna", "rez_gorna", "prawda_rez", "B. Rezerwacje w miesiącu", "Liczba rezerwacji") +
     theme(axis.text.y = element_blank())) +
  plot_layout(widths = c(1.25, 1)) +
  plot_annotation(subtitle = sprintf("Oferta nr %d: %d wyświetleń na 6. miejscu w 30 dniach\nkreski – 95%% przedział predykcji, krzyżyki – prawda z symulacji",
                                     nr6, sum(n_d)), theme = motyw)
p5                       # do pliku: ggsave("pozycja-ctr-prognoza-6-na-3.svg", p5, width = 10, height = 4.8)
Wynik w R
Rezerwacje na 100 kliknięć według pozycji (grupa z zamianą): 1: 11.8 2: 11.7 3: 10.6 4: 10.8 5: 10.8 6: 11.5 7: 11.3 8: 11.5 9: 12.3 10: 12.5
Test chi-kwadrat równości odsetka rezerwacji na pozycjach 1–10: chi2 = 7.86 df = 9 p = .548
Oferta nr 191 : na 6. miejscu 631 razy (komputer 236 , telefon 395 ) | kliknięć tam 24 | rezerwacje na kliknięcie w historii 7.4 % ( 29 / 393 )
Mnożnik naiwny: komputer 2.24 | telefon 3.15
                             wariant klik klik_dolna klik_gorna rez rez_dolna rez_gorna prawda_klik prawda_rez
                    dziś: 6. miejsce 15.3        8.0       24.0 1.1       0.0       4.0        14.9        1.0
         3. miejsce: prognoza naiwna 40.8          –          – 3.0         –         –        27.8        2.0
 3. miejsce: prognoza z eksperymentu 27.5       17.0       39.0 2.0       0.0       5.0        27.8        2.0
Przyrost kliknięć (eksperyment): średnio 12.3 95% PI [ 0, 26 ] | przyrost rezerwacji: średnio 0.9 95% PI [ -2, 5 ] | P(przyrost rezerwacji <= 0) = 0.427
Prawda: przyrost kliknięć 12.9 | przyrost rezerwacji 0.9
6. Grafika: lista wyników z odsetkami – Rysunek 6
R
# Rysunek 6. Grafika: lista wyników z odsetkami – co mówią logi, a co sama pozycja
# (korzysta z kol, motyw, p_telefon i ctr z przepisu 1, krzywa z przepisu 3 i wyn z przepisu 4; nic nie losuje)
library(ggplot2)

# Logi: CTR na pozycji względem 1. (oba urządzenia razem); eksperyment: średnia ważona udziałem telefonów
lg <- aggregate(cbind(klik, wysw) ~ pozycja, data = ctr, FUN = sum)
lg$wzgl <- (lg$klik / lg$wysw) / (lg$klik[1] / lg$wysw[1])
ek <- with(krzywa, tapply(wzgl * ifelse(urzadzenie == "telefon", p_telefon, 1 - p_telefon), pozycja, sum))
karta <- data.frame(pozycja = 1:10, logi = lg$wzgl, eksperyment = as.numeric(ek), y = 10:1)
print(data.frame(pozycja = karta$pozycja, logi_proc = round(100 * karta$logi), sama_pozycja_proc = round(100 * karta$eksperyment)),
      row.names = FALSE)

m36 <- wyn[wyn$metoda %in% c("Logi: surowy CTR", "Eksperyment: logistyczna + efekt oferty"), c("urzadzenie", "metoda", "m")]
tekst36 <- sprintf("Z 6. na 3. miejsce:\nlogi obiecują ×%.2f (komputer)\ni ×%.2f (telefon),\neksperyment daje ×%.2f i ×%.2f",
                   m36$m[m36$urzadzenie == "komputer" & grepl("^Logi", m36$metoda)],
                   m36$m[m36$urzadzenie == "telefon" & grepl("^Logi", m36$metoda)],
                   m36$m[m36$urzadzenie == "komputer" & grepl("^Eksp", m36$metoda)],
                   m36$m[m36$urzadzenie == "telefon" & grepl("^Eksp", m36$metoda)])
x0 <- 1.2; skala <- 3.4                                       # początek i długość paska 100%
p6 <- ggplot(karta) +
  geom_rect(aes(xmin = 0, xmax = 5.2, ymin = y - 0.42, ymax = y + 0.42), fill = "#f4f2ee", colour = "#dedbd4") +
  geom_rect(aes(xmin = 0, xmax = 5.2, ymin = y - 0.42, ymax = y + 0.42), data = karta[karta$pozycja %in% c(3, 6), ],
            fill = NA, colour = "#0f1d3a", linewidth = 0.7) +
  geom_text(aes(x = 0.35, y = y, label = paste0(pozycja, ".")), size = 4.6, fontface = "bold", colour = "#0f1d3a") +
  geom_rect(aes(xmin = x0, xmax = x0 + skala * logi, ymin = y + 0.04, ymax = y + 0.30), fill = kol[["pomaranczowy"]]) +
  geom_rect(aes(xmin = x0, xmax = x0 + skala * eksperyment, ymin = y - 0.30, ymax = y - 0.04), fill = kol[["niebieski"]]) +
  geom_text(aes(x = x0 + skala * logi + 0.08, y = y + 0.17, label = sprintf("%.0f%%", 100 * logi)), hjust = 0, size = 3.3,
            colour = kol[["pomaranczowy"]]) +
  geom_text(aes(x = x0 + skala * eksperyment + 0.08, y = y - 0.17, label = sprintf("%.0f%%", 100 * eksperyment)),
            hjust = 0, size = 3.3, colour = kol[["niebieski"]], fontface = "bold") +
  annotate("curve", x = 5.35, y = 5, xend = 5.35, yend = 8, curvature = 0.45, colour = "#0f1d3a",
           arrow = arrow(length = unit(0.18, "cm")), linewidth = 0.6) +
  annotate("rect", xmin = 6.25, xmax = 10.6, ymin = 6.2, ymax = 9.9, fill = "#dcebf6", colour = NA) +
  annotate("text", x = 6.4, y = 8.05, hjust = 0, size = 3.7, lineheight = 0.95, colour = "#0f1d3a", label = tekst36) +
  annotate("rect", xmin = 6.25, xmax = 10.6, ymin = 0.6, ymax = 5.8, fill = "#f4f2ee", colour = "#dedbd4") +
  annotate("text", x = 6.4, y = 3.2, hjust = 0, size = 3.5, lineheight = 0.95, colour = "#0f1d3a",
           label = paste("Jak czytać kartę:",
                         "pomarańczowy pasek – CTR z logów względem 1.;",
                         "miesza efekt pozycji z tym, że wyżej stoją",
                         "lepsze oferty.",
                         "Niebieski pasek – sam efekt pozycji",
                         "z eksperymentu z zamianą sąsiednich",
                         "pozycji (62% telefon, 38% komputer).",
                         "Różnica to błąd selekcji.", sep = "\n")) +
  coord_cartesian(xlim = c(-0.1, 10.7), ylim = c(0.5, 10.6), expand = FALSE) +
  labs(title = "Lista wyników: CTR z logów a czysty efekt pozycji",
       subtitle = "Odsetki względem 1. pozycji (= 100%); obramowane pozycje 3. i 6.", x = NULL, y = NULL) +
  motyw + theme(panel.grid.major = element_blank(), axis.text = element_blank())
p6                       # do pliku: ggsave("pozycja-ctr-lista-wynikow-karta.svg", p6, width = 10, height = 6.2)
Wynik w R
 pozycja logi_proc sama_pozycja_proc
       1       100               100
       2        58                72
       3        36                55
       4        25                43
       5        18                34
       6        13                30
       7         9                25
       8         7                21
       9         5                18
      10         3                16
7. Kontrola palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – pomarańczowy" = c("#0072B2", "#D55E00"), "błękit – żółty" = c("#56B4E9", "#E69F00"),
             "niebieski – grafit" = c("#0072B2", "#333333"), "czerwony – zielony (dla porównania)" = c("#E41A1C", "#4DAF4A"))
odl <- function(p, f = identity) { x <- f(p); as.numeric(sqrt(rowSums(diff(as(hex2RGB(x), "LAB")@coords)^2))) }
print(round(t(sapply(pary, function(p) c(widzenie_typowe = odl(p), deuteranopia = odl(p, deutan),
                                           protanopia = odl(p, protan)))), 1))
Wynik w R
                                    widzenie_typowe deuteranopia protanopia
niebieski – pomarańczowy                      114.6        108.3       91.9
błękit – żółty                                113.1        111.4      101.5
niebieski – grafit                             48.3         50.3       47.4
czerwony – zielony (dla porównania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie, regresję logistyczną (glm) i test χ² wykonano pakietem stats (z podstawowej instalacji R), regresję beta-dwumianową – pakietem glmmTMB, a losowanie współczynników do prognozy – funkcją mvrnorm z pakietu MASS. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- glmmTMB (wersja 1.1.15.2): Brooks, M. E., Kristensen, K., van Benthem, K. J., Magnusson, A., Berg, C. W., Nielsen, A., Skaug, H. J., Mächler, M., & Bolker, B. M. (2017). glmmTMB balances speed and flexibility among packages for zero-inflated generalized linear mixed modeling. The R Journal, 9(2), 378–400. https://doi.org/10.32614/RJ-2017-066
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Krzywa CTR z logów jako efekt pozycji – miesza pozycję z jakością ofert (rysunki 1 i 2).
- „Dodałem efekt oferty, więc jest przyczynowo” – nie, gdy pozycja zależy od dopasowania do wyszukiwania (rysunek 4).
- Jedna krzywa dla wszystkich urządzeń – na telefonie widać mniej wyników (rysunki 3 i 6).
- Kliknięcia ≠ rezerwacje – przyrost kliknięć to nie przyrost przychodu (rysunek 5).
- Pseudoreplikacja – wyświetlenia tej samej oferty nie są niezależne; dlatego model beta-dwumianowy albo efekt oferty. Ta sama logika wraca w eksperymencie z porą wysyłki mailingu, a czas od wejścia do zakupu analizuje wpis o okresie próbnym i freemium.
Najczęstsze pytania
Dlaczego CTR na pierwszej pozycji w wynikach jest dużo wyższy niż na dalszych?
Z dwóch powodów naraz. Wynik wyżej częściej ktoś w ogóle zobaczy (efekt pozycji), a algorytm stawia wyżej oferty, które i tak są częściej klikane (błąd selekcji). W przykładzie oferty z 3. miejsca były same z siebie 1.52 raza atrakcyjniejsze niż z 6., więc stosunek CTR z logów (2.24) był wyraźnie większy niż sam efekt pozycji (1.57).
Jak zmierzyć czysty efekt pozycji w wynikach wyszukiwania?
Najprościej eksperymentem: na części ruchu losowo zamieniaj sąsiednie pozycje (np. 3. i 4.). Na obie pozycje trafiają wtedy oferty o tej samej średniej atrakcyjności, więc stosunek CTR mierzy samą pozycję. W przykładzie zamiany w 40% wyszukiwań przez 28 dni dały mnożnik 3. / 6. pozycji 1.55, 95% CI [1.35, 1.78], przy prawdziwym 1.57.
Czy efekt oferty w regresji usuwa błąd selekcji w danych o kliknięciach?
Tylko częściowo. Usuwa stałą jakość oferty, ale nie to, że ta sama oferta trafia wyżej w wyszukiwaniach, do których lepiej pasuje. W przykładzie regresja logistyczna z efektem 300 ofert na logach dała mnożnik 1.91 [1.82, 2.01] zamiast prawdziwych 1.57 – wąski przedział, ale obciążony.
Kiedy użyć regresji beta-dwumianowej zamiast logistycznej dla kliknięć?
Gdy masz zbiorcze liczby kliknięć i wyświetleń, a kliknięcia są bardziej zmienne, niż przewiduje rozkład dwumianowy – np. bo w jednej komórce są różne oferty. W przykładzie χ²/df Pearsona w modelu logistycznym wynosiło 1.57–1.72, a model beta-dwumianowy miał niższe AIC i dał zbliżony mnożnik (1.51 i 1.98) z nieco szerszym przedziałem.
Czy wyższa pozycja w wynikach zwiększa rezerwacje, czy tylko kliknięcia?
W przykładzie pozycja zmieniała tylko to, ile osób ofertę obejrzy: po kliknięciu rezerwowało 10.6–12.5% osób na każdej pozycji (p = .548). Dla oferty z 7.4% rezerwacji na kliknięcie przesunięcie z 6. na 3. miejsce dało średnio 12.3 kliknięcia, ale tylko 0.9 rezerwacji miesięcznie więcej, z 95% przedziałem predykcji [−2, 5].
Powiązane hasła
Przeczytaj też
Wyszukiwarka w sklepie – NDCG i przeplatanie
Sklep z narzędziami: precyzja@5, MRR i NDCG krok po kroku, obciążenie pozycji, test A/B vs przeplatanie team-draft i zapytania rzadkie – kod R.
Czytaj →PoradnikOkres próbny i freemium – analiza przeżycia
Ilu użytkowników kiedyś kupi i jak szybko? Kaplan–Meier, model frakcji wyleczonych i test 7 vs 14 dni okresu próbnego – z kodem R.
Czytaj →PoradnikPora wysyłki mailingu
4 pory × 8 tygodni newslettera: model mieszany zamiast pseudoreplikacji, „własna” pora odbiorcy i test personalizacji – z kodem R.
Czytaj →Analizujesz kliknięcia, rankingi albo eksperymenty online w pracy?
Pomożemy zaplanować eksperyment z losową zmianą pozycji, dobrać model dla kliknięć i opisać wyniki oraz ich ograniczenia tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Craswell, N., Zoeter, O., Taylor, M., & Ramsey, B. (2008). An experimental comparison of click position-bias models. In Proceedings of the International Conference on Web Search and Web Data Mining (WSDM '08) (pp. 87–94). Association for Computing Machinery. https://doi.org/10.1145/1341531.1341545
- Joachims, T., Swaminathan, A., & Schnabel, T. (2017). Unbiased learning-to-rank with biased feedback. In Proceedings of the Tenth ACM International Conference on Web Search and Data Mining (WSDM '17) (pp. 781–789). Association for Computing Machinery. https://doi.org/10.1145/3018661.3018699 ● Otwarty dostęp
- Narayanan, S., & Kalyanam, K. (2015). Position effects in search advertising and their moderators: A regression discontinuity approach. Marketing Science, 34(3), 388–407. https://doi.org/10.1287/mksc.2014.0893
- Skellam, J. G. (1948). A probability distribution derived from the binomial distribution by regarding the probability of success as variable between the sets of trials. Journal of the Royal Statistical Society: Series B (Methodological), 10(2), 257–261. https://doi.org/10.1111/j.2517-6161.1948.tb00014.x
- Ursu, R. M. (2018). The power of rankings: Quantifying the effect of rankings on online consumer search and purchase decisions. Marketing Science, 37(4), 530–552. https://doi.org/10.1287/mksc.2017.1072 ● Otwarty dostęp: pełny tekst
- Wang, X., Golbandi, N., Bendersky, M., Metzler, D., & Najork, M. (2018). Position bias estimation for unbiased learning to rank in personal search. In Proceedings of the Eleventh ACM International Conference on Web Search and Data Mining (WSDM '18) (pp. 610–618). Association for Computing Machinery. https://doi.org/10.1145/3159652.3159732 ● Otwarty dostęp
Cytowania BibTeX
@inproceedings{craswell2008experimental, author={Craswell, Nick and Zoeter, Onno and Taylor, Michael and Ramsey, Bill}, title={{An experimental comparison of click position-bias models}}, booktitle={Proceedings of the International Conference on Web Search and Web Data Mining (WSDM '08)}, year={2008}, pages={87--94}, publisher={Association for Computing Machinery}, doi={10.1145/1341531.1341545}}@inproceedings{joachims2017unbiased, author={Joachims, Thorsten and Swaminathan, Adith and Schnabel, Tobias}, title={{Unbiased learning-to-rank with biased feedback}}, booktitle={Proceedings of the Tenth ACM International Conference on Web Search and Data Mining (WSDM '17)}, year={2017}, pages={781--789}, publisher={Association for Computing Machinery}, doi={10.1145/3018661.3018699}}@article{narayanan2015position, author={Narayanan, Sridhar and Kalyanam, Kirthi}, title={{Position effects in search advertising and their moderators: A regression discontinuity approach}}, journal={Marketing Science}, year={2015}, volume={34}, number={3}, pages={388--407}, doi={10.1287/mksc.2014.0893}}@article{skellam1948probability, author={Skellam, J. G.}, title={{A probability distribution derived from the binomial distribution by regarding the probability of success as variable between the sets of trials}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1948}, volume={10}, number={2}, pages={257--261}, doi={10.1111/j.2517-6161.1948.tb00014.x}}@article{ursu2018power, author={Ursu, Raluca M.}, title={{The power of rankings: Quantifying the effect of rankings on online consumer search and purchase decisions}}, journal={Marketing Science}, year={2018}, volume={37}, number={4}, pages={530--552}, doi={10.1287/mksc.2017.1072}}@inproceedings{wang2018position, author={Wang, Xuanhui and Golbandi, Nadav and Bendersky, Michael and Metzler, Donald and Najork, Marc}, title={{Position bias estimation for unbiased learning to rank in personal search}}, booktitle={Proceedings of the Eleventh ACM International Conference on Web Search and Data Mining (WSDM '18)}, year={2018}, pages={610--618}, publisher={Association for Computing Machinery}, doi={10.1145/3159652.3159732}}