Co to jest pasmo ufności i pasmo predykcji?
Zacieniowany obszar wokół prostej na wykresie regresji prostej może oznaczać dwie różne rzeczy. Pasmo ufności (ang. confidence band) łączy przedziały ufności dla średniego wyniku przy kolejnych wartościach predyktora – mówi, jak dokładnie znamy położenie prostej. Pasmo predykcji (prediction band) łączy przedziały, w których powinien wypaść wynik jednej nowej osoby. Błąd standardowy średniej przy wartości x0 to s·√(1/n + (x0 − x̄)²/Σ(x − x̄)²), a dla nowej osoby pod pierwiastkiem dochodzi jeszcze 1 – rozrzut osób wokół prostej. Dlatego pasmo predykcji jest zawsze szersze. Przedziały ufności w regresji przystępnie omawiają Bewick, Cheek i Ball (2003).
Jak czytać oba pasma
- Pasmo ufności odpowiada na pytanie „gdzie leży prawdziwa średnia dla osób w wieku x0?”. Jest najwęższe przy średniej predyktora.
- Pasmo predykcji odpowiada na pytanie „jaki wynik może mieć kolejna osoba w wieku x0?”.
- Pasmo punktowe a jednoczesne. Zwykłe pasmo jest punktowe: 95% pokrycia ma przy każdym x0 osobno. Pasmo obejmujące całą prostą naraz – pasmo Workinga–Hotellinga (Working i Hotelling, 1929) – jest szersze: kwantyl t zastępuje w nim √(2F0.95; 2, n−2).
Przykład
W symulowanych danych 30 dzieci w wieku 6–12 lat przewidywano tempo czytania (słowa na minutę) na podstawie wieku. Parametry symulacji (prosta 20 + 12 × wiek, σ = 15) ustawiono ręcznie, by różnica pasm była wyraźna; ziaren (779, 7790, 77900) nie zmieniano. Dopasowana prosta to 39.34 + 9.64 × wiek, s = 16.11. Dla dziewięciolatków przewidywana średnia wynosi 126.1 słowa na minutę, 95% CI [120.1, 132.1], a 95% przedział predykcji dla jednego dziecka – [92.6, 159.6], czyli jest ponad pięć razy szerszy.
Na rysunku
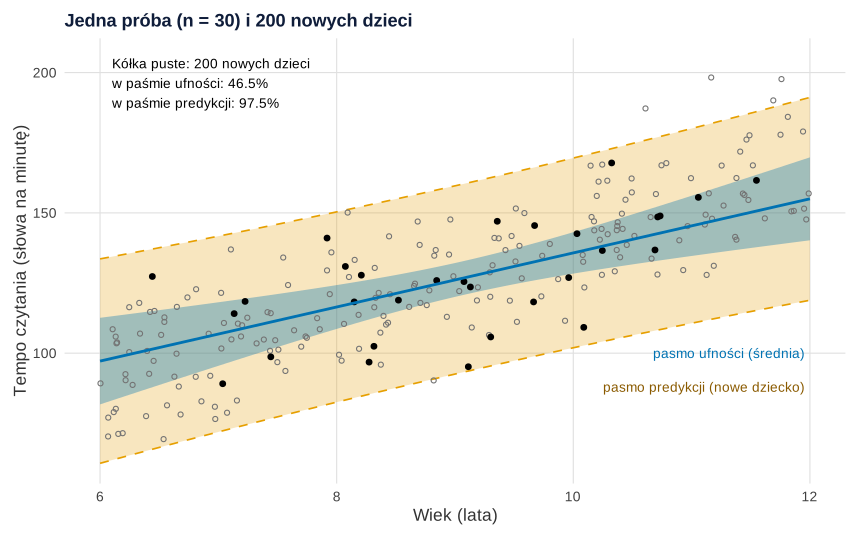
set.seed(779) i set.seed(7790)).Co widać. Pasmo ufności obejmuje tylko 46.5% nowych dzieci, a pasmo predykcji – 97.5%. To nie wada: pasmo ufności dotyczy średniej, nie pojedynczych osób. Opisanie go jako „zakresu typowych wyników” wprowadza czytelnika w błąd.
Na co uważać. Oba pasma zakładają liniowość i stały rozrzut. Przy heterogeniczności wariancji pasmo predykcji jest za wąskie tam, gdzie rozrzut jest duży. Poza zakresem danych żadne pasmo nie chroni przed ekstrapolacją – pokazuje to wpis wynik regresji na wykresie.
Podpis do pracy:
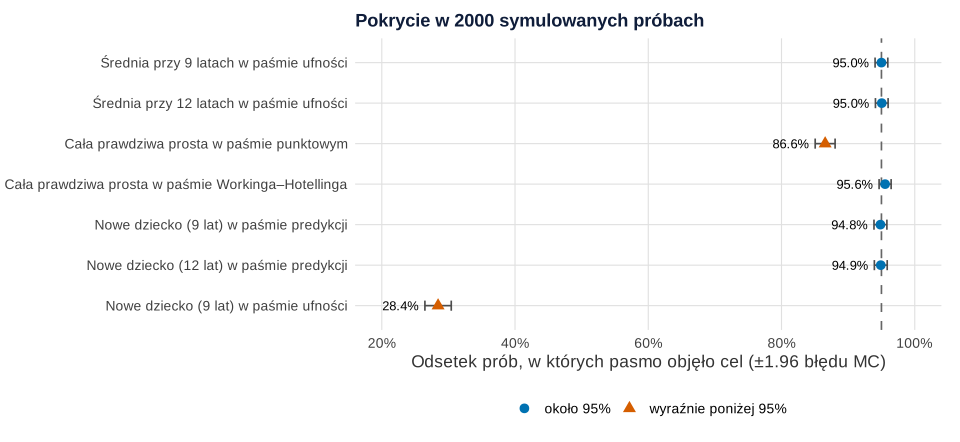
set.seed(77900)).Co widać. Każde pasmo ma 95% pokrycia, ale tylko dla swojego celu: pasmo ufności obejmuje prawdziwą średnią w 95.0% prób (przy 9 i przy 12 latach), a pasmo predykcji – nowe dziecko w 94.8% i 94.9%. Nowe dziecko w paśmie ufności to tylko 28.4% prób (błąd MC 1.0 punktu procentowego). Całą prawdziwą prostą pasmo punktowe obejmuje w 86.6% prób, a pasmo Workinga–Hotellinga w 95.6%.
Na co uważać. Pokrycie to średnia po wielu próbach, nie gwarancja dla konkretnej próby. Symulacja zakłada liniowy model z normalnym błędem; przy skośnych resztach pasmo predykcji pokrywa gorzej.
Podpis do pracy:
Kod obu rysunków zawiera sekcja Oba pasma w R; na stronie obiekty p1 i p2 dostały tylko motyw serwisu.
Jak opisać w pracy
Na co uważać
- Pasmo bez nazwy. Napisz w podpisie, czy to pasmo ufności, czy predykcji, i na jakim poziomie.
- Pasmo ufności jako zakres norm. Do wyznaczania typowych wyników osób służy pasmo predykcji, nie ufności.
- Pasmo punktowe jako jednoczesne. Wniosek o całej linii wymaga pasma jednoczesnego.
- Mylenie z metaanalizą. Przedział predykcji w metaanalizie dotyczy efektu w nowym badaniu, nie wyniku nowej osoby. Dopasowanie prostej pokazuje wpis metoda najmniejszych kwadratów w obrazkach.
Oba pasma w R
Kod symuluje próbę, dopasowuje regresję prostą funkcją lm(), wyznacza oba pasma funkcją predict() (interval = "confidence" i interval = "prediction"), sprawdza je na 200 nowych dzieciach, a potem w 2000 próbach liczy pokrycie z błędem Monte Carlo. Każdy losujący blok ma własne set.seed(). Obliczenia trwają około sekundy.
Pasma, nowe obserwacje i pokrycie
R
# Pasmo ufności i pasmo predykcji w regresji prostej + symulacja pokrycia
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})  # patchwork: oba rysunki razem
kol <- c(ufnosc = "#0072B2", predykcja = "#E69F00", nowe = "#D55E00")  # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom")
b0 <- 20; b1 <- 12; sigma <- 15                     # prawdziwa prosta i rozrzut (ustalone ręcznie)
set.seed(779)                                       # próba: 30 dzieci w wieku 6–12 lat
n <- 30
wiek <- runif(n, 6, 12)
tempo <- b0 + b1 * wiek + rnorm(n, 0, sigma)        # słowa przeczytane na minutę
m <- lm(tempo ~ wiek)
siatka <- data.frame(wiek = seq(6, 12, by = 0.05))
pu <- predict(m, siatka, interval = "confidence")   # pasmo ufności (punktowe, 95%)
pp <- predict(m, siatka, interval = "prediction")   # pasmo predykcji (95%)
pasma <- data.frame(siatka, fit = pu[, 1], u_d = pu[, 2], u_g = pu[, 3], p_d = pp[, 2], p_g = pp[, 3])
set.seed(7790)                                      # 200 nowych dzieci z tej samej populacji
nowe <- data.frame(wiek = runif(200, 6, 12))
nowe$tempo <- b0 + b1 * nowe$wiek + rnorm(200, 0, sigma)
gu <- predict(m, nowe, interval = "confidence"); gp <- predict(m, nowe, interval = "prediction")
w_ufn <- mean(nowe$tempo >= gu[, 2] & nowe$tempo <= gu[, 3])
w_pred <- mean(nowe$tempo >= gp[, 2] & nowe$tempo <= gp[, 3])
x0 <- data.frame(wiek = 9)
przedzialy <- rbind(predict(m, x0, interval = "confidence"), predict(m, x0, interval = "prediction"))
rownames(przedzialy) <- c("ufnosc_9_lat", "predykcja_9_lat")
round(przedzialy, 1)
round(c(b0 = coef(m)[[1]], b1 = coef(m)[[2]], sigma = sigma(m)), 2)
round(c(nowe_w_pasmie_ufnosci = w_ufn, nowe_w_pasmie_predykcji = w_pred), 3)
p1 <- ggplot(pasma, aes(wiek)) +
  geom_ribbon(aes(ymin = p_d, ymax = p_g), fill = kol[["predykcja"]], alpha = 0.25) +
  geom_line(aes(y = p_d), colour = kol[["predykcja"]], linetype = "dashed") +
  geom_line(aes(y = p_g), colour = kol[["predykcja"]], linetype = "dashed") +
  geom_ribbon(aes(ymin = u_d, ymax = u_g), fill = kol[["ufnosc"]], alpha = 0.35) +
  geom_point(data = nowe, aes(y = tempo), shape = 1, colour = "grey45", size = 1.4) +
  geom_point(data = data.frame(wiek, tempo), aes(y = tempo), shape = 16, colour = "black", size = 2) +
  geom_line(aes(y = fit), colour = kol[["ufnosc"]], linewidth = 1) +
  annotate("text", x = 6.1, y = 205, hjust = 0, vjust = 1, size = 3.6,
           label = sprintf("Kółka puste: 200 nowych dzieci\nw paśmie ufności: %.1f%%\nw paśmie predykcji: %.1f%%",
                           100 * w_ufn, 100 * w_pred)) +
  annotate("text", x = 11.95, y = 100, hjust = 1, size = 3.6, colour = kol[["ufnosc"]],
           label = "pasmo ufności (średnia)") +
  annotate("text", x = 11.95, y = 88, hjust = 1, size = 3.6, colour = "#8A5A00",
           label = "pasmo predykcji (nowe dziecko)") +
  labs(title = "Jedna próba (n = 30) i 200 nowych dzieci",
       x = "Wiek (lata)", y = "Tempo czytania (słowa na minutę)")
# Symulacja: jak często każde pasmo „łapie” to, co ma łapać (2000 prób po 30 dzieci)
set.seed(77900)
R <- 2000; xs <- seq(6, 12, by = 0.1); X <- cbind(1, xs)
tq <- qt(0.975, n - 2); W <- sqrt(2 * qf(0.95, 2, n - 2))  # W: pasmo jednoczesne Workinga–Hotellinga
wyn <- t(replicate(R, {
  x <- runif(n, 6, 12); y <- b0 + b1 * x + rnorm(n, 0, sigma)
  f <- lm.fit(cbind(1, x), y); s <- sqrt(sum(f$residuals^2) / (n - 2))
  V <- solve(crossprod(cbind(1, x)))
  dop <- drop(X %*% f$coefficients); se <- s * sqrt(rowSums((X %*% V) * X))
  prawda <- b0 + b1 * xs
  i <- c(srodek = which.min(abs(xs - 9)), brzeg = which.min(abs(xs - 12)))
  ynowe <- prawda[i] + rnorm(2, 0, sigma)
  c(ci_sr = abs(dop[i[1]] - prawda[i[1]]) <= tq * se[i[1]],
    ci_br = abs(dop[i[2]] - prawda[i[2]]) <= tq * se[i[2]],
    cala_punktowe = all(abs(dop - prawda) <= tq * se),
    cala_wh = all(abs(dop - prawda) <= W * se),
    nowa_pred = abs(ynowe[1] - dop[i[1]]) <= tq * sqrt(s^2 + se[i[1]]^2),
    nowa_pred_br = abs(ynowe[2] - dop[i[2]]) <= tq * sqrt(s^2 + se[i[2]]^2),
    nowa_ufn = abs(ynowe[1] - dop[i[1]]) <= tq * se[i[1]])
}))
pokr <- data.frame(
  co = c("Średnia przy 9 latach w paśmie ufności", "Średnia przy 12 latach w paśmie ufności",
         "Cała prawdziwa prosta w paśmie punktowym", "Cała prawdziwa prosta w paśmie Workinga–Hotellinga",
         "Nowe dziecko (9 lat) w paśmie predykcji", "Nowe dziecko (12 lat) w paśmie predykcji",
         "Nowe dziecko (9 lat) w paśmie ufności"),
  p = colMeans(wyn))
pokr$bmc <- sqrt(pokr$p * (1 - pokr$p) / R)        # błąd Monte Carlo
pokr$co <- factor(pokr$co, levels = rev(pokr$co))
pokr$ok <- ifelse(abs(pokr$p - 0.95) <= 0.02, "około 95%", "wyraźnie poniżej 95%")
print(transform(pokr[, c("co", "p", "bmc")], proc = round(100 * p, 1), bmc_proc = round(100 * bmc, 1),
                p = NULL, bmc = NULL), row.names = FALSE)
p2 <- ggplot(pokr, aes(p, co, shape = ok)) +
  geom_vline(xintercept = 0.95, linetype = "dashed", colour = "grey40") +
  geom_errorbar(aes(xmin = p - 1.96 * bmc, xmax = p + 1.96 * bmc), width = 0.25, orientation = "y",
                colour = "grey30") +
  geom_point(aes(colour = ok), size = 3) +
  geom_text(aes(x = p - 1.96 * bmc - 0.01, label = paste0(format(round(100 * p, 1), nsmall = 1), "%")), hjust = 1, size = 3.4) +
  scale_colour_manual(values = c("około 95%" = kol[["ufnosc"]], "wyraźnie poniżej 95%" = kol[["nowe"]]), name = NULL) +
  scale_shape_manual(values = c("około 95%" = 16, "wyraźnie poniżej 95%" = 17), name = NULL) +
  scale_x_continuous(labels = function(x) paste0(100 * x, "%"), limits = c(0.2, 1)) +
  labs(title = "Pokrycie w 2000 symulowanych próbach",
       x = "Odsetek prób, w których pasmo objęło cel (±1.96 błędu MC)", y = NULL)
p1 <- p1 + motyw
p2 <- p2 + motyw
p1 / p2
Wynik w R
                  fit   lwr   upr
ufnosc_9_lat    126.1 120.1 132.1
predykcja_9_lat 126.1  92.6 159.6
   b0    b1 sigma
39.34  9.64 16.11
  nowe_w_pasmie_ufnosci nowe_w_pasmie_predykcji
                  0.465                   0.975
                                                 co proc bmc_proc
             Średnia przy 9 latach w paśmie ufności 95.0      0.5
            Średnia przy 12 latach w paśmie ufności 95.0      0.5
           Cała prawdziwa prosta w paśmie punktowym 86.6      0.8
 Cała prawdziwa prosta w paśmie Workinga–Hotellinga 95.6      0.5
            Nowe dziecko (9 lat) w paśmie predykcji 94.8      0.5
           Nowe dziecko (12 lat) w paśmie predykcji 94.9      0.5
              Nowe dziecko (9 lat) w paśmie ufności 28.4      1.0
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje bazowe lm(), predict(), lm.fit(), qt() i qf(); rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Dlaczego pasmo ufności jest węższe w środku niż na brzegach?
Błąd standardowy przewidywanej średniej rośnie z kwadratem odległości od średniej predyktora. W środku chmury punktów niepewność dotyczy głównie wysokości prostej, a na brzegach dokłada się niepewność nachylenia, więc pasmo przyjmuje kształt klepsydry.
Czy pasmo predykcji zwęzi się, gdy zbiorę dużo więcej danych?
Tylko trochę. Z większą próbą znika niepewność położenia prostej, ale zostaje rozrzut osób wokół niej. Pasmo predykcji dąży więc do szerokości około dwóch odchyleń standardowych reszt w każdą stronę, a nie do zera jak pasmo ufności.
Które pasmo narysować w artykule?
To, które odpowiada pytaniu. Wniosek o przeciętnym wyniku grupy osób o danej wartości predyktora wymaga pasma ufności, a pytanie, jaki wynik może mieć konkretna nowa osoba – pasma predykcji. W podpisie zawsze nazwij pasmo i podaj jego poziom.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Wynik regresji na wykresie
Współczynniki z CI, pasmo ufności a predykcji, ekstrapolacja, interakcja, efekty brzegowe i prawdopodobieństwa – pięć rysunków z kodem R i podpisami APA.
Czytaj →PoradnikMetoda najmniejszych kwadratów w obrazkach
Reszty jako kwadraty, parabola sumy kwadratów, regresja y na x i x na y, oś główna, dźwignia i R² – skąd się bierze prosta regresji, na rysunkach z R.
Czytaj →PoradnikSiatka płac z regresji
220 płac w biurze projektowym: log(płacy) w procentach, przedział predykcji, płace poza siatką i widełki z regresji kwantylowej – z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bewick, V., Cheek, L., & Ball, J. (2003). Statistics review 7: Correlation and regression. Critical Care, 7(6), 451–459. https://doi.org/10.1186/cc2401 ● Otwarty dostęp
- Working, H., & Hotelling, H. (1929). Applications of the theory of error to the interpretation of trends. Journal of the American Statistical Association, 24(165A), 73–85. https://doi.org/10.1080/01621459.1929.10506274
Cytowania BibTeX
@article{bewick2003statistics, author={Bewick, Viv and Cheek, Liz and Ball, Jonathan}, title={{Statistics review 7: Correlation and regression}}, journal={Critical Care}, year={2003}, volume={7}, number={6}, pages={451--459}, doi={10.1186/cc2401}}@article{working1929applications, author={Working, Holbrook and Hotelling, Harold}, title={{Applications of the theory of error to the interpretation of trends}}, journal={Journal of the American Statistical Association}, year={1929}, volume={24}, number={165A}, pages={73--85}, doi={10.1080/01621459.1929.10506274}}