Czternaście osób i jedna prosta
Wzory na współczynniki i przykład liczony ręcznie znajdziesz w haśle metoda najmniejszych kwadratów. Tutaj nie ma ani jednego wzoru do przepisywania – są obrazy. Pokazują, co prosta regresji właściwie minimalizuje, dlaczego jest tylko jedna, czemu „odwrotna” regresja daje inną prostą i jak z tych samych kwadratów powstaje R².
Dane są fikcyjne: 14 studentów, wynik kolokwium i wynik egzaminu, oba w procentach. Ta sama skala na obu osiach jest celowa – tylko wtedy reszty można narysować jako prawdziwe kwadraty. Średnie wynoszą 62.29% (kolokwium) i 63.36% (egzamin), korelacja Pearsona r = .61. Prosta regresji liniowej ma postać: egzamin = 16.70 + 0.75 × kolokwium.
Przy każdym rysunku znajdziesz: co widać, czego wykres nie pokazuje, gotowy podpis i zdanie do pracy. Podpisy są w jednym ciągu – w pracy rozdziel numer, tytuł i notę „Uwaga.” według APA 7.
Kolory. Rysunki używają palety Okabe–Ito, a proste różnią się też rodzajem linii. Symulacja deuteranopii w przepisie 6 pokazuje, że para niebieski–cynober prawie nie traci kontrastu (ΔE 114.6 wobec 108.3), podczas gdy para czerwony–zielony spada ze 121.7 do 21.1.
Reszta: odcinek, który staje się kwadratem
Reszta to pionowa odległość punktu od prostej: wynik egzaminu minus wynik przewidywany. MNK sumuje nie odcinki, lecz ich kwadraty – czyli pola.
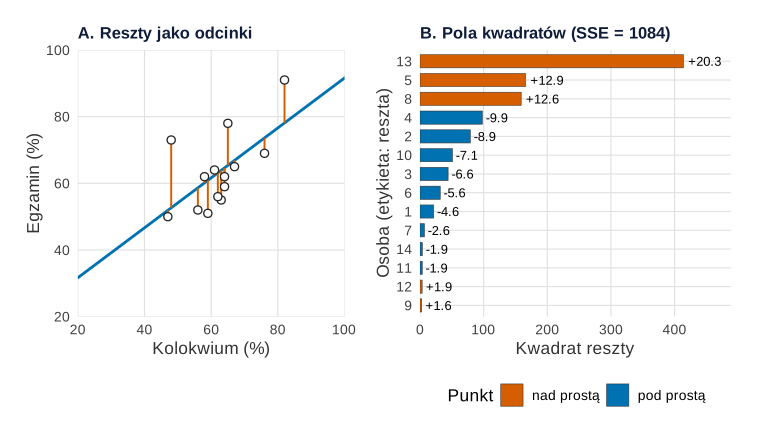
Co widać. Odcinki nad prostą i pod nią się równoważą: suma reszt wynosi 0, i tak jest zawsze, gdy model ma wyraz wolny. Dlatego nie da się po prostu „zsumować błędów” – trzeba się pozbyć znaku. Kwadrat robi to z wyraźną konsekwencją: osoba 13 (kolokwium 48%, egzamin 73%) ma resztę +20.3 i jej kwadrat, 414, to 38.2% całej sumy kwadratów reszt (SSE = 1084). Gdyby sumować wartości bezwzględne reszt, ta sama osoba miałaby udział 20.6%.
Czego ten wykres nie pokazuje. Rysunek nie mówi, czy prosta jest dobra – tylko jak rozkłada się błąd przy tej konkretnej prostej. Mała SSE nie oznacza też poprawnego modelu: łuk, lejek czy dwa pasma (zob. galeria wykresów reszt) mogą mieć małą sumę kwadratów i nadal łamać założenia.
Podpis do pracy.
Zdanie do pracy.
Trzy kandydatki i parabola
Każdą prostą można ocenić tą samą miarą: łącznym polem kwadratów. Porównajmy trzy kandydatki. A – pozioma linia na średniej egzaminu, czyli „model bez predyktora”. B – przekątna egzamin = kolokwium, czyli naiwna prognoza „dostaniesz tyle, ile na kolokwium”. C – prosta MNK.
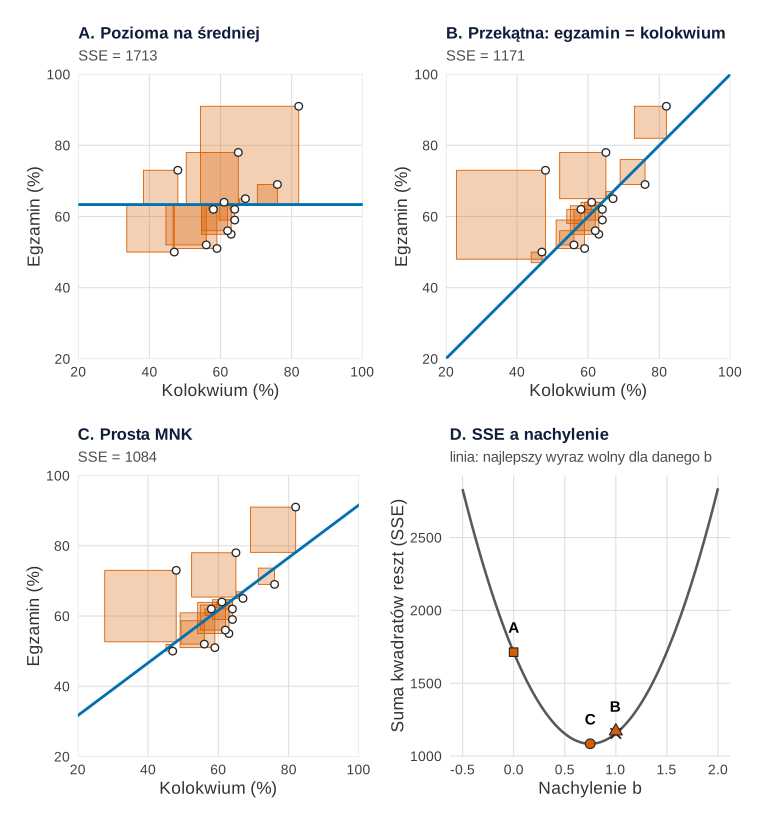
Co widać. Pozioma linia daje SSE = 1713, przekątna 1171, prosta MNK 1084 – najmniej. W panelu D każdy punkt krzywej to SSE prostej o danym nachyleniu, poprowadzonej przez punkt średnich (przy danym nachyleniu to najlepszy możliwy wyraz wolny). Krzywa jest parabolą z jednym minimum przy b = 0.75 – stąd jedna, jednoznaczna prosta MNK. Przekątna (trójkąt B) leży nieco nad parabolą: ma dobre nachylenie, ale zły wyraz wolny – jej reszty sumują się do 15, a nie do zera. Gdyby przesunąć ją do punktu średnich (krzyżyk), SSE spadłaby do 1154.93.
Czego ten wykres nie pokazuje. Parabola jest dla tej próby. Inne 14 osób dałoby inną parabolę i inne minimum – rozrzut tych minimów to właśnie błąd standardowy nachylenia (tu 95% CI dla b od 0.13 do 1.37). Płaskie dno paraboli oznacza, że wiele nachyleń jest prawie równie dobrych. Panel D nie pokazuje też wyrazu wolnego wprost: pełny „krajobraz” SSE to misa w dwóch wymiarach (nachylenie i wyraz wolny), a parabola pokazuje dla każdego nachylenia najniższy punkt tej misy.
Podpis do pracy.
Zdanie do Metody.
Nazwa „metoda najmniejszych kwadratów” pochodzi z początku XIX wieku; Stigler (1981) opisuje spór Legendre’a z Gaussem o pierwszeństwo jej odkrycia.
Y na X, X na Y i oś główna: trzy proste z tych samych danych
MNK mierzy odległość pionowo, bo pyta: jak dobrze przewiduję egzamin, znając kolokwium? Można jednak zapytać odwrotnie – jak przewidzieć kolokwium z egzaminu – i wtedy liczą się odległości poziome. Trzecia możliwość to oś główna: prosta minimalizująca odległości prostopadłe, czyli kierunek największego rozrzutu chmury (to samo, co pierwsza składowa główna dwóch zmiennych).
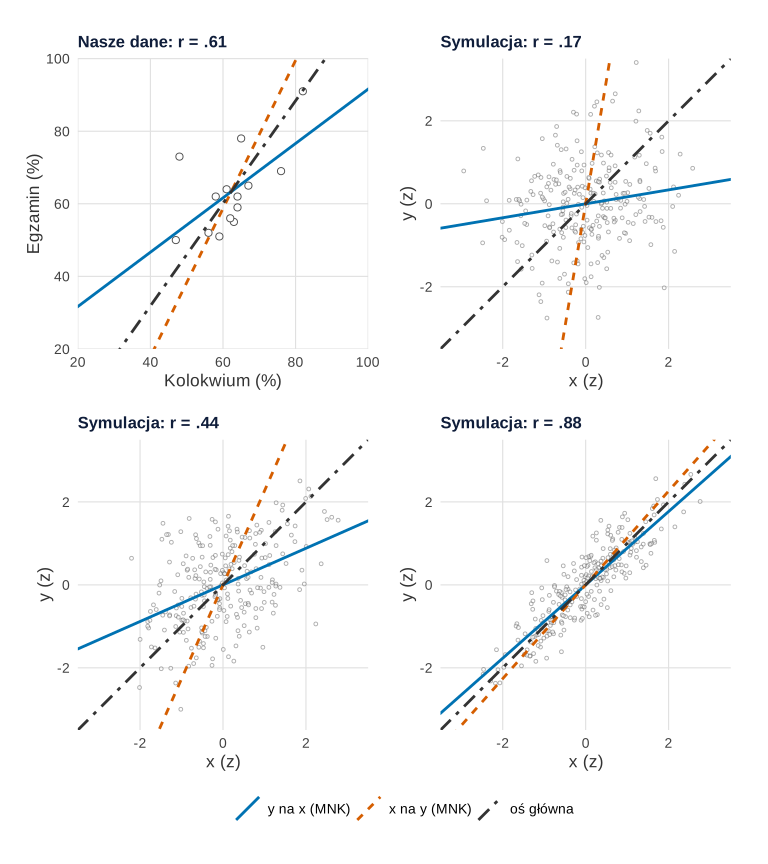
Co widać. W naszych danych regresja egzaminu na kolokwium ma nachylenie 0.75, regresja kolokwium na egzamin – przerysowana w tym samym układzie – 2.04, a oś główna 1.41. Trzy proste przecinają się w punkcie średnich i rozchodzą jak nożyce. W panelach z danymi w skali z widać regułę: nachylenie y na x równa się r, nachylenie x na y (w tym układzie) to 1/r, a oś główna przy dodatniej korelacji ma zawsze nachylenie 1. Przy r = .17 nożyce są rozwarte (0.17 wobec 5.95), przy r = .88 prawie zamknięte (0.88 wobec 1.13). Tylko przy r = 1 wszystkie trzy proste się pokrywają.
Skąd regresja do średniej. Nachylenie mniejsze niż 1 w skali z oznacza, że przewidywanie jest zawsze bliżej średniej niż punkt wyjścia. W symulacji z r = .44 10% osób z najwyższym x miało średnio z = 1.89 na osi x, ale tylko 1.17 na osi y. Działa to także w drugą stronę: 10% najlepszych na osi y miało średnio 1.67 na y i 1.08 na x. Żadna zmienna nie „ciągnie” drugiej – to skutek niepełnej korelacji. Tak wygląda regresja do średniej, a jej pułapki w badaniu przed–po opisuje wpis regresja do średniej w badaniu przed–po; Barnett i in. (2005) zwracają uwagę, że efekt jest silniejszy przy dużym błędzie pomiaru i przy analizie podgrupy wybranej po wyniku wyjściowym.
Czego ten wykres nie pokazuje. Wykres nie mówi, którą prostą wybrać – to zależy od pytania. Warton i in. (2006) w przeglądzie metod dopasowania prostej opisują regresję, oś główną i standaryzowaną oś główną jako alternatywy do różnych pytań badawczych. Smith (2009) podkreśla, że prosta MNK jest asymetryczna (zamiana zmiennych zmienia nachylenie), a osie główne są symetryczne, i proponuje, by o wyborze decydowało właśnie to, czy pytanie jest symetryczne. Gdy chcesz przewidywać egzamin – MNK y na x. Gdy porównujesz dwie metody pomiaru tej samej wielkości i obie mają błąd – raczej regresja Deminga (zob. zgodność dwóch metod pomiaru). Oś główna zależy też od jednostek: policzona na danych standaryzowanych (standaryzowana oś główna) i przeliczona z powrotem na procenty miałaby w naszych danych nachylenie 1.24, a nie 1.41.
Podpis do pracy.
Zdanie do Metody.
Jeden punkt: odstający w y czy dźwignia
Skoro MNK minimalizuje pola, jedno duże pole może przesunąć całą prostą. Ale nie każde tak samo. Dopisuję do 14 osób jedną piętnastą – raz z przeciętnym kolokwium i bardzo wysokim egzaminem (62% i 98%), raz ze skrajnym kolokwium i słabym egzaminem (97% i 50%). Pełną galerię takich przypadków na wykresach reszt pokazuje galeria wykresów reszt; tu chodzi tylko o mechanikę kwadratów.
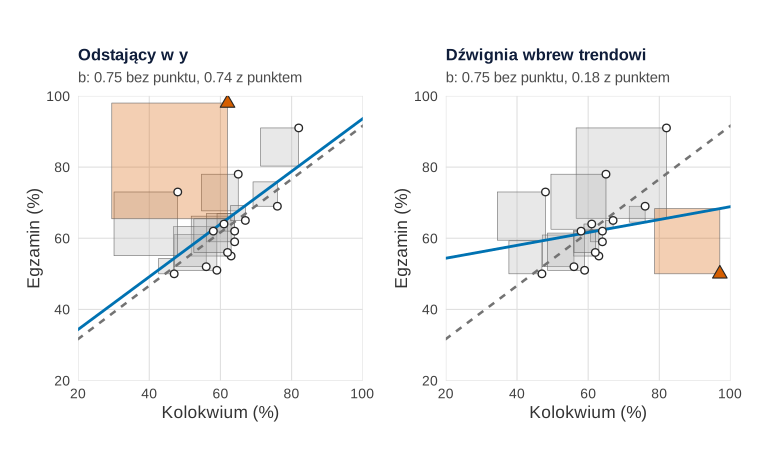
Co widać. Po lewej kwadrat dopisanej osoby jest ogromny – to 47.7% SSE – a mimo to nachylenie prawie się nie zmienia (0.74 wobec 0.75); prosta tylko się podnosi (wyraz wolny z 16.70 na 19.54). Punkt leży blisko średniej kolokwium, więc obrót prostej nic by nie dał. Po prawej kwadrat jest mniejszy (18.6% SSE), ale nachylenie spada z 0.75 do 0.18. Punkt ma dużą dźwignię (h = .53): leży daleko na osi x, więc obracając prostą, MNK zmniejsza jego kwadrat kosztem niewielkich zmian u pozostałych. Dlatego jego kwadrat jest „mały” – prosta już do niego podeszła. Odległość Cooka wynosi 2.98, wobec 0.24 dla punktu odstającego w y.
Czego ten wykres nie pokazuje. Mały kwadrat nie znaczy „niegroźny” – punkt wpływowy ukrywa swój kwadrat właśnie dlatego, że przyciągnął prostą. Hoaglin i Welsch (1978) opisują macierz kapeluszową, która mówi, jak każda obserwowana wartość wpływa na wartości dopasowane, a Cook (1977) zaproponował miarę łączącą resztę z tą informacją. Wykres nie powie też, czy to błąd w danych, czy prawdziwa osoba – to sprawdzasz w źródle (zob. wartości odstające: jak je wykryć). Gdy obserwacja jest prawdziwa, rozważ analizę wrażliwości z regresją odporną.
Podpis do pracy.
Zdanie do Wyników.
R² jako część pola „zabrana” przez prostą
Wróć do kandydatki A z Rysunku 2: pozioma linia na średniej to model bez predyktora, a jej suma kwadratów to całkowita zmienność wyniku (SST). Prosta MNK zostawia mniejsze kwadraty (SSE). Różnica to SSR – kwadraty odległości między prostą a średnią.
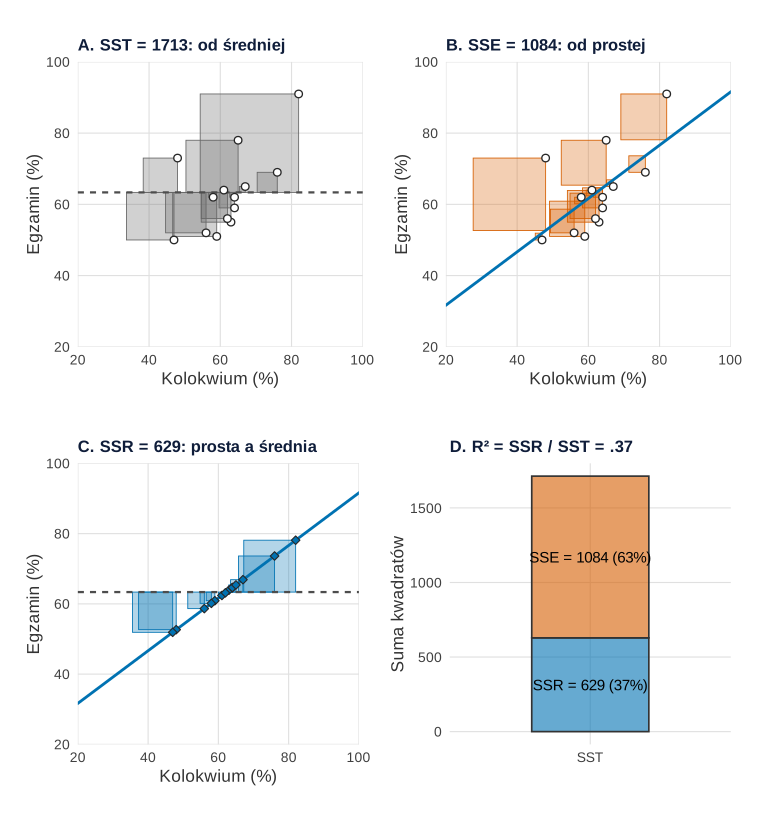
Co widać. SST = 1713.21, SSE = 1084.34, SSR = 628.88, a SSR + SSE daje dokładnie SST. Stosunek SSR/SST to R² = .37: prosta „zabrała” 37% pola kwadratów wokół średniej. W regresji z jednym predyktorem to po prostu r² (.61² ≈ .37). Ten sam podział stoi za testem F: SSR na 1 stopień swobody podzielone przez SSE na 12 stopni swobody daje F(1, 12) = 6.96, p = .022. Skąd się bierze rozkład tej statystyki, pokazuje wpis skąd się biorą rozkłady t, χ² i F.
Czego ten wykres nie pokazuje. R² mówi, jaką część zmienności wyjaśnia prosta w tej próbie – nie czy prosta jest właściwym kształtem i nie czy związek jest przyczynowy. W małej próbie R² jest zawyżone; jak to korygować, opisuje hasło R-kwadrat skorygowany. Kwartet Anscombe’a pokazuje, że te same R² mogą mieć cztery zupełnie różne obrazy (zawsze narysuj dane). Na Rysunku 4 jedna osoba obniżyła r z .61 do .20 – R² dziedziczy całą wrażliwość kwadratów.
Podpis do pracy.
Zdanie do Wyników.
Ściąga: co który obraz wyjaśnia
| Pojęcie | Obraz | Liczba w przykładzie |
|---|---|---|
| reszta | pionowy odcinek od punktu do prostej | największa: +20.3 |
| SSE | łączne pole kwadratów reszt | 1084 |
| prosta MNK | minimum paraboli SSE | b = 0.75 |
| regresja x na y | odległości poziome, stroma prosta | 2.04 w tym samym układzie |
| oś główna | odległości prostopadłe | 1.41 |
| dźwignia | punkt daleko na osi x obraca prostą | h = .53, b spada do 0.18 |
| R² | część pola SST „zabrana” przez prostą | .37 |
Jak pokazać sam wynik regresji – współczynniki z przedziałami i przewidywania z pasmem – opisuje wpis wynik regresji na wykresie. Inna metoda szacowania, największej wiarygodności, ma swój obraz w regresji logistycznej (regresja logistyczna w obrazkach).
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę, motyw, funkcję kwadraty() i osie, z których korzystają następne. Każdy przepis kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu przepisu 1. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Dane symulowane nie wymagają pobierania – kod sam je tworzy. Dla wygody 14 par wyników z przepisu 1 jest też w pliku mnk-dane-kolokwium-egzamin.csv (kolumny kolokwium, egzamin). Ziarna losowania ustalono z góry, bez dobierania pod wynik: 572 na początku przepisu 1 (dane 14 osób) i 5723 przed symulacjami w przepisie 3, więc symulacje odtworzysz także po skopiowaniu samego przepisu 3 (dane z przepisu 1 nie są losowane ponownie). Parametry ręczne: model generujący dane (20 + 0.65 × kolokwium, SD błędu 8), dwie dopisane osoby w przepisie 4, korelacje .2/.5/.9 i 250 osób w symulacjach przepisu 3. Przepisy nie są symulacjami Monte Carlo – każda liczba pochodzi z jednej wylosowanej próby.
1. Dane, paleta, motyw i reszty: Rysunek 1
R
# Reszty jako pionowe odcinki i jako kwadraty: 14 studentów, kolokwium i egzamin (dane symulowane)
library(ggplot2)
library(patchwork)
# Paleta Okabe–Ito (czytelna przy zaburzeniach widzenia barw) i prosty motyw
okabe <- c(niebieski = "#0072B2", cynober = "#D55E00", zielony = "#009E73", pomarancz = "#E69F00")
theme_set(theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(size = rel(0.95), face = "bold")))

set.seed(572)
n <- 14
dane <- data.frame(kolokwium = round(rnorm(n, 60, 12)))              # wynik kolokwium w %
dane$egzamin <- round(20 + 0.65 * dane$kolokwium + rnorm(n, 0, 8))   # wynik egzaminu w %
m <- lm(egzamin ~ kolokwium, data = dane)
dane$dopasowane <- fitted(m)
dane$reszta <- residuals(m)
round(c(srednia_x = mean(dane$kolokwium), srednia_y = mean(dane$egzamin), b0 = coef(m)[[1]],
        b1 = coef(m)[[2]], r = cor(dane$kolokwium, dane$egzamin), SSE = sum(dane$reszta^2),
        suma_reszt = sum(dane$reszta), max_reszta = max(abs(dane$reszta))), 3)

# Kwadrat reszty: bok = |reszta|, rysowany od punktu w lewo; przy coord_equal to naprawdę kwadrat
kwadraty <- function(d, przewidywane) {
  e <- d$egzamin - przewidywane
  data.frame(xmin = d$kolokwium - abs(e), xmax = d$kolokwium,
             ymin = pmin(d$egzamin, przewidywane), ymax = pmax(d$egzamin, przewidywane))
}
osie <- list(coord_equal(xlim = c(20, 100), ylim = c(20, 100), expand = FALSE),
             labs(x = "Kolokwium (%)", y = "Egzamin (%)"))

odcinki <- ggplot(dane, aes(kolokwium, egzamin)) +
  geom_abline(intercept = coef(m)[[1]], slope = coef(m)[[2]], colour = okabe[["niebieski"]], linewidth = 1) +
  geom_segment(aes(xend = kolokwium, yend = dopasowane), colour = okabe[["cynober"]], linewidth = 0.7) +
  geom_point(shape = 21, fill = "white", colour = "grey15", size = 2.4, stroke = 0.7) +
  osie + labs(title = "A. Reszty jako odcinki")
# Udział każdej osoby w SSE: kwadrat sprawia, że największa reszta „waży” nieproporcjonalnie dużo
udzial <- data.frame(osoba = factor(seq_len(n)), reszta = dane$reszta,
                     kwadrat = dane$reszta^2, proc_SSE = 100 * dane$reszta^2 / sum(dane$reszta^2),
                     proc_sumy_modulow = 100 * abs(dane$reszta) / sum(abs(dane$reszta)))
udzial <- udzial[order(-udzial$kwadrat), ]
print(head(udzial, 3), digits = 3, row.names = FALSE)
udzial$osoba <- factor(udzial$osoba, levels = rev(udzial$osoba))
udzial$znak <- ifelse(udzial$reszta > 0, "nad prostą", "pod prostą")
pola <- ggplot(udzial, aes(kwadrat, osoba, fill = znak)) +
  geom_col(width = 0.7, colour = "grey20", linewidth = 0.2) +
  geom_text(aes(label = sprintf("%+.1f", reszta)), hjust = -0.15, size = 3.4) +
  scale_fill_manual(values = c("nad prostą" = okabe[["cynober"]], "pod prostą" = okabe[["niebieski"]]), name = "Punkt") +
  scale_x_continuous(expand = expansion(mult = c(0, 0.18))) +
  labs(title = paste0("B. Pola kwadratów (SSE = ", round(sum(dane$reszta^2)), ")"),
       x = "Kwadrat reszty", y = "Osoba (etykieta: reszta)")

p1 <- odcinki + pola
p1
# ggsave("mnk-reszty-odcinki-kwadraty.svg", p1, width = 8, height = 4.6)   # zapis do pliku (pakiet svglite)
Wynik w R
 srednia_x  srednia_y         b0         b1          r        SSE suma_reszt
    62.286     63.357     16.702      0.749      0.606   1084.338      0.000
max_reszta
    20.343
 osoba reszta kwadrat proc_SSE proc_sumy_modulow
    13   20.3     414     38.2              20.6
     5   12.9     166     15.3              13.1
     8   12.6     159     14.7              12.8
2. Trzy kandydackie proste i parabola SSE: Rysunek 2
R
# Trzy kandydackie proste i suma kwadratów reszt (SSE) w funkcji nachylenia (wymaga przepisu 1)
kandydaci <- data.frame(
  prosta = c("A. Pozioma na średniej", "B. Przekątna: egzamin = kolokwium", "C. Prosta MNK"),
  b0 = c(mean(dane$egzamin), 0, coef(m)[[1]]),
  b1 = c(0, 1, coef(m)[[2]]))
kandydaci$SSE <- sapply(seq_len(nrow(kandydaci)), function(i)
  sum((dane$egzamin - kandydaci$b0[i] - kandydaci$b1[i] * dane$kolokwium)^2))
kandydaci$suma_reszt <- round(sapply(seq_len(nrow(kandydaci)), function(i)
  sum(dane$egzamin - kandydaci$b0[i] - kandydaci$b1[i] * dane$kolokwium)), 2)
print(kandydaci, digits = 4, row.names = FALSE)

panel_kandydata <- function(i) {
  przew <- kandydaci$b0[i] + kandydaci$b1[i] * dane$kolokwium
  ggplot(dane, aes(kolokwium, egzamin)) +
    geom_rect(data = kwadraty(dane, przew), inherit.aes = FALSE,
              aes(xmin = xmin, xmax = xmax, ymin = ymin, ymax = ymax),
              fill = okabe[["cynober"]], alpha = 0.3, colour = okabe[["cynober"]], linewidth = 0.3) +
    geom_abline(intercept = kandydaci$b0[i], slope = kandydaci$b1[i],
                colour = okabe[["niebieski"]], linewidth = 1) +
    geom_point(shape = 21, fill = "white", colour = "grey15", size = 2.2, stroke = 0.7) +
    osie + labs(title = kandydaci$prosta[i], subtitle = paste0("SSE = ", round(kandydaci$SSE[i])))
}

# Profil SSE: dla każdego nachylenia b najlepszy wyraz wolny to ȳ − b·x̄ (prosta przez punkt średnich)
SSE_b <- function(b) sum((dane$egzamin - (mean(dane$egzamin) - b * mean(dane$kolokwium)) - b * dane$kolokwium)^2)
profil <- data.frame(b = seq(-0.5, 2, by = 0.01))
profil$SSE <- sapply(profil$b, SSE_b)
round(c(b_minimum_siatki = profil$b[which.min(profil$SSE)], SSE_minimum = min(profil$SSE),
        SSE_b1_najlepszy_wyraz_wolny = SSE_b(1)), 2)

punkty <- data.frame(b = kandydaci$b1, SSE = kandydaci$SSE, etykieta = c("A", "B", "C"))
parabola <- ggplot(profil, aes(b, SSE)) +
  geom_line(colour = "grey35", linewidth = 0.9) +
  geom_point(data = data.frame(b = 1, SSE = SSE_b(1)), shape = 4, size = 2.6, stroke = 1, colour = "grey15") +
  geom_point(data = punkty, aes(shape = etykieta), size = 3, fill = okabe[["cynober"]], colour = "grey15") +
  geom_text(data = punkty, aes(label = etykieta), nudge_y = 170, size = 4, fontface = "bold") +
  scale_shape_manual(values = c(A = 22, B = 24, C = 21), guide = "none") +
  labs(title = "D. SSE a nachylenie", subtitle = "linia: najlepszy wyraz wolny dla danego b",
       x = "Nachylenie b", y = "Suma kwadratów reszt (SSE)")

p2 <- (panel_kandydata(1) + panel_kandydata(2)) / (panel_kandydata(3) + parabola)
p2
Wynik w R
                            prosta    b0    b1  SSE suma_reszt
            A. Pozioma na średniej 63.36 0.000 1713          0
 B. Przekątna: egzamin = kolokwium  0.00 1.000 1171         15
                     C. Prosta MNK 16.70 0.749 1084          0
            b_minimum_siatki                  SSE_minimum
                        0.75                      1084.34
SSE_b1_najlepszy_wyraz_wolny
                     1154.93
3. Y na X, X na Y i oś główna: Rysunek 3
R
# Regresja y na x, x na y i oś główna: trzy różne proste przy r < 1 (wymaga przepisu 1)
trzy_proste <- function(x, y) {
  sxx <- var(x); syy <- var(y); sxy <- cov(x, y)
  b_yx <- sxy / sxx                                    # y na x: minimalizuje odległości pionowe
  b_xy <- syy / sxy                                    # x na y, przerysowana w układzie (x, y): poziome
  b_os <- (syy - sxx + sqrt((syy - sxx)^2 + 4 * sxy^2)) / (2 * sxy)   # oś główna: prostopadłe
  data.frame(prosta = c("y na x (MNK)", "x na y (MNK)", "oś główna"),
             b1 = c(b_yx, b_xy, b_os), b0 = mean(y) - c(b_yx, b_xy, b_os) * mean(x))
}
proste_dane <- trzy_proste(dane$kolokwium, dane$egzamin)
print(proste_dane, digits = 3, row.names = FALSE)
round(c(r = cor(dane$kolokwium, dane$egzamin),
        SMA_os_standaryzowana = sign(cor(dane$kolokwium, dane$egzamin)) * sd(dane$egzamin) / sd(dane$kolokwium)), 3)

# Duże próby z populacji o r = .2, .5 i .9 w skali z (obie zmienne: średnia 0, SD 1)
set.seed(5723)                                       # własne ziarno przepisu 3
N <- 250
symulacja <- do.call(rbind, lapply(c(0.2, 0.5, 0.9), function(rho) {
  zx <- rnorm(N); zy <- rho * zx + sqrt(1 - rho^2) * rnorm(N)
  data.frame(rho = rho, zx = as.numeric(scale(zx)), zy = as.numeric(scale(zy)))
}))
nachylenia <- do.call(rbind, lapply(split(symulacja, symulacja$rho), function(d)
  cbind(rho = d$rho[1], r = cor(d$zx, d$zy), trzy_proste(d$zx, d$zy)[, c("prosta", "b1")])))
print(nachylenia, digits = 3, row.names = FALSE)

# Regresja do średniej w obie strony (r = .5): 10% najlepszych na osi x i 10% najlepszych na osi y
d5 <- symulacja[symulacja$rho == 0.5, ]
gora_x <- d5$zx >= quantile(d5$zx, 0.9); gora_y <- d5$zy >= quantile(d5$zy, 0.9)
round(rbind(najlepsi_w_x = c(srednia_zx = mean(d5$zx[gora_x]), srednia_zy = mean(d5$zy[gora_x])),
            najlepsi_w_y = c(srednia_zx = mean(d5$zx[gora_y]), srednia_zy = mean(d5$zy[gora_y]))), 2)

kolejnosc <- c("y na x (MNK)", "x na y (MNK)", "oś główna")
style <- list(scale_colour_manual(breaks = kolejnosc, values = c("y na x (MNK)" = okabe[["niebieski"]],
                                             "x na y (MNK)" = okabe[["cynober"]], "oś główna" = "grey20"), name = NULL),
              scale_linetype_manual(breaks = kolejnosc, values = c("y na x (MNK)" = "solid", "x na y (MNK)" = "22",
                                               "oś główna" = "4212"), name = NULL))
panel_trzy <- function(d, proste, tytul, x, y, zakres, rozmiar = 2.2, alfa = 1) {
  ggplot(d, aes({{ x }}, {{ y }})) +
    geom_point(shape = 21, fill = "white", colour = "grey30", size = rozmiar, stroke = 0.5, alpha = alfa) +
    geom_abline(data = proste, aes(intercept = b0, slope = b1, colour = prosta, linetype = prosta), linewidth = 1) +
    style + coord_equal(xlim = zakres, ylim = zakres, expand = FALSE) + labs(title = tytul)
}
panele <- list(panel_trzy(dane, proste_dane, paste0("Nasze dane: r = ", sub("^0", "", sprintf("%.2f", cor(dane$kolokwium, dane$egzamin)))),
                          kolokwium, egzamin, c(20, 100)) + labs(x = "Kolokwium (%)", y = "Egzamin (%)"))
for (rho in c(0.2, 0.5, 0.9)) {
  d <- symulacja[symulacja$rho == rho, ]
  panele[[length(panele) + 1]] <- panel_trzy(d, trzy_proste(d$zx, d$zy),
    paste0("Symulacja: r = ", sub("^0", "", sprintf("%.2f", cor(d$zx, d$zy)))), zx, zy, c(-3.5, 3.5), 1, 0.45) +
    labs(x = "x (z)", y = "y (z)")
}
p3 <- wrap_plots(panele, ncol = 2) + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p3
Wynik w R
       prosta    b1    b0
 y na x (MNK) 0.749  16.7
 x na y (MNK) 2.041 -63.7
    oś główna 1.413 -24.7
                    r SMA_os_standaryzowana
                0.606                 1.236
 rho     r       prosta    b1
 0.2 0.168 y na x (MNK) 0.168
 0.2 0.168 x na y (MNK) 5.948
 0.2 0.168    oś główna 1.000
 0.5 0.441 y na x (MNK) 0.441
 0.5 0.441 x na y (MNK) 2.266
 0.5 0.441    oś główna 1.000
 0.9 0.884 y na x (MNK) 0.884
 0.9 0.884 x na y (MNK) 1.131
 0.9 0.884    oś główna 1.000
             srednia_zx srednia_zy
najlepsi_w_x       1.89       1.17
najlepsi_w_y       1.08       1.67
4. Jeden dopisany punkt: Rysunek 4
R
# Jeden dopisany punkt: odstający w y (zwykłe kolokwium) a punkt dźwigni (skrajne kolokwium) (wymaga przepisu 1)
dopisany <- list("Odstający w y" = data.frame(kolokwium = 62, egzamin = 98),
                 "Dźwignia wbrew trendowi" = data.frame(kolokwium = 97, egzamin = 50))
wplyw <- sapply(dopisany, function(o) {
  d <- rbind(dane[, c("kolokwium", "egzamin")], o); mm <- lm(egzamin ~ kolokwium, data = d)
  e <- residuals(mm)
  c(b1_bez = coef(m)[[2]], b1_z = coef(mm)[[2]], b0_z = coef(mm)[[1]],
    reszta_z = e[[15]], dzwignia_h = hatvalues(mm)[[15]], Cook_D = cooks.distance(mm)[[15]],
    udzial_w_SSE_proc = 100 * e[[15]]^2 / sum(e^2), r_z = cor(d$kolokwium, d$egzamin))
})
round(wplyw, 3)

panel_punkt <- function(nazwa) {
  o <- dopisany[[nazwa]]; d <- rbind(dane[, c("kolokwium", "egzamin")], o)
  mm <- lm(egzamin ~ kolokwium, data = d); przew <- fitted(mm)
  kw <- kwadraty(d, przew); kw$typ <- c(rep("pozostali", n), "dopisany")
  ggplot(d, aes(kolokwium, egzamin)) +
    geom_rect(data = kw, inherit.aes = FALSE, aes(xmin = xmin, xmax = xmax, ymin = ymin, ymax = ymax, fill = typ),
              alpha = 0.3, colour = "grey40", linewidth = 0.2) +
    geom_abline(intercept = coef(m)[[1]], slope = coef(m)[[2]], colour = "grey45", linetype = "22", linewidth = 0.9) +
    geom_abline(intercept = coef(mm)[[1]], slope = coef(mm)[[2]], colour = okabe[["niebieski"]], linewidth = 1) +
    geom_point(data = dane, shape = 21, fill = "white", colour = "grey15", size = 2.2, stroke = 0.7) +
    geom_point(data = o, shape = 24, fill = okabe[["cynober"]], colour = "grey15", size = 3.4) +
    scale_fill_manual(values = c(pozostali = "grey70", dopisany = okabe[["cynober"]]), guide = "none") +
    coord_equal(xlim = c(20, 100), ylim = c(20, 100), expand = FALSE) +
    labs(title = nazwa, subtitle = sprintf("b: %.2f bez punktu, %.2f z punktem", coef(m)[[2]], coef(mm)[[2]]),
         x = "Kolokwium (%)", y = "Egzamin (%)")
}
p4 <- panel_punkt("Odstający w y") + panel_punkt("Dźwignia wbrew trendowi")
p4
Wynik w R
                  Odstający w y Dźwignia wbrew trendowi
b1_bez                    0.749                   0.749
b1_z                      0.741                   0.181
b0_z                     19.543                  50.764
reszta_z                 32.531                 -18.336
dzwignia_h                0.067                   0.534
Cook_D                    0.238                   2.978
udzial_w_SSE_proc        47.707                  18.616
r_z                       0.466                   0.198
5. SST, SSR, SSE i R²: Rysunek 5
R
# R² na rysunku: SST = SSR + SSE jako pola kwadratów (wymaga przepisu 1)
y_sr <- mean(dane$egzamin)
SST <- sum((dane$egzamin - y_sr)^2)            # od średniej: rozrzut bez modelu
SSE <- sum((dane$egzamin - dane$dopasowane)^2) # od prostej: rozrzut, którego model nie wyjaśnia
SSR <- sum((dane$dopasowane - y_sr)^2)         # od średniej do prostej: część „zabrana” przez prostą
round(c(SST = SST, SSR = SSR, SSE = SSE, SSR_plus_SSE = SSR + SSE, R2 = SSR / SST,
        R2_z_lm = summary(m)$r.squared, r_do_kwadratu = cor(dane$kolokwium, dane$egzamin)^2), 3)
# Test F to też stosunek pól: SSR na 1 stopień swobody do SSE na n − 2 stopni swobody
F_stat <- (SSR / 1) / (SSE / (n - 2))
round(c(F = F_stat, df1 = 1, df2 = n - 2, p = pf(F_stat, 1, n - 2, lower.tail = FALSE),
        p_z_lm = anova(m)[["Pr(>F)"]][1]), 4)
round(confint(m)["kolokwium", ], 2)

# Kwadraty o boku (górny − dolny), rysowane w lewo od x
kwadrat_od_do <- function(x, gora, dol) data.frame(xmin = x - abs(gora - dol), xmax = x,
                                                     ymin = pmin(gora, dol), ymax = pmax(gora, dol))
panel_sumy <- function(kw, tytul, kolor, linia_sr = TRUE, linia_mnk = TRUE) {
  ggplot(dane, aes(kolokwium, egzamin)) +
    geom_rect(data = kw, inherit.aes = FALSE, aes(xmin = xmin, xmax = xmax, ymin = ymin, ymax = ymax),
              fill = kolor, alpha = 0.3, colour = kolor, linewidth = 0.3) +
    { if (linia_sr) geom_hline(yintercept = y_sr, colour = "grey30", linetype = "22", linewidth = 0.8) } +
    { if (linia_mnk) geom_abline(intercept = coef(m)[[1]], slope = coef(m)[[2]], colour = okabe[["niebieski"]], linewidth = 1) } +
    geom_point(shape = 21, fill = "white", colour = "grey15", size = 2.2, stroke = 0.7) +
    osie + labs(title = tytul)
}
pSST <- panel_sumy(kwadrat_od_do(dane$kolokwium, dane$egzamin, y_sr),
                   paste0("A. SST = ", round(SST), ": od średniej"), "grey40", linia_mnk = FALSE)
pSSE <- panel_sumy(kwadrat_od_do(dane$kolokwium, dane$egzamin, dane$dopasowane),
                   paste0("B. SSE = ", round(SSE), ": od prostej"), okabe[["cynober"]], linia_sr = FALSE)
pSSR <- ggplot(dane, aes(kolokwium, dopasowane)) +
  geom_rect(data = kwadrat_od_do(dane$kolokwium, dane$dopasowane, y_sr), inherit.aes = FALSE,
            aes(xmin = xmin, xmax = xmax, ymin = ymin, ymax = ymax),
            fill = okabe[["niebieski"]], alpha = 0.3, colour = okabe[["niebieski"]], linewidth = 0.3) +
  geom_hline(yintercept = y_sr, colour = "grey30", linetype = "22", linewidth = 0.8) +
  geom_abline(intercept = coef(m)[[1]], slope = coef(m)[[2]], colour = okabe[["niebieski"]], linewidth = 1) +
  geom_point(shape = 23, fill = okabe[["niebieski"]], colour = "grey15", size = 2) +
  osie + labs(title = paste0("C. SSR = ", round(SSR), ": prosta a średnia"))
sumy <- data.frame(suma = factor(c("SSR", "SSE"), levels = c("SSE", "SSR")), wartosc = c(SSR, SSE))
pSlupek <- ggplot(sumy, aes(x = "SST", y = wartosc, fill = suma)) +
  geom_col(width = 0.5, colour = "grey20", alpha = 0.6) +
  geom_text(aes(label = paste0(suma, " = ", round(wartosc), " (", round(100 * wartosc / SST), "%)")),
            position = position_stack(vjust = 0.5), size = 4) +
  scale_fill_manual(values = c(SSR = okabe[["niebieski"]], SSE = okabe[["cynober"]]), guide = "none") +
  labs(title = paste0("D. R² = SSR / SST = ", sub("^0", "", sprintf("%.2f", SSR / SST))), x = NULL, y = "Suma kwadratów")

p5 <- (pSST + pSSE) / (pSSR + pSlupek)
p5
Wynik w R
          SST           SSR           SSE  SSR_plus_SSE            R2
     1713.214       628.876      1084.338      1713.214         0.367
      R2_z_lm r_do_kwadratu
        0.367         0.367
      F     df1     df2       p  p_z_lm
 6.9596  1.0000 12.0000  0.0216  0.0216
 2.5 % 97.5 %
  0.13   1.37
6. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Czy kolory wykresów przetrwają zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober (prosta MNK i kwadraty reszt)" = c("#0072B2", "#D55E00"),
             "szary – cynober (kwadraty SST i SSE)" = c("#666666", "#D55E00"),
             "niebieski – szary (prosta MNK i oś główna)" = c("#0072B2", "#333333"),
             "czerwony – zielony (dla porównania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                  widzenie_typowe deuteranopia
niebieski – cynober (prosta MNK i kwadraty reszt)           114.6        108.3
szary – cynober (kwadraty SST i SSE)                         77.4         64.4
niebieski – szary (prosta MNK i oś główna)                   48.3         50.3
czerwony – zielony (dla porównania)                         121.7         21.1
                                                  protanopia
niebieski – cynober (prosta MNK i kwadraty reszt)       91.9
szary – cynober (kwadraty SST i SSE)                    54.0
niebieski – szary (prosta MNK i oś główna)              47.4
czerwony – zielony (dla porównania)                     31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki wykonano w pakietach ggplot2 i patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1), 1–49. https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- „Prosta przechodzi przez jak najwięcej punktów”. MNK nie liczy trafień – minimalizuje pole kwadratów, więc może nie przechodzić przez żaden punkt.
- Odwracanie prostej algebraicznie. Przekształcenie równania y na x nie daje regresji x na y; w przykładzie nachylenia (w jednym układzie) to 0.75 i 2.04.
- Branie regresji do średniej za efekt. Najlepsi na kolokwium wypadają na egzaminie bliżej średniej, a najlepsi na egzaminie – na kolokwium. To skutek r < 1, nie interwencji.
- Szukanie wpływowego punktu po wielkości kwadratu. Punkt o dużej dźwigni miał mniejszy kwadrat niż odstający w y, a zmienił nachylenie z 0.75 na 0.18.
- MNK do porównania dwóch metod pomiaru. Gdy obie zmienne mają błąd, a pytanie jest symetryczne, rozważ regresję Deminga zamiast MNK.
- Rysowanie reszt na osiach o różnej skali. „Kwadraty” stają się prostokątami, a obraz przestaje odpowiadać sumie kwadratów.
Najczęstsze pytania
Dlaczego prosta regresji minimalizuje odległości pionowe, a nie prostopadłe?
Bo regresja y na x odpowiada na pytanie o przewidywanie y przy znanym x, a błąd przewidywania mierzy się na osi y. Prosta minimalizująca odległości prostopadłe to oś główna – opisuje kierunek największego rozrzutu chmury i traktuje obie zmienne symetrycznie. W przykładzie z tej strony nachylenia wynoszą 0.75 (y na x) i 1.41 (oś główna).
Dlaczego regresja y na x i regresja x na y dają różne proste?
Bo minimalizują różne odległości: pionowe albo poziome. W skali z nachylenie y na x równa się r, a regresja x na y narysowana w tym samym układzie ma nachylenie 1/r. Proste pokrywają się tylko przy |r| = 1; przy r = .17 w symulacji nachylenia wynosiły 0.17 i 5.95.
Kiedy użyć osi głównej zamiast regresji MNK?
Gdy pytanie jest symetryczne – interesuje Cię wspólny kierunek związku dwóch zmiennych, a nie przewidywanie jednej z drugiej. Do przewidywania zostań przy MNK y na x. Do porównania dwóch metod pomiaru z błędem w obu zmiennych zwykle stosuje się regresję Deminga lub Passinga–Babloka.
Jak narysować R² za pomocą sum kwadratów?
Narysuj kwadraty odchyleń od średniej (SST), od prostej (SSE) i między prostą a średnią (SSR). SSR + SSE = SST, a R² = SSR/SST. W przykładzie SST = 1713, SSR = 629 i SSE = 1084, więc prosta „zabrała” 37% pola.
Który punkt bardziej zmienia prostą MNK: odstający w y czy o dużej dźwigni?
Zwykle punkt o dużej dźwigni, leżący daleko na osi x wbrew trendowi. W przykładzie punkt odstający w y miał kwadrat równy 47.7% SSE, a nachylenie prawie się nie zmieniło (0.74 wobec 0.75); punkt dźwigni miał kwadrat 18.6% SSE, ale nachylenie spadło do 0.18, a odległość Cooka wyniosła 2.98.
Powiązane hasła
Przeczytaj też
Galeria wykresów reszt
Łuk, lejek, skos, dźwignia, dwa pasma i fale w czasie – jak wyglądają złamane założenia regresji na wykresach reszt z R, z podpisami i ćwiczeniem.
Czytaj →PoradnikRegresja do średniej w badaniu przed–po
Dlaczego osoby zakwalifikowane za wysoki wynik „poprawiają się” bez leczenia, ile wynosi ten efekt i jak go usunąć grupą kontrolną, ANCOVA i osobnym pomiarem wyjściowym.
Czytaj →PoradnikWynik regresji na wykresie
Współczynniki z CI, pasmo ufności a predykcji, ekstrapolacja, interakcja, efekty brzegowe i prawdopodobieństwa – pięć rysunków z kodem R i podpisami APA.
Czytaj →Nie wiesz, jak opisać regresję w pracy?
Pomożemy dobrać model regresji, sprawdzić obserwacje wpływowe i opisać wyniki z <em>R</em>² i przedziałami ufności – tak, żebyś umiał(a) je wyjaśnić i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Barnett, A. G., van der Pols, J. C., & Dobson, A. J. (2005). Regression to the mean: What it is and how to deal with it. International Journal of Epidemiology, 34(1), 215–220. https://doi.org/10.1093/ije/dyh299 ● Otwarty dostęp
- Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15–18. https://doi.org/10.1080/00401706.1977.10489493
- Hoaglin, D. C., & Welsch, R. E. (1978). The hat matrix in regression and ANOVA. The American Statistician, 32(1), 17–22. https://doi.org/10.1080/00031305.1978.10479237 ● Otwarty dostęp: pełny tekst
- Smith, R. J. (2009). Use and misuse of the reduced major axis for line-fitting. American Journal of Physical Anthropology, 140(3), 476–486. https://doi.org/10.1002/ajpa.21090
- Stigler, S. M. (1981). Gauss and the invention of least squares. The Annals of Statistics, 9(3), 465–474. https://doi.org/10.1214/aos/1176345451 ● Otwarty dostęp
- Warton, D. I., Wright, I. J., Falster, D. S., & Westoby, M. (2006). Bivariate line-fitting methods for allometry. Biological Reviews, 81(2), 259–291. https://doi.org/10.1017/s1464793106007007
Cytowania BibTeX
@article{barnett2005regression, author={Barnett, Adrian G. and van der Pols, Jolieke C. and Dobson, Annette J.}, title={{Regression to the mean: What it is and how to deal with it}}, journal={International Journal of Epidemiology}, year={2005}, volume={34}, number={1}, pages={215--220}, doi={10.1093/ije/dyh299}}@article{cook1977detection, author={Cook, R. Dennis}, title={{Detection of influential observation in linear regression}}, journal={Technometrics}, year={1977}, volume={19}, number={1}, pages={15--18}, doi={10.1080/00401706.1977.10489493}}@article{hoaglin1978hat, author={Hoaglin, David C. and Welsch, Roy E.}, title={{The hat matrix in regression and ANOVA}}, journal={The American Statistician}, year={1978}, volume={32}, number={1}, pages={17--22}, doi={10.1080/00031305.1978.10479237}}@article{smith2009use, author={Smith, Richard J.}, title={{Use and misuse of the reduced major axis for line-fitting}}, journal={American Journal of Physical Anthropology}, year={2009}, volume={140}, number={3}, pages={476--486}, doi={10.1002/ajpa.21090}}@article{stigler1981gauss, author={Stigler, Stephen M.}, title={{Gauss and the invention of least squares}}, journal={The Annals of Statistics}, year={1981}, volume={9}, number={3}, pages={465--474}, doi={10.1214/aos/1176345451}}@article{warton2006bivariate, author={Warton, David I. and Wright, Ian J. and Falster, Daniel S. and Westoby, Mark}, title={{Bivariate line-fitting methods for allometry}}, journal={Biological Reviews}, year={2006}, volume={81}, number={2}, pages={259--291}, doi={10.1017/s1464793106007007}}