Czy nowa metoda może zastąpić starą?
Badanie porównania metod (ang. method comparison study) odpowiada na praktyczne pytanie: czy wyniki z nowego urządzenia, testu albo analizatora można stosować zamiennie z wynikami metody odniesienia. Tańszy analizator bioimpedancji ma zastąpić densytometrię, glukometr – oznaczenie laboratoryjne, a skrócona procedura – pełną. Te same osoby albo próbki mierzysz obiema metodami i sprawdzasz, czy dostajesz te same liczby, a nie tylko czy wyniki rosną razem.
To drugie mierzy korelacja Pearsona, która do oceny zgodności się nie nadaje. Gdyby nowa metoda dodawała każdemu 5 jednostek, korelacja by się nie zmieniła, a zgodność byłaby zła. Bland i Altman (1986) piszą wprost, że korelacja w porównaniu metod wprowadza w błąd. Korelacja opisuje, czy osoby zachowują tę samą kolejność w obu pomiarach, a nie czy dostają te same wartości (Berchtold, 2016). Ten argument, wykres różnic i granice zgodności omawiają już hasło metoda Blanda–Altmana i poradnik badanie rzetelności pomiaru klinicznego. Tutaj ich nie powtarzamy. Zajmujemy się trzema narzędziami, które recenzenci prac z diagnostyki laboratoryjnej, nauk o sporcie czy żywienia często zestawiają z analizą Blanda–Altmana:
- współczynnikiem zgodności Lina (CCC) – jedną liczbą, która łączy precyzję i dokładność;
- regresją Deminga – prostą dla danych, w których obie metody mierzą z błędem;
- regresją Passinga–Babloka – nieparametryczną i odporną wersją tego samego pomysłu.
Obie regresje odpowiadają na pytanie, którego średnia różnica nie rozstrzyga: czy błąd nowej metody jest stały, czy rośnie z wielkością pomiaru.
Przykład: bioimpedancja a DXA
U 100 dorosłych zmierzono odsetek tkanki tłuszczowej dwiema metodami: densytometrią DXA (metoda odniesienia) i analizatorem bioimpedancji BIA (metoda nowa). Każdą metodą wykonano dwa pomiary. W porównaniu metod używamy pierwszego pomiaru, a pary pomiarów służą do oceny powtarzalności każdej metody. Dane są symulowane (set.seed(2371)). Możesz je pobrać jako plik CSV (100 wierszy: id, dxa1, dxa2, bia1, bia2).
DXA dała średnio 23.94% (SD = 4.99), BIA 23.51% (SD = 4.18). Korelacja wyniosła r = .894. Średnia różnica BIA − DXA to tylko −0.43 pkt proc., a granice zgodności od −4.84 do 3.98. Na pierwszy rzut oka BIA jest więc „prawie bez błędu systematycznego”. Mniejsze SD w BIA to jednak pierwszy sygnał, że coś jest nie tak: nowa metoda „ściska” zakres wyników. Kolejne sekcje pokazują, jak to uchwycić liczbowo.
CCC Lina: precyzja razy dokładność
Lin (1989) zaproponował współczynnik, który mierzy, jak blisko punkty leżą linii identyczności y = x, a nie dowolnej prostej. W tym tkwi różnica wobec korelacji. Wzór na współczynnik zgodności Lina (CCC):
Mianownik rośnie, gdy metody różnią się średnią albo rozrzutem, więc CCC jest zawsze niższy lub równy |r|. Rozkłada się na dwa czynniki. Korelacja r to precyzja, czyli rozrzut punktów wokół najlepszej prostej. Czynnik Cb (od 0 do 1) to dokładność, czyli odchylenie tej prostej od przekątnej. Przedział ufności liczy się po transformacji z Fishera (Lin, 1989).
W przykładzie CCC = .876, 95% CI [.826, .913]. Rozkład: r = .894 i Cb = .980. Stosunek odchyleń standardowych (BIA do DXA) wynosi 0.837, a przesunięcie położenia −0.095 SD. Zgodność obniża głównie rozrzut, a mniej różnica skali. Jedna liczba nie mówi jednak, przy jakich wartościach metoda się myli ani o ile w procentach tkanki tłuszczowej.
CCC jest liczbowo bardzo bliski ICC dla zgodności bezwzględnej i pojedynczego pomiaru. Tutaj ICC(2,1) = .877, 95% CI [.822, .916]. Dziedziczy też jego wadę: zależy od zróżnicowania próby. W grupie o szerokim zakresie tkanki tłuszczowej ta sama metoda dostanie wyższy CCC niż w jednorodnej grupie sportowców. Dlatego CCC raportuj obok wyników w jednostkach pomiaru, a nie zamiast nich.
Dlaczego nie zwykła regresja liniowa
Naturalny pomysł to regresja prosta BIA na DXA i sprawdzenie, czy przecięcie wynosi 0, a nachylenie 1. Metoda najmniejszych kwadratów (OLS) zakłada jednak, że x jest mierzony bez błędu. Gdy obie metody mają błąd, nachylenie jest zaniżone. Cornbleet i Gochman (1979) pokazali, że problem staje się istotny, gdy stosunek SD błędu pojedynczego pomiaru x do SD wartości x w próbie przekracza 0.2. Wskazali też regresję Deminga jako najbardziej użyteczne rozwiązanie.
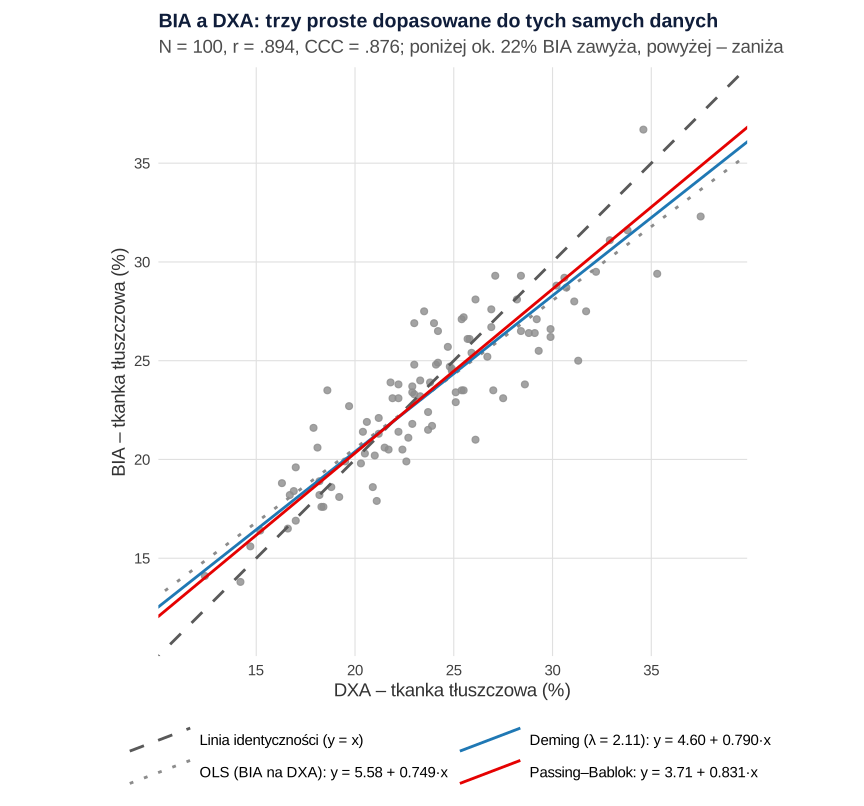
W przykładzie SD błędu DXA, oszacowane z par pomiarów, wynosi 1.18 pkt proc., a stosunek – 0.236. OLS daje y = 5.58 + 0.749x. Jeśli zamienisz osie (DXA na BIA) i przeliczysz prostą, dostaniesz nachylenie 0.936. Dwie odpowiedzi na to samo pytanie różnią się o 0.19, bo każda przypisuje cały błąd jednej metodzie.
Regresja Deminga: błąd w obu metodach
Regresja Deminga minimalizuje odległości punktów od prostej mierzone ukośnie, pod kątem wynikającym ze stosunku wariancji błędów obu metod. Oznaczmy go λ = σ²błąd BIA / σ²błąd DXA. Nachylenie ma postać zamkniętą:
Przy λ dążącym do nieskończoności (DXA bez błędu) wzór daje OLS BIA na DXA, a przy λ = 1 – regresję ortogonalną. Najlepszym źródłem λ są pomiary powtórzone w samym badaniu, tak jak tutaj. Z par pomiarów SD błędu BIA wynosi 1.71, a DXA 1.18, więc λ = 2.11. Inne źródła to dane o nieprecyzyjności z walidacji każdej metody (zob. standardowy błąd pomiaru i rzetelność test–retest).
Wynik: y = 4.60 + 0.790x. Bootstrapowe 95% CI dla nachylenia to [0.712, 0.879], a dla przecięcia [2.58, 6.43] (percentylowe, 2000 prób, zob. bootstrap). Nachylenie wyraźnie różni się od 1, a przecięcie od 0. Wrażliwość na λ jest umiarkowana: przy λ = 0.5, 1, 2.11 i 4 nachylenie wynosi 0.854, 0.820, 0.790 i 0.773. Jeśli λ jest niepewne, pokaż taką tabelę jako analizę wrażliwości.
Prosta regresja Deminga zakłada stałe SD błędu w całym zakresie. W wielu oznaczeniach stały jest raczej współczynnik zmienności. Martin (2000) pokazał w symulacjach, że prosta wersja daje wtedy niewiarygodne przedziały ufności błędu systematycznego. Wiarygodne dawała iteracyjnie ważona, ogólna regresja Deminga.
Regresja Passinga–Babloka: mediana nachyleń
Passing i Bablok (1983) zaproponowali procedurę bez założeń o rozkładzie próbek i błędów. Jej wynik nie zależy od tego, którą metodę postawisz na osi x. Algorytm regresji Passinga–Babloka jest prosty:
- Dla każdej pary obserwacji policz nachylenie odcinka, który je łączy. Przy 100 osobach to 4950 nachyleń. Pomija się pary identyczne i nachylenia równe −1.
- Posortuj nachylenia i weź ich medianę przesuniętą o K pozycji, gdzie K to liczba nachyleń mniejszych od −1. Przesunięcie sprawia, że estymator nie zależy od kolejności metod.
- Przecięcie to mediana wartości yi − bxi.
Wynik: y = 3.71 + 0.831x, bootstrapowe 95% CI dla nachylenia [0.754, 0.923], a dla przecięcia [1.54, 5.28]. Oryginalna procedura podaje też przedziały analityczne oparte na rangach nachyleń. Bootstrap jest prostą alternatywą, gdy nie masz gotowego pakietu. Bilić-Zulle (2011) przypomina założenia: dane ciągłe i liniowy związek metod. Liniowość sprawdza się wykresem reszt i testem cusum, a próbki nieliniowe nie nadają się do wnioskowania o zgodności.
Zaletą metody jest odporność. W przykładzie zaniżyliśmy o 12 pkt proc. dwa pomiary BIA przy wysokich wartościach, jakby wykonano je po wysiłku. Nachylenie Passinga–Babloka zmieniło się z 0.831 na 0.810. Nachylenie Deminga spadło z 0.790 do 0.711, a OLS z 0.749 do 0.657. CCC obniżył się z .876 do .797. Takie punkty sprawdź w dokumentacji, zanim cokolwiek zdecydujesz (zob. obserwacja odstająca). Ogólne odporne metody regresji opisujemy we wpisie regresja odporna.
Przecięcie i nachylenie: błąd stały a proporcjonalny
Obie regresje czyta się tak samo (Bilić-Zulle, 2011):
| Parametr | Wartość przy pełnej zgodności | Co oznacza odstępstwo | Jak sprawdzić |
|---|---|---|---|
| Przecięcie a | 0 | błąd stały: nowa metoda przesuwa każdy wynik o tę samą wartość | czy 95% CI dla a obejmuje 0 |
| Nachylenie b | 1 | błąd proporcjonalny: różnica rośnie lub maleje z wielkością pomiaru | czy 95% CI dla b obejmuje 1 |
| Różnica przy wartości x0 | 0 | łączny błąd systematyczny w punkcie, który ma znaczenie praktyczne | a + (b − 1)x0 z 95% CI |
Przecięcie interpretuj zawsze razem z nachyleniem. Przy nachyleniu 0.79 przecięcie 4.60 nie oznacza, że BIA zawyża każdy wynik o 4.6 pkt. Oznacza, że proste przecinają przekątną w okolicy 22%. Dlatego najbardziej użyteczna jest ostatnia kolumna tabeli: błąd systematyczny w punktach ważnych dla Twojego pytania (przedział ufności z tych samych prób bootstrapowych). Przy 15% tkanki tłuszczowej BIA zawyża wynik o 1.45 pkt proc., 95% CI [0.72, 2.15] (Deming), albo o 1.17, 95% CI [0.20, 1.86] (Passing–Bablok). Przy 30% zaniża go o 1.71, 95% CI [−2.41, −0.96], albo o 1.37, 95% CI [−2.34, −0.54].
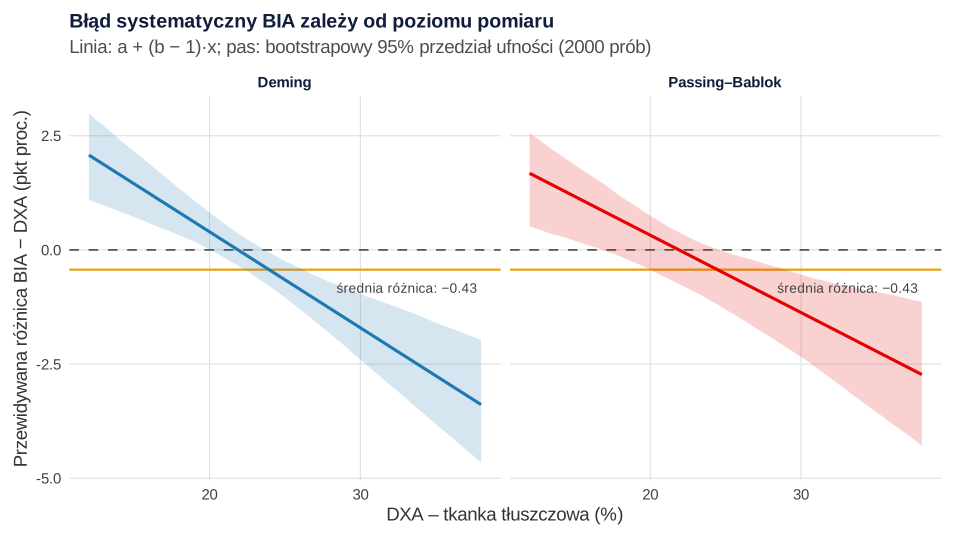
Ten sam błąd proporcjonalny widać na wykresie Blanda–Altmana jako nachylenie różnic względem średnich. Bland i Altman (1999) opisują dla takiej sytuacji granice zgodności z regresji. Regresja Deminga lub Passinga–Babloka daje natomiast gotowe równanie przeliczenia. Jeśli nowa metoda ma trafić do praktyki, możesz ją skalibrować (DXA ≈ (BIA − a) / b), a potem sprawdzić zgodność na nowej próbie.
Którą metodę wybrać
| Metoda | Odpowiada na pytanie | Wymaga | Uwaga |
|---|---|---|---|
| Bland–Altman | jak duże są różnice u pojedynczych osób | akceptowalnych granic ustalonych z góry | podstawa każdego porównania metod |
| CCC Lina | jak blisko przekątnej leżą punkty (jedna liczba) | niczego poza parami pomiarów | zależy od zróżnicowania próby, nie podaje jednostek |
| Regresja Deminga | czy błąd jest stały, czy proporcjonalny | λ lub pomiarów powtórzonych; rozkładu błędów zbliżonego do normalnego | wrażliwa na obserwacje odstające; przy stałym CV wersja ważona |
| Passing–Bablok | to samo co Deming | danych ciągłych, liniowego związku, raczej dużej próby | odporna na obserwacje odstające, nie wymaga λ ani normalności błędów |
W praktyce raportuje się dwie lub trzy metody naraz: analizę Blanda–Altmana z granicami zgodności, jedną z regresji i ewentualnie CCC. Stöckl i in. (1998) porównali OLS, regresję Deminga, analizę składowych głównych i Passinga–Babloka na rzeczywistych danych. Doszli do wniosku, że trafność interpretacji zależy bardziej od jakości danych niż od wyboru modelu. Gdy dopasowanie jest słabe, szukaj przyczyny w danych: nieliniowości, niskiej precyzji metod, wpływu cech samych próbek. Zmiana regresji jej nie usunie. Najważniejsza decyzja zapada przed badaniem: jaka różnica jest akceptowalna klinicznie lub praktycznie (Giavarina, 2015). Ten sam wymóg dotyczy trafności kryterialnej nowego narzędzia. Szerszy plan badania z pomiarem klinicznym opisuje przewodnik badania kliniczne i pomiar przed i po, a zgodność ocen kategorialnych – zgodność sędziów.
Jak opisać wyniki
Jeśli przygotowujesz badanie walidacyjne albo odpowiadasz recenzentowi, który pyta o regresję Deminga, możemy pomóc w ramach wsparcia statystycznego dla badaczy.
Przykład w R
Jeden przepis tworzy dane, zapisuje plik zgodnosc-metod-dane.csv (możesz go pobrać tutaj) i liczy wszystkie wyniki z tekstu. CCC i ICC pochodzą z pakietu DescTools, a regresję Deminga (wzór zamknięty) i Passinga–Babloka (przesunięta mediana nachyleń) liczą krótkie funkcje w podstawowym R.
CCC, regresja Deminga i Passinga–Babloka z bootstrapem
R
# Dane symulowane: odsetek tkanki tłuszczowej (%) zmierzony u 100 dorosłych dwiema metodami,
# każdą dwukrotnie: densytometrią DXA (metoda odniesienia) i analizatorem bioimpedancji BIA (metoda nowa)
set.seed(2371)
n <- 100
prawdziwy <- rnorm(n, 24, 5)                                  # prawdziwy odsetek tkanki tłuszczowej
dxa1 <- prawdziwy + rnorm(n, 0, 1.2); dxa2 <- prawdziwy + rnorm(n, 0, 1.2)
bia_prawdziwy <- 3.5 + 0.82 * prawdziwy                       # błąd stały i proporcjonalny BIA
bia1 <- bia_prawdziwy + rnorm(n, 0, 1.6); bia2 <- bia_prawdziwy + rnorm(n, 0, 1.6)
dane <- data.frame(id = 1:n, dxa1 = round(dxa1, 1), dxa2 = round(dxa2, 1), bia1 = round(bia1, 1), bia2 = round(bia2, 1))
write.csv(dane, "zgodnosc-metod-dane.csv", row.names = FALSE)
x <- dane$dxa1                                               # porównanie metod: pierwszy pomiar DXA
y <- dane$bia1                                               # i pierwszy pomiar BIA (drugie pomiary – tylko do lambda)

# 1. Korelacja, Bland–Altman w skrócie i CCC Lina
round(c(M_DXA = mean(x), SD_DXA = sd(x), M_BIA = mean(y), SD_BIA = sd(y), r = cor(x, y)), 3)
d <- y - x
round(c(srednia_roznica = mean(d), dolna_LoA = mean(d) - 1.96 * sd(d), gorna_LoA = mean(d) + 1.96 * sd(d)), 2)
ccc <- DescTools::CCC(x, y, ci = "z-transform", conf.level = .95)
round(unlist(ccc$rho.c), 3)                                   # CCC z 95% CI
round(c(precyzja_r = cor(x, y), dokladnosc_Cb = ccc$C.b, przesuniecie_skali = ccc$s.shift,
        przesuniecie_polozenia = ccc$l.shift), 3)
round(DescTools::ICC(cbind(x, y), conf.level = .95)$results[2, c("est", "lwr.ci", "upr.ci")], 3)   # ICC(2,1): zgodność bezwzględna

# 2. Powtarzalność każdej metody z par pomiarów i stosunek wariancji błędów (lambda)
s2_dxa <- sum((dane$dxa1 - dane$dxa2)^2) / (2 * n)            # wariancja błędu pojedynczego pomiaru DXA
s2_bia <- sum((dane$bia1 - dane$bia2)^2) / (2 * n)
lambda <- s2_bia / s2_dxa                                     # wariancja błędu BIA / wariancja błędu DXA
round(c(SD_bledu_DXA = sqrt(s2_dxa), SD_bledu_BIA = sqrt(s2_bia), lambda = lambda,
        blad_x_do_SD_x = sqrt(s2_dxa) / sd(x)), 3)       # powyżej ok. 0.2 OLS zaniża nachylenie (Cornbleet i Gochman, 1979)

# 3. Regresja Deminga – wzór zamknięty (y = BIA, x = DXA)
deming <- function(x, y, lambda) {
  sxx <- var(x); syy <- var(y); sxy <- cov(x, y)
  b <- (syy - lambda * sxx + sqrt((syy - lambda * sxx)^2 + 4 * lambda * sxy^2)) / (2 * sxy)
  c(a = mean(y) - b * mean(x), b = b)
}
# 4. Regresja Passinga–Babloka: przesunięta mediana nachyleń wszystkich par (Passing i Bablok, 1983)
passing_bablok <- function(x, y) {
  p <- combn(length(x), 2)
  dx <- x[p[2, ]] - x[p[1, ]]; dy <- y[p[2, ]] - y[p[1, ]]
  ok <- !(dx == 0 & dy == 0)
  s <- dy[ok] / dx[ok]                                        # dx = 0: nachylenie ±Inf
  s <- sort(s[is.na(s) | s != -1])
  K <- sum(s < -1)                                            # przesunięcie mediany
  N <- length(s)
  b <- if (N %% 2 == 1) s[(N + 1) / 2 + K] else (s[N / 2 + K] + s[N / 2 + 1 + K]) / 2
  c(a = median(y - b * x), b = b)
}
ols <- coef(lm(y ~ x)); names(ols) <- c("a", "b")
ols_odwrotna <- coef(lm(x ~ y)); ols_odwrotna <- c(a = -ols_odwrotna[[1]] / ols_odwrotna[[2]], b = 1 / ols_odwrotna[[2]])
dem <- deming(x, y, lambda); pb <- passing_bablok(x, y)
round(rbind(OLS_BIA_na_DXA = ols, OLS_DXA_na_BIA = ols_odwrotna, Deming = dem, Passing_Bablok = pb), 3)

# Wrażliwość nachylenia Deminga na lambda (lambda bardzo duże = OLS BIA na DXA)
l <- c(0.5, 1, lambda, 4, 1e6)
setNames(round(sapply(l, function(v) deming(x, y, v)[["b"]]), 3), round(l, 2))

# 5. Bootstrapowe 95% CI (percentylowe, 2000 prób) dla przecięcia, nachylenia i różnicy przy 15% i 30%
B <- 2000
boot <- t(replicate(B, {
  i <- sample(n, replace = TRUE)
  c(deming(x[i], y[i], lambda), passing_bablok(x[i], y[i]))
}))
colnames(boot) <- c("a_Deming", "b_Deming", "a_PB", "b_PB")
ci <- function(v) quantile(v, c(.025, .975))
round(t(apply(boot, 2, ci)), 3)
roznica_w <- function(a, b, x0) a + (b - 1) * x0             # przewidywana różnica BIA − DXA przy wartości x0
wyn <- sapply(c(15, 30), function(x0) c(
  Deming = roznica_w(dem[["a"]], dem[["b"]], x0), ci(roznica_w(boot[, "a_Deming"], boot[, "b_Deming"], x0)),
  PB = roznica_w(pb[["a"]], pb[["b"]], x0), ci(roznica_w(boot[, "a_PB"], boot[, "b_PB"], x0))))
colnames(wyn) <- c("przy_15_proc", "przy_30_proc"); round(wyn, 2)

# 6. Odporność: dwa błędne pomiary BIA (np. pomiar po wysiłku) i ponowna analiza
y_odst <- y; y_odst[order(x)[c(n - 5, n - 2)]] <- y[order(x)[c(n - 5, n - 2)]] - 12
round(rbind(Deming = deming(x, y_odst, lambda), Passing_Bablok = passing_bablok(x, y_odst),
            OLS = setNames(coef(lm(y_odst ~ x)), c("a", "b"))), 3)
round(c(CCC_bez = ccc$rho.c$est, CCC_z_odstajacymi = DescTools::CCC(x, y_odst)$rho.c$est), 3)
Wynik w R
 M_DXA SD_DXA  M_BIA SD_BIA      r
23.944  4.987 23.511  4.176  0.894
srednia_roznica       dolna_LoA       gorna_LoA
          -0.43           -4.84            3.98
   est lwr.ci upr.ci
 0.876  0.826  0.913
            precyzja_r          dokladnosc_Cb     przesuniecie_skali
                 0.894                  0.980                  0.837
przesuniecie_polozenia
                -0.095
                       est lwr.ci upr.ci
Single_random_raters 0.877  0.822  0.916
  SD_bledu_DXA   SD_bledu_BIA         lambda blad_x_do_SD_x
         1.178          1.714          2.115          0.236
                   a     b
OLS_BIA_na_DXA 5.581 0.749
OLS_DXA_na_BIA 1.088 0.936
Deming         4.599 0.790
Passing_Bablok 3.712 0.831
  0.5     1  2.11     4 1e+06
0.854 0.820 0.790 0.773 0.749
          2.5% 97.5%
a_Deming 2.580 6.431
b_Deming 0.712 0.879
a_PB     1.542 5.283
b_PB     0.754 0.923
       przy_15_proc przy_30_proc
Deming         1.45        -1.71
2.5%           0.72        -2.41
97.5%          2.15        -0.96
PB             1.17        -1.37
2.5%           0.20        -2.34
97.5%          1.86        -0.54
                   a     b
Deming         6.244 0.711
Passing_Bablok 4.091 0.810
OLS            7.548 0.657
          CCC_bez CCC_z_odstajacymi
            0.876             0.797
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje lm(), combn(), replicate() oraz CCC() i ICC() z pakietu DescTools); rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics (R package version 0.99.60) [Computer software]. https://CRAN.R-project.org/package=DescTools
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Wysoka korelacja jako dowód zgodności. Tutaj r = .894, a mimo to BIA myli się systematycznie o 1.2–1.7 pkt proc. przy 15% i 30% tkanki tłuszczowej, i to w przeciwne strony.
- Zwykła regresja liniowa przy błędzie w obu metodach. Nachylenie jest zaniżone, a wynik zależy od tego, którą metodę postawisz na osi x.
- Regresja Deminga z λ = 1 „domyślnie”. Podaj, skąd wziąłeś λ, i pokaż wrażliwość wyniku.
- Odczytywanie przecięcia bez nachylenia. Duże przecięcie przy nachyleniu różnym od 1 nie oznacza stałego przesunięcia o tę wartość.
- Sam CCC bez wyników w jednostkach. Czytelnik musi wiedzieć, o ile i przy jakich wartościach metody się różnią.
- Brak kryterium akceptowalności ustalonego przed badaniem. Bez niego żadna z czterech metod nie odpowie, czy BIA może zastąpić DXA.
Najczęstsze pytania
Dlaczego CCC jest niższy niż korelacja, skoro średnie obu metod są prawie równe?
Bo CCC karze nie tylko przesunięcie średnich, ale też różnicę rozrzutu. CCC to iloczyn korelacji (precyzji) i czynnika dokładności C_b (Lin, 1989). W przykładzie średnie różnią się o 0.43 pkt proc., ale SD w BIA to tylko 0.84 SD w DXA, więc C_b = .980, a CCC = .876 przy r = .894.
Czy w badaniu porównania metod wystarczy podać CCC albo ICC?
Nie. Oba współczynniki są tu niemal równe (CCC = .876, ICC(2,1) = .877) i oba zależą od zróżnicowania próby. Żaden nie mówi, o ile i przy jakich wartościach metody się różnią. Dodaj średnią różnicę z granicami zgodności oraz błąd systematyczny z regresji Deminga lub Passinga–Babloka w ważnych punktach zakresu.
Jak zaplanować pomiary, żeby oszacować λ do regresji Deminga?
Zmierz każdą osobę lub próbkę każdą metodą co najmniej dwukrotnie, w warunkach, w jakich metoda będzie stosowana. Z różnic par policz wariancję błędu każdej metody, a λ to ich iloraz (tu 1.71² / 1.18² ≈ 2.11). Gdy powtórzeń nie ma, użyj danych o nieprecyzyjności z walidacji i pokaż wyniki dla kilku wartości λ.
Dlaczego regresja BIA na DXA i DXA na BIA dają różne nachylenia?
Zwykła regresja przypisuje cały błąd zmiennej na osi y, więc zamiana osi zmienia wynik: w przykładzie 0.749 albo 0.936. Regresja Deminga dzieli błąd między metody według λ, a regresja Passinga–Babloka z założenia nie zależy od przypisania metod do osi (Passing i Bablok, 1983).
Czy przecięcie różne od zera oznacza, że nowa metoda zawyża wszystkie wyniki?
Nie, jeśli nachylenie też różni się od 1. Przy BIA = 4.60 + 0.790 × DXA proste przecinają przekątną przy około 22%: poniżej BIA zawyża, powyżej zaniża. Zamiast interpretować samo przecięcie, policz różnicę a + (b − 1)x₀ z przedziałem ufności w punktach ważnych dla Twojego pytania.
Powiązane hasła
Przeczytaj też
Badanie rzetelności pomiaru klinicznego
Plan badania powtarzalności, forma ICC, SEM i MDC95, wykres Blanda–Altmana, zgodność dwóch urządzeń i raport według GRRAS – z przykładem w R.
Czytaj →PoradnikBadania kliniczne i pomiar przed i po – przewodnik
Osiem etapów badania z interwencją: schemat, etyka, błąd pomiaru, liczebność, ITT, ANCOVA, RCI i MCID oraz CONSORT – z linkami do każdego etapu.
Czytaj →PoradnikRegresja odporna: estymatory M i MM
Huber, bisquare i MM, rlm i lmrob w R, wagi obserwacji, różnica wobec HC3, granice metody i wzór opisu APA.
Czytaj →Walidujesz nowe urządzenie albo recenzent pyta o regresję Deminga?
Pomożemy zaplanować badanie porównania metod, ustalić kryterium akceptowalności, policzyć CCC, regresję Deminga i Passinga–Babloka oraz opisać wyniki tak, żebyś mógł(a) je samodzielnie obronić.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Berchtold, A. (2016). Test–retest: Agreement or reliability? Methodological Innovations, 9, Article 2059799116672875. https://doi.org/10.1177/2059799116672875 ● Otwarty dostęp
- Bilić-Zulle, L. (2011). Comparison of methods: Passing and Bablok regression. Biochemia Medica, 21(1), 49–52. https://doi.org/10.11613/bm.2011.010 ● Otwarty dostęp
- Bland, J. M., & Altman, D. G. (1986). Statistical methods for assessing agreement between two methods of clinical measurement. The Lancet, 327(8476), 307–310. https://doi.org/10.1016/s0140-6736(86)90837-8
- Bland, J. M., & Altman, D. G. (1999). Measuring agreement in method comparison studies. Statistical Methods in Medical Research, 8(2), 135–160. https://doi.org/10.1177/096228029900800204
- Cornbleet, P. J., & Gochman, N. (1979). Incorrect least-squares regression coefficients in method-comparison analysis. Clinical Chemistry, 25(3), 432–438. https://doi.org/10.1093/clinchem/25.3.432
- Giavarina, D. (2015). Understanding Bland Altman analysis. Biochemia Medica, 25(2), 141–151. https://doi.org/10.11613/bm.2015.015 ● Otwarty dostęp
- Lin, L. I.-K. (1989). A concordance correlation coefficient to evaluate reproducibility. Biometrics, 45(1), 255–268. https://doi.org/10.2307/2532051
- Martin, R. F. (2000). General Deming regression for estimating systematic bias and its confidence interval in method-comparison studies. Clinical Chemistry, 46(1), 100–104. https://doi.org/10.1093/clinchem/46.1.100
- Passing, H., & Bablok, W. (1983). A new biometrical procedure for testing the equality of measurements from two different analytical methods. Application of linear regression procedures for method comparison studies in clinical chemistry, Part I. Journal of Clinical Chemistry and Clinical Biochemistry, 21(11), 709–720. https://doi.org/10.1515/cclm.1983.21.11.709 ● Otwarty dostęp
- Stöckl, D., Dewitte, K., & Thienpont, L. M. (1998). Validity of linear regression in method comparison studies: Is it limited by the statistical model or the quality of the analytical input data? Clinical Chemistry, 44(11), 2340–2346. https://doi.org/10.1093/clinchem/44.11.2340
Cytowania BibTeX
@article{berchtold2016test, author={Berchtold, André}, title={{Test–retest: Agreement or reliability?}}, journal={Methodological Innovations}, year={2016}, volume={9}, eid={2059799116672875}, doi={10.1177/2059799116672875}}@article{bilic2011comparison, author={Bilić-Zulle, Lidija}, title={{Comparison of methods: Passing and Bablok regression}}, journal={Biochemia Medica}, year={2011}, volume={21}, number={1}, pages={49--52}, doi={10.11613/bm.2011.010}}@article{bland1986statistical, author={Bland, J. Martin and Altman, Douglas G.}, title={{Statistical methods for assessing agreement between two methods of clinical measurement}}, journal={The Lancet}, year={1986}, volume={327}, number={8476}, pages={307--310}, doi={10.1016/s0140-6736(86)90837-8}}@article{bland1999measuring, author={Bland, J. Martin and Altman, Douglas G.}, title={{Measuring agreement in method comparison studies}}, journal={Statistical Methods in Medical Research}, year={1999}, volume={8}, number={2}, pages={135--160}, doi={10.1177/096228029900800204}}@article{cornbleet1979incorrect, author={Cornbleet, P. J. and Gochman, N.}, title={{Incorrect least-squares regression coefficients in method-comparison analysis}}, journal={Clinical Chemistry}, year={1979}, volume={25}, number={3}, pages={432--438}, doi={10.1093/clinchem/25.3.432}}@article{giavarina2015understanding, author={Giavarina, Davide}, title={{Understanding Bland Altman analysis}}, journal={Biochemia Medica}, year={2015}, volume={25}, number={2}, pages={141--151}, doi={10.11613/bm.2015.015}}@article{lin1989concordance, author={Lin, Lawrence I-Kuei}, title={{A concordance correlation coefficient to evaluate reproducibility}}, journal={Biometrics}, year={1989}, volume={45}, number={1}, pages={255--268}, doi={10.2307/2532051}}@article{martin2000general, author={Martin, Robert F.}, title={{General Deming regression for estimating systematic bias and its confidence interval in method-comparison studies}}, journal={Clinical Chemistry}, year={2000}, volume={46}, number={1}, pages={100--104}, doi={10.1093/clinchem/46.1.100}}@article{passing1983new, author={Passing, H. and Bablok, W.}, title={{A new biometrical procedure for testing the equality of measurements from two different analytical methods. Application of linear regression procedures for method comparison studies in clinical chemistry, Part I}}, journal={Journal of Clinical Chemistry and Clinical Biochemistry}, year={1983}, volume={21}, number={11}, pages={709--720}, doi={10.1515/cclm.1983.21.11.709}}@article{stockl1998validity, author={Stöckl, Dietmar and Dewitte, Katy and Thienpont, Linda M.}, title={{Validity of linear regression in method comparison studies: Is it limited by the statistical model or the quality of the analytical input data?}}, journal={Clinical Chemistry}, year={1998}, volume={44}, number={11}, pages={2340--2346}, doi={10.1093/clinchem/44.11.2340}}