Przykład: biuro projektowe i 220 płac
Fikcyjne biuro projektowe konstrukcji budowlanych zatrudnia 220 osób na sześciu poziomach stanowisk: od asystenta projektanta (P1, 50 osób) przez projektanta, starszego i głównego projektanta, po kierownika zespołu (P5, 18 osób) i dyrektora (P6, 10 osób). Osoby pracują w czterech działach: konstrukcje budynków (106), mosty i obiekty inżynierskie (56), BIM i dokumentacja (49) oraz ekspertyzy (9). Zarząd chce wprowadzić siatkę płac: widełki dla każdego poziomu do ogłoszeń o pracę i rozmów o podwyżkach. Pytania są dwa: jakie widełki wynikają z obecnych płac i kto już dziś jest poza nimi?
Narzędziem jest regresja wieloraka logarytmu płacy (poziom, staż w firmie, dział). Odpowiada na trzy pytania, które w raportach kadrowych często się mieszają: gdzie leży typowa płaca, gdzie płaca jednej osoby i gdzie krańce rozkładu.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Parametry ustawiliśmy ręcznie: mediany płac przy zerowym stażu od 6500 zł (P1) do 22 000 zł (P6), rozrzut płac rosnący z poziomem (odchylenie standardowe od 0.07 do 0.15 na skali logarytmu), średni staż od 2 do 15 lat, +1.2% płacy za rok stażu (0.012 na skali logarytmu), premię +7% (0.07) dla osób zatrudnionych mniej niż 2 lata temu (rynek pracy inżynierów podniósł stawki), różnice działów (mosty +4%, BIM −6%, ekspertyzy +3% wobec budynków) i pięć osób poza siatką: O070, O130 i O175 zarabiają o ok. 22% mniej (−0.25 na skali logarytmu), a O020 i O200 – o ok. 35% więcej (+0.30), niż wynikałoby z ich cech. Ziarno 716 ustaliliśmy raz i nie zmienialiśmy go. Dane pobierzesz jako siatka-plac-biuro-projektowe-220.csv (wiersz = osoba). Dane o płacach są poufne: analizuj je na identyfikatorach, bez nazwisk.
Rysunek 1: płace według poziomu
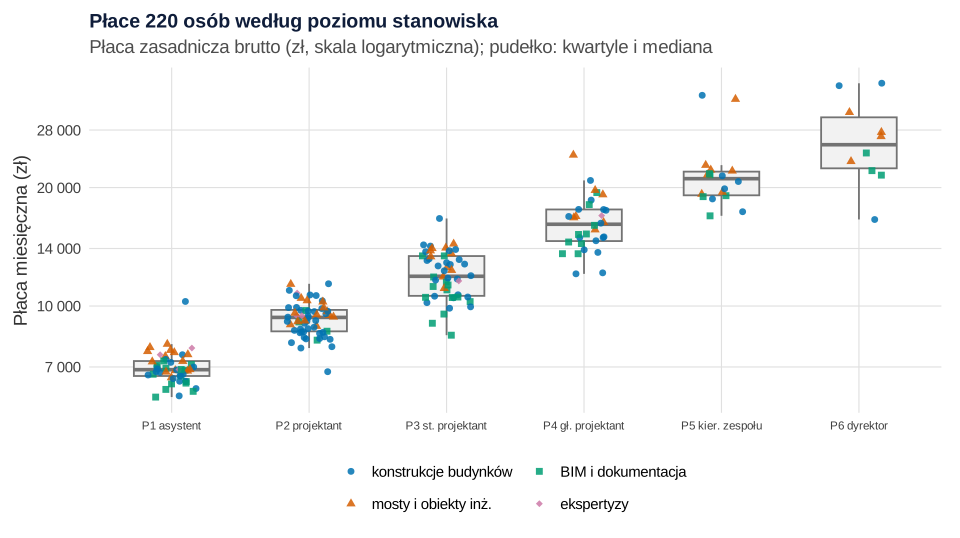
set.seed(716)).Co widać. Mediana rośnie z 6890 zł (P1) do 25 725 zł (P6), a rozrzut rośnie razem z nią: w P1 środkowe 80% osób mieści się między 6323 a 7675 zł, w P6 – między 21 018 a 36 352 zł. Sąsiednie poziomy zachodzą na siebie. Najdroższy asystent (O020, 10 270 zł) zarabia więcej niż mediana projektantów.
Jak może zmylić. Wykres nie uwzględnia stażu ani działu: dyrektorzy mają średnio 15.7 roku stażu, asystenci 2.2. Oś jest logarytmiczna: równe odstępy to równe procentowe różnice.
Podpis do pracy:
Model: logarytm płacy i wynik w procentach
Modelujemy logarytm płacy, bo podwyżki i premie są procentem płacy, więc współczynnik opisuje zmianę procentową:
Zmiana procentowa to 100 × (eb − 1). Model wyjaśnia 93% zmienności logarytmu płacy (R² = .93, odchylenie reszt s = 0.110).
| Zmienna (odniesienie) | b | Zmiana płacy | 95% CI |
|---|---|---|---|
| P2 projektant (P1) | 0.254 | +28.9% | [23.5, 34.6] |
| P3 starszy projektant (P1) | 0.492 | +63.5% | [56.2, 71.2] |
| P6 dyrektor (P1) | 1.142 | +213.1% | [187.2, 241.4] |
| Staż (na rok) | 0.013 | +1.3% | [1.0, 1.6] |
| Mosty (budynki) | 0.057 | +5.8% | [2.0, 9.8] |
| BIM i dokumentacja (budynki) | −0.074 | −7.1% | [−10.7, −3.5] |
| Ekspertyzy, n = 9 (budynki) | 0.042 | +4.3% | [−3.4, 12.5] |
Przy małych b skrót „100 × b procent” działa (0.013 → 1.3%). Przy dużych myli: b = 1.142 to nie „+114%”, tylko +213%. Poprawka Kennedy’ego, którą omawiają van Garderen i Shah (2002), zmienia tu wynik o najwyżej 0.3 punktu procentowego (212.8% zamiast 213.1%). Druga rzecz: eprzewidywanie to mediana płacy, nie średnia. Średnią daje dopiero mnożnik smearing Duana (1983), tu 1.006 – o 0.6% więcej.
Reszty mają różny rozrzut w poziomach: 0.087 w P1 i 0.160 w P6 (test Breuscha–Pagana: LM = 18.61, df = 9, p = .029). Założenie homoskedastyczności nie jest spełnione – wrócimy do tego przy widełkach.
Rysunek 2: przedział ufności średniej a przedział predykcji dla osoby
Ile powinien zarabiać starszy projektant z działu budynków z 7-letnim stażem? Model daje dwie odpowiedzi, zależnie od pytania (szczegóły w haśle pasmo ufności i pasmo predykcji).
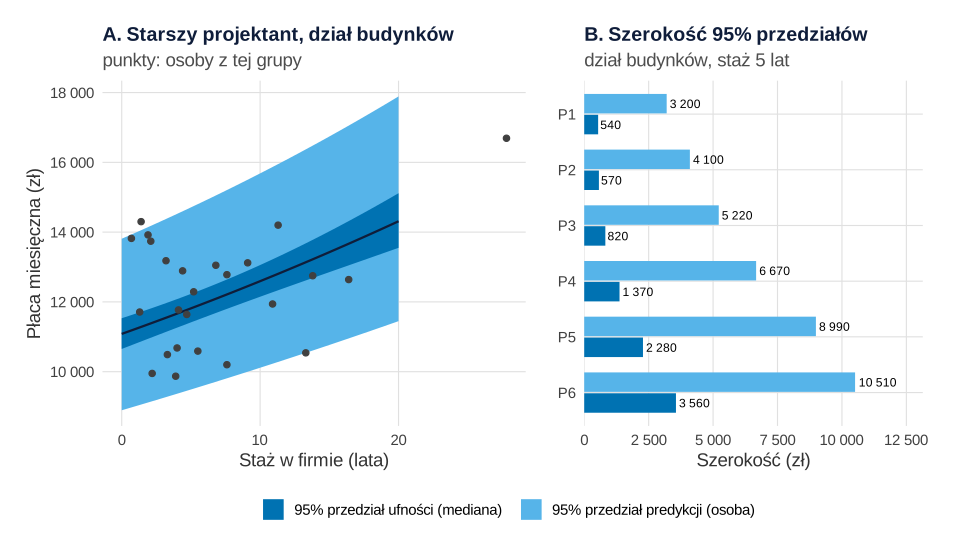
Co widać. Przewidywana mediana to 12 120 zł. Przedział ufności [11 710, 12 540] mówi, gdzie leży typowa płaca takich osób. Przedział predykcji [9 740, 15 090] mówi, gdzie powinna wypaść płaca jednej osoby – jest 6.4 razy szerszy. Z 25 starszych projektantów działu budynków w paśmie ufności mieści się 16%, w paśmie predykcji – 92%. W panelu B przedział ufności rośnie w małych poziomach (z 540 zł w P1 do 3560 zł w P6), a przedział predykcji ma wszędzie ok. 44–47% mediany, bo zależy głównie od rozrzutu osób.
Jak może zmylić. Wąski przedział ufności kusi, by uznać go za widełki – wtedy 84% starszych projektantów działu budynków byłoby „poza siatką”. Do oceny jednej osoby służy przedział predykcji. Przedziały ufności w regresji przystępnie omawiają Bewick i in. (2003).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: kto jest poza siatką?
Osobę „poza siatką” najprościej zdefiniować tak: jej płaca leży poza 95% przedziałem predykcji z modelu policzonego bez niej. To dokładnie to samo co reszta studentyzowana (zewnętrznie) większa co do modułu niż 1.97 – kwantyl rozkładu t. Przykład: O130 zarabia 8430 zł, przedział predykcji z modelu bez niej to [9 170, 14 150] zł, a jej reszta studentyzowana wynosi −2.73.
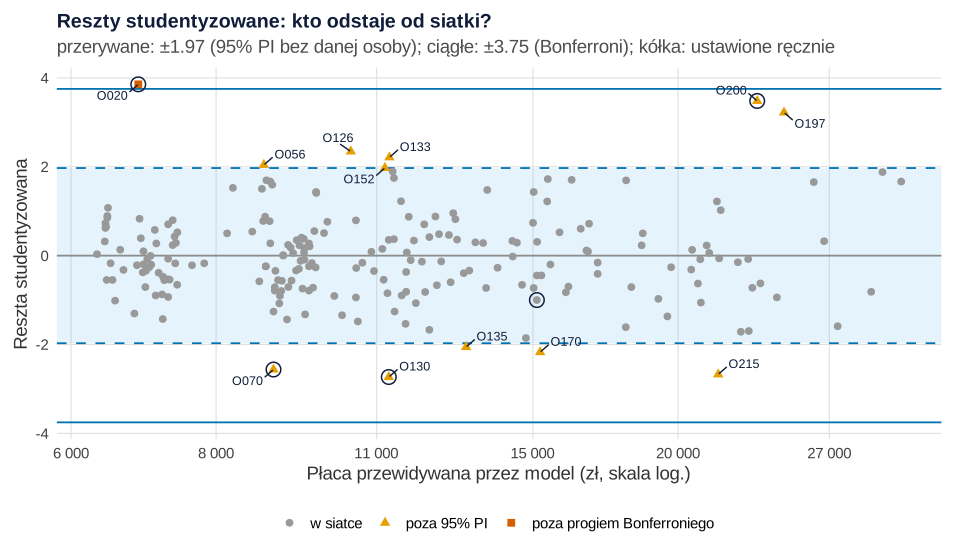
Co widać. Poza 95% przedziałem jest 12 osób z 220 – mniej więcej tyle, ile spodziewalibyśmy się przy samym przypadku (ok. 11). Próg 3.75 z poprawką Bonferroniego na 220 osób przekracza tylko O020: asystent z płacą 10 270 zł przy przewidywanych 6860 zł (+49.8%). Cztery z pięciu ustawionych przez nas osób są wśród dwunastu (O020, O200, O130, O070); piątej, O175, model nie wskazał. Wśród pozostałych jest kierownik O197 (+39.0%) i pięć osób zatrudnionych w ostatnich dwóch latach, z czego cztery zarabiają o 24–28% powyżej przewidywań. Nowi stanowią 24% firmy, ale połowę listy (6 z 12) – do tego wrócimy w ostatniej sekcji.
Jak może zmylić. Przy 220 osobach ok. 11 przekroczy próg 95% przez przypadek – to problem wielokrotnych porównań. Reszta mówi „nietypowo”, nie „niesłusznie”: obserwacja odstająca bywa błędem w danych, uzasadnionym wyjątkiem (rzadkie uprawnienia) albo problemem płacowym. Spośród wielu miar wpływu i odstawania wystarczy kilka – razem z wykresami (Chatterjee i Hadi, 1986); procedurę opisuje wpis wartości odstające – jak je wykryć.
Zdanie do Wyników:
Rysunek 4: widełki z regresji kwantylowej
Widełki to zwykle 10. i 90. centyl płac na danym poziomie. Regresja liniowa daje je tylko przy założeniu jednego rozrzutu dla całej firmy (80% przedział predykcji). Regresja kwantylowa szacuje osobny model dla każdego centyla, minimalizując ważoną sumę wartości bezwzględnych reszt (Koenker i Hallock, 2001). Wszystkie widełki liczymy dla działu budynków i stażu 5 lat.
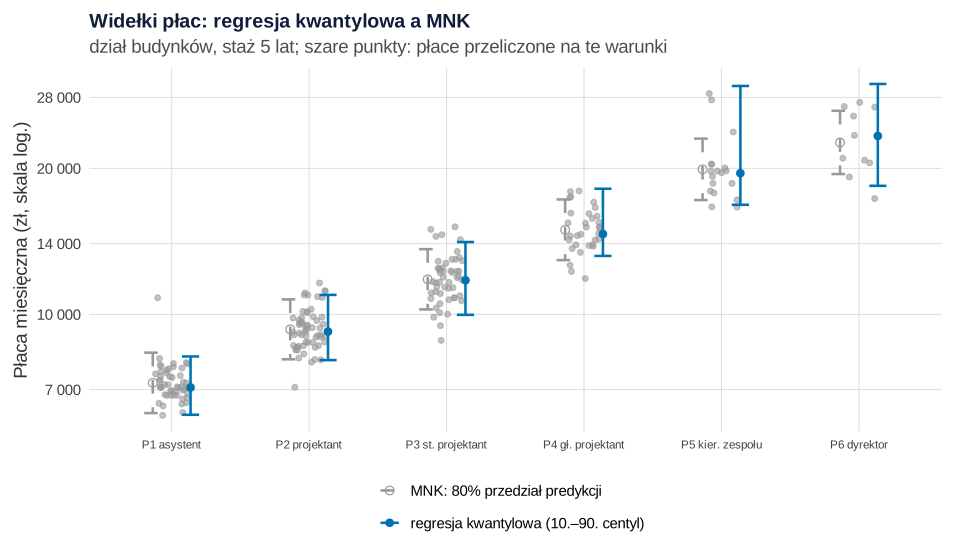
Co widać. W poziomach P1–P4 obie metody dają podobne widełki, np. P1: 6210–8190 zł z kwantyli i 6260–8340 zł z przedziału predykcji. W P5 i P6 kwantyle dają znacznie szersze pasma: P5 16 830–29 580 zł (rozpiętość 75.7%), a model z jednym rozrzutem – 17 210–23 040 zł (33.9%). Sprawdzian: w 80% przedziale predykcji mieści się 96.0% asystentów, ale tylko 50.0% dyrektorów; w widełkach z kwantyli – od 77.8 do 81.2% osób na każdym poziomie, czyli zgodnie z założeniem.
Jak może zmylić. 90. centyl w grupie 18 osób wyznaczają w praktyce dwie najlepiej opłacane – w P5 to O200, którą sami zawyżyliśmy, i O197. Precyzja krańców jest mała: bootstrap (1000 prób, ziarno 7160) daje dla 90. centyla w P1 przedział 7480–8860 zł, a w P6 – 25 160–32 330 zł. Przybliżone błędy standardowe kwantyli bywają bardzo wrażliwe na odstępstwa od założenia jednakowych, niezależnych błędów, dlatego zaleca się przy nich metody resamplingowe (Kocherginsky i in., 2005). Procedurę opisuje wpis regresja kwantylowa krok po kroku.
Podpis do pracy:
Rysunek 5: schemat siatki płac
Propozycja siatki: minimum = 10. centyl, środek = mediana, maksimum = 90. centyl (zaokrąglone do 100 zł).
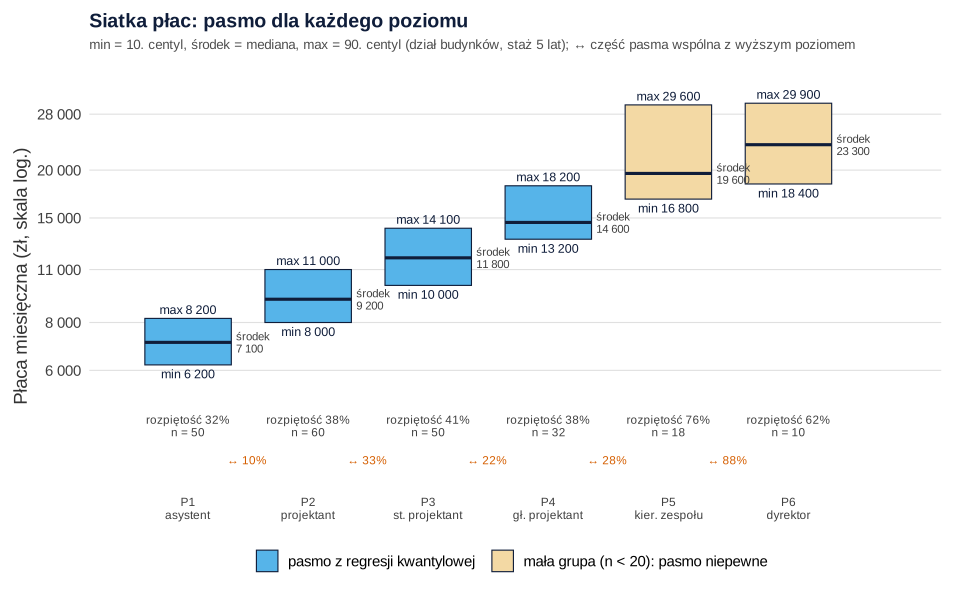
Co widać. Pasma P1–P4 mają rozpiętość 32–41% i zachodzą na wyższy poziom w 10–33% swojej szerokości – to typowa, rozsądna siatka: awans nie musi oznaczać skoku płacy, ale środek kolejnego pasma jest wyraźnie wyżej. P5 i P6 (rozpiętość 76% i 62%) zachodzą na siebie w 88% – górne krańce prawie się pokrywają (29 600 i 29 900 zł).
Jak może zmylić. Pasma P5 i P6 to skutek 18 i 10 osób, w tym dwóch nietypowych. Dla małych poziomów przyjmij rozpiętość z liczniejszych (np. 40%) wokół mediany z modelu.
Rysunek 6: kompresja płac – nowi zarabiają więcej
Gdy rynek podnosi stawki szybciej niż firma podwyżki, nowo zatrudnieni dostają więcej niż koledzy z kilkuletnim stażem na tym samym poziomie. Po dodaniu oznaczenia „zatrudniony mniej niż 2 lata temu” premia nowych wynosi w naszych danych +10.4%, 95% CI [6.2, 14.7] (ustawiliśmy +7%), a efekt stażu rośnie z 1.29 do 1.55% na rok. Symulacja 1000 fikcyjnych biur o tej samej strukturze (ziarno 7161) sprawdza skutki premii 0, 4, 8 i 12%.
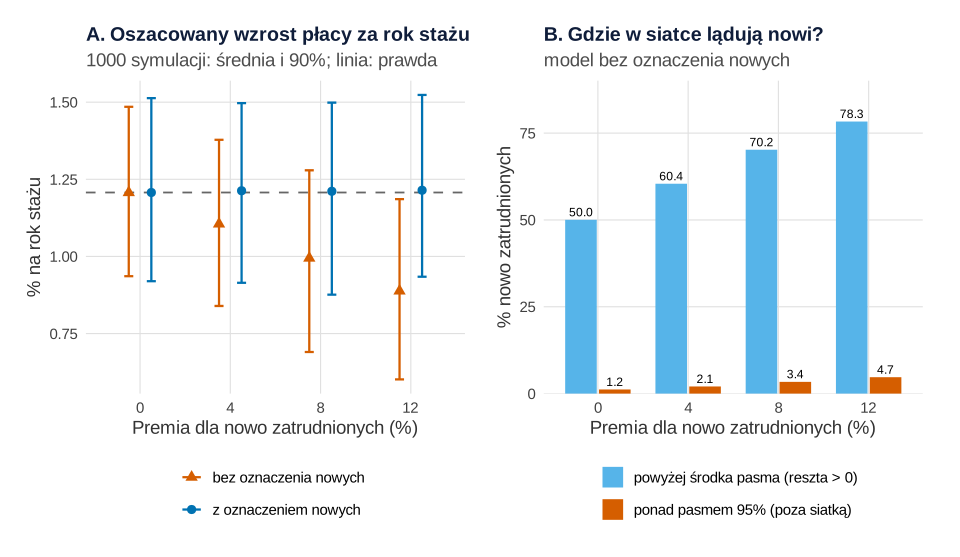
set.seed(7161)).Co widać. Bez oznaczenia nowych średni oszacowany wzrost płacy za rok stażu spada z 1.21% (prawda) do 0.89% przy premii 12%; z oznaczeniem wynosi 1.21% przy każdej premii. Nowi lądują w górnej części siatki: powyżej środka pasma jest ich 50% bez premii i 78.3% przy premii 12% (błąd Monte Carlo ≤ 0.19 punktu procentowego), a ponad pasmem 95% – odpowiednio 1.2% i 4.7%.
Jak może zmylić. W przekroju wpływ stażu miesza dwie rzeczy: podwyżki w firmie i to, za ile zatrudniano w różnych latach. Castle (2005) pokazuje na płacach nauczycieli akademickich, że efekty stażu bywają w badaniach dodatnie albo ujemne i zależą od sposobu pomiaru stażu i specyfikacji modelu. Przekrój ma też drugą słabość: widzimy tylko tych, którzy zostali. Jak dobór osób do danych zniekształca zależności, pokazuje wpis o trafności testu rekrutacyjnego, a wpis o rotacji pracowników – jak sprawdzić, czy niedopłaceni długoletni pracownicy częściej odchodzą.
Zdanie do Metody:
Co z tym zrobić w firmie
- Oceniaj osoby przedziałem predykcji, nie przedziałem ufności (rysunek 2).
- Listę „poza siatką” traktuj jako listę do rozmowy. Z 12 osób jedna przekracza próg Bonferroniego; połowa to nowi pracownicy. Zacznij od O020, O197 i osób poniżej pasma z kilkuletnim i dłuższym stażem (O130, O135).
- Widełki buduj z regresji kwantylowej albo z modelu z różnym rozrzutem w poziomach (rysunek 4).
- Dla małych poziomów i działów ustal pasma regułą. Dział ekspertyz (9 osób) ma premię +4.3% z przedziałem od −3.4 do +12.5% – na takiej podstawie nie twórz osobnej siatki.
- Sprawdź kompresję przed wdrożeniem siatki. Inaczej siatka „zamrozi” niedopłacenie długoletnich pracowników.
Pytanie, czy płace różnią się między kobietami i mężczyznami przy tych samych cechach, to osobna analiza – opisuje ją wpis luka płacowa i dekompozycja Oaxaca–Blindera. Inny model dla danych kadrowych – liczby dni nieobecności – pokazuje wpis o absencji chorobowej.
Jak opisać w pracy
Opisz zmienną zależną, predyktory i kategorie odniesienia, przeliczenie na procenty, rodzaj przedziałów, regułę „poza siatką” i sposób wyznaczenia widełek. Więcej o analizach w pracach z zarządzania: statystyka w pracy z zarządzania i ekonomii.
Kod R: dane, model, przedziały, kwantyle i symulacja
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane pr, przepis 2 – model m1, przepis 5 – tabelę widełek wid, z których korzystają dalsze przepisy. Przepisy z rysunkami kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (set.seed(716)), 5 (bootstrap, set.seed(7160)) i 7 (symulacja 4 × 1000 firm, set.seed(7161)); rozrzut punktów na wykresach i etykiety pakietu ggrepel ustawiają stałe seed = 1 i seed = 2. Ziarna ustalono raz i nie zmieniano ich. Ręcznie ustalono (przepis 1): liczebności poziomów (50, 60, 50, 32, 18, 10), mediany płac przy zerowym stażu (6500–22 000 zł), rozrzut 0.07–0.15 na skali logarytmu, średni staż 2–15 lat, +1.2% za rok stażu, premię +7% dla zatrudnionych krócej niż 2 lata, udziały i efekty działów oraz pięć osób przesuniętych o −0.25 albo +0.30 na skali logarytmu. Po pierwszym uruchomieniu nie zmieniano parametrów danych. Zmieniono sposób prezentacji: w przepisie 7 w panelu B zamiast odsetka osób z co najmniej 10-letnim stażem poniżej pasma (malał wraz z premią, bo model bez oznaczenia nowych zaniża efekt stażu i długoletni pracownicy rzadziej wypadają pod pasmo) pokazano odsetek nowych powyżej środka pasma, który lepiej oddaje kompresję; poprawiono też legendy i podpisy rysunków 2, 3 i 6. Przepisy liczą się w kilka sekund (najdłużej symulacja, ok. 5 s). Kolory zielony i różowy (działy na rysunku 1) są przy deuteranopii słabo rozróżnialne (przepis 8), dlatego działy różnią się też kształtem punktu.
1. Dane: Rysunek 1
R
# Rysunek 1. Fikcyjne biuro projektowe konstrukcji budowlanych: 220 osób, 6 poziomów stanowisk
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", pomaranczowy = "#D55E00", blekit = "#56B4E9", zielony = "#009E73",
         zolty = "#E69F00", rozowy = "#CC79A7", szary = "#999999", granat = "#0f1d3a")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustawione ręcznie
poziomy   <- c("P1 asystent", "P2 projektant", "P3 st. projektant", "P4 gł. projektant",
               "P5 kier. zespołu", "P6 dyrektor")
liczebnosc <- c(50, 60, 50, 32, 18, 10)                       # razem 220 osób
baza_zl   <- c(6500, 8500, 11000, 14000, 17500, 22000)        # mediana płacy przy stażu 0 (dział budynków)
sd_log    <- c(0.07, 0.08, 0.09, 0.11, 0.13, 0.15)            # rozrzut płac w poziomie rośnie z poziomem
staz_sr   <- c(2, 4, 7, 10, 12, 15)                           # średni staż w firmie (lata)
podwyzka  <- 0.012                                            # +1.2% płacy za rok stażu (log-skala)
premia_nowych <- 0.07                                         # zatrudnieni < 2 lata temu: +7% (rynek)
dzialy    <- c("konstrukcje budynków", "mosty i obiekty inż.", "BIM i dokumentacja", "ekspertyzy")
udzial_dz <- c(0.50, 0.25, 0.20, 0.05)
efekt_dz  <- c(0, 0.04, -0.06, 0.03)                          # log-skala względem budynków

set.seed(716)
pr <- data.frame(id = sprintf("O%03d", 1:sum(liczebnosc)),
                 poziom = rep(seq_along(poziomy), liczebnosc))
pr$dzial <- sample(dzialy, nrow(pr), replace = TRUE, prob = udzial_dz)
pr$staz  <- round(pmin(rgamma(nrow(pr), shape = 2, rate = 2 / staz_sr[pr$poziom]), 30), 1)
pr$nowy  <- as.integer(pr$staz < 2)
log_pl <- log(baza_zl[pr$poziom]) + podwyzka * pr$staz + premia_nowych * pr$nowy +
  efekt_dz[match(pr$dzial, dzialy)] + rnorm(nrow(pr), 0, sd_log[pr$poziom])
# Pięć osób ustawionych ręcznie poza siatką: trzy zaniżone o 25%, dwie zawyżone o 30%
poza <- c(O070 = -0.25, O130 = -0.25, O175 = -0.25, O020 = 0.30, O200 = 0.30)
log_pl[match(names(poza), pr$id)] <- log_pl[match(names(poza), pr$id)] + poza
pr$placa <- round(exp(log_pl), -1)                            # miesięczna płaca zasadnicza brutto, zł
pr$poziom <- factor(poziomy[pr$poziom], levels = poziomy)
pr$dzial  <- factor(pr$dzial, levels = dzialy)
write.csv(pr, "siatka-plac-biuro-projektowe-220.csv", row.names = FALSE)

cat("Osób:", nrow(pr), "| nowo zatrudnionych (staż < 2 lata):", sum(pr$nowy), "\n")
print(table(pr$dzial))
opis <- function(x) c(n = length(x), mediana = median(x), P10 = unname(quantile(x, .1)),
                      P90 = unname(quantile(x, .9)), min = min(x), max = max(x))
tab <- t(sapply(split(pr$placa, pr$poziom), opis))
print(round(cbind(tab, staz_sr = tapply(pr$staz, pr$poziom, mean)), 1))
cat("Mediana płacy w firmie:", median(pr$placa), "zł\n")

p1 <- ggplot(pr, aes(poziom, placa)) +
  geom_boxplot(outlier.shape = NA, width = 0.55, colour = "grey45", fill = "grey95") +
  geom_point(aes(colour = dzial, shape = dzial), position = position_jitter(width = 0.18, seed = 1),
             size = 2, alpha = 0.85) +
  scale_y_log10(breaks = c(5000, 7000, 10000, 14000, 20000, 28000),
                labels = function(x) format(x, big.mark = " ")) +
  scale_colour_manual(values = unname(kol[c("niebieski", "pomaranczowy", "zielony", "rozowy")]), name = NULL) +
  scale_shape_manual(values = c(16, 17, 15, 18), name = NULL) +
  guides(colour = guide_legend(nrow = 2), shape = guide_legend(nrow = 2)) +
  labs(title = "Płace 220 osób według poziomu stanowiska",
       subtitle = "Płaca zasadnicza brutto (zł, skala logarytmiczna); pudełko: kwartyle i mediana",
       x = NULL, y = "Płaca miesięczna (zł)") +
  motyw + theme(axis.text.x = element_text(size = rel(0.78)))
p1                       # do pliku: ggsave("siatka-plac-dane-poziomy.svg", p1, width = 10, height = 5.6)
Wynik w R
Osób: 220 | nowo zatrudnionych (staż < 2 lata): 52

konstrukcje budynków mosty i obiekty inż.   BIM i dokumentacja
                 106                   56                   49
          ekspertyzy
                   9
                   n mediana   P10   P90   min   max staz_sr
P1 asystent       50    6890  6323  7675  5870 10270     2.2
P2 projektant     60    9355  8248 10621  6810 11390     3.8
P3 st. projektant 50   11900 10175 14014  8430 16690     6.7
P4 gł. projektant 32   16135 13590 19397 12070 24200    11.6
P5 kier. zespołu  18   21070 18305 26022 16950 34310    10.3
P6 dyrektor       10   25725 21018 36352 16590 36820    15.7
Mediana płacy w firmie: 10480 zł
2. Regresja logarytmu płacy
R
# Regresja log(płacy): poziom, staż i dział – współczynniki w procentach
# (korzysta z obiektu pr z przepisu 1 – bez nowego losowania)
m1 <- lm(log(placa) ~ poziom + staz + dzial, data = pr)
s1 <- summary(m1)
cat("R2 =", round(s1$r.squared, 3), "| s (log) =", round(s1$sigma, 4), "| df =", m1$df.residual, "\n")

b  <- coef(m1)[-1]
se <- sqrt(diag(vcov(m1)))[-1]
tk <- qt(0.975, m1$df.residual)
tab <- data.frame(czlon = names(b),
                  b = round(b, 4),
                  proc = round(100 * (exp(b) - 1), 1),                       # exp(b) − 1
                  dolna = round(100 * (exp(b - tk * se) - 1), 1),
                  gorna = round(100 * (exp(b + tk * se) - 1), 1),
                  proc_kennedy = round(100 * (exp(b - se^2 / 2) - 1), 1),    # poprawka Kennedy’ego
                  p = signif(2 * pt(-abs(b / se), m1$df.residual), 2))
print(tab, row.names = FALSE)

# Rozrzut reszt w poziomach (czy jeden rozrzut pasuje do całej siatki?)
cat("\nSD reszt w poziomach (log):\n")
print(round(tapply(resid(m1), pr$poziom, sd), 3))
bp <- lm(resid(m1)^2 ~ poziom + staz + dzial, data = pr)                     # studentyzowany test Breuscha–Pagana
lm_stat <- nrow(pr) * summary(bp)$r.squared
cat("Test Breuscha–Pagana: LM =", round(lm_stat, 2), "| df =", length(coef(bp)) - 1, "| p =",
    sub("^0", "", sprintf("%.3f", pchisq(lm_stat, length(coef(bp)) - 1, lower.tail = FALSE))), "\n")

# exp(przewidywanie) to mediana płacy; średnia jest wyższa o czynnik smearing (Duan)
cat("Czynnik smearing mean(exp(reszta)) =", round(mean(exp(resid(m1))), 4), "\n")
Wynik w R
R2 = 0.93 | s (log) = 0.1098 | df = 210
                     czlon       b  proc dolna gorna proc_kennedy       p
       poziomP2 projektant  0.2542  28.9  23.5  34.6         28.9 1.3e-24
   poziomP3 st. projektant  0.4918  63.5  56.2  71.2         63.5 9.6e-54
   poziomP4 gł. projektant  0.7268 106.8  95.3 119.1        106.8 1.1e-64
    poziomP5 kier. zespołu  1.0138 175.6 158.3 194.1        175.5 1.2e-79
         poziomP6 dyrektor  1.1415 213.1 187.2 241.4        212.8 1.0e-67
                      staz  0.0128   1.3   1.0   1.6          1.3 6.6e-14
 dzialmosty i obiekty inż.  0.0567   5.8   2.0   9.8          5.8 2.4e-03
   dzialBIM i dokumentacja -0.0741  -7.1 -10.7  -3.5         -7.2 2.1e-04
           dzialekspertyzy  0.0417   4.3  -3.4  12.5          4.2 2.8e-01

SD reszt w poziomach (log):
      P1 asystent     P2 projektant P3 st. projektant P4 gł. projektant
            0.087             0.097             0.115             0.104
 P5 kier. zespołu       P6 dyrektor
            0.151             0.160
Test Breuscha–Pagana: LM = 18.61 | df = 9 | p = .029
Czynnik smearing mean(exp(reszta)) = 1.0059
3. Przedział ufności a przedział predykcji: Rysunek 2
R
# Rysunek 2. Przedział ufności średniej a przedział predykcji dla jednej osoby
# (korzysta z kol, motyw, pr z przepisu 1 i m1 z przepisu 2 – bez nowego losowania)
library(ggplot2)
suppressPackageStartupMessages(library(patchwork))
zl <- function(x) format(round(x, -1), big.mark = " ", trim = TRUE)

# A. Starszy projektant (P3) w dziale budynków, staż od 0 do 20 lat
siatka <- data.frame(poziom = factor("P3 st. projektant", levels = levels(pr$poziom)),
                     dzial = factor("konstrukcje budynków", levels = levels(pr$dzial)),
                     staz = seq(0, 20, by = 0.25))
ufn <- exp(predict(m1, siatka, interval = "confidence"))      # mediana płacy i jej 95% CI
pre <- exp(predict(m1, siatka, interval = "prediction"))      # 95% przedział dla jednej osoby
siatka <- cbind(siatka, med = ufn[, 1], cl = ufn[, 2], cu = ufn[, 3], pl = pre[, 2], pu = pre[, 3])
s7 <- siatka[siatka$staz == 7, ]
cat("P3, budynki, staż 7 lat: mediana", zl(s7$med), "zł | 95% CI [", zl(s7$cl), ",", zl(s7$cu),
    "] | 95% PI [", zl(s7$pl), ",", zl(s7$pu), "]\n")
cat("Szerokość CI:", zl(s7$cu - s7$cl), "zł | szerokość PI:", zl(s7$pu - s7$pl), "zł | iloraz:",
    round((s7$pu - s7$pl) / (s7$cu - s7$cl), 1), "\n")
p3b <- pr[pr$poziom == "P3 st. projektant" & pr$dzial == "konstrukcje budynków", ]
w_ci <- with(p3b, {
  pp <- exp(predict(m1, p3b, interval = "confidence")); mean(placa >= pp[, 2] & placa <= pp[, 3]) })
w_pi <- with(p3b, {
  pp <- exp(predict(m1, p3b, interval = "prediction")); mean(placa >= pp[, 2] & placa <= pp[, 3]) })
cat("Osoby P3 z budynków (n =", nrow(p3b), "): w paśmie CI", round(100 * w_ci, 1), "% | w paśmie PI",
    round(100 * w_pi, 1), "%\n")

# B. Szerokość obu przedziałów w każdym poziomie (dział budynków, staż 5 lat)
nowe <- data.frame(poziom = factor(levels(pr$poziom), levels = levels(pr$poziom)),
                   dzial = factor("konstrukcje budynków", levels = levels(pr$dzial)), staz = 5)
u <- exp(predict(m1, nowe, interval = "confidence")); r <- exp(predict(m1, nowe, interval = "prediction"))
szer <- data.frame(poziom = nowe$poziom, n = as.vector(table(pr$poziom)), mediana = round(u[, 1], -1),
                   CI = round(u[, 3] - u[, 2], -1), PI = round(r[, 3] - r[, 2], -1),
                   CI_proc = round(100 * (u[, 3] - u[, 2]) / u[, 1], 1), PI_proc = round(100 * (r[, 3] - r[, 2]) / r[, 1], 1))
print(szer, row.names = FALSE)

pA <- ggplot(siatka, aes(staz)) +
  geom_ribbon(aes(ymin = pl, ymax = pu, fill = "95% przedział predykcji (osoba)")) +
  geom_ribbon(aes(ymin = cl, ymax = cu, fill = "95% przedział ufności (mediana)")) +
  geom_line(aes(y = med), colour = kol[["granat"]], linewidth = 0.8) +
  geom_point(data = p3b, aes(staz, placa), colour = "grey25", size = 1.8) +
  scale_fill_manual(values = c("95% przedział ufności (mediana)" = kol[["niebieski"]],
                               "95% przedział predykcji (osoba)" = kol[["blekit"]]), name = NULL,
                    breaks = c("95% przedział ufności (mediana)", "95% przedział predykcji (osoba)")) +
  scale_y_continuous(labels = function(x) format(x, big.mark = " ")) +
  guides(fill = guide_legend(nrow = 1)) +
  labs(title = "A. Starszy projektant, dział budynków",
       subtitle = "punkty: osoby z tej grupy", x = "Staż w firmie (lata)", y = "Płaca miesięczna (zł)") + motyw
dl <- rbind(data.frame(poziom = szer$poziom, rodzaj = "95% przedział ufności (mediana)", w = szer$CI),
            data.frame(poziom = szer$poziom, rodzaj = "95% przedział predykcji (osoba)", w = szer$PI))
dl$rodzaj <- factor(dl$rodzaj, levels = c("95% przedział ufności (mediana)", "95% przedział predykcji (osoba)"))
pB <- ggplot(dl, aes(w, poziom, fill = rodzaj)) +
  geom_col(position = position_dodge(width = 0.75), width = 0.7) +
  geom_text(aes(label = zl(w)), position = position_dodge(width = 0.75), hjust = -0.1, size = 3.2) +
  scale_y_discrete(limits = rev(levels(pr$poziom)), labels = function(x) sub(" .*", "", x)) +
  scale_x_continuous(labels = function(x) format(x, big.mark = " "), expand = expansion(mult = c(0, 0.25))) +
  scale_fill_manual(values = c("95% przedział ufności (mediana)" = kol[["niebieski"]],
                               "95% przedział predykcji (osoba)" = kol[["blekit"]]), name = NULL,
                    breaks = c("95% przedział ufności (mediana)", "95% przedział predykcji (osoba)")) +
  guides(fill = "none") +                     # te same kolory co w panelu A – jedna legenda
  labs(title = "B. Szerokość 95% przedziałów", subtitle = "dział budynków, staż 5 lat",
       x = "Szerokość (zł)", y = NULL) + motyw
p2 <- pA + pB + plot_layout(widths = c(1.25, 1), guides = "collect") & theme(legend.position = "bottom")
p2                       # do pliku: ggsave("siatka-plac-ufnosc-a-predykcja.svg", p2, width = 10, height = 5.8)
Wynik w R
P3, budynki, staż 7 lat: mediana 12 120 zł | 95% CI [ 11 710 , 12 540 ] | 95% PI [ 9 740 , 15 090 ]
Szerokość CI: 830 zł | szerokość PI: 5 350 zł | iloraz: 6.4
Osoby P3 z budynków (n = 25 ): w paśmie CI 16 % | w paśmie PI 92 %
            poziom  n mediana   CI    PI CI_proc PI_proc
       P1 asystent 50    7220  540  3200     7.5    44.3
     P2 projektant 60    9320  570  4100     6.1    44.1
 P3 st. projektant 50   11810  820  5220     6.9    44.2
 P4 gł. projektant 32   14940 1370  6670     9.2    44.6
  P5 kier. zespołu 18   19910 2280  8990    11.4    45.1
       P6 dyrektor 10   22620 3560 10510    15.8    46.5
4. Reszty studentyzowane: Rysunek 3
R
# Rysunek 3. Kto jest poza siatką? Reszty studentyzowane i przedział predykcji bez danej osoby
# (korzysta z kol, motyw, pr z przepisu 1 i m1 z przepisu 2 – bez nowego losowania)
library(ggplot2)
library(ggrepel)
zl <- function(x) format(round(x, -1), big.mark = " ", trim = TRUE)

n <- nrow(pr); df_r <- m1$df.residual - 1                    # stopnie swobody reszty studentyzowanej
pr$rstud <- rstudent(m1)                                      # reszta studentyzowana zewnętrznie
pr$przew <- exp(fitted(m1))                                   # przewidywana mediana płacy
pr$roznica_proc <- 100 * (pr$placa / pr$przew - 1)
prog95 <- qt(0.975, df_r)
prog_bonf <- qt(1 - 0.025 / n, df_r)                          # poprawka Bonferroniego na 220 osób
cat("Próg 95%: |t| >", round(prog95, 2), "| próg z poprawką Bonferroniego:", round(prog_bonf, 2), "\n")

# |reszta studentyzowana| > t(0.975) <=> osoba leży poza 95% przedziałem predykcji z modelu bez niej
i <- which(pr$id == "O130")
m_bez <- update(m1, data = pr[-i, ])
pi_bez <- exp(predict(m_bez, pr[i, ], interval = "prediction"))
cat("O130: płaca", pr$placa[i], "zł | 95% PI z modelu bez O130 [", zl(pi_bez[2]), ",", zl(pi_bez[3]),
    "] | reszta studentyzowana", round(pr$rstud[i], 2), "\n")

pr$strefa <- factor(ifelse(abs(pr$rstud) > prog_bonf, "poza progiem Bonferroniego",
                    ifelse(abs(pr$rstud) > prog95, "poza 95% PI", "w siatce")),
                    levels = c("w siatce", "poza 95% PI", "poza progiem Bonferroniego"))
pr$ustawiona <- pr$id %in% c("O070", "O130", "O175", "O020", "O200")   # znane z symulacji
cat("Poza 95% PI:", sum(abs(pr$rstud) > prog95), "osób (spodziewane przy samym przypadku ok.",
    round(0.05 * n), ") | poza progiem Bonferroniego:", sum(abs(pr$rstud) > prog_bonf), "\n")
d <- pr[abs(pr$rstud) > prog95, ]
d <- d[order(-abs(d$rstud)), ]
print(data.frame(id = d$id, poziom = sub(" .*", "", d$poziom), dzial = substr(d$dzial, 1, 9), staz = d$staz,
                 placa = d$placa, przew = round(d$przew, -1), roznica = round(d$roznica_proc, 1),
                 rstud = round(d$rstud, 2), ustawiona = d$ustawiona), row.names = FALSE)
cat("Ustawione ręcznie, które nie przekroczyły progu 95%:",
    paste(pr$id[pr$ustawiona & abs(pr$rstud) <= prog95], collapse = ", "), "\n")
cat("Wśród osób poza 95% PI nowo zatrudnionych (staż < 2):", sum(d$nowy), "z", nrow(d),
    "| w całej firmie:", round(100 * mean(pr$nowy), 1), "%\n")

pr$etykieta <- ifelse(pr$strefa != "w siatce", pr$id, NA)
p3 <- ggplot(pr, aes(przew, rstud)) +
  annotate("rect", xmin = 3000, xmax = 60000, ymin = -prog95, ymax = prog95, fill = kol[["blekit"]], alpha = 0.15) +
  geom_hline(yintercept = c(-prog95, prog95), linetype = "dashed", colour = kol[["niebieski"]]) +
  geom_hline(yintercept = c(-prog_bonf, prog_bonf), colour = kol[["niebieski"]]) +
  geom_hline(yintercept = 0, colour = "grey55") +
  geom_point(aes(shape = strefa, colour = strefa), size = 2.3) +
  geom_point(data = pr[pr$ustawiona, ], shape = 1, size = 4.6, colour = kol[["granat"]], stroke = 0.8) +
  geom_text_repel(aes(label = etykieta), size = 3.3, colour = kol[["granat"]], seed = 1, na.rm = TRUE,
                  min.segment.length = 0.2, box.padding = 0.45) +
  scale_x_log10(breaks = c(6000, 8000, 11000, 15000, 20000, 27000), labels = function(x) format(x, big.mark = " ")) +
  coord_cartesian(xlim = range(pr$przew)) +
  scale_shape_manual(values = c(16, 17, 15), name = NULL) +
  scale_colour_manual(values = c(kol[["szary"]], kol[["zolty"]], kol[["pomaranczowy"]]), name = NULL) +
  labs(title = "Reszty studentyzowane: kto odstaje od siatki?",
       subtitle = sprintf("przerywane: ±%.2f (95%% PI bez danej osoby); ciągłe: ±%.2f (Bonferroni); kółka: ustawione ręcznie",
                          prog95, prog_bonf),
       x = "Płaca przewidywana przez model (zł, skala log.)", y = "Reszta studentyzowana") + motyw
p3                       # do pliku: ggsave("siatka-plac-poza-siatka-reszty.svg", p3, width = 10, height = 5.8)
Wynik w R
Próg 95%: |t| > 1.97 | próg z poprawką Bonferroniego: 3.75
O130: płaca 8430 zł | 95% PI z modelu bez O130 [ 9 170 , 14 150 ] | reszta studentyzowana -2.73
Poza 95% PI: 12 osób (spodziewane przy samym przypadku ok. 11 ) | poza progiem Bonferroniego: 1
   id poziom     dzial staz placa przew roznica rstud ustawiona
 O020     P1 konstrukc  0.9 10270  6860    49.8  3.86      TRUE
 O200     P5 mosty i o 13.2 33540 23400    43.3  3.48      TRUE
 O197     P5 konstrukc 21.8 34310 24680    39.0  3.22     FALSE
 O130     P3 BIM i dok  7.1  8430 11270   -25.2 -2.73      TRUE
 O215     P6 konstrukc  1.6 16590 21660   -23.4 -2.67     FALSE
 O070     P2 konstrukc  2.0  6810  8970   -24.0 -2.56      TRUE
 O126     P3 BIM i dok  1.2 13410 10450    28.3  2.34     FALSE
 O133     P3 konstrukc  1.4 14300 11280    26.7  2.21     FALSE
 O170     P4 konstrukc  6.4 12070 15210   -20.7 -2.17     FALSE
 O135     P3 konstrukc 13.3 10540 13140   -19.8 -2.06     FALSE
 O056     P2 konstrukc  0.5 10960  8790    24.6  2.04     FALSE
 O152     P3 konstrukc  0.7 13820 11180    23.6  1.97     FALSE
Ustawione ręcznie, które nie przekroczyły progu 95%: O175
Wśród osób poza 95% PI nowo zatrudnionych (staż < 2): 6 z 12 | w całej firmie: 23.6 %
5. Regresja kwantylowa i widełki: Rysunek 4
R
# Rysunek 4. Widełki z regresji kwantylowej (10. i 90. centyl) a jeden rozrzut z MNK
# (korzysta z kol, motyw, pr z przepisu 1 i m1 z przepisu 2)
library(ggplot2)
suppressPackageStartupMessages(library(quantreg))
zl <- function(x) format(round(x, -1), big.mark = " ", trim = TRUE)

pr$staz5 <- pr$staz - 5                                       # staż wycentrowany na 5 lat
tau <- c(0.10, 0.50, 0.90)
mq <- suppressWarnings(rq(log(placa) ~ poziom + staz5 + dzial, tau = tau, data = pr))   # ostrzeżenie: rozwiązanie niejednoznaczne
cat("Nachylenie stażu (% na rok) dla tau = .10, .50, .90:", round(100 * (exp(coef(mq)["staz5", ]) - 1), 2), "\n")

# Widełki: dział budynków, staż 5 lat
nowe <- data.frame(poziom = factor(levels(pr$poziom), levels = levels(pr$poziom)),
                   dzial = factor("konstrukcje budynków", levels = levels(pr$dzial)), staz5 = 0, staz = 5)
q <- exp(predict(mq, nowe))
colnames(q) <- c("P10", "P50", "P90")
# Dla porównania: MNK z jednym rozrzutem – 80% przedział predykcji odpowiada widełkom 10.–90. centyl
o <- exp(predict(m1, nowe, interval = "prediction", level = 0.80))
wid <- data.frame(poziom = nowe$poziom, n = as.vector(table(pr$poziom)),
                  q10 = round(q[, 1], -1), q50 = round(q[, 2], -1), q90 = round(q[, 3], -1),
                  rozp_q = round(100 * (q[, 3] / q[, 1] - 1), 1),
                  mnk10 = round(o[, 2], -1), mnk90 = round(o[, 3], -1), rozp_mnk = round(100 * (o[, 3] / o[, 2] - 1), 1))
print(wid, row.names = FALSE)

# Bootstrap (pary obserwacji) dla 90. centyla w P1 i P6 – jak dokładne są górne krańce widełek?
set.seed(7160)
bq <- t(replicate(1000, {
  j <- sample(nrow(pr), replace = TRUE)
  f <- try(suppressWarnings(rq(log(placa) ~ poziom + staz5 + dzial, tau = 0.90, data = pr[j, ])), silent = TRUE)
  if (inherits(f, "try-error")) c(NA, NA) else exp(predict(f, nowe[c(1, 6), ]))
}))
cat("Bootstrap (1000 prób), 90. centyl – 95% przedział percentylowy:\n")
cat("  P1:", zl(quantile(bq[, 1], .025, na.rm = TRUE)), "–", zl(quantile(bq[, 1], .975, na.rm = TRUE)), "zł\n")
cat("  P6:", zl(quantile(bq[, 2], .025, na.rm = TRUE)), "–", zl(quantile(bq[, 2], .975, na.rm = TRUE)), "zł\n")

# Ile osób w każdym poziomie mieści się w widełkach (po przeliczeniu na staż 5 lat i dział budynków)?
pr$q10 <- exp(predict(mq, pr)[, 1]); pr$q90 <- exp(predict(mq, pr)[, 3])
op <- exp(predict(m1, pr, interval = "prediction", level = 0.80))
w <- data.frame(poziom = levels(pr$poziom),
                w_kwantylowych = round(100 * tapply(pr$placa >= pr$q10 & pr$placa <= pr$q90, pr$poziom, mean), 1),
                w_mnk80 = round(100 * tapply(pr$placa >= op[, 2] & pr$placa <= op[, 3], pr$poziom, mean), 1))
print(w, row.names = FALSE)

wd <- rbind(data.frame(poziom = wid$poziom, metoda = "regresja kwantylowa (10.–90. centyl)",
                       dol = wid$q10, sr = wid$q50, gor = wid$q90),
            data.frame(poziom = wid$poziom, metoda = "MNK: 80% przedział predykcji",
                       dol = wid$mnk10, sr = exp(predict(m1, nowe)), gor = wid$mnk90))
wd$metoda <- factor(wd$metoda, levels = c("MNK: 80% przedział predykcji", "regresja kwantylowa (10.–90. centyl)"))
pr$placa5 <- pr$placa * exp(-coef(m1)["staz"] * (pr$staz - 5) -
                            ifelse(pr$dzial == "konstrukcje budynków", 0,
                                   coef(m1)[paste0("dzial", pr$dzial)]))     # płaca przeliczona na staż 5 lat i dział budynków
p4 <- ggplot() +
  geom_point(data = pr, aes(poziom, placa5), colour = "grey60", alpha = 0.6, size = 1.6,
             position = position_jitter(width = 0.12, seed = 2)) +
  geom_errorbar(data = wd, aes(x = poziom, ymin = dol, ymax = gor, colour = metoda, linetype = metoda),
                width = 0.25, linewidth = 0.9, position = position_dodge(width = 0.55)) +
  geom_point(data = wd, aes(poziom, sr, colour = metoda, shape = metoda), size = 2.6,
             position = position_dodge(width = 0.55)) +
  scale_y_log10(breaks = c(5000, 7000, 10000, 14000, 20000, 28000), labels = function(x) format(x, big.mark = " ")) +
  scale_colour_manual(values = c(kol[["szary"]], kol[["niebieski"]]), name = NULL) +
  scale_linetype_manual(values = c("dashed", "solid"), name = NULL) +
  scale_shape_manual(values = c(1, 16), name = NULL) +
  guides(colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2), shape = guide_legend(nrow = 2)) +
  labs(title = "Widełki płac: regresja kwantylowa a MNK",
       subtitle = "dział budynków, staż 5 lat; szare punkty: płace przeliczone na te warunki",
       x = NULL, y = "Płaca miesięczna (zł, skala log.)") +
  motyw + theme(axis.text.x = element_text(size = rel(0.78)))
p4                       # do pliku: ggsave("siatka-plac-regresja-kwantylowa-widelki.svg", p4, width = 10, height = 5.8)
Wynik w R
Nachylenie stażu (% na rok) dla tau = .10, .50, .90: 0.99 1.29 0.89
            poziom  n   q10   q50   q90 rozp_q mnk10 mnk90 rozp_mnk
       P1 asystent 50  6210  7070  8190   32.0  6260  8340     33.2
     P2 projektant 60  8050  9220 10970   36.2  8080 10740     33.0
 P3 st. projektant 50  9980 11760 14100   41.3 10240 13630     33.1
 P4 gł. projektant 32 13200 14650 18160   37.6 12940 17260     33.5
  P5 kier. zespołu 18 16830 19550 29580   75.7 17210 23040     33.9
       P6 dyrektor 10 18410 23330 29860   62.2 19470 26290     35.0
Bootstrap (1000 prób), 90. centyl – 95% przedział percentylowy:
  P1: 7 480 – 8 860 zł
  P6: 25 160 – 32 330 zł
            poziom w_kwantylowych w_mnk80
       P1 asystent           78.0    96.0
     P2 projektant           78.3    80.0
 P3 st. projektant           80.0    80.0
 P4 gł. projektant           81.2    78.1
  P5 kier. zespołu           77.8    72.2
       P6 dyrektor           80.0    50.0
6. Schemat siatki płac: Rysunek 5
R
# Rysunek 5. Schemat siatki płac: pasma poziomów z regresji kwantylowej (grafika)
# (korzysta z kol, motyw z przepisu 1 i tabeli wid z przepisu 5)
library(ggplot2)
zl <- function(x) format(round(x, -1), big.mark = " ", trim = TRUE)

s <- data.frame(k = 1:6, poziom = as.character(wid$poziom), n = wid$n,
                min = round(wid$q10, -2), mid = round(wid$q50, -2), max = round(wid$q90, -2))
s$rozpietosc <- round(100 * (s$max / s$min - 1))
s$nakladanie <- c(round(100 * pmax(0, s$max[-6] - s$min[-1]) / (s$max[-6] - s$min[-6])), NA)  # część pasma wspólna z wyższym
s$mala <- s$n < 20
print(s[, c("poziom", "n", "min", "mid", "max", "rozpietosc", "nakladanie")], row.names = FALSE)

p5 <- ggplot(s) +
  geom_rect(aes(xmin = k - 0.36, xmax = k + 0.36, ymin = min, ymax = max, fill = mala), colour = kol[["granat"]],
            linewidth = 0.4) +
  geom_segment(aes(x = k - 0.36, xend = k + 0.36, y = mid, yend = mid), colour = kol[["granat"]], linewidth = 1.1) +
  geom_text(aes(k, max, label = paste("max", zl(max))), vjust = -0.5, size = 3.3, colour = kol[["granat"]]) +
  geom_text(aes(k, min, label = paste("min", zl(min))), vjust = 1.5, size = 3.3, colour = kol[["granat"]]) +
  geom_text(aes(k + 0.4, mid, label = paste0("środek\n", zl(mid))), hjust = 0, size = 3, colour = "grey25",
            lineheight = 0.9) +
  geom_text(aes(k, 4300, label = paste0("rozpiętość ", rozpietosc, "%\nn = ", n)), size = 3.1,
            colour = "grey25", lineheight = 0.9) +
  geom_text(data = s[!is.na(s$nakladanie), ], aes(k + 0.5, 3500, label = paste0("↔ ", nakladanie, "%")),
            size = 3.1, colour = kol[["pomaranczowy"]]) +
  scale_fill_manual(values = c(`FALSE` = kol[["blekit"]], `TRUE` = "#F3D9A4"),
                    labels = c("pasmo z regresji kwantylowej", "mała grupa (n < 20): pasmo niepewne"), name = NULL) +
  scale_x_continuous(breaks = 1:6, labels = sub(" ", "\n", s$poziom), limits = c(0.5, 6.95)) +
  scale_y_log10(breaks = c(6000, 8000, 11000, 15000, 20000, 28000), labels = function(x) format(x, big.mark = " ")) +
  coord_cartesian(ylim = c(3300, 34000)) +
  labs(title = "Siatka płac: pasmo dla każdego poziomu",
       subtitle = "min = 10. centyl, środek = mediana, max = 90. centyl (dział budynków, staż 5 lat); ↔ część pasma wspólna z wyższym poziomem",
       x = NULL, y = "Płaca miesięczna (zł, skala log.)") +
  motyw + theme(axis.text.x = element_text(size = rel(0.8)), panel.grid.major.x = element_blank(),
                plot.subtitle = element_text(size = rel(0.72)))
p5                       # do pliku: ggsave("siatka-plac-schemat-pasm.svg", p5, width = 10, height = 6.2)
Wynik w R
            poziom  n   min   mid   max rozpietosc nakladanie
       P1 asystent 50  6200  7100  8200         32         10
     P2 projektant 60  8000  9200 11000         38         33
 P3 st. projektant 50 10000 11800 14100         41         22
 P4 gł. projektant 32 13200 14600 18200         38         28
  P5 kier. zespołu 18 16800 19600 29600         76         88
       P6 dyrektor 10 18400 23300 29900         62         NA
7. Kompresja płac i symulacja: Rysunek 6
R
# Rysunek 6. Kompresja płac: nowo zatrudnieni dostają więcej – co to robi z modelem i z siatką?
# (korzysta z kol, motyw, pr z przepisu 1 i m1 z przepisu 2; symulacja losuje – własne ziarno)
library(ggplot2)
suppressPackageStartupMessages(library(patchwork))

# 1. W danych firmy: model z oznaczeniem „zatrudniony mniej niż 2 lata temu”
m2 <- lm(log(placa) ~ poziom + staz + nowy + dzial, data = pr)
ci2 <- confint(m2)
cat("Model z oznaczeniem nowych: premia nowych", round(100 * (exp(coef(m2)["nowy"]) - 1), 1), "%, 95% CI [",
    round(100 * (exp(ci2["nowy", 1]) - 1), 1), ",", round(100 * (exp(ci2["nowy", 2]) - 1), 1), "]\n")
cat("Staż: bez oznaczenia", round(100 * (exp(coef(m1)["staz"]) - 1), 2), "% na rok | z oznaczeniem",
    round(100 * (exp(coef(m2)["staz"]) - 1), 2), "% na rok (prawda: 1.21%)\n")
t2 <- qt(0.975, m2$df.residual - 1)
cat("Poza 95% PI: model bez oznaczenia", sum(abs(rstudent(m1)) > qt(0.975, m1$df.residual - 1)),
    "osób | z oznaczeniem", sum(abs(rstudent(m2)) > t2), "osób\n")

# 2. Symulacja: 1000 fikcyjnych biur o tej samej strukturze, premia nowych 0, 4, 8 lub 12%
generuj <- function(premia) {
  poz <- rep(1:6, c(50, 60, 50, 32, 18, 10))
  dz <- sample(1:4, length(poz), replace = TRUE, prob = c(0.50, 0.25, 0.20, 0.05))
  staz <- round(pmin(rgamma(length(poz), shape = 2, rate = 2 / c(2, 4, 7, 10, 12, 15)[poz]), 30), 1)
  nowy <- as.integer(staz < 2)
  y <- log(c(6500, 8500, 11000, 14000, 17500, 22000)[poz]) + 0.012 * staz + premia * nowy +
    c(0, 0.04, -0.06, 0.03)[dz] + rnorm(length(poz), 0, c(0.07, 0.08, 0.09, 0.11, 0.13, 0.15)[poz])
  data.frame(y, poziom = factor(poz), dzial = factor(dz), staz, nowy)
}
jedna <- function(premia) {
  d <- generuj(premia)
  a <- lm(y ~ poziom + staz + dzial, data = d)
  b <- lm(y ~ poziom + staz + nowy + dzial, data = d)
  ra <- rstudent(a); ta <- qt(0.975, a$df.residual - 1)
  c(staz_bez = 100 * (exp(unname(coef(a)["staz"])) - 1), staz_z = 100 * (exp(unname(coef(b)["staz"])) - 1),
    nowi_nad_srodkiem = mean(ra[d$nowy == 1] > 0), nowi_ponad = mean(ra[d$nowy == 1] > ta))
}
set.seed(7161)
premie <- c(0, 0.04, 0.08, 0.12)
wyn <- do.call(rbind, lapply(premie, function(pm) data.frame(premia = pm, t(replicate(1000, jedna(pm))))))
sumy <- aggregate(cbind(staz_bez, staz_z, nowi_nad_srodkiem, nowi_ponad) ~ premia, data = wyn, FUN = mean)
sumy[, c("nowi_nad_srodkiem", "nowi_ponad")] <- 100 * sumy[, c("nowi_nad_srodkiem", "nowi_ponad")]
print(round(sumy, 2), row.names = FALSE)
bladmc <- aggregate(cbind(nowi_nad_srodkiem, nowi_ponad) ~ premia, data = wyn,
                    FUN = function(x) 100 * sd(x) / sqrt(length(x)))
cat("Błąd Monte Carlo (pp) – nad środkiem:", round(bladmc$nowi_nad_srodkiem, 2), "| ponad pasmem:",
    round(bladmc$nowi_ponad, 2), "\n")

dl <- rbind(data.frame(premia = wyn$premia, model = "bez oznaczenia nowych", b = wyn$staz_bez),
            data.frame(premia = wyn$premia, model = "z oznaczeniem nowych", b = wyn$staz_z))
q <- aggregate(b ~ premia + model, data = dl, FUN = function(x) c(sr = mean(x), d = quantile(x, .05), g = quantile(x, .95)))
q <- data.frame(premia = q$premia, model = q$model, q$b)
names(q)[3:5] <- c("sr", "d", "g")
pA <- ggplot(q, aes(factor(100 * premia), sr, colour = model, shape = model)) +
  geom_hline(yintercept = 100 * (exp(0.012) - 1), linetype = "dashed", colour = "grey40") +
  geom_errorbar(aes(ymin = d, ymax = g), width = 0.2, linewidth = 0.8, position = position_dodge(width = 0.5)) +
  geom_point(size = 2.8, position = position_dodge(width = 0.5)) +
  scale_colour_manual(values = c(kol[["pomaranczowy"]], kol[["niebieski"]]), name = NULL) +
  scale_shape_manual(values = c(17, 16), name = NULL) +
  guides(colour = guide_legend(nrow = 2)) +
  labs(title = "A. Oszacowany wzrost płacy za rok stażu",
       subtitle = "1000 symulacji: średnia i 90%; linia: prawda", x = "Premia dla nowo zatrudnionych (%)",
       y = "% na rok stażu") + motyw
dB <- rbind(data.frame(premia = sumy$premia, grupa = "powyżej środka pasma (reszta > 0)", v = sumy$nowi_nad_srodkiem),
            data.frame(premia = sumy$premia, grupa = "ponad pasmem 95% (poza siatką)", v = sumy$nowi_ponad))
dB$grupa <- factor(dB$grupa, levels = unique(dB$grupa))
pB <- ggplot(dB, aes(factor(100 * premia), v, fill = grupa)) +
  geom_col(position = position_dodge(width = 0.75), width = 0.7) +
  geom_text(aes(label = sprintf("%.1f", v)), position = position_dodge(width = 0.75), vjust = -0.4, size = 3.2) +
  scale_fill_manual(values = c(kol[["blekit"]], kol[["pomaranczowy"]]), name = NULL) +
  scale_y_continuous(expand = expansion(mult = c(0, 0.15))) +
  guides(fill = guide_legend(nrow = 2)) +
  labs(title = "B. Gdzie w siatce lądują nowi?", subtitle = "model bez oznaczenia nowych",
       x = "Premia dla nowo zatrudnionych (%)", y = "% nowo zatrudnionych") + motyw
p6 <- pA + pB
p6                       # do pliku: ggsave("siatka-plac-kompresja-symulacja.svg", p6, width = 10, height = 5.8)
Wynik w R
Model z oznaczeniem nowych: premia nowych 10.4 %, 95% CI [ 6.2 , 14.7 ]
Staż: bez oznaczenia 1.29 % na rok | z oznaczeniem 1.55 % na rok (prawda: 1.21%)
Poza 95% PI: model bez oznaczenia 12 osób | z oznaczeniem 12 osób
 premia staz_bez staz_z nowi_nad_srodkiem nowi_ponad
   0.00     1.21   1.21             50.05       1.20
   0.04     1.11   1.21             60.42       2.06
   0.08     0.99   1.21             70.20       3.39
   0.12     0.89   1.21             78.34       4.73
Błąd Monte Carlo (pp) – nad środkiem: 0.18 0.19 0.18 0.17 | ponad pasmem: 0.05 0.06 0.07 0.08
8. Sprawdzenie palety (deuteranopia)
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – błękit" = c("#0072B2", "#56B4E9"), "niebieski – pomarańczowy" = c("#0072B2", "#D55E00"),
             "zielony – różowy" = c("#009E73", "#CC79A7"), "pomarańczowy – zielony" = c("#D55E00", "#009E73"),
             "szary – żółty" = c("#999999", "#E69F00"), "żółty – pomarańczowy" = c("#E69F00", "#D55E00"),
             "błękit – piaskowy (pasma)" = c("#56B4E9", "#F3D9A4"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
niebieski – błękit                          26.4         24.7       24.6
niebieski – pomarańczowy                   114.6        108.3       91.9
zielony – różowy                            87.5         18.1       36.2
pomarańczowy – zielony                     102.4         53.5       37.3
szary – żółty                               76.8         73.9       70.0
żółty – pomarańczowy                        33.4         18.4       24.9
błękit – piaskowy (pasma)                   68.0         71.1       62.5
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie, regresję liniową (lm), przedziały ufności i predykcji (predict) oraz reszty studentyzowane (rstudent) wykonano pakietem stats (z podstawowej instalacji R), regresję kwantylową – pakietem quantreg. Rysunki wykonano w pakiecie ggplot2, etykiety rozmieszczono pakietem ggrepel, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- quantreg (wersja 6.1): Koenker, R. (2025). quantreg: Quantile regression (R package version 6.1) [Computer software]. https://doi.org/10.32614/CRAN.package.quantreg
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- ggrepel (wersja 0.9.8): Slowikowski, K. (2026). ggrepel: Automatically position non-overlapping text labels with 'ggplot2' [R package]. https://doi.org/10.32614/CRAN.package.ggrepel
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Przedział ufności zamiast predykcji. Widełki z przedziału ufności wyrzucają z siatki większość ludzi (84% starszych projektantów działu budynków).
- „b × 100 procent” przy dużych współczynnikach. 1.14 na skali logarytmu to +213%, nie +114%.
- Małe działy i poziomy. Dziewięć osób w ekspertyzach i dziesięciu dyrektorów to za mało na własne widełki.
- Siatka „z obecnych płac” utrwala obecne błędy. Najpierw przejrzyj listę osób poza siatką, potem licz widełki.
Najczęstsze pytania
Jak wyznaczyć widełki płacowe dla stanowiska?
Najczęściej jako 10. i 90. centyl płac na danym poziomie po uwzględnieniu stażu i działu. Najprościej policzyć je regresją kwantylową (w R pakiet quantreg). Przedział predykcji ze zwykłej regresji daje podobny wynik tylko wtedy, gdy rozrzut płac jest taki sam na każdym poziomie; w przykładzie biura projektowego objął 96% asystentów i 50% dyrektorów. Dla poziomów z kilkunastoma osobami przyjmij rozpiętość pasma z liczniejszych poziomów.
Jak interpretować współczynnik w regresji logarytmu płacy?
Zmiana procentowa płacy to 100 × (eb − 1). Dla małych b to prawie 100 × b (0.013 → 1.3% na rok stażu), ale dla dużych różnica jest ogromna: b = 1.142 oznacza +213%, nie +114%. Pamiętaj też, że eprzewidywanie to mediana płacy, a nie średnia.
Siatka płac: przedział predykcji czy przedział ufności?
Przedział ufności mówi, gdzie leży średnia (tu: mediana) płacy osób o danych cechach. Przedział predykcji mówi, gdzie powinna wypaść płaca jednej nowej osoby – dodaje rozrzut osób wokół modelu, więc jest szerszy. W przykładzie był 6.4 razy szerszy: 9 740–15 090 zł wobec 11 710–12 540 zł.
Jak znaleźć pracowników, których płaca odbiega od siatki?
Policz reszty studentyzowane (w R rstudent()). Reszta większa co do modułu niż kwantyl rozkładu t (ok. 1.97) oznacza, że płaca leży poza 95% przedziałem predykcji z modelu oszacowanego bez tej osoby. Przy wielu osobach część przekroczy próg przez przypadek – w firmie z 220 osobami ok. 11 – więc podaj też wynik z poprawką Bonferroniego i traktuj listę jako listę do sprawdzenia, nie do kary.
Co to jest kompresja płac i jak wpływa na analizę?
Kompresja płac to sytuacja, w której nowo zatrudnieni dostają tyle co koledzy z dłuższym stażem albo więcej, bo rynek podnosi stawki szybciej niż firma podwyżki. W modelu z samym stażem zaniża to efekt stażu – w symulacji z 1.21% do 0.89% na rok przy premii 12% – a nowi częściej trafiają do górnej części widełek. Pomaga dodanie zmiennej „zatrudniony w ostatnich 2 latach” albo roku zatrudnienia.
Powiązane hasła
Przeczytaj też
Luka płacowa – Oaxaca–Blinder
900 pracowników zakładu meblarskiego: surowa luka, regresja log płac, dekompozycja z bootstrapem, grupa odniesienia, nadkontrola i regresja kwantylowa – pięć rysunków z kodem R.
Czytaj →PoradnikRegresja kwantylowa krok po kroku
Model dla kilku τ, błędy standardowe, wykres współczynników w funkcji τ, test równości nachyleń i porównanie z MNK – na jednym przykładzie w R.
Czytaj →PoradnikTrafność testu rekrutacyjnego i korekta Thorndike’a
Test koreluje z oceną pracy tylko na r = .27, bo zatrudniono najlepszych. Korekta Thorndike’a z przedziałem bootstrap, test uwagi i próg – z kodem R.
Czytaj →Analizujesz wynagrodzenia w pracy dyplomowej albo w firmie?
Pomożemy zbudować model płac, wyznaczyć widełki z niepewnością i opisać wynik tak, żebyś umiał(a) go obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bewick, V., Cheek, L., & Ball, J. (2003). Statistics review 7: Correlation and regression. Critical Care, 7(6), 451–459. https://doi.org/10.1186/cc2401 ● Otwarty dostęp
- Castle, D. S. (2005). Estimating seniority effects in faculty salary studies: Measurement and model specification. Public Personnel Management, 34(4), 377–384. https://doi.org/10.1177/009102600503400408
- Chatterjee, S., & Hadi, A. S. (1986). Influential observations, high leverage points, and outliers in linear regression. Statistical Science, 1(3), 379–393. https://doi.org/10.1214/ss/1177013622 ● Otwarty dostęp
- Duan, N. (1983). Smearing estimate: A nonparametric retransformation method. Journal of the American Statistical Association, 78(383), 605–610. https://doi.org/10.1080/01621459.1983.10478017
- Kocherginsky, M., He, X., & Mu, Y. (2005). Practical confidence intervals for regression quantiles. Journal of Computational and Graphical Statistics, 14(1), 41–55. https://doi.org/10.1198/106186005x27563
- Koenker, R., & Hallock, K. F. (2001). Quantile regression. Journal of Economic Perspectives, 15(4), 143–156. https://doi.org/10.1257/jep.15.4.143
- van Garderen, K. J., & Shah, C. (2002). Exact interpretation of dummy variables in semilogarithmic equations. The Econometrics Journal, 5(1), 149–159. https://doi.org/10.1111/1368-423x.00078
Cytowania BibTeX
@article{bewick2003statistics, author={Bewick, Viv and Cheek, Liz and Ball, Jonathan}, title={{Statistics review 7: Correlation and regression}}, journal={Critical Care}, year={2003}, volume={7}, number={6}, pages={451--459}, doi={10.1186/cc2401}}@article{castle2005estimating, author={Castle, David S.}, title={{Estimating seniority effects in faculty salary studies: Measurement and model specification}}, journal={Public Personnel Management}, year={2005}, volume={34}, number={4}, pages={377--384}, doi={10.1177/009102600503400408}}@article{chatterjee1986influential, author={Chatterjee, Samprit and Hadi, Ali S.}, title={{Influential observations, high leverage points, and outliers in linear regression}}, journal={Statistical Science}, year={1986}, volume={1}, number={3}, pages={379--393}, doi={10.1214/ss/1177013622}}@article{duan1983smearing, author={Duan, Naihua}, title={{Smearing estimate: A nonparametric retransformation method}}, journal={Journal of the American Statistical Association}, year={1983}, volume={78}, number={383}, pages={605--610}, doi={10.1080/01621459.1983.10478017}}@article{kocherginsky2005practical, author={Kocherginsky, Masha and He, Xuming and Mu, Yunming}, title={{Practical confidence intervals for regression quantiles}}, journal={Journal of Computational and Graphical Statistics}, year={2005}, volume={14}, number={1}, pages={41--55}, doi={10.1198/106186005x27563}}@article{koenker2001quantile, author={Koenker, Roger and Hallock, Kevin F.}, title={{Quantile regression}}, journal={Journal of Economic Perspectives}, year={2001}, volume={15}, number={4}, pages={143--156}, doi={10.1257/jep.15.4.143}}@article{vangarderen2002exact, author={van Garderen, Kees Jan and Shah, Chandra}, title={{Exact interpretation of dummy variables in semilogarithmic equations}}, journal={The Econometrics Journal}, year={2002}, volume={5}, number={1}, pages={149--159}, doi={10.1111/1368-423x.00078}}