se = "nid" albo bootstrap. Różnice między kwantylami sprawdź testem z anova(), a nie nakładaniem się przedziałów.Kiedy średnia nie wystarcza
Regresja MNK odpowiada na jedno pytanie: jak predyktor zmienia średnią warunkową wyniku. Często to wystarcza. Bywa jednak, że ważniejsze są skraje rozkładu. Kliniczne zainteresowanie budzą najdłuższe czasy reakcji, najcięższe objawy albo najniższa masa urodzeniowa. Wtedy jedna liczba dla średniej może ukryć efekt, który działa tylko w ogonie rozkładu.
Definicję, funkcję straty i prosty przykład z jednym predyktorem znajdziesz w haśle regresja kwantylowa. Ten wpis prowadzi przez pełną analizę do artykułu. Na jednym zbiorze danych pokazujemy model z kilkoma predyktorami, porównanie z MNK przy heterogeniczności wariancji, wybór błędów standardowych, wykres współczynników w funkcji τ i test równości nachyleń. Koenker i Bassett (1978) wprowadzili kwantyle regresyjne. Przystępny przegląd metody dają Koenker i Hallock (2001), a pełny wykład – monografia Koenkera (2005).
Po regresję kwantylową sięgnij, gdy:
- pytanie badawcze dotyczy ogona rozkładu, np. 90. centyla, a nie średniej;
- rozrzut wyniku zmienia się wraz z predyktorem, więc efekt może być inny na dole i na górze rozkładu;
- wynik jest silnie skośny albo ma odstające wartości, a chcesz opisać medianę warunkową bez transformacji.
Jeśli chodzi tylko o odporność oszacowania średniego trendu na odstające obserwacje, lepiej pasuje regresja odporna (estymatory M i MM). Ona nadal opisuje jeden „typowy” trend, a regresja kwantylowa opisuje cały rozkład warunkowy.
Przykład: wiek, aktywność fizyczna i czas reakcji
W badaniu wzięło udział 600 dorosłych w wieku 20–79 lat. Wynikiem jest czas reakcji w zadaniu wyboru (ms, mediana z prób danej osoby). Predyktory to wiek (w modelu w dekadach, wycentrowany na 50 lat) i regularna aktywność fizyczna (tak/nie). Dane są symulowane (set.seed(328)) z modelu, w którym wiek podnosi czas reakcji i zwiększa jego rozrzut, a aktywność skraca głównie najdłuższe czasy. Możesz je pobrać jako plik CSV (600 wierszy).
| Grupa | n | M | SD | 10. centyl | Mediana | 90. centyl |
|---|---|---|---|---|---|---|
| Nieaktywni | 342 | 467.4 | 66.3 | 398.8 | 455.5 | 552.1 |
| Aktywni fizycznie | 258 | 455.6 | 53.7 | 396.0 | 442.9 | 528.3 |
Już surowe statystyki pokazują wzór: 10. centyle prawie się nie różnią (2.8 ms), a 90. centyle różnią się o 23.8 ms. Różnica średnich (11.8 ms) leży pomiędzy nimi.
Krok 1. Model MNK i diagnoza heteroskedastyczności
Zacznij od zwykłej regresji liniowej. Z każdą dekadą wieku średni czas reakcji rośnie o 20.97 ms, 95% CI [18.71, 23.24]. Osoby aktywne reagują średnio o 11.78 ms szybciej, 95% CI [−19.74, −3.83]. Model wyjaśnia 36.3% wariancji (R² = .363).
Założenie homoskedastyczności nie jest tu spełnione. Odchylenie standardowe reszt wynosi 27.0 ms u osób do 40. roku życia, 50.4 ms w wieku 40–60 lat i 63.3 ms powyżej 60 lat. Studentyzowany test Breuscha–Pagana (Breusch i Pagan, 1979) to potwierdza, BP(2) = 39.33, p < .001. Typowa reakcja to błędy HC3, zalecane przez Longa i Ervina (2000). Dla aktywności dają SE = 3.81 zamiast 4.05, t = −3.09, p = .002. Wniosek się nie zmienia, a dalsze kroki diagnostyki opisuje wpis diagnostyka regresji w R.
HC3 naprawia jednak tylko błąd standardowy, a nie pytanie. Heteroskedastyczność oznacza, że predyktory zmieniają nie tylko położenie rozkładu, lecz także jego skalę. Model średniej tego nie opisze. Regresja kwantylowa robi z tej „usterki” wynik.
Krok 2. Regresja kwantylowa dla kilku τ
Funkcja rq() z pakietu quantreg przyjmuje wektor kwantyli. Dopasowaliśmy model z tymi samymi predyktorami dla τ = .10, .25, .50, .75 i .90. Przedziały ufności pochodzą z bootstrapu par (1000 powtórzeń, o wyborze metody piszemy w kroku 3).
| Model | Wiek (na 10 lat), b [95% CI] | Aktywność (tak − nie), b [95% CI] |
|---|---|---|
| MNK (średnia) | 20.97 [18.71, 23.24] | −11.78 [−19.74, −3.83] |
| τ = .10 | 11.27 [9.03, 13.50] | 4.45 [−4.23, 13.13] |
| τ = .25 | 16.08 [13.82, 18.33] | −3.41 [−9.99, 3.17] |
| τ = .50 | 20.87 [18.52, 23.23] | −8.95 [−15.11, −2.79] |
| τ = .75 | 25.64 [23.46, 27.82] | −22.49 [−31.48, −13.50] |
| τ = .90 | 32.05 [27.23, 36.88] | −42.82 [−60.08, −25.56] |
Jak czytać współczynnik dla τ. Przy τ = .90 współczynnik aktywności wynosi −42.82. Oznacza to, że wśród osób w tym samym wieku 90. centyl czasu reakcji jest u aktywnych o 42.8 ms niższy niż u nieaktywnych. Przy τ = .10 różnica wynosi 4.45 ms i jest nieistotna. Aktywność skraca więc długie czasy reakcji, a najszybszych nie przyspiesza. Wiek przesuwa wszystkie kwantyle, ale górne bardziej: 90. centyl rośnie o 32.05 ms na dekadę, a 10. tylko o 11.27 ms.
Zwróć uwagę, czego to zdanie nie mówi. Współczynnik porównuje warunkowe rozkłady dwóch grup, a nie losy konkretnych osób. „Osoby z 90. centyla” to nie stała grupa wolnych uczestników. To górna część rozkładu przy danym wieku. Twierdzenie, że aktywność pomogłaby najbardziej tym samym ludziom, którzy dziś są najwolniejsi, wymaga dodatkowego założenia o zachowaniu kolejności (rang). Indywidualnych efektów takie dane nie identyfikują. Przy pytaniach o zróżnicowany efekt interwencji zajrzyj do hasła o heterogenicznym efekcie leczenia.
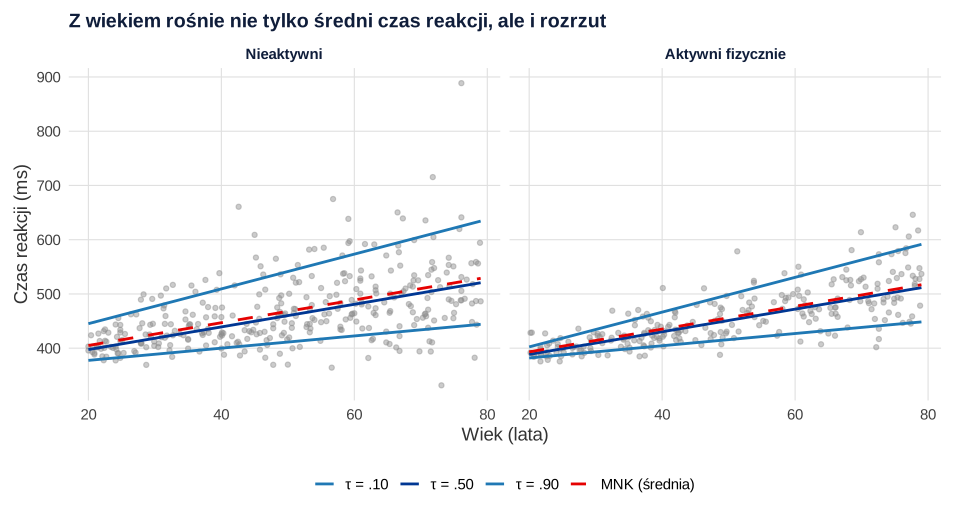
Model pozwala też przewidzieć warunkowe centyle dla konkretnych profili. Dla 70-latka nieaktywnego przewidywany 90. centyl wynosi 605.4 ms, a dla aktywnego 562.6 ms. Dla 30-latków te same wartości to 477.2 i 434.4 ms. Takie liczby łatwiej przekazać czytelnikowi niż same współczynniki.
Uruchamiając kod, zobaczysz ostrzeżenie Solution may be nonunique. Pojawiło się przy τ = .50. Oznacza, że minimum funkcji celu osiąga więcej niż jeden wektor współczynników, podobnie jak mediana parzystej liczby obserwacji nie jest jednoznaczna. Różnice między takimi rozwiązaniami są zwykle pomijalne i ostrzeżenie nie świadczy o błędzie w modelu.
Krok 3. Który błąd standardowy?
Wariancja estymatora kwantylowego zależy od gęstości błędów w pobliżu danego kwantyla. Kocherginsky i in. (2005) zwracają uwagę, że część standardowych przybliżeń dużej próby jest bardzo wrażliwa na odstępstwa od założenia błędów niezależnych o jednakowym rozkładzie (iid). Funkcja summary.rq() oferuje kilka metod:
"iid"– klasyczny wzór asymptotyczny, który zakłada ten sam rozkład błędów dla wszystkich obserwacji;"rank"– przedział z odwrócenia testu rangowego, domyślny przy n < 1001; w wersji domyślnej również zakłada iid;"nid"i"ker"– estymatory kanapkowe, które dopuszczają różną gęstość błędów przy różnych wartościach predyktorów;"boot"– bootstrap, domyślnie par obserwacji (bsmethod = "xy"); są też inne warianty, m.in. wild bootstrap dla danych klastrowanych.
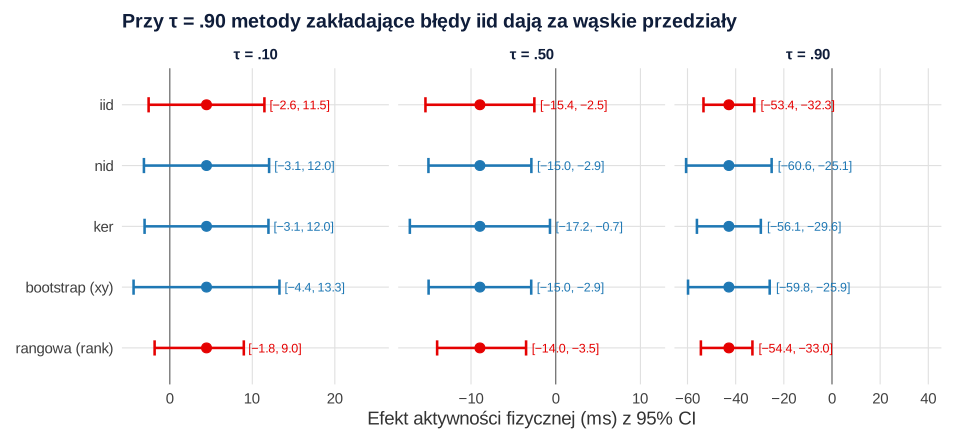
Przy τ = .10 i .50 metody dają podobne wyniki. Przy τ = .90 rozjeżdżają się wyraźnie. Błąd iid wynosi 5.38, a nid 9.06 i bootstrap 8.65. Przedział rangowy [−54.4, −33.0] jest prawie tak wąski jak przedział iid. Przy heteroskedastyczności, czyli właśnie wtedy, gdy regresja kwantylowa jest najciekawsza, metody iid zawyżają precyzję. Wybierz "nid" albo bootstrap. Przy bootstrapie podaj liczbę powtórzeń, wariant i ziarno generatora.
Krok 4. Wykres współczynników w funkcji τ
Pięć kwantyli to wciąż wybór arbitralny. Pełniejszy obraz daje proces kwantylowy, czyli współczynniki oszacowane na gęstej siatce τ z pasmem ufności. Tło tworzy oszacowanie MNK z jego przedziałem. Taki wykres to standard w artykułach z regresją kwantylową. Petscher i Logan (2014) pokazują na danych rozwojowych, że może on prowadzić do innych wniosków niż sama regresja liniowa.
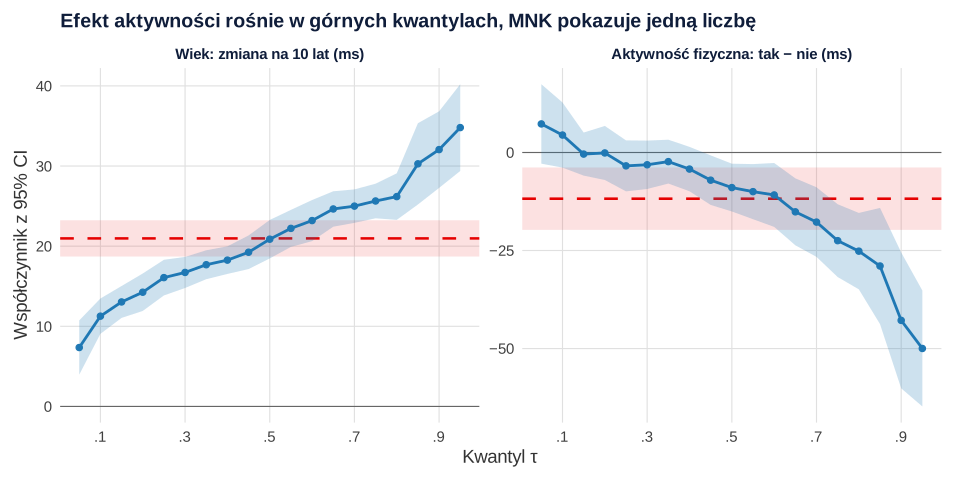
Gdyby predyktory przesuwały tylko położenie rozkładu, obie krzywe byłyby płaskie i mieściłyby się w paśmie MNK. Tu obie mają wyraźne nachylenie. Efekt wieku rośnie od 7.35 ms przy τ = .05 do 34.80 ms przy τ = .95. Efekt aktywności spada od 7.29 ms, 95% CI [−2.85, 17.42], do −49.99 ms, 95% CI [−64.78, −35.20]. Średnia z MNK opisuje dobrze tylko okolice mediany.
Krok 5. Test równości nachyleń
To, że przedziały dla τ = .10 i .90 się nie pokrywają, nie jest jeszcze testem. Funkcja anova() dla obiektów rq liczy test Walda hipotezy, że nachylenia są równe dla podanych kwantyli. Według dokumentacji pakietu to wariant testu Koenkera i Bassetta (1982), którzy porównanie kwantyli regresyjnych wykorzystali do odpornego testowania heteroskedastyczności. Domyślnie używa błędów "nid".
| Hipoteza zerowa | Statystyka | p |
|---|---|---|
| Oba nachylenia równe dla τ = .10, .50, .90 (test łączny) | F(4, 1796) = 35.76 | < .001 |
| Nachylenie wieku równe dla τ = .10, .50, .90 | F(2, 1798) = 45.33 | < .001 |
| Nachylenie aktywności równe dla τ = .10, .50, .90 | F(2, 1798) = 13.27 | < .001 |
| Nachylenie wieku: τ = .10 a τ = .90 | F(1, 1199) = 67.42 | < .001 |
| Nachylenie aktywności: τ = .10 a τ = .90 | F(1, 1199) = 24.95 | < .001 |
Odrzucenie hipotezy oznacza, że predyktor zmienia kształt lub rozrzut rozkładu warunkowego, a nie tylko jego położenie. Planuj takie testy z góry i ogranicz ich liczbę. Porównanie wielu par τ zwiększa ryzyko fałszywych odkryć tak samo jak każde inne porównania wielokrotne.
Krzyżowanie kwantyli i transformacje
Każdy kwantyl szacuje się osobno, więc nic nie gwarantuje, że przewidywany 30. centyl będzie niższy od 35. Na siatce 19 kwantyli przewidywania „krzyżowały się” u 29 z 600 osób. Wszystkie były aktywnymi osobami w wieku 20.2–25.9 lat, czyli na skraju danych, gdzie proste o różnych nachyleniach się spotykają. Krzyżowanie w środku zakresu predyktorów sugeruje źle określony model, np. pominiętą nieliniowość lub interakcję. Na skrajach najczęściej wystarcza rearanżacja, czyli posortowanie przewidywanych kwantyli dla każdej osoby. Chernozhukov i in. (2010) wykazali, że taka krzywa jest w skończonych próbach bliższa prawdziwej niż krzywa wyjściowa. Po sortowaniu krzyżowań było zero.
Druga właściwość dotyczy transformacji logarytmicznej. Kwantyle przechodzą przez przekształcenia monotoniczne bez zmian: mediana logarytmu to logarytm mediany. Po exp() przewidywania z modelu medianowego dla log(czasu) nadal dzieliły obserwacje na połowy (50.2% poniżej). Ze średnią tak nie jest. Wartości exp() z MNK na logarytmach dały średnią 460.0 ms wobec 462.3 ms w danych, bo to średnie geometryczne. Jeśli więc musisz logarytmować skośny wynik, regresja kwantylowa pozwala wrócić do milisekund bez korekt.
Jak opisać regresję kwantylową w artykule
W części „Metody” podaj kwantyle wybrane przed analizą i uzasadnienie, model, funkcję i pakiet, metodę błędów standardowych (przy bootstrapie z liczbą powtórzeń) oraz test równości nachyleń. W wynikach pokaż tabelę dla kilku τ obok MNK i wykres współczynników w funkcji τ. Wzory takich tabel i rysunków znajdziesz we wpisie tabele i rysunki do artykułu naukowego.
Jeśli recenzent pyta, czy regresja kwantylowa jest uzasadniona, albo chcesz sprawdzić wybór błędów standardowych przed wysłaniem tekstu, możemy przejrzeć analizę w ramach wsparcia statystycznego dla badaczy.
Przykład w R
Cztery przepisy uruchamiane po kolei w jednej sesji R. Pierwszy tworzy plik regresja-kwantylowa-czas-reakcji-dane.csv (możesz go pobrać tutaj). Potrzebne pakiety: quantreg, sandwich i lmtest. Ostrzeżenia Solution may be nonunique w wynikach omawiamy w kroku 2.
1. Dane, model MNK i heteroskedastyczność
R
# Dane symulowane: 600 dorosłych (20–79 lat), czas reakcji w zadaniu wyboru (ms, mediana z prób osoby)
# i regularna aktywność fizyczna (1 = tak, 0 = nie). Wiek podnosi czas reakcji i zwiększa jego rozrzut,
# a aktywność skraca głównie najdłuższe czasy (model położenia i skali, błąd prawoskośny).
suppressPackageStartupMessages({library(sandwich); library(lmtest)})
set.seed(328)
n <- 600
wiek <- round(runif(n, 20, 79), 1)
aktywnosc <- rbinom(n, 1, 0.45)
dekady <- (wiek - 50) / 10                                  # wiek wycentrowany na 50 lat, w dekadach
skala <- 55 * (1 + 0.22 * dekady) * (1 - 0.35 * aktywnosc)
blad <- rnorm(n, 0, 0.45) + rexp(n, 1) - 1                 # średnia 0, rozkład prawoskośny
czas <- round(470 + 22 * dekady - 14 * aktywnosc + skala * blad, 1)
dane <- data.frame(id = 1:n, wiek, aktywnosc, czas_reakcji = czas)
write.csv(dane, "regresja-kwantylowa-czas-reakcji-dane.csv", row.names = FALSE)
dane$wiek10 <- (dane$wiek - 50) / 10

# Opis: średnia, SD i centyle czasu reakcji w grupach aktywności
opis <- function(x) c(n = length(x), M = mean(x), SD = sd(x), quantile(x, c(.10, .50, .90)))
round(rbind(nieaktywni = opis(dane$czas_reakcji[dane$aktywnosc == 0]),
            aktywni = opis(dane$czas_reakcji[dane$aktywnosc == 1])), 1)

# Regresja MNK: model średniej warunkowej
m_mnk <- lm(czas_reakcji ~ wiek10 + aktywnosc, data = dane)
round(cbind(b = coef(m_mnk), SE = sqrt(diag(vcov(m_mnk))), confint(m_mnk)), 2)
round(summary(m_mnk)$r.squared, 3)

# Heteroskedastyczność: test Breuscha–Pagana (studentyzowany) i błędy HC3
bptest(m_mnk)
round(coeftest(m_mnk, vcov. = vcovHC(m_mnk, type = "HC3")), 3)

# Rozrzut reszt MNK w tercylach wieku (SD reszt)
round(tapply(resid(m_mnk), cut(dane$wiek, c(19, 40, 60, 80)), sd), 1)
Wynik w R
             n     M   SD   10%   50%   90%
nieaktywni 342 467.4 66.3 398.8 455.5 552.1
aktywni    258 455.6 53.7 396.0 442.9 528.3
                 b   SE  2.5 % 97.5 %
(Intercept) 467.93 2.66 462.71 473.15
wiek10       20.97 1.15  18.71  23.24
aktywnosc   -11.78 4.05 -19.74  -3.83
[1] 0.363

	studentized Breusch-Pagan test

data:  m_mnk
BP = 39.327, df = 2, p-value = 2.886e-09


t test of coefficients:

            Estimate Std. Error t value Pr(>|t|)
(Intercept)  467.929      3.130 149.495   <2e-16 ***
wiek10        20.973      1.202  17.454   <2e-16 ***
aktywnosc    -11.782      3.809  -3.093    0.002 **
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

(19,40] (40,60] (60,80]
   27.0    50.4    63.3
2. Regresja kwantylowa dla pięciu τ
R
# Regresja kwantylowa dla pięciu kwantyli (wymaga obiektów z przepisu 1)
suppressPackageStartupMessages(library(quantreg))
tau <- c(.10, .25, .50, .75, .90)
m_rq <- rq(czas_reakcji ~ wiek10 + aktywnosc, tau = tau, data = dane)

# Współczynniki z 95% CI z bootstrapu par (xy), 1000 powtórzeń
set.seed(3281)
s_boot <- summary(m_rq, se = "boot", bsmethod = "xy", R = 1000)
tabela <- do.call(rbind, lapply(s_boot, function(s) {
  ct <- coef(s); data.frame(tau = s$tau, efekt = rownames(ct), b = ct[, 1], SE = ct[, 2],
                            dolny = ct[, 1] - 1.96 * ct[, 2], gorny = ct[, 1] + 1.96 * ct[, 2], p = ct[, 4]) }))
rownames(tabela) <- NULL
print(transform(tabela, b = round(b, 2), SE = round(SE, 2), dolny = round(dolny, 2),
                gorny = round(gorny, 2), p = round(p, 4)), row.names = FALSE)

# Przewidywane warunkowe centyle czasu reakcji dla osób w wieku 30 i 70 lat
profile <- expand.grid(wiek10 = c(-2, 2), aktywnosc = 0:1)
przew <- predict(m_rq, newdata = profile)
print(cbind(wiek = 50 + 10 * profile$wiek10, aktywnosc = profile$aktywnosc, round(przew, 1)), row.names = FALSE)

# Ekwiwariancja: kwantyl po przekształceniu monotonicznym przenosi się wprost, średnia nie.
# Mediana z modelu dla log(czasu) po exp() nadal dzieli obserwacje na połowy; exp() z MNK dla log(czasu) daje średnią geometryczną.
m_log_rq <- rq(log(czas_reakcji) ~ wiek10 + aktywnosc, tau = .5, data = dane)
m_log_mnk <- lm(log(czas_reakcji) ~ wiek10 + aktywnosc, data = dane)
round(c(odsetek_ponizej_exp_mediany = mean(dane$czas_reakcji < exp(fitted(m_log_rq))),
        srednia_czasu = mean(dane$czas_reakcji), srednia_exp_z_MNK_log = mean(exp(fitted(m_log_mnk)))), 3)
Wynik w R
Warning in rq.fit.br(x, y, tau = tau, ...) : Solution may be nonunique
  tau       efekt      b   SE  dolny  gorny      p
 0.10 (Intercept) 411.30 4.58 402.32 420.28 0.0000
 0.10      wiek10  11.27 1.14   9.03  13.50 0.0000
 0.10   aktywnosc   4.45 4.43  -4.23  13.13 0.3152
 0.25 (Intercept) 435.51 2.88 429.86 441.15 0.0000
 0.25      wiek10  16.08 1.15  13.82  18.33 0.0000
 0.25   aktywnosc  -3.41 3.36  -9.99   3.17 0.3099
 0.50 (Intercept) 460.07 2.93 454.32 465.82 0.0000
 0.50      wiek10  20.87 1.20  18.52  23.23 0.0000
 0.50   aktywnosc  -8.95 3.14 -15.11  -2.79 0.0045
 0.75 (Intercept) 497.05 4.20 488.83 505.28 0.0000
 0.75      wiek10  25.64 1.11  23.46  27.82 0.0000
 0.75   aktywnosc -22.49 4.59 -31.48 -13.50 0.0000
 0.90 (Intercept) 541.34 7.73 526.19 556.49 0.0000
 0.90      wiek10  32.05 2.46  27.23  36.88 0.0000
 0.90   aktywnosc -42.82 8.81 -60.08 -25.56 0.0000
  wiek aktywnosc tau= 0.10 tau= 0.25 tau= 0.50 tau= 0.75 tau= 0.90
1   30         0     388.8     403.3     418.3     445.8     477.2
2   70         0     433.8     467.7     501.8     548.3     605.4
3   30         1     393.2     399.9     409.4     423.3     434.4
4   70         1     438.3     464.3     492.9     525.8     562.6
Warning in rq.fit.br(x, y, tau = tau, ...) : Solution may be nonunique
odsetek_ponizej_exp_mediany               srednia_czasu
                      0.502                     462.326
      srednia_exp_z_MNK_log
                    459.975
3. Porównanie metod błędów standardowych
R
# Porównanie metod błędów standardowych dla efektu aktywności przy τ = .10, .50 i .90 (wymaga przepisów 1–2)
metody <- c("iid", "nid", "ker", "boot")
porownaj <- function(t) {
  m <- rq(czas_reakcji ~ wiek10 + aktywnosc, tau = t, data = dane)
  wyn <- sapply(metody, function(se) {
    set.seed(3282)
    ct <- coef(summary(m, se = se, R = 1000))
    c(b = ct["aktywnosc", 1], SE = ct["aktywnosc", 2]) })
  ci_rank <- coef(summary(m, se = "rank"))["aktywnosc", 2:3]       # przedział z odwrócenia testu rangowego
  c(tau = t, b = wyn["b", 1], wyn["SE", ], rank_dolny = ci_rank[[1]], rank_gorny = ci_rank[[2]])
}
round(t(sapply(c(.10, .50, .90), porownaj)), 2)
Wynik w R
Warning in rq.fit.br(x, y, tau = tau, ci = TRUE, ...) :
  Solution may be nonunique
Warning in rq.fit.br(x, y, tau = tau, ...) : Solution may be nonunique
Warning in rq.fit.br(x, y, tau = tau, ci = TRUE, ...) :
  Solution may be nonunique
     tau      b  iid  nid  ker boot rank_dolny rank_gorny
[1,] 0.1   4.45 3.58 3.87 3.83 4.51      -1.84       8.97
[2,] 0.5  -8.95 3.28 3.10 4.22 3.09     -14.00      -3.50
[3,] 0.9 -42.82 5.38 9.06 6.77 8.65     -54.44     -33.04
4. Test równości nachyleń i krzyżowanie kwantyli
R
# Testy równości nachyleń między kwantylami (Wald, Koenker i Bassett, 1982) – wymaga przepisów 1–2
m3 <- rq(czas_reakcji ~ wiek10 + aktywnosc, tau = c(.10, .50, .90), data = dane)
anova(m3)                       # test łączny: oba nachylenia równe dla τ = .10, .50, .90
anova(m3, joint = FALSE)        # osobno dla każdego predyktora

# Para kwantyli: τ = .10 a τ = .90
m_10 <- rq(czas_reakcji ~ wiek10 + aktywnosc, tau = .10, data = dane)
m_90 <- rq(czas_reakcji ~ wiek10 + aktywnosc, tau = .90, data = dane)
anova(m_10, m_90, joint = FALSE)

# Proces kwantylowy na siatce τ = .05, .10, ..., .95 (błędy nid) i sprawdzenie krzyżowania się kwantyli
siatka <- seq(.05, .95, by = .05)
m_siatka <- rq(czas_reakcji ~ wiek10 + aktywnosc, tau = siatka, data = dane)
przew <- predict(m_siatka, newdata = dane)
krzyz <- apply(przew, 1, function(w) any(diff(w) < 0))
c(osoby_z_krzyzowaniem = sum(krzyz), min_wiek = min(dane$wiek[krzyz]), max_wiek = max(dane$wiek[krzyz]),
  aktywni = sum(dane$aktywnosc[krzyz]))
# Uporządkowanie przewidywanych kwantyli (rearanżacja; Chernozhukov i in., 2010) usuwa krzyżowanie
przew_upor <- t(apply(przew, 1, sort))
c(po_uporzadkowaniu = sum(apply(przew_upor, 1, function(w) any(diff(w) < 0))))
Wynik w R
Warning in rq.fit.br(x, y, tau = tau, ...) : Solution may be nonunique
Quantile Regression Analysis of Deviance Table

Model: czas_reakcji ~ wiek10 + aktywnosc
Joint Test of Equality of Slopes: tau in {  0.1 0.5 0.9  }

  Df Resid Df F value    Pr(>F)
1  4     1796  35.763 < 2.2e-16 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Quantile Regression Analysis of Deviance Table

Model: czas_reakcji ~ wiek10 + aktywnosc
Tests of Equality of Distinct Slopes: tau in {  0.1 0.5 0.9  }

          Df Resid Df F value    Pr(>F)
wiek10     2     1798  45.332 < 2.2e-16 ***
aktywnosc  2     1798  13.273 1.895e-06 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Quantile Regression Analysis of Deviance Table

Model: czas_reakcji ~ wiek10 + aktywnosc
Tests of Equality of Distinct Slopes: tau in {  0.1 0.9  }

          Df Resid Df F value    Pr(>F)
wiek10     1     1199  67.419 5.551e-16 ***
aktywnosc  1     1199  24.949 6.760e-07 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Warning in rq.fit.br(x, y, tau = tau, ...) : Solution may be nonunique
osoby_z_krzyzowaniem             min_wiek             max_wiek
                29.0                 20.2                 25.9
             aktywni
                29.0
po_uporzadkowaniu
                0
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietami quantreg (z zależnością SparseM), sandwich i lmtest; rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- quantreg (wersja 6.1): Koenker, R. (2025). quantreg: Quantile regression (R package version 6.1) [Computer software]. https://doi.org/10.32614/CRAN.package.quantreg
- SparseM (wersja 1.84.2): Koenker, R. (2024). SparseM: Sparse linear algebra (R package version 1.84-2) [Computer software]. https://doi.org/10.32614/CRAN.package.SparseM
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- lmtest (wersja 0.9.40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Podział próby według wyniku. Osobne regresje MNK dla „wolnych” i „szybkich” obcinają zakres zmiennej zależnej i obciążają nachylenia. To inny problem niż podział predyktora na tercyle, ale skutki są podobne. Regresja kwantylowa korzysta z całej próby.
- Interpretacja τ jako grupy osób. Współczynnik dotyczy warunkowego kwantyla, a nie „najwolniejszych uczestników”.
- Domyślne błędy przy heteroskedastyczności. Przy n < 1001 domyślna jest metoda rangowa z założeniem iid. Ustaw
se = "nid"albo bootstrap. - Wnioskowanie z nakładania się przedziałów. Równość nachyleń sprawdź testem z
anova(). - Skrajne τ w małej próbie. Przy τ = .05 i 100 obserwacjach oszacowanie opiera się na kilku punktach. Wybieraj kwantyle, które dane są w stanie unieść, a przy wielu predyktorach – szerszy zakres τ dopiero przy dużym n.
- Brak porównania z MNK. Pokaż oba modele. Czytelnik powinien zobaczyć, co regresja kwantylowa dodaje do średniej. Ogólne zasady budowy modelu omawia wpis regresja wieloraka krok po kroku.
Najczęstsze pytania
Jak interpretować współczynnik regresji kwantylowej dla τ = .90?
To zmiana 90. centyla warunkowego rozkładu wyniku przy zmianie predyktora o jednostkę i stałych pozostałych predyktorach. W przykładzie 90. centyl czasu reakcji był u osób aktywnych o 42.8 ms niższy niż u nieaktywnych w tym samym wieku. Nie oznacza to, że aktywność skraca czas o 42.8 ms u najwolniejszych osób: to porównanie rozkładów, a nie efekt indywidualny.
Którą metodę błędów standardowych wybrać w quantreg?
Przy heteroskedastyczności wybierz se = "nid" albo bootstrap (se = "boot"). Metoda "iid" i domyślna przy n < 1001 metoda rangowa zakładają ten sam rozkład błędów dla wszystkich obserwacji. W przykładzie przy τ = .90 błąd iid wyniósł 5.38, a nid 9.06 i bootstrap 8.65. Przy bootstrapie podaj liczbę powtórzeń, wariant i ziarno.
Jak sprawdzić, czy efekt różni się między kwantylami?
Dopasuj model dla kilku τ jednym wywołaniem rq() i użyj anova(). Funkcja liczy test Walda równości nachyleń, łącznie albo osobno dla każdego predyktora (joint = FALSE). Brak nakładania się przedziałów ufności nie zastępuje testu.
Co zrobić, gdy przewidywane kwantyle się krzyżują?
Sprawdź, gdzie to się dzieje. Na skrajach zakresu predyktorów zwykle wystarcza posortowanie przewidywanych kwantyli dla każdej obserwacji, czyli rearanżacja (Chernozhukov i in., 2010). Krzyżowanie w środku danych sugeruje źle określony model, np. pominiętą nieliniowość lub interakcję.
Czy przed regresją kwantylową trzeba logarytmować skośny wynik?
Nie trzeba, bo regresja kwantylowa nie zakłada normalności reszt. Jeśli logarytmujesz z innych powodów, kwantyle łatwo przenieść z powrotem: exp() z przewidywanej mediany logarytmu to mediana wyniku. Ze średnią z MNK tak nie jest – po exp() dostajesz średnią geometryczną.
Powiązane hasła
Przeczytaj też
Statystyka w pracy z logistyki
Czasy dostaw i percentyle, błędy kompletacji na 1000 linii, przerwany szereg czasowy w magazynie, dostawcy jako skupienia i prognoza popytu: analizy, zdania APA i kod R.
Czytaj →PoradnikDiagnostyka regresji w R
Reszty studentyzowane, dźwignia, Cook i DFBETAS, VIF, maskowanie heteroskedastyczności, HC3 i analiza wrażliwości – z danymi i kodem R.
Czytaj →PoradnikRegresja odporna: estymatory M i MM
Huber, bisquare i MM, rlm i lmrob w R, wagi obserwacji, różnica wobec HC3, granice metody i wzór opisu APA.
Czytaj →PoradnikRegresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikSiatka płac z regresji
220 płac w biurze projektowym: log(płacy) w procentach, przedział predykcji, płace poza siatką i widełki z regresji kwantylowej – z kodem R.
Czytaj →Recenzent pyta, czy średnia wystarczy, czy potrzebna jest regresja kwantylowa?
Pomożemy dobrać kwantyle i błędy standardowe, sprawdzić test równości nachyleń i przygotować tabele oraz wykresy tak, żebyś mógł(a) samodzielnie opisać i obronić analizę.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Breusch, T. S., & Pagan, A. R. (1979). A simple test for heteroscedasticity and random coefficient variation. Econometrica, 47(5), 1287–1294. https://doi.org/10.2307/1911963
- Chernozhukov, V., Fernández-Val, I., & Galichon, A. (2010). Quantile and probability curves without crossing. Econometrica, 78(3), 1093–1125. https://doi.org/10.3982/ecta7880
- Kocherginsky, M., He, X., & Mu, Y. (2005). Practical confidence intervals for regression quantiles. Journal of Computational and Graphical Statistics, 14(1), 41–55. https://doi.org/10.1198/106186005x27563
- Koenker, R. (2005). Quantile regression. Cambridge University Press. https://doi.org/10.1017/cbo9780511754098
- Koenker, R., & Bassett, G., Jr. (1978). Regression quantiles. Econometrica, 46(1), 33–50. https://doi.org/10.2307/1913643
- Koenker, R., & Bassett, G., Jr. (1982). Robust tests for heteroscedasticity based on regression quantiles. Econometrica, 50(1), 43–61. https://doi.org/10.2307/1912528
- Koenker, R., & Hallock, K. F. (2001). Quantile regression. Journal of Economic Perspectives, 15(4), 143–156. https://doi.org/10.1257/jep.15.4.143
- Long, J. S., & Ervin, L. H. (2000). Using heteroscedasticity consistent standard errors in the linear regression model. The American Statistician, 54(3), 217–224. https://doi.org/10.1080/00031305.2000.10474549
- Petscher, Y., & Logan, J. A. R. (2014). Quantile regression in the study of developmental sciences. Child Development, 85(3), 861–881. https://doi.org/10.1111/cdev.12190 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{breusch1979simple, author={Breusch, T. S. and Pagan, A. R.}, title={{A simple test for heteroscedasticity and random coefficient variation}}, journal={Econometrica}, year={1979}, volume={47}, number={5}, pages={1287--1294}, doi={10.2307/1911963}}@article{chernozhukov2010quantile, author={Chernozhukov, Victor and Fern{\'a}ndez-Val, Iv{\'a}n and Galichon, Alfred}, title={{Quantile and probability curves without crossing}}, journal={Econometrica}, year={2010}, volume={78}, number={3}, pages={1093--1125}, doi={10.3982/ecta7880}}@article{kocherginsky2005practical, author={Kocherginsky, Masha and He, Xuming and Mu, Yunming}, title={{Practical confidence intervals for regression quantiles}}, journal={Journal of Computational and Graphical Statistics}, year={2005}, volume={14}, number={1}, pages={41--55}, doi={10.1198/106186005x27563}}@book{koenker2005quantile, author={Koenker, Roger}, title={{Quantile regression}}, year={2005}, publisher={Cambridge University Press}, doi={10.1017/cbo9780511754098}}@article{koenker1978regression, author={Koenker, Roger and Bassett, Gilbert}, title={{Regression quantiles}}, journal={Econometrica}, year={1978}, volume={46}, number={1}, pages={33--50}, doi={10.2307/1913643}}@article{koenker1982robust, author={Koenker, Roger and Bassett, Gilbert}, title={{Robust tests for heteroscedasticity based on regression quantiles}}, journal={Econometrica}, year={1982}, volume={50}, number={1}, pages={43--61}, doi={10.2307/1912528}}@article{koenker2001quantile, author={Koenker, Roger and Hallock, Kevin F.}, title={{Quantile regression}}, journal={Journal of Economic Perspectives}, year={2001}, volume={15}, number={4}, pages={143--156}, doi={10.1257/jep.15.4.143}}@article{long2000using, author={Long, J. Scott and Ervin, Laurie H.}, title={{Using heteroscedasticity consistent standard errors in the linear regression model}}, journal={The American Statistician}, year={2000}, volume={54}, number={3}, pages={217--224}, doi={10.1080/00031305.2000.10474549}}@article{petscher2014quantile, author={Petscher, Yaacov and Logan, Jessica A. R.}, title={{Quantile regression in the study of developmental sciences}}, journal={Child Development}, year={2014}, volume={85}, number={3}, pages={861--881}, doi={10.1111/cdev.12190}}