Co to jest CATE?
CATE (conditional average treatment effect, warunkowy przeciętny efekt leczenia) to średni efekt interwencji wśród osób o tych samych cechach X = x: τ(x) = E[Y(1) − Y(0) | X = x]. Pojęcie pochodzi z modelu potencjalnych wyników. Przeciętny efekt ATE to średnia τ(x) w populacji, a CATE pokazuje, komu interwencja pomaga bardziej, a komu mniej. Czym innym jest moderacja czy efekt interakcji w regresji, gdzie badacz z góry wybiera moderator i kształt zależności.
Las przyczynowy
Ręczna analiza podgrup łatwo daje fałszywe odkrycia. Las przyczynowy (causal forest) Wagera i Athey (2018) rozszerza las losowy Breimana (zob. drzewa decyzyjne i lasy losowe) – szuka różnic w efekcie, nie w wyniku. Autorzy wykazali, że przy braku nieobserwowanych zakłóceń oszacowania τ(x) są zgodne i mają asymptotycznie rozkład normalny, więc można budować przedziały ufności. Drzewa są „uczciwe”: jedna część próby wybiera podziały, druga szacuje efekt w liściach. Uogólnienie metody (generalized random forests) i pakiet grf opisali Athey, Tibshirani i Wager (2019).
W badaniu obserwacyjnym grf najpierw szacuje prawdopodobieństwo przydziału i oczekiwany wynik, a ATE podaje estymatorem AIPW, czyli podwójnie odpornym. Test kalibracji sprawdza, czy prognozy CATE różnicują efekt: współczynnik przy differential.forest.prediction bliski 1 i istotny oznacza realną heterogeniczność.
Przykład
W symulowanej próbie 2000 osób przydział zależy od x1, a prawdziwy efekt to τ = 1 + x2 (średnio 1.02). Naiwna różnica średnich wynosi 1.99. Las przyczynowy daje ATE = 1.11, 95% CI [1.00, 1.22]. W teście kalibracji współczynnik heterogeniczności wynosi 1.10 (p < .001). Nachylenie liniowej projekcji CATE dla x2 wynosi 1.09, a CATE rośnie od −0.46 (x2 ≤ −1) do 2.50 (x2 > 1).
Na rysunku
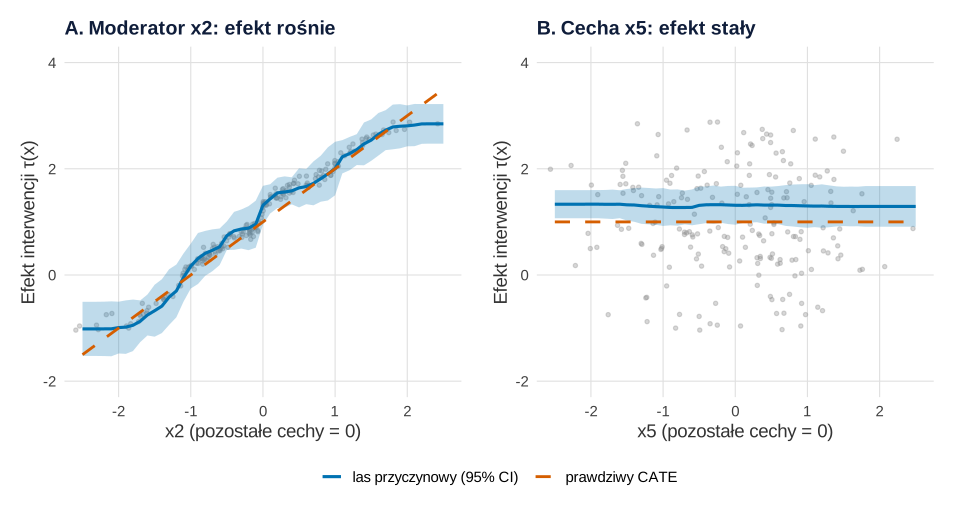
Co widać. Las z przykładu przewiduje efekt dla „typowej” osoby (wszystkie cechy = 0) przy kolejnych wartościach jednej cechy. W panelu A oszacowanie idzie za prawdziwą prostą 1 + x2: przy x2 = −1 wynosi 0.17, 95% CI [−0.25, 0.59], a przy x2 = 1 – 2.01 [1.50, 2.51]. W panelu B, dla cechy x5, od której efekt nie zależy, linia jest płaska (od 1.28 do 1.33). Las znalazł więc moderator tam, gdzie był, i nie wymyślił go tam, gdzie go nie ma. Szare punkty to prognozy poza workiem dla 200 losowych osób.
Na co uważać. Na krańcach x2 las się spłaszcza (przy x2 = −2 daje −0.99 zamiast −1, ale dalej już nie spada), bo liście drzew uśredniają osoby z rzadkich obszarów. Przedziały są punktowe, a nie łączne dla całej krzywej: prawdziwy efekt mieści się w paśmie w 90% punktów siatki dla x2 i tylko w 76% dla x5, bo cały profil leży około 0.3 za wysoko – tak jak ATE z przykładu (1.11 wobec 1.02). Profil przy pozostałych cechach równych 0 nie jest średnim efektem w podgrupie. Klasyczny obraz moderacji z ręcznie wybranym moderatorem pokazuje Moderacja – wizualizacja na obrazkach. Dane, las i ziarno 7130 są te same co w przykładzie; liczbę 200 pokazanych osób wybrano ręcznie dla czytelności.
Podpis do pracy:
Kod R rysunku 1
# Rysunek 1: CATE z lasu przyczynowego na tle prawdziwego efektu (dane i las z przykładu)
library(grf)
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(las = "#0072B2", prawda = "#D55E00", punkty = "grey55")
motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(0.95)),
        plot.background = element_rect(fill = "white", colour = NA))

set.seed(7130)                                       # te same dane i ten sam las co w przykładzie
n <- 2000; p <- 6
X <- matrix(rnorm(n * p), n, p, dimnames = list(NULL, paste0("x", 1:p)))
W <- rbinom(n, 1, plogis(0.5 * X[, 1]))
tau <- 1 + X[, 2]
Y <- 2 * X[, 1] + X[, 3] + tau * W + rnorm(n)
cf <- causal_forest(X, Y, W, num.trees = 2000, seed = 7130)

# Profil CATE: zmieniamy jedną cechę na siatce, pozostałe ustawiamy na 0 (średnia)
profil <- function(j, siatka = seq(-2.5, 2.5, by = 0.1)) {
  Xn <- matrix(0, length(siatka), p, dimnames = list(NULL, colnames(X)))
  Xn[, j] <- siatka
  pr <- predict(cf, Xn, estimate.variance = TRUE)
  se <- sqrt(pr$variance.estimates)
  data.frame(cecha = colnames(X)[j], x = siatka, cate = pr$predictions,
             lo = pr$predictions - 1.96 * se, hi = pr$predictions + 1.96 * se,
             prawda = 1 + (j == 2) * siatka)       # prawdziwy CATE: 1 + x2 (od x5 nie zależy)
}
pr2 <- profil(2); pr5 <- profil(5)
tab <- rbind(pr2, pr5)
tab$pokrywa <- tab$lo <= tab$prawda & tab$prawda <= tab$hi
print(data.frame(round(subset(tab, x %in% c(-2, -1, 0, 1, 2))[, c("x", "cate", "lo", "hi", "prawda")], 2),
                 cecha = subset(tab, x %in% c(-2, -1, 0, 1, 2))$cecha), row.names = FALSE)
round(tapply(tab$pokrywa, tab$cecha, mean), 2)     # odsetek punktów siatki, w których CI obejmuje prawdę

oob <- data.frame(x2 = X[, 2], x5 = X[, 5], tau_hat = predict(cf)$predictions)
round(mean(oob$tau_hat), 3)                         # kontrola: ten sam las co w przykładzie (1.114)
pokaz <- oob[sample(n, 200), ]                       # 200 losowych osób, żeby wykres był czytelny

rys <- function(pr, xvar, tytul, lab) {
  ggplot(pr, aes(x)) +
    geom_point(data = pokaz, aes(.data[[xvar]], tau_hat), colour = kol[["punkty"]], alpha = 0.35, size = 1.1) +
    geom_ribbon(aes(ymin = lo, ymax = hi), fill = kol[["las"]], alpha = 0.25) +
    geom_line(aes(y = cate, linetype = "las przyczynowy (95% CI)"), colour = kol[["las"]], linewidth = 1.1) +
    geom_line(aes(y = prawda, linetype = "prawdziwy CATE"), colour = kol[["prawda"]], linewidth = 1) +
    scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
    coord_cartesian(xlim = c(-2.5, 2.5), ylim = c(-2, 4)) +
    labs(title = tytul, x = lab, y = "Efekt interwencji τ(x)") + motyw +
    guides(linetype = guide_legend(override.aes = list(colour = unname(kol[c("las", "prawda")]))))
}
p1 <- rys(pr2, "x2", "A. Moderator x2: efekt rośnie", "x2 (pozostałe cechy = 0)") +
  rys(pr5, "x5", "B. Cecha x5: efekt stały", "x5 (pozostałe cechy = 0)") +
  plot_layout(guides = "collect") & theme(legend.position = "bottom")
p1   # zapis: ggsave("cate-profil-lasu.svg", p1, width = 10, height = 5.4)
Wynik w R
  x  cate    lo    hi prawda cecha
 -2 -0.99 -1.48 -0.50     -1    x2
 -1  0.17 -0.25  0.59      0    x2
  0  1.31  0.95  1.68      1    x2
  1  2.01  1.50  2.51      2    x2
  2  2.81  2.42  3.19      3    x2
 -2  1.33  1.07  1.60      1    x5
 -1  1.28  0.92  1.64      1    x5
  0  1.31  0.95  1.68      1    x5
  1  1.30  0.89  1.71      1    x5
  2  1.29  0.91  1.67      1    x5
  x2   x5
0.90 0.76
[1] 1.114
Rysunek na stronie powstał z tego kodu z motywem serwisu (dane, geometrie i skale identyczne).
Jak opisać w pracy
Na co uważać
- Zakłócenia nieobserwowane. Las nie zastąpi założenia, że zmierzono wszystkie zakłócacze.
- Prognozy dla jednej osoby. Pojedyncze τ(x) są niepewne. Opisuj grupy i oceniaj je poza próbą uczącą, bo grozi przeuczenie.
- Ważność zmiennej to nie mechanizm. Częsty udział w podziałach nie dowodzi, że zmienna zmienia efekt.
Przeciętny efekt przy wielu zakłócaczach szacuje podwójne uczenie maszynowe.
CATE i las przyczynowy w R
Kod symuluje dane obserwacyjne z efektem zależnym od x2, dopasowuje las przyczynowy, liczy ATE, test kalibracji, ważność zmiennych i liniową projekcję CATE. Liczby w tekście pochodzą z tego kodu.
Las przyczynowy: ATE, kalibracja i profil CATE
R
set.seed(7130)
library(grf)
n <- 2000; p <- 6                                    # dane symulowane: 2000 osób, 6 cech
X <- matrix(rnorm(n * p), n, p, dimnames = list(NULL, paste0("x", 1:p)))
e <- plogis(0.5 * X[, 1])                            # przydział zależy od x1 (zakłócenie obserwowalne)
W <- rbinom(n, 1, e)
tau <- 1 + X[, 2]                                    # prawdziwy CATE rośnie z x2
Y <- 2 * X[, 1] + X[, 3] + tau * W + rnorm(n)
round(c(naiwna_roznica = mean(Y[W == 1]) - mean(Y[W == 0]), prawdziwy_ATE = mean(tau)), 3)
cf <- causal_forest(X, Y, W, num.trees = 2000, seed = 7130)
ate <- average_treatment_effect(cf, target.sample = "all")      # ATE (estymator AIPW)
round(c(ate, ci = ate[1] + c(-1, 1) * qnorm(.975) * ate[2]), 3)
test_calibration(cf)                                 # differential.forest.prediction > 0: realna heterogeniczność
round(head(sort(variable_importance(cf)[, 1] |> setNames(colnames(X)), decreasing = TRUE), 3), 3)
best_linear_projection(cf, X[, 1:3])                 # liniowe podsumowanie CATE względem x1–x3
tau_hat <- predict(cf)$predictions                   # CATE poza workiem (out-of-bag)
round(c(kor_z_prawdziwym = cor(tau_hat, tau), mean_tau_hat = mean(tau_hat)), 3)
round(tapply(tau_hat, cut(X[, 2], c(-Inf, -1, 0, 1, Inf)), mean), 2)   # CATE w przedziałach x2
Wynik w R
naiwna_roznica  prawdziwy_ATE
         1.985          1.018
estimate  std.err      ci1      ci2
   1.107    0.056    0.996    1.218

Best linear fit using forest predictions (on held-out data)
as well as the mean forest prediction as regressors, along
with one-sided heteroskedasticity-robust (HC3) SEs:

                               Estimate Std. Error t value    Pr(>t)
mean.forest.prediction         0.992431   0.045594  21.767 < 2.2e-16 ***
differential.forest.prediction 1.096041   0.054704  20.036 < 2.2e-16 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

   x2    x3    x1
0.753 0.058 0.050

Best linear projection of the conditional average treatment effect.
Confidence intervals are cluster- and heteroskedasticity-robust (HC3):

            Estimate Std. Error t value Pr(>|t|)
(Intercept) 1.087339   0.050968 21.3337   <2e-16 ***
x1          0.026660   0.059456  0.4484   0.6539
x2          1.092099   0.054019 20.2168   <2e-16 ***
x3          0.038585   0.053790  0.7173   0.4733
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

kor_z_prawdziwym     mean_tau_hat
           0.982            1.114
(-Inf,-1]    (-1,0]     (0,1]  (1, Inf]
    -0.46      0.65      1.65      2.50
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet grf); rysunek wykonano w pakiecie ggplot2, panele połączono pakietem patchwork, a plik zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- grf (wersja 2.6.1): Tibshirani, J., Athey, S., Sverdrup, E., & Wager, S. (2026). grf: Generalized random forests (R package version 2.6.1) [Computer software]. https://doi.org/10.32614/CRAN.package.grf
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym CATE różni się od moderacji?
Moderacja w regresji testuje z góry wybrany moderator i założony kształt interakcji. CATE to przyczynowy efekt warunkowy na cechach, a las przyczynowy sam szuka, od których cech i w jaki sposób efekt zależy.
Jak sprawdzić, czy efekt naprawdę jest heterogeniczny?
W grf służy do tego test_calibration(): istotny współczynnik differential.forest.prediction bliski 1 wskazuje, że prognozy CATE różnicują efekt. W przykładzie wyniósł 1.10, p < .001.
Czy las przyczynowy działa na danych obserwacyjnych?
Tak, jeśli zmierzono wszystkie ważne zakłócacze i grupy mają wspólne wsparcie. grf szacuje wtedy prawdopodobieństwo przydziału i oczekiwany wynik, a ATE liczy estymatorem AIPW.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Analiza podgrup – kiedy jej wierzyć
Ile fałszywych interakcji daje sprawdzanie wielu cech, skala addytywna a multiplikatywna, kryteria ICEMAN i opis podgrup w artykule.
Czytaj →PoradnikDrzewa decyzyjne i lasy losowe
CART i przycinanie w rpart, las losowy w ranger, ważność permutacyjna, zależność cząstkowa, walidacja na nowych danych i wzór opisu.
Czytaj →PoradnikModelowanie uplift: komu wysłać kupon
Przekonywalni, pewniacy i „nie przeszkadzać”: T-learner, las przyczynowy, krzywa Qini i zysk kampanii na przykładzie sklepu z grami, z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Athey, S., Tibshirani, J., & Wager, S. (2019). Generalized random forests. The Annals of Statistics, 47(2), 1148–1178. https://doi.org/10.1214/18-aos1709 ● Otwarty dostęp
- Wager, S., & Athey, S. (2018). Estimation and inference of heterogeneous treatment effects using random forests. Journal of the American Statistical Association, 113(523), 1228–1242. https://doi.org/10.1080/01621459.2017.1319839 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{athey2019generalized, author={Athey, Susan and Tibshirani, Julie and Wager, Stefan}, title={{Generalized random forests}}, journal={The Annals of Statistics}, year={2019}, volume={47}, number={2}, pages={1148--1178}, doi={10.1214/18-aos1709}}@article{wager2018estimation, author={Wager, Stefan and Athey, Susan}, title={{Estimation and inference of heterogeneous treatment effects using random forests}}, journal={Journal of the American Statistical Association}, year={2018}, volume={113}, number={523}, pages={1228--1242}, doi={10.1080/01621459.2017.1319839}}