Przykład: sklep z grami planszowymi i kupon na 15 zł
Fikcyjny sklep internetowy z grami planszowymi ma 20 000 klientów w bazie mailowej. Dział marketingu chce wysłać kupon „15 zł rabatu na zamówienie w ciągu 14 dni” i pyta: komu wysłać kupon, żeby sprzedaż wzrosła bardziej, niż kosztuje rabat? Zwykle wybiera się klientów, którzy „najchętniej kupią”. Pokażemy, dlaczego to błąd i jak oszacować, u kogo kupon zmienia decyzję – to modelowanie uplift (ang. uplift modeling). Przewidywanie samego zdarzenia, np. odejścia klienta, opisuje wpis model przewidywania odejść klientów, a inne projekty z marketingu – statystyka w pracy z marketingu.
Punktem wyjścia jest eksperyment. Sklep wysłał kupon losowo połowie bazy (9980 osób), a druga połowa (10 020) nic nie dostała – to zwykły test A/B, w którym o grupie decyduje randomizacja. Wynik to zakup w ciągu 14 dni (tak/nie). Cechy klienta: dni od ostatniego zamówienia, liczba zamówień w roku, udział zamówień z rabatem, odsetek otwieranych newsletterów i korzystanie z aplikacji.
Dane są fikcyjne, więc znamy prawdę. Dla każdego klienta ustaliliśmy ręcznie dwa prawdopodobieństwa zakupu: bez kuponu i z kuponem. Kupon działa najsilniej na klientów, którzy lubią rabaty, czytają maile i kupili ostatnio 25–160 dni temu. Stałym klientom kupującym bez rabatów (co najmniej 2 zamówienia w roku) mail z kuponem obniża prawdopodobieństwo zakupu nawet o 12 pp. Ten ujemny efekt wzmocniliśmy (z −10 do −12 pp i od 2 zamiast od 3 zamówień) po pierwszym uruchomieniu, bo grupa „nie przeszkadzać” liczyła tylko 0.6% klientów. Ziarno 609 ustalono raz i nie zmieniano go. Dane pobierzesz jako uplift-kupon-klienci.csv (kolumny prawdziwy_uplift i typ są „z symulacji” – w prawdziwych danych ich nie ma).
Rysunek 1: cztery typy klientów
Każdy klient ma dwa potencjalne wyniki: co zrobiłby z kuponem i co bez niego. Widzimy zawsze tylko jeden – to podstawowa idea modelu potencjalnych wyników. Dwa wyniki tak/nie dają cztery typy klientów.
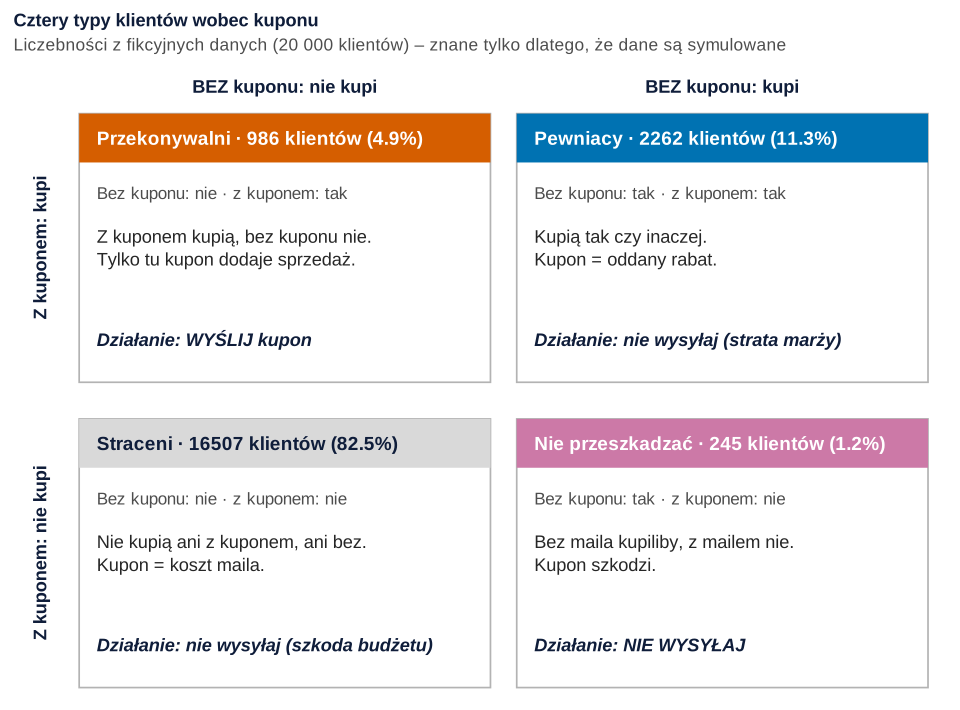
set.seed(609)).Co widać. Kupon dodaje sprzedaż tylko u przekonywalnych: 986 osób, 4.9% bazy. Pewniaków (2262, 11.3%) jest ponad dwa razy więcej – kupią i tak, a kupon zabiera im 15 zł z marży sklepu. Ogromna większość to straceni (82.5%). Najmniejsza, ale kosztowna grupa to „nie przeszkadzać” (245 osób, 1.2%): bez maila kupiliby, z mailem nie.
Jak może zmylić. Typu pojedynczego klienta nie da się zaobserwować – tego, co zrobiłby w drugiej grupie, nigdy nie zobaczymy. Liczebności na rysunku znamy tylko dlatego, że dane są symulowane. W prawdziwych danych szacujemy coś łatwiejszego: uplift, czyli różnicę prawdopodobieństw zakupu z kuponem i bez kuponu u klientów o danych cechach x:
W języku wnioskowania przyczynowego to CATE – warunkowy przeciętny efekt. Uplift równy +0.20 znaczy: na 100 takich klientów kupon daje 20 dodatkowych zakupów. Średni prawdziwy uplift w bazie wynosi 3.6 pp, u 34.6% klientów przekracza 5 pp, a u 15.7% jest niższy niż −2 pp.
Podpis do pracy:
Rysunek 2: wynik eksperymentu – średnio i w podgrupach
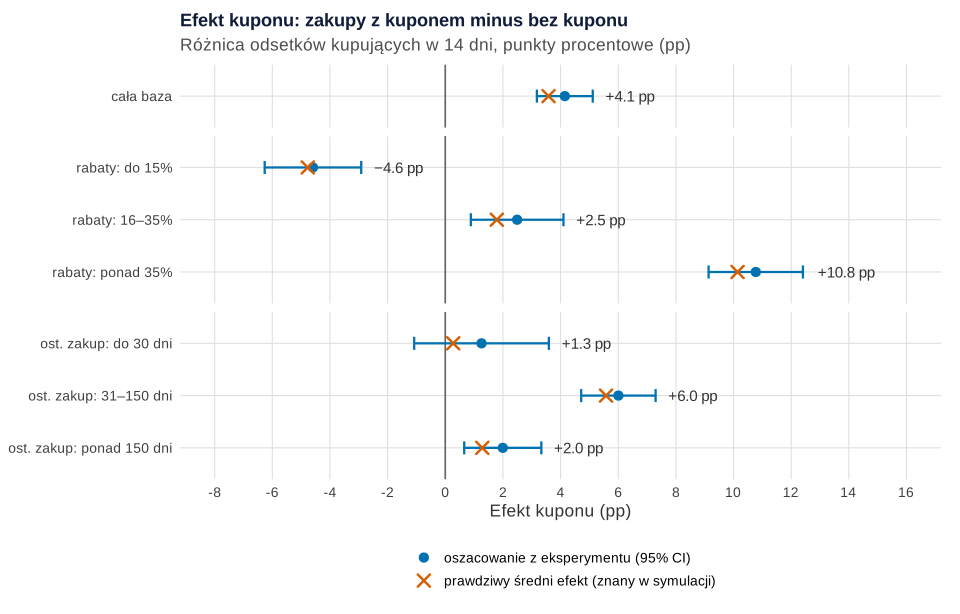
Co widać. W całej bazie kupiło 16.4% osób z kuponem i 12.26% bez kuponu. Efekt kuponu to +4.15 pp, 95% CI [3.18, 5.12], χ²(1) = 70.1, p < .001 (to test dla dwóch proporcji w wersji chi-kwadrat). U klientów, których ponad 35% zamówień było z rabatem, efekt wynosi +10.8 pp. U klientów kupujących prawie bez rabatów (do 15% zamówień) jest ujemny: −4.6 pp, 95% CI [−6.26, −2.92]. U kupujących w ostatnich 30 dniach przedział obejmuje zero (+1.3 pp). Prawdziwe efekty (krzyżyki) leżą w każdym przedziale.
Jak może zmylić. Podgrupy wybraliśmy z góry, po dwie cechy i trzy przedziały. Gdy przegląda się dziesiątki podziałów i opisuje tylko te „istotne”, pojawia się problem wielokrotnych porównań. Efekt zależny od kilku cech naraz wykryją dopiero modele uplift.
Podpis do pracy:
Zdanie do Wyników:
Trzy sposoby wyboru klientów
Klientów losowo dzielimy na połowę uczącą i testową (po 10 000). Modele budujemy na uczącej, oceniamy na testowej – jak przy walidacji krzyżowej.
- Model samej odpowiedzi. Regresja logistyczna przewiduje zakup wśród klientów, którzy dostali kupon.
- T-learner (dwa modele). Dwie regresje logistyczne o tej samej postaci: jedna na klientach z kuponem, druga na klientach bez kuponu. Uplift to różnica ich prognoz. Gdy model służy do wyboru działania, trzeba modelować zmianę prawdopodobieństwa wywołaną działaniem, a nie samo prawdopodobieństwo (Rzepakowski i Jaroszewicz, 2012). Künzel i in. (2019) opisują T-learner jako jeden z metaalgorytmów, które dowolną metodę regresji zamieniają w estymator CATE. W symulacjach żaden z nich nie był najlepszy we wszystkich warunkach.
- Las przyczynowy. Las z pakietu
grfszuka podziałów, które najbardziej różnicują efekt, a nie sam zakup (Wager i Athey, 2018; Athey i in., 2019). Działa jak las losowy, ale w liściach liczy różnicę „kupon minus brak kuponu”. Podajemy mu prawdopodobieństwo kuponu 0.5, bo kupon losowano.
Las szacuje średni efekt w zbiorze uczącym na 4.64 pp (SE = 0.68), zgodnie z eksperymentem.
Rysunek 3: czy modele odgadują uplift?
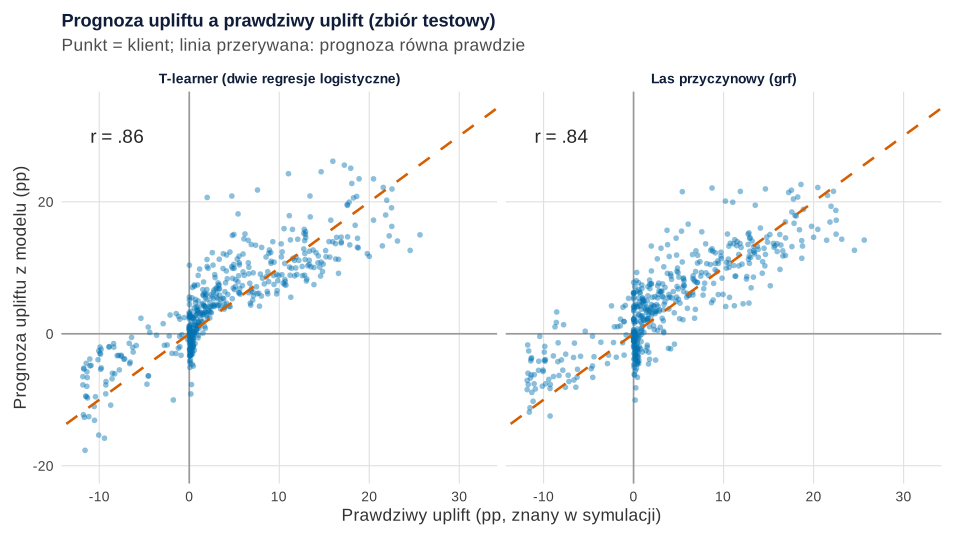
set.seed(609)).Co widać. Prognozy obu modeli uplift rosną razem z prawdziwym upliftem. Korelacja z prawdą w całym zbiorze testowym wynosi r = .86 dla T-learnera i r = .84 dla lasu. Wynik modelu samej odpowiedzi koreluje z prawdziwym upliftem słabiej (r = .54), a mocno z tym, czy klient kupiłby bez kuponu (r = .74).
Jak może zmylić. Pionowa „kolumna” punktów przy zerze to klienci bez efektu, którym modele przypisują efekty różne od zera. Modele dobrze porządkują grupy klientów, ale pojedyncze prognozy są niepewne. W prawdziwych danych takiego wykresu nie narysujesz – stąd krzywa Qini.
Podpis do pracy:
Rysunek 4: krzywa Qini na zbiorze testowym
Krzywą Qini liczy się bez znajomości prawdy. Sortujemy klientów testowych od najwyższego wyniku modelu. Dla górnych k% liczymy z eksperymentu różnicę odsetków zakupu z kuponem i bez kuponu i mnożymy ją przez liczbę klientów w tej grupie. Wychodzi liczba dodatkowych zakupów, gdyby kupon dostało tych k% klientów. To kuzyn wykresu gain: tam liczymy zdarzenia, tu – zdarzenia dodatkowe, wywołane działaniem.
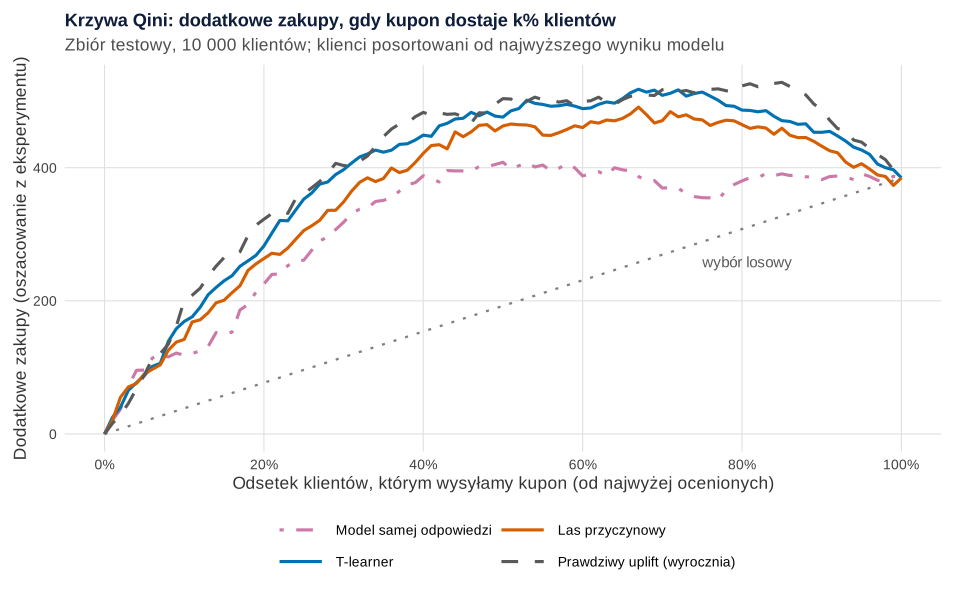
Co widać. Kupon dla wszystkich daje 385 dodatkowych zakupów. Gdy kupon dostaje 20% klientów, T-learner daje 283 dodatkowe zakupy, las 264, a model samej odpowiedzi 226. Krzywe uplift rosną do ok. 500 przy 70% klientów, a potem spadają – w ogonie są klienci „nie przeszkadzać”. Wysokość krzywej nad przekątną, uśredniona po wszystkich k i odniesiona do wyroczni (sortowania po prawdziwym uplifcie), wynosi 93.2% dla T-learnera, 80.7% dla lasu i 57.9% dla modelu odpowiedzi.
Jak może zmylić. Krzywa jest „poszarpana”, bo w każdej grupie porównujemy dwie losowe połowy. Devriendt i in. (2018) w przeglądzie metod uplift stwierdzili, że wyniki modeli silnie różnią się między zbiorami danych i między podpróbami, a miary Qini nie mówią wprost o praktycznej użyteczności. Przewaga T-learnera nad lasem dotyczy tylko tego przykładu: ukryte zależności są gładkie i pasują do regresji ze splajnami.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: ile zarobi kampania?
Przyjęliśmy (ręcznie): zamówienie daje 40 zł marży, każdy zakup z kuponem kosztuje 15 zł rabatu, a mail 0.10 zł. Zysk z wysłania kuponu grupie klientów to 40 zł × dodatkowe zakupy − 15 zł × wszystkie zakupy z kuponem − koszt maili.
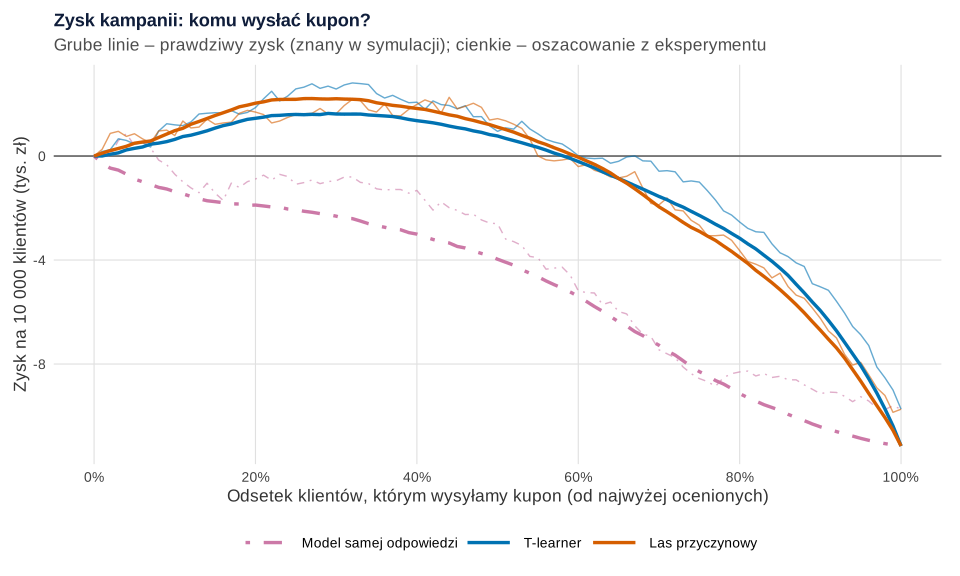
Co widać. Kupon dla wszystkich 10 000 klientów testowych to strata 11 153 zł (prawdziwa; oszacowanie z eksperymentu: −9736 zł). Model samej odpowiedzi traci od pierwszych procentów: przy 20% klientów −1885 zł. Jego najlepszy wybór to nie wysyłać nikomu. Modele uplift zarabiają: najwięcej las przyczynowy (2211 zł przy 27% klientów) i T-learner (1639 zł przy 29%). Wyrocznia znająca prawdziwy uplift zarobiłaby 4008 zł.
Jak może zmylić. Przy 20% klientów kolejność modeli uplift jest odwrotna niż na krzywej Qini (las 2033 zł, T-learner 1451 zł), bo zysk zależy też od tego, ilu pewniaków trafi do wybranej grupy. Najlepszy próg odczytany z tego samego zbioru testowego jest zbyt optymistyczny – ustal go na osobnych danych albo w kolejnym teście.
Podpis do pracy:
Rysunek 6: kogo wybiera model?
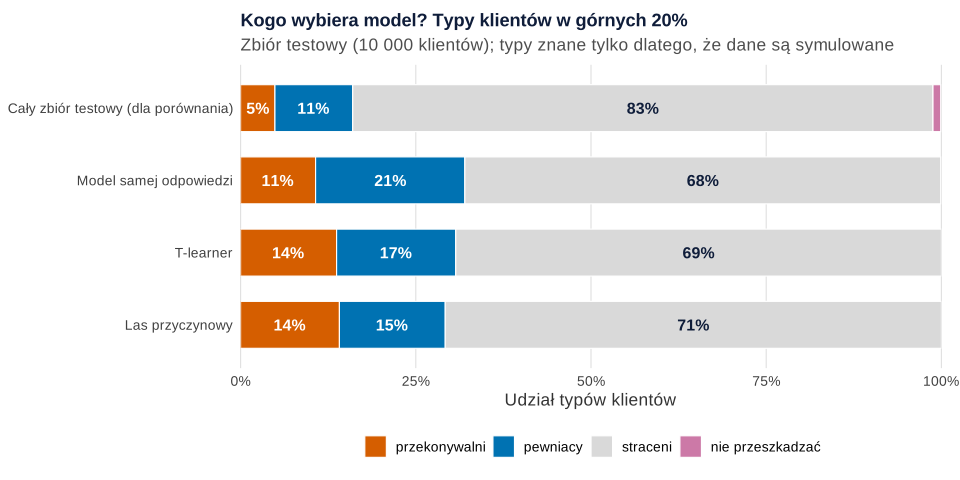
Co widać. W całym zbiorze testowym przekonywalni to 4.9%. Wśród 20% klientów wybranych przez modele uplift jest ich 13.7% (T-learner) i 14.1% (las), a przez model odpowiedzi – 10.7%. Model odpowiedzi bierze za to najwięcej pewniaków: 21.3% wobec 15.1% u lasu. Jego wybrani kupiliby bez kuponu średnio w 22.6%, wybrani przez las – w 15.7%. Grupy „nie przeszkadzać” nie wybrał żaden model.
Jak może zmylić. Nawet najlepszy wybór to w ok. 70% straceni, a o zysku decydują też koszty każdej grupy. Ten sam mechanizm opisała Ascarza (2018) przy kampaniach retencyjnych: klienci o najwyższym ryzyku odejścia nie musieli być najlepszymi adresatami, a wybór według wrażliwości na działanie okazał się skuteczniejszy. Dlatego w modelu przewidywania odejść prognoza ryzyka to dopiero pierwszy krok.
Podpis do pracy:
Co z tym zrobić w marketingu
- Zawsze zostaw grupę kontrolną (np. 10% bazy losowo bez kuponu) – bez niej uplift jest niemierzalny.
- Kupon dla łowców rabatów, którzy „stygną” (rabaty w ponad 35% zamówień, 31–150 dni od zakupu, otwierają maile) – tu efekt jest największy.
- Nie wysyłaj kuponu stałym klientom kupującym bez rabatów. Lepszy będzie mail z zapowiedzią nowości albo żaden (zob. segmentacja klientów).
- Licz zysk, nie zakupy – krzywą zysku dla własnej marży i wartości kuponu.
- Sprawdź model w kolejnej kampanii: połowa bazy wybrana przez model, połowa losowo, w obu grupach część bez kuponu. Kontrolowany eksperyment to najlepszy sposób ustalenia, czy zmiana wpływa na zachowanie klientów (Kohavi i in., 2009). Typowe błędy takich testów opisuje wpis pułapki testów A/B na obrazkach.
Jak opisać w pracy
W Metodzie opisz eksperyment, podział na zbiory, modele i miarę oceny; w Wynikach – średni efekt z przedziałem ufności, krzywą Qini i zysk. Gdy kupon nie był losowany, modele uplift nie wystarczą – potrzebne są metody dla danych obserwacyjnych, np. propensity score.
W tabeli podaj dla każdego modelu dodatkowe zakupy przy kilku progach, współczynnik Qini i zysk. W Ograniczeniach napisz, że wynik dotyczy jednej kampanii.
Kod R: eksperyment, modele uplift, krzywa Qini i zysk
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, z których korzystają kolejne. Modele to glm() z naturalnymi splajnami ns() (pakiet splines dołączony do R) i causal_forest() z pakietu grf; krzywą Qini i zysk liczy kilka wierszy bazowego R. Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (dane) i 3 (podział na zbiory, las przyczynowy, wybór punktów do rysunku); każde losowanie zaczyna się od własnego set.seed(609), a las ma też argument seed = 609. Ziarno 609 ustalono raz i nie zmieniano go. Ręcznie ustalono: 20 000 klientów i rozkłady ich cech (dni od zakupu: 1 + gamma(1.3; 70), najwyżej 365; zamówienia: Poisson ze średnią exp(1.1 − dni/150); udział rabatów: beta(1.3; 2.6); otwieranie maili: beta(1.6; 3); aplikacja: 35%), współczynniki prawdopodobieństwa zakupu bez kuponu, funkcję efektu kuponu (do 0.22 × (0.5 + otwieranie maili) dla lubiących rabaty w oknie 25–160 dni, −0.12 dla stałych klientów bez rabatów – ujemny efekt wzmocniony z −0.10 po pierwszym uruchomieniu), kupon dla połowy klientów, podział 50/50, liczby stopni swobody splajnów, 2000 drzew, kwoty 40 zł, 15 zł i 0.10 zł oraz 500 punktów na rysunku 3 (ze względu na rozmiar pliku). Całość liczy się w ok. 10 sekund.
1. Paleta, dane i cztery typy klientów: Rysunek 1
R
# Rysunek 1. Fikcyjny sklep z grami planszowymi: kupon e-mail wysłany losowo połowie klientów (dane symulowane)
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         fiolet = "#CC79A7", szary = "grey60", ciemny = "grey20")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

set.seed(609)                                   # ziarno ustalone raz, bez dobierania pod wynik
N <- 20000
klienci <- data.frame(
  id = seq_len(N),
  dni_od_zakupu = pmin(365, round(rgamma(N, shape = 1.3, scale = 70)) + 1),   # dni od ostatniego zamówienia
  aplikacja = rbinom(N, 1, 0.35),                                            # 1 = korzysta z aplikacji sklepu
  udzial_rabatow = round(rbeta(N, 1.3, 2.6), 2),                             # część zamówień z rabatem
  otwieranie_maili = round(rbeta(N, 1.6, 3), 2))                             # część otwieranych newsletterów
klienci$zamowienia <- rpois(N, exp(1.1 - klienci$dni_od_zakupu / 150))      # zamówienia w ostatnim roku

# Prawdziwe prawdopodobieństwo zakupu w 14 dni bez kuponu (p_bez), z kuponem (p_z) i efekt kuponu (tau) – ustalone ręcznie
p_bez <- with(klienci, plogis(-2.6 + 0.32 * pmin(zamowienia, 6) - 0.006 * dni_od_zakupu + 0.35 * aplikacja +
                           0.8 * otwieranie_maili))
tau <- with(klienci,
  0.22 * plogis((udzial_rabatow - 0.35) / 0.06) *                         # kupon działa na lubiących rabaty…
    plogis((dni_od_zakupu - 25) / 8) * plogis((160 - dni_od_zakupu) / 25) *  # …którzy „stygną” (25–160 dni)…
    (0.5 + otwieranie_maili) -                                             # …i czytają maile
  0.12 * plogis((0.15 - udzial_rabatow) / 0.03) * (zamowienia >= 2))      # stali klienci bez rabatów: mail szkodzi
p_z <- pmin(pmax(p_bez + tau, 0.002), 0.98)                                    # prawdopodobieństwo zakupu z kuponem
klienci$prawdziwy_uplift <- round(p_z - p_bez, 4)

# Potencjalne wyniki: ta sama osoba bez kuponu (Y0) i z kuponem (Y1); jedna liczba losowa u na osobę
u <- runif(N)
Y0 <- as.integer(u < p_bez); Y1 <- as.integer(u < p_z)
klienci$typ <- factor(ifelse(Y0 == 1 & Y1 == 1, "pewniacy", ifelse(Y0 == 0 & Y1 == 1, "przekonywalni",
                      ifelse(Y0 == 1 & Y1 == 0, "nie przeszkadzać", "straceni"))),
                      levels = c("przekonywalni", "pewniacy", "straceni", "nie przeszkadzać"))
klienci$kupon <- rbinom(N, 1, 0.5)                                         # losowanie: kupon dla połowy
klienci$zakup <- ifelse(klienci$kupon == 1, Y1, Y0)                        # widzimy tylko jeden z dwóch wyników
klienci$p_bez <- p_bez; klienci$p_z <- p_z

write.csv(klienci[, c("id", "dni_od_zakupu", "zamowienia", "udzial_rabatow", "otwieranie_maili", "aplikacja",
                      "kupon", "zakup", "prawdziwy_uplift", "typ")],
          "uplift-kupon-klienci.csv", row.names = FALSE)
c(klienci = N, z_kuponem = sum(klienci$kupon), bez_kuponu = sum(1 - klienci$kupon))
round(c(sredni_prawdziwy_uplift_pp = 100 * mean(p_z - p_bez), uplift_dodatni_pow_5pp = 100 * mean(p_z - p_bez > 0.05),
        uplift_ujemny_pon_minus2pp = 100 * mean(p_z - p_bez < -0.02)), 1)
typy <- as.data.frame(table(typ = klienci$typ))
typy$procent <- round(100 * typy$Freq / N, 1)
typy

# Rysunek 1: karty czterech typów klientów (grafika z prostokątów i tekstu, bez danych na osiach)
karty <- data.frame(typ = levels(klienci$typ),
                    x = c(0, 1, 0, 1), y = c(1, 1, 0, 0),            # kolumna: zakup BEZ kuponu nie/tak; wiersz: Z kuponem tak/nie
                    bez = c("nie", "tak", "nie", "tak"), z = c("tak", "tak", "nie", "nie"))
karty$n <- typy$Freq; karty$proc <- typy$procent
karty$naglowek <- sprintf("%s · %d klientów (%.1f%%)", c("Przekonywalni", "Pewniacy", "Straceni", "Nie przeszkadzać"),
                          karty$n, karty$proc)
karty$opis <- c("Z kuponem kupią, bez kuponu nie.\nTylko tu kupon dodaje sprzedaż.",
                "Kupią tak czy inaczej.\nKupon = oddany rabat.",
                "Nie kupią ani z kuponem, ani bez.\nKupon = koszt maila.",
                "Bez maila kupiliby, z mailem nie.\nKupon szkodzi.")
karty$dzialanie <- paste0("Działanie: ", c("WYŚLIJ kupon", "nie wysyłaj (strata marży)",
                                            "nie wysyłaj (szkoda budżetu)", "NIE WYSYŁAJ"))
karty$kolor <- c(kol[["cynober"]], kol[["niebieski"]], "#D9D9D9", kol[["fiolet"]])
karty$kolor_tekstu <- c("white", "white", "#0f1d3a", "white")   # ciemny tekst na jasnoszarym nagłówku
s <- 0.47
p1 <- ggplot(karty) +
  geom_rect(aes(xmin = x - s, xmax = x + s, ymin = y - 0.44, ymax = y + 0.44), fill = "white",
            colour = "grey70", linewidth = 0.6) +
  geom_rect(aes(xmin = x - s, xmax = x + s, ymin = y + 0.28, ymax = y + 0.44, fill = kolor), colour = NA) +
  geom_text(aes(x = x - s + 0.04, y = y + 0.36, label = naglowek, colour = kolor_tekstu), hjust = 0, fontface = "bold",
            size = 5) +
  geom_text(aes(x = x - s + 0.04, y = y + 0.2, label = sprintf("Bez kuponu: %s · z kuponem: %s", bez, z)),
            hjust = 0, vjust = 1, size = 4.5, colour = "grey30") +
  geom_text(aes(x = x - s + 0.04, y = y + 0.06, label = opis), hjust = 0, vjust = 1, size = 4.8,
            lineheight = 1.05, colour = "grey15") +
  geom_text(aes(x = x - s + 0.04, y = y - 0.3, label = dzialanie), hjust = 0, size = 4.8,
            fontface = "bold.italic", colour = "#0f1d3a") +
  annotate("text", x = c(0, 1), y = 1.53, label = c("BEZ kuponu: nie kupi", "BEZ kuponu: kupi"),
           fontface = "bold", size = 4.8, colour = "#0f1d3a") +
  annotate("text", x = -0.56, y = c(1, 0), label = c("Z kuponem: kupi", "Z kuponem: nie kupi"), angle = 90,
           fontface = "bold", size = 4.8, colour = "#0f1d3a") +
  scale_fill_identity() + scale_colour_identity() +
  coord_cartesian(xlim = c(-0.62, 1.5), ylim = c(-0.47, 1.6), expand = FALSE) +
  labs(title = "Cztery typy klientów wobec kuponu",
       subtitle = "Liczebności z fikcyjnych danych (20 000 klientów) – znane tylko dlatego, że dane są symulowane") +
  motyw + theme(axis.text = element_blank(), axis.title = element_blank(), panel.grid.major = element_blank())
p1   # zapis: ggsave("uplift-cztery-typy-klientow.svg", p1, width = 10, height = 7.4)
Wynik w R
   klienci  z_kuponem bez_kuponu
     20000       9980      10020
sredni_prawdziwy_uplift_pp     uplift_dodatni_pow_5pp
                       3.6                       34.6
uplift_ujemny_pon_minus2pp
                      15.7
               typ  Freq procent
1    przekonywalni   986     4.9
2         pewniacy  2262    11.3
3         straceni 16507    82.5
4 nie przeszkadzać   245     1.2
2. Wynik eksperymentu w całej bazie i w podgrupach: Rysunek 2
R
# Rysunek 2. Wynik eksperymentu: efekt kuponu w całej bazie i w prostych podgrupach (korzysta z klienci z przepisu 1)
library(ggplot2)

# Różnica odsetków zakupu (kupon − brak) z 95% przedziałem ufności (przybliżenie normalne)
roznica <- function(d) {
  t1 <- d$zakup[d$kupon == 1]; t0 <- d$zakup[d$kupon == 0]
  r <- mean(t1) - mean(t0)
  se <- sqrt(mean(t1) * (1 - mean(t1)) / length(t1) + mean(t0) * (1 - mean(t0)) / length(t0))
  data.frame(n = nrow(d), z_kuponem = 100 * mean(t1), bez_kuponu = 100 * mean(t0), efekt = 100 * r,
             dolna = 100 * (r - 1.96 * se), gorna = 100 * (r + 1.96 * se), prawdziwy = 100 * mean(d$prawdziwy_uplift))
}
calosc <- roznica(klienci)
round(calosc, 2)
test <- chisq.test(table(klienci$kupon, klienci$zakup), correct = FALSE)
c(chi2 = round(unname(test$statistic), 1), df = unname(test$parameter), p_ponizej_001 = test$p.value < .001)

# Te same liczby w podgrupach zdefiniowanych z góry (dwie cechy po trzy przedziały)
klienci$grupa_rabaty <- cut(klienci$udzial_rabatow, c(-Inf, 0.15, 0.35, Inf),
                            labels = c("rabaty: do 15%", "rabaty: 16–35%", "rabaty: ponad 35%"))
klienci$grupa_dni <- cut(klienci$dni_od_zakupu, c(-Inf, 30, 150, Inf),
                         labels = c("ost. zakup: do 30 dni", "ost. zakup: 31–150 dni", "ost. zakup: ponad 150 dni"))
pod <- rbind(cbind(cecha = "Udział zamówień z rabatem", grupa = levels(klienci$grupa_rabaty),
                   do.call(rbind, lapply(split(klienci, klienci$grupa_rabaty), roznica))),
             cbind(cecha = "Dni od ostatniego zakupu", grupa = levels(klienci$grupa_dni),
                   do.call(rbind, lapply(split(klienci, klienci$grupa_dni), roznica))),
             cbind(cecha = "Wszyscy", grupa = "cała baza", calosc))
pod$grupa <- factor(pod$grupa, rev(pod$grupa))
pod$cecha <- factor(pod$cecha, c("Wszyscy", "Udział zamówień z rabatem", "Dni od ostatniego zakupu"))
print(cbind(pod[, c("grupa", "n")], round(pod[, c("z_kuponem", "bez_kuponu", "efekt", "dolna", "gorna", "prawdziwy")], 2)),
      row.names = FALSE)

p2 <- ggplot(pod, aes(y = grupa)) +
  geom_vline(xintercept = 0, colour = "grey40") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.25, orientation = "y", colour = kol[["niebieski"]],
                linewidth = 0.8) +
  geom_point(aes(x = efekt, shape = "oszacowanie z eksperymentu (95% CI)"), colour = kol[["niebieski"]], size = 3.2) +
  geom_point(aes(x = prawdziwy, shape = "prawdziwy średni efekt (znany w symulacji)"), colour = kol[["cynober"]],
             size = 3.4, stroke = 1.3) +
  geom_text(aes(x = gorna, label = sub("-", "−", sprintf("%+.1f pp", efekt))), hjust = -0.25, size = 4, colour = "grey20") +
  scale_shape_manual(values = c(16, 4), name = NULL) +
  facet_grid(cecha ~ ., scales = "free_y", space = "free_y") +
  scale_x_continuous(limits = c(-8, 16), breaks = seq(-8, 16, 2)) +
  labs(title = "Efekt kuponu: zakupy z kuponem minus bez kuponu",
       subtitle = "Różnica odsetków kupujących w 14 dni, punkty procentowe (pp)", x = "Efekt kuponu (pp)", y = NULL) +
  motyw + theme(strip.text.y = element_blank(), legend.direction = "vertical")   # panele tylko oddzielają cechy
p2   # zapis: ggsave("uplift-efekt-w-podgrupach.svg", p2, width = 10, height = 6.4)
Wynik w R
      n z_kuponem bez_kuponu efekt dolna gorna prawdziwy
1 20000      16.4      12.26  4.15  3.18  5.12      3.58
         chi2            df p_ponizej_001
         70.1           1.0           1.0
                     grupa     n z_kuponem bez_kuponu efekt dolna gorna
            rabaty: do 15%  4999      7.95      12.54 -4.59 -6.26 -2.92
            rabaty: 16–35%  6776     14.37      11.88  2.49  0.89  4.10
         rabaty: ponad 35%  8225     23.16      12.38 10.77  9.13 12.41
     ost. zakup: do 30 dni  4530     20.77      19.51  1.26 -1.08  3.59
    ost. zakup: 31–150 dni 11775     18.16      12.16  6.01  4.72  7.30
 ost. zakup: ponad 150 dni  3695      5.52       3.52  2.00  0.66  3.33
                 cała baza 20000     16.40      12.26  4.15  3.18  5.12
 prawdziwy
     -4.77
      1.79
     10.14
      0.28
      5.58
      1.28
      3.58
3. Model odpowiedzi, T-learner i las przyczynowy: Rysunek 3
R
# Rysunek 3. Trzy modele na zbiorze uczącym, ocena na testowym (korzysta z klienci, kol, motyw z przepisu 1)
library(ggplot2)
library(splines)   # naturalne splajny ns() – pakiet dołączony do R
library(grf)       # las przyczynowy

set.seed(609)                                    # losowy podział: połowa klientów do uczenia, połowa do testu
ucz <- sort(sample(nrow(klienci), nrow(klienci) / 2))
U <- klienci[ucz, ]; Te <- klienci[-ucz, ]
wzor <- zakup ~ ns(dni_od_zakupu, 4) + ns(pmin(zamowienia, 6), 3) + ns(udzial_rabatow, 4) +
                ns(otwieranie_maili, 3) + aplikacja

# (a) Model samej odpowiedzi: kto kupuje PO kuponie (tylko klienci z kuponem)
m_odp <- glm(wzor, family = binomial, data = U[U$kupon == 1, ])
# (b) T-learner: dwa osobne modele – z kuponem i bez kuponu; uplift = różnica prognoz
m_z   <- glm(wzor, family = binomial, data = U[U$kupon == 1, ])
m_bez <- glm(wzor, family = binomial, data = U[U$kupon == 0, ])
# (c) Las przyczynowy: szuka różnic w efekcie, a nie w samym zakupie; W.hat = 0.5, bo kupon losowano
cechy <- c("dni_od_zakupu", "zamowienia", "udzial_rabatow", "otwieranie_maili", "aplikacja")
las <- causal_forest(as.matrix(U[, cechy]), U$zakup, U$kupon, W.hat = 0.5, num.trees = 2000, seed = 609)

Te$wynik_odpowiedz <- predict(m_odp, Te, type = "response")
Te$uplift_t <- predict(m_z, Te, type = "response") - predict(m_bez, Te, type = "response")
Te$uplift_las <- predict(las, as.matrix(Te[, cechy]))$predictions
c(uczacy = nrow(U), testowy = nrow(Te))
round(average_treatment_effect(las) * 100, 2)          # ATE z lasu (zbiór uczący), pp
zgodnosc <- sapply(Te[, c("wynik_odpowiedz", "uplift_t", "uplift_las")], function(s)
  c(r_z_prawdziwym_upliftem = cor(s, Te$prawdziwy_uplift),
    r_z_prawdopodobienstwem_bez_kuponu = cor(s, Te$p_bez)))
round(zgodnosc, 3)

# Rysunek 3: prognoza upliftu a prawdziwy uplift (500 losowych klientów testowych, żeby plik był lekki)
set.seed(609)
pokaz <- Te[sample(nrow(Te), 500), ]
d3 <- rbind(data.frame(model = "T-learner (dwie regresje logistyczne)", prawdziwy = pokaz$prawdziwy_uplift,
                       prognoza = pokaz$uplift_t, typ = pokaz$typ),
            data.frame(model = "Las przyczynowy (grf)", prawdziwy = pokaz$prawdziwy_uplift,
                       prognoza = pokaz$uplift_las, typ = pokaz$typ))
d3$model <- factor(d3$model, unique(d3$model))
etyk <- data.frame(model = factor(levels(d3$model), levels(d3$model)),
                   tekst = sprintf("r = %s", sub("^0", "", sprintf("%.2f", zgodnosc[1, c("uplift_t", "uplift_las")]))))
p3 <- ggplot(d3, aes(prawdziwy * 100, prognoza * 100)) +
  geom_hline(yintercept = 0, colour = "grey60") + geom_vline(xintercept = 0, colour = "grey60") +
  geom_point(colour = kol[["niebieski"]], alpha = 0.45, size = 1.6, shape = 16) +
  geom_abline(slope = 1, intercept = 0, colour = kol[["cynober"]], linetype = "dashed", linewidth = 0.9) +
  geom_text(data = etyk, aes(x = -11, y = 30, label = tekst), hjust = 0, size = 5, colour = "grey15",
            inherit.aes = FALSE) +
  facet_wrap(~ model) +
  coord_cartesian(xlim = c(-12, 32), ylim = c(-20, 34)) +
  labs(title = "Prognoza upliftu a prawdziwy uplift (zbiór testowy)",
       subtitle = "Punkt = klient; linia przerywana: prognoza równa prawdzie",
       x = "Prawdziwy uplift (pp, znany w symulacji)", y = "Prognoza upliftu z modelu (pp)") +
  motyw
p3   # zapis: ggsave("uplift-prognoza-a-prawda.svg", p3, width = 10, height = 5.6)
Wynik w R
 uczacy testowy
  10000   10000
estimate  std.err
    4.64     0.68
                                   wynik_odpowiedz uplift_t uplift_las
r_z_prawdziwym_upliftem                      0.536    0.863      0.845
r_z_prawdopodobienstwem_bez_kuponu           0.741    0.077      0.068
4. Krzywa Qini: Rysunek 4
R
# Rysunek 4. Krzywa Qini na zbiorze testowym (korzysta z Te, kol, motyw z przepisów 1 i 3)
library(ggplot2)

# Dla każdego odsetka k klientów z najwyższym wynikiem modelu: ile dodatkowych zakupów dałby kupon dla nich?
# Oszacowanie z eksperymentu w tej grupie: (odsetek zakupów z kuponem − bez kuponu) × liczba klientów w grupie
krzywa <- function(wynik, d, k = seq(0, 1, by = 0.01)) {
  o <- order(wynik, decreasing = TRUE)
  t <- d$kupon[o]; y <- d$zakup[o]; prawda <- d$prawdziwy_uplift[o]; pz <- d$p_z[o]
  do.call(rbind, lapply(k, function(f) {
    m <- round(f * nrow(d))
    if (m == 0) return(data.frame(k = 0, dodatkowe = 0, dodatkowe_prawda = 0, r_z = NA, r_bez = NA, m = 0,
                                  suma_pz = 0))
    r_z <- mean(y[1:m][t[1:m] == 1]); r_bez <- mean(y[1:m][t[1:m] == 0])
    data.frame(k = f, dodatkowe = (r_z - r_bez) * m, dodatkowe_prawda = sum(prawda[1:m]), r_z = r_z,
               r_bez = r_bez, m = m, suma_pz = sum(pz[1:m]))
  }))
}
modele <- c("Model samej odpowiedzi" = "wynik_odpowiedz", "T-learner" = "uplift_t",
            "Las przyczynowy" = "uplift_las", "Prawdziwy uplift (wyrocznia)" = "prawdziwy_uplift")
Q <- do.call(rbind, lapply(names(modele), function(nm) cbind(model = nm, krzywa(Te[[modele[nm]]], Te))))
Q$model <- factor(Q$model, names(modele))
calosc_test <- with(Te, (mean(zakup[kupon == 1]) - mean(zakup[kupon == 0])) * nrow(Te))
# Współczynnik Qini: średnia wysokość krzywej nad przekątną losowego wyboru, jako % tej wielkości dla wyroczni
pole <- tapply(Q$dodatkowe - Q$k * calosc_test, Q$model, mean)
round(c(kupon_dla_wszystkich_dodatkowe_zakupy = calosc_test), 0)
tab4 <- data.frame(dodatkowe_przy_20proc = Q$dodatkowe[Q$k == 0.2], dodatkowe_przy_40proc = Q$dodatkowe[Q$k == 0.4],
                   maksimum = tapply(Q$dodatkowe, Q$model, max),
                   k_maksimum = tapply(seq_len(nrow(Q)), Q$model, function(i) Q$k[i][which.max(Q$dodatkowe[i])]),
                   qini_proc_wyroczni = 100 * pole / pole[["Prawdziwy uplift (wyrocznia)"]], row.names = names(modele))
round(tab4, 1)

p4 <- ggplot(Q, aes(k * 100, dodatkowe, colour = model, linetype = model)) +
  annotate("segment", x = 0, y = 0, xend = 100, yend = calosc_test, colour = "grey50", linetype = "dotted",
           linewidth = 0.8) +
  annotate("text", x = 75, y = 0.75 * calosc_test - 30, label = "wybór losowy", hjust = 0, size = 4, colour = "grey35") +
  geom_line(linewidth = 1.1) +
  scale_colour_manual(values = c(kol[["fiolet"]], kol[["niebieski"]], kol[["cynober"]], "#595959"), name = NULL) +
  scale_linetype_manual(values = c("dotdash", "solid", "solid", "dashed"), name = NULL) +
  scale_x_continuous(breaks = seq(0, 100, 20), labels = function(x) paste0(x, "%")) +
  guides(colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2)) +
  labs(title = "Krzywa Qini: dodatkowe zakupy, gdy kupon dostaje k% klientów",
       subtitle = "Zbiór testowy, 10 000 klientów; klienci posortowani od najwyższego wyniku modelu",
       x = "Odsetek klientów, którym wysyłamy kupon (od najwyżej ocenionych)",
       y = "Dodatkowe zakupy (oszacowanie z eksperymentu)") +
  motyw + theme(legend.key.width = unit(1.4, "cm"))
p4   # zapis: ggsave("uplift-krzywa-qini.svg", p4, width = 10, height = 6.2)
Wynik w R
kupon_dla_wszystkich_dodatkowe_zakupy
                                  385
                             dodatkowe_przy_20proc dodatkowe_przy_40proc
Model samej odpowiedzi                       225.5                 387.9
T-learner                                    282.5                 449.0
Las przyczynowy                              263.5                 421.6
Prawdziwy uplift (wyrocznia)                 322.6                 483.1
                             maksimum k_maksimum qini_proc_wyroczni
Model samej odpowiedzi          408.2        0.5               57.9
T-learner                       517.9        0.7               93.2
Las przyczynowy                 491.1        0.7               80.7
Prawdziwy uplift (wyrocznia)    528.3        0.8              100.0
5. Zysk kampanii: Rysunek 5
R
# Rysunek 5. Zysk kampanii w funkcji odsetka klientów z kuponem (korzysta z Q, modele z przepisu 4)
library(ggplot2)

marza <- 40      # zł zysku z jednego zamówienia (ustalone ręcznie)
kupon_zl <- 15   # zł rabatu oddanego przy każdym zakupie z kuponem
mail_zl <- 0.1   # zł kosztu wysłania jednego maila
# Zysk = marża × dodatkowe zakupy − rabat × wszystkie zakupy z kuponem − koszt maili
Q$zysk <- with(Q, marza * dodatkowe - kupon_zl * ifelse(m > 0, r_z * m, 0) - mail_zl * m)
Q$zysk_prawda <- with(Q, marza * dodatkowe_prawda - kupon_zl * suma_pz - mail_zl * m)
tab5 <- t(sapply(split(Q, Q$model), function(d) c(
  zysk_20proc = d$zysk[d$k == 0.2], zysk_prawda_20proc = d$zysk_prawda[d$k == 0.2],
  najlepszy_k_prawda = 100 * d$k[which.max(d$zysk_prawda)], zysk_prawda_max = max(d$zysk_prawda),
  zysk_wszyscy = d$zysk[d$k == 1], zysk_prawda_wszyscy = d$zysk_prawda[d$k == 1])))
round(tab5, 0)

d5 <- Q[Q$model != "Prawdziwy uplift (wyrocznia)", ]
p5 <- ggplot(d5, aes(k * 100, zysk_prawda / 1000, colour = model, linetype = model)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_line(aes(y = zysk / 1000), linewidth = 0.5, alpha = 0.6, show.legend = FALSE) +
  geom_line(linewidth = 1.2) +
  scale_colour_manual(values = c(kol[["fiolet"]], kol[["niebieski"]], kol[["cynober"]]), name = NULL) +
  scale_linetype_manual(values = c("dotdash", "solid", "solid"), name = NULL) +
  scale_x_continuous(breaks = seq(0, 100, 20), labels = function(x) paste0(x, "%")) +
  labs(title = "Zysk kampanii: komu wysłać kupon?",
       subtitle = "Grube linie – prawdziwy zysk (znany w symulacji); cienkie – oszacowanie z eksperymentu",
       x = "Odsetek klientów, którym wysyłamy kupon (od najwyżej ocenionych)",
       y = "Zysk na 10 000 klientów (tys. zł)") +
  motyw + theme(legend.key.width = unit(1.4, "cm"))
p5   # zapis: ggsave("uplift-zysk-kampanii.svg", p5, width = 10, height = 6)
Wynik w R
                             zysk_20proc zysk_prawda_20proc najlepszy_k_prawda
Model samej odpowiedzi              -884              -1885                  0
T-learner                           1863               1451                 29
Las przyczynowy                     1690               2033                 27
Prawdziwy uplift (wyrocznia)        3937               3733                 27
                             zysk_prawda_max zysk_wszyscy zysk_prawda_wszyscy
Model samej odpowiedzi                     0        -9736              -11153
T-learner                               1639        -9736              -11153
Las przyczynowy                         2211        -9736              -11153
Prawdziwy uplift (wyrocznia)            4008        -9736              -11153
6. Kogo wybiera model: Rysunek 6
R
# Rysunek 6. Kogo wybiera każdy model? Prawdziwe typy wśród 20% klientów z najwyższym wynikiem (korzysta z Te, modele)
library(ggplot2)

gora <- function(wynik) Te$typ[order(wynik, decreasing = TRUE)[1:(0.2 * nrow(Te))]]
sklad <- rbind(cbind(wybor = "Cały zbiór testowy (dla porównania)", as.data.frame(prop.table(table(typ = Te$typ)))),
               do.call(rbind, lapply(names(modele)[1:3], function(nm)
                 cbind(wybor = nm, as.data.frame(prop.table(table(typ = gora(Te[[modele[nm]]]))))))))
sklad$procent <- round(100 * sklad$Freq, 1)
sklad$wybor <- factor(sklad$wybor, rev(c("Cały zbiór testowy (dla porównania)", names(modele)[1:3])))
xtabs(procent ~ wybor + typ, sklad)[4:1, ]
# Średni prawdziwy uplift (pp) i prawdopodobieństwo zakupu bez kuponu (%) w wybranych 20%
round(sapply(modele[1:3], function(s) { i <- order(Te[[s]], decreasing = TRUE)[1:2000]
  c(uplift_pp = 100 * mean(Te$prawdziwy_uplift[i]), zakup_bez_kuponu_proc = 100 * mean(Te$p_bez[i])) }), 1)

p6 <- ggplot(sklad, aes(procent, wybor, fill = typ)) +
  geom_col(width = 0.65, colour = "white", linewidth = 0.4, position = position_stack(reverse = TRUE)) +
  geom_text(aes(label = ifelse(procent >= 4, sprintf("%.0f%%", procent), "")), position = position_stack(vjust = 0.5, reverse = TRUE),
            colour = ifelse(sklad$typ == "straceni", "#0f1d3a", "white"), fontface = "bold", size = 4.2) +
  scale_fill_manual(values = c(przekonywalni = kol[["cynober"]], pewniacy = kol[["niebieski"]],
                               straceni = "#D9D9D9", "nie przeszkadzać" = kol[["fiolet"]]), name = NULL) +
  scale_x_continuous(labels = function(x) paste0(x, "%"), expand = c(0, 0)) +
  labs(title = "Kogo wybiera model? Typy klientów w górnych 20%",
       subtitle = "Zbiór testowy (10 000 klientów); typy znane tylko dlatego, że dane są symulowane",
       x = "Udział typów klientów", y = NULL) +
  motyw + theme(panel.grid.major.y = element_blank())
p6   # zapis: ggsave("uplift-kogo-wybiera-model.svg", p6, width = 10, height = 5)
Wynik w R
                                     typ
wybor                                 przekonywalni pewniacy straceni
  Cały zbiór testowy (dla porównania)           4.9     11.1     82.8
  Model samej odpowiedzi                       10.7     21.3     67.9
  T-learner                                    13.7     17.0     69.3
  Las przyczynowy                              14.1     15.1     70.8
                                     typ
wybor                                 nie przeszkadzać
  Cały zbiór testowy (dla porównania)              1.1
  Model samej odpowiedzi                           0.0
  T-learner                                        0.0
  Las przyczynowy                                  0.0
                      Model samej odpowiedzi T-learner Las przyczynowy
uplift_pp                               10.2      13.7            13.9
zakup_bez_kuponu_proc                   22.6      17.3            15.7
7. Sprawdzenie palety (deuteranopia, protanopia)
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("cynober – niebieski (przekonywalni / pewniacy; las / T-learner)" = c("#D55E00", "#0072B2"),
             "cynober – fiolet (przekonywalni / nie przeszkadzać; las / model odpowiedzi)" = c("#D55E00", "#CC79A7"),
             "niebieski – fiolet (pewniacy / nie przeszkadzać; T-learner / model odpowiedzi)" = c("#0072B2", "#CC79A7"),
             "fiolet – jasnoszary (nie przeszkadzać / straceni)" = c("#CC79A7", "#D9D9D9"),
             "fiolet – ciemnoszary (model odpowiedzi / wyrocznia na krzywej Qini)" = c("#CC79A7", "#595959"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                                               widzenie_typowe
cynober – niebieski (przekonywalni / pewniacy; las / T-learner)                          114.6
cynober – fiolet (przekonywalni / nie przeszkadzać; las / model odpowiedzi)               74.3
niebieski – fiolet (pewniacy / nie przeszkadzać; T-learner / model odpowiedzi)            53.6
fiolet – jasnoszary (nie przeszkadzać / straceni)                                         47.5
fiolet – ciemnoszary (model odpowiedzi / wyrocznia na krzywej Qini)                       46.2
czerwony – zielony (do unikania)                                                         121.7
                                                                               deuteranopia
cynober – niebieski (przekonywalni / pewniacy; las / T-learner)                       108.3
cynober – fiolet (przekonywalni / nie przeszkadzać; las / model odpowiedzi)            70.2
niebieski – fiolet (pewniacy / nie przeszkadzać; T-learner / model odpowiedzi)         42.0
fiolet – jasnoszary (nie przeszkadzać / straceni)                                      24.9
fiolet – ciemnoszary (model odpowiedzi / wyrocznia na krzywej Qini)                    26.1
czerwony – zielony (do unikania)                                                       21.1
                                                                               protanopia
cynober – niebieski (przekonywalni / pewniacy; las / T-learner)                      91.9
cynober – fiolet (przekonywalni / nie przeszkadzać; las / model odpowiedzi)          71.9
niebieski – fiolet (pewniacy / nie przeszkadzać; T-learner / model odpowiedzi)       22.5
fiolet – jasnoszary (nie przeszkadzać / straceni)                                    33.6
fiolet – ciemnoszary (model odpowiedzi / wyrocznia na krzywej Qini)                  26.6
czerwony – zielony (do unikania)                                                     31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, regresja logistyczna, test χ² – pakiety base i stats; splajny – pakiet splines dołączony do R; las przyczynowy – pakiet grf). Rysunki wykonano w ggplot2, pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- grf (wersja 2.6.1): Tibshirani, J., Athey, S., Sverdrup, E., & Wager, S. (2026). grf: Generalized random forests (R package version 2.6.1) [Computer software]. https://doi.org/10.32614/CRAN.package.grf
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Wybór według prawdopodobieństwa zakupu. Trafia w pewniaków i oddaje im rabat (rysunki 5 i 6). Wysoka prognoza zakupu to nie wysoki efekt kuponu.
- Uplift bez losowania. Gdy kupon dostali np. najaktywniejsi klienci, różnica „z kuponem minus bez” miesza efekt kuponu z różnicami między klientami – zob. korelacja a przyczynowość.
- Ocena na danych uczących. Krzywa Qini policzona na tych samych klientach, na których uczono model, jest zawyżona – to przeuczenie.
- Za mała próba. Uplift to różnica dwóch odsetków w każdej grupie klientów, więc jest dużo bardziej zaszumiony niż sam zakup. Nawet przy 10 000 klientów testowych krzywa Qini jest wyraźnie poszarpana (rysunek 4).
- Jedna interakcja zamiast modelu. Efekt interakcji „kupon × cecha” wystarcza, gdy z góry wiesz, od czego zależy efekt; przy wielu cechach lepszy jest T-learner albo las.
- Zapomniana grupa „nie przeszkadzać”. Ujemny efekt jest realny: u klientów kupujących prawie bez rabatów kupon obniżył odsetek kupujących o 4.59 pp (rysunek 2).
Pomoc przy takiej analizie: analizy statystyczne dla studentów.
Najczęstsze pytania
Czym różni się model uplift od zwykłego modelu predykcyjnego?
Zwykły model przewiduje, czy klient kupi (albo odejdzie). Model uplift przewiduje, o ile zmieni się ta szansa, jeśli klient dostanie ofertę. W przykładzie model samej odpowiedzi wybierał klientów, którzy kupiliby także bez kuponu (21.3% pewniaków wśród wybranych 20%), i przy żadnym progu nie dawał zysku, a modele uplift dawały do 2211 zł zysku na 10 000 klientów.
Czy do modelowania uplift potrzebna jest grupa kontrolna?
Tak. Uplift to różnica między klientami z ofertą i bez oferty, więc potrzebni są podobni klienci w obu grupach – najlepiej z losowego przydziału jak w teście A/B. Bez losowania różnica miesza efekt oferty z różnicami między klientami i potrzebne są metody dla danych obserwacyjnych, np. propensity score.
Co to jest krzywa Qini?
Krzywa Qini pokazuje, ile dodatkowych zdarzeń (np. zakupów) daje działanie skierowane do k% klientów z najwyższym przewidywanym upliftem. Dodatkowe zdarzenia szacuje się z eksperymentu jako różnicę odsetków w grupie z ofertą i bez oferty pomnożoną przez liczebność grupy. Im wyżej krzywa nad przekątną wyboru losowego, tym lepiej model porządkuje klientów. Licz ją na zbiorze testowym.
Co to jest T-learner?
T-learner to dwa osobne modele przewidujące wynik: jeden na osobach, które dostały ofertę, drugi na osobach bez oferty. Przewidywany efekt to różnica ich prognoz. Künzel i in. (2019) opisują go wśród metaalgorytmów szacujących heterogeniczny efekt dowolną metodą regresji; w ich symulacjach żaden metaalgorytm nie był najlepszy zawsze.
Kim są klienci „nie przeszkadzać” (sleeping dogs)?
To klienci, którzy bez kontaktu kupiliby, a po kontakcie rezygnują – oferta działa na nich negatywnie. W przykładzie było ich 1.2%, a wśród klientów kupujących prawie bez rabatów kupon obniżył odsetek kupujących o 4.59 pp. Dobry model uplift przypisuje im ujemny efekt, więc nie trafiają na listę wysyłki.
Powiązane hasła
Przeczytaj też
Model odejść klientów i kampania retencyjna
Operator komórkowy, 10 000 abonentów: regresja i las losowy, gain i lift, kalibracja, macierz decyzji, krzywa zysku i przeciek danych – pięć rysunków z kodem R.
Czytaj →PoradnikPułapki testów A/B na obrazkach
Zaglądanie do p, wiele wersji i metryk, efekt nowości i SRM w symulacjach 1000 testów A/A – pięć rysunków z kodem R i lista kontrolna.
Czytaj →PoradnikStatystyka w pracy z marketingu
Skala postaw wobec marki, NPS z przedziałem ufności, test A/B, intencja zakupu, mediacja i segmentacja: testy, zdania APA, dane XLSX i kod R.
Czytaj →PoradnikSMS i e-mail razem – eksperyment 2 × 2
Sieć gabinetów stomatologicznych: przypomnienie SMS × e-mail, interakcja na dwóch skalach, koszt dodatkowej wizyty i moc dla interakcji – sześć rysunków z kodem R.
Czytaj →Masz w pracy dane z kampanii lub testu A/B?
Pomożemy oszacować efekt kampanii, zbudować i ocenić model uplift oraz opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Ascarza, E. (2018). Retention futility: Targeting high-risk customers might be ineffective. Journal of Marketing Research, 55(1), 80–98. https://doi.org/10.1509/jmr.16.0163 ● Otwarty dostęp: pełny tekst
- Athey, S., Tibshirani, J., & Wager, S. (2019). Generalized random forests. The Annals of Statistics, 47(2), 1148–1178. https://doi.org/10.1214/18-aos1709 ● Otwarty dostęp
- Devriendt, F., Moldovan, D., & Verbeke, W. (2018). A literature survey and experimental evaluation of the state-of-the-art in uplift modeling: A stepping stone toward the development of prescriptive analytics. Big Data, 6(1), 13–41. https://doi.org/10.1089/big.2017.0104
- Kohavi, R., Longbotham, R., Sommerfield, D., & Henne, R. M. (2009). Controlled experiments on the web: Survey and practical guide. Data Mining and Knowledge Discovery, 18(1), 140–181. https://doi.org/10.1007/s10618-008-0114-1 ● Otwarty dostęp
- Künzel, S. R., Sekhon, J. S., Bickel, P. J., & Yu, B. (2019). Metalearners for estimating heterogeneous treatment effects using machine learning. Proceedings of the National Academy of Sciences, 116(10), 4156–4165. https://doi.org/10.1073/pnas.1804597116 ● Otwarty dostęp
- Rzepakowski, P., & Jaroszewicz, S. (2012). Decision trees for uplift modeling with single and multiple treatments. Knowledge and Information Systems, 32(2), 303–327. https://doi.org/10.1007/s10115-011-0434-0 ● Otwarty dostęp
- Wager, S., & Athey, S. (2018). Estimation and inference of heterogeneous treatment effects using random forests. Journal of the American Statistical Association, 113(523), 1228–1242. https://doi.org/10.1080/01621459.2017.1319839 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{ascarza2018retention, author={Ascarza, Eva}, title={{Retention futility: Targeting high-risk customers might be ineffective}}, journal={Journal of Marketing Research}, year={2018}, volume={55}, number={1}, pages={80--98}, doi={10.1509/jmr.16.0163}}@article{athey2019generalized, author={Athey, Susan and Tibshirani, Julie and Wager, Stefan}, title={{Generalized random forests}}, journal={The Annals of Statistics}, year={2019}, volume={47}, number={2}, pages={1148--1178}, doi={10.1214/18-aos1709}}@article{devriendt2018literature, author={Devriendt, Floris and Moldovan, Darie and Verbeke, Wouter}, title={{A literature survey and experimental evaluation of the state-of-the-art in uplift modeling: A stepping stone toward the development of prescriptive analytics}}, journal={Big Data}, year={2018}, volume={6}, number={1}, pages={13--41}, doi={10.1089/big.2017.0104}}@article{kohavi2009controlled, author={Kohavi, Ron and Longbotham, Roger and Sommerfield, Dan and Henne, Randal M.}, title={{Controlled experiments on the web: Survey and practical guide}}, journal={Data Mining and Knowledge Discovery}, year={2009}, volume={18}, number={1}, pages={140--181}, doi={10.1007/s10618-008-0114-1}}@article{kunzel2019metalearners, author={Künzel, Sören R. and Sekhon, Jasjeet S. and Bickel, Peter J. and Yu, Bin}, title={{Metalearners for estimating heterogeneous treatment effects using machine learning}}, journal={Proceedings of the National Academy of Sciences}, year={2019}, volume={116}, number={10}, pages={4156--4165}, doi={10.1073/pnas.1804597116}}@article{rzepakowski2012decision, author={Rzepakowski, Piotr and Jaroszewicz, Szymon}, title={{Decision trees for uplift modeling with single and multiple treatments}}, journal={Knowledge and Information Systems}, year={2012}, volume={32}, number={2}, pages={303--327}, doi={10.1007/s10115-011-0434-0}}@article{wager2018estimation, author={Wager, Stefan and Athey, Susan}, title={{Estimation and inference of heterogeneous treatment effects using random forests}}, journal={Journal of the American Statistical Association}, year={2018}, volume={113}, number={523}, pages={1228--1242}, doi={10.1080/01621459.2017.1319839}}