Przykład: operator komórkowy i 10 000 abonentów
Fikcyjny operator komórkowy chce dzwonić z ofertą rabatu do klientów, którzy mogą odejść. Dział retencji pyta: do kogo zadzwonić, żeby kampania się opłaciła?
Bierzemy stan bazy na 31 marca: 10 000 abonentów, a dla każdego staż, rodzaj umowy, miesiące do końca umowy, zgłoszenia do obsługi, zmianę korzystania z internetu, rachunek, pakiet z telewizją, opóźnione płatności i wiek. Wynik to odejście w kwietniu–czerwcu (1 = tak). Odeszło 12.2% klientów: 29.6% wśród tych, którym umowa kończyła się w ciągu 2 miesięcy, 18.2% bez umowy i 7.5% z dłuższą umową.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Współczynniki prawdziwego modelu ustawiliśmy ręcznie (m.in. skok ryzyka pod koniec umowy, silniejszy przy zgłoszeniach). Wyraz wolny zmieniliśmy raz, z −3.3 na −2.5, bo pierwsze uruchomienie dało tylko 6.3% odejść. Ziarna 608 nie zmienialiśmy. Dane pobierzesz jako churn-klienci-operatora.csv.
Pytamy „kto odejdzie w najbliższym kwartale?”. Pytanie „kiedy?” opisuje wpis odejścia klientów jako analiza przeżycia. Modele budujemy na 6000 klientach, a oceniamy na 4000 pozostałych (zbiór testowy, 476 odejść, 11.9%).
Rysunek 1: dwa modele, wykres gain i lift
Pierwszy model to regresja logistyczna z dziewięcioma predyktorami wpisanymi liniowo, bez żadnego dopasowywania do danych (procedurę i założenia opisuje wpis regresja logistyczna krok po kroku). Drugi to las losowy: 500 drzew decyzyjnych, każde uczone na próbie bootstrapowej i z losowym wyborem zmiennych przy podziałach (Breiman, 2001). Las sam znajduje progi i interakcje (więcej: drzewa decyzyjne i lasy losowe). Sortujemy klientów testowych od najwyższego przewidywanego ryzyka i sprawdzamy, ile odejść „złapiemy”, dzwoniąc do górnych 10%, 20%, 30%.
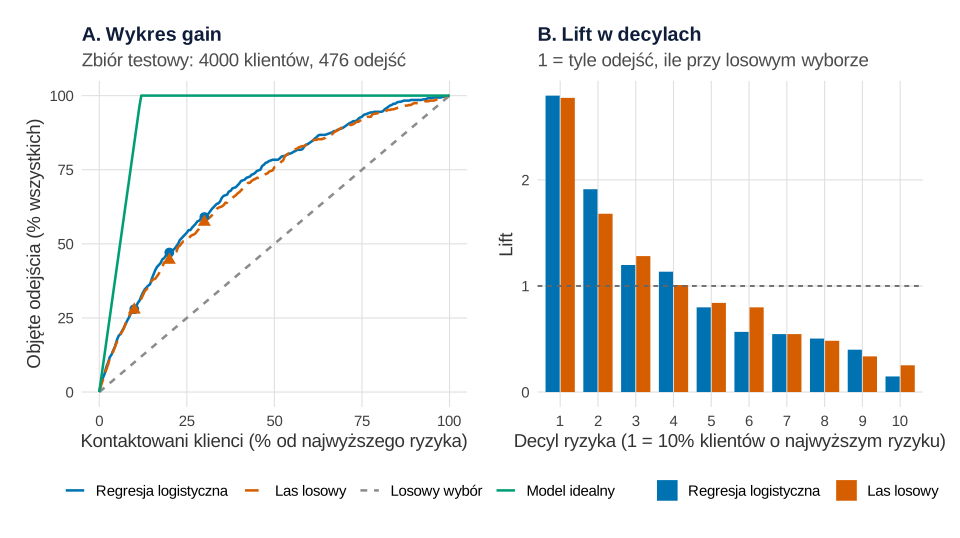
set.seed(608)).Co widać. Na wykresie gain (panel A) górne 10% klientów według regresji obejmuje 27.9% wszystkich odejść, górne 20% – 47.1%, a górne 30% – 59.0%. Las losowy wypada prawie tak samo (27.7%, 44.5%, 57.4%). Lift w pierwszym decylu (panel B) to 2.79 dla regresji i 2.77 dla lasu: wśród 400 klientów o najwyższym ryzyku odejść jest prawie trzy razy więcej niż przy losowym wyborze. Pole pod krzywą ROC (AUC) wyniosło .732 dla regresji i .718 dla lasu.
Jak może zmylić. Las nie wygrał, choć w danych są progi i interakcje. To typowe: w przeglądzie 71 badań klinicznych uczenie maszynowe nie przewyższało regresji logistycznej w porównaniach o niskim ryzyku błędu (Christodoulou i in., 2019). Lemmens i Croux (2006) poprawili przewidywanie odejść u operatora baggingiem i boostingiem drzew (zob. gradient boosting). Wykres gain mówi tylko o kolejności klientów. Maksymalny możliwy lift to 100 / 11.9 = 8.4.
Podpis do pracy:
Zdanie do Wyników:
Ilorazy szans z regresji: opóźniona płatność OR = 2.23, 95% CI [1.78, 2.80], każde zgłoszenie do obsługi OR = 1.31 [1.19, 1.44], każdy dodatkowy miesiąc do końca umowy OR = 0.93 [0.92, 0.95], pakiet z telewizją OR = 0.49 [0.40, 0.60].
Rysunek 2: czy przewidywane ryzyko jest prawdziwe?
Jeśli model mówi „30% ryzyka”, to wśród takich klientów powinno odejść około 30%. Tę zgodność nazywamy kalibracją. Steyerberg i in. (2010) zalecają raportować zawsze dwie rzeczy: dyskryminację (np. AUC) i kalibrację. Krzywa ROC, wykres lift i wykres kalibracji to trzy spojrzenia na ten sam model (Vuk i Curk, 2006).
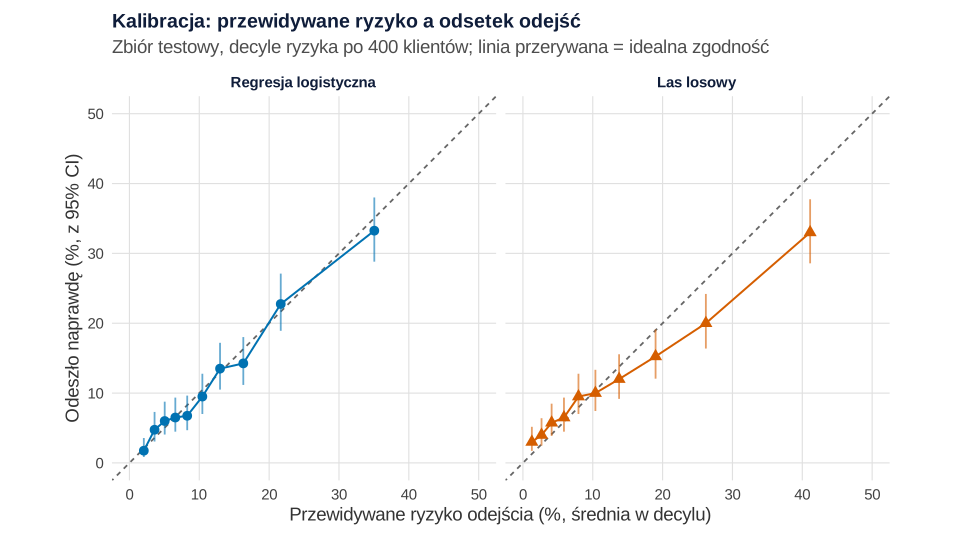
set.seed(608)).Co widać. Punkty regresji leżą blisko przekątnej: w decylu o najwyższym ryzyku przewidziała 35.1%, a odeszło 33.2%. Nachylenie kalibracji to 0.969 (ideał = 1). Las losowy przesadza w obie strony: w górnym decylu przewiduje 41.1%, a odchodzi 33.0%; w dolnym 1.3%, a odchodzi 3.0%. Jego nachylenie to 0.734, czyli przewidywania są zbyt skrajne. Wynik Briera (średni kwadrat błędu przewidywania) prawie się nie różni: .096 i .098.
Jak może zmylić. Kalibracja w dziesięciu grupach jest zgrubna. Neslin i in. (2006) zauważyli, że modele odejść niewiele traciły na trafności po trzech miesiącach, ale po zmianie cennika kalibracja może się rozjechać – sprawdzaj ją przed każdą kampanią. Sztuczne wyrównywanie klas (SMOTE, wagi) psuje kalibrację – zob. nierównowaga klas.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: macierz decyzji – ile kosztuje telefon?
Teraz przekładamy ryzyko na pieniądze. Każdy klient trafia do jednej z czterech komórek: dzwonimy albo nie × odszedłby albo zostałby. To ta sama tabela co macierz pomyłek, tylko zamiast „trafień” wpisujemy złotówki.
Parametry kampanii ustaliliśmy ręcznie (to przykład, nie dane rynkowe): telefon konsultanta kosztuje 10 zł, oferta to rabat wart 60 zł, a klient, który zostaje, daje 600 zł marży w kolejnym roku. Zakładamy, że telefon zatrzymuje 30% klientów, którzy chcieli odejść. Z tych liczb wynika próg: kontakt opłaca się, gdy ryzyko przekracza
gdzie s to skuteczność oferty, a V – marża. Przy tym ryzyku zysk z uratowanych równoważy koszt telefonów i rabatów dla tych, którzy zostaliby i tak.
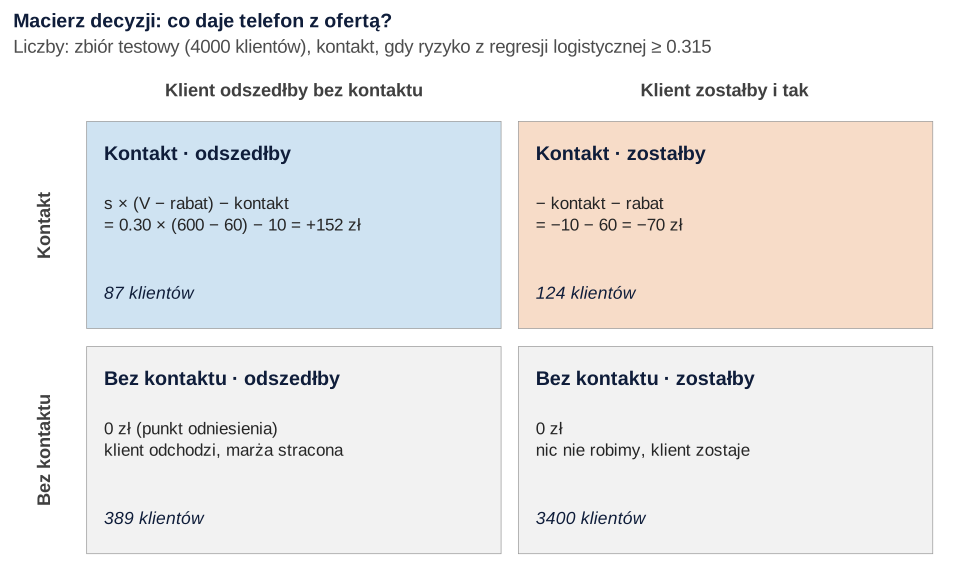
set.seed(608)).Co widać. Telefon do klienta, który odszedłby, daje średnio +152 zł (30% z 540 zł minus 10 zł). Telefon do klienta, który zostałby i tak, to −70 zł. Przy progu 0.315 regresja wskazała 211 klientów testowych (5.3%): 87 odchodzących i 124 zostających. Kampania daje 87 × 152 − 124 × 70 = 4544 zł. 389 odchodzących miało ryzyko poniżej progu.
Jak może zmylić. Wszystkie kwoty to założenia; skuteczność 30% trzeba zmierzyć. Marżę policz porządnie – zob. wartość klienta w czasie (CLV). Wzór na próg działa tylko wtedy, gdy model jest dobrze skalibrowany.
Podpis do pracy (np. w rozdziale o kampanii):
Zdanie do Metody:
Rysunek 4: krzywa zysku – jaki próg wybrać?
Sprawdzamy progi od 0.05 do 0.70 i dla każdego liczymy zysk kampanii na zbiorze testowym.
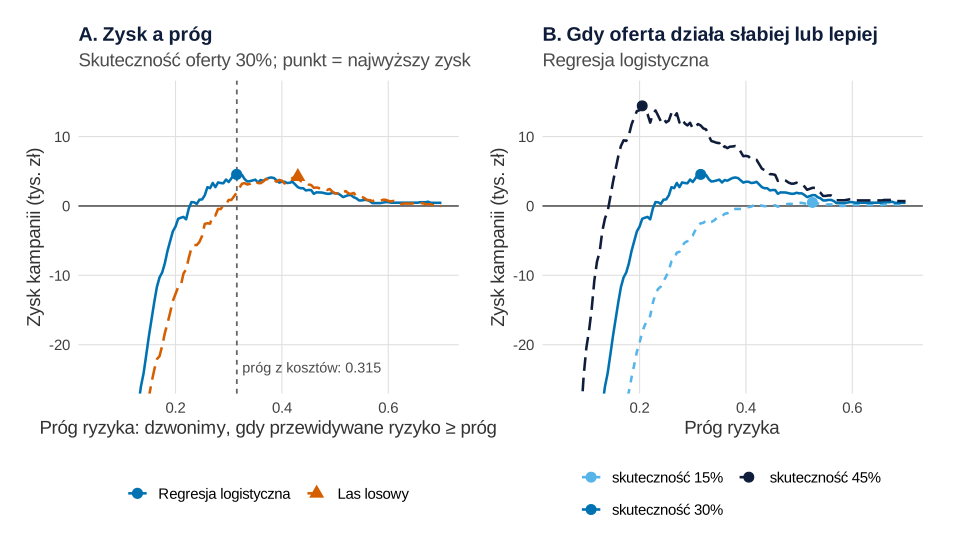
set.seed(608)).Co widać. W panelu A zysk regresji jest najwyższy (4544 zł) dokładnie przy progu 0.315 z wzoru – bo regresja jest dobrze skalibrowana. Las osiąga maksimum 4220 zł dopiero przy progu 0.430, a przy progu 0.315 daje tylko 1980 zł: jego zawyżone ryzyko „przepycha” ponad próg zbyt wielu klientów. Domyślny próg 0.5 dałby z regresji 1814 zł, a telefon do wszystkich 4000 klientów – stratę 174 328 zł. Panel B pokazuje wrażliwość na skuteczność oferty: przy 15% opłaca się dzwonić tylko do 0.5% klientów (próg 0.496, zysk 503 zł), przy 45% – do 16.6% (próg 0.231, zysk 14 423 zł).
Jak może zmylić. Krzywa jest „poszarpana”, bo w zbiorze testowym jest tylko 476 odejść. Próg wybrany na tym samym zbiorze, na którym liczysz zysk, jest zbyt optymistyczny – wybierz go na zbiorze uczącym lub w walidacji krzyżowej, a na testowym tylko sprawdź. Oś jest przycięta: przy progu bliskim zera strata dochodzi do 174 328 zł. Neslin i in. (2006) pokazali, że różnice w trafności modeli odejść mogą zmieniać zysk kampanii o setki tysięcy dolarów.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: przeciek danych z przyszłości
W bazie jest kolumna „prośba o kod przeniesienia numeru”. Analityk dołączył ją z całego półrocza, a klient składa taką prośbę po 31 marca, gdy już odchodzi. To przeciek (ang. leakage): informacja o wyniku, której w dniu prognozy nie da się znać (Kaufman i in., 2012).
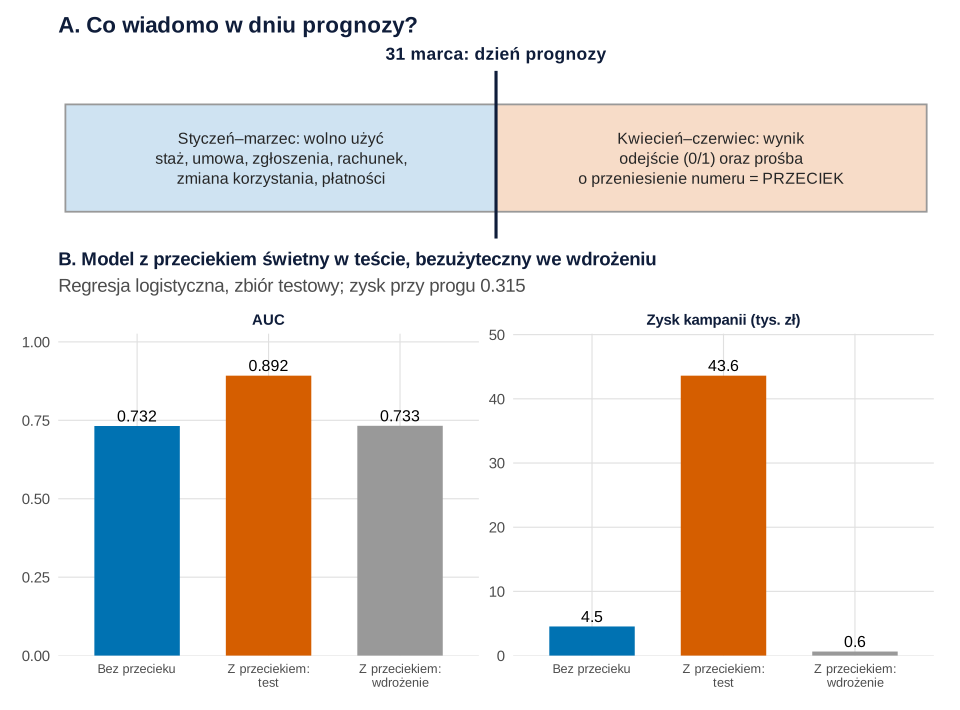
set.seed(608)).Co widać. Z prośbą o przeniesienie numeru (OR = 132.3) model ma AUC = .892, a górne 10% klientów obejmuje 67.2% odejść. Zysk przy progu 0.315 rośnie do 43 608 zł – prawie dziesięć razy więcej. We wdrożeniu, 31 marca, nikt jeszcze nie złożył prośby, więc kolumna ma same zera. AUC spada do .733, średnie przewidywane ryzyko do 4.9% (przy 11.9% odejść), próg przekracza 0.2% klientów, a zysk to 632 zł.
Jak może zmylić. Przeciek nie zawsze jest tak oczywisty. Podejrzane są zmienne liczone „do dziś”, np. połączenia z działem rezygnacji. Kaufman i in. (2012) zalecają rozdzielić dane do uczenia i do przewidywania: każdy predyktor musi mieć datę sprzed dnia prognozy. Podejrzanie wysokie AUC to alarm.
Podpis do pracy:
Zdanie do Metody:
Co z tym zrobić w marketingu
- Wybierz model po zysku, nie po AUC. Tu regresja dała więcej niż las, bo była lepiej skalibrowana.
- Ustal próg z kosztów. Policz go wzorem, a potem sprawdź na krzywej zysku. Próg 0.5 „z przyzwyczajenia” oddał tu ponad połowę zysku.
- Zmierz skuteczność oferty. Wśród klientów powyżej progu wylosuj grupę kontrolną bez telefonu i porównaj odejścia (test A/B). Od tej liczby zależy, czy kampania się opłaca.
- Predykcja to nie wpływ. Model mówi, kto odejdzie, a nie kogo telefon zatrzyma. Ascarza (2018) w dwóch eksperymentach terenowych pokazała, że klienci o najwyższym ryzyku nie muszą być najlepszymi adresatami kampanii i że lepiej wybierać ich według wrażliwości na ofertę. Jak to policzyć, opisuje wpis modelowanie uplift – komu wysłać kupon.
- Ilorazy szans to nie dźwignie. To, że klienci z pakietem telewizyjnym rzadziej odchodzą, nie znaczy, że dorzucenie telewizji ich zatrzyma (zob. korelacja a przyczynowość).
Jak opisać w pracy
Napisz, co było znane w dniu prognozy, jak podzielono dane i jak oceniono model. Ogólne zasady opisuje wpis modele predykcyjne: walidacja i kalibracja.
W Wynikach podaj tabelę porównania modeli:
| Model | AUC | Gain 10% (%) | Lift 1. decyl | Nachylenie kalibracji | Brier | Najwyższy zysk (zł) |
|---|---|---|---|---|---|---|
| Regresja logistyczna | .732 | 27.9 | 2.79 | 0.97 | .096 | 4544 (próg 0.315) |
| Las losowy | .718 | 27.7 | 2.77 | 0.73 | .098 | 4220 (próg 0.430) |
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę i motyw, przepis 2 – modele i przewidywania, przepis 4 – parametry kampanii używane w przepisach 5 i 6. Przepisy 2–6 kończą się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki 1–4 na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka), a rysunek 5 zapisano bez zmian – dane, geometrie i skale są identyczne.
Losują tylko przepisy 1 i 2: każdy zaczyna od własnego set.seed(608), a las losowy dostaje też seed = 608. Skopiowany osobno (z przepisem 1) da te same liczby co na stronie. Ziarno 608 ustalono raz i nie zmieniano go. Ręcznie ustalono: liczbę klientów, rozkłady cech i współczynniki prawdziwego modelu odejścia (wyraz wolny zmieniony raz z −3.3 na −2.5, gdy pierwsze uruchomienie dało 6.3% odejść), odsetki prośby o przeniesienie numeru (65% u odchodzących, 1.5% u zostających) i podział 6000/4000 (przepis 1); 500 drzew lasu (przepis 2); koszty i skuteczność kampanii (przepis 4); zakres progów 0.05–0.70 i skuteczności 15% i 45% (przepis 5). Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się w kilka sekund.
1. Dane, podział na zbiór uczący i testowy
R
# Przepis 1. Klienci fikcyjnego operatora komórkowego: stan na 31 marca i odejścia w kwietniu–czerwcu
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii), kształty i prosty motyw rysunków
kol <- c("Regresja logistyczna" = "#0072B2", "Las losowy" = "#D55E00", "Losowy wybór" = "grey55",
         "Model idealny" = "#009E73")
ksztalt <- c("Regresja logistyczna" = 16, "Las losowy" = 17, "Losowy wybór" = 1, "Model idealny" = 15)
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# 10 000 klientów abonamentowych. Współczynniki prawdziwego modelu odejścia ustalono ręcznie:
# skok ryzyka, gdy do końca umowy zostały najwyżej 2 miesiące (silniejszy przy zgłoszeniach reklamacji),
# wyższe ryzyko bez umowy terminowej, przy spadku korzystania z usług i opóźnionych płatnościach.
set.seed(608)                                    # ziarno ustalone raz, bez dobierania pod wynik
n <- 10000
bez_umowy <- rbinom(n, 1, 0.25)                  # abonament bez zobowiązania (można odejść w każdej chwili)
do_konca <- ifelse(bez_umowy == 1, 0, sample(0:23, n, replace = TRUE))   # miesiące do końca umowy
staz <- pmax(1, round(rgamma(n, 2, 2 / 40)))      # staż w miesiącach
zgloszenia <- rpois(n, 0.6)                       # zgłoszenia do obsługi klienta w ostatnich 3 miesiącach
zmiana_uzycia <- round(rnorm(n, 0, 25))           # zmiana korzystania z internetu: ostatnie 3 mies. vs poprzednie (%)
rachunek <- round(pmin(250, pmax(30, rnorm(n, 85, 30))))   # średni miesięczny rachunek (zł)
pakiet_tv <- rbinom(n, 1, 0.30)                   # usługa w pakiecie z telewizją
opoznienia <- rbinom(n, 1, 0.10)                  # opóźniona płatność w ostatnich 3 miesiącach
wiek <- round(pmin(85, pmax(18, rnorm(n, 44, 14))))
koniec <- as.numeric(bez_umowy == 0 & do_konca <= 2)
logit <- -2.5 + 1.5 * koniec + 1.0 * bez_umowy + 0.30 * zgloszenia + 0.35 * koniec * zgloszenia -
  0.025 * zmiana_uzycia - 0.7 * pakiet_tv - 0.006 * staz + 0.6 * opoznienia + 0.004 * (rachunek - 85)
odejdzie <- rbinom(n, 1, plogis(logit))           # odejście w kwietniu–czerwcu (1 = tak)

# Zmienna z przyszłości: prośba o kod przeniesienia numeru (składana PO 31 marca, w oknie odejścia).
# Analityk dołączył ją z całego półrocza – to przeciek danych (zob. przepis 5).
prosba_przeniesienia <- rbinom(n, 1, ifelse(odejdzie == 1, 0.65, 0.015))

klienci <- data.frame(id = sprintf("C%05d", 1:n), staz, bez_umowy, do_konca, zgloszenia, zmiana_uzycia,
                      rachunek, pakiet_tv, opoznienia, wiek, prosba_przeniesienia, odejdzie)
write.csv(klienci, "churn-klienci-operatora.csv", row.names = FALSE)

# Podział na zbiór uczący (6000) i testowy (4000) – zbioru testowego nie używamy do budowy modeli
set.seed(608)
ucz <- sample(n, 6000)
train <- klienci[ucz, ]; test <- klienci[-ucz, ]
c(odejscia_proc = round(100 * mean(klienci$odejdzie), 1), uczacy = round(100 * mean(train$odejdzie), 1),
  testowy = round(100 * mean(test$odejdzie), 1), odejscia_test = sum(test$odejdzie))
# Odsetek odejść w grupach – szybki rzut oka na dane
round(100 * tapply(klienci$odejdzie, ifelse(klienci$bez_umowy == 1, "bez umowy",
                   ifelse(klienci$do_konca <= 2, "umowa: koniec za 0–2 mies.", "umowa: dłużej")), mean), 1)
Wynik w R
odejscia_proc        uczacy       testowy odejscia_test
         12.2          12.3          11.9         476.0
                 bez umowy              umowa: dłużej
                      18.2                        7.5
umowa: koniec za 0–2 mies.
                      29.6
2. Regresja logistyczna, las losowy, gain i lift: Rysunek 1
R
# Przepis 2. Regresja logistyczna i las losowy na zbiorze uczącym; wykres gain i lift na zbiorze testowym
# (korzysta z train, test, kol, ksztalt i motyw z przepisu 1)
library(ggplot2)
library(patchwork)
library(ranger)

predyktory <- c("staz", "bez_umowy", "do_konca", "zgloszenia", "zmiana_uzycia", "rachunek", "pakiet_tv",
                "opoznienia", "wiek")                       # tylko informacje znane 31 marca
wzor <- reformulate(predyktory, "odejdzie")
rl <- glm(wzor, family = binomial, data = train)
round(cbind(OR = exp(coef(rl)), exp(confint.default(rl)))[-1, ], 3)
set.seed(608)
las <- ranger(wzor, data = transform(train, odejdzie = factor(odejdzie)), num.trees = 500,
              probability = TRUE, importance = "permutation", seed = 608)
round(sort(las$variable.importance, decreasing = TRUE), 4)   # ważność permutacyjna (spadek trafności)

test$p_rl <- predict(rl, test, type = "response")
test$p_las <- predict(las, test)$predictions[, "1"]
auc <- function(p, y) {                       # AUC = P(ryzyko odchodzącego > ryzyko zostającego)
  r <- rank(p); n1 <- sum(y); n0 <- length(y) - n1
  (sum(r[y == 1]) - n1 * (n1 + 1) / 2) / (n1 * n0)
}
c(AUC_rl = auc(test$p_rl, test$odejdzie), AUC_las = auc(test$p_las, test$odejdzie)) |> round(3)

# Gain: jaki odsetek wszystkich odejść obejmie kontakt z górnymi x% klientów według ryzyka
gain <- function(p, y, nazwa) {
  o <- order(p, decreasing = TRUE); k <- seq(0, length(y), by = 20)     # punkt co 20 klientów
  data.frame(model = nazwa, odsetek = k / length(y), zlapani = c(0, cumsum(y[o]) / sum(y))[k + 1])
}
y <- test$odejdzie
g <- rbind(gain(test$p_rl, y, "Regresja logistyczna"), gain(test$p_las, y, "Las losowy"),
           gain(y, y, "Model idealny"),
           data.frame(model = "Losowy wybór", odsetek = c(0, 1), zlapani = c(0, 1)))
g$model <- factor(g$model, names(kol))
# Lift w decylach ryzyka: odsetek odejść w decylu / odsetek odejść w całym zbiorze testowym
decyl <- function(p) ceiling(10 * rank(-p, ties.method = "first") / length(p))   # 1 = najwyższe ryzyko
lift <- rbind(data.frame(model = "Regresja logistyczna", decyl = decyl(test$p_rl), y),
              data.frame(model = "Las losowy", decyl = decyl(test$p_las), y))
lift <- aggregate(y ~ model + decyl, lift, function(v) mean(v) / mean(y))
names(lift)[3] <- "lift"
lift$model <- factor(lift$model, names(kol)[1:2])
print(reshape(lift, idvar = "decyl", timevar = "model", direction = "wide") |> round(2), row.names = FALSE)
pkt <- subset(g, model %in% names(kol)[1:2] & round(odsetek * 4000) %in% c(400, 800, 1200))
print(transform(pkt, zlapani = round(100 * zlapani, 1)), row.names = FALSE)

pa <- ggplot(g, aes(100 * odsetek, 100 * zlapani, colour = model, linetype = model)) +
  geom_line(linewidth = 0.9) +
  geom_point(data = pkt, aes(shape = model), size = 3, show.legend = FALSE) +
  scale_colour_manual(values = kol, name = NULL) + scale_shape_manual(values = ksztalt, name = NULL) +
  scale_linetype_manual(values = c("solid", "42", "22", "solid"), name = NULL) +
  labs(x = "Kontaktowani klienci (% od najwyższego ryzyka)", y = "Objęte odejścia (% wszystkich)",
       title = "A. Wykres gain", subtitle = "Zbiór testowy: 4000 klientów, 476 odejść") + motyw
pb <- ggplot(lift, aes(factor(decyl), lift, fill = model)) +
  geom_col(position = position_dodge(0.8), width = 0.75) +
  geom_hline(yintercept = 1, linetype = "22", colour = "grey40") +
  scale_fill_manual(values = kol[1:2], name = NULL) +
  labs(x = "Decyl ryzyka (1 = 10% klientów o najwyższym ryzyku)", y = "Lift",
       title = "B. Lift w decylach", subtitle = "1 = tyle odejść, ile przy losowym wyborze") + motyw
p1 <- pa + pb + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p1   # zapis: ggsave("churn-gain-lift.svg", p1, width = 10, height = 5.6)
Wynik w R
                 OR 2.5 % 97.5 %
staz          0.996 0.993  0.999
bez_umowy     0.999 0.801  1.247
do_konca      0.934 0.920  0.949
zgloszenia    1.311 1.191  1.443
zmiana_uzycia 0.976 0.972  0.979
rachunek      1.003 1.000  1.005
pakiet_tv     0.488 0.400  0.595
opoznienia    2.233 1.784  2.795
wiek          1.005 0.999  1.011
     do_konca     bez_umowy zmiana_uzycia    opoznienia     pakiet_tv
       0.0263        0.0138        0.0085        0.0016        0.0013
   zgloszenia          staz      rachunek          wiek
       0.0013        0.0004       -0.0001       -0.0005
 AUC_rl AUC_las
  0.732   0.718
 decyl lift.Las losowy lift.Regresja logistyczna
     1            2.77                      2.79
     2            1.68                      1.91
     3            1.28                      1.20
     4            1.01                      1.13
     5            0.84                      0.80
     6            0.80                      0.57
     7            0.55                      0.55
     8            0.48                      0.50
     9            0.34                      0.40
    10            0.25                      0.15
                model odsetek zlapani
 Regresja logistyczna     0.1    27.9
 Regresja logistyczna     0.2    47.1
 Regresja logistyczna     0.3    59.0
           Las losowy     0.1    27.7
           Las losowy     0.2    44.5
           Las losowy     0.3    57.4
3. Kalibracja i wynik Briera: Rysunek 2
R
# Przepis 3. Kalibracja: czy przewidywane ryzyko zgadza się z odsetkiem odejść? (zbiór testowy)
# (korzysta z test, p_rl, p_las, decyl(), kol, ksztalt i motyw z przepisów 1–2)
library(ggplot2)

kal <- rbind(data.frame(model = "Regresja logistyczna", p = test$p_rl, y = test$odejdzie),
             data.frame(model = "Las losowy", p = test$p_las, y = test$odejdzie))
kal$grupa <- ave(kal$p, kal$model, FUN = decyl)
tab <- do.call(rbind, lapply(split(kal, list(kal$model, kal$grupa)), function(d) {
  ci <- prop.test(sum(d$y), nrow(d), correct = FALSE)$conf.int          # przedział Wilsona
  data.frame(model = d$model[1], grupa = d$grupa[1], przewidywane = mean(d$p), obserwowane = mean(d$y),
             dolna = ci[1], gorna = ci[2])
}))
tab$model <- factor(tab$model, names(kol)[1:2])
print(transform(tab[order(tab$model, tab$grupa), c("model", "grupa", "przewidywane", "obserwowane")],
                przewidywane = round(100 * przewidywane, 1), obserwowane = round(100 * obserwowane, 1)),
      row.names = FALSE)

# Średnie ryzyko, wynik Briera oraz wyraz wolny i nachylenie kalibracji (regresja wyniku na logit ryzyka)
logit <- function(p) log(p / (1 - p))
sapply(split(kal, kal$model), function(d) {
  pp <- pmin(pmax(d$p, 0.001), 0.999)                     # las losowy daje też 0 i 1
  c(srednie_ryzyko = mean(d$p), odsetek_odejsc = mean(d$y), Brier = mean((d$p - d$y)^2),
    nachylenie = unname(coef(glm(d$y ~ logit(pp), family = binomial))[2]),
    wyraz_wolny = unname(coef(glm(d$y ~ offset(logit(pp)), family = binomial))[1]))
}) |> round(3)

p2 <- ggplot(tab, aes(100 * przewidywane, 100 * obserwowane, colour = model, shape = model)) +
  geom_abline(slope = 1, intercept = 0, linetype = "22", colour = "grey40") +
  geom_errorbar(aes(ymin = 100 * dolna, ymax = 100 * gorna), width = 0, alpha = 0.6) +
  geom_line(linewidth = 0.7) + geom_point(size = 3) +
  scale_colour_manual(values = kol[1:2], name = NULL) + scale_shape_manual(values = ksztalt[1:2], name = NULL) +
  facet_wrap(~ model) +
  coord_equal(xlim = c(0, 50), ylim = c(0, 50)) +
  labs(x = "Przewidywane ryzyko odejścia (%, średnia w decylu)", y = "Odeszło naprawdę (%, z 95% CI)",
       title = "Kalibracja: przewidywane ryzyko a odsetek odejść",
       subtitle = "Zbiór testowy, decyle ryzyka po 400 klientów; linia przerywana = idealna zgodność") +
  motyw + theme(legend.position = "none")
p2   # zapis: ggsave("churn-kalibracja.svg", p2, width = 10, height = 5.6)
Wynik w R
                model grupa przewidywane obserwowane
 Regresja logistyczna     1         35.1        33.2
 Regresja logistyczna     2         21.7        22.8
 Regresja logistyczna     3         16.3        14.2
 Regresja logistyczna     4         13.0        13.5
 Regresja logistyczna     5         10.4         9.5
 Regresja logistyczna     6          8.3         6.8
 Regresja logistyczna     7          6.6         6.5
 Regresja logistyczna     8          5.0         6.0
 Regresja logistyczna     9          3.6         4.8
 Regresja logistyczna    10          2.1         1.8
           Las losowy     1         41.1        33.0
           Las losowy     2         26.2        20.0
           Las losowy     3         19.0        15.2
           Las losowy     4         13.8        12.0
           Las losowy     5         10.4        10.0
           Las losowy     6          8.0         9.5
           Las losowy     7          5.9         6.5
           Las losowy     8          4.1         5.8
           Las losowy     9          2.7         4.0
           Las losowy    10          1.3         3.0
               Las losowy Regresja logistyczna
srednie_ryzyko      0.132                0.122
odsetek_odejsc      0.119                0.119
Brier               0.098                0.096
nachylenie          0.734                0.969
wyraz_wolny        -0.139               -0.031
4. Macierz decyzji i próg z kosztów: Rysunek 3
R
# Przepis 4. Macierz decyzji kampanii retencyjnej: koszt lub zysk w każdej komórce (grafika z prostokątów i tekstu)
# (korzysta z test i p_rl z przepisów 1–2)
library(ggplot2)

# Parametry kampanii ustalone ręcznie (przykład, nie dane rynkowe):
c_kontakt <- 10    # koszt telefonu konsultanta (zł na kontaktowanego klienta)
d_rabat   <- 60    # koszt oferty: rabat na 6 miesięcy (zł), płacony, gdy klient zostaje
V         <- 600   # marża z klienta, który zostaje na kolejne 12 miesięcy (zł)
s         <- 0.30  # skuteczność oferty: odsetek odchodzących, których kontakt zatrzyma

# Zysk z kontaktu na klienta w dwóch komórkach (brak kontaktu = 0 zł, punkt odniesienia)
zysk_odchodzacy <- s * (V - d_rabat) - c_kontakt   # 30% zostaje (marża minus rabat), każdemu płacimy za telefon
zysk_zostajacy  <- -c_kontakt - d_rabat            # i tak by został, a dostał rabat
prog_teoria <- (c_kontakt + d_rabat) / (s * (V - d_rabat) + d_rabat)   # kontakt opłaca się, gdy ryzyko > próg
c(zysk_odchodzacy = zysk_odchodzacy, zysk_zostajacy = zysk_zostajacy, prog = round(prog_teoria, 3))

# Liczby klientów testowych w komórkach przy progu teoretycznym (regresja logistyczna)
kontakt <- test$p_rl >= prog_teoria
m <- table(decyzja = factor(ifelse(kontakt, "kontakt", "brak kontaktu"), c("kontakt", "brak kontaktu")),
           wynik = factor(ifelse(test$odejdzie == 1, "odszedłby", "zostałby"), c("odszedłby", "zostałby")))
m
c(zysk_kampanii = sum(kontakt * ifelse(test$odejdzie == 1, zysk_odchodzacy, zysk_zostajacy)),
  kontaktowani_proc = round(100 * mean(kontakt), 1))

komorki <- data.frame(x = c(1, 2, 1, 2), y = c(2, 2, 1, 1),
  tytul = c("Kontakt · odszedłby", "Kontakt · zostałby", "Bez kontaktu · odszedłby", "Bez kontaktu · zostałby"),
  wzor = c(sprintf("s × (V − rabat) − kontakt\n= %.2f × (%d − %d) − %d = %+d zł", s, V, d_rabat, c_kontakt, zysk_odchodzacy),
           sprintf("− kontakt − rabat\n= −%d − %d = −%d zł", c_kontakt, d_rabat, -zysk_zostajacy),
           "0 zł (punkt odniesienia)\nklient odchodzi, marża stracona",
           "0 zł\nnic nie robimy, klient zostaje"),
  liczba = sprintf("%d klientów", c(m[1, 1], m[1, 2], m[2, 1], m[2, 2])),
  rola = c("zysk", "strata", "zero", "zero"))
p4 <- ggplot(komorki) +
  geom_tile(aes(x, y, fill = rola), width = 0.96, height = 0.92, colour = "grey60") +
  geom_text(aes(x - 0.44, y + 0.32, label = tytul), hjust = 0, fontface = "bold", size = 5.2, colour = "#0f1d3a") +
  geom_text(aes(x - 0.44, y + 0.05, label = wzor), hjust = 0, size = 4.5, lineheight = 1.05, colour = "grey15") +
  geom_text(aes(x - 0.44, y - 0.3, label = liczba), hjust = 0, size = 4.6, fontface = "italic", colour = "#0f1d3a") +
  annotate("text", x = c(1, 2), y = 2.6, label = c("Klient odszedłby bez kontaktu", "Klient zostałby i tak"),
           fontface = "bold", size = 4.8, colour = "grey25") +
  annotate("text", x = 0.42, y = c(2, 1), label = c("Kontakt", "Bez kontaktu"), angle = 90,
           fontface = "bold", size = 4.8, colour = "grey25") +
  scale_fill_manual(values = c(zysk = "#cfe3f2", strata = "#f7dcc8", zero = "grey95"), guide = "none") +
  coord_cartesian(xlim = c(0.35, 2.5), ylim = c(0.5, 2.7), expand = FALSE) +
  labs(title = "Macierz decyzji: co daje telefon z ofertą?",
       subtitle = sprintf("Liczby: zbiór testowy (4000 klientów), kontakt, gdy ryzyko z regresji logistycznej ≥ %.3f", prog_teoria)) +
  theme_void(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a"), plot.subtitle = element_text(colour = "grey30"),
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
p4   # zapis: ggsave("churn-macierz-decyzji.svg", p4, width = 10, height = 6)
Wynik w R
zysk_odchodzacy  zysk_zostajacy            prog
        152.000         -70.000           0.315
               wynik
decyzja         odszedłby zostałby
  kontakt              87      124
  brak kontaktu       389     3400
    zysk_kampanii kontaktowani_proc
           4544.0               5.3
5. Krzywa zysku i wrażliwość na skuteczność oferty: Rysunek 4
R
# Przepis 5. Krzywa zysku kampanii w funkcji progu ryzyka (zbiór testowy)
# (korzysta z test, p_rl, p_las, kol, ksztalt, motyw z przepisów 1–2 oraz parametrów z przepisu 4)
library(ggplot2)
library(patchwork)

zysk <- function(p, y, prog, s) {                 # zysk kampanii (zł) przy kontakcie z ryzykiem >= prog
  k <- p >= prog
  sum(k * ifelse(y == 1, s * (V - d_rabat) - c_kontakt, -c_kontakt - d_rabat))
}
progi <- seq(0.05, 0.70, by = 0.005)
krzywa <- function(p, nazwa, s_ = s) data.frame(model = nazwa, s = s_, prog = progi,
  zysk = sapply(progi, function(t) zysk(p, test$odejdzie, t, s_)),
  kontakt = sapply(progi, function(t) mean(p >= t)))
kz <- rbind(krzywa(test$p_rl, "Regresja logistyczna"), krzywa(test$p_las, "Las losowy"))
kz$model <- factor(kz$model, names(kol)[1:2])
naj <- do.call(rbind, lapply(split(kz, kz$model), function(d) d[which.max(d$zysk), ]))
print(transform(naj, kontakt = round(100 * kontakt, 1)), row.names = FALSE)
# Dla porównania: kontakt ze wszystkimi, próg 0.5 i próg teoretyczny
c(wszyscy = zysk(test$p_rl, test$odejdzie, 0, s), prog_0.5_rl = zysk(test$p_rl, test$odejdzie, 0.5, s),
  prog_teoria_rl = zysk(test$p_rl, test$odejdzie, prog_teoria, s),
  prog_teoria_las = zysk(test$p_las, test$odejdzie, prog_teoria, s))

# Wrażliwość: skuteczność oferty 15%, 30% i 45% (regresja logistyczna)
wr <- do.call(rbind, lapply(c(0.15, 0.30, 0.45), function(si) krzywa(test$p_rl, "Regresja logistyczna", si)))
wr$skutecznosc <- factor(sprintf("skuteczność %d%%", round(100 * wr$s)))
naj_wr <- do.call(rbind, lapply(split(wr, wr$skutecznosc), function(d) d[which.max(d$zysk), ]))
print(transform(naj_wr[c("skutecznosc", "prog", "zysk", "kontakt")], kontakt = round(100 * kontakt, 1)),
      row.names = FALSE)
round(sapply(c(0.15, 0.30, 0.45), function(si) (c_kontakt + d_rabat) / (si * (V - d_rabat) + d_rabat)), 3)

pa <- ggplot(kz, aes(prog, zysk / 1000, colour = model, linetype = model)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_vline(xintercept = prog_teoria, linetype = "22", colour = "grey40") +
  geom_line(linewidth = 0.9) +
  geom_point(data = naj, aes(shape = model), size = 3.5) +
  annotate("text", x = prog_teoria + 0.01, y = -24, hjust = 0, vjust = 0, size = 3.8,
           label = sprintf("próg z kosztów: %.3f", prog_teoria), colour = "grey30") +
  scale_colour_manual(values = kol[1:2], name = NULL) + scale_shape_manual(values = ksztalt[1:2], name = NULL) +
  scale_linetype_manual(values = c("solid", "42"), name = NULL) +
  coord_cartesian(ylim = c(-25, 16)) +                         # oś przycięta: przy niskich progach strata rośnie
  labs(x = "Próg ryzyka: dzwonimy, gdy przewidywane ryzyko ≥ próg", y = "Zysk kampanii (tys. zł)",
       title = "A. Zysk a próg", subtitle = "Skuteczność oferty 30%; punkt = najwyższy zysk") + motyw
pb <- ggplot(wr, aes(prog, zysk / 1000, colour = skutecznosc, linetype = skutecznosc)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_line(linewidth = 0.9) +
  geom_point(data = naj_wr, size = 3) +
  scale_colour_manual(values = c("#56B4E9", "#0072B2", "#0f1d3a"), name = NULL) +
  scale_linetype_manual(values = c("22", "solid", "42"), name = NULL) +
  coord_cartesian(ylim = c(-25, 16)) +
  labs(x = "Próg ryzyka", y = "Zysk kampanii (tys. zł)", title = "B. Gdy oferta działa słabiej lub lepiej",
       subtitle = "Regresja logistyczna") + motyw +
  guides(colour = guide_legend(nrow = 2))
p3 <- pa + pb & theme(legend.position = "bottom")
p3   # zapis: ggsave("churn-krzywa-zysku.svg", p3, width = 10, height = 5.8)
Wynik w R
                model   s  prog zysk kontakt
 Regresja logistyczna 0.3 0.315 4544     5.3
           Las losowy 0.3 0.430 4220     3.2
        wszyscy     prog_0.5_rl  prog_teoria_rl prog_teoria_las
        -174328            1814            4544            1980
     skutecznosc  prog  zysk kontakt
 skuteczność 15% 0.525   503     0.5
 skuteczność 30% 0.315  4544     5.3
 skuteczność 45% 0.205 14423    16.6
[1] 0.496 0.315 0.231
6. Przeciek danych z przyszłości: Rysunek 5
R
# Przepis 6. Pułapka: przeciek danych z przyszłości (prośba o przeniesienie numeru)
# (korzysta z train, test, predyktory, rl, auc(), gain-u z przepisów 1–2, zysk() z przepisu 5 i parametrów z przepisu 4)
library(ggplot2)
library(patchwork)

rl_przeciek <- glm(reformulate(c(predyktory, "prosba_przeniesienia"), "odejdzie"), family = binomial, data = train)
round(exp(coef(rl_przeciek))["prosba_przeniesienia"], 1)
# Wdrożenie: 31 marca nikt jeszcze nie złożył prośby – w danych do prognozy zmienna wynosi 0 u wszystkich
wdrozenie <- transform(test, prosba_przeniesienia = 0)
p_test <- predict(rl_przeciek, test, type = "response")
p_wdr  <- predict(rl_przeciek, wdrozenie, type = "response")
gain10 <- function(p, y) sum(y[order(p, decreasing = TRUE)][1:(length(y) / 10)]) / sum(y)
ocena <- function(p, nazwa) data.frame(sytuacja = nazwa, AUC = auc(p, test$odejdzie),
  gain_10 = 100 * gain10(p, test$odejdzie), srednie_ryzyko = 100 * mean(p),
  kontaktowani = 100 * mean(p >= prog_teoria), zysk = zysk(p, test$odejdzie, prog_teoria, s))
wyn <- rbind(ocena(test$p_rl, "Bez przecieku"), ocena(p_test, "Z przeciekiem: test"),
             ocena(p_wdr, "Z przeciekiem: wdrożenie"))
print(transform(wyn, AUC = round(AUC, 3), gain_10 = round(gain_10, 1), srednie_ryzyko = round(srednie_ryzyko, 1),
                kontaktowani = round(kontaktowani, 1)), row.names = FALSE)

# A. Oś czasu: co wolno wiedzieć w dniu prognozy (grafika)
pa <- ggplot() +
  annotate("rect", xmin = 0, xmax = 3, ymin = 0.2, ymax = 1, fill = "#cfe3f2", colour = "grey60") +
  annotate("rect", xmin = 3, xmax = 6, ymin = 0.2, ymax = 1, fill = "#f7dcc8", colour = "grey60") +
  annotate("segment", x = 3, xend = 3, y = 0, yend = 1.25, linewidth = 1.1, colour = "#0f1d3a") +
  annotate("text", x = 3, y = 1.38, label = "31 marca: dzień prognozy", fontface = "bold", size = 4.6, colour = "#0f1d3a") +
  annotate("text", x = 1.5, y = 0.6, size = 4.2, lineheight = 1.05, colour = "grey15",
           label = "Styczeń–marzec: wolno użyć\nstaż, umowa, zgłoszenia, rachunek,\nzmiana korzystania, płatności") +
  annotate("text", x = 4.5, y = 0.6, size = 4.2, lineheight = 1.05, colour = "grey15",
           label = "Kwiecień–czerwiec: wynik\nodejście (0/1) oraz prośba\no przeniesienie numeru = PRZECIEK") +
  coord_cartesian(xlim = c(-0.05, 6.05), ylim = c(0, 1.5), expand = FALSE) +
  labs(title = "A. Co wiadomo w dniu prognozy?") + theme_void(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a"))
# B. Ocena trzech sytuacji
dl <- rbind(data.frame(sytuacja = wyn$sytuacja, miara = "AUC", wartosc = wyn$AUC, etykieta = sprintf("%.3f", wyn$AUC)),
            data.frame(sytuacja = wyn$sytuacja, miara = "Zysk kampanii (tys. zł)", wartosc = wyn$zysk / 1000,
                       etykieta = sprintf("%.1f", wyn$zysk / 1000)))
dl$sytuacja <- factor(dl$sytuacja, wyn$sytuacja)
pb <- ggplot(dl, aes(sytuacja, wartosc, fill = sytuacja)) +
  geom_col(width = 0.65) + geom_text(aes(label = etykieta), vjust = -0.4, size = 4.2) +
  facet_wrap(~ miara, scales = "free_y") +
  scale_y_continuous(expand = expansion(mult = c(0, 0.15))) +
  scale_fill_manual(values = c("#0072B2", "#D55E00", "#999999"), guide = "none") +
  scale_x_discrete(labels = function(x) sub(": ", ":\n", x)) +
  labs(x = NULL, y = NULL, title = "B. Model z przeciekiem świetny w teście, bezużyteczny we wdrożeniu",
       subtitle = sprintf("Regresja logistyczna, zbiór testowy; zysk przy progu %.3f", prog_teoria)) +
  motyw + theme(axis.text.x = element_text(size = rel(0.85), lineheight = 0.9))
p5 <- pa / pb + plot_layout(heights = c(1, 1.6))
p5   # zapis: ggsave("churn-przeciek-danych.svg", p5, width = 10, height = 7.4)
Wynik w R
prosba_przeniesienia
               132.3
                 sytuacja   AUC gain_10 srednie_ryzyko kontaktowani  zysk
            Bez przecieku 0.732    27.9           12.2          5.3  4544
      Z przeciekiem: test 0.892    67.2           11.7          8.9 43608
 Z przeciekiem: wdrożenie 0.733    28.6            4.9          0.2   632
7. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Przepis 7. Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("regresja – las" = c("#0072B2", "#D55E00"), "regresja – model idealny" = c("#0072B2", "#009E73"),
             "las – model idealny" = c("#D55E00", "#009E73"), "las – losowy wybór" = c("#D55E00", "#8C8C8C"),
             "przeciek: test – wdrożenie" = c("#D55E00", "#999999"), "skuteczność 15% – 30%" = c("#56B4E9", "#0072B2"),
             "komórka zysku – straty" = c("#cfe3f2", "#f7dcc8"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
regresja – las                             114.6        108.3       91.9
regresja – model idealny                    70.1         55.4       58.0
las – model idealny                        102.4         53.5       37.3
las – losowy wybór                          76.8         62.6       54.8
przeciek: test – wdrożenie                  77.2         62.9       56.0
skuteczność 15% – 30%                       26.4         24.7       24.6
komórka zysku – straty                      24.8         24.8       20.8
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, regresja logistyczna (glm()) i przedziały Wilsona (prop.test()) – pakiet stats z podstawowej instalacji R; las losowy – pakiet ranger. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ranger (wersja 0.18.0): Wright, M. N., & Ziegler, A. (2017). ranger: A fast implementation of random forests for high dimensional data in C++ and R. Journal of Statistical Software, 77(1), 1–17. https://doi.org/10.18637/jss.v077.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Przeciek z przyszłości. Zmienna zarejestrowana po dniu prognozy podniosła AUC z .732 do .892, a we wdrożeniu model prawie nikogo nie wskazał (rysunek 5).
- Ocena na zbiorze uczącym. Trafność liczona na tych samych danych, na których model się uczył, jest zawyżona – to przeuczenie. Zbiór testowy odłóż na początku.
- Trafność zamiast zysku. Przy 11.9% odejść model „nikt nie odejdzie” ma 88.1% trafnych klasyfikacji i zero wartości. Patrz na gain, kalibrację i krzywą zysku.
- Zbalansowanie klas bez korekty. Lemmens i Croux (2006) zalecają przy rzadkim zdarzeniu próbę zbalansowaną, ale z korektą obciążenia; bez niej przewidywane ryzyko jest zawyżone, a próg z kosztów przestaje działać.
Najczęstsze pytania
Czym różni się model przewidywania odejść od analizy przeżycia?
Model odejść (np. regresja logistyczna) odpowiada na pytanie, kto odejdzie w ustalonym oknie, np. w najbliższym kwartale, i daje ryzyko do wyboru adresatów kampanii. Analiza przeżycia odpowiada na pytanie, kiedy klient odejdzie, i uwzględnia klientów wciąż aktywnych – zob. churn jako analiza przeżycia.
Czy las losowy jest lepszy od regresji logistycznej w przewidywaniu churnu?
Nie zawsze. W przykładzie las miał AUC = .718, a regresja .732, i był gorzej skalibrowany (nachylenie 0.73 wobec 0.97), więc dał mniejszy zysk przy progu z kosztów. Porównuj modele na zbiorze testowym: gain, kalibracja i zysk kampanii, nie tylko AUC.
Jak wybrać próg ryzyka do kampanii retencyjnej?
Policz go z kosztów: (koszt kontaktu + rabat) / (skuteczność × (marża − rabat) + rabat). Przy 10 zł, 60 zł, 600 zł i skuteczności 30% wychodzi 0.315. Potem sprawdź krzywą zysku. Wzór działa tylko dla dobrze skalibrowanego modelu, a próg 0.5 nie ma uzasadnienia.
Co to jest przeciek danych w modelu churn?
To zmienna, której nie da się znać w dniu prognozy, np. prośba o przeniesienie numeru złożona już w okresie odejścia. W przykładzie podniosła AUC z .732 do .892, a we wdrożeniu model wskazał tylko 0.2% klientów. Każdy predyktor musi mieć datę sprzed dnia prognozy.
Czy klientom z najwyższym ryzykiem odejścia warto dawać rabat?
Niekoniecznie. Model pokazuje, kto odejdzie, a nie kogo oferta zatrzyma; klient z najwyższym ryzykiem może być już zdecydowany. Skuteczność oferty zmierz w teście A/B z grupą kontrolną, a adresatów wybieraj modelem uplift (modelowanie uplift).
Powiązane hasła
Przeczytaj też
Churn jako analiza przeżycia
Aplikacja z abonamentem, 2400 klientów: cenzurowanie, Kaplan–Meier według planu, hazard w czasie i model Coxa z okresami – pięć rysunków z kodem R.
Czytaj →PoradnikModelowanie uplift: komu wysłać kupon
Przekonywalni, pewniacy i „nie przeszkadzać”: T-learner, las przyczynowy, krzywa Qini i zysk kampanii na przykładzie sklepu z grami, z kodem R.
Czytaj →PoradnikModele predykcyjne: walidacja i kalibracja
Liczebność, przeuczenie, walidacja krzyżowa i bootstrap, LASSO i ridge, kalibracja, wynik Briera i TRIPOD+AI – na danych do pobrania, z kodem R.
Czytaj →PoradnikOdzyskiwanie klientów (win-back)
Serwis treningowy: eksperyment 3 grup, przyrost powrotów, Kaplan–Meier i Cox, pułapka selekcji wśród powracających i wartość na osobę – kod R.
Czytaj →Budujesz model odejść klientów do pracy z marketingu?
Pomożemy przygotować dane bez przecieku, porównać modele, ocenić kalibrację, policzyć zysk kampanii i opisać wyniki – tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Ascarza, E. (2018). Retention futility: Targeting high-risk customers might be ineffective. Journal of Marketing Research, 55(1), 80–98. https://doi.org/10.1509/jmr.16.0163 ● Otwarty dostęp: pełny tekst
- Breiman, L. (2001). Random forests. Machine Learning, 45(1), 5–32. https://doi.org/10.1023/a:1010933404324 ● Otwarty dostęp: pełny tekst
- Christodoulou, E., Ma, J., Collins, G. S., Steyerberg, E. W., Verbakel, J. Y., & Van Calster, B. (2019). A systematic review shows no performance benefit of machine learning over logistic regression for clinical prediction models. Journal of Clinical Epidemiology, 110, 12–22. https://doi.org/10.1016/j.jclinepi.2019.02.004 ● Otwarty dostęp: pełny tekst
- Kaufman, S., Rosset, S., Perlich, C., & Stitelman, O. (2012). Leakage in data mining: Formulation, detection, and avoidance. ACM Transactions on Knowledge Discovery from Data, 6(4), 1–21. https://doi.org/10.1145/2382577.2382579
- Lemmens, A., & Croux, C. (2006). Bagging and boosting classification trees to predict churn. Journal of Marketing Research, 43(2), 276–286. https://doi.org/10.1509/jmkr.43.2.276 ● Otwarty dostęp: pełny tekst
- Neslin, S. A., Gupta, S., Kamakura, W., Lu, J., & Mason, C. H. (2006). Defection detection: Measuring and understanding the predictive accuracy of customer churn models. Journal of Marketing Research, 43(2), 204–211. https://doi.org/10.1509/jmkr.43.2.204
- Steyerberg, E. W., Vickers, A. J., Cook, N. R., Gerds, T., Gonen, M., Obuchowski, N., Pencina, M. J., & Kattan, M. W. (2010). Assessing the performance of prediction models: A framework for traditional and novel measures. Epidemiology, 21(1), 128–138. https://doi.org/10.1097/ede.0b013e3181c30fb2 ● Otwarty dostęp: pełny tekst
- Vuk, M., & Curk, T. (2006). ROC curve, lift chart and calibration plot. Advances in Methodology and Statistics, 3(1). https://doi.org/10.51936/noqf3710 ● Otwarty dostęp
Cytowania BibTeX
@article{ascarza2018retention, author={Ascarza, Eva}, title={{Retention futility: Targeting high-risk customers might be ineffective}}, journal={Journal of Marketing Research}, year={2018}, volume={55}, number={1}, pages={80--98}, doi={10.1509/jmr.16.0163}}@article{breiman2001random, author={Breiman, Leo}, title={{Random forests}}, journal={Machine Learning}, year={2001}, volume={45}, number={1}, pages={5--32}, doi={10.1023/a:1010933404324}}@article{christodoulou2019systematic, author={Christodoulou, Evangelia and Ma, Jie and Collins, Gary S. and Steyerberg, Ewout W. and Verbakel, Jan Y. and Van Calster, Ben}, title={{A systematic review shows no performance benefit of machine learning over logistic regression for clinical prediction models}}, journal={Journal of Clinical Epidemiology}, year={2019}, volume={110}, pages={12--22}, doi={10.1016/j.jclinepi.2019.02.004}}@article{kaufman2012leakage, author={Kaufman, Shachar and Rosset, Saharon and Perlich, Claudia and Stitelman, Ori}, title={{Leakage in data mining: Formulation, detection, and avoidance}}, journal={ACM Transactions on Knowledge Discovery from Data}, year={2012}, volume={6}, number={4}, pages={1--21}, doi={10.1145/2382577.2382579}}@article{lemmens2006bagging, author={Lemmens, Aurélie and Croux, Christophe}, title={{Bagging and boosting classification trees to predict churn}}, journal={Journal of Marketing Research}, year={2006}, volume={43}, number={2}, pages={276--286}, doi={10.1509/jmkr.43.2.276}}@article{neslin2006defection, author={Neslin, Scott A. and Gupta, Sunil and Kamakura, Wagner and Lu, Junxiang and Mason, Charlotte H.}, title={{Defection detection: Measuring and understanding the predictive accuracy of customer churn models}}, journal={Journal of Marketing Research}, year={2006}, volume={43}, number={2}, pages={204--211}, doi={10.1509/jmkr.43.2.204}}@article{steyerberg2010assessing, author={Steyerberg, Ewout W. and Vickers, Andrew J. and Cook, Nancy R. and Gerds, Thomas and Gonen, Mithat and Obuchowski, Nancy and Pencina, Michael J. and Kattan, Michael W.}, title={{Assessing the performance of prediction models: A framework for traditional and novel measures}}, journal={Epidemiology}, year={2010}, volume={21}, number={1}, pages={128--138}, doi={10.1097/ede.0b013e3181c30fb2}}@article{vuk2006roc, author={Vuk, Miha and Curk, Tomaž}, title={{ROC curve, lift chart and calibration plot}}, journal={Advances in Methodology and Statistics}, year={2006}, volume={3}, number={1}, doi={10.51936/noqf3710}}