Co to jest nierównowaga klas?
Nierównowaga klas (ang. class imbalance) oznacza, że w zmiennej wynikowej jedna kategoria występuje dużo rzadziej niż druga – np. zdarzenie u 5% badanych. Model przewidujący zawsze klasę częstą ma wtedy 95% trafności, choć nie rozpoznaje nikogo z klasy rzadkiej. Stąd popularne „korekty”:
- SMOTE (Synthetic Minority Over-sampling Technique) – tworzy syntetyczne przypadki klasy rzadkiej przez interpolację między obserwacją a jej najbliższymi sąsiadami z tej samej klasy; Chawla i in. (2002) pokazali, że połączenie SMOTE z podpróbkowaniem klasy częstej daje lepsze wyniki w przestrzeni ROC niż samo podpróbkowanie;
- wagi klas – obserwacje klasy rzadkiej dostają większą wagę w funkcji straty;
- przesunięcie progu decyzji – model zostaje bez zmian, a przypadek klasyfikuje się jako zdarzenie już przy prawdopodobieństwie np. 0.05 zamiast 0.5.
Van den Goorbergh i in. (2022) pokazali w symulacjach z regresją logistyczną, że podpróbkowanie, nadpróbkowanie i SMOTE nie podnoszą AUC, za to silnie zawyżają przewidywane prawdopodobieństwo klasy rzadkiej. Korekty poprawiały równowagę czułości i swoistości, ale podobny efekt dawało samo przesunięcie progu.
Przykład
W symulowanych danych 6000 osób zdarzenie wystąpiło u 4.7% zbioru uczącego. Na zbiorze testowym (odsetek 4.0%) wszystkie trzy modele miały praktycznie to samo pole pod krzywą ROC (0.827–0.828). Model bez korekty przy progu 0.5 wykrył tylko 5.0% zdarzeń, ale jego średnie przewidywane ryzyko (0.045) zgadzało się z rzeczywistością. Wagi i SMOTE dały przy progu 0.5 czułość 0.752, lecz średnie ryzyko 0.350 i 0.343 – prawie dziewięć razy za dużo. Ten sam model bez korekty z progiem 0.05 osiągnął czułość 0.736 i swoistość 0.758.
Na rysunku
Oba rysunki używają danych i modeli z przykładu (ziarno 688, nie dobierane) i pokazują zbiór testowy: 3000 osób, w tym 121 ze zdarzeniem. SMOTE pominięto, bo dał prawie to samo co wagi.
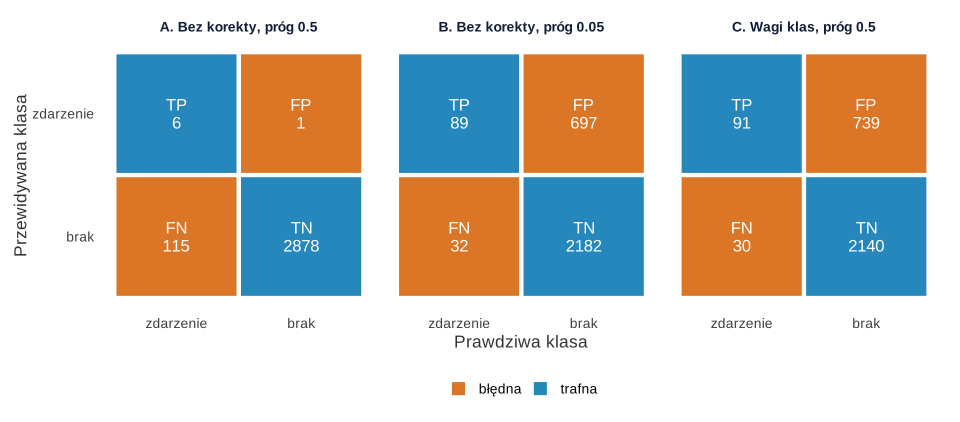
Co widać. Przy progu 0.5 model bez korekty wykrywa 6 ze 121 zdarzeń (panel A). Obniżenie progu do 0.05 (B) i wagi klas przy progu 0.5 (C) dają prawie tę samą macierz pomyłek: 89 i 91 wykrytych zdarzeń. Wagi działają więc w praktyce jak przesunięcie progu.
Na co uważać. Macierz zależy od jednego progu. W panelach B i C na 89–91 trafnych alarmów przypada 697–739 fałszywych, więc przy rzadkim zdarzeniu większość alarmów jest fałszywa. Pełniejszy obraz dla wszystkich progów daje krzywa precyzja–czułość.
Podpis do pracy:
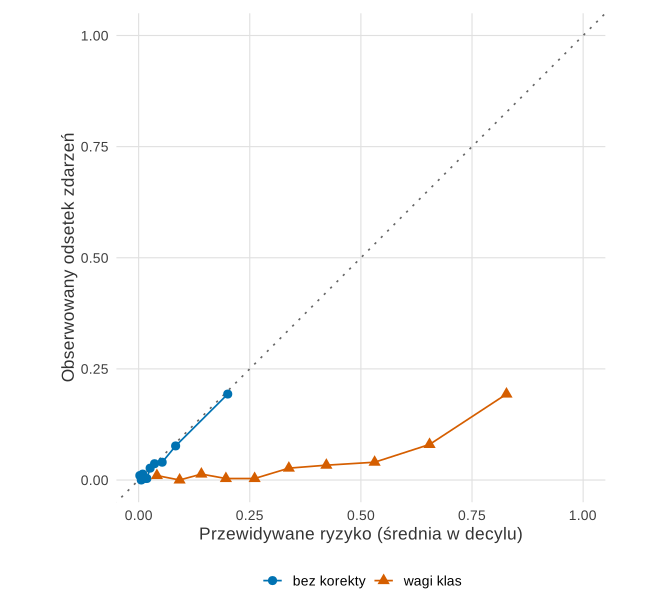
Co widać. Model bez korekty leży na przekątnej: średnie przewidywane ryzyko 0.045 przy obserwowanym 0.040. Model z wagami przewiduje średnio 0.350, a w najwyższym decylu 0.828, choć obserwowany odsetek zdarzeń wyniósł tam 0.193. Kolejność osób jest ta sama (AUC się nie zmienia), ale liczby ryzyka są zawyżone.
Na co uważać. W pięciu najniższych decylach (po 300 osób) było od 0 do 4 zdarzeń, a w najwyższym 58, więc punkty przy zerze są bardzo niepewne. Szerzej o tym wykresie w haśle kalibracja modelu.
Podpis do pracy:
Kod poniżej odtwarza oba rysunki i liczby; paletę Okabe–Ito i motyw definiuje sam. Rysunki na stronie powstały z tych samych obiektów p1 i p2 z motywem serwisu (inny krój czcionki i siatka).
Kod R rysunków 1–2
# Rysunki 1–2. Macierze pomyłek przy progu 0.5 i 0.05 oraz wpływ wag klas na kalibrację
library(ggplot2)

kol <- c("trafna" = "#0072B2", "błędna" = "#D55E00")    # Okabe–Ito; typ komórki opisuje też etykieta
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold", size = rel(0.95)))

# Dane i modele z przykładu w haśle (to samo ziarno i te same losowania)
set.seed(688)
n <- 6000
d <- data.frame(x1 = rnorm(n), x2 = rnorm(n), x3 = rnorm(n))
d$y <- rbinom(n, 1, plogis(-3.6 + 1.0 * d$x1 + 0.7 * d$x2 + 0.4 * d$x3))
ucz <- d[1:3000, ]; test <- d[3001:6000, ]
f <- y ~ x1 + x2 + x3
m_brak <- glm(f, binomial, data = ucz)                            # bez korekty
w <- ifelse(ucz$y == 1, sum(ucz$y == 0) / sum(ucz$y == 1), 1)    # wagi klas
m_wagi <- suppressWarnings(glm(f, binomial, data = ucz, weights = w))
p_brak <- predict(m_brak, test, type = "response")
p_wagi <- predict(m_wagi, test, type = "response")
table(test$y)                                          # zbiór testowy: 0 = brak zdarzenia, 1 = zdarzenie

# Rysunek 1: macierze pomyłek w zbiorze testowym (n = 3000)
macierz <- function(p, prog, nazwa) {
  pred <- factor(ifelse(p >= prog, "zdarzenie", "brak"), c("zdarzenie", "brak"))
  prawda <- factor(ifelse(test$y == 1, "zdarzenie", "brak"), c("zdarzenie", "brak"))
  tb <- as.data.frame(table(przewidywana = pred, prawdziwa = prawda))
  tb$typ <- ifelse(tb$przewidywana == tb$prawdziwa, "trafna", "błędna")
  tb$etykieta <- c("TP", "FN", "FP", "TN")[match(paste(tb$przewidywana, tb$prawdziwa),
                  c("zdarzenie zdarzenie", "brak zdarzenie", "zdarzenie brak", "brak brak"))]
  tb$model <- nazwa
  tb
}
mp <- rbind(macierz(p_brak, 0.5, "A. Bez korekty, próg 0.5"),
            macierz(p_brak, 0.05, "B. Bez korekty, próg 0.05"),
            macierz(p_wagi, 0.5, "C. Wagi klas, próg 0.5"))
print(reshape(mp[, c("model", "etykieta", "Freq")], idvar = "model", timevar = "etykieta", direction = "wide"),
      row.names = FALSE)
p1 <- ggplot(mp, aes(prawdziwa, przewidywana, fill = typ)) +
  geom_tile(colour = "white", linewidth = 1.5, alpha = 0.85) +
  geom_text(aes(label = paste0(etykieta, "\n", Freq)), colour = "white", size = 4.4, lineheight = 0.9) +
  facet_wrap(~ model, ncol = 3) +
  scale_fill_manual(NULL, values = kol) +
  scale_y_discrete(limits = c("brak", "zdarzenie")) +
  labs(x = "Prawdziwa klasa", y = "Przewidywana klasa") + motyw +
  theme(panel.grid.major = element_blank())

# Rysunek 2: kalibracja w decylach przewidywanego ryzyka – model bez korekty i z wagami
decyle <- function(p, nazwa) {
  g <- cut(p, quantile(p, 0:10 / 10), include.lowest = TRUE, labels = FALSE)
  data.frame(model = nazwa, przewid = tapply(p, g, mean), obserw = tapply(test$y, g, mean),
             zdarzen = tapply(test$y, g, sum))
}
kal <- rbind(decyle(p_brak, "bez korekty"), decyle(p_wagi, "wagi klas"))
round(c(sr_brak = mean(p_brak), sr_wagi = mean(p_wagi), obserw = mean(test$y),
        max_dec_brak = max(kal$przewid[kal$model == "bez korekty"]),
        max_dec_wagi = max(kal$przewid[kal$model == "wagi klas"]),
        obs_max_dec = max(kal$obserw)), 3)
kal$zdarzen[kal$model == "bez korekty"]               # liczba zdarzeń w decylach (po 300 osób)
p2 <- ggplot(kal, aes(przewid, obserw, colour = model, shape = model)) +
  geom_abline(slope = 1, intercept = 0, linetype = "dotted", colour = "grey40") +
  geom_line(linewidth = 0.6) + geom_point(size = 2.8) +
  scale_colour_manual(NULL, values = c("bez korekty" = "#0072B2", "wagi klas" = "#D55E00")) +
  scale_shape_manual(NULL, values = c("bez korekty" = 16, "wagi klas" = 17)) +
  coord_equal(xlim = c(0, 1), ylim = c(0, 1)) +
  labs(x = "Przewidywane ryzyko (średnia w decylu)", y = "Obserwowany odsetek zdarzeń") + motyw
p1
p2
Wynik w R
   0    1
2879  121
                     model Freq.TP Freq.FN Freq.FP Freq.TN
  A. Bez korekty, próg 0.5       6     115       1    2878
 B. Bez korekty, próg 0.05      89      32     697    2182
    C. Wagi klas, próg 0.5      91      30     739    2140
     sr_brak      sr_wagi       obserw max_dec_brak max_dec_wagi  obs_max_dec
       0.045        0.350        0.040        0.200        0.828        0.193
 [1]  3  0  4  1  1  8 11 12 23 58
Jak opisać w pracy
Na co uważać
- Nie oceniaj modelu samą trafnością. Pełny obraz daje macierz pomyłek, AUC i kalibracja.
- SMOTE stosuj tylko w zbiorze uczącym, wewnątrz każdej części walidacji krzyżowej – nigdy przed podziałem danych.
- Po korekcie prawdopodobieństwa wymagają ponownej kalibracji, jeśli mają trafić do pacjenta lub decydenta.
- Próg wybieraj z kosztów błędów, a nie domyślnie 0.5; ta sama zasada dotyczy gradient boostingu i innych klasyfikatorów.
Nierównowaga klas w R
Kod dopasowuje regresję logistyczną bez korekty, z wagami klas i po SMOTE (smotefamily::SMOTE()), a następnie porównuje na zbiorze testowym AUC, średnie przewidywane prawdopodobieństwo, czułość i swoistość. Liczby w tekście pochodzą z tego kodu.
Bez korekty, wagi, SMOTE i przesunięty próg
R
set.seed(688)                                        # dane symulowane: zdarzenie u ok. 5% osób
n <- 6000
d <- data.frame(x1 = rnorm(n), x2 = rnorm(n), x3 = rnorm(n))
d$y <- rbinom(n, 1, plogis(-3.6 + 1.0 * d$x1 + 0.7 * d$x2 + 0.4 * d$x3))
ucz <- d[1:3000, ]; test <- d[3001:6000, ]
cat("odsetek zdarzeń: uczący", round(mean(ucz$y), 3), "| testowy", round(mean(test$y), 3), "\n")
f <- y ~ x1 + x2 + x3
m_brak <- glm(f, binomial, data = ucz)                           # bez korekty
w <- ifelse(ucz$y == 1, sum(ucz$y == 0) / sum(ucz$y == 1), 1)  # wagi klas: zdarzenia ważą tyle co cała klasa 0
m_wagi <- suppressWarnings(glm(f, binomial, data = ucz, weights = w))
suppressPackageStartupMessages(library(smotefamily))
sm <- SMOTE(ucz[, c("x1", "x2", "x3")], ucz$y, K = 5)            # syntetyczne przypadki klasy rzadkiej
uczS <- sm$data; uczS$y <- as.numeric(uczS$class); uczS$class <- NULL
cat("po SMOTE: n =", nrow(uczS), "| odsetek zdarzeń", round(mean(uczS$y), 3), "\n")
m_smote <- glm(f, binomial, data = uczS)
auc <- function(p, y) { r <- rank(p); n1 <- sum(y); (sum(r[y == 1]) - n1 * (n1 + 1) / 2) / (n1 * sum(1 - y)) }
ocena <- function(p, prog) c(AUC = auc(p, test$y), sr_p = mean(p), obs = mean(test$y),
                              czulosc = mean(p[test$y == 1] >= prog), swoistosc = mean(p[test$y == 0] < prog))
p <- lapply(list(brak = m_brak, wagi = m_wagi, smote = m_smote), predict, newdata = test, type = "response")
tab <- rbind(brak_prog_0.5 = ocena(p$brak, 0.5), wagi_prog_0.5 = ocena(p$wagi, 0.5),
             smote_prog_0.5 = ocena(p$smote, 0.5), brak_prog_0.05 = ocena(p$brak, 0.05))
print(round(tab, 3))
Wynik w R
odsetek zdarzeń: uczący 0.047 | testowy 0.04
po SMOTE: n = 5679 | odsetek zdarzeń 0.497
                 AUC  sr_p  obs czulosc swoistosc
brak_prog_0.5  0.827 0.045 0.04   0.050     1.000
wagi_prog_0.5  0.827 0.350 0.04   0.752     0.743
smote_prog_0.5 0.828 0.343 0.04   0.752     0.748
brak_prog_0.05 0.827 0.045 0.04   0.736     0.758
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet smotefamily 1.4.0). Rysunki 1–2 wykonano w pakiecie ggplot2 i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- smotefamily (wersja 1.4.0): Siriseriwan, W. (2024). smotefamily: A collection of oversampling techniques for class imbalance problem based on SMOTE (R package version 1.4.0) [Computer software]. https://doi.org/10.32614/CRAN.package.smotefamily
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czy przy rzadkim zdarzeniu trzeba stosować SMOTE?
Nie. Sama nierównowaga nie jest problemem, jeśli model ma podawać prawdopodobieństwa. Van den Goorbergh i in. (2022) wykazali, że korekty nie poprawiły AUC, a pogorszyły kalibrację. Częstszym problemem jest za mała liczba zdarzeń względem liczby predyktorów.
Jak wybrać próg decyzji przy niezbalansowanych danych?
Na podstawie konsekwencji błędów: ile kosztuje przeoczenie zdarzenia, a ile fałszywy alarm. Prostym punktem wyjścia jest próg równy częstości zdarzenia; można też wybrać punkt na krzywej ROC zaplanowany przed analizą.
Czym różnią się wagi klas od SMOTE?
Wagi zmieniają wpływ istniejących obserwacji w funkcji straty, a SMOTE dopisuje nowe, sztuczne przypadki klasy rzadkiej. W przykładzie na tej stronie oba podejścia zawyżyły średnie przewidywane ryzyko w podobnym stopniu.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Modele predykcyjne: walidacja i kalibracja
Liczebność, przeuczenie, walidacja krzyżowa i bootstrap, LASSO i ridge, kalibracja, wynik Briera i TRIPOD+AI – na danych do pobrania, z kodem R.
Czytaj →PoradnikKrzywa ROC i punkt odcięcia krok po kroku
AUC z 95% CI, tabela progów, trzy reguły wyboru progu, czułość i swoistość z przedziałami oraz test DeLonga dla dwóch skal – w R z pakietem pROC.
Czytaj →PoradnikWykrywanie nadużyć przy rzadkich zdarzeniach
Ubezpieczyciel, 60 000 szkód i 200 kontroli miesięcznie: krzywe ROC i PR, macierz kosztów, wybór według zysku, SMOTE a kalibracja i etykiety z kontroli – pięć rysunków z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Chawla, N. V., Bowyer, K. W., Hall, L. O., & Kegelmeyer, W. P. (2002). SMOTE: Synthetic minority over-sampling technique. Journal of Artificial Intelligence Research, 16, 321–357. https://doi.org/10.1613/jair.953 ● Otwarty dostęp
- van den Goorbergh, R., van Smeden, M., Timmerman, D., & Van Calster, B. (2022). The harm of class imbalance corrections for risk prediction models: Illustration and simulation using logistic regression. Journal of the American Medical Informatics Association, 29(9), 1525–1534. https://doi.org/10.1093/jamia/ocac093 ● Otwarty dostęp
Cytowania BibTeX
@article{chawla2002smote, author={Chawla, Nitesh V. and Bowyer, Kevin W. and Hall, Lawrence O. and Kegelmeyer, W. Philip}, title={{SMOTE: Synthetic minority over-sampling technique}}, journal={Journal of Artificial Intelligence Research}, year={2002}, volume={16}, pages={321--357}, doi={10.1613/jair.953}}@article{vandengoorbergh2022harm, author={van den Goorbergh, Ruben and van Smeden, Maarten and Timmerman, Dirk and Van Calster, Ben}, title={{The harm of class imbalance corrections for risk prediction models: Illustration and simulation using logistic regression}}, journal={Journal of the American Medical Informatics Association}, year={2022}, volume={29}, number={9}, pages={1525--1534}, doi={10.1093/jamia/ocac093}}