Przykład: ubezpieczyciel i 60 000 szkód komunikacyjnych
Fikcyjny ubezpieczyciel komunikacyjny przyjmuje około 2500 zgłoszeń szkód miesięcznie. Dział likwidacji może dokładnie sprawdzić 200 szkód w miesiącu. Pytanie biznesowe brzmi: które 200 szkód sprawdzić, żeby kontrole dały jak najwięcej?
Mamy 24 miesiące, czyli 60 000 szkód. Przy każdej znamy cechy dostępne w dniu zgłoszenia: dni od zawarcia polisy, dni od zdarzenia do zgłoszenia, brak notatki policji i świadków, porę zdarzenia, wcześniejsze szkody klienta, wiek auta i kierowcy, warsztat powiązany z innymi podejrzanymi szkodami oraz żądaną kwotę. Wyłudzeniem okazało się 1.77% szkód. Mediana żądanej kwoty wyniosła 6010 zł w szkodach uczciwych i 7730 zł w wyłudzeniach.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Współczynniki prawdziwego modelu wyłudzenia ustawiliśmy ręcznie (m.in. szkoda w ciągu 30 dni od zawarcia polisy, brak świadków, warsztat powiązany, interakcja nowej polisy z brakiem świadków). Ręcznie ustaliliśmy też dawne reguły kontroli: szkody powyżej 25 000 zł, nocne bez policji i bez świadków oraz 1% losowo. Ziarna 639 ani parametrów nie zmienialiśmy po obejrzeniu wyników. Dane pobierzesz jako naduzycia-szkody-komunikacyjne.csv.
Modele uczymy na miesiącach 1–18, a oceniamy na miesiącach 19–24 (15 000 szkód, 270 wyłudzeń, 1.80%). Taki podział naśladuje wdrożenie (zob. prognoza upadłości firm i przeciek danych i walidacja w czasie).
Rysunek 1: trafność 98% i dwie krzywe
Reguła „nikt nie oszukuje” podejmuje trafną decyzję w 98.20% szkód testowych. Regresja logistyczna z progiem 0.5 ma trafność 98.19% i nie wskazuje ani jednego wyłudzenia, bo żadna szkoda nie ma przewidywanego ryzyka powyżej 50%. Przy rzadkim zdarzeniu trafność mierzy głównie to, jak rzadkie jest zdarzenie.
Dlatego patrzymy na dwie inne liczby z macierzy pomyłek. Czułość to odsetek wyłudzeń, które alarm wykrył (czułość i swoistość). Precyzja to odsetek alarmów trafnych, czyli wartość predykcyjna dodatnia. Porównujemy regresję logistyczną z lasem losowym (300 drzew, każde na próbie bootstrapowej; Breiman, 2001; więcej: drzewa decyzyjne i lasy losowe).
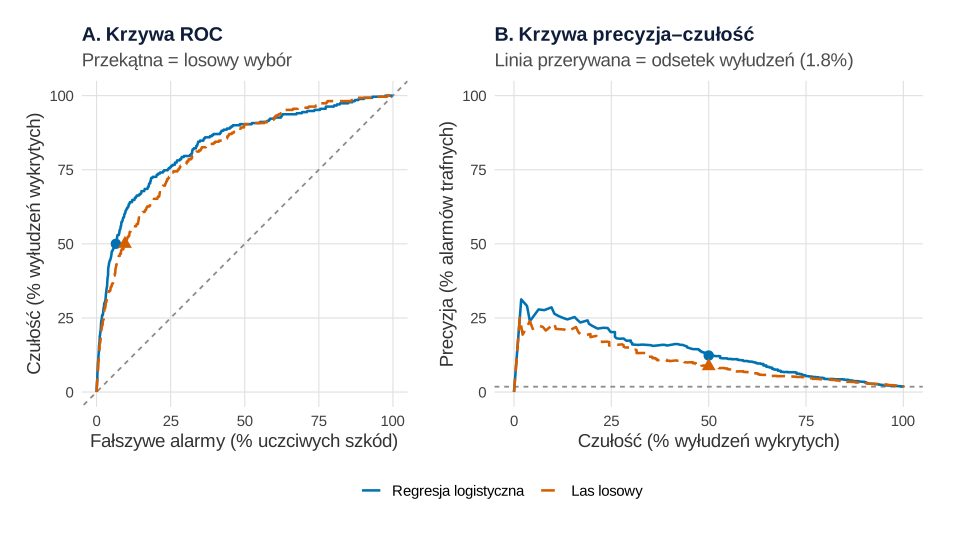
set.seed(639)).Co widać. Na krzywej ROC (panel A) oba modele wyglądają dobrze: AUC = .835 dla regresji i .814 dla lasu. Punkt na krzywej oznacza, że przy wykryciu połowy wyłudzeń regresja daje alarm w 6.5% uczciwych szkód. Na krzywej precyzja–czułość (panel B) ten sam punkt to precyzja 12.3%: na każde 100 alarmów tylko około 12 dotyczy wyłudzeń. Dla lasu precyzja wynosi 8.7%. Średnia precyzja (AP, pole pod krzywą PR) to .138 i .109, przy poziomie losowym .018.
Jak może zmylić. 6.5% fałszywych alarmów brzmi niewinnie, ale to 6.5% z 14 730 uczciwych szkód, czyli setki kontroli. Krzywa ROC tego nie pokazuje, bo nie zależy od częstości zdarzenia. Saito i Rehmsmeier (2015) pokazali, że przy silnie niezrównoważonych klasach wykres PR lepiej oddaje praktyczną skuteczność klasyfikatora. Las nie wygrał z regresją, co zgadza się z porównaniem technik wykrywania wyłudzeń w ubezpieczeniach komunikacyjnych, gdzie regresja logistyczna wypadała bardzo dobrze (Viaene i in., 2002).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: macierz decyzji z kosztami
Model daje ryzyko, a firma potrzebuje decyzji: kontrolować czy wypłacić. Parametry ustaliliśmy ręcznie (to przykład, nie dane rynkowe): kontrola kosztuje 350 zł, uczciwy klient, którego sprawdzamy, kosztuje dodatkowo 150 zł (dłuższe czekanie, skargi), a wykryte wyłudzenie pozwala nie wypłacić 85% żądanej kwoty. Oczekiwany zysk z kontroli konkretnej szkody to
gdzie p to ryzyko z modelu. Próg ryzyka zależy więc od kwoty: kontrola szkody na 3000 zł opłaca się od ryzyka 0.185, na 6000 zł od 0.095, a na 20 000 zł już od 0.029. Inaczej niż w modelu odejść klientów stawka zmienia się ze szkodą.
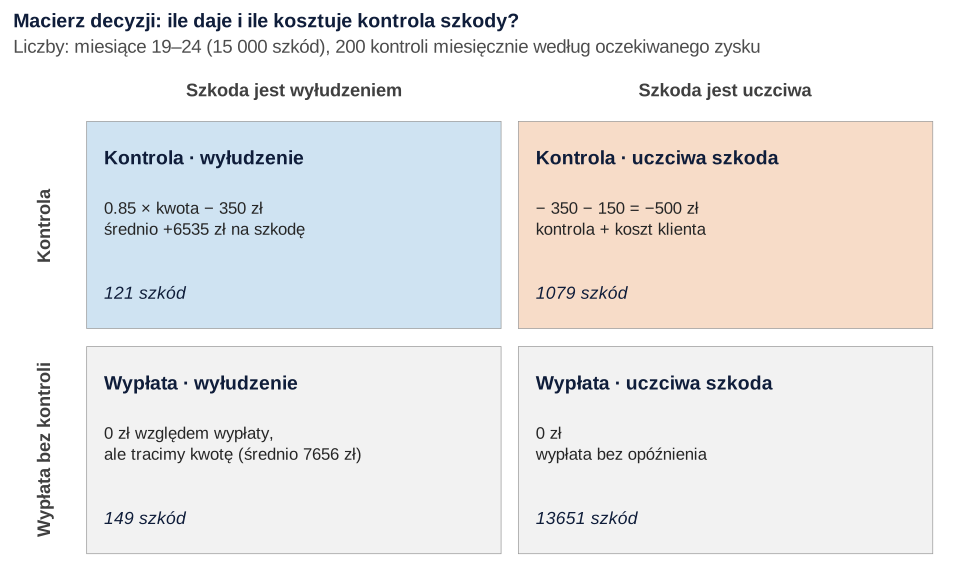
set.seed(639)).Co widać. Co miesiąc kontrolujemy 200 szkód o najwyższym oczekiwanym zysku z regresji. W sześciu miesiącach to 1200 kontroli: 121 trafnych i 1079 alarmów fałszywych. Precyzja wynosi 10.1%, czułość 44.8%. Mimo to kontrole się opłacają: jedno wykryte wyłudzenie daje średnio +6535 zł, a fałszywy alarm kosztuje 500 zł. Razem to 828 827 zł w sześć miesięcy. 149 wyłudzeń (średnio 7656 zł) przeszło bez kontroli.
Jak może zmylić. Precyzja 10% nie znaczy, że model jest zły – przy tych kosztach wystarczy kilka trafień na sto kontroli. Kwoty to jednak założenia; oszacuj je z danych działu likwidacji.
Podpis do pracy:
Zdanie do Metody:
Rysunek 3: budżet 200 kontroli – według czego wybierać?
Porównujemy budżety od 0 do 1000 kontroli miesięcznie i cztery sposoby wyboru: ryzyko z regresji, ryzyko z lasu, oczekiwany zysk (ryzyko × kwota) i losowanie.
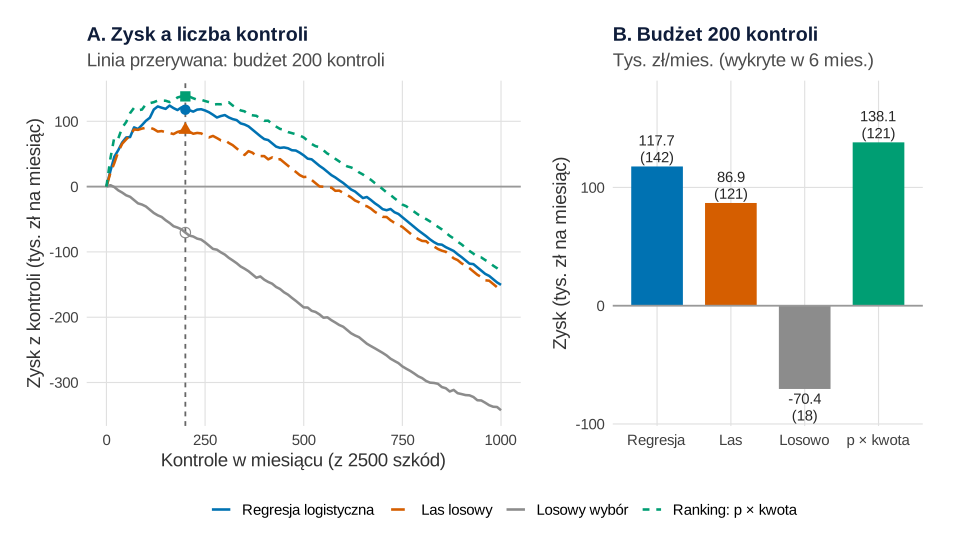
set.seed(639)).Co widać. Przy 200 kontrolach ranking według samego ryzyka z regresji wykrywa najwięcej wyłudzeń: 142 z 270 (precyzja 11.8%, czułość 52.6%) i daje 117 744 zł miesięcznie. Ranking według oczekiwanego zysku wykrywa mniej, bo 121, ale zarabia 138 138 zł miesięcznie: wybiera droższe szkody. Las daje 86 873 zł, a losowe kontrole to strata 70 404 zł miesięcznie. Zielona krzywa ma szczyt przy około 200 kontrolach, a reguła „kontroluj, gdy oczekiwany zysk > 0” wskazałaby średnio 166.5 szkody miesięcznie (131 310 zł).
Jak może zmylić. Najwięcej wykrytych wyłudzeń nie oznacza najwyższego zysku. Ranking według ryzyka × kwota działa tylko wtedy, gdy ryzyko jest dobrze skalibrowane – co psuje następny krok.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: SMOTE i przeważanie zawyżają ryzyko
Popularna rada przy rzadkich zdarzeniach brzmi: „wyrównaj klasy”. SMOTE tworzy sztuczne wyłudzenia przez interpolację między prawdziwymi wyłudzeniami a ich najbliższymi sąsiadami (Chawla i in., 2002). Przeważanie daje każdemu wyłudzeniu wagę 55.7. W obu wersjach model „widzi” 50% wyłudzeń zamiast 1.8%. Szerzej opisuje to hasło nierównowaga klas.
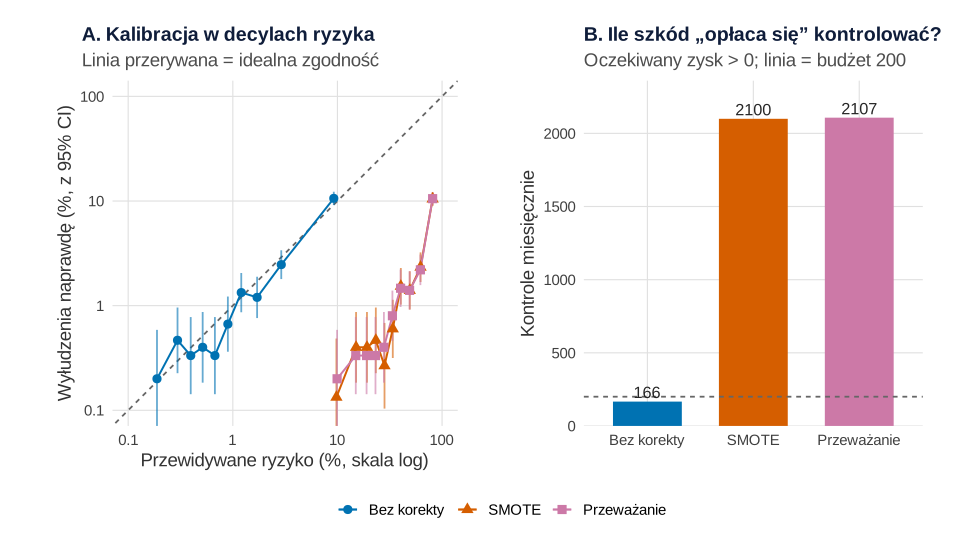
set.seed(639)).Co widać. Ranking prawie się nie zmienia: AUC = .835, .835 i .836, AP = .138, .136 i .136. Zmienia się za to skala ryzyka. Średnie przewidywane ryzyko to 1.80% bez korekty i 36.2% po SMOTE, przy 1.8% wyłudzeń. W decylu najwyższego ryzyka model po SMOTE przewiduje 81.2%, a wyłudzeń jest 10.5%. To brak kalibracji. Skutek: reguła „oczekiwany zysk > 0” wskazuje średnio 2099.7 szkody miesięcznie zamiast 166.5 i daje stratę 648 568 zł miesięcznie. Nawet przy sztywnym budżecie 200 kontroli ranking według ryzyka × kwota po SMOTE wykrywa 62 wyłudzenia zamiast 121 i zarabia 97 537 zł zamiast 138 138 zł, bo zawyżone ryzyko zbyt mocno faworyzuje wysokie kwoty.
Jak może zmylić. Po samym AUC uznasz, że SMOTE „nie zaszkodził”; szkodzi, gdy ryzyko wchodzi do rachunku kosztów. Van den Goorbergh i in. (2022) pokazali w symulacjach, że podpróbkowanie, nadpróbkowanie i SMOTE dają silnie zawyżone ryzyko klasy rzadkiej bez wzrostu AUC, a podobną równowagę czułości i swoistości daje samo przesunięcie progu.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: etykiety tylko dla skontrolowanych
Dotąd znaliśmy prawdę o każdej szkodzie. W firmie wiemy tylko, co wykazała kontrola. Dawne reguły obejmowały 7.9% szkód i tylko 18.3% wyłudzeń. W miesiącach 1–18 widać więc 147 wyłudzeń z 793. Sprawdzamy dwa typowe wyjścia: (1) nieskontrolowane szkody traktujemy jak uczciwe, (2) uczymy model tylko na 3560 skontrolowanych szkodach.
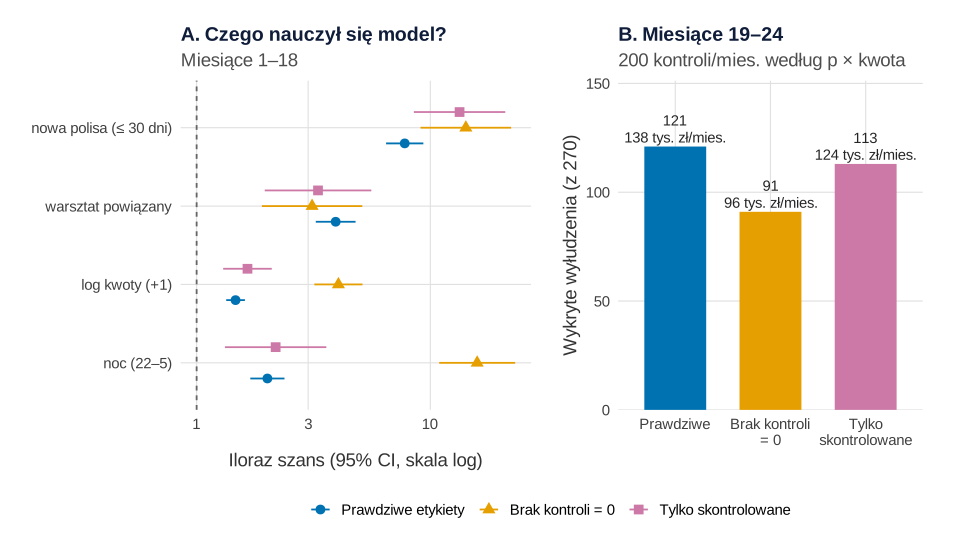
set.seed(639)).Co widać. Model uczony na etykietach „brak kontroli = uczciwa” odtwarza dawne reguły. Iloraz szans dla zdarzeń nocnych rośnie z 2.01 do 15.86, a dla kwoty z 1.47 do 4.04, bo właśnie takie szkody kiedyś sprawdzano. Średnie przewidywane ryzyko spada do 0.34%. Przy 200 kontrolach wykrywa 91 wyłudzeń zamiast 121 i zarabia 96 103 zł miesięcznie zamiast 138 138 zł. Z 50 wyłudzeń przez warsztaty powiązane znajduje 14 zamiast 31. Model uczony tylko na skontrolowanych traci mniej (113 wyłudzeń, 124 067 zł).
Jak może zmylić. To błąd weryfikacji: Begg i Greenes (1983) opisali go dla testów diagnostycznych – ocena tylko na osobach zweryfikowanych może poważnie obciążyć czułość i swoistość, a korekta wymaga założeń o tym, kogo weryfikowano. Lekarstwem jest mała losowa próba kontroli co miesiąc (np. 10–20 z 200), która daje nieobciążone etykiety.
Podpis do pracy:
Zdanie do Metody:
Co z tym zrobić w firmie
- Raportuj precyzję i czułość przy budżecie. „200 kontroli wykrywa 45% wyłudzeń, trafia co dziesiąta” rozumie zarząd.
- Wybieraj szkody według oczekiwanego zysku. Ryzyko × kwota dało tu o 20 394 zł miesięcznie więcej niż samo ryzyko.
- Nie wyrównuj klas, jeśli liczysz pieniądze. Zostaw model bez korekty, a o liczbie kontroli decyduj budżetem lub progiem z kosztów.
- Losuj część kontroli. Bez tego model uczy się dawnych reguł.
- Model to sito, nie wyrok. Alarm uzasadnia kontrolę, a nie odmowę wypłaty. Podobnie działa test kwot w prawie Benforda w audycie. Bolton i Hand (2002) zauważają, że sprawcy dostosowują się do zabezpieczeń – sprawdzaj model co kilka miesięcy.
Jak opisać w pracy
Napisz, jak powstały etykiety, jak podzielono dane w czasie i jak przełożono ryzyko na decyzję. Ogólne zasady opisuje wpis modele predykcyjne: walidacja i kalibracja, a kontekst prac z finansów – statystyka w pracy z finansów i rachunkowości. Podobny opis znajdziesz we wpisie o scoringu kredytowym.
W Wynikach podaj tabelę porównania modeli i reguł:
| Model i reguła wyboru | AUC | AP | Wykryte (z 270) | Precyzja (%) | Zysk (zł/mies.) |
|---|---|---|---|---|---|
| Regresja, ryzyko | .835 | .138 | 142 | 11.8 | 117 744 |
| Regresja, ryzyko × kwota | .835 | .138 | 121 | 10.1 | 138 138 |
| Las losowy, ryzyko | .814 | .109 | 121 | 10.1 | 86 873 |
| Regresja po SMOTE, ryzyko × kwota | .835 | .136 | 62 | 5.2 | 97 537 |
| Losowy wybór | – | .018 | 18 | 1.5 | −70 404 |
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę i motyw, przepis 2 – modele i przewidywania, przepis 3 – parametry kosztów i funkcje używane w przepisach 4–6. Przepisy 2–6 kończą się nazwą wykresu (p1, p3–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1, 2, 4 i 5: każdy zaczyna od własnego set.seed(639), a las losowy dostaje też seed = 639. Ziarno 639 ustalono raz i nie zmieniano go. Ręcznie ustalono: liczbę szkód, rozkłady cech, współczynniki prawdziwego modelu wyłudzenia i dawne reguły kontroli (przepis 1); 300 drzew i minimalną wielkość liścia 50 (przepis 2); koszty kontroli, odzysk i budżet (przepis 3); 5 sąsiadów w SMOTE (przepis 5). Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się w kilka sekund.
1. Dane i podział w czasie
R
# Przepis 1. Szkody komunikacyjne fikcyjnego ubezpieczyciela: 24 miesiące zgłoszeń, ok. 1.5% wyłudzeń
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii), kształty i prosty motyw rysunków
kol <- c("Regresja logistyczna" = "#0072B2", "Las losowy" = "#D55E00", "Losowy wybór" = "grey55",
         "Ranking: p × kwota" = "#009E73")
ksztalt <- c("Regresja logistyczna" = 16, "Las losowy" = 17, "Losowy wybór" = 1, "Ranking: p × kwota" = 15)
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# 2500 zgłoszeń miesięcznie przez 24 miesiące. Cechy znane w dniu zgłoszenia szkody.
# Współczynniki prawdziwego modelu wyłudzenia ustalono ręcznie (m.in. szkoda tuż po zawarciu polisy,
# brak policji i świadków, warsztat powiązany z innymi podejrzanymi szkodami, interakcja z kwotą).
set.seed(639)                                    # ziarno ustalone raz, bez dobierania pod wynik
n <- 2500 * 24
miesiac <- rep(1:24, each = 2500)
dni_od_polisy <- round(rexp(n, 1 / 200))         # dni od zawarcia polisy do zdarzenia
nowa_polisa <- as.numeric(dni_od_polisy <= 30)
dni_do_zgloszenia <- rpois(n, 3)                 # dni od zdarzenia do zgłoszenia
bez_policji <- rbinom(n, 1, 0.55)                # brak notatki policji na miejscu
bez_swiadkow <- rbinom(n, 1, 0.40)
noc <- rbinom(n, 1, 0.15)                        # zdarzenie między 22:00 a 5:00
wczesniejsze_szkody <- rpois(n, 0.4)             # szkody klienta w ostatnich 3 latach
wiek_auta <- pmin(25, round(rgamma(n, 3, 3 / 10)))
wiek_kierowcy <- round(pmin(85, pmax(18, rnorm(n, 45, 14))))
warsztat_powiazany <- rbinom(n, 1, 0.06)         # warsztat obsługujący wcześniejsze podejrzane szkody
kwota <- round(exp(rnorm(n, log(6000), 0.8)), -1)   # żądana kwota odszkodowania (zł)
logit <- -6.3 + 1.6 * nowa_polisa + 0.5 * bez_policji + 0.6 * bez_swiadkow + 0.7 * noc +
  0.35 * wczesniejsze_szkody + 0.05 * dni_do_zgloszenia + 0.03 * wiek_auta - 0.015 * (wiek_kierowcy - 45) +
  1.5 * warsztat_powiazany + 0.45 * log(kwota / 6000) + 0.8 * nowa_polisa * bez_swiadkow
wyludzenie <- rbinom(n, 1, plogis(logit))        # prawda znana tylko dlatego, że dane są fikcyjne

# Dawne reguły kontroli: likwidatorzy sprawdzali szkody powyżej 25 000 zł oraz nocne bez policji i bez świadków
# (plus 1% losowo); wyłudzenie „widać” w danych tylko w skontrolowanych szkodach (zob. przepis 6)
kontrola_dawniej <- as.numeric(kwota > 25000 | (noc == 1 & bez_policji == 1 & bez_swiadkow == 1) | runif(n) < 0.01)
etykieta_z_kontroli <- wyludzenie * kontrola_dawniej

szkody <- data.frame(id = sprintf("S%05d", 1:n), miesiac, dni_od_polisy, nowa_polisa, dni_do_zgloszenia,
                     bez_policji, bez_swiadkow, noc, wczesniejsze_szkody, wiek_auta, wiek_kierowcy,
                     warsztat_powiazany, kwota, kontrola_dawniej, etykieta_z_kontroli, wyludzenie)
write.csv(szkody, "naduzycia-szkody-komunikacyjne.csv", row.names = FALSE)

# Podział w czasie: uczymy na miesiącach 1–18, oceniamy na 19–24 (jak przy wdrożeniu)
train <- subset(szkody, miesiac <= 18); test <- subset(szkody, miesiac > 18)
c(wyludzenia_proc = round(100 * mean(szkody$wyludzenie), 2), uczacy = round(100 * mean(train$wyludzenie), 2),
  testowy = round(100 * mean(test$wyludzenie), 2), wyludzenia_test = sum(test$wyludzenie),
  szkody_test = nrow(test))
# Mediana żądanej kwoty: szkody uczciwe i wyłudzenia
tapply(szkody$kwota, szkody$wyludzenie, median)
# Dawne kontrole: odsetek skontrolowanych szkód i odsetek wyłudzeń, które w ogóle zostały sprawdzone
c(kontrolowane_proc = round(100 * mean(szkody$kontrola_dawniej), 1),
  wyludzenia_sprawdzone_proc = round(100 * mean(szkody$kontrola_dawniej[szkody$wyludzenie == 1]), 1))
Wynik w R
wyludzenia_proc          uczacy         testowy wyludzenia_test     szkody_test
           1.77            1.76            1.80          270.00        15000.00
   0    1
6010 7730
         kontrolowane_proc wyludzenia_sprawdzone_proc
                       7.9                       18.3
2. Regresja logistyczna, las losowy, ROC i PR: Rysunek 1
R
# Przepis 2. Regresja logistyczna i las losowy (miesiące 1–18); trafność, krzywe ROC i PR na miesiącach 19–24
# (korzysta z train, test, kol, ksztalt i motyw z przepisu 1)
library(ggplot2)
library(patchwork)
library(ranger)

predyktory <- c("dni_od_polisy", "nowa_polisa", "dni_do_zgloszenia", "bez_policji", "bez_swiadkow", "noc",
                "wczesniejsze_szkody", "wiek_auta", "wiek_kierowcy", "warsztat_powiazany", "log_kwota")
train$log_kwota <- log(train$kwota); test$log_kwota <- log(test$kwota)
wzor <- reformulate(predyktory, "wyludzenie")
rl <- glm(wzor, family = binomial, data = train)
round(cbind(OR = exp(coef(rl)), exp(confint.default(rl)))[-1, ], 2)
set.seed(639)
las <- ranger(wzor, data = transform(train, wyludzenie = factor(wyludzenie)), num.trees = 300,
              probability = TRUE, min.node.size = 50, seed = 639)
test$p_rl <- predict(rl, test, type = "response")
test$p_las <- predict(las, test)$predictions[, "1"]
y <- test$wyludzenie

# „Trafność 98%”: odsetek poprawnych decyzji przy progu 0.5 i reguła „nikt nie oszukuje”
trafnosc <- function(p, prog = 0.5) mean((p >= prog) == (y == 1))
c(nikt_nie_oszukuje = 100 * mean(y == 0), rl_prog_05 = 100 * trafnosc(test$p_rl),
  las_prog_05 = 100 * trafnosc(test$p_las), wykryte_rl_prog_05 = sum(test$p_rl >= 0.5 & y == 1)) |> round(2)

# AUC (pole pod ROC) i średnia precyzja AP (pole pod krzywą PR) – policzone wprost z rang
auc <- function(p, y) { r <- rank(p); n1 <- sum(y); n0 <- length(y) - n1
  (sum(r[y == 1]) - n1 * (n1 + 1) / 2) / (n1 * n0) }
ap <- function(p, y) { o <- order(p, decreasing = TRUE); tp <- cumsum(y[o])
  mean((tp / seq_along(o))[y[o] == 1]) }          # średnia precyzja w miejscach, gdzie „łapiemy” wyłudzenie
c(AUC_rl = auc(test$p_rl, y), AUC_las = auc(test$p_las, y), AP_rl = ap(test$p_rl, y),
  AP_las = ap(test$p_las, y), AP_losowo = mean(y)) |> round(3)

krzywe <- function(p, nazwa) {
  o <- order(p, decreasing = TRUE); tp <- cumsum(y[o]); fp <- cumsum(1 - y[o]); k <- seq_along(o)
  data.frame(model = nazwa, czulosc = tp / sum(y), fpr = fp / sum(1 - y), precyzja = tp / k)[seq(1, length(o), 15), ]
}
kr <- rbind(krzywe(test$p_rl, "Regresja logistyczna"), krzywe(test$p_las, "Las losowy"))
kr$model <- factor(kr$model, names(kol)[1:2])
# Ten sam punkt na obu krzywych: czułość 50% – ile fałszywych alarmów?
pkt <- do.call(rbind, lapply(split(kr, kr$model), function(d) d[which(d$czulosc >= 0.5)[1], ]))
print(transform(pkt, fpr = round(100 * fpr, 1), precyzja = round(100 * precyzja, 1),
                czulosc = round(100 * czulosc, 1)), row.names = FALSE)

pa <- ggplot(kr, aes(100 * fpr, 100 * czulosc, colour = model, linetype = model)) +
  geom_abline(slope = 1, intercept = 0, linetype = "22", colour = "grey55") +
  geom_line(linewidth = 0.9) + geom_point(data = pkt, aes(shape = model), size = 3.2, show.legend = FALSE) +
  scale_colour_manual(values = kol[1:2], name = NULL) + scale_shape_manual(values = ksztalt[1:2], name = NULL) +
  scale_linetype_manual(values = c("solid", "42"), name = NULL) + coord_equal() +
  labs(x = "Fałszywe alarmy (% uczciwych szkód)", y = "Czułość (% wyłudzeń wykrytych)",
       title = "A. Krzywa ROC", subtitle = "Przekątna = losowy wybór") + motyw
pb <- ggplot(kr, aes(100 * czulosc, 100 * precyzja, colour = model, linetype = model)) +
  geom_hline(yintercept = 100 * mean(y), linetype = "22", colour = "grey55") +
  geom_line(linewidth = 0.9) + geom_point(data = pkt, aes(shape = model), size = 3.2, show.legend = FALSE) +
  scale_colour_manual(values = kol[1:2], name = NULL) + scale_shape_manual(values = ksztalt[1:2], name = NULL) +
  scale_linetype_manual(values = c("solid", "42"), name = NULL) + coord_cartesian(ylim = c(0, 100)) +
  labs(x = "Czułość (% wyłudzeń wykrytych)", y = "Precyzja (% alarmów trafnych)",
       title = "B. Krzywa precyzja–czułość", subtitle = sprintf("Linia przerywana = odsetek wyłudzeń (%.1f%%)", 100 * mean(y))) + motyw
p1 <- pa + pb + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p1   # zapis: ggsave("naduzycia-roc-i-pr.svg", p1, width = 10, height = 5.6)
Wynik w R
                      OR 2.5 % 97.5 %
dni_od_polisy       1.00  1.00   1.00
nowa_polisa         7.77  6.47   9.33
dni_do_zgloszenia   1.04  1.00   1.09
bez_policji         1.59  1.37   1.85
bez_swiadkow        2.85  2.45   3.31
noc                 2.01  1.70   2.38
wczesniejsze_szkody 1.51  1.37   1.66
wiek_auta           1.03  1.02   1.05
wiek_kierowcy       0.98  0.98   0.99
warsztat_powiazany  3.93  3.23   4.79
log_kwota           1.47  1.34   1.61
 nikt_nie_oszukuje         rl_prog_05        las_prog_05 wykryte_rl_prog_05
             98.20              98.19              98.20               0.00
   AUC_rl   AUC_las     AP_rl    AP_las AP_losowo
    0.835     0.814     0.138     0.109     0.018
                model czulosc fpr precyzja
 Regresja logistyczna      50 6.5     12.3
           Las losowy      50 9.6      8.7
3. Macierz decyzji z kosztami: Rysunek 2
R
# Przepis 3. Macierz decyzji z kosztami: kontrola albo wypłata × wyłudzenie albo uczciwa szkoda
# (korzysta z test i p_rl z przepisów 1–2)
library(ggplot2)

# Parametry ustalone ręcznie (przykład, nie dane rynkowe):
koszt_kontroli <- 350   # praca likwidatora specjalnego i rzeczoznawcy (zł na skontrolowaną szkodę)
koszt_klienta  <- 150   # uczciwy klient czeka dłużej na wypłatę: odsetki, skargi, ryzyko odejścia (zł)
odzysk         <- 0.85  # część kwoty wyłudzenia, której po kontroli nie wypłacamy (reszta: spory, ugody)
budzet         <- 200   # kontroli miesięcznie, na które stać dział

# Zysk z kontroli względem wypłaty bez kontroli (punkt odniesienia = 0 zł)
zysk_kontroli <- function(y, kwota) ifelse(y == 1, odzysk * kwota - koszt_kontroli, -koszt_kontroli - koszt_klienta)
# Oczekiwany zysk z kontroli konkretnej szkody: ryzyko × odzyskana kwota − koszty
oczekiwany <- function(p, kwota) p * odzysk * kwota - koszt_kontroli - (1 - p) * koszt_klienta
test$ez_rl <- oczekiwany(test$p_rl, test$kwota)
# Próg ryzyka, od którego kontrola się opłaca, zależy od kwoty: p* = 500 / (0.85 × kwota + 150)
prog <- function(kwota) (koszt_kontroli + koszt_klienta) / (odzysk * kwota + koszt_klienta)
round(c(prog_3000 = prog(3000), prog_6000 = prog(6000), prog_20000 = prog(20000)), 3)

# Wybór w każdym miesiącu: 200 szkód o najwyższym oczekiwanym zysku z regresji logistycznej
wybierz <- function(wynik, k) ave(-wynik, test$miesiac, FUN = function(v) rank(v, ties.method = "first")) <= k
kontrola <- wybierz(test$ez_rl, budzet)
y <- test$wyludzenie
m <- table(decyzja = factor(ifelse(kontrola, "kontrola", "wypłata"), c("kontrola", "wypłata")),
           wynik = factor(ifelse(y == 1, "wyłudzenie", "uczciwa"), c("wyłudzenie", "uczciwa")))
m
c(precyzja_proc = round(100 * m[1, 1] / sum(m[1, ]), 1), czulosc_proc = round(100 * m[1, 1] / sum(m[, 1]), 1),
  sredni_zysk_trafnej = round(mean(zysk_kontroli(1, test$kwota[kontrola & y == 1]))),
  srednia_kwota_niewykrytych = round(mean(test$kwota[!kontrola & y == 1])),
  zysk_6_miesiecy = sum(zysk_kontroli(y, test$kwota)[kontrola]))

komorki <- data.frame(x = c(1, 2, 1, 2), y = c(2, 2, 1, 1),
  tytul = c("Kontrola · wyłudzenie", "Kontrola · uczciwa szkoda", "Wypłata · wyłudzenie", "Wypłata · uczciwa szkoda"),
  wzor = c(sprintf("%.2f × kwota − %d zł\nśrednio %+d zł na szkodę", odzysk, koszt_kontroli,
                   round(mean(zysk_kontroli(1, test$kwota[kontrola & y == 1])))),
           sprintf("− %d − %d = −%d zł\nkontrola + koszt klienta", koszt_kontroli, koszt_klienta, koszt_kontroli + koszt_klienta),
           sprintf("0 zł względem wypłaty,\nale tracimy kwotę (średnio %d zł)", round(mean(test$kwota[!kontrola & y == 1]))),
           "0 zł\nwypłata bez opóźnienia"),
  liczba = sprintf("%d szkód", c(m[1, 1], m[1, 2], m[2, 1], m[2, 2])),
  rola = c("zysk", "strata", "zero", "zero"))
p3 <- ggplot(komorki) +
  geom_tile(aes(x, y, fill = rola), width = 0.96, height = 0.92, colour = "grey60") +
  geom_text(aes(x - 0.44, y + 0.30, label = tytul), hjust = 0, fontface = "bold", size = 5.1, colour = "#0f1d3a") +
  geom_text(aes(x - 0.44, y + 0.03, label = wzor), hjust = 0, size = 4.4, lineheight = 1.05, colour = "grey15") +
  geom_text(aes(x - 0.44, y - 0.30, label = liczba), hjust = 0, size = 4.6, fontface = "italic", colour = "#0f1d3a") +
  annotate("text", x = c(1, 2), y = 2.6, label = c("Szkoda jest wyłudzeniem", "Szkoda jest uczciwa"),
           fontface = "bold", size = 4.8, colour = "grey25") +
  annotate("text", x = 0.42, y = c(2, 1), label = c("Kontrola", "Wypłata bez kontroli"), angle = 90,
           fontface = "bold", size = 4.8, colour = "grey25") +
  scale_fill_manual(values = c(zysk = "#cfe3f2", strata = "#f7dcc8", zero = "grey95"), guide = "none") +
  coord_cartesian(xlim = c(0.35, 2.5), ylim = c(0.5, 2.7), expand = FALSE) +
  labs(title = "Macierz decyzji: ile daje i ile kosztuje kontrola szkody?",
       subtitle = "Liczby: miesiące 19–24 (15 000 szkód), 200 kontroli miesięcznie według oczekiwanego zysku") +
  theme_void(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a"), plot.subtitle = element_text(colour = "grey30"),
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
p3   # zapis: ggsave("naduzycia-macierz-decyzji.svg", p3, width = 10, height = 6)
Wynik w R
 prog_3000  prog_6000 prog_20000
     0.185      0.095      0.029
          wynik
decyzja    wyłudzenie uczciwa
  kontrola        121    1079
  wypłata         149   13651
             precyzja_proc               czulosc_proc
                      10.1                       44.8
       sredni_zysk_trafnej srednia_kwota_niewykrytych
                    6535.0                     7656.0
           zysk_6_miesiecy
                  828827.0
4. Zysk a budżet kontroli: Rysunek 3
R
# Przepis 4. Ile kontroli miesięcznie i według czego wybierać? Zysk w funkcji budżetu kontroli
# (korzysta z test, p_rl, p_las, kol, ksztalt, motyw z przepisów 1–2 oraz funkcji i parametrów z przepisu 3)
library(ggplot2)
library(patchwork)

test$ez_las <- oczekiwany(test$p_las, test$kwota)
y <- test$wyludzenie
zysk_szkody <- zysk_kontroli(y, test$kwota)          # co dałaby kontrola tej szkody (znamy prawdę – dane fikcyjne)
set.seed(639)
los <- runif(nrow(test))                              # losowy wybór szkód do kontroli – punkt odniesienia
rankingi <- list("Regresja logistyczna" = test$p_rl, "Las losowy" = test$p_las,
                 "Ranking: p × kwota" = test$ez_rl, "Losowy wybór" = los)
ks <- seq(0, 1000, by = 10)
krzywa <- do.call(rbind, lapply(names(rankingi), function(nz) {
  r <- ave(-rankingi[[nz]], test$miesiac, FUN = function(v) rank(v, ties.method = "first"))
  data.frame(ranking = nz, k = ks, zysk = sapply(ks, function(k) sum(zysk_szkody[r <= k])) / 6,
             wykryte = sapply(ks, function(k) sum(y[r <= k])))
}))
krzywa$ranking <- factor(krzywa$ranking, names(kol))
# Przy budżecie 200 kontroli miesięcznie: zysk na miesiąc, wykryte wyłudzenia (z 270), precyzja i czułość
przy200 <- subset(krzywa, k == 200)
print(transform(przy200, zysk = round(zysk), precyzja_proc = round(100 * wykryte / 1200, 1),
                czulosc_proc = round(100 * wykryte / sum(y), 1)), row.names = FALSE)
# Najlepszy budżet (bez ograniczenia) dla rankingu p × kwota oraz reguła „kontroluj, gdy oczekiwany zysk > 0”
naj <- subset(krzywa, ranking == "Ranking: p × kwota"); naj[which.max(naj$zysk), c("k", "zysk")]
c(kontrole_mies_ez_dodatni = sum(test$ez_rl > 0) / 6, zysk_mies_ez_dodatni = round(sum(zysk_szkody[test$ez_rl > 0]) / 6))

p4a <- ggplot(krzywa, aes(k, zysk / 1000, colour = ranking, linetype = ranking)) +
  geom_vline(xintercept = 200, linetype = "22", colour = "grey40") +
  geom_hline(yintercept = 0, colour = "grey60") +
  geom_line(linewidth = 0.9) +
  geom_point(data = przy200, aes(shape = ranking), size = 3.2, show.legend = FALSE) +
  scale_colour_manual(values = kol, name = NULL) + scale_shape_manual(values = ksztalt, name = NULL) +
  scale_linetype_manual(values = c("solid", "42", "solid", "22"), name = NULL) +
  labs(x = "Kontrole w miesiącu (z 2500 szkód)", y = "Zysk z kontroli (tys. zł na miesiąc)",
       title = "A. Zysk a liczba kontroli", subtitle = "Linia przerywana: budżet 200 kontroli") + motyw
p4b <- ggplot(przy200, aes(ranking, zysk / 1000, fill = ranking)) +
  geom_col(width = 0.7) +
  geom_text(aes(label = sprintf("%.1f\n(%d)", zysk / 1000, wykryte)),
            vjust = ifelse(przy200$zysk >= 0, -0.15, 1.15), size = 3.9, lineheight = 0.95, colour = "grey15") +
  geom_hline(yintercept = 0, colour = "grey60") +
  scale_fill_manual(values = kol, guide = "none") +
  scale_x_discrete(labels = c("Regresja", "Las", "Losowo", "p × kwota")) +
  scale_y_continuous(expand = expansion(mult = c(0.15, 0.25))) +
  labs(x = NULL, y = "Zysk (tys. zł na miesiąc)", title = "B. Budżet 200 kontroli",
       subtitle = "Tys. zł/mies. (wykryte w 6 mies.)") + motyw
p4 <- p4a + p4b + plot_layout(widths = c(1.4, 1), guides = "collect") & theme(legend.position = "bottom")
p4   # zapis: ggsave("naduzycia-budzet-kontroli.svg", p4, width = 10, height = 5.8)
Wynik w R
              ranking   k   zysk wykryte precyzja_proc czulosc_proc
 Regresja logistyczna 200 117744     142          11.8         52.6
           Las losowy 200  86873     121          10.1         44.8
   Ranking: p × kwota 200 138138     121          10.1         44.8
         Losowy wybór 200 -70404      18           1.5          6.7
      k     zysk
223 200 138137.8
kontrole_mies_ez_dodatni     zysk_mies_ez_dodatni
                   166.5                 131310.0
5. SMOTE, przeważanie i kalibracja: Rysunek 4
R
# Przepis 5. SMOTE i przeważanie klas: ranking podobny, przewidywane ryzyko zawyżone
# (korzysta z train, test, wzor, predyktory, rl, auc(), ap() z przepisu 2 oraz oczekiwany(), zysk_kontroli(),
#  wybierz() i budzet z przepisu 3)
library(ggplot2)
library(patchwork)

# SMOTE policzony ręcznie: dla każdego wyłudzenia 5 najbliższych wyłudzeń (odległość na cechach standaryzowanych),
# nowy przypadek = punkt na odcinku między wyłudzeniem a losowym sąsiadem; aż do równej liczby obu klas
set.seed(639)
X <- as.matrix(train[train$wyludzenie == 1, predyktory])
Z <- scale(X)
D <- as.matrix(dist(Z)); diag(D) <- Inf
sasiedzi <- t(apply(D, 1, function(d) order(d)[1:5]))
ile <- sum(train$wyludzenie == 0) - nrow(X)
i <- sample(nrow(X), ile, replace = TRUE)
j <- sasiedzi[cbind(i, sample(5, ile, replace = TRUE))]
nowe <- X[i, ] + runif(ile) * (X[j, ] - X[i, ])
calkowite <- setdiff(predyktory, "log_kwota")                 # zmienne 0/1 i liczby całkowite zaokrąglamy
nowe[, calkowite] <- round(nowe[, calkowite])
train_smote <- rbind(train[, c(predyktory, "wyludzenie")], data.frame(nowe, wyludzenie = 1))
rl_smote <- glm(wzor, family = binomial, data = train_smote)
# Przeważanie: każde wyłudzenie dostaje wagę = liczba uczciwych / liczba wyłudzeń
w <- ifelse(train$wyludzenie == 1, sum(train$wyludzenie == 0) / sum(train$wyludzenie == 1), 1)
rl_wagi <- suppressWarnings(glm(wzor, family = binomial, data = train, weights = w))
c(wyludzenia_w_smote_proc = 100 * mean(train_smote$wyludzenie), waga_wyludzenia = round(w[train$wyludzenie == 1][1], 1))

y <- test$wyludzenie
modele <- list("Bez korekty" = test$p_rl, "SMOTE" = predict(rl_smote, test, type = "response"),
               "Przeważanie" = predict(rl_wagi, test, type = "response"))
ocena <- t(sapply(modele, function(p) {
  ez <- oczekiwany(p, test$kwota); k200 <- wybierz(ez, budzet)
  c(AUC = auc(p, y), AP = ap(p, y), srednie_ryzyko_proc = 100 * mean(p), odsetek_wyludzen_proc = 100 * mean(y),
    kontrole_mies_ez_dodatni = sum(ez > 0) / 6, zysk_mies_ez_dodatni = sum(zysk_kontroli(y, test$kwota)[ez > 0]) / 6,
    zysk_mies_budzet_200 = sum(zysk_kontroli(y, test$kwota)[k200]) / 6, wykryte_200 = sum(y[k200]))
}))
round(ocena, 3)

# Kalibracja w decylach przewidywanego ryzyka (po 1500 szkód) z 95% przedziałami Wilsona
kal <- do.call(rbind, lapply(names(modele), function(nz) {
  p <- modele[[nz]]; g <- ceiling(10 * rank(p, ties.method = "first") / length(p))
  do.call(rbind, lapply(split(seq_along(p), g), function(ix) {
    ci <- prop.test(sum(y[ix]), length(ix), correct = FALSE)$conf.int
    data.frame(model = nz, przewidywane = mean(p[ix]), obserwowane = mean(y[ix]), dolna = ci[1], gorna = ci[2])
  }))
}))
kal$model <- factor(kal$model, names(modele))
print(transform(subset(kal, przewidywane == ave(przewidywane, model, FUN = max)),
                przewidywane = round(100 * przewidywane, 1), obserwowane = round(100 * obserwowane, 1),
                dolna = NULL, gorna = NULL), row.names = FALSE)   # decyl o najwyższym ryzyku

kol_k <- c("Bez korekty" = "#0072B2", "SMOTE" = "#D55E00", "Przeważanie" = "#CC79A7")
p5a <- ggplot(kal, aes(100 * przewidywane, 100 * obserwowane, colour = model, shape = model)) +
  geom_abline(slope = 1, intercept = 0, linetype = "22", colour = "grey40") +
  geom_errorbar(aes(ymin = 100 * dolna, ymax = 100 * gorna), width = 0, alpha = 0.6) +
  geom_line(linewidth = 0.7) + geom_point(size = 2.8) +
  scale_x_log10(breaks = c(0.1, 1, 10, 100), labels = c("0.1", "1", "10", "100")) +
  scale_y_log10(breaks = c(0.1, 1, 10, 100), labels = c("0.1", "1", "10", "100")) +
  coord_equal(xlim = c(0.1, 100), ylim = c(0.1, 100)) +
  scale_colour_manual(values = kol_k, name = NULL) + scale_shape_manual(values = c(16, 17, 15), name = NULL) +
  labs(x = "Przewidywane ryzyko (%, skala log)", y = "Wyłudzenia naprawdę (%, z 95% CI)",
       title = "A. Kalibracja w decylach ryzyka", subtitle = "Linia przerywana = idealna zgodność") + motyw
sl <- data.frame(model = factor(rownames(ocena), names(modele)), kontrole = ocena[, "kontrole_mies_ez_dodatni"])
p5b <- ggplot(sl, aes(model, kontrole, fill = model)) +
  geom_col(width = 0.65) + geom_hline(yintercept = budzet, linetype = "22", colour = "grey40") +
  geom_text(aes(label = round(kontrole)), vjust = -0.3, size = 4.3, colour = "grey15") +
  scale_fill_manual(values = kol_k, guide = "none") +
  scale_y_continuous(expand = expansion(mult = c(0, 0.12))) +
  labs(x = NULL, y = "Kontrole miesięcznie", title = "B. Ile szkód „opłaca się” kontrolować?",
       subtitle = "Oczekiwany zysk > 0; linia = budżet 200") + motyw
p5 <- p5a + p5b + plot_layout(widths = c(1.2, 1), guides = "collect") & theme(legend.position = "bottom")
p5   # zapis: ggsave("naduzycia-smote-kalibracja.svg", p5, width = 10, height = 5.8)
Wynik w R
wyludzenia_w_smote_proc         waga_wyludzenia
                   50.0                    55.7
              AUC    AP srednie_ryzyko_proc odsetek_wyludzen_proc
Bez korekty 0.835 0.138               1.801                   1.8
SMOTE       0.835 0.136              36.224                   1.8
Przeważanie 0.836 0.136              36.071                   1.8
            kontrole_mies_ez_dodatni zysk_mies_ez_dodatni zysk_mies_budzet_200
Bez korekty                  166.500             131310.2            138137.83
SMOTE                       2099.667            -648567.9             97537.33
Przeważanie                 2107.167            -652317.9             95446.83
            wykryte_200
Bez korekty         121
SMOTE                62
Przeważanie          61
       model przewidywane obserwowane
 Bez korekty          9.2        10.6
       SMOTE         81.2        10.5
 Przeważanie         81.2        10.5
6. Etykiety tylko dla skontrolowanych: Rysunek 5
R
# Przepis 6. Etykiety tylko dla skontrolowanych szkód: model uczy się dawnych reguł kontroli
# (korzysta z train, test, predyktory, rl, auc(), ap() z przepisu 2 oraz oczekiwany(), zysk_kontroli(),
#  wybierz() i budzet z przepisu 3)
library(ggplot2)
library(patchwork)

# Wariant 1: nieskontrolowane szkody traktujemy jak uczciwe (etykieta = wynik kontroli albo 0)
rl_etyk <- glm(reformulate(predyktory, "etykieta_z_kontroli"), family = binomial, data = train)
# Wariant 2: uczymy tylko na skontrolowanych szkodach (etykiety prawdziwe, ale próba wybrana regułami)
rl_skontr <- glm(reformulate(predyktory, "wyludzenie"), family = binomial, data = subset(train, kontrola_dawniej == 1))
c(skontrolowane_w_uczacym = sum(train$kontrola_dawniej), wyludzenia_widoczne = sum(train$etykieta_z_kontroli),
  wyludzenia_prawdziwe = sum(train$wyludzenie))

y <- test$wyludzenie
warianty <- list("Prawdziwe etykiety" = rl, "Brak kontroli = 0" = rl_etyk,
                 "Tylko skontrolowane" = rl_skontr)
wyn <- t(sapply(warianty, function(m) {
  p <- predict(m, test, type = "response"); k200 <- wybierz(oczekiwany(p, test$kwota), budzet)
  c(AUC = auc(p, y), AP = ap(p, y), srednie_ryzyko_proc = 100 * mean(p), wykryte_200 = sum(y[k200]),
    wykryte_warsztat = sum(y[k200] * test$warsztat_powiazany[k200]),
    zysk_mies_200 = sum(zysk_kontroli(y, test$kwota)[k200]) / 6)
}))
round(wyn, 3)
c(wyludzenia_test = sum(y), w_tym_warsztat = sum(y * test$warsztat_powiazany))

# Ilorazy szans trzech wybranych cech w trzech wariantach (95% CI)
cechy <- c("nowa_polisa", "warsztat_powiazany", "log_kwota", "noc")
or <- do.call(rbind, lapply(names(warianty), function(nz) {
  m <- warianty[[nz]]; ci <- exp(confint.default(m)[cechy, ])
  data.frame(wariant = nz, cecha = cechy, OR = exp(coef(m)[cechy]), dolna = ci[, 1], gorna = ci[, 2])
}))
print(transform(or, OR = round(OR, 2), dolna = round(dolna, 2), gorna = round(gorna, 2)), row.names = FALSE)

kol_e <- c("Prawdziwe etykiety" = "#0072B2", "Brak kontroli = 0" = "#E69F00", "Tylko skontrolowane" = "#CC79A7")
or$wariant <- factor(or$wariant, names(kol_e))
or$cecha <- factor(or$cecha, rev(cechy), rev(c("nowa polisa (≤ 30 dni)", "warsztat powiązany", "log kwoty (+1)", "noc (22–5)")))
p6a <- ggplot(or, aes(OR, cecha, colour = wariant, shape = wariant)) +
  geom_vline(xintercept = 1, linetype = "22", colour = "grey40") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0, orientation = "y", position = position_dodge(0.6)) +
  geom_point(size = 3, position = position_dodge(0.6)) +
  scale_x_log10() +
  scale_colour_manual(values = kol_e, name = NULL) + scale_shape_manual(values = c(16, 17, 15), name = NULL) +
  labs(x = "Iloraz szans (95% CI, skala log)", y = NULL, title = "A. Czego nauczył się model?",
       subtitle = "Miesiące 1–18") + motyw
wd <- data.frame(wariant = factor(rownames(wyn), names(kol_e)), wykryte = wyn[, "wykryte_200"],
                 zysk = wyn[, "zysk_mies_200"])
p6b <- ggplot(wd, aes(wariant, wykryte, fill = wariant)) +
  geom_col(width = 0.65) +
  geom_text(aes(label = sprintf("%d\n%.0f tys. zł/mies.", wykryte, zysk / 1000)), vjust = -0.15, size = 3.9,
            lineheight = 0.95, colour = "grey15") +
  scale_fill_manual(values = kol_e, guide = "none") +
  scale_x_discrete(labels = c("Prawdziwe", "Brak kontroli\n= 0", "Tylko\nskontrolowane")) +
  scale_y_continuous(expand = expansion(mult = c(0, 0.25))) +
  labs(x = NULL, y = sprintf("Wykryte wyłudzenia (z %d)", sum(y)), title = "B. Miesiące 19–24",
       subtitle = "200 kontroli/mies. według p × kwota") + motyw
p6 <- p6a + p6b + plot_layout(widths = c(1.15, 1), guides = "collect") & theme(legend.position = "bottom")
p6   # zapis: ggsave("naduzycia-etykiety-z-kontroli.svg", p6, width = 10, height = 5.8)
Wynik w R
skontrolowane_w_uczacym     wyludzenia_widoczne    wyludzenia_prawdziwe
                   3560                     147                     793
                      AUC    AP srednie_ryzyko_proc wykryte_200
Prawdziwe etykiety  0.835 0.138               1.801         121
Brak kontroli = 0   0.793 0.094               0.337          91
Tylko skontrolowane 0.832 0.135               1.661         113
                    wykryte_warsztat zysk_mies_200
Prawdziwe etykiety                31     138137.83
Brak kontroli = 0                 14      96103.33
Tylko skontrolowane               24     124067.25
wyludzenia_test  w_tym_warsztat
            270              50
             wariant              cecha    OR dolna gorna
  Prawdziwe etykiety        nowa_polisa  7.77  6.47  9.33
  Prawdziwe etykiety warsztat_powiazany  3.93  3.23  4.79
  Prawdziwe etykiety          log_kwota  1.47  1.34  1.61
  Prawdziwe etykiety                noc  2.01  1.70  2.38
   Brak kontroli = 0        nowa_polisa 14.19  9.08 22.17
   Brak kontroli = 0 warsztat_powiazany  3.12  1.90  5.12
   Brak kontroli = 0          log_kwota  4.04  3.19  5.12
   Brak kontroli = 0                noc 15.86 10.91 23.06
 Tylko skontrolowane        nowa_polisa 13.33  8.50 20.92
 Tylko skontrolowane warsztat_powiazany  3.31  1.96  5.59
 Tylko skontrolowane          log_kwota  1.65  1.30  2.10
 Tylko skontrolowane                noc  2.18  1.32  3.59
7. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Przepis 7. Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("regresja – las" = c("#0072B2", "#D55E00"), "regresja – p × kwota" = c("#0072B2", "#009E73"),
             "las – p × kwota" = c("#D55E00", "#009E73"), "las – losowy wybór" = c("#D55E00", "#8C8C8C"),
             "SMOTE – przeważanie" = c("#D55E00", "#CC79A7"), "bez korekty – przeważanie" = c("#0072B2", "#CC79A7"),
             "prawdziwe – brak kontroli = 0" = c("#0072B2", "#E69F00"), "brak kontroli = 0 – tylko skontrolowane" = c("#E69F00", "#CC79A7"),
             "komórka zysku – straty" = c("#cfe3f2", "#f7dcc8"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                        widzenie_typowe deuteranopia protanopia
regresja – las                                    114.6        108.3       91.9
regresja – p × kwota                               70.1         55.4       58.0
las – p × kwota                                   102.4         53.5       37.3
las – losowy wybór                                 76.8         62.6       54.8
SMOTE – przeważanie                                74.3         70.2       71.9
bez korekty – przeważanie                          53.6         42.0       22.5
prawdziwe – brak kontroli = 0                     120.2        121.5      109.3
brak kontroli = 0 – tylko skontrolowane            88.6         81.3       87.6
komórka zysku – straty                             24.8         24.8       20.8
czerwony – zielony (do unikania)                  121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, regresja logistyczna (glm()), odległości w SMOTE (dist()) i przedziały Wilsona (prop.test()) – pakiet stats z podstawowej instalacji R; las losowy – pakiet ranger. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ranger (wersja 0.18.0): Wright, M. N., & Ziegler, A. (2017). ranger: A fast implementation of random forests for high dimensional data in C++ and R. Journal of Statistical Software, 77(1), 1–17. https://doi.org/10.18637/jss.v077.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Trafność i próg 0.5. 98.20% trafności ma reguła, która nie wykrywa nic, a próg 0.5 nie wskazał żadnej szkody (rysunek 1).
- Wyrównywanie klas bez korekty. SMOTE i wagi zawyżyły ryzyko ponad dwudziestokrotnie (rysunek 4); próg z kosztów przestaje wtedy działać.
- Etykiety z dawnych kontroli. Model uczy się, kogo sprawdzano, a nie kto oszukiwał (rysunek 5).
Najczęstsze pytania
Dlaczego trafność 98% nie świadczy o dobrym modelu wykrywania nadużyć?
Bo przy rzadkim zdarzeniu trafność mierzy głównie jego rzadkość. W przykładzie 1.8% szkód to wyłudzenia, więc reguła „nikt nie oszukuje” ma 98.20% trafności, a regresja logistyczna z progiem 0.5 – 98.19% przy zerze wykrytych wyłudzeń. Podawaj precyzję (odsetek trafnych alarmów) i czułość (odsetek wykrytych wyłudzeń).
Krzywa ROC czy krzywa precyzja–czułość przy rzadkich zdarzeniach?
Pokaż obie, ale wnioski o praktycznej skuteczności opieraj na krzywej PR. W przykładzie AUC wyniosło .835, a przy czułości 50% precyzja tylko 12.3% – około 12 trafnych alarmów na 100. Krzywa ROC tego nie pokazuje, bo nie zależy od częstości zdarzenia. Zob. krzywa precyzja–czułość.
Jak wybrać próg alarmu przy ograniczonym budżecie kontroli?
Policz oczekiwany zysk z kontroli każdej sprawy (ryzyko × odzyskana kwota minus koszty) i co miesiąc kontroluj sprawy o najwyższym zysku w ramach budżetu. W przykładzie przy 200 kontrolach dało to 138 138 zł miesięcznie, a wybór według samego ryzyka 117 744 zł. Wymaga to dobrze skalibrowanego modelu.
Czy przy rzadkich zdarzeniach warto stosować SMOTE?
Zwykle nie, jeśli ryzyko służy do rachunku kosztów. W przykładzie SMOTE nie zmienił AUC (.835), ale zawyżył średnie ryzyko z 1.80% do 36.2% i przy budżecie 200 kontroli zmniejszył liczbę wykrytych wyłudzeń z 121 do 62. Zamiast wyrównywać klasy, zmień próg lub wybieraj według budżetu – zob. nierównowaga klas.
Co zrobić, gdy wiemy tylko, które skontrolowane sprawy były nadużyciem?
Nie traktuj niekontrolowanych spraw jak uczciwych bez zastrzeżeń – model nauczy się dawnych reguł kontroli. W przykładzie wykrył wtedy 91 zamiast 121 wyłudzeń. Kontroluj co miesiąc małą losową próbę spraw, a w pracy opisz ryzyko błędu weryfikacji.
Powiązane hasła
Przeczytaj też
Model odejść klientów i kampania retencyjna
Operator komórkowy, 10 000 abonentów: regresja i las losowy, gain i lift, kalibracja, macierz decyzji, krzywa zysku i przeciek danych – pięć rysunków z kodem R.
Czytaj →PoradnikPrognoza upadłości firm – regresja logistyczna
1500 firm transportowych: winsoryzacja wskaźników, ilorazy szans, walidacja w czasie, AUC i kalibracja oraz złudna trafność – pięć rysunków z kodem R.
Czytaj →PoradnikScoring kredytowy: WoE, IV i karta punktowa
Kasa spółdzielcza, 6000 pożyczek: przedziały, WoE i IV ręcznie, karta punktowa z PDO, Gini i KS, PSI i przetrenowane przedziały – pięć rysunków z kodem R.
Czytaj →Budujesz model wykrywania nadużyć do pracy z finansów?
Pomożemy podzielić dane w czasie, dobrać miary dla rzadkich zdarzeń, policzyć koszt alarmu i budżet kontroli oraz opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Begg, C. B., & Greenes, R. A. (1983). Assessment of diagnostic tests when disease verification is subject to selection bias. Biometrics, 39(1), 207–215. https://doi.org/10.2307/2530820
- Bolton, R. J., & Hand, D. J. (2002). Statistical fraud detection: A review. Statistical Science, 17(3), 235–255. https://doi.org/10.1214/ss/1042727940 ● Otwarty dostęp
- Breiman, L. (2001). Random forests. Machine Learning, 45(1), 5–32. https://doi.org/10.1023/a:1010933404324 ● Otwarty dostęp: pełny tekst
- Chawla, N. V., Bowyer, K. W., Hall, L. O., & Kegelmeyer, W. P. (2002). SMOTE: Synthetic minority over-sampling technique. Journal of Artificial Intelligence Research, 16, 321–357. https://doi.org/10.1613/jair.953 ● Otwarty dostęp
- Saito, T., & Rehmsmeier, M. (2015). The precision-recall plot is more informative than the ROC plot when evaluating binary classifiers on imbalanced datasets. PLOS ONE, 10(3), Article e0118432. https://doi.org/10.1371/journal.pone.0118432 ● Otwarty dostęp
- van den Goorbergh, R., van Smeden, M., Timmerman, D., & Van Calster, B. (2022). The harm of class imbalance corrections for risk prediction models: Illustration and simulation using logistic regression. Journal of the American Medical Informatics Association, 29(9), 1525–1534. https://doi.org/10.1093/jamia/ocac093 ● Otwarty dostęp
- Viaene, S., Derrig, R. A., Baesens, B., & Dedene, G. (2002). A comparison of state-of-the-art classification techniques for expert automobile insurance claim fraud detection. Journal of Risk and Insurance, 69(3), 373–421. https://doi.org/10.1111/1539-6975.00023
Cytowania BibTeX
@article{begg1983assessment, author={Begg, Colin B. and Greenes, Robert A.}, title={{Assessment of diagnostic tests when disease verification is subject to selection bias}}, journal={Biometrics}, year={1983}, volume={39}, number={1}, pages={207--215}, doi={10.2307/2530820}}@article{bolton2002statistical, author={Bolton, Richard J. and Hand, David J.}, title={{Statistical fraud detection: A review}}, journal={Statistical Science}, year={2002}, volume={17}, number={3}, pages={235--255}, doi={10.1214/ss/1042727940}}@article{breiman2001random, author={Breiman, Leo}, title={{Random forests}}, journal={Machine Learning}, year={2001}, volume={45}, number={1}, pages={5--32}, doi={10.1023/a:1010933404324}}@article{chawla2002smote, author={Chawla, Nitesh V. and Bowyer, Kevin W. and Hall, Lawrence O. and Kegelmeyer, W. Philip}, title={{SMOTE: Synthetic minority over-sampling technique}}, journal={Journal of Artificial Intelligence Research}, year={2002}, volume={16}, pages={321--357}, doi={10.1613/jair.953}}@article{saito2015precision, author={Saito, Takaya and Rehmsmeier, Marc}, title={{The precision-recall plot is more informative than the ROC plot when evaluating binary classifiers on imbalanced datasets}}, journal={PLOS ONE}, year={2015}, volume={10}, number={3}, eid={e0118432}, doi={10.1371/journal.pone.0118432}}@article{vandengoorbergh2022harm, author={van den Goorbergh, Ruben and van Smeden, Maarten and Timmerman, Dirk and Van Calster, Ben}, title={{The harm of class imbalance corrections for risk prediction models: Illustration and simulation using logistic regression}}, journal={Journal of the American Medical Informatics Association}, year={2022}, volume={29}, number={9}, pages={1525--1534}, doi={10.1093/jamia/ocac093}}@article{viaene2002comparison, author={Viaene, Stijn and Derrig, Richard A. and Baesens, Bart and Dedene, Guido}, title={{A comparison of state-of-the-art classification techniques for expert automobile insurance claim fraud detection}}, journal={Journal of Risk and Insurance}, year={2002}, volume={69}, number={3}, pages={373--421}, doi={10.1111/1539-6975.00023}}