Przykład: pożyczki ratalne w kasie spółdzielczej
Fikcyjna kasa spółdzielcza udziela członkom pożyczek ratalnych; dotąd o każdej decydował doradca. Zarząd pyta: czy da się oceniać wnioski jedną przejrzystą regułą, którą doradca policzy i wytłumaczy klientowi? Taką regułą jest karta punktowa (scorecard): każda cecha wniosku daje punkty, a ich suma przekłada się na prawdopodobieństwo niespłacenia.
Mamy 6000 pożyczek udzielonych w latach 2023–2024. Dla każdej znamy cechy z dnia wniosku: wiek, formę zatrudnienia, obciążenie ratą (rata jako procent dochodu netto), liczbę zapytań o kredyt w innych instytucjach w ostatnich 6 miesiącach i staż członkowski w kasie. Dorzuciliśmy miesiąc urodzenia – cechę bez związku ze spłatą. Pożyczka jest „zła”, jeśli w ciągu 12 miesięcy od wypłaty pojawiła się zaległość co najmniej 90 dni. Takich było 6.6%: 12.1% przy umowie cywilnoprawnej i 4.5% wśród emerytów. Osobno mamy 2500 wniosków z 2025 roku, których spłat jeszcze nie znamy.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Rozkłady cech i współczynniki prawdziwego modelu ustawiliśmy ręcznie: ryzyko rośnie z obciążeniem ratą i liczbą zapytań, maleje ze stażem w kasie, jest wyższe u najmłodszych i przy umowie cywilnoprawnej. W 2025 roku kasa uruchomiła wnioski przez internet – stąd młodsi wnioskodawcy, krótszy staż i więcej zapytań. Ziarna 636 ani parametrów po pierwszym uruchomieniu nie zmienialiśmy. Dane pobierzesz jako scoring-pozyczki-kasa.csv.
Kartę budujemy na 4200 losowo wybranych pożyczkach (zbiór uczący, 269 złych), a sprawdzamy na pozostałych 1800 (zbiór testowy, 127 złych, 7.1%). Podstawą jest regresja logistyczna, jak w prognozie upadłości firm. Hand i Henley (1997) opisują scoring jako klasyfikację wnioskodawców na „dobre” i „złe” ryzyko; zauważają, że wiele praktyki pozostaje poza literaturą z powodu poufności.
Rysunek 1: przedziały, WoE i IV
Karta dzieli każdą cechę na kilka przedziałów i każdemu przypisuje WoE (weight of evidence, waga dowodu):
WoE dodatnie znaczy „lepiej niż przeciętnie”, ujemne – „gorzej”. Siłę cechy podsumowuje IV (information value): suma (% spłaconych − % niespłaconych) × WoE po przedziałach; IV = 0 to brak związku ze spłatą.
Najpierw bierzemy drobne przedziały (decyle zbioru uczącego), potem łączymy sąsiednie, aż odsetek złych pożyczek zmienia się w jednym kierunku, każdy przedział ma co najmniej 5% pożyczek, a przedziałów jest najwyżej pięć (reguły ustalone ręcznie). Zapytania dzielimy na 0, 1, 2 i 3+.
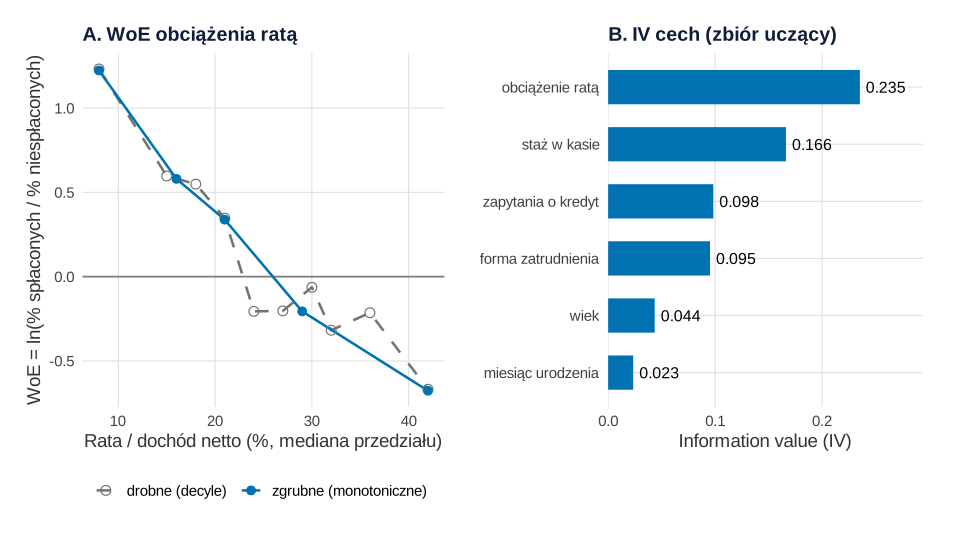
set.seed(636)).Co widać. W decylach (panel A, linia szara) WoE obciążenia ratą skacze – w decylu jest od 8 do 46 złych pożyczek, więc kilka przypadków przesuwa wynik. Po połączeniu zostaje pięć przedziałów z WoE malejącym od 1.22 (rata do 11% dochodu, 1.9% złych) do −0.68 (powyżej 38%, 11.9% złych). Najsilniejsze cechy to obciążenie ratą (IV = 0.235) i staż w kasie (0.166). Wiek zredukował się do dwóch przedziałów (do 34 lat: 9.0% złych, starsi: 5.7%; IV = 0.044).
Jak może zmylić. Miesiąc urodzenia, czysty szum, ma IV = 0.023 tylko dlatego, że ma 12 kategorii (rysunek 5). Progi typu „IV 0.02 – słaba cecha” są umowne. Wymuszona monotoniczność spłaszczy zależność w kształcie litery U.
Podpis do pracy:
Zdanie do Wyników:
Tabela dla obciążenia ratą (punkty – z następnej sekcji):
| Rata / dochód (%) | n | Niespłacone | % niespłaconych | WoE | Wkład do IV | Punkty |
|---|---|---|---|---|---|---|
| ≤ 11 | 426 | 8 | 1.9 | 1.223 | 0.092 | 149 |
| 12–19 | 846 | 31 | 3.7 | 0.580 | 0.053 | 130 |
| 20–22 | 436 | 20 | 4.6 | 0.338 | 0.010 | 123 |
| 23–38 | 2104 | 164 | 7.8 | −0.206 | 0.023 | 107 |
| > 38 | 388 | 46 | 11.9 | −0.677 | 0.057 | 93 |
Rysunek 2: od regresji do karty punktowej
Do regresji logistycznej wstawiamy WoE pięciu cech (bez miesiąca urodzenia). Model przewiduje logit niespłacenia, a WoE dodatnie oznacza bezpieczniej, więc współczynniki są ujemne i bliskie −1: od −0.94 (forma zatrudnienia) do −1.05 (staż), wyraz wolny −2.686. Współczynnik wyraźnie mniejszy co do wartości bezwzględnej oznaczałby, że cecha dubluje informację innych. Zamiast ilorazów szans karta pokazuje punkty.
Skalę wybraliśmy ręcznie: 600 punktów to szanse spłaty 50 : 1, a każde 20 punktów podwaja szanse (PDO, points to double the odds):
Wyraz wolny i offset dzielimy równo między pięć cech: punkty przedziału = −(b × WoE + b0 / 5) × factor + offset / 5.
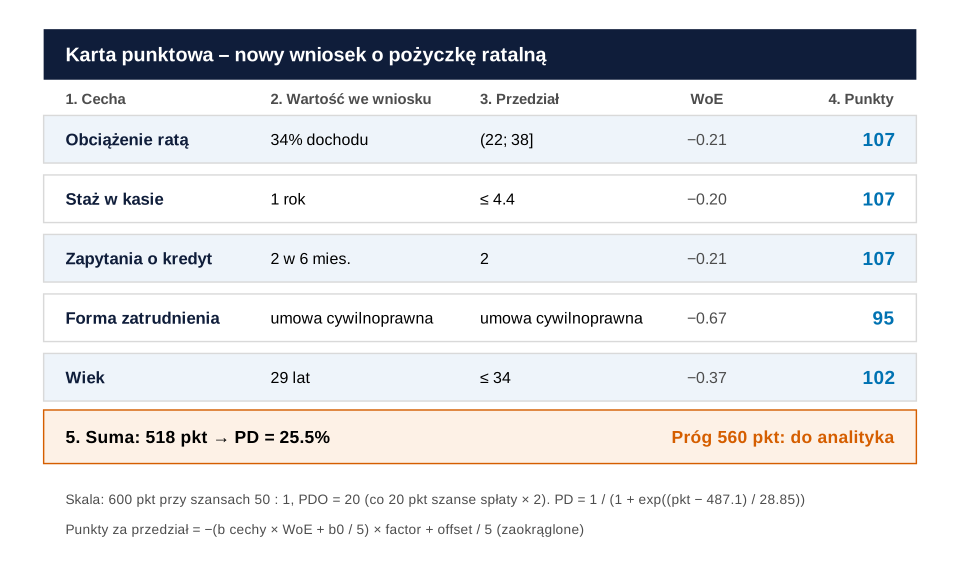
set.seed(636)).Co widać. Wnioskodawca: 29 lat, umowa cywilnoprawna, rata 34% dochodu, dwa zapytania, rok w kasie. Punkty: 107 + 107 + 107 + 95 + 102 = 518, co odpowiada prawdopodobieństwu niespłacenia (PD) 25.5%. Przy przyjętym w przykładzie progu 560 punktów (PD 7.4%) wniosek trafia do analityka. Widać też, co obniżyło wynik: umowa cywilnoprawna (95 punktów).
Jak może zmylić. Rata 23% i 38% dochodu daje tyle samo punktów, a drobna zmiana na granicy przedziału – skok o kilkanaście. Próg 560 jest założeniem; w praktyce wynika z kosztów (wykrywanie nadużyć – koszt alarmu, model odejść – próg z kosztów). PD z karty jest wiarygodne tylko przy dobrej kalibracji.
Podpis do pracy:
Zdanie do Metody:
Rysunek 3: Gini, AUC i KS na zbiorze testowym
Kartę oceniamy na 1800 pożyczkach, których nie widziała. Gini = 2 × AUC − 1 to pole pod krzywą ROC przeskalowane tak, że 0 oznacza losowe punkty, a 1 – idealne rozdzielenie (z indeksem Giniego nierówności łączy go tylko pomysł pola między krzywą a przekątną). KS to największa pionowa odległość między dystrybuantami punktów złych i dobrych pożyczek – ta sama statystyka co w teście Kołmogorowa–Smirnowa. Baesens i in. (2003) porównali wiele klasyfikatorów na ośmiu zbiorach danych kredytowych: regresja logistyczna wypadała bardzo dobrze obok bardziej złożonych metod.
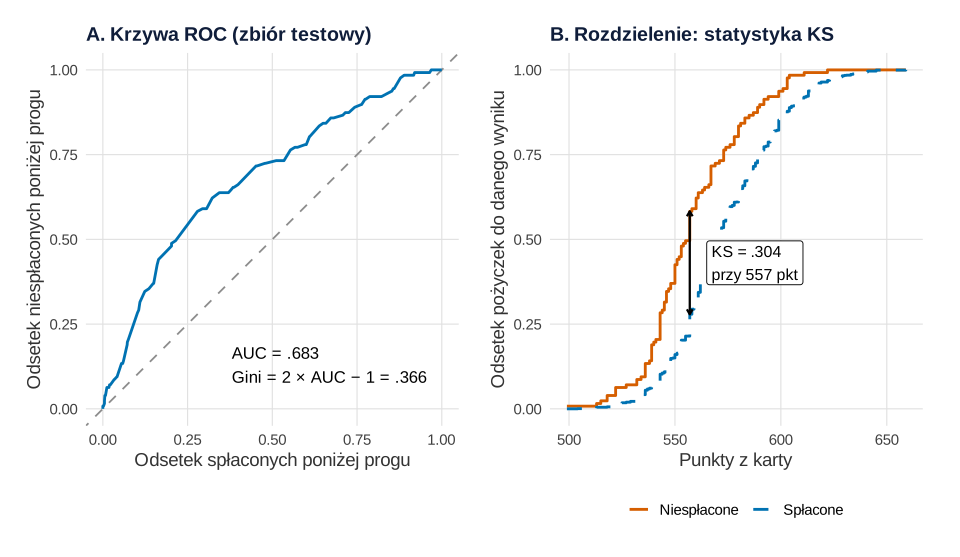
set.seed(636)).Co widać. W zbiorze testowym AUC = .683, Gini = .366, 95% CI [.267, .461], a KS = .304 [.233, .398] przy 557 punktach. W zbiorze uczącym Gini wynosił .426. Przy progu 560 karta akceptuje 67.4% wniosków; złych jest 4.3% wśród zaakceptowanych i 12.8% wśród odrzuconych.
Jak może zmylić. Przy 127 złych pożyczkach przedział dla Gini (bootstrap, 2000 prób) ma szerokość prawie .20. Gini i KS mówią o kolejności wniosków, nie o trafności PD. Podział był losowy; uczciwszy jest podział w czasie (walidacja w czasie).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: czy klienci z 2025 roku są tacy sami?
Karta działa, dopóki wnioskodawcy przypominają tych, na których ją zbudowano. Spłat z 2025 roku jeszcze nie znamy, ale rozkład punktów porównamy od razu. PSI (population stability index) sumuje po pasmach punktów (decylach z lat 2023–2024) wyrażenie (udział teraz − udział dawniej) × ln(udział teraz / udział dawniej). Ten sam wzór stosujemy do przedziałów każdej cechy.
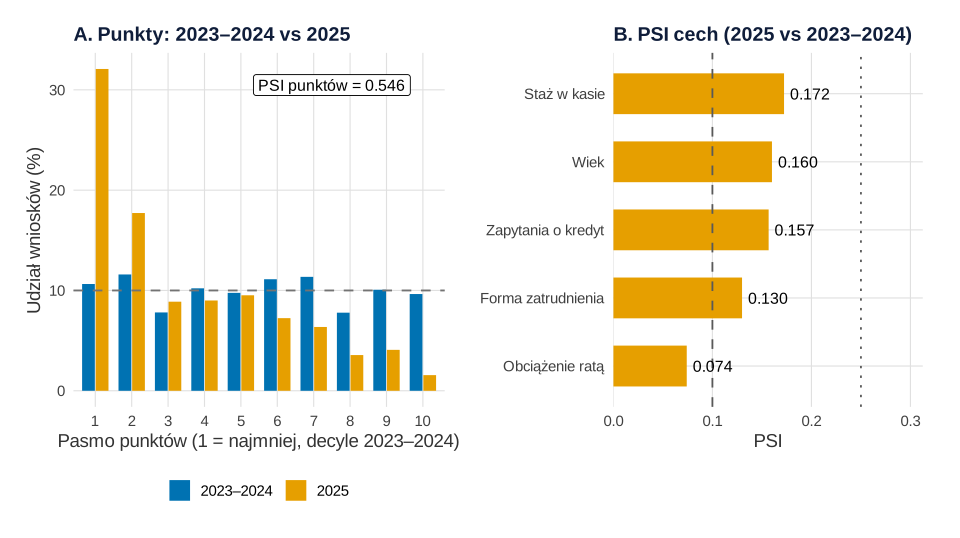
set.seed(636)).Co widać. Między zbiorem uczącym a testowym (ta sama populacja) PSI = 0.006. Między latami 2023–2024 a 2025 – PSI = 0.546: do najniższego pasma wpada 32.1% nowych wniosków (wcześniej 10.6%), do najwyższego – 1.6% (wcześniej 9.6%). Średni wynik spadł z 572.8 do 555.1 punktu; karta zaakceptowałaby 38.5% wniosków (średnie PD 10.5%). Źródła zmiany (panel B): staż w kasie (0.172), wiek (0.160) i zapytania (0.157) – to, co zmienił kanał internetowy.
Jak może zmylić. Popularna reguła mówi: PSI poniżej 0.10 – mała zmiana, 0.10–0.25 – umiarkowana, powyżej 0.25 – znaczna. Yurdakul i Naranjo (2020) zauważają, że progi te stosuje się bez odniesienia do błędów I i II rodzaju. Wysokie PSI nie znaczy, że karta przestała różnicować – trzeba to sprawdzić na spłatach.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: przetrenowane przedziały i koszt dzielenia
Ile przedziałów to za dużo? Symulacja: cechę z czystego szumu dzielimy na 2–50 równolicznych przedziałów i liczymy jej IV w zbiorze uczącym (500 powtórzeń). Potem porównujemy Gini czterech wariantów modelu.
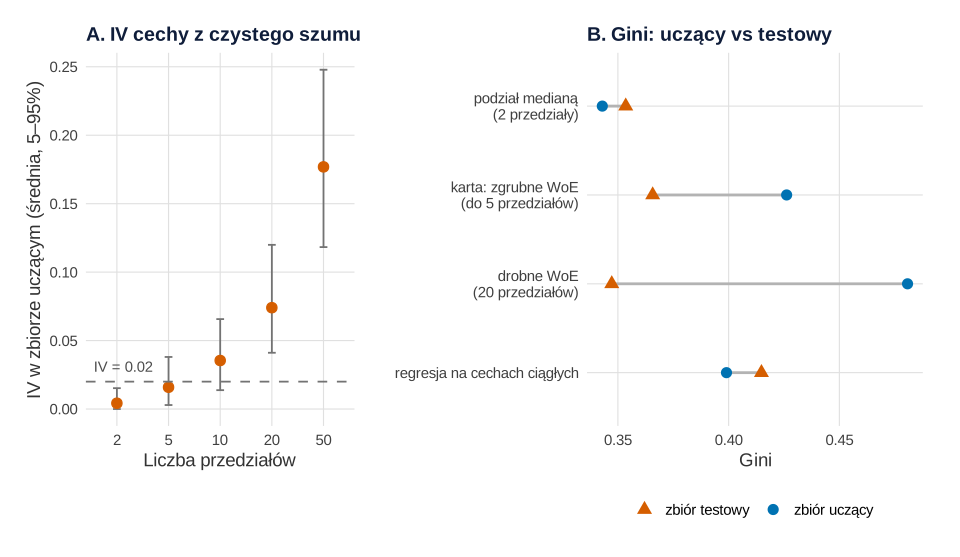
set.seed(636)).Co widać. Szum podzielony na 2 przedziały ma średnio IV = 0.004, na 10 – 0.035 (82.8% symulacji powyżej 0.02), na 20 – 0.074, na 50 – 0.177 (błąd Monte Carlo średnich 0.0003–0.0018). W panelu B karta z 20 drobnymi przedziałami ma najwyższy Gini w zbiorze uczącym (.481) i najniższy w testowym (.347) – to przeuczenie. Podział każdej cechy medianą daje w teście .354, karta ze zgrubnymi przedziałami .366, a zwykła regresja na cechach ciągłych .415.
Jak może zmylić. Różnice w teście (.347–.415) są mniejsze niż szerokość przedziału z rysunku 3 – nie ogłaszaj zwycięzcy na jednym podziale, użyj walidacji krzyżowej. Kierunek zgadza się z literaturą: dzielenie zmiennej ciągłej traci informację (dzielenie medianą), a granice wybrane na danych obciążają wynik (Royston i in., 2006). Karta wygrywa przejrzystością, nie trafnością; nieliniowość lepiej oddają splajny i GAM.
Podpis do pracy:
Zdanie do Metody:
Co z tym zrobić w firmie
- Wdróż kartę jako regułę z wyjątkami. Wnioski poniżej progu kieruj do analityka; próg ustal z kosztu straconej pożyczki i zysku z dobrej.
- Używaj punktów w rozmowie z klientem. Gdy wynik obniża wysoka rata, doradca może zaproponować dłuższy okres spłaty.
- Monitoruj PSI co kwartał. Po zmianie kanału sprzedaży sprawdź kartę na pierwszych spłatach, zanim zdecyduje o wnioskach internetowych.
- Nie wyciągaj wniosków przyczynowych. Dłuższy staż daje punkty, ale nie „robi” lepszych dłużników.
Jak opisać w pracy
Opisz definicję „złej” pożyczki, przedziały, skalę punktów i ocenę karty. Kontekst daje wpis statystyka w pracy z finansów i rachunkowości, procedurę – regresja logistyczna krok po kroku.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę i motyw, przepis 2 – przedziały i WoE, przepis 3 – kartę, przepis 4 – punkty i funkcję auc() używane w przepisach 5 i 6. Przepisy 2–6 kończą się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki 1 i 3–5 na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka), a rysunek 2 zapisano bez zmian – dane, geometrie i skale są identyczne.
Losują przepisy 1, 4 i 6: każdy blok losujący zaczyna od własnego set.seed(636), więc skopiowany osobno (z wcześniejszymi przepisami) da te same liczby co na stronie. Ziarno 636 ustalono raz i nie zmieniano go. Ręcznie ustalono: liczebności (6000 pożyczek, 2500 wniosków z 2025 roku, podział 4200/1800), rozkłady cech w obu okresach i współczynniki prawdziwego modelu niespłacenia (przepis 1; wyraz wolny −2.9 nie był zmieniany); reguły łączenia przedziałów – decyle, monotoniczność, co najmniej 5% obserwacji, najwyżej 5 przedziałów – i przedziały liczby zapytań (przepis 2); skalę karty (600 punktów, szanse 50 : 1, PDO = 20), próg 560 punktów i cechy przykładowego wniosku (przepis 3); 2000 prób bootstrapowych (przepis 4); 500 powtórzeń symulacji i liczby przedziałów 2–50 (przepis 6). Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się w kilka sekund.
1. Dane: pożyczki 2023–2024, wnioski z 2025 roku i podział na zbiory
R
# Przepis 1. Pożyczki ratalne fikcyjnej kasy spółdzielczej: wnioski z lat 2023–2024 (ze spłatą) i z 2025 roku
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw rysunków
kol <- c("Spłacone" = "#0072B2", "Niespłacone" = "#D55E00", "2023–2024" = "#0072B2", "2025" = "#E69F00",
         "zbiór uczący" = "#0072B2", "zbiór testowy" = "#D55E00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Cechy wnioskodawcy znane w dniu wniosku. Rozkłady i współczynniki prawdziwego modelu ustalono ręcznie.
# W 2025 roku kasa uruchomiła wnioski przez internet: więcej młodych osób, umów cywilnoprawnych,
# nowych członków i zapytań o kredyt w innych instytucjach (to zmiana populacji z przepisu 5).
losuj_wnioski <- function(n, rok2025 = FALSE) {
  wiek <- round(pmin(75, pmax(21, rnorm(n, if (rok2025) 38 else 45, 13))))
  forma <- sample(c("umowa o pracę", "emerytura", "umowa cywilnoprawna", "działalność"), n, replace = TRUE,
                  prob = if (rok2025) c(.50, .16, .24, .10) else c(.55, .25, .12, .08))
  obciazenie <- round(pmin(60, pmax(3, rnorm(n, if (rok2025) 28 else 25, 10))))   # rata / dochód netto (%)
  zapytania <- rpois(n, if (rok2025) 1.2 else 0.8)      # zapytania o kredyt w innych instytucjach (6 mies.)
  staz_kasa <- pmin(30, round(rexp(n, 1 / (if (rok2025) 4 else 6)), 1))   # lata członkostwa w kasie
  miesiac_ur <- sample(1:12, n, replace = TRUE)         # miesiąc urodzenia – cecha bez związku ze spłatą
  data.frame(wiek, forma, obciazenie, zapytania, staz_kasa, miesiac_ur)
}
set.seed(636)                                    # ziarno ustalone raz, bez dobierania pod wynik
pozyczki <- losuj_wnioski(6000)                  # pożyczki udzielone w latach 2023–2024
logit <- -2.9 + 0.9 * exp(-(pozyczki$wiek - 21) / 8) + 0.045 * (pozyczki$obciazenie - 25) +
  0.35 * pozyczki$zapytania - 0.06 * pozyczki$staz_kasa +
  c("umowa o pracę" = 0, "emerytura" = -0.3, "umowa cywilnoprawna" = 0.6, "działalność" = 0.4)[pozyczki$forma]
pozyczki$zla <- rbinom(6000, 1, plogis(logit))   # 1 = zaległość 90+ dni w ciągu 12 miesięcy od wypłaty
wnioski2025 <- losuj_wnioski(2500, rok2025 = TRUE)   # wnioski z 2025 roku – spłat jeszcze nie znamy
write.csv(pozyczki, "scoring-pozyczki-kasa.csv", row.names = FALSE)

# Podział pożyczek 2023–2024: zbiór uczący (4200) i testowy (1800)
set.seed(636)
ucz <- sample(6000, 4200)
train <- pozyczki[ucz, ]; test <- pozyczki[-ucz, ]
c(niesplacone_proc = round(100 * mean(pozyczki$zla), 1), uczacy = round(100 * mean(train$zla), 1),
  testowy = round(100 * mean(test$zla), 1), niesplacone_uczacy = sum(train$zla), niesplacone_test = sum(test$zla))
round(100 * tapply(pozyczki$zla, pozyczki$forma, mean), 1)   # odsetek niespłaconych według formy zatrudnienia
Wynik w R
  niesplacone_proc             uczacy            testowy niesplacone_uczacy
               6.6                6.4                7.1              269.0
  niesplacone_test
             127.0
        działalność           emerytura umowa cywilnoprawna       umowa o pracę
                8.9                 4.5                12.1                 6.1
2. Przedziały, WoE i IV (rysunek 1)
R
# Przepis 2. Przedziały, WoE i IV liczone ręcznie na zbiorze uczącym (korzysta z train, test, kol, motyw z przepisu 1)
library(ggplot2)
library(patchwork)

# Tabela WoE: dla każdego przedziału liczba spłaconych (dobrych) i niespłaconych (złych),
# WoE = ln(% dobrych / % złych), wkład do IV = (% dobrych − % złych) × WoE.
# 0.5 dodane do liczebności chroni przed ln(0) w bardzo małych przedziałach.
tabela_woe <- function(przedzial, zla) {
  t <- table(przedzial, factor(zla, levels = 0:1))
  dobrzy <- t[, "0"] + 0.5; zli <- t[, "1"] + 0.5
  woe <- log((dobrzy / sum(dobrzy)) / (zli / sum(zli)))
  data.frame(przedzial = rownames(t), n = as.vector(rowSums(t)), zli = as.vector(t[, "1"]),
             proc_zlych = round(100 * as.vector(t[, "1"] / rowSums(t)), 1), woe = round(as.vector(woe), 3),
             iv = round(as.vector((dobrzy / sum(dobrzy) - zli / sum(zli)) * woe), 4))
}
# Drobne przedziały: decyle zbioru uczącego. Zgrubne: łączymy sąsiednie przedziały, dopóki odsetek złych
# nie zmienia się monotonicznie (w kierunku korelacji ze zmienną), każdy przedział ma ≥ 5% pożyczek,
# a przedziałów jest najwyżej 5. Granice zapamiętujemy i stosujemy bez zmian do zbioru testowego i do 2025 roku.
zgrubne_granice <- function(x, zla, max_przedz = 5, min_udzial = 0.05) {
  gr <- unique(quantile(x, seq(0, 1, 0.1), type = 1))
  gr[1] <- -Inf; gr[length(gr)] <- Inf
  kierunek <- sign(cor(x, zla, method = "spearman"))
  repeat {
    p <- cut(x, gr, right = TRUE)
    zl <- tapply(zla, p, sum); n <- tapply(zla, p, length); r <- zl / n
    zle <- which(kierunek * diff(r) <= 0)                 # pary łamiące monotoniczność
    male <- which(n / length(x) < min_udzial)
    if (length(zle) == 0 && length(male) == 0 && length(n) <= max_przedz) break
    if (length(zle)) i <- zle[which.min(abs(diff(r))[zle])]          # najpierw najmniejsze złamanie
    else if (length(male)) i <- min(max(male[1] - 1, 1), length(n) - 1)
    else i <- which.min(abs(diff(r)))                     # potem para najbardziej podobnych przedziałów
    gr <- gr[-(i + 1)]                                    # usunięcie granicy = połączenie przedziałów i, i+1
  }
  gr
}
ciagle <- c("wiek", "obciazenie", "staz_kasa")
granice <- lapply(setNames(ciagle, ciagle), function(v) zgrubne_granice(train[[v]], train$zla))
przedzialy <- function(d) {                               # te same reguły dla każdego zbioru danych
  out <- lapply(ciagle, function(v) cut(d[[v]], granice[[v]], right = TRUE))
  names(out) <- ciagle
  out$zapytania <- cut(d$zapytania, c(-Inf, 0, 1, 2, Inf), labels = c("0", "1", "2", "3+"))
  out$forma <- factor(d$forma)
  out$miesiac_ur <- factor(d$miesiac_ur)
  as.data.frame(out)
}
bin_train <- przedzialy(train)
woe_tab <- lapply(bin_train, tabela_woe, zla = train$zla)
woe_tab$obciazenie
woe_tab$wiek
iv <- sort(sapply(woe_tab, function(t) sum(t$iv)), decreasing = TRUE)
round(iv, 3)                                              # IV zgrubnych przedziałów (miesiąc urodzenia: 12)

# Rysunek 1. A: WoE obciążenia ratą w drobnych (decyle) i zgrubnych przedziałach; B: IV cech
dec <- cut(train$obciazenie, unique(c(-Inf, quantile(train$obciazenie, seq(0.1, 0.9, 0.1), type = 1), Inf)))
drobne <- tabela_woe(dec, train$zla)
drobne[, c("przedzial", "n", "zli", "woe")]                 # WoE w decylach skacze
srodek <- function(x, p) tapply(x, p, median)
d1 <- rbind(data.frame(rodzaj = "drobne (decyle)", x = srodek(train$obciazenie, dec), woe = drobne$woe),
            data.frame(rodzaj = "zgrubne (monotoniczne)", x = srodek(train$obciazenie, bin_train$obciazenie),
                       woe = woe_tab$obciazenie$woe))
pA <- ggplot(d1, aes(x, woe, colour = rodzaj, shape = rodzaj, linetype = rodzaj)) +
  geom_hline(yintercept = 0, colour = "grey50") + geom_line(linewidth = 0.9) + geom_point(size = 3) +
  scale_colour_manual(values = c("grey45", "#0072B2"), name = NULL) +
  scale_shape_manual(values = c(1, 16), name = NULL) + scale_linetype_manual(values = c("dashed", "solid"), name = NULL) +
  labs(title = "A. WoE obciążenia ratą", x = "Rata / dochód netto (%, mediana przedziału)",
       y = "WoE = ln(% spłaconych / % niespłaconych)") + motyw + theme(legend.position = "bottom")
nazwy <- c(obciazenie = "obciążenie ratą", zapytania = "zapytania o kredyt", wiek = "wiek",
           staz_kasa = "staż w kasie", forma = "forma zatrudnienia", miesiac_ur = "miesiąc urodzenia")
d2 <- data.frame(cecha = factor(nazwy[names(iv)], levels = rev(nazwy[names(iv)])), iv = iv)
pB <- ggplot(d2, aes(iv, cecha)) + geom_col(fill = "#0072B2", width = 0.6) +
  geom_text(aes(label = sprintf("%.3f", round(iv, 3))), hjust = -0.15, size = 4.2) +
  scale_x_continuous(expand = expansion(mult = c(0, 0.25))) +
  labs(title = "B. IV cech (zbiór uczący)", x = "Information value (IV)", y = NULL) + motyw
p1 <- pA + pB + plot_layout(widths = c(1.15, 1))
p1   # zapis: ggsave("scoring-woe-iv.svg", p1, width = 10, height = 5.6)
Wynik w R
  przedzial    n zli proc_zlych    woe     iv
1 (-Inf,11]  426   8        1.9  1.223 0.0919
2   (11,19]  846  31        3.7  0.580 0.0530
3   (19,22]  436  20        4.6  0.338 0.0103
4   (22,38] 2104 164        7.8 -0.206 0.0231
5 (38, Inf]  388  46       11.9 -0.677 0.0570
  przedzial    n zli proc_zlych    woe     iv
1 (-Inf,34]  869  78        9.0 -0.368 0.0329
2 (34, Inf] 3331 191        5.7  0.119 0.0106
obciazenie  staz_kasa  zapytania      forma       wiek miesiac_ur
     0.235      0.166      0.098      0.095      0.044      0.023
   przedzial   n zli    woe
1  (-Inf,11] 426   8  1.232
2    (11,16] 446  16  0.597
3    (16,19] 400  15  0.549
4    (19,22] 436  20  0.347
5    (22,25] 475  37 -0.206
6    (25,28] 489  38 -0.203
7    (28,30] 325  22 -0.063
8    (30,33] 394  34 -0.318
9    (33,38] 421  33 -0.214
10 (38, Inf] 388  46 -0.668
3. Regresja na WoE i karta punktowa (rysunek 2)
R
# Przepis 3. Regresja logistyczna na WoE i karta punktowa (korzysta z przepisów 1–2)
library(ggplot2)

cechy <- c("obciazenie", "staz_kasa", "zapytania", "forma", "wiek")   # miesiąc urodzenia pomijamy
na_woe <- function(bin) {                                 # zamiana przedziału na jego WoE ze zbioru uczącego
  out <- sapply(cechy, function(v) woe_tab[[v]]$woe[match(as.character(bin[[v]]), woe_tab[[v]]$przedzial)])
  as.data.frame(out)
}
w_train <- na_woe(bin_train); w_train$zla <- train$zla
model <- glm(zla ~ ., family = binomial, data = w_train)
round(cbind(b = coef(model), confint.default(model)), 3)  # przy WoE współczynniki bliskie −1

# Skalowanie: 600 punktów przy szansach 50 : 1 (spłacona : niespłacona), co 20 punktów (PDO) szanse się podwajają
pdo <- 20; wynik0 <- 600; szanse0 <- 50
factor <- pdo / log(2); offset <- wynik0 - factor * log(szanse0)
round(c(factor = factor, offset = offset), 2)
k <- length(cechy); b0 <- coef(model)[1]
karta <- do.call(rbind, lapply(cechy, function(v) {
  t <- woe_tab[[v]]
  data.frame(cecha = v, przedzial = t$przedzial, woe = t$woe,
             punkty = round(-(coef(model)[v] * t$woe + b0 / k) * factor + offset / k))
}))
karta                                                     # karta punktowa: punkty za każdy przedział
punkty_wniosku <- function(bin) {                         # suma punktów wniosków (wiersze bin)
  rowSums(sapply(cechy, function(v) {
    kv <- karta[karta$cecha == v, ]; kv$punkty[match(as.character(bin[[v]]), kv$przedzial)]
  }))
}
pd_z_punktow <- function(s) 1 / (1 + exp((s - offset) / factor))   # punkty → prawdopodobieństwo niespłacenia

# Nowy wniosek (fikcyjny): 29 lat, umowa cywilnoprawna, rata = 34% dochodu, 2 zapytania, 1 rok w kasie
wniosek <- data.frame(wiek = 29, forma = "umowa cywilnoprawna", obciazenie = 34, zapytania = 2,
                      staz_kasa = 1, miesiac_ur = 5)
b_wn <- przedzialy(wniosek)
pk <- sapply(cechy, function(v) karta$punkty[karta$cecha == v & karta$przedzial == as.character(b_wn[[v]])])
suma <- sum(pk)
prog <- 560                                               # próg akceptacji przyjęty w przykładzie
c(punkty = pk, suma = suma, PD_proc = round(100 * pd_z_punktow(suma), 1),
  PD_w_progu_proc = round(100 * pd_z_punktow(prog), 1))

# Rysunek 2 (grafika): karta punktowa dla jednego wniosku krok po kroku
etyk <- c(obciazenie = "Obciążenie ratą", staz_kasa = "Staż w kasie", zapytania = "Zapytania o kredyt",
          forma = "Forma zatrudnienia", wiek = "Wiek")
wartosc <- c(obciazenie = "34% dochodu", staz_kasa = "1 rok", zapytania = "2 w 6 mies.",
             forma = "umowa cywilnoprawna", wiek = "29 lat")
ladnie <- function(p) {                                   # "(22,38]" → "23–38"; "(-Inf,11]" → "≤ 11"
  p <- gsub("\\(-Inf,([0-9.]+)\\]", "≤ \\1", p); p <- gsub("\\(([0-9.]+), ?Inf\\]", "> \\1", p)
  gsub("\\(([0-9.]+),([0-9.]+)\\]", "(\\1; \\2]", p)
}
wiersze <- data.frame(y = 6:2, cecha = etyk[cechy], wart = wartosc[cechy],
                      przedz = ladnie(sapply(cechy, function(v) as.character(b_wn[[v]]))),
                      woe = sapply(cechy, function(v) woe_tab[[v]]$woe[woe_tab[[v]]$przedzial == as.character(b_wn[[v]])]),
                      pkt = pk)
p2 <- ggplot() + xlim(0, 10) + ylim(-0.9, 7.9) +
  annotate("rect", xmin = 0, xmax = 10, ymin = 7.0, ymax = 7.85, fill = "#0f1d3a") +
  annotate("text", x = 0.25, y = 7.43, label = "Karta punktowa – nowy wniosek o pożyczkę ratalną",
           hjust = 0, colour = "white", fontface = "bold", size = 5.2) +
  annotate("text", x = c(0.25, 2.6, 5.0, 7.6, 9.75), y = 6.68, hjust = c(0, 0, 0, 0.5, 1), size = 3.9,
           colour = "grey30", fontface = "bold",
           label = c("1. Cecha", "2. Wartość we wniosku", "3. Przedział", "WoE", "4. Punkty")) +
  geom_rect(data = wiersze, aes(xmin = 0, xmax = 10, ymin = y - 0.4, ymax = y + 0.4),
            fill = rep(c("#eef4fa", "white"), length.out = 5), colour = "grey85") +
  geom_text(data = wiersze, aes(0.25, y, label = cecha), hjust = 0, size = 4.4, fontface = "bold", colour = "#0f1d3a") +
  geom_text(data = wiersze, aes(2.6, y, label = wart), hjust = 0, size = 4.2) +
  geom_text(data = wiersze, aes(5.0, y, label = przedz), hjust = 0, size = 4.2) +
  geom_text(data = wiersze, aes(7.6, y, label = sub("-", "−", sprintf("%.2f", woe))), size = 4.2, colour = "grey30") +
  geom_text(data = wiersze, aes(9.75, y, label = pkt), hjust = 1, size = 5, fontface = "bold", colour = "#0072B2") +
  annotate("rect", xmin = 0, xmax = 10, ymin = 0.55, ymax = 1.45, fill = "#fdf1e6", colour = "#D55E00") +
  annotate("text", x = 0.25, y = 1, hjust = 0, size = 4.6, fontface = "bold",
           label = sprintf("5. Suma: %d pkt  →  PD = %.1f%%", suma, 100 * pd_z_punktow(suma))) +
  annotate("text", x = 9.75, y = 1, hjust = 1, size = 4.6, fontface = "bold", colour = "#D55E00",
           label = sprintf("Próg %d pkt: %s", prog, ifelse(suma >= prog, "akceptacja", "do analityka"))) +
  annotate("text", x = 0.25, y = -0.05, hjust = 0, size = 3.6, colour = "grey30",
           label = sprintf("Skala: %d pkt przy szansach %d : 1, PDO = %d (co %d pkt szanse spłaty × 2). PD = 1 / (1 + exp((pkt − %.1f) / %.2f))",
                           wynik0, szanse0, pdo, pdo, offset, factor)) +
  annotate("text", x = 0.25, y = -0.55, hjust = 0, size = 3.6, colour = "grey30",
           label = "Punkty za przedział = −(b cechy × WoE + b0 / 5) × factor + offset / 5 (zaokrąglone)") +
  theme_void() + theme(plot.background = element_rect(fill = "white", colour = NA))
p2   # zapis: ggsave("scoring-karta-punktowa.svg", p2, width = 10, height = 6)
Wynik w R
                 b  2.5 % 97.5 %
(Intercept) -2.686 -2.820 -2.552
obciazenie  -1.036 -1.327 -0.744
staz_kasa   -1.053 -1.455 -0.652
zapytania   -0.971 -1.347 -0.595
forma       -0.938 -1.317 -0.559
wiek        -1.014 -1.592 -0.436
factor offset
 28.85 487.12
        cecha           przedzial    woe punkty
1  obciazenie           (-Inf,11]  1.223    149
2  obciazenie             (11,19]  0.580    130
3  obciazenie             (19,22]  0.338    123
4  obciazenie             (22,38] -0.206    107
5  obciazenie           (38, Inf] -0.677     93
6   staz_kasa          (-Inf,4.4] -0.200    107
7   staz_kasa           (4.4,5.7] -0.138    109
8   staz_kasa           (5.7,9.7] -0.028    112
9   staz_kasa          (9.7,13.8]  0.729    135
10  staz_kasa         (13.8, Inf]  1.334    153
11  zapytania                   0  0.293    121
12  zapytania                   1 -0.057    111
13  zapytania                   2 -0.215    107
14  zapytania                  3+ -0.898     88
15      forma         działalność -0.150    109
16      forma           emerytura  0.273    120
17      forma umowa cywilnoprawna -0.668     95
18      forma       umowa o pracę  0.109    116
19       wiek           (-Inf,34] -0.368    102
20       wiek           (34, Inf]  0.119    116
punkty.obciazenie  punkty.staz_kasa  punkty.zapytania      punkty.forma
            107.0             107.0             107.0              95.0
      punkty.wiek              suma           PD_proc   PD_w_progu_proc
            102.0             518.0              25.5               7.4
4. AUC, Gini i KS na zbiorze testowym (rysunek 3)
R
# Przepis 4. Ocena karty na zbiorze testowym: AUC, Gini i KS (korzysta z przepisów 1–3)
library(ggplot2)
library(patchwork)

bin_test <- przedzialy(test)
test$punkty <- punkty_wniosku(bin_test)
train$punkty <- punkty_wniosku(bin_train)
auc <- function(s, y) {             # AUC = P(spłacona pożyczka ma więcej punktów niż niespłacona)
  r <- rank(s); n1 <- sum(y == 0); n0 <- sum(y == 1)
  (sum(r[y == 0]) - n1 * (n1 + 1) / 2) / (n1 * n0)
}
ks <- function(s, y) {              # KS = największa różnica dystrybuant punktów złych i dobrych
  g <- sort(unique(s)); max(abs(ecdf(s[y == 1])(g) - ecdf(s[y == 0])(g)))
}
wyn <- c(AUC_uczacy = auc(train$punkty, train$zla), AUC_test = auc(test$punkty, test$zla),
         Gini_uczacy = 2 * auc(train$punkty, train$zla) - 1, Gini_test = 2 * auc(test$punkty, test$zla) - 1,
         KS_uczacy = ks(train$punkty, train$zla), KS_test = ks(test$punkty, test$zla))
round(wyn, 3)
set.seed(636)                        # bootstrap przedziałów dla Gini i KS w zbiorze testowym (2000 prób)
boot <- replicate(2000, { i <- sample(nrow(test), replace = TRUE)
  c(gini = 2 * auc(test$punkty[i], test$zla[i]) - 1, ks = ks(test$punkty[i], test$zla[i])) })
round(apply(boot, 1, quantile, c(.025, .975)), 3)
akcept <- test$punkty >= prog        # próg 560 pkt z przepisu 3
round(c(akceptacja_proc = 100 * mean(akcept), zle_wsrod_akcept = 100 * mean(test$zla[akcept]),
        zle_wsrod_odrzuc = 100 * mean(test$zla[!akcept])), 1)

# Rysunek 3. A: krzywa ROC; B: dystrybuanty punktów złych i dobrych z odległością KS
g <- sort(unique(test$punkty))
Fz <- ecdf(test$punkty[test$zla == 1])(g); Fd <- ecdf(test$punkty[test$zla == 0])(g)
roc <- data.frame(fpr = c(0, Fd), tpr = c(0, Fz))   # próg t: „odrzuć”, gdy punkty ≤ t
pA <- ggplot(roc, aes(fpr, tpr)) + geom_abline(linetype = "dashed", colour = "grey55") +
  geom_path(colour = "#0072B2", linewidth = 1) +
  annotate("text", x = 0.38, y = 0.13, hjust = 0, size = 4.4,
           label = gsub("= 0\\.", "= .", sprintf("AUC = %.3f\nGini = 2 × AUC − 1 = %.3f", wyn["AUC_test"], wyn["Gini_test"]))) +
  coord_equal() + labs(title = "A. Krzywa ROC (zbiór testowy)",
                       x = "Odsetek spłaconych poniżej progu", y = "Odsetek niespłaconych poniżej progu") + motyw
i <- which.max(abs(Fz - Fd))
d <- rbind(data.frame(grupa = "Niespłacone", punkty = g, F = Fz), data.frame(grupa = "Spłacone", punkty = g, F = Fd))
pB <- ggplot(d, aes(punkty, F, colour = grupa, linetype = grupa)) + geom_step(linewidth = 1) +
  annotate("segment", x = g[i], xend = g[i], y = Fd[i], yend = Fz[i], colour = "black", linewidth = 0.8,
           arrow = arrow(ends = "both", length = unit(0.15, "cm"))) +
  annotate("label", x = g[i] + 8, y = (Fd[i] + Fz[i]) / 2, hjust = 0, size = 4.2,
           label = sub("= 0", "= ", sprintf("KS = %.3f\nprzy %d pkt", wyn["KS_test"], g[i]))) +
  scale_colour_manual(values = kol, name = NULL) + scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  labs(title = "B. Rozdzielenie: statystyka KS", x = "Punkty z karty", y = "Odsetek pożyczek do danego wyniku") + motyw
p3 <- pA + pB
p3   # zapis: ggsave("scoring-gini-ks.svg", p3, width = 10, height = 5.6)
Wynik w R
 AUC_uczacy    AUC_test Gini_uczacy   Gini_test   KS_uczacy     KS_test
      0.713       0.683       0.426       0.366       0.297       0.304
       gini    ks
2.5%  0.267 0.233
97.5% 0.461 0.398
 akceptacja_proc zle_wsrod_akcept zle_wsrod_odrzuc
            67.4              4.3             12.8
5. Stabilność populacji – PSI (rysunek 4)
R
# Przepis 5. Stabilność populacji (PSI) między latami 2023–2024 a 2025 (korzysta z przepisów 1–4)
library(ggplot2)
library(patchwork)

# PSI = Σ (udział teraz − udział w danych do budowy) × ln(udział teraz / udział w danych do budowy)
psi <- function(oczek, akt) {
  e <- as.vector(prop.table(table(oczek))); a <- as.vector(prop.table(table(akt)))
  sum((a - e) * log(a / e))
}
bin_2025 <- przedzialy(wnioski2025)
wnioski2025$punkty <- punkty_wniosku(bin_2025)
pasma <- unique(c(-Inf, quantile(train$punkty, seq(0.1, 0.9, 0.1), type = 1), Inf))   # pasma punktów
pas <- function(s) cut(s, pasma)
round(c(PSI_uczacy_vs_test = psi(pas(train$punkty), pas(test$punkty)),
        PSI_uczacy_vs_2025 = psi(pas(train$punkty), pas(wnioski2025$punkty))), 3)
csi <- sapply(cechy, function(v) psi(bin_train[[v]], bin_2025[[v]]))   # ten sam wzór dla każdej cechy
round(sort(csi, decreasing = TRUE), 3)
round(c(srednie_pkt_uczacy = mean(train$punkty), srednie_pkt_2025 = mean(wnioski2025$punkty),
        akceptacja_2025_proc = 100 * mean(wnioski2025$punkty >= prog),
        PD_srednie_2025_proc = 100 * mean(pd_z_punktow(wnioski2025$punkty))), 1)

# Rysunek 4. A: rozkład punktów w pasmach; B: PSI cech (CSI) z umownymi progami 0.10 i 0.25
uk <- function(s, okres) data.frame(okres = okres, pasmo = factor(seq_along(pasma[-1])),
                                     udzial = 100 * as.vector(prop.table(table(pas(s)))))
d4 <- rbind(uk(train$punkty, "2023–2024"), uk(wnioski2025$punkty, "2025"))
reshape(transform(d4, udzial = round(udzial, 1)), idvar = "pasmo", timevar = "okres", direction = "wide")
pA <- ggplot(d4, aes(pasmo, udzial, fill = okres)) + geom_col(position = position_dodge(0.75), width = 0.7) +
  geom_hline(yintercept = 10, linetype = "dashed", colour = "grey45") +
  scale_fill_manual(values = kol, name = NULL) +
  annotate("label", x = 7.5, y = max(d4$udzial) * 0.95, size = 4.2,
           label = sprintf("PSI punktów = %.3f", psi(pas(train$punkty), pas(wnioski2025$punkty)))) +
  labs(title = "A. Punkty: 2023–2024 vs 2025", x = "Pasmo punktów (1 = najmniej, decyle 2023–2024)",
       y = "Udział wniosków (%)") + motyw
d5 <- data.frame(cecha = factor(etyk[names(csi)], levels = etyk[names(sort(csi))]), csi = csi)
pB <- ggplot(d5, aes(csi, cecha)) + geom_col(fill = "#E69F00", width = 0.6) +
  geom_vline(xintercept = c(0.10, 0.25), linetype = c("dashed", "dotted"), colour = "grey35") +
  geom_text(aes(label = sprintf("%.3f", csi)), hjust = -0.15, size = 4.2) +
  scale_x_continuous(expand = expansion(mult = c(0, 0.25))) +
  labs(title = "B. PSI cech (2025 vs 2023–2024)", x = "PSI", y = NULL) + motyw
p4 <- pA + pB + plot_layout(widths = c(1.2, 1))
p4   # zapis: ggsave("scoring-psi-stabilnosc.svg", p4, width = 10, height = 5.6)
Wynik w R
PSI_uczacy_vs_test PSI_uczacy_vs_2025
             0.006              0.546
 staz_kasa       wiek  zapytania      forma obciazenie
     0.172      0.160      0.157      0.130      0.074
  srednie_pkt_uczacy     srednie_pkt_2025 akceptacja_2025_proc
               572.8                555.1                 38.5
PD_srednie_2025_proc
                10.5
   pasmo udzial.2023–2024 udzial.2025
1      1             10.6        32.1
2      2             11.6        17.7
3      3              7.8         8.9
4      4             10.2         9.0
5      5              9.8         9.5
6      6             11.1         7.2
7      7             11.4         6.4
8      8              7.8         3.6
9      9             10.1         4.1
10    10              9.6         1.6
6. Przetrenowane przedziały i koszt dzielenia (rysunek 5)
R
# Przepis 6. Przetrenowanie przedziałów i koszt dzielenia zmiennych (korzysta z przepisów 1–4)
library(ggplot2)
library(patchwork)

# A. Symulacja: cecha z czystego szumu (bez związku ze spłatą) dzielona na k równolicznych przedziałów.
# Ile wynosi jej IV w zbiorze uczącym? 500 powtórzeń dla każdego k, te same wyniki spłat co w train.
set.seed(636)
ki <- c(2, 5, 10, 20, 50)
sym <- do.call(rbind, lapply(ki, function(k) {
  ivs <- replicate(500, { x <- runif(nrow(train))
    sum(tabela_woe(cut(x, quantile(x, seq(0, 1, length.out = k + 1)), include.lowest = TRUE), train$zla)$iv) })
  data.frame(k = k, sr = mean(ivs), blad_mc = sd(ivs) / sqrt(500), q05 = unname(quantile(ivs, .05)), q95 = unname(quantile(ivs, .95)),
             proc_iv_pow_002 = 100 * mean(ivs > 0.02))
}))
round(sym, 4)

# B. Gini w zbiorze uczącym i testowym dla czterech sposobów potraktowania cech ciągłych
gini_wariant <- function(podzial) {   # podzial(x_train, x) zwraca przedziały; WoE zawsze ze zbioru uczącego
  bt <- bin_train; bs <- bin_test
  for (v in ciagle) { bt[[v]] <- podzial(train[[v]], train[[v]]); bs[[v]] <- podzial(train[[v]], test[[v]]) }
  wt <- lapply(bt[cechy], tabela_woe, zla = train$zla)
  zamien <- function(b) as.data.frame(sapply(cechy, function(v) wt[[v]]$woe[match(as.character(b[[v]]), wt[[v]]$przedzial)]))
  m <- glm(train$zla ~ ., family = binomial, data = zamien(bt))
  c(uczacy = 2 * auc(-predict(m), train$zla) - 1, testowy = 2 * auc(-predict(m, zamien(bs)), test$zla) - 1)
}
mediana <- function(xt, x) cut(x, c(-Inf, median(xt), Inf))
drobne20 <- function(xt, x) cut(x, unique(c(-Inf, quantile(xt, seq(0.05, 0.95, 0.05), type = 1), Inf)))
ciagly <- glm(zla ~ wiek + obciazenie + zapytania + staz_kasa + forma, family = binomial, data = train)
por <- rbind("podział medianą (2 przedziały)" = gini_wariant(mediana),
             "karta: zgrubne WoE (do 5 przedziałów)" = c(wyn["Gini_uczacy"], wyn["Gini_test"]),
             "drobne WoE (20 przedziałów)" = gini_wariant(drobne20),
             "regresja na cechach ciągłych" = c(2 * auc(-predict(ciagly), train$zla) - 1,
                                                2 * auc(-predict(ciagly, test), test$zla) - 1))
round(por, 3)

# Rysunek 5
pA <- ggplot(sym, aes(factor(k), sr)) +
  geom_errorbar(aes(ymin = q05, ymax = q95), width = 0.15, colour = "grey45") +
  geom_point(size = 3.2, colour = "#D55E00") + geom_hline(yintercept = 0.02, linetype = "dashed", colour = "grey45") +
  annotate("text", x = 0.55, y = 0.031, hjust = 0, label = "IV = 0.02", size = 3.9, colour = "grey30") +
  labs(title = "A. IV cechy z czystego szumu", x = "Liczba przedziałów",
       y = "IV w zbiorze uczącym (średnia, 5–95%)") + motyw
d6 <- data.frame(wariant = factor(rep(rownames(por), 2), levels = rev(rownames(por))),
                 zbior = rep(c("zbiór uczący", "zbiór testowy"), each = nrow(por)), gini = c(por[, 1], por[, 2]))
pB <- ggplot(d6, aes(gini, wariant, colour = zbior, shape = zbior)) +
  geom_line(aes(group = wariant), colour = "grey70", linewidth = 1) + geom_point(size = 3.5) +
  scale_colour_manual(values = kol, name = NULL) + scale_shape_manual(values = c(17, 16), name = NULL) +
  scale_y_discrete(labels = function(x) gsub(" \\(", "\n(", x)) +
  labs(title = "B. Gini: uczący vs testowy", x = "Gini", y = NULL) + motyw
p5 <- pA + pB + plot_layout(widths = c(1, 1.25))
p5   # zapis: ggsave("scoring-przetrenowanie-przedzialow.svg", p5, width = 10, height = 5.6)
Wynik w R
   k     sr blad_mc    q05    q95 proc_iv_pow_002
1  2 0.0042  0.0003 0.0000 0.0152             2.6
2  5 0.0159  0.0005 0.0029 0.0380            27.6
3 10 0.0354  0.0008 0.0138 0.0657            82.8
4 20 0.0740  0.0011 0.0411 0.1199           100.0
5 50 0.1769  0.0018 0.1183 0.2478           100.0
                                      uczacy testowy
podział medianą (2 przedziały)         0.343   0.354
karta: zgrubne WoE (do 5 przedziałów)  0.426   0.366
drobne WoE (20 przedziałów)            0.481   0.347
regresja na cechach ciągłych           0.399   0.415
7. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Przepis 7. Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("spłacone – niespłacone" = c("#0072B2", "#D55E00"), "2023–2024 – 2025" = c("#0072B2", "#E69F00"),
             "drobne – zgrubne przedziały" = c("#737373", "#0072B2"), "wiersz karty – tło" = c("#eef4fa", "#FFFFFF"),
             "suma punktów – tło" = c("#fdf1e6", "#FFFFFF"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
spłacone – niespłacone                     114.6        108.3       91.9
2023–2024 – 2025                           120.2        121.5      109.3
drobne – zgrubne przedziały                 41.5         45.1       38.2
wiersz karty – tło                           5.5          5.6        4.9
suma punktów – tło                           8.2          8.2        7.9
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, regresja logistyczna (glm()) i dystrybuanty empiryczne (ecdf()) – pakiet stats z podstawowej instalacji R; przedziały, WoE, IV, karta punktowa, AUC, KS i PSI liczone są własnymi krótkimi funkcjami, bez pakietów do scoringu. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Przetrenowane przedziały. Im więcej przedziałów i im bardziej „dopasowane” granice, tym wyższe IV i Gini w zbiorze uczącym i tym większy spadek w teście (rysunek 5). Granice wyznaczaj tylko na zbiorze uczącym.
- Odrzuceni wnioskodawcy. Kartę budujemy tylko na pożyczkach udzielonych – o odrzuconych nie wiemy, czy by spłacili. To błąd selekcji. Banasik i in. (2003) pokazali w symulacji, że im niższe ryzyko próby uczącej, tym gorsze przewidywania dla wszystkich wnioskodawców i tym bardziej przeszacowana trafność. Metody reject inference łagodzą problem, ale nie zastąpią danych o spłacie.
- Zakazane cechy. Płeć, pochodzenie czy stan zdrowia nie mogą wchodzić do karty, a zmienne z nimi powiązane mogą je przemycić; Kozodoi i in. (2022) pokazują, że dyskryminację algorytmiczną da się mierzyć i ograniczyć stosunkowo niskim kosztem.
- Trafność zamiast Gini. Przy 6.6% złych pożyczek reguła „akceptuj wszystkich” ma 93.4% trafności i zero wartości.
Najczęstsze pytania
Jak policzyć WoE i IV?
Dla każdego przedziału cechy policz, jaki odsetek wszystkich spłaconych i jaki odsetek wszystkich niespłaconych pożyczek do niego trafia. WoE = ln(% spłaconych / % niespłaconych), a wkład do IV = (% spłaconych − % niespłaconych) × WoE; IV to suma wkładów. W przykładzie przedział raty do 11% dochodu miał WoE = 1.223, a całe obciążenie ratą IV = 0.235. Do zera w przedziale dodaj 0.5, żeby uniknąć ln(0).
Co to jest PDO w karcie punktowej?
PDO (points to double the odds) to liczba punktów, o którą rośnie wynik, gdy szanse spłaty podwajają się. Przy PDO = 20 i 600 punktach dla szans 50 : 1 punkty = 487.12 + 28.85 × ln(szans spłaty). Skalę wybiera się umownie – nie zmienia ona kolejności wnioskodawców, tylko liczby na karcie.
Czym różni się Gini od KS w scoringu?
Gini = 2 × AUC − 1 opisuje, jak dobrze punkty porządkują wszystkie pary pożyczka spłacona – niespłacona. KS to największa różnica między dystrybuantami punktów obu grup, czyli rozdzielenie w jednym, najlepszym punkcie skali. W przykładzie Gini = .366, a KS = .304 przy 557 punktach. Żadna z tych miar nie sprawdza kalibracji PD.
Jaki PSI oznacza, że kartę trzeba przebudować?
W praktyce przyjmuje się progi 0.10 i 0.25, ale są one umowne i nie wynikają z błędów I i II rodzaju (Yurdakul i Naranjo, 2020). Wysokie PSI oznacza, że wnioskodawcy się zmienili – w przykładzie 0.546 po uruchomieniu wniosków internetowych – i że trzeba sprawdzić trafność karty na nowych spłatach. Samo PSI nie mówi, że karta przestała różnicować.
Czy karta punktowa jest lepsza od zwykłej regresji logistycznej?
Nie pod względem trafności. W przykładzie regresja na cechach ciągłych miała w zbiorze testowym Gini = .415, a karta .366 – choć przy 127 złych pożyczkach różnica mieści się w niepewności. Przewagą karty jest przejrzystość: każdy przedział ma punkty, które doradca może wytłumaczyć klientowi.
Powiązane hasła
Przeczytaj też
Prognoza upadłości firm – regresja logistyczna
1500 firm transportowych: winsoryzacja wskaźników, ilorazy szans, walidacja w czasie, AUC i kalibracja oraz złudna trafność – pięć rysunków z kodem R.
Czytaj →PoradnikWykrywanie nadużyć przy rzadkich zdarzeniach
Ubezpieczyciel, 60 000 szkód i 200 kontroli miesięcznie: krzywe ROC i PR, macierz kosztów, wybór według zysku, SMOTE a kalibracja i etykiety z kontroli – pięć rysunków z kodem R.
Czytaj →PoradnikStatystyka w pracy z finansów i rachunkowości
Ankieta wśród przedsiębiorców, skośne wskaźniki i winsoryzacja, regresja z błędami odpornymi, dane panelowe i model upadłości – z gotowymi zdaniami APA i kodem R.
Czytaj →PoradnikOcena leadów w sprzedaży B2B
Szansa zamknięcia, AUC i kalibracja, czas do umowy z ryzykiem konkurencyjnym, próg z kosztu i prognoza lejka – fikcyjna firma, kod R.
Czytaj →Budujesz model scoringowy do pracy z finansów?
Pomożemy podzielić cechy na przedziały, policzyć WoE i IV, zbudować kartę punktową, ocenić ją na zbiorze testowym i opisać wyniki z tabelą i rysunkami – tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Baesens, B., Van Gestel, T., Viaene, S., Stepanova, M., Suykens, J., & Vanthienen, J. (2003). Benchmarking state-of-the-art classification algorithms for credit scoring. Journal of the Operational Research Society, 54(6), 627–635. https://doi.org/10.1057/palgrave.jors.2601545
- Banasik, J., Crook, J., & Thomas, L. (2003). Sample selection bias in credit scoring models. Journal of the Operational Research Society, 54(8), 822–832. https://doi.org/10.1057/palgrave.jors.2601578
- Hand, D. J., & Henley, W. E. (1997). Statistical classification methods in consumer credit scoring: A review. Journal of the Royal Statistical Society: Series A (Statistics in Society), 160(3), 523–541. https://doi.org/10.1111/j.1467-985x.1997.00078.x
- Kozodoi, N., Jacob, J., & Lessmann, S. (2022). Fairness in credit scoring: Assessment, implementation and profit implications. European Journal of Operational Research, 297(3), 1083–1094. https://doi.org/10.1016/j.ejor.2021.06.023 ● Otwarty dostęp: pełny tekst
- Royston, P., Altman, D. G., & Sauerbrei, W. (2006). Dichotomizing continuous predictors in multiple regression: A bad idea. Statistics in Medicine, 25(1), 127–141. https://doi.org/10.1002/sim.2331
- Yurdakul, B., & Naranjo, J. (2020). Statistical properties of the population stability index. The Journal of Risk Model Validation, 14(4), 89–100. https://doi.org/10.21314/jrmv.2020.227 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{baesens2003benchmarking, author={Baesens, Bart and Van Gestel, Tony and Viaene, Stijn and Stepanova, Maria and Suykens, Johan and Vanthienen, Jan}, title={{Benchmarking state-of-the-art classification algorithms for credit scoring}}, journal={Journal of the Operational Research Society}, year={2003}, volume={54}, number={6}, pages={627--635}, doi={10.1057/palgrave.jors.2601545}}@article{banasik2003sample, author={Banasik, John and Crook, Jonathan and Thomas, Lyn}, title={{Sample selection bias in credit scoring models}}, journal={Journal of the Operational Research Society}, year={2003}, volume={54}, number={8}, pages={822--832}, doi={10.1057/palgrave.jors.2601578}}@article{hand1997statistical, author={Hand, David J. and Henley, William E.}, title={{Statistical classification methods in consumer credit scoring: A review}}, journal={Journal of the Royal Statistical Society: Series A (Statistics in Society)}, year={1997}, volume={160}, number={3}, pages={523--541}, doi={10.1111/j.1467-985x.1997.00078.x}}@article{kozodoi2022fairness, author={Kozodoi, Nikita and Jacob, Johannes and Lessmann, Stefan}, title={{Fairness in credit scoring: Assessment, implementation and profit implications}}, journal={European Journal of Operational Research}, year={2022}, volume={297}, number={3}, pages={1083--1094}, doi={10.1016/j.ejor.2021.06.023}}@article{royston2006dichotomizing, author={Royston, Patrick and Altman, Douglas G. and Sauerbrei, Willi}, title={{Dichotomizing continuous predictors in multiple regression: A bad idea}}, journal={Statistics in Medicine}, year={2006}, volume={25}, number={1}, pages={127--141}, doi={10.1002/sim.2331}}@article{yurdakul2020statistical, author={Yurdakul, Bilal and Naranjo, Joshua}, title={{Statistical properties of the population stability index}}, journal={The Journal of Risk Model Validation}, year={2020}, volume={14}, number={4}, pages={89--100}, doi={10.21314/jrmv.2020.227}}