Pięć typowych projektów w pracy z finansów i rachunkowości
Prace dyplomowe z finansów i rachunkowości opierają się zwykle na jednym z dwóch źródeł danych. Pierwsze to ankieta: pytasz właścicieli firm, księgowych albo pracowników biur rachunkowych o praktyki, opinie i decyzje. Drugie to dane ze sprawozdań finansowych: liczysz wskaźniki dla wielu spółek, często przez kilka lat, i szukasz ich związków. Każde źródło ma własne pułapki. W ankiecie są to odpowiedzi porządkowe i tabele krzyżowe, a w danych ze sprawozdań – skrajnie skośne wskaźniki, obserwacje wpływowe, powtarzane pomiary tych samych spółek i rzadkie zdarzenia, takie jak upadłość. Tabela porządkuje pięć projektów omówionych w tym poradniku.
| Projekt | Typowe pytanie | Dane | Analiza główna | Wielkość efektu |
|---|---|---|---|---|
| 1. Ankieta wśród właścicieli firm | Czy sposób prowadzenia księgowości zależy od wielkości firmy? Czy wykształcenie ekonomiczne wiąże się z oceną sprawozdań? | kategorie (tabela krzyżowa) i ocena na skali 1–5 | test chi-kwadrat z resztami; test Manna–Whitneya | V Craméra; korelacja rangowo-dwuseryjna |
| 2. Rozkłady wskaźników finansowych | Jak wyglądają rentowność i płynność badanych spółek? | wskaźniki ze sprawozdań, jedna obserwacja na spółkę | mediana i rozstęp międzykwartylowy, skośność, winsoryzacja jako wariant | – (opis) |
| 3. Rentowność a struktura kapitału | Czy spółki bardziej zadłużone mają niższą rentowność aktywów? | ROA, dźwignia, wielkość, branża | regresja wieloraka z błędami HC3 + regresja odporna | b z 95% CI, R² |
| 4. Dane panelowe spółek | Jak zmienia się wynik, gdy ta sama spółka zwiększa zadłużenie? | 120 spółek × 6 lat | efekty stałe firm i lat, błędy klastrowane | b z 95% CI |
| 5. Zagrożenie upadłością | Które wskaźniki poprzedzają upadłość? | upadła / nie upadła, wskaźniki z poprzedniego roku | regresja logistyczna, korekta wyrazu wolnego, AUC | OR z 95% CI, AUC |
Wszystkie dane w przykładach są symulowane, a liczby nie opisują żadnej rzeczywistej grupy spółek ani przedsiębiorców. Pełny kod znajdziesz w sekcji Przykład w R. Jeśli Twoja praca to ankieta wśród pracowników o konstruktach zarządczych albo klasyczny model ekonometryczny z weryfikacją założeń (test Jarque–Bera, Breuscha–Pagana, RESET), zacznij od poradnika statystyka w pracy z zarządzania i ekonomii – tutaj tych testów nie powtarzamy. Indeksy, średnie tempo zmian i wskaźniki sezonowości przećwiczysz w zbiorze statystyka w ekonomii – zadania z rozwiązaniami. Nie wiesz, który test pasuje do Twojej hipotezy? Pomoże kreator doboru testu, a cały proces od pytania do rozdziału wyników opisuje przewodnik po statystyce w pracy dyplomowej.
Zanim zaczniesz: dane ze sprawozdań to też pomiar
Ustal jednostkę analizy. W danych finansowych obserwacją jest zwykle „spółka w danym roku”. Jeśli masz 40 spółek z pięciu lat, masz 200 wierszy, ale tylko 40 niezależnych jednostek. To rozróżnienie decyduje o tym, jakie błędy standardowe policzysz (projekt 4). Zapisz dane w formacie długim: jeden wiersz to jedna spółka w jednym roku, kolumny to identyfikator spółki, rok, branża i wskaźniki.
Zdefiniuj wskaźniki, zanim zaczniesz je liczyć. ROA można policzyć z zysku netto albo z zysku operacyjnego, z aktywów na koniec roku albo ze średniej z początku i końca roku. Dźwignię – jako zobowiązania ogółem do aktywów albo tylko dług oprocentowany do kapitału własnego. Wszystkie wersje są spotykane, ale w jednej pracy stosuj jedną, podaj wzór w rozdziale metodologicznym i trzymaj się go we wszystkich latach. Gdy porównujesz swoje wyniki z literaturą, sprawdź, czy autorzy liczyli wskaźnik tak samo.
Zastanów się, kogo nie ma w danych. Bazy notowań i zbiory sprawozdań zawierają spółki, które przetrwały do dnia pobrania danych albo opublikowały komplet raportów. Spółki, które upadły lub wycofały się z giełdy, łatwo „wypadają” z próby, a wtedy średnia rentowność wygląda lepiej, niż była. Opisz kryteria doboru spółek (branża, lata, wymóg kompletnych danych) i liczbę spółek wykluczonych na każdym etapie. To ograniczenie warto wpisać do dyskusji.
Nie podawaj liczb o gospodarce bez źródła. Jeśli we wstępie przywołujesz liczbę upadłości, udział biur rachunkowych w rynku czy średnią rentowność branży, cytuj konkretną publikację albo oficjalną statystykę z datą odczytu. Liczby z przykładów w tym poradniku są symulowane i nie nadają się do cytowania.
Projekt 1. Ankieta wśród przedsiębiorców: tabela krzyżowa i ocena na skali 1–5
Ankieta wśród właścicieli małych firm, księgowych czy pracowników działów finansowych to najczęstszy projekt na studiach licencjackich. Typowe pytania dotyczą tego, kto prowadzi księgowość firmy, z jakich narzędzi korzysta, jak ocenia przydatność sprawozdań albo analiz finansowych w podejmowaniu decyzji. Dane są wtedy kategorialne albo porządkowe, więc do ich analizy nie potrzebujesz regresji – wystarczą dobrze opisane tabele i testy nieparametryczne.
Przykład: 280 właścicieli firm odpowiedziało, czy księgowość ich firmy prowadzi biuro rachunkowe, czy własny dział (lub księgowa na etacie). W firmach mikro biuro rachunkowe wskazało 84.8% osób (117 ze 138), w małych 51.1% (48 z 94), a w średnich 29.2% (14 z 48). Przedstaw to jako tabelę krzyżową z procentami w wierszach, bo pytanie brzmi „jak w każdej grupie wielkości rozkładają się odpowiedzi”, a nie odwrotnie.
Test chi-kwadrat i reszty
Sposób prowadzenia księgowości wiązał się z wielkością firmy, χ²(2) = 57.93, p < .001, V Craméra = .45. Najmniejsza liczebność oczekiwana wynosiła 17.31, więc warunek testu był spełniony. Sam wynik testu mówi tylko, że rozkłady się różnią. Gdzie dokładnie, pokazują reszty standaryzowane skorygowane: dla biura rachunkowego wynosiły 7.16 w firmach mikro, −3.19 w małych i −5.51 w średnich. Wartości powyżej 1.96 co do modułu oznaczają komórki, w których odpowiedzi było wyraźnie więcej albo mniej, niż wynikałoby z niezależności zmiennych. Odczytywanie reszt krok po kroku pokazujemy w zbiorze chi-kwadrat – zadania z rozwiązaniami, a to samo w programie z menu – w poradniku chi-kwadrat i tabele krzyżowe w jamovi.
Ocena na skali 1–5: rozkład zamiast samej średniej
Drugie pytanie brzmiało: „Na ile sprawozdanie finansowe Twojej firmy jest przydatne w podejmowaniu decyzji?” (1 – zupełnie nieprzydatne, 5 – bardzo przydatne). Pojedyncza pozycja w skali Likerta to dane porządkowe, więc porównaj grupy testem Manna–Whitneya i pokaż pełny rozkład odpowiedzi. Wśród osób bez wykształcenia ekonomicznego (n = 178) najwyższą ocenę wybrało 10.7%, a wśród osób z takim wykształceniem (n = 102) – 25.5%. Najniższą ocenę wybrało odpowiednio 12.9% i 7.8%. Mediana wynosiła 3 i 4. Osoby z wykształceniem ekonomicznym oceniały sprawozdanie wyżej, U = 6638, p < .001, a korelacja rangowo-dwuseryjna wynosiła r = .27. Spór o to, czy z pozycji Likerta wolno liczyć średnią, omawiamy we wpisie skala Likerta: średnia czy mediana?.
Pamiętaj o dwóch ograniczeniach. Po pierwsze, ankieta rozesłana przez znajomych i grupy w mediach społecznościowych nie jest próbą losową firm, więc odsetki opisują badaną grupę, a nie wszystkie firmy w Polsce. Po drugie, wykształcenie ekonomiczne właściciela wiąże się z wieloma innymi cechami (wielkość firmy, branża, staż), więc różnica w ocenach nie dowodzi, że to wykształcenie ją powoduje.
Projekt 2. Wskaźniki finansowe: skośność, wartości skrajne i winsoryzacja
Wskaźniki finansowe rzadko mają rozkład zbliżony do normalnego. Rentowność ma długi lewy ogon, bo kilka spółek w danym roku notuje duże straty. Wskaźniki z mianownikiem, który może być bliski zera, potrafią przyjmować wartości absurdalnie wysokie. Przykład: 120 spółek z jednego roku, dane symulowane.
| Wskaźnik | M | SD | Me | Q1–Q3 | Min–Max | Skośność |
|---|---|---|---|---|---|---|
| ROA (%) | 3.45 | 8.01 | 4.72 | −0.20 – 7.42 | −49.62 – 19.04 | −2.73 |
| Dźwignia (zobowiązania / aktywa) | 0.45 | 0.16 | 0.44 | 0.32 – 0.55 | 0.07 – 0.92 | 0.32 |
| Płynność bieżąca | 8.75 | 60.84 | 2.44 | 1.74 – 3.61 | 0.76 – 668.06 | 10.61 |
Płynność bieżąca (aktywa obrotowe podzielone przez zobowiązania krótkoterminowe) pokazuje problem najwyraźniej. Mediana wynosiła 2.44, połowa spółek mieściła się między 1.74 a 3.61, ale średnia to 8.75, a odchylenie standardowe 60.84. Wystarczy jedna spółka, która prawie nie ma zobowiązań krótkoterminowych, by wskaźnik osiągnął 668.06 i „pociągnął” średnią. Taka wartość nie musi być błędem w danych – po prostu ułamek z małym mianownikiem nie nadaje się do liczenia średniej. W pracy opisz takie wskaźniki medianą i rozstępem międzykwartylowym, a w modelach rozważ logarytm wskaźnika.
Winsoryzacja: co zmienia i czego nie naprawia
W badaniach z rachunkowości i finansów bardzo często stosuje się winsoryzację: wartości poniżej 1. percentyla i powyżej 99. percentyla (albo 5. i 95.) zastępuje się wartościami tych percentyli. Obserwacje zostają w próbie, ale ich wpływ słabnie. W przykładzie winsoryzacja ROA na 1. i 99. percentylu zmieniła 4 wartości: średnia wzrosła z 3.45 do 3.67, odchylenie standardowe spadło z 8.01 do 6.72, a skośność z −2.73 do −1.05. Winsoryzacja na 5. i 95. percentylu zmieniła już 12 wartości (10% próby), dała średnią 3.96 i skośność −0.14. Mediana i kwartyle nie zmieniły się wcale, bo winsoryzacja dotyka tylko ogonów.
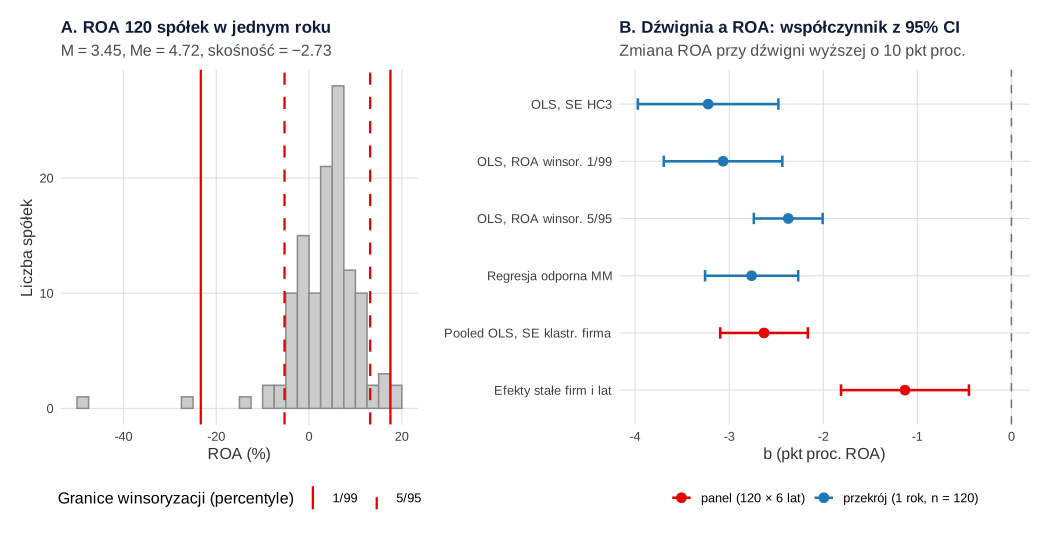
Leone i in. (2019) zwracają uwagę, że winsoryzacja i obcinanie opierają się na progach wybranych przez badacza i stosowanych zmienna po zmiennej, więc mogą zmieniać prawidłowe obserwacje. W ich symulacjach obie metody słabo wykrywały obserwacje, które naprawdę wpływają na wyniki regresji, a najlepiej wypadła regresja odporna. Autorzy zalecają, by stosować ją albo przynajmniej raportować jako analizę wrażliwości. W pracy dyplomowej wniosek jest prosty: wybierz próg winsoryzacji przed analizą, uzasadnij go i pokaż, czy wynik zmienia się bez winsoryzacji lub w regresji odpornej. Jak wykrywać wartości odstające i kiedy można je usunąć, opisujemy w poradniku wartości odstające: jak je wykryć i co z nimi zrobić.
Jeśli piszesz pracę z audytu albo kontroli wewnętrznej, możesz spotkać się z inną analizą rozkładu liczb księgowych – sprawdzaniem częstości pierwszych cyfr. Jej logikę i ograniczenia opisuje hasło prawo Benforda.
Projekt 3. Rentowność a struktura kapitału: regresja z błędami odpornymi
Pytanie o związek zadłużenia z rentownością pojawia się w wielu pracach z finansów przedsiębiorstw. Rajan i Zingales (1995) pokazali na danych spółek publicznych z krajów G7, że czynniki skorelowane z zadłużeniem w USA są podobnie skorelowane w innych krajach, ale zaznaczyli, że teoretyczne wyjaśnienie tych korelacji pozostaje w dużej mierze nierozstrzygnięte. To ważna wskazówka dla Ciebie: regresja w przekroju pokaże związek, ale nie rozstrzygnie, czy zadłużenie obniża rentowność, czy mniej rentowne spółki muszą się bardziej zadłużać.
Przykład: te same 120 spółek. Zmienna zależna to ROA w procentach, predyktory to dźwignia, logarytm aktywów (wielkość spółki) i branża (pięć kategorii). Dźwignię wpisano w jednostkach po 10 punktów procentowych, aby współczynnik był łatwy do odczytania. Model wyjaśniał 45.8% wariancji ROA (R² = .458).
| Wariant analizy | b (zmiana ROA w pkt proc.) | SE | 95% CI |
|---|---|---|---|
| OLS, klasyczne błędy standardowe | −3.22 | 0.36 | [−3.93, −2.52] |
| OLS, błędy HC3 | −3.22 | 0.38 | [−3.97, −2.48] |
| OLS, ROA winsoryzowane 1/99, HC3 | −3.07 | 0.32 | [−3.70, −2.44] |
| OLS, ROA winsoryzowane 5/95, HC3 | −2.37 | 0.19 | [−2.74, −2.01] |
| Regresja odporna MM | −2.76 | 0.25 | [−3.26, −2.27] |
We wszystkich wariantach wyższej dźwigni towarzyszyła niższa rentowność, ale wielkość związku różniła się wyraźnie. W zwykłej regresji spółka zadłużona o 10 punktów procentowych bardziej miała ROA niższe średnio o 3.22 punktu, a po winsoryzacji na 5. i 95. percentylu – o 2.37 punktu. Regresja odporna MM dała −2.76, 95% CI [−3.26, −2.27], i nadała wagi mniejsze niż 0.5 trzem spółkom. W tych danych duże straty zdarzały się częściej w spółkach mocno zadłużonych, więc to one „wydłużały” nachylenie w zwykłej regresji. Która wartość jest „prawdziwa”, zależy od pytania: jeśli kryzysowe lata są częścią zjawiska, które badasz, nie powinieneś ich osłabiać; jeśli są zakłóceniem – regresja odporna jest uczciwsza niż arbitralny próg winsoryzacji. Dlatego w pracy podaj wynik główny i co najmniej jedną analizę wrażliwości.
Błędy standardowe policz w wersji odpornej na heteroskedastyczność. Hayes i Cai (2007) przypominają, że przy niejednorodnej wariancji reszt współczynniki MNK pozostają nieobciążone, ale ich błędy standardowe mogą być obciążone, przez co testy i przedziały ufności bywają zbyt liberalne albo zbyt konserwatywne. Autorzy zalecają rutynowe stosowanie błędów odpornych. Tu błąd HC3 (0.38) był nieco większy od klasycznego (0.36). Szczegóły opisują hasło odporne błędy standardowe (HC3) i poradnik regresja odporna: estymatory M i MM. Gdy predyktory są ze sobą silnie powiązane (np. kilka wskaźników zadłużenia naraz), sprawdź też współliniowość.
Projekt 4. Dane panelowe: te same spółki przez kilka lat
Gdy masz dane tych samych spółek z kilku lat, zyskujesz dwie rzeczy: więcej obserwacji i możliwość porównania spółki z samą sobą. Tracisz jednak niezależność obserwacji. Wynik spółki w jednym roku jest podobny do jej wyniku w roku następnym, a zły rok dla gospodarki obniża wyniki wielu spółek naraz. Petersen (2009) zwraca uwagę, że w panelowych danych z finansów reszty mogą być skorelowane między firmami albo w czasie, a wtedy zwykłe błędy standardowe MNK bywają obciążone; porównuje metody stosowane w literaturze i wyjaśnia, kiedy dają te same, poprawne wyniki, a kiedy się rozchodzą.
Przykład: 120 spółek obserwowanych przez 6 lat, czyli 720 wierszy. Ta sama regresja ROA na dźwignię, wielkość i branżę, policzona na wszystkich latach naraz (pooled OLS), dała b = −2.63. Klasyczny błąd standardowy wynosił 0.14, ale błąd odporny na klastrowanie według spółki – 0.24, czyli 1.64 raza więcej. Klasyczny błąd traktuje 720 wierszy jak 720 niezależnych spółek i przez to zawyża precyzję. Cameron i Miller (2015) opisują, że przy danych pogrupowanych w klastry domyślne błędy standardowe mogą znacznie zawyżać precyzję, a przy dużej liczbie klastrów wnioskowanie powinno opierać się na błędach odpornych na klastrowanie. Ostrzegają też przed komplikacjami przy małej liczbie klastrów – a to ważne w finansach, gdzie lat jest zwykle niewiele.
W przykładzie klastrowanie jednocześnie według spółki i roku dało błąd 0.21, ale przy zaledwie 6 latach takie oszacowanie jest niestabilne, a przedział ufności liczony z 5 stopniami swobody wyraźnie się poszerza: 95% CI [−3.17, −2.09]. Gow i in. (2010) pokazali, że część metod popularnych w badaniach rachunkowości nie koryguje jednocześnie zależności przekrojowej i czasowej, a poprawna korekta zmienia wnioski niektórych opublikowanych badań. W pracy dyplomowej zwykle wystarczy klastrowanie według spółki i efekty stałe lat, które usuwają wspólne dla wszystkich spółek szoki koniunktury.
Efekty stałe: porównanie spółki z samą sobą
Ważniejsze od błędów standardowych jest jednak to, co oznacza współczynnik. Pooled OLS porównuje różne spółki: bardziej zadłużone z mniej zadłużonymi. Te spółki różnią się też cechami, których nie widać w danych, np. jakością zarządzania czy pozycją rynkową. Model z efektami stałymi spółek i lat porównuje każdą spółkę z nią samą: pyta, jak zmienia się ROA, gdy ta sama spółka zwiększa zadłużenie. W przykładzie współczynnik spadł z −2.63 do −1.13, 95% CI [−1.81, −0.45], p = .001 (błędy klastrowane według spółki). Ponad połowa związku z pooled OLS wynikała więc z różnic między spółkami, a nie ze zmian zadłużenia w czasie.
Zwróć uwagę na koszt: model z efektami stałymi korzysta tylko ze zmienności wewnątrz spółek, która dla dźwigni jest zwykle niewielka, więc przedział ufności jest szerszy. Nie oszacujesz w nim też efektu cech stałych w czasie, takich jak branża – efekty stałe spółek je pochłaniają. Wybór między efektami stałymi a losowymi, test Hausmana i model within–between opisujemy w poradniku dane panelowe: FE, RE i test Hausmana. Jeśli w modelu chcesz uwzględnić opóźnioną wartość zmiennej zależnej (np. ROA z poprzedniego roku), przeczytaj najpierw hasło dynamiczne dane panelowe, bo zwykły model z efektami stałymi daje wtedy obciążone wyniki.
Projekt 5. Zagrożenie upadłością: regresja logistyczna i próba dobrana parami
Modele przewidywania upadłości to klasyczny temat prac z finansów. Altman (1968) zastosował do tego analizę dyskryminacyjną na wskaźnikach finansowych, a Ohlson (1980) – model logitowy, który daje wprost prawdopodobieństwo upadłości. W pracy dyplomowej zwykle oszacujesz regresję logistyczną: zmienna zależna to upadłość w ciągu roku (tak/nie), a predyktory to wskaźniki z ostatniego sprawozdania przed tym okresem. Pamiętaj o kolejności w czasie: wskaźniki muszą pochodzić sprzed zdarzenia, inaczej model „przewiduje” upadłość na podstawie jej skutków.
Problem: próba 1:1 przeszacowuje ryzyko
Upadłości są rzadkie, więc studenci często budują próbę tak: wszystkie upadłe spółki i tyle samo spółek zdrowych, dobranych losowo albo parami (np. z tej samej branży i wielkości). Taki dobór jest efektywny, ale zmienia odsetek zdarzeń w próbie. King i Zeng (2001) pokazują, że przy rzadkich zdarzeniach dobór wszystkich zdarzeń i tylko części nie-zdarzeń jest rozsądną strategią, pod warunkiem że skorygujesz wyniki. Bez korekty wyraz wolny modelu odzwierciedla odsetek upadłości w próbie (tu 50%), a nie rzeczywiste ryzyko.
Przykład: populacja 1500 spółek, z których w ciągu roku upadło 51 (3.4%). Model na całej populacji pokazał, że ryzyko upadłości rosło z dźwignią (OR = 1.62 na 10 punktów procentowych, 95% CI [1.34, 1.95]) i malało wraz z ROA (OR = 0.89 na 1 punkt procentowy, 95% CI [0.84, 0.93]), z logarytmem płynności bieżącej (OR = 0.22, 95% CI [0.11, 0.44]) i z logarytmem aktywów (OR = 0.64, 95% CI [0.48, 0.85]). Model na próbie 1:1 (51 upadłych i 51 zdrowych spółek) dał podobne ilorazy szans dla ROA (0.86) i dźwigni (1.68), ale znacznie szersze przedziały, a dla wielkości spółki – OR = 0.85, 95% CI [0.53, 1.38], czyli wynik nieistotny.
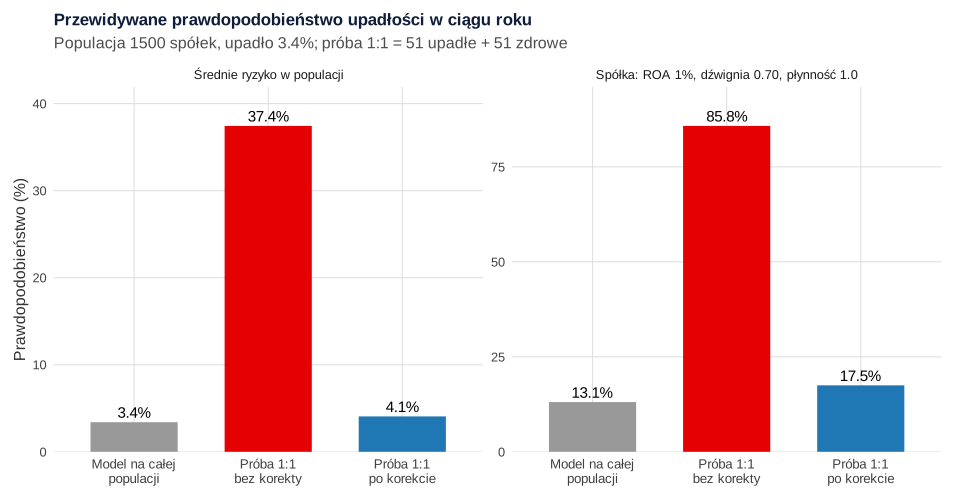
Rysunek 2 pokazuje skutek. Model z próby 1:1 zastosowany do wszystkich 1500 spółek przewidywał średnie ryzyko upadłości 37.4%, choć naprawdę upadło 3.4% spółek. Dla spółki z ROA 1%, dźwignią 0.70 i płynnością bieżącą 1.0 dawał 85.8%, podczas gdy model z pełnych danych – 13.1%. Po korekcie wyrazu wolnego, która odejmuje od niego logarytm stosunku szans zdarzenia w próbie do szans w populacji, średnie ryzyko spadło do 4.1%, a dla tej spółki – do 17.5%. Ilorazy szans z próby dobranej możesz interpretować, ale prawdopodobieństw – dopiero po korekcie i tylko wtedy, gdy znasz odsetek upadłości w populacji, z której dobierałeś spółki.
Zdolność rozróżniania i liczba zdarzeń
Korekta wyrazu wolnego nie zmienia kolejności spółek według ryzyka, więc nie zmienia AUC. Model z próby 1:1 rozróżniał spółki upadłe i zdrowe w populacji z AUC = .805, 95% CI [.743, .868]. Ta wartość jest optymistyczna, bo 102 spółki z próby uczącej należą do tej samej populacji; w pracy oceń model na spółkach, których nie użyłeś do jego oszacowania, albo walidacją krzyżową. Druga sprawa to liczba zdarzeń. Peduzzi i in. (1996) w symulacji wykazali, że przy mniej niż 10 zdarzeniach na zmienną współczynniki regresji logistycznej są obciążone, a przedziały ufności mają niewłaściwe pokrycie. W przykładzie 51 upadłości przypadało na 4 predyktory, czyli 12.75 zdarzenia na zmienną. Z 20 wskaźnikami finansowymi taki model nie miałby sensu. Więcej o tym piszemy we wpisie ile predyktorów w regresji, interpretację OR – w poradniku regresja logistyczna krok po kroku, a obliczenia z menu programu – w poradniku regresja logistyczna w jamovi.
Szeregi czasowe i stopy zwrotu – krótko
Część prac z finansów analizuje jedną wielkość w czasie: miesięczne kursy, stopy procentowe, sprzedaż firmy. To osobny świat metod. Dwie zasady wystarczą, by uniknąć najpoważniejszych błędów. Po pierwsze, nie koreluj ze sobą dwóch szeregów z trendem, np. kursu akcji i poziomu cen – wyjdzie wysoka korelacja nawet wtedy, gdy szeregi nie mają ze sobą nic wspólnego. Analizuj zmiany (stopy zwrotu, przyrosty) albo sprawdź stacjonarność szeregów; symulację takiej pozornej regresji pokazujemy w poradniku o zarządzaniu i ekonomii. Po drugie, w regresji na danych czasowych sprawdź autokorelację reszt, bo przy dodatniej autokorelacji zwykłe błędy standardowe są zwykle zbyt małe. Modele ARIMA, prognozowanie i sezonowość opisujemy w poradniku szeregi czasowe i ARIMA w praktyce.
Jak opisać analizę statystyczną w pracy z finansów i rachunkowości
Rozdział metodologiczny w pracy na danych finansowych powinien pozwolić innej osobie odtworzyć próbę i wskaźniki. Podaj źródło danych, lata, kryteria doboru spółek, wzory wskaźników, sposób traktowania wartości skrajnych i rodzaj błędów standardowych. Poniżej wzór akapitu dla projektów 2–5.
Gotowe zdania do pojedynczych wyników sprawdzisz w generatorze opisu wyników APA. Jeśli potrzebujesz pomocy w doborze analiz albo w odpowiedzi na uwagi promotora, możesz skonsultować je ze statystykiem w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Przykład w R: wskaźniki, regresja, panel i upadłość
Kod odtwarza wszystkie liczby z tego wpisu. Najważniejszy jest przepis 1: od statystyk opisowych wskaźników i winsoryzacji, przez regresję z błędami HC3 i regresję odporną, po porównanie błędów standardowych w danych panelowych i model z efektami stałymi. Przepis 2 zawiera ankietę i model upadłości z korektą wyrazu wolnego, a przepis 3 – rysunki. Każdy przepis tworzy własne dane symulowane. Błędy odporne liczy pakiet sandwich, regresję MM – pakiet robustbase, a AUC – pakiet pROC.
1. Projekty 2–4: wskaźniki, winsoryzacja, regresja z HC3 i MM, dane panelowe
R
# Projekty 2–4: wskaźniki finansowe spółek, regresja rentowności i dane panelowe (dane symulowane).
# 120 spółek × 6 lat; ROA w %, dźwignia = zobowiązania / aktywa, aktywa w mln zł, płynność bieżąca.
suppressPackageStartupMessages({ library(sandwich); library(robustbase) })
set.seed(41501)
N <- 120; Tlat <- 6
firmy <- data.frame(firma = factor(1:N),
                    branza = factor(sample(c("handel", "produkcja", "usługi", "budownictwo", "IT"), N, replace = TRUE)),
                    jakosc = rnorm(N, 0, 4))                       # nieobserwowana „jakość” firmy (efekt stały)
firmy$lev_sr <- plogis(qlogis(.45) - 0.12 * firmy$jakosc + rnorm(N, 0, .45))   # lepsze firmy – mniej długu
firmy$log_akt_sr <- rnorm(N, log(150), 1.1)
szok_roku <- rnorm(Tlat, 0, 1.5)                                    # wspólny szok koniunktury w danym roku
p <- merge(firmy, data.frame(rok = 1:Tlat))
p <- p[order(p$firma, p$rok), ]
p$dzwignia <- pmin(.95, pmax(.02, p$lev_sr + rnorm(nrow(p), 0, .06)))
p$aktywa <- round(exp(p$log_akt_sr + rnorm(nrow(p), 0, .15)), 1)
kryzys <- p$dzwignia > .60 & runif(nrow(p)) < .15                  # część mocno zadłużonych spółek ma rok dużej straty
p$roa <- round(4 + p$jakosc + szok_roku[p$rok] - 6 * (p$dzwignia - .45) + 0.6 * (log(p$aktywa) - log(150)) +
               2 * rt(nrow(p), df = 3) - ifelse(kryzys, rexp(nrow(p), 1 / 20), 0), 2)
zob_kr <- p$aktywa * p$dzwignia * runif(nrow(p), .2, .6)
zob_kr[sample(nrow(p), 8)] <- zob_kr[sample(nrow(p), 8)] * .01    # kilka spółek prawie bez zobowiązań krótkoterminowych
p$plynnosc <- round(p$aktywa * runif(nrow(p), .25, .55) / zob_kr, 2)
p$log_akt <- log(p$aktywa)

## Projekt 2. Rozkłady wskaźników w ostatnim roku (przekrój: 120 spółek) ------------------
x <- subset(p, rok == Tlat)
skos <- function(v) mean((v - mean(v))^3) / sd(v)^3
opis <- function(v) round(c(M = mean(v), SD = sd(v), Me = median(v), Q1 = unname(quantile(v, .25)),
                            Q3 = unname(quantile(v, .75)), Min = min(v), Max = max(v), Skosnosc = skos(v)), 2)
rbind(ROA = opis(x$roa), Dzwignia = opis(x$dzwignia), Plynnosc = opis(x$plynnosc))

# Winsoryzacja: wartości poniżej percentyla p i powyżej 1 − p zastępujemy tymi percentylami
winsor <- function(v, p) { q <- quantile(v, c(p, 1 - p)); pmin(pmax(v, q[1]), q[2]) }
x$roa_w1 <- winsor(x$roa, .01); x$roa_w5 <- winsor(x$roa, .05)
rbind(surowe = opis(x$roa), w_1_99 = opis(x$roa_w1), w_5_95 = opis(x$roa_w5))
c(zmienione_1_99 = sum(x$roa != x$roa_w1), zmienione_5_95 = sum(x$roa != x$roa_w5))

## Projekt 3. Rentowność a struktura kapitału: regresja w przekroju -----------------------
# Efekt dźwigni podajemy na 10 punktów procentowych zadłużenia (dzwignia10 = dzwignia × 10)
x$dzwignia10 <- x$dzwignia * 10
f <- ~ dzwignia10 + log_akt + branza
m_ols  <- lm(update(f, roa ~ .), data = x)
m_w1   <- lm(update(f, roa_w1 ~ .), data = x)
m_w5   <- lm(update(f, roa_w5 ~ .), data = x)
m_mm   <- lmrob(update(f, roa ~ .), data = x, setting = "KS2014")   # regresja odporna MM
wiersz <- function(b, se, df) { b <- unname(b); se <- unname(se); c(b = b, SE = se, CI_d = b - qt(.975, df) * se, CI_g = b + qt(.975, df) * se,
                                p = 2 * pt(-abs(b / se), df)) }
se_hc3 <- function(m) sqrt(diag(vcovHC(m, type = "HC3")))["dzwignia10"]
tab3 <- rbind(
  "OLS, klasyczne SE"     = wiersz(coef(m_ols)["dzwignia10"], sqrt(diag(vcov(m_ols)))["dzwignia10"], m_ols$df.residual),
  "OLS, SE HC3"           = wiersz(coef(m_ols)["dzwignia10"], se_hc3(m_ols), m_ols$df.residual),
  "OLS winsor. 1/99, HC3" = wiersz(coef(m_w1)["dzwignia10"], se_hc3(m_w1), m_w1$df.residual),
  "OLS winsor. 5/95, HC3" = wiersz(coef(m_w5)["dzwignia10"], se_hc3(m_w5), m_w5$df.residual),
  "Regresja odporna MM"   = wiersz(coef(m_mm)["dzwignia10"], sqrt(diag(vcov(m_mm)))["dzwignia10"], m_mm$df.residual))
pokaz <- function(t) data.frame(round(t[, 1:4], 3), p = signif(t[, "p"], 3), check.names = FALSE)
pokaz(tab3)
c(R2_OLS = round(summary(m_ols)$r.squared, 3), spolki_z_waga_MM_ponizej_0.5 = sum(weights(m_mm, type = "robustness") < .5))

## Projekt 4. Panel 120 spółek × 6 lat: te same dane, różne błędy standardowe -------------
p$dzwignia10 <- p$dzwignia * 10
m_pool <- lm(roa ~ dzwignia10 + log_akt + branza, data = p)
m_fe   <- lm(roa ~ dzwignia10 + log_akt + firma + factor(rok), data = p)   # efekty stałe firm i lat
se_ <- function(m, V) sqrt(diag(V))["dzwignia10"]
tab4 <- rbind(
  "Pooled OLS, klasyczne SE"        = wiersz(coef(m_pool)["dzwignia10"], se_(m_pool, vcov(m_pool)), m_pool$df.residual),
  "Pooled OLS, SE klastr. firma"     = wiersz(coef(m_pool)["dzwignia10"], se_(m_pool, vcovCL(m_pool, cluster = ~firma)), N - 1),
  "Pooled OLS, SE firma + rok"       = wiersz(coef(m_pool)["dzwignia10"], se_(m_pool, vcovCL(m_pool, cluster = ~firma + rok)), Tlat - 1),
  "FE firma + rok, SE klastr. firma" = wiersz(coef(m_fe)["dzwignia10"], se_(m_fe, vcovCL(m_fe, cluster = ~firma)), N - 1))
pokaz(tab4)
# Ile razy klastrowany błąd jest większy od klasycznego?
round(tab4[2:3, "SE"] / tab4[1, "SE"], 2)
Wynik w R
            M    SD   Me    Q1   Q3    Min    Max Skosnosc
ROA      3.45  8.01 4.72 -0.20 7.42 -49.62  19.04    -2.73
Dzwignia 0.45  0.16 0.44  0.32 0.55   0.07   0.92     0.32
Plynnosc 8.75 60.84 2.44  1.74 3.61   0.76 668.06    10.61
          M   SD   Me   Q1   Q3    Min   Max Skosnosc
surowe 3.45 8.01 4.72 -0.2 7.42 -49.62 19.04    -2.73
w_1_99 3.67 6.72 4.72 -0.2 7.42 -23.32 17.54    -1.05
w_5_95 3.96 5.21 4.72 -0.2 7.42  -5.28 13.18    -0.14
zmienione_1_99 zmienione_5_95
             4             12
                           b    SE   CI_d   CI_g        p
OLS, klasyczne SE     -3.224 0.357 -3.931 -2.517 5.16e-15
OLS, SE HC3           -3.224 0.377 -3.971 -2.477 6.68e-14
OLS winsor. 1/99, HC3 -3.065 0.318 -3.695 -2.435 2.10e-16
OLS winsor. 5/95, HC3 -2.372 0.185 -2.738 -2.007 7.63e-24
Regresja odporna MM   -2.762 0.250 -3.257 -2.267 1.04e-19
                      R2_OLS spolki_z_waga_MM_ponizej_0.5
                       0.458                        3.000
                                      b    SE   CI_d   CI_g        p
Pooled OLS, klasyczne SE         -2.630 0.144 -2.912 -2.347 1.82e-61
Pooled OLS, SE klastr. firma     -2.630 0.235 -3.096 -2.164 2.92e-20
Pooled OLS, SE firma + rok       -2.630 0.209 -3.167 -2.093 5.62e-05
FE firma + rok, SE klastr. firma -1.131 0.343 -1.811 -0.452 1.30e-03
Pooled OLS, SE klastr. firma   Pooled OLS, SE firma + rok
                        1.64                         1.45
2. Projekty 1 i 5: ankieta oraz regresja logistyczna upadłości z próbą 1:1
R
# Projekty 1 i 5: ankieta wśród przedsiębiorców i model zagrożenia upadłością (dane symulowane).
suppressPackageStartupMessages(library(pROC))

## Projekt 1. Ankieta wśród właścicieli firm -----------------------------------------------
# 280 właścicieli: wielkość firmy (mikro/mała/średnia), sposób prowadzenia księgowości
# (biuro rachunkowe / własny dział lub księgowa na etacie), wykształcenie ekonomiczne (tak/nie)
# i ocena przydatności sprawozdania finansowego w podejmowaniu decyzji (1 – zupełnie nieprzydatne, 5 – bardzo przydatne).
set.seed(41502)
n1 <- 280
wielkosc <- factor(sample(c("mikro", "mała", "średnia"), n1, replace = TRUE, prob = c(.55, .30, .15)),
                   levels = c("mikro", "mała", "średnia"))
p_biuro <- c(mikro = .80, mała = .58, średnia = .30)[as.character(wielkosc)]
ksiegowosc <- factor(ifelse(runif(n1) < p_biuro, "biuro rachunkowe", "własny dział"))
ekonom <- factor(ifelse(runif(n1) < .40, "tak", "nie"), levels = c("nie", "tak"))
lat <- 0.6 * (ekonom == "tak") + 0.3 * (wielkosc != "mikro") + rlogis(n1)
ocena <- findInterval(lat, c(-1.6, -0.5, 0.6, 1.9)) + 1

tab <- table(wielkosc, ksiegowosc)
tab
round(100 * prop.table(tab, 1), 1)                      # procenty w wierszach: w każdej grupie wielkości
chi <- chisq.test(tab)
signif(chi$p.value, 3)
round(c(chi2 = unname(chi$statistic), df = unname(chi$parameter),
        V_Cramera = sqrt(unname(chi$statistic) / (n1 * (min(dim(tab)) - 1))), min_oczekiwana = min(chi$expected)), 4)
round(chi$stdres, 2)                                     # reszty standaryzowane skorygowane

# Ocena przydatności sprawozdania (porządkowa 1–5): rozkład i test Manna–Whitneya
round(100 * prop.table(table(ekonom, ocena), 1), 1)
tapply(ocena, ekonom, median)
mw <- wilcox.test(ocena ~ ekonom, exact = FALSE, correct = TRUE)
n_nie <- sum(ekonom == "nie"); n_tak <- sum(ekonom == "tak")
U <- unname(mw$statistic)                                # U dla grupy „nie”
r_rb <- 1 - 2 * U / (n_nie * n_tak)                      # korelacja rangowo-dwuseryjna (dodatnia: wyżej „tak”)
round(c(n_nie = n_nie, n_tak = n_tak, U = U, r_rb = r_rb), 3)
signif(mw$p.value, 3)

## Projekt 5. Zagrożenie upadłością: regresja logistyczna --------------------------------
# Populacja 1500 spółek; w ciągu roku upadło ok. 4%; predyktory z poprzedniego sprawozdania.
set.seed(41505)
n5 <- 1500
s <- data.frame(roa = rnorm(n5, 4, 6), dzwignia = rbeta(n5, 4, 5), log_plyn = rnorm(n5, log(1.6), .45),
                log_akt = rnorm(n5, log(60), 1))
eta <- -4.1 - 0.14 * (s$roa - 4) + 5 * (s$dzwignia - .45) - 1.0 * (s$log_plyn - log(1.6)) - 0.3 * (s$log_akt - log(60))
s$upadlosc <- rbinom(n5, 1, plogis(eta))
s$dzwignia10 <- s$dzwignia * 10
c(upadlosci = sum(s$upadlosc), odsetek_proc = round(100 * mean(s$upadlosc), 2))
f5 <- upadlosc ~ roa + dzwignia10 + log_plyn + log_akt

# Model A: cała populacja spółek
mA <- glm(f5, family = binomial, data = s)
orci <- function(m) round(cbind(OR = exp(coef(m)), exp(confint.default(m)))[-1, ], 2)
orci(mA)

# Model B: typowy schemat z prac – wszystkie upadłe spółki + tyle samo losowo dobranych zdrowych
set.seed(41506)
upadle <- which(s$upadlosc == 1)
proba <- s[c(upadle, sample(which(s$upadlosc == 0), length(upadle))), ]
mB <- glm(f5, family = binomial, data = proba)
orci(mB)
c(EPV = sum(proba$upadlosc) / 4)                         # zdarzenia na predyktor

# Przewidywane prawdopodobieństwa dla populacji: model B przeszacowuje ryzyko,
# korekta wyrazu wolnego (prior correction, King i Zeng 2001): b0 − ln[((1 − τ)/τ) · (ȳ/(1 − ȳ))]
tau <- mean(s$upadlosc); ybar <- mean(proba$upadlosc)
pB <- predict(mB, newdata = s, type = "response")
pB_kor <- plogis(predict(mB, newdata = s, type = "link") - log(((1 - tau) / tau) * (ybar / (1 - ybar))))
round(100 * c(rzeczywisty_odsetek = tau, srednia_model_A = mean(fitted(mA)), srednia_model_B = mean(pB),
              srednia_model_B_po_korekcie = mean(pB_kor)), 2)

# Profil spółki: ROA = 1%, dźwignia = 0.70, płynność bieżąca = 1.0, aktywa 60 mln zł
profil <- data.frame(roa = 1, dzwignia10 = 7, log_plyn = log(1), log_akt = log(60))
round(100 * c(model_A = unname(predict(mA, profil, type = "response")), model_B = unname(predict(mB, profil, type = "response")),
              model_B_po_korekcie = unname(plogis(predict(mB, profil) - log(((1 - tau) / tau) * (ybar / (1 - ybar)))))), 1)

# Zdolność rozróżniania (AUC) nie zależy od korekty wyrazu wolnego
aucB <- roc(s$upadlosc, pB, quiet = TRUE)
round(c(AUC_model_B_w_populacji = as.numeric(auc(aucB)), AUC_po_korekcie = as.numeric(auc(roc(s$upadlosc, pB_kor, quiet = TRUE)))), 3)
round(as.numeric(ci.auc(aucB)), 3)
Wynik w R
         ksiegowosc
wielkosc  biuro rachunkowe własny dział
  mikro                117           21
  mała                  48           46
  średnia               14           34
         ksiegowosc
wielkosc  biuro rachunkowe własny dział
  mikro               84.8         15.2
  mała                51.1         48.9
  średnia             29.2         70.8
[1] 2.64e-13
          chi2             df      V_Cramera min_oczekiwana
       57.9250         2.0000         0.4548        17.3143
         ksiegowosc
wielkosc  biuro rachunkowe własny dział
  mikro               7.16        -7.16
  mała               -3.19         3.19
  średnia            -5.51         5.51
      ocena
ekonom    1    2    3    4    5
   nie 12.9 20.8 30.3 25.3 10.7
   tak  7.8  9.8 25.5 31.4 25.5
nie tak
  3   4
   n_nie    n_tak        U     r_rb
 178.000  102.000 6638.000    0.269
[1] 0.000119
   upadlosci odsetek_proc
        51.0          3.4
             OR 2.5 % 97.5 %
roa        0.89  0.84   0.93
dzwignia10 1.62  1.34   1.95
log_plyn   0.22  0.11   0.44
log_akt    0.64  0.48   0.85
             OR 2.5 % 97.5 %
roa        0.86  0.79   0.94
dzwignia10 1.68  1.22   2.30
log_plyn   0.19  0.06   0.58
log_akt    0.85  0.53   1.38
  EPV
12.75
        rzeczywisty_odsetek             srednia_model_A             srednia_model_B
                       3.40                        3.40                       37.43
srednia_model_B_po_korekcie
                       4.07
            model_A             model_B model_B_po_korekcie
               13.1                85.8                17.5
AUC_model_B_w_populacji         AUC_po_korekcie
                  0.805                   0.805
[1] 0.743 0.805 0.868
3. Rysunki
R
# Rysunki do wpisu (uruchom z folderu kod/): LANG=en_US.UTF-8 LC_ALL=en_US.UTF-8 Rscript b415-rysunki.R > b415-rysunki-wynik.txt
suppressPackageStartupMessages({ library(ggplot2); library(patchwork); library(svglite) })
KOLORY <- c(akcent = "#e50101", drugi = "#1f78b4", dane = "grey55", granat = "#0f1d3a")
theme_metodolog <- function(base_size = 13) {
  theme_minimal(base_size = base_size) +
    theme(plot.title = element_text(face = "bold", colour = KOLORY[["granat"]], size = rel(1.05), margin = margin(b = 6)),
          plot.subtitle = element_text(colour = "grey30", margin = margin(b = 8)),
          panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
          axis.title = element_text(colour = "grey20"), axis.text = element_text(colour = "grey25"),
          legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA),
          plot.margin = margin(10, 14, 10, 10))
}
zapisz_svg <- function(wykres, plik, szer = 10, wys = 5.6) {
  svglite::svglite(plik, width = szer, height = wys, bg = "white"); print(wykres); invisible(grDevices::dev.off())
  cat(sprintf("Zapisano %s: w HTML width=\"%d\" height=\"%d\" (%d KB)\n", plik, round(szer * 100), round(wys * 100), round(file.info(plik)$size / 1024)))
}
pdf(NULL)
invisible(capture.output({ for (skrypt in c("b415-1-wskazniki-regresja-panel.R", "b415-2-ankieta-upadlosc.R")) source(skrypt, local = TRUE) }))

# Rysunek 1: rozkład ROA i granice winsoryzacji (A) oraz efekt dźwigni w różnych podejściach (B)
gr <- data.frame(q = quantile(x$roa, c(.01, .05, .95, .99)), typ = c("1/99", "5/95", "5/95", "1/99"))
print(round(gr$q, 2))
rA <- ggplot(x, aes(roa)) + geom_histogram(binwidth = 2.5, boundary = 0, fill = "grey80", colour = "grey55") +
  geom_vline(data = gr, aes(xintercept = q, linetype = typ), colour = KOLORY[["akcent"]], linewidth = .8) +
  scale_linetype_manual(values = c("1/99" = "solid", "5/95" = "dashed"), name = "Granice winsoryzacji (percentyle)") +
  labs(title = "A. ROA 120 spółek w jednym roku", subtitle = sub("-", "\u2212", sprintf("M = %.2f, Me = %.2f, skośność = %.2f", round(mean(x$roa), 2), round(median(x$roa), 2), round(skos(x$roa), 2))),
       x = "ROA (%)", y = "Liczba spółek") + theme_metodolog(12)
efekty <- rbind(data.frame(metoda = rownames(tab3)[2:5], tab3[2:5, c("b", "CI_d", "CI_g")], dane = "przekrój (1 rok, n = 120)"),
                data.frame(metoda = rownames(tab4)[c(2, 4)], tab4[c(2, 4), c("b", "CI_d", "CI_g")], dane = "panel (120 × 6 lat)"))
efekty$metoda <- factor(efekty$metoda, levels = rev(efekty$metoda),
                        labels = rev(c("OLS, SE HC3", "OLS, ROA winsor. 1/99", "OLS, ROA winsor. 5/95", "Regresja odporna MM",
                                       "Pooled OLS, SE klastr. firma", "Efekty stałe firm i lat")))
print(efekty, row.names = FALSE, digits = 3)
rB <- ggplot(efekty, aes(b, metoda, colour = dane)) + geom_vline(xintercept = 0, colour = "grey45", linetype = 2) +
  geom_errorbar(aes(xmin = CI_d, xmax = CI_g), width = .2, orientation = "y", linewidth = .9) + geom_point(size = 3) +
  scale_colour_manual(values = c("przekrój (1 rok, n = 120)" = KOLORY[["drugi"]], "panel (120 × 6 lat)" = KOLORY[["akcent"]]), name = NULL) +
  labs(title = "B. Dźwignia a ROA: współczynnik z 95% CI", subtitle = "Zmiana ROA przy dźwigni wyższej o 10 pkt proc.",
       x = "b (pkt proc. ROA)", y = NULL) + theme_metodolog(12)
zapisz_svg(rA + rB + plot_layout(widths = c(1, 1.15)), "../statystyka-finanse-wskazniki-winsoryzacja.svg", szer = 11, wys = 5.6)

# Rysunek 2: przewidywane ryzyko upadłości z modelu na próbie dobranej 1:1 przed i po korekcie
d2 <- data.frame(co = rep(c("Średnie ryzyko w populacji", "Spółka: ROA 1%, dźwignia 0.70, płynność 1.0"), each = 3),
                 model = rep(c("Model na całej\npopulacji", "Próba 1:1\nbez korekty", "Próba 1:1\npo korekcie"), 2),
                 proc = c(100 * mean(fitted(mA)), 100 * mean(pB), 100 * mean(pB_kor),
                          100 * predict(mA, profil, type = "response"), 100 * predict(mB, profil, type = "response"),
                          100 * plogis(predict(mB, profil) - log(((1 - tau) / tau) * (ybar / (1 - ybar))))))
d2$model <- factor(d2$model, levels = unique(d2$model))
d2$co <- factor(d2$co, levels = unique(d2$co))
print(transform(d2, model = gsub("\n", " ", model)), row.names = FALSE, digits = 3)
r2 <- ggplot(d2, aes(model, proc, fill = model)) + geom_col(width = .65) +
  geom_text(aes(label = sprintf("%.1f%%", proc)), vjust = -.4, size = 4) + facet_wrap(~co, scales = "free_y") +
  scale_fill_manual(values = c("grey60", KOLORY[["akcent"]], KOLORY[["drugi"]]), guide = "none") +
  scale_y_continuous(expand = expansion(mult = c(0, .12))) +
  labs(title = "Przewidywane prawdopodobieństwo upadłości w ciągu roku",
       subtitle = sprintf("Populacja 1500 spółek, upadło %.1f%%; próba 1:1 = %d upadłe + %d zdrowe", 100 * tau, sum(proba$upadlosc), sum(proba$upadlosc == 0)),
       x = NULL, y = "Prawdopodobieństwo (%)") + theme_metodolog(12) + theme(axis.text.x = element_text(size = 10))
zapisz_svg(r2, "../statystyka-finanse-upadlosc-proba-dobrana.svg", szer = 10, wys = 5.2)
Wynik w R
[1] -23.32  -5.28  13.18  17.54
                       metoda     b  CI_d   CI_g                      dane
                  OLS, SE HC3 -3.22 -3.97 -2.477 przekrój (1 rok, n = 120)
        OLS, ROA winsor. 1/99 -3.07 -3.70 -2.435 przekrój (1 rok, n = 120)
        OLS, ROA winsor. 5/95 -2.37 -2.74 -2.007 przekrój (1 rok, n = 120)
          Regresja odporna MM -2.76 -3.26 -2.267 przekrój (1 rok, n = 120)
 Pooled OLS, SE klastr. firma -2.63 -3.10 -2.164       panel (120 × 6 lat)
      Efekty stałe firm i lat -1.13 -1.81 -0.452       panel (120 × 6 lat)
Zapisano ../statystyka-finanse-wskazniki-winsoryzacja.svg: w HTML width="1100" height="560" (19 KB)
                                          co                    model  proc
                  Średnie ryzyko w populacji Model na całej populacji  3.40
                  Średnie ryzyko w populacji    Próba 1:1 bez korekty 37.43
                  Średnie ryzyko w populacji    Próba 1:1 po korekcie  4.07
 Spółka: ROA 1%, dźwignia 0.70, płynność 1.0 Model na całej populacji 13.09
 Spółka: ROA 1%, dźwignia 0.70, płynność 1.0    Próba 1:1 bez korekty 85.77
 Spółka: ROA 1%, dźwignia 0.70, płynność 1.0    Próba 1:1 po korekcie 17.50
Zapisano ../statystyka-finanse-upadlosc-proba-dobrana.svg: w HTML width="1000" height="520" (11 KB)
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje lm(), glm(), chisq.test() i wilcox.test() z pakietu stats); rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- robustbase (wersja 0.99.7): Maechler, M., Rousseeuw, P., Croux, C., Todorov, V., Ruckstuhl, A., Salibian-Barrera, M., Verbeke, T., Koller, M., Conceicao, E. L. T., & Anna di Palma, M. (2026). robustbase: Basic robust statistics [R package]. http://robustbase.r-forge.r-project.org/
- pROC (wersja 1.19.0.1): Robin, X., Turck, N., Hainard, A., Tiberti, N., Lisacek, F., Sanchez, J.-C., & Müller, M. (2011). pROC: An open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics, 12, Article 77. https://doi.org/10.1186/1471-2105-12-77
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device (R package version 2.2.2) [Computer software]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy w analizach prac z finansów i rachunkowości
- Średnia i odchylenie standardowe jako jedyny opis wskaźników – przy płynności bieżącej w przykładzie średnia 8.75 przy medianie 2.44.
- Winsoryzacja „bo tak się robi”, bez podania progu, liczby zmienionych wartości i wyniku bez winsoryzacji.
- Usunięcie spółek ze stratami albo z ujemnym kapitałem własnym bez opisu, jak zmienia to próbę i wnioski.
- Wiersze spółka-rok traktowane jak niezależne obserwacje, czyli klasyczne błędy standardowe w danych panelowych.
- Wniosek przyczynowy z regresji w przekroju, np. „zadłużenie obniża rentowność”, gdy porównujesz różne spółki.
- Prawdopodobieństwa upadłości z próby 1:1 bez korekty i AUC liczone tylko na tych samych spółkach, na których oszacowano model.
- Wskaźniki z roku upadłości jako predyktory zamiast danych sprzed zdarzenia.
- Kilkanaście wskaźników w modelu przy kilkudziesięciu upadłościach – za mało zdarzeń na zmienną.
- Średnia z pojedynczej pozycji Likerta i test t bez pokazania rozkładu odpowiedzi.
- Korelacja dwóch szeregów z trendem zamiast analizy zmian lub sprawdzenia stacjonarności.
Najczęstsze pytania
Jakie analizy statystyczne wybrać do pracy magisterskiej z finansów?
Zależy to od danych. Ankietę z pytaniami kategorialnymi analizuj tabelami krzyżowymi i testem chi-kwadrat z V Craméra, oceny na skali 1–5 – testem Manna–Whitneya. Wskaźniki ze sprawozdań opisz medianą i rozstępem międzykwartylowym, związki między nimi – regresją z błędami odpornymi, dane kilku lat – modelem panelowym, a upadłość – regresją logistyczną.
Czy wskaźniki finansowe trzeba winsoryzować?
Nie ma takiego obowiązku. Winsoryzacja osłabia wpływ wartości skrajnych, ale zależy od arbitralnego progu i może zmieniać prawidłowe obserwacje. Jeśli ją stosujesz, ustal próg przed analizą, podaj liczbę zmienionych wartości i pokaż wynik bez winsoryzacji albo z regresji odpornej jako analizę wrażliwości.
Jak liczyć błędy standardowe w danych panelowych spółek?
Klasyczne błędy traktują każdy wiersz spółka-rok jak niezależną obserwację i zawyżają precyzję. Licz błędy odporne na klastrowanie według spółki i dodaj efekty stałe lat, które usuwają wspólne szoki koniunktury. Klastrowanie według lat ma sens dopiero przy większej ich liczbie.
Czy próbę do modelu upadłości można dobrać 1:1?
Można, bo upadłości są rzadkie i taki dobór jest efektywny. Ilorazy szans z takiej próby da się interpretować, ale przewidywane prawdopodobieństwa są zawyżone. Przed ich podaniem skoryguj wyraz wolny modelu o odsetek upadłości w populacji, z której dobierałeś spółki.
Ile spółek potrzeba do regresji logistycznej upadłości?
Liczy się przede wszystkim liczba upadłości, a nie wszystkich spółek. Przy mniej niż 10 zdarzeniach na predyktor współczynniki bywają obciążone, a przedziały ufności mają złe pokrycie. Przy 50 upadłościach ogranicz więc model do kilku wskaźników wybranych z literatury.
Powiązane hasła
Przeczytaj też
Regresja w Gretlu krok po kroku
Import CSV, model KMNK, odczyt okna modelu i gwiazdek, testy White’a, Breuscha–Pagana i RESET, VIF, błędy HC3 oraz tabela APA – z danymi do pobrania.
Czytaj →PoradnikStatystyka w pracy z logistyki
Czasy dostaw i percentyle, błędy kompletacji na 1000 linii, przerwany szereg czasowy w magazynie, dostawcy jako skupienia i prognoza popytu: analizy, zdania APA i kod R.
Czytaj →PoradnikJak napisać pracę z finansów i rachunkowości
Teoria i kierunek związku, dobór spółek i przetrwanie, wzory wskaźników, winsoryzacja, model panelowy, skala wyniku w złotych – z przykładami do poprawienia.
Czytaj →PoradnikStatystyka w pracy z zarządzania i ekonomii
Ankieta wśród pracowników i model ekonometryczny na danych wtórnych: regresja, weryfikacja modelu, elastyczności, kod R i gotowe opisy wyników.
Czytaj →PoradnikDane panelowe: FE, RE i test Hausmana
Pooled OLS, efekty stałe i losowe, test Hausmana liczony ręcznie, błędy klastrowane CR2, efekty czasu, model within–between i przykład w R.
Czytaj →PoradnikStatystyka w pracy dyplomowej – przewodnik
Osiem etapów od hipotez do obrony: na każdy etap poradniki, hasła i kalkulatory oraz tabela typowych problemów z odpowiedzią, co przeczytać.
Czytaj →PoradnikPrognoza upadłości firm – regresja logistyczna
1500 firm transportowych: winsoryzacja wskaźników, ilorazy szans, walidacja w czasie, AUC i kalibracja oraz złudna trafność – pięć rysunków z kodem R.
Czytaj →PoradnikScoring kredytowy: WoE, IV i karta punktowa
Kasa spółdzielcza, 6000 pożyczek: przedziały, WoE i IV ręcznie, karta punktowa z PDO, Gini i KS, PSI i przetrenowane przedziały – pięć rysunków z kodem R.
Czytaj →PoradnikPrawo Benforda w audycie
Pierwsza i dwie pierwsze cyfry faktur, χ² i MAD, wpływ liczebności, kwoty z limitów i sito audytora – sześć rysunków z kodem R.
Czytaj →PoradnikBadanie zdarzeń (event study)
60 fikcyjnych ogłoszeń skupu akcji: model rynkowy, AR i CAR z przedziałami, testy t, BMP i bootstrap oraz fałszywe alarmy przy wspólnej dacie zdarzenia.
Czytaj →PoradnikVaR i expected shortfall – ryzyko kursowe
3 mln euro należności i 10 dni: VaR i ES metodą historyczną, normalną i GARCH, reguła √10 i test wsteczny Kupca – z kodem R.
Czytaj →Piszesz pracę z finansów lub rachunkowości i nie wiesz, jak policzyć wyniki?
Pomożemy dobrać analizy do Twoich danych – ankiety, wskaźników ze sprawozdań, panelu spółek albo modelu upadłości – policzyć je w R lub SPSS i wyjaśnić tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Altman, E. I. (1968). Financial ratios, discriminant analysis and the prediction of corporate bankruptcy. The Journal of Finance, 23(4), 589–609. https://doi.org/10.1111/j.1540-6261.1968.tb00843.x
- Cameron, A. C., & Miller, D. L. (2015). A practitioner’s guide to cluster-robust inference. Journal of Human Resources, 50(2), 317–372. https://doi.org/10.3368/jhr.50.2.317
- Gow, I. D., Ormazabal, G., & Taylor, D. J. (2010). Correcting for cross-sectional and time-series dependence in accounting research. The Accounting Review, 85(2), 483–512. https://doi.org/10.2308/accr.2010.85.2.483 ● Otwarty dostęp: pełny tekst
- Hayes, A. F., & Cai, L. (2007). Using heteroskedasticity-consistent standard error estimators in OLS regression: An introduction and software implementation. Behavior Research Methods, 39(4), 709–722. https://doi.org/10.3758/bf03192961 ● Otwarty dostęp
- King, G., & Zeng, L. (2001). Logistic regression in rare events data. Political Analysis, 9(2), 137–163. https://doi.org/10.1093/oxfordjournals.pan.a004868 ● Otwarty dostęp
- Leone, A. J., Minutti-Meza, M., & Wasley, C. E. (2019). Influential observations and inference in accounting research. The Accounting Review, 94(6), 337–364. https://doi.org/10.2308/accr-52396 ● Otwarty dostęp: pełny tekst
- Ohlson, J. A. (1980). Financial ratios and the probabilistic prediction of bankruptcy. Journal of Accounting Research, 18(1), 109–131. https://doi.org/10.2307/2490395
- Peduzzi, P., Concato, J., Kemper, E., Holford, T. R., & Feinstein, A. R. (1996). A simulation study of the number of events per variable in logistic regression analysis. Journal of Clinical Epidemiology, 49(12), 1373–1379. https://doi.org/10.1016/s0895-4356(96)00236-3 ● Otwarty dostęp
- Petersen, M. A. (2009). Estimating standard errors in finance panel data sets: Comparing approaches. The Review of Financial Studies, 22(1), 435–480. https://doi.org/10.1093/rfs/hhn053 ● Otwarty dostęp: pełny tekst
- Rajan, R. G., & Zingales, L. (1995). What do we know about capital structure? Some evidence from international data. The Journal of Finance, 50(5), 1421–1460. https://doi.org/10.1111/j.1540-6261.1995.tb05184.x ● Otwarty dostęp
Cytowania BibTeX
@article{altman1968financial, author={Altman, Edward I.}, title={{Financial ratios, discriminant analysis and the prediction of corporate bankruptcy}}, journal={The Journal of Finance}, year={1968}, volume={23}, number={4}, pages={589--609}, doi={10.1111/j.1540-6261.1968.tb00843.x}}@article{cameron2015practitioner, author={Cameron, A. Colin and Miller, Douglas L.}, title={{A practitioner’s guide to cluster-robust inference}}, journal={Journal of Human Resources}, year={2015}, volume={50}, number={2}, pages={317--372}, doi={10.3368/jhr.50.2.317}}@article{gow2010correcting, author={Gow, Ian D. and Ormazabal, Gaizka and Taylor, Daniel J.}, title={{Correcting for cross-sectional and time-series dependence in accounting research}}, journal={The Accounting Review}, year={2010}, volume={85}, number={2}, pages={483--512}, doi={10.2308/accr.2010.85.2.483}}@article{hayes2007using, author={Hayes, Andrew F. and Cai, Li}, title={{Using heteroskedasticity-consistent standard error estimators in OLS regression: An introduction and software implementation}}, journal={Behavior Research Methods}, year={2007}, volume={39}, number={4}, pages={709--722}, doi={10.3758/bf03192961}}@article{king2001logistic, author={King, Gary and Zeng, Langche}, title={{Logistic regression in rare events data}}, journal={Political Analysis}, year={2001}, volume={9}, number={2}, pages={137--163}, doi={10.1093/oxfordjournals.pan.a004868}}@article{leone2019influential, author={Leone, Andrew J. and Minutti-Meza, Miguel and Wasley, Charles E.}, title={{Influential observations and inference in accounting research}}, journal={The Accounting Review}, year={2019}, volume={94}, number={6}, pages={337--364}, doi={10.2308/accr-52396}}@article{ohlson1980financial, author={Ohlson, James A.}, title={{Financial ratios and the probabilistic prediction of bankruptcy}}, journal={Journal of Accounting Research}, year={1980}, volume={18}, number={1}, pages={109--131}, doi={10.2307/2490395}}@article{peduzzi1996simulation, author={Peduzzi, Peter and Concato, John and Kemper, Elizabeth and Holford, Theodore R. and Feinstein, Alvan R.}, title={{A simulation study of the number of events per variable in logistic regression analysis}}, journal={Journal of Clinical Epidemiology}, year={1996}, volume={49}, number={12}, pages={1373--1379}, doi={10.1016/s0895-4356(96)00236-3}}@article{petersen2009estimating, author={Petersen, Mitchell A.}, title={{Estimating standard errors in finance panel data sets: Comparing approaches}}, journal={The Review of Financial Studies}, year={2009}, volume={22}, number={1}, pages={435--480}, doi={10.1093/rfs/hhn053}}@article{rajan1995what, author={Rajan, Raghuram G. and Zingales, Luigi}, title={{What do we know about capital structure? Some evidence from international data}}, journal={The Journal of Finance}, year={1995}, volume={50}, number={5}, pages={1421--1460}, doi={10.1111/j.1540-6261.1995.tb05184.x}}