Przykład: czy rynek reaguje na ogłoszenie skupu akcji?
Na fikcyjnej giełdzie notowany jest fikcyjny indeks NOVA. W ciągu około czterech lat 60 spółek z indeksu (oznaczamy je S01–S60) ogłosiło program skupu akcji własnych. Student piszący pracę z finansów pyta: czy w dniach wokół ogłoszenia kurs tych spółek rośnie bardziej, niż wynikałoby z ruchu całego rynku? To samo pytanie zadaje analityk w dziale relacji inwestorskich, który chce ocenić, jak rynek odebrał komunikat. Odpowiada na nie badanie zdarzeń (ang. event study).
Metodę zaproponowali Fama i in. (1969) do pomiaru, jak ceny akcji dostosowują się do nowej informacji. Dziś stosuje się ją także w ekonomii, zarządzaniu i marketingu (Corrado, 2011). Uwaga na nazwę: hasło badanie zdarzeń w słowniku opisuje wersję panelową (współczynniki okresów przed programem i po nim w regresji z efektami stałymi). Tu zajmujemy się wersją finansową: nadwyżkowymi stopami zwrotu wokół ogłoszenia. Wpis ma charakter metodologiczny i nie jest poradą inwestycyjną.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Dzienne stopy zwrotu indeksu i spółek losuje kod z rozkładu t z 5 stopniami swobody (grube ogony, zob. kurtoza). Ręcznie ustaliliśmy: betę spółek od 0.6 do 1.4, odchylenie dziennych reszt 1.2–2.4 pp, efekt ogłoszenia w dniu 0 różny w spółkach (średnio +1.5 pp, SD = 1.5 pp), efekt w dniu +1 (średnio +0.4 pp) i przeciek: +0.12 pp dziennie w pięciu sesjach przed ogłoszeniem. Prawdziwy średni CAR[−1, +1] w tych 60 spółkach wynosi więc 2.32 pp. Ziarno 638 ustalono raz i go nie zmieniano. Po pierwszym uruchomieniu z 40 spółkami zwiększyliśmy próbę do 60: jedna spółka miała w dniu ogłoszenia resztę odchyloną o ponad 14 odchyleń standardowych i zdominowała średnią. Dane pobierzesz jako event-study-skup-akcji-stopy-zwrotu.csv (15 660 wierszy: spółka, sesja, dzień względem ogłoszenia, stopa zwrotu spółki R i indeksu Rm).
Rysunek 1: dwa okna wokół ogłoszenia
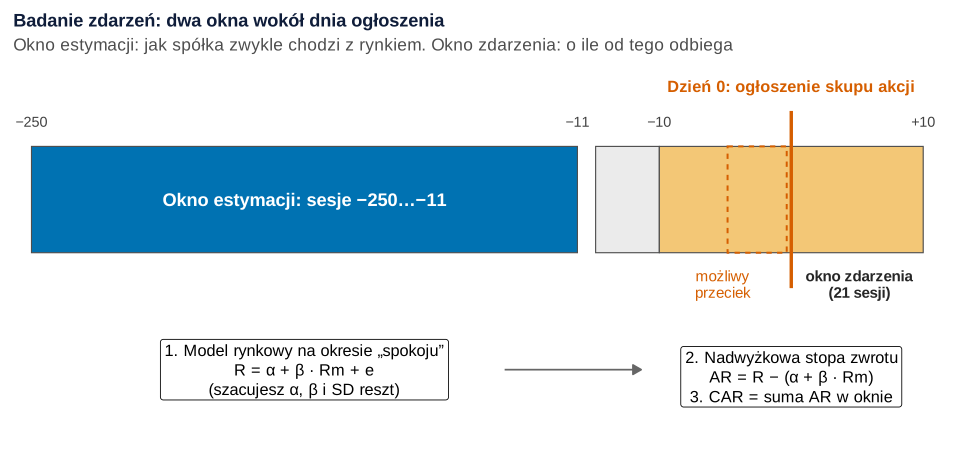
Co widać. Każda spółka ma własną oś czasu, liczoną w sesjach od dnia ogłoszenia. W oknie estymacji (240 sesji „spokoju”) szacujemy, jak spółka zwykle porusza się razem z rynkiem. To prosta regresja liniowa stopy zwrotu spółki na stopę zwrotu indeksu, czyli model rynkowy. Potem w oknie zdarzenia liczymy, o ile rzeczywista stopa zwrotu odbiega od przewidywanej:
Słowami: nadwyżkowa stopa zwrotu (AR, ang. abnormal return) to ta część ruchu kursu, której nie tłumaczy rynek. Skumulowana nadwyżkowa stopa zwrotu (CAR) to suma AR w wybranym oknie, np. od dnia −1 do +1. Średnie po spółkach oznacza się AAR i CAAR.
Jak może zmylić. Przerwa między oknami nie jest ozdobą. Gdyby okno estymacji sięgało dnia −1, przeciek przed ogłoszeniem trafiłby do α̂ i zaniżył AR.
Podpis do pracy:
Zdanie do Metody:
Rysunek 2: model rynkowy jednej spółki
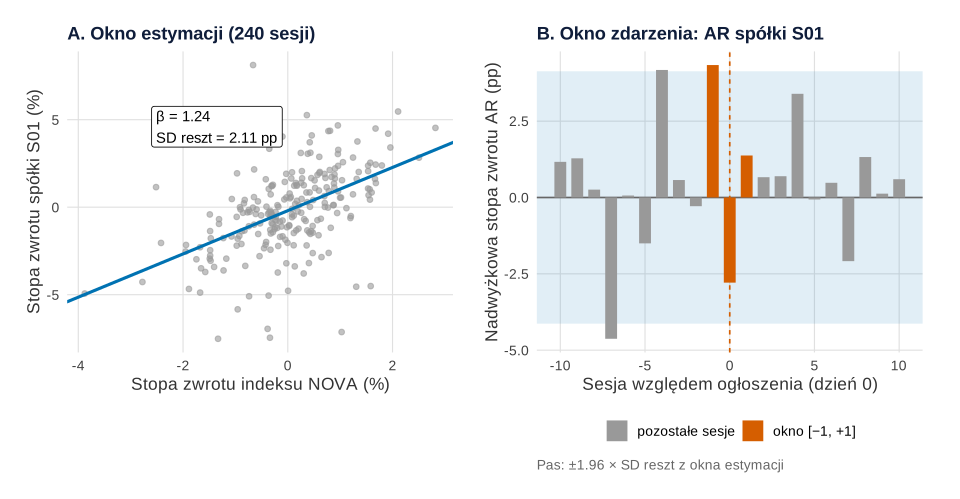
set.seed(638)).Co widać. Model rynkowy oszacowany metodą najmniejszych kwadratów dał dla S01 β = 1.24 i odchylenie reszt 2.11 pp (R² = .24). W oknie [−1, +1] AR wyniosły 4.34, −2.79 i 1.37 pp, razem CAR = 2.92 pp. Dla wszystkich 60 spółek oszacowane bety wahały się od 0.50 do 1.45 i korelowały z wartościami ustawionymi w danych na poziomie r = .91.
Jak może zmylić. Jedna spółka to za mało. Pas ±1.96 × SD reszt (±4.1 pp na sesję) pokazuje, że nawet AR = 4.34 pp mieści się w zwykłym szumie. Badanie zdarzeń działa dzięki uśrednianiu wielu spółek. Dzienne stopy zwrotu tworzą szereg czasowy o grubych ogonach, a ich zmienność bywa zmienna w czasie (zob. modele ARCH i GARCH). Model rynkowy tego nie uwzględnia.
Podpis do pracy:
Zdanie do Metody:
Rysunek 3: średnia reakcja 60 spółek
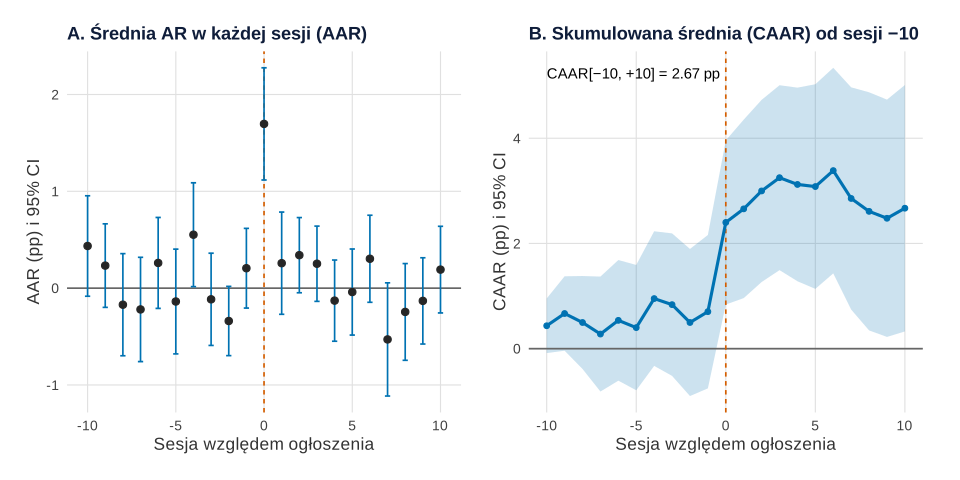
Co widać. W dniu ogłoszenia średnia AR wyniosła 1.70 pp, 95% CI [1.12, 2.28]. W pozostałych sesjach średnie krążą wokół zera. CAAR rośnie skokowo w dniu 0 i w sesji +10 wynosi 2.67 pp. Po ogłoszeniu nie widać dalszego dryfu: CAR[+2, +10] = 0.01 pp. Przedziały liczymy z rozrzutu wyników między spółkami, czyli testem t dla jednej próby (zob. test t dla jednej próby).
Jak może zmylić. Szukaliśmy przecieku i go nie znaleźliśmy, choć był w danych. CAR[−10, −2] = 0.50 pp, t(59) = 0.71, p = .479, a CAR[−5, −2] = −0.04 pp, p = .940, przy prawdziwych 0.48 pp. Przeciek rzędu 0.1 pp dziennie ginie w szumie 60 spółek – to kwestia mocy testu. Z kolei w sesji −4 przedział średniej AR nie obejmuje zera (0.55 pp, 95% CI [0.02, 1.09]), choć prawdziwy efekt tego dnia był mały. Przy 21 przedziałach jeden „istotny” dzień to zwykła sprawa (zob. problem wielokrotnych porównań). Okna testu ustal więc przed obejrzeniem wykresu.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: test średniego CAR – t, BMP i bootstrap
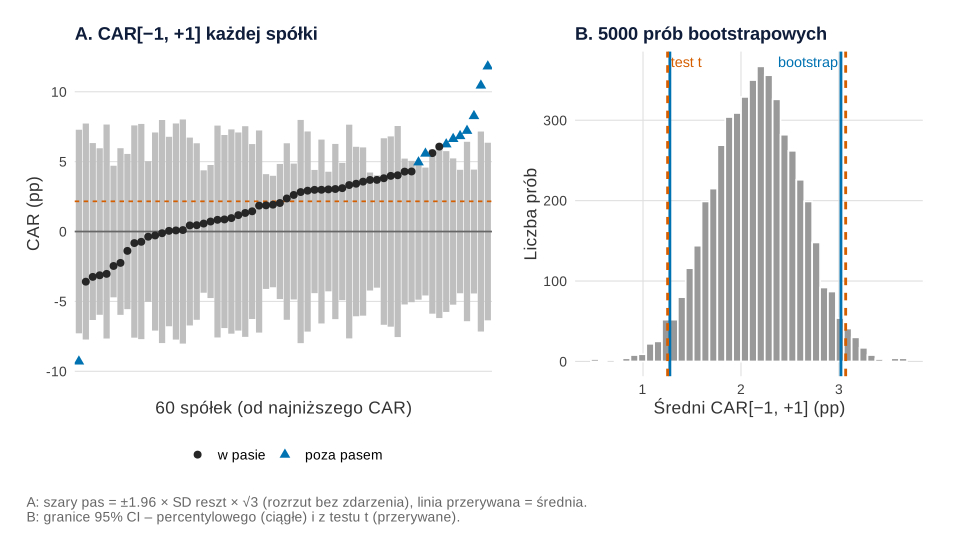
set.seed(638)).Co widać. Średni CAR[−1, +1] wyniósł 2.16 pp, 95% CI [1.25, 3.07], t(59) = 4.76, p < .001 – blisko prawdziwych 2.32 pp. Ale spółki reagują różnie: 13 z 60 ma CAR ujemny, a 10 wypada poza pas, w którym bez zdarzenia znalazłoby się około 3. Ogłoszenie zwiększa więc zmienność stóp zwrotu. Harrington i Shrider (2007) pokazują, że gdy efekt zdarzenia różni się między spółkami, wzrost wariancji jest nieunikniony, a popularne testy stają się obciążone.
Dlatego porównaliśmy trzy testy tej samej hipotezy:
- Test „klasyczny” bierze wariancję z okna estymacji: z = 6.10. Zakłada, że w dniu ogłoszenia zmienność jest taka jak zwykle.
- Test t przekrojowy bierze wariancję z rozrzutu CAR między spółkami: t(59) = 4.76.
- Test BMP (Boehmera, Musumeciego i Poulsena) standaryzuje CAR każdej spółki jej odchyleniem z okna estymacji, a potem stosuje wariancję przekrojową: t(59) = 5.16. Wariancja standaryzowanych CAR wyniosła 1.40 zamiast oczekiwanego 1.
Trzecią drogą jest bootstrap (Efron, 1979): losujemy spółki ze zwracaniem 5000 razy. Przedział percentylowy [1.27, 3.02] pp prawie pokrywa się z przedziałem t (mechanizm pokazuje wpis bootstrap – wizualizacja na obrazkach).
Jak może zmylić. Tu wszystkie testy są „istotne”, więc wybór wygląda na akademicki. Ale test klasyczny daje największą statystykę właśnie dlatego, że ignoruje wzrost zmienności – rysunek 5A pokazuje, co to robi z fałszywymi alarmami. Bootstrap po spółkach zakłada, że spółki są niezależne. Nie pomoże, gdy zdarzenia nakładają się w czasie.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: fałszywe alarmy – wzrost zmienności i wspólny dzień zdarzenia
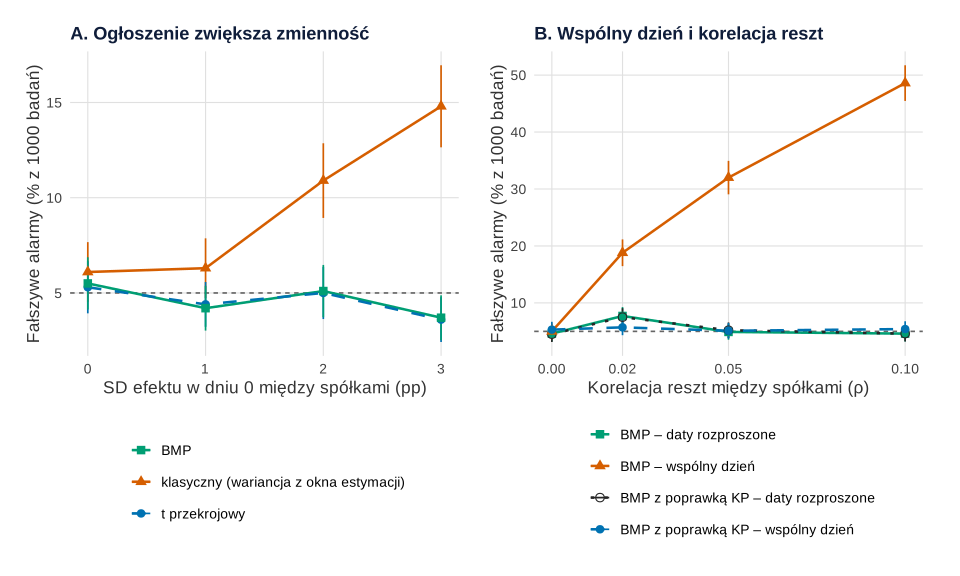
set.seed(6381) i set.seed(6382)).Co widać. W obu panelach ogłoszenie średnio nic nie zmienia, więc każde odrzucenie hipotezy zerowej to błąd I rodzaju. Każde badanie ma 60 spółek, 240 sesji estymacji i okno [−1, +1].
- Panel A – wzrost zmienności. Efekt w dniu 0 ma średnią 0, ale różni się między spółkami. Gdy jego SD rośnie od 0 do 3 pp, test klasyczny daje 6.1%, 6.3%, 10.9% i 14.8% fałszywych alarmów (błąd MC ok. 1 pp). Test t przekrojowy (3.6–5.3%) i BMP (3.7–5.5%) trzymają poziom. To heterogeniczność wariancji w praktyce.
- Panel B – nakładanie się zdarzeń. Wszystkie spółki mają ten sam dzień zdarzenia (np. zmiana przepisów dotycząca całej branży), a ich reszty są skorelowane. Przy korelacji .02, .05 i .10 test BMP daje 18.8%, 32.0% i 48.6% fałszywych alarmów. Przy rozproszonych datach ta sama korelacja nie szkodzi (4.6–7.7%). Kolari i Pynnönen (2010) pokazują, że przy wspólnej dacie zdarzenia nawet niska korelacja między nadwyżkowymi stopami zwrotu prowadzi do zbyt częstego odrzucania hipotezy zerowej. Proponują poprawkę testu BMP; w kodzie mnożymy statystykę przez √[(1 − r̄) / (1 + (n − 1)r̄)], gdzie r̄ to średnia korelacja reszt z okna estymacji. Z poprawką odsetek wynosi 5.1–5.7%.
Jak może zmylić. Korelacja .02 wydaje się zaniedbywalna, ale przy 60 spółkach sumuje się 1770 par. Symulacja zakłada jeden typ zależności. W danych rzeczywistych zależność bywa jednocześnie przekrojowa i czasowa – Gow i in. (2010) wykazali, że korekty odporne tylko na jeden rodzaj zależności dają źle określone statystyki testowe. Jeden punkt przy rozproszonych datach (7.7% przy korelacji .02) odstaje od 5% o ponad trzy błędy MC, ale nie układa się w trend: przy rozproszonych datach korelacja nie wchodzi do okna zdarzenia, a pozostałe punkty tej krzywej wynoszą 4.6–4.9%.
Podpis do pracy:
Zdanie do Metody:
Co z tym zrobić w firmie
- Ocena komunikatu. CAR[−1, +1] z przedziałem ufności mówi, jak rynek odebrał ogłoszenie na tle zwykłych wahań. Raportuj średnią z przedziałem i odsetek spółek z ujemnym CAR, nie tylko „istotność”.
- Kontrola obiegu informacji. Dodatnie AR przed ogłoszeniem to sygnał do sprawdzenia, kto znał informację wcześniej, a nie dowód przecieku. Brak istotności przed dniem 0 też niczego nie dowodzi (rysunek 3).
- Termin ogłoszenia. Komunikat ogłoszony w dniu publikacji wyników kwartalnych miesza dwa zdarzenia. Takich przypadków nie da się rozdzielić bez osobnego modelu, więc w analizie oznacz je albo wyklucz.
- Przegląd wielu decyzji naraz. Gdy oceniasz zmianę dotyczącą całej branży w jednym dniu, licz test z poprawką na korelację (rysunek 5B) albo analizuj portfel spółek jako jedną serię.
Planowanie inwestycji z niepewnymi założeniami to inny problem – opisuje go wpis o symulacji Monte Carlo opłacalności projektu.
Pułapki
- Okno wybrane po obejrzeniu wykresu. Okna [−1, +1] i pomocnicze ustal z góry i podaj w Metodzie.
- Okno estymacji zbyt blisko zdarzenia. Przeciek „wsiąka” w α̂. Zostaw przerwę.
- Test klasyczny przy zróżnicowanych efektach. Używaj testu przekrojowego, BMP lub bootstrapu (Harrington i Shrider, 2007).
- Wspólna data zdarzenia. Korelacja między spółkami zawyża fałszywe alarmy (Kolari i Pynnönen, 2010).
- Obserwacje skrajne. Jedna sesja z wiadomością niezwiązaną ze zdarzeniem może zdominować średnią – sprawdź wynik bez niej (zob. obserwacja odstająca) i podaj medianę CAR.
- Długi horyzont. Błąd modelu oczekiwanej stopy zwrotu sumuje się z każdą sesją, więc CAR liczony przez miesiące zależy od wyboru modelu bardziej niż CAR z trzech dni.
Jak opisać w pracy
W Metodzie podaj źródło dat ogłoszeń, kryteria doboru spółek, długość okna estymacji i zdarzenia, model oczekiwanej stopy zwrotu i testy. W Wynikach – tabelę CAR w kilku oknach i rysunek CAAR. Ogólny plan pracy znajdziesz we wpisach jak napisać pracę z finansów i rachunkowości oraz statystyka w pracy z finansów i rachunkowości.
| Okno (sesje) | Średni CAR (pp) | Statystyka testu | p |
|---|---|---|---|
| [−10, −2] | 0.50 | t(59) = 0.71 | .479 |
| [−5, −2] | −0.04 | t(59) = −0.08 | .940 |
| [−1, +1] | 2.16, 95% CI [1.25, 3.07] | t(59) = 4.76; BMP t(59) = 5.16 | < .001 |
| [+2, +10] | 0.01 | – | – |
| [−10, +10] | 2.67 | – | – |
Do Metody:
Do Wyników:
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, z których korzystają przepisy 2–4 (przepis 5 potrzebuje tylko palety i motywu). Każdy przepis kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Przepisy, które losują, mają własne ziarno: set.seed(638) w przepisach 1 i 4, set.seed(6381) i set.seed(6382) w przepisie 5. Ziaren nie zmieniano. Ręcznie ustalono: 1000 sesji, okno estymacji −250…−11 i zdarzenia −10…+10, rozkład t z 5 stopniami swobody, średnią (0.03 pp) i odchylenie (1 pp) stopy zwrotu indeksu, bety 0.6–1.4, odchylenia reszt 1.2–2.4 pp, efekt w dniu 0 (średnio 1.5 pp, SD 1.5 pp), w dniu +1 (0.4 pp, SD 0.6 pp), przeciek 0.12 pp dziennie w sesjach −5…−1, 5000 prób bootstrapowych oraz siatki parametrów symulacji (SD efektu 0–3 pp, korelacja reszt 0–.10). Liczbę spółek (60 zamiast 40) zmieniono po pierwszym uruchomieniu – powód opisuje sekcja z przykładem. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym.
1. Paleta, dane i oś czasu: Rysunek 1
R
# Rysunek 1. Oś czasu badania zdarzeń: okno estymacji, przerwa i okno zdarzenia (grafika) + dane fikcyjne
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", pomarancz = "#E69F00", zielony = "#009E73", cynober = "#D55E00",
         grafit = "#262626", szary = "grey60", jasny = "grey92")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Fikcyjny rynek: indeks NOVA i 60 fikcyjnych spółek, 1000 dni sesyjnych (ok. 4 lata).
# Każda spółka raz ogłasza skup akcji własnych; dzień ogłoszenia = dzień 0.
N <- 60; dni <- 1000         # 60 spółek: ustalono po pierwszym uruchomieniu z 40 (opis na stronie)
okno_est <- -250:-11        # okno estymacji (240 sesji)
okno_zd  <- -10:10          # okno zdarzenia (21 sesji)

set.seed(638)                                     # ziarno ustalone raz, bez dobierania pod wynik
losuj_t <- function(n, sd, df = 5) rt(n, df) * sd / sqrt(df / (df - 2))  # rozkład t(5): grube ogony, zadane SD
Rm <- 0.0003 + losuj_t(dni, 0.010)                     # dzienna stopa zwrotu indeksu NOVA
spolki <- data.frame(spolka = sprintf("S%02d", 1:N),
                     alfa  = rnorm(N, 0, 0.0002),
                     beta  = round(runif(N, 0.6, 1.4), 2),
                     sigma = runif(N, 0.012, 0.024))
# Dni ogłoszeń rozrzucone w czasie (co najmniej 251 sesji historii i 10 sesji po)
spolki$dzien0 <- sort(sample(260:985, N))
# Prawdziwy efekt ogłoszenia (ustalony ręcznie): różny w spółkach
spolki$efekt0 <- rnorm(N, 0.015, 0.015)           # dzień 0: średnio +1.5 pp, SD 1.5 pp
spolki$efekt1 <- rnorm(N, 0.004, 0.006)           # dzień +1: średnio +0.4 pp
przeciek <- 0.0012                                # dni −5…−1: +0.12 pp dziennie (przeciek informacji)

R <- sapply(1:N, function(i) with(spolki[i, ], alfa + beta * Rm + losuj_t(dni, sigma)))
for (i in 1:N) {
  d0 <- spolki$dzien0[i]
  R[d0, i]     <- R[d0, i] + spolki$efekt0[i]
  R[d0 + 1, i] <- R[d0 + 1, i] + spolki$efekt1[i]
  R[d0 + (-5:-1), i] <- R[d0 + (-5:-1), i] + przeciek
}

# Dane w formacie długim: tylko sesje od −250 do +10 wokół ogłoszenia każdej spółki
dane <- do.call(rbind, lapply(1:N, function(i) {
  t <- c(okno_est, -10:10); d <- spolki$dzien0[i] + t
  data.frame(spolka = spolki$spolka[i], sesja = d, dzien_wzgl = t,
             R = round(R[d, i], 6), Rm = round(Rm[d], 6))
}))
dane <- dane[dane$dzien_wzgl %in% c(okno_est, okno_zd), ]
write.csv(dane, "event-study-skup-akcji-stopy-zwrotu.csv", row.names = FALSE)

c(spolki = N, wiersze = nrow(dane), sesje_estymacji = length(okno_est), sesje_zdarzenia = length(okno_zd))
round(100 * c(sr_Rm = mean(Rm), sd_Rm = sd(Rm), sr_sigma = mean(spolki$sigma)), 3)   # w pp
round(100 * c(efekt0_sr = mean(spolki$efekt0), efekt0_sd = sd(spolki$efekt0),
              ujemny_efekt0 = mean(spolki$efekt0 < 0)), 1)
range(spolki$dzien0)

# Grafika: oś czasu (skala schematyczna – okno estymacji ściśnięte)
okna <- data.frame(x0 = c(0, 6.2, 6.9), x1 = c(6, 6.9, 9.8),
                   nazwa = c("Okno estymacji: sesje −250…−11", "Przerwa", "Okno zdarzenia: −10…+10"),
                   wypelnienie = c("est", "przerwa", "zd"))
p1 <- ggplot() +
  geom_rect(data = okna, aes(xmin = x0, xmax = x1, ymin = 0.55, ymax = 0.85, fill = wypelnienie),
            colour = "grey30", linewidth = 0.4) +
  geom_text(data = okna[1, ], aes(x = (x0 + x1) / 2, y = 0.70, label = nazwa),
            fontface = "bold", size = 4.8, colour = "white") +
  annotate("text", x = 9.1, y = 0.50, label = "okno zdarzenia\n(21 sesji)", size = 4.0, lineheight = 0.9,
           fontface = "bold", colour = "grey15", vjust = 1) +
  annotate("segment", x = 8.35, xend = 8.35, y = 0.45, yend = 0.95, linewidth = 1.2, colour = kol[["cynober"]]) +
  annotate("text", x = 8.35, y = 1.02, label = "Dzień 0: ogłoszenie skupu akcji",
           fontface = "bold", size = 4.3, colour = kol[["cynober"]]) +
  annotate("rect", xmin = 7.65, xmax = 8.3, ymin = 0.55, ymax = 0.85, fill = NA,
           colour = kol[["cynober"]], linetype = "22", linewidth = 0.7) +
  annotate("text", x = 7.6, y = 0.50, label = "możliwy\nprzeciek", size = 4.0, lineheight = 0.9,
           colour = kol[["cynober"]], vjust = 1) +
  annotate("text", x = c(0, 6, 6.9, 9.8), y = 0.92, label = c("−250", "−11", "−10", "+10"),
           size = 3.8, colour = "grey25") +
  # trzy kroki pod osią
  annotate("label", x = 3, y = 0.22, size = 4.3, lineheight = 1.0, fill = "white",
           label = "1. Model rynkowy na okresie „spokoju”\nR = α + β · Rm + e\n(szacujesz α, β i SD reszt)") +
  annotate("label", x = 8.35, y = 0.20, size = 4.3, lineheight = 1.0, fill = "white",
           label = "2. Nadwyżkowa stopa zwrotu\nAR = R − (α + β · Rm)\n3. CAR = suma AR w oknie") +
  annotate("segment", x = 5.2, xend = 6.7, y = 0.22, yend = 0.22, colour = "grey40",
           arrow = arrow(length = unit(0.25, "cm"), type = "closed")) +
  scale_fill_manual(values = c(est = kol[["niebieski"]], przerwa = kol[["jasny"]], zd = "#F3C776"), guide = "none") +
  coord_cartesian(xlim = c(-0.2, 10), ylim = c(0, 1.08), expand = FALSE) +
  labs(title = "Badanie zdarzeń: dwa okna wokół dnia ogłoszenia",
       subtitle = "Okno estymacji: jak spółka zwykle chodzi z rynkiem. Okno zdarzenia: o ile od tego odbiega") +
  motyw + theme(axis.text = element_blank(), axis.title = element_blank(),
                panel.grid.major = element_blank(), panel.grid.minor = element_blank())
p1   # ggsave("event-study-os-czasu.svg", p1, width = 10, height = 4.8)
Wynik w R
         spolki         wiersze sesje_estymacji sesje_zdarzenia
             60           15660             240              21
   sr_Rm    sd_Rm sr_sigma
  -0.009    1.015    1.805
    efekt0_sr     efekt0_sd ujemny_efekt0
          1.8           1.6          15.0
[1] 264 985
2. Model rynkowy i nadwyżkowe stopy zwrotu: Rysunek 2
R
# Rysunek 2. Model rynkowy jednej spółki (okno estymacji) i jej nadwyżkowe stopy zwrotu (okno zdarzenia)
library(ggplot2); library(patchwork)
# korzysta z obiektów z przepisu 1: dane, spolki, kol, motyw

# Model rynkowy dla każdej spółki osobno: R = α + β · Rm + e, tylko sesje −250…−11
modele <- do.call(rbind, lapply(split(dane, dane$spolka), function(d) {
  m <- lm(R ~ Rm, data = d[d$dzien_wzgl <= -11, ])
  data.frame(spolka = d$spolka[1], alfa_hat = coef(m)[[1]], beta_hat = coef(m)[[2]],
             sigma_hat = summary(m)$sigma, r2 = summary(m)$r.squared)
}))
rownames(modele) <- NULL
dane <- merge(dane, modele, by = "spolka")
dane <- dane[order(dane$spolka, dane$dzien_wzgl), ]
dane$AR <- dane$R - (dane$alfa_hat + dane$beta_hat * dane$Rm)   # nadwyżkowa stopa zwrotu
zd <- dane[dane$dzien_wzgl >= -10, ]                             # okno zdarzenia

# Oszacowania a wartości ustawione w danych
summary(modele[, c("beta_hat", "sigma_hat", "r2")])
round(cor(modele$beta_hat, spolki$beta), 3)

# Spółka S01 krok po kroku
s1 <- modele[modele$spolka == "S01", ]
round(c(alfa_pp = 100 * s1$alfa_hat, beta = s1$beta_hat, sigma_pp = 100 * s1$sigma_hat, r2 = s1$r2), 3)
z1 <- zd[zd$spolka == "S01", ]
round(100 * z1[z1$dzien_wzgl %in% -1:1, c("R", "Rm", "AR")], 2)   # w pp
round(100 * sum(z1$AR[z1$dzien_wzgl %in% -1:1]), 2)                 # CAR[−1, +1] spółki S01

e1 <- dane[dane$spolka == "S01" & dane$dzien_wzgl <= -11, ]
p2a <- ggplot(e1, aes(100 * Rm, 100 * R)) +
  geom_point(colour = kol[["szary"]], alpha = 0.6, size = 1.6) +
  geom_abline(intercept = 100 * s1$alfa_hat, slope = s1$beta_hat, colour = kol[["niebieski"]], linewidth = 1.1) +
  annotate("label", x = -2.6, y = 4.6, hjust = 0, size = 3.9, fill = "white",
           label = sprintf("β = %.2f\nSD reszt = %.2f pp", s1$beta_hat, 100 * s1$sigma_hat)) +
  labs(title = "A. Okno estymacji (240 sesji)", x = "Stopa zwrotu indeksu NOVA (%)",
       y = "Stopa zwrotu spółki S01 (%)") + motyw
p2b <- ggplot(z1, aes(dzien_wzgl, 100 * AR)) +
  annotate("rect", xmin = -Inf, xmax = Inf, ymin = -196 * s1$sigma_hat, ymax = 196 * s1$sigma_hat,
           fill = kol[["niebieski"]], alpha = 0.12) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_vline(xintercept = 0, colour = kol[["cynober"]], linetype = "22") +
  geom_col(aes(fill = dzien_wzgl %in% -1:1), width = 0.7) +
  scale_fill_manual(values = c(`FALSE` = kol[["szary"]], `TRUE` = kol[["cynober"]]),
                    labels = c("pozostałe sesje", "okno [−1, +1]"), name = NULL) +
  labs(title = "B. Okno zdarzenia: AR spółki S01", x = "Sesja względem ogłoszenia (dzień 0)",
       y = "Nadwyżkowa stopa zwrotu AR (pp)",
       caption = "Pas: ±1.96 × SD reszt z okna estymacji") + motyw
p2 <- p2a + p2b
p2   # ggsave("event-study-model-rynkowy.svg", p2, width = 10, height = 5)
Wynik w R
    beta_hat        sigma_hat             r2
 Min.   :0.5013   Min.   :0.01175   Min.   :0.04959
 1st Qu.:0.7707   1st Qu.:0.01444   1st Qu.:0.17540
 Median :1.0448   Median :0.01853   Median :0.25254
 Mean   :0.9996   Mean   :0.01804   Mean   :0.26674
 3rd Qu.:1.2086   3rd Qu.:0.02114   3rd Qu.:0.36664
 Max.   :1.4528   Max.   :0.02362   Max.   :0.55885
[1] 0.91
 alfa_pp     beta sigma_pp       r2
  -0.198    1.236    2.109    0.244
        R   Rm    AR
250  5.40 1.02  4.34
251 -1.55 1.17 -2.79
252  1.49 0.25  1.37
[1] 2.92
3. AAR, CAAR i trzy testy średniego CAR: Rysunek 3
R
# Rysunek 3. Średnie nadwyżkowe stopy zwrotu (AAR) i skumulowane (CAAR) 60 spółek z 95% CI; testy średniego CAR
library(ggplot2); library(patchwork)
# korzysta z obiektów z przepisów 1–2: zd, modele, spolki, przeciek, kol, motyw

# CAR każdej spółki narastająco od sesji −10
zd <- zd[order(zd$spolka, zd$dzien_wzgl), ]
zd$CAR <- ave(zd$AR, zd$spolka, FUN = cumsum)
# Dla każdej sesji: średnia po spółkach i 95% CI z rozrzutu między spółkami (test t przekrojowy)
podsum <- function(x) { n <- length(x); m <- mean(x); se <- sd(x) / sqrt(n)
  c(m = m, dol = m - qt(.975, n - 1) * se, gora = m + qt(.975, n - 1) * se) }
aar  <- data.frame(dzien = -10:10, t(sapply(-10:10, function(t) podsum(zd$AR[zd$dzien_wzgl == t]))))
caar <- data.frame(dzien = -10:10, t(sapply(-10:10, function(t) podsum(zd$CAR[zd$dzien_wzgl == t]))))
round(100 * aar[aar$dzien %in% -6:3, -1], 2)

# CAR w trzech oknach dla każdej spółki
car_okno <- function(od, do) tapply(zd$AR[zd$dzien_wzgl %in% od:do], zd$spolka[zd$dzien_wzgl %in% od:do], sum)
car_m11 <- car_okno(-1, 1); car_przed <- car_okno(-10, -2); car_po <- car_okno(2, 10)
round(100 * c(CAR_m1_p1 = mean(car_m11), CAR_m10_m2 = mean(car_przed), CAR_p2_p10 = mean(car_po),
              CAR_m10_p10 = caar$m[caar$dzien == 10]), 2)

# Trzy testy H0: średni CAR[−1, +1] = 0 (L = 3 sesje)
L <- 3; sig <- modele$sigma_hat[match(names(car_m11), modele$spolka)]
# (a) „klasyczny”: wariancja z okna estymacji, zakłada, że ogłoszenie nie zmienia zmienności
z_klas <- sum(car_m11 / (sig * sqrt(L))) / sqrt(length(car_m11))
# (b) test t przekrojowy: wariancja z rozrzutu CAR między spółkami
t_przekr <- t.test(car_m11)
# (c) Boehmer, Musumeci i Poulsen (BMP): standaryzowane CAR + wariancja przekrojowa
scar <- car_m11 / (sig * sqrt(L))
t_bmp <- mean(scar) / (sd(scar) / sqrt(length(scar)))
testy <- data.frame(test = c("klasyczny (wariancja z okna estymacji)", "t przekrojowy", "BMP"),
                    statystyka = c(z_klas, unname(t_przekr$statistic), t_bmp),
                    p = c(2 * pnorm(-abs(z_klas)), t_przekr$p.value, 2 * pt(-abs(t_bmp), length(scar) - 1)))
testy$statystyka <- round(testy$statystyka, 2); testy$p <- signif(testy$p, 3)
testy
round(100 * t_przekr$conf.int, 2)                          # 95% CI średniego CAR[−1, +1] w pp
round(100 * (przeciek + mean(spolki$efekt0) + mean(spolki$efekt1)), 2)   # prawdziwy średni CAR[−1, +1] w tych 60 spółkach
round(var(scar), 2)                                        # wariancja SCAR: ok. 1 bez wzrostu zmienności

# Przeciek: CAR[−10, −2] i CAR[−5, −2] – test t przekrojowy
car_m5_m2 <- car_okno(-5, -2)
round(rbind(okno_m10_m2 = c(CAR_pp = 100 * mean(car_przed), t = unname(t.test(car_przed)$statistic), p = t.test(car_przed)$p.value),
            okno_m5_m2  = c(CAR_pp = 100 * mean(car_m5_m2), t = unname(t.test(car_m5_m2)$statistic), p = t.test(car_m5_m2)$p.value)), 3)

p3a <- ggplot(aar, aes(dzien, 100 * m)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_vline(xintercept = 0, colour = kol[["cynober"]], linetype = "22") +
  geom_errorbar(aes(ymin = 100 * dol, ymax = 100 * gora), width = 0.3, colour = kol[["niebieski"]]) +
  geom_point(colour = kol[["grafit"]], size = 2.2) +
  labs(title = "A. Średnia AR w każdej sesji (AAR)", x = "Sesja względem ogłoszenia",
       y = "AAR (pp) i 95% CI") + motyw
p3b <- ggplot(caar, aes(dzien, 100 * m)) +
  geom_ribbon(aes(ymin = 100 * dol, ymax = 100 * gora), fill = kol[["niebieski"]], alpha = 0.2) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_vline(xintercept = 0, colour = kol[["cynober"]], linetype = "22") +
  geom_line(colour = kol[["niebieski"]], linewidth = 1.1) + geom_point(colour = kol[["niebieski"]], size = 1.6) +
  annotate("text", x = -10, y = 100 * max(caar$gora), hjust = 0, vjust = 1, size = 3.9,
           label = sprintf("CAAR[−10, +10] = %.2f pp", 100 * caar$m[caar$dzien == 10])) +
  labs(title = "B. Skumulowana średnia (CAAR) od sesji −10", x = "Sesja względem ogłoszenia",
       y = "CAAR (pp) i 95% CI") + motyw
p3 <- p3a + p3b
p3   # ggsave("event-study-aar-caar.svg", p3, width = 10, height = 5)
Wynik w R
       m   dol gora
5   0.26 -0.21 0.73
6  -0.14 -0.68 0.40
7   0.55  0.02 1.09
8  -0.12 -0.59 0.36
9  -0.34 -0.70 0.02
10  0.21 -0.21 0.62
11  1.70  1.12 2.28
12  0.26 -0.27 0.79
13  0.34 -0.05 0.73
14  0.25 -0.14 0.64
  CAR_m1_p1  CAR_m10_m2  CAR_p2_p10 CAR_m10_p10
       2.16        0.50        0.01        2.67
                                    test statystyka        p
1 klasyczny (wariancja z okna estymacji)       6.10 1.07e-09
2                          t przekrojowy       4.76 1.32e-05
3                                    BMP       5.16 3.09e-06
[1] 1.25 3.07
attr(,"conf.level")
[1] 0.95
[1] 2.32
[1] 1.4
            CAR_pp      t     p
okno_m10_m2  0.498  0.712 0.479
okno_m5_m2  -0.040 -0.076 0.940
4. CAR spółek i bootstrap: Rysunek 4
R
# Rysunek 4. CAR[−1, +1] każdej z 60 spółek i bootstrapowy rozkład średniego CAR
library(ggplot2); library(patchwork)
# korzysta z obiektów z przepisów 1–3: car_m11, sig, t_przekr, kol, motyw

# Ile spółek „wyskakuje” poza pas, którego oczekiwalibyśmy bez zdarzenia (±1.96 × SD reszt × √3)?
poza <- abs(car_m11) > 1.96 * sig * sqrt(3)
c(spolek_poza_pasem = sum(poza), oczekiwane_bez_efektu = round(0.05 * length(car_m11), 1),
  ujemny_CAR = sum(car_m11 < 0))

# Bootstrap: losowanie spółek ze zwracaniem, 5000 prób
set.seed(638)
B <- 5000
sr_boot <- replicate(B, mean(sample(car_m11, replace = TRUE)))
ci_boot <- quantile(sr_boot, c(.025, .975))
round(100 * c(srednia = mean(car_m11), boot_dol = ci_boot[[1]], boot_gora = ci_boot[[2]],
              t_dol = t_przekr$conf.int[1], t_gora = t_przekr$conf.int[2]), 2)
round(100 * sd(sr_boot), 3)                              # bootstrapowy błąd standardowy (pp)

kar <- data.frame(spolka = names(car_m11), car = car_m11, pas = 1.96 * sig * sqrt(3), poza = poza)
kar$spolka <- factor(kar$spolka, levels = kar$spolka[order(kar$car)])
p4a <- ggplot(kar, aes(x = spolka, y = 100 * car)) +
  geom_errorbar(aes(ymin = -100 * pas, ymax = 100 * pas), width = 0, colour = "grey75", linewidth = 2.2) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_hline(yintercept = 100 * mean(car_m11), colour = kol[["cynober"]], linetype = "22") +
  geom_point(aes(shape = poza, colour = poza), size = 2.4) +
  scale_shape_manual(values = c(`FALSE` = 16, `TRUE` = 17), labels = c("w pasie", "poza pasem"), name = NULL) +
  scale_colour_manual(values = c(`FALSE` = kol[["grafit"]], `TRUE` = kol[["niebieski"]]),
                      labels = c("w pasie", "poza pasem"), name = NULL) +
  labs(title = "A. CAR[−1, +1] każdej spółki", x = paste(length(car_m11), "spółek (od najniższego CAR)"), y = "CAR (pp)") +
  motyw + theme(axis.text.x = element_blank(), panel.grid.major.x = element_blank())
p4b <- ggplot(data.frame(m = 100 * sr_boot), aes(m)) +
  geom_histogram(bins = 40, fill = kol[["szary"]], colour = "white") +
  geom_vline(xintercept = 100 * ci_boot, colour = kol[["niebieski"]], linewidth = 1) +
  geom_vline(xintercept = 100 * t_przekr$conf.int, colour = kol[["cynober"]], linetype = "22", linewidth = 1) +
  annotate("text", x = 100 * ci_boot[[2]], y = Inf, vjust = 1.5, hjust = 1.05, size = 3.8,
           colour = kol[["niebieski"]], label = "bootstrap") +
  annotate("text", x = 100 * t_przekr$conf.int[1], y = Inf, vjust = 1.5, hjust = -0.1, size = 3.8,
           colour = kol[["cynober"]], label = "test t") +
  labs(title = "B. 5000 prób bootstrapowych", x = "Średni CAR[−1, +1] (pp)", y = "Liczba prób") + motyw
p4 <- p4a + p4b + plot_layout(widths = c(1.2, 1)) +
  plot_annotation(caption = paste0("A: szary pas = ±1.96 × SD reszt × √3 (rozrzut bez zdarzenia), linia przerywana = średnia.\n",
                                   "B: granice 95% CI – percentylowego (ciągłe) i z testu t (przerywane)."))
p4   # ggsave("event-study-car-spolek-bootstrap.svg", p4, width = 10, height = 5.2)
Wynik w R
    spolek_poza_pasem oczekiwane_bez_efektu            ujemny_CAR
                   10                     3                    13
  srednia  boot_dol boot_gora     t_dol    t_gora
     2.16      1.27      3.02      1.25      3.07
[1] 0.444
5. Symulacje fałszywych alarmów: Rysunek 5
R
# Rysunek 5. Fałszywe alarmy testów, gdy ogłoszenie nic nie zmienia średnio (H0 prawdziwa):
# (A) ogłoszenie zwiększa zmienność, (B) wszystkie spółki mają ten sam dzień zdarzenia i skorelowane reszty
library(ggplot2); library(patchwork)
# korzysta tylko z palety kol i motywu z przepisu 1

losuj_t <- function(n, sd, df = 5) rt(n, df) * sd / sqrt(df / (df - 2))
jedno_badanie <- function(N = 60, T = 240, L = 3, sd_efekt = 0, rho = 0, wspolny_dzien = FALSE) {
  beta <- runif(N, 0.6, 1.4); sigma <- runif(N, 0.012, 0.024)
  # wspólny dzień: jedna ścieżka indeksu i jeden czynnik branżowy f dla wszystkich spółek
  Rm <- if (wspolny_dzien) matrix(losuj_t(T + L, 0.01), T + L, N) else matrix(losuj_t((T + L) * N, 0.01), T + L)
  f  <- if (wspolny_dzien) matrix(rnorm(T + L), T + L, N) else matrix(rnorm((T + L) * N), T + L)
  u  <- matrix(losuj_t((T + L) * N, 1), T + L)
  e  <- (sqrt(rho) * f + sqrt(1 - rho) * u) * rep(sigma, each = T + L)
  R  <- Rm * rep(beta, each = T + L) + e
  dzien0 <- T + 2                                         # okno zdarzenia: T+1 … T+3, dzień 0 w środku
  R[dzien0, ] <- R[dzien0, ] + rnorm(N, 0, sd_efekt)       # efekt o średniej 0, ale różny w spółkach
  est <- 1:T; zd <- T + 1:L
  Mc <- Rm[est, ] - rep(colMeans(Rm[est, ]), each = T)     # odchylenia od średnich w oknie estymacji
  Rc <- R[est, ] - rep(colMeans(R[est, ]), each = T)
  b <- colSums(Mc * Rc) / colSums(Mc^2)
  a <- colMeans(R[est, ]) - b * colMeans(Rm[est, ])
  res <- Rc - Mc * rep(b, each = T)                          # reszty modelu rynkowego
  s <- sqrt(colSums(res^2) / (T - 2))
  AR <- R[zd, ] - Rm[zd, ] * rep(b, each = L) - rep(a, each = L)
  car <- colSums(AR); scar <- car / (s * sqrt(L))
  z_klas <- sum(scar) / sqrt(N)
  t_prz  <- mean(car) / (sd(car) / sqrt(N))
  t_bmp  <- mean(scar) / (sd(scar) / sqrt(N))
  r_sr   <- (sum(cor(res)) - N) / (N * (N - 1))             # średnia korelacja reszt z okna estymacji
  t_kp   <- t_bmp * sqrt((1 - r_sr) / (1 + (N - 1) * r_sr)) # poprawka Kolariego i Pynnönena
  c(klasyczny = 2 * pnorm(-abs(z_klas)) < .05, przekrojowy = 2 * pt(-abs(t_prz), N - 1) < .05,
    BMP = 2 * pt(-abs(t_bmp), N - 1) < .05, BMP_KP = 2 * pt(-abs(t_kp), N - 1) < .05)
}
reps <- 1000

# A. Wzrost zmienności w dniu ogłoszenia (rozproszone daty, reszty niezależne)
set.seed(6381)
sd_efektu <- c(0, 0.01, 0.02, 0.03)
symA <- do.call(rbind, lapply(sd_efektu, function(sdx) {
  w <- rowMeans(replicate(reps, jedno_badanie(sd_efekt = sdx)))
  data.frame(sd_efekt_pp = 100 * sdx, test = names(w)[1:3], odsetek = w[1:3])
}))
symA$blad_MC <- sqrt(symA$odsetek * (1 - symA$odsetek) / reps)
symA[, 3:4] <- round(100 * symA[, 3:4], 1); rownames(symA) <- NULL
symA

# B. Wspólny dzień zdarzenia i korelacja reszt spółek (np. jedna branża), bez wzrostu zmienności
set.seed(6382)
rhos <- c(0, 0.02, 0.05, 0.10)
symB <- do.call(rbind, lapply(rhos, function(r) do.call(rbind, lapply(c(FALSE, TRUE), function(wsp) {
  w <- rowMeans(replicate(reps, jedno_badanie(rho = r, wspolny_dzien = wsp)))
  data.frame(rho = r, daty = ifelse(wsp, "wspólny dzień", "daty rozproszone"),
             test = c("BMP", "BMP z poprawką KP"), odsetek = w[c("BMP", "BMP_KP")])
}))))
symB$blad_MC <- sqrt(symB$odsetek * (1 - symB$odsetek) / reps)
symB[, 4:5] <- round(100 * symB[, 4:5], 1); rownames(symB) <- NULL
symB

nazwyA <- c(klasyczny = "klasyczny (wariancja z okna estymacji)", przekrojowy = "t przekrojowy", BMP = "BMP")
p5a <- ggplot(symA, aes(sd_efekt_pp, odsetek, colour = test, shape = test, linetype = test)) +
  geom_hline(yintercept = 5, linetype = "22", colour = "grey40") +
  geom_errorbar(aes(ymin = odsetek - 1.96 * blad_MC, ymax = odsetek + 1.96 * blad_MC), width = 0, linetype = 1) +
  geom_line(linewidth = 0.9) + geom_point(size = 2.6) +
  scale_colour_manual(values = c(klasyczny = kol[["cynober"]], przekrojowy = kol[["niebieski"]], BMP = kol[["zielony"]]),
                      labels = nazwyA, name = NULL) +
  scale_shape_manual(values = c(klasyczny = 17, przekrojowy = 16, BMP = 15), labels = nazwyA, name = NULL) +
  scale_linetype_manual(values = c(klasyczny = 1, przekrojowy = 2, BMP = 1), labels = nazwyA, name = NULL) +
  scale_x_continuous(breaks = 100 * sd_efektu) +
  labs(title = "A. Ogłoszenie zwiększa zmienność", x = "SD efektu w dniu 0 między spółkami (pp)",
       y = "Fałszywe alarmy (% z 1000 badań)") +
  motyw + guides(colour = guide_legend(ncol = 1), shape = guide_legend(ncol = 1), linetype = guide_legend(ncol = 1))
symB$grupa <- paste(symB$test, "–", symB$daty)
p5b <- ggplot(symB, aes(rho, odsetek, colour = grupa, shape = grupa, linetype = grupa)) +
  geom_hline(yintercept = 5, linetype = "22", colour = "grey40") +
  geom_errorbar(aes(ymin = odsetek - 1.96 * blad_MC, ymax = odsetek + 1.96 * blad_MC), width = 0, linetype = 1) +
  geom_line(linewidth = 0.9) + geom_point(size = 2.6) +
  scale_colour_manual(values = c(kol[["zielony"]], kol[["cynober"]], kol[["grafit"]], kol[["niebieski"]]), name = NULL) +
  scale_shape_manual(values = c(15, 17, 1, 16), name = NULL) +
  scale_linetype_manual(values = c(1, 1, 3, 2), name = NULL) +
  scale_x_continuous(breaks = rhos) +
  labs(title = "B. Wspólny dzień i korelacja reszt", x = "Korelacja reszt między spółkami (ρ)",
       y = "Fałszywe alarmy (% z 1000 badań)") +
  motyw + guides(colour = guide_legend(ncol = 1))
p5 <- p5a + p5b
p5   # ggsave("event-study-symulacje-falszywe-alarmy.svg", p5, width = 10, height = 5.6)
Wynik w R
   sd_efekt_pp        test odsetek blad_MC
1            0   klasyczny     6.1     0.8
2            0 przekrojowy     5.3     0.7
3            0         BMP     5.5     0.7
4            1   klasyczny     6.3     0.8
5            1 przekrojowy     4.4     0.6
6            1         BMP     4.2     0.6
7            2   klasyczny    10.9     1.0
8            2 przekrojowy     5.0     0.7
9            2         BMP     5.1     0.7
10           3   klasyczny    14.8     1.1
11           3 przekrojowy     3.6     0.6
12           3         BMP     3.7     0.6
    rho             daty              test odsetek blad_MC
1  0.00 daty rozproszone               BMP     4.6     0.7
2  0.00 daty rozproszone BMP z poprawką KP     4.5     0.7
3  0.00    wspólny dzień               BMP     5.0     0.7
4  0.00    wspólny dzień BMP z poprawką KP     5.3     0.7
5  0.02 daty rozproszone               BMP     7.7     0.8
6  0.02 daty rozproszone BMP z poprawką KP     7.5     0.8
7  0.02    wspólny dzień               BMP    18.8     1.2
8  0.02    wspólny dzień BMP z poprawką KP     5.7     0.7
9  0.05 daty rozproszone               BMP     4.9     0.7
10 0.05 daty rozproszone BMP z poprawką KP     5.2     0.7
11 0.05    wspólny dzień               BMP    32.0     1.5
12 0.05    wspólny dzień BMP z poprawką KP     5.1     0.7
13 0.10 daty rozproszone               BMP     4.6     0.7
14 0.10 daty rozproszone BMP z poprawką KP     4.6     0.7
15 0.10    wspólny dzień               BMP    48.6     1.6
16 0.10    wspólny dzień BMP z poprawką KP     5.4     0.7
6. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober" = c("#0072B2", "#D55E00"), "zielony – cynober" = c("#009E73", "#D55E00"),
             "niebieski – zielony" = c("#0072B2", "#009E73"), "grafit – niebieski" = c("#262626", "#0072B2"),
             "szary – niebieski" = c("#999999", "#0072B2"), "grafit – zielony" = c("#262626", "#009E73"), "szary – cynober" = c("#999999", "#D55E00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
odl <- function(a, b) { x <- coords(as(hex2RGB(c(a, b)), "LAB")); sqrt(sum((x[1, ] - x[2, ])^2)) }
wynik <- t(sapply(pary, function(p) c(normalne = odl(p[1], p[2]),
                                      deuteranopia = odl(deutan(p[1]), deutan(p[2])),
                                      protanopia = odl(protan(p[1]), protan(p[2])))))
round(wynik, 1)   # ΔE w CIELAB; powyżej ok. 20 – barwy łatwo odróżnić
Wynik w R
                                 normalne deuteranopia protanopia
niebieski – cynober                 114.6        108.3       91.9
zielony – cynober                   102.4         53.5       37.3
niebieski – zielony                  70.1         55.4       58.0
grafit – niebieski                   51.7         53.3       51.3
szary – niebieski                    44.9         48.9       40.6
grafit – zielony                     63.8         41.7       49.0
szary – cynober                      77.2         62.9       56.0
czerwony – zielony (do unikania)    121.7         21.1       31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Model rynkowy, testy, bootstrap i symulacje zapisano w bazowym R (funkcje lm(), t.test(), replicate()). Rysunki wykonano w ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite; paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Jak policzyć nadwyżkową stopę zwrotu w event study?
Dla każdej spółki oszacuj model rynkowy w oknie estymacji (np. 240 sesji kończących się 11 sesji przed ogłoszeniem): regresję stopy zwrotu spółki na stopę zwrotu indeksu. Nadwyżkowa stopa zwrotu w dniu t to AR = R − (α̂ + β̂ · Rm), a CAR to suma AR w wybranym oknie, np. od dnia −1 do +1.
Jak długie powinno być okno estymacji i okno zdarzenia?
Okno estymacji to zwykle około roku sesji (np. 120–250 dni), zakończone kilka–kilkanaście sesji przed ogłoszeniem, żeby przeciek informacji nie trafił do parametrów modelu. Okno zdarzenia główne bywa krótkie, np. [−1, +1]; dłuższe okna przed ogłoszeniem i po nim traktuj jako dodatkowe. Wszystkie okna ustal przed obejrzeniem wyników.
Jakim testem sprawdzić, czy średni CAR różni się od zera?
Najprościej przekrojowym testem t dla jednej próby na CAR spółek albo testem Boehmera, Musumeciego i Poulsena (BMP), który najpierw standaryzuje CAR każdej spółki. Oba biorą wariancję z rozrzutu wyników między spółkami, więc są odporne na wzrost zmienności wywołany zdarzeniem. Test z wariancją z okna estymacji daje wtedy za dużo fałszywych alarmów – w symulacji do 14.8% zamiast 5%.
Co zrobić, gdy wiele spółek ma ten sam dzień zdarzenia?
Wtedy nadwyżkowe stopy zwrotu spółek są skorelowane i zwykłe testy zbyt często odrzucają hipotezę zerową – w symulacji przy korelacji .05 test BMP dał 32.0% fałszywych alarmów. Użyj poprawki uwzględniającej średnią korelację reszt (Kolari i Pynnönen, 2010) albo analizuj spółki jako jeden portfel.
Czy brak istotnego CAR przed ogłoszeniem oznacza brak przecieku informacji?
Nie. Mały przeciek, rzędu 0.1 pp dziennie, łatwo ginie w szumie dziennych stóp zwrotu. W przykładzie przeciek o łącznej wielkości 0.48 pp był w danych, a test dla okna [−5, −2] dał p = .940. Brak istotności oznacza tylko, że dane nie pozwalają go wykryć.
Powiązane hasła
Przeczytaj też
Statystyka w pracy z finansów i rachunkowości
Ankieta wśród przedsiębiorców, skośne wskaźniki i winsoryzacja, regresja z błędami odpornymi, dane panelowe i model upadłości – z gotowymi zdaniami APA i kodem R.
Czytaj →PoradnikMonte Carlo NPV – opłacalność projektu
Linia produkcyjna w mleczarni: NPV, rozkłady założeń, 10 000 symulacji, P(NPV < 0), tornado i korelacja ceny z popytem – sześć rysunków z kodem R.
Czytaj →PoradnikJak napisać pracę z finansów i rachunkowości
Teoria i kierunek związku, dobór spółek i przetrwanie, wzory wskaźników, winsoryzacja, model panelowy, skala wyniku w złotych – z przykładami do poprawienia.
Czytaj →Robisz badanie zdarzeń w pracy z finansów?
Pomożemy dobrać okna i model rynkowy, policzyć AR i CAR, wybrać test odporny na wzrost zmienności i nakładanie się zdarzeń oraz opisać wyniki z tabelą i rysunkami – tak, żebyś umiał(a) je wyjaśnić na obronie.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Corrado, C. J. (2011). Event studies: A methodology review. Accounting & Finance, 51(1), 207–234. https://doi.org/10.1111/j.1467-629x.2010.00375.x ● Otwarty dostęp: pełny tekst
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552 ● Otwarty dostęp
- Fama, E. F., Fisher, L., Jensen, M. C., & Roll, R. (1969). The adjustment of stock prices to new information. International Economic Review, 10(1), 1–21. https://doi.org/10.2307/2525569 ● Otwarty dostęp: pełny tekst
- Gow, I. D., Ormazabal, G., & Taylor, D. J. (2010). Correcting for cross-sectional and time-series dependence in accounting research. The Accounting Review, 85(2), 483–512. https://doi.org/10.2308/accr.2010.85.2.483 ● Otwarty dostęp: pełny tekst
- Harrington, S. E., & Shrider, D. G. (2007). All events induce variance: Analyzing abnormal returns when effects vary across firms. Journal of Financial and Quantitative Analysis, 42(1), 229–256. https://doi.org/10.1017/s002210900000226x ● Otwarty dostęp: pełny tekst
- Kolari, J. W., & Pynnönen, S. (2010). Event study testing with cross-sectional correlation of abnormal returns. Review of Financial Studies, 23(11), 3996–4025. https://doi.org/10.1093/rfs/hhq072
Cytowania BibTeX
@article{corrado2011event, author={Corrado, Charles J.}, title={{Event studies: A methodology review}}, journal={Accounting \& Finance}, year={2011}, volume={51}, number={1}, pages={207--234}, doi={10.1111/j.1467-629x.2010.00375.x}}@article{efron1979bootstrap, author={Efron, Bradley}, title={{Bootstrap methods: Another look at the jackknife}}, journal={The Annals of Statistics}, year={1979}, volume={7}, number={1}, pages={1--26}, doi={10.1214/aos/1176344552}}@article{fama1969adjustment, author={Fama, Eugene F. and Fisher, Lawrence and Jensen, Michael C. and Roll, Richard}, title={{The adjustment of stock prices to new information}}, journal={International Economic Review}, year={1969}, volume={10}, number={1}, pages={1--21}, doi={10.2307/2525569}}@article{gow2010correcting, author={Gow, Ian D. and Ormazabal, Gaizka and Taylor, Daniel J.}, title={{Correcting for cross-sectional and time-series dependence in accounting research}}, journal={The Accounting Review}, year={2010}, volume={85}, number={2}, pages={483--512}, doi={10.2308/accr.2010.85.2.483}}@article{harrington2007all, author={Harrington, Scott E. and Shrider, David G.}, title={{All events induce variance: Analyzing abnormal returns when effects vary across firms}}, journal={Journal of Financial and Quantitative Analysis}, year={2007}, volume={42}, number={1}, pages={229--256}, doi={10.1017/s002210900000226x}}@article{kolari2010event, author={Kolari, James W. and Pynnönen, Seppo}, title={{Event study testing with cross-sectional correlation of abnormal returns}}, journal={Review of Financial Studies}, year={2010}, volume={23}, number={11}, pages={3996--4025}, doi={10.1093/rfs/hhq072}}