Co to jest badanie zdarzeń?
Badanie zdarzeń (ang. event study) w analizie danych panelowych to model, w którym zamiast jednego efektu programu szacujesz osobny współczynnik dla każdego okresu względem zdarzenia: kilka okresów przed nim (ang. leads) i kilka po nim (ang. lags). Jest to rozwinięcie różnicy w różnicach, zwykle w postaci regresji z efektami stałymi jednostek i okresów. Jeden okres, najczęściej ostatni przed zdarzeniem, jest punktem odniesienia. W finansach ta sama nazwa oznacza też analizę nadzwyczajnych stóp zwrotu wokół ogłoszenia informacji – to inny schemat.
Co odczytać z wykresu
- Współczynniki przed zdarzeniem bliskie zera wspierają założenie równoległych trendów.
- Współczynniki po zdarzeniu pokazują, czy efekt pojawia się od razu, narasta czy wygasa.
- Błędy standardowe licz odporne na klastrowanie po jednostkach.
Pułapki
Roth (2022) pokazuje, że testy trendów wstępnych mogą mieć niską moc, a uzależnianie analizy od ich wyniku może zwiększać obciążenie i zaniżać pokrycie przedziałów ufności. Brak istotnych różnic przed zdarzeniem nie dowodzi więc równoległych trendów. Sun i Abraham (2021) wykazali, że przy różnych momentach wprowadzenia programu współczynnik danego okresu w zwykłej regresji z efektami stałymi może być „zanieczyszczony” efektami z innych okresów, a pozorne trendy wstępne mogą wynikać wyłącznie z niejednorodności efektów; proponują estymator wolny od tego problemu. Freyaldenhoven i in. (2019) opisują sytuację, w której trendy wstępne wynikają z niemierzonych czynników zakłócających, i proponują identyfikację przez zmienne powiązane z programem tylko przez te czynniki.
Przykład
W symulacji 40 szkół przez 10 okresów program wprowadzono w 20 szkołach w okresie 6. Współczynniki przed programem wyniosły od −0.96 do −0.17 (SE 0.60–0.80), a łączny test Walda dał χ²(4) = 2.86, p = .582. Po programie współczynniki rosły od 1.57 w okresie wprowadzenia do 3.94 i 3.44 w dwóch ostatnich okresach (prawdziwy efekt: od 2.0 do 4.0 punktu). Podobną logikę ma przerwany szereg czasowy, ale bez grupy porównawczej.
Błędy standardowe zależą od korekty małej próby: sandwich::vcovCL() wlicza do niej wszystkie efekty stałe, a fixest::feols() z domyślną korektą daje przy tych samych współczynnikach nieco mniejsze SE (0.57–0.79).
Na rysunku
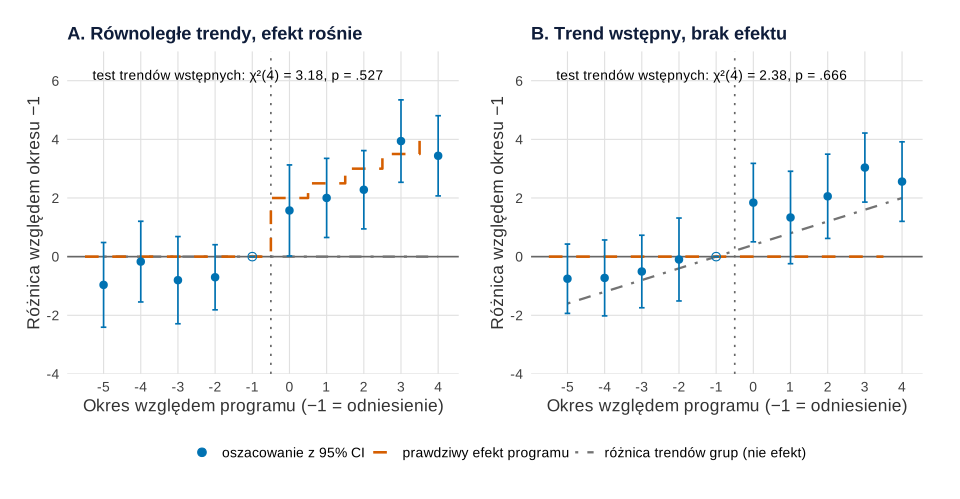
set.seed(58301); B – set.seed(58302)).Co widać. Panel A to dane z przykładu oszacowane funkcją fixest::feols(): współczynniki są te same (od −0.96 do −0.17 przed programem, od 1.57 do 3.94 po nim), a błędy standardowe – z domyślną korektą fixest – wynoszą 0.57–0.79, więc łączny test trendów wstępnych daje tu χ²(4) = 3.18, p = .527 (w przykładzie z vcovCL(): p = .582). Schodki prawdziwego efektu mieszczą się w przedziałach. Panel B ma ten sam układ 40 szkół, ale program nie działa: szkoły, które go wprowadziły, po prostu rosną szybciej o 0.4 punktu na okres. Współczynniki po programie (od 1.34 do 3.04) wyglądają jak efekt, a w rzeczywistości podążają za linią różnicy trendów. Test trendów wstępnych tego nie wykrył: χ²(4) = 2.38, p = .666 – to przykład niskiej mocy, o której pisze Roth (2022). Ogólnie o mocy przy małych efektach – wpis Moc testu w obrazkach.
Na co uważać. Okres −1 ma z definicji wartość 0 i nie ma przedziału; wszystkie punkty są różnicami względem niego, więc inny okres odniesienia przesuwa cały wykres. Przedziały są punktowe – pasmo obejmujące wszystkie okresy naraz byłoby szersze. Rysunek dotyczy jednego momentu wprowadzenia programu; przy wprowadzeniu rozłożonym w czasie współczynniki zwykłej regresji z efektami stałymi mogą mieszać efekty różnych okresów (Sun i Abraham, 2021). Panel B to jedna realizacja danych – wynik testu nie zastąpi sprawdzenia, czy punkty przed programem układają się w linię.
Podpis do pracy:
Kod rysunku ma osobne ziarno dla każdego panelu: set.seed(58301) (te same dane co w przykładzie) i set.seed(58302) (panel B); ziaren nie zmieniano. Różnicę trendów w panelu B (0.4 punktu na okres) ustalono ręcznie tak, by w ostatnim okresie (2 punkty) dorównywała efektowi z panelu A w okresie wprowadzenia programu. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Wykres badania zdarzeń: współczynniki okresów względem programu z 95% CI, bez trendu wstępnego (A) i z nim (B); dane symulowane
suppressPackageStartupMessages({library(ggplot2); library(patchwork); library(fixest)})
kol <- c(oszac = "#0072B2", prawda = "#D55E00", trend = "grey45")   # Okabe–Ito + szary
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), legend.position = "bottom")
panel <- function(ziarno, efekt_po, trend_wstepny) {   # 40 szkół × 10 okresów, program od okresu 6 w 20 szkołach
  set.seed(ziarno)
  szk <- 40; okresy <- 1:10; start <- 6
  d <- expand.grid(szkola = 1:szk, okres = okresy)
  d$program <- as.integer(d$szkola <= 20)
  d$wzgl <- ifelse(d$program == 1, d$okres - start, -1)        # szkoły bez programu w okresie odniesienia (−1)
  efekt <- ifelse(d$program == 1 & d$wzgl >= 0, efekt_po(d$wzgl), 0)
  d$y <- 50 + rnorm(szk)[d$szkola] + 0.3 * d$okres + efekt + rnorm(nrow(d), sd = 1.5) +
         trend_wstepny * d$program * (d$okres - start)        # własny trend szkół z programem
  m <- feols(y ~ i(wzgl, ref = -1) | szkola + okres, data = d, cluster = ~ szkola)
  b <- coef(m); V <- vcov(m); k <- as.numeric(sub("wzgl::", "", names(b)))
  pre <- which(k < -1)
  chi2 <- drop(t(b[pre]) %*% solve(V[pre, pre]) %*% b[pre])   # łączny test Walda dla okresów przed programem
  wsp <- data.frame(k = c(k, -1), b = c(b, 0), se = c(sqrt(diag(V)), 0))
  list(wsp = wsp[order(wsp$k), ], chi2 = chi2, p = pchisq(chi2, length(pre), lower.tail = FALSE))
}
A <- panel(58301, function(k) 2 + 0.5 * k, trend_wstepny = 0)    # dane z przykładu: efekt 2 rosnący o 0.5
B <- panel(58302, function(k) 0 * k, trend_wstepny = 0.4)        # brak efektu, szkoły z programem rosną szybciej o 0.4
round(cbind(A_b = A$wsp$b, A_se = A$wsp$se, B_b = B$wsp$b, B_se = B$wsp$se), 2)
round(c(A_chi2 = A$chi2, A_p = A$p, B_chi2 = B$chi2, B_p = B$p), 3)
etykiety <- c("oszacowanie z 95% CI", "prawdziwy efekt programu", "różnica trendów grup (nie efekt)")
rysuj <- function(x, prawda, tytul, trend) {
  w <- x$wsp
  pr <- data.frame(k = -5:4, b = prawda)
  ggplot(w, aes(k, b)) +
    geom_hline(yintercept = 0, colour = "grey40") +
    geom_line(data = data.frame(k = -5:4, b = trend), linewidth = 0.8,
              aes(colour = "różnica trendów grup (nie efekt)", linetype = "różnica trendów grup (nie efekt)")) +
    geom_vline(xintercept = -0.5, colour = "grey40", linetype = "dotted") +
    geom_step(data = transform(pr, k = k - 0.5), aes(colour = "prawdziwy efekt programu", linetype = "prawdziwy efekt programu"),
              direction = "hv", linewidth = 0.9) +
    geom_errorbar(aes(ymin = b - 1.96 * se, ymax = b + 1.96 * se), width = 0.15, colour = kol[["oszac"]]) +
    geom_point(aes(colour = "oszacowanie z 95% CI", shape = k == -1), size = 2.6) +
    scale_shape_manual(values = c(16, 1), guide = "none") +
    scale_colour_manual(values = c("oszacowanie z 95% CI" = kol[["oszac"]], "prawdziwy efekt programu" = kol[["prawda"]],
                                   "różnica trendów grup (nie efekt)" = kol[["trend"]]), limits = etykiety) +
    scale_linetype_manual(values = c("oszacowanie z 95% CI" = "blank", "prawdziwy efekt programu" = "dashed",
                                     "różnica trendów grup (nie efekt)" = "dotdash"), limits = etykiety) +
    scale_x_continuous(breaks = -5:4) + coord_cartesian(ylim = c(-3.5, 6.5)) +
    annotate("text", x = -5.3, y = 6.2, hjust = 0, size = 3.6,
             label = sprintf("test trendów wstępnych: χ²(4) = %.2f, p %s", x$chi2,
                             ifelse(x$p < .001, "< .001", sub("^0", "= ", sprintf("%.3f", x$p))))) +
    labs(title = tytul, x = "Okres względem programu (−1 = odniesienie)", y = "Różnica względem okresu −1",
         colour = NULL, linetype = NULL)
}
p1 <- (rysuj(A, c(rep(0, 5), 2 + 0.5 * 0:4), "A. Równoległe trendy, efekt rośnie", trend = rep(0, 10)) +
       rysuj(B, rep(0, 10), "B. Trend wstępny, brak efektu", trend = 0.4 * (-5:4 + 1))) +
      plot_layout(guides = "collect") & motyw
p1
Wynik w R
        A_b A_se   B_b B_se
 [1,] -0.96 0.74 -0.75 0.60
 [2,] -0.17 0.70 -0.73 0.66
 [3,] -0.80 0.76 -0.51 0.63
 [4,] -0.70 0.57 -0.10 0.72
 [5,]  0.00 0.00  0.00 0.00
 [6,]  1.57 0.79  1.84 0.68
 [7,]  2.00 0.69  1.34 0.80
 [8,]  2.28 0.68  2.06 0.73
 [9,]  3.94 0.72  3.04 0.60
[10,]  3.44 0.70  2.56 0.69
A_chi2    A_p B_chi2    B_p
 3.184  0.527  2.382  0.666
Jak opisać w pracy
Badanie zdarzeń w R
Kod tworzy zmienne zerojedynkowe dla okresów względem wprowadzenia programu (okres −1 jako odniesienie), szacuje regresję z efektami stałymi szkół i okresów, liczy błędy standardowe odporne na klastrowanie (sandwich::vcovCL) i łączny test Walda dla okresów przed programem.
Współczynniki okresów względnych i test trendów wstępnych
R
# Badanie zdarzeń: współczynniki dla okresów względem wprowadzenia programu (dane symulowane)
suppressPackageStartupMessages({library(sandwich); library(lmtest)})
set.seed(58301)
szk <- 40; okresy <- 1:10; start <- 6                 # program od okresu 6 w 20 szkołach
d <- expand.grid(szkola = 1:szk, okres = okresy)
d$program <- as.integer(d$szkola <= 20)
d$wzgl <- ifelse(d$program == 1, d$okres - start, NA)  # czas względem zdarzenia: -5 ... 4
efekt <- ifelse(!is.na(d$wzgl) & d$wzgl >= 0, 2 + 0.5 * d$wzgl, 0)   # efekt rośnie w czasie
d$y <- 50 + rnorm(szk)[d$szkola] + 0.3 * d$okres + efekt + rnorm(nrow(d), sd = 1.5)
# zmienne zerojedynkowe dla okresów względnych; okres -1 jest punktem odniesienia
for (k in setdiff(-5:4, -1)) d[[paste0("k", ifelse(k < 0, paste0("m", -k), k))]] <-
  as.integer(!is.na(d$wzgl) & d$wzgl == k)
f <- reformulate(c(grep("^k", names(d), value = TRUE), "factor(szkola)", "factor(okres)"), "y")
m <- lm(f, data = d)
V <- vcovCL(m, cluster = ~ szkola)
wsp <- coeftest(m, vcov = V)[grep("^k", names(coef(m))), 1:2]
round(wsp, 2)
# łączny test Walda: czy współczynniki przed programem (km5–km2) są równe zero
pre <- c("km5", "km4", "km3", "km2")
chi2 <- drop(t(coef(m)[pre]) %*% solve(V[pre, pre]) %*% coef(m)[pre])
round(c(chi2 = chi2, df = 4, p = pchisq(chi2, 4, lower.tail = FALSE)), 3)
Wynik w R
    Estimate Std. Error
km5    -0.96       0.78
km4    -0.17       0.74
km3    -0.80       0.80
km2    -0.70       0.60
k0      1.57       0.84
k1      2.00       0.73
k2      2.28       0.72
k3      3.94       0.76
k4      3.44       0.74
 chi2    df     p
2.858 4.000 0.582
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietami sandwich 3.1.1 i lmtest 0.9.40 (rysunek 1 – pakiety fixest, ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- lmtest (wersja 0.9.40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- fixest (wersja 0.14.2): Bergé, L. R., Butts, K., & McDermott, G. (2026). Fast and user-friendly econometrics estimations: The R package fixest. arXiv preprint arXiv:2601.21749. https://doi.org/10.48550/arXiv.2601.21749
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Który okres wybrać jako odniesienie w badaniu zdarzeń?
Najczęściej ostatni okres przed zdarzeniem (−1). Wszystkie współczynniki są wtedy różnicami względem tego okresu, więc wybór odniesienia trzeba podać w opisie i podpisie wykresu.
Czy nieistotne współczynniki przed zdarzeniem potwierdzają równoległe trendy?
Nie. Test może mieć zbyt małą moc, by wykryć realne różnice, a wybieranie analizy na podstawie jego wyniku zniekształca wnioskowanie. Pokaż oszacowania z przedziałami ufności i rozważ analizę wrażliwości.
Co zmienia rozłożone w czasie wprowadzenie programu?
Gdy jednostki zaczynają program w różnych okresach, a efekt różni się między nimi, zwykła regresja z efektami stałymi miesza efekty z różnych okresów. Wtedy stosuje się estymatory dla zróżnicowanego momentu wprowadzenia.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Quasi-eksperyment i różnica w różnicach (DiD)
Ocena programu bez losowania: równoległe trendy, regresja z interakcją, błędy klastrowane, model zdarzeń, test placebo, zagrożenia trafności i kod R.
Czytaj →PoradnikDane panelowe: FE, RE i test Hausmana
Pooled OLS, efekty stałe i losowe, test Hausmana liczony ręcznie, błędy klastrowane CR2, efekty czasu, model within–between i przykład w R.
Czytaj →PoradnikBadanie zdarzeń (event study)
60 fikcyjnych ogłoszeń skupu akcji: model rynkowy, AR i CAR z przedziałami, testy t, BMP i bootstrap oraz fałszywe alarmy przy wspólnej dacie zdarzenia.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Freyaldenhoven, S., Hansen, C., & Shapiro, J. M. (2019). Pre-event trends in the panel event-study design. American Economic Review, 109(9), 3307–3338. https://doi.org/10.1257/aer.20180609 ● Otwarty dostęp: pełny tekst
- Roth, J. (2022). Pretest with caution: Event-study estimates after testing for parallel trends. American Economic Review: Insights, 4(3), 305–322. https://doi.org/10.1257/aeri.20210236
- Sun, L., & Abraham, S. (2021). Estimating dynamic treatment effects in event studies with heterogeneous treatment effects. Journal of Econometrics, 225(2), 175–199. https://doi.org/10.1016/j.jeconom.2020.09.006 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{freyaldenhoven2019pre, author={Freyaldenhoven, Simon and Hansen, Christian and Shapiro, Jesse M.}, title={{Pre-event trends in the panel event-study design}}, journal={American Economic Review}, year={2019}, volume={109}, number={9}, pages={3307--3338}, doi={10.1257/aer.20180609}}@article{roth2022pretest, author={Roth, Jonathan}, title={{Pretest with caution: Event-study estimates after testing for parallel trends}}, journal={American Economic Review: Insights}, year={2022}, volume={4}, number={3}, pages={305--322}, doi={10.1257/aeri.20210236}}@article{sun2021estimating, author={Sun, Liyang and Abraham, Sarah}, title={{Estimating dynamic treatment effects in event studies with heterogeneous treatment effects}}, journal={Journal of Econometrics}, year={2021}, volume={225}, number={2}, pages={175--199}, doi={10.1016/j.jeconom.2020.09.006}}