Czym są dane panelowe
Dane panelowe to wielokrotne pomiary tych samych jednostek w kolejnych okresach: firm w kolejnych latach, gmin w kolejnych kwartałach, osób w kolejnych falach badania. Mają dwa wymiary: N jednostek i T okresów. W analizie zapisujesz je w formacie długim, w którym jeden wiersz to para jednostka–okres. Panel jest zbilansowany, gdy każdą jednostkę obserwujesz w każdym okresie. Gdy części pomiarów brakuje, jest niezbilansowany. To częste w danych firmowych i badaniach podłużnych.
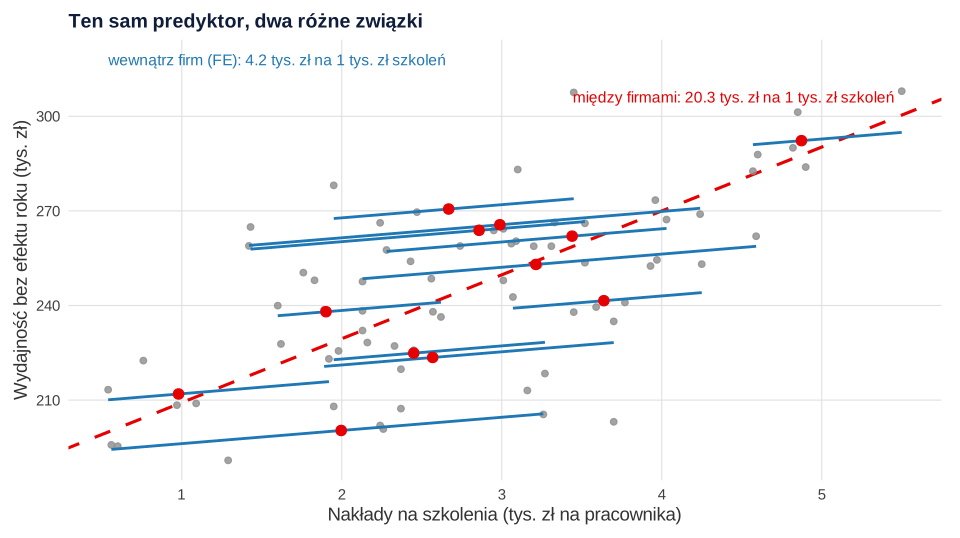
Najważniejsza cecha panelu to dwa źródła zmienności każdej zmiennej. Zmienność między jednostkami (ang. between) to różnice średnich: jedne firmy przez cały okres szkolą więcej niż inne. Zmienność wewnątrz jednostek (ang. within) to wahania wokół własnej średniej: ta sama firma w jednym roku szkoli więcej, w innym mniej. Związek z wynikiem może mieć w obu wymiarach inną siłę. Curran i Bauer (2011) pokazują, że ta możliwość rozdzielenia efektów jest w badaniach podłużnych często niewykorzystywana. Wybór między pooled OLS, efektami stałymi i losowymi to pytanie, którą z tych zmienności model wykorzystuje.
Ogólne tło opisuje hasło ekonometria (zob. też statystyka w pracy z zarządzania i ekonomii), a standardowy wykład tych modeli to podręcznik Wooldridge’a (2010).
Przykład: szkolenia i wydajność 150 firm
Obserwujemy 150 firm przez 6 lat (2019–2024), razem 900 obserwacji firma–rok. Pytanie brzmi: czy firma, która zwiększa nakłady na szkolenia, osiąga wyższą wydajność pracy? Wynikiem jest przychód na pracownika (tys. zł), predyktorem nakłady na szkolenia (tys. zł na pracownika), a zmienną stałą w czasie branża (produkcja lub usługi). Dane są symulowane (set.seed(2301)) i możesz je pobrać jako plik CSV. W symulacji nieobserwowana jakość zarządzania podnosi jednocześnie nakłady na szkolenia i wydajność. Taki czynnik zakłócający stały w czasie to typowa sytuacja w danych firmowych. Prawdziwy efekt szkoleń wewnątrz firm wynosi 4 tys. zł na każdy 1 tys. zł nakładów.
Odchylenie standardowe nakładów na szkolenia wynosi 0.96 tys. zł. Na zmienność między firmami przypada SD = 0.76, a na wahania wewnątrz firm SD = 0.59.
Pooled OLS: dlaczego zwykła regresja miesza dwa efekty
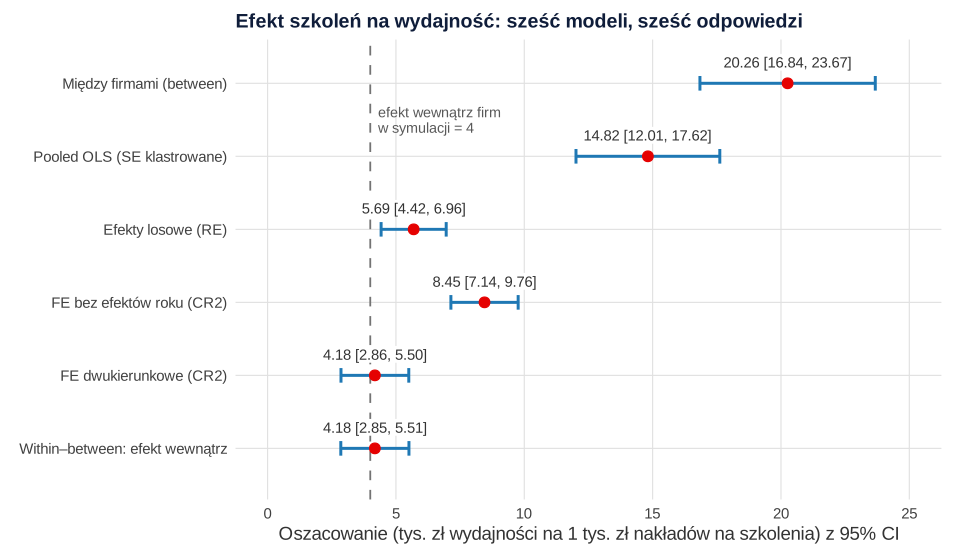
Najprostsze podejście to regresja wieloraka na wszystkich 900 wierszach, tak jakby były niezależnymi obserwacjami (ang. pooled OLS). Daje ona średnią ważoną efektu wewnątrz i między firmami. W przykładzie wynik to 14.82 tys. zł, ponad trzy razy więcej niż prawdziwy efekt wewnątrz firm. Estymator między firmami, czyli regresja na 150 średnich firm, daje aż 20.26 tys. zł. Lepiej zarządzane firmy szkolą więcej i są wydajniejsze, a pooled OLS przypisuje tę różnicę szkoleniom.
Drugi problem dotyczy błędów standardowych. Klasyczny błąd standardowy nachylenia wynosi 0.73, a odporny na klastrowanie po firmach – 1.43, czyli prawie dwa razy więcej. Sześć obserwacji tej samej firmy nie wnosi sześciu niezależnych informacji.
Efekty stałe (FE): porównanie firmy z samą sobą
Model z efektami stałymi (ang. fixed effects, FE) daje każdej firmie własny wyraz wolny αi. Usuwa w ten sposób wszystkie cechy firmy stałe w czasie, zarówno zmierzone, jak i niezmierzone. Ten sam wynik daje transformacja within: od każdej zmiennej odejmujesz średnią firmy i liczysz regresję na odchyleniach. Szczegóły estymatora opisuje hasło estymator efektów stałych w danych panelowych.
W R wystarczy lm() z czynnikiem firmy, czyli 150 zmiennymi zero-jedynkowymi (zob. dummy coding). Oba sposoby dały w przykładzie β = 4.18. Uwaga na pułapkę: ręczna regresja na odchyleniach nie wie, że odjęcie średnich zużyło 150 stopni swobody. Jej błąd standardowy (0.62) jest za mały i dopiero po poprawce df zgadza się z modelem z czynnikiem firmy (0.68).
Ceną FE jest utrata informacji między firmami. Model nie oszacuje efektu branży ani innej zmiennej stałej w czasie, a predyktor zmieniający się w firmach niewiele oszacuje nieprecyzyjnie. FE odpowiada tylko na pytanie, co się dzieje, gdy ta sama firma zmienia nakłady.
Efekty losowe (RE): więcej informacji, mocniejsze założenie
Model z efektami losowymi (ang. random effects, RE) traktuje αi jak losowanie z rozkładu normalnego. To ten sam model wielopoziomowy z losowym wyrazem wolnym, który znasz z psychologii (zob. efekty stałe i losowe; uwaga na różnicę nazw w obu tradycjach). Dopasowujemy go funkcją lmer() z pakietu lme4 (Bates i in., 2015). RE odejmuje od zmiennych tylko część średniej firmy, θ = 1 − √[σ²ε / (σ²ε + Tσ²α)]. W przykładzie SD efektów firm wynosi 18.73, SD reszt 10.86, ICC = .75, a θ = .77. Oszacowanie RE (5.69 tys. zł) leży więc bliżej FE niż pooled OLS, ale nadal korzysta z części zmienności między firmami.
Kluczowe założenie RE brzmi: efekt firmy nie jest skorelowany z predyktorami. Gdy jest spełnione, RE jest efektywniejszy od FE i pozwala oszacować efekty zmiennych stałych w czasie. Gdy nie jest, a tak jest w przykładzie, oszacowanie RE jest obciążone (Wooldridge, 2010). Bell i Jones (2015) zauważają, że to obciążenie to zwykły błąd pominiętej zmiennej.
Test Hausmana krok po kroku
Test Hausmana (1978) porównuje dwa estymatory. Pierwszy jest zgodny zawsze, ale mniej efektywny (FE). Drugi jest efektywny, ale zgodny tylko przy prawdziwej H0 (RE). Hausman wykorzystał fakt, że przy prawdziwej H0 estymator efektywny nie jest skorelowany z różnicą obu estymatorów. Wariancja tej różnicy upraszcza się więc do różnicy wariancji. Krótką definicję znajdziesz w haśle test Hausmana.
Porównujesz tylko współczynniki zmiennych zmieniających się w czasie. Efektów zmiennych stałych FE nie szacuje. W przykładzie porównujemy jeden współczynnik, więc wzór macierzowy upraszcza się do ilorazu:
| Element | Wartość |
|---|---|
| bFE (SE) | 4.179 (0.677) |
| bRE (SE) | 5.690 (0.647) |
| Różnica | −1.511 |
| Var(bFE) − Var(bRE) | 0.677² − 0.647² = 0.040 |
| H = różnica² / różnica wariancji | χ²(1) = 56.52, p < .001 |
Funkcja hausman() z przepisu w R, liczona wzorem macierzowym, daje tę samą wartość. Hipotezę o braku korelacji efektu firmy ze szkoleniami odrzucamy, więc RE w tej postaci daje obciążony wynik. Pakiet plm (tu niezainstalowany) liczy RE inną metodą estymacji wariancji niż REML w lme4, więc jego H może się nieco różnić.
Klasyczna wersja testu ma dwie słabości. Po pierwsze, zakłada, że RE jest w pełni efektywny, czyli że reszty są homoskedastyczne i nieskorelowane w czasie. Przy danych panelowych rzadko tak jest, a wtedy rozkład χ² nie obowiązuje. Po drugie, różnica macierzy wariancji w próbie bywa nieodwracalna albo ujemna, co daje ujemne H. Oba problemy rozwiązuje regresyjna wersja testu z błędami odpornymi na klastrowanie (Wooldridge, 2010), którą pokazujemy w części o modelu Mundlaka.
Test nie rozstrzyga też sam wyboru modelu. Clark i Linzer (2015) pokazali w symulacjach, że to, który model popełnia mniejszy łączny błąd, zależy od cech danych. Nieistotny wynik w małym panelu może wynikać z małej mocy testu.
Błędy standardowe odporne na klastrowanie
Efekt firmy to nie jedyne źródło zależności. Reszty tej samej firmy bywają skorelowane w kolejnych latach (autokorelacja reszt), a ich wariancja różni się między firmami. Cameron i Miller (2015) piszą, że domyślne błędy standardowe w danych pogrupowanych mogą znacznie zawyżać precyzję. Przy dużej liczbie klastrów zalecają błędy odporne na klastrowanie, uogólnienie odpornych błędów HC. Klastrem jest jednostka panelu.
| Estymator wariancji (model FE) | SE | Uwagi |
|---|---|---|
| Klasyczny | 0.677 | zakłada niezależne reszty |
CR1, vcovCL na modelu z czynnikiem firmy | 0.737 | poprawka liczy 150 zmiennych firm jako parametry |
CR1, vcovCL na modelu within | 0.673 | poprawka tylko dla właściwych parametrów |
| CR2 z df Satterthwaite’a (clubSandwich) | 0.674 | df = 109.7 |
W FE z efektami roku różnice są tu niewielkie, bo efekt firmy zabrał większość zależności między latami. W pooled OLS różnica była prawie dwukrotna. Tabela pokazuje też pułapkę techniczną: CR1 z poprawką małej próby liczoną na modelu ze 150 zmiennymi firm zawyża SE. Pustejovsky i Tipton (2018) pokazali, że przy małej liczbie klastrów zwykłe testy odporne na klastrowanie zbyt często odrzucają H0. Zaproponowali poprawkę CR2 z przybliżeniem Satterthwaite’a dla modeli z efektami stałymi, dostępną w pakiecie clubSandwich. Przy kilkudziesięciu jednostkach lub mniej wybieraj CR2.
Efekty czasu: model dwukierunkowy
Wszystkie firmy przeszły przez ten sam rok 2020 i to samo późniejsze ożywienie. Jeśli nakłady na szkolenia też rosły z roku na rok, model bez efektów czasu przypisze szkoleniom wspólny trend. W przykładzie FE bez efektów roku daje 8.45 tys. zł, a FE z efektami firm i lat (model dwukierunkowy, ang. two-way FE) 4.18 tys. zł. Efekty lat są łącznie istotne, F(5, 744) = 62.96, p < .001. Względem roku 2019 wynoszą od −13.31 tys. zł (2020) do 7.68 tys. zł (2024).
Zmienne zero-jedynkowe lat dodawaj domyślnie, gdy okresów jest niewiele. Model dwukierunkowy to też podstawa metody różnicy w różnicach. Jej założenia i pułapki opisujemy we wpisie quasi-eksperyment i różnica w różnicach.
Model Mundlaka i within–between
Mundlak (1978) zaproponował dodanie do modelu RE średniej predyktora w jednostce. Bell i Jones (2015) wykazali, że takie sformułowanie usuwa obciążenie RE. Model z efektami losowymi daje wtedy wszystko, co FE, a do tego zmienne stałe w czasie, losowe nachylenia i interakcje międzypoziomowe. Wariant najłatwiejszy w interpretacji to model within–between (REWB). Predyktor rozkładasz na odchylenie od średniej firmy i średnią firmy. To ten sam zabieg, który w modelach wielopoziomowych nazywa się centrowaniem względem średniej grupy. Opisujemy go we wpisie model wielopoziomowy krok po kroku.
| Model within–between (REML) | b (SE) | 95% CI |
|---|---|---|
| Szkolenia – odchylenie od średniej firmy (wewnątrz) | 4.18 (0.68) | [2.85, 5.51] |
| Szkolenia – średnia firmy (między) | 20.26 (1.74) | [16.84, 23.68] |
| Branża: produkcja a usługi | 11.45 (2.67) | [6.22, 16.67] |
Efekt wewnątrz jest identyczny z FE, a efekt między – z regresją na średnich firm. W tym samym modelu oszacowaliśmy też efekt branży, którego FE nie daje. W wersji Mundlaka (surowa zmienna i średnia firmy) współczynnik średniej to różnica efektów między i wewnątrz: 20.26 − 4.18 = 16.08. Hasło efekt kontekstowy wyjaśnia, jak go interpretować. Test Walda, że ta różnica wynosi zero, odpowiada testowi Hausmana: χ²(1) = 73.95, p < .001 (zob. test Walda). Wartość różni się od H = 56.52, bo oba testy są równoważne asymptotycznie, a nie liczbowo. Odporna wersja, czyli pooled OLS ze średnią firmy i błędami CR2, daje F(1, 102.5) = 67.51, p < .001.
Bell i in. (2019) zalecają model within–between jako punkt wyjścia w analizach wielopoziomowych, także podłużnych. W ich symulacjach pominięcie losowych nachyleń dawało zbyt małe błędy standardowe. Gdy pytasz o trajektorie zmian, a nie o związek dwóch zmiennych zmieniających się w czasie, zajrzyj do wpisu modele wzrostu w lme4. Które zmienne kontrolować, pomogą ustalić grafy przyczynowe (DAG).
Jak opisać analizę panelową
W metodzie podaj strukturę panelu (N, T, zbilansowanie), model główny, efekty czasu, sposób liczenia błędów standardowych i liczbę klastrów. Przy wyborze FE albo RE dołącz test Hausmana albo jego odporną wersję. Gdy ważny jest efekt między jednostkami, pokaż model within–between.
Jeśli przygotowujesz artykuł na danych panelowych albo odpowiadasz recenzentowi, który pyta o wybór między FE a RE, możemy wspólnie sprawdzić specyfikację i obliczenia w ramach wsparcia statystycznego dla badaczy.
Przykład w R
Dwa przepisy uruchamiane po kolei w jednej sesji. Pierwszy tworzy dane, zapisuje plik panel-firm-dane.csv (możesz go pobrać tutaj) i liczy pooled OLS, FE, RE, test Hausmana, błędy klastrowane i efekty czasu. Drugi dopasowuje model within–between i model Mundlaka. Potrzebne pakiety: lme4, sandwich, lmtest i clubSandwich. Pakiet plm nie jest potrzebny.
1. Pooled OLS, FE, RE, test Hausmana i błędy klastrowane
R
# Dane symulowane: panel 150 firm obserwowanych przez 6 lat (2019–2024), N × T = 900 obserwacji
# wydajnosc – przychód na pracownika (tys. zł); szkolenia – nakłady na szkolenia (tys. zł na pracownika);
# produkcja – branża (1 = produkcja, 0 = usługi, stała w czasie). Nieobserwowana jakość zarządzania
# podnosi jednocześnie nakłady na szkolenia i wydajność, więc efekt firmy jest skorelowany z predyktorem.
suppressPackageStartupMessages({
  library(lme4); library(sandwich); library(lmtest); library(clubSandwich)
})
set.seed(2301)
n_firm <- 150; n_lat <- 6; lata <- 2019:2024
firma <- rep(sprintf("f%03d", 1:n_firm), each = n_lat)
rok <- rep(lata, times = n_firm)
okres <- rep(0:(n_lat - 1), times = n_firm)
produkcja <- rep(rbinom(n_firm, 1, .5), each = n_lat)
zarzadzanie <- rep(rnorm(n_firm), each = n_lat)                         # cecha firmy, której nie mierzymy
ar1 <- function(rho) as.vector(t(apply(matrix(rnorm(n_firm * n_lat), n_firm), 1,
                                         function(z) stats::filter(z * sqrt(1 - rho^2), rho, "recursive"))))
szkolenia <- round(pmax(2 + 0.8 * zarzadzanie + 0.3 * produkcja + 0.15 * okres + 0.6 * ar1(0.6), 0), 2)  # budżety szkoleń są trwałe
efekt_firmy <- 12 * zarzadzanie + rep(rnorm(n_firm, 0, 15), each = n_lat)
efekt_roku <- c(0, -12, -5, 2, 6, 10)[okres + 1]                  # wspólne wstrząsy, m.in. rok 2020
skala <- rep(exp(rnorm(n_firm, 0, 0.3)), each = n_lat)                 # różna zmienność reszt w firmach
e <- ar1(0.6)                                                  # reszty skorelowane w czasie w obrębie firmy
wydajnosc <- round(220 + 4 * szkolenia + 15 * produkcja + efekt_firmy + efekt_roku + 10 * skala * e, 1)
panel <- data.frame(firma, rok, produkcja, szkolenia, wydajnosc)
write.csv(panel, "panel-firm-dane.csv", row.names = FALSE)

# 1. Struktura panelu: zmienność szkoleń całkowita, między firmami i wewnątrz firm
panel$szk_srednia <- ave(panel$szkolenia, panel$firma)
panel$szk_within <- panel$szkolenia - panel$szk_srednia
c(firmy = length(unique(panel$firma)), lata = length(unique(panel$rok)), obserwacje = nrow(panel))
round(c(SD_calkowite = sd(panel$szkolenia), SD_miedzy = sd(tapply(panel$szkolenia, panel$firma, mean)),
        SD_wewnatrz = sd(panel$szk_within)), 3)

# 2. Pooled OLS, estymator between, FE (LSDV i within) i RE – wszystkie z efektami roku
panel$rok_f <- factor(panel$rok)
m_pooled <- lm(wydajnosc ~ szkolenia + produkcja + rok_f, data = panel)
srednie <- aggregate(cbind(wydajnosc, szkolenia, produkcja) ~ firma, data = panel, FUN = mean)
m_between <- lm(wydajnosc ~ szkolenia + produkcja, data = srednie)
m_fe <- lm(wydajnosc ~ szkolenia + rok_f + factor(firma), data = panel)          # LSDV: czynnik firmy
# to samo przez transformację within (odjęcie średnich firmy; lata też jako odchylenia)
odejmij <- function(x) x - ave(x, panel$firma)
X_w <- sapply(data.frame(szkolenia = panel$szkolenia, model.matrix(~ rok_f, panel)[, -1]), odejmij)
m_within <- lm(odejmij(panel$wydajnosc) ~ 0 + X_w)
m_re <- lmer(wydajnosc ~ szkolenia + produkcja + rok_f + (1 | firma), data = panel, REML = TRUE)
b <- c(pooled = coef(m_pooled)[["szkolenia"]], between = coef(m_between)[["szkolenia"]],
       FE_LSDV = coef(m_fe)[["szkolenia"]], FE_within = coef(m_within)[[1]], RE = fixef(m_re)[["szkolenia"]])
round(b, 3)
# SE z transformacji within bez poprawki stopni swobody jest za mały: df = NT − K zamiast NT − N − K
se_lsdv <- summary(m_fe)$coefficients["szkolenia", 2]
se_within <- summary(m_within)$coefficients[1, 2]
round(c(SE_LSDV = se_lsdv, SE_within_bez_poprawki = se_within,
        SE_within_poprawiony = se_within * sqrt(df.residual(m_within) / df.residual(m_fe))), 3)

# Wariancje komponentów RE i współczynnik częściowego odjęcia średnich θ
vc <- as.data.frame(VarCorr(m_re))
s2_u <- vc$vcov[vc$grp == "firma"]; s2_e <- vc$vcov[vc$grp == "Residual"]
round(c(SD_firmy = sqrt(s2_u), SD_reszt = sqrt(s2_e), ICC = s2_u / (s2_u + s2_e),
        theta = 1 - sqrt(s2_e / (s2_e + n_lat * s2_u))), 3)

# 3. Test Hausmana ręcznie: H = (b_FE − b_RE)² / [Var(b_FE) − Var(b_RE)], df = 1 (współczynnik szkoleń)
roznica <- b[["FE_LSDV"]] - b[["RE"]]
v_fe <- vcov(m_fe)["szkolenia", "szkolenia"]; v_re <- as.matrix(vcov(m_re))["szkolenia", "szkolenia"]
H <- roznica^2 / (v_fe - v_re)
round(c(b_FE = b[["FE_LSDV"]], b_RE = b[["RE"]], roznica = roznica, SE_FE = sqrt(v_fe), SE_RE = sqrt(v_re),
        H = H, df = 1, p = pchisq(H, 1, lower.tail = FALSE)), 4)
# Ogólna formuła macierzowa (gdy porównujesz kilka współczynników): q' [V_FE − V_RE]^(-1) q
hausman <- function(b1, b0, V1, V0) {
  q <- b1 - b0; H <- drop(t(q) %*% solve(V1 - V0) %*% q)
  c(H = H, df = length(q), p = pchisq(H, length(q), lower.tail = FALSE))
}
round(hausman(coef(m_fe)["szkolenia"], fixef(m_re)["szkolenia"],
              vcov(m_fe)["szkolenia", "szkolenia", drop = FALSE],
              as.matrix(vcov(m_re))["szkolenia", "szkolenia", drop = FALSE]), 4)

# 4. Błędy standardowe FE: klasyczne, odporne na klastrowanie CR1 (sandwich) i CR2 (clubSandwich)
se_klas <- sqrt(v_fe)
se_cr1 <- sqrt(vcovCL(m_fe, cluster = ~ firma, type = "HC1")["szkolenia", "szkolenia"])
cr2 <- coef_test(m_fe, vcov = "CR2", cluster = panel$firma, test = "Satterthwaite", coefs = "szkolenia")
# CR1 na modelu within (poprawka liczy tylko K parametrów, a nie 150 zmiennych zero-jedynkowych firm)
se_cr1_within <- sqrt(vcovCL(m_within, cluster = panel$firma, type = "HC1")[1, 1])
round(c(SE_klasyczny = se_klas, SE_CR1_LSDV = se_cr1, SE_CR1_within = se_cr1_within, SE_CR2 = cr2$SE, df_CR2 = cr2$df_Satt), 3)
ci_cr2 <- b[["FE_LSDV"]] + c(-1, 1) * qt(.975, cr2$df_Satt) * cr2$SE
round(c(b = b[["FE_LSDV"]], dolny95 = ci_cr2[1], gorny95 = ci_cr2[2], t = b[["FE_LSDV"]] / cr2$SE, p = cr2$p_Satt), 3)
# Pooled OLS: klasyczny SE a klastrowany po firmach
round(c(SE_klasyczny = summary(m_pooled)$coefficients["szkolenia", 2],
        SE_CR1 = sqrt(vcovCL(m_pooled, cluster = ~ firma, type = "HC1")["szkolenia", "szkolenia"])), 3)

# 5. Efekty czasu: FE bez efektów roku a FE dwukierunkowe
m_fe_bez_lat <- lm(wydajnosc ~ szkolenia + factor(firma), data = panel)
round(c(FE_bez_efektow_roku = coef(m_fe_bez_lat)[["szkolenia"]], FE_z_efektami_roku = b[["FE_LSDV"]]), 3)
anova(m_fe_bez_lat, m_fe)                                         # łączny test efektów roku (F)
round(coef(m_fe)[grep("rok_f", names(coef(m_fe)))], 2)
Wynik w R
     firmy       lata obserwacje
       150          6        900
SD_calkowite    SD_miedzy  SD_wewnatrz
       0.958        0.759        0.587
   pooled   between   FE_LSDV FE_within        RE
   14.815    20.259     4.179     4.179     5.690
               SE_LSDV SE_within_bez_poprawki   SE_within_poprawiony
                 0.677                  0.618                  0.677
SD_firmy SD_reszt      ICC    theta
  18.732   10.862    0.748    0.770
   b_FE    b_RE roznica   SE_FE   SE_RE       H      df       p
 4.1795  5.6901 -1.5106  0.6773  0.6468 56.5177  1.0000  0.0000
      H      df       p
56.5177  1.0000  0.0000
 SE_klasyczny   SE_CR1_LSDV SE_CR1_within        SE_CR2        df_CR2
        0.677         0.737         0.673         0.674       109.742
      b dolny95 gorny95       t       p
  4.179   2.844   5.515   6.204   0.000
SE_klasyczny       SE_CR1
       0.725        1.429
FE_bez_efektow_roku  FE_z_efektami_roku
              8.451               4.179
Analysis of Variance Table

Model 1: wydajnosc ~ szkolenia + factor(firma)
Model 2: wydajnosc ~ szkolenia + rok_f + factor(firma)
  Res.Df    RSS Df Sum of Sq      F    Pr(>F)
1    749 124102
2    744  87205  5     36897 62.958 < 2.2e-16 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
rok_f2020 rok_f2021 rok_f2022 rok_f2023 rok_f2024
   -13.31     -5.40      0.14      4.93      7.68
2. Model within–between i odporna wersja testu Hausmana
R
# Kontynuacja przepisu 1 (te same dane panel): model Mundlaka i model within–between (REWB)
# Średnia szkoleń w firmie (szk_srednia) i odchylenie od niej (szk_within) policzono w przepisie 1.

# 1. Model within–between: efekt wewnątrz firm, efekt między firmami i zmienna stała w czasie
m_rewb <- lmer(wydajnosc ~ szk_within + szk_srednia + produkcja + rok_f + (1 | firma), data = panel, REML = TRUE)
round(summary(m_rewb)$coefficients[c("szk_within", "szk_srednia", "produkcja"), 1:2], 3)
round(confint(m_rewb, parm = c("szk_within", "szk_srednia", "produkcja"), method = "Wald"), 3)

# 2. Model Mundlaka: surowe szkolenia + średnia firmy; współczynnik średniej = efekt między − efekt wewnątrz
m_mundlak <- lmer(wydajnosc ~ szkolenia + szk_srednia + produkcja + rok_f + (1 | firma), data = panel, REML = TRUE)
k <- summary(m_mundlak)$coefficients
round(k[c("szkolenia", "szk_srednia"), 1:2], 3)
# Test Walda dla średniej firmy (H0: efekt kontekstowy = 0) – odpowiednik testu Hausmana
W <- (k["szk_srednia", 1] / k["szk_srednia", 2])^2
round(c(W = W, df = 1, p = pchisq(W, 1, lower.tail = FALSE)), 4)

# 3. Odporna wersja testu (regresja pomocnicza): pooled OLS ze średnią firmy, SE odporne na klastrowanie
m_pom <- lm(wydajnosc ~ szkolenia + szk_srednia + produkcja + rok_f, data = panel)
coeftest(m_pom, vcov. = vcovCL(m_pom, cluster = ~ firma, type = "HC1"))[c("szkolenia", "szk_srednia"), ]
Wald_test(m_pom, constraints = constrain_zero("szk_srednia"), vcov = "CR2", cluster = panel$firma, test = "HTZ")
Wynik w R
            Estimate Std. Error
szk_within     4.179      0.677
szk_srednia   20.259      1.743
produkcja     11.449      2.666
             2.5 % 97.5 %
szk_within   2.852  5.507
szk_srednia 16.843 23.675
produkcja    6.223 16.674
            Estimate Std. Error
szkolenia      4.179      0.677
szk_srednia   16.079      1.870
      W      df       p
73.9531  1.0000  0.0000
             Estimate Std. Error  t value     Pr(>|t|)
szkolenia    4.179473  0.6736702 6.204034 8.417894e-10
szk_srednia 16.079312  1.9400712 8.288001 4.210928e-16
 test Fstat df_num df_denom  p_val sig
  HTZ  67.5      1      103 <0.001 ***
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje lm(), lmer(), vcovCL(), coef_test(), Wald_test()); rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- lmtest (wersja 0.9.40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- clubSandwich (wersja 0.7.0): Pustejovsky, J. E. (2026). clubSandwich: Cluster-robust (sandwich) variance estimators with small-sample corrections [R package]. https://CRAN.R-project.org/package=clubSandwich
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Pooled OLS z klasycznymi błędami standardowymi. Miesza efekt wewnątrz i między jednostkami i zawyża precyzję. W przykładzie SE był za mały o połowę.
- Interpretowanie FE jak efektu między jednostkami. FE mówi, co się dzieje, gdy ta sama firma zmienia nakłady. Nie mówi, czym różnią się firmy, które szkolą dużo, od tych, które szkolą mało.
- Brak efektów czasu. Wspólny trend przypisany predyktorowi podwoił w przykładzie oszacowanie FE.
- Mechaniczny wybór modelu testem Hausmana. Klasyczna wersja zakłada efektywność RE, a w małym panelu ma małą moc. Raportuj wersję odporną i rozważ model within–between.
- Uznanie FE za dowód przyczynowości. FE usuwa tylko zakłócacze stałe w czasie. Zakłócacze zmienne w czasie i odwrotny kierunek zależności pozostają (zob. RDD i zmienne instrumentalne).
Najczęstsze pytania
Czy wynik testu Hausmana wystarczy do wyboru między efektami stałymi a losowymi?
Nie. Klasyczny test zakłada, że model efektów losowych jest w pełni efektywny, czyli że reszty nie są skorelowane w czasie ani heteroskedastyczne. W małym panelu ma też małą moc. Raportuj odporną wersję (regresja pomocnicza Mundlaka z błędami klastrowanymi) i pytaj, czy interesuje Cię efekt wewnątrz, czy między jednostkami. Clark i Linzer (2015) pokazali, że lepszy model zależy od cech danych.
Co zrobić, gdy statystyka testu Hausmana wychodzi ujemna?
Ujemne H oznacza, że różnica macierzy wariancji FE i RE w próbie nie jest dodatnio określona, co zdarza się w skończonych próbach i przy naruszeniu założeń. Nie interpretuj takiej wartości. Policz test regresyjnie: dodaj do modelu RE albo pooled OLS średnie predyktorów w jednostkach i sprawdź testem Walda z błędami odpornymi na klastrowanie, czy ich współczynniki są równe zero (Wooldridge, 2010).
Jak uwzględnić zmienną stałą w czasie, np. branżę lub płeć, gdy potrzebuję efektów stałych?
Model FE jej nie oszacuje, bo efekt jednostki ją pochłania. Użyj modelu within–between: predyktory zmienne w czasie rozłóż na odchylenie od średniej jednostki i średnią jednostki, a zmienną stałą dodaj zwyczajnie. Efekt wewnątrz jest wtedy identyczny z FE, a zmienna stała dostaje własny współczynnik (Bell i Jones, 2015). W przykładzie efekt branży wyniósł 11.45 tys. zł.
Czy w modelu z efektami stałymi trzeba jeszcze klastrować błędy standardowe?
Tak, zwykle po jednostce panelu. Efekt jednostki usuwa stałą część zależności, ale reszty bywają skorelowane w kolejnych okresach i mają różną wariancję. Cameron i Miller (2015) zalecają wtedy błędy odporne na klastrowanie. Przy kilkudziesięciu jednostkach lub mniej użyj poprawki CR2 z przybliżeniem Satterthwaite’a (Pustejovsky i Tipton, 2018).
Czym różni się model z efektami stałymi w ekonometrii od modelu mieszanego w psychologii?
W ekonometrii panelowej „efekty stałe” to osobny wyraz wolny dla każdej jednostki, szacowany jak zwykły parametr. W modelach mieszanych efekt stały to przeciętny współczynnik w populacji, a jednostki mają efekty losowe. Model RE z ekonometrii to model wielopoziomowy z losowym wyrazem wolnym, a model within–between to ten sam model z predyktorem centrowanym względem średniej jednostki.
Powiązane hasła
Przeczytaj też
Model wielopoziomowy krok po kroku w R
Pięć modeli na danych o pracownikach w zespołach: ICC, centrowanie CWC i CGM, losowe nachylenia, interakcja międzypoziomowa, REML a ML i wzór raportu.
Czytaj →PoradnikQuasi-eksperyment i różnica w różnicach (DiD)
Ocena programu bez losowania: równoległe trendy, regresja z interakcją, błędy klastrowane, model zdarzeń, test placebo, zagrożenia trafności i kod R.
Czytaj →PoradnikModele wzrostu w lme4
Losowy wyraz wolny i nachylenie czasu, kodowanie czasu, nieregularne terminy, predyktor × czas, braki MAR, porównanie z LGM i wzór opisu APA.
Czytaj →Analizujesz dane panelowe i musisz obronić wybór między FE a RE?
Pomożemy dobrać specyfikację, policzyć odporne wersje testu Hausmana i błędy klastrowane, dopasować model within–between i opisać wyniki tak, żebyś mógł(a) je samodzielnie obronić przed recenzentem.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01 ● Otwarty dostęp
- Bell, A., & Jones, K. (2015). Explaining fixed effects: Random effects modeling of time-series cross-sectional and panel data. Political Science Research and Methods, 3(1), 133–153. https://doi.org/10.1017/psrm.2014.7 ● Otwarty dostęp
- Bell, A., Fairbrother, M., & Jones, K. (2019). Fixed and random effects models: Making an informed choice. Quality & Quantity, 53(2), 1051–1074. https://doi.org/10.1007/s11135-018-0802-x ● Otwarty dostęp
- Cameron, A. C., & Miller, D. L. (2015). A practitioner’s guide to cluster-robust inference. Journal of Human Resources, 50(2), 317–372. https://doi.org/10.3368/jhr.50.2.317
- Clark, T. S., & Linzer, D. A. (2015). Should I use fixed or random effects? Political Science Research and Methods, 3(2), 399–408. https://doi.org/10.1017/psrm.2014.32
- Curran, P. J., & Bauer, D. J. (2011). The disaggregation of within-person and between-person effects in longitudinal models of change. Annual Review of Psychology, 62(1), 583–619. https://doi.org/10.1146/annurev.psych.093008.100356 ● Otwarty dostęp: pełny tekst
- Hausman, J. A. (1978). Specification tests in econometrics. Econometrica, 46(6), 1251–1271. https://doi.org/10.2307/1913827 ● Otwarty dostęp: pełny tekst
- Mundlak, Y. (1978). On the pooling of time series and cross section data. Econometrica, 46(1), 69–85. https://doi.org/10.2307/1913646
- Pustejovsky, J. E., & Tipton, E. (2018). Small-sample methods for cluster-robust variance estimation and hypothesis testing in fixed effects models. Journal of Business & Economic Statistics, 36(4), 672–683. https://doi.org/10.1080/07350015.2016.1247004 ● Otwarty dostęp: pełny tekst
- Wooldridge, J. M. (2010). Econometric analysis of cross section and panel data (2nd ed.). MIT Press.
Cytowania BibTeX
@article{bates2015fitting, author={Bates, Douglas and Mächler, Martin and Bolker, Ben and Walker, Steve}, title={{Fitting linear mixed-effects models using lme4}}, journal={Journal of Statistical Software}, year={2015}, volume={67}, number={1}, pages={1--48}, doi={10.18637/jss.v067.i01}}@article{bell2015explaining, author={Bell, Andrew and Jones, Kelvyn}, title={{Explaining fixed effects: Random effects modeling of time-series cross-sectional and panel data}}, journal={Political Science Research and Methods}, year={2015}, volume={3}, number={1}, pages={133--153}, doi={10.1017/psrm.2014.7}}@article{bell2019fixed, author={Bell, Andrew and Fairbrother, Malcolm and Jones, Kelvyn}, title={{Fixed and random effects models: Making an informed choice}}, journal={Quality \& Quantity}, year={2019}, volume={53}, number={2}, pages={1051--1074}, doi={10.1007/s11135-018-0802-x}}@article{cameron2015practitioner, author={Cameron, A. Colin and Miller, Douglas L.}, title={{A practitioner’s guide to cluster-robust inference}}, journal={Journal of Human Resources}, year={2015}, volume={50}, number={2}, pages={317--372}, doi={10.3368/jhr.50.2.317}}@article{clark2015should, author={Clark, Tom S. and Linzer, Drew A.}, title={{Should I use fixed or random effects?}}, journal={Political Science Research and Methods}, year={2015}, volume={3}, number={2}, pages={399--408}, doi={10.1017/psrm.2014.32}}@article{curran2011disaggregation, author={Curran, Patrick J. and Bauer, Daniel J.}, title={{The disaggregation of within-person and between-person effects in longitudinal models of change}}, journal={Annual Review of Psychology}, year={2011}, volume={62}, number={1}, pages={583--619}, doi={10.1146/annurev.psych.093008.100356}}@article{hausman1978specification, author={Hausman, Jerry A.}, title={{Specification tests in econometrics}}, journal={Econometrica}, year={1978}, volume={46}, number={6}, pages={1251--1271}, doi={10.2307/1913827}}@article{mundlak1978pooling, author={Mundlak, Yair}, title={{On the pooling of time series and cross section data}}, journal={Econometrica}, year={1978}, volume={46}, number={1}, pages={69--85}, doi={10.2307/1913646}}@article{pustejovsky2018small, author={Pustejovsky, James E. and Tipton, Elizabeth}, title={{Small-sample methods for cluster-robust variance estimation and hypothesis testing in fixed effects models}}, journal={Journal of Business \& Economic Statistics}, year={2018}, volume={36}, number={4}, pages={672--683}, doi={10.1080/07350015.2016.1247004}}@book{wooldridge2010econometric, author={Wooldridge, Jeffrey M.}, title={{Econometric analysis of cross section and panel data (2nd ed.)}}, year={2010}, publisher={MIT Press}}