Co to jest test McCrary’ego?
Test McCrary’ego (ang. McCrary density test) sprawdza, czy w regresji nieciągłej (RDD) uczestnicy nie manipulowali zmienną przydziału. W RDD o udziale w programie decyduje to, po której stronie progu leży wartość tej zmiennej (Imbens i Lemieux, 2008). Identyfikacja wymaga ciągłości oczekiwanych wyników kontrfaktycznych w progu, a manipulacja może ją naruszyć. McCrary (2008) zaproponował więc test ciągłości funkcji gęstości zmiennej przydziału w progu.
Logika testu
Jeśli ludzie „dociągają” wynik, by przekroczyć próg, tuż pod nim brakuje obserwacji, a tuż nad nim jest ich za dużo. Na histogramie widać wtedy skok wysokości słupków w progu. W wersji McCrary’ego gęstość szacuje się osobno po obu stronach progu – z drobnego histogramu wygładzonego regresją lokalnie liniową – i testuje różnicę logarytmów obu wysokości. Cattaneo i in. (2020) zaproponowali estymator gęstości oparty na wielomianach lokalnych, który nie wymaga wcześniejszego grupowania danych w przedziały, i wyprowadzili z niego nowy test nieciągłości gęstości. To podejście, pokrewne estymatorowi jądrowemu gęstości, jest obecnie częstszym wyborem.
Interpretacja
- Istotny skok to sygnał manipulacji – efekt w progu może być obciążony.
- Brak skoku nie dowodzi braku manipulacji: test może mieć małą moc przy niewielkiej próbie.
- Skok może też wynikać z zaokrąglania wyników do pełnych wartości, a nie z manipulacji.
Test uzupełnij sprawdzeniem, czy zmienne wyjściowe są ciągłe w progu. Pamiętaj, że RDD szacuje efekt lokalny, podobnie jak LATE, i należy do schematów quasi-eksperymentalnych.
Przykład
W symulacji 3000 wyników testu 25% osób z wynikiem 47–49.9 pkt podniosło go powyżej progu 50 pkt. W przedziale tuż pod progiem było 110 osób, tuż nad nim 210. W oknie 3 pkt pod progiem znalazło się 251 osób, a nad nim 466; uproszczony test dwumianowy dał p < .0001. Test gęstości z pakietu rddensity potwierdził nieciągłość: oszacowana gęstość w progu wzrosła z 0.047 do 0.082, T = 3.60, p < .001.
Na rysunku
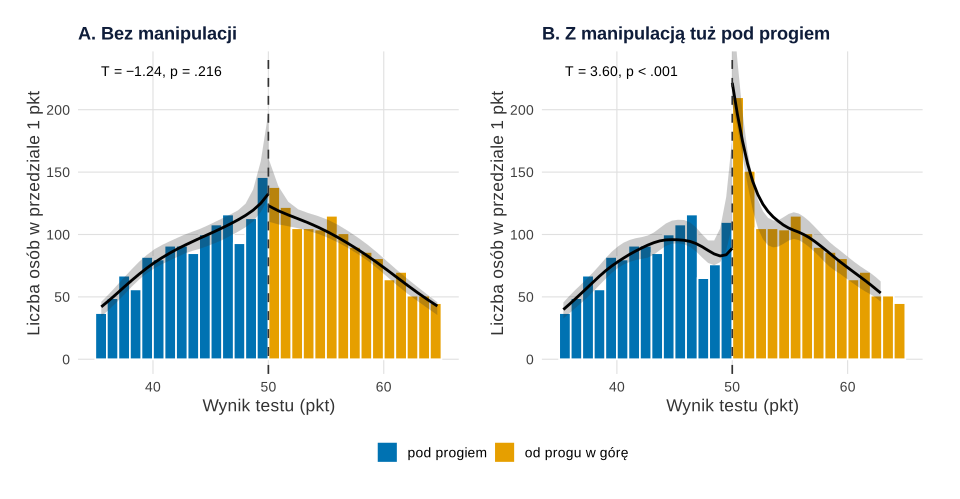
set.seed(58401)).Co widać. Panel A to te same 3000 wyników z przykładu przed przesunięciem, panel B – po nim. Bez manipulacji w oknie 3 pkt pod progiem jest 352 osób, a nad nim 365; linie gęstości po obu stronach prawie się stykają, a test gęstości daje T = −1.24, p = .216. Po manipulacji pod progiem widać dołek, nad nim najwyższy słupek (251 wobec 466 osób w tych samych oknach), a oszacowana gęstość skacze z 0.047 do 0.082: T = 3.60, p < .001. Czarne linie to dokładnie to, co porównuje test z pakietu rddensity – dwie gęstości oszacowane osobno do progu z lewej i z prawej strony – przeliczone na liczbę osób w przedziale 1 pkt; szare pasma to 95% przedziały ufności.
Na co uważać. Wygląd histogramu zależy od szerokości przedziałów i od tego, czy granica przedziału wypada dokładnie w progu – próg zawsze ustaw jako granicę (więcej o doborze przedziałów we wpisie Rozkład zmiennej na wykresie). Panel A pokazuje, że nawet bez manipulacji linie nie stykają się idealnie, bo gęstość szacowana na brzegu jest mało precyzyjna. Brak skoku nie wyklucza manipulacji, gdy osoby przesuwają się w obie strony albo próba przy progu jest mała. Rysunek nie mówi też, czy zmienne wyjściowe są ciągłe w progu – to osobne sprawdzenie.
Podpis do pracy:
Kod rysunku ma jedno ziarno (set.seed(58401), to samo co w przykładzie, niezmieniane) i te same parametry danych; panel A to wyniki z pierwszego losowania przed przesunięciem. Ręcznie ustalono tylko zakres osi (35–65 pkt) i szerokość przedziałów (1 pkt). Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Histogram zmiennej przydziału wokół progu 50 pkt i gęstość z wielomianów lokalnych: bez manipulacji (A) i z nią (B); dane symulowane z przykładu
suppressPackageStartupMessages({library(ggplot2); library(patchwork); library(rddensity)})
kol <- c(pod = "#0072B2", nad = "#E69F00", gestosc = "black")   # Okabe–Ito + czarny
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), legend.position = "bottom")
set.seed(58401)                                 # te same dane co w przykładzie
x0 <- round(rnorm(3000, mean = 50, sd = 10), 1) # wyniki przed manipulacją
x <- x0
blisko <- which(x >= 47 & x < 50)                  # część osób tuż pod progiem
podnies <- blisko[runif(length(blisko)) < 0.25]    # 25% z nich "dociąga" wynik
x[podnies] <- round(runif(length(podnies), 50, 51.5), 1)
panel <- function(v, tytul) {
  test <- rddensity(X = v, c = 50)
  g <- rdplotdensity(test, v, plotN = 30, noPlot = TRUE)   # gęstość po obu stronach progu, 95% CI
  est <- rbind(data.frame(g$Estl$Estimate, strona = "pod"), data.frame(g$Estr$Estimate, strona = "nad"))
  est <- est[est$grid >= 35 & est$grid <= 65, ]                       # zakres histogramu
  est[, c("f_p", "f_q", "se_q")] <- est[, c("f_p", "f_q", "se_q")] * length(v)   # gęstość × n × szerokość przedziału (1 pkt)
  h <- data.frame(v = v[v >= 35 & v < 65])
  h$strona <- ifelse(h$v < 50, "pod", "nad")
  wynik <- c(T = test$test$t_jk, p = test$test$p_jk, gestosc_pod = test$hat$left, gestosc_nad = test$hat$right)
  rys <- ggplot(h, aes(v)) +
    geom_histogram(aes(fill = strona), breaks = 35:65, colour = "white", closed = "left") +
    geom_ribbon(data = est, aes(x = grid, ymin = f_q - 1.96 * se_q, ymax = f_q + 1.96 * se_q, group = strona),
                inherit.aes = FALSE, fill = "grey20", alpha = 0.25) +
    geom_line(data = est, aes(x = grid, y = f_p, group = strona), colour = kol[["gestosc"]], linewidth = 1) +
    geom_vline(xintercept = 50, linetype = "dashed", colour = "grey20") +
    annotate("text", x = 35.5, y = 235, hjust = 0, vjust = 1, size = 3.7,
             label = sprintf("T = %s, p %s", sub("-", "−", sprintf("%.2f", wynik[["T"]])),
                             ifelse(wynik[["p"]] < .001, "< .001", sub("^0", "= ", sprintf("%.3f", wynik[["p"]]))))) +
    scale_fill_manual(values = c(pod = kol[["pod"]], nad = kol[["nad"]]),
                      labels = c(pod = "pod progiem", nad = "od progu w górę"), breaks = c("pod", "nad")) +
    coord_cartesian(ylim = c(0, 235)) +
    labs(title = tytul, x = "Wynik testu (pkt)", y = "Liczba osób w przedziale 1 pkt", fill = NULL)
  list(rys = rys, wynik = wynik)
}
A <- panel(x0, "A. Bez manipulacji")
B <- panel(x, "B. Z manipulacją tuż pod progiem")
round(rbind(bez_manipulacji = A$wynik, z_manipulacja = B$wynik), 4)
rbind(bez_manipulacji = table(cut(x0, c(47, 50, 53), right = FALSE)),
      z_manipulacja = table(cut(x, c(47, 50, 53), right = FALSE)))
p1 <- (A$rys + B$rys) + plot_layout(guides = "collect") & motyw
p1
Wynik w R
                      T      p gestosc_pod gestosc_nad
bez_manipulacji -1.2369 0.2161      0.0545      0.0453
z_manipulacja    3.5975 0.0003      0.0475      0.0825
                [47,50) [50,53)
bez_manipulacji     352     365
z_manipulacja       251     466
Jak opisać w pracy
Manipulacja w progu w R
Kod pokazuje zliczenia w przedziałach wokół progu i uproszczone porównanie liczebności po obu stronach (binom.test()), a potem właściwy test gęstości funkcją rddensity::rddensity(). Uproszczona wersja pomija nachylenie gęstości, więc nadaje się tylko do wąskich okien.
Zliczenia wokół progu
R
# Manipulacja zmienną przydziału przy progu 50 pkt (dane symulowane)
set.seed(58401)
x <- round(rnorm(3000, mean = 50, sd = 10), 1)
blisko <- which(x >= 47 & x < 50)                  # część osób tuż pod progiem
podnies <- blisko[runif(length(blisko)) < 0.25]    # 25% z nich "dociąga" wynik
x[podnies] <- round(runif(length(podnies), 50, 51.5), 1)
# zliczenia w przedziałach o szerokości 1 pkt wokół progu
przedzialy <- table(cut(x, breaks = 44:56, right = FALSE))
print(przedzialy)
# uproszczone sprawdzenie: liczebność 3 pkt pod progiem i 3 pkt nad nim
pod <- sum(x >= 47 & x < 50); nad <- sum(x >= 50 & x < 53)
c(pod = pod, nad = nad)
format.pval(binom.test(nad, pod + nad)$p.value, eps = 1e-4)
# właściwy test gęstości: wielomiany lokalne (Cattaneo i in., 2020); pełny opis daje summary(test)
test <- rddensity::rddensity(X = x, c = 50)
round(c(T = test$test$t_jk, p = test$test$p_jk, gestosc_pod = test$hat$left,
        gestosc_nad = test$hat$right, h_pod = test$h$left, h_nad = test$h$right), 4)
Wynik w R
[44,45) [45,46) [46,47) [47,48) [48,49) [49,50) [50,51) [51,52) [52,53) [53,54)
    100     108     116      65      76     110     210     151     105     105
[54,55) [55,56)
    104     115
pod nad
251 466
[1] "< 1e-04"
          T           p gestosc_pod gestosc_nad       h_pod       h_nad
     3.5975      0.0003      0.0475      0.0825      5.0539      4.2880
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base i stats oraz pakiet rddensity 3.0; rysunek 1 – także pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- rddensity (wersja 3.0): Cattaneo, M. D., Jansson, M., & Ma, X. (2026). rddensity: Manipulation testing based on density discontinuity (R package version 3.0) [Computer software]. https://doi.org/10.32614/CRAN.package.rddensity
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Co oznacza istotny wynik testu McCrary’ego?
Że gęstość zmiennej przydziału ma skok w progu, czyli po jednej stronie jest nienaturalnie dużo obserwacji. To sygnał możliwej manipulacji, który podważa porównanie osób tuż pod progiem i tuż nad nim.
Czy brak istotnego wyniku wyklucza manipulację?
Nie. Przy małej liczbie obserwacji w pobliżu progu test ma niską moc. Manipulacja może też przesuwać osoby w obie strony, nie zmieniając gęstości. Sprawdź dodatkowo ciągłość zmiennych wyjściowych w progu.
Jak wykonać test gęstości w R?
Najczęściej używa się pakietu rddensity, który implementuje test oparty na wielomianach lokalnych. Bez niego możesz pokazać histogram z granicą przedziału w progu i porównać liczebności w wąskim oknie, ale to tylko przybliżenie.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Cattaneo, M. D., Jansson, M., & Ma, X. (2020). Simple local polynomial density estimators. Journal of the American Statistical Association, 115(531), 1449–1455. https://doi.org/10.1080/01621459.2019.1635480 ● Otwarty dostęp: pełny tekst
- Imbens, G. W., & Lemieux, T. (2008). Regression discontinuity designs: A guide to practice. Journal of Econometrics, 142(2), 615–635. https://doi.org/10.1016/j.jeconom.2007.05.001
- McCrary, J. (2008). Manipulation of the running variable in the regression discontinuity design: A density test. Journal of Econometrics, 142(2), 698–714. https://doi.org/10.1016/j.jeconom.2007.05.005 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{cattaneo2020simple, author={Cattaneo, Matias D. and Jansson, Michael and Ma, Xinwei}, title={{Simple local polynomial density estimators}}, journal={Journal of the American Statistical Association}, year={2020}, volume={115}, number={531}, pages={1449--1455}, doi={10.1080/01621459.2019.1635480}}@article{imbens2008regression, author={Imbens, Guido W. and Lemieux, Thomas}, title={{Regression discontinuity designs: A guide to practice}}, journal={Journal of Econometrics}, year={2008}, volume={142}, number={2}, pages={615--635}, doi={10.1016/j.jeconom.2007.05.001}}@article{mccrary2008manipulation, author={McCrary, Justin}, title={{Manipulation of the running variable in the regression discontinuity design: A density test}}, journal={Journal of Econometrics}, year={2008}, volume={142}, number={2}, pages={698--714}, doi={10.1016/j.jeconom.2007.05.005}}