Co to jest estymator jądrowy gęstości?
Estymator jądrowy gęstości (ang. kernel density estimation, KDE) to gładka krzywa przybliżająca funkcję gęstości zmiennej ciągłej bez zakładania jej kształtu. Nad każdą obserwacją umieszcza się małą „górkę” – jądro, najczęściej krzywą normalną – i sumuje wszystkie górki, a wynik dzieli przez liczbę obserwacji. W odróżnieniu od histogramu wynik nie zależy od punktu startowego przedziałów i nie ma schodków.
Decydujący jest jeden parametr: szerokość pasma (ang. bandwidth, h). Za małe h daje poszarpaną krzywą z fałszywymi szczytami, za duże – zlewa prawdziwe podgrupy w jeden garb. Wybór jądra ma znacznie mniejsze znaczenie. Sheather (2004) opisuje praktyczne zasady stosowania KDE i ich implementacje w R, a Sheather i Jones (1991) zaproponowali metodę doboru h na podstawie danych, która w symulacjach działała bardzo dobrze dla gładkich gęstości.
Przykład w R
Wyniki testu 200 osób pochodzą z dwóch podgrup (średnie 50 i 80). Domyślna reguła R (bw.nrd0) daje h = 4.77, a metoda Sheathera–Jonesa h = 3.12. W obu przypadkach krzywa ma dwa szczyty, z modą około 50.5. Przy h = 1 pojawia się 11 drobnych szczytów, a przy h = 15 – tylko jeden, choć podgrupy są dwie.
Kiedy używać
- Kształt rozkładu – skośność, ciężkie ogony i wielomodalność widać lepiej niż w tabeli. Silverman (1981) wykorzystał KDE do badania liczby szczytów rozkładu, z automatycznym doborem stopnia wygładzenia.
- Porównanie grup – kilka krzywych na jednym wykresie albo wykres skrzypcowy i raincloud, które są zbudowane z KDE.
- Uzupełnienie oceny normalności – obok wykresu Q-Q; KDE nie jest testem.
Uwaga na granice: przy zmiennych ograniczonych (np. czas reakcji > 0) krzywa „wycieka” poza możliwy zakres.
Na rysunku
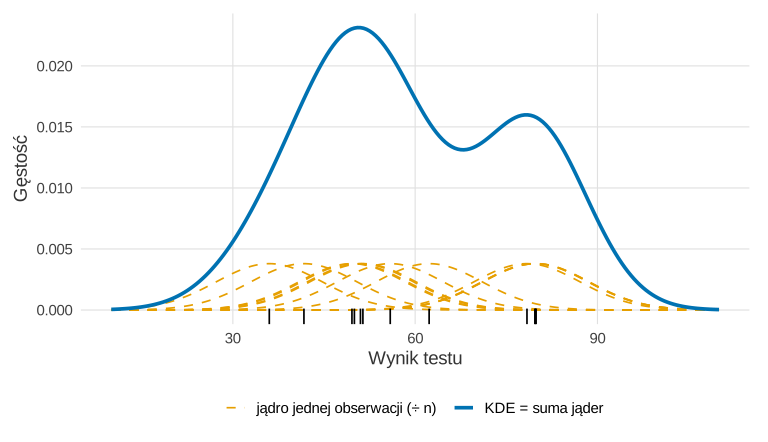
bw.nrd0). Obliczenia: R, pakiet ggplot2 (dane symulowane, ziarno 5641).Co widać. Nad każdym z 12 wyników (kreski na osi) stoi krzywa normalna o odchyleniu równym pasmu h = 8.75 i polu 1/12. Suma tych górek to KDE: tam, gdzie obserwacje leżą gęsto, górki się nakładają i krzywa rośnie. Ręczne sumowanie daje to samo co density() (największa różnica 4.5 × 10⁻⁶).
Na co uważać. Przy 12 obserwacjach kształt krzywej zależy od pojedynczych punktów – drugi garb tworzą tu cztery wyniki. Krzywa wychodzi też poza zakres danych, bo każde jądro ma ogony.
Podpis do pracy:
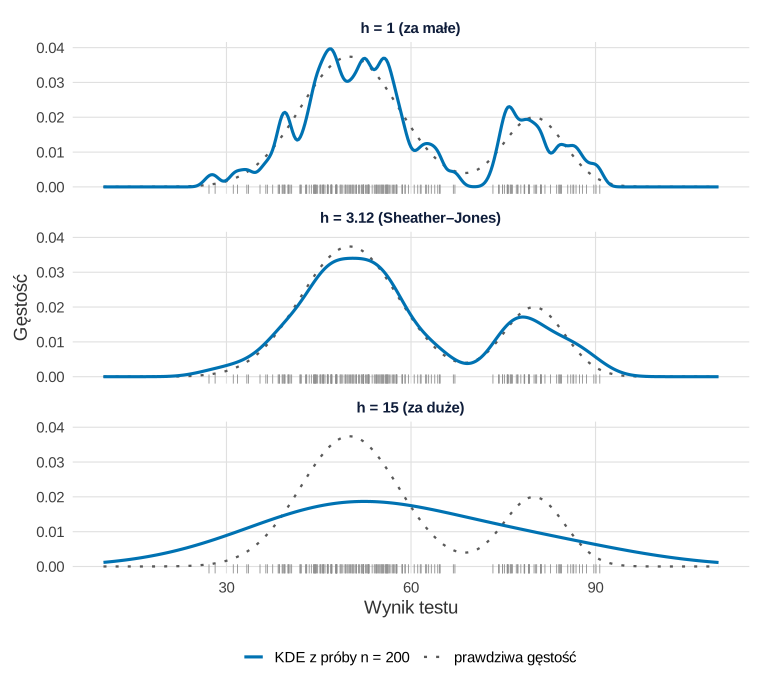
Co widać. To te same dane co w przykładzie wyżej. Przy h = 1 krzywa ma wiele fałszywych szczytów, przy h = 15 zlewa obie podgrupy w jeden garb. Pasmo Sheathera–Jonesa (h = 3.12) jest najbliżej prawdziwej gęstości: całkowity błąd kwadratowy wynosi 0.00022 wobec 0.00097 przy h = 1 i 0.0058 przy h = 15.
Na co uważać. Prawdziwą gęstość znamy tylko w symulacji. W prawdziwych danych nie sprawdzisz, które pasmo jest najlepsze, więc w pracy podaj metodę wyboru i wartość h. Cztery szerokości pasma na tle histogramu i porównanie z ECDF pokazuje wpis Rozkład zmiennej na wykresie.
Podpis do pracy:
Kod R rysunków
# Rysunki 1–2: jak powstaje estymator jądrowy gęstości i jak zmienia się przy różnej szerokości pasma
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(kde = "#0072B2", jadra = "#E69F00", prawda = "grey35")
motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        strip.text = element_text(face = "bold", colour = "#0f1d3a"),
        plot.background = element_rect(fill = "white", colour = NA))

# Rysunek 1: KDE jako suma jąder normalnych nad 12 obserwacjami
set.seed(5641)
x12 <- round(c(rnorm(8, 50, 8), rnorm(4, 80, 5)), 1)     # 12 wyników z dwóch podgrup
h12 <- bw.nrd0(x12)                                     # domyślna reguła R
siatka <- seq(10, 110, by = 0.5)
jadra <- data.frame(obs = rep(seq_along(x12), each = length(siatka)), x = siatka,
                    y = as.vector(sapply(x12, function(xi) dnorm(siatka, xi, h12) / length(x12))))
suma <- aggregate(y ~ x, data = jadra, FUN = sum)        # KDE = suma jąder podzielonych przez n
spr <- density(x12, bw = h12, from = 10, to = 110, n = length(siatka))
round(h12, 2)                                           # szerokość pasma
signif(max(abs(spr$y - suma$y)), 2)                     # różnica względem density(): błąd przybliżenia
p1 <- ggplot() +
  geom_line(data = jadra, aes(x, y, group = obs, linetype = "jądro jednej obserwacji (÷ n)"),
            colour = kol[["jadra"]], linewidth = 0.6) +
  geom_line(data = suma, aes(x, y, linetype = "KDE = suma jąder"), colour = kol[["kde"]], linewidth = 1.3) +
  geom_rug(data = data.frame(x = x12), aes(x), length = unit(0.05, "npc"), linewidth = 0.6) +
  scale_linetype_manual(values = c("dashed", "solid"), name = NULL,
                        guide = guide_legend(override.aes = list(colour = unname(kol[c("jadra", "kde")])))) +
  labs(x = "Wynik testu", y = "Gęstość") + motyw

# Rysunek 2: dane z przykładu (200 wyników) przy trzech szerokościach pasma na tle prawdziwej gęstości
set.seed(564)
x <- c(rnorm(150, 50, 8), rnorm(50, 80, 5))              # te same dane co w przykładzie w haśle
prawdziwa <- function(t) 0.75 * dnorm(t, 50, 8) + 0.25 * dnorm(t, 80, 5)
pasma <- c("h = 1 (za małe)" = 1, "h = 3.12 (Sheather–Jones)" = bw.SJ(x), "h = 15 (za duże)" = 15)
names(pasma)[2] <- sprintf("h = %.2f (Sheather–Jones)", bw.SJ(x))
krzywe <- do.call(rbind, lapply(names(pasma), function(nm) {
  d <- density(x, bw = pasma[[nm]], from = 10, to = 110, n = 401)
  data.frame(pasmo = nm, x = d$x, kde = d$y, prawda = prawdziwa(d$x))
}))
krzywe$pasmo <- factor(krzywe$pasmo, levels = names(pasma))
# całkowity błąd kwadratowy (ISE) względem prawdziwej gęstości, całka metodą prostokątów
ise <- aggregate(cbind(blad = (kde - prawda)^2) ~ pasmo, data = krzywe, FUN = function(v) sum(v) * 0.25)
print(transform(ise, blad = signif(blad, 3)), row.names = FALSE)
p2 <- ggplot(krzywe, aes(x)) +
  geom_line(aes(y = prawda, linetype = "prawdziwa gęstość"), colour = kol[["prawda"]], linewidth = 0.8) +
  geom_line(aes(y = kde, linetype = "KDE z próby n = 200"), colour = kol[["kde"]], linewidth = 1.1) +
  geom_rug(data = data.frame(x = x), aes(x), colour = "grey55", linewidth = 0.3, length = unit(0.06, "npc"), inherit.aes = FALSE) +
  facet_wrap(~ pasmo, ncol = 1) +
  scale_linetype_manual(values = c("solid", "dotted"), name = NULL,
                        guide = guide_legend(override.aes = list(colour = unname(kol[c("kde", "prawda")])))) +
  labs(x = "Wynik testu", y = "Gęstość") + motyw

p1   # zapis: ggsave("estymator-jadrowy-gestosci-jadra.svg", p1, width = 8, height = 4.6)
p2   # zapis: ggsave("estymator-jadrowy-gestosci-pasmo.svg", p2, width = 8, height = 7.2)
Wynik w R
[1] 8.75
[1] 4.5e-06
                     pasmo     blad
           h = 1 (za małe) 0.000969
 h = 3.12 (Sheather–Jones) 0.000223
          h = 15 (za duże) 0.005820
Rysunki na stronie powstały z tego kodu z motywem serwisu (dane, geometrie i skale identyczne). Liczebności i parametry podgrup w rysunku 1 ustalono ręcznie; ziarna nie zmieniano.
Jak opisać w pracy
Estymator jądrowy gęstości w R
Kod liczy KDE funkcją bazową density() dla czterech szerokości pasma: reguły domyślnej bw.nrd0(), metody Sheathera–Jonesa bw.SJ() oraz celowo za małej i za dużej wartości, i zlicza szczyty krzywej.
Wpływ szerokości pasma na liczbę szczytów
R
# Estymator jądrowy gęstości: wpływ szerokości pasma (bw)
set.seed(564)
x <- c(rnorm(150, 50, 8), rnorm(50, 80, 5))     # dwie podgrupy wyników testu
szczyty <- function(d) sum(diff(sign(diff(d$y))) == -2)
bw <- c(nrd0 = bw.nrd0(x), SJ = bw.SJ(x), za_male = 1, za_duze = 15)
wyn <- sapply(bw, function(h) {
  d <- density(x, bw = h, kernel = "gaussian", n = 1024)
  c(bw = h, szczyty = szczyty(d), moda = d$x[which.max(d$y)])
})
round(wyn, 2)
Wynik w R
         nrd0    SJ za_male za_duze
bw       4.77  3.12    1.00    15.0
szczyty  2.00  2.00   11.00     1.0
moda    50.50 50.52   46.86    52.4
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (przykład bez dodatkowych pakietów); rysunki wykonano w pakiecie ggplot2, a pliki zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Jak wybrać szerokość pasma w estymatorze jądrowym?
Zacznij od metody opartej na danych, np. Sheathera–Jonesa (bw.SJ() w R), i porównaj z regułą domyślną. Zawsze sprawdź też krzywą przy mniejszym i większym h: wniosek o kilku szczytach powinien przetrwać rozsądne zmiany pasma.
Czy KDE jest lepsze od histogramu?
Daje gładszy obraz i nie zależy od punktu startowego przedziałów, ale nadal wymaga wyboru wygładzenia. Przy małej próbie oba wykresy mogą mylić. Dobrze jest pokazać KDE razem z punktami surowymi, np. na wykresie raincloud.
Dlaczego krzywa gęstości wychodzi poza zakres danych?
Jądro normalne rozciąga się poza każdą obserwację, więc część gęstości trafia np. poniżej zera przy czasach reakcji. Przy zmiennych ograniczonych przytnij wykres do możliwego zakresu albo użyj transformacji, np. logarytmu.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Rozkład zmiennej na wykresie
Histogram przy czterech szerokościach przedziału, gęstość za gładka i za szorstka, ECDF, dwie grupy i skala Likerta – sześć rysunków z kodem R.
Czytaj →PoradnikJak sprawdzić normalność rozkładu
Co ma być normalne, wykres Q-Q reszt, skośność i kurtoza, granice testu Shapiro-Wilka i sześć strategii na brak normalności – z kodem R, SPSS i opisem APA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Sheather, S. J. (2004). Density estimation. Statistical Science, 19(4), 588–597. https://doi.org/10.1214/088342304000000297
- Sheather, S. J., & Jones, M. C. (1991). A reliable data-based bandwidth selection method for kernel density estimation. Journal of the Royal Statistical Society: Series B (Methodological), 53(3), 683–690. https://doi.org/10.1111/j.2517-6161.1991.tb01857.x
- Silverman, B. W. (1981). Using kernel density estimates to investigate multimodality. Journal of the Royal Statistical Society: Series B (Methodological), 43(1), 97–99. https://doi.org/10.1111/j.2517-6161.1981.tb01155.x
Cytowania BibTeX
@article{sheather2004density, author={Sheather, Simon J.}, title={{Density estimation}}, journal={Statistical Science}, year={2004}, volume={19}, number={4}, pages={588--597}, doi={10.1214/088342304000000297}}@article{sheather1991reliable, author={Sheather, S. J. and Jones, M. C.}, title={{A reliable data-based bandwidth selection method for kernel density estimation}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1991}, volume={53}, number={3}, pages={683--690}, doi={10.1111/j.2517-6161.1991.tb01857.x}}@article{silverman1981using, author={Silverman, Bernard W.}, title={{Using kernel density estimates to investigate multimodality}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1981}, volume={43}, number={1}, pages={97--99}, doi={10.1111/j.2517-6161.1981.tb01155.x}}