Co to jest wykres heksagonalny?
Wykres heksagonalny (ang. hexbin plot, hexagonal binning) to dwuwymiarowy histogram. Płaszczyznę dwóch zmiennych ilościowych dzieli się na sześciokątne komórki, zlicza obserwacje w każdej z nich i koloruje komórkę według liczebności. Zastępuje wykres rozrzutu, gdy obserwacji jest tak dużo, że punkty nakładają się na siebie (ang. overplotting) i chmura zlewa się w jednolitą plamę. Sześciokąt jest bliższy kołu niż kwadrat, więc punkty w komórce leżą w podobnej odległości od jej środka niezależnie od kierunku.
Pokrewny jest wykres konturowy gęstości dwuwymiarowej: zamiast zliczeń rysuje się poziomice gładkiej powierzchni z estymatora jądrowego, podobnie jak na mapie wysokości terenu. Sheather (2004) opisuje praktyczne stosowanie metod jądrowych.
Kiedy go użyć
- Tysiące obserwacji – duże ankiety, rejestry, dane z aplikacji – gdy nawet półprzezroczyste punkty dają jednolitą plamę.
- Pytanie „gdzie jest najwięcej osób?” – skupiska, drugi szczyt, obszary puste.
- Nie przy kilkuset obserwacjach – wtedy wystarczy wykres rozrzutu, a heksagony ukryłyby pojedyncze punkty.
Dang i in. (2010) zwracają uwagę, że wszystkie typowe sposoby radzenia sobie z nakładaniem punktów – pole, kolor albo agregacja (histogramy, gęstości jądrowe) – mają wady: liczebność odczytana z koloru lub pola jest zniekształcona, a rozróżnialnych odcieni jest mniej niż rozróżnialnych długości.
Przykład
Symulowano wyniki 20 000 uczniów z matematyki i czytania (w punktach). U 18 000 wyniki mają rozkład normalny (średnia 50, odchylenie standardowe 10) i korelują na poziomie .5. Pozostałe 2 000 osób tworzy zwartą grupę z wynikami około 62 punktów z matematyki i 46 z czytania – np. uczniowie klas o profilu matematycznym. Położenie i rozrzut tej grupy ustawiono ręcznie tak, by schowała się w chmurze punktów; ziarna (742) nie zmieniano. W całej próbie korelacja wynosi r = .42.
Na rysunku
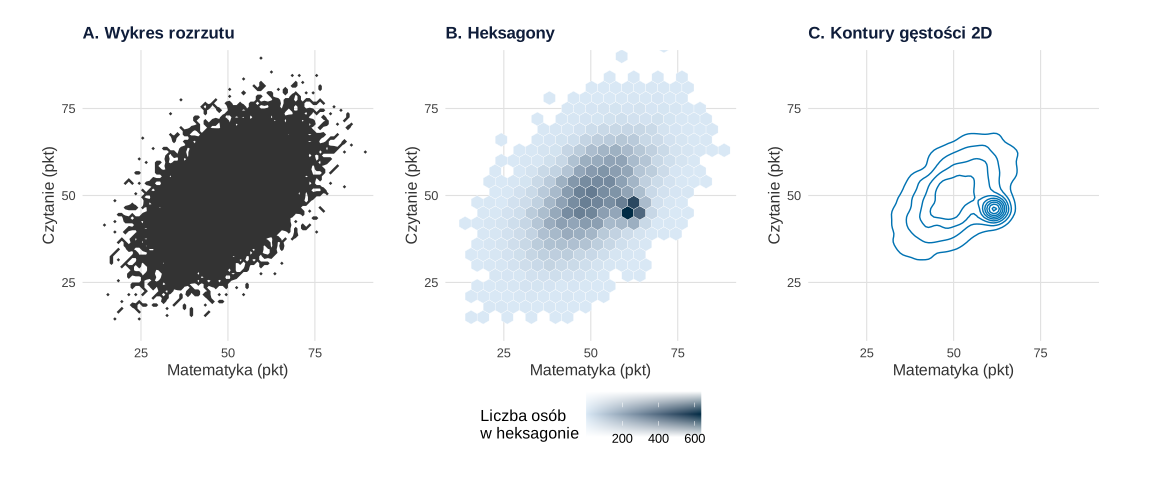
set.seed(742)).Co widać. W panelu A punkty zlewają się w ciemną plamę. Widać tylko zarys chmury i kilka odległych punktów, ale nie to, gdzie leży najwięcej osób. Panel B dzieli płaszczyznę na 340 heksagonów o promieniu 2 punktów. W najgęstszym, o środku przy 61 punktach z matematyki i 45 z czytania, jest 635 osób, a połowa heksagonów ma najwyżej 13 osób. Ukryta grupa jest więc ciemną plamą poza środkiem głównej chmury. Panel C pokazuje to samo jako ciasne skupisko poziomic, czyli drugi szczyt gęstości.
Na co uważać. Obraz zależy od wielkości komórki. Przy promieniu 1 punktu heksagonów jest 1075, a największy liczy 217 osób; przy promieniu 4 – tylko 99 heksagonów, a największy 1665 osób. Za duże komórki rozmyją małą grupę, za małe dadzą szum. Kontury zależą w ten sam sposób od szerokości pasma – jak gęstość jednej zmiennej we wpisie Rozkład zmiennej na wykresie. Najbardziej zewnętrzna poziomica pomija rzadkie obszary, a heksagony nie pokazują, która obserwacja jest odstająca.
Podpis do pracy:
Jak opisać w pracy
Na co uważać
- Tęczowa skala barw. Używaj skali od jasnego do ciemnego odcienia jednej barwy – czytelnej też w druku czarno-białym i dla osób z zaburzeniami widzenia barw. Zawsze dodaj legendę z liczbami.
- Różne jednostki osi. Heksagony liczone w surowych jednostkach są „rozciągnięte”, gdy osie mają bardzo różny zakres. Wybierz rozmiar komórki osobno dla każdej osi albo licz w wynikach standaryzowanych.
- Jedna wielkość komórki. Sprawdź dwie, trzy wielkości i podaj wybraną w podpisie. Wybór szerokości komórek i pasma omawia szczegółowo monografia Scotta (1992).
Przy kilku zmiennych heksagony można wstawić do komórek macierzy wykresów rozrzutu; mniejsze zbiory i nakładanie się punktów w danych z ankiet pokazuje wpis Korelacje na wykresie.
Wykres heksagonalny w R
Heksagony liczymy ręcznie, żeby było widać, co robi algorytm: dwie przesunięte siatki prostokątne i przypisanie punktu do bliższego środka. Gotową wersję daje funkcja geom_hex() z ggplot2. Kontury rysuje geom_density_2d(), która korzysta z funkcji kde2d() z pakietu MASS. Panel A zapisano jako obszar, w którym leży choć jeden punkt: zwykły geom_point() daje ten sam obraz, ale plik z 20 000 punktów byłby bardzo duży. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne.
Rozrzut, heksagony i kontury dla 20 000 punktów
R
# Wykres heksagonalny: 20 000 punktów jako zwykły rozrzut, heksagony i kontury gęstości dwuwymiarowej
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
motyw <- theme_minimal(base_size = 12) + theme(panel.grid.minor = element_blank())
set.seed(742)                                      # 18 000 uczniów + ukryta grupa 2 000 o podobnych wynikach
n1 <- 18000; n2 <- 2000
z1 <- rnorm(n1); z2 <- 0.5 * z1 + sqrt(1 - 0.5^2) * rnorm(n1)
d <- data.frame(mat = c(50 + 10 * z1, rnorm(n2, 62, 2)),
                czyt = c(50 + 10 * z2, rnorm(n2, 46, 2)))
nrow(d); round(cor(d$mat, d$czyt), 2)
# heksagony liczone ręcznie: dwie przesunięte siatki prostokątne, punkt trafia do bliższego środka
hex_licz <- function(x, y, r) {                    # r – promień heksagonu (w jednostkach osi)
  dx <- sqrt(3) * r; dy <- 3 * r
  ax <- round(x / dx) * dx;             ay <- round(y / dy) * dy
  bx <- round(x / dx - 0.5 + 1e-9) * dx + dx / 2
  by <- round(y / dy - 0.5 + 1e-9) * dy + dy / 2
  a_blizej <- (x - ax)^2 + (y - ay)^2 <= (x - bx)^2 + (y - by)^2
  cx <- round(ifelse(a_blizej, ax, bx), 6); cy <- round(ifelse(a_blizej, ay, by), 6)
  h <- aggregate(list(n = rep(1, length(x))), list(cx = cx, cy = cy), sum)
  h$id <- seq_len(nrow(h))
  kat <- seq(30, 330, by = 60) * pi / 180         # wierzchołki heksagonu „ostrym końcem do góry”
  w <- h[rep(h$id, each = 6), ]
  w$px <- w$cx + r * cos(kat); w$py <- w$cy + r * sin(kat)
  list(srodki = h, wierzcholki = w)
}
hx <- hex_licz(d$mat, d$czyt, r = 2)
c(heksagony = nrow(hx$srodki), max_n = max(hx$srodki$n), mediana_n = median(hx$srodki$n))
hx$srodki[which.max(hx$srodki$n), c("cx", "cy", "n")]
sapply(c(r_1 = 1, r_2 = 2, r_4 = 4), function(r) {           # wielkość heksagonu zmienia obraz
  h <- hex_licz(d$mat, d$czyt, r)$srodki; c(heksagony = nrow(h), max_n = max(h$n)) })
# A: zwykły rozrzut – obszar, w którym leży choć jeden punkt (geom_point() daje ten sam obraz,
#    ale plik z 20 000 punktów jest bardzo duży, więc punkty zliczono w drobnej siatce)
siatka <- as.data.frame(table(kx = cut(d$mat, 0:100), ky = cut(d$czyt, 0:100)))   # komórki 1 × 1 pkt
siatka$x <- as.integer(siatka$kx) - 0.5; siatka$y <- as.integer(siatka$ky) - 0.5
osie <- list(coord_equal(xlim = c(12, 88), ylim = c(12, 88)), labs(x = "Matematyka (pkt)", y = "Czytanie (pkt)"))
pA <- ggplot(siatka, aes(x, y, z = Freq)) +
  geom_contour_filled(breaks = c(0.5, Inf), fill = "grey20", show.legend = FALSE) +
  osie + labs(title = "A. Wykres rozrzutu")
pB <- ggplot(hx$wierzcholki, aes(px, py, group = id, fill = n)) + geom_polygon(colour = "white", linewidth = 0.1) +
  scale_fill_gradient(low = "#D9E8F5", high = "#002B44", name = "Liczba osób\nw heksagonie") +
  osie + labs(title = "B. Heksagony")
pC <- ggplot(d, aes(mat, czyt)) + geom_density_2d(colour = "#0072B2", bins = 10, linewidth = 0.5) +
  osie + labs(title = "C. Kontury gęstości 2D")
p1 <- (pA + pB + pC) & motyw & theme(legend.position = "bottom")
p1
Wynik w R
[1] 20000
[1] 0.42
heksagony     max_n mediana_n
      340       635        13
          cx cy   n
145 60.62178 45 635
           r_1 r_2  r_4
heksagony 1075 340   99
max_n      217 635 1665
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje bazowe rnorm(), aggregate(), table(); rysunek – pakiety ggplot2 i patchwork, kontury przez MASS). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
Najczęstsze pytania
Kiedy zamiast wykresu rozrzutu użyć wykresu heksagonalnego?
Gdy obserwacji jest tak dużo, że nawet półprzezroczyste punkty zlewają się w plamę – zwykle od kilku tysięcy wzwyż. Przy kilkuset obserwacjach lepszy jest zwykły wykres rozrzutu, bo pokazuje każdą osobę.
Jak dobrać wielkość heksagonu?
Sprawdź kilka wielkości. W przykładzie przy promieniu 1 punktu było 1075 heksagonów z maksimum 217 osób, a przy promieniu 4 – 99 heksagonów z maksimum 1665. Za duże komórki rozmywają małe skupiska, za małe dają szum.
Czym kontury gęstości różnią się od heksagonów?
Heksagony pokazują surowe zliczenia w komórkach, a kontury – poziomice gładkiej gęstości z estymatora jądrowego. Kontury wyglądają czyściej, ale zależą od szerokości pasma i pomijają rzadkie obszary na obrzeżach chmury.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Korelacje na wykresie
Mapa cieplna w dobrej kolejności, korekta zamiast gwiazdek, ggpairs ujawniający próg i sufit oraz korelacje z przedziałami ufności – pięć rysunków z kodem R.
Czytaj →PoradnikRozkład zmiennej na wykresie
Histogram przy czterech szerokościach przedziału, gęstość za gładka i za szorstka, ECDF, dwie grupy i skala Likerta – sześć rysunków z kodem R.
Czytaj →PoradnikWykresy w pracy dyplomowej
Jaki wykres do jakich danych, błędy źle → dobrze, podpis rysunku i gotowe zdania opisu wykresu w rozdziale wyników.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Dang, T. N., Wilkinson, L., & Anand, A. (2010). Stacking graphic elements to avoid over-plotting. IEEE Transactions on Visualization and Computer Graphics, 16(6), 1044–1052. https://doi.org/10.1109/tvcg.2010.197
- Scott, D. W. (1992). Multivariate density estimation: Theory, practice, and visualization. Wiley. https://doi.org/10.1002/9780470316849
- Sheather, S. J. (2004). Density estimation. Statistical Science, 19(4), 588–597. https://doi.org/10.1214/088342304000000297
Cytowania BibTeX
@article{dang2010stacking, author={Dang, Tuan Nhon and Wilkinson, Leland and Anand, Anushka}, title={{Stacking graphic elements to avoid over-plotting}}, journal={IEEE Transactions on Visualization and Computer Graphics}, year={2010}, volume={16}, number={6}, pages={1044--1052}, doi={10.1109/tvcg.2010.197}}@book{scott1992multivariate, author={Scott, David W.}, title={{Multivariate density estimation: Theory, practice, and visualization}}, year={1992}, publisher={Wiley}, doi={10.1002/9780470316849}}@article{sheather2004density, author={Sheather, Simon J.}, title={{Density estimation}}, journal={Statistical Science}, year={2004}, volume={19}, number={4}, pages={588--597}, doi={10.1214/088342304000000297}}