Po co rysować macierz korelacji
Dwanaście zmiennych to 66 współczynników korelacji. W macierzy korelacji zapisanej jako tabela trudno zobaczyć, które zmienne tworzą bloki, które korelacje są ujemne i gdzie kryje się coś nietypowego. Rysunek odpowiada na trzy pytania, na które tabela odpowiada słabo:
- Jaka jest struktura? Które zmienne korelują ze sobą najsilniej – odpowiada mapa cieplna korelacji z dobrze dobraną kolejnością zmiennych (rysunki 1–2).
- Czy jeden współczynnik dobrze opisuje związek? Korelacja Pearsona mierzy tylko związek liniowy, więc kształt chmury punktów trzeba zobaczyć w macierzy wykresów rozrzutu (rysunek 4).
- Jak dokładne są oszacowania? Odpowiada wykres punktowy z przedziałami ufności (rysunek 5).
Ten wpis nie powtarza ogólnych zasad – jak dobrać typ wykresu i opisać rysunek w pracy, piszemy we wpisie wykresy w pracy dyplomowej, a o kolorach, eksporcie i podpisach do artykułu – w tekście tabele i rysunki do artykułu. Tu pokazujemy pięć rysunków jednej macierzy i kod R, który je tworzy. Przy każdym rysunku znajdziesz cztery części: co widać, czego wykres nie pokazuje, gotowy podpis i zdanie do Wyników.
Przykład: wypalenie, zaangażowanie i dziesięć innych liczb
Dane są fikcyjne (symulowane): 240 osób studiujących wypełniło dwie skale, każdą z trzema podskalami (średnie z pozycji, 1–5). Skala wypalenia akademickiego ma podskale wyczerpanie, cynizm i nieskuteczność, a skala zaangażowania w naukę – wigor, oddanie i pochłonięcie. Do tego sześć zmiennych opisowych: wiek, rok studiów, liczba godzin pracy zarobkowej w tygodniu, liczba godzin snu, średnia ocen i satysfakcja z kierunku (jedno pytanie 1–5). Plik CSV pobierzesz w pierwszym bloku kodu. W danych celowo umieściliśmy dwie pułapki: prawie połowa osób nie pracuje zarobkowo, a satysfakcja z kierunku ma wyraźny sufit.
Rysunek 1: kolejność zmiennych decyduje, co zobaczysz
Program zwykle ustawia zmienne w kolejności z pliku albo alfabetycznie. Rysunek 1 pokazuje dolny trójkąt macierzy (górny tylko by go powtarzał) z wartościami r w polach. Skala barw jest rozbieżna i symetryczna wokół zera: biel oznacza brak związku, niebieski – korelację ujemną, pomarańczowy – dodatnią, a granice to −1 i 1, a nie najmniejsza i największa wartość w danych. Paletę oparto na kolorach Okabe–Ito.
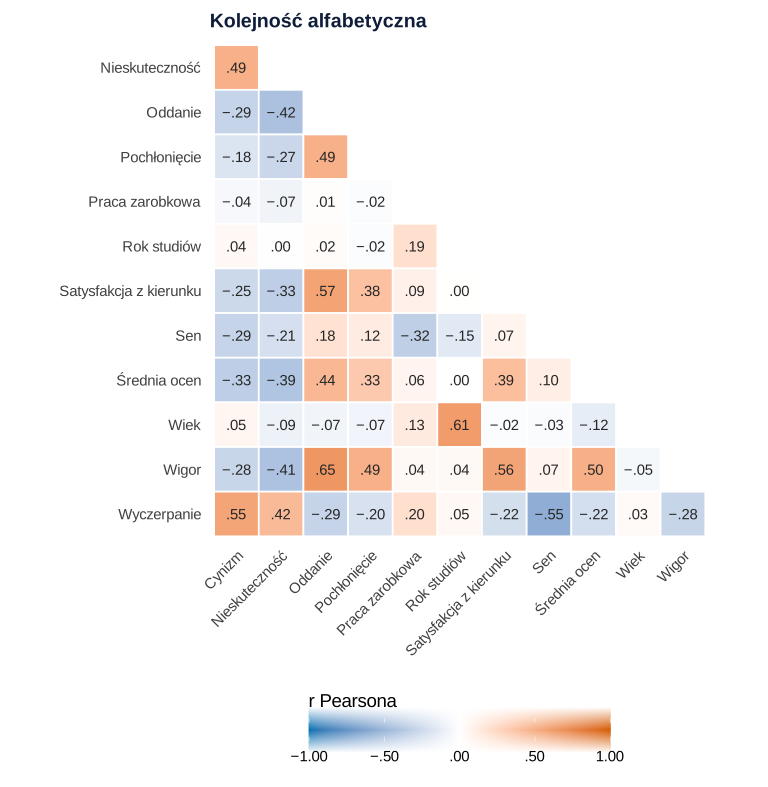
Co widać. Korelacje od −.55 do .65. Najsilniejsza para, wigor i oddanie (r = .65), leży w lewym dolnym rogu, a trzy podskale wypalenia są rozrzucone: cynizm w pierwszej kolumnie, nieskuteczność w drugiej, wyczerpanie w ostatnim wierszu. Kolory tworzą szachownicę, z której nie da się odczytać, że w danych są dwie skale.
Czego ten wykres nie pokazuje. Struktury – bo zależy ona od kolejności, a alfabet nic o danych nie wie. Wystarczy, że zmienną nazwiesz inaczej (np. „Zaangażowanie – wigor”), a obraz się zmieni. Mapa nie mówi też nic o kształcie związków, liczebności ani istotności.
Podpis do pracy (jeśli zostajesz przy kolejności z kwestionariusza, napisz to w nocie):
Zdanie do Wyników. Przy tej kolejności zmiennych dobre zdanie trudno napisać – dlatego zamiast niego zmień kolejność (rysunek 2).
Kod rysunku 1: mapa cieplna w ggplot2
Pobierz plik korelacje-na-wykresie-dane.csv (240 osób, dane symulowane), zapisz go w katalogu roboczym R i uruchamiaj kod rysunków po kolei w jednej sesji – kolejne bloki korzystają z obiektów i funkcji utworzonych wcześniej (motyw, paleta, funkcja trojkat()). Rysunki na tej stronie powstały dokładnie z tego kodu: motyw motyw to skrócona wersja motywu serwisu, a pliki zapisano w formacie SVG (w kodzie – zakomentowane wywołanie ggsave()). Ziarno danych (565) i ziarno danych bez związków (2026) ustalono raz, bez dobierania pod wynik.
1. Macierz korelacji, motyw, paleta i mapa w kolejności alfabetycznej
R
# Rysunek 1. Mapa cieplna 12 zmiennych w kolejności alfabetycznej (dane symulowane, N = 240)
library(ggplot2)
dane <- read.csv("korelacje-na-wykresie-dane.csv")
nazwy <- c(wyczerpanie = "Wyczerpanie", cynizm = "Cynizm", nieskutecznosc = "Nieskuteczność",
           wigor = "Wigor", oddanie = "Oddanie", pochloniecie = "Pochłonięcie", wiek = "Wiek",
           rok_studiow = "Rok studiów", praca_h = "Praca zarobkowa", sen_h = "Sen",
           srednia_ocen = "Średnia ocen", satysfakcja = "Satysfakcja z kierunku")
X <- dane[, names(nazwy)]
R <- cor(X)                                  # Pearson; braków danych tu nie ma
dimnames(R) <- list(unname(nazwy), unname(nazwy))

# Motyw i paleta (rozbieżna, symetryczna wokół 0, czytelna przy zaburzeniach widzenia barw)
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.05)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        axis.text = element_text(colour = "grey25"), legend.position = "bottom", legend.title.position = "top",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
napis_r <- function(r) {                     # zapis APA: bez zera wiodącego, z minusem typograficznym
  s <- sprintf("%.2f", round(r, 2) + 0)      # + 0 zamienia −0.00 na 0.00
  sub("-", "−", sub("^(-?)0\\.", "\\1.", s))
}
skala_r <- scale_fill_gradient2(low = "#0072B2", mid = "white", high = "#D55E00", midpoint = 0, limits = c(-1, 1),
                                breaks = seq(-1, 1, 0.5), labels = napis_r, na.value = "white", name = "r Pearsona")

# Dolny trójkąt macierzy w zadanej kolejności zmiennych -> format długi dla ggplot
trojkat <- function(R, kolejnosc) {
  R <- R[kolejnosc, kolejnosc]
  d <- expand.grid(wiersz = rownames(R), kolumna = colnames(R), stringsAsFactors = FALSE)
  d$r <- as.vector(R)
  d <- d[match(d$wiersz, kolejnosc) > match(d$kolumna, kolejnosc), ]   # tylko pod przekątną
  d$wiersz  <- factor(d$wiersz, levels = rev(kolejnosc))
  d$kolumna <- factor(d$kolumna, levels = kolejnosc)
  d
}
alfabet <- sort(unname(nazwy))               # kolejność alfabetyczna
d1 <- trojkat(R, alfabet)
p1 <- ggplot(d1, aes(kolumna, wiersz, fill = r)) +
  geom_tile(colour = "white", linewidth = 0.6) +
  geom_text(aes(label = napis_r(r)), size = 3.9, colour = "grey15") +
  skala_r + coord_equal() + labs(x = NULL, y = NULL, title = "Kolejność alfabetyczna") + motyw +
  theme(axis.text.x = element_text(angle = 45, hjust = 1), panel.grid.major = element_blank(),
        legend.key.width = unit(1.6, "cm"))
# p1   # wyświetl; zapis: ggsave("mapa-alfabetycznie.svg", p1, width = 8, height = 8.2)

alfabet
c(liczba_korelacji = nrow(d1), min_r = round(min(d1$r), 2), max_r = round(max(d1$r), 2))
Wynik w R
 [1] "Cynizm"                 "Nieskuteczność"         "Oddanie"
 [4] "Pochłonięcie"           "Praca zarobkowa"        "Rok studiów"
 [7] "Satysfakcja z kierunku" "Sen"                    "Średnia ocen"
[10] "Wiek"                   "Wigor"                  "Wyczerpanie"
liczba_korelacji            min_r            max_r
           66.00            -0.55             0.65
Rysunek 2: kolejność z grupowania hierarchicznego
Friendly (2002) zaproponował dwie zasady rysowania macierzy korelacji: zakoduj znak i siłę współczynnika symbolem lub kolorem i ustaw zmienne tak, by podobne leżały obok siebie. Druga zasada pochodzi z map cieplnych z drzewami grupowania, których historię opisali Wilkinson i Friendly (2009). W praktyce: policz odległość między zmiennymi jako 1 − r, zbuduj drzewo metodą średniego wiązania (hclust(..., "average")) i ustaw zmienne w kolejności liści drzewa. To ta sama logika co w analizie skupień, tyle że grupujesz zmienne, a nie osoby.
Gotowe funkcje robią to jednym argumentem (ggcorrplot(R, hc.order = TRUE), corrplot(R, order = "hclust")), ale domyślnie metodą pełnego wiązania, więc kolejność może się nieco różnić. Ręczny kod pokazuje, co dokładnie się dzieje.
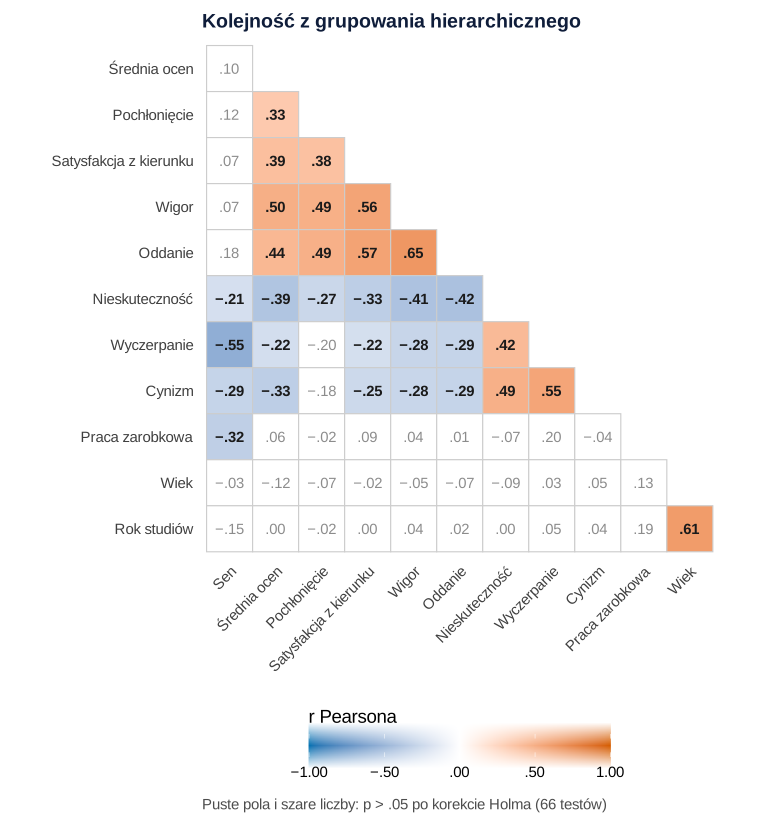
Co widać. Po cięciu drzewa na cztery części powstały grupy: zaangażowanie razem ze średnią ocen i satysfakcją z kierunku, trzy podskale wypalenia, wiek z rokiem studiów i pracą zarobkową oraz sen osobno. Bloki są teraz widoczne gołym okiem, a między nimi leży pas korelacji ujemnych (np. nieskuteczność z oddaniem, r = −.42). Ze 66 korelacji 38 miało p < .05 bez korekty, a 31 po poprawce Holma (Holm, 1979). Najsilniejsza korelacja, która nie przetrwała korekty, wynosi |r| = .20.
Czego ten wykres nie pokazuje. Grupowanie nie jest analizą czynnikową – ułatwia oglądanie, ale nie dowodzi, że zmienne mierzą wspólny czynnik. Kolejność nie jest też jedyna: gałęzie drzewa można obracać, a inna miara odległości daje inny układ. Przy 1 − |r| (bez znaku) sen trafia obok wypalenia, bo z wyczerpaniem koreluje ujemnie (r = −.55). Wybierz miarę przed rysowaniem i podaj ją w nocie. Puste pole nie znaczy „brak związku”, tylko „nie wykazano go przy tej korekcie”.
Podpis do pracy:
Zdanie do Wyników:
Kod rysunku 2: kolejność z drzewa i korekta Holma
2. Grupowanie hierarchiczne zmiennych, wartości p i korekty
R
# Rysunek 2. Ta sama macierz: kolejność z grupowania hierarchicznego i korekta Holma (kontynuacja: X, R, nazwy, trojkat, skala_r, napis_r, motyw)
drzewo <- hclust(as.dist(1 - R), method = "average")   # odległość 1 − r: silna korelacja dodatnia = blisko
kolejnosc <- rownames(R)[drzewo$order]
kolejnosc
cutree(drzewo, k = 4)[kolejnosc]                        # grupy zmiennych po cięciu drzewa na 4 części

# wartości p dla wszystkich 66 par i korekty na wielokrotne testowanie
pary <- t(combn(ncol(X), 2))
p <- apply(pary, 1, function(ij) cor.test(X[, ij[1]], X[, ij[2]])$p.value)
p_holm <- p.adjust(p, method = "holm")
c(testy = length(p), p_ponizej_05 = sum(p < .05), po_Holmie = sum(p_holm < .05),
  po_BH = sum(p.adjust(p, method = "BH") < .05))
P <- matrix(NA, ncol(X), ncol(X), dimnames = dimnames(R))
P[pary] <- p_holm; P[pary[, 2:1]] <- p_holm

d2 <- trojkat(R, kolejnosc)
d2$istotna <- P[cbind(as.character(d2$wiersz), as.character(d2$kolumna))] < .05
c(istotne_w_pol_Holm = sum(d2$istotna), max_abs_r_nieistotna = round(max(abs(d2$r[!d2$istotna])), 2))
p2 <- ggplot(d2, aes(kolumna, wiersz)) +
  geom_tile(aes(fill = ifelse(istotna, r, NA)), colour = "grey80", linewidth = 0.4) +
  geom_text(aes(label = napis_r(r), colour = istotna, fontface = ifelse(istotna, "bold", "plain")),
            size = 3.9, show.legend = FALSE) +
  scale_colour_manual(values = c(`TRUE` = "grey10", `FALSE` = "grey55")) +
  skala_r +                                              # pola nieistotne (NA) zostają białe
  coord_equal() + labs(x = NULL, y = NULL, title = "Kolejność z grupowania hierarchicznego",
                       caption = "Puste pola i szare liczby: p > .05 po korekcie Holma (66 testów)") + motyw +
  theme(axis.text.x = element_text(angle = 45, hjust = 1), panel.grid.major = element_blank(),
        legend.key.width = unit(1.6, "cm"), plot.caption = element_text(colour = "grey30", hjust = 0))
# p2   # zapis: ggsave("mapa-grupowanie.svg", p2, width = 8, height = 8.6)

# dla porównania: odległość 1 − |r| ustawia obok siebie także zmienne skorelowane ujemnie
rownames(R)[hclust(as.dist(1 - abs(R)), method = "average")$order]
Wynik w R
 [1] "Sen"                    "Średnia ocen"           "Pochłonięcie"
 [4] "Satysfakcja z kierunku" "Wigor"                  "Oddanie"
 [7] "Nieskuteczność"         "Wyczerpanie"            "Cynizm"
[10] "Praca zarobkowa"        "Wiek"                   "Rok studiów"
                   Sen           Średnia ocen           Pochłonięcie
                     4                      2                      2
Satysfakcja z kierunku                  Wigor                Oddanie
                     2                      2                      2
        Nieskuteczność            Wyczerpanie                 Cynizm
                     1                      1                      1
       Praca zarobkowa                   Wiek            Rok studiów
                     3                      3                      3
       testy p_ponizej_05    po_Holmie        po_BH
          66           38           31           37
  istotne_w_pol_Holm max_abs_r_nieistotna
                31.0                  0.2
 [1] "Średnia ocen"           "Pochłonięcie"           "Satysfakcja z kierunku"
 [4] "Wigor"                  "Oddanie"                "Sen"
 [7] "Nieskuteczność"         "Wyczerpanie"            "Cynizm"
[10] "Praca zarobkowa"        "Wiek"                   "Rok studiów"
Rysunek 3: dlaczego nie gwiazdki
Gwiazdki przy korelacjach to skrót, który przy dużej macierzy myli. Każda gwiazdka to osobny test na poziomie .05, a w macierzy 12 zmiennych testów jest 66. Gdyby wszystkie hipotezy zerowe były prawdziwe, średnio 3.3 korelacji dostałoby gwiazdkę przypadkiem – to problem wielokrotnych porównań. Rysunek 3 pokazuje to na danych, w których z definicji nie ma żadnych związków: 12 niezależnych zmiennych losowych dla 240 osób.
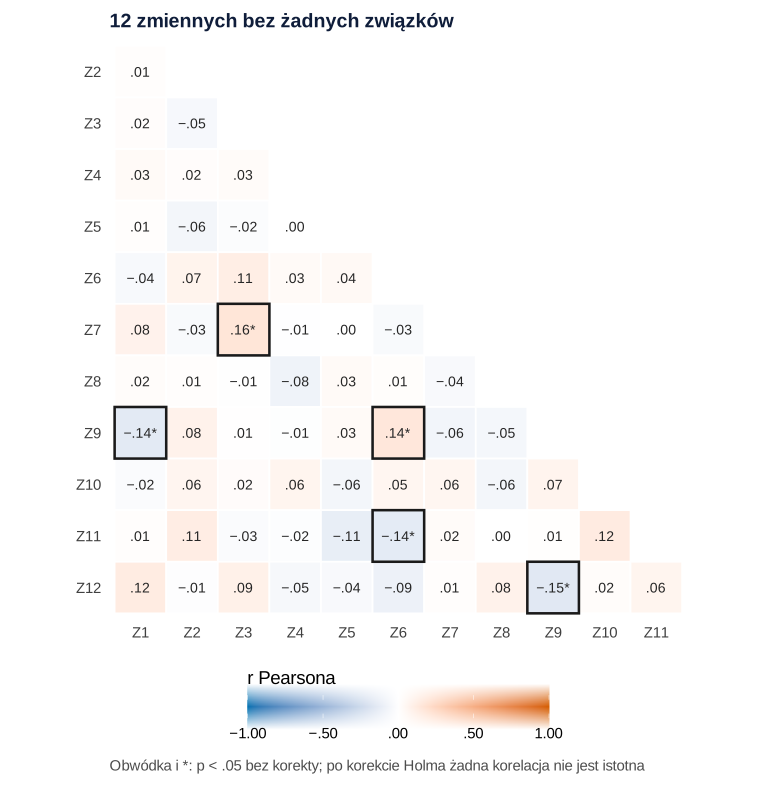
set.seed(2026)).Co widać. Pięć „istotnych” korelacji (|r| od .14 do .16, p od .016 do .036), choć żaden związek nie istnieje. Po korekcie Holma i po procedurze Benjaminiego–Hochberga (Benjamini i Hochberg, 1995) nie zostaje żadna. Gdyby 66 testów było niezależnych, szansa na co najmniej jedną fałszywą gwiazdkę wynosiłaby .966.
Czego ten wykres nie pokazuje. To jeden losowy zbiór – w innym gwiazdek może być dwie albo osiem. Rysunek nie mówi też, którą korektę wybrać: Holm kontroluje szansę choćby jednego błędu w całej rodzinie testów, a procedura Benjaminiego–Hochberga – oczekiwany odsetek fałszywych odkryć i daje więcej mocy. Więcej o tym, jak to ująć w tabeli, piszemy we wpisie jak opisać tabelę korelacji.
Podpis do pracy (rysunek przydaje się w aneksie lub w prezentacji na obronę, gdy ktoś pyta o korektę):
Zdanie do Wyników (w opisie metody analizy albo przed opisem macierzy):
Kod rysunku 3: gwiazdki w danych bez związków
3. Dwanaście niezależnych zmiennych i „istotne” korelacje
R
# Rysunek 3. Gwiazdki w danych bez żadnych związków: 12 niezależnych zmiennych, N = 240 (kontynuacja: trojkat, skala_r, napis_r, motyw)
set.seed(2026)                                    # ziarno ustalone raz, bez dobierania pod wynik
szum <- as.data.frame(matrix(rnorm(240 * 12), ncol = 12, dimnames = list(NULL, paste0("Z", 1:12))))
Rs <- cor(szum)
pary_s <- t(combn(12, 2))
p_s <- apply(pary_s, 1, function(ij) cor.test(szum[, ij[1]], szum[, ij[2]])$p.value)
c(testy = length(p_s), oczekiwane_falszywe = 66 * .05, p_ponizej_05 = sum(p_s < .05),
  po_Holmie = sum(p.adjust(p_s, "holm") < .05), po_BH = sum(p.adjust(p_s, "BH") < .05))
round(1 - .95^66, 3)                              # szansa na co najmniej jedną „gwiazdkę”, gdyby testy były niezależne
Ps <- matrix(NA, 12, 12, dimnames = dimnames(Rs)); Ps[pary_s] <- p_s; Ps[pary_s[, 2:1]] <- p_s
d3 <- trojkat(Rs, colnames(Rs))
d3$p <- Ps[cbind(as.character(d3$wiersz), as.character(d3$kolumna))]
d3$gwiazdki <- ifelse(d3$p < .001, "***", ifelse(d3$p < .01, "**", ifelse(d3$p < .05, "*", "")))
d3[d3$gwiazdki != "", c("wiersz", "kolumna", "r", "p")] |> transform(r = round(r, 2), p = round(p, 3))

p3 <- ggplot(d3, aes(kolumna, wiersz, fill = r)) +
  geom_tile(colour = "white", linewidth = 0.6) +
  geom_tile(data = subset(d3, gwiazdki != ""), colour = "grey10", linewidth = 0.9, fill = NA) +   # obwódka = gwiazdka
  geom_text(aes(label = paste0(napis_r(r), gwiazdki)), size = 3.7, colour = "grey15") +
  skala_r + coord_equal() +
  labs(x = NULL, y = NULL, title = "12 zmiennych bez żadnych związków",
       caption = "Obwódka i *: p < .05 bez korekty; po korekcie Holma żadna korelacja nie jest istotna") + motyw +
  theme(panel.grid.major = element_blank(), legend.key.width = unit(1.6, "cm"),
        plot.caption = element_text(colour = "grey30", hjust = 0))
# p3   # zapis: ggsave("gwiazdki-w-szumie.svg", p3, width = 8, height = 8.2)
Wynik w R
              testy oczekiwane_falszywe        p_ponizej_05           po_Holmie
               66.0                 3.3                 5.0                 0.0
              po_BH
                0.0
[1] 0.966
    wiersz kolumna     r     p
9       Z9      Z1 -0.14 0.031
31      Z7      Z3  0.16 0.016
69      Z9      Z6  0.14 0.026
71     Z11      Z6 -0.14 0.036
108    Z12      Z9 -0.15 0.020
Rysunek 4: macierz wykresów rozrzutu
Mapa cieplna pokazuje liczby, ale nie dane. Ten sam współczynnik może opisywać zupełnie różne chmury punktów – klasyczny przykład omawiamy we wpisie o kwartecie Anscombe’a. Dlatego dla kilku kluczowych zmiennych narysuj macierz wykresów rozrzutu. Funkcja ggpairs() z pakietu GGally rysuje pod przekątną pary zmiennych, na przekątnej rozkłady, a nad przekątną liczby. Emerson i in. (2013) opisują ją jako uogólnienie macierzy wykresów rozrzutu, które pozwala dobrać typ wykresu do rodzaju zmiennych. Przy czterech, pięciu zmiennych rysunek jest czytelny; przy dwunastu – już nie.
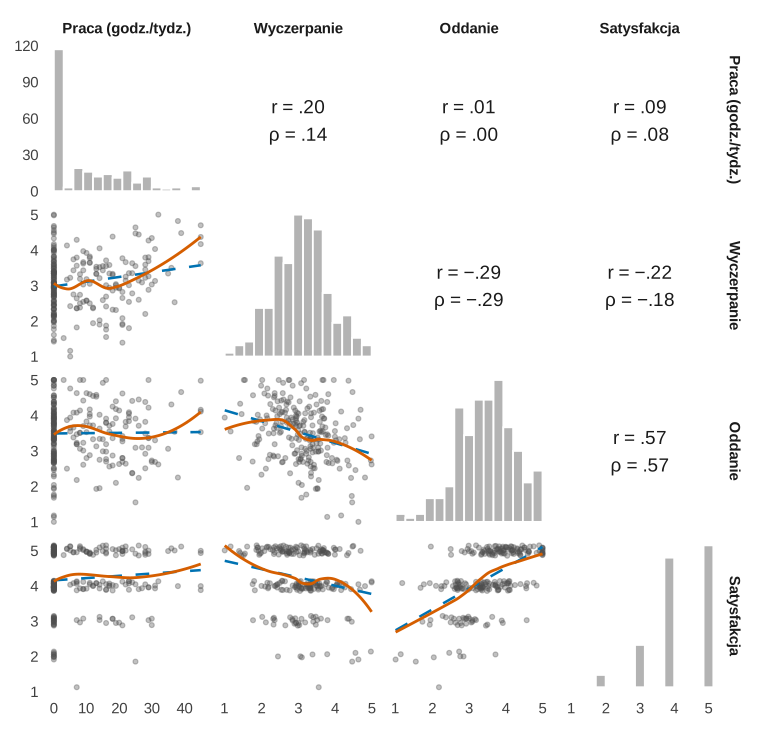
Co widać. Dwie rzeczy, których mapa cieplna nie zdradzi. Po pierwsze, 48.8% osób nie pracuje zarobkowo (słupek przy zerze), a krzywa loess dla wyczerpania jest płaska do około 20 godzin w tygodniu i dopiero potem rośnie. Do 20 godzin korelacja wynosi −.04, a średnie wyczerpanie to 3.03 wobec 3.38 u 48 osób pracujących dłużej. Współczynnik r = .20 uśrednia te dwa obrazy, a Spearman daje ρ = .14. Po drugie, satysfakcja z kierunku ma efekt sufitu: 43.3% osób zaznaczyło 5, więc wśród najbardziej oddanych nauką odpowiedzi nie mogą już rosnąć i krzywa się spłaszcza.
Czego ten wykres nie pokazuje. Mechanizmu. Związek pracy z wyczerpaniem może wynikać z trzeciej zmiennej (np. roku studiów) – korelacja to nie przyczynowość. Krzywa loess na końcach zakresu opiera się na kilku punktach, więc jej „zakręty” przy 40 godzinach nie są wynikiem. Przy zmiennej 1–5 punkty trzeba lekko rozrzucić (jitter), inaczej setki osób nakładają się w kilku miejscach.
Podpis do pracy:
Zdanie do Wyników:
Kod rysunku 4: macierz wykresów rozrzutu (GGally)
4. ggpairs() z własnymi panelami
R
# Rysunek 4. Macierz wykresów rozrzutu dla 4 zmiennych (kontynuacja: dane, motyw, napis_r)
library(GGally)
wybrane <- c(praca_h = "Praca (godz./tydz.)", wyczerpanie = "Wyczerpanie", oddanie = "Oddanie",
             satysfakcja = "Satysfakcja")
d4 <- setNames(dane[, names(wybrane)], wybrane)

# pod przekątną: punkty (rozrzucone tylko przy zmiennej 1–5), prosta (linia przerywana) i krzywa loess
rozrzut <- function(data, mapping, ...) {
  x <- eval_data_col(data, mapping$x); y <- eval_data_col(data, mapping$y)
  ggplot(data, mapping) +
    geom_point(position = position_jitter(width  = if (length(unique(x)) <= 5) 0.15 else 0,
                                          height = if (length(unique(y)) <= 5) 0.15 else 0, seed = 1),
               alpha = 0.35, size = 1.3, colour = "grey30") +
    geom_smooth(method = "lm", formula = y ~ x, se = FALSE, colour = "#0072B2", linetype = "dashed", linewidth = 0.9) +
    geom_smooth(method = "loess", formula = y ~ x, se = FALSE, colour = "#D55E00", linewidth = 1)
}
histogram <- function(data, mapping, ...) {
  ggplot(data, mapping) + geom_histogram(bins = 15, fill = "grey70", colour = "white")
}
# nad przekątną: r Pearsona i rho Spearmana (bez gwiazdek)
korelacje <- function(data, mapping, ...) {
  x <- eval_data_col(data, mapping$x); y <- eval_data_col(data, mapping$y)
  ggally_text(paste0("r = ", napis_r(cor(x, y)), "\nρ = ", napis_r(cor(x, y, method = "spearman"))),
              size = 5, colour = "grey10") + theme_void()
}
p4 <- ggpairs(d4, lower = list(continuous = rozrzut), diag = list(continuous = histogram),
              upper = list(continuous = korelacje), progress = FALSE) +
  motyw + theme(panel.grid.major = element_blank(), strip.text = element_text(face = "bold"))
# p4   # zapis: ggsave("macierz-rozrzutu.svg", p4, width = 8, height = 7.6)

# liczby, które widać na rysunku
round(c(praca_0_godz = mean(dane$praca_h == 0), satysfakcja_5 = mean(dane$satysfakcja == 5)), 3)
round(rbind(Pearson = cor(d4)[, "Wyczerpanie"], Spearman = cor(d4, method = "spearman")[, "Wyczerpanie"]), 2)
round(cor(d4$Oddanie, d4$Satysfakcja), 2)               # oddanie a satysfakcja
# związek progowy: wyczerpanie przy pracy do 20 godzin tygodniowo i powyżej
do20 <- dane$praca_h <= 20
round(c(r_do_20h = cor(dane$praca_h[do20], dane$wyczerpanie[do20]), M_do_20h = mean(dane$wyczerpanie[do20]),
        M_powyzej_20h = mean(dane$wyczerpanie[!do20]), n_powyzej_20h = sum(!do20)), 2)
# efekt sufitu: oddanie u osób z najwyższą i niższą satysfakcją
round(tapply(dane$oddanie, ifelse(dane$satysfakcja == 5, "satysfakcja_5", "satysfakcja_1_4"), mean), 2)
Wynik w R
 praca_0_godz satysfakcja_5
        0.488         0.433
         Praca (godz./tydz.) Wyczerpanie Oddanie Satysfakcja
Pearson                 0.20           1   -0.29       -0.22
Spearman                0.14           1   -0.29       -0.18
[1] 0.57
     r_do_20h      M_do_20h M_powyzej_20h n_powyzej_20h
        -0.04          3.03          3.38         48.00
satysfakcja_1_4   satysfakcja_5
           3.14            3.97
Rysunek 5: korelacje z przedziałami ufności
Gdy hipoteza dotyczy jednej zmiennej – tu wyczerpania – zamiast kolumny tabeli możesz pokazać jej korelacje jako punkty z 95% przedziałami ufności, posortowane od najsilniejszej ujemnej do najsilniejszej dodatniej. Przedział dla Pearsona daje cor.test() przez transformację Fishera z. Bonett i Wright (2000) omawiają przedziały ufności dla korelacji Pearsona, Kendalla i Spearmana i proponują ulepszony błąd standardowy dla korelacji Spearmana. W naszym kodzie przedział dla Spearmana liczymy przez tę samą transformację z błędem standardowym √((1 + ρ²/2)/(n − 3)) – to wzór używany w kodzie, nie cytat ze źródła. Kolor nie jest jedynym nośnikiem informacji: metody różnią się też kształtem punktu.
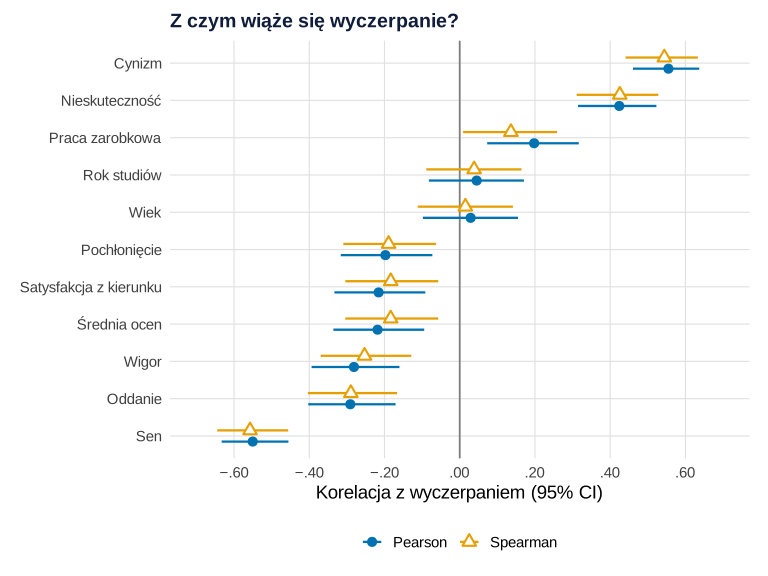
Co widać. Najsilniej z wyczerpaniem wiążą się sen (r = −.55, 95% CI [−.63, −.46]) i cynizm (r = .55, 95% CI [.46, .64]). Przy 240 osobach przedział dla korelacji bliskiej zera ma szerokość około .25 – dla wieku od −.10 do .16. Pearson i Spearman niemal się pokrywają, z wyjątkiem pracy zarobkowej (.20 wobec .14) oraz satysfakcji i średniej ocen (−.22 wobec −.18) – czyli tam, gdzie rysunek 4 pokazał próg i sufit.
Czego ten wykres nie pokazuje. Korelacji między pozostałymi zmiennymi – to widok jednej kolumny macierzy. Przedziały są nieskorygowane: dla pochłonięcia (−.20, 95% CI [−.32, −.07]) przedział nie obejmuje zera, choć po korekcie Holma tej korelacji nie uznano za istotną. Jeśli wnioskujesz z wielu przedziałów naraz, napisz o tym albo użyj przedziałów skorygowanych.
Podpis do pracy:
Zdanie do Wyników:
Kod rysunku 5: korelacje z przedziałami ufności
5. Pearson i Spearman z 95% CI dla jednej zmiennej
R
# Rysunek 5. Korelacje wyczerpania z 11 zmiennymi: punkty z 95% CI zamiast kolumny tabeli (kontynuacja: X, nazwy, motyw, napis_r)
n <- nrow(X)
ci_pearson <- t(sapply(setdiff(names(nazwy), "wyczerpanie"), function(v) {
  t <- cor.test(X$wyczerpanie, X[[v]]); c(r = unname(t$estimate), lo = t$conf.int[1], hi = t$conf.int[2])
}))
# Spearman: przedział z transformacji Fishera, błąd standardowy sqrt((1 + rs^2/2)/(n − 3))
ci_spearman <- t(sapply(setdiff(names(nazwy), "wyczerpanie"), function(v) {
  rs <- cor(X$wyczerpanie, X[[v]], method = "spearman")
  se <- sqrt((1 + rs^2 / 2) / (n - 3))
  c(r = rs, lo = tanh(atanh(rs) - qnorm(.975) * se), hi = tanh(atanh(rs) + qnorm(.975) * se))
}))
d5 <- rbind(data.frame(zmienna = nazwy[rownames(ci_pearson)], metoda = "Pearson", ci_pearson),
            data.frame(zmienna = nazwy[rownames(ci_spearman)], metoda = "Spearman", ci_spearman))
d5$zmienna <- factor(d5$zmienna, levels = nazwy[rownames(ci_pearson)][order(ci_pearson[, "r"])])
round(cbind(ci_pearson, rs = ci_spearman[, "r"], rs_lo = ci_spearman[, "lo"], rs_hi = ci_spearman[, "hi"]), 2)

p5 <- ggplot(d5, aes(r, zmienna, colour = metoda, shape = metoda)) +
  geom_vline(xintercept = 0, colour = "grey50") +
  geom_errorbar(aes(xmin = lo, xmax = hi), width = 0, linewidth = 0.8, orientation = "y",
                position = position_dodge(width = 0.6)) +
  geom_point(size = 2.8, fill = "white", stroke = 1.1, position = position_dodge(width = 0.6)) +
  scale_colour_manual(values = c(Pearson = "#0072B2", Spearman = "#E69F00"), name = NULL) +
  scale_shape_manual(values = c(Pearson = 16, Spearman = 24), name = NULL) +
  scale_x_continuous(limits = c(-0.7, 0.7), breaks = seq(-0.6, 0.6, 0.2), labels = napis_r) +
  labs(x = "Korelacja z wyczerpaniem (95% CI)", y = NULL, title = "Z czym wiąże się wyczerpanie?") + motyw
# p5   # zapis: ggsave("korelacje-z-przedzialami.svg", p5, width = 8, height = 6)
Wynik w R
                   r    lo    hi    rs rs_lo rs_hi
cynizm          0.55  0.46  0.64  0.54  0.44  0.63
nieskutecznosc  0.42  0.31  0.52  0.43  0.31  0.53
wigor          -0.28 -0.39 -0.16 -0.25 -0.37 -0.13
oddanie        -0.29 -0.40 -0.17 -0.29 -0.40 -0.17
pochloniecie   -0.20 -0.32 -0.07 -0.19 -0.31 -0.06
wiek            0.03 -0.10  0.16  0.01 -0.11  0.14
rok_studiow     0.05 -0.08  0.17  0.04 -0.09  0.16
praca_h         0.20  0.07  0.32  0.14  0.01  0.26
sen_h          -0.55 -0.63 -0.46 -0.56 -0.64 -0.46
srednia_ocen   -0.22 -0.34 -0.09 -0.18 -0.30 -0.06
satysfakcja    -0.22 -0.33 -0.09 -0.18 -0.30 -0.06
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (korelacje, testy, korekty i grupowanie – pakiet stats). Rysunki wykonano w ggplot2 i GGally i zapisano pakietem svglite; paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- GGally (wersja 2.4.0): Schloerke, B., Cook, D., Larmarange, J., Briatte, F., Marbach, M., Thoen, E., Elberg, A., & Crowley, J. (2025). GGally: Extension to 'ggplot2' (R package version 2.4.0) [Computer software]. https://doi.org/10.32614/CRAN.package.GGally
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Ile rysunków w pracy, a ile w aneksie
Pięć rysunków jednej macierzy to za dużo na rozdział Wyniki. Rozsądny podział:
- W tekście: jeden rysunek odpowiadający na pytanie badawcze – mapa w kolejności z grupowania (rysunek 2), gdy pytasz o strukturę, albo wykres z przedziałami (rysunek 5), gdy pytasz o jedną zmienną. Do tego tabela korelacji w APA z dokładnymi wartościami, bo z koloru nikt nie odczyta r do dwóch miejsc.
- W aneksie: pełna macierz z liczebnościami i przedziałami ufności oraz macierz wykresów rozrzutu, która uzasadnia decyzje (Spearman zamiast Pearsona, próg pracy zarobkowej).
- Tylko w Twoich plikach: rysunek w kolejności alfabetycznej i wersje z gwiazdkami.
Każda liczba powinna trafić do jednego miejsca: jeśli r są w tabeli, na mapie mogą zostać same kolory z notą „wartości – Tabela 2”. Paletę sprawdź w symulacji zaburzeń widzenia barw. Pakiet colorspace ma do tego funkcję deutan() i gotowe palety rozbieżne (Zeileis i in., 2020). Unikaj palety tęczowej i zestawienia czerwony–zielony, które zniekształcają odczyt i są nieczytelne dla części osób (Crameri i in., 2020). Nasza paleta po symulacji deuteranopii zostaje parą niebieski–oliwkowy, nadal łatwą do odróżnienia, a liczby w polach i tak niosą tę samą informację.
Najczęstsze błędy
- Skala barw od minimum do maksimum danych. Wtedy r = .10 może wyglądać jak silna korelacja. Ustal granice −1 i 1, z bielą w zerze.
- Kolejność alfabetyczna lub przypadkowa. Bloki zmiennych znikają (rysunek 1).
- Gwiazdki bez korekty przy kilkudziesięciu testach. W szumie pojawi się kilka „istotnych” korelacji (rysunek 3).
- Cała macierz kwadratowa z przekątną jedynek. Połowa rysunku powtarza drugą połowę.
- Sama mapa cieplna bez wykresów rozrzutu. Próg, sufit czy obserwacja odstająca kryją się pod jednym kolorem (rysunek 4).
- Grupy z drzewa opisane jak czynniki. Do tego potrzebna jest analiza czynnikowa, nie kolejność na rysunku.
- Brak informacji w nocie: jaki współczynnik, jakie N, jaka korekta, skąd kolejność zmiennych.
Najczęstsze pytania
Jak uporządkować zmienne na mapie cieplnej korelacji?
Najczęściej według grupowania hierarchicznego zmiennych: odległość 1 − r, drzewo z hclust() i kolejność liści (drzewo$order). Silnie skorelowane zmienne trafiają obok siebie i widać bloki, np. podskale jednej skali. Alternatywą jest kolejność teoretyczna (skala po skali); alfabetyczna zwykle rozrzuca podobne zmienne po całym rysunku.
Czy na mapie cieplnej korelacji zaznaczać istotność gwiazdkami?
Przy kilkudziesięciu korelacjach lepiej nie. Gwiazdka oznacza osobny test na poziomie .05, więc w 66 testach średnio 3.3 „istotne” wyniki pojawią się nawet bez żadnych związków. Zaznacz korelacje istotne po korekcie (np. Holma lub Benjaminiego–Hochberga) i napisz w nocie, jaką korektę zastosowałeś.
Jak zrobić macierz wykresów rozrzutu w R?
Najprościej funkcją ggpairs() z pakietu GGally: pod przekątną wykresy rozrzutu, na przekątnej rozkłady, nad przekątną współczynniki. Własne funkcje paneli pozwalają dodać krzywą loess, lekki rozrzut punktów dla zmiennych 1–5 i korelację Spearmana obok Pearsona. Wybierz 4–5 kluczowych zmiennych – przy dwunastu rysunek jest nieczytelny.
Czy mapę cieplną korelacji wstawić do pracy, czy do aneksu?
Do tekstu wstaw jeden rysunek, który odpowiada na pytanie badawcze (np. mapę uporządkowaną grupowaniem albo wykres korelacji z przedziałami ufności), a dokładne wartości – w tabeli korelacji w stylu APA. Pełną macierz z przedziałami i macierz wykresów rozrzutu przenieś do aneksu.
Jaka paleta barw do mapy korelacji jest czytelna przy daltonizmie?
Rozbieżną skalę dwóch barw z bielą w zerze i stałymi granicami −1 i 1, np. niebieski–pomarańczowy z palety Okabe–Ito. Unikaj palety tęczowej i pary czerwony–zielony, sprawdź rysunek w symulacji deuteranopii (colorspace::deutan()) i wpisz wartości r w pola, żeby kolor nie był jedynym nośnikiem informacji.
Powiązane hasła
Przeczytaj też
Ograniczony zakres zmiennej – wizualizacja
Progi przyjęcia, selekcja po X i po Y, skrajne grupy i 1000 badań z poprawką Thorndike’a – pięć rysunków z kodem R.
Czytaj →PoradnikWykresy w pracy dyplomowej
Jaki wykres do jakich danych, błędy źle → dobrze, podpis rysunku i gotowe zdania opisu wykresu w rozdziale wyników.
Czytaj →PoradnikJak opisać tabelę korelacji w pracy?
Tabela korelacji w stylu APA, opis wzorca zamiast listy współczynników, korekta przy wielu korelacjach, Pearson obok Spearmana i gotowy wzór opisu.
Czytaj →PoradnikZawsze narysuj dane
Kwartet Anscombe’a i cztery pułapki korelacji na wykresach z R – z podpisem APA i zdaniem do Wyników przy każdym rysunku.
Czytaj →Masz macierz korelacji do opisania w pracy?
Pomożemy policzyć korelacje z właściwą korektą, przygotować czytelne rysunki i tabelę APA oraz opisać wyniki tak, żebyś umiał(a) je wyjaśnić na obronie.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Benjamini, Y., & Hochberg, Y. (1995). Controlling the false discovery rate: A practical and powerful approach to multiple testing. Journal of the Royal Statistical Society: Series B (Methodological), 57(1), 289–300. https://doi.org/10.1111/j.2517-6161.1995.tb02031.x
- Bonett, D. G., & Wright, T. A. (2000). Sample size requirements for estimating Pearson, Kendall and Spearman correlations. Psychometrika, 65(1), 23–28. https://doi.org/10.1007/bf02294183
- Crameri, F., Shephard, G. E., & Heron, P. J. (2020). The misuse of colour in science communication. Nature Communications, 11(1), Article 5444. https://doi.org/10.1038/s41467-020-19160-7 ● Otwarty dostęp
- Emerson, J. W., Green, W. A., Schloerke, B., Crowley, J., Cook, D., Hofmann, H., & Wickham, H. (2013). The generalized pairs plot. Journal of Computational and Graphical Statistics, 22(1), 79–91. https://doi.org/10.1080/10618600.2012.694762
- Friendly, M. (2002). Corrgrams: Exploratory displays for correlation matrices. The American Statistician, 56(4), 316–324. https://doi.org/10.1198/000313002533
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70. https://www.jstor.org/stable/4615733
- Wilkinson, L., & Friendly, M. (2009). The history of the cluster heat map. The American Statistician, 63(2), 179–184. https://doi.org/10.1198/tas.2009.0033
- Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01 ● Otwarty dostęp
Cytowania BibTeX
@article{benjamini1995controlling, author={Benjamini, Yoav and Hochberg, Yosef}, title={{Controlling the false discovery rate: A practical and powerful approach to multiple testing}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1995}, volume={57}, number={1}, pages={289--300}, doi={10.1111/j.2517-6161.1995.tb02031.x}}@article{bonett2000sample, author={Bonett, Douglas G. and Wright, Thomas A.}, title={{Sample size requirements for estimating Pearson, Kendall and Spearman correlations}}, journal={Psychometrika}, year={2000}, volume={65}, number={1}, pages={23--28}, doi={10.1007/bf02294183}}@article{crameri2020misuse, author={Crameri, Fabio and Shephard, Grace E. and Heron, Philip J.}, title={{The misuse of colour in science communication}}, journal={Nature Communications}, year={2020}, volume={11}, number={1}, eid={5444}, doi={10.1038/s41467-020-19160-7}}@article{emerson2013generalized, author={Emerson, John W. and Green, Walton A. and Schloerke, Barret and Crowley, Jason and Cook, Dianne and Hofmann, Heike and Wickham, Hadley}, title={{The generalized pairs plot}}, journal={Journal of Computational and Graphical Statistics}, year={2013}, volume={22}, number={1}, pages={79--91}, doi={10.1080/10618600.2012.694762}}@article{friendly2002corrgrams, author={Friendly, Michael}, title={{Corrgrams: Exploratory displays for correlation matrices}}, journal={The American Statistician}, year={2002}, volume={56}, number={4}, pages={316--324}, doi={10.1198/000313002533}}@article{holm1979simple, author={Holm, Sture}, title={{A simple sequentially rejective multiple test procedure}}, journal={Scandinavian Journal of Statistics}, year={1979}, volume={6}, number={2}, pages={65--70}, url={https://www.jstor.org/stable/4615733}}@article{wilkinson2009history, author={Wilkinson, Leland and Friendly, Michael}, title={{The history of the cluster heat map}}, journal={The American Statistician}, year={2009}, volume={63}, number={2}, pages={179--184}, doi={10.1198/tas.2009.0033}}@article{zeileis2020colorspace, author={Zeileis, Achim and Fisher, Jason C. and Hornik, Kurt and Ihaka, Ross and McWhite, Claire D. and Murrell, Paul and Stauffer, Reto and Wilke, Claus O.}, title={{colorspace: A toolbox for manipulating and assessing colors and palettes}}, journal={Journal of Statistical Software}, year={2020}, volume={96}, number={1}, doi={10.18637/jss.v096.i01}}