Ta sama zależność, coraz mniejsze r
Definicję i wzór znajdziesz w haśle korelacja Pearsona, a szerszy obraz tego, kto trafia do próby – w haśle błąd selekcji. Jeden przykład ograniczonego zakresu pokazuje wpis zawsze narysuj dane, a wiek i nasilenie objawów w próbie studenckiej – wpis badanie na studentach. Tutaj idziemy dalej. Sprawdzamy, po której zmiennej odbyła się selekcja, co dzieje się z nachyleniem prostej, kiedy korelacja rośnie zamiast maleć i co daje poprawka Thorndike’a.
Przykład jest fikcyjny. Populacja to 100 000 maturzystów z trzema wynikami w skali T (średnia 50, SD = 10): X – test umiejętności matematycznych, Y – test rozumowania statystycznego, Z – punkty rekrutacyjne na kierunek. Korelacje ustawiliśmy ręcznie: X z Y .50, X z Z .70, Y z Z .45. Funkcja mvrnorm() z argumentem empirical = TRUE daje je w populacji dokładnie, więc wiemy, ile „powinno” wyjść. Ziarno 593 ustalono raz i nie zmieniano go. Losowe 1000 osób z populacji pobierzesz jako ograniczony-zakres-populacja-1000.csv. Przy każdym rysunku: co widać, czego wykres nie pokazuje, podpis i zdanie do pracy.
Rysunek 1: coraz wyższy próg przyjęcia
Wyobraź sobie, że kierunek przyjmuje tylko osoby z wysokim wynikiem testu matematycznego. Badacz ma później dane wyłącznie przyjętych.
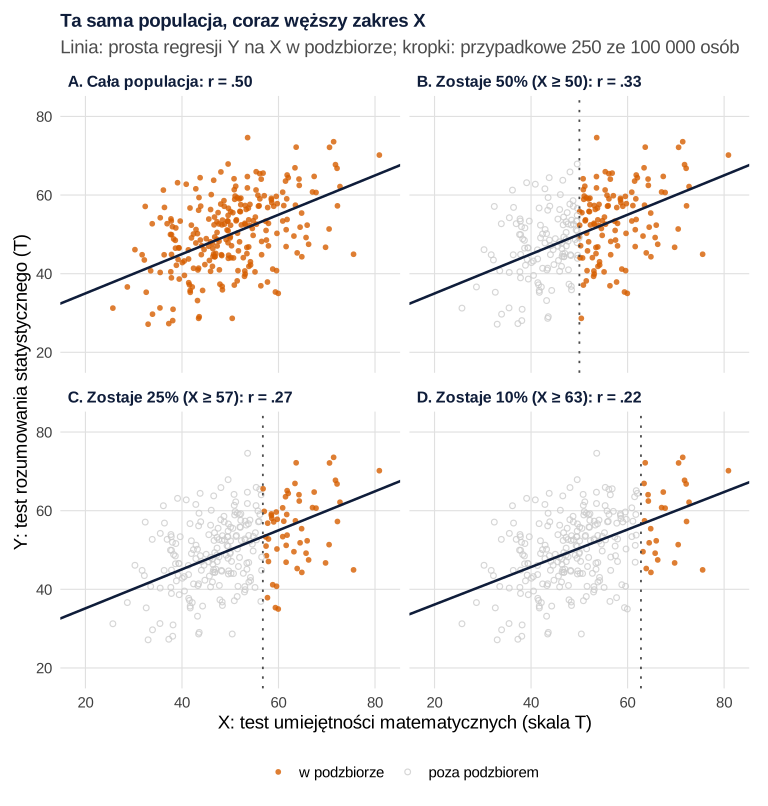
set.seed(593)).Co widać. W całej populacji r = .50. Gdy zostaje górna połowa (próg X ≥ 50.0), r spada do .33, przy górnej ćwiartce (X ≥ 56.8) do .27, a przy górnych 10% (X ≥ 62.8) do .23. Prosta regresji prawie się nie zmienia: nachylenie wynosi 0.50, 0.50, 0.50 i 0.48 punktu Y na punkt X. Zmienia się rozrzut X: SD maleje z 10 do 6.02, 4.93 i 4.14. SD Y maleje dużo mniej: z 10 do 9.17, 8.97 i 8.78. Korelacja porównuje zmienność wyjaśnioną przez X z całą zmiennością Y. Kiedy X prawie się nie różnicuje, na „wyjaśnianie” zostaje niewiele.
Czego ten wykres nie pokazuje. Na panelu D chmura wygląda jak „brak związku”, a związek jest dokładnie ten sam co na panelu A. W prawdziwym badaniu nie zobaczysz szarych punktów – masz tylko pomarańczowe. Dlatego wniosek „zmienne są słabo powiązane” z próby po selekcji dotyczy tylko tej wąskiej grupy. Bland i Altman (2011) przypominają tę zasadę na przykładzie korelacji liczonej osobno w przedziałach jednej zmiennej.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: po której zmiennej była selekcja
Ten sam mechanizm działa nie tylko przy progu w X. Na rysunku 2 zawężamy populację krokami po 5%: według X, według Y albo według punktów rekrutacyjnych Z, które silnie korelują z X (.70) i słabiej z Y (.45).
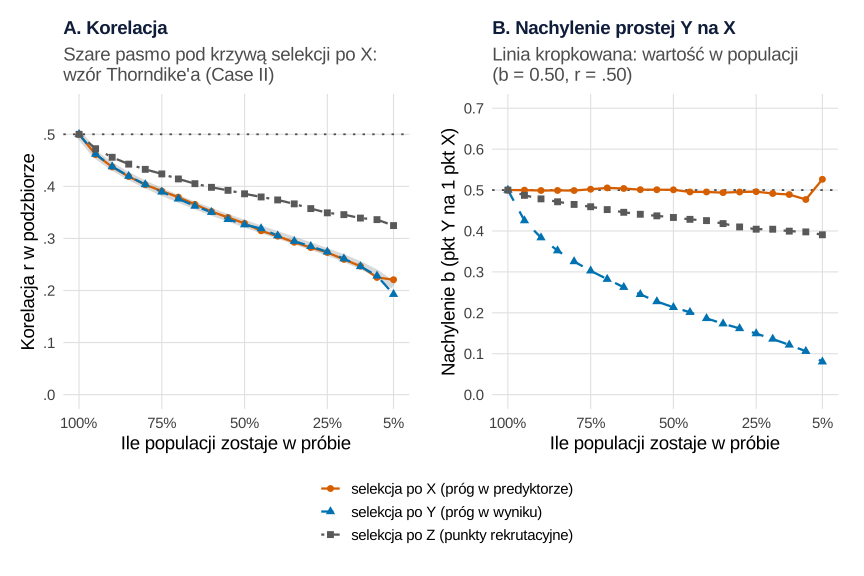
set.seed(593)).Co widać. Panel A: korelacja spada we wszystkich trzech wariantach. Przy 30% zachowanych wynosi .28 przy selekcji po X, .29 po Y i .36 po Z. Selekcja po Z obniża r wolniej, bo Z tylko częściowo „ściska” rozrzut X (SD X = 8.01 zamiast 5.15). Szare pasmo pod krzywą selekcji po X to wynik wzoru Thorndike’a odwróconego w drugą stronę. Przy 30% zachowanych wzór daje .285, a w danych wyszło .282. Na całej siatce od 100% do 5% różnica nie przekroczyła .011. Panel B pokazuje, czego nie widać w samej korelacji. Przy selekcji po X nachylenie stoi w miejscu (0.50 przy 30%). Przy selekcji po Y spada do 0.16, a przy 10% zachowanych – do 0.11.
Czego ten wykres nie pokazuje. Krzywe opierają się na populacji o rozkładzie normalnym i zależności liniowej. Przy skośnych rozkładach albo progu, który nie jest ostry (np. część osób z niższym wynikiem też trafia do próby), spadek będzie inny. Sackett i Yang (2000) opisują 11 takich sytuacji. Zależą one od tego, po której zmiennej odbyła się selekcja i czy znasz jej rozrzut bez ograniczenia. Selekcja po Y to też częsty mechanizm zmiennej zderzeniowej – więcej we wpisach błąd selekcji i zmienna zderzeniowa w praktyce i zmienna zakłócająca i collider – wizualizacja na obrazkach.
Podpis do pracy:
Zdanie do Metody:
Rysunek 3: selekcja po predyktorze a po wyniku
Z panelu A rysunku 2 wynika, że przy 30% zachowanych korelacja jest prawie taka sama po obu rodzajach selekcji. Rysunek 3 pokazuje, że za tym samym r stoją różne problemy.
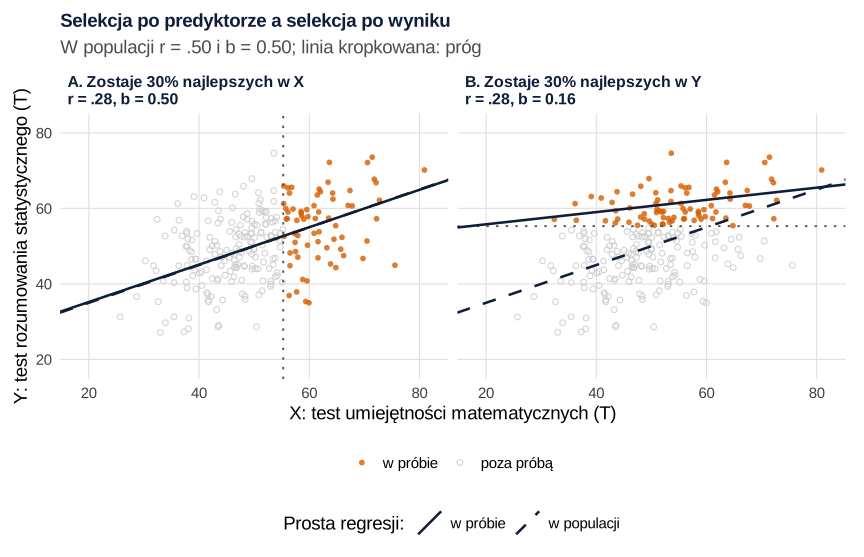
set.seed(593)).Co widać. Obie próby to górne 30% populacji (próg 55.3 w X albo w Y). Korelacja wynosi .28 i .29. Po lewej prosta z próby pokrywa się z prostą populacyjną (b = 0.50). Po prawej jest wyraźnie płaska (b = 0.16). Odcięcie dołu Y usuwa osoby z niskim X i niskim Y. Zostają osoby z niskim X, którym „udało się” w Y, a to spłaszcza prostą. Gdy selekcja odbyła się po X, nachylenie i przewidywania z modelu regresji pozostają poprawne, choć r i R² są zaniżone. Gdy selekcja odbyła się po Y, zaniżone jest także nachylenie.
Czego ten wykres nie pokazuje. W prawdziwych danych rzadko wiesz, po której zmiennej działała selekcja. Selekcja po Y bywa ukryta: badasz tylko osoby, które zaliczyły przedmiot, zgłosiły się do koła naukowego albo nie przerwały studiów. Wykres nie pokazuje też, że zawężenie zmienia wartość standaryzowanego β – pułapkę tę omawia wpis współczynniki standaryzowane czy niestandaryzowane. Gdy selekcja jest silna i dotyczy wyniku, rozwiązaniem bywa model selekcji Heckmana, ale potrzebuje on danych o osobach niewybranych.
Podpis do pracy:
Zdanie do Dyskusji:
Rysunek 4: skrajne grupy zawyżają r
Mechanizm działa w obie strony. Jeśli do badania wybierasz osoby z najniższym i najwyższym wynikiem X, a pomijasz środek, rozrzut X rośnie, a razem z nim korelacja.
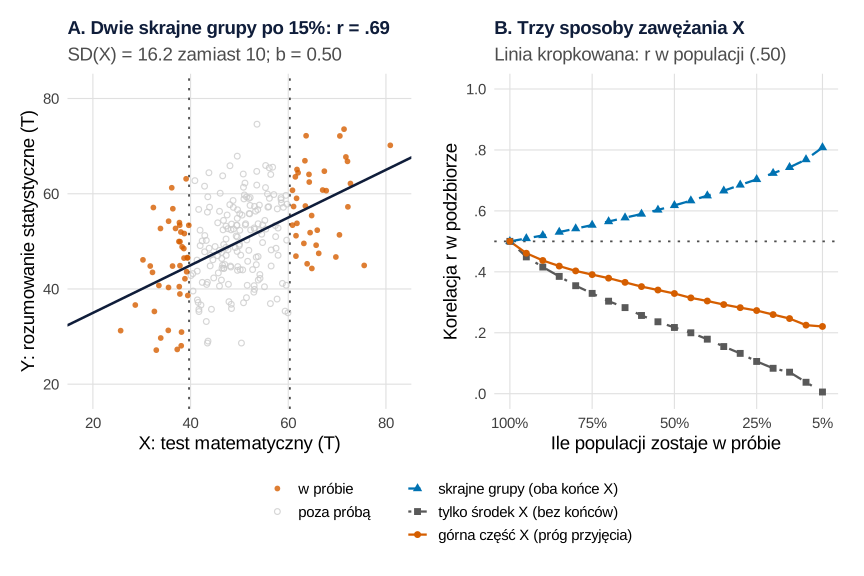
set.seed(593)).Co widać. Gdy zostaje po 15% osób z obu końców X (razem 30% populacji), SD X rośnie z 10 do 16.16, a r – z .50 do .69. Nachylenie znów stoi w miejscu (0.50). Panel B porównuje trzy sposoby zawężania. Przy 10% zachowanych skrajne grupy dają r = .77, próg przyjęcia .23, a sam środek X – .04. Ten sam związek daje więc korelację od prawie zera do ponad .75, zależnie od tego, kogo zbadasz. Preacher i in. (2005) piszą, że dobór grup skrajnych zwiększa moc, ale zmienia standaryzowaną wielkość efektu i utrudnia interpretację.
Czego ten wykres nie pokazuje. Grupy skrajne często łączy się z podziałem zmiennej na „niskich” i „wysokich” – to osobny problem, opisany we wpisach dychotomizacja zmiennych ciągłych i podział na medianie – wizualizacja na obrazkach. Wykres pomija też błąd pomiaru. Skrajne wyniki w pierwszym pomiarze częściowo wynikają z przypadku i w drugim pomiarze wracają ku średniej. Pokazuje to wpis regresja do średniej – wizualizacja na obrazkach.
Podpis do pracy:
Zdanie do Metody:
Rysunek 5: 1000 badań i poprawka Thorndike’a
Do tej pory liczyliśmy na całej populacji. W prawdziwym badaniu masz jedną próbę. Rysunek 5 pokazuje 1000 badań tym samym schematem. W każdym losujemy 334 kandydatów i badamy 100 osób: (A) przypadkowych, (B) 100 najlepszych w X, (C) tych samych co w B, ale z poprawką, (D) 100 najlepszych w punktach rekrutacyjnych Z, z poprawką liczoną na X.
Poprawka Thorndike’a dla bezpośredniej selekcji po X (Case II) to rc = r·u / √(1 − r² + r²u²), gdzie u to SD X w populacji podzielone przez SD X w próbie. Wymaga znajomości SD bez ograniczenia, np. z norm testowych. Le i Schmidt (2006) opisują ją jako konwencjonalną poprawkę dla ograniczenia bezpośredniego. Wiberg i Sundström (2009) na danych z egzaminu na prawo jazdy uzyskali empiryczne potwierdzenie jej trafności przy selekcji po predyktorze.
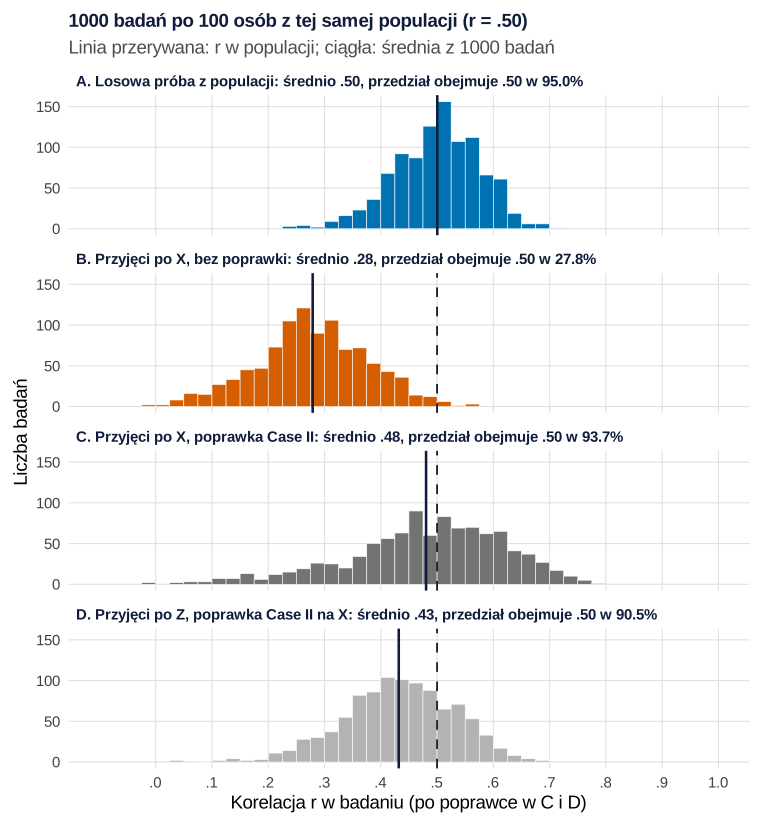
set.seed(593)).Co widać. Losowe próby dają średnio r = .50 (SD = 0.076), a przedział ufności obejmuje .50 w 95.0% badań (błąd Monte Carlo 0.7 pp). Próby przyjętych dają średnio .28, a przedział obejmuje .50 tylko w 27.8% badań (błąd MC 1.4 pp). Ograniczenie zakresu zabiera też moc: istotną korelację uzyskało 81.7% badań zamiast 100%. Poprawka przesuwa rozkład z powrotem (średnio .48, mediana .50), a poprawione granice przedziału obejmują .50 w 93.7% badań. Ceną jest rozrzut. SD poprawionych korelacji wynosi 0.140, prawie dwa razy więcej niż w losowych próbach tej samej wielkości. Wiersz D pokazuje pułapkę: przy selekcji po Z poprawka liczona na X daje średnio .43. Dzieje się tak, bo SD X jest tylko nieco zawężone (średnie u = 1.26), a selekcja dotknęła też Y. Hunter i in. (2006) zwracają uwagę, że ograniczenie zakresu jest zwykle pośrednie, a poprawka dla bezpośredniego niedoszacowuje wtedy korekty.
Czego ten wykres nie pokazuje. W symulacji znamy prawdziwe SD populacji i wiemy, że rozkład jest normalny. W pracy dyplomowej oba założenia bywają wątpliwe: normy mogą dotyczyć innej populacji, a próg rekrutacji nie zawsze jest ostry. Sackett i in. (2022) wykazali, że w metaanalizach trafności metod selekcji korekty na ograniczenie zakresu często były nadmierne. Poprawka nie usuwa też osłabienia przez błąd pomiaru. To osobna korekta na atenuację, pokazana we wpisie rzetelność i błąd pomiaru – wizualizacja na obrazkach. O mocy przy małym efekcie pisze wpis moc testu w obrazkach.
Podpis do pracy:
Zdanie do Wyników:
Co napisać w ograniczeniach pracy
Najczęstszy przypadek w pracy dyplomowej to próba studentów jednego kierunku, często jednego rocznika. Taka grupa została już raz wyselekcjonowana – przez rekrutację, zainteresowania i to, kto przetrwał pierwszy rok. Nie trzeba tego ukrywać. Wystarczą trzy kroki.
- Podaj SD głównych zmiennych i porównaj je z normami albo z badaniami na szerszych grupach. Stosunek u powie czytelnikowi, jak bardzo zakres jest zawężony. Gdy u ≈ 1, problem jest mały.
- Nazwij zmienną, po której była selekcja. Po X zaniża głównie r, po Y także nachylenie (rysunek 3).
- Raportuj nachylenie w jednostkach skali obok r. Przy selekcji po predyktorze nachylenie jest odporniejsze niż korelacja. Jeśli liczysz poprawkę, podaj wartość przed i po, wzór i źródło SD populacji – zasady opisuje hasło trafność kryterialna.
Więcej o pisaniu tej części – we wpisie ograniczenia badania – jak je opisać. Inne konsekwencje próby wygodnej pokazuje wpis dobór nielosowy w obrazkach, a macierz korelacji z przedziałami – wpis korelacje na wykresie. Jak mało widać przy r = .3, pokazuje wpis wielkość efektu w obrazkach.
Kod R wszystkich rysunków i liczb
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 definiuje motyw, paletę, populację i funkcję opis(), z których korzystają następne. Każdy przepis tworzy obiekt wykresu (p1–p5); wpisz jego nazwę, żeby go wyświetlić, a do zapisu użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały dokładnie z tego kodu: motyw to skrócona wersja motywu serwisu, a pliki zapisano w formacie SVG.
Dane są fikcyjne. Ręcznie ustaliliśmy: wielkość populacji (100 000), średnie i SD w skali T, trzy korelacje (.50, .70 i .45), progi (górne 50, 25 i 10% na rysunku 1; 30% na rysunkach 3 i 4A; siatkę 100–5% co 5 punktów na rysunkach 2 i 4B) oraz schemat symulacji (334 kandydatów i 100 badanych w każdym z 1000 badań; SD populacji 10 jako wartość „z norm”). Każdy przepis, który losuje (1 i 5), zaczyna się od własnego set.seed(593), więc skopiowany osobno da te same liczby co na stronie. Ziarna nie dobieraliśmy pod wynik. Cały kod liczy się w kilka sekund.
1. Motyw, paleta, populacja i progi przyjęcia: Rysunek 1
R
# Rysunek 1. Ta sama populacja (r = .50), coraz wyższy próg przyjęcia w X – coraz niższe r (dane fikcyjne)
options(width = 100, scipen = 10)
library(ggplot2)
library(patchwork)

# Krótki motyw i paleta Okabe–Ito (sprawdzona w symulacji deuteranopii; kolor zawsze wspiera kształt lub linię)
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        axis.text = element_text(colour = "grey25"), strip.text = element_text(face = "bold", colour = "#0f1d3a"),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA),
        plot.margin = margin(10, 14, 10, 10))
kol <- c(wybrani = "#D55E00", drugi = "#0072B2", tlo = "grey80", ciemny = "#0f1d3a")
bz <- function(x, d = 2) sub("^(-?)0\\.", "\\1.", formatC(x, format = "f", digits = d))   # .50 zamiast 0.50

# Populacja fikcyjna: 100 000 maturzystów, trzy zmienne w skali T (M = 50, SD = 10):
# X – test umiejętności matematycznych, Y – test rozumowania statystycznego, Z – punkty rekrutacyjne na kierunek.
# Korelacje ustawiono ręcznie; empirical = TRUE daje je w populacji dokładnie.
N <- 100000
R <- matrix(c(1, .50, .70,
              .50, 1, .45,
              .70, .45, 1), 3, dimnames = list(c("X", "Y", "Z"), c("X", "Y", "Z")))
set.seed(593)
pop <- as.data.frame(MASS::mvrnorm(N, mu = c(50, 50, 50), Sigma = R * 100, empirical = TRUE))
round(cor(pop), 2)
round(sapply(pop, sd), 2)

# Korelacja, SD i nachylenie Y względem X w podzbiorze
opis <- function(d) c(n = nrow(d), r = cor(d$X, d$Y), SD_X = sd(d$X), SD_Y = sd(d$Y),
                      b = unname(coef(lm(Y ~ X, d))[2]))

# Próg przyjęcia w X: zostaje górne 100%, 50%, 25% albo 10% populacji
zostaje <- c(1, .50, .25, .10)
progi <- quantile(pop$X, 1 - zostaje, names = FALSE)
tab1 <- t(sapply(progi, function(k) opis(pop[pop$X >= k, ])))
tab1 <- data.frame(zostaje = paste0(100 * zostaje, "%"), prog_X = ifelse(zostaje == 1, NA, round(progi, 1)), tab1)
tab1$u <- 10 / tab1$SD_X                        # ile razy SD w populacji jest większe niż w podzbiorze
print(transform(tab1, r = round(r, 3), SD_X = round(SD_X, 2), SD_Y = round(SD_Y, 2), b = round(b, 3), u = round(u, 2)),
      row.names = FALSE)

# Na rysunkach 250 losowych osób z populacji (rysowanie 100 000 punktów nic nie dodaje); r liczone na całej populacji
set.seed(593)
pokaz <- pop[sample.int(N, 250), ]
etyk <- sprintf("%s. Zostaje %s (X ≥ %.0f): r = %s", LETTERS[1:4], tab1$zostaje, progi, bz(tab1$r))
etyk[1] <- sprintf("A. Cała populacja: r = %s", bz(tab1$r[1]))
panele <- do.call(rbind, lapply(1:4, function(i)
  data.frame(pokaz, panel = etyk[i], wybrany = pokaz$X >= progi[i])))
panele$panel <- factor(panele$panel, etyk)
panele$grupa <- factor(ifelse(panele$wybrany, "w podzbiorze", "poza podzbiorem"), c("w podzbiorze", "poza podzbiorem"))
linie <- data.frame(panel = factor(etyk, etyk), prog = progi, b = tab1$b,
                    a = sapply(progi, function(k) coef(lm(Y ~ X, pop[pop$X >= k, ]))[1]))
linie$prog[1] <- NA

p1 <- ggplot(panele, aes(X, Y)) +
  geom_point(aes(colour = grupa, shape = grupa), size = 1.6, alpha = 0.8) +
  geom_vline(data = linie, aes(xintercept = prog), colour = "grey30", linetype = "dotted", na.rm = TRUE) +
  geom_abline(data = linie, aes(intercept = a, slope = b), colour = kol[["ciemny"]], linewidth = 0.9) +
  facet_wrap(~ panel, ncol = 2) +
  scale_colour_manual(values = c("w podzbiorze" = kol[["wybrani"]], "poza podzbiorem" = kol[["tlo"]]), name = NULL) +
  scale_shape_manual(values = c("w podzbiorze" = 16, "poza podzbiorem" = 1), name = NULL) +
  coord_cartesian(xlim = c(18, 82), ylim = c(18, 82)) +
  labs(x = "X: test umiejętności matematycznych (skala T)", y = "Y: test rozumowania statystycznego (T)",
       title = "Ta sama populacja, coraz węższy zakres X",
       subtitle = "Linia: prosta regresji Y na X w podzbiorze; kropki: przypadkowe 250 ze 100 000 osób") +
  motyw + theme(strip.text = element_text(hjust = 0, size = rel(0.85)))
p1   # zapis: ggsave("ograniczony-zakres-progi-przyjecia.svg", p1, width = 8, height = 8.4)
Wynik w R
    X    Y    Z
X 1.0 0.50 0.70
Y 0.5 1.00 0.45
Z 0.7 0.45 1.00
 X  Y  Z
10 10 10
 zostaje prog_X      n     r  SD_X  SD_Y     b    u
    100%     NA 100000 0.500 10.00 10.00 0.500 1.00
     50%   50.0  50000 0.329  6.02  9.17 0.501 1.66
     25%   56.8  25000 0.273  4.93  8.97 0.496 2.03
     10%   62.8  10000 0.225  4.14  8.78 0.477 2.42
2. Korelacja i nachylenie przy selekcji po X, Y i Z: Rysunek 2
R
# Rysunek 2. Korelacja i nachylenie w funkcji odsetka zachowanych: selekcja po X, po Y i po Z
# (kontynuacja: pop, opis(), kol, motyw i bz() z przepisu 1; bez losowania)

# Zostaje górne 100%, 95%, …, 5% populacji według X, według Y albo według Z (punkty rekrutacyjne)
odsetki <- seq(1, .05, by = -.05)
krzywe <- do.call(rbind, lapply(c("X", "Y", "Z"), function(v) {
  do.call(rbind, lapply(odsetki, function(q) {
    d <- pop[pop[[v]] >= quantile(pop[[v]], 1 - q), ]
    data.frame(selekcja = v, zostaje = q, t(opis(d)))
  }))
}))

# Odwrotność poprawki Thorndike'a (Case II): jakie r zostanie po selekcji bezpośredniej po X,
# gdy w populacji rho = .50, a SD(X) zmalało u-krotnie
rho <- 0.50
krzywe$u <- 10 / krzywe$SD_X
krzywe$r_wzor <- with(krzywe, ifelse(selekcja == "X", rho / sqrt(u^2 * (1 - rho^2) + rho^2), NA))   # wzór tylko dla selekcji po X

wybrane <- krzywe[round(krzywe$zostaje, 2) %in% c(1, .50, .30, .10), ]
wybrane$zostaje <- paste0(round(100 * wybrane$zostaje), "%")
print(transform(wybrane[, c("selekcja", "zostaje", "r", "b", "SD_X", "SD_Y", "r_wzor")],
                r = round(r, 3), b = round(b, 3), SD_X = round(SD_X, 2), SD_Y = round(SD_Y, 2),
                r_wzor = round(r_wzor, 3)), row.names = FALSE)
# Największa różnica między r przy selekcji po X a wzorem (cała siatka 100–5%)
round(max(abs(krzywe$r - krzywe$r_wzor), na.rm = TRUE), 4)

nazwy <- c(X = "selekcja po X (próg w predyktorze)", Y = "selekcja po Y (próg w wyniku)",
           Z = "selekcja po Z (punkty rekrutacyjne)")
krzywe$selekcja_n <- factor(nazwy[krzywe$selekcja], nazwy)
skala_kol <- scale_colour_manual(values = setNames(c(kol[["wybrani"]], kol[["drugi"]], "grey35"), nazwy), name = NULL)
skala_ksz <- scale_shape_manual(values = setNames(c(16, 17, 15), nazwy), name = NULL)
skala_lin <- scale_linetype_manual(values = setNames(c("solid", "dashed", "dotdash"), nazwy), name = NULL)
os_x <- scale_x_reverse(labels = function(x) paste0(100 * x, "%"), breaks = c(1, .75, .5, .25, .05))

pa <- ggplot(krzywe, aes(zostaje, r, colour = selekcja_n, shape = selekcja_n, linetype = selekcja_n)) +
  geom_hline(yintercept = rho, colour = "grey30", linetype = "dotted") +
  geom_line(data = krzywe[krzywe$selekcja == "X", ], aes(zostaje, r_wzor), inherit.aes = FALSE,
            colour = "black", linewidth = 2.6, alpha = 0.15) +
  geom_line(linewidth = 0.8) + geom_point(size = 2) +
  skala_kol + skala_ksz + skala_lin + os_x +
  scale_y_continuous(limits = c(0, .55), breaks = seq(0, .5, .1), labels = function(x) bz(x, 1)) +
  labs(x = "Ile populacji zostaje w próbie", y = "Korelacja r w podzbiorze",
       title = "A. Korelacja",
       subtitle = "Szare pasmo pod krzywą selekcji po X:\nwzór Thorndike'a (Case II)") + motyw
pb <- ggplot(krzywe, aes(zostaje, b, colour = selekcja_n, shape = selekcja_n, linetype = selekcja_n)) +
  geom_hline(yintercept = 0.50, colour = "grey30", linetype = "dotted") +
  geom_line(linewidth = 0.8) + geom_point(size = 2) +
  skala_kol + skala_ksz + skala_lin + os_x +
  scale_y_continuous(limits = c(0, .7), breaks = seq(0, .7, .1), labels = function(x) sprintf("%.1f", x)) +
  labs(x = "Ile populacji zostaje w próbie", y = "Nachylenie b (pkt Y na 1 pkt X)",
       title = "B. Nachylenie prostej Y na X",
       subtitle = "Linia kropkowana: wartość w populacji\n(b = 0.50, r = .50)") + motyw
p2 <- pa + pb + plot_layout(guides = "collect") & theme(legend.position = "bottom", legend.direction = "vertical")
p2   # zapis: ggsave("ograniczony-zakres-r-i-nachylenie.svg", p2, width = 9, height = 6)
Wynik w R
 selekcja zostaje     r     b  SD_X  SD_Y r_wzor
        X    100% 0.500 0.500 10.00 10.00  0.500
        X     50% 0.329 0.501  6.02  9.17  0.328
        X     30% 0.282 0.495  5.15  9.04  0.285
        X     10% 0.225 0.477  4.14  8.78  0.232
        Y    100% 0.500 0.500 10.00 10.00     NA
        Y     50% 0.326 0.213  9.18  6.00     NA
        Y     30% 0.285 0.162  9.03  5.12     NA
        Y     10% 0.228 0.106  8.79  4.09     NA
        Z    100% 0.500 0.500 10.00 10.00     NA
        Z     50% 0.386 0.433  8.31  9.33     NA
        Z     30% 0.357 0.410  8.01  9.18     NA
        Z     10% 0.336 0.398  7.71  9.13     NA
[1] 0.0112
3. Selekcja po X a selekcja po Y: Rysunek 3
R
# Rysunek 3. Ten sam odsetek zachowanych (30%), dwa rodzaje selekcji: po X i po Y
# (kontynuacja: pop, pokaz, opis(), kol, motyw i bz() z przepisu 1; bez losowania)

q <- 0.30
prog_x <- quantile(pop$X, 1 - q, names = FALSE)
prog_y <- quantile(pop$Y, 1 - q, names = FALSE)
po_x <- pop[pop$X >= prog_x, ]
po_y <- pop[pop$Y >= prog_y, ]
tab3 <- rbind(populacja = opis(pop), "selekcja po X" = opis(po_x), "selekcja po Y" = opis(po_y))
round(tab3, 3)
c(prog_X = round(prog_x, 1), prog_Y = round(prog_y, 1))

etyk3 <- c(sprintf("A. Zostaje 30%% najlepszych w X\nr = %s, b = %.2f", bz(tab3[2, "r"]), tab3[2, "b"]),
           sprintf("B. Zostaje 30%% najlepszych w Y\nr = %s, b = %.2f", bz(tab3[3, "r"]), tab3[3, "b"]))
d3 <- rbind(data.frame(pokaz, panel = etyk3[1], wybrany = pokaz$X >= prog_x),
            data.frame(pokaz, panel = etyk3[2], wybrany = pokaz$Y >= prog_y))
d3$panel <- factor(d3$panel, etyk3)
d3$grupa <- factor(ifelse(d3$wybrany, "w próbie", "poza próbą"), c("w próbie", "poza próbą"))
wsp <- function(d) coef(lm(Y ~ X, d))
proste <- data.frame(panel = factor(rep(etyk3, each = 2), etyk3),
                     prosta = factor(rep(c("w próbie", "w populacji"), 2), c("w próbie", "w populacji")),
                     a = c(wsp(po_x)[1], wsp(pop)[1], wsp(po_y)[1], wsp(pop)[1]),
                     b = c(wsp(po_x)[2], wsp(pop)[2], wsp(po_y)[2], wsp(pop)[2]))
progi3 <- data.frame(panel = factor(etyk3, etyk3), x = c(prog_x, NA), y = c(NA, prog_y))

p3 <- ggplot(d3, aes(X, Y)) +
  geom_point(aes(colour = grupa, shape = grupa), size = 1.6, alpha = 0.8) +
  geom_vline(data = progi3, aes(xintercept = x), colour = "grey30", linetype = "dotted", na.rm = TRUE) +
  geom_hline(data = progi3, aes(yintercept = y), colour = "grey30", linetype = "dotted", na.rm = TRUE) +
  geom_abline(data = proste, aes(intercept = a, slope = b, linetype = prosta), colour = kol[["ciemny"]], linewidth = 0.9) +
  facet_wrap(~ panel, ncol = 2) +
  scale_colour_manual(values = c("w próbie" = kol[["wybrani"]], "poza próbą" = kol[["tlo"]]), name = NULL) +
  scale_shape_manual(values = c("w próbie" = 16, "poza próbą" = 1), name = NULL) +
  scale_linetype_manual(values = c("w próbie" = "solid", "w populacji" = "dashed"), name = "Prosta regresji:") +
  coord_cartesian(xlim = c(18, 82), ylim = c(18, 82)) +
  labs(x = "X: test umiejętności matematycznych (T)", y = "Y: test rozumowania statystycznego (T)",
       title = "Selekcja po predyktorze a selekcja po wyniku",
       subtitle = "W populacji r = .50 i b = 0.50; linia kropkowana: próg") +
  motyw + theme(strip.text = element_text(hjust = 0, size = rel(0.85)), legend.box = "vertical")
p3   # zapis: ggsave("ograniczony-zakres-po-x-czy-po-y.svg", p3, width = 9, height = 5.8)
Wynik w R
                   n     r   SD_X   SD_Y     b
populacja     100000 0.500 10.000 10.000 0.500
selekcja po X  30000 0.282  5.152  9.035 0.495
selekcja po Y  30000 0.285  9.025  5.125 0.162
prog_X prog_Y
  55.3   55.3
4. Skrajne grupy i trzy sposoby zawężania X: Rysunek 4
R
# Rysunek 4. Odwrotny kierunek: tylko skrajne grupy w X zawyżają r (kontynuacja: pop, pokaz, opis(), kol,
# motyw i bz() z przepisu 1; bez losowania)

# A: zostaje po 15% osób z najniższym i z najwyższym X (razem 30% populacji), środek odpada
dol <- quantile(pop$X, .15, names = FALSE); gora <- quantile(pop$X, .85, names = FALSE)
skrajne <- pop[pop$X <= dol | pop$X >= gora, ]
tab4 <- rbind(populacja = opis(pop), "skrajne 2 × 15%" = opis(skrajne))
round(tab4, 3)

# B: r w funkcji odsetka zachowanych dla trzech sposobów zawężania X
odsetki <- seq(1, .05, by = -.05)
sposoby <- list(
  "skrajne grupy (oba końce X)" = function(q) pop$X <= quantile(pop$X, q / 2) | pop$X >= quantile(pop$X, 1 - q / 2),
  "tylko środek X (bez końców)" = function(q) pop$X >= quantile(pop$X, .5 - q / 2) & pop$X <= quantile(pop$X, .5 + q / 2),
  "górna część X (próg przyjęcia)" = function(q) pop$X >= quantile(pop$X, 1 - q))
krzywe4 <- do.call(rbind, lapply(names(sposoby), function(s)
  do.call(rbind, lapply(odsetki, function(q) data.frame(sposob = s, zostaje = q, t(opis(pop[sposoby[[s]](q), ])))))))
krzywe4$sposob <- factor(krzywe4$sposob, names(sposoby))
w4 <- krzywe4[round(krzywe4$zostaje, 2) %in% c(.50, .30, .10), c("sposob", "zostaje", "r", "SD_X", "b")]
print(transform(w4, r = round(r, 3), SD_X = round(SD_X, 2), b = round(b, 3)), row.names = FALSE)

d4 <- data.frame(pokaz, grupa = factor(ifelse(pokaz$X <= dol | pokaz$X >= gora, "w próbie", "poza próbą"),
                                       c("w próbie", "poza próbą")))
wsp_s <- coef(lm(Y ~ X, skrajne))
pa <- ggplot(d4, aes(X, Y)) +
  geom_vline(xintercept = c(dol, gora), colour = "grey30", linetype = "dotted") +
  geom_point(aes(colour = grupa, shape = grupa), size = 1.6, alpha = 0.8) +
  geom_abline(intercept = wsp_s[1], slope = wsp_s[2], colour = kol[["ciemny"]], linewidth = 0.9) +
  scale_colour_manual(values = c("w próbie" = kol[["wybrani"]], "poza próbą" = kol[["tlo"]]), name = NULL) +
  scale_shape_manual(values = c("w próbie" = 16, "poza próbą" = 1), name = NULL) +
  coord_cartesian(xlim = c(18, 82), ylim = c(18, 82)) +
  labs(x = "X: test matematyczny (T)", y = "Y: rozumowanie statystyczne (T)",
       title = sprintf("A. Dwie skrajne grupy po 15%%: r = %s", bz(tab4[2, "r"])),
       subtitle = sprintf("SD(X) = %.1f zamiast 10; b = %.2f", tab4[2, "SD_X"], tab4[2, "b"])) + motyw
pb <- ggplot(krzywe4, aes(zostaje, r, colour = sposob, shape = sposob, linetype = sposob)) +
  geom_hline(yintercept = .50, colour = "grey30", linetype = "dotted") +
  geom_line(linewidth = 0.8) + geom_point(size = 2) +
  scale_colour_manual(values = c(kol[["drugi"]], "grey35", kol[["wybrani"]]), name = NULL) +
  scale_shape_manual(values = c(17, 15, 16), name = NULL) +
  scale_linetype_manual(values = c("dashed", "dotdash", "solid"), name = NULL) +
  scale_x_reverse(labels = function(x) paste0(100 * x, "%"), breaks = c(1, .75, .5, .25, .05)) +
  scale_y_continuous(limits = c(0, 1), breaks = seq(0, 1, .2), labels = function(x) bz(x, 1)) +
  labs(x = "Ile populacji zostaje w próbie", y = "Korelacja r w podzbiorze",
       title = "B. Trzy sposoby zawężania X", subtitle = "Linia kropkowana: r w populacji (.50)") + motyw
p4 <- pa + pb + plot_layout(guides = "collect") & theme(legend.position = "bottom", legend.direction = "vertical")
p4   # zapis: ggsave("ograniczony-zakres-skrajne-grupy.svg", p4, width = 9, height = 6)
Wynik w R
                     n     r   SD_X   SD_Y     b
populacja       100000 0.500 10.000 10.000 0.500
skrajne 2 × 15%  30000 0.685 16.156 11.807 0.501
                         sposob zostaje     r  SD_X     b
    skrajne grupy (oba końce X)     0.5 0.618 13.62 0.499
    skrajne grupy (oba końce X)     0.3 0.685 16.16 0.501
    skrajne grupy (oba końce X)     0.1 0.769 20.99 0.498
    tylko środek X (bez końców)     0.5 0.217  3.80 0.507
    tylko środek X (bez końców)     0.3 0.132  2.23 0.520
    tylko środek X (bez końców)     0.1 0.038  0.73 0.442
 górna część X (próg przyjęcia)     0.5 0.329  6.02 0.501
 górna część X (próg przyjęcia)     0.3 0.282  5.15 0.495
 górna część X (próg przyjęcia)     0.1 0.225  4.14 0.477
5. 1000 badań i poprawka Thorndike’a (Case II): Rysunek 5
R
# Rysunek 5. 1000 badań po 100 osób: pełny zakres, próba przyjętych i poprawka Thorndike'a (Case II)
# (kontynuacja: pop, N, kol, motyw i bz() z przepisu 1)

# Poprawka Case II dla selekcji bezpośredniej po X: u = SD(X) w populacji / SD(X) w próbie.
# SD w populacji (10 punktów T) badacz zna z norm testu.
case2 <- function(r, u) r * u / sqrt(1 + r^2 * (u^2 - 1))
ci_r <- function(r, n) tanh(atanh(r) + c(-1, 1) * qnorm(.975) / sqrt(n - 3))   # 95% CI z transformacji Fishera

B <- 1000; n <- 100; kandydaci <- 334        # 100 z 334 kandydatów to ok. 30%
set.seed(593)
sym <- do.call(rbind, lapply(1:B, function(i) {
  k <- pop[sample.int(N, kandydaci), ]
  losowa <- k[sample.int(kandydaci, n), ]                 # badanie bez selekcji: 100 przypadkowych osób
  przyj_x <- k[order(-k$X)[1:n], ]                       # przyjęto 100 najlepszych w X (selekcja bezpośrednia)
  przyj_z <- k[order(-k$Z)[1:n], ]                       # przyjęto 100 najlepszych w Z (selekcja pośrednia)
  wiersz <- function(d, typ, popraw) {
    r <- cor(d$X, d$Y); u <- 10 / sd(d$X); ci <- ci_r(r, n)
    if (popraw) { r <- case2(r, u); ci <- case2(ci, u) }
    data.frame(badanie = i, typ = typ, r = r, dolna = ci[1], gorna = ci[2], u = u,
               p = cor.test(d$X, d$Y)$p.value)
  }
  rbind(wiersz(losowa, "A. Losowa próba z populacji", FALSE),
        wiersz(przyj_x, "B. Przyjęci po X, bez poprawki", FALSE),
        wiersz(przyj_x, "C. Przyjęci po X, poprawka Case II", TRUE),
        wiersz(przyj_z, "D. Przyjęci po Z, poprawka Case II na X", TRUE))
}))
sym$typ <- factor(sym$typ, unique(sym$typ))

# Średnie r, rozrzut, odsetek p < .05 i pokrycie przedziału (z błędem Monte Carlo)
mc <- function(p) sqrt(p * (1 - p) / B)
pods <- do.call(rbind, lapply(split(sym, sym$typ), function(d) {
  istotne <- mean(d$p < .05); pokrycie <- mean(d$dolna <= .50 & d$gorna >= .50)
  data.frame(typ = d$typ[1], sr_r = mean(d$r), mediana_r = median(d$r), SD_r = sd(d$r), sr_u = mean(d$u),
             p_mniej_05 = istotne, MC_p = mc(istotne), pokrycie_95 = pokrycie, MC_pokr = mc(pokrycie))
}))
print(transform(pods, sr_r = round(sr_r, 3), mediana_r = round(mediana_r, 3), SD_r = round(SD_r, 3),
                sr_u = round(sr_u, 2), p_mniej_05 = round(p_mniej_05, 3), MC_p = round(MC_p, 3),
                pokrycie_95 = round(pokrycie_95, 3), MC_pokr = round(MC_pokr, 3)), row.names = FALSE)

# Etykiety paneli z wynikiem symulacji
pods$etyk <- sprintf("%s: średnio %s, przedział obejmuje .50 w %.1f%%", pods$typ, bz(pods$sr_r), 100 * pods$pokrycie_95)
sym$panel <- factor(pods$etyk[match(sym$typ, pods$typ)], pods$etyk)
pods$panel <- factor(pods$etyk, pods$etyk)
p5 <- ggplot(sym, aes(r)) +
  geom_histogram(aes(fill = panel), binwidth = 0.025, boundary = 0, colour = "white", linewidth = 0.2) +
  geom_vline(xintercept = .50, colour = kol[["ciemny"]], linetype = "dashed") +
  geom_vline(data = pods, aes(xintercept = sr_r), colour = kol[["ciemny"]], linewidth = 0.9) +
  facet_wrap(~ panel, ncol = 1) +
  scale_fill_manual(values = c(kol[["drugi"]], kol[["wybrani"]], "grey45", "grey70"), guide = "none") +
  scale_x_continuous(limits = c(-0.1, 1), breaks = seq(0, 1, .1), labels = function(x) bz(x, 1)) +
  labs(x = "Korelacja r w badaniu (po poprawce w C i D)", y = "Liczba badań",
       title = "1000 badań po 100 osób z tej samej populacji (r = .50)",
       subtitle = "Linia przerywana: r w populacji; ciągła: średnia z 1000 badań") +
  motyw + theme(strip.text = element_text(hjust = 0, size = rel(0.8)))
p5   # zapis: ggsave("ograniczony-zakres-1000-badan.svg", p5, width = 8, height = 8.6)
Wynik w R
                                     typ  sr_r mediana_r  SD_r sr_u p_mniej_05  MC_p pokrycie_95
             A. Losowa próba z populacji 0.500     0.505 0.076 1.00      1.000 0.000       0.950
          B. Przyjęci po X, bez poprawki 0.279     0.276 0.099 1.97      0.817 0.012       0.278
      C. Przyjęci po X, poprawka Case II 0.480     0.496 0.140 1.97      0.817 0.012       0.937
 D. Przyjęci po Z, poprawka Case II na X 0.432     0.435 0.099 1.26      0.955 0.007       0.905
 MC_pokr
   0.007
   0.014
   0.008
   0.009
6. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Czy kolory rysunków przetrwają zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
roznica <- function(k) {                        # najmniejsza odległość ΔE (CIELAB) między kolorami zestawu
  lab <- coords(as(hex2RGB(k), "LAB")); min(dist(lab))
}
zestawy <- list("w próbie / poza próbą (rysunki 1, 3, 4A)" = c("#D55E00", "grey80"),
                "selekcja po X / po Y / po Z (rysunek 2)" = c("#D55E00", "#0072B2", "grey35"),
                "trzy sposoby zawężania (rysunek 4B)" = c("#0072B2", "grey35", "#D55E00"),
                "cztery histogramy (rysunek 5)" = c("#0072B2", "#D55E00", "grey45", "grey70"),
                "czerwony – zielony (dla porównania)" = c("#E41A1C", "#4DAF4A"))
zestawy <- lapply(zestawy, function(k) rgb(t(col2rgb(k)), maxColorValue = 255))
round(t(sapply(zestawy, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                      protanopia = roznica(protan(k))))), 1)
Wynik w R
                                         widzenie_typowe deuteranopia protanopia
w próbie / poza próbą (rysunki 1, 3, 4A)            81.6         67.1       63.9
selekcja po X / po Y / po Z (rysunek 2)             42.2         45.3       39.9
trzy sposoby zawężania (rysunek 4B)                 42.2         45.3       39.9
cztery histogramy (rysunek 5)                       24.5         24.5       24.5
czerwony – zielony (dla porównania)                121.7         21.1       31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (korelacje, regresja, test korelacji i losowanie – pakiet stats; populacja o zadanych korelacjach – funkcja mvrnorm() pakietu MASS). Rysunki wykonano w ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite; paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1), 1–49. https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- „Zmienne nie są powiązane”, bo w wyselekcjonowanej próbie r jest małe. Związek może być taki sam jak w populacji – zabrakło rozrzutu (rysunek 1).
- Porównywanie korelacji z prób o różnym zakresie. Różnica r między kierunkami czy rocznikami może wynikać tylko z różnych SD (rysunek 2).
- Badanie tylko „skrajnych” osób i podawanie r jako siły związku w populacji. Taki dobór zawyża korelację (rysunek 4).
- Poprawka Case II bez sprawdzenia, po czym była selekcja. Przy selekcji pośredniej niedoszacowuje korekty, a przy selekcji po Y nachylenie też jest zaniżone (rysunki 3 i 5).
- Tylko skorygowane r, bez wartości z próby i bez źródła SD populacji. Czytelnik nie może ocenić korekty.
Najczęstsze pytania
Dlaczego w wyselekcjonowanej próbie korelacja jest niższa, choć związek jest ten sam?
Bo korelacja porównuje zmienność wyjaśnioną z całą zmiennością. Gdy w próbie zostają osoby o podobnym X, X ma mało do wyjaśnienia. W naszej fikcyjnej populacji r = .50, ale wśród górnych 10% według X r = .23. Nachylenie prostej wciąż wynosiło około 0.5 punktu Y na punkt X.
Czy ma znaczenie, czy selekcja odbyła się po predyktorze, czy po zmiennej zależnej?
Tak. Przy 30% zachowanych korelacja była w obu przypadkach podobna (.28 i .29), ale przy selekcji po X nachylenie zostało prawidłowe (0.50), a przy selekcji po Y spadło do 0.16. Selekcja po wyniku bywa ukryta, np. gdy badasz tylko osoby, które zaliczyły przedmiot.
Czy wybór skrajnych grup może zawyżyć korelację?
Tak. Gdy zostawisz po 15% osób z najniższym i najwyższym X, rozrzut X rośnie, a r w naszym przykładzie wzrosło z .50 do .69. Przy 10% zachowanych było to już .77. Taki dobór zwiększa moc, ale r z niego nie jest oszacowaniem korelacji w populacji.
Kiedy stosować poprawkę Thorndike’a na ograniczenie zakresu?
Gdy selekcja odbyła się bezpośrednio po zmiennej X i znasz jej SD bez ograniczenia, np. z norm. W 1000 symulowanych badaniach poprawka przesunęła średnie r z .28 do .48, ale niemal podwoiła rozrzut wyników. Przy selekcji po trzeciej zmiennej ta sama poprawka dała średnio .43 zamiast .50. Zawsze podawaj wartość przed i po poprawce.
Co napisać w ograniczeniach pracy, gdy badałem studentów jednego kierunku?
Podaj SD głównych zmiennych i porównaj je z normami albo z badaniami na szerszych grupach. Nazwij zmienną, według której odbyła się selekcja (np. rekrutacja), i napisz, że korelacje mogą być niższe niż w populacji. Obok r raportuj nachylenie w jednostkach skali.
Powiązane hasła
Przeczytaj też
Badanie na studentach i ankieta na zajęciach
Co wolno wnioskować z próby studenckiej, wąski zakres zmiennych, grupy ćwiczeniowe jako skupienia, symulacje w R i zdania do Metody.
Czytaj →PoradnikZawsze narysuj dane
Kwartet Anscombe’a i cztery pułapki korelacji na wykresach z R – z podpisem APA i zdaniem do Wyników przy każdym rysunku.
Czytaj →PoradnikBłąd selekcji i zmienna zderzeniowa w praktyce
Ochotnicy online, rezygnacje i biobanki: symulacje w R, korekta wagami IPW i sytuacje, w których żadna korekta nie wystarczy.
Czytaj →PoradnikZmienna zakłócająca i collider – wizualizacja
Trzy grafy w ggplot2, kontrola w regresji na wykresie rozrzutu, 1000 badań z każdego grafu i dobór próby według zderzacza – pięć rysunków z kodem R.
Czytaj →PoradnikTrafność testu rekrutacyjnego i korekta Thorndike’a
Test koreluje z oceną pracy tylko na r = .27, bo zatrudniono najlepszych. Korekta Thorndike’a z przedziałem bootstrap, test uwagi i próg – z kodem R.
Czytaj →Masz próbę z jednego kierunku i słabe korelacje?
Pomożemy ocenić, czy zakres zmiennych jest zawężony, dobrać sposób raportowania i opisać ograniczenia tak, żebyś umiał(a) je obronić przed promotorem i recenzentem.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bland, J. M., & Altman, D. G. (2011). Correlation in restricted ranges of data. BMJ, 342, Article d556. https://doi.org/10.1136/bmj.d556
- Hunter, J. E., Schmidt, F. L., & Le, H. (2006). Implications of direct and indirect range restriction for meta-analysis methods and findings. Journal of Applied Psychology, 91(3), 594–612. https://doi.org/10.1037/0021-9010.91.3.594
- Le, H., & Schmidt, F. L. (2006). Correcting for indirect range restriction in meta-analysis: Testing a new meta-analytic procedure. Psychological Methods, 11(4), 416–438. https://doi.org/10.1037/1082-989x.11.4.416 ● Otwarty dostęp: pełny tekst
- Preacher, K. J., Rucker, D. D., MacCallum, R. C., & Nicewander, W. A. (2005). Use of the extreme groups approach: A critical reexamination and new recommendations. Psychological Methods, 10(2), 178–192. https://doi.org/10.1037/1082-989x.10.2.178 ● Otwarty dostęp: pełny tekst
- Sackett, P. R., & Yang, H. (2000). Correction for range restriction: An expanded typology. Journal of Applied Psychology, 85(1), 112–118. https://doi.org/10.1037/0021-9010.85.1.112
- Sackett, P. R., Zhang, C., Berry, C. M., & Lievens, F. (2022). Revisiting meta-analytic estimates of validity in personnel selection: Addressing systematic overcorrection for restriction of range. Journal of Applied Psychology, 107(11), 2040–2068. https://doi.org/10.1037/apl0000994
- Wiberg, M., & Sundström, A. (2009). A comparison of two approaches to correction of restriction of range in correlation analysis. Practical Assessment, Research, and Evaluation, 14, Article 5. https://doi.org/10.7275/as0k-tm88 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{bland2011correlation, author={Bland, J. Martin and Altman, Douglas G.}, title={{Correlation in restricted ranges of data}}, journal={BMJ}, year={2011}, volume={342}, eid={d556}, doi={10.1136/bmj.d556}}@article{hunter2006implications, author={Hunter, John E. and Schmidt, Frank L. and Le, Huy}, title={{Implications of direct and indirect range restriction for meta-analysis methods and findings}}, journal={Journal of Applied Psychology}, year={2006}, volume={91}, number={3}, pages={594--612}, doi={10.1037/0021-9010.91.3.594}}@article{le2006correcting, author={Le, Huy and Schmidt, Frank L.}, title={{Correcting for indirect range restriction in meta-analysis: Testing a new meta-analytic procedure}}, journal={Psychological Methods}, year={2006}, volume={11}, number={4}, pages={416--438}, doi={10.1037/1082-989x.11.4.416}}@article{preacher2005use, author={Preacher, Kristopher J. and Rucker, Derek D. and MacCallum, Robert C. and Nicewander, W. Alan}, title={{Use of the extreme groups approach: A critical reexamination and new recommendations}}, journal={Psychological Methods}, year={2005}, volume={10}, number={2}, pages={178--192}, doi={10.1037/1082-989x.10.2.178}}@article{sackett2000correction, author={Sackett, Paul R. and Yang, Hyuckseung}, title={{Correction for range restriction: An expanded typology}}, journal={Journal of Applied Psychology}, year={2000}, volume={85}, number={1}, pages={112--118}, doi={10.1037/0021-9010.85.1.112}}@article{sackett2022revisiting, author={Sackett, Paul R. and Zhang, Charlene and Berry, Christopher M. and Lievens, Filip}, title={{Revisiting meta-analytic estimates of validity in personnel selection: Addressing systematic overcorrection for restriction of range}}, journal={Journal of Applied Psychology}, year={2022}, volume={107}, number={11}, pages={2040--2068}, doi={10.1037/apl0000994}}@article{wiberg2009comparison, author={Wiberg, Marie and Sundström, Anna}, title={{A comparison of two approaches to correction of restriction of range in correlation analysis}}, journal={Practical Assessment, Research, and Evaluation}, year={2009}, volume={14}, eid={5}, doi={10.7275/as0k-tm88}}