Co to jest model selekcji Heckmana?
Model selekcji Heckmana (ang. Heckman selection model, heckit) koryguje regresję, gdy wynik obserwujemy tylko u części osób, a o tym, kto trafia do próby, decyduje proces związany z wynikiem. Klasyczny przykład: płacę znamy tylko u pracujących, a decyzja o pracy zależy od spodziewanej płacy. Heckman (1979) potraktował taki błąd selekcji jak błąd specyfikacji, czyli pominięcie zmiennej, i zaproponował prosty, zgodny estymator dwustopniowy.
Dwa kroki
- Równanie selekcji. Regresja probitowa na wszystkich osobach: czy wynik jest obserwowany.
- Równanie wyniku. Regresja liniowa tylko na obserwowanych, z odwrotnym ilorazem Millsa (IMR) z kroku 1 jako dodatkowym predyktorem.
Istotny współczynnik przy IMR wskazuje na selekcję związaną z wynikiem. Zwykłe błędy standardowe z kroku 2 są niepoprawne; właściwe liczą pakiety, a alternatywą jest estymacja metodą największej wiarygodności.
Założenia i krytyka
Model zakłada łączny rozkład normalny błędów obu równań. Potrzebna jest też restrykcja wykluczająca: zmienna, która wpływa na selekcję, ale nie na wynik. Bez niej identyfikacja opiera się tylko na nieliniowości IMR, a IMR bywa silnie współliniowy z pozostałymi predyktorami. Puhani (2000) w przeglądzie symulacji zaleca sprawdzenie współliniowości przed wyborem estymatora. Bez niej estymator największej wiarygodności jest lepszy od dwustopniowego, a przy silnej współliniowości najodporniejszy jest MNK na podpróbie lub model dwuczęściowy. Winship i Mare (1992) podkreślają wrażliwość wyników na założenia o mechanizmie selekcji i zalecają porównanie kilku metod.
Przykład
W przykładzie z R prawdziwe nachylenie wynosi 0.5, a wynik znamy u 52.4% osób. Zwykła regresja na obserwowanych daje 0.376, model Heckmana 0.450, a współczynnik przy IMR wynosi 0.495. Funkcja heckit() z pakietu sampleSelection daje te same współczynniki z poprawionym błędem standardowym nachylenia (0.032 zamiast 0.031), a estymacja metodą największej wiarygodności (selection()) – nachylenie 0.458 i korelację błędów ρ = 0.55 (prawdziwa 0.6).
Model Heckmana odróżnij od modelu tobitowego, w którym jeden proces decyduje o obserwacji i wartości wyniku, oraz od danych uciętych. Brakujące wyniki są tu brakami typu MNAR (braki danych).
Na rysunku
Panel A pokazuje dane z przykładu (set.seed(57901)). W symulacji znamy też wyniki osób, których „nie obserwujemy”, więc widać, co ginie przy selekcji. Dla czytelności narysowano 600 pierwszych osób, ale proste policzono na wszystkich 2000. Panel B to 500 powtórzeń tego samego badania (ponownie set.seed(57901)) z parametrami z przykładu, ustawionymi ręcznie: nachylenie 0.5, korelacja błędów 0.6.
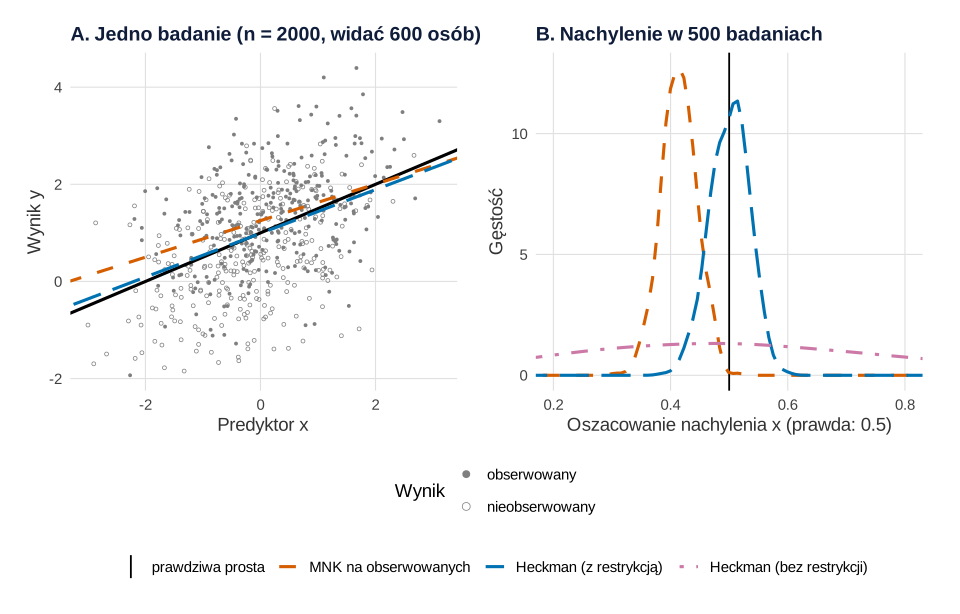
Co widać. Przy niskim x do próby trafiają głównie osoby z wysokim wynikiem, a przy wysokim x – prawie wszyscy. Lewy koniec chmury jest więc „podniesiony” i prosta MNK na obserwowanych się spłaszcza: nachylenie 0.376 zamiast 0.5. Model Heckmana daje 0.450. W panelu B MNK na obserwowanych systematycznie zaniża nachylenie (średnio 0.414, SD 0.030). Model Heckmana z restrykcją wykluczającą trafia średnio w 0.500 (SD 0.033). Błąd Monte Carlo średnich wynosi 0.001.
Na co uważać. Trzecia krzywa to ten sam model bez zmiennej z w równaniu selekcji. Identyfikacja opiera się wtedy tylko na nieliniowości IMR. Średnio oszacowanie jest bliskie prawdy (0.492, błąd MC 0.013), ale SD wynosi 0.297, a 49.6% oszacowań leży poza przedziałem 0.3–0.7. W pojedynczym badaniu taki wynik jest prawie bezużyteczny. Rysunek pokazuje też sytuację idealną: błędy są dokładnie normalne, a z naprawdę nie wpływa na wynik. W danych rzeczywistych żadnego z tych założeń nie da się sprawdzić na wykresie, więc poprawka może być gorsza niż na rysunku. Inne skutki nielosowego doboru pokazuje wpis dobór nielosowy w obrazkach.
Podpis do pracy:
Kod poniżej odtwarza rysunek i liczby z opisu. Jest samowystarczalny: paletę Okabe–Ito i prosty motyw definiuje sam. Rysunek na stronie powstał z tego samego obiektu p z motywem serwisu. Dane, geometrie i skale są identyczne, różni się tylko krój czcionki i siatka.
Kod R rysunku 1
# Rysunek 1. Selekcja zależna od wyniku: dane z przykładu (A) i rozkład nachylenia w 500 symulowanych badaniach (B)
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito i prosty motyw; metody rozróżnia też typ linii
kol <- c("prawdziwa prosta" = "black", "MNK na obserwowanych" = "#D55E00",
         "Heckman (z restrykcją)" = "#0072B2", "Heckman (bez restrykcji)" = "#CC79A7")
lin <- c("prawdziwa prosta" = "solid", "MNK na obserwowanych" = "dashed",
         "Heckman (z restrykcją)" = "longdash", "Heckman (bez restrykcji)" = "dotdash")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

# Generator danych jak w przykładzie: prawdziwe nachylenie 0.5, korelacja błędów 0.6, z wpływa tylko na selekcję
generuj <- function(n = 2000) {
  x <- rnorm(n); z <- rnorm(n)
  u <- rnorm(n); e <- 0.6 * u + sqrt(1 - 0.6^2) * rnorm(n)
  data.frame(x, z, s = (0.2 + 1.0 * z + 0.5 * x + u) > 0, y = 1 + 0.5 * x + e)
}
mnk <- function(d) coef(lm(y ~ x, data = d, subset = s))
heckman <- function(d, wzor_selekcji) {               # dwa kroki: probit, IMR, MNK na obserwowanych
  xb <- predict(glm(wzor_selekcji, family = binomial(link = "probit"), data = d), type = "link")
  d$imr <- dnorm(xb) / pnorm(xb)
  coef(lm(y ~ x + imr, data = d, subset = s))[c("(Intercept)", "x")]
}

# A. Dane z przykładu: wyniki obserwowane i nieobserwowane (te znamy tylko w symulacji)
set.seed(57901)
d <- generuj()
proste <- data.frame(metoda = factor(names(kol)[1:3], levels = names(kol)),
                     rbind(c(1, 0.5), mnk(d), heckman(d, s ~ z + x)))
names(proste)[2:3] <- c("wyraz", "nachylenie")
print(cbind(proste[1], round(proste[-1], 3)), row.names = FALSE)
d$status <- factor(ifelse(d$s, "obserwowany", "nieobserwowany"), levels = c("obserwowany", "nieobserwowany"))
pA <- ggplot(d[1:600, ], aes(x, y)) +                # punkty: pierwsze 600 osób (proste liczone na wszystkich 2000)
  geom_point(aes(shape = status), colour = "grey50", size = 1.1, stroke = 0.4) +
  geom_abline(data = proste, aes(intercept = wyraz, slope = nachylenie, colour = metoda, linetype = metoda), linewidth = 1.1) +
  scale_shape_manual(values = c(obserwowany = 16, nieobserwowany = 1), name = "Wynik") +
  scale_colour_manual(values = kol, name = NULL, drop = TRUE) +
  scale_linetype_manual(values = lin, name = NULL, drop = TRUE) +
  guides(shape = guide_legend(order = 1, ncol = 1, override.aes = list(size = 2.5)), colour = "none", linetype = "none") +
  labs(title = "A. Jedno badanie (n = 2000, widać 600 osób)", x = "Predyktor x", y = "Wynik y") +
  motyw

# B. 500 symulowanych badań: MNK na obserwowanych i Heckman z restrykcją wykluczającą (z) oraz bez niej
set.seed(57901)
R <- 500
sym <- t(replicate(R, {
  ds <- generuj()
  c(mnk(ds)["x"], heckman(ds, s ~ z + x)["x"], heckman(ds, s ~ x)["x"])
}))
colnames(sym) <- names(kol)[2:4]
round(rbind(srednia = colMeans(sym), SD = apply(sym, 2, sd), blad_MC_sredniej = apply(sym, 2, sd) / sqrt(R),
            odsetek_poza_0.3_0.7 = colMeans(sym < 0.3 | sym > 0.7)), 3)
dl <- data.frame(metoda = factor(rep(colnames(sym), each = R), levels = names(kol)), b = c(sym))
pB <- ggplot(dl, aes(b, colour = metoda, linetype = metoda)) +
  geom_vline(data = data.frame(metoda = factor("prawdziwa prosta", levels = names(kol))),
             aes(xintercept = 0.5, colour = metoda, linetype = metoda)) +
  geom_line(stat = "density", linewidth = 1.1, adjust = 1.2, n = 256) +
  scale_colour_manual(values = kol, name = NULL, drop = FALSE) +
  scale_linetype_manual(values = lin, name = NULL, drop = FALSE) +
  coord_cartesian(xlim = c(0.2, 0.8)) +
  labs(title = "B. Nachylenie w 500 badaniach", x = "Oszacowanie nachylenia x (prawda: 0.5)", y = "Gęstość") +
  motyw

p <- (pA + pB) + plot_layout(guides = "collect") & theme(legend.position = "bottom", legend.box = "vertical")
p
Wynik w R
                 metoda wyraz nachylenie
       prawdziwa prosta 1.000      0.500
   MNK na obserwowanych 1.252      0.376
 Heckman (z restrykcją) 0.990      0.450
                     MNK na obserwowanych Heckman (z restrykcją)
srednia                             0.414                  0.500
SD                                  0.030                  0.033
blad_MC_sredniej                    0.001                  0.001
odsetek_poza_0.3_0.7                0.000                  0.000
                     Heckman (bez restrykcji)
srednia                                 0.492
SD                                      0.297
blad_MC_sredniej                        0.013
odsetek_poza_0.3_0.7                    0.496
Jak opisać w pracy
Dwustopniowy model Heckmana w R
Kod symuluje selekcję zależną od wyniku i liczy model Heckmana ręcznie: probit, odwrotny iloraz Millsa, MNK. Na końcu ten sam model liczą funkcje sampleSelection::heckit() (dwa kroki z poprawnymi błędami standardowymi) i sampleSelection::selection() (największa wiarygodność).
Probit, IMR i MNK na obserwowanych
R
# Model selekcji Heckmana: dwa kroki ręcznie (dane symulowane)
set.seed(57901)
n <- 2000
x <- rnorm(n)                           # np. staż pracy (standaryzowany)
z <- rnorm(n)                           # wpływa tylko na selekcję (restrykcja wykluczająca)
u <- rnorm(n); e <- 0.6 * u + sqrt(1 - 0.6^2) * rnorm(n)   # korelacja błędów 0.6
s <- (0.2 + 1.0 * z + 0.5 * x + u) > 0  # czy wynik jest obserwowany (np. czy pracuje)
y <- 1 + 0.5 * x + e                    # wynik (np. log płacy), prawdziwe nachylenie 0.5
y[!s] <- NA
# Krok 1: probit selekcji i odwrotny iloraz Millsa
pr <- glm(s ~ z + x, family = binomial(link = "probit"))
xb <- predict(pr, type = "link")
imr <- dnorm(xb) / pnorm(xb)
# Krok 2: MNK na obserwowanych z IMR jako dodatkowym predyktorem
naiwny <- lm(y ~ x, subset = s)
heck <- lm(y ~ x + imr, subset = s)
round(c(obserwowani = mean(s), nachylenie_naiwne = unname(coef(naiwny)["x"]),
        nachylenie_heckman = unname(coef(heck)["x"]), wsp_IMR = unname(coef(heck)["imr"])), 3)
# Błędy standardowe z kroku 2 są niepoprawne; pakiet sampleSelection liczy je właściwie
dwa <- coef(summary(sampleSelection::heckit(s ~ z + x, y ~ x)))     # dwa kroki
mnw <- coef(summary(sampleSelection::selection(s ~ z + x, y ~ x)))  # największa wiarygodność
round(rbind(krok2_lm = coef(summary(heck))["x", 1:2], heckit = dwa[5, 1:2], ML = mnw[5, 1:2]), 3)  # nachylenie x i SE
round(c(IMR_heckit = dwa["invMillsRatio", 1], rho_heckit = dwa["rho", 1], rho_ML = mnw["rho", 1]), 3)
Wynik w R
       obserwowani  nachylenie_naiwne nachylenie_heckman            wsp_IMR
             0.524              0.376              0.450              0.495
         Estimate Std. Error
krok2_lm    0.450      0.031
heckit      0.450      0.032
ML          0.458      0.032
IMR_heckit rho_heckit     rho_ML
     0.495      0.515      0.551
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base i stats oraz pakiet sampleSelection 1.2.16). Rysunek 1 wykonano pakietami ggplot2 i patchwork i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- sampleSelection (wersja 1.2.16): Toomet, O., & Henningsen, A. (2008). Sample selection models in R: Package sampleSelection. Journal of Statistical Software, 27(7), 1–23. https://doi.org/10.18637/jss.v027.i07
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym jest odwrotny iloraz Millsa w modelu Heckmana?
To iloraz gęstości i dystrybuanty rozkładu normalnego w punkcie przewidywanym przez probit selekcji. Mierzy, jak bardzo dana osoba „musiała” zostać wyselekcjonowana. Dodany do regresji wyniku pełni rolę pominiętej zmiennej, o której pisał Heckman (1979).
Czy model Heckmana działa bez restrykcji wykluczającej?
Formalnie tak, bo identyfikuje go nieliniowość IMR, ale wyniki są wtedy niestabilne przez współliniowość. Puhani (2000) zaleca najpierw sprawdzić współliniowość; przy silnej lepszy bywa MNK na podpróbie lub model dwuczęściowy.
Kiedy wybrać model Heckmana, a kiedy model tobitowy?
Model tobitowy zakłada, że jeden proces decyduje i o tym, czy wynik przekracza próg, i o jego wartości. Model Heckmana pozwala, by o selekcji decydowały inne zmienne niż o wartości wyniku, np. liczba dzieci o podjęciu pracy, a staż o płacy.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Błąd selekcji i zmienna zderzeniowa w praktyce
Ochotnicy online, rezygnacje i biobanki: symulacje w R, korekta wagami IPW i sytuacje, w których żadna korekta nie wystarczy.
Czytaj →PoradnikDobór próby w pracy dyplomowej
Metody losowe i nielosowe, co wolno wnioskować z próby wygodnej, symulacja w R, kryteria włączenia i gotowy opis doboru do rozdziału metodologicznego.
Czytaj →PoradnikAukcje internetowe – co podnosi cenę końcową
3000 aukcji zegarków: regresja log(ceny) w %, niesprzedane aukcje i cenzurowanie, model dwuczęściowy, mediator i błędy klastrowane – z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Heckman, J. J. (1979). Sample selection bias as a specification error. Econometrica, 47(1), 153. https://doi.org/10.2307/1912352
- Puhani, P. (2000). The Heckman correction for sample selection and its critique. Journal of Economic Surveys, 14(1), 53–68. https://doi.org/10.1111/1467-6419.00104 ● Otwarty dostęp: pełny tekst
- Winship, C., & Mare, R. D. (1992). Models for sample selection bias. Annual Review of Sociology, 18(1), 327–350. https://doi.org/10.1146/annurev.so.18.080192.001551
Cytowania BibTeX
@article{heckman1979sample, author={Heckman, James J.}, title={{Sample selection bias as a specification error}}, journal={Econometrica}, year={1979}, volume={47}, number={1}, pages={153}, doi={10.2307/1912352}}@article{puhani2000heckman, author={Puhani, Patrick}, title={{The Heckman correction for sample selection and its critique}}, journal={Journal of Economic Surveys}, year={2000}, volume={14}, number={1}, pages={53--68}, doi={10.1111/1467-6419.00104}}@article{winship1992models, author={Winship, Christopher and Mare, Robert D.}, title={{Models for sample selection bias}}, journal={Annual Review of Sociology}, year={1992}, volume={18}, number={1}, pages={327--350}, doi={10.1146/annurev.so.18.080192.001551}}