Czym są dane ucięte?
Dane ucięte (ang. truncated data, truncation) powstają, gdy do próby trafiają tylko osoby z wynikiem po jednej stronie progu, a o pozostałych nie wiemy nic – nawet tego, że istniały. Przy danych ocenzurowanych (censored data) osoba jest w próbie, znamy jej predyktory, a o wyniku wiemy tylko, że leży na progu lub poza nim (obserwacja cenzurowana). W polskich tekstach „ucięta” bywa używane jako synonim „cenzurowanej”; w modelach statystycznych to dwa różne problemy.
Przykłady
- Regresja: badanie wydatków tylko wśród osób, które coś kupiły (ucięcie), a wydatki zero zapisane jako 0 przy pełnej próbie (cenzurowanie, model tobitowy).
- Analiza przeżycia: Cain i in. (2011) opisują badania podłużne, w których część uczestników przeszła już badany etap przed włączeniem. Wiek tego etapu jest lewostronnie cenzurowany, jeśli takie osoby włączono do badania, a lewostronnie ucięty, jeśli ich nie włączono.
Skutki i metody
Zwykła regresja na danych uciętych według zmiennej zależnej zwykle zaniża nachylenie, bo próba nie obejmuje części rozkładu. W przykładzie z R (prawdziwe nachylenie 2, próg y = 0) MNK na pełnych danych daje 2.09, na danych uciętych 1.31, a na danych z zerami 1.32. Tobit na danych ocenzurowanych daje 2.12, a model ucięty (największa wiarygodność z gęstością podzieloną przez prawdopodobieństwo przekroczenia progu) – 2.07. W analizie przeżycia ucięcie uwzględnia się, licząc ryzyko dopiero od momentu wejścia do badania. Cain i in. (2011) pokazali w symulacjach, że pominięcie lewostronnego ucięcia daje istotne obciążenie i zaniżone błędy standardowe; lepiej, jeśli to możliwe, zebrać informację o etapie od wszystkich kandydatów i traktować ich jako cenzurowanych.
Na rysunku
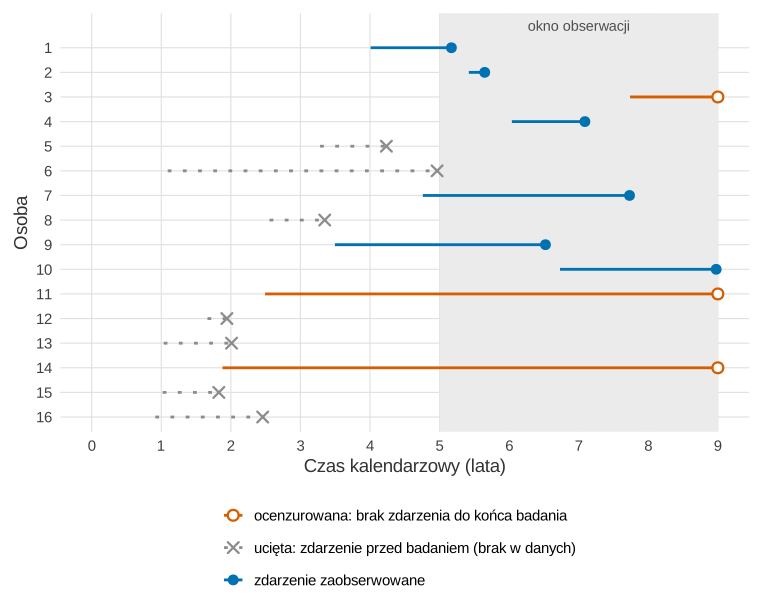
Co widać. Siedem z 16 osób miało zdarzenie przed startem badania (krzyżyki) – to obserwacje ucięte, nieobecne w danych. Trzy osoby do końca badania nie miały zdarzenia (puste kółka) – są w danych z czasem ocenzurowanym. W populacji 10 000 osób średni czas do zdarzenia wynosi 2.99 roku. Wśród osób, które trafiły do badania, jest to 3.82 roku, bo ucięcie usuwa głównie krótkie czasy (32.4% populacji). Gdy czasy ocenzurowane policzyć tak, jakby zdarzenie nastąpiło na końcu badania, średnia spada do 2.68 roku.
Na co uważać. Osoby ucięte widać tylko w symulacji. Część osób zaczęła okres ryzyka przed rokiem 5 (późne wejście); w krzywej Kaplana–Meiera ryzyko liczy się dla nich od wejścia do badania. Taki układ to odmiana wykresu pływaka. Okno 5–9 lat, średni czas 3 lata i liczbę 16 osób ustalono ręcznie; ziarna nie zmieniano.
Podpis do pracy:
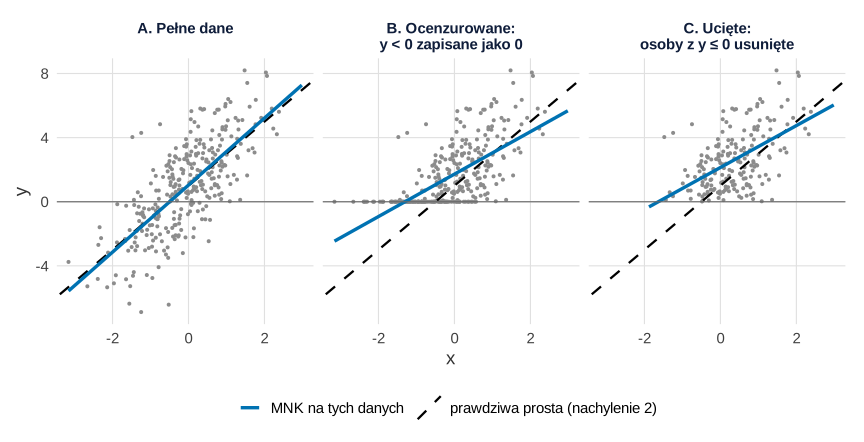
Co widać. Cenzurowanie układa wyniki ujemne w rzędzie na y = 0, a ucięcie usuwa dolną część chmury. W obu wersjach prosta MNK jest płaska: nachylenie 1.32 i 1.31 zamiast 2.09 na pełnych danych.
Na co uważać. Na wykresie są punkty pierwszych 300 z 1000 osób, a proste policzono ze wszystkich. Przy danych uciętych na wykresie nie widać, że czegoś brakuje – jedyną wskazówką jest ostra dolna granica chmury.
Podpis do pracy:
Kod R rysunków
# Rysunki 1–2: ucięcie i cenzurowanie na osi czasu oraz w regresji z progiem y = 0
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(zdarzenie = "#0072B2", cenzura = "#D55E00", uciete = "grey55", prawda = "#000000")
motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        strip.text = element_text(face = "bold", colour = "#0f1d3a"),
        plot.background = element_rect(fill = "white", colour = NA))

# Rysunek 1: początek ryzyka u ~ U(0, 8) lat, czas do zdarzenia T ~ wykładniczy (średnia 3 lata);
# badanie obserwuje lata 5–9 (okno i średnia ustalone ręcznie)
set.seed(5861)
start_b <- 5; koniec_b <- 9
osoby <- function(n) {
  u <- runif(n, 0, 8); T <- rexp(n, rate = 1 / 3)
  status <- ifelse(u + T < start_b, "ucięta: zdarzenie przed badaniem (brak w danych)",
            ifelse(u + T > koniec_b, "ocenzurowana: brak zdarzenia do końca badania",
                   "zdarzenie zaobserwowane"))
  data.frame(u = u, T = T, koniec = pmin(u + T, koniec_b), status = status)
}
populacja <- osoby(10000)                                # duża populacja do policzenia średnich
w_badaniu <- populacja[populacja$status != "ucięta: zdarzenie przed badaniem (brak w danych)", ]
round(c(srednia_T_populacja = mean(populacja$T),
        srednia_T_w_badaniu = mean(w_badaniu$T),            # gdyby znać pełne T osób w badaniu
        srednia_naiwna = mean(w_badaniu$koniec - w_badaniu$u), # cenzurowane czasy liczone jak zdarzenia
        odsetek_ucietych = 1 - nrow(w_badaniu) / nrow(populacja)), 3)
os <- osoby(16)                                         # 16 osób do rysunku
os$id <- factor(seq_len(nrow(os)), levels = rev(seq_len(nrow(os))))
os$koniec_rys <- ifelse(grepl("^ucięta", os$status), os$u + os$T, os$koniec)
p1 <- ggplot(os) +
  annotate("rect", xmin = start_b, xmax = koniec_b, ymin = -Inf, ymax = Inf, fill = "grey92") +
  annotate("text", x = (start_b + koniec_b) / 2, y = nrow(os) + 0.9, label = "okno obserwacji",
           size = 3.8, colour = "grey30") +
  geom_segment(aes(x = u, xend = koniec_rys, y = id, yend = id, colour = status, linetype = status),
               linewidth = 1) +
  geom_point(aes(x = koniec_rys, y = id, colour = status, shape = status), size = 3, stroke = 1.2,
             fill = "white") +
  scale_colour_manual(values = unname(kol[c("cenzura", "uciete", "zdarzenie")]), name = NULL) +
  scale_linetype_manual(values = c("solid", "dotted", "solid"), name = NULL) +
  scale_shape_manual(values = c(21, 4, 16), name = NULL) +
  scale_x_continuous(breaks = 0:12, limits = c(0, NA)) +
  scale_y_discrete(expand = expansion(add = c(0.6, 1.4))) +
  guides(colour = guide_legend(ncol = 1), linetype = guide_legend(ncol = 1), shape = guide_legend(ncol = 1)) +
  labs(x = "Czas kalendarzowy (lata)", y = "Osoba") + motyw

# Rysunek 2: dane z przykładu w haśle – y = 1 + 2x + błąd, próg y = 0
set.seed(586)
n <- 1000
x <- rnorm(n); y <- 1 + 2 * x + rnorm(n, sd = 2)
wersje <- c("A. Pełne dane\n ", "B. Ocenzurowane:\ny < 0 zapisane jako 0", "C. Ucięte:\nosoby z y ≤ 0 usunięte")
d2 <- rbind(data.frame(wersja = wersje[1], x = x, y = y),
            data.frame(wersja = wersje[2], x = x, y = pmax(y, 0)),
            data.frame(wersja = wersje[3], x = x[y > 0], y = y[y > 0]))
d2$wersja <- factor(d2$wersja, levels = wersje)
nachylenia <- sapply(split(d2, d2$wersja), function(d) coef(lm(y ~ x, data = d))[[2]])
round(setNames(nachylenia, c("pelne", "ocenzurowane", "uciete")), 2)
pokaz <- d2[d2$x %in% x[1:300], ]                        # na rysunku punkty pierwszych 300 osób
p2 <- ggplot(d2, aes(x, y)) +
  geom_point(data = pokaz, colour = "grey55", size = 1, shape = 16) +
  geom_abline(aes(intercept = 1, slope = 2, linetype = "prawdziwa prosta (nachylenie 2)"),
              colour = kol[["prawda"]], linewidth = 0.8) +
  geom_smooth(aes(linetype = "MNK na tych danych"), method = "lm", formula = y ~ x, se = FALSE,
              colour = kol[["zdarzenie"]], linewidth = 1.2) +
  geom_hline(yintercept = 0, colour = "grey40", linewidth = 0.4) +
  facet_wrap(~ wersja, ncol = 3) +
  scale_linetype_manual(values = c("solid", "dashed"), name = NULL,
                        guide = guide_legend(override.aes = list(colour = unname(kol[c("zdarzenie", "prawda")])))) +
  labs(x = "x", y = "y") + motyw

p1   # zapis: ggsave("dane-uciete-os-czasu.svg", p1, width = 8, height = 6.4)
p2   # zapis: ggsave("dane-uciete-regresja.svg", p2, width = 9, height = 4.6)
Wynik w R
srednia_T_populacja srednia_T_w_badaniu      srednia_naiwna    odsetek_ucietych
              2.990               3.821               2.677               0.324
       pelne ocenzurowane       uciete
        2.09         1.32         1.31
Rysunki na stronie powstały z tego kodu z motywem serwisu (dane, geometrie i skale identyczne).
Jak opisać w pracy
Na co uważać
Model ucięty zakłada znany próg i zwykle rozkład normalny reszt. Gdy o wejściu do próby decyduje odrębny proces, właściwszy bywa model selekcji Heckmana, a samo ucięcie jest szczególnym przypadkiem błędu selekcji. Standardowe metody dla cenzurowania też wymagają założeń o jego mechanizmie, który w badaniach obserwacyjnych zwykle jest nieznany (Leung i in., 1997).
Ucięcie i cenzurowanie w R
Kod tworzy jeden zbiór danych i z progu y = 0 robi dwie wersje: ocenzurowaną (wyniki ujemne zapisane jako 0) i uciętą (osoby z wynikiem ujemnym usunięte). Porównuje MNK, tobit (survreg()) i model ucięty napisany ręcznie (optim()).
Pięć oszacowań nachylenia
R
# Dane ucięte a ocenzurowane: ten sam próg y = 0, prawdziwe nachylenie 2
library(survival)
set.seed(586)
n <- 1000
x <- rnorm(n); y <- 1 + 2 * x + rnorm(n, sd = 2)
cenz <- pmax(y, 0)                         # cenzurowanie: osoby zostają, wynik = 0
uc <- y > 0                                # ucięcie: osób z y <= 0 nie ma w danych
tobit <- survreg(Surv(cenz, cenz > 0, type = "left") ~ x, dist = "gaussian")
# model ucięty (truncated regression) ręcznie: gęstość normalna podzielona przez P(y > 0)
nll <- function(p, y, x) {
  mu <- p[1] + p[2] * x; s <- exp(p[3])
  -sum(dnorm(y, mu, s, log = TRUE) - pnorm(0, mu, s, lower.tail = FALSE, log.p = TRUE))
}
trunc_fit <- optim(c(0, 1, 0), nll, y = y[uc], x = x[uc], method = "BFGS")
round(c(MNK_pelne = coef(lm(y ~ x))[[2]],
        MNK_uciete = coef(lm(y[uc] ~ x[uc]))[[2]],
        MNK_zera = coef(lm(cenz ~ x))[[2]],
        tobit = coef(tobit)[[2]],
        model_uciety = trunc_fit$par[2]), 2)
c(n_cenzurowane = sum(cenz == 0), n_w_danych_po_ucieciu = sum(uc))
Wynik w R
   MNK_pelne   MNK_uciete     MNK_zera        tobit model_uciety
        2.09         1.31         1.32         2.12         2.07
        n_cenzurowane n_w_danych_po_ucieciu
                  362                   638
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet survival: survreg(), Surv(); MNK funkcją lm(), model ucięty funkcją optim()); rysunki wykonano w pakiecie ggplot2, a pliki zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R [R package]. https://CRAN.R-project.org/package=survival
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Jak sprawdzić, czy moje dane są ucięte, czy ocenzurowane?
Zapytaj, czy osoby spoza progu są w zbiorze. Jeśli są, ale z wynikiem zapisanym jako próg, dane są ocenzurowane. Jeśli nie trafiły do próby wcale, dane są ucięte.
Czy model tobitowy nadaje się do danych uciętych?
Nie. Tobit wykorzystuje osoby z wynikiem na progu i ich predyktory. Gdy takich osób nie ma w danych, potrzebny jest model ucięty, w którym gęstość dzieli się przez prawdopodobieństwo przekroczenia progu.
Co to jest lewostronne ucięcie w analizie przeżycia?
Osoba trafia do badania dopiero po pewnym czasie od początku ryzyka, a ci, u których zdarzenie nastąpiło wcześniej, nie zostali włączeni. Ryzyko liczy się wtedy od momentu wejścia do badania.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Efekt sufitu i model Tobita
Cenzurowanie czy prawdziwe maksimum, Tobit w R z progiem górnym, trzy efekty z jednego współczynnika, założenia w symulacji i alternatywy.
Czytaj →PoradnikKaplan–Meier i model Coxa krok po kroku
Krzywe Kaplana–Meiera, log-rank, RMST, model Coxa, proporcjonalność hazardów i ryzyka konkurujące w R – z tabelą APA i opisem do artykułu.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Cain, K. C., Harlow, S. D., Little, R. J., Nan, B., Yosef, M., Taffe, J. R., & Elliott, M. R. (2011). Bias due to left truncation and left censoring in longitudinal studies of developmental and disease processes. American Journal of Epidemiology, 173(9), 1078–1084. https://doi.org/10.1093/aje/kwq481 ● Otwarty dostęp
- Leung, K.-M., Elashoff, R. M., & Afifi, A. A. (1997). Censoring issues in survival analysis. Annual Review of Public Health, 18(1), 83–104. https://doi.org/10.1146/annurev.publhealth.18.1.83
Cytowania BibTeX
@article{cain2011bias, author={Cain, Kevin C. and Harlow, Siobán D. and Little, Roderick J. and Nan, Bin and Yosef, Matheos and Taffe, John R. and Elliott, Michael R.}, title={{Bias due to left truncation and left censoring in longitudinal studies of developmental and disease processes}}, journal={American Journal of Epidemiology}, year={2011}, volume={173}, number={9}, pages={1078--1084}, doi={10.1093/aje/kwq481}}@article{leung1997censoring, author={Leung, Kwan-Moon and Elashoff, Robert M. and Afifi, Abdelmonem A.}, title={{Censoring issues in survival analysis}}, journal={Annual Review of Public Health}, year={1997}, volume={18}, number={1}, pages={83--104}, doi={10.1146/annurev.publhealth.18.1.83}}