Co to jest model tobitowy?
Model tobitowy (ang. tobit, od nazwiska Jamesa Tobina) to regresja dla zmiennej ciągłej, która ma skupisko wartości na progu – zwykle w zerze. Zakłada ukrytą zmienną y* = β₀ + β₁x + ε z błędem o rozkładzie normalnym; obserwujemy y = y*, gdy y* > 0, i y = 0 w przeciwnym razie. Model szacuje się metodą największej wiarygodności: obserwacje dodatnie wnoszą gęstość, a zera – prawdopodobieństwo, że y* ≤ 0, tak jak w regresji probitowej. Amemiya (1984) opisuje liczne odmiany, m.in. z progiem górnym i obustronnym.
Cenzurowanie a ucięcie
Zmienna jest cenzurowana, gdy znamy predyktory wszystkich osób, ale dla części tylko to, że wynik leży na progu lub poza nim – jak w obserwacji cenzurowanej w analizie przeżycia, tylko na osi wyniku zamiast czasu. Jest ucięta, gdy osób spoza progu w ogóle nie ma w danych. Typowe przykłady cenzurowania to wynik poniżej progu wykrywalności, efekt podłogi testu i wydatki, które dla wielu osób wynoszą zero.
McDonald i Moffitt (1980) pokazali, że współczynnik tobitu można rozłożyć na zmianę prawdopodobieństwa wyniku powyżej progu i zmianę wartości wśród wyników dodatnich. Cragg (1971) zaproponował modele, w których o tym, czy wynik jest dodatni, i o jego wielkości decydują różne parametry – to podstawa modeli dwuczęściowych. Dla zliczeń z nadmiarem zer lepszy jest model z nadmiarem zer.
Przykład
W symulacji 400 osób (38% zer, prawdziwe nachylenie 2) regresja liniowa dała b = 1.40, a tobit b = 2.19 przy σ = 1.97.
Na rysunku
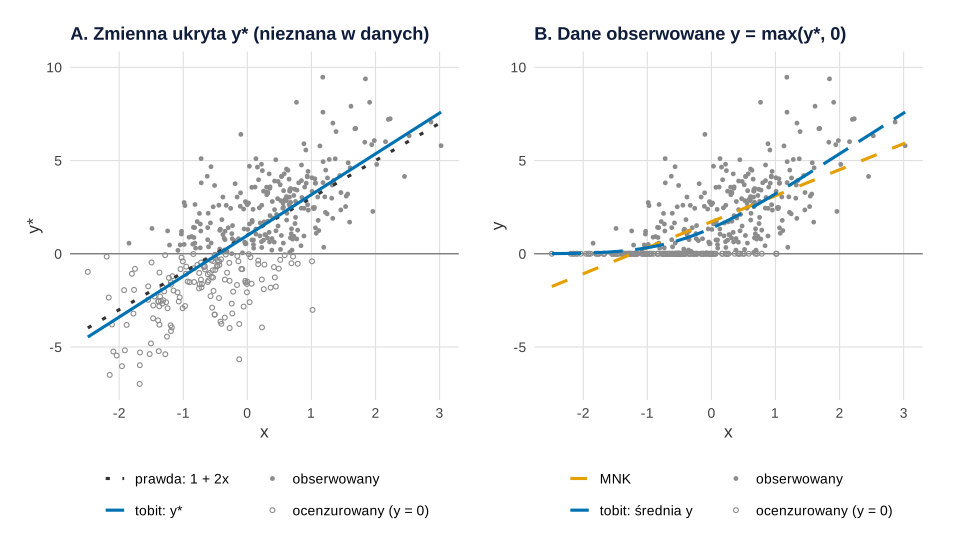
set.seed(4431)).Co widać. Panel A pokazuje to, czego w prawdziwych danych nie widać: wartości y* także u 38% osób, które w danych mają 0 (puste kółka). Prosta tobitu (b = 2.19) prawie pokrywa się z prawdziwą prostą 1 + 2x. Panel B to dane, które naprawdę mamy. Prosta MNK (b = 1.40) jest płaska, bo zera po lewej ją podnoszą. Model tobitowy przewiduje średnią obserwowanego y jako krzywą: przy niskim x leży ona przy zerze, a przy wysokim zbliża się do prostej dla y*. Jej nachylenie wynosi 0.59 przy x = −1, 1.51 przy x = 0 i 2.07 przy x = 1, a średnio w próbie 1.37 – blisko MNK.
Na co uważać. MNK nie jest więc „zepsutym tobitem”: przybliża prostą średnią obserwowanego y, ale błędnie przewiduje wartości ujemne po lewej i nie opisuje zakrzywienia. Współczynnik tobitu dotyczy y*, a efekt na obserwowany wynik zależy od miejsca na osi x – to rozkład McDonalda i Moffitta (1980) w obrazku. Prosta tobitu trafia tu w prawdę, bo dane wygenerowano z normalnym błędem o stałej wariancji; przy innym rozkładzie błędu tak dobrze nie będzie. Wykres nie odróżnia też cenzurowania od prawdziwych zer ani od danych uciętych. Cenzurowanie przy górnym progu skali i symulację wielu prób pokazuje wpis Efekt sufitu i model Tobita; zob. też efekt sufitu i efekt podłogi.
Podpis do pracy:
Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne. Ziarno 4431 jest to samo co w przykładzie.
Kod R rysunku 1
# Rysunek 1. Zmienna ukryta i prosta tobitu (A) oraz dane obserwowane z prostą MNK i średnią z tobitu (B)
suppressPackageStartupMessages({library(survival); library(ggplot2); library(patchwork)})
kol <- c(tobit = "#0072B2", mnk = "#E69F00", prawda = "grey20")   # Okabe–Ito + czerń; różne typy linii
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), legend.position = "bottom")
set.seed(4431)                                        # te same dane co w przykładzie
n <- 400
x <- rnorm(n)
y_ukryte <- 1 + 2 * x + rnorm(n, sd = 2)
y <- pmax(y_ukryte, 0)
m_ols <- lm(y ~ x)
m_tobit <- survreg(Surv(y, y > 0, type = "left") ~ x, dist = "gaussian")
b <- coef(m_tobit); s <- m_tobit$scale
siatka <- data.frame(x = seq(min(x), max(x), length.out = 200))
eta <- b[1] + b[2] * siatka$x
linie <- rbind(
  data.frame(siatka, y = 1 + 2 * siatka$x, co = "prawda: 1 + 2x"),
  data.frame(siatka, y = eta, co = "tobit: y*"),
  data.frame(siatka, y = pnorm(eta / s) * eta + s * dnorm(eta / s), co = "tobit: średnia y"),
  data.frame(siatka, y = predict(m_ols, siatka), co = "MNK"))
styl <- c("prawda: 1 + 2x" = "dotted", "tobit: y*" = "solid", "tobit: średnia y" = "longdash", "MNK" = "dashed")
barwa <- c("prawda: 1 + 2x" = kol[["prawda"]], "tobit: y*" = kol[["tobit"]], "tobit: średnia y" = kol[["tobit"]], "MNK" = kol[["mnk"]])
pkt <- data.frame(x, y, y_ukryte, status = ifelse(y > 0, "obserwowany", "ocenzurowany (y = 0)"))
skale <- list(scale_colour_manual(values = barwa, name = NULL), scale_linetype_manual(values = styl, name = NULL),
              scale_shape_manual(values = c(obserwowany = 16, "ocenzurowany (y = 0)" = 1), name = NULL),
              coord_cartesian(ylim = c(-7, 10)), guides(colour = guide_legend(nrow = 2), shape = guide_legend(nrow = 2)))
pA <- ggplot(pkt, aes(x, y_ukryte)) +
  geom_hline(yintercept = 0, colour = "grey40", linewidth = 0.4) +
  geom_point(aes(shape = status), colour = "grey55", size = 1.3) +
  geom_line(data = subset(linie, co %in% c("prawda: 1 + 2x", "tobit: y*")), aes(x, y, colour = co, linetype = co), linewidth = 1.1) +
  skale + labs(title = "A. Zmienna ukryta y* (nieznana w danych)", x = "x", y = "y*")
pB <- ggplot(pkt, aes(x, y)) +
  geom_hline(yintercept = 0, colour = "grey40", linewidth = 0.4) +
  geom_point(aes(shape = status), colour = "grey55", size = 1.3) +
  geom_line(data = subset(linie, co %in% c("tobit: średnia y", "MNK")), aes(x, y, colour = co, linetype = co), linewidth = 1.1) +
  skale + labs(title = "B. Dane obserwowane y = max(y*, 0)", x = "x", y = "y")
# nachylenie średniej y z tobitu (pochodna = b * P(y* > 0)) w trzech punktach x i średnio w próbie
eta_i <- b[1] + b[2] * x
round(c(nachylenie_x_m1 = b[[2]] * pnorm((b[[1]] - b[[2]]) / s), nachylenie_x_0 = b[[2]] * pnorm(b[[1]] / s),
        nachylenie_x_p1 = b[[2]] * pnorm((b[[1]] + b[[2]]) / s), srednio = mean(b[[2]] * pnorm(eta_i / s)),
        MNK = unname(coef(m_ols)[2])), 2)
p1 <- (pA + pB) & motyw
p1
Wynik w R
nachylenie_x_m1  nachylenie_x_0 nachylenie_x_p1         srednio             MNK
           0.59            1.51            2.07            1.37            1.40
Jak opisać w pracy
Na co uważać
- Założenia. Przy nienormalnym lub heteroskedastycznym błędzie tobit daje obciążone oszacowania.
- Prawdziwe zera. Jeśli zero oznacza decyzję „nie”, a nie wynik poza skalą, rozważ model dwuczęściowy.
- Interpretacja. b dotyczy ukrytej y*, nie obserwowanej średniej y.
Model tobitowy w R
Kod symuluje zmienną ukrytą, cenzuruje jej ujemne wartości w zerze i porównuje regresję MNK z modelem tobitowym oszacowanym funkcją survreg().
MNK a tobit przy 38% zer
R
library(survival)
set.seed(4431)
n <- 400
x <- rnorm(n)
y_ukryte <- 1 + 2 * x + rnorm(n, sd = 2)            # zmienna ukryta
y <- pmax(y_ukryte, 0)                                # obserwujemy 0 zamiast wartości ujemnych
mean(y == 0)                                          # odsetek zer
round(coef(lm(y ~ x)), 3)                             # MNK – współczynnik zaniżony
m_tobit <- survreg(Surv(y, y > 0, type = "left") ~ x, dist = "gaussian")
round(c(coef(m_tobit), sigma = m_tobit$scale), 3)     # tobit odtwarza 1, 2 i 2
Wynik w R
[1] 0.3775
(Intercept)           x
      1.720       1.395
(Intercept)           x       sigma
      0.983       2.189       1.969
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet survival: survreg(), Surv(); MNK funkcją lm(); rysunek 1 – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R [R package]. https://CRAN.R-project.org/package=survival
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czym zmienna cenzurowana różni się od zmiennej uciętej?
Przy cenzurowaniu widzisz wszystkie osoby i ich predyktory, ale dla części znasz tylko to, że wynik jest na progu lub poza nim. Przy ucięciu osób poza progiem w ogóle nie ma w próbie. Tobit służy do cenzurowania; do ucięcia potrzebny jest model ucięty.
Czy zamiast modelu tobitowego można usunąć zera i policzyć zwykłą regresję?
Nie. Usunięcie zer tworzy próbę uciętą, a regresja na wszystkich danych z zerami zaniża nachylenie. W przykładzie MNK dało b = 1.40 zamiast prawdziwego 2, a tobit – 2.19.
Jak oszacować model tobitowy w R bez pakietu AER?
Użyj pakietu survival: survreg(Surv(y, y > 0, type = "left") ~ x, dist = "gaussian"). Zera są tu traktowane jako cenzurowane lewostronnie, a m$scale to odchylenie standardowe błędu.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Efekt sufitu i model Tobita
Cenzurowanie czy prawdziwe maksimum, Tobit w R z progiem górnym, trzy efekty z jednego współczynnika, założenia w symulacji i alternatywy.
Czytaj →PoradnikPopyt ukryty przez braki towaru
Sprzedaż ucięta zapasem, model z cenzurowaniem, godzina wyczerpania i dostawa z kwantyla popytu – na fikcyjnych sklepach z sokami, z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Amemiya, T. (1984). Tobit models: A survey. Journal of Econometrics, 24(1–2), 3–61. https://doi.org/10.1016/0304-4076(84)90074-5
- Cragg, J. G. (1971). Some statistical models for limited dependent variables with application to the demand for durable goods. Econometrica, 39(5), 829–844. https://doi.org/10.2307/1909582
- McDonald, J. F., & Moffitt, R. A. (1980). The uses of Tobit analysis. The Review of Economics and Statistics, 62(2), 318–321. https://doi.org/10.2307/1924766
Cytowania BibTeX
@article{amemiya1984tobit, author={Amemiya, Takeshi}, title={{Tobit models: A survey}}, journal={Journal of Econometrics}, year={1984}, volume={24}, number={1–2}, pages={3--61}, doi={10.1016/0304-4076(84)90074-5}}@article{cragg1971some, author={Cragg, John G.}, title={{Some statistical models for limited dependent variables with application to the demand for durable goods}}, journal={Econometrica}, year={1971}, volume={39}, number={5}, pages={829--844}, doi={10.2307/1909582}}@article{mcdonald1980uses, author={McDonald, John F. and Moffitt, Robert A.}, title={{The uses of Tobit analysis}}, journal={The Review of Economics and Statistics}, year={1980}, volume={62}, number={2}, pages={318--321}, doi={10.2307/1924766}}