Co to jest regresja probitowa?
Regresja probitowa (ang. probit regression) to model dla zmiennej binarnej, w którym prawdopodobieństwo zdarzenia wynosi P(Y = 1) = Φ(β₀ + β₁x), gdzie Φ to dystrybuanta rozkładu normalnego. Można ją rozumieć tak: istnieje ukryta skłonność y* = β₀ + β₁x + ε o normalnym błędzie, a obserwujemy tylko, czy y* przekroczyła zero. Nazwa pochodzi od „metody probitów” opisanej przez Blissa (1934). Model należy do rodziny GLM z funkcją łączącą probit i jest szacowany metodą największej wiarygodności.
Probit a logit
Regresja logistyczna używa dystrybuanty rozkładu logistycznego. Obie krzywe są niemal identyczne poza ogonami: Chambers i Cox (1967) pokazali, że do odróżnienia ich w eksperymencie z trzema dawkami potrzeba około 1000 obserwacji. Różnica dotyczy więc głównie interpretacji. Współczynnik logitu po potęgowaniu daje iloraz szans, a współczynnik probitu – zmianę ukrytej zmiennej w odchyleniach standardowych. Dlatego w probicie raportuje się zwykle efekty krańcowe na prawdopodobieństwo; Hanmer i Kalkan (2013) zalecają przeciętny efekt policzony dla obserwowanych wartości predyktorów, a nie dla „przeciętnego przypadku”.
Przykład
Dla 500 symulowanych osób probit dał b = 0.652, a logit b = 1.076 (stosunek 1.65). AIC były prawie równe (584.95 i 585.37), a przeciętny efekt krańcowy wyniósł w obu modelach 0.21: wzrost x o jedno odchylenie standardowe podnosi prawdopodobieństwo zdarzenia średnio o około 21 punktów procentowych. Na skali prawdopodobieństwa oba modele są tu praktycznie wymienne.
Na rysunku
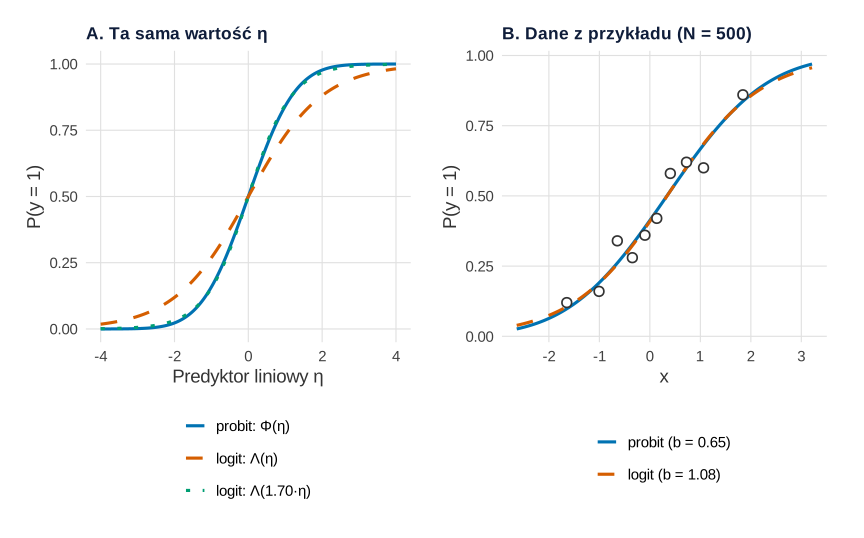
set.seed(4421)).Co widać. Przy tej samej wartości predyktora liniowego η krzywa logit jest bardziej płaska niż probit (A): w najgorszym miejscu różnią się o 0.117. Wystarczy jednak pomnożyć η przez 1.70, a Λ(1.70·η) i Φ(η) różnią się najwyżej o 0.009 – na rysunku zielona linia znika pod niebieską. Stąd przelicznik współczynników: około 1.6, gdy dopasujemy nachylenia w środku krzywej (1.596), około 1.8, gdy odchylenia standardowe obu rozkładów (1.814). W danych z przykładu (B) logit dał współczynnik 1.650 razy większy, a przewidywane prawdopodobieństwa różnią się najwyżej o 0.013, czyli mniej niż rozrzut odsetków w decylach x.
Na co uważać. Podobieństwo dotyczy środka krzywej; w skrajnych ogonach logit zbliża się do 0 i 1 wolniej, co ma znaczenie przy bardzo rzadkich zdarzeniach. Rysunek nie rozstrzyga, który model jest „prawdziwy” – przy takiej liczebności dane tego nie odróżnią. Inną, asymetryczną funkcję łączącą pokazuje hasło model komplementarny log-log, a dopasowanie krzywej logistycznej do danych 0/1 krok po kroku – wpis Regresja logistyczna w obrazkach.
Podpis do pracy:
Ziarno set.seed(4421) to ziarno danych z przykładu; nie było zmieniane. Panel A nie losuje; mnożnik 1.70 wyznacza funkcja optimize() jako ten, który minimalizuje największą różnicę krzywych na odcinku η od −4 do 4. Rysunek na stronie różni się od wyniku kodu tylko motywem serwisu.
Kod R rysunku 1
# Rysunek 1. Probit a logit: ta sama wartość predyktora liniowego (A) i dopasowanie do danych z przykładu (B)
library(ggplot2)
library(patchwork)

motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))
kol <- c("#0072B2", "#D55E00", "#009E73")            # paleta Okabe–Ito
typ <- c("solid", "dashed", "dotted")

# A. Dystrybuanty: normalna Φ(η) i logistyczna Λ(η); k – mnożnik, przy którym Λ(k·η) najlepiej udaje Φ(η)
eta <- seq(-4, 4, by = 0.01)
k <- optimize(function(k) max(abs(pnorm(eta) - plogis(k * eta))), c(1, 2.5))$minimum
round(c(SD_rozkladu_logistycznego = pi / sqrt(3), nachylenie_w_zerze = dnorm(0) / dlogis(0),
        k_najlepsze = k, max_roznica_bez_skalowania = max(abs(pnorm(eta) - plogis(eta))),
        max_roznica_po_skalowaniu = max(abs(pnorm(eta) - plogis(k * eta)))), 3)
etyk_A <- c("probit: Φ(η)", "logit: Λ(η)", sprintf("logit: Λ(%.2f·η)", k))
a <- data.frame(eta = rep(eta, 3), p = c(pnorm(eta), plogis(eta), plogis(k * eta)),
                krzywa = factor(rep(etyk_A, each = length(eta)), etyk_A))
pA <- ggplot(a, aes(eta, p, colour = krzywa, linetype = krzywa)) +
  geom_line(linewidth = 1.1) +
  scale_colour_manual(values = kol, name = NULL) + scale_linetype_manual(values = typ, name = NULL) +
  guides(colour = guide_legend(ncol = 1)) +
  labs(title = "A. Ta sama wartość η", x = "Predyktor liniowy η", y = "P(y = 1)") + motyw

# B. Dane z przykładu: probit i logit dopasowane do tych samych 500 osób
set.seed(4421)                                       # te same dane co w przykładzie wyżej
n <- 500
x <- rnorm(n)
y <- rbinom(n, 1, pnorm(-0.3 + 0.8 * x))
m_probit <- glm(y ~ x, family = binomial(link = "probit"))
m_logit  <- glm(y ~ x, family = binomial(link = "logit"))
s <- data.frame(x = seq(min(x), max(x), length.out = 200))
p_pr <- predict(m_probit, s, type = "response"); p_lo <- predict(m_logit, s, type = "response")
round(c(stosunek_b = unname(coef(m_logit)["x"] / coef(m_probit)["x"]),
        max_roznica_P = max(abs(p_pr - p_lo))), 3)
dec <- cut(x, quantile(x, 0:10 / 10), include.lowest = TRUE)  # 10 grup po 50 osób według x
obs <- data.frame(x = tapply(x, dec, mean), p = tapply(y, dec, mean))
etyk_B <- c(sprintf("probit (b = %.2f)", coef(m_probit)["x"]), sprintf("logit (b = %.2f)", coef(m_logit)["x"]))
b <- data.frame(x = rep(s$x, 2), p = c(p_pr, p_lo), model = factor(rep(etyk_B, each = 200), etyk_B))
pB <- ggplot(b, aes(x, p)) +
  geom_line(aes(colour = model, linetype = model), linewidth = 1.1) +
  geom_point(data = obs, shape = 21, fill = "white", colour = "grey20", size = 2.8, stroke = 0.9) +
  scale_colour_manual(values = kol[1:2], name = NULL) + scale_linetype_manual(values = typ[1:2], name = NULL) +
  guides(colour = guide_legend(ncol = 1)) +
  labs(title = "B. Dane z przykładu (N = 500)", x = "x", y = "P(y = 1)") + motyw
p1 <- pA + pB
p1
Wynik w R (rysunek 1)
 SD_rozkladu_logistycznego         nachylenie_w_zerze
                     1.814                      1.596
               k_najlepsze max_roznica_bez_skalowania
                     1.702                      0.117
 max_roznica_po_skalowaniu
                     0.009
   stosunek_b max_roznica_P
        1.650         0.013
Jak opisać w pracy
Na co uważać
- Współczynnik jak iloraz szans. exp(b) z probitu nie jest ilorazem szans.
- Porównywanie b między modelami. Współczynników probitu i logitu nie zestawia się bezpośrednio – porównuj efekty krańcowe.
- Kategorie uporządkowane. Dla więcej niż dwóch uporządkowanych kategorii użyj regresji porządkowej (z łączem probit lub logit).
Regresja probitowa w R
Kod symuluje dane binarne, dopasowuje model probitowy i logistyczny, porównuje współczynniki i AIC oraz liczy przeciętny efekt krańcowy predyktora.
Probit i logit na tych samych danych
R
set.seed(4421)
n <- 500
x <- rnorm(n)
y <- rbinom(n, 1, pnorm(-0.3 + 0.8 * x))            # dane z modelu probitowego
m_probit <- glm(y ~ x, family = binomial(link = "probit"))
m_logit  <- glm(y ~ x, family = binomial(link = "logit"))
wsp <- rbind(probit = coef(m_probit), logit = coef(m_logit))
round(cbind(wsp, AIC = c(AIC(m_probit), AIC(m_logit))), 3)
round(coef(m_logit)["x"] / coef(m_probit)["x"], 2)   # stosunek współczynników
# przeciętny efekt krańcowy x na P(y = 1)
round(c(probit = mean(dnorm(predict(m_probit))) * unname(coef(m_probit)["x"]),
        logit  = mean(dlogis(predict(m_logit))) * unname(coef(m_logit)["x"])), 3)
Wynik w R
       (Intercept)     x     AIC
probit      -0.220 0.652 584.952
logit       -0.367 1.076 585.374
   x
1.65
probit  logit
 0.215  0.214
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (bez dodatkowych pakietów; glm()). Rysunek 1 wykonano w pakiecie ggplot2 4.0.2, panele złożono pakietem patchwork 1.3.2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kiedy wybrać probit zamiast regresji logistycznej?
Gdy przyjmujesz, że za odpowiedzią „tak/nie” stoi ukryta zmienna o rozkładzie normalnym, albo gdy probit jest standardem w twojej dziedzinie (np. analiza dawka–odpowiedź, część ekonometrii). Jeśli zależy ci na ilorazach szans, wybierz logit.
Dlaczego współczynniki probitu są mniejsze niż w logicie?
Bo błąd ukryty ma w probicie wariancję 1, a w logicie π²/3. Współczynniki logitu są zwykle około 1.6–1.8 razy większe; w naszym przykładzie stosunek wyniósł 1.65. Na skali prawdopodobieństwa oba modele dają prawie to samo.
Jak policzyć regresję probitową w R?
Użyj glm(y ~ x, family = binomial(link = "probit")). Efekt krańcowy na prawdopodobieństwo to średnia z dnorm(predict(m)) * coef(m)["x"] – kod jest w sekcji z przykładem.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bliss, C. I. (1934). The method of probits. Science, 79(2037), 38–39. https://doi.org/10.1126/science.79.2037.38
- Chambers, E. A., & Cox, D. R. (1967). Discrimination between alternative binary response models. Biometrika, 54(3–4), 573–578. https://doi.org/10.1093/biomet/54.3-4.573
- Hanmer, M. J., & Kalkan, K. O. (2013). Behind the curve: Clarifying the best approach to calculating predicted probabilities and marginal effects from limited dependent variable models. American Journal of Political Science, 57(1), 263–277. https://doi.org/10.1111/j.1540-5907.2012.00602.x
Cytowania BibTeX
@article{bliss1934method, author={Bliss, C. I.}, title={{The method of probits}}, journal={Science}, year={1934}, volume={79}, number={2037}, pages={38--39}, doi={10.1126/science.79.2037.38}}@article{chambers1967discrimination, author={Chambers, Elizabeth A. and Cox, D. R.}, title={{Discrimination between alternative binary response models}}, journal={Biometrika}, year={1967}, volume={54}, number={3–4}, pages={573--578}, doi={10.1093/biomet/54.3-4.573}}@article{hanmer2013behind, author={Hanmer, Michael J. and Kalkan, Kerem Ozan}, title={{Behind the curve: Clarifying the best approach to calculating predicted probabilities and marginal effects from limited dependent variable models}}, journal={American Journal of Political Science}, year={2013}, volume={57}, number={1}, pages={263--277}, doi={10.1111/j.1540-5907.2012.00602.x}}