Co to jest błąd selekcji?
Błąd selekcji (ang. selection bias) powstaje, gdy o tym, kto trafia do analizowanych danych, decydują czynniki związane zarówno z badaną przyczyną, jak i ze skutkiem. Wtedy związek w próbie różni się od związku w populacji, choć każdy pomiar może być dokładny. Hernán i in. (2004) pokazują, że różne odmiany tego błędu – niewłaściwy dobór kontroli w badaniu kliniczno-kontrolnym, informatywną utratę uczestników w kohorcie – mają tę samą strukturę: warunkowanie na wspólnym skutku, czyli zmiennej zderzeniowej.
Przykład
Ankieta o korzystaniu z internetu rozesłana wyłącznie online, z dobrowolnym udziałem, przeszacuje aktywność w sieci: odpowiadają głównie osoby, które dużo z niej korzystają. Bethlehem (2010) wskazuje, że niedopokrycie i samoselekcja obciążają wyniki ankiet internetowych, a samoselekcja prowadzi do niewiarygodnych oszacowań, czego ważenie nie zawsze naprawia.
Na rysunku
Rysunek pokazuje przykład z ankietą internetową w symulacji: 600 osób, z których każda odpowiada z prawdopodobieństwem rosnącym wraz z tym, ile czasu spędza w sieci. Selekcja zależy więc od samego wyniku, a nie od progu na jednej zmiennej, jak we wpisie Ograniczony zakres zmiennej – wizualizacja. Parametry (związek z wiekiem, siłę selekcji) ustawiono ręcznie tak, by efekt był wyraźny; ziarna nie zmieniano.
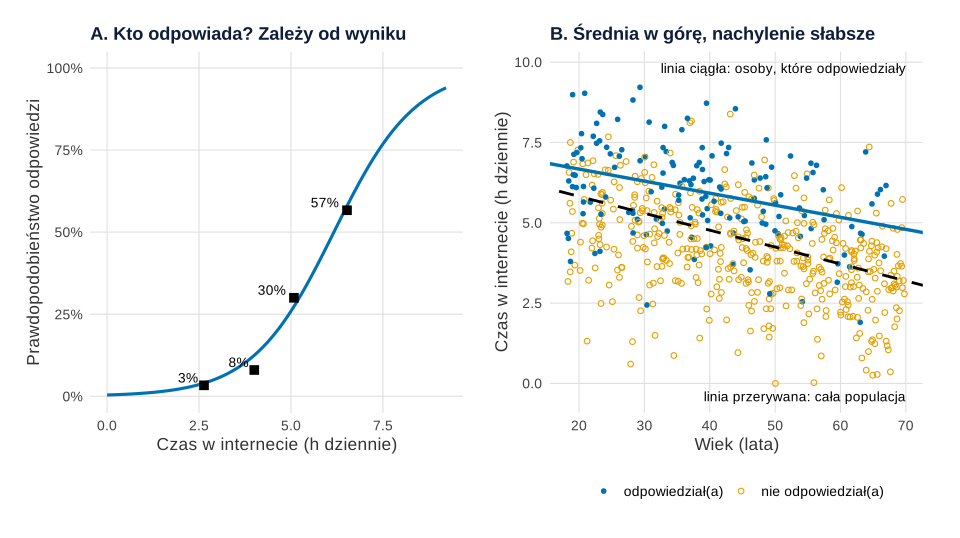
set.seed(475)).Co widać. Odpowiedziało 147 z 600 osób (24.5%), ale bardzo nierówno: 3.3% w najniższym kwartylu czasu w internecie i 56.7% w najwyższym (panel A). W efekcie średni czas w sieci wśród respondentów wynosi 5.98 h dziennie, a w populacji 4.56 h. Panel B pokazuje drugi skutek: zależność od wieku też jest zniekształcona. W populacji z każdą dekadą życia czas w sieci spada o 0.53 h, wśród respondentów – o 0.38 h. Selekcja według wyniku spłaszcza nachylenie, bo z dołu chmury znikają głównie osoby starsze o niskim wyniku.
Na co uważać. W prawdziwym badaniu nie ma żółtych punktów ani linii przerywanej – widać tylko niebieską chmurę, która wygląda zupełnie zwyczajnie. Ważenie według wieku nie naprawi tego wyniku, bo udział zależy od czasu w internecie także przy tym samym wieku. Jak selekcja przez udział zniekształca też związki, pokazuje wpis Błąd selekcji i zmienna zderzeniowa w praktyce; model korekty opisuje hasło model selekcji Heckmana.
Podpis do pracy:
Kod rysunku jest samowystarczalny: paletę Okabe–Ito i prosty motyw definiuje sam. Rysunek na stronie powstał z tego samego obiektu p1, w którym podmieniono tylko motyw (krój czcionki, siatka).
Kod R rysunku 1
# Rysunek 1. Prawdopodobieństwo udziału w ankiecie zależy od wyniku (A); populacja a osoby, które odpowiedziały (B)
library(ggplot2)
library(patchwork)

kol <- c("odpowiedział(a)" = "#0072B2", "nie odpowiedział(a)" = "#E69F00")   # Okabe–Ito
ksz <- c("odpowiedział(a)" = 16, "nie odpowiedział(a)" = 1)                  # kształt dubluje kolor
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold", size = rel(0.95)))

set.seed(475)
N <- 600                                          # populacja (np. mieszkańcy, do których wysłano link)
wiek <- runif(N, 18, 70)
godziny <- pmax(0, 4.5 - 0.05 * (wiek - 44) + rnorm(N, sd = 1.5))   # dzienny czas w internecie (h)
p_odp <- plogis(-1.5 + 0.9 * (godziny - 4.5))     # szansa odpowiedzi rośnie z czasem w internecie
odp <- rbinom(N, 1, p_odp) == 1
dane <- data.frame(wiek, godziny,
                   status = factor(ifelse(odp, "odpowiedział(a)", "nie odpowiedział(a)"), names(kol)))

b_pop <- coef(lm(godziny ~ wiek))                 # prawdziwa zależność w populacji
b_odp <- coef(lm(godziny ~ wiek, subset = odp))   # to, co widzi badacz
print(round(c(odpowiedzialo = sum(odp), odsetek = mean(odp),
              srednia_populacja = mean(godziny), srednia_odpowiedzi = mean(godziny[odp]),
              nachylenie_populacja = unname(b_pop[2]) * 10, nachylenie_odpowiedzi = unname(b_odp[2]) * 10), 3))
# odsetek odpowiedzi w kwartylach czasu w internecie
kwartyl <- cut(godziny, quantile(godziny, 0:4 / 4), include.lowest = TRUE, labels = c("Q1", "Q2", "Q3", "Q4"))
kw <- data.frame(kwartyl = levels(kwartyl), srodek = tapply(godziny, kwartyl, median),
                 odsetek = tapply(odp, kwartyl, mean))
print(kw, digits = 3, row.names = FALSE)

# A: mechanizm selekcji – prawdopodobieństwo odpowiedzi jako funkcja wyniku
krzywa <- data.frame(godziny = seq(min(godziny), max(godziny), length.out = 200))
krzywa$p <- plogis(-1.5 + 0.9 * (krzywa$godziny - 4.5))
pA <- ggplot(krzywa, aes(godziny, p)) +
  geom_line(linewidth = 1.1, colour = kol[["odpowiedział(a)"]]) +
  # punkty: odsetek odpowiedzi w kwartylach czasu w internecie (punkt w medianie kwartyla)
  geom_point(data = kw, aes(srodek, odsetek), size = 3, shape = 15) +
  geom_text(data = kw, aes(srodek, odsetek, label = paste0(round(100 * odsetek), "%")),
            hjust = 1.3, vjust = -0.3, size = 3.6) +
  scale_y_continuous(labels = function(v) paste0(100 * v, "%"), limits = c(0, 1)) +
  labs(x = "Czas w internecie (h dziennie)", y = "Prawdopodobieństwo odpowiedzi",
       title = "A. Kto odpowiada? Zależy od wyniku")

# B: wiek a czas w internecie – linia w populacji i wśród osób, które odpowiedziały
pB <- ggplot(dane, aes(wiek, godziny)) +
  geom_point(aes(colour = status, shape = status), size = 1.6) +
  geom_abline(intercept = b_pop[1], slope = b_pop[2], linetype = "dashed", linewidth = 1) +
  geom_abline(intercept = b_odp[1], slope = b_odp[2], colour = kol[["odpowiedział(a)"]], linewidth = 1.2) +
  annotate("text", x = 70, y = c(max(godziny) + 0.6, min(godziny) - 0.4), hjust = 1, size = 3.6,
           label = c("linia ciągła: osoby, które odpowiedziały", "linia przerywana: cała populacja")) +
  scale_colour_manual(NULL, values = kol) +
  scale_shape_manual(NULL, values = ksz) +
  labs(x = "Wiek (lata)", y = "Czas w internecie (h dziennie)",
       title = "B. Średnia w górę, nachylenie słabsze")
p1 <- (pA | pB) & motyw
p1
Wynik w R
        odpowiedzialo               odsetek     srednia_populacja
              147.000                 0.245                 4.555
   srednia_odpowiedzi  nachylenie_populacja nachylenie_odpowiedzi
                5.982                -0.526                -0.375
 kwartyl srodek odsetek
      Q1   2.64  0.0333
      Q2   4.00  0.0800
      Q3   5.08  0.3000
      Q4   6.52  0.5667
Bibliografia oprogramowania
Wyniki i rysunek pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiety base, stats, ggplot2 i patchwork; zapis SVG pakietem svglite).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Czym różni się od pokrewnych błędów
- Zakłócenie wynika ze wspólnej przyczyny ekspozycji i wyniku; błąd selekcji – z warunkowania na ich wspólnym skutku (Hernán i in., 2004). Kontrola dodatkowych zmiennych może tu pogorszyć sytuację.
- Błąd braku odpowiedzi to szczególny przypadek: selekcja następuje, gdy wylosowane osoby nie biorą udziału w badaniu.
- Błąd przeżywalności to selekcja, w której widzimy tylko jednostki, które „przetrwały” do momentu pomiaru.
- Błąd przypominania nie jest błędem selekcji, lecz pomiaru: właściwe osoby są w próbie, ale źle odtwarzają przeszłość.
Jak mu zapobiegać
- Losuj z operatu pokrywającego populację zamiast opierać się na doborze wygodnym.
- Śledź utratę uczestników i porównaj osoby, które odpadły, z pozostałymi.
- Nie zawężaj próby według zmiennej, na którą wpływa ekspozycja lub wynik (np. tylko hospitalizowani, tylko absolwenci).
- Gdy selekcji nie da się uniknąć, opisz ją i jej możliwy kierunek; Hernán i in. (2004) proponują jednolite podejście do jej korekty, wynikające z tej samej struktury przyczynowej.
Jak opisać w pracy
Najczęstsze pytania
Czy próba wygodna zawsze oznacza błąd selekcji?
Nie zawsze, ale zwiększa ryzyko. Problem pojawia się, gdy udział zależy od badanych zmiennych, np. w ankiecie o stresie odpowiadają głównie osoby zestresowane. Opisz sposób rekrutacji i jego możliwy wpływ na wyniki.
Czym błąd selekcji różni się od zmiennej zakłócającej?
Zakłócenie wynika ze wspólnej przyczyny ekspozycji i wyniku i usuwa się je, kontrolując tę przyczynę. Błąd selekcji wynika z warunkowania na wspólnym skutku, więc dodatkowa kontrola zmiennych go nie usuwa, a może go wywołać.
Czy duża próba chroni przed błędem selekcji?
Nie. Większa próba zmniejsza błąd losowy, ale nie systematyczny – zawężenie do niereprezentatywnej grupy daje precyzyjny, lecz wciąż obciążony wynik.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Ograniczony zakres zmiennej – wizualizacja
Progi przyjęcia, selekcja po X i po Y, skrajne grupy i 1000 badań z poprawką Thorndike’a – pięć rysunków z kodem R.
Czytaj →PoradnikBłąd selekcji i zmienna zderzeniowa w praktyce
Ochotnicy online, rezygnacje i biobanki: symulacje w R, korekta wagami IPW i sytuacje, w których żadna korekta nie wystarczy.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bethlehem, J. (2010). Selection bias in web surveys. International Statistical Review, 78(2), 161–188. https://doi.org/10.1111/j.1751-5823.2010.00112.x ● Otwarty dostęp
- Hernán, M. A., Hernández-Díaz, S., & Robins, J. M. (2004). A structural approach to selection bias. Epidemiology, 15(5), 615–625. https://doi.org/10.1097/01.ede.0000135174.63482.43
Cytowania BibTeX
@article{bethlehem2010selection, author={Bethlehem, Jelke}, title={{Selection bias in web surveys}}, journal={International Statistical Review}, year={2010}, volume={78}, number={2}, pages={161--188}, doi={10.1111/j.1751-5823.2010.00112.x}}@article{hernan2004structural, author={Hernán, Miguel A. and Hernández-Díaz, Sonia and Robins, James M.}, title={{A structural approach to selection bias}}, journal={Epidemiology}, year={2004}, volume={15}, number={5}, pages={615--625}, doi={10.1097/01.ede.0000135174.63482.43}}