Selekcja psuje nie tylko reprezentatywność
Recenzent pisze: „Próba nie jest reprezentatywna, a 38% uczestników nie wypełniło ostatniego pomiaru”. Typowa odpowiedź brzmi: „Badamy związki, a nie częstości, więc reprezentatywność nie jest kluczowa”. Ta odpowiedź bywa trafna, ale tylko przy określonym mechanizmie selekcji. Gdy o udziale w badaniu decydują jednocześnie ekspozycja i wynik (albo ich przyczyny), związek w próbie różni się od związku w populacji.
Definicje znajdziesz w hasłach błąd selekcji i zmienna zderzeniowa, a dobór zmiennych kontrolnych na grafie – we wpisie o grafach przyczynowych (DAG). Tu zajmujemy się praktyką: jak rozpoznać selekcję we własnym projekcie, jak duże obciążenie może dać, kiedy da się je skorygować wagami i czego żadna korekta nie naprawi.
Hernán i in. (2004) pokazali, że różne odmiany błędu selekcji mają tę samą strukturę: analiza ograniczona do osób, które „przeszły” przez jakiś filtr, warunkuje na wspólnym skutku ekspozycji i wyniku albo ich przyczyn. Elwert i Winship (2014) nazywają to endogennym błędem selekcji. Wywołać go może warunkowanie na wyniku, na zmiennej mierzonej po wyniku, na zmiennej mierzonej po ekspozycji, a czasem nawet na zmiennej sprzed ekspozycji.
Pięć sytuacji, w których warunkujesz na zderzaczu
Zanim zaczniesz analizę, dorysuj do swojego DAG węzeł S („trafił do analizowanych danych”) i strzałki do niego. Poniższa tabela zbiera sytuacje, w których ten węzeł zwykle ma strzałki od ekspozycji i od wyniku.
| Sytuacja | Co jest zderzaczem | Co można zrobić |
|---|---|---|
| Próba z jednej poradni lub szpitala (paradoks Berksona) | Zgłoszenie się do placówki, na które wpływa zarówno ekspozycja, jak i objawy | Rekrutacja z populacji, nie z placówki; opis ścieżki skierowania; porównanie z danymi populacyjnymi |
| Analiza tylko osób, które ukończyły badanie | Ukończenie, zależne od ekspozycji i od przebiegu objawów | Wagi IPW lub imputacja wielokrotna z danymi zebranymi przed rezygnacją |
| Warunkowanie na wyniku pośrednim (np. analiza tylko zatrudnionych po programie) | Wynik pośredni, na który wpływa ekspozycja i czynniki związane z wynikiem końcowym | Pytanie o efekt całkowity na wszystkich osobach; efekty w podgrupach tylko z modelem selekcji, np. modelem Heckmana |
| Ochotnicy w badaniu online | Decyzja o udziale, zależna od zainteresowania tematem i od badanych cech | Losowanie z operatu, wagi z danych o populacji, analiza wrażliwości |
| Biobanki i duże kohorty | Zgoda na udział i pozostanie w kohorcie, zależne od zdrowia, wykształcenia, stylu życia | Modelowanie udziału, porównanie z danymi populacyjnymi, analiza wrażliwości |
Do tej listy należą też błąd przeżywalności i błąd braku odpowiedzi. Ten sam schemat opisuje też kontrolę zmiennej, na którą wpłynęła ekspozycja: Hernán i in. (2004) zaliczają ją do tej samej struktury co selekcję.
Ochotnicy online: najpierw psują się średnie, potem związki
Rohrer (2018) przypomina, że niereprezentatywna próba działa jak kontrola zderzacza. Ile to kosztuje w praktyce? W symulacji populacja liczy 20 000 dorosłych. Aktywność fizyczna i dobrostan (oba w jednostkach SD) korelują na poziomie r = .204. Ankietę o zdrowym stylu życia wypełnia około 10% osób, a szansa udziału rośnie z obiema cechami. Siłę selekcji opisuje iloraz szans udziału na 1 SD każdej cechy.
| OR udziału na 1 SD każdej cechy | n ochotników | r wśród ochotników [95% CI] | Średni dobrostan ochotników (SD) |
|---|---|---|---|
| 1.00 (brak selekcji) | 2005 | .176 [.133, .218] | −0.001 |
| 1.28 | 1957 | .191 [.148, .233] | 0.267 |
| 1.65 | 1958 | .186 [.143, .229] | 0.512 |
| 2.72 | 2002 | .054 [.010, .098] | 0.907 |
| 4.48 | 2015 | −.119 [−.162, −.076] | 1.050 |
Wynik ma dwie warstwy. Przy łagodnej selekcji (OR 1.65) korelacja mieści się jeszcze w granicach zmienności z próby, ale średni dobrostan ochotników jest o pół SD wyższy niż w populacji. Przy silniejszej selekcji (OR 2.72) korelacja spada do r = .054, a nachylenie z 0.205 do 0.056. Przy OR 4.48 zmienia znak. To ilustruje argument Munafò i in. (2018): selekcja do badania albo rezygnacja z niego może obciążyć nie tylko częstości, ale też oszacowania związków, nawet przy umiarkowanym wpływie cech na udział. Kiedy obciążenie staje się duże, zależy od siły selekcji i od tego, jaki odsetek populacji trafia do próby.
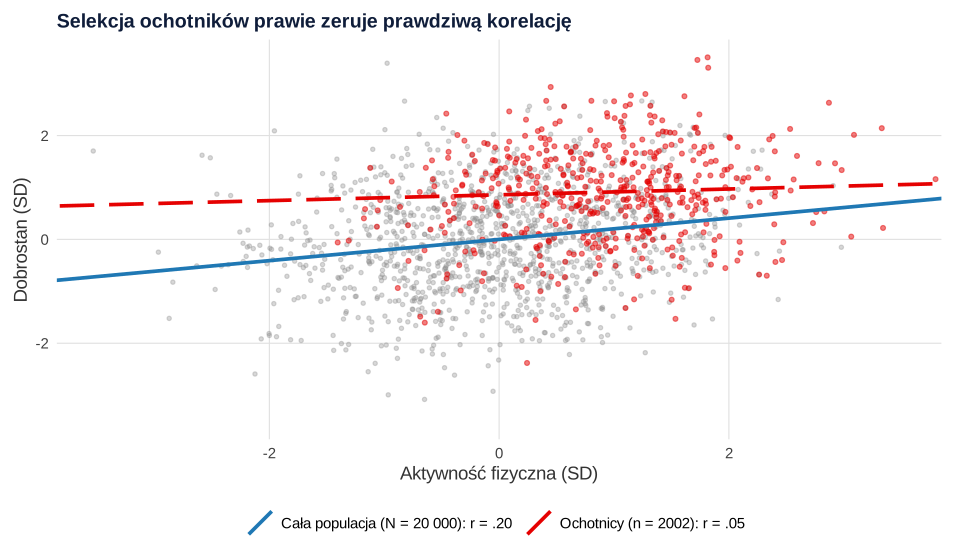
Żadna zmienna kontrolna w modelu tego nie naprawi, bo w danych nie ma osób, które nie wzięły udziału. Pomóc mogą dane spoza próby: rozkłady cech w populacji (wagi poststratyfikacyjne), losowanie z operatu zamiast rekrutacji online i jasny opis, do jakiej populacji odnoszą się wyniki (zob. reprezentatywność próby).
Collider scope: biobanki i duże kohorty
Duża próba nie chroni przed selekcją. Daje tylko węższy przedział wokół obciążonej wartości. Fry i in. (2017) porównali uczestników UK Biobank z populacją. Do udziału zaproszono około 9.2 mln osób, a w badaniu wyjściowym wzięło udział 5.5%. Uczestnicy rzadziej byli otyli, rzadziej palili i codziennie pili alkohol, mieli mniej chorób i niższą umieralność niż populacja. Autorzy nazywają to selekcją „zdrowego ochotnika”, ale twierdzą, że związki ekspozycja–choroba mogą się mimo to uogólniać.
Munafò i in. (2018) odpowiadają, że to założenie trzeba sprawdzić, a nie przyjąć. Jeśli udział zależy od cech powiązanych z ekspozycją i z wynikiem, selekcja tworzy błąd zderzacza także w oszacowaniach związków, w tym związków z wariantami genetycznymi. Griffith i in. (2020) pokazali to na badaniach czynników ryzyka COVID-19. Próby złożone z hospitalizowanych, testowanych albo ochotników były silnie wyselekcjonowane: w UK Biobank osoby testowane różniły się od reszty kohorty cechami genetycznymi, behawioralnymi, sercowo-naczyniowymi, demograficznymi i antropometrycznymi. Autorzy wskazują, że najlepszą ochroną jest właściwy dobór próby na etapie planowania. Korekta po fakcie jest dopiero drugą linią obrony.
Analiza tylko osób, które ukończyły badanie
Najczęstsza selekcja w psychologii dzieje się w trakcie badania. Drugi przykład to kohorta 4000 studentów (dane symulowane). Samotność mierzymy na starcie (T1), objawy depresji w połowie roku (T2) i na końcu (T3). Pytamy o efekt całkowity samotności na objawy w T3. Prawdziwa wartość to 0.5 SD: 0.2 bezpośrednio i 0.5 × 0.6 = 0.3 przez objawy w T2. Z badania rezygnują częściej osoby samotne i te, którym objawy narosły w T2. Pomiar T3 wykonało 2466 z 4000 osób (61.7%).
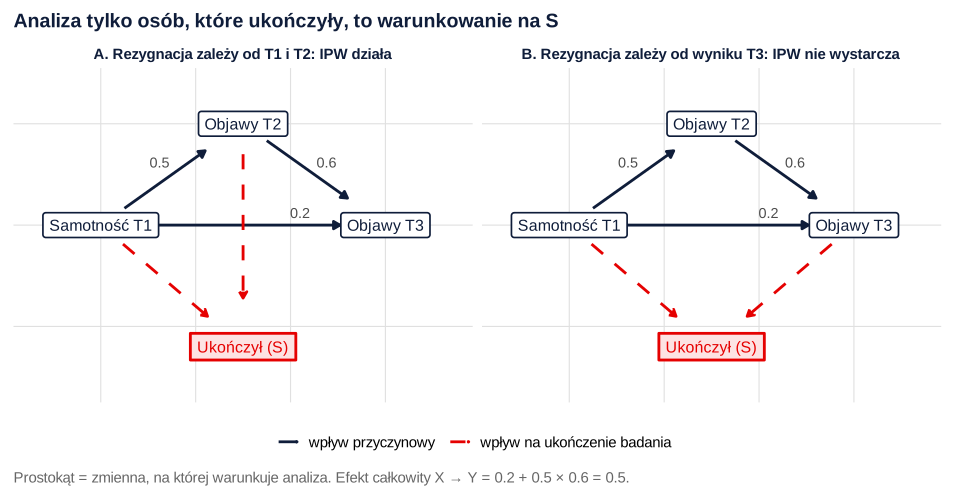
W panelu A węzeł S ma strzałki od samotności i od objawów T2. Warunkowanie na S otwiera ścieżkę samotność → S ← objawy T2 → objawy T3. Wśród osób, które zostały, samotni mieli więc „wyjątkowo” niskie objawy w T2, bo inaczej by zrezygnowali. Regresja na 2466 osobach dała 0.429, 95% CI [0.394, 0.465], podczas gdy w pełnych danych wychodzi 0.514. Średni poziom objawów w T3 wyniósł wśród nich −0.320 SD zamiast 0.003.
Odruch „dodam objawy T2 do modelu” nie pomaga. Zamyka wprawdzie ścieżkę przez zderzacz, ale objawy T2 są mediatorem, więc model daje efekt bezpośredni: 0.221. To odpowiedź na inne pytanie. Jest to ten sam błąd nadmiernej kontroli, który omawia wpis o DAG.
Korekta wagami IPW krok po kroku
Jeśli udział zależy tylko od zmiennych zmierzonych u wszystkich, każdą osobę, która ukończyła badanie, ważymy odwrotnością jej prawdopodobieństwa ukończenia. Osoba z szansą ukończenia .25 „reprezentuje” wtedy cztery podobne osoby, w tym trzy, które odpadły. Seaman i White (2013) opisują to podejście jako często stosowaną korektę obciążenia analizy pełnych przypadków. Działa tak samo jak wagi IPW w porównaniu grup, tyle że modelujemy udział, a nie przydział do leczenia.
- Model udziału. Regresja logistyczna ukończenia na zmiennych sprzed rezygnacji, oszacowana na wszystkich osobach. W przykładzie szansa ukończenia malała z samotnością (b = −0.547) i jeszcze silniej z objawami T2 (b = −1.466).
- Wagi. w = 1 / P(ukończenie). Wśród osób, które ukończyły, wagi wynosiły od 1.00 do 19.49, z medianą 1.23. Efektywna liczebność według Kisha to 1534 z 2466: tyle kosztuje korekta.
- Model wyniku z wagami. Ta sama regresja co bez korekty, z argumentem
weightsi odpornym błędem standardowym (estymator kanapkowy). Wynik: 0.500, SE = 0.025, 95% CI [0.452, 0.549]. Bootstrap, który za każdym razem szacuje model udziału od nowa, dał SE = 0.023 i przedział percentylowy [0.456, 0.545]. - Kontrola. Ważona średnia objawów T3 wyniosła −0.015, blisko wartości z pełnych danych. Wagi z funkcji
weightit()(estymanda ATE) różniły się od ręcznych tylko błędem zaokrągleń, więc oba sposoby są równoważne.
Cole i Hernán (2008) wymieniają założenia, od których zależy ta korekta: wymienność (po uwzględnieniu zmiennych w modelu udział nie zależy od wyniku), dodatniość (każdy ma niezerową szansę ukończenia), spójność i poprawny model wag. Podkreślają, że diagnostyka wag i analizy wrażliwości są niezbędne, a przycinanie wag pokazują jako prosty kompromis między obciążeniem a precyzją. Seaman i White (2013) dodają, że imputacja wielokrotna jest zwykle bardziej efektywna, choć w niektórych sytuacjach IPW bywa preferowane, i omawiają przycinanie oraz stabilizację wag.
Czego wagi nie naprawią
Pojedynczy przykład może być szczęśliwy. Powtórzyliśmy więc badanie 1000 razy (n = 2000, ukończenie średnio 62.7%) dla dwóch mechanizmów z Rysunku 2. W mechanizmie B rezygnacja zależy od samych objawów T3, których u osób rezygnujących nie znamy. To braki MNAR (zob. braki danych MCAR, MAR, MNAR).
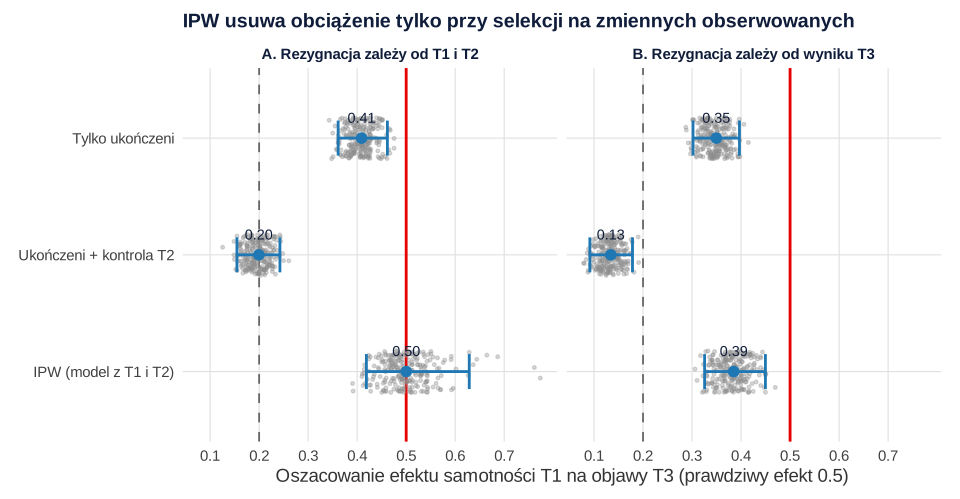
W mechanizmie A IPW jest nieobciążone: średnia 0.500 przy błędzie Monte Carlo 0.0017. Analiza osób, które ukończyły, daje 0.409, a jej 95% przedział obejmował prawdziwy efekt tylko w 7.1% powtórzeń. W mechanizmie B IPW zmniejsza obciążenie (0.385 zamiast 0.349), ale go nie usuwa, a pokrycie spada do 8.2%. Średni poziom objawów po ważeniu jest w mechanizmie B wciąż o 0.226 SD za niski. Model udziału nie widzi przyczyny rezygnacji, więc wagi nie mogą jej odtworzyć.
Symulacja pokazuje też koszt korekty. SD oszacowań IPW (0.053) była dwa razy większa niż analizy bez korekty (0.026), a średni odporny SE (0.043) ją niedoszacowywał. Pokrycie wyniosło więc .912 zamiast .95. Winne są rzadkie, bardzo duże wagi. Podaj ich rozkład i efektywną liczebność, a analizę powtórz z wagami przyciętymi.
Korekta nie naprawi zatem:
- selekcji zależnej od wyniku albo od niezmierzonych przyczyn wyniku (MNAR);
- selekcji, o której nie masz danych, np. osób, które nigdy nie otworzyły zaproszenia, jeśli nic o nich nie wiesz;
- braku dodatniości: grup, z których nikt nie trafił do próby, np. osób bez dostępu do internetu w badaniu online;
- źle określonego modelu udziału, np. bez interakcji, które naprawdę decydują o rezygnacji.
W takich sytuacjach zostaje analiza wrażliwości: założone odchylenie wyników osób rezygnujących, np. analiza punktu krytycznego, albo model selekcji z jawnymi założeniami. Munafò i in. (2018) proponują też modelowanie samego udziału: jeśli wiesz, które cechy mierzone u wszystkich przewidują późniejszy udział, możesz ocenić, jak bardzo selekcja mogła zniekształcić wynik.
Jak opisać selekcję w artykule
Opisz trzy rzeczy: kto mógł trafić do próby i kto trafił, od czego zależał udział (z porównaniem osób, które ukończyły i zrezygnowały, zob. utrata uczestników) oraz jak to uwzględniono w analizie. Wynik bez korekty podaj obok wyniku skorygowanego.
Jeśli recenzent kwestionuje próbę albo utratę uczestników, możemy wspólnie narysować mechanizm selekcji, przygotować korektę i analizę wrażliwości w ramach analiz statystycznych dla badaczy.
Przykład w R
Przepisy uruchamiasz po kolei w jednej sesji R (trzeci korzysta z funkcji z drugiego). Drugi zapisuje dane kohorty do pliku blad-selekcji-kohorta.csv (możesz go pobrać tutaj; brak wyniku T3 oznacza rezygnację). Całość liczy się kilkanaście sekund. Potrzebne pakiety: WeightIt, sandwich i lmtest.
1. Ochotnicy: selekcja a korelacja
R
# Krok 1. Ochotnicy w badaniu online: jak łagodna selekcja zniekształca korelację (dane symulowane)
# Populacja dorosłych: aktywność fizyczna (X) i dobrostan (Y) w jednostkach SD, prawdziwa korelacja .20.
# Szansa udziału w ankiecie o zdrowym stylu życia rośnie z aktywnością i z dobrostanem.
set.seed(3481)
N <- 20000
akt <- rnorm(N)
dobr <- 0.2 * akt + sqrt(1 - 0.2^2) * rnorm(N)

# Udział: logit P(udział) = a + b·X + b·Y; a dobieramy tak, by wzięło udział ok. 10% populacji
udzial_przy <- function(b, cel = 0.10) {
  a <- uniroot(function(a) mean(plogis(a + b * akt + b * dobr)) - cel, c(-10, 5))$root
  runif(N) < plogis(a + b * akt + b * dobr)
}
bs <- c(0, 0.25, 0.5, 1, 1.5)
udzial <- lapply(bs, udzial_przy)
wyniki <- t(mapply(function(b, s) {
  ci <- cor.test(akt[s], dobr[s])$conf.int
  c(b = b, OR_na_SD = exp(b), n = sum(s), r_populacja = cor(akt, dobr), r_uczestnicy = cor(akt[s], dobr[s]),
    dolna = ci[1], gorna = ci[2], M_dobrostan = mean(dobr[s]))
}, bs, udzial))
print(round(wyniki, 3), row.names = FALSE)

# Scenariusz do rysunku 1: OR = 2.72 na 1 SD każdej cechy (b = 1)
s1 <- udzial[[4]]
write.csv(data.frame(akt = round(akt, 3), dobr = round(dobr, 3), udzial = s1), "rysunek1-ochotnicy.csv", row.names = FALSE)
# Regresja dobrostanu na aktywność: populacja i ochotnicy
round(rbind(populacja = coef(lm(dobr ~ akt)), ochotnicy = coef(lm(dobr ~ akt, subset = s1))), 3)
Wynik w R
        b OR_na_SD    n r_populacja r_uczestnicy  dolna  gorna M_dobrostan
[1,] 0.00    1.000 2005       0.204        0.176  0.133  0.218      -0.001
[2,] 0.25    1.284 1957       0.204        0.191  0.148  0.233       0.267
[3,] 0.50    1.649 1958       0.204        0.186  0.143  0.229       0.512
[4,] 1.00    2.718 2002       0.204        0.054  0.010  0.098       0.907
[5,] 1.50    4.482 2015       0.204       -0.119 -0.162 -0.076       1.050
          (Intercept)   akt
populacja       0.000 0.205
ochotnicy       0.858 0.056
2. Rezygnacja z badania i korekta wagami IPW
R
# Krok 2. Analiza tylko osób, które ukończyły badanie, i korekta wagami IPW (dane symulowane)
# Kohorta studentów: samotność na starcie (T1), objawy depresji w połowie badania (T2) i na końcu (T3).
# Pytanie: o ile wyższe są objawy w T3 przy samotności wyższej o 1 SD (efekt całkowity).
suppressPackageStartupMessages({library(sandwich); library(lmtest); library(WeightIt)})

generuj_kohorte <- function(n) {
  samotnosc <- rnorm(n)                                          # T1, jednostki SD
  objawy_t2 <- 0.5 * samotnosc + sqrt(0.75) * rnorm(n)           # T2: skutek samotności (wynik pośredni)
  objawy_t3 <- 0.2 * samotnosc + 0.6 * objawy_t2 + sqrt(0.48) * rnorm(n)  # T3: efekt całkowity 0.2 + 0.6·0.5 = 0.5
  data.frame(samotnosc, objawy_t2, objawy_t3)
}
# Mechanizm A: rezygnacja zależy od zmiennych obserwowanych u wszystkich (samotność T1, objawy T2)
# Mechanizm B: rezygnacja zależy od samego wyniku T3, którego u osób rezygnujących nie znamy
ukonczenie <- function(d, mechanizm) {
  lp <- if (mechanizm == "A") 0.8 - 0.5 * d$samotnosc - 1.5 * d$objawy_t2
        else                  0.8 - 0.5 * d$samotnosc - 1.5 * d$objawy_t3
  rbinom(nrow(d), 1, plogis(lp))
}

set.seed(3482)
d <- generuj_kohorte(4000)
d$ukonczyl <- ukonczenie(d, "A")
d$objawy_t3_obs <- ifelse(d$ukonczyl == 1, d$objawy_t3, NA)      # tak wyglądają prawdziwe dane
write.csv(transform(d[, c("samotnosc", "objawy_t2", "objawy_t3_obs", "ukonczyl")],
                    samotnosc = round(samotnosc, 3), objawy_t2 = round(objawy_t2, 3),
                    objawy_t3_obs = round(objawy_t3_obs, 3)),
          "blad-selekcji-kohorta.csv", row.names = FALSE)
cat("Ukończyło badanie:", sum(d$ukonczyl), "z", nrow(d), sprintf("(%.1f%%)\n", 100 * mean(d$ukonczyl)))

# Kto zrezygnował? Porównanie danych z T1 i T2 (te mamy u wszystkich)
round(aggregate(cbind(samotnosc, objawy_t2) ~ ukonczyl, data = d, FUN = mean), 3)

# Model udziału (selekcji) na wszystkich osobach i wagi 1/P(ukończenie)
m_udzial <- glm(ukonczyl ~ samotnosc + objawy_t2, family = binomial, data = d)
round(coef(summary(m_udzial)), 3)
d$p_ukoncz <- fitted(m_udzial)
d$w <- 1 / d$p_ukoncz
uk <- subset(d, ukonczyl == 1)
cat("Wagi u osób, które ukończyły: min", round(min(uk$w), 2), " mediana", round(median(uk$w), 2),
    " max", round(max(uk$w), 2), "\n")
cat("Efektywna liczebność (Kish):", round(sum(uk$w)^2 / sum(uk$w^2)), "z", nrow(uk), "\n")

# To samo w WeightIt: wagi ATE dla grupy 'ukończył' są równe 1/P(ukończenie)
wi <- weightit(ukonczyl ~ samotnosc + objawy_t2, data = d, method = "glm", estimand = "ATE")
cat("Największa różnica wag glm i WeightIt:", signif(max(abs(wi$weights[d$ukonczyl == 1] - uk$w)), 3), "\n")

# Cztery analizy efektu samotności na objawy T3
pelne  <- lm(objawy_t3 ~ samotnosc, data = d)                    # niedostępne w praktyce: punkt odniesienia
tylko  <- lm(objawy_t3_obs ~ samotnosc, data = uk)               # tylko osoby, które ukończyły
z_t2   <- lm(objawy_t3_obs ~ samotnosc + objawy_t2, data = uk)   # kontrola wyniku pośredniego
ipw    <- lm(objawy_t3_obs ~ samotnosc, data = uk, weights = w)  # ważenie odwrotnością P(ukończenia)
wiersz <- function(m, V = vcov(m)) {
  ct <- coeftest(m, vcov. = V)["samotnosc", ]
  c(b = ct[["Estimate"]], SE = ct[["Std. Error"]],
    dolna = ct[["Estimate"]] - 1.96 * ct[["Std. Error"]], gorna = ct[["Estimate"]] + 1.96 * ct[["Std. Error"]])
}
tab <- rbind(pelne_dane = wiersz(pelne), tylko_ukonczeni = wiersz(tylko),
             z_kontrola_T2 = wiersz(z_t2), IPW_odporne_SE = wiersz(ipw, vcovHC(ipw, type = "HC0")))
print(round(tab, 3))

# Średni poziom objawów w T3: pełne dane, osoby, które ukończyły, i średnia ważona IPW
round(c(pelne = mean(d$objawy_t3), tylko_ukonczeni = mean(uk$objawy_t3_obs),
        IPW = weighted.mean(uk$objawy_t3_obs, uk$w)), 3)

# Bootstrap IPW: w każdej próbie bootstrapowej model udziału szacujemy od nowa
ipw_b <- function(dd) {
  dd$w <- 1 / fitted(glm(ukonczyl ~ samotnosc + objawy_t2, family = binomial, data = dd))
  coef(lm(objawy_t3_obs ~ samotnosc, data = dd[dd$ukonczyl == 1, ], weights = w))[["samotnosc"]]
}
set.seed(34821)
b_boot <- replicate(1000, ipw_b(d[sample(nrow(d), replace = TRUE), ]))
round(c(SE_bootstrap = sd(b_boot), dolna_perc = quantile(b_boot, .025, names = FALSE),
        gorna_perc = quantile(b_boot, .975, names = FALSE)), 3)
Wynik w R
Ukończyło badanie: 2466 z 4000 (61.7%)
  ukonczyl samotnosc objawy_t2
1        0     0.534     0.706
2        1    -0.316    -0.426
            Estimate Std. Error z value Pr(>|z|)
(Intercept)    0.751      0.043  17.567        0
samotnosc     -0.547      0.049 -11.172        0
objawy_t2     -1.466      0.060 -24.532        0
Wagi u osób, które ukończyły: min 1  mediana 1.23  max 19.49
Efektywna liczebność (Kish): 1534 z 2466
Największa różnica wag glm i WeightIt: 2.84e-14
                    b    SE dolna gorna
pelne_dane      0.514 0.014 0.488 0.541
tylko_ukonczeni 0.429 0.018 0.394 0.465
z_kontrola_T2   0.221 0.016 0.189 0.253
IPW_odporne_SE  0.500 0.025 0.452 0.549
          pelne tylko_ukonczeni             IPW
          0.003          -0.320          -0.015
SE_bootstrap   dolna_perc   gorna_perc
       0.023        0.456        0.545
3. Monte Carlo: kiedy IPW działa, a kiedy nie
R
# Krok 3. Czego IPW nie naprawi: 1000 powtórzeń dla dwóch mechanizmów rezygnacji
# (wymaga funkcji z kroku 2; prawdziwy efekt całkowity = 0.5, efekt bezpośredni = 0.2)
jedna_kohorta <- function(n, mechanizm) {
  d <- generuj_kohorte(n)
  d$ukonczyl <- ukonczenie(d, mechanizm)
  d$w <- 1 / fitted(glm(ukonczyl ~ samotnosc + objawy_t2, family = binomial, data = d))
  uk <- d[d$ukonczyl == 1, ]
  m_ipw <- lm(objawy_t3 ~ samotnosc, data = uk, weights = w)
  se_ipw <- sqrt(vcovHC(m_ipw, type = "HC0")["samotnosc", "samotnosc"])
  m_tylko <- lm(objawy_t3 ~ samotnosc, data = uk)
  m_t2 <- lm(objawy_t3 ~ samotnosc + objawy_t2, data = uk)
  b <- c(tylko_ukonczeni = coef(m_tylko)[["samotnosc"]], z_kontrola_T2 = coef(m_t2)[["samotnosc"]],
         IPW = coef(m_ipw)[["samotnosc"]])
  se <- c(sqrt(vcov(m_tylko)["samotnosc", "samotnosc"]), sqrt(vcov(m_t2)["samotnosc", "samotnosc"]), se_ipw)
  c(b, setNames(se, paste0("SE_", names(b))), setNames(abs(b - 0.5) < 1.96 * se, paste0("pokrycie_", names(b))),
    srednia_tylko = mean(uk$objawy_t3), srednia_IPW = weighted.mean(uk$objawy_t3, uk$w),
    odsetek_ukonczenia = mean(d$ukonczyl))
}
set.seed(3483)
R <- 1000
mc <- lapply(c(A = "A", B = "B"), function(m) t(replicate(R, jedna_kohorta(2000, m))))
for (m in names(mc)) write.csv(mc[[m]], paste0("mc-mechanizm-", m, ".csv"), row.names = FALSE)
podsumuj <- function(x) {
  nazwy <- c("tylko_ukonczeni", "z_kontrola_T2", "IPW")
  est <- x[, nazwy]
  rbind(srednia = colMeans(est), obciazenie = colMeans(est) - 0.5, SD = apply(est, 2, sd),
        sredni_SE = colMeans(x[, paste0("SE_", nazwy)]), pokrycie_95 = colMeans(x[, paste0("pokrycie_", nazwy)]))
}
cat("Mechanizm A: rezygnacja zależy od samotności T1 i objawów T2 (obserwowanych)\n")
print(round(podsumuj(mc$A), 3))
cat("Mechanizm B: rezygnacja zależy od objawów T3 (wyniku)\n")
print(round(podsumuj(mc$B), 3))
cat("Średnia objawów T3 (prawdziwa 0): tylko ukończeni / IPW\n")
round(rbind(A = colMeans(mc$A[, c("srednia_tylko", "srednia_IPW")]),
            B = colMeans(mc$B[, c("srednia_tylko", "srednia_IPW")])), 3)
round(c(ukonczenie_A = mean(mc$A[, "odsetek_ukonczenia"]), ukonczenie_B = mean(mc$B[, "odsetek_ukonczenia"])), 3)
# Błąd Monte Carlo średniego oszacowania IPW (mechanizm A):
round(sd(mc$A[, "IPW"]) / sqrt(R), 4)
Wynik w R
Mechanizm A: rezygnacja zależy od samotności T1 i objawów T2 (obserwowanych)
            tylko_ukonczeni z_kontrola_T2   IPW
srednia               0.409         0.199 0.500
obciazenie           -0.091        -0.301 0.000
SD                    0.026         0.023 0.053
sredni_SE             0.026         0.023 0.043
pokrycie_95           0.071         0.000 0.912
Mechanizm B: rezygnacja zależy od objawów T3 (wyniku)
            tylko_ukonczeni z_kontrola_T2    IPW
srednia               0.349         0.134  0.385
obciazenie           -0.151        -0.366 -0.115
SD                    0.024         0.022  0.032
sredni_SE             0.024         0.022  0.031
pokrycie_95           0.000         0.000  0.082
Średnia objawów T3 (prawdziwa 0): tylko ukończeni / IPW
  srednia_tylko srednia_IPW
A        -0.317       0.000
B        -0.426      -0.226
ukonczenie_A ukonczenie_B
       0.627        0.627
[1] 0.0017
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–3 w R 4.5.3 (modele lm() i glm() z pakietu stats) z pakietami WeightIt, sandwich i lmtest; rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- WeightIt (wersja 2.1.0): Greifer, N. (2026). WeightIt: Weighting for covariate balance in observational studies (R package version 2.1.0) [Computer software]. https://doi.org/10.32614/CRAN.package.WeightIt
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- lmtest (wersja 0.9.40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- „Badamy związki, więc selekcja nie ma znaczenia”. Ma, gdy udział zależy od ekspozycji i wyniku albo ich przyczyn.
- Porównanie osób utraconych tylko pod względem demografii. Sprawdź też zmienne związane z ekspozycją i wynikiem, zwłaszcza te zmierzone tuż przed rezygnacją.
- Kontrola wyniku pośredniego zamiast korekty selekcji. Zamyka jedną ścieżkę, ale zmienia pytanie z efektu całkowitego na bezpośredni.
- Model udziału tylko z danymi demograficznymi. Wagi korygują tylko to, co jest w modelu.
- Brak diagnostyki wag. Bez rozkładu wag i efektywnej liczebności czytelnik nie oceni, ile kosztowała korekta.
- Selekcja przemilczana w dyskusji. Napisz, do jakiej populacji odnosi się wynik i w którą stronę może być obciążony.
Najczęstsze pytania
Czy analiza tylko osób, które ukończyły badanie, jest obciążona?
Jest obciążona, gdy rezygnacja zależy jednocześnie od ekspozycji i od wyniku albo jego przyczyn, bo ukończenie badania staje się wtedy zmienną zderzeniową. W przykładzie analiza 2466 z 4000 osób dała efekt 0.43 zamiast 0.51 w pełnych danych. Jeśli rezygnacja zależy tylko od zmiennych, które są w modelu jako predyktory, oszacowanie współczynnika pozostaje nieobciążone.
Jak skorygować utratę uczestników wagami IPW?
Oszacuj na wszystkich osobach regresję logistyczną ukończenia badania na zmiennych zebranych przed rezygnacją, a osobom, które ukończyły, nadaj wagi 1/P(ukończenie). Model wyniku dopasuj z tymi wagami i z odpornym błędem standardowym albo bootstrapem, który szacuje model udziału od nowa. Podaj rozkład wag i efektywną liczebność.
Czy błąd selekcji zmienia korelacje, czy tylko średnie?
Zmienia jedno i drugie. W symulacji ochotników średnie reagowały szybciej: przy umiarkowanej selekcji korelacja prawie się nie zmieniła, a średni dobrostan wzrósł o pół SD. Przy silniejszej selekcji korelacja spadła z .20 do .05, a przy jeszcze silniejszej zmieniła znak.
Kiedy wagi IPW nie usuną błędu selekcji?
Gdy udział zależy od samego wyniku albo od niezmierzonych przyczyn wyniku (braki MNAR), gdy części populacji w ogóle nie ma w próbie (brak dodatniości) i gdy model udziału jest źle określony. W symulacji z rezygnacją zależną od wyniku IPW dało średnio 0.39 zamiast 0.5. Pozostaje wtedy analiza wrażliwości.
Co to jest collider scope w badaniach z biobanków?
To określenie Munafò i in. (2018) na sytuację, w której selekcja do dużej kohorty lub biobanku działa jak warunkowanie na zderzaczu i obciąża oszacowania związków, nie tylko częstości. Duża liczebność nie chroni przed tym błędem, daje tylko węższy przedział wokół obciążonej wartości.
Powiązane hasła
Przeczytaj też
Grafy przyczynowe (DAG)
Zakłócacz, mediator i zderzacz, kryterium tylnych drzwi i zbiór dostosowujący – z symulacją w R, która pokazuje koszt złej kontroli.
Czytaj →PoradnikBraki danych i imputacja wielokrotna w R
MCAR, MAR i MNAR, test Little’a, symulacja metod i imputacja wielokrotna w R krok po kroku – z kodem, regułami Rubina i gotowym opisem APA.
Czytaj →PoradnikEmulacja badania docelowego krok po kroku
Tabela protokołu, punkt zero, klonowanie–cenzurowanie–ważenie i ważone krzywe przeżycia w R – na kohorcie, w której znamy prawdziwy efekt.
Czytaj →Recenzent pyta o selekcję próby albo utratę uczestników?
Pomożemy opisać mechanizm selekcji, przygotować i sprawdzić korektę wagami oraz analizę wrażliwości tak, żebyś mógł(a) samodzielnie obronić wnioski przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Cole, S. R., & Hernán, M. A. (2008). Constructing inverse probability weights for marginal structural models. American Journal of Epidemiology, 168(6), 656–664. https://doi.org/10.1093/aje/kwn164 ● Otwarty dostęp
- Elwert, F., & Winship, C. (2014). Endogenous selection bias: The problem of conditioning on a collider variable. Annual Review of Sociology, 40(1), 31–53. https://doi.org/10.1146/annurev-soc-071913-043455 ● Otwarty dostęp
- Fry, A., Littlejohns, T. J., Sudlow, C., Doherty, N., Adamska, L., Sprosen, T., Collins, R., & Allen, N. E. (2017). Comparison of sociodemographic and health-related characteristics of UK Biobank participants with those of the general population. American Journal of Epidemiology, 186(9), 1026–1034. https://doi.org/10.1093/aje/kwx246 ● Otwarty dostęp
- Griffith, G. J., Morris, T. T., Tudball, M. J., Herbert, A., Mancano, G., Pike, L., Sharp, G. C., Sterne, J., Palmer, T. M., Davey Smith, G., Tilling, K., Zuccolo, L., Davies, N. M., & Hemani, G. (2020). Collider bias undermines our understanding of COVID-19 disease risk and severity. Nature Communications, 11(1), Article 5749. https://doi.org/10.1038/s41467-020-19478-2 ● Otwarty dostęp
- Hernán, M. A., Hernández-Díaz, S., & Robins, J. M. (2004). A structural approach to selection bias. Epidemiology, 15(5), 615–625. https://doi.org/10.1097/01.ede.0000135174.63482.43
- Munafò, M. R., Tilling, K., Taylor, A. E., Evans, D. M., & Davey Smith, G. (2018). Collider scope: When selection bias can substantially influence observed associations. International Journal of Epidemiology, 47(1), 226–235. https://doi.org/10.1093/ije/dyx206 ● Otwarty dostęp
- Rohrer, J. M. (2018). Thinking clearly about correlations and causation: Graphical causal models for observational data. Advances in Methods and Practices in Psychological Science, 1(1), 27–42. https://doi.org/10.1177/2515245917745629 ● Otwarty dostęp
- Seaman, S. R., & White, I. R. (2013). Review of inverse probability weighting for dealing with missing data. Statistical Methods in Medical Research, 22(3), 278–295. https://doi.org/10.1177/0962280210395740
Cytowania BibTeX
@article{cole2008constructing, author={Cole, Stephen R. and Hernán, Miguel A.}, title={{Constructing inverse probability weights for marginal structural models}}, journal={American Journal of Epidemiology}, year={2008}, volume={168}, number={6}, pages={656--664}, doi={10.1093/aje/kwn164}}@article{elwert2014endogenous, author={Elwert, Felix and Winship, Christopher}, title={{Endogenous selection bias: The problem of conditioning on a collider variable}}, journal={Annual Review of Sociology}, year={2014}, volume={40}, number={1}, pages={31--53}, doi={10.1146/annurev-soc-071913-043455}}@article{fry2017comparison, author={Fry, Anna and Littlejohns, Thomas J. and Sudlow, Cathie and Doherty, Nicola and Adamska, Ligia and Sprosen, Tim and Collins, Rory and Allen, Naomi E.}, title={{Comparison of sociodemographic and health-related characteristics of UK Biobank participants with those of the general population}}, journal={American Journal of Epidemiology}, year={2017}, volume={186}, number={9}, pages={1026--1034}, doi={10.1093/aje/kwx246}}@article{griffith2020collider, author={Griffith, Gareth J. and Morris, Tim T. and Tudball, Matthew J. and Herbert, Annie and Mancano, Giulia and Pike, Lindsey and Sharp, Gemma C. and Sterne, Jonathan and Palmer, Tom M. and Davey Smith, George and Tilling, Kate and Zuccolo, Luisa and Davies, Neil M. and Hemani, Gibran}, title={{Collider bias undermines our understanding of COVID-19 disease risk and severity}}, journal={Nature Communications}, year={2020}, volume={11}, number={1}, eid={5749}, doi={10.1038/s41467-020-19478-2}}@article{hernan2004structural, author={Hernán, Miguel A. and Hernández-Díaz, Sonia and Robins, James M.}, title={{A structural approach to selection bias}}, journal={Epidemiology}, year={2004}, volume={15}, number={5}, pages={615--625}, doi={10.1097/01.ede.0000135174.63482.43}}@article{munafo2018collider, author={Munafò, Marcus R. and Tilling, Kate and Taylor, Amy E. and Evans, David M. and Davey Smith, George}, title={{Collider scope: When selection bias can substantially influence observed associations}}, journal={International Journal of Epidemiology}, year={2018}, volume={47}, number={1}, pages={226--235}, doi={10.1093/ije/dyx206}}@article{rohrer2018thinking, author={Rohrer, Julia M.}, title={{Thinking clearly about correlations and causation: Graphical causal models for observational data}}, journal={Advances in Methods and Practices in Psychological Science}, year={2018}, volume={1}, number={1}, pages={27--42}, doi={10.1177/2515245917745629}}@article{seaman2013review, author={Seaman, Shaun R. and White, Ian R.}, title={{Review of inverse probability weighting for dealing with missing data}}, journal={Statistical Methods in Medical Research}, year={2013}, volume={22}, number={3}, pages={278--295}, doi={10.1177/0962280210395740}}