Najpierw protokół, potem dane
Hasło emulacja badania docelowego wyjaśnia ideę: opisujesz badanie randomizowane, które odpowiedziałoby na Twoje pytanie, i naśladujesz je w danych obserwacyjnych (Hernán i Robins, 2016). Ten wpis pokazuje, jak zrobić to w praktyce, gdy leczenie nie zaczyna się w punkcie zero, tylko „w ciągu kilku tygodni”. To najczęstsza sytuacja w rejestrach i dokumentacji medycznej. Zwykłe porównanie „rozpoczęli” vs „nie rozpoczęli” wpada wtedy w błąd czasu nieśmiertelnego. Rozwiązaniem jest klonowanie, cenzurowanie i ważenie (Hernán, 2018).
Zanim zaczniesz, narysuj graf przyczynowy (DAG). Z niego wynika, które zmienne musisz zmierzyć, żeby skorygować zakłócenie. Bez tej listy wagi niczego nie naprawią.
Przykład: psychoterapia po wypisie ze szpitala
Pytanie: czy rozpoczęcie psychoterapii ambulatoryjnej w ciągu 12 tygodni od wypisu ze szpitala psychiatrycznego zmniejsza ryzyko ponownej hospitalizacji w ciągu roku? Dane są symulowane (set.seed(3325)). Rejestr obejmuje 6000 wypisów, a czas mierzymy w tygodniach. Terapię częściej zaczynają osoby z cięższymi objawami przy wypisie. To zakłócenie przez wskazanie: te same osoby mają też wyższe ryzyko hospitalizacji. Osoby po wcześniejszych hospitalizacjach są w podobnej sytuacji. Po rozpoczęciu terapii tygodniowy hazard hospitalizacji spada (HR = 0.6).
Symulacja ma jedną przewagę nad prawdziwym rejestrem: znamy prawdę. Ta sama populacja 200 000 osób „przeszła” obie strategie. Ryzyko hospitalizacji w ciągu 52 tygodni wyniosło 23.4% przy strategii z terapią i 30.8% bez niej. Prawdziwa różnica ryzyk to −7.5 punktu procentowego. Dane kohorty możesz pobrać jako plik CSV.
Krok 1. Protokół w tabeli
Każdy element zapisz dwa razy: jak wyglądałby w badaniu randomizowanym i jak odtwarzasz go w danych. Tabelę dołącz do artykułu albo do planu analizy, zanim zobaczysz wyniki.
| Element | Badanie docelowe | Emulacja w danych |
|---|---|---|
| Kwalifikacja | dorośli wypisani ze szpitala psychiatrycznego, bez psychoterapii przed hospitalizacją | wypisy z rejestru; wykluczono osoby w terapii przed wypisem (zostało 4737 z 6000) |
| Strategie | A: rozpocznij psychoterapię w ciągu 12 tygodni, najpóźniej w 12. tygodniu; B: nie rozpoczynaj jej w tym czasie | te same, odczytane z dat pierwszej sesji |
| Przydział | losowy, w dniu wypisu | każda osoba trafia do obu ramion (klony); zakłócenie korygują wagi |
| Punkt zero | wypis = kwalifikacja = przydział | dzień wypisu dla obu klonów |
| Wynik | ponowna hospitalizacja psychiatryczna | tydzień hospitalizacji z rejestru |
| Okres obserwacji | 52 tygodnie albo do hospitalizacji | to samo; klon kończy obserwację także przy odstępstwie od strategii |
| Kontrast przyczynowy | różnica ryzyk 52-tygodniowych przy przestrzeganiu strategii | odpowiednik efektu per protocol |
| Analiza | krzywe skumulowanego ryzyka w ramionach | klonowanie, cenzurowanie, wagi, ważone krzywe Kaplana–Meiera, bootstrap |
Dwa wiersze wymagają komentarza. Strategia A musi mówić, co się dzieje w okresie na rozpoczęcie leczenia (ang. grace period). Tu: kto nie zaczął wcześniej, zaczyna w 12. tygodniu. Od tej definicji zależą wagi. Kontrast przyczynowy to estymanda analizy. Odpowiednika analizy ITT nie da się tu zbudować, bo w dniu wypisu nikt nie jest „przydzielony”. Zostaje efekt przestrzegania strategii, czyli odpowiednik analizy per protocol (Hernán i Robins, 2017).
Krok 2. Zobacz, co psuje naiwne porównanie
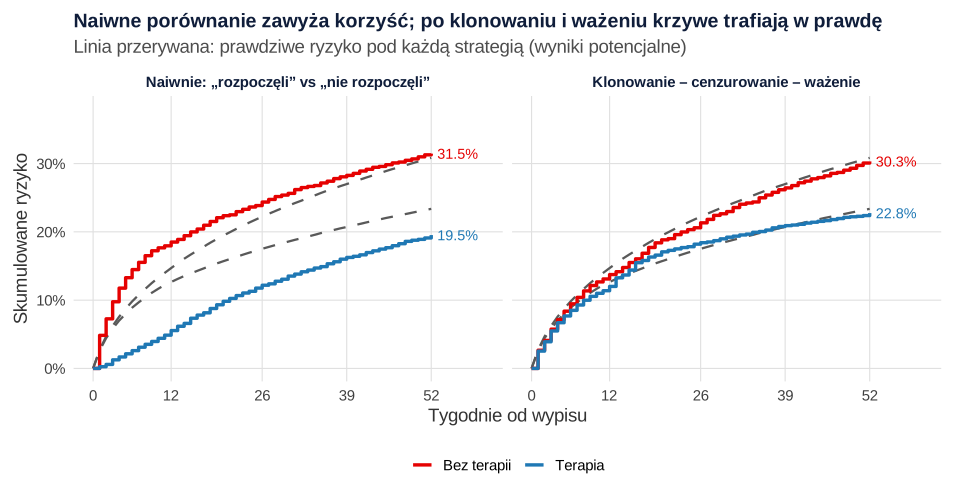
Terapię w ciągu 12 tygodni rozpoczęło 2381 z 4737 osób, w medianie w 5. tygodniu. Naiwna analiza dzieli kohortę na tych, którzy zaczęli, i tych, którzy nie zaczęli, i liczy czas od wypisu. Grupy powstają jednak z informacji z przyszłości. Żeby trafić do grupy „terapia”, trzeba dożyć pierwszej sesji bez hospitalizacji. Hospitalizacje z pierwszych tygodni trafiają więc głównie do grupy „bez terapii” (Hernán i in., 2016).
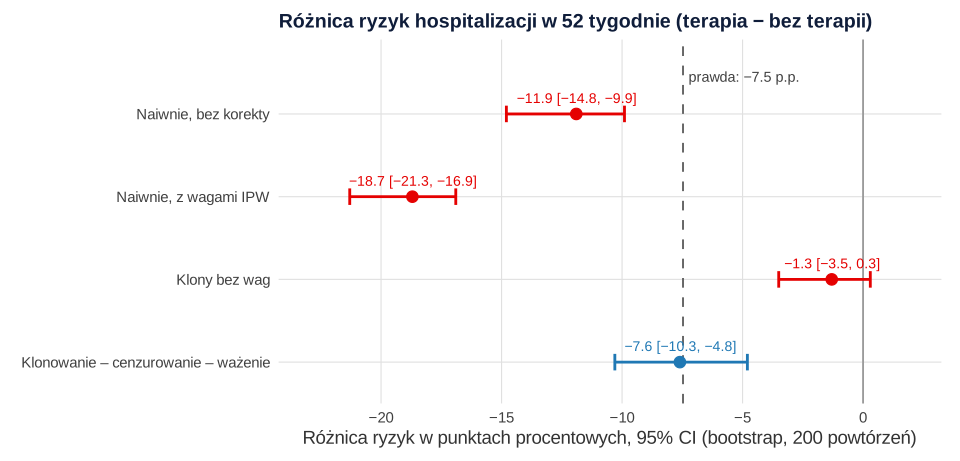
Wynik: ryzyko 19.5% z terapią i 31.5% bez niej, różnica −11.9 p.p., a HR = 0.55. Korzyść jest zawyżona o ponad połowę. Wagi IPW dla nasilenia objawów i wcześniejszych hospitalizacji pogarszają sprawę: różnica rośnie do −18.7 p.p. W kohorcie osoby rozpoczynające terapię miały średnio wyższe nasilenie objawów (0.210 wobec −0.218 w skali z). Zakłócenie przez wskazanie działało przeciw terapii i częściowo maskowało błąd czasu nieśmiertelnego. Korekta usunęła maskę, ale nie usunęła błędu. Korekta zakłócenia nie naprawi błędu w projekcie. Tak samo działałoby dopasowanie z wpisu o propensity score.
Krok 3. Klonowanie i cenzurowanie
W dniu wypisu nie wiadomo, którą strategię realizuje dana osoba. Hospitalizacja w 3. tygodniu bez terapii jest zgodna z obiema strategiami: osoba mogła jeszcze zacząć. Dlatego każdą osobę kopiujesz do obu ramion. Klon jest cenzurowany w chwili, gdy jego dalsza historia przestaje być zgodna z jego strategią:
- ramię A – na początku 12. tygodnia, jeśli osoba wciąż nie zaczęła terapii;
- ramię B – w chwili rozpoczęcia terapii;
- hospitalizacja przed startem i przed 12. tygodniem liczy się w obu ramionach (tu 423 zdarzenia).
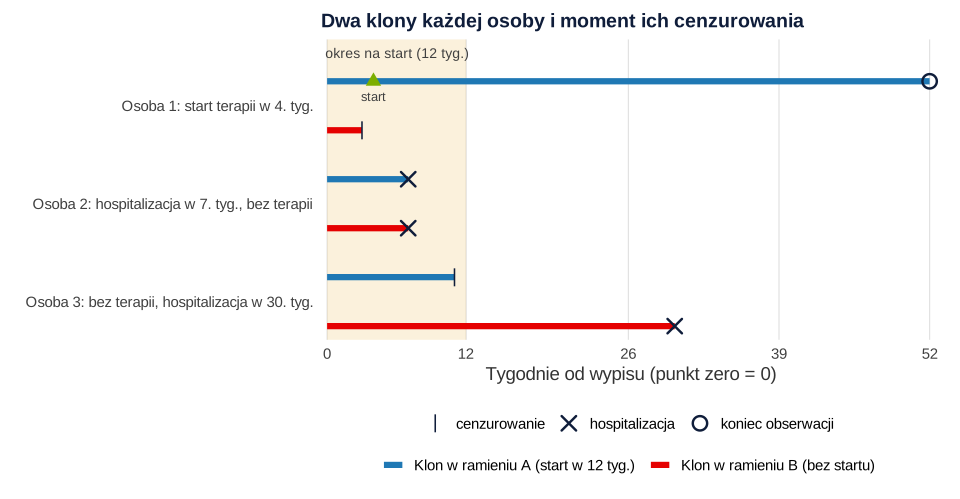
Dane przechowuj w formacie długim: jeden wiersz to jeden tydzień jednego klona. W przykładzie ramię A ma 133 226 osobotygodni, a ramię B 105 216. W ramieniu A cenzurowano 1933 klony, a w B 2381. Klonowanie usuwa zakłócenie w punkcie zero, bo oba ramiona zawierają tych samych ludzi. Problem nie znika, tylko się przenosi. Cenzurowanie zależy teraz od nasilenia objawów, więc jest informatywne.
Krok 4. Wagi za cenzurowanie
Gdy analizujesz klony bez wag, ramię B traci osoby, które zaczęły terapię. To głównie osoby z cięższymi objawami. Ramię A traci osoby, które nie zaczęły, czyli lżejsze przypadki. Oba ramiona przesuwają się ku sobie: różnica wynosi tylko −1.3 p.p., 95% CI [−3.5, 0.3]. Maringe i in. (2020) pokazali w samouczku, że analiza klonów bez wag może się mylić także w drugą stronę: w ich danych o operacjach raka płuca zawyżyła korzyść.
Wagi przywracają cenzurowanych. Najpierw dopasuj model rozpoczęcia terapii w kolejnych tygodniach okresu na rozpoczęcie. W przykładzie to regresja logistyczna dyskretnego hazardu z tygodniem, nasileniem objawów i wcześniejszymi hospitalizacjami. Potem:
- w ramieniu B klon dostaje w każdym tygodniu iloczyn 1 / P(brak startu) z dotychczasowych tygodni;
- w ramieniu A wagę większą niż 1 dostają tylko osoby, które zaczęły dokładnie w 12. tygodniu: 1 / P(start w 12. tygodniu). Reprezentują wszystkich podobnych, którzy nie zaczęli i zostali ocenzurowani.
To są wagi IPW za cenzurowanie. Działają przy założeniach wymienności, dodatniości i poprawnej specyfikacji modelu (Cole i Hernán, 2008). Sprawdź ich rozkład. W ramieniu B maksimum wyniosło 11.17. W ramieniu A doszło do 34.80, bo w 12. tygodniu terapię zaczyna niewielu. Duże wagi zwiększają wariancję. Opisz je, a przycinanie wag pokaż jako analizę wrażliwości. W prawdziwych danych model wag obejmuje też zmienne mierzone po wypisie, np. objawy na wizytach kontrolnych. To ta sama logika co w marginalnych modelach strukturalnych. Podstawy ważenia przy leczeniu zmiennym w czasie omawia podręcznik Hernána i Robinsa (2020).
Krok 5. Krzywe ważone i miary efektu
Z ważonych danych klonów policz krzywe Kaplana–Meiera w formacie start–stop (survfit() z argumentem weights). Ryzyko 52-tygodniowe wyniosło 22.8% w ramieniu A i 30.3% w ramieniu B. Różnica −7.6 p.p. prawie pokrywa się z prawdą (−7.5 p.p.).
Przedział ufności policz bootstrapem. Losuj osoby, a nie klony ani osobotygodnie, i powtarzaj całą procedurę, także dopasowanie modelu wag. Odporny błąd standardowy z ważonego modelu pomija niepewność oszacowania wag. Przy 200 powtórzeniach różnica ryzyk wyniosła −7.6 p.p., 95% CI [−10.3, −4.8]. Granice przedziału mają własny błąd Monte Carlo, więc w artykule zwiększ liczbę powtórzeń.
Podaj ryzyka w obu ramionach, ich różnicę i iloraz (tu 0.75). Ważony iloraz hazardów (0.73) możesz dodać, ale nie jako jedyną miarę. HR uśrednia zmieniający się w czasie efekt i ma wbudowane obciążenie selekcją (Hernán, 2010). Gdy wystarczy ustalić ekspozycję w jednym momencie, prostszą alternatywą bywa analiza landmark. Odpowiada jednak na inne pytanie, bo przesuwa punkt zero.
Jak opisać emulację w artykule
Wytyczne TARGET (Cashin i in., 2025) zalecają kilka elementów. Nazwij badanie emulacją badania docelowego i podaj pytanie przyczynowe. Pokaż tabelę protokołu i jej odwzorowanie w danych. Wymień założenia identyfikujące i podaj oszacowanie każdej estymandy z precyzją oraz analizy wrażliwości. Przy ocenie ryzyka błędu recenzenci użyją narzędzia ROBINS-I, które też porównuje badanie z hipotetycznym badaniem docelowym (Sterne i in., 2016). Wrażliwość na niezmierzone zakłócenie możesz pokazać E-wartością.
Jeśli recenzent pyta o czas nieśmiertelny albo o konstrukcję wag, możemy wspólnie sprawdzić projekt i kod w ramach wsparcia statystycznego dla badaczy.
Emulacja badania docelowego w R
Cztery przepisy uruchamiane po kolei w jednej sesji R. Pierwszy tworzy plik emulacja-psychoterapia-dane.csv (możesz go pobrać tutaj). Potrzebny jest tylko pakiet survival; reszta to funkcje bazowego R. Liczby w tekście pochodzą z tych wyników.
1. Kohorta, prawdziwe ryzyka i kryteria kwalifikacji
R
# Emulacja badania docelowego: psychoterapia po wypisie ze szpitala psychiatrycznego (dane symulowane).
# Punkt zero = dzień wypisu. Czas w tygodniach (1–52). Decyzja o starcie terapii zapada na początku tygodnia 1–12.
# Strategia A: rozpocznij psychoterapię w ciągu 12 tygodni od wypisu. Strategia B: nie rozpoczynaj jej w tym czasie.
# Wynik: ponowna hospitalizacja w ciągu 52 tygodni. Zakłócacze: nasilenie objawów przy wypisie (z) i wcześniejsze hospitalizacje.
suppressPackageStartupMessages(library(survival))
set.seed(3325)
K <- 52; G <- 12                                   # okres obserwacji i okres na rozpoczęcie (grace period), w tygodniach
symuluj <- function(L, P, Ui, Uo, strategia = "obserwowana") {
  n <- length(L); start <- rep(NA_integer_, n); czas <- rep(K, n); zd <- rep(0L, n); zyje <- rep(TRUE, n)
  for (w in 1:K) {
    if (w <= G) {                                  # start terapii: częściej przy cięższych objawach (wskazanie)
      kand <- zyje & is.na(start)
      chce <- Ui[, w] < plogis(-2.8 + 0.4 * L + 0.3 * P)
      rozp <- switch(strategia, obserwowana = kand & chce, A = kand & (chce | w == G), B = rep(FALSE, n))
      start[rozp] <- w
    }
    leczony <- !is.na(start)                       # terapia zmniejsza tygodniowy hazard (HR = 0.6 od startu)
    p <- 1 - exp(-exp(-4.0 - 0.45 * log(w) + 0.6 * L + 0.4 * P + log(0.6) * leczony))
    nowe <- zyje & Uo[, w] < p
    czas[nowe] <- w; zd[nowe] <- 1L; zyje[nowe] <- FALSE
  }
  data.frame(nasilenie = L, wczesniejsze_hosp = P, tydzien_startu = start, tydzien_konca = czas, hospitalizacja = zd)
}

# 1. Prawdziwe ryzyka 52-tygodniowe: ta sama populacja pod strategią A i B (wspólne liczby losowe)
nP <- 200000
LP <- rnorm(nP); PP <- rbinom(nP, 1, plogis(-0.4 + 0.8 * LP))
UiP <- matrix(runif(nP * G), nP); UoP <- matrix(runif(nP * K), nP)
pA <- symuluj(LP, PP, UiP, UoP, "A"); pB <- symuluj(LP, PP, UiP, UoP, "B"); rm(UiP, UoP)
prawda_krzywe <- data.frame(tydzien = 1:K,                 # skumulowane ryzyko hospitalizacji w kolejnych tygodniach
  A = sapply(1:K, function(t) mean(pA$hospitalizacja == 1 & pA$tydzien_konca <= t)),
  B = sapply(1:K, function(t) mean(pB$hospitalizacja == 1 & pB$tydzien_konca <= t)))
round(prawda_krzywe[c(G, 26, K), ], 3)
prawda <- with(prawda_krzywe[K, ], c(ryzyko_A = A, ryzyko_B = B, roznica = A - B, iloraz = A / B))
round(prawda, 3)

# 2. Obserwowana kohorta: 6000 wypisów, część osób była w psychoterapii już przed hospitalizacją
n <- 6000
terapia_wczesniej <- rbinom(n, 1, 0.2)
L <- rnorm(n); P <- rbinom(n, 1, plogis(-0.4 + 0.8 * L))
kohorta <- cbind(id = 1:n, terapia_przed_wypisem = terapia_wczesniej,
                 symuluj(L, P, matrix(runif(n * G), n), matrix(runif(n * K), n)))
kohorta$nasilenie <- round(kohorta$nasilenie, 3)
write.csv(kohorta, "emulacja-psychoterapia-dane.csv", row.names = FALSE, na = "")

# 3. Kryteria kwalifikacji: tylko nowi pacjenci psychoterapii (bez terapii przed wypisem)
k <- subset(kohorta, terapia_przed_wypisem == 0)
k$terapia12 <- as.integer(!is.na(k$tydzien_startu))
c(wypisy = n, kwalifikuje_sie = nrow(k), rozpoczelo_w_12_tyg = sum(k$terapia12),
  hosp_w_tyg_1_11_bez_terapii = sum(k$hospitalizacja == 1 & k$tydzien_konca < G & is.na(k$tydzien_startu)))
summary(k$tydzien_startu)
round(tapply(k$nasilenie, k$terapia12, mean), 3)
Wynik w R
   tydzien     A     B
12      12 0.127 0.147
26      26 0.175 0.222
52      52 0.234 0.308
ryzyko_A ryzyko_B  roznica   iloraz
   0.234    0.308   -0.075    0.758
                     wypisy             kwalifikuje_sie
                       6000                        4737
        rozpoczelo_w_12_tyg hosp_w_tyg_1_11_bez_terapii
                       2381                         423
   Min. 1st Qu.  Median    Mean 3rd Qu.    Max.    NA's
  1.000   2.000   5.000   5.373   8.000  12.000    2356
     0      1
-0.218  0.210
2. Porównania naiwne
R
# Porównania naiwne (wymaga obiektów z przepisu 1): „rozpoczęli terapię w 12 tygodni” vs „nie rozpoczęli”,
# obserwacja od wypisu. Grupy powstają z informacji z przyszłości, więc pojawia się czas nieśmiertelny.
ryzyko52 <- function(fit) 1 - summary(fit, times = K)$surv

# 1. Bez żadnej korekty
km_n <- survfit(Surv(tydzien_konca, hospitalizacja) ~ terapia12, data = k)
r_n <- ryzyko52(km_n)
round(c(ryzyko_B = r_n[1], ryzyko_A = r_n[2], roznica = r_n[2] - r_n[1]), 3)
round(exp(coef(coxph(Surv(tydzien_konca, hospitalizacja) ~ terapia12, data = k))), 3)

# 2. Z wagami IPW dla zakłócaczy z punktu zero (nasilenie, wcześniejsze hospitalizacje)
ps <- fitted(glm(terapia12 ~ nasilenie + wczesniejsze_hosp, family = binomial, data = k))
k$w_ipw <- ifelse(k$terapia12 == 1, 1 / ps, 1 / (1 - ps))
km_ipw <- survfit(Surv(tydzien_konca, hospitalizacja) ~ terapia12, data = k, weights = w_ipw)
r_ipw <- ryzyko52(km_ipw)
round(c(ryzyko_B = r_ipw[1], ryzyko_A = r_ipw[2], roznica = r_ipw[2] - r_ipw[1]), 3)
Wynik w R
ryzyko_B ryzyko_A  roznica
   0.315    0.195   -0.119
terapia12
    0.548
ryzyko_B ryzyko_A  roznica
   0.362    0.175   -0.187
3. Klonowanie, cenzurowanie i ważenie
R
# Klonowanie – cenzurowanie – ważenie (wymaga obiektów z przepisów 1–2).
# Każda osoba trafia do obu ramion. Klon jest cenzurowany, gdy jego zachowanie przestaje być zgodne ze strategią:
#   ramię A (start w 12 tyg.): na początku 12. tygodnia, jeśli do tego czasu nie rozpoczął terapii;
#   ramię B (bez startu):      w chwili rozpoczęcia terapii.
# Hospitalizacja przed startem i przed 12. tygodniem jest zgodna z obiema strategiami: liczy się w obu ramionach.
klonuj <- function(k) {
  # format osobo-tygodni: jeden wiersz = tydzień w (od w − 1 do w)
  pt <- k[rep(seq_len(nrow(k)), k$tydzien_konca), c("id", "nasilenie", "wczesniejsze_hosp", "tydzien_startu",
                                                    "tydzien_konca", "hospitalizacja")]
  pt$w <- sequence(k$tydzien_konca)
  pt$zd <- as.integer(pt$hospitalizacja == 1 & pt$w == pt$tydzien_konca)
  # model startu terapii (dyskretny hazard) w tygodniach 1–12 u osób, które jeszcze nie zaczęły
  ryz <- subset(pt, w <= G & (is.na(tydzien_startu) | tydzien_startu >= w))
  ryz$start <- as.integer(!is.na(ryz$tydzien_startu) & ryz$tydzien_startu == ryz$w)
  m_start <- glm(start ~ factor(w) + nasilenie + wczesniejsze_hosp, family = binomial, data = ryz)
  pt$h <- 0
  pt$h[pt$w <= G] <- predict(m_start, newdata = pt[pt$w <= G, ], type = "response")
  # Ramię A: klon bez startu do 12. tygodnia jest cenzurowany po 11. tygodniu.
  # Waga 1 / P(start w 12. tyg.) dla tych, którzy zaczęli dokładnie w 12. tygodniu – reprezentują cenzurowanych.
  A <- subset(pt, !(is.na(tydzien_startu) & w >= G))
  h12 <- A$h[A$w == G][match(A$id, A$id[A$w == G])]
  A$waga <- ifelse(!is.na(A$tydzien_startu) & A$tydzien_startu == G & A$w >= G, 1 / h12, 1)
  # Ramię B: klon cenzurowany w chwili startu; waga = iloczyn 1 / P(brak startu) w kolejnych tygodniach
  B <- subset(pt, is.na(tydzien_startu) | w < tydzien_startu)
  B$waga <- ave(1 / (1 - B$h), B$id, FUN = cumprod)
  rbind(cbind(A, ramie = "A"), cbind(B, ramie = "B"))
}
klony <- klonuj(k)
c(osobotygodnie_A = sum(klony$ramie == "A"), osobotygodnie_B = sum(klony$ramie == "B"),
  cenzurowani_A = sum(is.na(k$tydzien_startu) & k$tydzien_konca >= G),
  cenzurowani_B = sum(!is.na(k$tydzien_startu)))
# diagnostyka wag: rozkład w 12. tygodniu i na końcu obserwacji
round(do.call(rbind, tapply(klony$waga[klony$w %in% c(G, K)], klony$ramie[klony$w %in% c(G, K)], summary)), 2)

# Krzywe ważone (Kaplan–Meier w formacie start–stop) i ryzyko 52-tygodniowe
km_ccw <- survfit(Surv(w - 1, w, zd) ~ ramie, data = klony, weights = waga)
km_klony <- survfit(Surv(w - 1, w, zd) ~ ramie, data = klony)            # klony bez wag (dla porównania)
r_ccw <- ryzyko52(km_ccw); r_kl <- ryzyko52(km_klony)
round(rbind(klony_bez_wag = c(ryzyko_A = r_kl[1], ryzyko_B = r_kl[2], roznica = r_kl[1] - r_kl[2]),
            klonowanie_cenzurowanie_wazenie = c(r_ccw[1], r_ccw[2], r_ccw[1] - r_ccw[2]),
            prawda = prawda[1:3]), 3)
round(c(iloraz_ryzyk = unname(r_ccw[1] / r_ccw[2]),
        HR_wazony = unname(exp(coef(coxph(Surv(w - 1, w, zd) ~ ramie == "A", data = klony, weights = waga))))), 3)
Wynik w R
osobotygodnie_A osobotygodnie_B   cenzurowani_A   cenzurowani_B
         133226          105216            1933            2381
  Min. 1st Qu. Median Mean 3rd Qu.  Max.
A 1.00    1.00   1.00 1.84    1.00 34.80
B 1.19    1.62   1.89 2.09    2.32 11.17
                                ryzyko_A ryzyko_B roznica
klony_bez_wag                      0.250    0.263  -0.013
klonowanie_cenzurowanie_wazenie    0.228    0.303  -0.076
prawda                             0.234    0.308  -0.075
iloraz_ryzyk    HR_wazony
       0.751        0.732
4. Bootstrap całej procedury
R
# Bootstrap (wymaga funkcji i obiektów z przepisów 1–3): losujemy osoby ze zwracaniem i powtarzamy
# całą procedurę, także dopasowanie modeli wag. 200 powtórzeń (ok. minuty obliczeń).
ryzyka_kw <- function(dl) {                       # ważony KM liczony ręcznie: hazard w każdym tygodniu
  sapply(c("A", "B"), function(r) { x <- dl[dl$ramie == r, ]
    h <- tapply(x$waga * x$zd, x$w, sum) / tapply(x$waga, x$w, sum); 1 - prod(1 - h) })
}
oszacuj <- function(kb) {
  kb$terapia12 <- as.integer(!is.na(kb$tydzien_startu))
  n0 <- 1 - summary(survfit(Surv(tydzien_konca, hospitalizacja) ~ terapia12, data = kb), times = K)$surv
  ps <- fitted(glm(terapia12 ~ nasilenie + wczesniejsze_hosp, family = binomial, data = kb))
  kb$w_ipw <- ifelse(kb$terapia12 == 1, 1 / ps, 1 / (1 - ps))
  n1 <- 1 - summary(survfit(Surv(tydzien_konca, hospitalizacja) ~ terapia12, data = kb, weights = w_ipw), times = K)$surv
  dl <- klonuj(kb); r <- ryzyka_kw(dl); dl$waga <- 1; r0 <- ryzyka_kw(dl)
  c(naiwnie = n0[2] - n0[1], naiwnie_IPW = n1[2] - n1[1], klony_bez_wag = unname(r0[1] - r0[2]),
    CCW = unname(r[1] - r[2]))
}
round(oszacuj(k), 3)                              # zgodność z przepisami 2–3
set.seed(3324)
B <- 200
boot <- t(replicate(B, { kb <- k[sample(nrow(k), replace = TRUE), ]; kb$id <- seq_len(nrow(kb)); oszacuj(kb) }))
round(rbind(oszacowanie = oszacuj(k), SE_boot = apply(boot, 2, sd),
            dolny_2.5 = apply(boot, 2, quantile, 0.025), gorny_97.5 = apply(boot, 2, quantile, 0.975)), 3)
# niepewność Monte Carlo granic przedziału: przy 200 powtórzeniach granice percentylowe są przybliżone
round(c(prawda_roznica = unname(prawda[3])), 3)
Wynik w R
      naiwnie   naiwnie_IPW klony_bez_wag           CCW
       -0.119        -0.187        -0.013        -0.076
            naiwnie naiwnie_IPW klony_bez_wag    CCW
oszacowanie  -0.119      -0.187        -0.013 -0.076
SE_boot       0.013       0.012         0.010  0.014
dolny_2.5    -0.148      -0.213        -0.035 -0.103
gorny_97.5   -0.099      -0.169         0.003 -0.048
prawda_roznica
        -0.075
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem survival (survfit(), coxph()); rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R [R package]. https://CRAN.R-project.org/package=survival
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Grupy według leczenia „kiedykolwiek”. Klasyfikacja z przyszłości daje czas nieśmiertelny. Zrównaj kwalifikację, przydział i punkt zero albo użyj klonów.
- Strategia bez definicji okresu na rozpoczęcie. „Rozpocznij terapię” nie jest strategią, dopóki nie powiesz, do kiedy i co z tymi, którzy nie zaczęli.
- Klony bez wag. Cenzurowanie przy odstępstwie jest informatywne. W przykładzie ukryło prawie cały efekt.
- Bootstrap po wierszach. Losuj osoby i dopasowuj wagi w każdej próbie od nowa.
- Dawni użytkownicy w kohorcie. Osoby leczone przed punktem zero to wyselekcjonowani „przeżywający” – wyklucz je w kryteriach kwalifikacji.
- Protokół napisany po analizie. Tabela protokołu chroni przed dopasowywaniem projektu do wyniku tylko wtedy, gdy powstaje przed nim.
Najczęstsze pytania
Co to jest okres na rozpoczęcie leczenia (grace period) w emulacji badania docelowego?
To czas od punktu zero, w którym strategia pozwala rozpocząć leczenie, np. „w ciągu 12 tygodni od wypisu”. Odpowiada praktyce, w której leczenie rzadko zaczyna się tego samego dnia. W protokole określ jego długość i to, co dzieje się z osobami, które nie zaczęły do jego końca. Od tej definicji zależy moment cenzurowania klonów i konstrukcja wag.
Dlaczego po klonowaniu nie koryguje się zakłócenia w punkcie zero?
Bo oba ramiona zawierają w punkcie zero dokładnie te same osoby, więc nie różnią się żadną cechą wyjściową. Zakłócenie wraca jednak przez cenzurowanie: klon odpada, gdy jego zachowanie odbiega od strategii, a to zależy od cech pacjenta. Dlatego zmienne zakłócające trafiają do modelu wag za cenzurowanie, a nie do modelu wyniku.
Czy klonowanie nie podwaja liczebności próby i nie zaniża błędów standardowych?
Podwaja liczbę wierszy, ale nie liczbę niezależnych informacji, więc zwykłe błędy standardowe byłyby za małe. Przedział ufności licz bootstrapem, w którym losujesz osoby (z oboma klonami) i za każdym razem od nowa szacujesz wagi. W przykładzie 200 powtórzeń dało 95% CI [−10.3, −4.8] dla różnicy ryzyk.
Co zrobić, gdy wagi za cenzurowanie są bardzo duże?
Sprawdź, w którym ramieniu i tygodniu powstają. Często wynika to z rzadkiego zachowania, np. startu leczenia dopiero na końcu okresu na rozpoczęcie (w przykładzie maksimum 34.8). Rozważ dłuższy lub krótszy okres na rozpoczęcie, prostszy model wag albo przycinanie wag i pokaż wynik jako analizę wrażliwości. Opisz rozkład wag w artykule.
Czy w emulacji badania docelowego podawać HR, czy różnicę ryzyk?
Główną miarą powinny być ryzyka w obu ramionach w ustalonym czasie oraz ich różnica i iloraz, bo odpowiadają kontrastowi z protokołu. Ważony HR możesz dodać, ale nie jako jedyną miarę: uśrednia efekt zmieniający się w czasie i ma wbudowane obciążenie selekcją (Hernán, 2010).
Powiązane hasła
Przeczytaj też
Propensity score: dopasowanie i ważenie
Badanie obserwacyjne krok po kroku w R: ATE czy ATT, dopasowanie 1:1 z kaliprem, wagi IPTW, równowaga SMD, bootstrap, E-value i opis do artykułu.
Czytaj →PoradnikGrafy przyczynowe (DAG)
Zakłócacz, mediator i zderzacz, kryterium tylnych drzwi i zbiór dostosowujący – z symulacją w R, która pokazuje koszt złej kontroli.
Czytaj →PoradnikKaplan–Meier i model Coxa krok po kroku
Krzywe Kaplana–Meiera, log-rank, RMST, model Coxa, proporcjonalność hazardów i ryzyka konkurujące w R – z tabelą APA i opisem do artykułu.
Czytaj →Recenzent pyta o czas nieśmiertelny albo o wagi w emulacji badania docelowego?
Pomożemy rozpisać protokół, ustawić punkt zero i sprawdzić klonowanie, wagi oraz bootstrap tak, żebyś mógł(a) samodzielnie opisać i obronić analizę.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Cashin, A. G., Hansford, H. J., Hernán, M. A., Swanson, S. A., Lee, H., Jones, M. D., Dahabreh, I. J., Dickerman, B. A., Egger, M., Garcia-Albeniz, X., Golub, R. M., Islam, N., Lodi, S., Moreno-Betancur, M., Pearson, S.-A., Schneeweiss, S., Sharp, M. K., Sterne, J. A. C., Stuart, E. A., & McAuley, J. H. (2025). Transparent reporting of observational studies emulating a target trial: The TARGET Statement. BMJ, 390, Article e087179. https://doi.org/10.1136/bmj-2025-087179 ● Otwarty dostęp
- Cole, S. R., & Hernán, M. A. (2008). Constructing inverse probability weights for marginal structural models. American Journal of Epidemiology, 168(6), 656–664. https://doi.org/10.1093/aje/kwn164 ● Otwarty dostęp
- Hernán, M. A. (2010). The hazards of hazard ratios. Epidemiology, 21(1), 13–15. https://doi.org/10.1097/ede.0b013e3181c1ea43 ● Otwarty dostęp: pełny tekst
- Hernán, M. A. (2018). How to estimate the effect of treatment duration on survival outcomes using observational data. BMJ, 360, Article k182. https://doi.org/10.1136/bmj.k182 ● Otwarty dostęp: pełny tekst
- Hernán, M. A., & Robins, J. M. (2016). Using big data to emulate a target trial when a randomized trial is not available. American Journal of Epidemiology, 183(8), 758–764. https://doi.org/10.1093/aje/kwv254 ● Otwarty dostęp
- Hernán, M. A., & Robins, J. M. (2017). Per-protocol analyses of pragmatic trials. New England Journal of Medicine, 377(14), 1391–1398. https://doi.org/10.1056/nejmsm1605385
- Hernán, M. A., & Robins, J. M. (2020). Causal inference: What if. Chapman & Hall/CRC. https://miguelhernan.org/whatifbook ● Otwarty dostęp
- Hernán, M. A., Sauer, B. C., Hernández-Díaz, S., Platt, R., & Shrier, I. (2016). Specifying a target trial prevents immortal time bias and other self-inflicted injuries in observational analyses. Journal of Clinical Epidemiology, 79, 70–75. https://doi.org/10.1016/j.jclinepi.2016.04.014 ● Otwarty dostęp: pełny tekst
- Maringe, C., Benitez Majano, S., Exarchakou, A., Smith, M., Rachet, B., Belot, A., & Leyrat, C. (2020). Reflection on modern methods: Trial emulation in the presence of immortal-time bias. Assessing the benefit of major surgery for elderly lung cancer patients using observational data. International Journal of Epidemiology, 49(5), 1719–1729. https://doi.org/10.1093/ije/dyaa057 ● Otwarty dostęp
- Sterne, J. A. C., Hernán, M. A., Reeves, B. C., Savović, J., Berkman, N. D., Viswanathan, M., Henry, D., Altman, D. G., Ansari, M. T., Boutron, I., Carpenter, J. R., Chan, A.-W., Churchill, R., Deeks, J. J., Hróbjartsson, A., Kirkham, J., Jüni, P., Loke, Y. K., Pigott, T. D., . . . Higgins, J. P. T. (2016). ROBINS-I: A tool for assessing risk of bias in non-randomised studies of interventions. BMJ, 355, Article i4919. https://doi.org/10.1136/bmj.i4919 ● Otwarty dostęp
Cytowania BibTeX
@article{cashin2025transparent, author={Cashin, Aidan G. and Hansford, Harrison J. and Hernán, Miguel A. and Swanson, Sonja A. and Lee, Hopin and Jones, Matthew D. and Dahabreh, Issa J. and Dickerman, Barbra A. and Egger, Matthias and Garcia-Albeniz, Xabier and Golub, Robert M. and Islam, Nazrul and Lodi, Sara and Moreno-Betancur, Margarita and Pearson, Sallie-Anne and Schneeweiss, Sebastian and Sharp, Melissa K. and Sterne, Jonathan A. C. and Stuart, Elizabeth A. and McAuley, James H.}, title={{Transparent reporting of observational studies emulating a target trial: The TARGET Statement}}, journal={BMJ}, year={2025}, volume={390}, eid={e087179}, doi={10.1136/bmj-2025-087179}}@article{cole2008constructing, author={Cole, Stephen R. and Hernán, Miguel A.}, title={{Constructing inverse probability weights for marginal structural models}}, journal={American Journal of Epidemiology}, year={2008}, volume={168}, number={6}, pages={656--664}, doi={10.1093/aje/kwn164}}@article{hernan2010hazards, author={Hernán, Miguel A.}, title={{The hazards of hazard ratios}}, journal={Epidemiology}, year={2010}, volume={21}, number={1}, pages={13--15}, doi={10.1097/ede.0b013e3181c1ea43}}@article{hernan2018how, author={Hernán, Miguel A.}, title={{How to estimate the effect of treatment duration on survival outcomes using observational data}}, journal={BMJ}, year={2018}, volume={360}, eid={k182}, doi={10.1136/bmj.k182}}@article{hernan2016using, author={Hernán, Miguel A. and Robins, James M.}, title={{Using big data to emulate a target trial when a randomized trial is not available}}, journal={American Journal of Epidemiology}, year={2016}, volume={183}, number={8}, pages={758--764}, doi={10.1093/aje/kwv254}}@article{hernan2017per, author={Hernán, Miguel A. and Robins, James M.}, title={{Per-protocol analyses of pragmatic trials}}, journal={New England Journal of Medicine}, year={2017}, volume={377}, number={14}, pages={1391--1398}, doi={10.1056/nejmsm1605385}}@book{hernan2020causal, author={Hernán, Miguel A. and Robins, James M.}, title={{Causal inference: What if}}, year={2020}, publisher={Chapman \& Hall/CRC}, url={https://miguelhernan.org/whatifbook}}@article{hernan2016specifying, author={Hernán, Miguel A. and Sauer, Brian C. and Hernández-Díaz, Sonia and Platt, Robert and Shrier, Ian}, title={{Specifying a target trial prevents immortal time bias and other self-inflicted injuries in observational analyses}}, journal={Journal of Clinical Epidemiology}, year={2016}, volume={79}, pages={70--75}, doi={10.1016/j.jclinepi.2016.04.014}}@article{maringe2020reflection, author={Maringe, Camille and Benitez Majano, Sara and Exarchakou, Aimilia and Smith, Matthew and Rachet, Bernard and Belot, Aurélien and Leyrat, Clémence}, title={{Reflection on modern methods: Trial emulation in the presence of immortal-time bias. Assessing the benefit of major surgery for elderly lung cancer patients using observational data}}, journal={International Journal of Epidemiology}, year={2020}, volume={49}, number={5}, pages={1719--1729}, doi={10.1093/ije/dyaa057}}@article{sterne2016robinsi, author={Sterne, Jonathan A. C. and Hernán, Miguel A and Reeves, Barnaby C and Savović, Jelena and Berkman, Nancy D and Viswanathan, Meera and Henry, David and Altman, Douglas G and Ansari, Mohammed T and Boutron, Isabelle and Carpenter, James R and Chan, An-Wen and Churchill, Rachel and Deeks, Jonathan J and Hróbjartsson, Asbjørn and Kirkham, Jamie and Jüni, Peter and Loke, Yoon K and Pigott, Theresa D and Ramsay, Craig R and Regidor, Deborah and Rothstein, Hannah R and Sandhu, Lakhbir and Santaguida, Pasqualina L and Schünemann, Holger J and Shea, Beverly and Shrier, Ian and Tugwell, Peter and Turner, Lucy and Valentine, Jeffrey C and Waddington, Hugh and Waters, Elizabeth and Wells, George A and Whiting, Penny F and Higgins, Julian PT}, title={{ROBINS-I: A tool for assessing risk of bias in non-randomised studies of interventions}}, journal={BMJ}, year={2016}, volume={355}, eid={i4919}, doi={10.1136/bmj.i4919}}