Co to jest zakłócenie przez wskazanie?
Zakłócenie przez wskazanie (ang. confounding by indication) to szczególny przypadek zmiennej zakłócającej w badaniach obserwacyjnych leczenia: powód, dla którego lekarz zleca terapię (choroba, jej ciężkość, rokowanie), sam wpływa na wynik. Leczeni są więc z góry inni niż nieleczeni. Salas, Hofman i Stricker (1999) proponują zarezerwować ten termin dla sytuacji, gdy zakłóca sama choroba będąca wskazaniem, a wpływ jej ciężkości nazywać zakłóceniem przez ciężkość (confounding by severity). Odróżniają oba pojęcia od błędu protopatycznego i od błędu selekcji.
Przykład w R
W symulacji 10 000 pacjentów ciężej chorzy częściej dostają lek i częściej umierają, a lek naprawdę zmniejsza ryzyko (OR = 0.70). Surowa regresja logistyczna daje OR = 2.20 – lek wygląda na szkodliwy. Po uwzględnieniu ciężkości choroby OR = 0.70 (95% CI 0.61–0.81). Gdy jednak ciężkość mierzymy z dużym błędem, skorygowany OR wynosi 1.43: część zakłócenia zostaje.
Ten sam problem opisali Bosco i in. (2010) na prawdziwych danych. Surowo chemioterapia wiązała się z wyższym ryzykiem nawrotu raka piersi (HR = 2.6), bo dostawały ją kobiety o gorszym rokowaniu. Ani restrykcja, ani regresja, ani propensity score, ani metoda zmiennej instrumentalnej nie usunęły zakłócenia w pełni.
Na rysunku
Rysunek korzysta z danych przykładu: 10 000 pacjentów, prawdziwy OR leku = 0.70, set.seed(534).
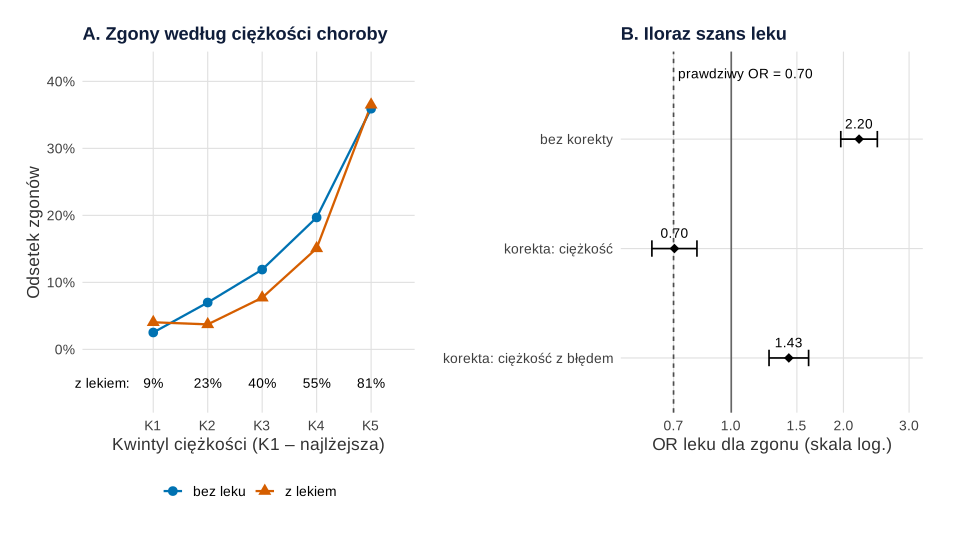
set.seed(534)).Co widać. Panel A pokazuje źródło problemu. Z ciężkością rosną naraz śmiertelność i odsetek leczonych: od 9% w najlżejszym kwintylu do 81% w najcięższym. Leczeni to więc głównie ciężko chorzy. W kwintylach 2–4 linia leczonych leży niżej (np. w K4: 15.1% wobec 19.7% zgonów), czyli lek pomaga. W surowym porównaniu wygrywa jednak skład grup i OR = 2.20. Po uwzględnieniu ciężkości OR = 0.70, tyle co prawdziwy. Gdy ciężkość zmierzono z błędem, OR = 1.43 – lek nadal wygląda na szkodliwy.
Na co uważać. Kwintyle to zgrubny podział. W K1 i K5 linie się stykają, a w K1 leczeni mają nawet więcej zgonów (4.0% wobec 2.5%). W każdym kwintylu leczeni są średnio nieco ciężej chorzy niż nieleczeni (w K5: 1.44 wobec 1.20 SD ciężkości), a w K1 leczonych jest niewielu. Warstwy z grubym podziałem nie usuwają więc całego zakłócenia, podobnie jak pomiar z błędem. Wykres nie pokaże też czynników, których nie zmierzono. Ten sam mechanizm w tabeli 2 × 2 × 2 pokazuje wpis paradoks Simpsona – wizualizacja.
Podpis do pracy:
Kod rysunku jest samowystarczalny. Rysunek na stronie powstał z tego samego kodu, w którym podmieniono tylko motyw (krój czcionki, siatka).
Kod R rysunku 1
# Rysunek 1. Zgony w kwintylach ciężkości choroby (A) i ilorazy szans leku z różną korektą (B)
library(ggplot2)
library(patchwork)

kol <- c("bez leku" = "#0072B2", "z lekiem" = "#D55E00")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold", size = rel(0.95)))

set.seed(534)                                         # ziarno i dane z przykładu w haśle
n <- 10000
ciezkosc <- rnorm(n)
lek <- rbinom(n, 1, plogis(-0.5 + 1.5 * ciezkosc))    # lek częściej przy cięższej chorobie
zgon <- rbinom(n, 1, plogis(-2 + 1.2 * ciezkosc + log(0.7) * lek))  # prawdziwe OR leku = 0.70
ciezkosc_bl <- ciezkosc + rnorm(n, sd = 1)            # ciężkość zmierzona z błędem

# A: odsetek zgonów w kwintylach ciężkości, osobno dla leczonych i nieleczonych
kw <- cut(ciezkosc, quantile(ciezkosc, 0:5 / 5), include.lowest = TRUE, labels = paste0("K", 1:5))
tA <- aggregate(zgon ~ kw + lek, FUN = mean, data = data.frame(zgon, kw, lek))
tA$grupa <- factor(ifelse(tA$lek == 1, "z lekiem", "bez leku"), names(kol))
udzial <- tapply(lek, kw, mean)                       # odsetek leczonych w kwintylu
round(rbind(zgony_bez_leku = tA$zgon[tA$lek == 0], zgony_z_lekiem = tA$zgon[tA$lek == 1],
            udzial_leczonych = udzial), 3)
round(tapply(ciezkosc, list(kw, lek = lek), mean), 2)  # średnia ciężkość w kwintylu: bez leku (0) i z lekiem (1)
pA <- ggplot(tA, aes(kw, zgon, colour = grupa, shape = grupa, group = grupa)) +
  geom_line(linewidth = 0.8) + geom_point(size = 3) +
  annotate("text", x = 1:5, y = -0.05, label = paste0(round(100 * udzial), "%"), size = 3.6) +
  annotate("text", x = 0.55, y = -0.05, label = "z lekiem:", hjust = 1, size = 3.6) +
  scale_colour_manual(NULL, values = kol) + scale_shape_manual(NULL, values = c(16, 17)) +
  scale_y_continuous("Odsetek zgonów", labels = function(x) paste0(100 * x, "%"),
                     breaks = seq(0, 0.4, 0.1)) +
  coord_cartesian(ylim = c(-0.07, 0.42), xlim = c(0.3, 5.2), clip = "off") +
  labs(title = "A. Zgony według ciężkości choroby", x = "Kwintyl ciężkości (K1 – najlżejsza)") + motyw

# B: OR leku z 95% CI (Walda) bez korekty, z korektą i z korektą o ciężkość zmierzoną z błędem
or_lek <- function(m) exp(c(coef(m)["lek"], confint.default(m)["lek", ]))
tB <- data.frame(model = c("bez korekty", "korekta: ciężkość", "korekta: ciężkość z błędem"),
                 rbind(or_lek(glm(zgon ~ lek, family = binomial)),
                       or_lek(glm(zgon ~ lek + ciezkosc, family = binomial)),
                       or_lek(glm(zgon ~ lek + ciezkosc_bl, family = binomial))))
names(tB)[2:4] <- c("OR", "dolna", "gorna")
tB$model <- factor(tB$model, rev(tB$model))
print(tB, digits = 3, row.names = FALSE)
pB <- ggplot(tB, aes(OR, model)) +
  geom_vline(xintercept = 1, colour = "grey40") +
  geom_vline(xintercept = 0.7, linetype = "22", colour = "grey30") +
  annotate("text", x = 0.72, y = 3.6, label = "prawdziwy OR = 0.70", hjust = 0, size = 3.6) +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.15, orientation = "y") +
  geom_point(size = 3, shape = 18) +
  geom_text(aes(label = sprintf("%.2f", OR)), vjust = -1.1, size = 3.6) +
  scale_x_log10("OR leku dla zgonu (skala log.)", breaks = c(0.5, 0.7, 1, 1.5, 2, 3), limits = c(0.55, 3)) +
  scale_y_discrete(expand = expansion(add = c(0.5, 0.8))) +
  labs(title = "B. Iloraz szans leku", y = NULL) + motyw
p1 <- pA + pB + plot_layout(widths = c(1.1, 1))
p1
Wynik w R
                    K1    K2    K3    K4    K5
zgony_bez_leku   0.025 0.070 0.119 0.197 0.359
zgony_z_lekiem   0.040 0.037 0.077 0.151 0.365
udzial_leczonych 0.086 0.228 0.396 0.550 0.814
    lek
         0     1
  K1 -1.39 -1.15
  K2 -0.51 -0.47
  K3 -0.01  0.02
  K4  0.49  0.53
  K5  1.20  1.44
                      model    OR dolna gorna
                bez korekty 2.202 1.967 2.466
          korekta: ciężkość 0.704 0.612 0.809
 korekta: ciężkość z błędem 1.427 1.263 1.613
Jak ograniczać zakłócenie przez wskazanie
- Najpewniejsza jest randomizacja, bo przydział nie zależy od rokowania.
- W danych obserwacyjnych: porównuj pacjentów z tym samym wskazaniem, a najlepiej dwa leczenia stosowane przy nim. Mierz ciężkość dokładnie i rysuj założenia na grafie przyczynowym (DAG).
- Dopasowanie lub ważenie (propensity score w praktyce) pomaga tylko dla czynników zmierzonych.
- Wrażliwość na niezmierzone zakłócenie oceń E-wartością.
Jak opisać w pracy
Na co uważać
Zakłócenie przez wskazanie może działać w obu kierunkach: leczenie wygląda na szkodliwe, gdy dostają je ciężej chorzy, lub na zbyt korzystne, gdy lekarze wybierają pacjentów o dobrym rokowaniu. Sama korekta statystyczna nie zastąpi dobrego schematu porównania.
Zakłócenie przez wskazanie w R
Kod symuluje badanie obserwacyjne, w którym ciężkość choroby wpływa i na przydział leku, i na zgon, a następnie porównuje iloraz szans surowy, skorygowany o ciężkość i skorygowany o ciężkość zmierzoną z błędem (glm()).
OR surowy a skorygowany
R
# Zakłócenie przez wskazanie: ciężej chorzy częściej dostają lek
set.seed(534)
n <- 10000
ciezkosc <- rnorm(n)                                  # ciężkość choroby (zmierzona)
lek <- rbinom(n, 1, plogis(-0.5 + 1.5 * ciezkosc))    # lek częściej przy cięższej chorobie
zgon <- rbinom(n, 1, plogis(-2 + 1.2 * ciezkosc + log(0.7) * lek))  # prawdziwe OR leku = 0.70
surowy <- glm(zgon ~ lek, family = binomial)
skoryg <- glm(zgon ~ lek + ciezkosc, family = binomial)
round(c(OR_prawdziwe = 0.70,
        OR_surowe = unname(exp(coef(surowy)["lek"])),
        OR_skorygowane = unname(exp(coef(skoryg)["lek"]))), 3)
round(exp(confint.default(skoryg)["lek", ]), 3)
# Gdy ciężkość mierzymy z błędem, część zakłócenia zostaje
ciezkosc_bl <- ciezkosc + rnorm(n, sd = 1)
round(unname(exp(coef(glm(zgon ~ lek + ciezkosc_bl, family = binomial))["lek"])), 3)
Wynik w R
  OR_prawdziwe      OR_surowe OR_skorygowane
         0.700          2.202          0.704
 2.5 % 97.5 %
 0.612  0.809
[1] 1.427
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (przykład – bez dodatkowych pakietów; rysunek 1 – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czy propensity score usuwa zakłócenie przez wskazanie?
Tylko w części, którą da się zmierzyć. Propensity score równoważy grupy pod względem uwzględnionych zmiennych, ale nie pod względem ocen lekarza, których nie ma w danych.
Czym zakłócenie przez wskazanie różni się od zakłócenia przez ciężkość?
W węższym ujęciu zakłóca sama choroba będąca powodem leczenia, a przy zakłóceniu przez ciężkość – stopień jej zaawansowania wśród chorych. W praktyce oba zjawiska często występują razem.
Jak zmniejszyć zakłócenie przez wskazanie bez randomizacji?
Porównuj pacjentów z tym samym wskazaniem, najlepiej dwa aktywne leczenia stosowane w tej samej sytuacji. Dokładnie mierz ciężkość przed leczeniem i oceń wrażliwość wyniku na niezmierzone zakłócenie.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Propensity score: dopasowanie i ważenie
Badanie obserwacyjne krok po kroku w R: ATE czy ATT, dopasowanie 1:1 z kaliprem, wagi IPTW, równowaga SMD, bootstrap, E-value i opis do artykułu.
Czytaj →PoradnikGrafy przyczynowe (DAG)
Zakłócacz, mediator i zderzacz, kryterium tylnych drzwi i zbiór dostosowujący – z symulacją w R, która pokazuje koszt złej kontroli.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bosco, J. L. F., Silliman, R. A., Thwin, S. S., Geiger, A. M., Buist, D. S. M., Prout, M. N., Yood, M. U., Haque, R., Wei, F., & Lash, T. L. (2010). A most stubborn bias: No adjustment method fully resolves confounding by indication in observational studies. Journal of Clinical Epidemiology, 63(1), 64–74. https://doi.org/10.1016/j.jclinepi.2009.03.001 ● Otwarty dostęp: pełny tekst
- Salas, M., Hofman, A., & Stricker, B. H. (1999). Confounding by indication: An example of variation in the use of epidemiologic terminology. American Journal of Epidemiology, 149(11), 981–983. https://doi.org/10.1093/oxfordjournals.aje.a009758
Cytowania BibTeX
@article{bosco2010most, author={Bosco, Jaclyn L. F. and Silliman, Rebecca A. and Thwin, Soe Soe and Geiger, Ann M. and Buist, Diana S. M. and Prout, Marianne N. and Yood, Marianne Ulcickas and Haque, Reina and Wei, Feifei and Lash, Timothy L.}, title={{A most stubborn bias: No adjustment method fully resolves confounding by indication in observational studies}}, journal={Journal of Clinical Epidemiology}, year={2010}, volume={63}, number={1}, pages={64--74}, doi={10.1016/j.jclinepi.2009.03.001}}@article{salas1999confounding, author={Salas, M. and Hofman, A. and Stricker, B. H.}, title={{Confounding by indication: An example of variation in the use of epidemiologic terminology}}, journal={American Journal of Epidemiology}, year={1999}, volume={149}, number={11}, pages={981--983}, doi={10.1093/oxfordjournals.aje.a009758}}