Co pokazują rysunki
Definicję, wzór na średnią ważoną i przykład z tabelą znajdziesz w haśle paradoks Simpsona. Tu nie powtarzamy tamtego przykładu. Pokazujemy na rysunkach trzy rzeczy, które w tabeli wyników łatwo przeoczyć: jak paradoks wygląda w chmurze punktów, skąd bierze się odwrócenie odsetków i dlaczego to wiedza o przyczynach, a nie statystyka, rozstrzyga, której liczbie wierzyć.
Wszystkie dane są fikcyjne. Używamy trzech przykładów:
- Kurs języka (180 osób, po 60 na poziomie startowym A1, A2 i B1): godziny ćwiczeń w aplikacji tygodniowo i wynik testu końcowego.
- Terapia (180 pacjentów, po 60 z objawami łagodnymi, umiarkowanymi i ciężkimi na początku): liczba sesji i nasilenie objawów po terapii.
- Badanie obserwacyjne dwóch terapii (820 pacjentów): nowa albo standardowa terapia, choroba łagodna albo ciężka, poprawa tak/nie.
Średnie, rozrzuty, liczebności i nachylenia w grupach ustawiono ręcznie tak, by odwrócenie kierunku było wyraźne (parametry są wypisane w kodzie). Ziarno 591 ustalono raz i nie dobierano go pod wynik. Dane z rysunku 1 pobierzesz jako paradoks-simpsona-dane-symulowane.csv. Przy każdym rysunku: co widać, czego wykres nie pokazuje, podpis i zdanie do pracy.
Rysunek 1: w grupach w górę, razem w dół
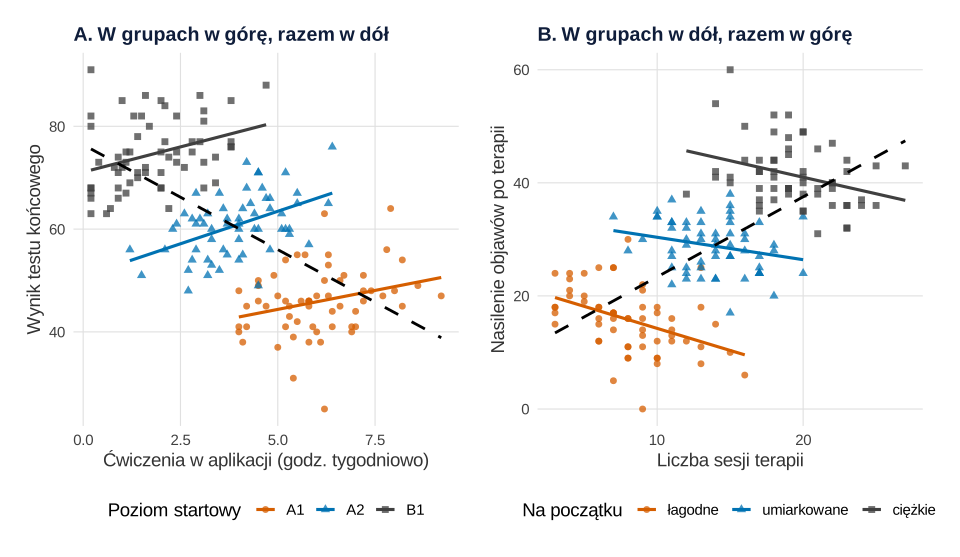
set.seed(591)).Co widać. Panel A: w każdym poziomie startowym więcej ćwiczeń idzie w parze z lepszym wynikiem. Korelacje w grupach wynoszą .28 (A1), .47 (A2) i .33 (B1), a nachylenia od 1.48 do 2.53 punktu na godzinę. W całej próbie korelacja jest silnie ujemna: r = −.64, p < .001, nachylenie −4.08. Osoby z poziomu A1 ćwiczą najwięcej, bo mają najwięcej do nadrobienia, i mają najniższe wyniki. Przerywana prosta łączy więc trzy chmury, a nie opisuje żadnej z nich. Panel B pokazuje odwrotny kierunek: w każdej grupie więcej sesji to mniej objawów (r od −.24 do −.42), a razem r = .66. Na więcej sesji kierowano osoby, które zaczynały z cięższymi objawami.
Czego ten wykres nie pokazuje. Grupy widać tylko dlatego, że mają kolor i kształt. Ta sama chmura w jednym kolorze wyglądałaby jak zwykła korelacja ujemna. Grupy, której nie zmierzyłeś, żaden wykres nie ujawni. Kievit i in. (2013) pokazują, że paradoks zdarza się w psychologii częściej, niż się sądzi, zwłaszcza gdy wniosek o całej populacji przenosi się na podgrupy albo na pojedyncze osoby. Ten sam problem ma wersję „grupy – osoby” opisaną w haśle błąd ekologiczny i wersję „pomiary – osoba” we wpisie efekty wewnątrz- i międzyosobowe. Wykres nie mówi też, który z dwóch obrazów jest „prawdziwy”. To rozstrzyga rysunek 5.
Podpis do pracy:
Zdanie do Wyników:
Ten sam mechanizm z dwiema wersjami testu pokazuje pułapka 2 we wpisie zawsze narysuj dane. Tu dodajemy kierunek odwrotny i wersję regresyjną.
Rysunek 2: zmienna grupująca zmienia znak współczynnika
W regresji paradoks Simpsona to po prostu zmiana znaku współczynnika po dodaniu zmiennej grupującej. Porównujemy dwa modele dla kursu języka: wynik ~ godziny i wynik ~ godziny + poziom. Potem powtarzamy to samo badanie 1000 razy na nowych 180 osobach z tej samej populacji, w której prawdziwe nachylenie w grupach wynosi 2 punkty na godzinę.
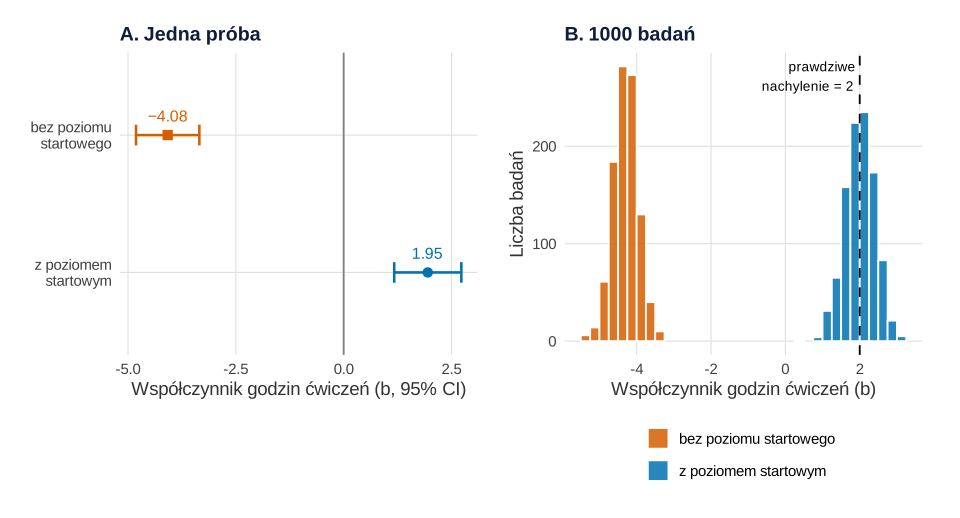
Co widać. W jednej próbie współczynnik godzin wynosi −4.08, 95% CI [−4.81, −3.35] bez poziomu startowego i 1.95, 95% CI [1.17, 2.73] z nim. Oba przedziały są wąskie i nie obejmują zera, choć wskazują przeciwne kierunki. R² rośnie z .403 do .796. Panel B pokazuje, że to nie pech jednej próby. We wszystkich 1000 badaniach model bez poziomu dał istotny współczynnik ujemny (mediana −4.29, 95% wyników między −4.97 a −3.60). Model z poziomem dał istotny współczynnik dodatni w 99.8% badań (błąd Monte Carlo 0.1 pp), z medianą 2.02 – blisko prawdziwych 2. Większa próba niczego by nie naprawiła: przedziały byłyby węższe, ale wokół złej wartości.
Czego ten wykres nie pokazuje. Model z poziomem zakłada jedno nachylenie we wszystkich grupach. Sprawdziliśmy to modelem z interakcją godzin i poziomu: F(2, 174) = 0.59, p = .554, więc brak podstaw do różnych nachyleń. Wykres nie mówi też, czy poziom startowy to zmienna zakłócająca. Statystycznie zmiana współczynnika po dodaniu trzeciej zmiennej wygląda tak samo przy zakłócaniu, mediacji i supresji (MacKinnon i in., 2000). Różnica jest pojęciowa i wynika z wiedzy o badaniu. Jak „kontrolowanie” wygląda na wykresie zmiennej dodanej, pokazuje wpis regresja wieloraka w obrazkach, a odmianę, w której współczynnik po kontroli rośnie – hasło supresja.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: wersja dla odsetków
Teraz badanie obserwacyjne: 820 pacjentów, nowa albo standardowa terapia, poprawa po leczeniu tak albo nie. Lekarze częściej dawali nową terapię ciężej chorym: ciężki przebieg miało 71.4% leczonych nową terapią i 25.0% leczonych standardową. Epidemiolodzy nazywają to zakłóceniem przez wskazanie, a gdy chodzi o stopień choroby – zakłóceniem przez ciężkość (Salas i in., 1999).
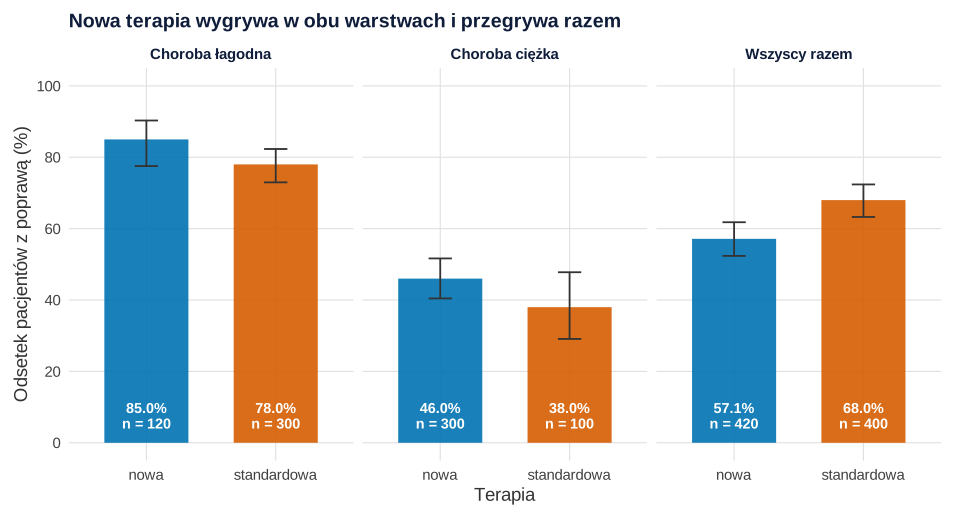
Co widać. Przy chorobie łagodnej nowa terapia daje poprawę u 85.0% pacjentów, standardowa u 78.0% (różnica 7.0 pp). Przy ciężkiej: 46.0% wobec 38.0% (8.0 pp). Razem: 57.1% wobec 68.0%, czyli nowa terapia „przegrywa” o 10.9 pp. Ten sam obraz dają ilorazy szans: w warstwach OR = 1.60 i 1.39, łącznie 0.63. Wspólny iloraz szans Mantela–Haenszela wynosi 1.47, 95% CI [1.03, 2.11], p = .035. W 1000 symulowanych badaniach z takim samym sposobem przydziału surowa różnica była ujemna we wszystkich 1000 (mediana −10.7 pp). Różnica liczona w warstwach i uśredniona według składu próby była ujemna tylko w 1.8% (mediana 7.4 pp).
Czego ten wykres nie pokazuje. Słupek „razem” ukrywa skład grup. Nie widać, że pod niebieskim słupkiem kryje się 300 ciężko chorych, a pod pomarańczowym tylko 100. Dlatego liczebności są wpisane w słupki. Słupki skumulowane do 100% i mozaika pokazałyby skład lepiej, ale gorzej porównują odsetki – te typy wykresów omawia wpis tabela krzyżowa na wykresie. Przy ilorazie szans jest jeszcze jedna pułapka. Wynik łączny może różnić się od warstwowego nawet bez zakłócenia, bo OR nie jest „składalny” (ang. non-collapsibility). Greenland i in. (1999) podkreślają, że tych dwóch zjawisk nie wolno mylić. Różnica odsetków takiej własności nie ma, dlatego tu na niej się opieramy.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: odsetek łączny jako punkt na odcinku
Odsetek łączny każdej terapii to średnia ważona odsetków z warstw. Można to narysować: na osi poziomej udział łagodnie chorych w grupie, na pionowej odsetek poprawy. Każda terapia ma swój odcinek – od wyniku u samych ciężko chorych (lewa krawędź) do wyniku u samych łagodnie chorych (prawa krawędź). Odsetek łączny leży na tym odcinku w miejscu składu grupy.
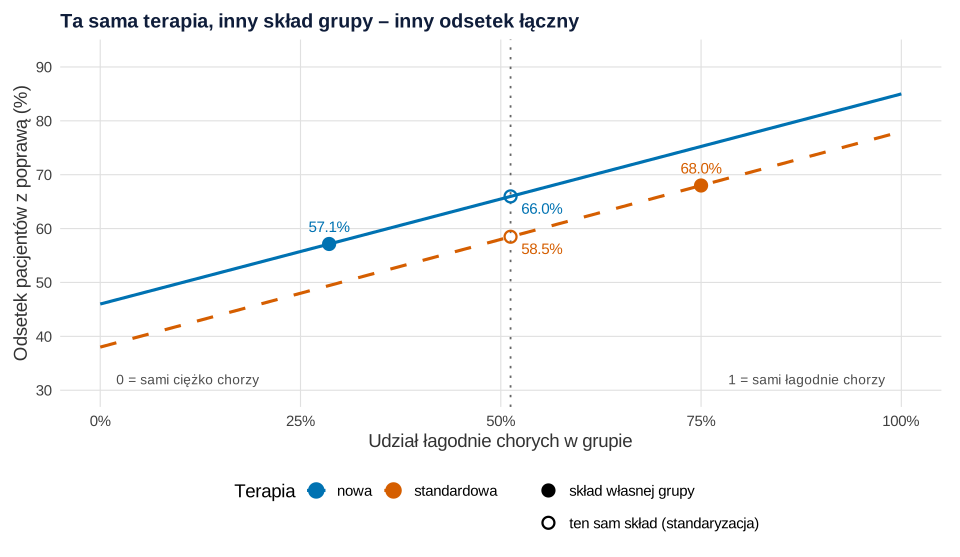
Co widać. Prosta nowej terapii leży w całości nad prostą standardowej: przy każdym składzie grupy nowa terapia wypada lepiej. Grupa nowej terapii ma jednak tylko 28.6% łagodnie chorych, więc jej punkt leży nisko na lewo (57.1%). Grupa standardowej ma 75.0% łagodnie chorych i jej punkt leży wysoko na prawo (68.0%). Paradoks to porównanie dwóch punktów z różnych miejsc osi poziomej. Gdy obie terapie „dostaną” ten sam skład – całej próby, 51.2% łagodnie chorych – wychodzi 66.0% wobec 58.5%. Nowa terapia jest lepsza o 7.5 pp. To standaryzacja bezpośrednia, znana z porównań wskaźników przy różnej strukturze wieku.
Czego ten wykres nie pokazuje. Proste są tak proste tylko przy jednej zmiennej warstwującej o dwóch poziomach. Przy kilku zmiennych lub zmiennej ciągłej potrzebny jest model, nie rysunek. Wykres zakłada też, że w warstwach nie ma innych różnic między grupami terapii. Jeśli w warstwie „ciężka” nową terapię dostawali jeszcze ciężej chorzy, pozostaje zakłócenie resztkowe. Wiele zmiennych zakłócających naraz porządkuje wpis grafy przyczynowe (DAG). Rysunek nie rozstrzyga wreszcie, czy w ogóle wolno ważyć według ciężkości. To zależy od tego, kiedy ciężkość została zmierzona (rysunek 5).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: kiedy warstwy, a kiedy tabela łączna
Nazwa zjawiska pochodzi od pracy Simpsona (1951). Pokazał on na przykładzie tabeli 2 × 2 × 2, że brak interakcji drugiego rzędu nie uzasadnia mechanicznego tworzenia z niej tabel składowych 2 × 2 i testowania każdej z nich standardowymi metodami. Hernán i in. (2011) zapisali strukturę przyczynową jego przykładu i pokazali, że paradoks znika, gdy analizą kieruje wiedza merytoryczna. Te same liczby z rysunku 3 mogą opisywać dwa różne badania.
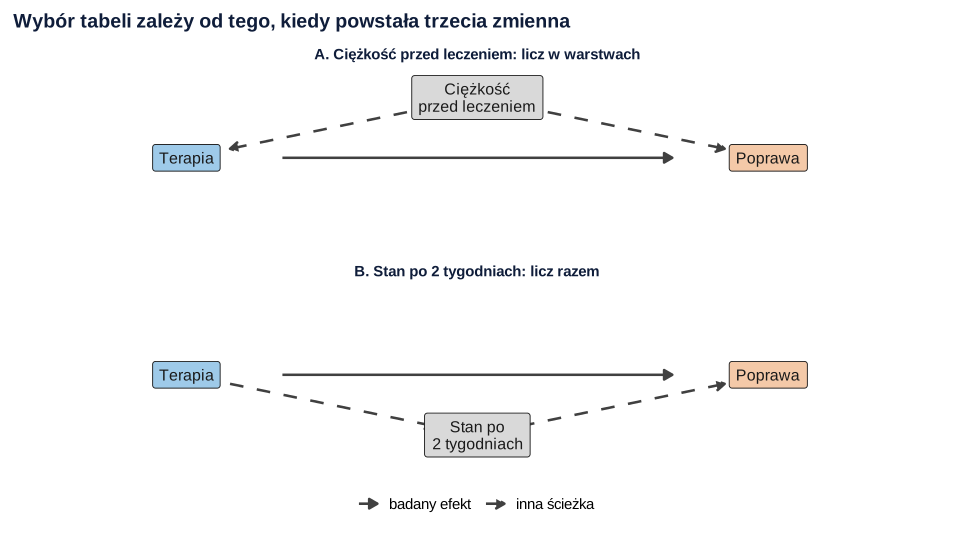
Co widać. Panel A: ciężkość oceniono przed leczeniem i to ona skłaniała lekarzy do nowej terapii. Jest wspólną przyczyną terapii i poprawy, czyli zmienną zakłócającą. Ścieżkę przez nią trzeba zamknąć, więc wierzymy warstwom. Panel B: podział na „łagodny” i „ciężki” to stan po dwóch tygodniach leczenia, a terapię przydzielono losowo. Wtedy stan po dwóch tygodniach jest częścią drogi od terapii do poprawy, czyli mediatorem. Warstwowanie odcięłoby część efektu, a pytanie „czy terapia pomaga” odpowiada tabela łączna. Kievit i in. (2013) przypominają, że same dane nie powiedzą, który przypadek mamy.
Czego ten wykres nie pokazuje. To dwa najprostsze grafy. Trzecia zmienna może też być wspólnym skutkiem terapii i poprawy – wtedy warstwowanie tworzy związek z niczego. Ten przypadek opisuje hasło zmienna zderzeniowa (collider), a wszystkie trzy struktury w symulacjach pokazuje wpis zmienna zakłócająca i collider – wizualizacja na obrazkach. Graf nie pokazuje też siły związków ani zmiennych niezmierzonych.
Podpis do pracy:
Zdanie do Metody:
Co zrobić w praktyce
- Narysuj chmurę z kolorami grup, zanim policzysz korelację w całej próbie. Kandydatów na zmienną grupującą wybierz z wiedzy o badaniu: płeć, kierunek, poziom wyjściowy, ośrodek.
- Policz związek razem i w grupach i porównaj znaki. Przy kilku grupach dodaj zmienną grupującą do regresji (rysunek 2); przy wielu grupach o różnej liczebności rozważ model wielopoziomowy – zob. model mieszany w obrazkach.
- Przy odsetkach pokaż skład grup (liczebności w warstwach) obok odsetków (rysunki 3 i 4).
- Zdecyduj na podstawie czasu i przyczyn, czy trzecia zmienna jest zakłócająca, pośrednicząca czy zderzeniowa (rysunek 5). Uzasadnienie wpisz do Metody. Różnicę między zakłócaniem a modyfikacją efektu wyjaśnia hasło czynnik zakłócający a modyfikator efektu.
- Raportuj oba wyniki: łączny i w grupach, z liczebnościami. Odwrócenie nie dowodzi przyczynowości w żadną stronę – zob. korelacja a przyczynowość.
Zdanie do pracy dyplomowej (dyskusja ograniczeń, gdy grupy nie były zmierzone):
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę i motyw, z których korzystają następne, a przepis 4 korzysta z obiektów przepisu 3. Każdy przepis kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Każdy blok, który losuje (przepisy 1, 2 i 3), ma własne set.seed(591); ziarno ustalono z góry i nie dobierano go pod wynik. Ręcznie wybrano: średnie godzin (6, 4, 2) i wyników (45, 60, 75) w poziomach kursu, nachylenie 2 i SD reszt 6; średnie sesji (8, 14, 20) i objawów (15, 28, 41), nachylenie −0.6 i SD 5 w przykładzie terapii; liczebności tabeli 2 × 2 × 2 oraz odsetki poprawy i prawdopodobieństwa przydziału w symulacji odsetków; liczbę powtórzeń (1000 w przepisach 2 i 3). Cały kod liczy się w kilka sekund.
1. Dwie chmury punktów: Rysunek 1
R
# Rysunek 1. Paradoks Simpsona na wykresie rozrzutu: dwie fikcyjne chmury punktów
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (cynober, niebieski, grafit) + różne kształty punktów i prosty motyw
kol <- c("#D55E00", "#0072B2", "grey25")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.05)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# A: kurs języka – godziny ćwiczeń w aplikacji tygodniowo a wynik testu końcowego (0–100),
#    trzy poziomy startowe po 60 osób; w każdym poziomie +2 punkty za godzinę (parametry ustalone ręcznie)
set.seed(591)
n <- 60
poziomy <- c("A1", "A2", "B1")
kurs <- data.frame(poziom = factor(rep(poziomy, each = n), levels = poziomy))
sr_godz <- c(A1 = 6, A2 = 4, B1 = 2); sr_wyn <- c(A1 = 45, A2 = 60, B1 = 75)
kurs$godziny <- round(pmax(0.2, sr_godz[kurs$poziom] + rnorm(3 * n, 0, 1.2)), 1)
kurs$wynik <- round(sr_wyn[kurs$poziom] + 2 * (kurs$godziny - sr_godz[kurs$poziom]) + rnorm(3 * n, 0, 6))

# B: terapia – liczba sesji a nasilenie objawów po terapii (0–60), trzy poziomy wyjściowego nasilenia
#    po 60 osób; w każdym poziomie −0.6 punktu za sesję (parametry ustalone ręcznie)
set.seed(591)
stopnie <- c("łagodne", "umiarkowane", "ciężkie")
terapia <- data.frame(nasilenie = factor(rep(stopnie, each = n), levels = stopnie))
sr_ses <- c(8, 14, 20); sr_obj <- c(15, 28, 41)
k <- as.integer(terapia$nasilenie)
terapia$sesje <- pmax(1, round(sr_ses[k] + rnorm(3 * n, 0, 3)))
terapia$objawy <- pmax(0, round(sr_obj[k] - 0.6 * (terapia$sesje - sr_ses[k]) + rnorm(3 * n, 0, 5)))

# Korelacje i nachylenia: razem i w grupach
opis <- function(x, y, g) {
  w <- sapply(split(data.frame(x, y), g), function(d) c(r = cor(d$x, d$y), b = unname(coef(lm(y ~ x, d))[2])))
  round(cbind(razem = c(r = cor(x, y), b = unname(coef(lm(y ~ x))[2])), w), 2)
}
opis(kurs$godziny, kurs$wynik, kurs$poziom)
format.pval(cor.test(kurs$godziny, kurs$wynik)$p.value, eps = .001)   # p dla r w całej próbie
opis(terapia$sesje, terapia$objawy, terapia$nasilenie)
format.pval(cor.test(terapia$sesje, terapia$objawy)$p.value, eps = .001)

chmura <- function(d, x, y, g, tytul, ox, oy, legenda) {
  ggplot(d, aes({{ x }}, {{ y }})) +
    geom_point(aes(colour = {{ g }}, shape = {{ g }}), size = 2, alpha = 0.75) +
    geom_smooth(aes(colour = {{ g }}, group = {{ g }}), method = "lm", formula = y ~ x, se = FALSE, linewidth = 1.1) +
    geom_smooth(method = "lm", formula = y ~ x, se = FALSE, colour = "black", linetype = "dashed", linewidth = 1) +
    scale_colour_manual(values = kol, name = legenda) + scale_shape_manual(values = c(16, 17, 15), name = legenda) +
    labs(x = ox, y = oy, title = tytul) + motyw
}
pa <- chmura(kurs, godziny, wynik, poziom, "A. W grupach w górę, razem w dół",
             "Ćwiczenia w aplikacji (godz. tygodniowo)", "Wynik testu końcowego", "Poziom startowy")
pb <- chmura(terapia, sesje, objawy, nasilenie, "B. W grupach w dół, razem w górę",
             "Liczba sesji terapii", "Nasilenie objawów po terapii", "Na początku")
p1 <- pa + pb
p1   # zapis: ggsave("paradoks-simpsona-dwie-chmury.svg", p1, width = 10, height = 5.8)
Wynik w R
  razem   A1   A2   B1
r -0.64 0.28 0.47 0.33
b -4.08 1.48 2.53 1.96
[1] "< 0.001"
  razem łagodne umiarkowane ciężkie
r  0.66   -0.42       -0.24   -0.32
b  1.42   -0.78       -0.40   -0.58
[1] "< 0.001"
2. Regresja ze zmienną grupującą i 1000 badań: Rysunek 2
R
# Rysunek 2. Dodanie zmiennej grupującej zmienia znak współczynnika + 1000 badań tym samym schematem
# (kontynuacja: kurs, n, sr_godz, sr_wyn, kol, motyw z bloku 1)
library(patchwork)

m_razem <- lm(wynik ~ godziny, data = kurs)              # bez poziomu startowego
m_grupy <- lm(wynik ~ godziny + poziom, data = kurs)     # z poziomem startowym (zmienna grupująca)
m_inter <- lm(wynik ~ godziny * poziom, data = kurs)     # czy nachylenia w grupach się różnią?
wsp <- rbind(bez_poziomu = c(coef(m_razem)["godziny"], confint(m_razem)["godziny", ]),
             z_poziomem = c(coef(m_grupy)["godziny"], confint(m_grupy)["godziny", ]))
round(wsp, 2)
round(c(R2_bez = summary(m_razem)$r.squared, R2_z = summary(m_grupy)$r.squared), 3)
round(anova(m_grupy, m_inter)[2, c("F", "Pr(>F)")], 3)   # test równoległości nachyleń

# 1000 badań: za każdym razem nowe 180 osób z tej samej populacji (prawdziwe nachylenie w grupach = 2)
R <- 1000
set.seed(591)
sym <- t(replicate(R, {
  poz <- factor(rep(poziomy, each = n), levels = poziomy)
  g <- pmax(0.2, sr_godz[poz] + rnorm(3 * n, 0, 1.2))
  w <- sr_wyn[poz] + 2 * (g - sr_godz[poz]) + rnorm(3 * n, 0, 6)
  s1 <- summary(lm(w ~ g))$coefficients["g", ]
  s2 <- summary(lm(w ~ g + poz))$coefficients["g", ]
  c(b_bez = s1[[1]], p_bez = s1[[4]], b_z = s2[[1]], p_z = s2[[4]])
}))
odsetek <- function(x) c(procent = 100 * mean(x), blad_MC_pp = 100 * sqrt(mean(x) * (1 - mean(x)) / length(x)))
round(rbind(bez_poziomu_istotnie_ujemny = odsetek(sym[, "b_bez"] < 0 & sym[, "p_bez"] < .05),
            z_poziomem_istotnie_dodatni = odsetek(sym[, "b_z"] > 0 & sym[, "p_z"] < .05)), 1)
round(apply(sym[, c("b_bez", "b_z")], 2, quantile, c(.025, .5, .975)), 2)

dw <- data.frame(model = factor(c("bez poziomu startowego", "z poziomem startowym"),
                                levels = c("bez poziomu startowego", "z poziomem startowym")),
                 b = wsp[, 1], dolna = wsp[, 2], gorna = wsp[, 3])
pa <- ggplot(dw, aes(b, model, colour = model, shape = model)) +
  geom_vline(xintercept = 0, colour = "grey50") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.15, linewidth = 0.9, orientation = "y") +
  geom_point(size = 3.2) +
  geom_text(aes(label = sub("-", "−", sprintf("%.2f", b))), vjust = -1.2, size = 4.2, show.legend = FALSE) +
  scale_colour_manual(values = kol[c(1, 2)], guide = "none") + scale_shape_manual(values = c(15, 16), guide = "none") +
  scale_y_discrete(limits = rev, labels = c("z poziomem\nstartowym", "bez poziomu\nstartowego")) +
  labs(x = "Współczynnik godzin ćwiczeń (b, 95% CI)", y = NULL, title = "A. Jedna próba") + motyw
ds <- data.frame(b = c(sym[, "b_bez"], sym[, "b_z"]),
                 model = factor(rep(levels(dw$model), each = R), levels = levels(dw$model)))
pb <- ggplot(ds, aes(b, fill = model)) +
  geom_histogram(binwidth = 0.25, boundary = 0, colour = "white", alpha = 0.85, position = "identity") +
  geom_vline(xintercept = 2, linetype = "dashed", colour = "black") +
  annotate("text", x = 2, y = Inf, label = "prawdziwe\nnachylenie = 2", vjust = 1.3, hjust = 1.08, size = 3.6) +
  scale_fill_manual(values = kol[c(1, 2)], name = NULL) +
  labs(x = "Współczynnik godzin ćwiczeń (b)", y = "Liczba badań", title = "B. 1000 badań") + motyw +
  guides(fill = guide_legend(ncol = 1))
p2 <- pa + pb
p2   # zapis: ggsave("paradoks-simpsona-regresja-1000-badan.svg", p2, width = 10, height = 5.4)
Wynik w R
            godziny 2.5 % 97.5 %
bez_poziomu   -4.08 -4.81  -3.35
z_poziomem     1.95  1.17   2.73
R2_bez   R2_z
 0.403  0.796
      F Pr(>F)
2 0.593  0.554
                            procent blad_MC_pp
bez_poziomu_istotnie_ujemny   100.0        0.0
z_poziomem_istotnie_dodatni    99.8        0.1
      b_bez  b_z
2.5%  -4.97 1.19
50%   -4.29 2.02
97.5% -3.60 2.75
3. Tabela 2 × 2 × 2, standaryzacja i 1000 badań: Rysunek 3
R
# Rysunek 3. Wersja dla odsetków: tabela 2 × 2 × 2 (terapia × ciężkość choroby × poprawa), dane fikcyjne
# (kontynuacja: kol, motyw z bloku 1)
tab <- array(c(102, 18, 234, 66,     138, 162, 38, 62), dim = c(2, 2, 2), dimnames = list(
  poprawa = c("tak", "nie"), terapia = c("nowa", "standardowa"), ciezkosc = c("łagodna", "ciężka")))
liczebnosci <- apply(tab, 2:3, sum)
liczebnosci
round(100 * prop.table(liczebnosci, 1), 1)                        # skład grup: odsetek ciężkich przypadków
w_warstwach <- 100 * tab["tak", , ] / liczebnosci                  # odsetek poprawy w warstwach
razem <- apply(tab, 1:2, sum)
lacznie <- 100 * razem["tak", ] / colSums(razem)                   # odsetek poprawy razem
round(cbind(w_warstwach, razem = lacznie), 1)
round(c(roznica_lagodna = unname(w_warstwach["nowa", "łagodna"] - w_warstwach["standardowa", "łagodna"]),
        roznica_ciezka = unname(w_warstwach["nowa", "ciężka"] - w_warstwach["standardowa", "ciężka"]),
        roznica_razem = unname(lacznie["nowa"] - lacznie["standardowa"])), 1)

# Standaryzacja: co by było, gdyby obie terapie dostała ta sama mieszanka pacjentów (skład całej próby)
sklad <- colSums(liczebnosci) / sum(liczebnosci)
standaryzowane <- w_warstwach %*% sklad
round(c(sklad_lagodna = sklad[["łagodna"]], nowa = standaryzowane[1], standardowa = standaryzowane[2],
        roznica = standaryzowane[1] - standaryzowane[2]), 3)
mh <- mantelhaen.test(tab, correct = FALSE)                        # wspólny OR w warstwach
or <- function(t) (t[1, 1] * t[2, 2]) / (t[1, 2] * t[2, 1])
round(c(OR_razem = or(razem), OR_lagodna = or(tab[, , 1]), OR_ciezka = or(tab[, , 2]),
        OR_MH = unname(mh$estimate), dolna = mh$conf.int[1], gorna = mh$conf.int[2], p = mh$p.value), 3)

# 1000 badań obserwacyjnych: lekarze częściej dają nową terapię cięższym przypadkom (zakłócenie przez ciężkość)
R <- 1000
set.seed(591)
p_popr <- c(lagodna_nowa = .85, lagodna_std = .78, ciezka_nowa = .46, ciezka_std = .38)   # prawdziwe odsetki
roznice <- t(replicate(R, {
  ciezka <- rbinom(820, 1, 0.49)
  nowa <- rbinom(820, 1, ifelse(ciezka == 1, 0.75, 0.29))       # przydział zależny od ciężkości
  pr <- ifelse(ciezka == 1, ifelse(nowa == 1, p_popr[3], p_popr[4]), ifelse(nowa == 1, p_popr[1], p_popr[2]))
  y <- rbinom(820, 1, pr)
  w <- tapply(y, list(nowa, ciezka), mean)                       # wiersze: terapia 0/1, kolumny: ciężkość 0/1
  sk <- prop.table(table(ciezka))
  c(surowa = mean(y[nowa == 1]) - mean(y[nowa == 0]), standaryzowana = sum((w[2, ] - w[1, ]) * sk))
}))
round(100 * apply(roznice, 2, quantile, c(.025, .5, .975)), 1)
odsetek <- mean(roznice[, "surowa"] < 0)
round(c(surowa_ujemna_procent = 100 * odsetek, blad_MC_pp = 100 * sqrt(odsetek * (1 - odsetek) / R),
        standaryzowana_ujemna_procent = 100 * mean(roznice[, "standaryzowana"] < 0)), 1)

# Wykres: odsetek poprawy z 95% CI (Wilsona) w warstwach i razem
ci <- function(x, n) prop.test(x, n, correct = FALSE)$conf.int * 100
d3 <- expand.grid(terapia = c("nowa", "standardowa"), panel = c("łagodna", "ciężka", "razem"))
d3$x <- c(tab["tak", , "łagodna"], tab["tak", , "ciężka"], razem["tak", ])
d3$n <- c(liczebnosci[, "łagodna"], liczebnosci[, "ciężka"], colSums(razem))
d3$proc <- 100 * d3$x / d3$n
d3[, c("dolna", "gorna")] <- t(mapply(ci, d3$x, d3$n))
d3$panel <- factor(d3$panel, levels = c("łagodna", "ciężka", "razem"),
                   labels = c("Choroba łagodna", "Choroba ciężka", "Wszyscy razem"))
p3 <- ggplot(d3, aes(terapia, proc, fill = terapia)) +
  geom_col(width = 0.65, alpha = 0.9) +
  geom_errorbar(aes(ymin = dolna, ymax = gorna), width = 0.18, colour = "grey20") +
  geom_text(aes(y = 4, label = sprintf("%.1f%%\nn = %d", proc, n)), vjust = 0, colour = "white",
            size = 3.8, fontface = "bold", lineheight = 0.9) +
  facet_wrap(~ panel) +
  scale_fill_manual(values = c(nowa = kol[2], standardowa = kol[1]), guide = "none") +
  scale_y_continuous(limits = c(0, 100), breaks = seq(0, 100, 20)) +
  labs(x = "Terapia", y = "Odsetek pacjentów z poprawą (%)",
       title = "Nowa terapia wygrywa w obu warstwach i przegrywa razem") + motyw
p3   # zapis: ggsave("paradoks-simpsona-odsetki-w-warstwach.svg", p3, width = 10, height = 5.4)
Wynik w R
             ciezkosc
terapia       łagodna ciężka
  nowa            120    300
  standardowa     300    100
             ciezkosc
terapia       łagodna ciężka
  nowa           28.6   71.4
  standardowa    75.0   25.0
            łagodna ciężka razem
nowa             85     46  57.1
standardowa      78     38  68.0
roznica_lagodna  roznica_ciezka   roznica_razem
            7.0             8.0           -10.9
sklad_lagodna          nowa   standardowa       roznica
        0.512        65.976        58.488         7.488
  OR_razem OR_lagodna  OR_ciezka      OR_MH      dolna      gorna          p
     0.627      1.598      1.390      1.472      1.028      2.108      0.035
      surowa standaryzowana
2.5%   -17.1            0.6
50%    -10.7            7.4
97.5%   -4.1           14.1
        surowa_ujemna_procent                    blad_MC_pp
                        100.0                           0.0
standaryzowana_ujemna_procent
                          1.8
4. Odsetek łączny jako średnia ważona: Rysunek 4
R
# Rysunek 4. Odsetek łączny to średnia ważona: każda terapia leży na własnym odcinku, w miejscu swojego składu
# (kontynuacja: w_warstwach, lacznie, liczebnosci, sklad, standaryzowane, kol, motyw z bloku 3)
udzial_lagodnych <- liczebnosci[, "łagodna"] / rowSums(liczebnosci)
round(udzial_lagodnych, 3)
linie <- do.call(rbind, lapply(c("nowa", "standardowa"), function(t)
  data.frame(terapia = t, udzial = c(0, 1), proc = c(w_warstwach[t, "ciężka"], w_warstwach[t, "łagodna"]))))
punkty <- data.frame(terapia = c("nowa", "standardowa"), udzial = udzial_lagodnych, proc = lacznie,
                     rodzaj = "skład własnej grupy")
wspolny <- data.frame(terapia = c("nowa", "standardowa"), udzial = sklad[["łagodna"]], proc = as.vector(standaryzowane),
                      rodzaj = "ten sam skład (standaryzacja)")
# sprawdzenie: punkt łączny = odsetek w ciężkiej + udział łagodnych × (odsetek w łagodnej − odsetek w ciężkiej)
round(w_warstwach[, "ciężka"] + udzial_lagodnych * (w_warstwach[, "łagodna"] - w_warstwach[, "ciężka"]) - lacznie, 10)

p4 <- ggplot(linie, aes(udzial, proc, colour = terapia)) +
  geom_vline(xintercept = sklad[["łagodna"]], linetype = "dotted", colour = "grey40") +
  geom_line(aes(linetype = terapia), linewidth = 1.1) +
  geom_point(data = punkty, aes(shape = rodzaj), size = 4.2, stroke = 1.2) +
  geom_point(data = wspolny, aes(shape = rodzaj), size = 3.4, stroke = 1.2) +
  geom_text(data = punkty, aes(label = sprintf("%.1f%%", proc)), vjust = -1.1, size = 4, show.legend = FALSE) +
  geom_text(data = wspolny, aes(label = sprintf("%.1f%%", proc)), hjust = -0.25, vjust = 1.6, size = 4, show.legend = FALSE) +
  annotate("text", x = 0.02, y = 32, label = "0 = sami ciężko chorzy", hjust = 0, size = 3.6, colour = "grey30") +
  annotate("text", x = 0.98, y = 32, label = "1 = sami łagodnie chorzy", hjust = 1, size = 3.6, colour = "grey30") +
  scale_colour_manual(values = c(nowa = kol[2], standardowa = kol[1]), name = "Terapia") +
  scale_linetype_manual(values = c(nowa = "solid", standardowa = "dashed"), name = "Terapia") +
  scale_shape_manual(values = c("skład własnej grupy" = 16, "ten sam skład (standaryzacja)" = 1), name = NULL) +
  scale_x_continuous(labels = scales::percent, breaks = seq(0, 1, 0.25)) +
  scale_y_continuous(limits = c(30, 92), breaks = seq(30, 90, 10)) +
  guides(colour = guide_legend(order = 1), linetype = guide_legend(order = 1), shape = guide_legend(order = 2, ncol = 1)) +
  labs(x = "Udział łagodnie chorych w grupie", y = "Odsetek pacjentów z poprawą (%)",
       title = "Ta sama terapia, inny skład grupy – inny odsetek łączny") + motyw
p4   # zapis: ggsave("paradoks-simpsona-srednia-wazona.svg", p4, width = 10, height = 5.8)
Wynik w R
       nowa standardowa
      0.286       0.750
       nowa standardowa
          0           0
5. Graf przyczynowy w ggplot2: Rysunek 5
R
# Rysunek 5. Te same liczby, dwie historie przyczynowe: kiedy warstwy, a kiedy tabela łączna
# (kontynuacja: kol, motyw z bloku 1; graf rysowany w ggplot2, bez pakietów do grafów)
wezly <- data.frame(
  panel = rep(c("A. Ciężkość przed leczeniem: licz w warstwach", "B. Stan po 2 tygodniach: licz razem"), each = 3),
  x = c(0, 2, 1, 0, 2, 1), y = c(0, 0, 1, 0, 0, -1),
  etykieta = c("Terapia", "Poprawa", "Ciężkość\nprzed leczeniem", "Terapia", "Poprawa", "Stan po\n2 tygodniach"),
  rola = c("przyczyna", "wynik", "zakłócająca", "przyczyna", "wynik", "pośrednicząca"))
strzalki <- data.frame(
  panel = rep(unique(wezly$panel), each = 3),
  x = c(0.33, 0.85, 1.15, 0.33, 0.15, 1.15), y = c(0, 0.85, 0.85, 0, -0.15, -0.85),
  xend = c(1.67, 0.15, 1.85, 1.67, 0.85, 1.85), yend = c(0, 0.15, 0.15, 0, -0.85, -0.15),
  typ = c("badany efekt", "inna ścieżka", "inna ścieżka", "badany efekt", "inna ścieżka", "inna ścieżka"))
p5 <- ggplot() +
  geom_segment(data = strzalki, aes(x, y, xend = xend, yend = yend, linetype = typ),
               arrow = arrow(length = unit(0.25, "cm"), type = "closed"), linewidth = 0.9, colour = "grey25") +
  geom_label(data = wezly, aes(x, y, label = etykieta, fill = rola), size = 4.2, lineheight = 0.9,
             label.padding = unit(0.4, "lines"), colour = "grey10") +
  facet_wrap(~ panel, ncol = 1) +
  scale_fill_manual(values = c(przyczyna = "#9ECAE9", wynik = "#F4C9A8", "zakłócająca" = "grey85", "pośrednicząca" = "grey85"),
                    guide = "none") +
  scale_linetype_manual(values = c("badany efekt" = "solid", "inna ścieżka" = "dashed"), name = NULL) +
  scale_x_continuous(limits = c(-0.45, 2.45)) + scale_y_continuous(limits = c(-1.35, 1.35)) +
  labs(x = NULL, y = NULL, title = "Wybór tabeli zależy od tego, kiedy powstała trzecia zmienna") +
  motyw + theme(axis.text = element_blank(), panel.grid.major = element_blank())
p5   # zapis: ggsave("paradoks-simpsona-struktura-przyczynowa.svg", p5, width = 10, height = 5.6)
6. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("cynober – niebieski (grupa 1 / grupa 2, terapie)" = c("#D55E00", "#0072B2"),
             "cynober – grafit (grupa 1 / grupa 3)" = c("#D55E00", "#404040"),
             "niebieski – grafit (grupa 2 / grupa 3)" = c("#0072B2", "#404040"),
             "jasnoniebieski – brzoskwiniowy (węzły grafu)" = c("#9ECAE9", "#F4C9A8"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                 widzenie_typowe deuteranopia
cynober – niebieski (grupa 1 / grupa 2, terapie)           114.6        108.3
cynober – grafit (grupa 1 / grupa 3)                        81.3         69.9
niebieski – grafit (grupa 2 / grupa 3)                      45.6         48.0
jasnoniebieski – brzoskwiniowy (węzły grafu)                46.1         45.6
czerwony – zielony (do unikania)                           121.7         21.1
                                                 protanopia
cynober – niebieski (grupa 1 / grupa 2, terapie)       91.9
cynober – grafit (grupa 1 / grupa 3)                   57.6
niebieski – grafit (grupa 2 / grupa 3)                 44.2
jasnoniebieski – brzoskwiniowy (węzły grafu)           38.8
czerwony – zielony (do unikania)                       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Regresje, test Mantela–Haenszela, przedziały Wilsona (prop.test()) i losowania wykonano pakietem stats. Rysunki wykonano w pakiecie ggplot2 (skala procentowa osi – pakiet scales), panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- scales (wersja 1.4.0): Wickham, H., Pedersen, T. L., & Seidel, D. (2025). scales: Scale functions for visualization [R package]. https://doi.org/10.32614/CRAN.package.scales
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- Korelacja w całej próbie bez wykresu z grupami. Ujemne r może kryć dodatnie r w każdej grupie (rysunek 1).
- „Większa próba to naprawi”. Nie naprawi – w 1000 badaniach zły znak pojawiał się za każdym razem (rysunek 2).
- Odsetki bez liczebności w warstwach. Bez składu grup czytelnik nie zobaczy, skąd bierze się odwrócenie (rysunki 3 i 4).
- Automatyczne „kontrolowanie wszystkiego”. Warstwowanie po mediatorze albo zmiennej zderzeniowej psuje wynik (rysunek 5).
- Mylenie zakłócenia z nieskładalnością OR. Różnica między OR łącznym a warstwowym nie zawsze oznacza zakłócenie.
- Wniosek przyczynowy z odwrócenia. Wynik w warstwach to nadal dane obserwacyjne – niezmierzone zmienne mogą działać tak samo.
Najczęstsze pytania
Jak pokazać paradoks Simpsona na wykresie?
Narysuj wykres rozrzutu, w którym kolor i kształt punktu oznaczają grupę, i dodaj proste regresji w grupach oraz jedną prostą dla całej próby. W przykładzie z kursem języka proste w trzech poziomach startowych rosną (r od .28 do .47), a prosta dla wszystkich 180 osób opada (r = −.64). Przy odsetkach pokaż słupki w warstwach i razem, z liczebnościami.
Dlaczego współczynnik regresji zmienia znak po dodaniu zmiennej?
Bo trzecia zmienna wiąże się i z predyktorem, i ze zmienną zależną. W przykładzie osoby z niższym poziomem startowym ćwiczyły więcej i miały niższe wyniki, więc bez poziomu współczynnik godzin wyniósł −4.08, a z poziomem 1.95. Statystycznie tak samo wygląda zakłócanie, mediacja i supresja (MacKinnon i in., 2000) – nazwę wybierasz na podstawie wiedzy o badaniu.
Czy większa próba usuwa paradoks Simpsona?
Nie. Paradoks wynika ze struktury danych, a nie z przypadku. W 1000 symulowanych badaniach po 180 osób model bez zmiennej grupującej dał istotnie ujemny współczynnik za każdym razem, choć prawdziwe nachylenie w grupach wynosiło 2. Większa próba zwęża przedział, ale wokół niewłaściwej wartości.
Kiedy wierzyć wynikom w podgrupach, a kiedy wynikowi łącznemu?
Gdy trzecia zmienna powstała przed ekspozycją i wpływa na nią oraz na wynik (zmienna zakłócająca, np. ciężkość choroby przed leczeniem) – wierz podgrupom. Gdy jest skutkiem badanej przyczyny (mediator) albo wspólnym skutkiem przyczyny i wyniku (zmienna zderzeniowa) – podział na podgrupy zniekształca efekt całkowity. Same dane tego nie rozstrzygną (Hernán i in., 2011).
Jak opisać paradoks Simpsona w pracy dyplomowej?
Podaj wynik łączny i wyniki w podgrupach z liczebnościami, opisz skład grup (np. 71.4% ciężko chorych w jednej grupie i 25.0% w drugiej) i uzasadnij w Metodzie, dlaczego zmienną grupującą traktujesz jako zakłócającą. Przy odsetkach możesz dodać odsetki standaryzowane do wspólnego składu albo iloraz szans Mantela–Haenszela.
Powiązane hasła
Przeczytaj też
Zmienna zakłócająca i collider – wizualizacja
Trzy grafy w ggplot2, kontrola w regresji na wykresie rozrzutu, 1000 badań z każdego grafu i dobór próby według zderzacza – pięć rysunków z kodem R.
Czytaj →PoradnikGrafy przyczynowe (DAG)
Zakłócacz, mediator i zderzacz, kryterium tylnych drzwi i zbiór dostosowujący – z symulacją w R, która pokazuje koszt złej kontroli.
Czytaj →PoradnikRegresja wieloraka w obrazkach
Wykres zmiennej dodanej, zmiana znaku współczynnika, elipsa ufności przy współliniowości i ten sam predyktor w pięciu modelach – „kontrolując” na rysunkach z R.
Czytaj →PoradnikLike-for-like i paradoks Simpsona
Sklepy przy stacjach paliw: sprzedaż porównywalna, indeksy Laspeyresa i Paaschego, efekt mieszanki i średnia ze średnich – pięć rysunków z kodem R.
Czytaj →Wynik w całej próbie i w grupach ma przeciwne znaki?
Pomożemy ustalić, które zmienne kontrolować, przygotować czytelne rysunki z podziałem na grupy i opisać wyniki tak, żebyś umiał(a) je obronić przed promotorem i recenzentem.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Greenland, S., Robins, J. M., & Pearl, J. (1999). Confounding and collapsibility in causal inference. Statistical Science, 14(1), 29–46. https://doi.org/10.1214/ss/1009211805 ● Otwarty dostęp
- Hernán, M. A., Clayton, D., & Keiding, N. (2011). The Simpson's paradox unraveled. International Journal of Epidemiology, 40(3), 780–785. https://doi.org/10.1093/ije/dyr041 ● Otwarty dostęp
- Kievit, R. A., Frankenhuis, W. E., Waldorp, L. J., & Borsboom, D. (2013). Simpson's paradox in psychological science: A practical guide. Frontiers in Psychology, 4, Article 513. https://doi.org/10.3389/fpsyg.2013.00513 ● Otwarty dostęp
- MacKinnon, D. P., Krull, J. L., & Lockwood, C. M. (2000). Equivalence of the mediation, confounding and suppression effect. Prevention Science, 1(4), 173–181. https://doi.org/10.1023/a:1026595011371 ● Otwarty dostęp: pełny tekst
- Salas, M., Hofman, A., & Stricker, B. H. (1999). Confounding by indication: An example of variation in the use of epidemiologic terminology. American Journal of Epidemiology, 149(11), 981–983. https://doi.org/10.1093/oxfordjournals.aje.a009758
- Simpson, E. H. (1951). The interpretation of interaction in contingency tables. Journal of the Royal Statistical Society: Series B (Methodological), 13(2), 238–241. https://doi.org/10.1111/j.2517-6161.1951.tb00088.x
Cytowania BibTeX
@article{greenland1999confounding, author={Greenland, Sander and Robins, James M. and Pearl, Judea}, title={{Confounding and collapsibility in causal inference}}, journal={Statistical Science}, year={1999}, volume={14}, number={1}, pages={29--46}, doi={10.1214/ss/1009211805}}@article{hernan2011simpson, author={Hern{\'a}n, Miguel A. and Clayton, David and Keiding, Niels}, title={{The Simpson's paradox unraveled}}, journal={International Journal of Epidemiology}, year={2011}, volume={40}, number={3}, pages={780--785}, doi={10.1093/ije/dyr041}}@article{kievit2013simpson, author={Kievit, Rogier A. and Frankenhuis, Willem E. and Waldorp, Lourens J. and Borsboom, Denny}, title={{Simpson's paradox in psychological science: A practical guide}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={513}, doi={10.3389/fpsyg.2013.00513}}@article{mackinnon2000equivalence, author={MacKinnon, David P. and Krull, Jennifer L. and Lockwood, Chondra M.}, title={{Equivalence of the mediation, confounding and suppression effect}}, journal={Prevention Science}, year={2000}, volume={1}, number={4}, pages={173--181}, doi={10.1023/a:1026595011371}}@article{salas1999confounding, author={Salas, M. and Hofman, A. and Stricker, B. H.}, title={{Confounding by indication: An example of variation in the use of epidemiologic terminology}}, journal={American Journal of Epidemiology}, year={1999}, volume={149}, number={11}, pages={981--983}, doi={10.1093/oxfordjournals.aje.a009758}}@article{simpson1951interpretation, author={Simpson, E. H.}, title={{The interpretation of interaction in contingency tables}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1951}, volume={13}, number={2}, pages={238--241}, doi={10.1111/j.2517-6161.1951.tb00088.x}}