Trzy sposoby liczenia średniej szkoły
Definicję, równania i procedurę modelu znajdziesz w haśle model wielopoziomowy i we wpisie model wielopoziomowy krok po kroku w R. Tu nie powtarzamy procedury. Pokazujemy na rysunkach jedną rzecz, która w wydruku jest niewidoczna: co model mieszany robi z wynikami pojedynczych grup.
Przykład jest fikcyjny. Mamy 18 szkół o bardzo różnej liczbie uczniów: od 3 do 60, razem 441 osób. Każdy uczeń ma wynik testu (w punktach) i deklarowany czas nauki (0–10 godzin tygodniowo). Średnią szkoły można oszacować na trzy sposoby:
- Brak łączenia (ang. no pooling): każda szkoła osobno, czyli zwykła średnia jej uczniów. Szkoła z trzema uczniami dostaje średnią z trzech liczb.
- Pełne łączenie (ang. complete pooling): jedna średnia dla wszystkich, jakby szkoły się nie różniły.
- Częściowe łączenie (ang. partial pooling): model mieszany z efektem losowym szkoły. Oszacowanie leży między średnią szkoły a średnią ogólną – tym bliżej średniej ogólnej, im mniej danych ma szkoła.
To trzecie zjawisko nazywa się kurczeniem do średniej (ang. shrinkage). Model dopasowujemy funkcją lmer() z pakietu lme4 (Bates i in., 2015) metodą REML. Prawdziwe parametry populacji ustaliliśmy ręcznie (średnia 60 punktów, SD szkół 5, SD uczniów 12, nachylenie czasu nauki 2 punkty na godzinę, SD nachyleń 1). Ziarno 573 ustalono raz, bez dobierania pod obraz. Dane pobierzesz jako model-mieszany-szkoly-dane-symulowane.csv. Przy każdym rysunku: co widać, czego wykres nie pokazuje, podpis i zdanie do pracy.
Rysunek 1: strzałki od średnich szkół do modelu
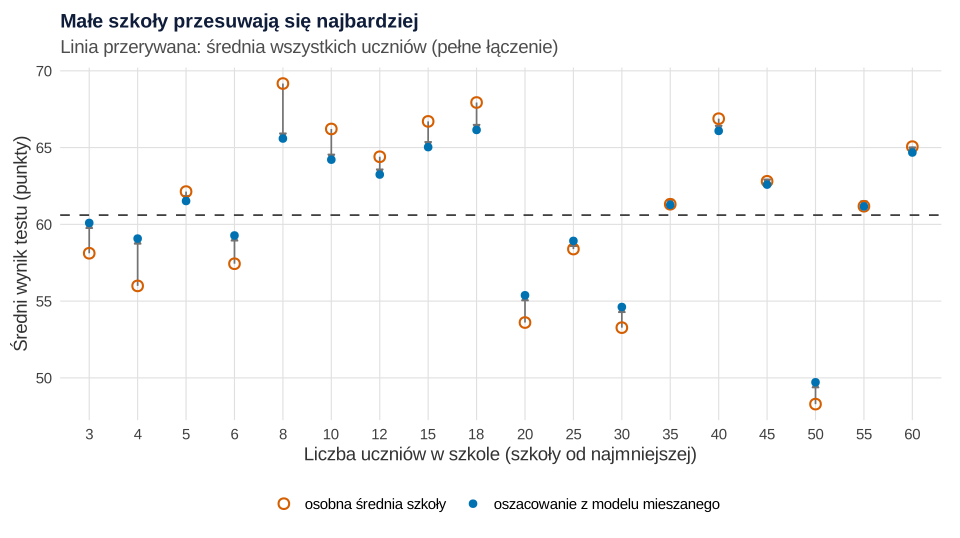
set.seed(573)).Co widać. Puste kółka to osobne średnie szkół, linia przerywana – średnia wszystkich uczniów (60.60), a pełne punkty – oszacowania z modelu. Każda strzałka biegnie w stronę średniej ogólnej. W szkołach do 10 uczniów oszacowanie przesunęło się średnio o 2.18 punktu, w szkołach od 40 uczniów – o 0.57. Szkoła z 8 uczniami spadła z 69.17 do 65.59, a szkoła z 4 uczniami wzrosła z 55.99 do 59.07. Szkoła z 50 uczniami ma bardzo niską średnią (48.29), ale model przesunął ją tylko do 49.71 – jej średnia opiera się na wielu osobach.
Czego ten wykres nie pokazuje. Długość strzałki zależy od dwóch rzeczy naraz: od liczby uczniów i od odległości średniej szkoły od średniej ogólnej. Szkoła z 5 uczniami prawie się nie ruszyła (z 62.13 do 61.52), bo i tak leżała blisko środka. Model ściąga też nie dokładnie do linii przerywanej, tylko do swojej średniej ogólnej (61.03). To średnia ważona średnich szkół, a nie średnia wszystkich uczniów. Wykres nie mówi też, które oszacowanie jest bliższe prawdy – to pokazuje rysunek 2.
Podpis do pracy:
Zdanie do Wyników:
Wartość ICC i jej znaczenie dla planu badania omawia hasło ICC – korelacja wewnątrzklasowa, a efekt schematu dla własnych liczb policzysz w kalkulatorze ICC i efektu schematu.
Rysunek 2: ile kurczenia i czy to się opłaca
Model zostawia z odchylenia szkoły od średniej ogólnej tylko pewną część. Ta część, czyli waga, wynosi τ² / (τ² + σ²/n), gdzie τ² to wariancja między szkołami, σ² – wariancja między uczniami, a n – liczba uczniów w szkole. To jedyny wzór w tym wpisie; resztę pokazują rysunki.
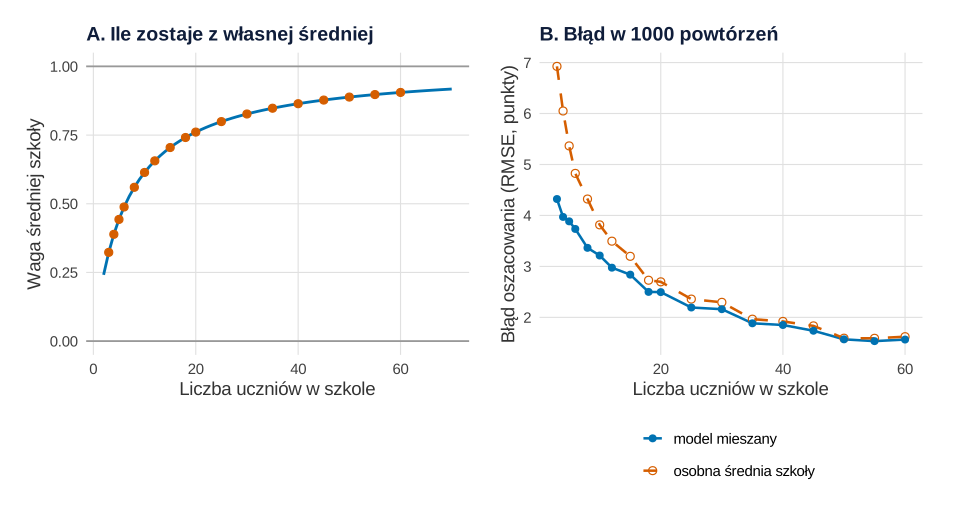
Co widać. Panel A: szkoła z 3 uczniami zachowuje 32% swojego odchylenia od średniej (waga .323), szkoła z 10 uczniami – 61%, z 30 – 83%, z 60 – 90.5%. Przy 6 uczniach średnia szkoły i średnia ogólna ważą mniej więcej po połowie. Punkty szkół leżą dokładnie na krzywej: w modelu z samym losowym wyrazem wolnym przesunięcie z rysunku 1 to właśnie ta waga. Panel B pokazuje 1000 powtórzeń: za każdym razem nowe szkoły i nowi uczniowie z tej samej populacji. Średni błąd (RMSE) osobnej średniej szkoły z 3 uczniami wyniósł 6.92 punktu, a oszacowania z modelu – 4.32. Przy 10 uczniach było to 3.82 wobec 3.21, a przy 60 – 1.62 wobec 1.57. Dla wszystkich 18 szkół razem: 3.62 wobec 2.80. Tylko w 1 z 1000 dopasowań wystąpił singular fit.
Czego ten wykres nie pokazuje. Panel B uśrednia błąd po wielu szkołach. Kurczenie wprowadza obciążenie: szkoła naprawdę wyjątkowa zostanie przez model nieco „uśredniona”. Opłaca się to średnio, bo mniejszy rozrzut z nadwiązką rekompensuje obciążenie – ale nie musi się opłacić dla każdej szkoły z osobna. To samo zjawisko w wersji jednej osoby mierzonej dwa razy opisuje hasło regresja do średniej. Krzywa w panelu A zależy też od oszacowanych τ² i σ², a przy kilkunastu szkołach τ² jest oszacowane mało precyzyjnie. Dlatego przy niewielu grupach zalecana jest estymacja REML (McNeish, 2017; zob. REML a ML).
Podpis do pracy:
Zdanie do Metody (gdy w pracy podajesz oszacowania dla poszczególnych grup):
Rysunek 3: kurczenie a ICC
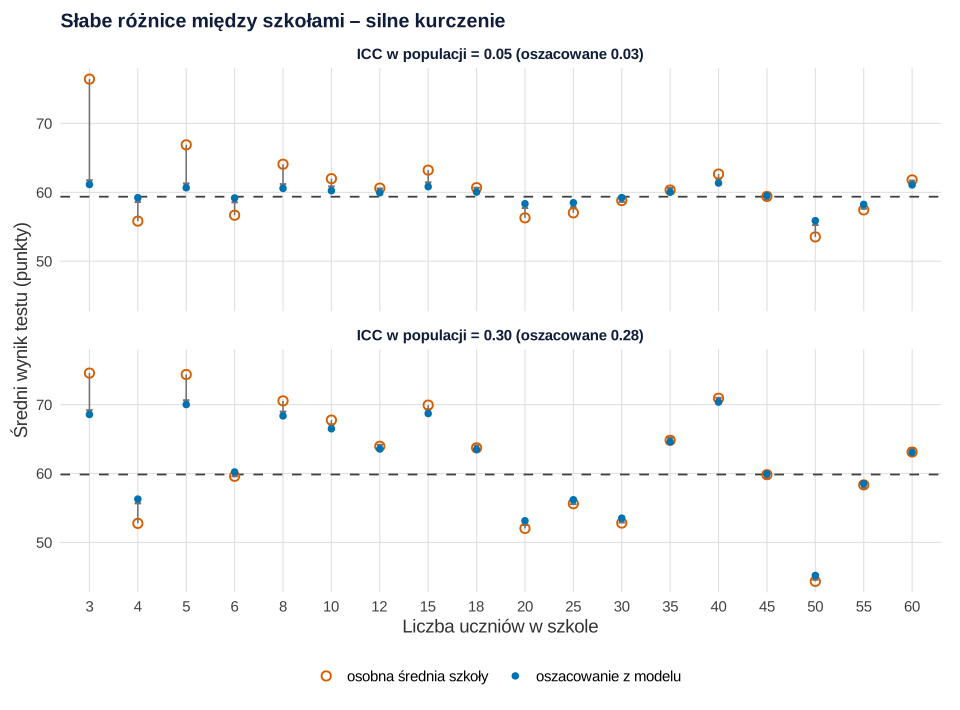
Co widać. Oba panele powstały z tych samych liczb losowych. Zmieniliśmy tylko skalę różnic między szkołami, tak by ICC w populacji wynosiło .05 albo .30 (oszacowane: .03 i .28). Przy ICC = .05 szkoły do 10 uczniów zachowały średnio tylko 16% swojego odchylenia, a ich oszacowania przesunęły się średnio o 5.45 punktu. Przy ICC = .30 zachowały 67%, a przesunięcie wyniosło 3.00. Rozrzut (SD) średnich szkół zmalał po kurczeniu z 5.15 do 1.34 przy niskim ICC i tylko z 8.48 do 6.91 przy wysokim.
Czego ten wykres nie pokazuje. Przy niskim ICC duża część różnic między osobnymi średnimi to szum losowania uczniów. Model to „wie” i niemal wszystkie szkoły ściąga do środka. Nie znaczy to, że szkoły są identyczne. Znaczy, że z tych danych nie da się ich wiarygodnie odróżnić. Przy jeszcze niższym ICC oszacowana wariancja szkół może spaść do zera (singular fit), a wtedy wszystkie oszacowania leżą na jednej linii. Niskie ICC nie zwalnia też z modelu mieszanego: zignorowanie zależności obserwacji w grupach zwiększa ryzyko fałszywie istotnych wyników (Aarts i in., 2014), o czym piszemy we wpisie GEE czy model mieszany.
Podpis do pracy:
Zdanie do pracy (np. w dyskusji ograniczeń):
Rysunek 4: wachlarz prostych z losowymi nachyleniami
Kurczenie dotyczy nie tylko średnich. Gdy model ma losowe nachylenie, ściąga do średniej także nachylenia prostych w poszczególnych szkołach. Tu czas nauki wyśrodkowaliśmy na 5 godzinach (zob. centrowanie zmiennych).
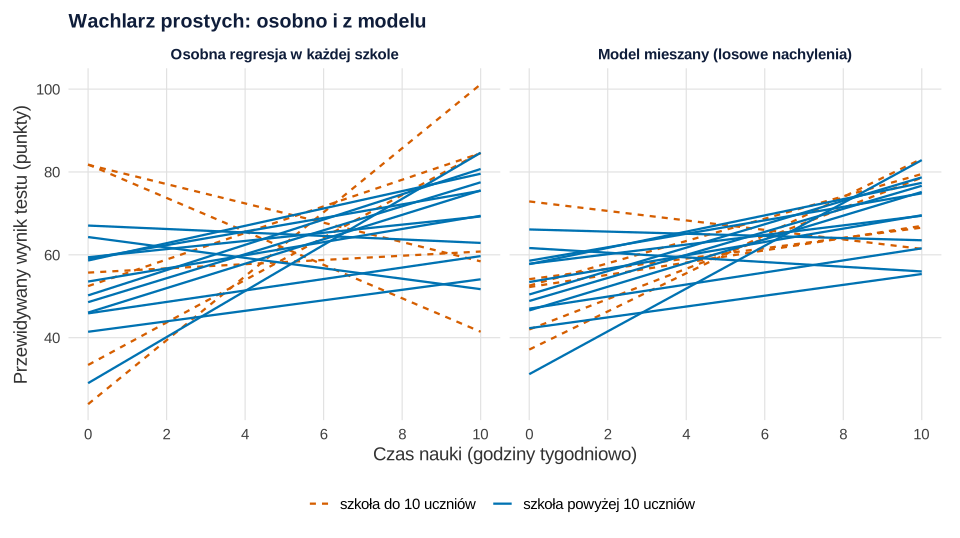
Co widać. Średnie nachylenie z modelu wynosi 1.92 punktu na godzinę nauki (w populacji: 2). Osobne regresje dają nachylenia od −4.04 do 7.72 (SD = 2.81). W modelu wachlarz jest węższy: od −1.15 do 5.17 (SD = 1.65). Najbardziej zmieniły się małe szkoły. W szkole z 3 uczniami ujemne nachylenie −4.04 zmieniło się w dodatnie 1.48, a w szkole z 4 uczniami 7.72 spadło do 4.61. W szkole z 60 uczniami nachylenie prawie się nie zmieniło (z −0.42 na −0.26).
Czego ten wykres nie pokazuje. Niepewności. Model oszacował SD nachyleń na 1.90, choć w populacji wynosi ono 1 – przy 18 szkołach to oszacowanie jest mało precyzyjne. Rozrzut prostych w prawym panelu (SD = 1.65) jest przy tym mniejszy niż oszacowane SD, bo proste też zostały skurczone. Nie licz więc wariancji nachyleń z narysowanych prostych – weź ją z wydruku modelu. Kiedy losowe nachylenie dodawać i jak je testować, opisują wpis o modelu wielopoziomowym krok po kroku (link na początku) i wpis ANOVA z powtarzanymi pomiarami czy model mieszany. Barr i in. (2013) pokazali, że pominięcie losowych nachyleń, gdy grupy różnią się wrażliwością na predyktor, pogarsza uogólnianie wyników. Takie same wachlarze dla danych podłużnych pokazuje wpis dane podłużne na wykresie.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: efekty losowe z przedziałami, a nie ranking
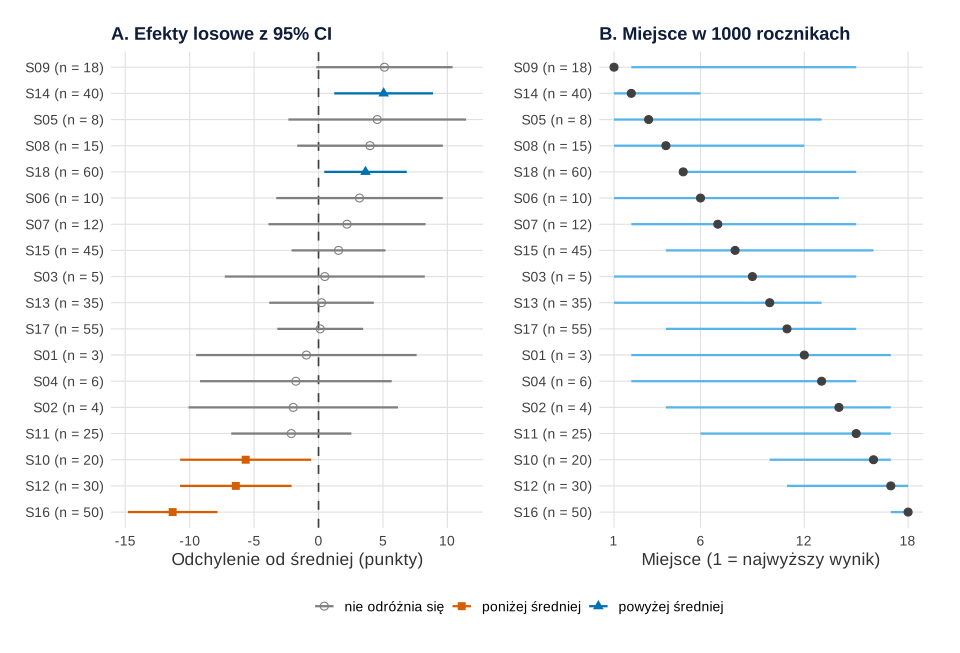
Co widać. Panel A to wykres gąsienicowy (ang. caterpillar plot): odchylenie każdej szkoły od średniej ogólnej z 95% przedziałem opartym na warunkowym odchyleniu standardowym (ranef(…, condVar = TRUE)). Przedziały małych szkół są szerokie mimo kurczenia. Tylko 5 z 18 szkół odróżnia się od średniej: dwie w górę (40 i 60 uczniów), trzy w dół. Panel B pokazuje, co by się stało z rankingiem, gdyby do tych samych szkół przyszło 1000 kolejnych roczników. Szkoła pierwsza w danych (18 uczniów) zajmowała w 95% roczników miejsca od 2 do 15. Do pierwszej trójki trafiła w 13.3% roczników, a według prawdziwych efektów jest ósma. Mediana szerokości zakresu miejsc to 13 miejsc na 18. Korelacja Spearmana miejsc w danych z prawdziwymi wyniosła .81 – ranking „mniej więcej” się zgadza, ale pojedyncze miejsca niewiele znaczą.
Czego ten wykres nie pokazuje. Przedziały w panelu A nie uwzględniają niepewności efektów stałych i wariancji, więc są raczej za wąskie niż za szerokie. Panel B zakłada, że szkoły się nie zmieniają, a różnią się tylko uczniowie – w realnym świecie ranking jest jeszcze mniej stabilny. Leckie i Goldstein (2009) pokazali na rankingach szkół w Anglii, że po uwzględnieniu niepewności tylko nieliczne szkoły da się z akceptowalną precyzją odróżnić od średniej i od siebie nawzajem. Kolejność wierszy w panelu A służy czytelności. Nie przepisuj jej do pracy jako rankingu.
Podpis do pracy:
Zdanie do Wyników:
Który rysunek do pracy
- Do Metody wystarczy zdanie o kurczeniu (rysunek 2), gdy w ogóle raportujesz oszacowania grup.
- Do Wyników – rysunek 4, gdy hipoteza dotyczy różnic w sile związku między grupami, albo panel A rysunku 5, gdy chcesz pokazać, ile grup odstaje od średniej.
- Do aneksu albo prezentacji na obronę – rysunki 1 i 3. Dobrze tłumaczą, dlaczego oszacowania z modelu różnią się od średnich z arkusza.
Tabelę efektów stałych i losowych przygotujesz według wpisu jak opisać wyniki modelu mieszanego, a R² – według hasła R² w modelach wielopoziomowych. Ten sam model wyklikasz w SPSS (MIXED) albo w jamovi (GAMLj). Szersze omówienie estymacji i interpretacji modeli wielopoziomowych, z przykładami z psychologii i edukacji, znajdziesz w podręczniku Hoxa i in. (2017). Ogólne zasady rysunków są we wpisie wykresy w pracy dyplomowej, a ten sam układ „rysunek – podpis – zdanie” dla przedziałów ufności i prostej regresji – we wpisach przedział ufności w obrazkach i metoda najmniejszych kwadratów w obrazkach.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę i motyw, z których korzystają następne. Każdy przepis kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Dane są symulowane w kodzie; ten sam zbiór pobierzesz też jako plik CSV (link na początku wpisu). Ziarno 573 ustalono z góry, jednakowe we wszystkich przepisach z losowaniem, i nie dobierano go pod wynik. Ręcznie wybrano liczebności szkół (3–60 uczniów), parametry populacji (średnia 60, SD szkół 5, SD uczniów 12, nachylenie 2, SD nachyleń 1), dwa poziomy ICC (.05 i .30) i liczbę powtórzeń (1000 w przepisach 2 i 5). Cały kod liczy się w kilkanaście sekund.
1. Dane, trzy podejścia i strzałki: Rysunek 1
R
# Rysunek 1. Brak łączenia, pełne łączenie i częściowe łączenie: średnie 18 szkół (dane fikcyjne)
library(ggplot2)
library(lme4)

# Paleta Okabe–Ito (niebieski i cynober rozróżnialne także przy deuteranopii) i prosty motyw
kol <- c(osobne = "#D55E00", model = "#0072B2", jasny = "#56B4E9", ciemny = "grey25")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.05)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Szkoły fikcyjne: liczba uczniów od 3 do 60, wynik testu (punkty) i czas nauki (godz. tygodniowo)
n_szk <- c(3, 4, 5, 6, 8, 10, 12, 15, 18, 20, 25, 30, 35, 40, 45, 50, 55, 60)
J <- length(n_szk); N <- sum(n_szk)
g00 <- 60; tau0 <- 5; b1 <- 2; tau1 <- 1; sigma <- 12   # parametry populacji (ustalone ręcznie)

set.seed(573)                                           # ziarno ustalone raz, bez dobierania pod wynik
u0 <- rnorm(J, 0, tau0); u1 <- rnorm(J, 0, tau1)        # prawdziwe odchylenia szkół
id <- rep(seq_len(J), n_szk)
nauka <- round(runif(N, 0, 10), 1)
wynik <- g00 + u0[id] + (b1 + u1[id]) * (nauka - 5) + rnorm(N, 0, sigma)
dane <- data.frame(szkola = factor(sprintf("S%02d", id)), n = n_szk[id], nauka, nauka_c = nauka - 5, wynik)
c(szkoly = J, uczniowie = N)

# Trzy podejścia do średniej szkoły
m0 <- lmer(wynik ~ 1 + (1 | szkola), data = dane)        # częściowe łączenie (REML)
vc <- as.data.frame(VarCorr(m0))
tau2 <- vc$vcov[1]; sig2 <- vc$vcov[2]
round(c(srednia_wszystkich = mean(dane$wynik), g00_model = fixef(m0)[[1]],
        tau = sqrt(tau2), sigma = sqrt(sig2), ICC = tau2 / (tau2 + sig2)), 3)

szk <- data.frame(szkola = levels(dane$szkola), n = n_szk,
                  osobna = as.vector(tapply(dane$wynik, dane$szkola, mean)),         # brak łączenia
                  model = coef(m0)$szkola[, 1])                                       # częściowe łączenie
szk$przesuniecie <- szk$model - szk$osobna
szk$waga <- tau2 / (tau2 + sig2 / szk$n)        # część odchylenia od średniej, która zostaje
szk$waga_z_danych <- (szk$model - fixef(m0)[[1]]) / (szk$osobna - fixef(m0)[[1]])
print(transform(szk, osobna = round(osobna, 2), model = round(model, 2), przesuniecie = round(przesuniecie, 2),
                waga = round(waga, 3), waga_z_danych = round(waga_z_danych, 3)), row.names = FALSE)
# średnie bezwzględne przesunięcie w szkołach do 10 osób i od 40 osób
round(c(male_do_10 = mean(abs(szk$przesuniecie[szk$n <= 10])),
        duze_od_40 = mean(abs(szk$przesuniecie[szk$n >= 40]))), 2)

szk$etykieta <- factor(szk$n, levels = szk$n)
p1 <- ggplot(szk, aes(etykieta)) +
  geom_hline(yintercept = mean(dane$wynik), linetype = "dashed", colour = kol[["ciemny"]]) +
  geom_segment(aes(y = osobna, yend = model, xend = etykieta), colour = "grey45", linewidth = 0.6,
               arrow = arrow(length = unit(0.16, "cm"), type = "closed")) +
  geom_point(aes(y = osobna, colour = "osobna średnia szkoły", shape = "osobna średnia szkoły"), size = 3, stroke = 1.1) +
  geom_point(aes(y = model, colour = "oszacowanie z modelu mieszanego", shape = "oszacowanie z modelu mieszanego"), size = 2.6) +
  scale_colour_manual(values = c(kol[["osobne"]], kol[["model"]]), name = NULL) +
  scale_shape_manual(values = c(1, 16), name = NULL) +
  labs(x = "Liczba uczniów w szkole (szkoły od najmniejszej)", y = "Średni wynik testu (punkty)",
       title = "Małe szkoły przesuwają się najbardziej",
       subtitle = "Linia przerywana: średnia wszystkich uczniów (pełne łączenie)") + motyw
p1   # zapis: ggsave("model-mieszany-trzy-podejscia.svg", p1, width = 10, height = 5.6)
Wynik w R
   szkoly uczniowie
       18       441
srednia_wszystkich          g00_model                tau              sigma
            60.602             61.034              5.304             13.300
               ICC
             0.137
 szkola  n osobna model przesuniecie  waga waga_z_danych
    S01  3  58.12 60.09         1.97 0.323         0.323
    S02  4  55.99 59.07         3.08 0.389         0.389
    S03  5  62.13 61.52        -0.61 0.443         0.443
    S04  6  57.43 59.28         1.84 0.488         0.488
    S05  8  69.17 65.59        -3.58 0.560         0.560
    S06 10  66.21 64.21        -2.00 0.614         0.614
    S07 12  64.40 63.24        -1.16 0.656         0.656
    S08 15  66.71 65.03        -1.68 0.705         0.705
    S09 18  67.94 66.15        -1.79 0.741         0.741
    S10 20  53.60 55.38         1.78 0.761         0.761
    S11 25  58.39 58.92         0.53 0.799         0.799
    S12 30  53.27 54.62         1.35 0.827         0.827
    S13 35  61.31 61.27        -0.04 0.848         0.848
    S14 40  66.88 66.09        -0.79 0.864         0.864
    S15 45  62.80 62.59        -0.22 0.877         0.877
    S16 50  48.29 49.71         1.42 0.888         0.888
    S17 55  61.18 61.16        -0.01 0.897         0.897
    S18 60  65.06 64.68        -0.38 0.905         0.905
male_do_10 duze_od_40
      2.18       0.57
2. Waga średniej szkoły i błąd w 1000 powtórzeń: Rysunek 2
R
# Rysunek 2. Ile kurczenia przy danej liczebności i czy to się opłaca (kontynuacja: n_szk, J, g00, tau0, sigma,
# szk, tau2, sig2, kol, motyw z bloku 1)
library(patchwork)

# A: waga własnej średniej szkoły w oszacowaniu z modelu, krzywa dla n od 2 do 70
krzywa <- data.frame(n = 2:70)
krzywa$waga <- tau2 / (tau2 + sig2 / krzywa$n)
round(krzywa$waga[krzywa$n %in% c(3, 10, 30, 60)], 3)
krzywa$n[which.min(abs(krzywa$waga - 0.5))]    # liczebność, przy której średnia szkoły i średnia ogólna ważą po połowie

# B: 1000 powtórzeń – nowe szkoły i nowi uczniowie z tej samej populacji (bez czasu nauki)
R <- 1000
set.seed(573)
id <- rep(seq_len(J), n_szk); grupa <- factor(id)
blad <- array(NA, c(R, J, 2), dimnames = list(NULL, n_szk, c("osobna", "model")))
osobliwe <- 0
for (r in seq_len(R)) {
  prawdziwa <- g00 + rnorm(J, 0, tau0)                    # prawdziwe średnie szkół w tym powtórzeniu
  y <- prawdziwa[id] + rnorm(length(id), 0, sigma)
  m <- lmer(y ~ 1 + (1 | grupa), control = lmerControl(calc.derivs = FALSE))
  osobliwe <- osobliwe + isSingular(m)
  blad[r, , "osobna"] <- tapply(y, grupa, mean) - prawdziwa
  blad[r, , "model"] <- coef(m)$grupa[, 1] - prawdziwa
}
rmse <- sqrt(apply(blad^2, c(2, 3), mean))
print(round(cbind(n = n_szk, rmse, model_do_osobnej = rmse[, "model"] / rmse[, "osobna"]), 2), row.names = FALSE)
round(sqrt(colMeans(apply(blad^2, c(2, 3), mean))), 2)    # RMSE dla wszystkich 18 szkół łącznie
c(powtorzenia = R, singular_fit = osobliwe)

pa <- ggplot(krzywa, aes(n, waga)) +
  geom_line(colour = kol[["model"]], linewidth = 1) +
  geom_point(data = szk, colour = kol[["osobne"]], size = 2.4) +
  geom_hline(yintercept = c(0, 1), colour = "grey60") +
  scale_y_continuous(limits = c(0, 1), breaks = seq(0, 1, 0.25)) +
  labs(x = "Liczba uczniów w szkole", y = "Waga średniej szkoły",
       title = "A. Ile zostaje z własnej średniej") + motyw
db <- data.frame(n = rep(n_szk, 2), rmse = c(rmse[, "osobna"], rmse[, "model"]),
                 metoda = rep(c("osobna średnia szkoły", "model mieszany"), each = J))
pb <- ggplot(db, aes(n, rmse, colour = metoda, shape = metoda, linetype = metoda)) +
  geom_line(linewidth = 0.9) + geom_point(size = 2.4) +
  scale_colour_manual(values = c("model mieszany" = kol[["model"]], "osobna średnia szkoły" = kol[["osobne"]]), name = NULL) +
  scale_shape_manual(values = c("model mieszany" = 16, "osobna średnia szkoły" = 1), name = NULL) +
  scale_linetype_manual(values = c("model mieszany" = "solid", "osobna średnia szkoły" = "dashed"), name = NULL) +
  guides(colour = guide_legend(ncol = 1)) +
  labs(x = "Liczba uczniów w szkole", y = "Błąd oszacowania (RMSE, punkty)",
       title = "B. Błąd w 1000 powtórzeń") + motyw
p2 <- pa + pb
p2   # zapis: ggsave("model-mieszany-ile-kurczenia.svg", p2, width = 10, height = 5.4)
Wynik w R
[1] 0.323 0.614 0.827 0.905
[1] 6
    n osobna model model_do_osobnej
3   3   6.92  4.32             0.62
4   4   6.05  3.97             0.66
5   5   5.36  3.88             0.72
6   6   4.83  3.74             0.77
8   8   4.32  3.36             0.78
10 10   3.82  3.21             0.84
12 12   3.50  2.98             0.85
15 15   3.20  2.84             0.89
18 18   2.73  2.50             0.92
20 20   2.70  2.50             0.93
25 25   2.36  2.19             0.93
30 30   2.30  2.16             0.94
35 35   1.96  1.88             0.96
40 40   1.92  1.85             0.96
45 45   1.83  1.74             0.95
50 50   1.59  1.57             0.99
55 55   1.59  1.53             0.97
60 60   1.62  1.57             0.97
osobna  model
  3.62   2.80
 powtorzenia singular_fit
        1000            1
3. Te same losowania, ICC = .05 i .30: Rysunek 3
R
# Rysunek 3. Te same losowania, dwa poziomy ICC (.05 i .30) – kurczenie zależy od proporcji wariancji
# (kontynuacja: n_szk, J, g00, sigma, kol, motyw z bloku 1)
set.seed(573)
id <- rep(seq_len(J), n_szk); grupa <- factor(id)
z_szk <- rnorm(J); e <- rnorm(length(id), 0, sigma)     # wspólne losowania dla obu scenariuszy
scenariusz <- function(icc) {
  tau <- sqrt(icc / (1 - icc)) * sigma                  # odchylenie szkół dające zadane ICC
  y <- g00 + tau * z_szk[id] + e
  m <- lmer(y ~ 1 + (1 | grupa))
  v <- as.data.frame(VarCorr(m))$vcov
  data.frame(scenariusz = sprintf("ICC w populacji = %.2f (oszacowane %.2f)", icc, v[1] / sum(v)),
             n = n_szk, osobna = as.vector(tapply(y, grupa, mean)), model = coef(m)$grupa[, 1],
             srednia = mean(y), waga = v[1] / (v[1] + v[2] / n_szk))
}
d3 <- rbind(scenariusz(.05), scenariusz(.30))
aggregate(cbind(przesuniecie = abs(model - osobna), waga) ~ scenariusz + (n <= 10), data = d3,
          FUN = function(x) round(mean(x), 2))
# rozrzut średnich szkół (SD) przed i po kurczeniu
aggregate(cbind(osobna, model) ~ scenariusz, data = d3, FUN = function(x) round(sd(x), 2))

d3$etykieta <- factor(d3$n, levels = n_szk)
p3 <- ggplot(d3, aes(etykieta)) +
  geom_hline(aes(yintercept = srednia), linetype = "dashed", colour = kol[["ciemny"]]) +
  geom_segment(aes(y = osobna, yend = model, xend = etykieta), colour = "grey45", linewidth = 0.55,
               arrow = arrow(length = unit(0.14, "cm"), type = "closed")) +
  geom_point(aes(y = osobna, colour = "osobna średnia szkoły", shape = "osobna średnia szkoły"), size = 2.6, stroke = 1) +
  geom_point(aes(y = model, colour = "oszacowanie z modelu", shape = "oszacowanie z modelu"), size = 2.2) +
  facet_wrap(~ scenariusz, ncol = 1) +
  scale_colour_manual(values = c(kol[["osobne"]], kol[["model"]]), name = NULL) +
  scale_shape_manual(values = c(1, 16), name = NULL) +
  labs(x = "Liczba uczniów w szkole", y = "Średni wynik testu (punkty)",
       title = "Słabe różnice między szkołami – silne kurczenie") + motyw
p3   # zapis: ggsave("model-mieszany-kurczenie-a-icc.svg", p3, width = 10, height = 7.4)
Wynik w R
                                scenariusz n <= 10 przesuniecie waga
1 ICC w populacji = 0.05 (oszacowane 0.03)   FALSE         1.11 0.49
2 ICC w populacji = 0.30 (oszacowane 0.28)   FALSE         0.52 0.91
3 ICC w populacji = 0.05 (oszacowane 0.03)    TRUE         5.45 0.16
4 ICC w populacji = 0.30 (oszacowane 0.28)    TRUE         3.00 0.67
                                scenariusz osobna model
1 ICC w populacji = 0.05 (oszacowane 0.03)   5.15  1.34
2 ICC w populacji = 0.30 (oszacowane 0.28)   8.48  6.91
4. Losowe nachylenia: Rysunek 4
R
# Rysunek 4. Losowe nachylenia: osobne proste w szkołach vs proste z modelu mieszanego
# (kontynuacja: dane, b1, tau1, kol, motyw z bloku 1)
m1 <- lmer(wynik ~ nauka_c + (1 + nauka_c | szkola), data = dane)   # czas nauki wyśrodkowany na 5 godz.
round(fixef(m1), 2)
print(VarCorr(m1), comp = "Std.Dev.", digits = 3)
isSingular(m1)

osobne <- t(sapply(split(dane, dane$szkola), function(d) coef(lm(wynik ~ nauka_c, data = d))))
z_modelu <- as.matrix(coef(m1)$szkola)
nach <- data.frame(n = n_szk, osobne = osobne[, 2], model = z_modelu[, 2])
print(round(nach, 2), row.names = FALSE)
round(c(SD_osobnych = sd(nach$osobne), SD_z_modelu = sd(nach$model), tau1_oszacowane = attr(VarCorr(m1)$szkola, "stddev")[[2]],
        zakres_osobnych = range(nach$osobne), zakres_z_modelu = range(nach$model)), 2)

siatka <- expand.grid(nauka = c(0, 10), szkola = levels(dane$szkola))
siatka$n <- n_szk[as.integer(siatka$szkola)]
proste <- rbind(
  data.frame(siatka, podejscie = "Osobna regresja w każdej szkole",
             wynik = osobne[siatka$szkola, 1] + osobne[siatka$szkola, 2] * (siatka$nauka - 5)),
  data.frame(siatka, podejscie = "Model mieszany (losowe nachylenia)",
             wynik = z_modelu[siatka$szkola, 1] + z_modelu[siatka$szkola, 2] * (siatka$nauka - 5)))
proste$podejscie <- factor(proste$podejscie, levels = unique(proste$podejscie))
proste$wielkosc <- ifelse(proste$n <= 10, "szkoła do 10 uczniów", "szkoła powyżej 10 uczniów")
p4 <- ggplot(proste, aes(nauka, wynik, group = szkola, colour = wielkosc, linetype = wielkosc)) +
  geom_line(linewidth = 0.8) +
  facet_wrap(~ podejscie) +
  scale_colour_manual(values = c("szkoła do 10 uczniów" = kol[["osobne"]], "szkoła powyżej 10 uczniów" = kol[["model"]]), name = NULL) +
  scale_linetype_manual(values = c("szkoła do 10 uczniów" = "22", "szkoła powyżej 10 uczniów" = "solid"), name = NULL) +
  scale_x_continuous(breaks = seq(0, 10, 2)) +
  labs(x = "Czas nauki (godziny tygodniowo)", y = "Przewidywany wynik testu (punkty)",
       title = "Wachlarz prostych: osobno i z modelu") + motyw
p4   # zapis: ggsave("model-mieszany-losowe-nachylenia.svg", p4, width = 10, height = 5.6)
Wynik w R
(Intercept)     nauka_c
      61.38        1.92
 Groups   Name        Std.Dev. Corr
 szkola   (Intercept)  5.51
          nauka_c      1.90    -0.13
 Residual             11.26
[1] FALSE
  n osobne model
  3  -4.04  1.48
  4   7.72  4.61
  5   5.13  3.67
  6   0.51  1.24
  8  -2.33 -1.15
 10   3.21  2.69
 12   0.98  1.16
 15   3.05  2.83
 18   2.09  1.96
 20   1.38  1.46
 25  -1.26 -0.57
 30   5.56  5.17
 35   2.89  2.78
 40   1.64  1.63
 45   2.95  2.86
 50   1.27  1.31
 55   1.59  1.61
 60  -0.42 -0.26
     SD_osobnych      SD_z_modelu  tau1_oszacowane zakres_osobnych1
            2.81             1.65             1.90            -4.04
zakres_osobnych2 zakres_z_modelu1 zakres_z_modelu2
            7.72            -1.15             5.17
5. Wykres gąsienicowy i niepewność rankingu: Rysunek 5
R
# Rysunek 5. Efekty losowe szkół z 95% przedziałami (wykres „gąsienicowy”) i niepewność miejsca w rankingu
# (kontynuacja: m0, dane, n_szk, J, g00, b1, u0, u1, sigma, kol, motyw z bloku 1)
re <- as.data.frame(ranef(m0, condVar = TRUE))             # oszacowania i warunkowe SD efektów losowych
re$n <- n_szk[match(re$grp, levels(dane$szkola))]
re$dolna <- re$condval - 1.96 * re$condsd; re$gorna <- re$condval + 1.96 * re$condsd
re$wzgledem_sredniej <- ifelse(re$dolna > 0, "powyżej średniej", ifelse(re$gorna < 0, "poniżej średniej", "nie odróżnia się"))
table(re$wzgledem_sredniej)
re$miejsce <- rank(-re$condval)                            # 1 = najwyższy wynik

# 1000 kolejnych roczników z tych samych szkół: prawdziwe efekty szkół stałe, nowi uczniowie
R <- 1000
set.seed(573)
id <- rep(seq_len(J), n_szk); grupa <- factor(id)
miejsca <- matrix(NA, R, J)
for (r in seq_len(R)) {
  nauka_r <- runif(length(id), 0, 10)
  y <- g00 + u0[id] + (b1 + u1[id]) * (nauka_r - 5) + rnorm(length(id), 0, sigma)
  m <- lmer(y ~ 1 + (1 | grupa), control = lmerControl(calc.derivs = FALSE))
  miejsca[r, ] <- rank(-ranef(m)$grupa[, 1], ties.method = "random")
}
re$m_dolna <- apply(miejsca, 2, quantile, .025, type = 1); re$m_gorna <- apply(miejsca, 2, quantile, .975, type = 1)
re$prawdziwe <- rank(-u0)                                  # miejsce według prawdziwych efektów szkół
re$top3 <- colMeans(miejsca <= 3)                          # jak często szkoła trafia do pierwszej trójki
print(transform(re[order(re$miejsce), c("grp", "n", "condval", "condsd", "miejsce", "prawdziwe", "m_dolna", "m_gorna", "top3")],
                condval = round(condval, 2), condsd = round(condsd, 2), top3 = round(top3, 3)), row.names = FALSE)
round(c(mediana_szerokosci_zakresu_miejsc = median(re$m_gorna - re$m_dolna + 1),
        korelacja_Spearmana_z_prawdziwym = cor(re$miejsce, re$prawdziwe, method = "spearman")), 2)

re$etykieta <- factor(sprintf("%s (n = %d)", re$grp, re$n), levels = sprintf("%s (n = %d)", re$grp, re$n)[order(-re$miejsce)])
pa <- ggplot(re, aes(condval, etykieta, colour = wzgledem_sredniej, shape = wzgledem_sredniej)) +
  geom_vline(xintercept = 0, linetype = "dashed", colour = kol[["ciemny"]]) +
  geom_linerange(aes(xmin = dolna, xmax = gorna), linewidth = 0.8) +
  geom_point(size = 2.4) +
  scale_colour_manual(values = c("nie odróżnia się" = "grey50", "powyżej średniej" = kol[["model"]],
                                 "poniżej średniej" = kol[["osobne"]]), name = NULL) +
  scale_shape_manual(values = c("nie odróżnia się" = 1, "powyżej średniej" = 17, "poniżej średniej" = 15), name = NULL) +
  guides(colour = guide_legend(nrow = 1)) +
  labs(x = "Odchylenie od średniej (punkty)", y = NULL, title = "A. Efekty losowe z 95% CI") + motyw
pb <- ggplot(re, aes(miejsce, etykieta)) +
  geom_linerange(aes(xmin = m_dolna, xmax = m_gorna), linewidth = 0.8, colour = kol[["jasny"]]) +
  geom_point(size = 2.4, colour = kol[["ciemny"]]) +
  scale_x_continuous(breaks = c(1, 6, 12, 18), limits = c(1, 18)) +
  labs(x = "Miejsce (1 = najwyższy wynik)", y = NULL, title = "B. Miejsce w 1000 rocznikach") +
  motyw + theme(axis.text.y = element_blank())
p5 <- pa + pb + plot_layout(widths = c(1.15, 1), guides = "collect") & theme(legend.position = "bottom")
p5   # zapis: ggsave("model-mieszany-efekty-losowe-ranking.svg", p5, width = 10, height = 6.6)
Wynik w R
nie odróżnia się poniżej średniej powyżej średniej
              13                3                2
 grp  n condval condsd miejsce prawdziwe m_dolna m_gorna  top3
 S09 18    5.12   2.70       1         8       2      15 0.133
 S14 40    5.05   1.95       2         1       1       6 0.849
 S05  8    4.56   3.52       3         4       1      13 0.334
 S08 15    4.00   2.88       4         3       1      12 0.462
 S18 60    3.65   1.63       5        10       5      15 0.012
 S06 10    3.18   3.30       6         5       1      14 0.328
 S07 12    2.21   3.11       7         7       2      15 0.139
 S15 45    1.55   1.86       8        12       4      16 0.014
 S03  5    0.49   3.96       9         2       1      15 0.309
 S13 35    0.23   2.07      10         6       1      13 0.226
 S17 55    0.13   1.70      11        11       4      15 0.010
 S01  3   -0.94   4.36      12        14       2      17 0.048
 S04  6   -1.76   3.79      13         9       2      15 0.111
 S02  4   -1.96   4.15      14        15       4      17 0.022
 S11 25   -2.11   2.38      15        13       6      17 0.003
 S10 20   -5.65   2.59      16        16      10      17 0.000
 S12 30   -6.42   2.21      17        17      11      18 0.000
 S16 50  -11.32   1.77      18        18      17      18 0.000
mediana_szerokosci_zakresu_miejsc  korelacja_Spearmana_z_prawdziwym
                            13.00                              0.81
6. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("cynober – niebieski (osobna / model)" = c("#D55E00", "#0072B2"),
             "jasnoniebieski – grafit (zakres miejsc / punkt)" = c("#56B4E9", "#3F3F3F"),
             "cynober – szary (poniżej / bez różnicy)" = c("#D55E00", "#7F7F7F"),
             "niebieski – szary (powyżej / bez różnicy)" = c("#0072B2", "#7F7F7F"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                widzenie_typowe deuteranopia
cynober – niebieski (osobna / model)                      114.6        108.3
jasnoniebieski – grafit (zakres miejsc / punkt)            56.7         56.0
cynober – szary (poniżej / bez różnicy)                    76.7         62.8
niebieski – szary (powyżej / bez różnicy)                  42.1         45.8
czerwony – zielony (do unikania)                          121.7         21.1
                                                protanopia
cynober – niebieski (osobna / model)                  91.9
jasnoniebieski – grafit (zakres miejsc / punkt)       56.1
cynober – szary (poniżej / bez różnicy)               54.1
niebieski – szary (powyżej / bez różnicy)             38.4
czerwony – zielony (do unikania)                      31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Modele mieszane dopasowano pakietem lme4 (funkcja lmer(), REML), osobne regresje i losowania – pakietem stats. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- Porównywanie średnich z arkusza z oszacowaniami z modelu jako „błąd programu”. Różnica to kurczenie (rysunek 1).
- Ranking grup z efektów losowych bez przedziałów. Pokaż przedziały i nie numeruj miejsc (rysunek 5).
- Wniosek „małe szkoły są przeciętne”. Oszacowania małych grup leżą blisko średniej, bo mają mało danych, a nie dlatego, że są przeciętne (rysunek 2).
- Liczenie wariancji nachyleń z narysowanych prostych. Weź ją z wydruku – proste są skurczone (rysunek 4).
- Pominięcie modelu mieszanego, bo ICC jest małe. Kurczenie przy małym ICC jest silne, ale grupowanie nadal zmienia błędy standardowe (rysunek 3).
- Brak informacji o liczebnościach grup. Na wykresie efektów losowych podaj n przy każdej grupie.
Najczęstsze pytania
Co to jest kurczenie do średniej w modelu mieszanym?
To przesunięcie oszacowań poszczególnych grup (np. szkół) w stronę średniej ogólnej. Model mieszany łączy informację z danej grupy z informacją o wszystkich grupach, więc oszacowanie leży między średnią grupy a średnią ogólną. W przykładzie z 18 szkołami oszacowania w szkołach do 10 uczniów przesunęły się średnio o 2.18 punktu, a w szkołach od 40 uczniów – o 0.57.
Dlaczego małe grupy są silniej ściągane do średniej?
Bo ich średnia opiera się na niewielu osobach i jest mało precyzyjna. Waga własnej średniej grupy wynosi τ² / (τ² + σ²/n), więc rośnie z liczebnością. W przykładzie przy ICC = .14 wynosiła .32 przy 3 uczniach, .61 przy 10 i .91 przy 60. Przy niższym ICC kurczenie jest jeszcze silniejsze.
Czy kurczenie do średniej zniekształca wyniki?
Wprowadza niewielkie obciążenie: naprawdę wyjątkowa grupa zostanie trochę „uśredniona”. W zamian zmniejsza rozrzut oszacowań. W symulacji 1000 powtórzeń średni błąd (RMSE) oszacowań z modelu wyniósł 2.80 punktu, a osobnych średnich – 3.62; dla szkoły z 3 uczniami 4.32 wobec 6.92. Zysk jest średni, nie gwarantowany dla każdej grupy.
Jak narysować efekty losowe w R?
Funkcja ranef(model, condVar = TRUE) z pakietu lme4 zwraca oszacowania efektów losowych i ich warunkowe odchylenia standardowe. Po zamianie na ramkę danych (as.data.frame()) narysujesz w ggplot2 wykres gąsienicowy: punkt i 95% przedział dla każdej grupy, z liczebnością grupy w etykiecie.
Czy z efektów losowych można zrobić ranking szkół?
Lepiej nie. W przykładzie tylko 5 z 18 szkół odróżniało się od średniej, a szkoła pierwsza w danych zajmowała w 1000 symulowanych rocznikach miejsca od 2 do 15. Pokaż efekty z przedziałami i opisz, które grupy odstają od średniej, zamiast numerować miejsca (Leckie i Goldstein, 2009).
Powiązane hasła
Przeczytaj też
Model wielopoziomowy krok po kroku w R
Pięć modeli na danych o pracownikach w zespołach: ICC, centrowanie CWC i CGM, losowe nachylenia, interakcja międzypoziomowa, REML a ML i wzór raportu.
Czytaj →PoradnikJak opisać wyniki modelu mieszanego
Co przepisać z wydruku lmer do pracy: struktura modelu, REML, df Satterthwaite’a, efekty stałe z CI, wariancje losowe, ICC i R² Nakagawy – z tabelą APA i wzorami zdań.
Czytaj →PoradnikDane podłużne na wykresie
Wykres spaghetti, średnie z 95% CI i liczbą osób, rzeczywista oś czasu i trajektorie z modelu mieszanego – sześć rysunków z kodem R i podpisami.
Czytaj →Masz dane zagnieżdżone i nie wiesz, jak je przeanalizować?
Pomożemy dobrać strukturę modelu mieszanego, przygotować czytelne rysunki efektów losowych i opisać wyniki tak, żebyś umiał(a) je wyjaśnić promotorowi i recenzentowi.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Aarts, E., Verhage, M., Veenvliet, J. V., Dolan, C. V., & van der Sluis, S. (2014). A solution to dependency: Using multilevel analysis to accommodate nested data. Nature Neuroscience, 17(4), 491–496. https://doi.org/10.1038/nn.3648
- Barr, D. J., Levy, R., Scheepers, C., & Tily, H. J. (2013). Random effects structure for confirmatory hypothesis testing: Keep it maximal. Journal of Memory and Language, 68(3), 255–278. https://doi.org/10.1016/j.jml.2012.11.001 ● Otwarty dostęp: pełny tekst
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01 ● Otwarty dostęp
- Hox, J. J., Moerbeek, M., & van de Schoot, R. (2017). Multilevel analysis: Techniques and applications (3rd ed.). Routledge. https://doi.org/10.4324/9781315650982
- Leckie, G., & Goldstein, H. (2009). The limitations of using school league tables to inform school choice. Journal of the Royal Statistical Society: Series A (Statistics in Society), 172(4), 835–851. https://doi.org/10.1111/j.1467-985x.2009.00597.x
- McNeish, D. (2017). Small sample methods for multilevel modeling: A colloquial elucidation of REML and the Kenward-Roger correction. Multivariate Behavioral Research, 52(5), 661–670. https://doi.org/10.1080/00273171.2017.1344538
Cytowania BibTeX
@article{aarts2014solution, author={Aarts, Emmeke and Verhage, Matthijs and Veenvliet, Jesse V. and Dolan, Conor V. and van der Sluis, Sophie}, title={{A solution to dependency: Using multilevel analysis to accommodate nested data}}, journal={Nature Neuroscience}, year={2014}, volume={17}, number={4}, pages={491--496}, doi={10.1038/nn.3648}}@article{barr2013random, author={Barr, Dale J. and Levy, Roger and Scheepers, Christoph and Tily, Harry J.}, title={{Random effects structure for confirmatory hypothesis testing: Keep it maximal}}, journal={Journal of Memory and Language}, year={2013}, volume={68}, number={3}, pages={255--278}, doi={10.1016/j.jml.2012.11.001}}@article{bates2015fitting, author={Bates, Douglas and Mächler, Martin and Bolker, Ben and Walker, Steve}, title={{Fitting linear mixed-effects models using lme4}}, journal={Journal of Statistical Software}, year={2015}, volume={67}, number={1}, pages={1--48}, doi={10.18637/jss.v067.i01}}@book{hox2017multilevel, author={Hox, Joop J. and Moerbeek, Mirjam and van de Schoot, Rens}, title={{Multilevel analysis: Techniques and applications (3rd ed.)}}, year={2017}, publisher={Routledge}, doi={10.4324/9781315650982}}@article{leckie2009limitations, author={Leckie, George and Goldstein, Harvey}, title={{The limitations of using school league tables to inform school choice}}, journal={Journal of the Royal Statistical Society: Series A (Statistics in Society)}, year={2009}, volume={172}, number={4}, pages={835--851}, doi={10.1111/j.1467-985x.2009.00597.x}}@article{mcneish2017small, author={McNeish, Daniel}, title={{Small sample methods for multilevel modeling: A colloquial elucidation of REML and the Kenward-Roger correction}}, journal={Multivariate Behavioral Research}, year={2017}, volume={52}, number={5}, pages={661--670}, doi={10.1080/00273171.2017.1344538}}