Dwa modele, dwa pytania
Masz pomiary powtarzane u tych samych osób albo pacjentów zebranych w oddziałach. Wiesz już, że obserwacje nie są niezależne i że zwykła regresja nie wystarczy. Pozostaje wybór między dwiema rodzinami metod. Pierwsza to uogólnione równania estymujące (GEE) Lianga i Zegera (1986). Druga to model mieszany, czyli dla wyniku binarnego lub zliczeniowego uogólniony liniowy model mieszany (GLMM).
Wybór nie sprowadza się do tego, który model jest „lepszy”. Oba modele szacują inne parametry:
- GEE – efekt brzegowy (ang. population-averaged): o ile zmienia się odsetek zdarzeń w całej populacji, gdy zmienia się predyktor. Zależność między pomiarami jest tu przeszkodą, którą trzeba uwzględnić w błędach standardowych.
- GLMM – efekt warunkowy (ang. subject-specific): jak zmienia się szansa zdarzenia u tej samej osoby lub w tym samym klastrze. Zależność opisuje efekt losowy, który jest częścią modelu.
Zeger i in. (1988) opisali to rozróżnienie dla danych podłużnych. Wpis o wielopoziomowej regresji logistycznej pokazuje je na pacjentach w szpitalach. Tutaj interesują nas inne kwestie: macierz robocza, błędy przy małej liczbie klastrów i braki danych. Jeśli wynik jest ciągły, a dylemat dotyczy ANOVA, zacznij od wpisu ANOVA z powtarzanymi pomiarami czy model mieszany.
Przykład: terapia bezsenności, cztery pomiary
Osiemdziesiąt osób z bezsennością przydzielono do programu terapii (n = 40) albo do grupy kontrolnej (n = 40). Co cztery tygodnie, w czterech pomiarach (czas = 0, 1, 2, 3), notowano, czy objawy są klinicznie istotne (tak/nie), oraz nasilenie objawów w punktach. Dane są symulowane (set.seed(3201)) z modelu warunkowego, w którym osoby bardzo różnią się skłonnością do objawów (SD losowego wyrazu wolnego = 2). Możesz je pobrać jako plik CSV (320 wierszy).
| Grupa | Pomiar 0 | Pomiar 1 | Pomiar 2 | Pomiar 3 |
|---|---|---|---|---|
| Kontrolna | 60.0% | 62.5% | 60.0% | 62.5% |
| Program | 65.0% | 52.5% | 45.0% | 27.5% |
Oba modele mają te same efekty stałe: czas, grupę i interakcję czas × grupa. GLMM dopasowano funkcją glmer() z losowym wyrazem wolnym osoby i kwadraturą (nAGQ = 10). Oszacowane SD efektu losowego wyniosło 1.55, co daje ICC na skali ukrytej .42. GEE z roboczą macierzą niezależności liczymy jako glm() z kanapkowym błędem odpornym na klastrowanie (pakiet sandwich; Zeileis i in., 2020). Przy macierzy niezależności równania estymujące GEE są równaniami wiarygodności zwykłego glm, więc oszacowania są identyczne. Błąd Lianga–Zegera to vcovCL(type = "HC0", cadjust = FALSE). Sprawdziliśmy to, licząc estymator kanapkowy ręcznie i funkcją geepack::geeglm() (przepis 5): oszacowania i błędy standardowe były zgodne do czwartego miejsca po przecinku.
Ilorazy szans z GEE i GLMM
| Efekt | GLMM: OR warunkowy [95% CI] | GEE: OR brzegowy [95% CI] | Przybliżenie z GLMM |
|---|---|---|---|
| Zmiana na pomiar, grupa kontrolna | 1.03 [0.73, 1.46] | 1.02 [0.82, 1.28] | 1.02 |
| Zmiana na pomiar, program | 0.50 [0.35, 0.72] | 0.61 [0.46, 0.81] | 0.60 |
| Interakcja czas × grupa | 0.49 [0.29, 0.80], p = .005 | 0.59 [0.41, 0.85], p = .005 | 0.59 |
Wnioski z obu modeli są zgodne: w programie objawów ubywa, w grupie kontrolnej nie. Liczby się jednak różnią. W GLMM szansa objawów u danej osoby spada z każdym pomiarem o połowę (OR = 0.50). W GEE szansa w całej grupie programu spada o 39% (OR = 0.61). To nie błąd żadnego z modeli. Iloraz szans nie jest kolapsowalny: średnia krzywych logistycznych dla osób o różnej skłonności jest bardziej płaska niż krzywa każdej z nich. Zeger i in. (1988) pokazali, że przy normalnym efekcie losowym współczynnik brzegowy to w przybliżeniu współczynnik warunkowy podzielony przez √(1 + 0.346 τ²). Tu daje to 0.60, prawie tyle co GEE.
Różnicę widać też w prawdopodobieństwach. W ostatnim pomiarze programu GLMM przewiduje 23.6% objawów dla „typowej osoby” (efekt losowy = 0). Uśrednienie po rozkładzie efektów losowych daje 30.4%, GEE 29.7%, a w danych było 27.5%. Do pytań o politykę zdrowotną („jaki odsetek pacjentów skorzysta”) pasuje efekt brzegowy. Do pytań o przebieg u jednostki pasuje warunkowy. Hubbard i in. (2010) bronią podejścia brzegowego, bo opiera się na mniejszej liczbie nieweryfikowalnych założeń o rozkładzie efektów losowych.
Dla wyniku ciągłego i funkcji tożsamościowej problem znika. W tym samym przykładzie nasilenie objawów analizowano przez lm, gls ze stałą korelacją pomiarów (odpowiednik GEE z macierzą wymienną) i lmer. Wszystkie trzy dały ten sam współczynnik interakcji, −1.26 pkt na pomiar.
Robocza macierz korelacji i błąd kanapkowy
GEE wymaga podania roboczej macierzy korelacji pomiarów w klastrze. Najczęstsze to niezależność, macierz wymienna (stała korelacja), AR(1) i macierz bez ograniczeń. Liang i Zeger (1986) pokazali, że oszacowania współczynników i ich wariancji pozostają zgodne przy łagodnych założeniach, nawet gdy macierz robocza jest zła. Warunek: błąd standardowy liczony jest estymatorem kanapkowym, który bierze kowariancję reszt z danych. Dobra macierz robocza zwiększa efektywność, ale nie decyduje o poprawności.
| Metoda | SE interakcji (wynik 0/1, logity) | SE interakcji (nasilenie, pkt) |
|---|---|---|
Zwykły glm / lm (naiwny) | 0.209 | 0.389 |
| GEE niezależność: kanapkowy HC0 | 0.185 | 0.240 |
| Kanapkowy HC0 z poprawką G/(G − 1) | 0.186 | – |
| Kanapkowy CR2 (clubSandwich) | 0.187 | 0.243 (gls, macierz wymienna) |
Modelowy (gls wymienna, lmer) | – | 0.261 |
Zwróć uwagę na kierunek różnicy. Czas zmienia się wewnątrz osoby, więc naiwny błąd jest tu za duży, a nie za mały. Dla predyktorów zmieniających się między klastrami, np. grupy, ignorowanie zależności zaniża błąd. Ta sama logika stoi za błędami odpornymi na klastrowanie w zwykłej regresji. Różnią się od błędów HC3, które chronią tylko przed heteroskedastycznością.
Mała liczba klastrów: CR2 zamiast HC0
Estymator kanapkowy jest asymptotyczny: działa dobrze, gdy klastrów jest dużo. Liczy się liczba klastrów, a nie obserwacji. Mancl i DeRouen (2001) pokazali, że przy 10–40 klastrach testy z odpornym błędem GEE mogą odrzucać prawdziwą hipotezę zerową 2–3 razy częściej niż deklarowane 5%. Zaproponowali estymator z korektą obciążenia. W R bez pakietu do GEE podobną rolę pełni poprawka CR2 ze stopniami swobody Satterthwaite'a z pakietu clubSandwich (Pustejovsky i Tipton, 2018), dostępna także dla obiektów glm i gls.
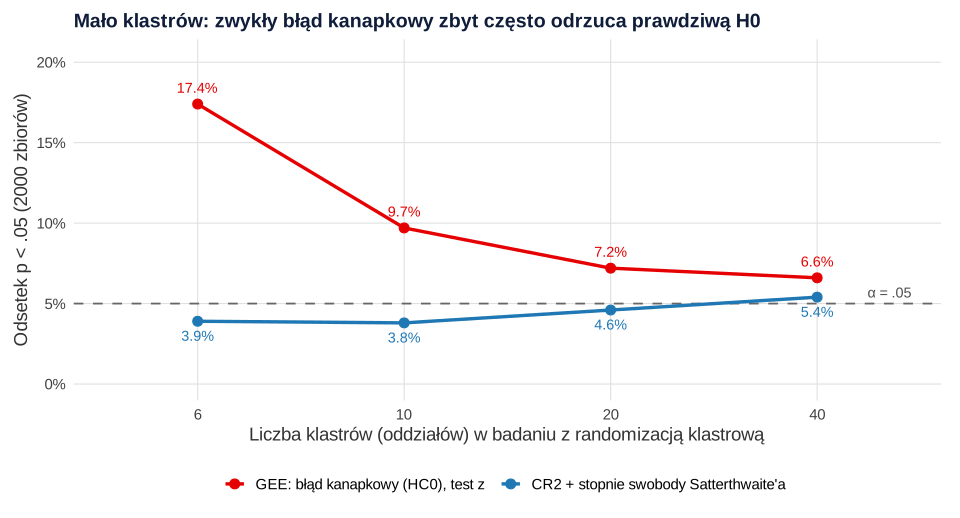
Przy sześciu oddziałach zwykły test z z błędem kanapkowym dawał 17.4% błędów pierwszego rodzaju, a przy dziesięciu 9.7%. Nawet przy 40 klastrach odsetek wynosił 6.6%. CR2 z testem t o stopniach swobody bliskich liczbie klastrów minus dwa utrzymał go między 3.8% a 5.4%. W przykładzie z bezsennością mamy 80 klastrów, więc poprawka prawie nic nie zmienia: t(77.9) = −2.79, p = .007 wobec z = −2.83, p = .005. Przy kilkunastu szkołach lub oddziałach różnica może jednak zmienić wniosek.
Braki danych: GEE wymaga MCAR, model mieszany MAR
W badaniach podłużnych uczestnicy odpadają (utrata uczestników), a wypadanie rzadko jest czysto losowe. Według klasyfikacji Rubina (1976) braki są MAR, gdy prawdopodobieństwo braku zależy tylko od danych obserwowanych, np. od wyniku w poprzednim pomiarze. Przy MAR wnioskowanie oparte na wiarygodności pozostaje ważne. Model mieszany dopasowany metodą największej wiarygodności korzysta ze wszystkich dostępnych pomiarów i nie wymaga usuwania osób. GEE nie jest metodą wiarygodnościową, więc bez dodatkowych kroków wymaga MCAR. Robins i in. (1995) zaproponowali ważone GEE, w którym każda obserwacja dostaje wagę równą odwrotności prawdopodobieństwa pozostania w badaniu (wagi IPW). Takie GEE działa przy MAR.
Sprawdziliśmy to symulacją: 200 osób, ten sam model co w przykładzie, 500 zbiorów na scenariusz. W grupie kontrolnej prawdziwa zmiana w czasie wynosi 0. Po każdym pomiarze osoba mogła odpaść. Przy MCAR prawdopodobieństwo było stałe (.15). Przy MAR wynosiło .30, gdy w ostatnim pomiarze osoba miała objawy, i .03, gdy ich nie miała. Komplet pomiarów miało średnio 61.4% osób przy MCAR i 55.1% przy MAR.
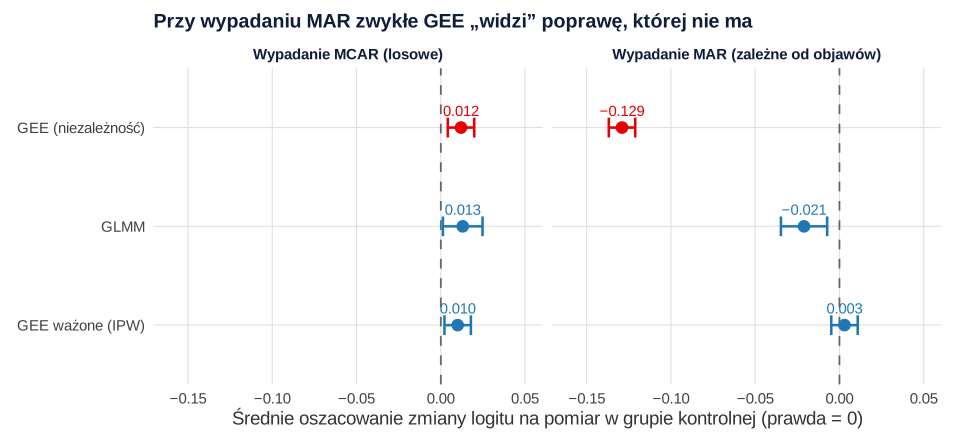
Przy MCAR wszystkie trzy metody dały oszacowania bliskie zeru (od 0.010 do 0.013). Przy MAR zwykłe GEE pokazało średnio −0.129 logita na pomiar. To pozorna poprawa: osoby z objawami częściej odpadały, więc w późnych pomiarach zostawały głównie osoby bez objawów. Model mieszany dał −0.021, a GEE ważone 0.003. Niewielkie odchylenie GLMM wynika prawdopodobnie z przybliżenia Laplace'a przy dużej wariancji efektu losowego. Interakcja była mało wrażliwa, bo wypadanie działało podobnie w obu grupach. W każdej metodzie obciążenie nie przekroczyło 3.1% wartości docelowej (−0.48 dla modeli brzegowych, −0.80 dla warunkowego). Nie licz jednak na to: przy wypadaniu zależnym od grupy obciążenie trafi wprost w efekt leczenia. Zamiast wag możesz użyć imputacji wielokrotnej. Żadna z tych metod nie chroni przed brakami MNAR. Do nich potrzebna jest analiza wrażliwości.
Wybór macierzy roboczej i QIC
GEE nie ma funkcji wiarygodności, więc nie można policzyć AIC. Pan (2001) zaproponował QIC (ang. quasi-likelihood under the independence model criterion). W QIC wiarygodność zastępuje quasi-wiarygodność liczona przy macierzy niezależności, a kara uwzględnia odporną macierz kowariancji. W praktyce QIC porównuje się dla różnych macierzy roboczych przy tych samych predyktorach albo różnych zestawów predyktorów (wariant QICu). Niższa wartość wskazuje lepszą macierz. Traktuj go jako wskazówkę, a nie test. Ponieważ błąd kanapkowy chroni przed złą macierzą, wybór przy dużej liczbie klastrów zmienia głównie efektywność. Przy małej liczbie klastrów i wielu pomiarach bogata macierz (bez ograniczeń) bywa niestabilna. Prostszą macierz łatwiej wtedy uzasadnić. W przykładzie funkcja geepack::QIC() daje 433.86 dla macierzy niezależności, 433.88 dla wymiennej (α = 0.29) i 434.05 dla AR(1) (α = 0.41). Różnice są pomijalne. Współczynnik interakcji prawie się nie zmienia: −0.523 przy macierzy niezależności i wymiennej oraz −0.543 przy AR(1), z odpornym błędem 0.185–0.186. Wybór macierzy roboczej nie wpływa więc tu na wnioski.
Kiedy który model
| Pytanie lub sytuacja | GEE | Model mieszany (GLMM) |
|---|---|---|
| Co opisuje współczynnik | efekt brzegowy, średni w populacji | efekt warunkowy, dla osoby lub klastra |
| Zmienność między klastrami | tylko „przeszkadza”, nie jest szacowana | wariancje efektów losowych, ICC, przewidywania dla klastrów |
| Założenia o rozkładzie | model średniej i macierz robocza (może być zła) | pełny model, w tym rozkład efektów losowych |
| Braki danych | MCAR; przy MAR wagi IPW lub imputacja | MAR, jeśli model jest poprawny |
| Mało klastrów (np. < 40) | poprawka CR2 lub Mancla–DeRouena | niestabilne wariancje, metody małej próby (REML, Kenward–Roger przy LMM) |
| Wynik ciągły, funkcja tożsamościowa | efekty stałe mają tę samą interpretację – różnią się głównie błędy i obsługa braków | |
Jeśli interesuje Cię cała struktura wielopoziomowa, losowe nachylenia albo interakcje międzypoziomowe, wybierz model mieszany (zob. model wielopoziomowy krok po kroku). Jeśli pytasz o średni efekt interwencji w populacji, a klastrów jest dużo i braki są nieliczne, GEE jest prostsze i mniej zależne od założeń. Gdy analizujesz schemat podłużny z wyraźnym wypadaniem, przewaga przechodzi na model mieszany albo GEE z wagami. W danych panelowych z ekonomii podobną rolę pełnią modele z efektami stałymi.
Jak opisać wybór w artykule
Napisz, który parametr szacujesz (brzegowy czy warunkowy) i dlaczego. Dla GEE podaj funkcję łączącą, macierz roboczą, rodzaj błędu standardowego i liczbę klastrów. Dla GLMM podaj strukturę efektów losowych i metodę przybliżenia. W obu przypadkach opisz braki danych i przyjęte założenie o ich mechanizmie.
Jeśli recenzent kwestionuje wybór modelu albo błędy przy małej liczbie klastrów, możemy wspólnie sprawdzić analizę w ramach wsparcia statystycznego dla badaczy.
Przykład w R
Pięć przepisów uruchamianych po kolei w jednej sesji R. Pierwszy tworzy plik gee-bezsennosc-dane.csv (możesz go pobrać tutaj). Potrzebne pakiety: lme4, sandwich, lmtest, clubSandwich, nlme i geepack.
1. Dane, GLMM i GEE z macierzą niezależności
R
# Dane symulowane: 80 osób z bezsennością (40 w programie terapii, 40 w grupie kontrolnej),
# 4 pomiary co 4 tygodnie (czas = 0, 1, 2, 3).
# bezsennosc: 1 = objawy klinicznie istotne, 0 = brak; nasilenie: wynik ciągły (punkty).
suppressPackageStartupMessages({library(lme4); library(sandwich); library(lmtest)})
set.seed(3201)
n_os <- 80
osoby <- data.frame(id = factor(sprintf("o%02d", 1:n_os)), grupa = rep(0:1, each = n_os / 2),
                    u = rnorm(n_os, 0, 2))                     # skłonność osoby (losowy wyraz wolny, SD = 2)
dane <- osoby[rep(1:n_os, each = 4), ]
dane$czas <- rep(0:3, n_os)
eta <- 1 + 0 * dane$czas + 0 * dane$grupa - 0.8 * dane$czas * dane$grupa + dane$u   # model warunkowy (logit)
dane$bezsennosc <- rbinom(nrow(dane), 1, plogis(eta))
dane$nasilenie <- round(16 + 1.5 * dane$u - 0.3 * dane$czas - 1.5 * dane$czas * dane$grupa + rnorm(nrow(dane), 0, 2.5), 1)
dane$u <- NULL
write.csv(dane, "gee-bezsennosc-dane.csv", row.names = FALSE)

# Odsetek osób z objawami w grupach i pomiarach
round(tapply(dane$bezsennosc, list(grupa = dane$grupa, czas = dane$czas), mean), 3)

# 1. Model mieszany (GLMM): efekty WARUNKOWE, czyli dla osoby o danej skłonności u
m_glmm <- glmer(bezsennosc ~ czas * grupa + (1 | id), data = dane, family = binomial, nAGQ = 10)
tau2 <- as.numeric(VarCorr(m_glmm)$id)
round(c(SD_u = sqrt(tau2), ICC_latentne = tau2 / (tau2 + pi^2 / 3)), 3)

# 2. GEE z roboczą macierzą niezależności = glm + kanapkowy błąd odporny na klastrowanie (osoba = klaster).
#    Równania estymujące GEE przy macierzy niezależności to równania wiarygodności glm, więc oszacowania są te same;
#    błąd Lianga–Zegera to vcovCL z type = "HC0" i bez poprawki G/(G − 1) (cadjust = FALSE).
m_gee <- glm(bezsennosc ~ czas * grupa, data = dane, family = binomial)
V_gee <- vcovCL(m_gee, cluster = ~ id, type = "HC0", cadjust = FALSE)

# Ilorazy szans: warunkowe (GLMM), brzegowe (GEE) i przybliżenie Zegera i in. (1988): b / sqrt(1 + 0.346 τ²)
b_c <- fixef(m_glmm); b_m <- coef(m_gee)
L <- rbind(czas_kontrola = c(0, 1, 0, 0), czas_program = c(0, 1, 0, 1), interakcja = c(0, 0, 0, 1))
ocena <- function(b, V) { e <- drop(L %*% b); s <- sqrt(diag(L %*% V %*% t(L)))
  cbind(OR = exp(e), dolny = exp(e - 1.96 * s), gorny = exp(e + 1.96 * s), p = 2 * pnorm(-abs(e / s))) }
round(ocena(b_c, as.matrix(vcov(m_glmm))), 3)
round(ocena(b_m, V_gee), 3)
round(c(c2 = (16 * sqrt(3) / (15 * pi))^2, OR_przyblizony = exp(drop(L %*% b_c) / sqrt(1 + 0.346 * tau2))), 3)

# Brzegowe prawdopodobieństwa z GLMM (uśrednione po rozkładzie u) a przewidywania GEE i odsetki w danych
u_w <- qnorm(ppoints(4000)) * sqrt(tau2)
siatka <- expand.grid(czas = 0:3, grupa = 0:1)
X <- model.matrix(~ czas * grupa, siatka)
siatka$typowa_osoba <- plogis(drop(X %*% b_c))
siatka$glmm_usrednione <- sapply(drop(X %*% b_c), function(e) mean(plogis(e + u_w)))
siatka$gee <- plogis(drop(X %*% b_m))
siatka$dane <- as.vector(t(tapply(dane$bezsennosc, list(dane$grupa, dane$czas), mean)))
print(round(siatka, 3), row.names = FALSE)
Wynik w R
     czas
grupa    0     1    2     3
    0 0.60 0.625 0.60 0.625
    1 0.65 0.525 0.45 0.275
        SD_u ICC_latentne
       1.545        0.420
                 OR dolny gorny     p
czas_kontrola 1.032 0.730 1.458 0.860
czas_program  0.500 0.348 0.718 0.000
interakcja    0.485 0.294 0.800 0.005
                 OR dolny gorny     p
czas_kontrola 1.021 0.818 1.275 0.853
czas_program  0.606 0.455 0.806 0.001
interakcja    0.593 0.413 0.852 0.005
                          c2 OR_przyblizony.czas_kontrola
                       0.346                        1.023
 OR_przyblizony.czas_program    OR_przyblizony.interakcja
                       0.599                        0.585
 czas grupa typowa_osoba glmm_usrednione   gee  dane
    0     0        0.653           0.609 0.605 0.600
    1     0        0.660           0.614 0.610 0.625
    2     0        0.667           0.619 0.615 0.600
    3     0        0.674           0.624 0.620 0.625
    0     1        0.712           0.653 0.656 0.650
    1     1        0.552           0.537 0.536 0.525
    2     1        0.382           0.416 0.411 0.450
    3     1        0.236           0.304 0.297 0.275
2. Błąd kanapkowy, CR2 i macierz wymienna
R
# Błędy standardowe i robocza macierz korelacji (wymaga obiektów z przepisu 1)
suppressPackageStartupMessages({library(clubSandwich); library(nlme)})

# 1. Estymator kanapkowy Lianga–Zegera policzony ręcznie: (X'WX)^-1 [Σ_i X_i'(y_i − μ_i)(y_i − μ_i)'X_i] (X'WX)^-1
X <- model.matrix(m_gee); mu <- fitted(m_gee); r <- dane$bezsennosc - mu
chleb <- solve(t(X) %*% (X * mu * (1 - mu)))
U <- rowsum(X * r, dane$id)                                  # sumy wyników (score) w obrębie osoby
V_reczny <- chleb %*% crossprod(U) %*% chleb
round(cbind(naiwny_glm = sqrt(diag(vcov(m_gee))), reczny_LZ = sqrt(diag(V_reczny)),
            vcovCL_HC0 = sqrt(diag(V_gee)),
            vcovCL_z_G_G1 = sqrt(diag(vcovCL(m_gee, cluster = ~ id, type = "HC0"))),
            CR2 = sqrt(diag(vcovCR(m_gee, cluster = dane$id, type = "CR2")))), 4)

# Test interakcji czas × grupa: z-test z błędem HC0 i test t z CR2 i stopniami swobody Satterthwaite'a
coeftest(m_gee, vcov. = V_gee)["czas:grupa", ]
coef_test(m_gee, vcov = "CR2", cluster = dane$id, test = "Satterthwaite")[4, ]

# 2. Wynik ciągły (nasilenie): ten sam model liniowy w czterech wersjach
m_lm <- lm(nasilenie ~ czas * grupa, data = dane)                                        # GEE niezależność
m_cs <- gls(nasilenie ~ czas * grupa, data = dane, correlation = corCompSymm(form = ~ 1 | id))  # odpowiednik GEE wymiennej
m_lmm <- lmer(nasilenie ~ czas * grupa + (1 | id), data = dane)                         # model mieszany
round(rbind(lm = coef(m_lm), gls_CS = coef(m_cs), lmer = fixef(m_lmm)), 3)
round(c(rho_CS = as.numeric(coef(m_cs$modelStruct$corStruct, unconstrained = FALSE)),
        ICC_lmer = { v <- as.data.frame(VarCorr(m_lmm))$vcov; v[1] / sum(v) }), 3)
round(rbind(lm_naiwny = sqrt(diag(vcov(m_lm))),
            lm_HC0_klaster = sqrt(diag(vcovCL(m_lm, cluster = ~ id, type = "HC0", cadjust = FALSE))),
            gls_CS_modelowy = sqrt(diag(vcov(m_cs))),
            gls_CS_CR2 = sqrt(diag(vcovCR(m_cs, type = "CR2"))),
            lmer = sqrt(diag(as.matrix(vcov(m_lmm))))), 3)
Wynik w R
            naiwny_glm reczny_LZ vcovCL_HC0 vcovCL_z_G_G1    CR2
(Intercept)     0.2709    0.3002     0.3002        0.3021 0.3040
czas            0.1452    0.1134     0.1134        0.1141 0.1148
grupa           0.3866    0.4190     0.4190        0.4216 0.4243
czas:grupa      0.2093    0.1847     0.1847        0.1858 0.1870
    Estimate   Std. Error      z value     Pr(>|z|)
-0.522726847  0.184684631 -2.830375459  0.004649341
Alternative hypothesis: two-sided
      Coef. Estimate    SE Null value t-stat d.f. (Satt) p-val (Satt) Sig.
 czas:grupa   -0.523 0.187          0  -2.79        77.9      0.00654   **
       (Intercept)   czas grupa czas:grupa
lm          15.384 -0.398 0.347      -1.26
gls_CS      15.384 -0.398 0.347      -1.26
lmer        15.384 -0.397 0.348      -1.26
  rho_CS ICC_lmer
   0.552    0.552
                (Intercept)  czas grupa czas:grupa
lm_naiwny             0.515 0.275 0.728      0.389
lm_HC0_klaster        0.632 0.186 0.844      0.240
gls_CS_modelowy       0.574 0.185 0.812      0.261
gls_CS_CR2            0.640 0.189 0.855      0.243
lmer                  0.574 0.185 0.812      0.261
3. Symulacja: wypadanie MCAR i MAR
R
# Symulacja: wypadanie z badania MCAR a MAR (zależne od ostatniego obserwowanego wyniku)
# Ten sam model warunkowy co w przepisie 1, ale 200 osób; w grupie kontrolnej PRAWDZIWA zmiana w czasie = 0.
# Po każdym pomiarze 0–2 osoba może odpaść: MCAR – z tym samym prawdopodobieństwem (.15), MAR – częściej, gdy w ostatnim pomiarze miała objawy (.30 wobec .03).
# 500 powtórzeń na scenariusz (obliczenia trwają kilka minut).
# Estymatory: GEE niezależność (glm), GLMM (glmer) i ważone GEE (wagi IPW z modelu wypadania).
suppressPackageStartupMessages(library(lme4))
set.seed(3203)
generuj <- function(n = 200) {
  d <- data.frame(id = rep(1:n, each = 4), grupa = rep(rep(0:1, each = n / 2), each = 4), czas = rep(0:3, n))
  u <- rnorm(n, 0, 2)[d$id]
  d$y <- rbinom(nrow(d), 1, plogis(1 - 0.8 * d$czas * d$grupa + u))
  d
}
wypadanie <- function(d, mechanizm) {
  d$y_poprz <- ave(d$y, d$id, FUN = function(v) c(NA, head(v, -1)))
  p_odp <- if (mechanizm == "MCAR") rep(.15, nrow(d)) else ifelse(d$y_poprz == 1, .30, .03)
  odpada <- d$czas > 0 & runif(nrow(d)) < p_odp
  d[ave(odpada, d$id, FUN = cumsum) == 0, ]                  # wypadanie monotoniczne: po odejściu brak dalszych pomiarów
}
ipw_wagi <- function(d) {                                      # P(pozostania) szacowane z danych: y_poprz, grupa, czas
  dd <- d; nast <- d[d$czas > 0, c("id", "czas")]
  ryzyko <- merge(d[d$czas < 3, c("id", "czas", "y", "grupa")], transform(nast, czas = czas - 1, zostal = 1), all.x = TRUE)
  ryzyko$zostal[is.na(ryzyko$zostal)] <- 0
  m_w <- glm(zostal ~ y * grupa + factor(czas), data = ryzyko, family = binomial)
  ryzyko$p <- fitted(m_w); ryzyko$czas <- ryzyko$czas + 1
  dd <- merge(dd, ryzyko[, c("id", "czas", "p")], all.x = TRUE); dd$p[dd$czas == 0] <- 1
  dd <- dd[order(dd$id, dd$czas), ]
  dd$w <- 1 / ave(dd$p, dd$id, FUN = cumprod)
  dd
}
estymuj <- function(d) {
  g <- coef(glm(y ~ czas * grupa, data = d, family = binomial))
  m <- fixef(glmer(y ~ czas * grupa + (1 | id), data = d, family = binomial))
  dw <- ipw_wagi(d)
  w <- suppressWarnings(coef(glm(y ~ czas * grupa, data = dw, family = binomial, weights = w)))
  c(GEE_czas = g[["czas"]], GEE_int = g[["czas:grupa"]], GLMM_czas = m[["czas"]], GLMM_int = m[["czas:grupa"]],
    wGEE_czas = w[["czas"]], wGEE_int = w[["czas:grupa"]], kompletne = mean(table(d$id) == 4))
}

# Wartości docelowe: warunkowe z modelu generującego, brzegowe z glm na bardzo dużym kompletnym zbiorze
duzy <- generuj(200000)
cel <- c(czas = 0, int_brzegowa = coef(glm(y ~ czas * grupa, data = duzy, family = binomial))[["czas:grupa"]], int_warunkowa = -0.8)
round(cel, 3)

R <- 500
wyniki <- lapply(c("MCAR", "MAR"), function(mech) {
  r <- t(replicate(R, suppressMessages(estymuj(wypadanie(generuj(), mech)))))
  k_czas <- c("GEE_czas", "GLMM_czas", "wGEE_czas"); k_int <- c("GEE_int", "GLMM_int", "wGEE_int")
  data.frame(mechanizm = mech, estymator = c("GEE (niezależność)", "GLMM", "GEE ważone (IPW)"),
             czas_kontrola = colMeans(r[, k_czas]), mcse_czas = apply(r[, k_czas], 2, sd) / sqrt(R),
             interakcja = colMeans(r[, k_int]),
             cel_interakcji = c(cel[["int_brzegowa"]], cel[["int_warunkowa"]], cel[["int_brzegowa"]]),
             odsetek_kompletnych = mean(r[, "kompletne"]), row.names = NULL)
})
wyniki <- do.call(rbind, wyniki)
wyniki$obciazenie_int_proc <- 100 * (wyniki$interakcja - wyniki$cel_interakcji) / abs(wyniki$cel_interakcji)
print(cbind(wyniki[, 1:2], round(wyniki[, -(1:2)], 3)), row.names = FALSE)
Wynik w R
         czas  int_brzegowa int_warunkowa
        0.000        -0.483        -0.800
Warning in checkConv(attr(opt, "derivs"), opt$par, ctrl = control$checkConv,  :
  Model failed to converge with max|grad| = 0.0639741 (tol = 0.002, component 1)
  See ?lme4::convergence and ?lme4::troubleshooting.
Warning in checkConv(attr(opt, "derivs"), opt$par, ctrl = control$checkConv,  :
  Model is nearly unidentifiable: very large eigenvalue
 - Rescale variables?
Warning in checkConv(attr(opt, "derivs"), opt$par, ctrl = control$checkConv,  :
  Model failed to converge with max|grad| = 0.0685176 (tol = 0.002, component 1)
  See ?lme4::convergence and ?lme4::troubleshooting.
Warning in checkConv(attr(opt, "derivs"), opt$par, ctrl = control$checkConv,  :
  Model is nearly unidentifiable: very large eigenvalue
 - Rescale variables?
 mechanizm          estymator czas_kontrola mcse_czas interakcja cel_interakcji
      MCAR GEE (niezależność)         0.012     0.004     -0.498         -0.483
      MCAR               GLMM         0.013     0.006     -0.804         -0.800
      MCAR   GEE ważone (IPW)         0.010     0.004     -0.497         -0.483
       MAR GEE (niezależność)        -0.129     0.004     -0.486         -0.483
       MAR               GLMM        -0.021     0.007     -0.787         -0.800
       MAR   GEE ważone (IPW)         0.003     0.004     -0.491         -0.483
 odsetek_kompletnych obciazenie_int_proc
               0.614              -3.081
               0.614              -0.454
               0.614              -2.838
               0.551              -0.671
               0.551               1.653
               0.551              -1.603
4. Symulacja: mała liczba klastrów
R
# Symulacja: błąd I rodzaju GEE przy małej liczbie klastrów
# Randomizacja klastrowa: K oddziałów (połowa w programie), 20 pacjentów w oddziale, wynik binarny,
# SD efektu oddziału = 1, PRAWDZIWY efekt programu = 0. Dla każdego K: 2000 zbiorów danych.
# Test 1: z-test z kanapkowym błędem Lianga–Zegera (HC0, bez poprawki) – tak liczy klasyczne GEE.
# Test 2: test t z poprawką CR2 i stopniami swobody Satterthwaite'a (clubSandwich).
suppressPackageStartupMessages({library(sandwich); library(clubSandwich)})
set.seed(3204)
jeden <- function(K, m = 20) {
  oddzial <- rep(1:K, each = m); program <- rep(rep(0:1, length.out = K), each = m)
  y <- rbinom(K * m, 1, plogis(-0.5 + rnorm(K, 0, 1)[oddzial]))
  d <- data.frame(y, program, oddzial)
  fit <- glm(y ~ program, data = d, family = binomial)
  se0 <- sqrt(vcovCL(fit, cluster = ~ oddzial, type = "HC0", cadjust = FALSE)["program", "program"])
  t2 <- coef_test(fit, vcov = "CR2", cluster = d$oddzial, test = "Satterthwaite")[2, ]
  c(HC0_z = 2 * pnorm(-abs(coef(fit)[["program"]] / se0)), CR2_Satt = t2$p_Satt, df = t2$df_Satt)
}
wyniki <- do.call(rbind, lapply(c(6, 10, 20, 40), function(K) {
  r <- t(replicate(2000, suppressWarnings(jeden(K))))
  data.frame(K, HC0_z = mean(r[, "HC0_z"] < .05), CR2_Satterthwaite = mean(r[, "CR2_Satt"] < .05),
             mediana_df = median(r[, "df"]))
}))
print(round(wyniki, 3), row.names = FALSE)
Wynik w R
  K HC0_z CR2_Satterthwaite mediana_df
  6 0.174             0.039      3.991
 10 0.097             0.038      7.991
 20 0.072             0.046     17.989
 40 0.066             0.054     37.987
5. GEE w pakiecie geepack
R
# GEE w pakiecie geepack (wymaga obiektów z przepisu 1; wiersze posortowane według id i czasu)
suppressPackageStartupMessages(library(geepack))
g_ind <- geeglm(bezsennosc ~ czas * grupa, id = id, data = dane, family = binomial, corstr = "independence")
g_exc <- geeglm(bezsennosc ~ czas * grupa, id = id, data = dane, family = binomial, corstr = "exchangeable")
g_ar1 <- geeglm(bezsennosc ~ czas * grupa, id = id, data = dane, family = binomial, corstr = "ar1")

# 1. Macierz niezależności: geeglm a glm + vcovCL(HC0) z przepisu 1 (oszacowania i odporne SE)
round(cbind(b_glm = coef(m_gee), b_geeglm = coef(g_ind),
            SE_vcovCL_HC0 = sqrt(diag(V_gee)), SE_geeglm = summary(g_ind)$coefficients[, "Std.err"]), 4)

# 2. Trzy macierze robocze: współczynnik interakcji czas × grupa, odporny SE i oszacowana korelacja
round(rbind(niezaleznosc = c(unlist(coef(summary(g_ind))["czas:grupa", ]), alfa = NA),
            wymienna = c(unlist(coef(summary(g_exc))["czas:grupa", ]), alfa = g_exc$geese$alpha),
            AR1 = c(unlist(coef(summary(g_ar1))["czas:grupa", ]), alfa = g_ar1$geese$alpha)), 4)

# 3. Ilorazy szans z macierzą wymienną (te same kontrasty L co w przepisie 1)
round(ocena(coef(g_exc), vcov(g_exc)), 3)

# 4. QIC trzech macierzy roboczych (niższy QIC = lepsza macierz; tylko wskazówka)
QIC(g_ind, g_exc, g_ar1)
Wynik w R
              b_glm b_geeglm SE_vcovCL_HC0 SE_geeglm
(Intercept)  0.4263   0.4263        0.3002    0.3002
czas         0.0211   0.0211        0.1134    0.1134
grupa        0.2183   0.2183        0.4190    0.4190
czas:grupa  -0.5227  -0.5227        0.1847    0.1847
             Estimate Std.err   Wald Pr(>|W|)   alfa
niezaleznosc  -0.5227  0.1847 8.0110   0.0046     NA
wymienna      -0.5227  0.1847 8.0110   0.0046 0.2938
AR1           -0.5426  0.1862 8.4911   0.0036 0.4103
                 OR dolny gorny     p
czas_kontrola 1.021 0.818 1.275 0.853
czas_program  0.606 0.455 0.806 0.001
interakcja    0.593 0.413 0.852 0.005
           QIC     QICu Quasi Lik      CIC params     QICC
g_ind 433.8608 431.2346 -211.6173 5.313081      4 434.3941
g_exc 433.8785 431.2350 -211.6175 5.321733      4 434.6893
g_ar1 434.0474 431.2496 -211.6248 5.398888      4 434.8582
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietami lme4, sandwich, lmtest, clubSandwich, nlme i geepack; rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- lmtest (wersja 0.9.40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- clubSandwich (wersja 0.7.0): Pustejovsky, J. E. (2026). clubSandwich: Cluster-robust (sandwich) variance estimators with small-sample corrections [R package]. https://doi.org/10.32614/CRAN.package.clubSandwich
- nlme (wersja 3.1.168): Pinheiro, J., Bates, D., & R Core Team. (2025). nlme: Linear and nonlinear mixed effects models [R package]. https://doi.org/10.32614/CRAN.package.nlme
- geepack (wersja 1.3.13): Højsgaard, S., Halekoh, U., & Yan, J. (2006). The R package geepack for generalized estimating equations. Journal of Statistical Software, 15(2), 1–11. https://doi.org/10.18637/jss.v015.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Porównywanie OR z GEE i GLMM jak dwóch oszacowań tej samej liczby. To różne parametry. Różnica nie świadczy, że któryś model jest zły.
- Modelowe zamiast kanapkowych błędów w GEE. Odporność na złą macierz roboczą daje tylko estymator kanapkowy.
- Kanapkowy błąd bez poprawki przy kilkunastu klastrach. Użyj CR2 albo poprawki Mancla–DeRouena i podaj liczbę klastrów.
- GEE na danych z wyraźnym wypadaniem bez komentarza. Sprawdź, od czego zależy wypadanie. Przy MAR użyj wag IPW, imputacji albo modelu mieszanego.
- Wybór macierzy roboczej po wartościach p. Ustal ją z góry albo porównaj QIC i opisz wynik jako analizę wrażliwości.
- Nieposortowane dane w pakietach do GEE. Macierze AR(1) i wymienna zakładają, że wiersze jednego klastra leżą obok siebie we właściwej kolejności.
Najczęstsze pytania
Czy glm z vcovCL to naprawdę to samo co GEE?
Tak, przy roboczej macierzy niezależności. Równania estymujące GEE sprowadzają się wtedy do równań wiarygodności glm, więc oszacowania są identyczne. Kanapkowy błąd Lianga–Zegera odpowiada vcovCL(type = "HC0", cadjust = FALSE). W przykładzie ręcznie policzony estymator i vcovCL dały ten sam błąd 0.1847. Domyślna poprawka G/(G − 1) zwiększa go nieznacznie, do 0.1858. Inne macierze robocze wymagają już pakietu do GEE.
Czy GEE z macierzą wymienną to to samo co model z losowym wyrazem wolnym?
Dla wyniku ciągłego i funkcji tożsamościowej prawie tak. Losowy wyraz wolny implikuje stałą korelację pomiarów, a efekty brzegowe i warunkowe są wtedy równe. W przykładzie gls z corCompSymm i lmer dały te same współczynniki, a korelacja .552 była równa ICC. Dla wyniku binarnego tak nie jest: GEE wymienne nadal szacuje efekt brzegowy, a GLMM warunkowy.
Czy można przeliczyć OR z modelu mieszanego na OR brzegowy?
W przybliżeniu tak. Przy normalnym losowym wyrazie wolnym współczynnik brzegowy to w przybliżeniu współczynnik warunkowy podzielony przez √(1 + 0.346 τ²) (Zeger i in., 1988). W przykładzie dało to OR 0.60 wobec 0.61 z GEE. Dokładniej: uśrednij przewidywane prawdopodobieństwa GLMM po rozkładzie efektów losowych. Przy losowych nachyleniach prosty wzór przestaje działać.
Ile klastrów potrzeba do GEE?
Nie ma jednej granicy, ale w naszej symulacji z kanapkowym błędem bez poprawki test odrzucał prawdziwą hipotezę zerową w 17.4% zbiorów przy 6 klastrach, 9.7% przy 10 i 7.2% przy 20. Poprawka CR2 ze stopniami swobody Satterthwaite'a utrzymała odsetek między 3.8% a 5.4%. Przy kilkudziesięciu klastrach lub mniej stosuj poprawkę małej próby i podaj ją w metodach.
Czy imputacja wielokrotna rozwiązuje problem GEE przy brakach MAR?
Może, jeśli model imputacyjny uwzględnia zmienną wyniku z innych pomiarów i strukturę klastrów. Inne rozwiązanie to GEE ważone odwrotnością prawdopodobieństwa pozostania w badaniu (Robins i in., 1995), które w naszej symulacji usunęło obciążenie. Model mieszany dopasowany metodą największej wiarygodności jest ważny przy MAR bez dodatkowych kroków, o ile jego założenia są spełnione.
Powiązane hasła
Przeczytaj też
GEE w SPSS krok po kroku
Generalized Estimating Equations od pliku .sav po opis APA: zakładka Repeated, macierz robocza i QIC, pułapka kategorii odniesienia, estymator odporny, exp(B), EM Means i składnia GENLIN.
Czytaj →PoradnikWielopoziomowa regresja logistyczna (GLMM)
glmer krok po kroku: ICC z π²/3 i MOR, ilorazy szans warunkowe a uśrednione, kwadratura, zbieżność, prawdopodobieństwa i wzór opisu APA.
Czytaj →PoradnikANOVA z powtarzanymi pomiarami czy model mieszany?
Ten sam przykład 2 × 4 w afex i lmerTest, symulacja odpadania MAR, struktura efektów losowych, stopnie swobody, R² i gotowy opis do artykułu.
Czytaj →PoradnikRandomizacja klastrowa – plan i analiza
ICC z przedziałem ufności, efekt schematu przy nierównych oddziałach, cztery analizy tych samych danych, poprawki df i raport CONSORT – z kodem R.
Czytaj →Recenzent pyta, dlaczego GEE, a nie model mieszany (albo odwrotnie)?
Pomożemy dobrać model do pytania badawczego, sprawdzić błędy standardowe przy małej liczbie klastrów i ocenić wpływ braków danych tak, żebyś mógł(a) samodzielnie opisać i obronić analizę.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Hubbard, A. E., Ahern, J., Fleischer, N. L., Van der Laan, M., Lippman, S. A., Jewell, N., Bruckner, T., & Satariano, W. A. (2010). To GEE or not to GEE: Comparing population average and mixed models for estimating the associations between neighborhood risk factors and health. Epidemiology, 21(4), 467–474. https://doi.org/10.1097/ede.0b013e3181caeb90
- Liang, K.-Y., & Zeger, S. L. (1986). Longitudinal data analysis using generalized linear models. Biometrika, 73(1), 13–22. https://doi.org/10.1093/biomet/73.1.13
- Mancl, L. A., & DeRouen, T. A. (2001). A covariance estimator for GEE with improved small-sample properties. Biometrics, 57(1), 126–134. https://doi.org/10.1111/j.0006-341x.2001.00126.x
- Pan, W. (2001). Akaike's information criterion in generalized estimating equations. Biometrics, 57(1), 120–125. https://doi.org/10.1111/j.0006-341x.2001.00120.x
- Pustejovsky, J. E., & Tipton, E. (2018). Small-sample methods for cluster-robust variance estimation and hypothesis testing in fixed effects models. Journal of Business & Economic Statistics, 36(4), 672–683. https://doi.org/10.1080/07350015.2016.1247004 ● Otwarty dostęp: pełny tekst
- Robins, J. M., Rotnitzky, A., & Zhao, L. P. (1995). Analysis of semiparametric regression models for repeated outcomes in the presence of missing data. Journal of the American Statistical Association, 90(429), 106–121. https://doi.org/10.1080/01621459.1995.10476493
- Rubin, D. B. (1976). Inference and missing data. Biometrika, 63(3), 581–592. https://doi.org/10.1093/biomet/63.3.581
- Zeger, S. L., Liang, K.-Y., & Albert, P. S. (1988). Models for longitudinal data: A generalized estimating equation approach. Biometrics, 44(4), 1049–1060. https://doi.org/10.2307/2531734
- Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01 ● Otwarty dostęp
Cytowania BibTeX
@article{hubbard2010gee, author={Hubbard, Alan E. and Ahern, Jennifer and Fleischer, Nancy L. and Van der Laan, Mark and Lippman, Sheri A. and Jewell, Nicholas and Bruckner, Tim and Satariano, William A.}, title={{To GEE or not to GEE: Comparing population average and mixed models for estimating the associations between neighborhood risk factors and health}}, journal={Epidemiology}, year={2010}, volume={21}, number={4}, pages={467--474}, doi={10.1097/ede.0b013e3181caeb90}}@article{liang1986longitudinal, author={Liang, Kung-Yee and Zeger, Scott L.}, title={{Longitudinal data analysis using generalized linear models}}, journal={Biometrika}, year={1986}, volume={73}, number={1}, pages={13--22}, doi={10.1093/biomet/73.1.13}}@article{mancl2001covariance, author={Mancl, Lloyd A. and DeRouen, Timothy A.}, title={{A covariance estimator for GEE with improved small-sample properties}}, journal={Biometrics}, year={2001}, volume={57}, number={1}, pages={126--134}, doi={10.1111/j.0006-341x.2001.00126.x}}@article{pan2001akaikes, author={Pan, Wei}, title={{Akaike's information criterion in generalized estimating equations}}, journal={Biometrics}, year={2001}, volume={57}, number={1}, pages={120--125}, doi={10.1111/j.0006-341x.2001.00120.x}}@article{pustejovsky2018small, author={Pustejovsky, James E. and Tipton, Elizabeth}, title={{Small-sample methods for cluster-robust variance estimation and hypothesis testing in fixed effects models}}, journal={Journal of Business \& Economic Statistics}, year={2018}, volume={36}, number={4}, pages={672--683}, doi={10.1080/07350015.2016.1247004}}@article{robins1995analysis, author={Robins, James M. and Rotnitzky, Andrea and Zhao, Lue Ping}, title={{Analysis of semiparametric regression models for repeated outcomes in the presence of missing data}}, journal={Journal of the American Statistical Association}, year={1995}, volume={90}, number={429}, pages={106--121}, doi={10.1080/01621459.1995.10476493}}@article{rubin1976inference, author={Rubin, Donald B.}, title={{Inference and missing data}}, journal={Biometrika}, year={1976}, volume={63}, number={3}, pages={581--592}, doi={10.1093/biomet/63.3.581}}@article{zeger1988models, author={Zeger, Scott L. and Liang, Kung-Yee and Albert, Paul S.}, title={{Models for longitudinal data: A generalized estimating equation approach}}, journal={Biometrics}, year={1988}, volume={44}, number={4}, pages={1049--1060}, doi={10.2307/2531734}}@article{zeileis2020various, author={Zeileis, Achim and Köll, Susanne and Graham, Nathaniel}, title={{Various versatile variances: An object-oriented implementation of clustered covariances in R}}, journal={Journal of Statistical Software}, year={2020}, volume={95}, number={1}, pages={1--36}, doi={10.18637/jss.v095.i01}}