Co to jest GEE?
GEE (ang. generalized estimating equations, uogólnione równania estymujące) to metoda szacowania regresji liniowej, logistycznej czy Poissona dla danych skorelowanych: pomiarów powtarzanych u tych samych osób albo uczniów w szkołach. Liang i Zeger (1986) zaproponowali równania, które dają zgodne oszacowania współczynników i ich wariancji bez określania łącznego rozkładu obserwacji jednej osoby. Badacz podaje model średniej i roboczą macierz korelacji: niezależną, wymienną, AR(1) albo nieustrukturyzowaną.
Efekty brzegowe i odporny błąd
GEE szacuje model uśredniony w populacji (Zeger i in., 1988): współczynnik opisuje różnicę średnich w całej populacji, a nie u konkretnej osoby. W modelu liniowym oba podejścia szacują ten sam parametr, ale w logistycznym brzegowy iloraz szans jest bliższy 1 niż warunkowy z GLMM. Hubbard i in. (2010) bronią GEE, bo nie wymaga nieweryfikowalnych założeń o rozkładzie efektów losowych.
Wnioskowanie opiera się na odpornym, kanapkowym błędzie standardowym, poprawnym nawet przy źle dobranej macierzy roboczej. Przy macierzy niezależności GEE daje te same współczynniki co zwykły glm, a jego odporny błąd to błąd odporny na klastrowanie bez poprawki małych prób. W R odpowiada mu sandwich::vcovCL(m, cluster = ~id, type = "HC0", cadjust = FALSE), co sprawdzamy w kodzie ręcznym wzorem.
Przykład
W symulacji 40 osób (połowa po treningu) zmierzono czterokrotnie samopoczucie. Grupa treningowa miała wynik wyższy o 3.94 punktu. Naiwny błąd, jak dla 160 niezależnych obserwacji, wyniósł 1.18 (p = .001), a odporny 1.99, z = 1.98, p = .048. Model brzegowy z macierzą wymienną (nlme::gls) dał SE = 2.04 przy korelacji pomiarów .65.
Na rysunku
W regresji logistycznej GEE i model mieszany szacują różne współczynniki; najłatwiej to zobaczyć na krzywych. Dane są symulowane: 200 osób po 6 pomiarów 0/1, logit rośnie o 0.8 na każdy pomiar, a efekt osoby ma SD = 2. Duże zróżnicowanie osób ustawiono ręcznie, żeby różnica krzywych była wyraźna; ziarna (4554 dla danych, 4555 dla wyboru 20 osób do rysunku) ustalono raz i nie zmieniano.
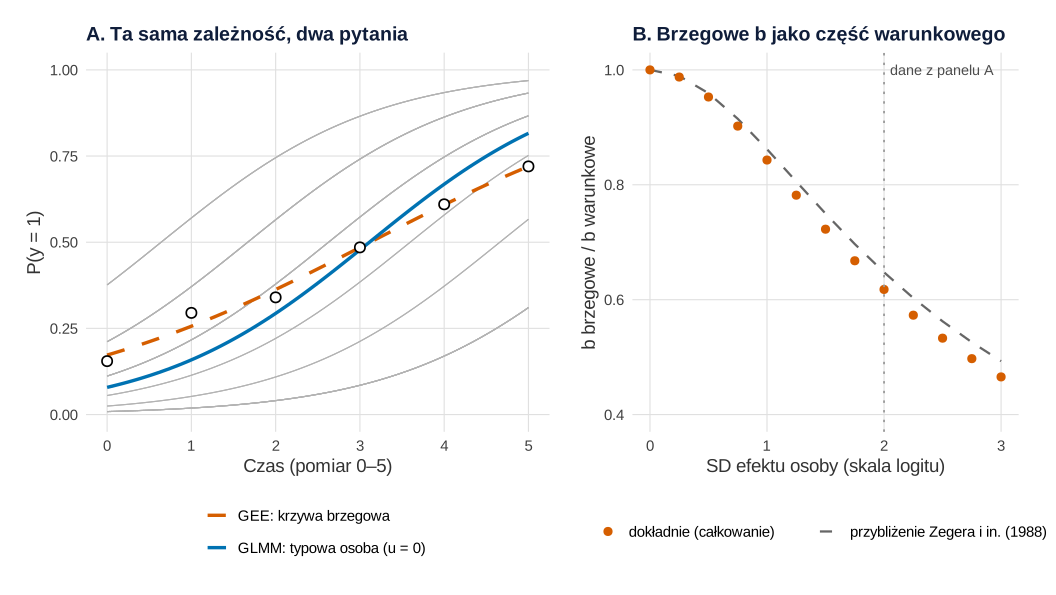
set.seed(4554)).Co widać. Szare krzywe to przewidywania modelu mieszanego dla 20 osób: każda ma ten sam kształt, ale inne położenie. Niebieska krzywa to osoba z efektem 0, czyli warunkowy współczynnik GLMM: b = 0.790, OR = 2.20. Pomarańczowa krzywa z GEE (b = 0.502, OR = 1.65) przechodzi przez obserwowane odsetki, od 0.155 w pierwszym pomiarze do 0.720 w ostatnim, bo opisuje średnią w populacji. Średnia z przesuniętych krzywych S jest bardziej płaska niż każda z nich. Panel B pokazuje, że to spłaszczenie rośnie ze zmiennością osób: przy SD = 2 współczynnik brzegowy to 0.618 warunkowego, a przybliżenie podawane za Zegerem i in. (1988) daje 0.648.
Na co uważać. Mniejszy iloraz szans z GEE nie znaczy, że GEE „zaniża” efekt. Oba modele odpowiadają na inne pytania: o różnicę w populacji i o zmianę u konkretnej osoby. Nie zestawiaj więc OR z GEE i z GLMM jako wyników tego samego. Rysunek nie pokazuje niepewności, a oba współczynniki są wyraźnie różne od zera (SE 0.037 i 0.060). Zakłada też normalny rozkład efektów osób. Jak czytać krzywe logistyczne i ilorazy szans, pokazuje wpis regresja logistyczna w obrazkach, a o efektach losowych – model mieszany w obrazkach.
Podpis do pracy:
Kod rysunku dopasowuje oba modele, wypisuje współczynniki i liczy krzywą z panelu B. Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. GEE a GLMM w regresji logistycznej: krzywa brzegowa (populacja) i warunkowa (typowa osoba)
suppressPackageStartupMessages({library(ggplot2); library(patchwork); library(lme4); library(sandwich)})

# Paleta Okabe–Ito i prosty motyw
kol <- c("GEE: krzywa brzegowa" = "#D55E00", "GLMM: typowa osoba (u = 0)" = "#0072B2")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

# Dane: 200 osób po 6 pomiarów (czas 0–5), wynik 0/1; logit P = -2.5 + 0.8 · czas + u_i, u_i ~ N(0, 2²)
# Parametry ustawiono ręcznie (duże SD efektu osoby), by różnica krzywych była wyraźna
set.seed(4554)
K <- 200; m <- 6; b0 <- -2.5; b1 <- 0.8; sd_u <- 2
d <- data.frame(id = factor(rep(1:K, each = m)), czas = rep(0:(m - 1), K))
u <- rnorm(K, sd = sd_u)
d$y <- rbinom(K * m, 1, plogis(b0 + b1 * d$czas + u[d$id]))

gee  <- glm(y ~ czas, family = binomial, data = d)              # GEE z macierzą niezależności = glm ...
V    <- vcovCL(gee, cluster = ~id, type = "HC0", cadjust = FALSE) # ... z błędem kanapkowym
glmm <- glmer(y ~ czas + (1 | id), family = binomial, data = d, nAGQ = 10)
tab <- rbind(GEE = c(b = coef(gee)[["czas"]], SE = sqrt(V["czas", "czas"])),
             GLMM = c(b = fixef(glmm)[["czas"]], SE = sqrt(vcov(glmm)["czas", "czas"])))
print(round(cbind(tab, OR = exp(tab[, "b"])), 3))
cat("SD efektu osoby z GLMM:", round(attr(VarCorr(glmm)$id, "stddev"), 2), "\n")
cat("Przybliżenie b_GLMM / sqrt(1 + 0.346 · SD²):",
    round(fixef(glmm)[["czas"]] / sqrt(1 + 0.346 * attr(VarCorr(glmm)$id, "stddev")^2), 3), "\n")

# Krzywe: brzegowa z GEE, warunkowa z GLMM przy u = 0 oraz 20 losowych osób (szare)
siatka <- seq(0, m - 1, by = 0.05)
krzywe <- rbind(
  data.frame(czas = siatka, p = plogis(coef(gee)[1] + coef(gee)[2] * siatka), model = names(kol)[1]),
  data.frame(czas = siatka, p = plogis(fixef(glmm)[1] + fixef(glmm)[2] * siatka), model = names(kol)[2]))
set.seed(4555)
wyb <- sample(K, 20)
re <- ranef(glmm)$id[wyb, 1]
osoby <- do.call(rbind, lapply(seq_along(wyb), function(j) data.frame(
  id = wyb[j], czas = siatka, p = plogis(fixef(glmm)[1] + re[j] + fixef(glmm)[2] * siatka))))
odsetki <- aggregate(y ~ czas, data = d, FUN = mean)
print(round(odsetki, 3), row.names = FALSE)

pA <- ggplot() +
  geom_line(data = osoby, aes(czas, p, group = id), colour = "grey70", linewidth = 0.4) +
  geom_line(data = krzywe, aes(czas, p, colour = model, linetype = model), linewidth = 1.2) +
  geom_point(data = odsetki, aes(czas, y), shape = 21, fill = "white", colour = "black", size = 3, stroke = 0.9) +
  scale_colour_manual(values = kol, name = NULL) + scale_linetype_manual(values = c("dashed", "solid"), name = NULL) +
  scale_y_continuous(limits = c(0, 1)) +
  labs(title = "A. Ta sama zależność, dwa pytania", x = "Czas (pomiar 0–5)", y = "P(y = 1)") +
  motyw + guides(colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2))

# Panel B: o ile brzegowy współczynnik jest bliższy zera niż warunkowy (b = 0.8) przy rosnącym SD efektu osoby
# Brzegowe P liczone całkowaniem po rozkładzie u, potem dopasowanie krzywej logistycznej do tych P
brzegowy_b <- function(s) {
  if (s == 0) return(b1)                                       # bez efektu osoby obie krzywe są identyczne
  pm <- sapply(0:(m - 1), function(t) integrate(function(v) plogis(b0 + b1 * t + v) * dnorm(v, sd = s), -Inf, Inf)$value)
  coef(suppressWarnings(glm(pm ~ I(0:(m - 1)), family = binomial)))[2]
}
sds <- seq(0, 3, by = 0.25)
tl <- data.frame(sd_u = sds, calka = sapply(sds, brzegowy_b) / b1, przybl = 1 / sqrt(1 + 0.346 * sds^2))
print(round(tl, 3), row.names = FALSE)
pB <- ggplot(tl, aes(sd_u)) +
  geom_line(aes(y = przybl, linetype = "przybliżenie Zegera i in. (1988)"), colour = "grey40", linewidth = 0.8) +
  geom_point(aes(y = calka, shape = "dokładnie (całkowanie)"), colour = "#D55E00", size = 2.8) +
  geom_vline(xintercept = sd_u, colour = "grey60", linetype = "dotted") +
  annotate("text", x = sd_u + 0.05, y = 1, label = "dane z panelu A", hjust = 0, size = 3.8, colour = "grey30") +
  scale_linetype_manual(values = "dashed", name = NULL) + scale_shape_manual(values = 16, name = NULL) +
  scale_y_continuous(limits = c(0.4, 1)) +
  labs(title = "B. Brzegowe b jako część warunkowego", x = "SD efektu osoby (skala logitu)", y = "b brzegowe / b warunkowe") +
  motyw + theme(legend.box = "vertical", legend.spacing.y = unit(0, "pt"))

p <- pA + pB + plot_layout(widths = c(1.2, 1))
p
Wynik w R
         b    SE    OR
GEE  0.502 0.037 1.652
GLMM 0.790 0.060 2.202
SD efektu osoby z GLMM: 1.9
Przybliżenie b_GLMM / sqrt(1 + 0.346 · SD²): 0.526
 czas     y
    0 0.155
    1 0.295
    2 0.340
    3 0.485
    4 0.610
    5 0.720
 sd_u calka przybl
 0.00 1.000  1.000
 0.25 0.988  0.989
 0.50 0.953  0.959
 0.75 0.902  0.915
 1.00 0.843  0.862
 1.25 0.782  0.806
 1.50 0.723  0.750
 1.75 0.668  0.697
 2.00 0.618  0.648
 2.25 0.573  0.603
 2.50 0.533  0.562
 2.75 0.497  0.526
 3.00 0.466  0.493
Jak opisać w pracy
Na co uważać
- Mało klastrów. Przy kilkudziesięciu osobach lub szkołach odporny błąd bywa zaniżony – rozważ poprawkę CR2.
- Braki danych. Zwykłe GEE zakłada braki MCAR. Przy MAR bezpieczniejszy jest model mieszany szacowany metodą największej wiarygodności.
- Pytanie badawcze. Gdy interesuje cię zmienność między osobami albo efekt dla typowej osoby, wybierz model mieszany. Porównanie obu podejść pokazuje wpis GEE czy model mieszany?
GEE z macierzą niezależności w R
Kod dopasowuje glm z błędem kanapkowym vcovCL, porównuje go z ręcznie policzonym wzorem Lianga i Zegera, a jako model z macierzą wymienną dopasowuje nlme::gls. Pakietu geepack nie używamy.
Naiwny i odporny błąd standardowy efektu grupy
R
suppressPackageStartupMessages({library(sandwich); library(nlme)})
set.seed(4553)
K <- 40; t <- 4                                  # 40 osób, po 4 pomiary
d <- data.frame(id = rep(1:K, each = t), czas = rep(0:3, K),
                grupa = rep(rep(0:1, each = K / 2), each = t))
d$y <- 50 + 3 * d$grupa + 1 * d$czas + rep(rnorm(K, sd = 6), each = t) + rnorm(K * t, sd = 4)
# GEE z roboczą macierzą niezależności = glm + kanapkowy błąd odporny na klastrowanie
m <- glm(y ~ grupa + czas, data = d)
V <- vcovCL(m, cluster = ~id, type = "HC0", cadjust = FALSE)
# sprawdzenie: wzór kanapkowy Liang–Zeger policzony ręcznie
X <- model.matrix(m); e <- residuals(m, type = "response")
B <- solve(crossprod(X)); M <- Reduce(`+`, lapply(split(seq_len(nrow(d)), d$id),
       function(i) tcrossprod(crossprod(X[i, , drop = FALSE], e[i]))))
cat("vcovCL = wzór ręczny:", isTRUE(all.equal(unname(V), unname(B %*% M %*% B))), "\n")
# model brzegowy z macierzą wymienną (odpowiednik GEE "exchangeable" dla wyniku ciągłego)
g <- gls(y ~ grupa + czas, data = d, correlation = corCompSymm(form = ~ 1 | id))
tab <- rbind(
  naiwny  = c(coef(m)["grupa"], SE = sqrt(vcov(m)["grupa", "grupa"])),
  odporny = c(coef(m)["grupa"], SE = sqrt(V["grupa", "grupa"])),
  gls_wym = c(coef(g)["grupa"], SE = sqrt(vcov(g)["grupa", "grupa"])))
tab <- cbind(tab, z = tab[, 1] / tab[, 2], p = 2 * pnorm(-abs(tab[, 1] / tab[, 2])))
print(round(tab, 3))
cat("SE czasu: naiwny", round(sqrt(vcov(m)["czas", "czas"]), 3),
    "odporny", round(sqrt(V["czas", "czas"]), 3), "\n")
cat("korelacja wymienna (rho):", round(coef(g$modelStruct$corStruct, unconstrained = FALSE), 2), "\n")
Wynik w R
vcovCL = wzór ręczny: TRUE
        grupa    SE     z     p
naiwny  3.937 1.176 3.348 0.001
odporny 3.937 1.988 1.981 0.048
gls_wym 3.937 2.039 1.931 0.054
SE czasu: naiwny 0.526 odporny 0.298
korelacja wymienna (rho): 0.65
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiety sandwich i nlme; kod rysunku 1 także ggplot2, patchwork i lme4). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- nlme (wersja 3.1.168): Pinheiro, J., Bates, D., & R Core Team. (2025). nlme: Linear and nonlinear mixed effects models [R package]. https://doi.org/10.32614/CRAN.package.nlme
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
Najczęstsze pytania
Którą roboczą macierz korelacji wybrać w GEE?
Przy pomiarach w czasie często wymienną lub AR(1), przy klastrach – wymienną. Zła macierz nie psuje zgodności oszacowań ani odpornego SE, ale obniża ich precyzję.
Czym różni się iloraz szans z GEE od ilorazu szans z modelu mieszanego?
GEE daje iloraz szans uśredniony w populacji, a model mieszany – warunkowy, dla osoby o danym efekcie losowym. W modelu logistycznym ten drugi jest zwykle dalej od 1.
Jak policzyć GEE w R bez pakietu geepack?
Dla macierzy niezależności: glm i sandwich::vcovCL(m, cluster = ~id, type = "HC0", cadjust = FALSE). Dla wyniku ciągłego i macierzy wymiennej: nlme::gls z corCompSymm(form = ~1 | id).
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
GEE w SPSS krok po kroku
Generalized Estimating Equations od pliku .sav po opis APA: zakładka Repeated, macierz robocza i QIC, pułapka kategorii odniesienia, estymator odporny, exp(B), EM Means i składnia GENLIN.
Czytaj →PoradnikPytanie wielokrotnego wyboru: porównanie grup
Dlaczego chi-kwadrat na tabeli zaznaczeń to błąd i co zamiast: testy dla opcji z korektą Holma, test łączny z permutacjami, GEE i Q Cochrana – z kodem R.
Czytaj →PoradnikGEE czy model mieszany?
Efekty brzegowe a warunkowe, robocza macierz korelacji, błąd kanapkowy i CR2, braki MCAR i MAR oraz QIC – na jednym przykładzie w R.
Czytaj →PoradnikANOVA z powtarzanymi pomiarami czy model mieszany?
Ten sam przykład 2 × 4 w afex i lmerTest, symulacja odpadania MAR, struktura efektów losowych, stopnie swobody, R² i gotowy opis do artykułu.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Hubbard, A. E., Ahern, J., Fleischer, N. L., Van der Laan, M., Lippman, S. A., Jewell, N., Bruckner, T., & Satariano, W. A. (2010). To GEE or not to GEE: Comparing population average and mixed models for estimating the associations between neighborhood risk factors and health. Epidemiology, 21(4), 467–474. https://doi.org/10.1097/ede.0b013e3181caeb90
- Liang, K.-Y., & Zeger, S. L. (1986). Longitudinal data analysis using generalized linear models. Biometrika, 73(1), 13–22. https://doi.org/10.1093/biomet/73.1.13
- Zeger, S. L., Liang, K.-Y., & Albert, P. S. (1988). Models for longitudinal data: A generalized estimating equation approach. Biometrics, 44(4), 1049–1060. https://doi.org/10.2307/2531734
Cytowania BibTeX
@article{hubbard2010gee, author={Hubbard, Alan E. and Ahern, Jennifer and Fleischer, Nancy L. and Van der Laan, Mark and Lippman, Sheri A. and Jewell, Nicholas and Bruckner, Tim and Satariano, William A.}, title={{To GEE or not to GEE: Comparing population average and mixed models for estimating the associations between neighborhood risk factors and health}}, journal={Epidemiology}, year={2010}, volume={21}, number={4}, pages={467--474}, doi={10.1097/ede.0b013e3181caeb90}}@article{liang1986longitudinal, author={Liang, Kung-Yee and Zeger, Scott L.}, title={{Longitudinal data analysis using generalized linear models}}, journal={Biometrika}, year={1986}, volume={73}, number={1}, pages={13--22}, doi={10.1093/biomet/73.1.13}}@article{zeger1988models, author={Zeger, Scott L. and Liang, Kung-Yee and Albert, Paul S.}, title={{Models for longitudinal data: A generalized estimating equation approach}}, journal={Biometrics}, year={1988}, volume={44}, number={4}, pages={1049--1060}, doi={10.2307/2531734}}