Dlaczego porównanie grup jest tu trudniejsze niż zwykle
Pytanie „zaznacz wszystkie, które pasują” daje jedną linijkę w formularzu, ale w danych zamienia się w kilka osobnych zmiennych 0/1 – po jednej na każdą opcję kafeterii. Jak rozpakować eksport z formularza, liczyć odsetki osób i ustalić mianownik, opisuje wpis główny tej serii: pytania wielokrotnego wyboru w ankiecie – jak zakodować i policzyć. (skrót: hasło analiza pytań wielokrotnego wyboru). Tutaj masz już zmienne 0/1 i chcesz wiedzieć, czy dwie grupy odpowiadają inaczej.
Kłopot polega na tym, że jedna osoba daje kilka odpowiedzi naraz. Kto zaznacza wiele źródeł, zaznacza je „hurtem”, więc odpowiedzi tej samej osoby są powiązane. Zwykłe testy dla tabel krzyżowych zakładają, że każda obserwacja w tabeli to inna, niezależna osoba. W pytaniu wielokrotnego wyboru to założenie nie jest spełnione, jeśli wrzucisz wszystkie zaznaczenia do jednej tabeli (Loughin i Scherer, 1998).
Przykład przewodni (dane symulowane). Studentka pielęgniarstwa zadała pytanie „Z jakich źródeł czerpiesz wiedzę o zapobieganiu zakażeniom szpitalnym? (zaznacz wszystkie, które pasują)”. Ankietę wypełniło 110 studentów pielęgniarstwa i 90 pielęgniarek pracujących na oddziałach, razem 200 osób. Kafeteria miała siedem opcji: podręczniki i skrypty, wykłady i szkolenia, procedury oddziału, artykuły naukowe, koleżanki i koledzy, strony internetowe, media społecznościowe, oraz pole „Inne (jakie?)”. Pytanie było obowiązkowe, więc w mianowniku każdej grupy są wszystkie osoby z tej grupy. Hipoteza: studenci i pielęgniarki korzystają z innych źródeł wiedzy.
Pułapka: chi-kwadrat na tabeli liczby zaznaczeń
Najczęstszy błąd wygląda niewinnie. Zliczasz, ile razy każda opcja została zaznaczona w każdej grupie, układasz tabelę 2 × 7 i liczysz test chi-kwadrat niezależności. W przykładzie taka tabela ma w sumie 652 zaznaczenia, choć osób jest 200. Program nie wie, że to te same osoby, i chętnie liczy: χ²(6) = 52.87, p < .001.
Ten wynik ma dwie wady. Po pierwsze, test jest niepoprawny statystycznie, bo jednostką w tabeli jest zaznaczenie, a nie osoba. Loughin i Scherer (1998) pokazali, że przy wielu odpowiedziach statystyka Pearsona nie ma już zwykłego rozkładu chi-kwadrat, a naiwnie zastosowany test silnie reaguje na wielokrotne odpowiedzi. Po drugie, test odpowiada na inne pytanie. Tabela zaznaczeń porównuje strukturę wszystkich wyborów w grupie („jaki procent wszystkich zaznaczeń przypada na podręczniki”), a Ciebie interesuje odsetek osób, które korzystają z danego źródła. Jeśli jedna grupa zaznacza więcej wszystkiego, struktura zaznaczeń bywa identyczna, choć odsetek osób przy każdej opcji jest wyższy (zob. symulacja niżej).
W przykładzie wniosek z błędnego testu przypadkiem zgadza się z poprawnymi metodami, bo różnice są duże. Nie licz na to w swoich danych.
Najpierw ustal, o co pytasz
„Czy grupy się różnią?” to w pytaniu wielokrotnego wyboru co najmniej trzy różne pytania. Każde ma inną hipotezę zerową i inny test. Zanim cokolwiek policzysz, zapisz w planie analizy, które z nich zadajesz.
| Pytanie badawcze | Hipoteza zerowa | Metoda |
|---|---|---|
| Przy których opcjach grupy się różnią? | Dla danej opcji odsetek osób jest taki sam w obu grupach | Osobny test 2 × 2 dla każdej opcji, różnica odsetków z 95% CI, korekta Holma |
| Czy grupy różnią się w czymkolwiek? | Dla wszystkich opcji naraz odsetki są takie same | Test łączny jednoczesnej niezależności brzegowej (MMI) z rozkładem z permutacji lub bootstrapu; Wald w modelu GEE |
| Czy grupy różnią się profilem, a nie tylko „ilością” zaznaczeń? | Różnica między grupami (iloraz szans) jest taka sama dla każdej opcji | GEE z interakcją opcja × grupa |
| Które opcje są popularniejsze w tej samej próbie? | Wszystkie opcje wybiera ten sam odsetek osób | Test Q Cochrana, potem McNemar parami z korektą Holma |
W pracy dyplomowej zwykle wystarczy pierwszy sposób; drugi lub trzeci dodajesz, gdy hipoteza dotyczy całego pytania. Poniżej liczymy wszystkie cztery na tych samych danych.
Sposób 1. Osobny test dla każdej opcji
Każda opcja to osobna zmienna tak/nie, a każda osoba jest w tabeli tylko raz. Dla opcji „procedury oddziału” tabela ma dwa wiersze (studenci, pielęgniarki) i dwie kolumny (zaznaczył, nie zaznaczył) – to zwykła tabela krzyżowa 2 × 2. Liczysz w niej odsetek osób w każdej grupie, różnicę odsetków i test. Gdy któraś liczebność oczekiwana jest mniejsza niż 5, zamiast chi-kwadrat użyj testu dokładnego Fishera. W przykładzie najmniejsza liczebność oczekiwana wyniosła 26.1, więc wystarczył chi-kwadrat bez poprawki Yatesa. Opcję „Inne” zaznaczyło tylko 5 studentów i 3 pielęgniarki, dlatego pokazujemy ją opisowo, bez testu. Jak przypisać wpisy z pola „Inne” do istniejących lub nowych kategorii, wyjaśnia wpis o odpowiedzi „Inne (jakie?)”.
Siedem testów to siedem okazji do fałszywego alarmu. Dlatego wartości p skoryguj poprawką Holma: zachowuje ona z góry ustalony poziom ochrony przed błędem I rodzaju dla całej rodziny testów i jest prosta w użyciu (Holm, 1979). Rodziną są zwykle wszystkie opcje jednego pytania; przy kilku takich pytaniach zdecyduj przed analizą, czy korygujesz w obrębie pytania, czy w całym badaniu.
Ważniejsza od p jest wielkość różnicy. Podaj różnicę odsetków w punktach procentowych z przedziałem Newcombe’a albo iloraz szans z 95% CI. Ogólne zasady porównywania dwóch odsetków omawia wpis jak porównać odsetki w dwóch grupach.
Tabela 1
Źródła wiedzy o zapobieganiu zakażeniom szpitalnym wskazywane przez studentów pielęgniarstwa i pielęgniarki
| Źródło wiedzy | Studenci n (%) | Pielęgniarki n (%) | Różnica [95% CI] | χ²(1) | pHolm |
|---|---|---|---|---|---|
| Procedury oddziału | 32 (29.1) | 68 (75.6) | 46.5 [33.1, 57.3] | 42.75 | < .001 |
| Koleżanki i koledzy | 35 (31.8) | 61 (67.8) | 36.0 [22.2, 47.8] | 25.64 | < .001 |
| Media społecznościowe | 34 (30.9) | 25 (27.8) | −3.1 [−15.4, 9.6] | 0.23 | .710 |
| Strony internetowe | 61 (55.5) | 44 (48.9) | −6.6 [−20.0, 7.2] | 0.86 | .710 |
| Artykuły naukowe | 38 (34.5) | 20 (22.2) | −12.3 [−24.2, 0.3] | 3.65 | .168 |
| Wykłady i szkolenia | 80 (72.7) | 41 (45.6) | −27.2 [−39.6, −13.5] | 15.29 | < .001 |
| Podręczniki i skrypty | 78 (70.9) | 35 (38.9) | −32.0 [−44.2, −18.3] | 20.65 | < .001 |
| Inne | 5 (4.5) | 3 (3.3) | — | — | — |
Uwaga. Studenci n = 110, pielęgniarki n = 90. Respondenci mogli zaznaczyć więcej niż jedno źródło, dlatego odsetki nie sumują się do 100. Różnica = odsetek pielęgniarek minus odsetek studentów, w punktach procentowych; 95% CI metodą Newcombe’a. χ² – test 2 × 2 dla danej opcji, p po korekcie Holma dla siedmiu opcji. Test łączny dla wszystkich siedmiu opcji: suma χ² = 109.07, p < .001 (9999 permutacji). Opcji „Inne” nie testowano z powodu małej liczebności. Dane symulowane.
Opcje uporządkowano według różnicy: pielęgniarki częściej sięgają po procedury oddziału i wiedzę od koleżanek i kolegów, studenci – po podręczniki i wykłady. Artykuły naukowe przed korektą dawały p = .056, a po korekcie Holma p = .168; przedział różnicy od −24.2 do 0.3 punktu obejmuje zero, ale też różnice umiarkowane. Napisz więc, że różnicy nie potwierdzono, a nie że grupy czytają artykuły tak samo. Inne układy tabeli i wykresy dla grup opisuje wpis o tabeli i wykresie dla pytania wielokrotnego wyboru.
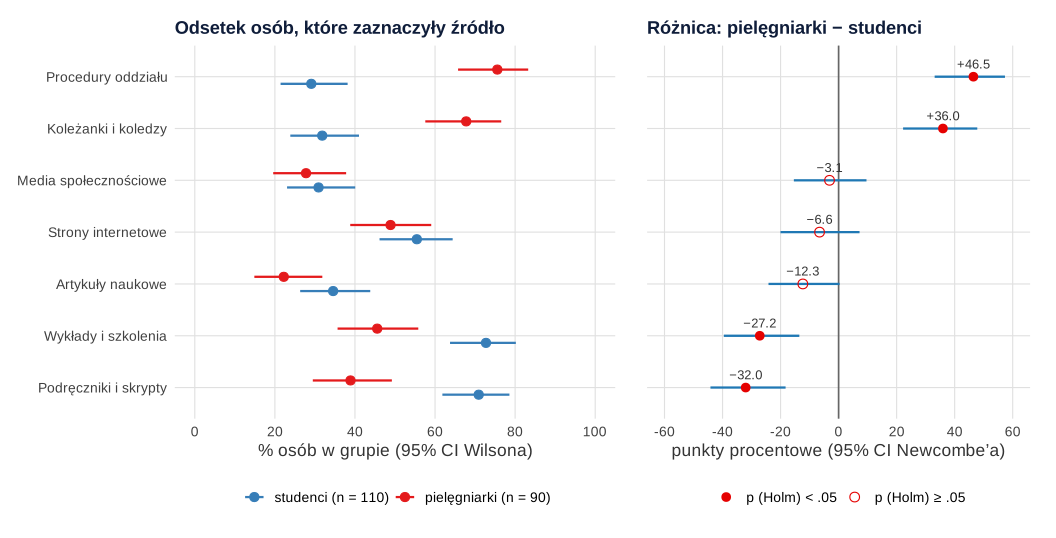
W SPSS i jamovi ten sposób to po prostu tabela krzyżowa grupa × zmienna 0/1 z testem chi-kwadrat, powtórzona dla każdej opcji. Jak ją wyklikać i co odczytać z wydruku, pokazują wpisy chi-kwadrat w SPSS i chi-kwadrat w jamovi, a skorygowane wartości p policzysz w kalkulatorze poprawek na wielokrotne porównania. Pilnuj tylko, żeby w każdej tabeli były osoby, a nie zaznaczenia.
Sposób 2. Test łączny: czy grupy różnią się w czymkolwiek?
Siedem osobnych testów nie odpowiada na pytanie, czy pytanie jako całość różnicuje grupy. Do tego służy test jednoczesnej niezależności brzegowej (ang. multiple marginal independence, MMI). Hipoteza zerowa mówi, że dla każdej opcji z osobna odsetek osób jest w obu grupach taki sam. Nazwa „brzegowa” oznacza, że test porównuje odsetki poszczególnych opcji, a nie całe kombinacje zaznaczeń. Bilder i in. (2000) zebrali i porównali metody tego testu, a dla praktyka podali zalecenia, którą wybrać.
Najprostsza statystyka to suma siedmiu statystyk chi-kwadrat z tabel 2 × 2. W przykładzie wynosi 109.07. Gdyby opcje były od siebie niezależne, suma miałaby rozkład chi-kwadrat z 7 stopniami swobody. Nie są: kto zaznacza wykłady, częściej zaznacza też podręczniki. Dlatego rozkład sumy przy prawdziwej hipotezie zerowej trzeba wyznaczyć inaczej. Loughin i Scherer (1998) zaproponowali bootstrap, a Decady i Thomas (2000) – prostszą poprawkę statystyki chi-kwadrat opartą na metodzie Rao–Scotta. W tym wpisie liczymy dwie wersje losowania, obie zachowują całe „wektory odpowiedzi” osób:
- test permutacyjny – losowo przetasowujesz etykiety grup między osobami (każda osoba zabiera ze sobą wszystkie swoje zaznaczenia), za każdym razem liczysz sumę chi-kwadrat i sprawdzasz, jak często jest ona co najmniej tak duża jak w danych (więcej o logice w haśle test permutacyjny);
- bootstrap z połączonej próby – losujesz ze zwracaniem całe wiersze osób z obu grup razem, przypisujesz je do grup o liczebnościach 110 i 90 i znowu liczysz sumę.
W obu wersjach powtórzeń było 9999, a p liczymy jako (b + 1) / (B + 1), gdzie b to liczba losowań z sumą co najmniej taką jak obserwowana. Dodanie jedynki sprawia, że permutacyjne p nigdy nie wynosi zero (Phipson i Smyth, 2010). Największa suma w 9999 permutacjach wyniosła 40.08, daleko od obserwowanych 109.07, więc p = .0001 w obu wersjach, czyli p < .001. Warto zajrzeć też w ogon rozkładu: 95. centyl rozkładu permutacyjnego to 14.54, a rozkładu chi-kwadrat z 7 stopniami swobody – 14.07. Przy silniej powiązanych opcjach ta różnica rośnie, a test „z tablic” zaczyna dawać zbyt wiele fałszywych alarmów.
Test łączny nie mówi, przy których opcjach grupy się różnią – do tego wracasz do sposobu 1. Logikę losowania opisuje wpis bootstrap i test permutacyjny krok po kroku.
Sposób 3. Model dla danych długich: regresja logistyczna GEE
Trzecie podejście zamienia pytanie w model. Dane przekształcasz do formatu długiego: każda osoba ma siedem wierszy, po jednym na opcję, a zmienna wynikowa to 0/1 („zaznaczył tę opcję”). W przykładzie to 1400 wierszy, a wiersze tej samej osoby są zależne. Uogólnione równania estymujące, czyli GEE, dają zgodne oszacowania współczynników i ich błędów standardowych bez opisywania pełnego rozkładu odpowiedzi osoby – wystarczy wskazać, które wiersze należą do tej samej osoby (Liang i Zeger, 1986).
Agresti i Liu (1999) opisali takie jednoczesne modelowanie logitów dla wszystkich opcji pytania wielokrotnego wyboru. Test, czy zmienna grupująca ma związek z którąkolwiek opcją, ma w nim c(r − 1) stopni swobody, gdzie c to liczba opcji, a r – liczba grup. W przykładzie to 7 × (2 − 1) = 7. Agresti i Liu (2001) wskazali później, że takie modele brzegowe słabiej opisują zależności między opcjami niż modele z efektami losowymi, ale wymagają mniej założeń i skupiają się na efektach, które zwykle najbardziej interesują badacza. Porównanie GEE z modelem mieszanym znajdziesz we wpisie GEE czy model mieszany.
W przykładzie dopasowaliśmy trzy modele i porównaliśmy je testem Walda z odpornymi błędami standardowymi:
- M0: tylko opcja – każda opcja ma swój odsetek, grupy się nie różnią;
- M1: opcja + grupa – grupa przesuwa szanse zaznaczenia każdej opcji o ten sam iloraz szans (jedna grupa „zaznacza więcej wszystkiego”);
- M2: opcja × grupa – różnica między grupami może być inna dla każdej opcji.
Porównanie M2 z M0 to test łączny w wersji modelowej: Wald χ²(7) = 106.4, p < .001 – wynik bardzo bliski sumie chi-kwadrat z poprzedniej sekcji. Porównanie M2 z M1 to test interakcji: χ²(6) = 106.39, p < .001. Wspólny iloraz szans dla grupy w modelu M1 wyniósł zaledwie 1.02. Razem te dwa wyniki mówią coś, czego nie widać w siedmiu osobnych testach: pielęgniarki nie zaznaczają więcej źródeł niż studenci, tylko inne źródła. Ilorazy szans dla poszczególnych opcji z modelu M2 są takie same jak w tabelach 2 × 2 (np. dla procedur oddziału OR = 7.53, 95% CI [4.00, 14.19], dla podręczników OR = 0.26, 95% CI [0.14, 0.47]), bo model z interakcją ma osobny parametr dla każdej komórki.
Po co więc model? Bo dodasz do niego zmienne kontrolne (np. staż), więcej grup albo zmienną ciągłą zamiast grupy. Uważaj tylko na opcje wybierane przez prawie wszystkich albo prawie nikogo – dają niestabilne oszacowania.
Uzupełnienie: liczba zaznaczonych opcji na osobę
Prosta zmienna pomocnicza pomaga zinterpretować wynik interakcji. Policz dla każdej osoby, ile opcji zaznaczyła, i porównaj grupy jak zwykłą zmienną ilościową. Studenci zaznaczali średnio 3.25 źródła (SD = 1.61), pielęgniarki 3.27 (SD = 1.70), mediana w obu grupach wyniosła 3. Test Manna–Whitneya nie wykazał różnicy, W = 4967.5, p = .966. To potwierdza odczytanie z modelu GEE: różnice w odsetkach przy poszczególnych opcjach nie wynikają z tego, że jedna grupa ma większą skłonność do zaznaczania.
Gdy taka różnica jest, zmienia interpretację: większość opcji wyjdzie w jednej grupie „istotnie częściej”, choć proporcje między źródłami mogą być takie same. Wtedy napisz najpierw o liczbie zaznaczeń, a potem o opcjach, które różnią się bardziej niż pozostałe (interakcja w GEE).
Sposób 4. Które opcje są popularniejsze w tej samej próbie?
Czasem pytanie nie dotyczy grup, tylko opcji: „czy z wykładów korzysta więcej osób niż z artykułów naukowych?”. To porównanie odsetków u tych samych osób, więc testy dla prób niezależnych nie pasują. Dla wszystkich opcji naraz użyj testu Q Cochrana, a pary porównaj testem McNemara z korektą Holma. W całej próbie (N = 200) odsetki wyniosły od 60.5% (wykłady i szkolenia) do 29.0% (artykuły naukowe), Q(6) = 83.36, p < .001. Spośród 21 par po korekcie istotne były wyłącznie porównania pięciu najczęstszych źródeł (od 48.0% do 60.5%) z dwoma najrzadszymi – mediami społecznościowymi (29.5%) i artykułami naukowymi (29.0%). Między pięcioma najczęstszymi różnice nie były istotne (najmniejsze skorygowane p = .162).
Uwaga: skoro grupy różnią się profilem, ranking w całej próbie zależy od tego, ilu w niej jest studentów, a ilu pielęgniarek. Opisz go wtedy osobno w każdej grupie albo zaznacz, że dotyczy próby o takim składzie.
Co się dzieje, gdy wybierzesz zły test: symulacja
Wygenerowaliśmy po 2000 badań w dwóch scenariuszach, z liczebnościami 110 i 90 osób i siedmioma powiązanymi opcjami. W scenariuszu A grupy nie różnią się w żadnej opcji, więc każdy wynik istotny to fałszywy alarm, a dobra metoda powinna dawać ich około 5%. W scenariuszu B pielęgniarki zaznaczają każdą opcję częściej (ten sam profil, większa liczba zaznaczeń), więc dobra metoda powinna tę różnicę wykryć.
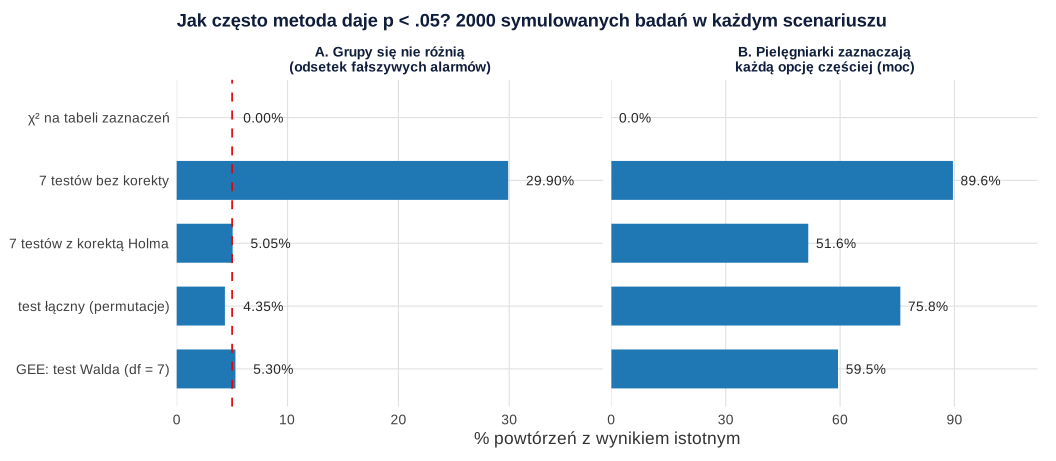
Wyniki są jednoznaczne (Rysunek 2). Siedem testów bez korekty dało co najmniej jeden fałszywy alarm w 29.90% badań, w których grupy w ogóle się nie różniły – sześć razy częściej niż deklarowane 5%. Korekta Holma (5.05%), test łączny z permutacjami (4.35%) i test Walda w modelu GEE (5.30%; w symulacji z niezależną macierzą roboczą) utrzymały poziom 5% w granicach błędu Monte Carlo, który przy 2000 powtórzeń wynosi około ±1.0 punktu procentowego. Naiwny chi-kwadrat na tabeli zaznaczeń w tych warunkach nie dał ani jednego wyniku istotnego. Był skrajnie zachowawczy, ale to nie zaleta: jego zachowanie zależy od tego, jak często i jak „hurtem” respondenci zaznaczają opcje, więc w innych danych może się mylić w przeciwną stronę.
Scenariusz B pokazuje drugą wadę naiwnego testu. Pielęgniarki zaznaczały w nim przeciętnie o jedną opcję więcej (w przykładowej próbie 4.16 wobec 3.17 na osobę), ale proporcje między opcjami były w obu grupach takie same. Naiwny test nie wykrył tej różnicy ani razu, bo porównuje strukturę zaznaczeń, a ta się nie zmieniła. Test łączny wykrył ją w 75.8% badań, test w modelu GEE w 59.5%, a osobne testy z korektą Holma w 51.6%. Wysokie 89.6% dla testów bez korekty nic nie znaczy, skoro ta procedura alarmuje w prawie co trzecim badaniu bez różnic. Gdy różnica jest rozłożona na wiele opcji, test łączny ma największą szansę ją wykryć, a testy z korektą pokażą, gdzie jest największa.
Jak opisać porównanie w pracy (APA)
W rozdziale o metodzie napisz, jak zakodowano pytanie, co jest mianownikiem odsetków i które testy wybrano – z korektą i liczbą powtórzeń losowania. W wynikach zacznij od tabeli (jak Tabela 1), a w tekście omów największe różnice z przedziałami ufności.
Jeśli chcesz, żeby ktoś sprawdził kodowanie pytań wielokrotnego wyboru i dobór testów, zanim oddasz rozdział promotorowi, zobacz ofertę analiz statystycznych dla studentów. Wyniki omawiamy tak, abyś umiał(a) samodzielnie je wyjaśnić; pomoc w analizie ujawnij zgodnie z zasadami swojej uczelni.
Najczęstsze błędy
- Jeden chi-kwadrat na tabeli zaznaczeń. W tabeli jest więcej obserwacji niż osób, test jest niepoprawny i porównuje strukturę zaznaczeń, a nie odsetki osób.
- Siedem testów bez korekty. Przy siedmiu opcjach szansa na co najmniej jeden fałszywy alarm jest kilkukrotnie większa niż 5% (zob. symulacja).
- Test łączny z tablic chi-kwadrat. Suma statystyk z siedmiu opcji nie ma rozkładu χ² z 7 stopniami swobody, bo opcje są powiązane. Rozkład wyznacz losowaniem.
- Testy dla prób niezależnych do porównania opcji między sobą. Opcje zaznaczają te same osoby – potrzebny jest Q Cochrana i McNemar.
- Pomijanie liczby zaznaczeń. Bez niej nie wiesz, czy grupa wybiera inne opcje, czy po prostu więcej opcji.
- Testowanie opcji „Inne” jak każdej innej. Najpierw ją zakoduj, resztę pokaż opisowo.
- Raport samego p. Podaj odsetki w grupach i różnicę z przedziałem ufności.
Porównanie pytań wielokrotnego wyboru w R: kod i wynik
Dwa przepisy liczą wszystkie liczby z tekstu, tabeli i rysunków. Pierwszy tworzy dane, rozpakowuje eksport w stylu Google Forms na zmienne 0/1, zapisuje plik CSV w folderze nadrzędnym (../) i liczy cztery sposoby porównania. Drugi to symulacja z Rysunku 2. Rysunki powstały w osobnym skrypcie na tych samych danych. Dane przykładu możesz pobrać: porownanie-pytan-wielokrotnego-wyboru-dane.csv (200 osób: grupa, surowa odpowiedź w jednej komórce i osiem zmiennych 0/1).
Studenci i pielęgniarki: pułapka, testy dla opcji, test łączny, GEE i Q Cochrana
R
# B425 – porównanie pytania wielokrotnego wyboru między dwiema grupami (dane symulowane)
# Pytanie: „Z jakich źródeł czerpiesz wiedzę o zapobieganiu zakażeniom szpitalnym?
# (zaznacz wszystkie, które pasują)”. Grupy: studenci pielęgniarstwa i pielęgniarki pracujące.
suppressPackageStartupMessages(library(geepack))
options(width = 110)
set.seed(425)

opcje <- c("Podręczniki i skrypty", "Wykłady i szkolenia", "Procedury oddziału",
           "Artykuły naukowe", "Koleżanki i koledzy", "Strony internetowe",
           "Media społecznościowe")
skrot <- c("podreczniki", "wyklady", "procedury", "artykuly", "koledzy", "internet", "media")
p_stud <- c(.70, .72, .30, .25, .35, .55, .30)   # prawdopodobieństwa w symulacji
p_piel <- c(.38, .55, .72, .24, .62, .52, .22)
n_stud <- 110; n_piel <- 90; N <- n_stud + n_piel
grupa <- factor(rep(c("studenci", "pielęgniarki"), c(n_stud, n_piel)),
                levels = c("studenci", "pielęgniarki"))
aktywnosc <- rnorm(N, 0, 0.8)          # skłonność osoby do zaznaczania wielu opcji
Y <- sapply(1:7, function(j) {
  p <- ifelse(grupa == "studenci", p_stud[j], p_piel[j])
  rbinom(N, 1, plogis(qlogis(p) + aktywnosc))
})
inne <- rbinom(N, 1, .04)
# Eksport w stylu Google Forms: wszystkie zaznaczenia w jednej komórce, rozdzielone „, ”
surowe <- sapply(1:N, function(i) paste(c(opcje[Y[i, ] == 1],
                                          if (inne[i] == 1) "plakaty w dyżurce"), collapse = ", "))
d <- data.frame(id = 1:N, grupa, zrodla = surowe)
head(d, 3)

# Rozpakowanie na zmienne 0/1 (szczegóły: wpis o kodowaniu pytań wielokrotnego wyboru)
czesci <- strsplit(d$zrodla, ", ", fixed = TRUE)
for (j in 1:7) d[[skrot[j]]] <- as.integer(sapply(czesci, function(x) opcje[j] %in% x))
d$inne <- as.integer(sapply(czesci, function(x) any(!x %in% opcje)))
write.csv(d, "../porownanie-pytan-wielokrotnego-wyboru-dane.csv", row.names = FALSE)
Y <- as.matrix(d[, skrot])
cat("Liczba osób w grupach:\n"); print(table(d$grupa))

cat("\n1. PUŁAPKA: chi-kwadrat na tabeli liczby zaznaczeń (opcja × grupa)\n")
zaznaczenia <- rbind(studenci = colSums(Y[d$grupa == "studenci", ]),
                     pielegniarki = colSums(Y[d$grupa == "pielęgniarki", ]))
print(zaznaczenia)
cat("Suma w tabeli:", sum(zaznaczenia), "zaznaczeń, a osób jest", N, "\n")
print(chisq.test(zaznaczenia))

cat("\n2. OSOBNY TEST DLA KAŻDEJ OPCJI (tabela 2 × 2, % osób) + korekta Holma\n")
wilson <- function(k, n) {               # przedział Wilsona dla jednej proporcji
  z <- qnorm(.975); p <- k / n
  srodek <- (p + z^2 / (2 * n)) / (1 + z^2 / n)
  pol <- z * sqrt(p * (1 - p) / n + z^2 / (4 * n^2)) / (1 + z^2 / n)
  c(srodek - pol, srodek + pol)
}
newcombe <- function(k1, n1, k2, n2) {   # różnica p2 − p1, przedział Newcombe’a (hybrydowy Wilsona)
  p1 <- k1 / n1; p2 <- k2 / n2; w1 <- wilson(k1, n1); w2 <- wilson(k2, n2)
  c(p2 - p1 - sqrt((p2 - w2[1])^2 + (w1[2] - p1)^2),
    p2 - p1 + sqrt((w2[2] - p2)^2 + (p1 - w1[1])^2))
}
s <- d$grupa == "studenci"; p <- d$grupa == "pielęgniarki"
wyniki <- do.call(rbind, lapply(1:7, function(j) {
  k1 <- sum(Y[s, j]); k2 <- sum(Y[p, j])
  tab <- table(d$grupa, factor(Y[, j], levels = c(1, 0)))
  ch <- suppressWarnings(chisq.test(tab, correct = FALSE))
  ci <- newcombe(k1, n_stud, k2, n_piel)
  or <- (k2 / (n_piel - k2)) / (k1 / (n_stud - k1))
  se <- sqrt(1 / k1 + 1 / (n_stud - k1) + 1 / k2 + 1 / (n_piel - k2))
  data.frame(opcja = skrot[j], stud_n = k1, stud_proc = 100 * k1 / n_stud,
             piel_n = k2, piel_proc = 100 * k2 / n_piel,
             roznica = 100 * (k2 / n_piel - k1 / n_stud), ci_dol = 100 * ci[1], ci_gora = 100 * ci[2],
             OR = or, OR_dol = exp(log(or) - 1.96 * se), OR_gora = exp(log(or) + 1.96 * se),
             chi2 = unname(ch$statistic), p = ch$p.value, min_oczek = min(ch$expected))
}))
wyniki$p_holm <- p.adjust(wyniki$p, method = "holm")
print(format(wyniki[, c("opcja", "stud_n", "stud_proc", "piel_n", "piel_proc")], digits = 3,
             nsmall = 1), row.names = FALSE)
print(data.frame(opcja = wyniki$opcja, roznica = round(wyniki$roznica, 1),
                 ci_dol = round(wyniki$ci_dol, 1), ci_gora = round(wyniki$ci_gora, 1),
                 OR = round(wyniki$OR, 2), OR_dol = round(wyniki$OR_dol, 2), OR_gora = round(wyniki$OR_gora, 2),
                 chi2 = round(wyniki$chi2, 2), p = signif(wyniki$p, 3), p_holm = signif(wyniki$p_holm, 3),
                 min_oczek = round(wyniki$min_oczek, 1)), row.names = FALSE)
cat("Opcja Inne:", sum(d$inne[s]), "studentów i", sum(d$inne[p]), "pielęgniarek (tylko opis)\n")

cat("\n3. TEST ŁĄCZNY (jednoczesna niezależność brzegowa, MMI)\n")
# Statystyka: suma chi-kwadrat Pearsona z tabel 2 × 2 dla wszystkich 7 opcji
suma_chi2 <- function(Y, g1) {           # g1 – macierz 0/1 (osoby × powtórzenia): czy osoba w grupie 1
  n <- nrow(Y); n1 <- sum(g1[, 1]); tj <- colSums(Y)
  A <- crossprod(g1, Y)                  # liczba zaznaczeń w grupie 1 dla każdej opcji
  X2 <- n * sweep(A * n, 2, n1 * tj)^2   # chi-kwadrat 2 × 2: n(an − n1t)² / (n1 n2 t (n − t))
  rowSums(sweep(X2, 2, n1 * (n - n1) * tj * (n - tj), "/"))
}
g_obs <- matrix(as.numeric(s), ncol = 1)
X2_obs <- suma_chi2(Y, g_obs)
cat(sprintf("Suma chi-kwadrat (7 opcji): %.2f\n", X2_obs))
cat(sprintf("Kontrola: suma z tabeli w punkcie 2 = %.2f\n", sum(wyniki$chi2)))
B <- 9999
perm <- sapply(1:B, function(b) sample(as.numeric(s)))            # permutacja etykiet grup
X2_perm <- suma_chi2(Y, perm)
boot <- sapply(1:B, function(b) sample(N, N, replace = TRUE))     # bootstrap z połączonej próby
X2_boot <- sapply(1:B, function(b) suma_chi2(Y[boot[, b], ], g_obs))
cat(sprintf("p permutacyjne (B = %d): %.4f\n", B, (sum(X2_perm >= X2_obs) + 1) / (B + 1)))
cat(sprintf("p bootstrapowe (B = %d): %.4f\n", B, (sum(X2_boot >= X2_obs) + 1) / (B + 1)))
cat(sprintf("Największa suma w %d permutacjach: %.2f\n", B, max(X2_perm)))
cat(sprintf("95. centyl rozkładu permutacyjnego: %.2f (chi-kwadrat z df = 7: %.2f)\n",
            quantile(X2_perm, .95), qchisq(.95, 7)))

cat("\n4. MODEL DLA DANYCH DŁUGICH: regresja logistyczna GEE (osoba × opcja)\n")
dl <- data.frame(id = rep(d$id, 7), grupa = rep(d$grupa, 7),
                 opcja = factor(rep(skrot, each = N), levels = skrot), y = as.vector(Y))
dl <- dl[order(dl$id), ]
m0 <- geeglm(y ~ opcja, family = binomial, id = id, data = dl, corstr = "exchangeable")
m1 <- geeglm(y ~ opcja + grupa, family = binomial, id = id, data = dl, corstr = "exchangeable")
m2 <- geeglm(y ~ opcja * grupa, family = binomial, id = id, data = dl, corstr = "exchangeable")
cat("Czy grupy różnią się w którejkolwiek opcji (M2 vs M0, df = 7)?\n"); print(anova(m2, m0))
cat("Czy różnica między grupami zależy od opcji (interakcja, M2 vs M1, df = 6)?\n"); print(anova(m2, m1))
cat(sprintf("Wspólny OR dla grupy w modelu bez interakcji (M1): %.2f\n", exp(coef(m1)["grupapielęgniarki"])))
# OR pielęgniarki vs studenci dla każdej opcji z modelu z interakcją (odporne SE)
L <- sapply(1:7, function(j) { l <- setNames(rep(0, length(coef(m2))), names(coef(m2)))
  l["grupapielęgniarki"] <- 1
  if (j > 1) l[paste0("opcja", skrot[j], ":grupapielęgniarki")] <- 1
  l })
est <- drop(t(L) %*% coef(m2)); se <- sqrt(diag(t(L) %*% vcov(m2) %*% L))
print(data.frame(opcja = skrot, OR_gee = round(exp(est), 2),
                 dol = round(exp(est - 1.96 * se), 2), gora = round(exp(est + 1.96 * se), 2)),
      row.names = FALSE)

cat("\n5. LICZBA ZAZNACZONYCH OPCJI NA OSOBĘ\n")
d$liczba <- rowSums(Y)
print(aggregate(liczba ~ grupa, data = d, function(x) round(c(M = mean(x), SD = sd(x), Me = median(x)), 2)))
print(wilcox.test(liczba ~ grupa, data = d, exact = FALSE))

cat("\n6. POPULARNOŚĆ OPCJI W TEJ SAMEJ PRÓBIE (wszyscy, N = 200): Q Cochrana + McNemar\n")
k <- ncol(Y); C <- colSums(Y); R <- rowSums(Y); S <- sum(Y)
Q <- (k - 1) * (k * sum(C^2) - S^2) / (k * S - sum(R^2))
print(round(sort(100 * C / N, decreasing = TRUE), 1))
cat(sprintf("Q(%d) = %.2f, p = %.3g\n", k - 1, Q, pchisq(Q, k - 1, lower.tail = FALSE)))
pary <- combn(skrot, 2)
mc <- apply(pary, 2, function(x) { t <- mcnemar.test(Y[, x[1]], Y[, x[2]], correct = FALSE)
  c(chi2 = unname(t$statistic), p = t$p.value) })
mc <- data.frame(para = apply(pary, 2, paste, collapse = "-"), chi2 = round(mc["chi2", ], 2),
                 p = signif(mc["p", ], 3), p_holm = signif(p.adjust(mc["p", ], "holm"), 3))
print(mc[order(mc$p), ], row.names = FALSE)
Wynik w R
  id    grupa                                                                                 zrodla
1  1 studenci                        Podręczniki i skrypty, Wykłady i szkolenia, Koleżanki i koledzy
2  2 studenci                                                                       Artykuły naukowe
3  3 studenci Podręczniki i skrypty, Wykłady i szkolenia, Koleżanki i koledzy, Media społecznościowe
Liczba osób w grupach:

    studenci pielęgniarki
         110           90

1. PUŁAPKA: chi-kwadrat na tabeli liczby zaznaczeń (opcja × grupa)
             podreczniki wyklady procedury artykuly koledzy internet media
studenci              78      80        32       38      35       61    34
pielegniarki          35      41        68       20      61       44    25
Suma w tabeli: 652 zaznaczeń, a osób jest 200

	Pearson's Chi-squared test

data:  zaznaczenia
X-squared = 52.873, df = 6, p-value = 1.244e-09


2. OSOBNY TEST DLA KAŻDEJ OPCJI (tabela 2 × 2, % osób) + korekta Holma
       opcja stud_n stud_proc piel_n piel_proc
 podreczniki     78      70.9     35      38.9
     wyklady     80      72.7     41      45.6
   procedury     32      29.1     68      75.6
    artykuly     38      34.5     20      22.2
     koledzy     35      31.8     61      67.8
    internet     61      55.5     44      48.9
       media     34      30.9     25      27.8
       opcja roznica ci_dol ci_gora   OR OR_dol OR_gora  chi2        p   p_holm min_oczek
 podreczniki   -32.0  -44.2   -18.3 0.26   0.14    0.47 20.65 5.51e-06 2.76e-05      39.1
     wyklady   -27.2  -39.6   -13.5 0.31   0.17    0.57 15.29 9.21e-05 3.68e-04      35.5
   procedury    46.5   33.1    57.3 7.53   4.00   14.19 42.75 6.23e-11 4.36e-10      45.0
    artykuly   -12.3  -24.2     0.3 0.54   0.29    1.02  3.65 5.60e-02 1.68e-01      26.1
     koledzy    36.0   22.2    47.8 4.51   2.48    8.19 25.64 4.11e-07 2.46e-06      43.2
    internet    -6.6  -20.0     7.2 0.77   0.44    1.34  0.86 3.55e-01 7.10e-01      42.8
       media    -3.1  -15.4     9.6 0.86   0.47    1.59  0.23 6.29e-01 7.10e-01      26.6
Opcja Inne: 5 studentów i 3 pielęgniarek (tylko opis)

3. TEST ŁĄCZNY (jednoczesna niezależność brzegowa, MMI)
Suma chi-kwadrat (7 opcji): 109.07
Kontrola: suma z tabeli w punkcie 2 = 109.07
p permutacyjne (B = 9999): 0.0001
p bootstrapowe (B = 9999): 0.0001
Największa suma w 9999 permutacjach: 40.08
95. centyl rozkładu permutacyjnego: 14.54 (chi-kwadrat z df = 7: 14.07)

4. MODEL DLA DANYCH DŁUGICH: regresja logistyczna GEE (osoba × opcja)
Czy grupy różnią się w którejkolwiek opcji (M2 vs M0, df = 7)?
Analysis of 'Wald statistic' Table

Model 1 y ~ opcja * grupa
Model 2 y ~ opcja
  Df    X2 P(>|Chi|)
1  7 106.4 < 2.2e-16 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Czy różnica między grupami zależy od opcji (interakcja, M2 vs M1, df = 6)?
Analysis of 'Wald statistic' Table

Model 1 y ~ opcja * grupa
Model 2 y ~ opcja + grupa
  Df     X2 P(>|Chi|)
1  6 106.39 < 2.2e-16 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Wspólny OR dla grupy w modelu bez interakcji (M1): 1.02
       opcja OR_gee  dol  gora
 podreczniki   0.26 0.14  0.47
     wyklady   0.31 0.17  0.57
   procedury   7.53 4.00 14.19
    artykuly   0.54 0.29  1.02
     koledzy   4.51 2.48  8.19
    internet   0.77 0.44  1.34
       media   0.86 0.47  1.59

5. LICZBA ZAZNACZONYCH OPCJI NA OSOBĘ
         grupa liczba.M liczba.SD liczba.Me
1     studenci     3.25      1.61      3.00
2 pielęgniarki     3.27      1.70      3.00

	Wilcoxon rank sum test with continuity correction

data:  liczba by grupa
W = 4967.5, p-value = 0.9662
alternative hypothesis: true location shift is not equal to 0


6. POPULARNOŚĆ OPCJI W TEJ SAMEJ PRÓBIE (wszyscy, N = 200): Q Cochrana + McNemar
    wyklady podreczniki    internet   procedury     koledzy       media    artykuly
       60.5        56.5        52.5        50.0        48.0        29.5        29.0
Q(6) = 83.36, p = 7.23e-16
                  para  chi2        p   p_holm
      wyklady-artykuly 41.78 1.02e-10 2.14e-09
         wyklady-media 41.78 1.02e-10 2.14e-09
  podreczniki-artykuly 35.59 2.44e-09 4.63e-08
     podreczniki-media 32.40 1.25e-08 2.26e-07
        internet-media 27.13 1.90e-07 3.24e-06
     artykuly-internet 23.75 1.10e-06 1.75e-05
       procedury-media 20.75 5.22e-06 7.84e-05
    procedury-artykuly 19.17 1.19e-05 1.67e-04
         koledzy-media 15.04 1.05e-04 1.37e-03
      artykuly-koledzy 14.73 1.24e-04 1.48e-03
       wyklady-koledzy  5.95 1.47e-02 1.62e-01
     wyklady-procedury  4.12 4.23e-02 4.23e-01
      wyklady-internet  3.46 6.29e-02 5.66e-01
   podreczniki-koledzy  2.56 1.10e-01 8.78e-01
 podreczniki-procedury  1.64 2.00e-01 1.00e+00
      koledzy-internet  0.95 3.29e-01 1.00e+00
   podreczniki-wyklady  0.76 3.83e-01 1.00e+00
  podreczniki-internet  0.76 3.83e-01 1.00e+00
    procedury-internet  0.25 6.15e-01 1.00e+00
     procedury-koledzy  0.22 6.42e-01 1.00e+00
        artykuly-media  0.01 9.08e-01 1.00e+00
Symulacja: fałszywe alarmy i moc pięciu sposobów analizy
R
# B425 – symulacja: jak często każda metoda daje p < .05 (dane symulowane)
# Scenariusz A: grupy NIE różnią się w żadnej opcji (prawdziwa H0) – odsetek p < .05 = błąd I rodzaju.
# Scenariusz B: pielęgniarki zaznaczają każdą opcję częściej (ten sam profil, większa liczba zaznaczeń).
suppressPackageStartupMessages(library(geepack))
set.seed(4250)
p_wspolne <- c(.54, .64, .49, .25, .47, .54, .27)  # te same prawdopodobieństwa w obu grupach
n1 <- 110; n2 <- 90; n <- n1 + n2; c_op <- 7
g <- rep(1:2, c(n1, n2))
generuj <- function(przesuniecie = 0) {   # przesunięcie logitu u pielęgniarek (scenariusz B)
  akt <- rnorm(n, 0, 0.8) + przesuniecie * (g == 2)
  sapply(p_wspolne, function(p) rbinom(n, 1, plogis(qlogis(p) + akt)))
}
suma_chi2 <- function(Y, G) {             # G – macierz 0/1: czy osoba w grupie 1 (kolumna = permutacja)
  tj <- colSums(Y); m1 <- sum(G[, 1])
  rowSums(sweep(n * sweep(crossprod(G, Y) * n, 2, m1 * tj)^2, 2, m1 * (n - m1) * tj * (n - tj), "/"))
}
jedna_proba <- function(Y) {
  g1 <- as.numeric(g == 1)
  zazn <- rbind(colSums(Y[g == 1, ]), colSums(Y[g == 2, ]))
  p_naiwny <- suppressWarnings(chisq.test(zazn)$p.value)
  p_opcje <- apply(Y, 2, function(y) suppressWarnings(chisq.test(table(g, y), correct = FALSE)$p.value))
  X2 <- suma_chi2(Y, matrix(g1, ncol = 1))
  X2_perm <- suma_chi2(Y, sapply(1:999, function(b) sample(g1)))
  dl <- data.frame(id = rep(1:n, each = c_op), grupa = factor(rep(g, each = c_op)),
                   opcja = factor(rep(1:c_op, n)), y = as.vector(t(Y)))
  m2 <- geeglm(y ~ opcja * grupa, family = binomial, id = id, data = dl, corstr = "independence")
  m0 <- geeglm(y ~ opcja, family = binomial, id = id, data = dl, corstr = "independence")
  c(naiwny = p_naiwny < .05,
    bez_korekty = any(p_opcje < .05),
    holm = any(p.adjust(p_opcje, "holm") < .05),
    mmi_perm = (sum(X2_perm >= X2) + 1) / 1000 < .05,
    gee = anova(m2, m0)$`P(>|Chi|)` < .05)
}
R <- 2000
A <- t(replicate(R, jedna_proba(generuj(0))))
B <- t(replicate(R, jedna_proba(generuj(0.5))))
wynik <- data.frame(metoda = colnames(A), H0_prawdziwa = 100 * colMeans(A), wiecej_zaznaczen = 100 * colMeans(B))
cat("Odsetek powtórzeń z wynikiem istotnym (p < .05),", R, "powtórzeń na scenariusz:\n")
print(format(wynik, digits = 3, nsmall = 1), row.names = FALSE)
cat(sprintf("Błąd Monte Carlo przy 5%%: ±%.1f pkt proc. (2 SE)\n", 200 * sqrt(.05 * .95 / R)))
Yb <- generuj(0.5)
cat(sprintf("Przykładowa próba ze scenariusza B: średnio %.2f vs %.2f zaznaczeń na osobę\n",
            mean(rowSums(Yb[g == 1, ])), mean(rowSums(Yb[g == 2, ]))))
write.csv(wynik, "b425-symulacja.csv", row.names = FALSE)
Wynik w R
Odsetek powtórzeń z wynikiem istotnym (p < .05), 2000 powtórzeń na scenariusz:
      metoda H0_prawdziwa wiecej_zaznaczen
      naiwny         0.00              0.0
 bez_korekty        29.90             89.6
        holm         5.05             51.6
    mmi_perm         4.35             75.8
         gee         5.30             59.5
Błąd Monte Carlo przy 5%: ±1.0 pkt proc. (2 SE)
Przykładowa próba ze scenariusza B: średnio 3.17 vs 4.16 zaznaczeń na osobę
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem geepack (pozostałe obliczenia: funkcje pakietów base i stats); rysunki przygotowano w pakietach ggplot2, patchwork i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- geepack (wersja 1.3.13): Halekoh, U., Højsgaard, S., & Yan, J. (2006). The R package geepack for generalized estimating equations. Journal of Statistical Software, 15(2), 1–11. https://doi.org/10.18637/jss.v015.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czy można zrobić jeden test chi-kwadrat dla całego pytania wielokrotnego wyboru i dwóch grup?
Nie na tabeli liczby zaznaczeń, bo każda osoba występuje w niej tyle razy, ile opcji zaznaczyła, a test zakłada niezależne obserwacje. Policz osobny test 2 × 2 dla każdej opcji, a jeśli potrzebujesz jednego wyniku dla całego pytania – test łączny, w którym rozkład sumy statystyk χ² wyznaczasz permutacjami etykiet grup.
Czy przy porównaniu grup w każdej opcji pytania wielokrotnego wyboru trzeba robić poprawkę?
Tak, jeśli wnioskujesz z serii testów, że grupy się różnią. W symulacji z siedmioma opcjami i bez prawdziwych różnic testy bez korekty dawały co najmniej jeden fałszywy alarm w 29.90% badań, a z korektą Holma w 5.05%. Rodziną testów są zwykle wszystkie opcje jednego pytania.
Co to jest test jednoczesnej niezależności brzegowej (MMI)?
To test hipotezy, że dla każdej opcji pytania wielokrotnego wyboru odsetek osób, które ją zaznaczyły, jest taki sam we wszystkich grupach. Statystyką bywa suma statystyk χ² z tabel 2 × 2 dla wszystkich opcji, a jej rozkład wyznacza się bootstrapem, permutacjami lub poprawką Rao–Scotta, bo opcje są ze sobą powiązane.
Jak sprawdzić, czy jedna grupa po prostu zaznacza więcej odpowiedzi?
Policz dla każdej osoby liczbę zaznaczonych opcji i porównaj grupy testem dla zmiennej ilościowej, np. Manna–Whitneya. Uzupełnij to modelem GEE: jeśli wspólny iloraz szans dla grupy jest bliski 1, a interakcja opcja × grupa jest istotna, grupy wybierają inne opcje, a nie więcej opcji.
Czy do pytania wielokrotnego wyboru można użyć regresji logistycznej?
Tak, ale w formacie długim (osoba × opcja) i z uwzględnieniem tego, że wiersze tej samej osoby są zależne, np. przez GEE z odpornymi błędami standardowymi. Model z interakcją opcja × grupa daje iloraz szans dla każdej opcji i pozwala dodać zmienne kontrolne, czego nie zrobisz w osobnych tabelach 2 × 2.
Powiązane hasła
Przeczytaj też
Pytania wielokrotnego wyboru – kodowanie i liczenie
Eksport z Google Forms i LimeSurvey, zmienne 0/1, mianownik, % osób z przedziałem Wilsona i liczenie w R, Excelu, SPSS, jamovi i SZTOS.
Czytaj →PoradnikPytanie wielokrotnego wyboru: tabela i wykres APA
Tabela APA z % osób i 95% CI, porównanie grup, poziome słupki, punkty dla grup, macierz współwystępowania i wykres kombinacji – z kodem R.
Czytaj →Poradnik„Inne (jakie?)” – jak zakodować wpisy własne
Eksport z Google Forms i LimeSurvey, czyszczenie tekstu, przekodowanie wsteczne, nowe kategorie według progu, kappa Cohena i odsetki przed i po – z kodem R.
Czytaj →Porównujesz grupy w pytaniach wielokrotnego wyboru i nie wiesz, który test wybrać?
Sprawdzimy kodowanie odpowiedzi, dobierzemy testy z odpowiednią korektą i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Agresti, A., & Liu, I. (2001). Strategies for modeling a categorical variable allowing multiple category choices. Sociological Methods & Research, 29(4), 403–434. https://doi.org/10.1177/0049124101029004001
- Agresti, A., & Liu, I.-M. (1999). Modeling a categorical variable allowing arbitrarily many category choices. Biometrics, 55(3), 936–943. https://doi.org/10.1111/j.0006-341x.1999.00936.x
- Bilder, C. R., Loughin, T. M., & Nettleton, D. (2000). Multiple marginal independence testing for pick any/C variables. Communications in Statistics – Simulation and Computation, 29(4), 1285–1316. https://doi.org/10.1080/03610910008813665
- Decady, Y. J., & Thomas, D. R. (2000). A simple test of association for contingency tables with multiple column responses. Biometrics, 56(3), 893–896. https://doi.org/10.1111/j.0006-341x.2000.00893.x
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70. https://www.jstor.org/stable/4615733
- Liang, K.-Y., & Zeger, S. L. (1986). Longitudinal data analysis using generalized linear models. Biometrika, 73(1), 13–22. https://doi.org/10.1093/biomet/73.1.13
- Loughin, T. M., & Scherer, P. N. (1998). Testing for association in contingency tables with multiple column responses. Biometrics, 54(2), 630–637. https://doi.org/10.2307/3109769
- Phipson, B., & Smyth, G. K. (2010). Permutation p-values should never be zero: Calculating exact p-values when permutations are randomly drawn. Statistical Applications in Genetics and Molecular Biology, 9(1), Article 39. https://doi.org/10.2202/1544-6115.1585 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{agresti2001strategies, author={Agresti, Alan and Liu, Ivy}, title={{Strategies for modeling a categorical variable allowing multiple category choices}}, journal={Sociological Methods \& Research}, year={2001}, volume={29}, number={4}, pages={403--434}, doi={10.1177/0049124101029004001}}@article{agresti1999modeling, author={Agresti, Alan and Liu, I-Ming}, title={{Modeling a categorical variable allowing arbitrarily many category choices}}, journal={Biometrics}, year={1999}, volume={55}, number={3}, pages={936--943}, doi={10.1111/j.0006-341x.1999.00936.x}}@article{bilder2000multiple, author={Bilder, Christopher R. and Loughin, Thomas M. and Nettleton, Dan}, title={{Multiple marginal independence testing for pick any/C variables}}, journal={Communications in Statistics – Simulation and Computation}, year={2000}, volume={29}, number={4}, pages={1285--1316}, doi={10.1080/03610910008813665}}@article{decady2000simple, author={Decady, Yves J. and Thomas, David R.}, title={{A simple test of association for contingency tables with multiple column responses}}, journal={Biometrics}, year={2000}, volume={56}, number={3}, pages={893--896}, doi={10.1111/j.0006-341x.2000.00893.x}}@article{holm1979simple, author={Holm, Sture}, title={{A simple sequentially rejective multiple test procedure}}, journal={Scandinavian Journal of Statistics}, year={1979}, volume={6}, number={2}, pages={65--70}, url={https://www.jstor.org/stable/4615733}}@article{liang1986longitudinal, author={Liang, Kung-Yee and Zeger, Scott L.}, title={{Longitudinal data analysis using generalized linear models}}, journal={Biometrika}, year={1986}, volume={73}, number={1}, pages={13--22}, doi={10.1093/biomet/73.1.13}}@article{loughin1998testing, author={Loughin, Thomas M. and Scherer, Peter N.}, title={{Testing for association in contingency tables with multiple column responses}}, journal={Biometrics}, year={1998}, volume={54}, number={2}, pages={630--637}, doi={10.2307/3109769}}@article{phipson2010permutation, author={Phipson, Belinda and Smyth, Gordon K.}, title={{Permutation p-values should never be zero: Calculating exact p-values when permutations are randomly drawn}}, journal={Statistical Applications in Genetics and Molecular Biology}, year={2010}, volume={9}, number={1}, eid={39}, doi={10.2202/1544-6115.1585}}