Co pokazać po policzeniu pytania wielokrotnego wyboru
Masz już pytanie „zaznacz wszystkie pasujące” zakodowane jako osobne zmienne 0/1 i wiesz, że odsetki liczy się od osób, a nie od zaznaczeń – to opisujemy w poradniku pytania wielokrotnego wyboru w ankiecie: jak zakodować i policzyć, a definicję znajdziesz w haśle analiza pytań wielokrotnego wyboru. Ten wpis zaczyna się w miejscu, w którym trzeba wyniki pokazać: jak zbudować tabelę w stylu APA, jak narysować wykres, który nie wprowadza w błąd, jak zestawić dwie grupy i jak pokazać, które odpowiedzi respondenci zaznaczali razem.
Wszystkie tabele i rysunki powstały na jednym przykładzie (dane symulowane). W ankiecie wśród 260 pielęgniarek i pielęgniarzy z oddziałów zabiegowych i zachowawczych zadano pytanie: „Co utrudnia Ci edukację pacjenta przed wypisem? (zaznacz wszystkie pasujące)”. Kafeteria miała siedem trudności, opcję „Inne (jakie?)” i opcję wykluczającą „Nie napotykam trudności”. Osiem osób pominęło pytanie. Dane w pliku CSV i kod R są na końcu wpisu.
Zwykle wystarczą tabela, jeden wykres i dwa–trzy zdania opisu; porównanie grup i współwystępowanie dodaj, gdy wynikają z pytań badawczych.
Wzór tabeli APA dla pytania wielokrotnego wyboru
Tabela 1 pokazuje cały wynik pytania w układzie, który możesz skopiować do pracy. Zasady formatowania (numer tabeli pogrubiony, tytuł kursywą, tylko linie poziome, nota pod tabelą) są takie same jak w każdej tabeli według stylu APA (American Psychological Association, 2020); więcej wzorów znajdziesz w zestawieniu tabele APA w pracy.
Tabela 1
Trudności w edukacji pacjenta przed wypisem zgłaszane przez pielęgniarki i pielęgniarzy
| Trudność | n | % | 95% CI |
|---|---|---|---|
| Brak czasu przy wypisie | 146 | 57.9 | [51.8, 63.9] |
| Przerywanie rozmowy przez inne obowiązki | 109 | 43.3 | [37.3, 49.4] |
| Brak materiałów edukacyjnych | 78 | 31.0 | [25.6, 36.9] |
| Zmęczenie lub zły stan pacjenta | 68 | 27.0 | [21.9, 32.8] |
| Brak spokojnego miejsca na rozmowę | 60 | 23.8 | [19.0, 29.4] |
| Bariera językowa | 45 | 17.9 | [13.6, 23.1] |
| Niejasny podział zadań w zespole | 31 | 12.3 | [8.8, 16.9] |
| Inne | 12 | 4.8 | [2.7, 8.1] |
| Nie napotykam trudności | 34 | 13.5 | [9.8, 18.3] |
Uwaga. N = 252 osoby, które odpowiedziały na pytanie (8 z 260 osób je pominęło). Pytanie typu „zaznacz wszystkie pasujące”; respondenci mogli wybrać więcej niż jedną odpowiedź, dlatego odsetki nie sumują się do 100. Odsetki liczono od liczby osób, nie od liczby zaznaczeń. Odpowiedź „Nie napotykam trudności” wykluczała pozostałe. CI = przedział ufności Wilsona. Dane symulowane.
Przy pytaniu wielokrotnego wyboru ważne są cztery decyzje.
- Kolejność. Opcje merytoryczne posortuj malejąco według odsetka, a nie w kolejności z kwestionariusza. „Inne” i opcję wykluczającą zostaw na końcu, oddzielone linią, bo nie należą do tej samej listy.
- Mianownik. Odsetki licz od osób, które odpowiedziały na pytanie (tu N = 252), a w nocie napisz, ile osób je pominęło. Gdybyś podzielił(a) przez wszystkich 260 ankietowanych, brak czasu dostałby 56.2% zamiast 57.9% – osoby, które pominęły pytanie, liczyłyby się jak te, które tej trudności nie zaznaczyły.
- Przedział ufności. Kolumna 95% CI mówi, z jaką precyzją odsetek z próby szacuje odsetek w populacji. Dla proporcji użyj przedziału Wilsona, a nie prostego przedziału Walda, którego pokrycie bywa wyraźnie gorsze od deklarowanych 95% (Brown i in., 2001). Szczegóły: przedział ufności dla proporcji.
- Nota. Musi wyjaśniać, dlaczego odsetki nie sumują się do 100, od jakiej podstawy je liczono i jaki był format pytania. Przy osobnym pytaniu „tak/nie” dla każdej opcji respondenci zaznaczają więcej opcji niż przy „zaznacz wszystkie”, choć kolejność opcji się nie zmienia (Callegaro i in., 2015), więc odsetków z dwóch formatów nie porównuj wprost.
Kolumny „% zaznaczeń” (podstawa: 549 zaznaczeń) zwykle nie pokazuj, a jeśli promotor jej wymaga, podpisz obie kolumny jednoznacznie. W tekście dodaj, ile opcji zaznaczała jedna osoba: średnio 2.18 (Mdn = 2). Tylko jedną trudność wskazała 61 osób, a cztery lub więcej – 47.
Opcje zakoduj w R, SPSS, Excelu albo jamovi, tak jak opisujemy w poradnikach o kodowaniu pytań wielokrotnego wyboru i o danych z Google Forms i LimeSurvey. Możesz też skorzystać z aplikacji SZTOS, która ma specjalny moduł do pytań wielokrotnego wyboru („rozpakowanie wielokrotnych odpowiedzi”) i importuje arkusze z Google Forms przez link (opis aplikacji).
Tabela porównania grup
Gdy pytanie badawcze dotyczy różnic między grupami, nie dokładaj kolejnych kolumn do tabeli 1, tylko zrób osobną tabelę. W każdej grupie podaj liczbę i odsetek osób, a obok – różnicę odsetków w punktach procentowych z przedziałem ufności. Różnica z CI mówi więcej niż samo p. Przedział dla różnicy dwóch proporcji licz metodą Newcombe’a, która łączy przedziały Wilsona obu grup (Newcombe, 1998); zob. hasło przedział Newcombe’a dla różnicy proporcji.
Tabela 2
Trudności w edukacji pacjenta przed wypisem według rodzaju oddziału
| Trudność | Zabiegowe n (%) | Zachowawcze n (%) | Różnica, p.p. [95% CI] | pHolm |
|---|---|---|---|---|
| Brak czasu przy wypisie | 82 (68.9) | 64 (48.1) | 20.8 [8.6, 32.1] | .007 |
| Przerywanie rozmowy przez inne obowiązki | 59 (49.6) | 50 (37.6) | 12.0 [−0.2, 23.8] | .331 |
| Brak materiałów edukacyjnych | 30 (25.2) | 48 (36.1) | −10.9 [−21.8, 0.6] | .331 |
| Zmęczenie lub zły stan pacjenta | 40 (33.6) | 28 (21.1) | 12.6 [1.6, 23.3] | .174 |
| Brak spokojnego miejsca na rozmowę | 25 (21.0) | 35 (26.3) | −5.3 [−15.6, 5.3] | .970 |
| Bariera językowa | 22 (18.5) | 23 (17.3) | 1.2 [−8.2, 10.8] | > .999 |
| Niejasny podział zadań w zespole | 14 (11.8) | 17 (12.8) | −1.0 [−9.2, 7.4] | > .999 |
| Inne | 3 (2.5) | 9 (6.8) | −4.2 [−10.1, 1.4] | .456 |
Uwaga. Oddziały zabiegowe n = 119, zachowawcze n = 133. Odsetki liczono od liczby osób w grupie; respondenci mogli wybrać więcej niż jedną odpowiedź. Różnica = odsetek na oddziałach zabiegowych minus odsetek na zachowawczych, w punktach procentowych; 95% CI metodą Newcombe’a (hybrydowy przedział Wilsona). p z testu χ² dla tabeli 2 × 2 (osobno dla każdej opcji), skorygowane metodą Holma dla 8 porównań. „Nie napotykam trudności” wybrało 13 osób (10.9%) z oddziałów zabiegowych i 21 (15.8%) z zachowawczych. Dane symulowane.
Wartość p w tabeli 2 pochodzi z osobnego testu chi-kwadrat dla każdej opcji (tabela 2 × 2: grupa × zaznaczył/nie zaznaczył). Takich testów jest osiem, dlatego wartości skorygowano poprawką Holma, która kontroluje ryzyko choćby jednego fałszywego wyniku w całej rodzinie testów (Holm, 1979). Nie licz jednego testu χ² na tabeli „opcja × grupa” z liczbą zaznaczeń: ta sama osoba trafia wtedy do kilku komórek, a test zakłada niezależne obserwacje (Bilder i Loughin, 2004). Jak wybrać test i kiedy sięgnąć po test łączny, opisujemy w poradniku porównanie pytań wielokrotnego wyboru między grupami; ogólne zasady dla dwóch odsetków – we wpisie jak porównać odsetki w dwóch grupach.
Zwróć uwagę na wiersz „Zmęczenie lub zły stan pacjenta”. Przedział różnicy, [1.6, 23.3], nie obejmuje zera, ale po poprawce Holma p = .174 (bez poprawki .025). Przedział w tabeli nie jest skorygowany na wielokrotne porównania, więc w opisie trzymaj się wartości skorygowanych i nie nazywaj tej różnicy istotną. Kolejność wierszy zachowaj jak w tabeli 1.
Wykres: poziome słupki z przedziałami ufności
Podstawowy wykres dla pytania wielokrotnego wyboru to wykres słupkowy z odsetkiem osób. Rysuj go poziomo: długie nazwy opcji mieszczą się wtedy przy osi i nie trzeba ich obracać. Słupki posortuj malejąco, a „Inne” i opcję wykluczającą umieść na dole i wyróżnij innym kolorem. Odczytywanie długości od wspólnej osi należy do najdokładniejszych zadań percepcyjnych, dokładniejszych niż porównywanie kątów i pól (Cleveland i McGill, 1984).
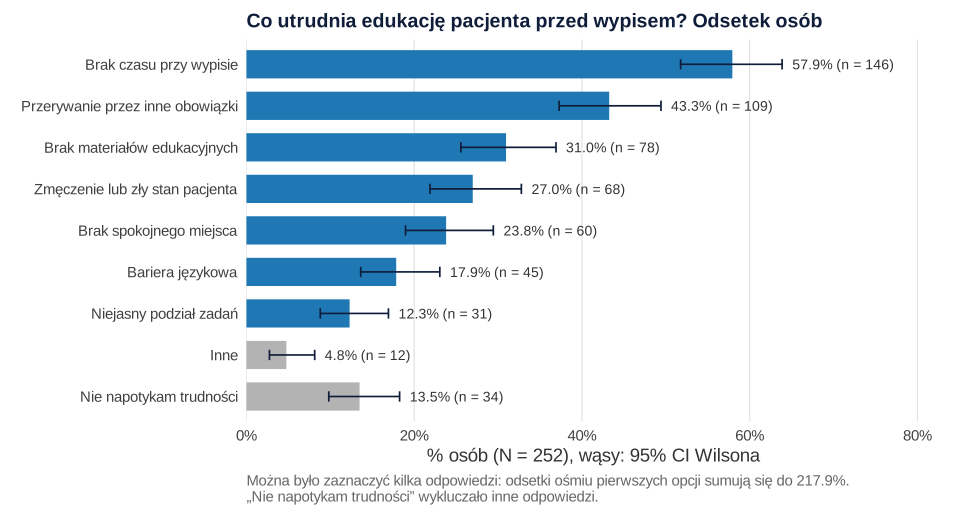
Przy słupkach podaj odsetek i n; oś zacznij od 0%. W podpisie napisz, że wąsy to 95% CI (mogą też oznaczać SE lub SD), podaj N i to, że odsetki nie sumują się do 100. Jeśli liczysz w programie, który nie rysuje przedziałów sam, dodaj słupki błędów o własnych długościach: odsetek minus dolna granica oraz górna granica minus odsetek. Ogólne zasady podpisów i numeracji rysunków omawiamy w poradniku wykresy w pracy dyplomowej.
Wykres dla dwóch grup
Dla dwóch grup masz do wyboru słupki obok siebie albo punkty z przedziałami (rysunek 2). Przy ośmiu opcjach słupki dają 16 prostokątów, na których tle giną przedziały ufności; punkty z wąsami od razu pokazują, gdzie grupy się rozchodzą. Cleveland i McGill (1984) proponowali takie wykresy punktowe jako zamiennik wielu wykresów słupkowych. Kolejność opcji zostaw taką jak na rysunku 1, a kolory grup – takie same we wszystkich rysunkach pracy.
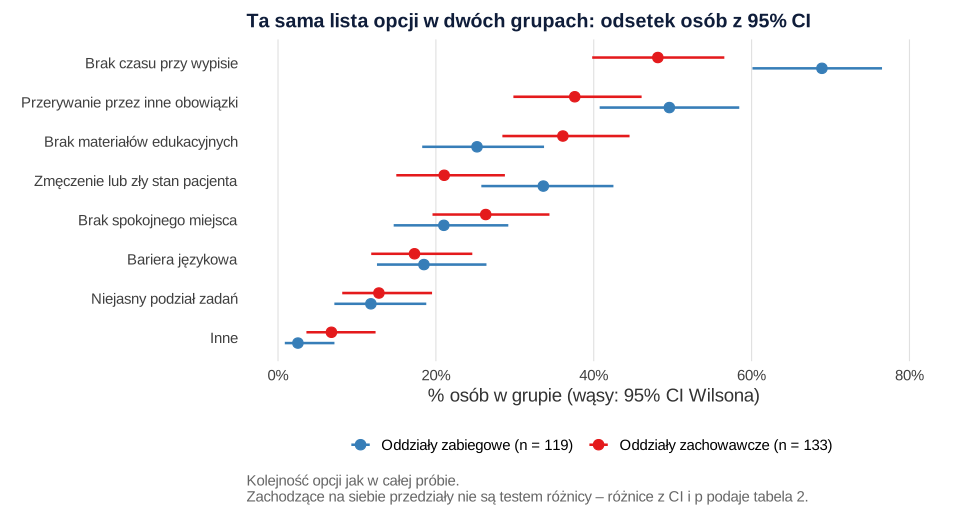
Nie oceniaj istotności różnicy „na oko” po tym, czy przedziały grup na siebie zachodzą. Przedziały dwóch niezależnych grup mogą częściowo się pokrywać, a różnica i tak może być istotna – Cumming i Finch (2005) podają reguły, jak takie rysunki czytać. Wykres pokazuje obraz całości, a wnioski opieraj na różnicach z tabeli 2.
Współwystępowanie odpowiedzi: macierz i najczęstsze kombinacje
Czy brak czasu i przerywanie rozmowy zaznaczają te same osoby? Odpowiada na to macierz współwystępowania (tabela 3): ile osób zaznaczyło jednocześnie trudność z wiersza i z kolumny. Działa jak tabela krzyżowa policzona dla wszystkich par opcji naraz. Dużą macierz możesz pokazać jako mapę ciepła, podobnie jak mapę cieplną korelacji.
Tabela 3
Liczba osób, które zaznaczyły obie trudności (macierz współwystępowania)
| Trudność | 1 | 2 | 3 | 4 | 5 | 6 | 7 |
|---|---|---|---|---|---|---|---|
| 1. Brak czasu | 146 | ||||||
| 2. Przerywanie | 79 | 109 | |||||
| 3. Brak materiałów | 53 | 45 | 78 | ||||
| 4. Stan pacjenta | 48 | 34 | 26 | 68 | |||
| 5. Brak miejsca | 45 | 38 | 21 | 17 | 60 | ||
| 6. Bariera językowa | 27 | 29 | 15 | 11 | 11 | 45 | |
| 7. Podział zadań | 23 | 18 | 15 | 7 | 7 | 5 | 31 |
Uwaga. N = 252. Na przekątnej (pogrubienie) liczba osób, które zaznaczyły daną trudność; poza przekątną – liczba osób, które zaznaczyły obie trudności z wiersza i kolumny (niezależnie od innych zaznaczeń). Macierz jest symetryczna, dlatego pokazano tylko dolny trójkąt. Dane symulowane.
Surowe liczby w macierzy zależą od popularności opcji: najczęstsze trudności zawsze będą miały duże wartości we wspólnych komórkach. Dlatego przy interpretacji przejdź na odsetki warunkowe. Brak czasu i przerywanie rozmowy zaznaczyło razem 79 osób (31.3% N). Wśród 146 osób, które wskazały brak czasu, przerywanie zaznaczyło 54.1%, a wśród 106 pozostałych – 28.3%. Te dwie trudności częściej występują razem, niż wynikałoby z samej ich popularności.
Macierz pokazuje pary, a respondent wybiera cały zestaw. Rozkład zestawów, czyli dokładnych kombinacji odpowiedzi, pokazuje wykres w stylu UpSet (Lex i in., 2014): u góry słupki z liczbą osób w każdej kombinacji, pod nimi macierz kropek z zaznaczonymi opcjami (rysunek 3). Taki wykres narysujesz w ggplot2 z dwóch paneli – nie potrzebujesz osobnego pakietu.
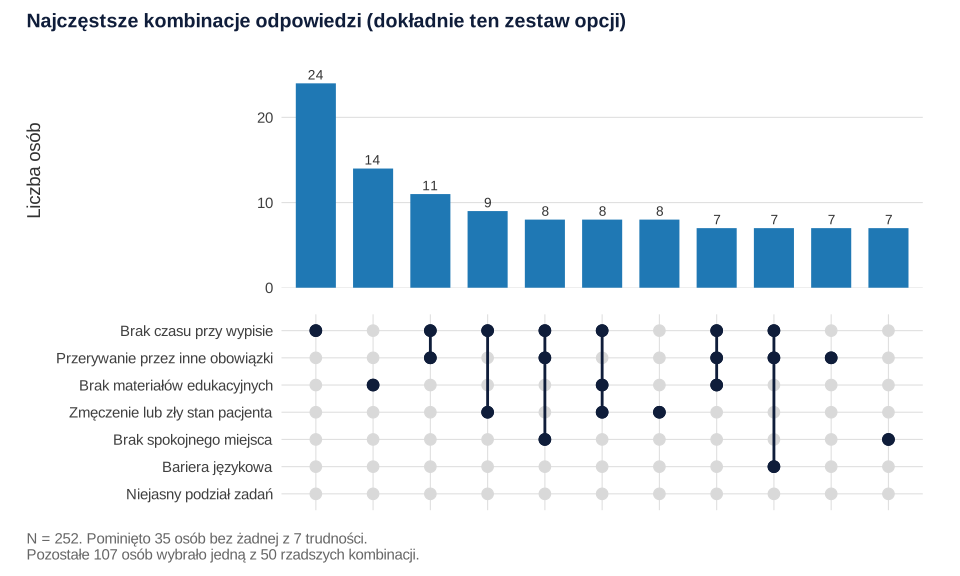
Odczytuj ten wykres inaczej niż macierz. Kombinację „brak czasu + przerywanie” wybrało dokładnie 11 osób (4.4% N), choć obie trudności zaznaczyło 79 osób. Pozostałe 68 dodało do nich jeszcze inne trudności z listy. Odpowiedzi są mocno rozproszone: 217 osób z co najmniej jedną trudnością utworzyło 61 różnych kombinacji, z czego 23 wybrała tylko jedna osoba. Najczęstsza kombinacja („tylko brak czasu”) obejmuje 24 osoby (9.5%), a 11 najczęstszych – 110 osób (43.7%). Wykres pokazuje typowe profile, ale nie zastąpi tabeli 1; w podpisie podaj, ilu osób nie obejmuje.
Czego nie robić: wykres kołowy i odsetek zaznaczeń
Wykres kołowy zakłada, że części tworzą całość równą 100%. W pytaniu wielokrotnego wyboru odsetki osób sumują się tu do 217.9%, więc nie da się ich narysować na kole. Program narysuje koło tylko z odsetków zaznaczeń – a te odpowiadają na inne pytanie. Brak czasu ma 26.6% wszystkich 549 zaznaczeń, więc na kole zajmie ćwierć powierzchni, choć zaznaczyło go 57.9% osób. Czytelnik odczyta „co czwarta pielęgniarka”, a prawda brzmi „więcej niż połowa”. Do tego kąty i pola porównuje się mniej dokładnie niż długości (Cleveland i McGill, 1984). Ta sama pułapka dotyczy słupka skumulowanego do 100% – ma on sens tylko wtedy, gdy każda osoba wybiera dokładnie jedną kategorię, jak w odpowiedziach Likerta.
Gotowe zdania do rozdziału wyników
Nie powtarzaj w tekście całej tabeli: przywołaj ją, podaj dwie–trzy najczęstsze odpowiedzi z przedziałami i jedną informację o liczbie zaznaczeń. Więcej wzorów zdań znajdziesz w poradniku jak opisać wyniki w stylu APA.
Opis jednej próby:
Porównanie grup:
Współwystępowanie:
W rozdziale o metodzie wystarczy jedno zdanie o analizie, np.: „Dla pytań wielokrotnego wyboru podano liczbę i odsetek osób, które zaznaczyły każdą opcję, z 95% przedziałami ufności Wilsona; grupy porównano osobno dla każdej opcji testem χ² z poprawką Holma”. Jak zbudować cały opis analiz, pokazuje przewodnik po statystyce w pracy dyplomowej.
Najczęstsze błędy
- Odsetek zaznaczeń zamiast odsetka osób. Tabela, w której odsetki sumują się do 100%, zwykle pokazuje strukturę zaznaczeń. Brak czasu ma wtedy 26.6% zamiast 57.9%.
- Brak N i podstawy odsetków. Bez noty czytelnik nie wie, czy osoby, które pominęły pytanie, są w mianowniku.
- Opcje w kolejności z kwestionariusza. Sortuj według częstości; wyjątkiem są skale z naturalnym porządkiem, a tych w pytaniu wielokrotnego wyboru zwykle nie ma.
- „Inne” w środku listy. Odpowiedzi „Inne” to zbiór różnych wpisów. Jeśli jest ich dużo, najpierw je zakoduj (zob. odpowiedź „Inne (jakie?)” – kodowanie wpisów własnych), a w tabeli zostaw tylko resztę.
- Jeden test χ² na wszystkich zaznaczeniach albo wiele testów bez korekty – zob. tabela 2 i porównanie między grupami.
- Porównanie popularności opcji testami dla grup niezależnych. Brak czasu i przerywanie zaznaczały te same osoby, więc do porównania opcji w jednej próbie służy test Q Cochrana, a nie test dla dwóch proporcji z różnych prób.
- Wykres kołowy, efekty 3D, wąsy bez opisu. Zamiast tego poziome słupki albo punkty z CI i podpis z N.
- Pytanie rankingowe pokazane jak wielokrotny wybór. Jeśli respondent wybierał „3 najważniejsze” albo układał ranking, pokaż także pozycje – zob. pytania rankingowe i „wybierz 3 najważniejsze”.
Pełną analizę ankiety z takim pytaniem pokazuje wpis ankieta wiedzy – analiza krok po kroku, a typowe analizy w pracach pielęgniarskich – statystyka w pracy z pielęgniarstwa. Tabele i obliczenia możemy też sprawdzić w ramach pomocy w analizie danych dla studentów.
Tabele i współwystępowanie w R: kod i wynik
Trzy przepisy liczą wszystkie liczby z tabel i opisu. Wczytują plik tabela-i-wykres-pytania-wielokrotnego-wyboru-dane.csv (260 osób, dane symulowane z set.seed(427); kolumny 0/1 dla każdej opcji, puste komórki u 8 osób, które pominęły pytanie). Używają tylko funkcji bazowego R. Rysunki powstały w osobnym skrypcie (ggplot2, patchwork), który korzysta z tych samych obliczeń.
Tabela 1: % osób z przedziałem Wilsona
R
# B427 – Tabela 1: pytanie wielokrotnego wyboru, % osób z 95% CI (Wilson)
options(width = 110)
dane <- read.csv("tabela-i-wykres-pytania-wielokrotnego-wyboru-dane.csv")
opcje <- c(brak_czasu = "Brak czasu przy wypisie",
           przerywanie = "Przerywanie rozmowy przez inne obowiązki",
           stan_pacjenta = "Zmęczenie lub zły stan pacjenta",
           brak_materialow = "Brak materiałów edukacyjnych",
           brak_miejsca = "Brak spokojnego miejsca na rozmowę",
           bariera_jezykowa = "Bariera językowa",
           podzial_zadan = "Niejasny podział zadań w zespole",
           inne = "Inne",
           brak_trudnosci = "Nie napotykam trudności")

# Mianownik: osoby, które odpowiedziały na pytanie (zaznaczyły cokolwiek, także opcję wykluczającą)
odp <- dane[!is.na(dane$brak_czasu), ]
N <- nrow(odp)
cat("Ankietę wypełniło:", nrow(dane), "; pominęło pytanie:", nrow(dane) - N, "; N =", N, "\n\n")

wilson <- function(x, n) prop.test(x, n, correct = FALSE)$conf.int   # przedział Wilsona
tab <- do.call(rbind, lapply(names(opcje), function(k) {
  x <- sum(odp[[k]]); ci <- wilson(x, N)
  data.frame(opcja = opcje[[k]], n = x, proc = 100 * x / N, dol = 100 * ci[1], gor = 100 * ci[2])
}))
# Sortuj malejąco merytoryczne opcje; „Inne” i opcję wykluczającą zostaw na końcu
mer <- tab[1:7, ]
tab <- rbind(mer[order(-mer$n), ], tab[8:9, ])
tab$proc_odp <- 100 * tab$n / sum(tab$n[1:8])   # % wszystkich zaznaczeń (bez opcji wykluczającej)
tab$proc_odp[9] <- NA
print(data.frame(opcja = tab$opcja, n = tab$n, proc_osob = round(tab$proc, 1),
                 CI95 = sprintf("[%.1f, %.1f]", tab$dol, tab$gor),
                 proc_zaznaczen = round(tab$proc_odp, 1)), row.names = FALSE)

zazn <- rowSums(odp[, names(opcje)[1:8]])
cat("\nSuma % osób (opcje 1–8):", round(sum(tab$proc[1:8]), 1), "%",
    "; liczba zaznaczeń:", sum(zazn), "\n")
cat("Zaznaczenia na osobę (bez opcji wykluczającej): M =", sprintf("%.2f", mean(zazn)),
    "; Mdn =", median(zazn), "; tylko 1 opcja:", sum(zazn == 1), "; 4 i więcej:", sum(zazn >= 4), "\n")
cat("Błędny mianownik – % od wszystkich 260 osób dla braku czasu:",
    sprintf("%.1f", 100 * tab$n[1] / nrow(dane)), "% zamiast", sprintf("%.1f", tab$proc[1]), "%\n")
Wynik w R
Ankietę wypełniło: 260 ; pominęło pytanie: 8 ; N = 252

                                    opcja   n proc_osob         CI95 proc_zaznaczen
                  Brak czasu przy wypisie 146      57.9 [51.8, 63.9]           26.6
 Przerywanie rozmowy przez inne obowiązki 109      43.3 [37.3, 49.4]           19.9
             Brak materiałów edukacyjnych  78      31.0 [25.6, 36.9]           14.2
          Zmęczenie lub zły stan pacjenta  68      27.0 [21.9, 32.8]           12.4
       Brak spokojnego miejsca na rozmowę  60      23.8 [19.0, 29.4]           10.9
                         Bariera językowa  45      17.9 [13.6, 23.1]            8.2
         Niejasny podział zadań w zespole  31      12.3  [8.8, 16.9]            5.6
                                     Inne  12       4.8   [2.7, 8.1]            2.2
                  Nie napotykam trudności  34      13.5  [9.8, 18.3]             NA

Suma % osób (opcje 1–8): 217.9 % ; liczba zaznaczeń: 549
Zaznaczenia na osobę (bez opcji wykluczającej): M = 2.18 ; Mdn = 2 ; tylko 1 opcja: 61 ; 4 i więcej: 47
Błędny mianownik – % od wszystkich 260 osób dla braku czasu: 56.2 % zamiast 57.9 %
Tabela 2: dwie grupy, różnica odsetków i poprawka Holma
R
# B427 – Tabela 2: porównanie oddziałów, % osób w grupach, różnica z 95% CI (Newcombe), p (Holm)
options(width = 110)
dane <- read.csv("tabela-i-wykres-pytania-wielokrotnego-wyboru-dane.csv")
odp <- dane[!is.na(dane$brak_czasu), ]
opcje <- c(brak_czasu = "Brak czasu przy wypisie",
           przerywanie = "Przerywanie rozmowy",
           brak_materialow = "Brak materiałów",
           stan_pacjenta = "Zły stan pacjenta",
           brak_miejsca = "Brak miejsca na rozmowę",
           bariera_jezykowa = "Bariera językowa",
           podzial_zadan = "Niejasny podział zadań",
           inne = "Inne")
g1 <- odp[odp$oddzial == "zabiegowy", ]; g2 <- odp[odp$oddzial == "zachowawczy", ]
n1 <- nrow(g1); n2 <- nrow(g2)
cat("Zabiegowe n =", n1, "; zachowawcze n =", n2, "\n\n")

wilson <- function(x, n) prop.test(x, n, correct = FALSE)$conf.int
newcombe <- function(x1, n1, x2, n2) {          # metoda 10 Newcombe'a (1998): łączy przedziały Wilsona
  p1 <- x1 / n1; p2 <- x2 / n2; c1 <- wilson(x1, n1); c2 <- wilson(x2, n2)
  d <- p1 - p2
  c(d, d - sqrt((p1 - c1[1])^2 + (c2[2] - p2)^2), d + sqrt((c1[2] - p1)^2 + (p2 - c2[1])^2))
}
tab <- do.call(rbind, lapply(names(opcje), function(k) {
  x1 <- sum(g1[[k]]); x2 <- sum(g2[[k]])
  r <- newcombe(x1, n1, x2, n2)
  data.frame(opcja = opcje[[k]], x1 = x1, p1 = 100 * x1 / n1, x2 = x2, p2 = 100 * x2 / n2,
             roznica = 100 * r[1], dol = 100 * r[2], gor = 100 * r[3],
             p = prop.test(c(x1, x2), c(n1, n2), correct = FALSE)$p.value)   # chi-kwadrat 2 × 2
}))
tab$p_holm <- p.adjust(tab$p, method = "holm")   # 8 porównań
print(data.frame(opcja = tab$opcja,
                 zabiegowe = sprintf("%d (%.1f)", tab$x1, tab$p1),
                 zachowawcze = sprintf("%d (%.1f)", tab$x2, tab$p2),
                 roznica_pp = sprintf("%.1f [%.1f, %.1f]", tab$roznica, tab$dol, tab$gor),
                 p = sprintf("%.3f", tab$p), p_holm = sprintf("%.3f", tab$p_holm)), row.names = FALSE)

cat("\nNie napotykam trudności: zabiegowe", sum(g1$brak_trudnosci), "(",
    sprintf("%.1f", 100 * mean(g1$brak_trudnosci)), "%), zachowawcze", sum(g2$brak_trudnosci), "(",
    sprintf("%.1f", 100 * mean(g2$brak_trudnosci)), "%)\n")
z1 <- rowSums(g1[, names(opcje)]); z2 <- rowSums(g2[, names(opcje)])
cat("Zaznaczenia na osobę: zabiegowe M =", sprintf("%.2f", mean(z1)), "; zachowawcze M =", sprintf("%.2f", mean(z2)), "\n")
Wynik w R
Zabiegowe n = 119 ; zachowawcze n = 133

                   opcja zabiegowe zachowawcze         roznica_pp     p p_holm
 Brak czasu przy wypisie 82 (68.9)   64 (48.1)   20.8 [8.6, 32.1] 0.001  0.007
     Przerywanie rozmowy 59 (49.6)   50 (37.6)  12.0 [-0.2, 23.8] 0.055  0.331
         Brak materiałów 30 (25.2)   48 (36.1) -10.9 [-21.8, 0.6] 0.062  0.331
       Zły stan pacjenta 40 (33.6)   28 (21.1)   12.6 [1.6, 23.3] 0.025  0.174
 Brak miejsca na rozmowę 25 (21.0)   35 (26.3)  -5.3 [-15.6, 5.3] 0.323  0.970
        Bariera językowa 22 (18.5)   23 (17.3)   1.2 [-8.2, 10.8] 0.805  1.000
  Niejasny podział zadań 14 (11.8)   17 (12.8)   -1.0 [-9.2, 7.4] 0.806  1.000
                    Inne   3 (2.5)     9 (6.8)  -4.2 [-10.1, 1.4] 0.114  0.456

Nie napotykam trudności: zabiegowe 13 ( 10.9 %), zachowawcze 21 ( 15.8 %)
Zaznaczenia na osobę: zabiegowe M = 2.31 ; zachowawcze M = 2.06
Tabela 3 i rysunek 3: macierz współwystępowania i kombinacje
R
# B427 – współwystępowanie opcji: macierz A × B, odsetki warunkowe i najczęstsze kombinacje
options(width = 110)
dane <- read.csv("tabela-i-wykres-pytania-wielokrotnego-wyboru-dane.csv")
odp <- dane[!is.na(dane$brak_czasu), ]
N <- nrow(odp)
skrot <- c(brak_czasu = "Czas", przerywanie = "Przerw", brak_materialow = "Mater",
           stan_pacjenta = "Stan", brak_miejsca = "Miejsce", bariera_jezykowa = "Język",
           podzial_zadan = "Zadania")
X <- as.matrix(odp[, names(skrot)]); colnames(X) <- skrot

# Macierz współwystępowania: na przekątnej n osób z daną opcją, poza nią – n osób z obiema opcjami
M <- crossprod(X)
print(M)

# Odsetek warunkowy: wśród osób z opcją z wiersza – ile % zaznaczyło też opcję z kolumny
cat("\nWśród osób z brakiem czasu (n =", M["Czas", "Czas"], ") zaznaczyło też (%):\n")
print(round(100 * M["Czas", -1] / M["Czas", "Czas"], 1))
cat("Wśród osób bez braku czasu (n =", N - M["Czas", "Czas"], ") przerywanie zaznaczyło:",
    sprintf("%.1f", 100 * sum(X[X[, "Czas"] == 0, "Przerw"]) / (N - M["Czas", "Czas"])), "%\n")
cat("Czas i Przerw razem:", M["Czas", "Przerw"], "osób =", sprintf("%.1f", 100 * M["Czas", "Przerw"] / N), "% N\n")

# Kombinacje dokładne (jak w wykresie UpSet): każda osoba ma jedną kombinację zaznaczeń
komb <- apply(X, 1, function(w) paste(colnames(X)[w == 1], collapse = " + "))
cat("\nBez żadnej z 7 trudności:", sum(komb == ""), "osób (w tym „Nie napotykam trudności”:",
    sum(odp$brak_trudnosci), "; tylko „Inne”:", sum(komb == "" & odp$inne == 1), ")\n")
tk <- sort(table(komb[komb != ""]), decreasing = TRUE)
cat("Liczba różnych kombinacji:", length(tk), "; kombinacji wybranych przez 1 osobę:", sum(tk == 1), "\n")
top <- tk[tk >= tk[10]]   # 10 najczęstszych, z remisami na 10. miejscu
print(data.frame(kombinacja = names(top), n = as.integer(top),
                 proc = sprintf("%.1f", 100 * as.integer(top) / N)), row.names = FALSE)
cat(length(top), "najczęstszych kombinacji obejmuje", sum(top), "osób (", sprintf("%.1f", 100 * sum(top) / N), "% N)\n")
Wynik w R
        Czas Przerw Mater Stan Miejsce Język Zadania
Czas     146     79    53   48      45    27      23
Przerw    79    109    45   34      38    29      18
Mater     53     45    78   26      21    15      15
Stan      48     34    26   68      17    11       7
Miejsce   45     38    21   17      60    11       7
Język     27     29    15   11      11    45       5
Zadania   23     18    15    7       7     5      31

Wśród osób z brakiem czasu (n = 146 ) zaznaczyło też (%):
 Przerw   Mater    Stan Miejsce   Język Zadania
   54.1    36.3    32.9    30.8    18.5    15.8
Wśród osób bez braku czasu (n = 106 ) przerywanie zaznaczyło: 28.3 %
Czas i Przerw razem: 79 osób = 31.3 % N

Bez żadnej z 7 trudności: 35 osób (w tym „Nie napotykam trudności”: 34 ; tylko „Inne”: 1 )
Liczba różnych kombinacji: 61 ; kombinacji wybranych przez 1 osobę: 23
              kombinacja  n proc
                    Czas 24  9.5
                   Mater 14  5.6
           Czas + Przerw 11  4.4
             Czas + Stan  9  3.6
     Czas + Mater + Stan  8  3.2
 Czas + Przerw + Miejsce  8  3.2
                    Stan  8  3.2
   Czas + Przerw + Język  7  2.8
   Czas + Przerw + Mater  7  2.8
                 Miejsce  7  2.8
                  Przerw  7  2.8
11 najczęstszych kombinacji obejmuje 110 osób ( 43.7 % N)
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base i stats); rysunki przygotowano w pakietach ggplot2, patchwork i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czy przy pytaniu wielokrotnego wyboru podawać przedziały ufności dla odsetków?
Tak, jeśli próba ma reprezentować szerszą grupę, np. pielęgniarki z oddziałów. Przedział pokazuje, jak dokładnie odsetek z próby szacuje odsetek w populacji: przy 252 osobach i 57.9% wynosi on [51.8, 63.9]. Licz go metodą Wilsona osobno dla każdej opcji, z liczbą osób odpowiadających na pytanie w mianowniku.
Gdzie w tabeli umieścić odpowiedź „Inne” i „żadne z powyższych”?
Na końcu tabeli, pod posortowanymi malejąco opcjami merytorycznymi i najlepiej oddzielone linią. „Inne” to zbiór różnych wpisów, a opcja wykluczająca („nie napotykam trudności”, „żadne z powyższych”) nie należy do tej samej listy. Jeśli wpisów w „Inne” jest dużo, najpierw je zakoduj i dopiero resztę pokaż jako „Inne”.
Jaki wykres zamiast kołowego wybrać do pytania z wieloma odpowiedziami?
Poziomy wykres słupkowy z odsetkiem osób, posortowany malejąco, z wąsami 95% przedziału ufności. Dla dwóch–trzech grup lepsze są punkty z przedziałami obok siebie. Koło wymaga części sumujących się do 100%, a odsetki osób w takim pytaniu sumują się zwykle do ponad 100%.
Jak pokazać, które odpowiedzi respondenci zaznaczali razem?
Pary pokaże macierz współwystępowania: w komórce liczba osób, które zaznaczyły obie opcje, na przekątnej liczba osób z daną opcją. Przy interpretacji przejdź na odsetki warunkowe, np. ile procent osób z opcją A zaznaczyło też B. Całe zestawy odpowiedzi pokaże wykres kombinacji w stylu UpSet.
Jak zrobić tabelę porównania grup dla pytania wielokrotnego wyboru?
Dla każdej opcji podaj liczbę i odsetek osób w każdej grupie, różnicę odsetków w punktach procentowych z 95% CI Newcombe’a i wartość p z osobnego testu 2 × 2 po poprawce Holma. Opcje ułóż w tej samej kolejności co w tabeli dla całej próby, a liczebności grup podaj w nocie.
Powiązane hasła
Przeczytaj też
Pytania wielokrotnego wyboru – kodowanie i liczenie
Eksport z Google Forms i LimeSurvey, zmienne 0/1, mianownik, % osób z przedziałem Wilsona i liczenie w R, Excelu, SPSS, jamovi i SZTOS.
Czytaj →PoradnikPytanie wielokrotnego wyboru: porównanie grup
Dlaczego chi-kwadrat na tabeli zaznaczeń to błąd i co zamiast: testy dla opcji z korektą Holma, test łączny z permutacjami, GEE i Q Cochrana – z kodem R.
Czytaj →PoradnikWykresy w pracy dyplomowej
Jaki wykres do jakich danych, błędy źle → dobrze, podpis rysunku i gotowe zdania opisu wykresu w rozdziale wyników.
Czytaj →Masz w ankiecie kilka pytań wielokrotnego wyboru i nie wiesz, jak je pokazać?
Sprawdzimy kodowanie i mianowniki, policzymy tabele z przedziałami ufności i porównania grup w R lub SPSS oraz wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- Bilder, C. R., & Loughin, T. M. (2004). Testing for marginal independence between two categorical variables with multiple responses. Biometrics, 60(1), 241–248. https://doi.org/10.1111/j.0006-341x.2004.00147.x
- Brown, L. D., Cai, T. T., & DasGupta, A. (2001). Interval estimation for a binomial proportion. Statistical Science, 16(2), 101–133. https://doi.org/10.1214/ss/1009213286
- Callegaro, M., Murakami, M. H., Tepman, Z., & Henderson, V. (2015). Yes–no answers versus check-all in self-administered modes: A systematic review and analyses. International Journal of Market Research, 57(2), 203–224. https://doi.org/10.2501/ijmr-2015-014a
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
- Cumming, G., & Finch, S. (2005). Inference by eye: Confidence intervals and how to read pictures of data. American Psychologist, 60(2), 170–180. https://doi.org/10.1037/0003-066X.60.2.170
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70. https://www.jstor.org/stable/4615733
- Lex, A., Gehlenborg, N., Strobelt, H., Vuillemot, R., & Pfister, H. (2014). UpSet: Visualization of intersecting sets. IEEE Transactions on Visualization and Computer Graphics, 20(12), 1983–1992. https://doi.org/10.1109/tvcg.2014.2346248 ● Otwarty dostęp
- Newcombe, R. G. (1998). Interval estimation for the difference between independent proportions: Comparison of eleven methods. Statistics in Medicine, 17(8), 873–890. https://doi.org/10.1002/(sici)1097-0258(19980430)17:8<873::aid-sim779>3.0.co;2-i
Cytowania BibTeX
@book{apa2020publication, author={{American Psychological Association}}, title={{Publication manual of the American Psychological Association}}, year={2020}, edition={7th ed.}, publisher={American Psychological Association}, doi={10.1037/0000165-000}}@article{bilder2004testing, author={Bilder, Christopher R. and Loughin, Thomas M.}, title={{Testing for marginal independence between two categorical variables with multiple responses}}, journal={Biometrics}, year={2004}, volume={60}, number={1}, pages={241--248}, doi={10.1111/j.0006-341x.2004.00147.x}}@article{brown2001interval, author={Brown, Lawrence D. and Cai, T. Tony and DasGupta, Anirban}, title={{Interval estimation for a binomial proportion}}, journal={Statistical Science}, year={2001}, volume={16}, number={2}, pages={101--133}, doi={10.1214/ss/1009213286}}@article{callegaro2015yes, author={Callegaro, Mario and Murakami, Michael H. and Tepman, Ziv and Henderson, Vani}, title={{Yes–no answers versus check-all in self-administered modes: A systematic review and analyses}}, journal={International Journal of Market Research}, year={2015}, volume={57}, number={2}, pages={203--224}, doi={10.2501/ijmr-2015-014a}}@article{cleveland1984graphical, author={Cleveland, William S. and McGill, Robert}, title={{Graphical perception: Theory, experimentation, and application to the development of graphical methods}}, journal={Journal of the American Statistical Association}, year={1984}, volume={79}, number={387}, pages={531--554}, doi={10.1080/01621459.1984.10478080}}@article{cumming2005inference, author={Cumming, Geoff and Finch, Sue}, title={{Inference by eye: Confidence intervals and how to read pictures of data}}, journal={American Psychologist}, year={2005}, volume={60}, number={2}, pages={170--180}, doi={10.1037/0003-066x.60.2.170}}@article{holm1979simple, author={Holm, Sture}, title={{A simple sequentially rejective multiple test procedure}}, journal={Scandinavian Journal of Statistics}, year={1979}, volume={6}, number={2}, pages={65--70}, url={https://www.jstor.org/stable/4615733}}@article{lex2014upset, author={Lex, Alexander and Gehlenborg, Nils and Strobelt, Hendrik and Vuillemot, Romain and Pfister, Hanspeter}, title={{UpSet: Visualization of intersecting sets}}, journal={IEEE Transactions on Visualization and Computer Graphics}, year={2014}, volume={20}, number={12}, pages={1983--1992}, doi={10.1109/tvcg.2014.2346248}}@article{newcombe1998interval, author={Newcombe, Robert G.}, title={{Interval estimation for the difference between independent proportions: Comparison of eleven methods}}, journal={Statistics in Medicine}, year={1998}, volume={17}, number={8}, pages={873--890}, doi={10.1002/(sici)1097-0258(19980430)17:8<873::aid-sim779>3.0.co;2-i}}