„Inne (jakie?)”: kilka słów od respondenta, kilka decyzji dla Ciebie
Opcja „Inne (jakie?)” z polem do wpisania zamienia pytanie zamknięte w pytanie półotwarte. Pojawia się w kafeterii jednokrotnego wyboru („Miejsce pracy: szpital / POZ / DPS / inne – jakie?”) i w pytaniach wielokrotnego wyboru („Zaznacz wszystko, co Cię dotyczy”). Chroni respondenta przed wybieraniem „najbliższej” odpowiedzi, ale Tobie zostawia kolumnę z wpisami w rodzaju „GRAFIK!!”, „dyzury, nadgodziny”, „-” i „nie wiem gdzie szukać ofert”.
Policzenie „Inne” jako jednej kategorii zostawia w tabeli „Inne: 22.8%”, choć połowa tych osób napisała coś, co już było na liście. Poniżej sześć kroków: wydzielenie i oczyszczenie tekstu, klucz, przekodowanie wpisów pasujących do listy (back-coding), nowe kategorie według reguły ustalonej z góry, zgodność dwóch osób kodujących i opis w pracy.
To nie jest analiza jakościowa: przypisujesz krótkie wpisy do kategorii, żeby je policzyć. Wpisy z pola „Inne” pokazują przy okazji, jak respondenci zrozumieli pytanie i czego zabrakło na liście (Singer i Couper, 2017). Pole „Inne” działa więc podobnie jak ogólne pytanie otwarte na końcu kwestionariusza, które O’Cathain i Thomas (2004) opisują jako „siatkę bezpieczeństwa” dla pytań zamkniętych – pod warunkiem że z góry wiesz, co zrobisz z odpowiedziami. Gdy masz dłuższe odpowiedzi na osobne pytanie otwarte, skorzystaj z hasła kodowanie odpowiedzi otwartych, wpisu o analizie treści pytań otwartych albo o analizie tekstu w R.
Przykład: co utrudnia pielęgniarkom udział w szkoleniach
Przez cały wpis używamy jednego przykładu (dane symulowane). W ankiecie online dla 240 pielęgniarek i pielęgniarzy było pytanie wielokrotnego wyboru: „Co utrudnia Ci udział w szkoleniach podyplomowych? Zaznacz wszystko, co Cię dotyczy”. Kafeteria miała siedem opcji: brak czasu (grafik dyżurów), koszt szkolenia, duża odległość lub dojazd, brak informacji o szkoleniach, brak zgody przełożonego, obowiązki rodzinne i brak odpowiedniej oferty tematycznej. Ósmą opcją było „Inne (jakie?)”.
Na pytanie odpowiedziały 232 osoby, a 8 je pominęło. Pole „Inne” wypełniły 53 osoby, czyli 22.8% odpowiadających. Tyle samo osób wybrało opcję „brak odpowiedniej oferty tematycznej”. Po zakodowaniu okaże się, że to w większości brak czasu i koszt opisane własnymi słowami. Surowy eksport przykładu możesz pobrać w sekcji z kodem R.
Jak „Inne” wygląda w eksporcie z Google Forms i LimeSurvey
Zanim zaczniesz kodować, sprawdź na kilku odpowiedziach testowych, gdzie narzędzie zapisuje tekst z „Inne” (szczegóły eksportu: dane z Google Forms i LimeSurvey).
| Narzędzie i typ pytania | Co widzisz w danych | Jak wydzielić wpis |
|---|---|---|
| Formularze Google, jednokrotny wybór | W kolumnie pytania jest etykieta wybranej opcji albo – zamiast słowa „Inne” – tekst wpisany przez osobę | Wszystko, co nie jest jedną z etykiet listy, to wpis z „Inne” |
| Formularze Google, pola wyboru | Jedna komórka: zaznaczone opcje rozdzielone przecinkiem i spacją, a na końcu wpisany tekst | Usuń z komórki pełne etykiety opcji; to, co zostanie, to wpis z „Inne” |
| LimeSurvey, lista i wielokrotny wybór | Opcja „Inne” ma własne pole tekstowe (w wyrażeniach LimeSurvey: kod_other), które w eksporcie trafia do osobnej kolumny | Wpis jest gotowy w osobnej kolumnie; „Inne” = 1, gdy kolumna nie jest pusta |
W Formularzach Google tekst z „Inne” trafia do tej samej komórki co zaznaczenia. Po podziale komórki po przecinkach wpis „dyzury, nadgodziny” rozpadnie się na dwie pseudoopcje. Bezpieczniej wyszukać pełne etykiety z listy, a za wpis własny uznać resztę – tak liczymy w przykładzie. Ogólne zasady zamiany takiej komórki na zmienne 0/1 i liczenia odsetków opisuje wpis główny serii: pytania wielokrotnego wyboru – jak zakodować i policzyć.
Krok 1. Wydziel wpis do osobnej kolumny i nie nadpisuj surowych danych
Po rozbiciu odpowiedzi masz siedem zmiennych 0/1 dla opcji z listy i jedną kolumnę tekstową inne_tekst. Surowej kolumny z eksportu nie zmieniaj. Każdą decyzję zapisuj w nowych zmiennych: inne_czysty, kod, a po przekodowaniu – w nowych wersjach zmiennych opcji. Dzięki temu promotor albo recenzent sprawdzi, skąd wzięła się każda liczba. W razie pomyłki w kluczu przeliczysz wszystko jednym uruchomieniem skryptu (zob. rekodowanie i kodowanie zmiennych w R).
Ustal też mianownik. Osoby, które pominęły całe pytanie (u nas 8), mają braki, a nie zera; brak wpisu u osoby, która odpowiedziała, to zero (zob. przygotowanie bazy danych do analizy).
Krok 2. Oczyść tekst: wielkość liter, spacje, puste wpisy
Ten sam wpis może wyglądać na kilka sposobów: „Grafik”, „grafik ” i „GRAFIK!!”. Zanim cokolwiek policzysz, sprowadź tekst do wspólnej postaci:
- zamień wielkie litery na małe;
- usuń spacje na początku i końcu oraz podwójne spacje w środku;
- usuń znaki interpunkcyjne na brzegach wpisu (wykrzykniki, kropki, myślniki), ale nie w środku – „e-learning” zostaje bez zmian;
- literówek nie poprawiaj ręcznie – uwzględnij je w regułach (reguła łapie i „dyżur”, i „dyzur”).
Osobno potraktuj wpisy niemerytoryczne: „-”, „.”, „brak”, „nic”, „nie wiem”. Takich wpisów nie licz jako odpowiedzi „Inne”. W przykładzie było ich 5 z 53. Listę wpisów niemerytorycznych ustal z góry i porównuj cały wpis, a nie jego fragment. Inaczej reguła „brak” wyrzuci też merytoryczny wpis „brak zastępstwa”. Wpis „nie wiem” w polu „Inne” to co innego niż opcja „nie wiem” w kafeterii – tu zwykle oznacza tylko puste pole. Więcej o porządkowaniu odpowiedzi z formularzy znajdziesz w haśle czyszczenie danych z ankiety online.
Krok 3. Klucz kodowy i reguła nowej kategorii – przed kodowaniem
Klucz kodowy to tabela: kategoria, definicja i przykłady wpisów należących i nienależących do niej. Dołączasz go do książki kodowej i do aneksu pracy. Zacznij od kategorii z kafeterii, a kandydatów na nowe dopisz po przeczytaniu części wpisów.
| Kod | Definicja | Przykłady: należy | Przykłady: nie należy |
|---|---|---|---|
| czas | Brak czasu z powodu organizacji pracy: grafik, dyżury, nadgodziny, drugi etat | „dyżury nocne”, „praca na 2 etaty”, „wieczne nadgodziny” | „nie mam siły po pracy” (to zmęczenie) |
| koszt | Cena szkolenia lub brak dofinansowania, także od pracodawcy | „za drogie”, „brak dofinansowania”, „pracodawca nie dopłaca” | „szef się nie zgadza” (to zgoda) |
| online | Brak szkoleń w formie zdalnej; szkolenia tylko stacjonarne | „tylko stacjonarnie”, „wolałabym e-learning”, „brak webinarów” | „daleko” (to dojazd) |
| zmeczenie | Zmęczenie, brak sił, wypalenie | „jestem wypalona”, „brak energii” | „brak czasu po dyżurach” (to czas) |
| inne | Wpis merytoryczny, który nie pasuje do żadnej kategorii | „słaby angielski”, „problemy zdrowotne” | „-”, „nie wiem” (wpisy niemerytoryczne) |
Dwie decyzje zapisz w kluczu, zanim zaczniesz kodować:
- Ile kodów może dostać wpis. Krótkie wpisy zwykle mają jeden temat, więc wystarcza jeden kod. Jeśli wpisy bywają złożone („za drogo i za daleko”), pozwól na kilka kodów. Wtedy każda kategoria jest osobną zmienną 0/1, a zgodność liczysz osobno w każdej kategorii, jak we wpisie o analizie treści.
- Kiedy wpisy tworzą nową kategorię. Przyjęliśmy regułę: nowa kategoria powstaje, gdy pasuje do niej co najmniej 3% osób, które odpowiedziały na pytanie, czyli 7 z 232. Mniejsze grupy zostają w „Inne”. Próg 3% to decyzja umowna, a nie norma z literatury – możesz przyjąć inny. Ważne, żeby wpisać go do planu analizy przed kodowaniem. Inaczej łatwo „dopasować” liczbę kategorii do wyniku, który akurat Ci odpowiada.
Krok 4. Przekodowanie wsteczne: wpisy, które pasują do listy
Przekodowanie wsteczne (ang. back-coding) przypisuje wpis z pola „Inne” do opcji, która już była na liście. Ktoś napisał „dyżury nocne” – to opcja „brak czasu (grafik dyżurów)”, więc dostaje 1 w tej zmiennej, a jego „Inne” znika. W R najwygodniej zrobić to słownikiem reguł. Dla każdego kodu zapisujesz wyrażenie regularne, np. dy[zż]ur|grafik|etat|nadgodzin dla kodu „czas”, a funkcja grepl() sprawdza, czy wpis do niego pasuje. Kodowanie słownikowe to jeden ze standardowych sposobów komputerowej analizy odpowiedzi otwartych (Züll, 2016). Słownik nie zastępuje jednak czytania: przejrzyj wszystkie dopasowania i wpisy bez dopasowania, a potem popraw reguły.
W przykładzie do opcji z listy wróciło 27 z 48 wpisów merytorycznych: 10 do braku czasu, 6 do kosztu, po 3 do odległości, braku informacji i obowiązków rodzinnych oraz 2 do braku zgody przełożonego (rysunek 1). Do opcji „brak oferty tematycznej” nie pasował żaden wpis.
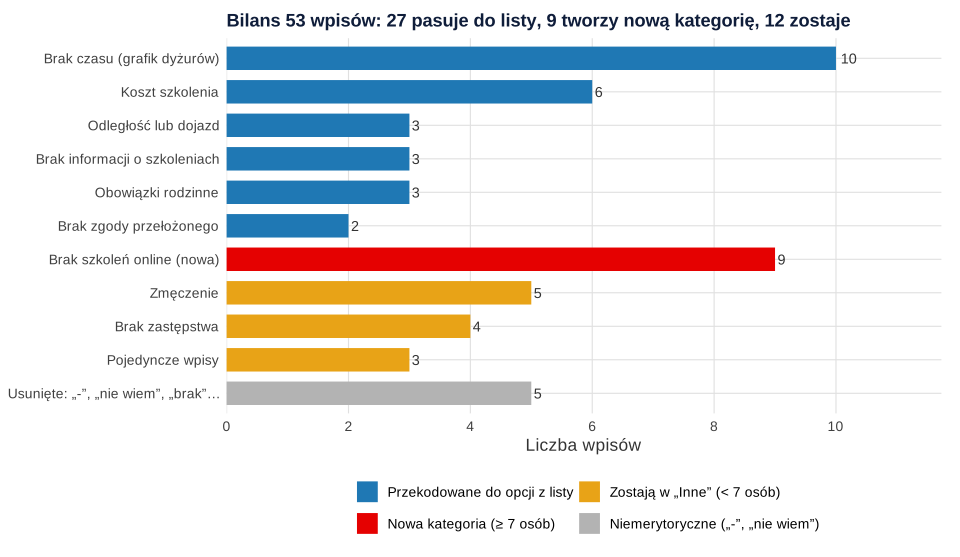
Przekodowanie nie zawsze podnosi liczbę osób w danej opcji. W pytaniu wielokrotnego wyboru 13 z 27 osób zaznaczyło już tę opcję, a potem dopisało ją jeszcze raz własnymi słowami, np. zaznaczyło „brak czasu” i wpisało „GRAFIK!!”. U tych osób przekodowanie tylko usuwa fałszywe „Inne”. Liczba osób w opcjach z listy wzrosła więc łącznie o 14, a nie o 27. W pytaniu jednokrotnego wyboru jest prościej, bo osoba miała tylko „Inne”, więc przekodowanie przenosi ją do innej kategorii. Liczebność kategorii rośnie dokładnie o tyle, o ile spada liczebność „Inne”.
Krok 5. Nowe kategorie i to, co zostaje w „Inne”
Po przekodowaniu zostało 21 wpisów, które nie pasowały do listy. Słownik zebrał je w trzy grupy kandydatów: brak szkoleń online (9 wpisów), zmęczenie (5) i brak zastępstwa na oddziale (4). Do tego doszły 3 pojedyncze wpisy („stres przed egzaminem”, „słaby angielski”, „problemy zdrowotne”). Według reguły z kroku 3 tylko szkolenia online przekroczyły próg 7 osób i stały się nową zmienną 0/1. Zmęczenie i brak zastępstwa zostały w „Inne”, które ma teraz 12 osób (5.2%).
Grupy poniżej progu możesz wymienić słownie („powtarzały się zmęczenie – 5 osób – i brak zastępstwa – 4 osoby”), ale nie rób z nich wierszy tabeli ani nie licz dla nich testów. Odsetek z kilku osób niewiele mówi.
Nowa kategoria z „Inne” nie jest porównywalna z opcjami z listy. 9 osób (3.9%) samodzielnie wpisało brak szkoleń online. Gdyby ta opcja była w kafeterii, zaznaczyłoby ją prawdopodobnie znacznie więcej osób, bo wybranie gotowej odpowiedzi jest łatwiejsze niż jej wymyślenie i wpisanie. Schuman i Scott (1987) pokazali w eksperymentach, że pytania otwarte i zamknięte dają różne wyniki – nie tylko inne odsetki, ale nawet inną kolejność wyborów. W raporcie pisz więc „co najmniej 3.9% osób spontanicznie wskazało…”. Nie układaj nowej kategorii w jednym rankingu z opcjami z listy bez takiego zastrzeżenia.
Krok 6. Druga osoba koduje niezależnie: kappa Cohena
Słownik reguł koduje zawsze tak samo, ale też myli się zawsze tak samo. Dlatego druga osoba koduje te same wpisy według tego samego klucza, nie widząc Twoich kodów. Zgodność opisz dwiema liczbami: procentem zgodnych decyzji i kappą Cohena. Kappa, wprowadzona przez Cohena (1960), koryguje procent zgodności o zgodność, której należałoby się spodziewać przypadkiem (McHugh, 2012).
W przykładzie dwie osoby zakodowały 48 wpisów merytorycznych w dziesięciu kategoriach klucza. Zgodziły się w 43 wpisach (89.6%), κ = .88, 95% CI [.78, .98] (rysunek 2). Rozbieżności są ważniejsze niż sama liczba, bo pokazują, gdzie klucz jest nieprecyzyjny:
- „pracodawca nie dopłaca” – koszt czy brak zgody przełożonego? Do klucza dopisz regułę, że brak dofinansowania to zawsze koszt;
- „tylko stacjonarnie” – szkolenia online czy dojazd? Klucz mówi: forma szkolenia to „online”, a odległość to „dojazd”;
- „braki kadrowe na oddziale” – brak zastępstwa czy brak czasu? Do przykładów dopisz granicę: brak czasu dotyczy grafiku tej osoby, a brak zastępstwa – obsady oddziału.
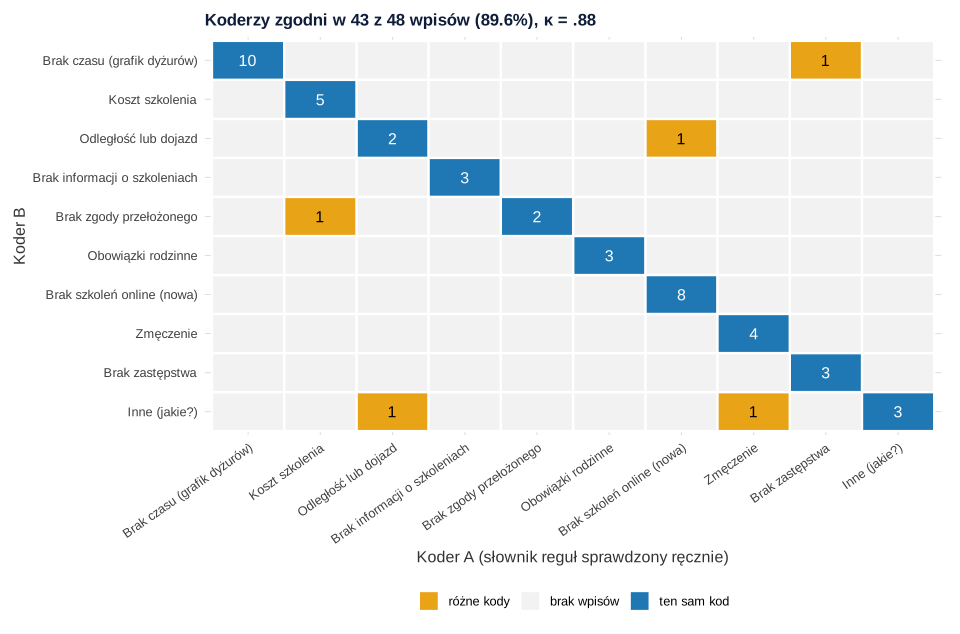
Rozbieżności rozstrzygnij dyskusją albo decyzją trzeciej osoby i zapisz ostateczne kody w osobnej zmiennej. Przy kilkunastu wpisach kappa ma bardzo szeroki przedział, więc podaj go. Uważaj też na kategorie rzadkie. Gdy prawie wszystkie decyzje brzmią „nie”, procent zgodności może być wysoki, a kappa niska (Feinstein i Cicchetti, 1990). Więcej o wyborze miary znajdziesz we wpisie zgodność sędziów: kappa, ICC, alfa.
Odsetki przed i po przekodowaniu
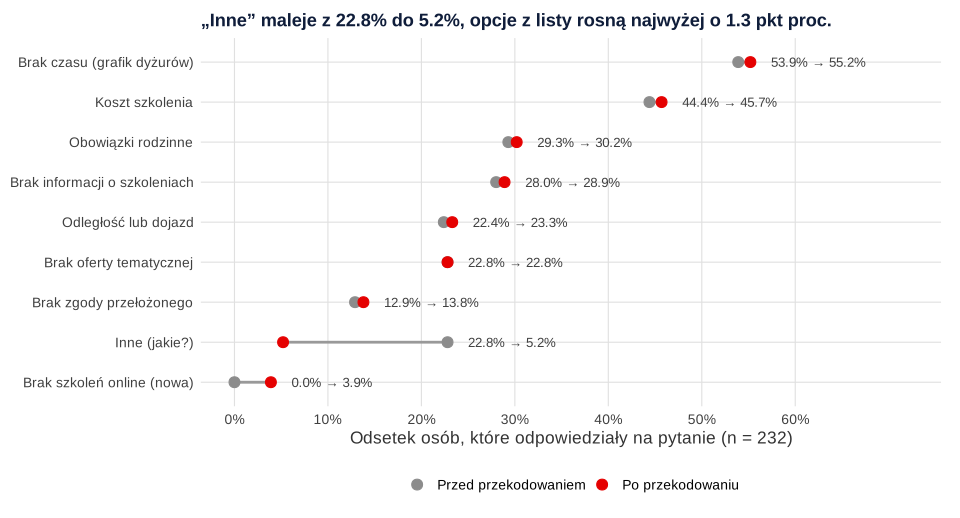
Tabela 1 zestawia odsetki osób przed przekodowaniem i po nim. Mianownik to 232 osoby, które odpowiedziały na pytanie. Odsetki sumują się do ponad 100%, bo można było zaznaczyć kilka opcji. W rozdziale wyników wystarczy kolumna „po”, a całą tabelę daj do aneksu. Jak sformatować tabelę główną z przedziałami ufności, pokazuje wpis o tabeli i wykresie dla pytania wielokrotnego wyboru.
Tabela 1
Przeszkody w udziale w szkoleniach podyplomowych przed przekodowaniem odpowiedzi „Inne” i po nim
| Przeszkoda | n przed | % przed | n po | % po | Zmiana (pkt proc.) |
|---|---|---|---|---|---|
| Brak czasu (grafik dyżurów) | 125 | 53.9 | 128 | 55.2 | +1.3 |
| Koszt szkolenia | 103 | 44.4 | 106 | 45.7 | +1.3 |
| Obowiązki rodzinne | 68 | 29.3 | 70 | 30.2 | +0.9 |
| Brak informacji o szkoleniach | 65 | 28.0 | 67 | 28.9 | +0.9 |
| Duża odległość lub dojazd | 52 | 22.4 | 54 | 23.3 | +0.9 |
| Brak odpowiedniej oferty tematycznej | 53 | 22.8 | 53 | 22.8 | 0.0 |
| Brak zgody przełożonego | 30 | 12.9 | 32 | 13.8 | +0.9 |
| Brak szkoleń onlinea | — | — | 9 | 3.9 | +3.9 |
| Inne (jakie?) | 53 | 22.8 | 12 | 5.2 | −17.6 |
Uwaga. n = 232 osoby, które odpowiedziały na pytanie (8 osób je pominęło). Respondenci mogli wybrać więcej niż jedną odpowiedź; odsetki nie sumują się do 100. „Przed” – kategoria „Inne” obejmuje wszystkie 53 wpisy w polu tekstowym. „Po” – 5 wpisów niemerytorycznych usunięto, 27 przekodowano do opcji z listy, 9 utworzyło nową kategorię. Dane symulowane.
a Kategoria utworzona z wpisów w polu „Inne” (odpowiedzi spontaniczne, nie było jej na liście).
„Inne” zmalało z 22.8% do 5.2%, czyli o 17.6 punktu procentowego. Opcje z listy wzrosły najwyżej o 1.3 punktu (brak czasu: z 53.9% do 55.2%, koszt: z 44.4% do 45.7%), bo połowa przekodowanych osób miała je już zaznaczone (rysunek 3). Kolejność opcji się nie zmieniła. W tabeli bez przekodowania „Inne” zrównałoby się z brakiem oferty tematycznej (po 22.8%), choć w większości są to opcje już obecne na liście.
Grupy porównuj na zmiennych po przekodowaniu, według zasad z wpisu o porównaniu pytań wielokrotnego wyboru między grupami. Kategorii „Inne” nie testuj, bo to zbiór różnych odpowiedzi bez wspólnej treści.
Kiedy zamiast kodować „Inne” lepiej poprawić kafeterię
Dużo wpisów w „Inne” to zwykle sygnał, że kafeteria jest niepełna. Najtańszy moment na poprawkę to badanie pilotażowe. Jeśli w pilotażu kilka osób wpisze to samo, dodaj tę opcję do listy przed badaniem głównym. Gdy nie wiesz, jak osoby rozumieją opcje, pomoże wywiad poznawczy. W przykładzie pilotaż prawdopodobnie ujawniłby brak opcji o szkoleniach online.
„Inne” zostaw na liście nawet po poprawkach. Kafeteria powinna być wyczerpująca, a lista bez „Inne” zmusza osobę do wyboru odpowiedzi, która do niej nie pasuje. Umieść „Inne” zawsze na końcu, poza losowaniem kolejności opcji (zob. efekt kolejności odpowiedzi). Nie rób pola tekstowego obowiązkowego – wymuszony wpis to właśnie „-” i „nie wiem”. Inne typowe usterki kafeterii opisuje wpis o najczęstszych błędach w ankietach.
Jak opisać kodowanie „Inne” w pracy
W metodzie napisz, ile było wpisów, jak je oczyszczono, jaki był klucz i reguła nowej kategorii, kto kodował i jaka była zgodność. W wynikach podaj odsetki po przekodowaniu, a nową kategorię opisz z zastrzeżeniem, że pochodzi z odpowiedzi spontanicznych.
Klucz kodowy i listę wpisów z kodami obu osób dołącz do aneksu. O rozdziale metodologicznym pracy z pielęgniarstwa piszemy we wpisie statystyka w pracy z pielęgniarstwa.
To samo w SPSS
W SPSS najpierw wydziel tekst do osobnej zmiennej. Z LimeSurvey dostajesz go od razu, a w danych z Formularzy Google najłatwiej zrobić to w R albo w arkuszu. Potem oczyść tekst i zapisz reguły w składni, a nie w ręcznie poprawianych komórkach. Funkcja LOWER zamienia wielkie litery na małe, LTRIM i RTRIM usuwają spacje z brzegów, a CHAR.INDEX zwraca pozycję szukanego fragmentu w tekście albo 0, gdy go nie ma. Szkic dwóch reguł:
STRING inne_cz (A200).iCOMPUTE inne_cz = LOWER(LTRIM(RTRIM(inne_tekst))).IF (CHAR.INDEX(inne_cz, 'grafik') > 0 OR CHAR.INDEX(inne_cz, 'dyżur') > 0 OR CHAR.INDEX(inne_cz, 'dyzur') > 0) czas_po = 1.
CHAR.INDEX szuka dokładnego fragmentu, a nie wzorca, więc każdy wariant pisowni to osobny warunek. Przy kilkudziesięciu wpisach często szybciej jest wpisać kod ręcznie w kolumnie obok wpisu i połączyć go z danymi po identyfikatorze (zob. przygotowanie danych w SPSS).
Najczęstsze błędy
- „Inne” bez przekodowania. Tabela zawyża „Inne”, a czytelnik nie wie, co się za nim kryje.
- Usunięcie wpisów „Inne” z analizy. Osoba, która zaznaczyła opcję z listy i dopisała coś w „Inne”, nadal jest w mianowniku. Usuwasz tylko wpisy niemerytoryczne, a nie osoby.
- Dzielenie komórki z Formularzy Google po przecinkach. Wpis „dyzury, nadgodziny” zamienia się w dwie fałszywe opcje. Wyszukuj pełne etykiety z listy, a resztę traktuj jako jeden wpis.
- Próg nowej kategorii ustalony po obejrzeniu danych. Ustal go przed kodowaniem i zapisz w planie analizy, inaczej liczba kategorii zależy od tego, co „ładnie wygląda”.
- Nowa kategoria porównywana z opcjami z listy jak równa z równą. 3.9% osób, które same wpisały brak szkoleń online, to dolne oszacowanie, nieporównywalne wprost z odsetkami opcji z listy (np. 22.8% dla braku oferty tematycznej).
- Kappa bez rozbieżności. Sama wartość κ = .88 nie mówi, które kategorie myliły się osobom kodującym. Rozbieżności pokaż w macierzy zgodności i wykorzystaj je do poprawy klucza.
Jeśli masz eksport z ankiety i nie wiesz, jak zakodować pytania wielokrotnego wyboru albo pole „Inne”, sprawdź pomoc w analizie danych dla studentów. Pełną drogę od formularza do opisu wyników znajdziesz też w przewodniku po ankietach i eksperymentach.
Kodowanie wpisów „Inne” w R: kod i wynik
Dwa przepisy liczą wszystkie liczby z tekstu. Pierwszy tworzy surowy eksport w stylu Formularzy Google i zapisuje go w folderze nadrzędnym (../). Potem wydziela wpisy z „Inne”, czyści je, koduje słownikiem reguł, stosuje regułę nowej kategorii i zestawia odsetki przed i po przekodowaniu. Drugi liczy zgodność dwóch osób kodujących. Rysunki powstały w osobnym skrypcie na tych samych danych. Surowy eksport możesz pobrać: inne-jakie-eksport-surowy.csv (kolumna bariery z zaznaczeniami i wpisami rozdzielonymi przecinkami).
Od surowego eksportu do tabeli przed i po przekodowaniu
R
# B426 – „Inne (jakie?)” w pytaniu wielokrotnego wyboru: od surowego eksportu
# do tabeli przed i po przekodowaniu wstecznym (dane symulowane)
set.seed(426)
N <- 240

# Kafeteria pytania: „Co utrudnia Ci udział w szkoleniach podyplomowych?”
opcje <- c(czas       = "Brak czasu (grafik dyżurów)",
           koszt      = "Koszt szkolenia",
           dojazd     = "Duża odległość lub dojazd",
           informacja = "Brak informacji o szkoleniach",
           zgoda      = "Brak zgody przełożonego",
           rodzina    = "Obowiązki rodzinne",
           oferta     = "Brak odpowiedniej oferty tematycznej")
p_opcji <- c(.55, .40, .22, .28, .12, .30, .18)

# Wpisy w polu „Inne (jakie?)” – z literówkami, wielkimi literami i pustymi „-”
wpisy <- c(
  "dyżury nocne", "Grafik", "praca na 2 etaty", "nadgodziny", "dyzury, nadgodziny",
  "brak czasu po dyżurach", "zmiany 12h", "GRAFIK!!", "wieczne nadgodziny", "drugi etat",
  "za drogie", "Drogo", "brak dofinansowania", "nie stać mnie", "cena", "pracodawca nie dopłaca",
  "daleko", "dojazd do miasta wojewódzkiego", "nie mam samochodu",
  "nie wiem gdzie szukać ofert", "nikt nie informuje", "brak ogłoszeń",
  "oddziałowa nie puszcza", "szef się nie zgadza",
  "małe dzieci", "opieka nad chorym rodzicem", "Dzieci",
  "brak szkoleń online", "tylko stacjonarnie", "wolałabym e-learning", "brak kursów przez internet",
  "brak formy zdalnej", "ONLINE", "brak webinarów", "kursy tylko stacjonarne", "e-learning",
  "zmęczenie", "jestem wypalona", "nie mam siły po pracy", "zmeczenie", "brak energii",
  "brak zastępstwa", "nie ma kto mnie zastąpić", "braki kadrowe na oddziale", "za mało personelu",
  "stres przed egzaminem", "słaby angielski", "problemy zdrowotne",
  "-", "nie wiem", "brak", ".", "nic")

# Surowy eksport w stylu Formularzy Google: jedna komórka, opcje rozdzielone „, ”,
# tekst z „Inne” dopisany w tej samej komórce
zazn <- sapply(p_opcji, function(p) rbinom(N, 1, p))
pominal <- sample(N, 8)                          # 8 osób pominęło całe pytanie
z_inne <- sample(setdiff(1:N, pominal), length(wpisy))
tekst_inne <- rep("", N); tekst_inne[z_inne] <- sample(wpisy)
komorka <- sapply(1:N, function(i) {
  if (i %in% pominal) return("")
  wyb <- opcje[zazn[i, ] == 1]
  if (length(wyb) == 0 && tekst_inne[i] == "") wyb <- sample(opcje, 1)
  paste(c(wyb, if (tekst_inne[i] != "") tekst_inne[i]), collapse = ", ")
})
eksport <- data.frame(id = 1:N, bariery = komorka)
write.csv(eksport, "../inne-jakie-eksport-surowy.csv", row.names = FALSE, fileEncoding = "UTF-8")

# KROK 1. Zmienne 0/1 dla opcji z listy i tekst, który został po ich usunięciu
odp <- eksport$bariery != ""                     # kto odpowiedział na pytanie
d <- eksport
for (k in names(opcje)) d[[k]] <- ifelse(odp, as.integer(grepl(opcje[[k]], d$bariery, fixed = TRUE)), NA)
reszta <- d$bariery
for (o in opcje) reszta <- gsub(o, "", reszta, fixed = TRUE)
d$inne_tekst <- gsub("^[ ,]+|[ ,]+$", "", reszta)

# KROK 2. Oczyszczenie tekstu: małe litery, spacje, znaki na brzegach
czysc <- function(x) {
  x <- tolower(trimws(x))
  x <- gsub("[[:space:]]+", " ", x)
  gsub("^[[:punct:] ]+|[[:punct:] ]+$", "", x)
}
d$inne_czysty <- czysc(d$inne_tekst)
niemerytoryczne <- c("", "nie wiem", "brak", "nic", "nie dotyczy")
d$inne_przed <- ifelse(odp, as.integer(d$inne_tekst != ""), NA)
d$wpis_ok <- d$inne_przed == 1 & !(d$inne_czysty %in% niemerytoryczne)

# KROK 3. Słownik reguł: kod -> wyrażenie regularne (pierwsza pasująca reguła wygrywa)
slownik <- c(czas       = "dy[zż]ur|grafik|etat|nadgodzin|zmian|czas",
             koszt      = "drog|dofinans|sta[cć] mnie|cena|dop[lł]ac|koszt",
             dojazd     = "daleko|doja[zź]d|samoch",
             informacja = "informuj|og[lł]osze|gdzie szuka",
             zgoda      = "oddzia[lł]ow|szef|prze[lł]o[zż]on|zgadza|puszcza",
             rodzina    = "dzieci|dziecko|rodzic|opiek",
             online     = "online|e-?learning|internet|zdaln|webinar|stacjonar",
             zmeczenie  = "zm[eę]cz|wypal|si[lł]y|energi",
             zastepstwo = "zast[eęą]p|kadrow|personel")
koduj <- function(x) {
  kod <- rep("inne", length(x))
  for (k in rev(names(slownik))) kod[grepl(slownik[[k]], x)] <- k
  kod
}
d$kod <- NA
d$kod[which(d$wpis_ok)] <- koduj(d$inne_czysty[which(d$wpis_ok)])

# KROK 4. Reguła ustalona przed kodowaniem: nowa kategoria, gdy wpis ma co najmniej 3% osób,
# które odpowiedziały na pytanie; mniejsze grupy zostają w „Inne”
n_odp <- sum(odp)
prog <- ceiling(0.03 * n_odp)
nowe_kandydaci <- setdiff(names(slownik), names(opcje))
licz_kandydatow <- table(factor(d$kod, levels = nowe_kandydaci))
nowe <- names(licz_kandydatow)[licz_kandydatow >= prog]
cat("Odpowiedziało na pytanie:", n_odp, "z", N, "| próg nowej kategorii:", prog, "osób\n")
cat("Kandydaci na nowe kategorie:\n"); print(licz_kandydatow)
cat("Nowe kategorie:", nowe, "\n\n")

# KROK 5. Przekodowanie wsteczne i nowe zmienne
po <- d
for (k in names(opcje)) po[[k]][which(d$kod == k)] <- 1L
for (k in nowe) po[[k]] <- ifelse(odp, as.integer(d$kod %in% k), NA)
po$inne <- ifelse(odp, as.integer(d$kod %in% c("inne", setdiff(nowe_kandydaci, nowe))), NA)

# Bilans wpisów z pola „Inne”
idx <- which(d$kod %in% names(opcje))
juz <- mapply(function(i, k) d[[k]][i] == 1, idx, d$kod[idx])  # opcja była już zaznaczona?
cat("BILANS WPISÓW „INNE”\n")
cat("Wszystkie wpisy:", sum(d$inne_przed, na.rm = TRUE), "\n")
cat("Niemerytoryczne (usunięte):", sum(d$inne_przed == 1 & !d$wpis_ok, na.rm = TRUE), "\n")
cat("Przekodowane do opcji z listy:", length(juz), "(w tym osoba już zaznaczyła tę opcję:", sum(juz), ")\n")
cat("Do nowej kategorii:", sum(d$kod %in% nowe), "\n")
cat("Zostały w „Inne”:", sum(po$inne, na.rm = TRUE), "\n")
print(table(d$kod[d$kod %in% c("inne", setdiff(nowe_kandydaci, nowe))]))

# KROK 6. Odsetki osób (mianownik: osoby, które odpowiedziały na pytanie)
kat <- c(names(opcje), nowe, "inne")
przed <- sapply(kat, function(k) if (k %in% names(d)) sum(d[[k]], na.rm = TRUE) else 0)
przed["inne"] <- sum(d$inne_przed, na.rm = TRUE)
pozniej <- sapply(kat, function(k) sum(po[[k]], na.rm = TRUE))
tab <- data.frame(kategoria = kat, n_przed = przed, proc_przed = round(100 * przed / n_odp, 1),
                  n_po = pozniej, proc_po = round(100 * pozniej / n_odp, 1))
tab$zmiana_pp <- tab$proc_po - tab$proc_przed
cat("\nODSETKI OSÓB PRZED I PO PRZEKODOWANIU (n =", n_odp, ")\n")
print(tab[order(-tab$n_po), ], row.names = FALSE)

# Zapis wpisów z kodami do sprawdzenia przez drugą osobę i do rysunków
wpisy_kody <- d[which(d$wpis_ok), c("id", "inne_tekst", "inne_czysty", "kod")]
write.csv(wpisy_kody, "b426-wpisy-kody.csv", row.names = FALSE, fileEncoding = "UTF-8")
write.csv(tab, "b426-tabela-przed-po.csv", row.names = FALSE, fileEncoding = "UTF-8")
Wynik w R
Odpowiedziało na pytanie: 232 z 240 | próg nowej kategorii: 7 osób
Kandydaci na nowe kategorie:

    online  zmeczenie zastepstwo
         9          5          4
Nowe kategorie: online

BILANS WPISÓW „INNE”
Wszystkie wpisy: 53
Niemerytoryczne (usunięte): 5
Przekodowane do opcji z listy: 27 (w tym osoba już zaznaczyła tę opcję: 13 )
Do nowej kategorii: 9
Zostały w „Inne”: 12

      inne zastepstwo  zmeczenie
         3          4          5

ODSETKI OSÓB PRZED I PO PRZEKODOWANIU (n = 232 )
  kategoria n_przed proc_przed n_po proc_po zmiana_pp
       czas     125       53.9  128    55.2       1.3
      koszt     103       44.4  106    45.7       1.3
    rodzina      68       29.3   70    30.2       0.9
 informacja      65       28.0   67    28.9       0.9
     dojazd      52       22.4   54    23.3       0.9
     oferta      53       22.8   53    22.8       0.0
      zgoda      30       12.9   32    13.8       0.9
       inne      53       22.8   12     5.2     -17.6
     online       0        0.0    9     3.9       3.9
Zgodność dwóch osób kodujących: procent zgodności i kappa Cohena
R
# B426 – zgodność dwóch koderów wpisów „Inne” (kappa Cohena); uruchom po b426-1-kodowanie.R
suppressPackageStartupMessages({library(irr); library(psych)})
w <- read.csv("b426-wpisy-kody.csv", encoding = "UTF-8")
w$koder_A <- w$kod                       # koder A: słownik reguł sprawdzony ręcznie

# Koder B koduje te same 48 wpisów niezależnie, według tego samego klucza
# (dane symulowane: w pięciu wpisach wybrał inny kod)
w$koder_B <- w$koder_A
inaczej <- c("pracodawca nie dopłaca" = "zgoda", "nie mam samochodu" = "inne",
             "braki kadrowe na oddziale" = "czas", "tylko stacjonarnie" = "dojazd",
             "brak energii" = "inne")
for (t in names(inaczej)) w$koder_B[w$inne_czysty == t] <- inaczej[[t]]

kody <- sort(unique(c(w$koder_A, w$koder_B)))
A <- factor(w$koder_A, levels = kody); B <- factor(w$koder_B, levels = kody)
cat("Wpisy kodowane przez obie osoby:", nrow(w), "| kategorie klucza:", length(kody), "\n")
cat("Zgodność procentowa:", round(100 * mean(A == B), 1), "%\n\n")

k <- kappa2(data.frame(A, B))
print(k)
ck <- suppressWarnings(cohen.kappa(data.frame(A, B)))  # ostrzeżenie dotyczy kappy ważonej
cat("\nKappa z 95% CI (psych::cohen.kappa):",
    sprintf("%.3f [%.3f, %.3f]", ck$confid[1, 2], ck$confid[1, 1], ck$confid[1, 3]), "\n\n")

cat("Wpisy, w których koderzy się różnią:\n")
print(w[A != B, c("inne_tekst", "koder_A", "koder_B")], row.names = FALSE)
write.csv(as.data.frame(table(A = A, B = B)), "b426-macierz-zgodnosci.csv", row.names = FALSE)
Wynik w R
Wpisy kodowane przez obie osoby: 48 | kategorie klucza: 10
Zgodność procentowa: 89.6 %

 Cohen's Kappa for 2 Raters (Weights: unweighted)

 Subjects = 48
   Raters = 2
    Kappa = 0.881

        z = 16.6
  p-value = 0

Kappa z 95% CI (psych::cohen.kappa): 0.881 [0.783, 0.979]

Wpisy, w których koderzy się różnią:
                inne_tekst    koder_A koder_B
         nie mam samochodu     dojazd    inne
        tylko stacjonarnie     online  dojazd
    pracodawca nie dopłaca      koszt   zgoda
 braki kadrowe na oddziale zastepstwo    czas
              brak energii  zmeczenie    inne
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietami irr i psych; rysunki przygotowano w pakietach ggplot2 i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- irr (wersja 0.85): Gamer, M., Lemon, J., Fellows, I., & Singh, P. (2026). irr: Various coefficients of interrater reliability and agreement (R package version 0.85) [Computer software]. https://doi.org/10.32614/CRAN.package.irr
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czy odpowiedzi „Inne” można po prostu usunąć z analizy?
Nie. Osoba, która coś wpisała, odpowiedziała na pytanie i zostaje w mianowniku odsetków. Usuń tylko wpisy bez treści („-”, „nie wiem”, „brak”) – wtedy ta osoba ma 0 w zmiennej „Inne”, ale nadal liczy się do osób odpowiadających. Pozostałe wpisy przeczytaj i przypisz do opcji z listy, do nowej kategorii albo zostaw w „Inne”.
Ile osób musi wpisać to samo, żeby utworzyć nową kategorię?
Nie ma jednej normy. Ustal próg sam, przed kodowaniem, i wpisz go do planu analizy, np. co najmniej 3% osób, które odpowiedziały na pytanie (w przykładzie 7 z 232). Grupy mniejsze niż próg zostaw w „Inne” i najwyżej wymień je słownie, bo odsetki z kilku osób są bardzo niestabilne.
Co zrobić, gdy ktoś zaznaczył „Inne” i wpisał odpowiedź, która jest na liście?
Przekoduj ją wstecz: wpisz 1 w zmiennej tej opcji i usuń „Inne” u tej osoby (back-coding). W pytaniu wielokrotnego wyboru osoba często ma już tę opcję zaznaczoną. Wtedy liczba osób w opcji się nie zmienia, tylko znika fałszywe „Inne”. W przykładzie dotyczyło to 13 z 27 przekodowanych wpisów.
Czy do kodowania odpowiedzi „Inne” potrzebna jest druga osoba?
Jest bardzo przydatna, a promotorzy coraz częściej jej oczekują. Druga osoba koduje te same wpisy według tego samego klucza i nie zna Twoich kodów. Podajesz procent zgodności i kappę Cohena z przedziałem ufności, a rozbieżności wykorzystujesz do poprawy klucza. Przy kilkunastu wpisach kappa ma szeroki przedział, więc go podaj.
Czy nowa kategoria utworzona z wpisów „Inne” jest porównywalna z opcjami z listy?
Nie w pełni. Zaznaczyć gotową opcję jest łatwiej niż samemu ją wpisać, więc odsetek z wpisów spontanicznych jest zwykle zaniżony. Opisz go jako dolne oszacowanie („co najmniej 3.9% osób samodzielnie wskazało…”). Jeśli kategoria jest ważna dla Twojego pytania badawczego, dodaj ją do kafeterii w kolejnym badaniu albo już po pilotażu.
Powiązane hasła
Przeczytaj też
Pytania wielokrotnego wyboru – kodowanie i liczenie
Eksport z Google Forms i LimeSurvey, zmienne 0/1, mianownik, % osób z przedziałem Wilsona i liczenie w R, Excelu, SPSS, jamovi i SZTOS.
Czytaj →PoradnikAnaliza treści pytań otwartych
Klucz kategoryzacji, pilotaż, kappa dla każdej kategorii, odsetki z przedziałem Wilsona i porównanie grup – z plikiem Excel, kodem R i opisem APA.
Czytaj →PoradnikDane z Google Forms i LimeSurvey: kodowanie do SPSS i R
Eksport, nazwy zmiennych, rekodowanie Likerta, pozycje odwrócone, wielokrotny wybór i braki – krok po kroku, z kodem R i wzorem książki kodowej.
Czytaj →Masz eksport z ankiety pełen wpisów „Inne”?
Pomożemy zakodować pytania wielokrotnego wyboru i wpisy własne, policzyć odsetki w R lub SPSS i opisać decyzje tak, żebyś umiał(a) samodzielnie obronić je przed promotorem.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Cohen, J. (1960). A coefficient of agreement for nominal scales. Educational and Psychological Measurement, 20(1), 37–46. https://doi.org/10.1177/001316446002000104
- Feinstein, A. R., & Cicchetti, D. V. (1990). High agreement but low kappa: I. The problems of two paradoxes. Journal of Clinical Epidemiology, 43(6), 543–549. https://doi.org/10.1016/0895-4356(90)90158-l
- McHugh, M. L. (2012). Interrater reliability: The kappa statistic. Biochemia Medica, 22(3), 276–282. https://doi.org/10.11613/BM.2012.031 ● Otwarty dostęp
- O’Cathain, A., & Thomas, K. J. (2004). “Any other comments?” Open questions on questionnaires – a bane or a bonus to research? BMC Medical Research Methodology, 4(1), Article 25. https://doi.org/10.1186/1471-2288-4-25 ● Otwarty dostęp
- Schuman, H., & Scott, J. (1987). Problems in the use of survey questions to measure public opinion. Science, 236(4804), 957–959. https://doi.org/10.1126/science.236.4804.957
- Singer, E., & Couper, M. P. (2017). Some methodological uses of responses to open questions and other verbatim comments in quantitative surveys. Methods, Data, Analyses, 11(2), 115–134. https://doi.org/10.12758/mda.2017.01 ● Otwarty dostęp: pełny tekst
- Züll, C. (2016). Open-ended questions. GESIS – Leibniz Institute for the Social Sciences. https://doi.org/10.15465/gesis-sg_en_002 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{cohen1960coefficient, author={Cohen, Jacob}, title={{A coefficient of agreement for nominal scales}}, journal={Educational and Psychological Measurement}, year={1960}, volume={20}, number={1}, pages={37--46}, doi={10.1177/001316446002000104}}@article{feinstein1990high, author={Feinstein, Alvan R. and Cicchetti, Domenic V.}, title={{High agreement but low kappa: I. The problems of two paradoxes}}, journal={Journal of Clinical Epidemiology}, year={1990}, volume={43}, number={6}, pages={543--549}, doi={10.1016/0895-4356(90)90158-l}}@article{mchugh2012interrater, author={McHugh, Mary L.}, title={{Interrater reliability: The kappa statistic}}, journal={Biochemia Medica}, year={2012}, volume={22}, number={3}, pages={276--282}, doi={10.11613/bm.2012.031}}@article{ocathain2004any, author={O'Cathain, Alicia and Thomas, Kate J.}, title={{“Any other comments?” Open questions on questionnaires – a bane or a bonus to research?}}, journal={BMC Medical Research Methodology}, year={2004}, volume={4}, number={1}, eid={25}, doi={10.1186/1471-2288-4-25}}@article{schuman1987problems, author={Schuman, Howard and Scott, Jacqueline}, title={{Problems in the use of survey questions to measure public opinion}}, journal={Science}, year={1987}, volume={236}, number={4804}, pages={957--959}, doi={10.1126/science.236.4804.957}}@article{singer2017some, author={Singer, Eleanor and Couper, Mick P.}, title={{Some methodological uses of responses to open questions and other verbatim comments in quantitative surveys}}, journal={Methods, Data, Analyses}, year={2017}, volume={11}, number={2}, pages={115--134}, doi={10.12758/mda.2017.01}}@techreport{zull2016open, author={Züll, Cornelia}, title={{Open-ended questions}}, year={2016}, institution={GESIS – Leibniz Institute for the Social Sciences}, doi={10.15465/gesis-sg_en_002}}